MCP 是什么:让 AI 连接外部工具的通用协议
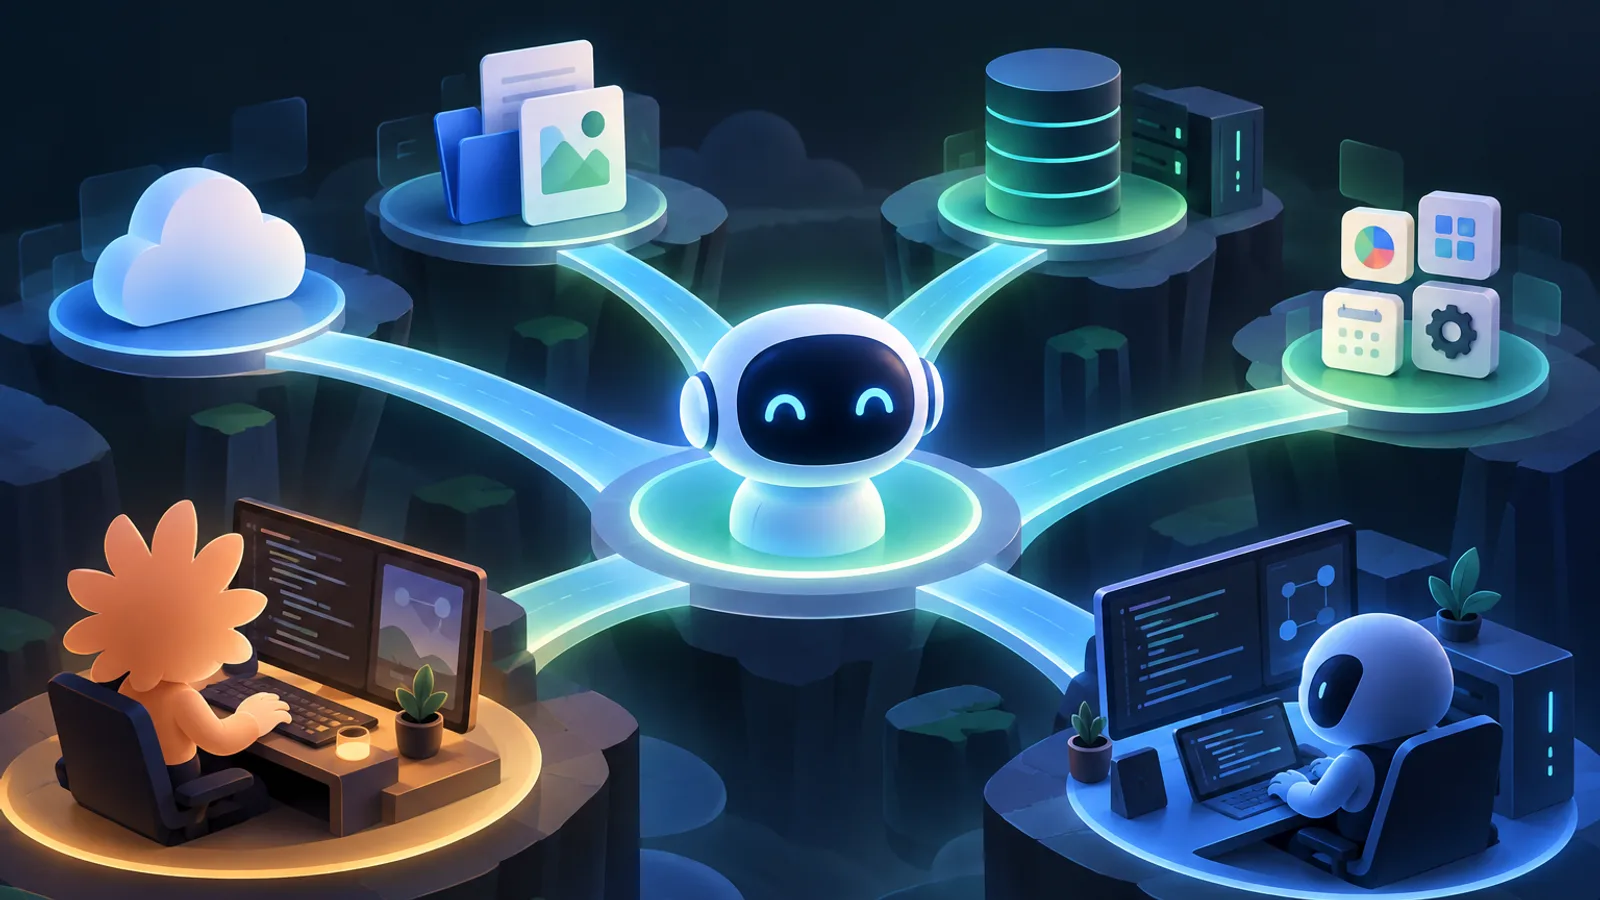
大语言模型擅长理解和生成文字,但它本身不一定能读取你的项目文件、查询数据库、操作设计稿或调用业务系统。MCP(Model Context Protocol,模型上下文协议)就是为这类连接提供共同约定:让 AI 应用能够以相对一致的方式发现并使用外部数据与工具。
可以把 MCP 想成 AI 应用与外部服务之间的“通用插头”。服务端按协议提供能力,客户端按协议连接;双方不必为每一种工具、每一种 AI 应用都单独设计一套接口。需要注意的是,MCP 是连接机制,不是模型,也不会自动让模型变聪明。它能否解决问题,仍取决于接入的服务、权限设置和模型的判断。
MCP 服务可以提供不同类型的能力,例如可供模型调用的工具、可读取的资源,以及可复用的提示模板。比如,一个代码搜索服务可以帮助 Agent 查找项目中的相关实现;一个设计工具连接器则可能让 Agent 读取或修改设计内容。实际提供什么能力,要看具体服务的实现。
为什么需要 MCP:从定制集成到统一接口
在 MCP 这类协议出现前,AI 应用要连接外部工具,通常需要针对不同服务分别开发集成。每个连接都可能有自己的配置方式、数据格式和权限处理逻辑。工具一多,维护成本也随之增加:服务端要适配多个客户端,客户端也要为不同服务准备不同的连接方式。
MCP 的思路是把一部分共通规则标准化。服务提供方实现 MCP 服务后,兼容的客户端就有机会按统一协议接入,而不必从零理解每个服务的通信方式。这并不代表所有 MCP 服务都能在所有客户端中即插即用:客户端支持的功能、服务的部署方式和认证要求仍可能不同。
对开发者而言,统一接口的价值主要体现在可组合性上:可以根据任务替换或增加服务,而不必把所有能力都写进一个 Agent。比如,编码 Agent 可以连接代码搜索服务,也可以连接其他开发工具;使用者则需要确认每个服务获得了哪些权限。
MCP 如何工作:客户端、服务器与工具调用
一次典型的 MCP 交互,涉及宿主应用、MCP 客户端和 MCP 服务端。宿主应用是用户实际操作的 AI 产品;客户端负责按照 MCP 协议与服务端通信;服务端则向客户端声明自己提供的能力。服务端可以在本机运行,也可以通过网络提供服务,具体取决于其实现和客户端支持的传输方式。
大致流程如下:
- 客户端连接服务端,并了解它提供的工具或其他能力。
- 模型根据用户请求判断是否需要使用某项能力。
- 客户端把调用请求发送给服务端。
- 服务端执行相应操作并返回结果。
- 模型结合结果继续回答,或发起下一步调用。
协议让“如何沟通”更一致,却不会消除安全责任。工具可能读取文件、访问外部服务,甚至执行会产生副作用的操作。因此,配置 MCP 时应核对服务来源、权限范围和具体能力;涉及删除、发布、付款等敏感操作时,更要保留必要的人工确认。不要把 API 密钥或其他凭据直接粘贴进不可信的配置或对话中。
提示
把 MCP 服务当作具有明确权限边界的集成来审查,而不是把它看成一段无害的提示词。只启用当前任务需要的能力。
从 Claude 到 Codex:MCP 在编码 Agent 中的应用
MCP 进入开发者视野,一个重要场景就是编码 Agent:它们需要理解代码库,也可能需要调用搜索、测试、设计或部署相关工具。Anthropic 的 Claude Code 是支持 MCP 集成的终端编码工具;目录中的 Claude Code Agent 也体现了 MCP 在多步工程任务中的应用。
OpenAI 的 Codex CLI 与 Codex Agent 则代表另一类终端编码 Agent。Codex 可通过 MCP 工具扩展代码生成和修复能力。具体可用功能、配置流程与权限机制会因客户端版本和服务而异,使用前应查看对应产品的文档,而不要假设不同客户端的设置完全相同。
例如,Claude Context 提供语义代码搜索能力,可为 Claude Code 等编码 Agent 补充整个代码库的上下文;TalkToFigma 则面向 AI Agent 与 Figma 的交互。它们展示了编码工作流如何越过纯文本编辑,连接到代码知识和设计工具。
需要区分 MCP 服务与 Skill:前者按协议提供可调用能力,后者通常提供任务说明或工作流程。比如 ui-taste 和 anti-ui-slop 是面向编码 Agent 的 Skill,并非 MCP 服务。它们可以与 MCP 工具分别发挥作用,但不能因为都能扩展 Agent 能力,就把两者当成同一种机制。
MCP 的发展历程与生态现状
MCP 最初由 Anthropic 提出,目标是为模型应用连接外部上下文和工具建立开放协议。随着更多客户端与服务开始支持这一思路,MCP 的使用场景逐渐从对话应用扩展到开发工具、自动化流程以及其他 Agent 工作流。它的发展重点也从“能不能连上”转向能力发现、权限控制、部署方式和实际任务中的可靠性。
生态目录中的条目能帮助新手观察这种多样性:除了编码工具,Puter 可让兼容客户端与其资源交互;claude-flow 则面向 AI 编排,提供多种 MCP 工具。另一方面,客户端形态也不止终端 Agent,例如 Repomix 可以把代码仓库整理成适合 AI 阅读的单一文件,而 E2Easy 面向无代码端到端测试场景。
这些例子说明,MCP 生态不是一个单独的“工具商店”,而是客户端、服务、Agent 和相关工作流共同构成的网络。条目出现在目录中,并不等于每个客户端都支持它的全部能力,也不等于服务适合所有环境。选择时应同时看任务是否匹配、需要哪些权限、如何运行,以及维护者提供了什么使用说明。
新手如何开始:选择客户端并尝试一个 MCP 服务
入门不必一次接入很多服务。先选一个自己熟悉、且明确支持 MCP 的客户端,例如 Claude Code 或 Codex,再从一个目标清晰、权限范围较小的服务开始。可以按以下步骤尝试:
- 确定任务。 例如,希望 Agent 能搜索代码库,或读取某项外部资源。
- 查找匹配的服务。 阅读服务说明,确认它提供的能力、运行条件和权限要求。
- 按客户端文档配置。 配置格式和连接方式可能不同,优先使用客户端及服务维护者提供的说明。
- 检查实际授权范围。 确认服务能访问什么,不要为了省事授予不必要的权限。
- 用低风险任务验证。 先让 Agent 查询或读取信息,再测试会修改数据的操作。
如果目标是让 Agent 理解大型代码库,可以先了解 Claude Context;如果关注设计协作,可查看 TalkToFigma。选择时以当前客户端的兼容性和服务文档为准。MCP 的价值在于让能力连接更容易复用,而安全、适配和结果验证仍需要开发者把关。从一个小任务开始,确认整个调用链按预期工作,再逐步扩展,通常是最稳妥的路径。