ClaudeR について
ClaudeRは、RStudioやPositronのライブR・Pythonセッションを、Claude CodeやCodexなどのMCP対応エージェントに接続します。複数エージェントによる研究作業を支援し、実行履歴を記録します。
主な機能
- 01エージェントをライブR・Pythonセッションに接続
- 02セッション内のデータやモデルでコードを実行
- 03プロット表示と環境オブジェクトの確認
- 04エディターで開いたファイルの編集
- 05複数エージェントとセッションの連携
- 06コマンドと実行履歴の記録
活用シーン
- 01作業中のRセッションでデータを分析
- 02複数エージェントで研究タスクを分担
- 03論文の監査と改訂準備
MCP 対応
ClaudeRはMCP対応エージェントをライブR・Pythonセッションに接続します。付属のMCPブリッジは、セッション、エディター、連携、バックグラウンドジョブ、論文監査のツールを提供します。
詳細

ClaudeR - 現代の研究者のためのツールキット
RStudio または Positron で使用中の R または Python セッションを、Claude Code、Codex、または MCP ベースのあらゆる LLM エージェントに接続します。対話型分析、マルチエージェントのオーケストレーション、自動化された原稿監査に対応します。




ClaudeR は、Claude Code や Codex などの MCP 対応 LLM エージェントを、すでに作業中の R セッションに接続します。エージェントは、クレンジング済みのデータや適合済みのモデルが実際に存在する場所でコードを実行し、描画したプロットを確認し、環境内のオブジェクトを読み取り、エディターで開いているファイルを編集できます。ライブ Python セッション向けのコンパニオン Python パッケージもあり、どちらも RStudio と Positron で動作します。
複数のエージェントを1つのセッションで共有して作業を分担させることも、セッションを個別に並行して実行し、各エージェントが互いに干渉せずに独自のデータセットを扱うこともできます。
有料の研究向け AI ツールが提供する機能の多くをカバーしながら、作業は自分のセッション内で行われ、エージェントが実行したすべての行の記録も残ります。
クイックスタート
# Install
if (!require("devtools")) install.packages("devtools")
devtools::install_github("IMNMV/ClaudeR")

# Set up your AI tool
library(ClaudeR)
install_clauder()          # For Claude Desktop / Cursor
install_cli(tools = "claude")  # For Claude Code CLI

# Start the server in RStudio
claudeAddin()
AI エージェント向け: 自動セットアップ手順については、llms-install.md を参照してください。
デモ
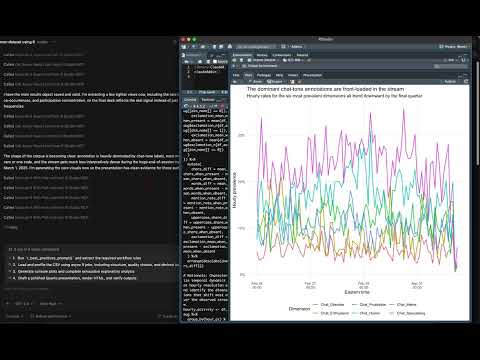
| Claude Desktop App 経由の単一エージェント | マルチエージェント:CLI 経由の Codex + Claude Code | GPT 5.4 Codex:データ分析 + Quarto レポート |
|---|---|---|
 |  |  |
最近の更新(クリックして展開)
-
長時間のジョブでの確認回数を削減、長い出力も失われず、Agents パネルもすっきり(R 0.16.2 / clauder-mcp 0.16.2)。
get_async_resultはジョブを待機し、完了した時点で結果を返すようになりました(最大wait_s秒、デフォルトは300秒)。そのため、20分かかるモデルの適合でも、約120回ではなく数回の呼び出しで済みます。出力が長すぎて全体を送信できない場合は、全出力がファイルに保存され、その保存先がエージェントに通知されます。これにより、コードを再実行せずに、切り捨てられた部分を読み取れます。アドインの Agents パネルでは、cr_roster()と同様に、1日間確認されていないエージェントが非表示になりました。そのため、新しく開いたセッションに数週間前のエージェントが表示されることはありません。 -
アドインからのコンソールログ記録を修正(R 0.14.2)。 アドインで「自分のコンソールコマンドも記録する」にチェックを入れても、0.14.1 では何も記録されませんでしたが、コンソールで
start_console_logging()を呼び出すと機能していました。原因は、警告とメッセージを監視するために使われるglobalCallingHandlers()は、ハンドラースタックが空の場合にしか呼び出せず、チェックボックスを処理する Shiny オブザーバー内でエラーが発生し、コンソールコールバックの登録前に関数が中断されていたことでした。コールバックは最初に無条件で登録されるようになりました。ハンドラーはコンソールからログ記録を開始した場合にのみ設定され、それ以外の場合は各コマンドの実行後にlast.warningから警告を読み取ります。アドインから開始した場合に記録されないのはmessage()の出力だけであり、その旨はアドインに表示されます。 -
エージェントに送る内容を制御し、誰も見ていないプロットの送信を停止(R 0.15.0 / clauder-mcp 0.15.0)。 2 件のユーザーリクエストを受けて追加されました。アドインに新しい AGENT CONTEXT パネルが追加され、2 つの設定を変更できます。「プロットをエージェントに自動送信する」はオフにできます。この場合、プロットが描画されたことがエージェントに伝えられ、必要に応じて
execute_r_with_plotで取得します。テキストが主な目的の場合、画像 1 枚あたり約 4,500 トークンを節約できます。どちらの設定でも、Plots ペインには影響しません。「エージェントが利用できるツール」では、使用していないツールグループ(エディター、セッション、調整、バックグラウンドジョブ、原稿監査)を非表示にできます。41 個すべてのツールを含めると、リクエストごとにスキーマのため約 8,600 トークンが必要ですが、プログラミングのみのセッションでは、そのうち約 1,200 トークンで済みます。どちらの設定もセッションごとに適用され、再起動なしで有効になります。ただし、一部の MCP クライアントは再接続するまでツールリストの変更を認識しません。これとは別に、バグも修正されました。p <- ggplot(...)は代入によって何も表示されないにもかかわらず、エージェントに画像全体を返していたため、Plots ペインには表示されていないプロットがエージェントに送信されていました。今後は、実際に表示されたプロットのみがキャプチャされます。 -
ログ記録を修正(R 0.14.1)。 ユーザーから報告された 2 つの問題に対応しました。エージェントの出力はログに記録されず、コードだけが記録されていました。コードの実行前にログのエントリが書き込まれていたためです。現在は、各呼び出しで出力された内容がログに記録されます。また、0.14.0 で追加された出力キャプチャが、コンソールのログ記録を完全に停止させることがありました。コンソールコールバックを登録する前に独自の出力シンクを開いていたため、シンクを開けないと何も記録されませんでした。シンクのオープンは任意になり、失敗した場合もコマンドとその値の記録に切り替わります。別の実行によってシンクが巻き戻された場合は復元され、エージェントの実行では、自身が開いていないシンクを閉じなくなりました。ログに記録された出力行にはマークが付けられ、再生、履歴、ノートブックへのエクスポートではスキップされます。
-
コンソールログで結果だけでなく出力もキャプチャ(R 0.14.0)。 ログ記録に関するリクエストへの追加対応です。ログにはコマンドが返した値が記録されていたため、副作用として出力された内容が抜けていました。たとえば
cat()、進捗出力、関数内で呼び出したprint()などです。f()を実行すると呼び出しは表示されても、f()が出力した内容は表示されませんでした。これは、自分で遭遇したエラーをエージェントに提示する際に必要となるコンテキストです。標準出力がログにも転送され、すでにキャプチャされている警告、メッセージ、エラーとともに、それを生成したコマンドの下にまとめられるようになりました。コンソールにはこれまでどおりすべてが表示されます。 -
Windows のセッション生存確認を修正(R 0.13.2)。 記録された R セッションがまだ動作中かどうかを確認する際に、
tools::pskill(pid, signal = 0)を使っていました。これは Unix で標準的な方法ですが、Windows ではpskillはシグナルにかかわらず常にTerminateProcessを呼び出します。そのため、確認対象のセッションを終了させたうえで動作中と報告し、古いディスカバリーファイルも残していました。その結果、サーバーの起動によって別の RStudio セッションが終了し、エージェントの接続先が応答しないポートになることがありました。現在は、シグナルを送らずに生存確認を行います。別途、異なる動作中のセッションがすでに使用している名前でセッションを登録しようとした場合、ディスカバリーファイルを黙って上書きするのではなく、警告が表示されます。これにより、エージェントが誤ったポートとトークンを保持してしまう問題が解消されます。 -
コンソールログの統合(R 0.13.0)。 セッションログにはエージェントが実行した内容は記録されていましたが、ユーザーが実行した内容は記録されていませんでした。そのため、コンソールで発生したエラーの説明をエージェントに求めるには、エージェント経由で作業を再実行する必要がありました。「Logging」の下にある「Also log my own console commands」にチェックを入れると、ユーザーのコンソール操作も同じファイルに記録され、誰が何を実行したかがタグ付けされます。記録されるのはコマンド、その出力、警告、メッセージ、エラーです。これで、エージェントがセッションの双方を確認するには「ログの最後の100行を読んでください」と伝えるだけで十分です。デフォルトでは無効です。アドインで切り替えるか、
start_console_logging()/stop_console_logging()を呼び出してください。 -
エディターツールの修正と、適用前に承認を求める編集機能(R 0.12.5 / clauder-mcp 0.14.4)。 ユーザーから寄せられた2件の報告をもとに対応しました。
modify_code_sectionとinsert_textはデフォルトでディスクに保存するようになり、saved_to_diskを報告するため、変更が未保存のバッファーに残っているのに、エージェントがファイルに書き込んだと思い込むことがなくなりました。範囲指定した置換では行数を変更できるようになりました(従来の行数一致の制約はなくなりました)。どちらのツールも、特定のファイルを対象にするpathを受け付け、そのファイルを開いてフォーカスします。また、別のドキュメントを誤って編集する代わりに、編集を拒否するようになりました。get_active_documentは、パス、ドキュメント ID、バッファーがディスク上の内容と異なるかどうかを報告するようになり、バッファーの状態とファイルの状態が混同されなくなりました。新しいsuggest_editツールでは、エージェントが変更案を提示し、ユーザーの承認を待ちます。インストール済みの rstudioapi が対応している場合はrstudioapi::showEditSuggestion()を使用し、そうでない場合は変更を未保存の状態でステージングします。ユーザーは保存して承認するか、元に戻して却下できます。 -
Reviewer Zero が照合作業だけでなく、推論も行うようになりました(R 0.12.4)。 基本の監査プロトコルに、必須の第5パス(内容の推論)を追加しました。決定論的なツール(reconcile_values、verify_references、check_cross_references、probe_scripts)は、数値、参照、相互参照、コードの不備を検出しますが、意味を推論することはできません。そのため、原稿がこれらのチェックをすべて通過しても、誤りが残ることがあります。第5パスは、ツールでは確認できない8項目を検証する、実行条件付きの同等の重みを持つパスです。具体的には、測定手段と出典の帰属、報告された各検定が実際に存在するデータから計算可能かどうか、引用された各図表に主張を裏付ける証拠が実際に含まれているかどうか、効果の大きさを示す表現、複数の研究を通じた収束、因果関係と一般化の表現、記述的な主張を裏付けるデータの存在、補足資料と付録の統合(すべての補足資料が引用され、本文中の主張が未引用の資料に依拠していないこと)です。既知の不備を含む合成原稿を使った統制ベンチマークでは、検出数がネイティブツールのベースライン(24項目中16.8項目)を下回る水準から、明確に上回る水準(24項目中21.3項目)に増加しました。偽陽性を増やすことなく、従来のツール主導のプロトコルで見逃していた推論上の不備を正確に検出しました。
-
共有接続でのアイデンティティ、コーディネーションの可視性、古いセッションのガード(R 0.12.2 / clauder-mcp 0.14.2)。 3つのペルソナが参加した実地セッションからの3つの修正です。(1)1つのMCP接続を共有するペルソナが互いの名前を変更していました。
set_agent_nameは接続全体のアイデンティティを変更するためです。send_message、check_messages、wait_for_messageに追加された新しいas_agentパラメーターを使うと、1回の呼び出しで名前付きペルソナとして動作し、名前ごとに別個の読み取りカーソルを持てます。ブリッジでもこのパターンを強制するようになりました。別の名前での2回目のset_agent_nameは、強制指定がない限り拒否され、送信確認には送信時の名前が反映され、エージェントの紹介文には現在のアイデンティティの由来が記載されます。(2)コーディネーションメッセージは設計上 R を経由しないため、エージェント同士が話している間、コンソールにも Agents パネルにも何も表示されませんでした。アドインは、新しいコーディネーションイベントをすべて(省略せずに)コンソールに出力し、セッションログに追加し、最終確認からの経過時間を含むリアルタイムのコーディネーション参加者一覧を表示するようになりました。(3)停止した R セッションを参照したままのブリッジが、稼働中のエージェントが読まないコーディネーションログに書き込みながら「成功」と報告していました。稼働中のセッションがない場合、コーディネーション呼び出しは明示的に失敗するようになり、接続が別の稼働中セッションに再バインドされたときは、そのことを通知するようになりました。パイロット 2 からの追加事項:check_cross_referencesが S で始まる補足資料の番号付けに対応し、監査プロトコルに htest フィールドのunname()と、著者名と年による引用照合が記載されました。 -
エージェントのアイデンティティと再起動をまたぐ履歴(R 0.11.0 / clauder-mcp 0.13.0)。 3日間にわたる3エージェントのセッションで寄せられた現場からの報告をもとに構築しました。新しい
set_agent_nameツールでは、エージェントが作業名(例:「Claude-Stasis」)を一度設定すると、実行履歴、メッセージの帰属情報、プレゼンス、読み取りカーソルにその名前が引き継がれます。これにより、複数のエージェントやペルソナが1つのMCP接続を共有し、1つのランダム ID にまとめられてしまう問題を解決します。get_session_historyにinclude_pastが追加されました。これを使うと、ディスク上の過去のセッションログファイルを解析するため、誰が何を実行したかの監査が R の再起動後も保持されます。コーディネーションプロトコルでは、チェックインの最初の手順としてアイデンティティを確認するようになりました。 -
研究者向けワークフローのリリース(R 0.10.0 / clauder-mcp 0.12.0)。 有料ツールで提供されている3つのワークフローを、ClaudeR にすでに備わっていた仕組みを活用して構築しました。(1)システマティックレビューのスクリーニング:異なるモデルファミリーから選ばれた2つの独立した AI スクリーナーが、すべての抄録を基準に照らして判定します。新しい
screening_reportツールが一致度、Cohen のカッパ、PRISMA フロー件数、意見の不一致がある文献の一覧を算出するため、人間が読むのは意見が分かれた文献だけです。(2)助成金審査パネルモード:grant_panel_prompt(rubric = "nih")を使うと、審査基準ごとに1人の査読者を割り当てた模擬審査会を開き、根拠のある弱点と、スコアを上げるために有効な改訂案を順位付けして提示します。(3)査読者への回答:reviewer_response_prompt()は採否通知を解析して項目ごとの対応表を作成し、解析を再実行して回答に実際の計算結果を含め、すべての項目に回答するまで先に進めないようにします。さらにexport_response_letter()を使って回答書をエクスポートし、原稿に Word コメントを追加します。 -
Coordination v2 とコンセンサスゲート(R 0.9.0 / clauder-mcp 0.11.0)。 マルチエージェント用ボードを、実際の数時間に及ぶマルチエージェントセッションの現場からの報告をもとに設計した、ディスク上の型付き追記専用イベントログにしました。散文を検索するのではなく型付きシグナルを使い、エージェントごとに読み取りカーソルを設けることで(共有データフレームでの競合は構造上起こりません)、返信のスレッド化、リースベースのタスク取得、共有状態のためのファクトストア、自動記録されるプレゼンス、相手エージェントのイベントが届くまで待機する
wait_for_messageツールを実現しました。ビジー状態の R セッションには触れません。新しいコンセンサスゲートでは、propose_plan()の後、すべてのエージェントが必須の文言を一字一句そのまま使ってconfirm_agreement()を実行するまで、実行レスポンスに合意バナーが表示されます。その後にのみ、計画が承認済みとマークされます。さらに、referee_prompt(stance = "reviewer2")では、敵対的ながら公平な Reviewer 2 が、予断のない3文の所見(中心的な主張、および有力な学術誌に採択されるかどうか)から始め、指摘事項を致命的/必須修正/軽微に分類し、それぞれに該当する研究を明記します。 -
Referee Mode v2:設定可能なレビュアー(R 0.8.0)。
referee_prompt()にlenses(任意の組み合わせを実行)、reviewers_per_lens(2 は敵対的な検察官と検証者のペア、3 はさらに逆方向に読むレビュアーを追加)、model(すべてのサブエージェントに適用するモデルのティア。素早い確認には"haiku"、投稿品質のレビューには"opus"など。またはレンズごとに名前を指定したベクトル)、およびcross_vendor = TRUEを指定できるようになりました。これにより、codex/agy/qwen のワンショットを介して、論理/手法のレビュアーを別のモデルベンダーに振り分けられます。手法には、レビューの崩壊を防ぐルールが必須となりました。レビュアーのプロンプトはレンズとスタンスごとに一から作成し、一貫性レンズは後ろから前に読み、各指摘事項には独立したレビュアー間での裏付け数を記載します。 -
Referee Mode(R 0.7.0 / clauder-mcp 0.10.0)。 有料サービスなら1回あたり約50ドルかかる本格的な原稿レビューを、すでに利用しているサブスクリプション上で無料で実行し、適切な場所、つまり原稿内の Word コメントとして提供します。
reviewer_zero_prompt(referee = TRUE)(または単独のreferee_prompt())は、CLI が対応している場合、内容に特化した5つのレビュー観点(論旨の論理、手法、内部整合性、エビデンスの提示、フレーミング)を並列サブエージェントとして実行します。すべての指摘事項は原文の引用に紐づけ、文書に反映される前に独立した検証を通過する必要があります。深刻度は適切に維持され、適切な論文に指摘事項がないという報告も有効な結果です。また、新しいcheck_cross_referencesツールは、宙に浮いた参照(Table 4 が存在しなくなったのに「Table 4 を参照」と記載されている場合など)や、本文で言及されていない表や図を確実に検出します。 -
値を優先する監査(R 0.6.0 / clauder-mcp 0.9.0)。 原稿と補足資料一式の監査後に寄せられた現場のフィードバックをもとに構築しました。
read_fileは.docx/.pdfを透過的に抽出するようになりました(以前は生のバイト列を返していました)。また、抽出時に構造を維持し、見出しを明示し、表のセルを区切り付きで行ごとに出力します(以前は完全に脱落していました)。新しいreconcile_valuesツールは、原稿内のすべての数値を列挙し、それぞれをコードが生成したコーパスと照合します。表示精度(5038.5 は 5038.46 と一致)、カンマ、パーセント、科学表記法、< .001の閾値にも対応します。値ごとのvalues_registryによって、数値の完全性を注意深さへの期待ではなく、構築によって確保できるようになりました。Reviewer Zero は監査に適した出力オプションを設定し(tibble の有効数字3桁による誤警告を解消)、数値の全件照合をゲート条件とし、probe_scripts(capture_output = TRUE)によるクリーンルーム実行から最終判定を取得します。CrossRef の照会では、429 エラー時にリトライとバックオフを行い、参照チェックが暗黙に途中で打ち切られることを防ぎます。 -
研究者向けツールキットのリリース(R 0.5.0 / clauder-mcp 0.8.0)。 論文を仕上げるための5つの機能を追加しました。(1)Reviewer Zero の書き戻し:
reviewer_zero_prompt(writeback = TRUE)を実行すると、新しいannotate_manuscript()を使って、指摘されたすべての主張を原稿のコピーにネイティブの Word コメントとして追加します。(2)引用機能の強化:verify_referencesが Crossref の更新通知を使って撤回済み/訂正済み論文を検出するようになりました。また、arXiv ID を解決し(出版済みバージョンを引用しているか確認)、DOI のない文献を書誌情報で照合します。新しいsearch_citations(OpenAlex)およびget_bibtex(doi.org)ツールにより、エージェントは引用を捏造せずに検索できます。(3)generate_notebook:セッションログを、レンダリング時に分析を再実行する、解説付きの Quarto ラボノートブックに変換します。(4)generate_codebook:1回の呼び出しで、変数単位のコードブックに加え、OSF や学術誌で必要となるパッケージ/スクリプト/出力の一覧を生成します。(5)すべて CI に組み込みました。 -
セッションチェックポイント(R 0.4.0 / clauder-mcp 0.7.0)。 3つの新しい MCP ツールを追加しました。
checkpoint_sessionは R のグローバル環境をディスクに保存し、restore_sessionは現在の状態を先に保存してから以前の状態に戻します(そのため、復元を取り消せます)。list_checkpointsは利用可能なチェックポイントを表示します。リスクの高い操作の前にチェックポイントを作成するよう、エージェントに指示しています。ユーザーはいつでもコンソールからClaudeR::restore_session()を実行して状態を復元できます。 -
Reviewer Zero:事前登録の監査と頑健性チェック。
reviewer_zero_prompt(prereg_path = ...)は Pass 5 を追加し、実行済みの分析を事前登録された計画と照合して監査し、逸脱の完全なレポートを作成します。reviewer_zero_prompt(robustness = TRUE)は Pass 6 を追加し、主要な主張に対する仕様曲線分析を実行します。妥当性を説明できる代替仕様をバックグラウンドジョブで複数実行し、感度分析表と仕様曲線として結果をまとめます。 -
詳細監査リリース(R 0.3.1 / clauder-mcp 0.6.2)。 アドイン、ブリッジ、Lab Mode 全体で20件以上のバグを修正しました。再度開いたアドイン UI が実行中のサーバーとライブ状態を共有するようになり(UI を閉じて再度開いた後も設定切り替えが機能します)、プロットのキャプチャがデバイスを認識するようになりました(
png(); plot(); dev.off()を実行しても、古い画面上の図が再送信されることはありません)。また、modify_code_sectionがバックスラッシュを含む置換文字列を破損する問題、非同期ジョブの結果が冪等にならずブリッジのタイムアウト後に失われる問題を修正しました。エラーレスポンスにはエラー発生前に出力された内容がすべて含まれるようになり、あるエージェントの長時間計算によって他のエージェントにアドインが停止したと誤って通知されることもなくなりました。さらに、Lab Mode の Round-2 以降の再検証ゲートが実際に動作するようになりました。セッショントークンは OS のエントロピーから生成されます。ロギングはデフォルトで有効です。CI(GitHub Actions)で、すべてのプッシュに対して R の機能チェックと、ビルド済みブリッジとの実際の MCP stdio ハンドシェイクを検証するようになりました。 -
mcp SDK を 1.x に固定。 MCP 2026-07-28 仕様のリリースにより、ブリッジが依存するサーバー API を削除した
mcp2.0.0 が PyPI に公開されました。clauder-mcp>= 0.6.1 ではmcp<2に固定しています。ブリッジが動作しなくなった場合は、uvx --refresh clauder-mcpを実行してください。SDK 2.0 への移行(および非同期ツール向けの新しい Tasks 拡張)の導入を予定しています。 -
AI によるデータアノテーション。 2つの新しい MCP ツール(
load_annotation_data、annotate)を使うと、エージェントがコードを書かずに CSV データセットの各行にラベルを付けられます。_schema列でアノテーション項目を定義し、data_annotation_prompt()を呼び出すと、あとはエージェントが処理します。元のファイルは変更されず、中断された場合はセッションが自動的に再開されます。 -
マルチエージェント調整プロトコル。 複数のエージェントが1つの RStudio セッションを共有するための組み込みプロトコルです。エージェントは R 環境内の共有メッセージボードを通じて交渉し、タスク計画に合意し、作業前にタスクを確保して、互いの出力を相互確認します。
multi_agent_prompt()で読み込みます。 -
verify_referencesツール。 原稿の参考文献一覧から DOI を抽出し、それぞれについて CrossRef API に問い合わせ、原稿中の主張と照合するためのメタデータ(タイトル、著者、年、学術誌)を返します。解決できない DOI、メタデータの不一致、DOI のない参考文献にフラグを付けます。単独での使用(「参考文献を確認して」)にも、Reviewer Zero の Pass 4 としての使用にも対応します。 -
R のベストプラクティスプロトコル。 EDA、仮定の確認、モデル構築、診断、多重補正、報告を網羅する、組み込みの統計分析プロトコルです。
r_best_practices_prompt()で読み込むか、エージェントに読むよう指示してください。 -
Reviewer Zero:学術論文の自動監査。 AI による原稿検証のための4パスプロトコルになりました。エージェントは統計的および方法論的な主張をすべて抽出し、その抽出内容を検証して、著者の R コードに基づいて値を再計算し、CrossRef を使って参考文献を確認します。「分散がゼロだったため検定できなかった」のような方法論的主張は、額面どおりに受け入れるのではなく、直接検証します。
reviewer_zero_prompt()を実行すると、プロトコル全体を取得できます。 -
clean_error_logツール。 エージェントにセッションログを渡すと、すべてのコードブロックを解析してエラーを特定し、それぞれに修正が続いているか確認したうえで、エラーブロックとその前にある重複コードを削除します。動作するコードだけを残したクリーンなログが作成されます。元のファイルを上書きせずに別ファイルへ出力するための、任意のoutput_pathを指定できます。 -
UI を再起動してもサーバーを維持。 Shiny アドインを閉じても(コンソールでの停止または Done ボタン)、MCP サーバーは終了しなくなりました。
claudeAddin()を再実行すると、正しいポート、セッション名、実行回数で、引き続き実行中のサーバーに再接続します。サーバーを停止するのは、UI の「Stop Server」をクリックした場合だけです。 -
内容がわかるログファイル名。 ログファイルにセッション名、ポート、タイムスタンプが含まれるようになりました:
clauder_default_8787_20260301_143022.R。「Start Server」をクリックするたびに新しいログファイルが作成されます。その後のコード実行はすべて、そのファイルに追記されます。 -
Viewer のコンテンツキャプチャと
insert_textツール。 2つの新しいツールを追加しました。get_viewer_contentは、インタラクティブウィジェット(plotly、DT、leaflet)の HTML をページ分割して読み取り、コンテキストを膨大にすることなく、エージェントが htmlwidget の出力を確認できるようにします。insert_textは、アクティブなドキュメントのカーソル位置または特定の行/列にテキストを挿入します。エージェントの実行中、htmlwidget は Shiny アドインの Viewer ペインを奪うことなく、ブラウザーで開きます。 -
複数セッションのルーティング修正。 複数のセッションがアクティブな場合、エージェントは「default」という名前のセッションを優先するようになりました。これにより、検出順が非決定的なために発生する誤ったルーティングを防ぎます。いったんセッションに接続すると、エージェントはそのセッションを優先して使い続けます。default 以外のセッションを使うエージェントは、対象のセッションを指定するために
connect_sessionを呼び出してください。 -
ログへの再現性メタデータの記録。 ロギングが有効な場合、新しいセッションログの先頭に、日付、作業ディレクトリ、完全な
sessionInfo()の出力(R のバージョン、プラットフォーム、アタッチされたパッケージ)を含むヘッダーが記録されます。ログを受け取った人は誰でも、コードが実行された環境を正確に確認できます。 -
クリーンなスクリプトのエクスポート。 Shiny アドインで「Export Clean Script」をクリックすると、セッションログからタイムスタンプ、エージェントのラベル、ログヘッダーをすべて削除し、コードだけを含む実行可能な
.Rファイルを作成します。エラーブロックはコメントとして保持されます。export_log_as_script()を使ったプログラムからの実行にも対応します。 -
PyPI パッケージ(
clauder-mcp)。 Python MCP ブリッジを PyPI のスタンドアロンパッケージとして利用できるようになりました。uvx clauder-mcpを実行すると、Python のパス設定や pip によるインストールが不要な、設定不要のセットアップで利用できます。インストーラー(install_cli()およびinstall_clauder())はデフォルトで uvx を使い、従来のセットアップ向けにuse_uvx = FALSEも指定できます。 -
read_fileツール。 エージェントは、RStudio で開いていないファイルも含め、ディスク上の任意のテキストファイル(.R、.qmd、.csv、.log など)を読み取れるようになりました。これにより、以前のログファイルをエージェントに渡して前回のセッションの続きから作業させるといった、セッション継続のワークフローが可能になります。 -
Codex CLI のサポート。
install_cli(tools = "codex")で OpenAI Codex のセットアップコマンドを生成できます。Codex が、サポート対象の CLI エージェントとして Claude Code と Gemini に加わりました。 -
マルチエージェントのオーケストレーション。 複数の AI エージェントを同じ R セッションで実行したり、別々の RStudio ウィンドウに分散させたりできます。各エージェントには起動時に一意の ID が割り当てられます。コンソール出力、ログファイル、実行履歴はすべてエージェントごとに記録されるため、誰が何をしたかを常に把握できます。最初のツール呼び出し時に、各エージェントには、自身の ID、セッション上でアクティブな他のエージェント、ログファイルのパスを含むコンテキスト説明が渡され、手動でセットアップしなくても共有環境を十分に把握できます。エージェントは
get_session_historyを呼び出して他のエージェントの作業を確認したり、共有ログファイルを直接読んだりできます。Shiny Viewer では、接続済みのエージェントがリアルタイムで表示されます。 -
セッションの検出。 各 RStudio セッションは、起動時に
~/.claude_r_sessions/に検出用ファイルを書き込みます。AI エージェントは、ポートをハードコードしなくてもセッションを自動的に検出します。セッションに名前(例:「analysis」、「modeling」)を付けて、異なるポートで実行できます。複数のセッションがある場合、エージェントは「default」という名前のセッションに自動的にルーティングします。default 以外のセッションを使うエージェントは、対象のセッションに接続するためにconnect_sessionを呼び出してください。セッションが1つの環境なら、設定不要で動作します。 -
Shiny Viewer を再設計。 Session、Agents、Logging、Advanced settings をまとめたパネルで、UI をより見やすくしました。接続済みのエージェントと実行回数がリアルタイムで表示されます。「?」ボタンをクリックすると、複数セッションのセットアップとエージェント ID に関する組み込みガイドを確認できます。
-
ブロックしない非同期実行。
execute_r_asyncは、長時間実行されるコードをcallr経由で別の R プロセス内で実行するようになり、メインセッションは完全に応答可能な状態を保ちます。ジョブの実行中も、他のエージェントは作業を続けられます。エージェントは、データを明示的にsaveRDSで保存/読み込みする自己完結型のコードを書いて送信し、get_async_resultで結果を取得します。環境のコピーもメモリの倍増もなく、ジョブに必要なデータだけがシリアライズされます。 -
古いプロットの検出。 新しいプロットが作成されていない場合でも、最後に生成されたプロット画像が残り、その後の
execute_r呼び出しのたびに再表示されるバグを修正しました。 -
プロットのトークン使用量を削減。 プロットのキャプチャに小さなサイズ(600x400、dpi 100)を使うようになり、base64 画像のサイズを抑え、トークン超過エラーを回避します。
-
MCP ツールのアノテーション。 現行の MCP 仕様に従い、すべてのツールに
readOnlyHint、destructiveHint、idempotentHintのアノテーションが追加されました。 -
文字列エスケープを強化。
escape_r_stringがバッククォート、キャリッジリターン、タブ、ヌルバイトを処理するようになりました。インジェクションを防ぐため、タスクツールの入力に適用されています。 -
install_cli()のコマンド構文を修正。 現行の Claude Code CLI に対応するため、--transport stdioフラグと--セパレーターを使うよう更新しました。また、新しい MCP 登録を追加する前に古い登録を削除し、R のバージョンをアップグレードした際の問題を防ぎます。
目次
- クイックスタート
- 機能
- Python セッションと Positron
- 仕組み
- Reviewer Zero
- R ベストプラクティスプロトコル
- マルチエージェント連携プロトコル
- AI 主導のデータアノテーション
- システマティックレビューのスクリーニング
- 助成金審査パネルモード
- 査読者への回答
- CLI 連携
- セキュリティモデル
- インストール
- 使い方
- ログ記録のオプション
- 操作例
- 重要な注意事項
- トラブルシューティング
- 制限事項
- ライセンス
- コントリビューション
機能
ClaudeR は、R 環境とやり取りするためのツール群を AI アシスタントに提供します。
-
execute_r:R コードを実行し、出力を返します。 -
execute_r_with_plot:モデルが確認できるプロットを生成する R コードを実行します。 -
execute_r_async:長時間実行される(25 秒超)R コードを非同期で実行します。ポーリング用のジョブ ID を返します。 -
get_async_result:非同期ジョブの完了を待ち、完了した時点で結果を返します(wait_s秒まで、デフォルトは 300)。wait_s = 0の場合は、状態を確認するだけです。 -
list_sessions:エージェントが接続できる、アクティブな RStudio セッションをすべて一覧表示します。 -
connect_session:複数セッションのワークフローで使用するため、名前を指定して特定の RStudio セッションに接続します。 -
get_session_history:エージェント ID で絞り込んだ実行履歴を表示します。 -
read_file:RStudio で開いていなくても、ディスク上の任意のファイル(.R、.qmd、.csv、.log など)を読み取ります。原稿は透過的に処理され、.docxと.pdfは見出しを明示し、表のセルを分離した構造化テキストとして抽出されます。大きなファイルでは、start_line/end_lineを指定したページネーションに対応しています。 -
check_cross_references:内部参照の整合性を決定論的に検証します。対応する表がない「表 4 を参照」などの参照切れや、本文で一度も参照されていない表・図を検出します。 -
annotate_manuscript(監査プロトコルで使用する R 関数):.docxのコピーに、ネイティブのアンカー付き Word コメントとして指摘事項を書き込みます。著者は Word 内で監査結果を承認または却下できます。 -
reconcile_values:監査の中核機能です。原稿内のすべての数値を抽出し、それぞれをコードが実際に生成した数値(ログ、出力、表)と照合します。表示精度、カンマ、パーセント、科学表記法、< .001のしきい値を考慮します。各数値のレジストリを返すため、見落としを防げます。 -
get_active_document:現在フォーカスされているエディターのバッファーを読み取ります。内容、ファイルパス、バッファーに未保存の変更があるかどうかを返すため、バッファーの状態とディスク上の状態を混同しません。 -
get_r_info:R 環境の情報を取得します。 -
modify_code_section:エディター内のドキュメントで、正規表現による検索と置換を行います。複数行のパターンに対応し、置換後の行数が変わっても処理できます。バックスラッシュをリテラルとして保持し、デフォルトでディスクに保存します。また、特定のファイルを対象にするためのpathを指定できます。 -
insert_text:カーソル位置、または指定した行・列にテキストを挿入します。デフォルトでディスクに保存し、特定のファイルを対象にするためのpathを指定できます。 -
suggest_edit:変更を適用する代わりに、ユーザーが承認できる編集案を提示します。利用可能な場合はrstudioapi::showEditSuggestion()を使用し、それ以外の場合は変更をエディター上で未保存の状態にします。ユーザーは保存して承認するか、元に戻して却下できます。 -
get_viewer_content:ビューアーペイン内の HTML コンテンツ(plotly、DT、leaflet ウィジェット)を読み取ります。ページネーションに対応しています。 -
clean_error_log:セッションログからエラーブロックと重複する直前のブロックを削除し、動作するコードと、その後に適用された修正だけを残します。 -
search_project_code:プロジェクトのソースファイル(.R、.Rmd、.qmd)全体から正規表現パターンを検索します。ファイル、行番号、抜粋を返します。 -
probe_scripts:クリーンなバックグラウンドセッションで R スクリプトを読み込み、作成されるオブジェクト(名前、クラス、次元)を報告します。メインセッションには影響しません。 -
verify_references:学術文献を検証します。DOI は CrossRef で確認し(Crossref の更新通知に基づく撤回・訂正フラグも確認)、arXiv ID は出版版の有無を確認しながら照合します。DOI のない文献は、候補 DOI を含めて書誌情報を照合します。 -
search_citations:主張に適した文献(タイトル、著者、年、掲載誌、DOI、被引用数)を OpenAlex の学術インデックスで検索し、記憶に頼った引用を避けます。 -
get_bibtex:doi.org のコンテンツネゴシエーションを通じて、DOI の標準 BibTeX エントリーを取得します。 -
generate_notebook:セッションログを、解説付きの Quarto ラボノートブックに変換します。レンダリング時にコードを再実行するため、出力とプロットが再生成されます。 -
generate_codebook:プロジェクトをスキャンし、OSF と学術誌が求めるコードブックを出力します。バージョン付きのパッケージ一覧、スクリプトの一覧、変数ごとの要約(クラス、n、欠損状況)、生成された出力が含まれます。 -
screening_report:システマティックレビューのスクリーニング結果を要約します。2 つのモデルスクリーナー間の一致度と Cohen のカッパ、PRISMA フローの件数、人間による判定が必要な不一致項目を算出します。 -
send_message/check_messages/wait_for_message/coordination_roster:追記専用の共有ログ上で、型付きの複数エージェント間メッセージをやり取りします。wait_for_messageは一致するイベントが届くまで待機するため(ポーリングなしで同期できます)、R セッションが別のエージェントのコードを実行中でも、すべての機能が動作します。 -
checkpoint_session:リスクのある操作を行う前に、R のグローバル環境のスナップショットをディスクに保存します。チェックポイントは R を再起動しても保持されます。 -
restore_session:環境をチェックポイントまでロールバックします。復元前に現在の状態が保存されるため、復元操作自体も取り消せます。エージェントの操作ミスから自分で復旧する場合は、コンソールからも呼び出せます(ClaudeR::restore_session())。 -
list_checkpoints:現在のセッションで保存されているチェックポイントを一覧表示します。 -
create_task_list:長いコンテキストを伴うタスクでの漏れを防ぐため、プロンプトに基づいてタスクリストを生成します。 -
update_task_status:生成されたリストの各タスクの進捗状況を追跡します。 これらのツールを使うと、次のことができます。 -
コードの直接実行:AI がアクティブな RStudio セッションでコードを記述、実行し、パッケージをインストールできます。
-
フィードバックと支援:R スクリプトの説明を受けたり、特定の行の編集を依頼したりできます。
-
可視化:AI がプロットや可視化を生成、表示、調整できます。
-
データ分析:AI にデータセットを分析させ、反復的にインサイトを提供させることができます。
-
マルチエージェントワークフロー:Claude Desktop、Claude Code、Gemini CLI を同じ R セッションで同時に実行できます。各エージェントは個別に識別され、共有履歴とログファイルを通じて互いの作業を確認できます。
-
長時間実行される分析:非同期実行により、タイムアウトせずにモデルのフィッティング、シミュレーション、大規模なデータ処理を行えます。
-
コードのログ記録:AI が実行したすべてのコードをログファイルに保存し、後で参照できます。各エントリには、実行したエージェントがタグ付けされます。
-
コンソールへの出力:実行前に AI のコードをコンソールに出力できます。
-
環境との統合:AI が R 環境内の変数や関数にアクセスできます。
-
動的な要約:オブジェクトやデータフレームから結果を動的に取得して要約できるため、ハルシネーションを防げます。
-
Quarto のレンダリング:AI が Quarto プレゼンテーションを作成し、レンダリングできます。最良の結果を得るには、.qmd ファイルの作成と、完成後の HTML でのレンダリングを依頼してください。
-
Reviewer Zero:学術論文を自動監査する組み込みプロトコルです。AI が原稿をブロックごとに読み、すべての統計的主張をレジストリに抽出して、その抽出内容を検証した後、著者の R コードを使って各主張を再計算します。プロトコル全体を確認するには、
reviewer_zero_prompt()を実行してください。下記の Reviewer Zero セクションを参照してください。
Reviewer Zero:学術論文の自動監査
ClaudeR には、学術論文の AI 駆動型テクニカルレビューを行う組み込みプロトコルがあります。AI は「Reviewer Zero」として機能し、論文中のすべての p 値、係数、信頼区間が、それらを生成したコードと一致しているかを体系的に検証します。
仕組み(コアプロトコル):
- 抽出:AI は、ページ分割された
read_fileを使って原稿をブロックごとに読み込みます(.docxと.pdfは表のセルを含め、構造を保持したまま抽出されます)。そして、定量的および方法論的な主張をすべて、構造化されたレジストリ(RStudio の環境ペインに表示される data.frame)に取り込みます。監査に適した出力オプションが最初に設定されるため、コンソール出力によって確認中の精度が切り捨てられることはありません。 - 検証:AI は各主張についてソース行を再読し、値を誤読していないことを確認します。すべての主張が検証されるまで、コードは実行されません。
- 照合と再計算:中核となるのは値の網羅的確認です。
reconcile_valuesは原稿と補足資料に含まれるすべての数値を列挙し、それぞれを、コードが実際に生成した数値のコーパスと、文書に表示された精度で照合します。一致しない値はすべて、監査を進める前に再計算するか、説明する必要があります。これは注意深さに頼るのではなく、仕組み上の網羅性を実現します。次に、主張レベルの再計算をクリーンルームのスクリプト出力(出力を捕捉するprobe_scripts)に対して実行するため、セッション内の古いオブジェクトによって検証が誤って一致することはありません。方法論に関する主張(例:「分散がゼロだったため検定が不可能だった」)は、そのまま受け入れるのではなく、直接検証します。 - 参考文献:
verify_referencesはすべての DOI を CrossRef に照会し、メタデータの不一致、解決できない DOI、撤回または訂正された論文にフラグを付けます。arXiv のプレプリントは解決され、出版済みのバージョンと照合されます。DOI のない参考文献は書誌情報に基づいて照合されます。本文中の引用は参考文献一覧と相互照合されます。
引数で組み合わせられるオプションの拡張機能(以下に例を示します):事前登録からの逸脱監査(prereg_path)、仕様曲線による頑健性チェック(robustness)、すべての監査結果を Word のコメントとして書き戻す機能(writeback)、およびReferee Mode(referee または単独の referee_prompt())。Referee Mode は推論そのものを実質的にレビューします。つまり、議論の論理、手法、内部整合性、エビデンスの提示、フレーミングを、設定可能なモデルティア、敵対的な立場、ベンダー横断のディスパッチを備えた並列レビュアーサブエージェントで評価し、決定論的な check_cross_references パスを実行して、該当箇所に紐づいた Word コメントとして提出します。
使い始めるには:
# Print the full protocol prompt to give to your AI agent
reviewer_zero_prompt()

# Optional Pass 5: audit the analysis against your preregistration.
# Produces a deviation report (followed / disclosed deviation /
# undisclosed deviation / not executed) plus a list of exploratory
# analyses that are not labelled as such.
reviewer_zero_prompt(prereg_path = "prereg.docx")

# Optional Pass 6: specification-curve robustness check. The agent
# enumerates defensible alternative analysis choices for the primary
# claims, runs the grid in background jobs, and reports a sensitivity
# table plus a specification curve.
reviewer_zero_prompt(robustness = TRUE)

# Optional write-back: every flagged claim becomes a native Word comment
# in a copy of the manuscript, so you can accept/dismiss findings in Word.
reviewer_zero_prompt(writeback = TRUE)

# All extensions together
reviewer_zero_prompt(prereg_path = "prereg.docx", robustness = TRUE, writeback = TRUE)

# Referee Mode, configured. Quick-and-dirty pass on a fast model tier:
referee_prompt(model = "haiku")

# Submission-grade: strongest tier, adversarial reviewer pairs per lens
# (prosecutor + verifier), and lenses dispatched across model vendors
# (codex/agy/qwen) so same-model blind spots can't hide the same flaw twice:
referee_prompt(model = "opus", reviewers_per_lens = 2, cross_vendor = TRUE)

# Mix tiers per lens: deep model where the reasoning is hard, fast elsewhere
referee_prompt(model = c(logic = "opus", methods = "opus", consistency = "haiku"))
このプロトコルは .docx、.pdf、.qmd、.Rmd、.tex、またはプレーンテキストの原稿に対応し、複数のスクリプトを含む R プロジェクトもサポートします。
R のベストプラクティスプロトコル
ClaudeR には、統計学の講義で学んだモデリングのワークフローをもとに、実際の統計分析で AI エージェントを使う際の試行錯誤を通じて改良した、統計分析プロトコルが組み込まれています。このプロトコルは、自然言語でモデルを導き、探索的データ分析、仮定の確認、モデル構築、診断、多重性補正、報告を網羅する、再現可能で理論に基づいた分析を実現することを目的としています。
# Print the full protocol to give to your AI agent
r_best_practices_prompt()
エージェントに ClaudeR::r_best_practices_prompt() を実行するよう伝えるだけでもかまいません。エージェントがプロトコルを自ら読み込みます。
マルチエージェント調整プロトコル
2つ以上のエージェントが同じ RStudio セッションを共有する場合、互いの作業を妨げずに分担する方法が必要です。Coordination v2 は、R セッションと各エージェントのブリッジが共有する、ディスク上の型付き追記専用イベントログを使って動作します。文章による慣習ではなく型付きシグナルを使い、エージェントごとに読み取りカーソルを設けるため、他のエージェントの状態が上書きされることはありません。また、返信をスレッド化できる to: による宛先指定、リースベースのタスク取得、共有状態を管理する最新優先のファクトストア、書き込みのたびに記録されるプレゼンス、そしてパートナーからシグナルが届くまでポーリングせずにエージェントが待機できる wait_for_message を備えています。ログは R を再起動しても保持されます。
中核となるのは合意ゲートです。エージェントが propose_plan() で計画を提案すると、すべてのエージェントが必須の文言を一字一句そのまま使って confirm_agreement() を実行するまで、セッション内のすべてのコード実行応答に明示的な合意を求めるバナーが表示されます。エージェント同士の認識がすれ違い、相反する作業を進めてしまうことはありません。全員が互いの立場を読んだうえで同意を確認した場合にのみ、計画が承認済みとして記録されます。
# Print the full protocol to give to your AI agents
multi_agent_prompt()
エージェントに ClaudeR::multi_agent_prompt() を実行するよう伝えるだけでも、エージェントが自分でプロトコルを読み取ります。
AI によるデータアノテーション
ClaudeR には、AI エージェントを使って CSV データセットにラベルを付けるための専用アノテーションワークフローが含まれています。エージェント側でコードを書く必要はなく、2つの専用 MCP ツールを使ってデータセットの各行を順に処理します。
CSV 形式: ファイルに _schema 列を追加し、シンプルな型構文を使って最初の行にアノテーションフィールドを定義します。
text,label,confidence,_schema
"Some text","","","label:choice[positive,negative,neutral];confidence:float[0,1]"
"More text","","",""
対応する型:choice[a,b,c]、float[min,max]、int[min,max]、bool、text
アノテーションセッションの実行:
# Print the full protocol to give to your agent
data_annotation_prompt()
または、エージェントに ClaudeR::data_annotation_prompt() を実行するよう伝えると、エージェントが自分でプロトコルを読み取ります。その後、エージェントは load_annotation_data を呼び出して処理を開始し、annotate を呼び出して各行にラベルを付けます。元のファイルは変更されず、セッションが中断された場合も自動的に再開できます。
システマティックレビューのスクリーニング
タイトルと抄録のスクリーニングは、システマティックレビューで最も時間がかかる作業です。通常は2人の人間がすべての記録を読みます。ClaudeR は、独立した2つの AI スクリーナーに大部分の読解を任せ、人間には意見が一致しない記録だけを残します。
ワークフロー:重複を除いたデータベース検索結果を CSV にエクスポートし、採用基準と除外基準を _schema 列に追加してから、異なるモデルファミリー(たとえば Claude と、無料で使えるローカルの ollama モデル)を使って run_annotation_job を2回実行します。その後:
# Agreement, Cohen's kappa, PRISMA counts, and the conflict set
screening_report("pass_claude_annotating.csv", "pass_qwen_annotating.csv")
レポートには、一致率、スクリーナー間の Cohen のカッパ係数、PRISMA フローの数値、および2つのモデルの判断が食い違った記録だけを含む screening_conflicts データフレームが表示されます。通常、全体のごく一部であるこれらの記録を、人間が裁定します。すべての判断に理由が記録されるため、監査証跡からフィルターを1つ使うだけで「なぜこの記録が除外されたのか」を確認できます。screening_prompt() でプロトコル全体を表示できます。
助成金審査委員会モード
実際の委員会が審査する前に、助成金申請書を模擬審査にかけられます。各審査基準に1つずつレビュアーのサブエージェントが付き、率直に採点し、すべての弱点を申請書からの引用に基づいて指摘します。
grant_panel_prompt(rubric = "nih")   # Significance, Investigators, Innovation,
                                     # Approach, Environment, scored 1 to 9
grant_panel_prompt(rubric = "nsf")   # Intellectual Merit and Broader Impacts
委員長による総括の最後には、重要な内容が示されます。採点を上げるための具体的な修正案を優先順位順に並べ、各案を今週実行できる作業として表現したリストです。指摘事項は、申請書のコピーに Word コメントとして書き込むこともできます。
査読者への回答
改訂・再投稿のワークフローを凝縮しました。判定通知書と原稿をエージェントに渡し、reviewer_response_prompt() を実行します。エージェントは通知書を個々の査読者の指摘に分解し、原稿内で各指摘に該当する箇所を探して、指摘ごとの回答案を作成します。査読者からデータに関する質問があった場合は、エージェントが現在のセッションで分析を再実行するため、回答には記憶に頼った数字ではなく、実際に計算した数字が含まれます。すべての指摘に回答案が作成されるまで、ゲートによって完了がブロックされます。
成果物は、export_response_letter() による書式設定済みの回答書(Markdown、および pandoc がインストールされている場合は .docx)と、編集が必要な各箇所に、その箇所が回答する査読者の指摘をタグ付けした Word コメントを付けた原稿です。
Python セッションと Positron
ClaudeR はエージェントをライブの Python セッションにも接続します。また、RStudio と同様に Positron でも、両方の機能を利用できます。
import clauder
clauder.start()
エージェントはそのセッションでコードを実行します。読み込み済みのデータフレームやフィット済みのモデルをそのまま利用でき、描画した図も確認できます。Positron、Jupyter、VS Code、または単独の REPL で実行できます。セッションは R の場合と同じ方法で通知されるため、list_sessions には両方が表示され、名前を指定してどちらにも接続できます。
Active sessions (2):
  analysis [python] — port 8790, pid 8088, started 2026-09-09T10:50:09
  modelling [r] — port 8787, pid 84615, started 2026-09-09T09:12:44
R の claudeAddin() と同様に、セッションごとに一度起動してください。ポートが使用中の場合は、次に空いているポートに移動し、使用するポートを通知します。
毎回入力したくない場合は、IPython の起動ファイルから実行してください。
# ~/.ipython/profile_default/startup/50-clauder.py
import clauder
clauder.start(quiet=True)
これを有効にすると、エージェントに公開するつもりのないものも含め、起動するすべての Python セッションでサーバーが開きます。そのため、デフォルトでは無効になっており、有効にする前によく検討することをお勧めします。
機能の対応状況
Python セッションではライブ環境を利用できます。エディターや監査ツールは利用できません。これらは rstudioapi を介して IDE を操作しますが、Python には同等のものがないためです。
| R | Python | |
|---|---|---|
| ライブセッションでコードを実行 | はい | はい |
| エージェントに返されるプロット、およびプロットペインに表示されるプロット | はい | はい |
| エージェントごとに実行したすべての行を記録 | はい | はい |
| 複数エージェントの連携とコンセンサスゲート | はい | はい |
| 開いているエディターバッファーの読み取りと編集 | はい | いいえ |
適用前に承認する編集(suggest_edit) | はい | いいえ |
| 環境のチェックポイント作成とロールバック | はい | いいえ |
| Reviewer Zero と監査ツール | はい | いいえ |
そのため、「このファイルを読み込み、モデルをフィットして、残差をプロットして」という操作は Python で機能します。「開いているファイルを確認して、その関数を修正して」は R 専用です。エージェントは独自のファイルツールを使ってこれらのファイルを読み書きできますが、エディターバッファーを介して操作することはできません。
Positron に関する注意事項
Positron で R を使う際に、特別な設定は必要ありません。Positron には rstudioapi 互換レイヤーが付属しているため、エディターツールも使用できます。ただし、suggest_edit は、Positron が実装していない showEditSuggestion() を使わずに、変更を未保存の状態で反映します。変更を受け入れるには保存し、拒否するには元に戻してください。
仕組み
ClaudeR は Model Context Protocol(MCP) を使い、AI アシスタントと RStudio 環境の間に双方向の接続を確立します。MCP は Anthropic が提供するオープンプロトコルで、AI がローカルのツールやデータを安全に操作できるようにします。
ワークフローは次のとおりです。
- Python MCP サーバーがブリッジとして機能します。
- AI が MCP サーバーにコード実行リクエストを送信します。
- サーバーがリクエストを RStudio で実行中の R アドインに転送します。
- コードが R セッションで実行され、結果が AI に返されます。
このアーキテクチャにより、AI が明確に定義されたインターフェースを通じて承認済みの操作のみを実行できるようになり、R 環境を完全に制御できます。
CLI 統合
ClaudeR は、Claude Code CLI、OpenAI Codex CLI、Qwen Code CLI、Google Antigravity CLI(agy)などのコマンドラインインターフェース(CLI)エージェントに対応しています。Google Gemini CLI は 2026 年 6 月 18 日に終了し、agy が後継となりました。古いバージョンに固定しているユーザー向けに、install_cli(tools = "gemini") も引き続き利用できます。ターミナルベースのワークフローを好む開発者に最適で、RStudio セッションとのライブ接続を維持しながら、コマンドラインから AI アシスタントを直接操作できます。
セキュリティモデル
ClaudeR は監視付きのパワーツールです。エージェントは、データや変数が存在するライブの RStudio セッションで R コードを実行します。同僚のコードを実行前に確認するのと同じように、エージェントの動作も確認してください。
サーバー認証
127.0.0.1 にバインドしても、セキュリティ境界にはなりません。マシン上のほかのプロセスはポートにコードを送信できます。また、アクセスした Web ページも、ブラウザーが CORS プリフライトなしで送信するクロスオリジン POST によって、コードを送信できます。どちらの場合も、R セッションで任意のコードが実行される可能性があります。ClaudeR には 2 つの防御策があります。
- オリジンブロック(常時有効)。
Originヘッダーを含むリクエストは、すべて 403 で拒否されます。Originを設定するのはブラウザーだけで、MCP ブリッジは設定しないため、設定や互換性への影響なしに、悪意のある Web ページ経由の攻撃を防げます。 - セッショントークン(オプトイン)。 Start Server をクリックすると、ClaudeR はランダムなトークンを生成し、ディスカバリーファイルに書き込みます(モード
0600、自分のみ読み取り可能)。ブリッジはこれを読み取り、X-Clauder-Tokenとして送り返します。Advanced の Require auth token にチェックを入れると、トークンのないリクエストをすべて拒否できます。これにより、ローカルプロセス経由の攻撃も防げます。
トークンはデフォルトで無効です。有効にすると clauder-mcp 0.6.0 より古いブリッジがすべて拒否され、アップグレード時に既存のインストールが動作しなくなるためです。有効にするには、次のようにします。
uvx --refresh clauder-mcp # get a bridge that sends the token
続いて、アドインの Advanced パネルで Require auth token にチェックを入れ、サーバーを再起動します。これを行うまでは、トークンのないブリッジが接続すると、アドインはコンソールに一度だけ通知を表示します。
ガードレール(サンドボックスではありません)
validate_code_security() は、明らかに危険な操作である system()、system2()、shell()、rstudioapi::terminal、再帰的またはワイルドカードによる削除を拒否します。これはシートベルトであり、サンドボックスではありません。正規表現によるブロックリストであり、設計上、簡単に回避できます(get("system")(...)、do.call、eval(parse(...)) など)。不注意なコード生成を検出するためのものであり、意図的なエージェントを阻止するためのものではありません。エージェントは任意の R コードを実行するため、完全に安全な仕組みはありません。
ClaudeR が制限しないこと
エージェントは、あなたが読み取れるすべてのファイルを読み取り、パッケージをインストールし、環境内のオブジェクトを上書きし、ネットワークにアクセスし、計算リソースを消費できます。これらは、エージェントを役立てるために必要です。そのため、次の点に注意してください。
- ログを使用してください(デフォルトで有効)。実行されたすべての行と、実行したエージェントの完全な記録が残ります。
- プロジェクトディレクトリで作業してください。これにより、エージェントがデフォルトで参照できる範囲を限定できます。
- 信頼する前に確認してください。特に Reviewer Zero の監査では、出力を下書きとして扱い、自分で検証してください。
プロンプトインジェクション:他人の原稿を監査する前にお読みください
ClaudeR は意図的に、次の3つを組み合わせています。任意の R コードを実行できるエージェント、信頼できないサードパーティコンテンツを取り込むツール(read_file、get_viewer_content、verify_references、load_annotation_data)、そしてファイルへの書き込みやネットワークへのアクセスが可能な R セッションです。
この組み合わせでは、他人が作成した原稿、CSV、HTML ウィジェットは、コード実行につながる経路上の信頼できない入力となります。Reviewer Zero の前提(自分が書いていない論文をエージェントに渡すこと)は、まさに危険な状況です。読者ではなくモデルに向けたテキストが文書に含まれていると、エージェントの動作を意図しない方向へ誘導される可能性があります。
コードの実行自体が機能であるため、これを防ぐフィルターはありません。サードパーティの文書を扱うエージェントセッションは、見知らぬ人のスクリプトを実行する場合と同様に扱ってください。プロジェクトディレクトリで実行し、ログ記録を有効にしてログを確認し、作業ディレクトリや環境に認証情報を放置しないでください。
制限が適用されるのは、AI が実行するコードのみです。手動で実行した R コードには影響しません。
インストール
ステップ 1:GitHub から ClaudeR をインストールする
RStudio コンソールで次のコマンドを実行します。
if (!require("devtools")) install.packages("devtools")
devtools::install_github("IMNMV/ClaudeR")
ステップ 2:適切なインストーラーを実行する
ご利用のワークフローに合ったオプションを選択してください。
オプション A:デスクトップアプリ(Claude Desktop / Cursor)の場合
この関数は、デスクトップアプリ用の MCP 設定ファイルを自動的に構成します。デフォルトでは uvx を使って clauder-mcp PyPI パッケージを実行し、Python の依存関係をすべて自動的に処理します。
# Load the package
library(ClaudeR)

# Run the installer for Claude Desktop
install_clauder()

# Optional: For Cursor users
# install_clauder(for_cursor = TRUE)
uvx を使用できないユーザー(制限された環境など)は、従来の Python パス方式を使用してください。
library(ClaudeR)
install_clauder(use_uvx = FALSE, python_path = "/path/to/your/python")
オプション B:CLI ツール(Claude Code / Codex / Gemini)の場合
この非対話型関数は、CLI ツールに必要なコマンドまたは JSON 設定を生成します。
library(ClaudeR)

# For Claude Code CLI
install_cli(tools = "claude")

# For OpenAI Codex CLI
install_cli(tools = "codex")

# For Qwen Code CLI
install_cli(tools = "qwen")

# For Google Antigravity CLI (agy, Gemini CLI's replacement)
install_cli(tools = "agy")

# For Google Gemini CLI (legacy, shuts down June 18, 2026)
install_cli(tools = "gemini")
uvx を使用できないユーザーは、従来の Python パス方式を使用してください。
install_cli(tools = "claude", use_uvx = FALSE, python_path = "/path/to/my/python")
関数を実行した後、設定を手動で適用する必要があります。
- Claude / Codex / Qwen の場合:R コンソールに表示されたコマンドをコピーし、ターミナルで実行します。
- Antigravity(agy)の場合:生成された JSON を
~/.gemini/config/mcp_config.json(グローバル)または.agents/mcp_config.json(ワークスペースごと)にコピーします。 - Gemini(レガシー)の場合:生成された JSON をコピーし、
~/.gemini/settings.jsonファイルに手動で追加します。
セットアップ後、新しい設定を読み込むため、起動中のデスクトップアプリまたはターミナルセッションを終了して再起動してください。
注:R のバージョンをアップグレードした場合は、MCP サーバーのパスを更新するために
install_cli()またはinstall_clauder()を再実行してください。CLI インストーラーは、新しい登録を追加する前に古い登録を自動的に削除します。
使い方
パート 1:RStudio での操作
すべてのワークフローで、まず RStudio から ClaudeR サーバーを起動する必要があります。
library(ClaudeR)
claudeAddin()
ClaudeR アドインが RStudio の Viewer ペインに表示されます。**「Start Server」**をクリックしてください。お好みのツールを使用している間、このウィンドウを開いたままにします。

パート 2:AI ツールでの操作
- デスクトップアプリの場合:Claude Desktop アプリまたは Cursor を開き、セッションを開始します。
- CLI ツールの場合:ターミナルを開き、
claudeまたはgeminiコマンドを使って AI アシスタントとの対話を開始します。
注:RStudio コンソールの停止ボタンをクリックすると、コンソールやアクティブなドキュメントを再び操作できるようになります。これにより Shiny UI は閉じますが、MCP サーバーはバックグラウンドで実行され続け、AI エージェントも接続されたままです。
claudeAddin()を再実行すると、同じサーバー状態(ポート、セッション名、実行回数)のまま Viewer ペインが再び表示されます。サーバーを完全に停止するには、閉じる前に UI の **「Stop Server」**をクリックしてください。
ログのオプション
- コードをコンソールに表示:実行前に、AI のコードを R コンソールで確認できます。コードの前には、ヘッダー
### LLM [agent-id] executing the following code ###が表示されます。 - コードをファイルに記録:実行したすべてのコードをログファイルに保存します。各エントリには実行したエージェントの ID が付けられるため、どの AI エージェントが何を実行したかを追跡できます。
- カスタムログパス:ログファイルの保存場所を指定できます。
- わかりやすいファイル名:ログファイルには
clauder_<session>_<port>_<timestamp>.Rという名前が付けられます(例:clauder_default_8787_20260301_143022.R)。これにより、どのセッションで生成されたログかをすぐに確認できます。 - 再現性ヘッダー:各ログは、日付、作業ディレクトリ、
sessionInfo()の完全な出力(R のバージョン、プラットフォーム、アタッチ済み/ロード済みのパッケージ)を含むヘッダーで始まります。これにより、再現性を確保するための情報がログに記録されます。 - クリーンスクリプトをエクスポート:ログパネルで「Export Clean Script」をクリックすると、タイムスタンプとログヘッダーをすべて取り除いた、実行可能な
.Rファイルを作成できます。エラーブロックはコメントとして残るため、問題が発生した箇所を確認できます。コンソールからexport_log_as_script()を実行して呼び出すこともできます。
Start Server をクリックするたびに、新しいログファイルが作成されます。エージェントが実行したコードは、サーバーを停止して再起動するまで、そのファイルに追記されます。
対話の例
- 「環境に
dataという名前のデータセットがあります。探索的データ分析を実行してください。」 - 「
mtcarsデータセットを読み込み、トレンドライン付きのmpgとhpの散布図を作成してください。」 - 「
wtとhpに基づいてmpgを予測する線形モデルを当てはめてください。」 - 「
irisデータセットの相関行列を生成し、可視化してください。」 - 「qmd ファイルを開いています。勾配降下法について、見栄えのよい Quarto プレゼンテーションを作成してください。対象者は技術に詳しい人たちです。滑らかな見た目にしてください。プレゼンテーションを /Users/nyk/QuartoDocs/ に保存してください。」
R でできることなら、AI アシスタントにもできます。
重要な注意事項
- セッションの維持:AI が作成した変数、データ、関数は、R セッション内に保持されます。
- コードの表示:デフォルトでは、AI のコードはコンソールに表示されます。
- ポートの設定:デフォルトのポートは
8787ですが、必要に応じて変更できます。RStudio Server では、8787 は IDE 自体が使用するポートなので、別のポート(例:8788)を選択してください。 - パッケージのインストール:AI はパッケージをインストールできます。動作を指示する際は、明確なプロンプトを使用してください。
トラブルシューティング
- 接続の問題:
- AI ツールが正しく設定されていることを確認してください。
configまたは CLI コマンドで Python のパスを確認してください。- アドインでサーバーが実行中であることを確認してください。
- ポートが使用中の場合は、RStudio を再起動してください。
- Python の依存関係に関する問題:
could not find function install_clauder:R セッションを再起動(Session -> Restart R)してから、もう一度お試しください。- MCP サーバーの起動に失敗する:
uvxを使用している場合は、uvがインストールされていることを確認してください(curl -LsSf https://astral.sh/uv/install.sh | sh)。従来の方法を使用している場合は、通常、誤った Python 環境が検出されたことを意味します。正しいpython_pathを指定してインストーラーを再実行するか、use_uvx = TRUEに切り替えてください。
- AI が結果を認識できない:
- アドインのウィンドウが開いており、サーバーが実行中であることを確認してください。
- プロットが表示されない:
- プロットオブジェクトを
print()で囲むよう AI に指示してください(例:print(my_plot))。 execute_r_with_plot関数を使用するよう AI に伝えてください。
- プロットオブジェクトを
- 実行時間の長いコードがタイムアウトする:
- 25 秒を超える処理には
execute_r_asyncを使用するよう AI に依頼してください。 - AI は
get_async_resultで結果を取得します。この関数はジョブが完了するまで待機します。 - 非同期ジョブは
callrを介して別の R プロセスで実行されるため、メインセッションの環境にはアクセスできません。AI は、データの受け渡しにsaveRDS()を使用して入力を書き込み、結果を出力する、自己完結型のコードを作成する必要があります。ジョブの完了後に、そのデータをメインセッションに読み込みます。
- 25 秒を超える処理には
- サーバーの再起動に関する問題:
- サーバーの再起動後に「address already in use」エラーが表示される場合、これは UI のバグです。サーバーは引き続きアクティブです。接続の問題が発生した場合は、Viewer Pane でポート番号を変更するか、RStudio を再起動してください。
- AI がまだ接続できない場合は、Advanced セクションの 「Force Release Port」 をクリックしてください。ポートを占有しているプロセスを強制終了し、クリーンな状態から開始できます。
- R のアップグレード後に MCP のパスが古くなる:
- R のアップグレード後にツールが動作しなくなった場合は、
install_cli()またはinstall_clauder()を再実行して、スクリプトのパスを更新してください。
- R のアップグレード後にツールが動作しなくなった場合は、
制限事項
- 各 R セッションが一度に接続できるのは、Claude Desktop/Cursor アプリのいずれか 1 つです。ただし、複数の CLI エージェント(Claude Code、Codex、Qwen、agy)は、デスクトップアプリと同じセッションを共有できます。エージェントを分離するには、セッション名とポートが異なる RStudio ウィンドウを別々に起動してください。
- Shiny UI を閉じても(コンソールの Stop ボタン)、AI と並行して作業できます。サーバーはバックグラウンドで動作し続け、エージェントは接続されたままです。
claudeAddin()を再実行すると UI が再表示されます。または、UI の Stop Server をクリックするとサーバーを完全に停止できます。 - R はシングルスレッドですが、非同期ジョブは
callrを介して別のプロセスで実行されるため、メインセッションは応答性を保ちます。バックグラウンドプロセスはメインセッションの環境を共有しないため、非同期コードは自己完結型である必要があります。
引用
ClaudeR が公開された研究に貢献した場合、引用していただけると幸いです:
citation("ClaudeR")
Vitali, N. (2026). ClaudeR: Connect live RStudio and Python sessions to AI
agents over MCP. R package version 0.15.0.
https://github.com/IMNMV/ClaudeR
サイドバーにある GitHub の「このリポジトリを引用」ボタンからも、CITATION.cff と同じ内容が生成されます。
ライセンス
このプロジェクトは MIT ライセンス のもとでライセンスされています。詳細は LICENSE ファイルをご覧ください。
コントリビューション
コントリビューションを歓迎します!お気軽にプルリクエストを送信してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。