Talamus について
Talamusはコーディングエージェント向けのローカル優先型メモリMCPサーバーです。決定事項や根拠をMarkdownで保存し、後続セッションで出典付き検索を提供します。時点に応じた履歴や任意のLLMエンジンにも対応します。
主な機能
- 01Markdown形式でのメモリ保存
- 02出典付き検索と回答
- 03時点を指定したメモリ検索
- 04ノートの検証と修正案
- 05複数のLLMエンジンに対応
活用シーン
- 01セッションをまたいだ決定の背景確認
- 02指定日時点のプロジェクト記憶の確認
- 03記憶の内容と出典の照合
MCP 対応
MCPクライアントにはデフォルトで読み取り専用のメモリアクセスを提供します。サーバー設定を再生成すると書き込みを有効にできます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
16掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| query | string | はい | |
| smart | boolean | いいえ |
詳細
Talamus




コーディングエージェントはセッションが終わると、判断の理由をすぐに忘れてしまいます。
Talamus は、覚えておく価値のある判断、根拠、修正を通常の Markdown として保存し、 Claude Code、Codex、Cursor、Gemini CLI、そして MCP エージェントが次のセッションで 出典付きで思い出せるようにします。
ホスト型アカウントは不要です。テレメトリーもありません。埋め込みも必須ではありません。プレーン検索は お使いのマシン上で完結し、LLM を利用するアクションでは選択したエンジンのみを使用します。
まずはローカル検索の一連の流れをお試しください。永続的なインストール、アカウント、
LLM、フックは不要で、./talamus-demo の外にファイルを書き込みません。
uvx --from talamus talamus demo --root ./talamus-demo
uvx --from talamus talamus search "embedding" --root ./talamus-demo
uvx --from talamus talamus read "Embedding" --root ./talamus-demo
技術評価には、 アーキテクチャと 測定済みベンチマークをご覧ください。
Talamus は、独立系の AI およびオープンソースプロジェクトである Ampresのもと、 Giovanni “Angio” Crapuzziが作成し、保守しています。 エンジニアリングのケーススタディ では、プロジェクトのアーキテクチャ、測定結果、トレードオフについて解説しています。
エージェントを接続する
コピーして貼り付けられる一連の手順です。再現可能なバージョンは
scripts/demo/run_magic.pyにあります。
-
プロジェクトのブレインをセットアップします。
talamus setupはブレインを初期化し、エンジンを選択します。Claude Code、Cursor、Codex、OpenCode、OpenClaw が検出された場合は MCP をインストールし、セッション記録フックをインストールする前に一度確認を求め、エンジンに対して小さなライブ呼び出しを一度実行して動作を確認できます。talamus setup -
エージェントのセッションが終了します。同意済みのフックがトランスクリプトと git diff を読み取り、記憶する価値があるかどうかの判定を行い、役立つメモリのみをこのブレインに書き込み、
.talamus/logs/capture.logにイベントを記録します。 -
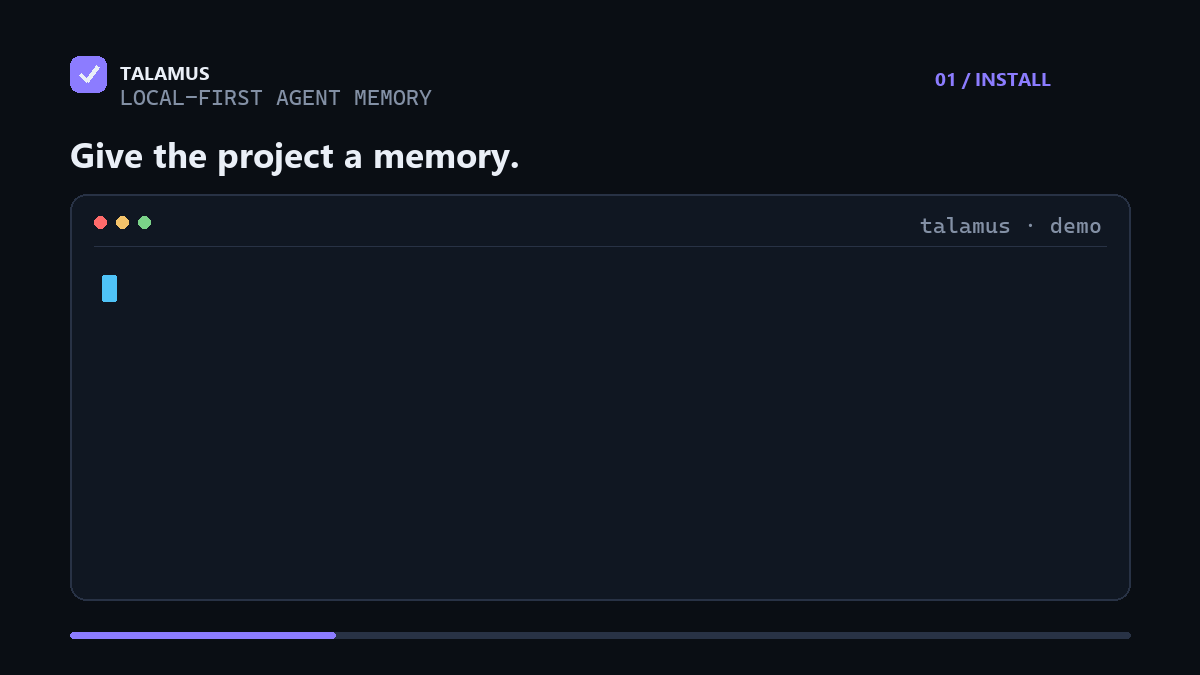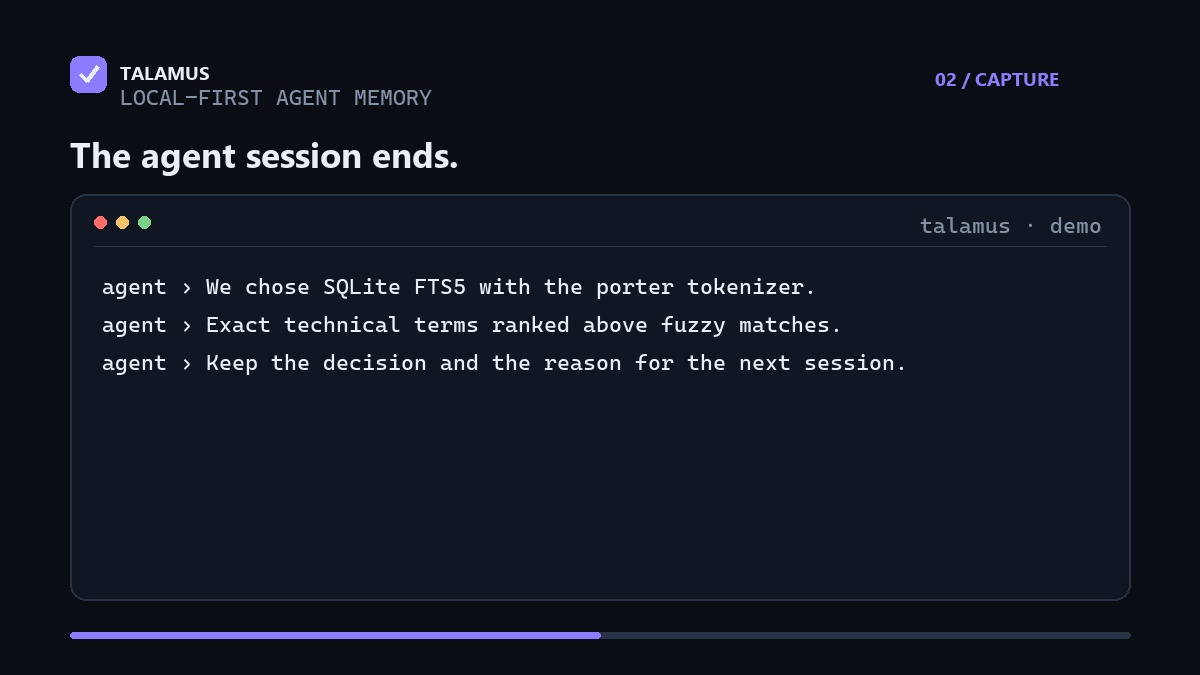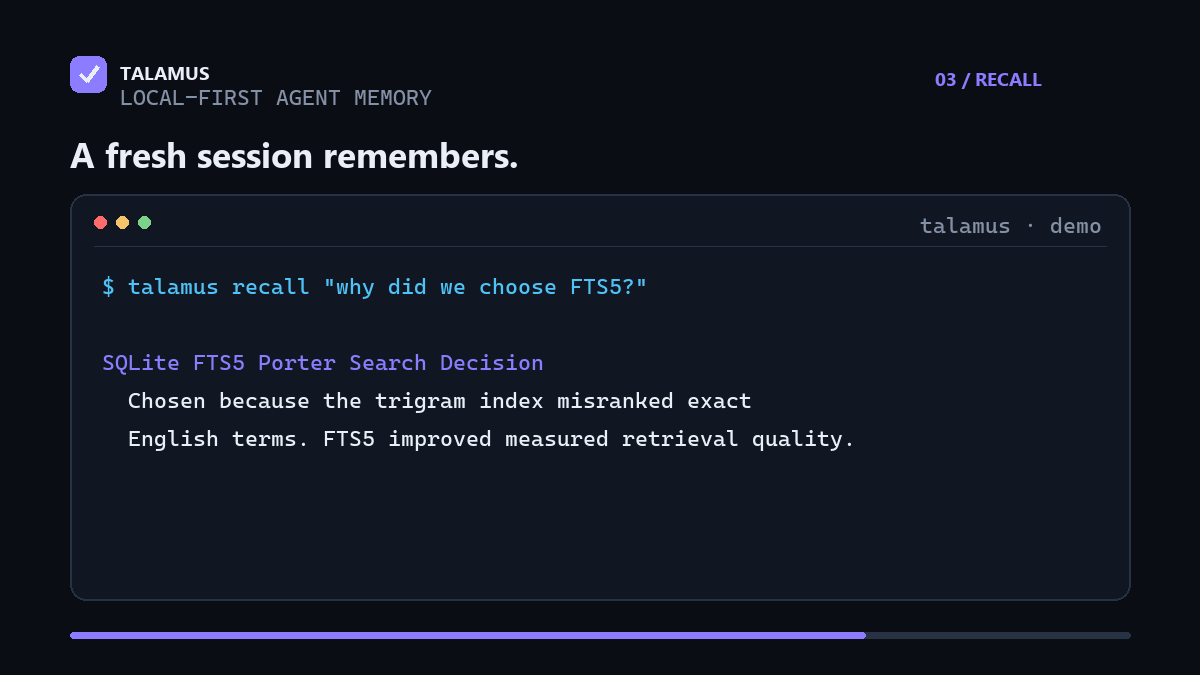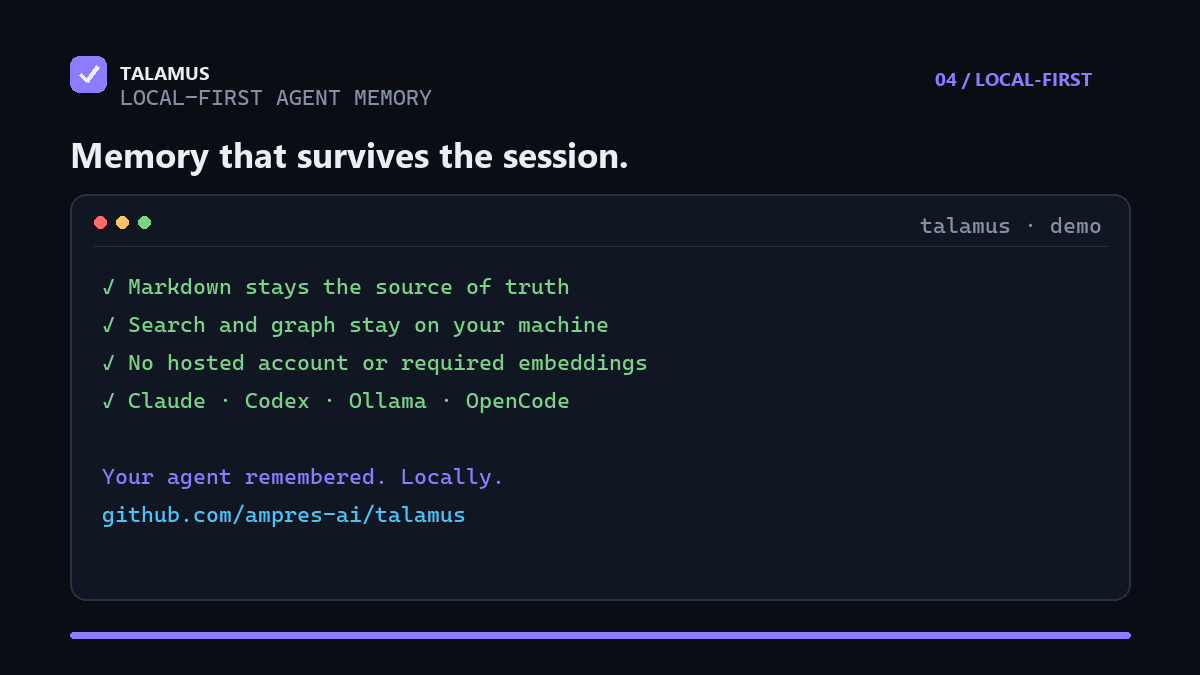
新しいセッションで何が起きたかを尋ねると、出典付きで実際のメモから回答が得られます。
talamus recall "why did we choose FTS5?" talamus ask "why did we choose FTS5?" -
LLM 呼び出しを消費せずにスクリプト化されたデモを再現するか、実際のエンジンを使って実行します。
python scripts/demo/run_magic.py --fake
python scripts/demo/run_magic.py --keep --engine claude-cli
異なる点
時間:メモにはバージョン履歴があり、事実には有効期間が設定されます。talamus ask --as-of 2026-01 を使うと、その時点のブレインに基づいて回答します。
意味:オントロジーは根拠から導出され、バージョン管理され、測定済みのルールによって昇格され、ブレインのクラスタリングとルーティングに使われます。
検証可能性:すべてのメモに来歴が付与されます。talamus verify はレビュー用の修正案を提示し、回答には参照したメモが引用されます。
測定済みの比較
1 画面ベンチマークはベンチマークガイドに掲載されており、
one-screen.mdとしてコミットされています。
以下のすべての数値は、コミット済みの結果アーティファクトに基づいています。
| コーパス | 指標 | Talamus | BM25 | MiniLM ベクター DB |
|---|---|---|---|---|
| SciFact、英語のみの領域 | recall@10 | 0.797 | 0.776 | 0.783 |
| SciFact、英語のみの領域 | nDCG | 0.664 | 0.652 | 0.645 |
| Book、言語横断+曖昧 | hit@10 | 0.971 | 0.829 | 0.743 |
| Book、言語横断+曖昧 | recall@10 | 0.929 | 0.771 | 0.700 |
コミット済みのアーティファクトで測定されたその他の数値は、脳をコンテキストに読み込む場合と比べて回答ごとのトークン数が −97.7%、範囲外の質問に対する拒否率が 1.000、検索レイテンシが 10k 件のノートで p95 72.6 ms/100k 件で p50 624 ms です。
率直に言うと、検索品質は使用する LLM に左右されます。強力な拡張エンジンを使うと、talamus-smart はランキングを含むすべての指標で、強力な多言語密ベクトルモデル(multilingual-e5)を上回ります(nDCG は 0.847 対 0.837)。性能の低いエンジンや無料のエンジンでは、ランキングは e5 が上回る一方、Talamus は hit/recall で最良の値を維持します。また、低速なローカルエンジンでは、通常の search が --smart を明確に上回ります。すべての数値はコミット済みのアーティファクトに基づいており、不利な結果も隠していません。
エンジン
すでにお使いの LLM をご利用ください:claude-cli、codex-cli、antigravity-cli(agy)、opencode、ollama、または anthropic-api。
クイックスタート
pipx install "talamus[mcp]"
talamus setup
talamus ingest ./notes && talamus ask "what should I remember?"
ステータスダッシュボードを表示するには talamus、基本コマンドを確認するには talamus quickstart、ローカルの React ワークベンチを起動するには talamus ui を実行してください。
エージェントの MCP 接続は、デフォルトで読み取り専用です。エージェントがこのプロジェクトの脳を明示的に更新できるようにするには、talamus mcp install --enable-writes で設定を再生成してください。中央の脳への書き込みには、追加で
--enable-central-writes フラグが必要です。
skills.shから、同意を尊重する Talamus エージェントスキルをインストールできます。
npx skills add ampres-ai/talamus --skill talamus-memory
OpenClaw では、ClawHub から同じスタンドアロンスキルを直接インストールできます。
openclaw skills install @ampres-ai/talamus-memory
スタンドアロンスキルをインストールしても、Talamus は自動的にはインストールされません。CLI が見つからない場合、スキルは分離されたインストール方法を説明し、実行前に確認を求めます。
Gemini CLI では、拡張機能ギャラリーまたはこのリポジトリから Talamus を直接インストールできます。この拡張機能は、固定された PyPI リリースを uvx で起動するため、クローンしたソースツリーは変更されません。
gemini extensions install https://github.com/ampres-ai/talamus --auto-update
goose では、このリポジトリを Open Plugin としてインストールできます。これにより、同意を尊重するメモリスキルが追加され、新しい CLI セッションごとに固定されたローカル MCP サーバーが起動します。
goose plugin install https://github.com/ampres-ai/talamus.git
このプラグインには PATH 上の uv が必要です。初回使用時に uvx が Talamus とその MCP 依存関係を分離されたキャッシュにダウンロードします。
コンテナ化された MCP(脳はマウントされたローカルフォルダーに残ります):
docker run --rm -i -v "$PWD:/data" ghcr.io/ampres-ai/talamus:1.1.3
リンク
ドキュメント:クイックスタート、ローカルファーストのエージェントメモリ、エージェントのインストールガイド、コマンド、エージェントのツール呼び出し、設定、ベンチマーク、アーキテクチャ、設計原則、評価、マルチブレイン、オントロジー。
プロジェクト:セキュリティ、コントリビューション、ロードマップ、変更履歴。
ソースコード、イシュートラッキング、リリース履歴は ampres-ai/talamusにあります。
開発
pip install -e ".[dev,mcp]"
python dev.py
python dev.pyを実行すると、ruff、フォーマットチェック、mypy、unittestが実行されます。製品の動作を変更する場合は、同じ変更でユーザードキュメントも更新してください。
ライセンス
Apache-2.0。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。