Mnemolith について
Mnemolithは、AIコーディングツールで共有するローカルメモリのMCPサーバーです。メモリをGitファイルの内容に結び付け、古くなった情報の退役や履歴管理を行い、現在のメモリをプロジェクトファイルに同期します。
主な機能
- 01コーディングツール間のメモリ共有
- 02ファイルハッシュによる古いメモリの検出
- 03メモリの履歴と出所の記録
- 04重複の統合と競合の確認
- 05AGENTS.mdとCLAUDE.mdへの同期
- 06メモリのセマンティック検索
活用シーン
- 01コーディングツール間でプロジェクト情報を共有
- 02関連ファイルの変更後にメモリを退役
- 03ファイル変更後もメモリが正しいか確認
- 04既存のノートをプロジェクトメモリに取り込み
MCP 対応
MCPサーバーを通じて、Claude Code、CursorなどのMCPツールがプロジェクトメモリを共有します。ツールからメモリの保存、検索、説明、置換、確認、同期を行えます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
10掲載時のツール一覧 · 5 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| fact | string | はい | |
| files | any | いいえ |
詳細
Mnemolith
コードに忠実であり続ける、AI コーディングツール向けの共有メモリです。

Mnemolith(NEE-mo-lith):「記憶の石」。AI が学んだことを、あらゆるツールから読める場所に刻みます。(名前の由来)
以前の名称は Aether Cache です。
aether-cacheをインストール済みの場合は、Aether Cache からの移行をご覧ください。メモリはそのまま引き継がれます。
Claude Code、Cursor などの AI ツールは、セッションのたびにプロジェクトのことを忘れてしまいます。また、覚えていたとしても、そのメモリが今も正しいかどうかを確認するものはありません。Mnemolith はすべてのツールに共通のローカルメモリを提供し、その内容が正確であり続けるようにします。
- コードが変わると、メモリは古くなります。 各メモリは関連するファイルと、その Git コンテンツハッシュのスナップショットに紐付けられます。
docker-compose.ymlが変更されると、それに関するメモリは AI に延々と渡されるのではなく、自動的に退役します。 - 矛盾はため込まず、置き換えます。 「MySQL に移行した」という情報が、「Postgres を使っている」という情報を退役させるため、モデルを混乱させることなく、類似した内容の重複も統合されます。
- すべてのメモリについて、その由来を確認できます。 どのツールとセッションが保存したか、どのファイルのバージョンに基づいていたか、そして作成、再確認、古くなった状態、確認済み、置き換えといったすべての変更履歴を確認できます。
- すでに使っているファイルと連携します。 現在のメモリは
AGENTS.mdとCLAUDE.mdの管理対象セクションに同期されるため、コミットして PR でレビューでき、Mnemolith を使っていないチームメイトにも見えるようになります。
すべてをお使いのマシン上で実行し、ゼロから独自に開発したデータベースエンジンを基盤にしています。
Redis クローンではありません
Mnemolith は Java で Redis をゼロから再構築することから始まり、その後も開発が続いています。ここにあるすべてのレイヤーはゼロから書かれており、それぞれが下位のレイヤーにはない機能を提供します。
| レイヤー | 提供する機能 |
|---|---|
| MCP サーバー | Claude Code、Cursor、あらゆる MCP ツールでメモリを共有 |
| Git 対応 | 記述対象のコードが変更されると、メモリを自動的に退役 |
| メモリレイヤー | ステータス、由来、全履歴、重複の統合、競合のレビューをエンジン内で実現 |
| HNSW ベクトルインデックス | セマンティック検索:100K ベクトルで再現率 99.4%、0.84 ms。完全検索より 22 倍高速 |
| Redis 互換エンジン | RESP プロトコル、50 以上のコマンド、レプリケーション、トランザクション、クラッシュセーフな永続化(1,039,890 回の書き込みと 8 回の kill -9 クラッシュを通じて、確認済みの書き込みが 1 件も失われない)を、実際の Redis のスループットの 88~93%で実現 |
最下層だけでも Redis として動作し、redis-cli、redis-benchmark、redis-py は変更なしで接続できます。メモリレイヤー、Git 対応、MCP サーバーは、Redis にはまったくない機能です。
Claude Code ─┐                       ┌─────────────────────────────────────────────┐
Cursor ──────┼─ MCP ─► mnemolith ─┼─ RESP ─► Java engine (Main.java)            │
other tools ─┘   (Python: embeddings,│          memories, HNSW vector index,       │
                  git hashing, sync) │          history, append-only file on disk  │
                                     └─────────────────────────────────────────────┘
実際の画面
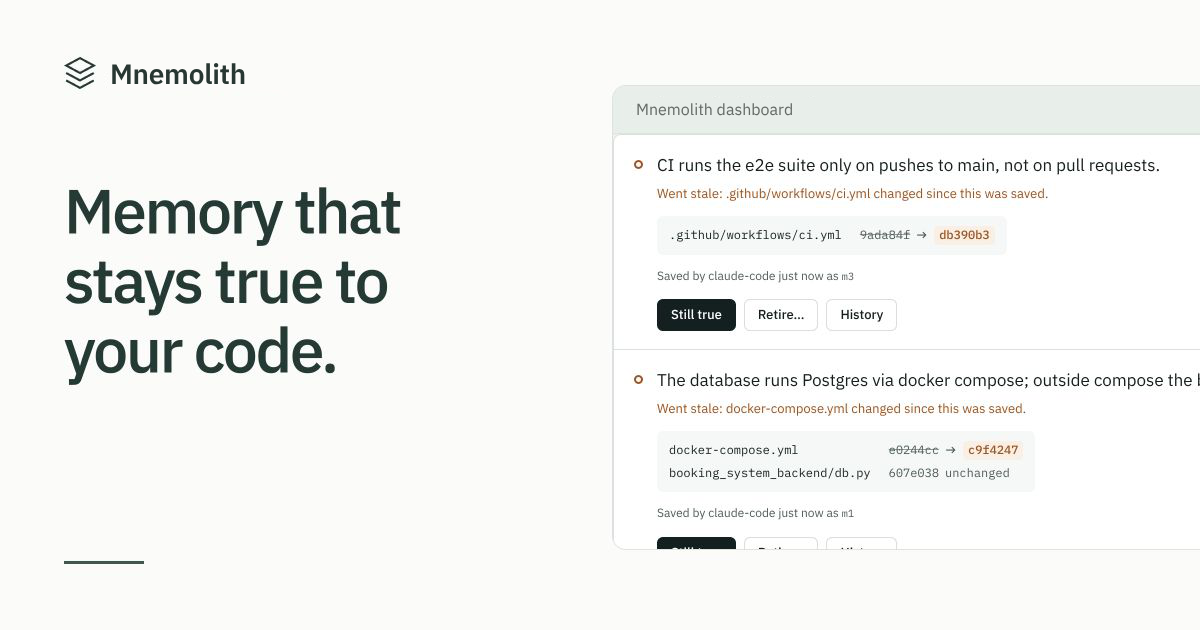
ダッシュボード(mnemolith ui)では、関連ファイルが変更されたメモリが判断を待つ状態になり、ファイルの各バージョンを並べて確認できます。

AI ツール側では、ファイルに紐付いたメモリのファイルが変更され、次回の検索でその変更が検出されます。
> remember("The database runs Postgres via docker compose", files=["docker-compose.yml"])
Saved as m1.

        ... someone edits docker-compose.yml ...

> recall("database setup")
These memories were just retired because files they depend on changed. If one is still true,
call confirm_memory; if it's wrong, save the corrected fact with remember:
[m1] "The database runs Postgres via docker compose" is now marked outdated: docker-compose.yml changed.

> confirm_memory("m1")        # still true, so re-link it to the new version of the file
Confirmed m1; it's active again and linked to the current file versions.

> explain_memory("m1")
m1: "The database runs Postgres via docker compose"
status: active, project: demo
saved by: claude-code (session eea54b5c)
linked files: docker-compose.yml@02ea346...
history:
  19:16  created: by claude-code (session eea54b5c), linked to docker-compose.yml@87da641...
  19:16  active -> stale: docker-compose.yml changed since this was saved
  19:16  re-linked: to docker-compose.yml@02ea346... (confirmed still true)
  19:16  stale -> active: confirmed still true
新しい事実が古い事実に置き換わる様子:
> remember("The API timeout was raised to 60 seconds")
Saved as m3.
Related existing memories:
[m1] (similarity 0.58) The API timeout is 30 seconds
If m3 makes any of these no longer true, call replace_memory(old_id, "m3"). Otherwise do nothing.

> replace_memory("m1", "m3")
m1 retired; m3 replaces it.
クイックスタート
1 行で必要なものをすべてインストールし、セットアップを実行できます。macOS または Linux の場合:
curl -fsSL https://mnemolith.dev/install.sh | sh
Windows(PowerShell)の場合:
powershell -ExecutionPolicy ByPass -c "irm https://mnemolith.dev/install.ps1 | iex"
インストーラー(install.sh、install.ps1)は、uv がない場合は取得し(uv には Python が含まれます)、Mnemolith をインストールして、mnemolith setup を実行します。自分で使いたいツールがある場合は、以下のいずれかを使い、その後 mnemolith setup を実行してください:
uv tool install mnemolith
pipx install mnemolith
pip install mnemolith        # Python 3.10+
setup はエンジンをバックグラウンドで起動し、埋め込みモデルを一度ダウンロード(約 90 MB)して、お使いのマシン上で見つかった対応済みの AI ツールすべてに接続します:Claude Code、Cursor、Codex。これで完了です。任意の git リポジトリで AI ツールを開き、次のように試してください:
テストには DOCKER_HOST の設定が必要だと覚えておいてください。docker-compose.yml に依存しています。
その後、新しいセッションを開始して、テストの実行方法を尋ねてください。
エンジンの実行には Java 11 以降が必要です。インストール済みであれば、それが使われます。ない場合、Mnemolith はプライベートコピー(約 50 MB)を ~/.mnemolith/java にダウンロードし、公開されているチェックサムと照合して、Mnemolith 専用に使用します。システム全体にはインストールされず、mnemolith uninstall で削除できます。
AI 用のメモをすでに CLAUDE.md、AGENTS.md、または Cursor ルールに保存していますか?リポジトリ内で mnemolith import を実行するか(ダッシュボードの メモをインポート を使用して)、それらをメモリに変換できます。メモリは、言及されているファイルにリンクされます。
メモリはプロジェクトごと(git リポジトリのフォルダー名ごと)に保存されるため、プロジェクトが混ざることはありません。すべてはお使いのマシン上に保存されます。エンジンはマシン内からの接続のみを受け付け、メモリは ~/.mnemolith に保存されます。
| コマンド | 内容 |
|---|---|
mnemolith setup | 初回セットアップ:エンジン、モデル、AI ツール |
mnemolith add | 現在のリポジトリ(または指定したパス)を追加し、ダッシュボードでそのファイルを確認できるようにします。ダッシュボードからリポジトリを検索して追加することもできます |
mnemolith ui | ダッシュボードを開きます:AI が記憶している内容を確認し、ファイルが変更されたメモリを確認または破棄できます |
mnemolith import | CLAUDE.md、AGENTS.md、Cursor ルールのメモをメモリに変換します。まず内容を表示し、確認を求めます |
mnemolith remove | プロジェクトを削除します(デフォルトでは現在のプロジェクト)。ダッシュボードの プロジェクトを削除 と同様に、メモリは削除されず、破棄されます |
mnemolith export | リンクされたファイルと履歴を含めてメモリを JSON ファイルに保存します(-p で単一のプロジェクトを指定) |
mnemolith status | 実行中かどうかと、このプロジェクトのメモリの内容を確認します |
mnemolith doctor | すべてを確認し、問題の修正方法を案内します |
mnemolith list / recall "query" / explain m1 | ターミナルからメモリを確認します |
mnemolith sync | 現在のメモリを AGENTS.md / CLAUDE.md に書き込みます |
mnemolith connect cursor | 1 つのツールを接続します(--print でほかの MCP ツールの設定を表示) |
mnemolith start / stop | エンジンを起動または停止します(ツールが必要とするときにも自動で起動します) |
mnemolith uninstall | AI ツールの接続を解除し、エンジンを停止して、メモリを削除する前に確認を求めます |
インストール後に mnemolith が見つからない場合は、uv tool update-shell を実行して新しいターミナルを開いてください。ポート 7380 が使用中ですか?MNEMOLITH_PORT を設定し、もう一度 setup を実行してください。アンインストールするには、mnemolith uninstall を実行し、その後 uv tool uninstall mnemolith を実行します。
Aether Cache からの移行
Mnemolith は以前、Aether Cache という名前でした。aether-cache をインストールしている場合は、上記のインストーラーを実行してください。Mnemolith をインストールし、aether-cache を削除して、メモリを ~/.aether-cache から ~/.mnemolith に移し、AI ツールを再接続します。データは失われず、CLAUDE.md / AGENTS.md に同期されたメモリもそのまま引き継がれます。
別の方法でインストールしましたか?同じ方法で mnemolith をインストールし、mnemolith setup を実行してから、aether-cache を削除してください(uv tool uninstall aether-cache、pipx uninstall aether-cache、または pip uninstall aether-cache)。
AI が呼び出せるツール
| ツール | 機能 |
|---|---|
remember(fact, files?) | 長期的に保持する事実を保存し、任意でファイルと関連付けます。ほぼ同一の内容の重複を統合し、関連するメモリーを表示するので、新しい事実が既存のメモリーに取って代わるかどうかを AI が判断できます。 |
recall(query, limit?) | 意味に基づいてプロジェクトのメモリーを検索します。関連付けられたファイルを先に確認するため、コードが変更されたメモリーが返されることはありません。 |
explain_memory(id) | メモリーの出所と、完全な履歴を表示します。 |
replace_memory(old, new) | 新しいメモリーによって事実ではなくなった古いメモリーを終了します。 |
mark_outdated(id, reason) | 誤りだと判明したメモリーを終了します。 |
confirm_memory(id) | ファイルが変更された後も正しいメモリーを復元し、現在のバージョンのファイルに再リンクします。 |
check_stale() | 必要に応じてファイルチェックを実行します。 |
list_conflicts() / resolve_conflict(...) | 矛盾している可能性がある、非常によく似たメモリーの組み合わせを確認します。 |
sync_to_files() | 現在のメモリーを AGENTS.md / CLAUDE.md に書き込みます(こちらも参照:mnemolith sync)。 |
設計上の判断と、測定結果
類似度では矛盾を検出できないため、AI が判断します
最初のバージョンでは、新しいメモリーが既存のメモリーと類似している場合、矛盾の可能性があるとしてフラグを立てていました。実際の all-MiniLM-L6-v2 埋め込みを使って調整したところ、この方法は機能しないことがわかりました。
| 組み合わせ | 種類 | 類似度 |
|---|---|---|
| "we use Postgres" / "the database is Postgres" | 重複 | 0.73 |
| "tests need DOCKER_HOST set" / "you have to set DOCKER_HOST before running tests" | 重複 | 0.92 |
| "we use Postgres" / "we migrated to MySQL" | 矛盾 | 0.30 |
| "API timeout is 30 seconds" / "API timeout is 60 seconds" | 矛盾 | 0.94 |
| "tests need DOCKER_HOST set" / "integration tests need a running Redis" | 関連あり、どちらも正しい | 0.34 |
重複の類似度は0.73~0.92、矛盾の類似度は0.30~0.94であり、両者を分けるしきい値はありません。実際の重複を統合できるほど低いしきい値を設定すると、「タイムアウトは30秒」と「タイムアウトは60秒」がひそかに統合されてしまいます。これはこの製品で起こりうる最悪のバグです。そのため、エンジンが自動統合するのは、類似度が0.97以上のほぼ同一のテキストに限られます。それ以外の場合は、埋め込みが関連するメモリーを見つけ、文の意味をすでに理解している AI が、どちらか一方が他方に取って代わるかどうかを判断します。
古さの判定ではコミットではなくファイルの内容を比較します
関連付けられた各ファイルは、git hash-object で計算した path@<git blob hash> として保存されます。コミット ID ではなくファイルの内容を比較するため、未コミットの編集を検出し、ファイルに変更がないコミットは無視できます。また、Git フックも不要です。recall は検索のたびに、関連付けられた少数のファイルのハッシュを再計算します。
メモリーがひそかに変更されることはありません
すべての変更は、タイムスタンプと理由を付けたイベントとして記録されます。エンジンは各メモリーを、割り当てた ID とタイムスタンプとともにログに記録します。そのため、再起動後にログを再生すると、新たな ID を発行するのではなく、ミリ秒単位まで同一のメモリーと履歴を再構築できます。
基盤となるエンジン
Java で一から書かれた、Redis 互換サーバーです。RESP に対応しているため、redis-cli、redis-benchmark、redis-py は変更せずに使用できます。コア部分は、CodeCrafters の「Build Your Own Redis」チャレンジのすべてのステージと拡張を完了して構築しました。ベクトルインデックス、永続化の強化、メモリーレイヤーは独自に追加したものです。
公式 Redis と比較したスループット
同じマシンで、redis-benchmark -t set,get を使用して10万件のリクエスト、50並列クライアント、3バイトの値で測定しました。
| Mnemolith | Redis 8.10.2 | Redis に対する Mnemolith の割合 | |
|---|---|---|---|
| SET | 205.8K ops/sec | 233.6K ops/sec | 88% |
| GET | 225.7K ops/sec | 242.7K ops/sec | 93% |
| p50 レイテンシー | 0.119 ms | 0.111 ms | |
| p99 レイテンシー(SET / GET) | 0.375 / 0.231 ms | 0.359 / 0.159 ms | |
| 最大レイテンシー(SET) | 19.7 ms | 1.3 ms | JVM の GC / JIT による一時停止 |
通常のレイテンシーは Redis と同等です。差が生じるのは最悪時のレイテンシーで、これは JVM のガベージコレクションと JIT のウォームアップが原因です。C で書かれた Redis には、こうした処理はありません。
HNSW ベクトル検索と正確な検索の比較
all-MiniLM-L6-v2 で埋め込んだ AG News の見出し10万件(384次元、コサイン類似度)と、保留したクエリ500件を使用しました。k = 10 です。再現率は、同じデータに対する総当たりの正確な検索を基準に測定しています。
| モード | Recall@10 | p50 レイテンシー | p99 レイテンシー |
|---|---|---|---|
| 正確(総当たり) | 1.000 | 18.58 ms | 20.52 ms |
| HNSW、ef=10 | 0.905 | 0.49 ms | 1.38 ms |
| HNSW、ef=20 | 0.951 | 0.52 ms | 0.73 ms |
| HNSW、ef=50 | 0.985 | 0.66 ms | 0.89 ms |
| HNSW、ef=100 | 0.994 | 0.84 ms | 1.41 ms |
| HNSW、ef=200 | 0.998 | 1.24 ms | 2.19 ms |
ef=100 では、HNSW は正解のトップ10の99.4%を、正確な検索より約22倍高速に返します。ベクトル10万件のインデックス構築には136秒かかりました(M=16、M0=32、efConstruction=200)。レイテンシーは Python クライアントから測定しているため、ネットワークとクライアントのオーバーヘッドを含みます。完全なセットアップと生データは results.json を参照してください。
**仕組み:**各ベクトルは、階層グラフ内の最も近い近傍とリンクします。検索は、長距離リンクを持つ疎な最上位層から始まり、クエリに向かって貪欲に移動しながら層を一つずつ下り、最下層で ef 個の最良候補を保持するベストファースト検索を行って終了します。近傍の選択には、HNSW 論文の多様性ヒューリスティック(近似重複よりも、異なる方向にある近傍を優先)を使用します。これにより、高い再現率が保たれます。
**フィルター付き検索:**HNSW はメモリの状態を把握できないため、検索では候補を多めに取得し、一致しないもの(古いもの、または置き換え済みのもの)を除外します。残った候補が少なすぎる場合は検索範囲を広げ、必要に応じて正確なスキャンにフォールバックします。有効なメモリが2%しかないメモリ2,000件のテストでは、フィルター付き検索は30件すべてのクエリで正しいトップ10を返しました。難点は、この選択率ではほとんどの場合に正確な検索へのフォールバックが実行されることです。これは、グラフインデックスで後処理フィルタリングを行う際の既知の弱点です。
クラッシュ時の安全性
すべての書き込みは追記専用ファイル(AOF)に記録され、起動時に再生されます。
kill -9 によるクラッシュテスト(crash_test.py):クライアントが可能な限り高速に書き込み、サーバーをランダムなタイミングで停止して再起動し、サーバーが応答を返したすべての書き込みを確認します。
| fsync ポリシー | クラッシュ回数 | 応答済みの書き込み | 消失数 |
|---|---|---|---|
everysec | 5 | 757,295 | 0 |
always | 3 | 282,595 | 0 |
再起動ごとの復旧には0.6秒かかり、最大約18万5,000件の書き込みを再生しました。
**書き込みの破損:**マシンのクラッシュによって、最後の書き込みが途中で切れることがあります。初期バージョンでは、そのようなファイルがあると起動を拒否していました。現在は最後の完全なコマンドまで再生し、途中で切れたコマンドを削除して、それ以前のデータをすべて保持したまま正常に起動します。
各 fsync ポリシーのコスト(SET スループット、クライアント50件):
| ポリシー | スループット | p50 レイテンシー |
|---|---|---|
always(書き込みごとに同期) | 42.9K/sec | 1.159 ms |
everysec(1秒ごとに同期) | 113.9K/sec | 0.103 ms |
no(OS に任せる) | 118.8K/sec | 0.103 ms |
everysec は always より2.7倍高速で、no との差は4%以内です。そのため、妥当なデフォルト設定となっています。macOS では、fsync を実行しても SSD 自身のキャッシュのフラッシュは強制されないため、ここでの always は Linux サーバーの場合より低コストに見えます。
コマンド一覧
- メモリ:
MEM.ADD、MEM.GET、MEM.SEARCH(STATUSフィルター付き)、MEM.STATUS、MEM.WHY、MEM.LISTMEM.FILES、MEM.SEEN、MEM.CONFLICTS、MEM.RESOLVE
- ベクトル:
VADD、VSEARCH(HNSW、調整可能なEF、EXACTモード) - 文字列:
GET、SET(EX/PX)、INCR、STRLEN、TYPE、KEYS * - リスト:
RPUSH、LPUSH、LRANGE、LLEN、LPOP、ブロッキングBLPOP - ストリーム:
XADD(明示的、部分的、自動の ID)、XRANGE、XREAD(BLOCKと$付き) - ソート済みセット:
ZADD、ZRANK、ZRANGE、ZCARD、ZSCORE、ZREM - ビットマップ:
SETBIT、GETBIT、BITCOUNT、BITOP AND/OR(バイナリセーフな文字列) - 地理空間:
GEOADD、GEOPOS、GEODIST、GEOSEARCH ... FROMLONLAT ... BYRADIUS - トランザクション:
MULTI、EXEC、DISCARD、WATCH、UNWATCH(キーごとの書き込みバージョンによる楽観的ロック) - Pub/Sub:
SUBSCRIBE、UNSUBSCRIBE、PUBLISH - レプリケーション:
- マスターとレプリカのハンドシェイク(
PING、REPLCONF、PSYNC)およびコマンドの伝播 REPLCONF GETACKによるオフセット追跡とWAIT
- マスターとレプリカのハンドシェイク(
- 永続化: RDB の読み込み、マニフェストを使用する AOF、
appendfsync always/everysec/no、および書き込みの途切れからの復旧 - 認証:
AUTH、ACL WHOAMI/GETUSER/SETUSER(SHA-256 パスワードハッシュ)
エンジンを単独で実行する
java src/main/java/Main.java                                   # port 6379
java src/main/java/Main.java --bind 127.0.0.1                  # accept connections from this machine only
java src/main/java/Main.java --port 6380 --replicaof "localhost 6379"
java src/main/java/Main.java --dir /tmp/data --appendonly yes --appendfsync everysec
ベンチマークの再現
各ベンチマークは、起動したエンジンに対して実行されます。
redis-benchmark -p 6379 -t set,get                 # throughput; also run against redis-server to compare
python vector_bench.py                             # HNSW recall and latency (start the engine with -Xmx4g)
python crash_test.py everysec 5                    # kill -9 crash test
python memory_mcp/calibrate.py                     # embedding similarity calibration
関連プロジェクト
Mnemolith は初期段階のオープンソースプロジェクトです。同じ分野の本番環境向けシステムを紹介します。
- Redis 形式のストアでのベクトル検索:
- Redis 8 vector sets と valkey-search は、Redis と Valkey に HNSW ベクトル検索を追加します。
- hnswlib は、HNSW のリファレンス実装です。
- Malkov & Yashunin(2016) は、このインデックスが準拠する論文です。
- AI エージェント向けメモリ: Mem0、Zep、Letta、および MCP reference memory server。
- 指示ファイル: AGENTS.md と
CLAUDE.md。Mnemolith はこれらを置き換えるのではなく、これらに同期します。
ステータスと制限事項
Mnemolith は v1 の初期段階です。自動テストではエンドツーエンドで動作しており、現在は実際の Claude Code セッションで試用されています。
未実装の項目:
- 実際のコーディングタスクにおいて、再説明が実際に減るかを測定するための、メモリありとメモリなしの評価。
- AOF の圧縮: ログは増え続け、ステータスが変わるたびに行が追加されます。
エンジンの制限事項:
- スレッド処理: イベントループではなく、接続ごとに OS スレッドを1つ使用します。ローカルツールとしては問題ありませんが、Redis のように数千のクライアントに対応できる規模には拡張できません。
- トランザクション:
EXECは分離されていないため、トランザクションのコマンド実行中に、他のクライアントのコマンドが割り込むことがあります。 - ベクトルインデックス: ベクトルを再追加すると、グラフリンクを再構築せずに更新され、削除機能もありません。退役したメモリは削除されず、フィルターで除外されます。
- レプリケーション: フル再同期のみ対応しており、新しいレプリカはマスターのデータセットが空であることを前提とします。
- その他の小さな制限:
KEYS *は文字列キーのみを一覧表示します。GEOSEARCHはすべてのメンバーを走査します。- ACL がサポートするのは
defaultユーザーのみです。 HELLO(RESP3)はサポートされていないため、クライアントは RESP2 を使用する必要があります。
プロジェクト構成
src/main/java/Main.java      the engine (single file, from the CodeCrafters setup)
mnemolith/                   the Python package behind the `mnemolith` command
  server.py                  MCP server: embeddings, git staleness, AGENTS.md/CLAUDE.md sync
  engine.py                  finds Java, starts and stops the engine in the background
  javart.py                  downloads a private copy of Java when the computer has none
  connect.py                 registers Mnemolith with Claude Code, Cursor, and Codex
  cli.py                     the `mnemolith` command
  ui.py, ui/index.html       the dashboard (`mnemolith ui`): a local server, its API, and the page
  portability.py             import from notes files, export to JSON
  engine/mnemolith-engine.jar the prebuilt engine (rebuild with `python scripts/build_engine.py`)
memory_mcp/calibrate.py      similarity calibration for duplicate/contradiction thresholds
vector_bench.py              HNSW benchmark (writes results.json)
crash_test.py                kill -9 crash-safety test
リリース
pyproject.toml、mnemolith/__init__.py、server.json のバージョンを更新してコミットし、次を実行します。
git tag v0.2.2 && git push --tags
リリースワークフローはバージョンの一致を確認し、パッケージをビルドしてスモークテストを実行した後、PyPI と MCP Registry に公開し、GitHub Release を作成します。
ライセンス
MIT。詳細はLICENSEを参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。