ArcadeDB について
ArcadeDBは、グラフ、ドキュメント、キー・バリュー、検索、時系列、ベクトル、地理空間データを扱うチーム向けのトランザクション型マルチモデルデータベースです。複数のクエリ言語に対応し、AI連携用のMCPサーバーを内蔵しています。
主な機能
- 01トランザクション型マルチモデルストレージ
- 02SQL、Cypher、Gremlin、GraphQL、MongoDBクエリ対応
- 03組み込みのグラフアルゴリズム70種類以上
- 04並列SQLクエリとマテリアライズドビュー
- 05地理空間および時系列機能
- 06モジュールを選んだカスタム配布パッケージ
活用シーン
- 01グラフアプリケーションやナレッジグラフの構築
- 02グラフとベクトルデータを使った推薦システム
- 03グラフと時系列の指標を使った不正検知
- 04IoTやサービス監視の時系列分析
MCP 対応
ArcadeDBは、AIアシスタントやLLMとの連携向けにModel Context Protocolサーバーを内蔵しています。READMEには公開するMCPツールやトランスポートの詳細は記載されていません。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
極めて高いパフォーマンスを実現するマルチモデル DBMS








| テストスイート | 実行頻度 | ステータス |
|---|---|---|
| Java CI - テスト | mainへのプッシュごと |  |
| HA統合テスト(Raft、組み込み) | 毎日 |  |
| HA耐障害性テスト(Docker、障害注入) | 毎日 |  |
| HAカオステスト(ランダムな障害、60分) | 毎週 |  |
| 負荷テスト | 毎日 |  |
| Boltドライバーバージョンマトリックス | 毎日 |  |
| ネイティブイメージのビルド | 毎日 |  |
| ベンチマーク | 毎週 |  |


ArcadeDB は完全なトランザクション対応 DBMS で、ACID トランザクション、構造化データと非構造化データ、ネイティブのグラフエンジン(結合ではなくレコード間のリンクを使用)、全文検索インデックス、地理空間クエリ、高度なセキュリティをサポートしています。
ArcadeDB は次のモデルをサポートしています。
- グラフデータベース(Neo4j Cypher、Apache Tinkerpop Gremlin、OrientDB SQL と互換)
- ドキュメントデータベース(MongoDB ドライバー、MongoDB クエリ、OrientDB SQL と互換)
- キー/バリュー(Redis ドライバーと互換)
- 検索エンジン
- 時系列(InfluxDB Line Protocol、Prometheus remote_write/read、PromQL のサポート)
- ベクトル埋め込み
- 地理空間
ArcadeDB は複数の言語に対応しています。
- SQL(OrientDB SQL 由来)
- Neo4j Cypher(Open Cypher)
- Apache Gremlin(Apache Tinkerpop v3.7.x)
- GraphQL 言語
- MongoDB クエリ言語
ArcadeDB の主な機能:
- 70 種類以上の組み込みグラフアルゴリズム — 経路探索、中心性、コミュニティ検出、リンク予測、グラフ埋め込みなどを、すべてすぐに利用できます
- 並列クエリ実行 — SQL クエリで複数の CPU コアを活用し、大規模なデータセットをより高速に処理します
- マテリアライズドビュー — クエリ結果を事前に計算して保存し、自動的に維持します
- MCP サーバー — AI アシスタントや LLM との連携に対応した、組み込みのModel Context Protocolサーバー
- AI アシスタント — クエリの支援やデータベース管理に役立つ、Studio に統合された AI アシスタント(ベータ版)
- 地理空間インデックス —
geo.*SQL 関数を使用したネイティブの空間クエリと近接検索 - 時系列 — Gorilla/Delta-of-Delta 圧縮を使用した列指向ストレージ、InfluxDB/Prometheus からのデータ取り込み、PromQL クエリ、Grafana 連携
- ハッシュインデックス — LSM-Tree インデックスに加え、拡張可能ハッシュを使用して完全一致検索を高速化
ArcadeDB は次の方法で使用できます。
- Java 仮想マシン上で、あらゆる言語から組み込みで使用
- arcadedb-python-bindingsのバインディングを使って Python に組み込みで使用
- HTTP/JSONを使用してリモートから使用
- Postgres ドライバーを使用してリモートから使用(ArcadeDB は Postgres Wire プロトコルを実装しています)
- Redis ドライバーを使用してリモートから使用(実装されているのは操作の一部のみです)
- MongoDB ドライバーを使用してリモートから使用(実装されているのは操作の一部のみです)
- 組み込みのMCP サーバー(Model Context Protocol)を介して AI アシスタントから使用
詳しくは、ドキュメントをご覧ください。
ユースケース
arcadedb-usecasesリポジトリで、実際のユースケースをご覧ください。Docker Compose、SQLスキーマ、実行可能なデモを含む自己完結型のプロジェクトで、次の内容を取り上げています。
- レコメンデーションエンジン — グラフ走査+ベクトル類似度+時系列
- ナレッジグラフ — 全文検索を備えた共著・引用ネットワーク
- グラフ RAG — LangChain4j と Neo4j Bolt を使った検索拡張生成
- 不正検知 — Cypher によるグラフ、ベクトル、時系列シグナル
- リアルタイム分析 — 時系列を使った IoT とサービスの監視
- ソーシャルネットワーク分析 — ポリグロットクエリを使ったマテリアライズドビューのダッシュボード
- サプライチェーン — PostgreSQL プロトコルと JavaScript による多階層の可視化
5 分で始める
Docker で ArcadeDB Server を起動します。
docker run --rm -p 2480:2480 \
           -v arcadedb-config:/home/arcadedb/config \
           -v arcadedb-databases:/home/arcadedb/databases \
           -e ARCADEDB_SETTINGS="-Darcadedb.server.rootPassword=playwithdata -Darcadedb.server.defaultDatabases=Imported[root]{import:https://github.com/ArcadeData/arcadedb-datasets/raw/main/orientdb/OpenBeer.gz}" \
           arcadedata/arcadedb:latest
--rm はコンテナとともに匿名ボリュームを削除するため、名前付きボリューム 2 つを使うと、インポート済みの OpenBeer データベース(databases)と、サーバーが実行時に書き込むユーザー、グループ、API トークン(config)を実行間で保持できます。新しく始める場合は、docker volume rm arcadedb-config arcadedb-databases で削除してください。
データベース設定は ARCADEDB_SETTINGS に、追加の JVM フラグは JAVA_OPTS に渡してください。Docker は環境変数に値を追加せず置き換えるため、この 2 つを分けておけば、イメージ独自のガベージコレクターとヒープサイズ設定(ARCADEDB_OPTS_GC と ARCADEDB_OPTS_MEMORY)が維持されます。ヒープサイズはコンテナのメモリ制限に対する割合で決まるため、追加の調整なしで docker run -m 512m と数 GB の本番コンテナの両方で動作します。
イメージは Java 25 で動作します。このバージョンでは、server.sh は JVM がフラグに対応していることを確認したうえで、コンパクトオブジェクトヘッダー(-XX:+UseCompactObjectHeaders)も有効にします(Java 25 以降の標準ディストリビューションでも同様です)。これを上書きするには ARCADEDB_OPTS_HEADERS を設定します。無効にするには空の値を設定してください。
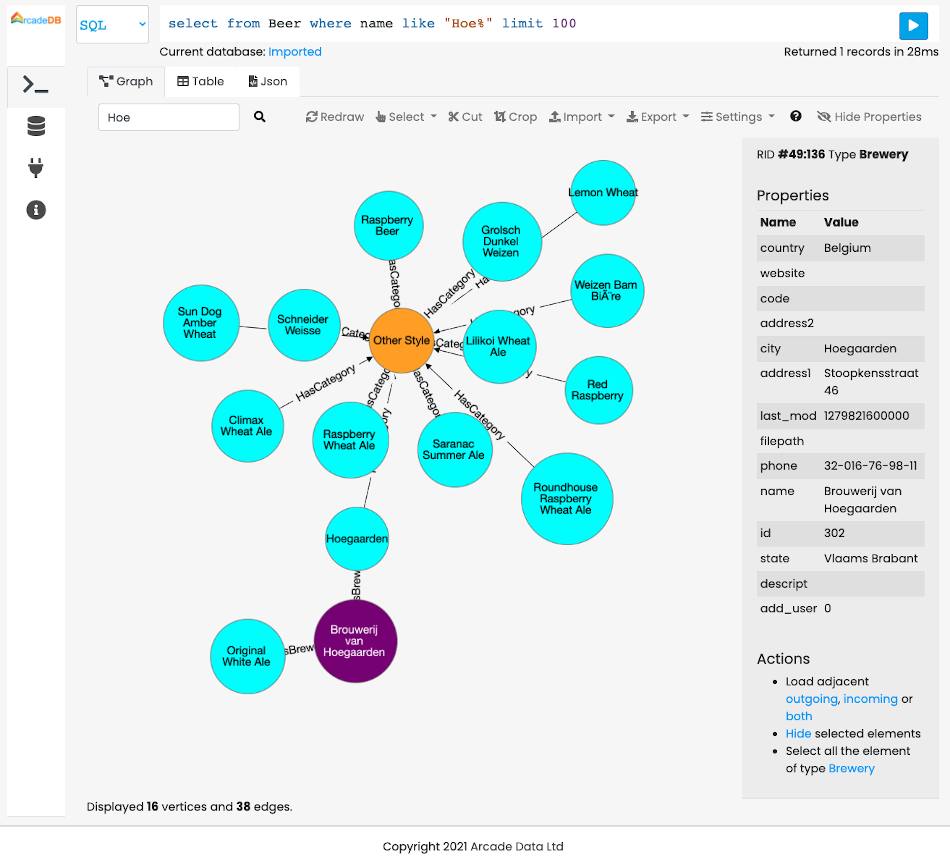
ブラウザーで http://localhost:2480 を開き、ArcadeDB Studio とインポート済みの OpenBeer データベースを使って、お気に入りのビールを探してみましょう。
ArcadeDB は Docker と Kubernetes に対応しており、クラウドですぐに利用できます。
最新リリースをダウンロードして、ローカルのハードドライブに展開し、bin/server.sh または Windows 用の bin/server.bat でサーバーを起動することもできます。
リリース
(約月 1 回の)リリースには、次の 4 種類があります。
full- すべてのモジュールを含む完全なパッケージですminimal-gremlin、redisw、mongodbw、graphqlモジュールを除外したパッケージですheadless-gremlin、redisw、mongodbw、graphql、studioモジュールを除外したパッケージですbase- コアエンジン、サーバー、ネットワークのみを含み、すべてのオプションモジュール(console、gremlin、studio、redisw、mongodbw、postgresw、grpcw、graphql、metrics)を除外します
リポジトリの最新コミットをもとにしたナイトリービルドは、 こちらでご覧いただけます。
カスタムパッケージビルダーを使って、必要なモジュールだけを含むカスタムディストリビューションをビルドすることもできます。
curl -fsSL https://github.com/ArcadeData/arcadedb/releases/download/26.3.1/arcadedb-builder.sh | \
  bash -s -- --version=26.3.1 --modules=gremlin,studio
利用可能なオプションモジュール:console、gremlin、studio、redisw、mongodbw、postgresw、grpcw、graphql、metrics。ビルダーは、対話モード、Docker イメージの生成、ローカルの Maven リポジトリを使ったオフラインビルドに対応しています。
実験的な GraalVM native-image ビルド(高速起動、低 RAM、JVM 不要)も利用できます。前提条件、ビルドとターゲットの対応表、Docker の使用方法については、docs/native-image.mdをご覧ください。
Java バージョン
ArcadeDB 24.4.1 以降のコードは Java 21 と互換性があります。
Java 21 のパッケージは Maven central で、Docker イメージは Docker Hub で入手できます。
まだ Java 21 にアップグレードできない方向けに、GitHub パッケージを通じて、別のブランチ java17 で Java 17 もサポートしています。
プロジェクト内で Java 17 を使用するには、リポジトリを pom.xml に追加し、次のように依存関係を指定します。
<repositories>
    <repository>
        <name>github</name>
        <id>github</id>
        <url>https://maven.pkg.github.com/ArcadeData/arcadedb</url>
    </repository>
</repositories>
<dependencies>
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-engine</artifactId>
    <version>26.3.1-java17</version>
</dependency>
</dependencies>
Docker イメージは ghcr.io でも入手できます。
docker pull ghcr.io/arcadedata/arcadedb:26.3.1-java17
エンジンとともに Gremlin を組み込む
arcadedb-engine とともに組み込む場合でも、単独で組み込む場合でも、Gremlin には必ず shaded classifier を使用してください。ANTLR ランタイムはプライベートなパッケージに再配置されるため、共有クラスパス上でエンジンの ANTLR 4.13.2 と競合することはありません。
通常の arcadedb-gremlin jar は、エンジンの SQL/Cypher パーサーが必要とするエンジンの 4.13.2(arcadedb-engine 経由で推移的に取得されます)に ANTLR を解決します。TinkerPop の Gremlin 文字列クエリパーサーには、再配置されたランタイムに対してのみデシリアライズされる、事前コンパイル済みの ANTLR 4.9.1 パーサーが含まれています。そのため、通常の jar だけでは Gremlin 文字列クエリを実行できません。shaded classifier を使用してください。
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-engine</artifactId>
    <version>26.8.1</version>
</dependency>
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-gremlin</artifactId>
    <version>26.8.1</version>
    <classifier>shaded</classifier>
</dependency>
ビルドとテスト
テストをスキップしてプロジェクト全体をビルドします。
mvn clean install -DskipTests
テストをスキップして Docker イメージをビルドします。
mvn clean install -DskipTests -Pdocker
単体テストの実行:
単体テスト一式をすべて実行します。
mvn test
一部のテストには、実行コストを示すタグが付いています。
slow- 実行にかなり時間がかかる機能テスト(大規模なバッチ、数秒に及ぶ実行時間、大きなペイロード)benchmark- 通常の CI 実行を想定していないマイクロベンチマーク。デフォルトでは除外されます(以下を参照)。
benchmark タグ付きのテストはデフォルトで除外されるため、通常の mvn test でもスキップされます。slow テストもスキップして高速なテストのみを実行するには、次のようにします。
mvn test -DexcludedGroups="slow,benchmark"
特定のタグのみを実行する場合(例:benchmark テストのみを単独で実行する場合)は、デフォルトの除外設定を解除してください。解除しないと選択が相殺され、何も実行されません。
mvn test -Dgroups="benchmark" -DexcludedGroups=
統合テストの実行:
統合テストをすべて実行します(Docker が必要です)。
mvn verify -Pintegration
エンドツーエンド、負荷、HA テストを除外して統合テストを実行します。
mvn verify -Pintegration -pl !e2e,!load-tests,!e2e-ha
エンドツーエンドテストの実行:
エンドツーエンドテストをすべて実行します(Docker が必要です)。
mvn verify -Pintegration -pl e2e,load-tests,e2e-ha
テストスイートの概要
コードベースは、対象範囲がそれぞれ異なる複数の相補的なテストスイートでカバーされています。「CI」列には各スイートの実行タイミングが記載されています。スケジュール実行されるスイートには、このページの上部にステータスバッジがあります。
| テストスイート | 実行方法 | CI | 範囲 |
|---|---|---|---|
| ユニットテスト | mvn test (*Test) | すべての PR | 単一のコンポーネントを分離した状態で実行する、高速なインプロセステストです。エンジン内部(ストレージ、ページ、WAL、インデックス、シリアライズ)、クエリの解析と実行(SQL、Cypher、Gremlin、GraphQL)、スキーマ、グラフのトラバーサル、セキュリティを対象とします。カバレッジの大部分を占め、外部サービスは不要です。CI では JUnit タグごとにレーンを分けます。slow(長時間の機能テスト)と vector(LSM ベクトルインデックスの再構築)はそれぞれ専用のレーンで実行し、benchmark はデフォルトで除外します。 |
| 統合テスト | mvn verify -Pintegration (*IT) | すべての PR | 同じ JVM/モジュール内の複数のコンポーネント、または稼働中のサーバーにまたがるテストです。HTTP/REST API、ワイヤープロトコル(Postgres、MongoDB、Redis、Bolt、gRPC)、モジュール間の動作を対象とします。一部のテストでは Docker が必要です。 |
HA 統合テスト(ha-raft) | mvn verify -Pintegration -pl ha-raft | 毎日 | 1 つの JVM 内で起動する複数サーバーの Raft 高可用性クラスターを対象に、レプリケーション、リーダー選出、スキーマとセキュリティの伝播、スナップショットのインストール、遅れているフォロワーの追いつきをテストします。実行時間が長いため、PR パイプラインから分離されています。 |
エンドツーエンドテスト(e2e) | mvn verify -Pintegration -pl e2e | すべての PR | Docker コンテナ内の実際の ArcadeDB サーバー(Testcontainers)に対するブラックボックステストです。外部クライアントと同じ方法で、JDBC/Postgres クエリ、リモート Java API、サーバー側 JavaScript 関数、Bolt および gRPC ドライバーを使用してテストします。 |
負荷テスト(load-tests) | mvn verify -Pintegration -pl load-tests | 毎日 | コンテナ内の単一サーバーおよび 3 ノードクラスターに対して、継続的な同時ワークロードを実行した場合のスループットと安定性をテストします。大量のドキュメントおよび時系列データの取り込みも対象です。競合状態でもデータの損失や破損がないことを検証します。 |
HA エンドツーエンドテスト(e2e-ha) | mvn verify -Pintegration -pl e2e-ha | 毎日 | スクリプト化された障害発生時の Raft クラスターの回復性と正確性をテストします。リーダーのフェイルオーバー、ローリング再起動、スプリットブレイン、ネットワークの分断/遅延/パケット損失、レプリケーションの収束、クラスター全体の操作(バックアップ/復元、インポート、データベースの削除、ユーザー管理)を対象とします。Testcontainers と障害注入(Toxiproxy)を使用します。 |
HA カオステスト(HaChaosIT) | mvn verify -Pintegration -pl e2e-ha -Dit.test=HaChaosIT -Dfailsafe.excludedGroups= | 毎週 | コンテナ化されたクラスターに対する、長時間(デフォルトで 60 分)のランダム化テストです。シード値を指定したスケジューラーが障害(強制終了、停止、ローリング再起動、一時停止、分離、分断、レイテンシ、パケット損失、60 秒以上フリーズしたフォロワーが Raft ストレージの再フォーマットなしで復旧すること)を注入する間、同時書き込みを実行します。各ステップの後、確認応答済みのすべての書き込みが全レプリカに反映されていることを検証します。各実行ではシード値が出力されるため、-Dchaos.seed=... を指定して失敗を再現できます。-Dchaos.nodes、-Dchaos.duration、-Dchaos.faults、-Dchaos.writers で調整できます。chaos タグが付いているため、通常の e2e-ha 実行ではスキップされます。 |
| ベンチマーク | mvn verify -Dgroups=benchmark -DexcludedGroups= | 毎週 | マイクロベンチマークと比較実行(@Tag("benchmark"))です。測定を行いますが、アサーションは行いません。他のすべての実行では除外されます。 |
Python クライアント(e2e-python) | cd e2e-python && pytest tests/ | すべての PR | Docker コンテナ内のサーバーに対して、実際の Python クライアント(psycopg2、asyncpg)と SQLAlchemy ORM を使用した Postgres ワイヤープロトコル、および公式の neo4j ドライバーを使用した Bolt プロトコルを検証します(Testcontainers)。 |
JavaScript クライアント(e2e-js) | cd e2e-js && npm install && npm test | すべての PR | Docker コンテナ内のサーバーに対して、Bolt(neo4j-driver)および Postgres(pg)プロトコル経由の Node.js クライアントの互換性を検証します(Jest + Testcontainers)。 |
C# クライアント(e2e-csharp) | cd e2e-csharp/ArcadeDB.E2ETests && dotnet test | すべての PR | Docker コンテナ内のサーバーに対して、.NET から Postgres ワイヤープロトコル(Npgsql)および Bolt プロトコル(平文および TLS の Neo4j.Driver)を検証します(xUnit + Testcontainers)。 |
Go クライアント(e2e-go) | cd e2e-go && go test ./... | すべての PR | Docker コンテナ内のサーバーに対して、公式の neo4j-go-driver を使用し、平文および TLS で Bolt との適合性を検証します。他のクライアントテストスイートと同様に、共通のシナリオ仕様 bolt/conformance/spec.yaml を実装しています。 |
| Bolt ドライバーマトリックス | bolt-nightly.yml ワークフロー | 毎日 | JavaScript、Python、C#、Go の各テストスイートで Bolt テストを再実行し、各公式ドライバーの複数のリリースバージョンを対象に検証した結果を COMPATIBILITY.md に公開します。 |
Studio(e2e-studio) | cd e2e-studio && npm install && npm test | すべての PR | Playwright を使用して Studio の Web UI をブラウザーでテストします。データベースの作成、クエリとグラフ、グラフビュー(スタイル、コンテキストメニュー、エクスポート)、テーブルビュー、ベクトル検索を対象とします。 |
コミュニティ
ArcadeDB に関するアイデア、ディスカッション、サポートを求めて、世界中で広がるコミュニティにぜひご参加ください。
- Discord でリアルタイムにチャットしましょう
- Twitter をフォローしてください
- または Bluesky でフォローしてください
- LinkedIn でつながりましょう
- または Facebook でつながりましょう
- Stack Overflow で
#arcadedbタグの付いた質問をご覧ください - 公式 ブログ をご覧ください
セキュリティ
セキュリティ上の問題については、GitHub で公開の issue を投稿する代わりに、[email protected] までメールでご連絡ください。
ライセンスと帰属表示
ArcadeDB はあらゆる用途で無料で使用でき、寛容な オープンソース Apache 2 ライセンスの下でライセンスされています。私たちは 永続的なオープンソースであり続けることをお約束します。単なる約束にとどまらない構造的な保証については、ガバナンスをご覧ください。 商用サポートが必要な場合や、問題を ASAP で修正する必要がある場合は、料金ページをご確認ください。
サードパーティの帰属表示と著作権表示については、以下をご覧ください。
- NOTICE - 必須の法的帰属表示
- ATTRIBUTIONS.md - サードパーティへの詳細な謝辞
- LICENSE - ライセンス全文
- GOVERNANCE.md - ライセンスの保証とプロジェクトのガバナンス
謝辞
 を提供してくださった YourKit Profiler に感謝します。私たちのコミッターが利用しています。
貢献
ArcadeDB プロジェクトへのご参加を心よりお待ちしています。 ご協力いただける場合は、貢献ガイドでプロジェクトへの貢献方法をご確認ください。
データを楽しみましょう!
ArcadeDB チーム
スターゲイザーの推移
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。