memory-boost について
memory-boost は、コーディングエージェント向けに編集可能な Markdown メモリを提供し、古くなった情報や未記録・未完了の項目を点検します。Claude Code のセッション利用状況も集計し、プロジェクト間で教訓を再利用できます。
主な機能
- 01Markdown wiki によるメモリ保存
- 02期限切れ・未更新・未記録項目の報告
- 03セッションチェックポイントの保存と復元
- 04Claude Code のツール利用状況の集計
- 05タグに基づくプロジェクト間の教訓共有
活用シーン
- 01再確認が必要なプロジェクト決定の把握
- 02コンテキスト圧縮後のセッション復元
- 03ファイルの再読や失敗コマンドの発見
- 04別プロジェクトでの教訓の活用
MCP 対応
MCP 経由で、検索、保存、セッションチェックポイント、ドリフトレポート、教訓検索など九つのメモリツールを提供します。stdio またはローカル HTTP サーバー経由でエージェントが接続できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
8掲載時のツール一覧 · 1 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| budget | integer | いいえ | |
| project | any | いいえ |
詳細
memory-boost
自分でレビューする、コーディングエージェントのためのメモリ。


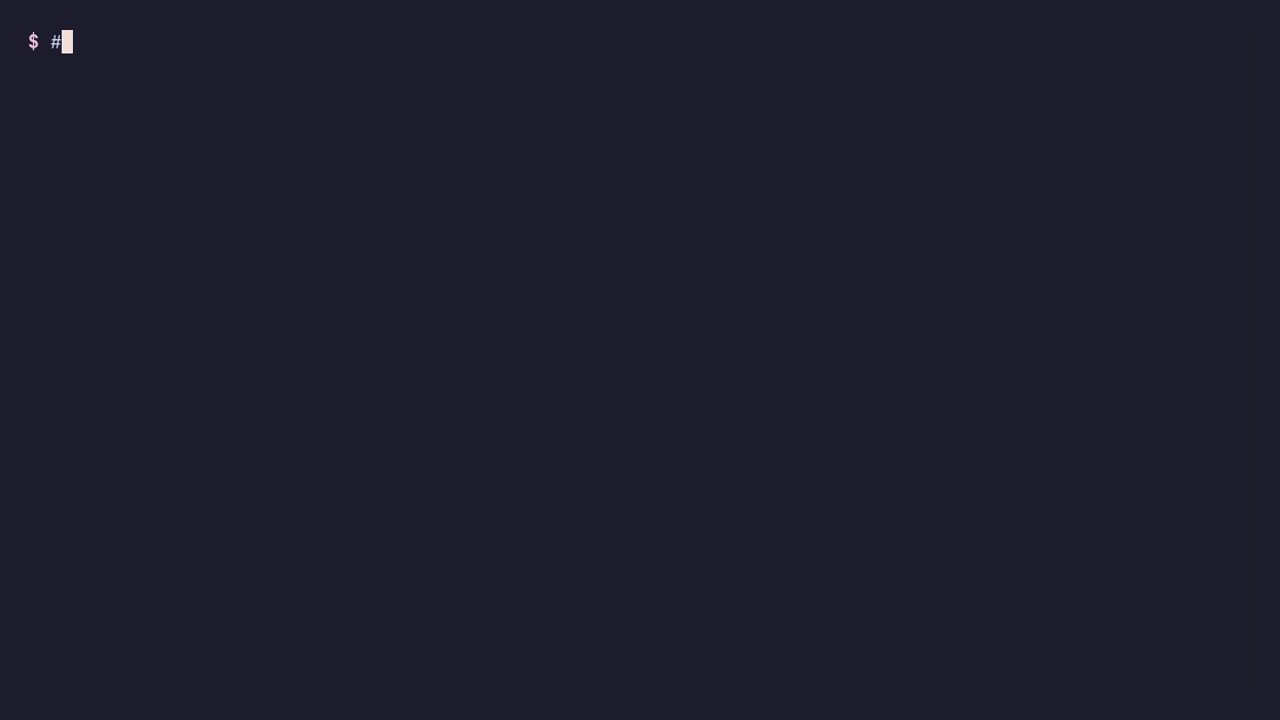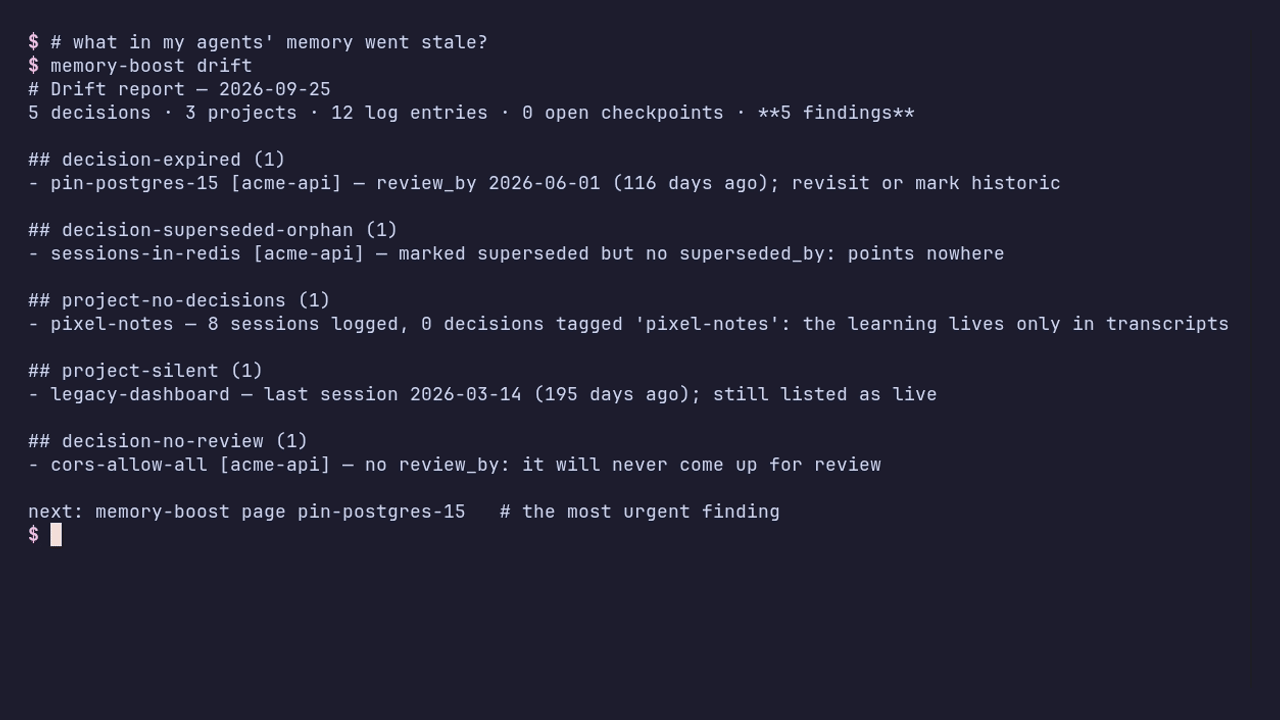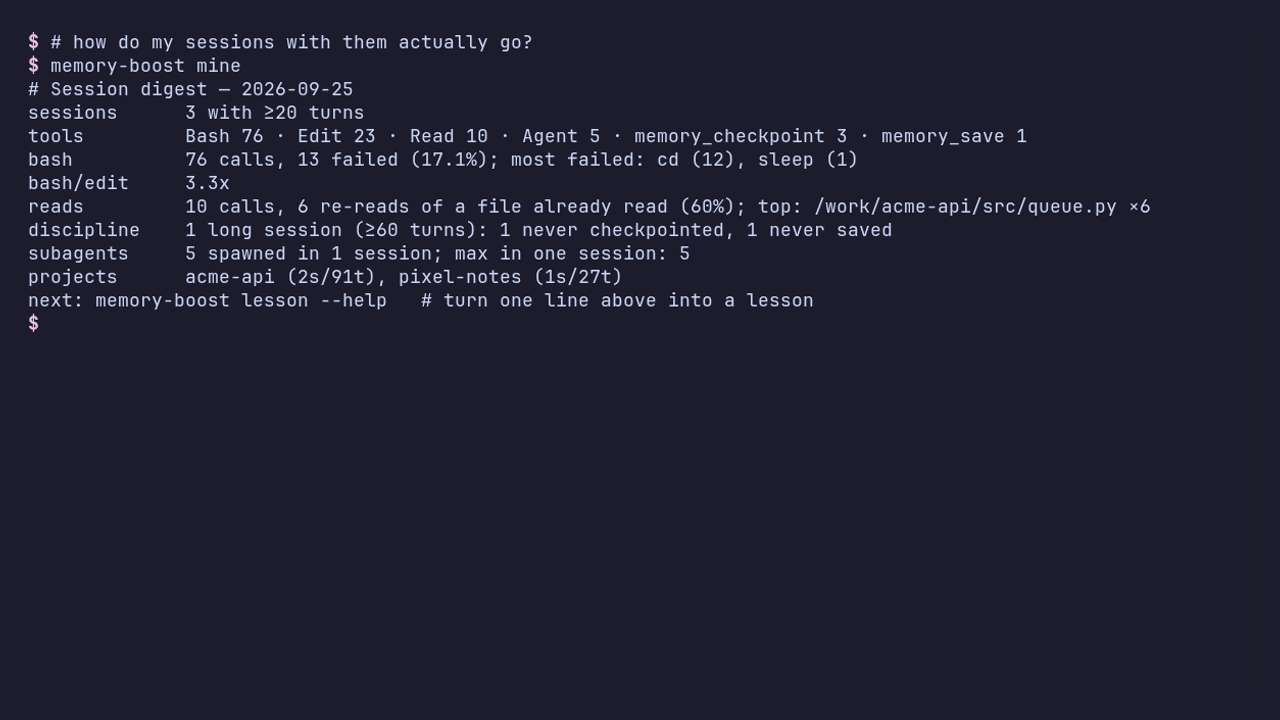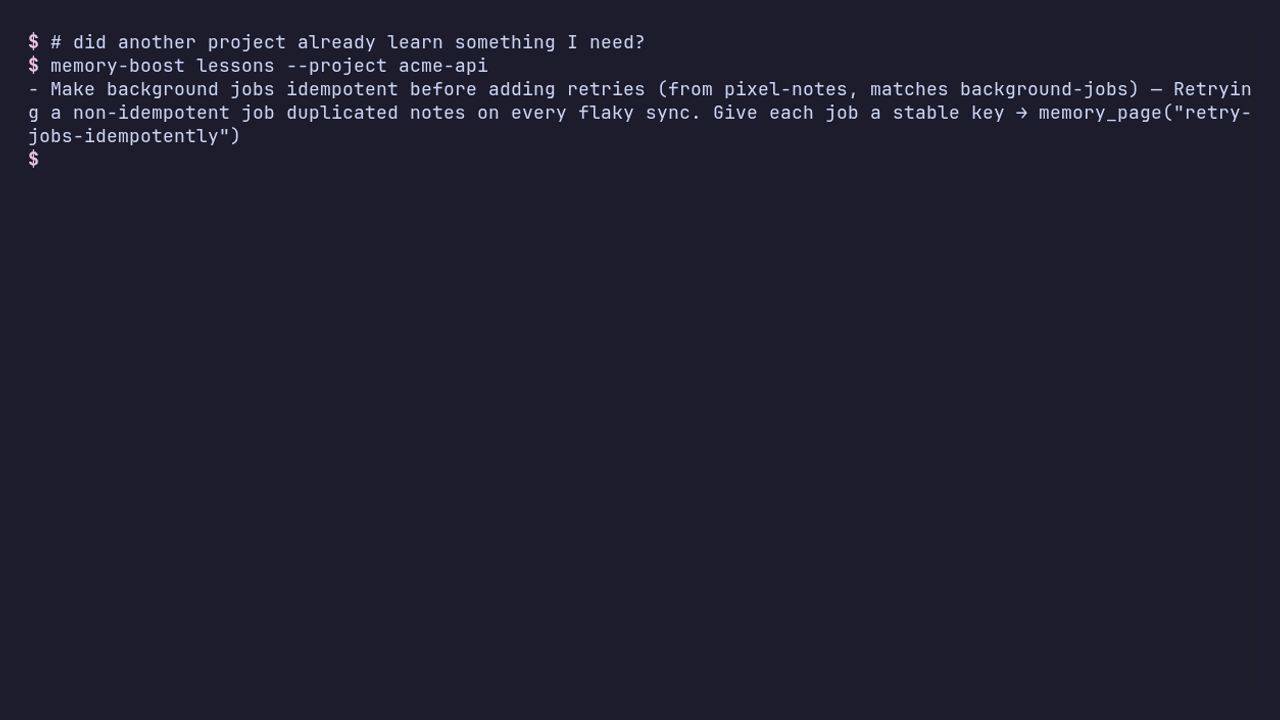
同梱のサンプルデータで drift、mine、lessons を実行 · すべてローカルで動作
試してみる · 答えられること · エージェントを接続する · 仕組み · 他の選択肢との比較
エージェントは何でも書き残します。でも、誰も読み返しません。
コーディングエージェント向けのメモリツールはどれも、より多くのことを覚えさせるのに役立ちます。でも、覚えていることの半分は7月に期限切れになった、という話をするものはありません。memory-boost は、エージェントが MCP 経由で読み書きするプレーンな Markdown のメモリを保ち、さらに、地味ながら大切な仕事もこなします。メモリとセッションを監査し、何が古くなったのかを数字とともに、丁寧に知らせてくれます。
エージェントが覚えていることのコードレビューであり、エージェントとの作業を記録するフィットネストラッカーだと考えてください。どちらかといえば、フィットネストラッカーのほうが近いです。mine によると、私が最も失敗したコマンドは cd でした。69回もです。
答えられること
| 気になること… | memory-boost の回答 |
|---|---|
| 開発に追われている間に、ひっそり期限切れになった決定は? | drift:review_by 2026-07-08、78日前 |
| 「進行中」のプロジェクトのうち、実際には何カ月も前に終わっているものは? | drift:最後のセッションは161日前。それでも進行中として記載されています |
| 別のリポジトリでこのバグを直したはずです。どうやったのでしょう? | lessons:同じ技術スタックのすべてのプロジェクトで、修正方法を参照できます |
| エージェントが同じファイルを何度も読み直すのはなぜ? | mine:1つのファイルを18回読み込み |
| エージェントは私に隠れてサブエージェントを20個起動していますか? | はい。どのセッションで起きたかも分かります |
/compact でコンテキストが消える前に、どこまで作業していましたか? | セッション開始フックがチェックポイントを復元します |
30秒で試す
インストールは不要です。Wiki は ~/.local/share/memory-boost に作成されます。
uvx memory-boost==0.2.0 init --example   # sample wiki with five kinds of rot + four synthetic transcripts
uvx memory-boost==0.2.0 drift            # what in that memory is stale, orphaned or never written down
uvx memory-boost==0.2.0 mine             # now on your real ~/.claude/projects: aggregates only
Claude Code で使い続けるには、プラグインをインストールしてください。MCP サーバー、セッション開始時の概要、スキルが一度に導入されます。必要なのは PATH 上の uv だけです。
/plugin marketplace add arnaugonzalez/memory-boost
/plugin install memory-boost@memory-boost
その他のエージェント、または CLI 単体で使う場合:uv tool install memory-boost==0.2.0(または
pipx install memory-boost==0.2.0)。エージェントにインストールを任せることもできます:エージェントからインストールをご覧ください。
エージェントからインストール
次の内容を Claude Code、Codex、Cline、または Cursor に貼り付けてください。
https://github.com/arnaugonzalez/memory-boost/blob/main/llms-install.md に従って memory-boost 0.2.0 をインストールしてください。CLI を
uv tool install memory-boost==0.2.0でインストールし、memory-boost initを実行してください。memory-boost serveをmemoryという名前の stdio MCP サーバーとして登録し、9つのmemory_*ツールで応答することを確認してください。その後、memory-boost driftを実行して、出力を見せてください。メモリの保存先 (~/.local/share/memory-boost) 以外への書き込みや、グローバルなエージェント設定の編集を行う前に、私に確認してください。
stdio および serve --http の設定手順を、ハーネスごとに確認方法とあわせてまとめたエージェント向けの手順は、
llms-install.md にあります。
実機での使用例
著者自身が5週間にわたって毎日使用した記録:29件の判断、24件のプロジェクト、657件のClaude Codeトランスクリプト。 出力は生成されたままです。置き換えているのはプロジェクト名とファイル名のみです。
$ memory-boost drift
# Drift report — 2026-09-24
29 decisions · 24 projects · 204 log entries · 33 open checkpoints · **20 findings**

## decision-expired (9)
- deploy-via-bastion — review_by 2026-07-08 (78 days ago); revisit or mark historic
- bot-guardrails — review_by 2026-07-08 (78 days ago); revisit or mark historic
  …
## project-no-decisions (2)
- thesis-solver — 20 sessions logged, 0 decisions tagged 'thesis-solver': the learning lives only in transcripts
## project-silent (5)
- mood-api — last session 2026-04-16 (161 days ago); still listed as live
  …

$ memory-boost mine
# Session digest — 2026-09-24
sessions      80 with ≥20 turns
tools         Bash 5956 · Edit 860 · Read 692 · Write 493 · Agent 203 · ToolSearch 138
bash          5956 calls, 159 failed (2.7%); most failed: cd (69), sleep (12), ssh (9), pkill (8), ls (7)
bash/edit     4.4x; extreme: crm-wt-f11 107.5x, sandbox 70.0x, sandbox 54.0x
reads         692 calls, 131 re-reads of a file already read (19%); top: …/apply_email.py ×18
discipline    62 long sessions (≥60 turns): 47 never checkpointed, 29 never saved
subagents     203 spawned in 44 sessions; max in one session: 20
どの行にも、変えるべき習慣、見直すべき判断、書き留める価値のあるルールが記されています。新しいツールは必要ありませんでした。データはすでにディスク上にありました。必要だったのは、それを読み取るものです。
概要
- 自分で管理するWiki。
projects/*.md、decisions/*.md、concepts/*.md、log.md。プレーンな Markdownで、手動で編集し、gitで管理できます。SQLite FTS5インデックスは破棄可能なキャッシュです。あらゆるハーネスで使える9つのMCP ツール:memory_brief、memory_recall、memory_page、memory_save、memory_checkpoint、memory_resume、memory_drift、memory_lesson、memory_shelf。memory_shelf(CLI:memory-boost shelf "idea")は、エージェントがページを読み返すことなく、 日付付きのアイデアを1行、concepts/idea-shelf.mdに追記します。 - データとしての鮮度。 判断には
status:とreview_by:が付きます。検索結果にはcurrent / unclassified / review / historic / supersededのタグが付き、currentが先頭に表示されます。 - セッションチェックポイントは
/compact後も保持されます。同じプロジェクトで並行するエージェントが 競合しないよう、ほかにアクティブな各セッションについて1行ずつ記録します。 - **
drift**はWikiを読み取り、期限切れの項目、更新が途絶えた項目、書き留められなかった項目、 途中で終わった項目を報告します。現在のプロジェクトに関する主な検出結果は、すべてのセッション概要に含まれます。 - **
mine**はローカルにあるClaude Codeのトランスクリプトを読み取り、ツールの使用状況、失敗したコマンド、 再読み込み、サブエージェントの展開、チェックポイントの運用状況を報告します。集計情報のみです。プロンプト、コマンド、 ファイルの内容は保存も表示もされないため、ダイジェストはどこに貼り付けても安全です。 lessons:applies_when: [tags]を持つconcepts/ページです。該当するtags:を記載した プロジェクトページには、そのレッスンが概要に含まれるため、あるリポジトリでうまくいったことを次のリポジトリにも活用できます。/retroスキルがセッション終了時にレッスンを書き込みます。
ハーネスを接続する
MCPサーバー(すべてのハーネス共通):コマンドはmemory-boost、引数は["serve"]です。
複数のセッション間で1つのサーバーを共有するには、ストリーム可能なHTTP(ステートレス、JSON
レスポンス)で実行し、各ハーネスをhttp://127.0.0.1:8765/mcpに向けます。
memory-boost serve --http                      # --host 127.0.0.1 --port 8765 are the defaults
claude mcp add --transport http memory -s user http://127.0.0.1:8765/mcp
デフォルトではループバックインターフェースにバインドされ、認証機能はありません。そのままにしておいてください。
| ハーネス | MCPの登録方法 | セッション開始時のコンテキスト |
|---|---|---|
| Claude Code(プラグイン) | /plugin install memory-boost@memory-boost | 含まれます:フック、MCPサーバー、スキル |
| Claude Code(手動) | claude mcp add memory -s user -- memory-boost serve | 以下のフック(起動、再開、compact);mineがトランスクリプトを読み取ります |
| Codex CLI | codex mcp add memory -- memory-boost serve | AGENTS.md:「最初にmemory_briefを呼び出す」 |
| Cursor / VS Code / Gemini CLI | 各ツールのmcp.json / settings.jsonにstdioエントリーを追加 | ルールに同じ行を記載(フックアダプターはロードマップに掲載) |
Claude Codeの手動フック(~/.claude/settings.json)。プラグインを使う場合は不要です。
{ "hooks": { "SessionStart": [ { "hooks": [ { "type": "command", "command": "memory-boost hook session-start" } ] } ] } }
startup/resumeでは約1kトークンを注入します。カタログ、プロジェクトのコンテキストと直近のセッション、
そのドリフト、ほかのプロジェクトからのレッスン、未完了のチェックポイントが含まれます。compactではこのセッションの
チェックポイントのみです。セッション開始を妨げることはありません。エラーが発生した場合は何も出力しません。
スキル:/memory-boost(ルーター:何をいつ実行するか)、/save-session、/restore-session、
/retro。プラグインをインストールすると、/memory-boost:retroなどの名前で使えます。プラグインを使わない場合は、
skills/*を~/.claude/skills/にコピーしてください。プラグインのインストール後、最初のセッションではuvが
PyPIからmemory-boost==0.2.0と依存関係を取得するため、数秒余計にかかります(プラグインが行う唯一の
ネットワークアクセスです)。それ以降のセッションは約0.2秒で開始します。
エージェント向けCLIの仕様:データはstdoutに、エラーはfix:行とともにstderrに出力します。すべての読み取りコマンドで
--jsonを使います(versionフィールドを含みます)。終了コード0 = stdoutを信頼、1 = 見つからない、2 = 入力不正です。
レポートの末尾には、実行すべき正確なコマンドを示すnext:行が付きます。
仕組み
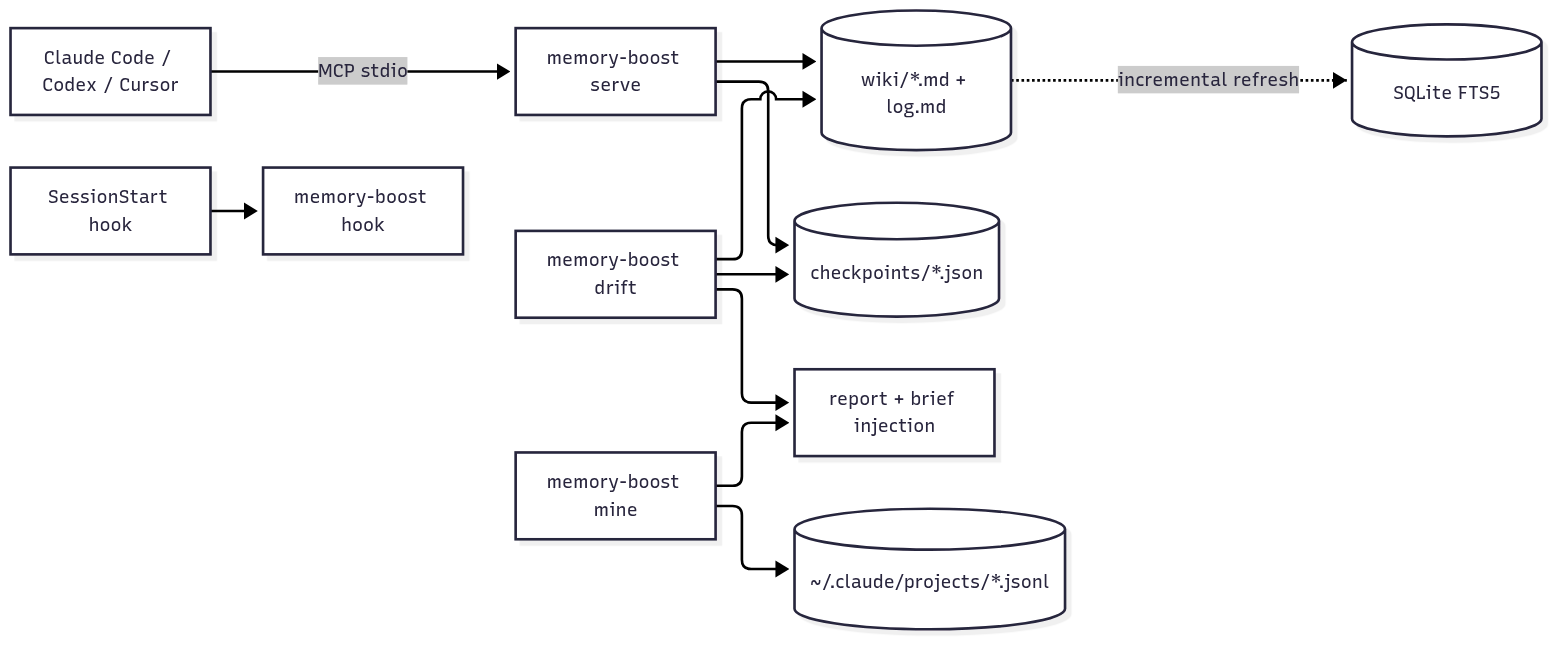
プロジェクトは作業ディレクトリ名から特定されます(~/work/acme-api → projects/acme-api.md)。
ほかの名前は aliases.json で対応付けます。Python は 1,900 行未満、依存関係は 1 つ(mcp)です。セマンティック検索を有効にしない限り埋め込みは使わず、serve --http を実行しない限りデーモンも起動しません。
セマンティック検索(任意)
デフォルトでは無効です。memory_recall は全文検索のみで、基本インストールの依存関係は 1 つのままです。
言い換えやほかの言語も検索対象にするには、ローカルの埋め込みモデルを実行します。
pip install "memory-boost[semantic]==0.2.0"   # adds sqlite-vec
ollama pull embeddinggemma
export MEMORY_BOOST_SEMANTIC=1
memory-boost index                       # embeds the wiki once; later runs embed only changes
CPU で大規模な wiki を初めてインデックス化する場合、数分かかることがあります。目安として、GPU のないノート PC で約 850 件のドキュメントを処理すると 15 分ほどかかります(1 回の計測であり、ベンチマークではありません)。実行中は memory-boost index と
recall が標準エラー出力に embedding N/M chunks… と表示します。以降の実行では変更された項目のみ再埋め込みします。
有効にしたときのデフォルトモードは hybrid(全文検索とベクトル検索を重み付き逆順位で統合)です。MEMORY_BOOST_RECALL_MODE=fts|semantic|hybrid または memory-boost recall --mode で変更できます。Ollama が停止している場合、検索は全文検索にフォールバックし、警告をログに記録します。インデックスをウォームアップした状態で CPU を使い、非公開の 64 件のクエリセット(文字どおりのクエリ 39 件、言い換え 25 件)で測定したところ、言い換えの nDCG@10 は 0.46 から 0.76 に、文字どおりのクエリは 0.80 から 0.85 に向上し、クエリあたりの p50 は約 110 ms でした。
クエリセットは公開されていません。
設定
| 変数 | デフォルト | 用途 |
|---|---|---|
MEMORY_BOOST_HOME | $XDG_DATA_HOME/memory-boost | Wiki、イベント、チェックポイント、aliases.json |
MEMORY_BOOST_WIKI | $MEMORY_BOOST_HOME/wiki | 既存の wiki(例:git リポジトリ)を指定します |
MEMORY_BOOST_INDEX | $XDG_CACHE_HOME/memory-boost/index-<hash>.db | 検索インデックス |
MEMORY_BOOST_CHECKPOINTS | $MEMORY_BOOST_HOME/checkpoints | チェックポイントディレクトリ |
MEMORY_BOOST_TRANSCRIPTS | ~/.claude/projects | mine が検索する場所(複数のディレクトリ:a:b) |
MEMORY_BOOST_TODAY | 今日(UTC) | 再現可能なレポートのための日付を固定します |
代替ツールとの比較
| memory-boost | basic-memory | claude-mem | agent-retro | |
|---|---|---|---|---|
| 保存先 | 自分で編集する Markdown wiki | Markdown | 収集した観察記録 | なし(プロンプトスキル) |
| 検索 | FTS5(+任意のローカルベクトル検索) | FTS+ベクトル検索 | FTS+ベクトル検索 | — |
| 情報の鮮度/レビュー日 | あり | なし | なし | — |
| メモリのドリフトレポート | あり | なし | なし | なし |
| セッション分析 | あり(集計、ローカル) | なし | なし | LLM が会話を読み取ります |
| 並行セッションの把握 | あり | なし | なし | — |
| ライセンス | MIT | AGPL-3.0 | Apache-2.0 | ? |
検索機能や連携機能の強化、コミュニティへの参加を望むなら、basic-memory をお使いください。すべてを自動で記録したいなら、claude-mem をお使いください。エージェントがすでに書き留めた内容から学習したいなら、memory-boost をお使いください。
制限事項/対象外
- デフォルトでは全文検索を使います。埋め込みを使うには、任意の
[semantic]エクストラとローカルの Ollama が必要です。 - 現時点で
mineが対応しているのは Claude Code のトランスクリプトです。Codex はロードマップに含まれています。 - レポートの品質は wiki に左右されます。wiki が空なら
driftも空になります。 - 単一ユーザー向けで、ローカルファイルを使います。Linux と macOS に対応しています。Windows は未検証です。
- エージェントは wiki を指示として読み込みます。信頼できる wiki のみを使用してください。SECURITY.md を参照してください。
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。