schemagate について
schemagateは、text-to-SQL向けのアクセス制御とスキーマ選択ツールです。呼び出し元のIDと権限に基づいてデータベースオブジェクトを絞り、読み取り可能なテーブルだけをモデルに渡します。LangChain、LlamaIndex、MCPなどでSQLエージェントを構築する開発者向けです。
主な機能
- 01IDとロールに基づくオブジェクトの絞り込み
- 02権限のないテーブルをプロンプトから除外
- 03質問に関連するテーブルとプロンプトの選択
- 04CLIとローカルStudioページ
- 05複数DBとSQLエージェント連携
活用シーン
- 01text-to-SQLエージェントが見られるテーブルを制限
- 02ロール別のスキーマコンテキストを用意
- 03リクエストごとに送るスキーマ情報を削減
- 04Studioで質問に対するテーブル選択を確認
MCP 対応
MCPやその他のSQLエージェントのワークフローで利用できます。呼び出し元が読み取りを許可されたデータベースオブジェクトを絞り、選択したスキーマをtext-to-SQLモデルに渡します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx schemagateSCHEMAGATE_DATABASE_URLシークレットSQLAlchemy URL of the database to reflect, or 'demo' for the bundled schemaSCHEMAGATE_CATALOG_CONFIGOptional path to a JSON file with roles, hints and shadow-name overridesローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
翻訳後に原文が更新されています。最新の内容は原文をご確認ください。
schemagate — スキーマ選択時のテキストから SQL へのアクセス制御




テキストから SQL を生成するエージェントは、呼び出し元に読み取り権限があるか誰も確認する前に、モデルに提示するテーブルを選びます。schemagate は先に権限を確認します。呼び出し元に付与された権限に基づいてスキーマをフィルタリングするため、制限されたテーブルは候補順位が低くなるのではなく、プロンプトに含まれません。Postgres、Oracle、MySQL、SQL Server、SQLite で、LangChain、MCP、その他の SQL エージェントと連携します。
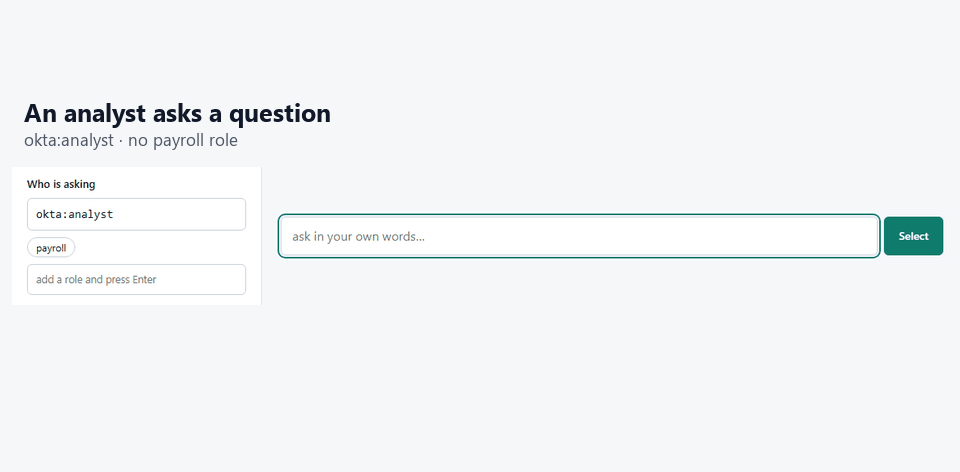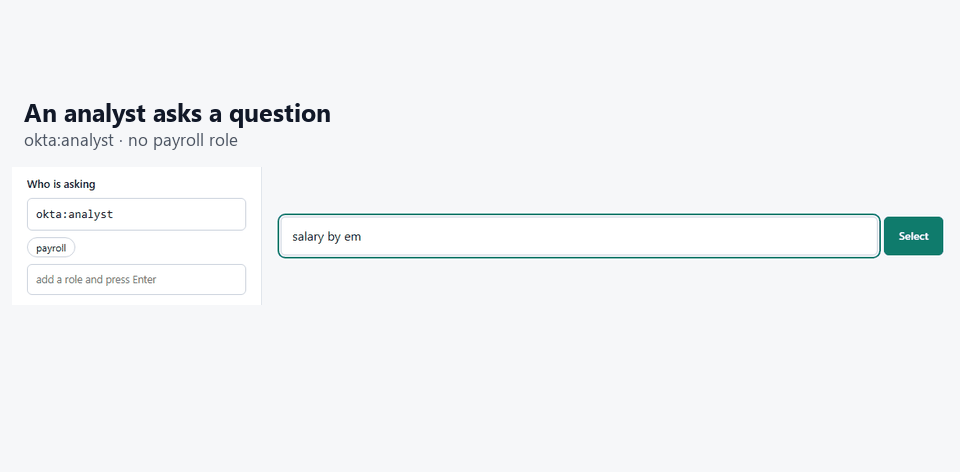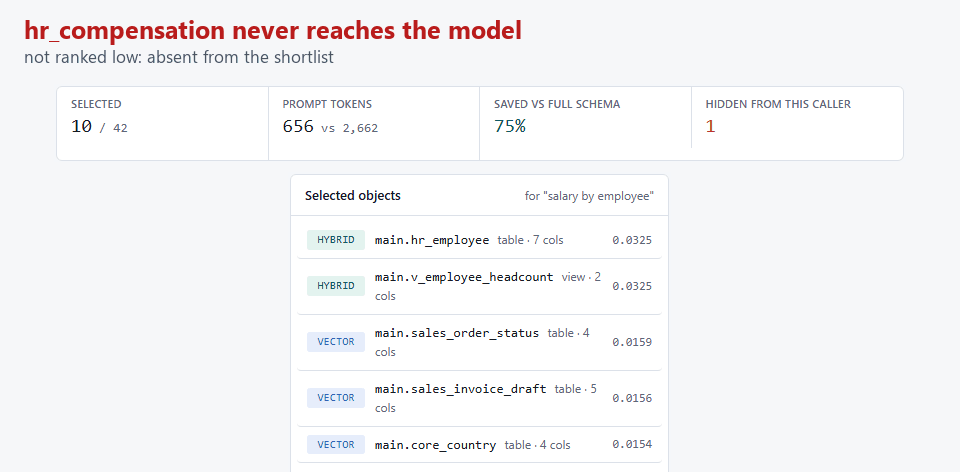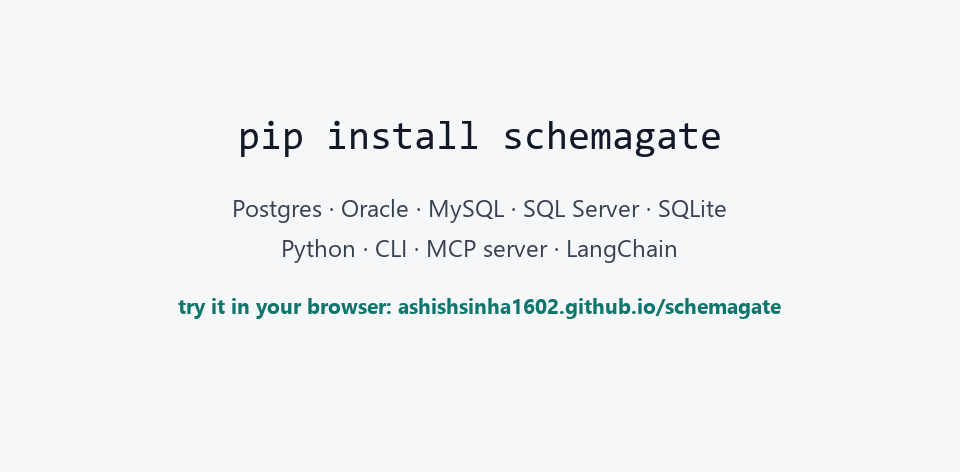
本来プロンプトに含まれるべきでないテーブルを除外できたら、⭐を付けて、SQL エージェントを開発しているほかの人にも見つけてもらいましょう。
行レベルセキュリティだけでは、問題は静かに起こります。モデルは呼び出し元が読み取れないテーブルに対する有効な SQL を生成し、RLS がすべての行を除外します。その結果、ユーザーには「レコードが見つかりません」と表示されますが、これは「このデータは存在しません」と区別できません。
デモ · インストール · ベンチマーク · ローカルモデル · 費用について · Vanna からの移行
同じ質問でも、呼び出し元によって結果は異なります。データベースもキーも不要です。
schemagate demo "salary by employee"                                     # hr_compensation absent
schemagate demo "salary by employee" --principal okta:hr --role payroll  # now it is first
順位が低くなるのではなく、候補から除外されます。呼び出し元が読み取れないテーブルはプロンプトに含まれないため、質問を言い換えてもそのテーブルに到達せず、回答から後で除外するものもありません。
ブラウザーで試す — インストールもデータベースもモデル呼び出しも不要です。
そして回答します
選択結果はプロンプトなので、あとは次のとおりです。
pip install schemagate
schemagate demo "which customers owe us money" --answer --provider <provider> --model <model-id>
main.crm_customer   main.crm_contact   main.v_customer_balance   (+5)
8 of 42 objects  ·  ~383 prompt tokens instead of ~2,036

-- SQL written by <provider> / <model-id>, from 8 tables
SELECT c.id, p.display_name, v.account_number, v.invoiced, v.paid,
       (v.invoiced - v.paid) AS balance_due
FROM v_customer_balance v
JOIN crm_customer c ON c.id = v.id_customer
JOIN core_party  p ON p.id = c.id_party
WHERE v.invoiced > v.paid

id  display_name       account_number  invoiced  paid     balance_due
--  -----------------  --------------  --------  -------  -----------
1   Northwind Trading  ACC-1001        33960.0   22080.0  11880.0
2   Kellner GmbH       ACC-1002        8760.0    3000.0   5760.0
質問から行を取得します。データベースのセットアップは不要で、同梱の42オブジェクトのスキーマに対して実行できます。<provider> は選択するモデルサービスです。
openai、anthropic、gemini、oci、local(キー不要)、または auto
(設定されているキーを使用)を指定します。--url を使えば、独自のデータベースを指定できます。
schemagate select "which customers owe us money" \
  --url "postgresql+psycopg://user:pw@host/db" --answer --provider <provider> --model <model-id>
キーがない場合は、--provider を省略すると、任意のチャットに貼り付けられるプロンプトが表示されます。返された SQL を --sql "SELECT ..." で実行してください。
同梱スキーマを使った例をさらに紹介します。実際によく入力される質問は次のとおりです。
schemagate demo "which customers owe us money"
schemagate demo "late shipments by carrier" --prompt   # the DDL the model gets
独自のデータベースでも同じ形式です。
schemagate select "revenue by month" --url postgresql://localhost/app --principal okta:jdoe --role finance
schemagate studio --url postgresql://localhost/app        # the same thing, as a page
schemagate studio を実行すると、質問を入力したり、呼び出し元のロールを切り替えたり、ヒントを編集したり、プロンプトに含まれる情報と含まれない情報を確認したりできるローカルページが開きます。同じページは、サーバーを介さず、ブラウザー上で同梱の6つのスキーマを使って、https://ashishsinha1602.github.io/schemagate/ で一般公開されています。このページのセレクターは、このライブラリを JavaScript に移植したもので、1,789件のケースを両方で実行してランキングが一致することを確認するテストもあります。
Vanna(2026年3月にアーカイブ)から移行する場合は、docs/migrating-from-vanna.md に要点をまとめています。Vanna は SQL の実行時にユーザーの識別情報を適用していましたが、schemagate はモデルがスキーマを見る前に適用します。User は1行で Principal にマッピングできます。
削減できるもの
テキストから SQL を生成する呼び出しでは、毎回プロンプトに含めるスキーマの分だけコストがかかります。スキーマ全体を含めると、質問のたびにすべてのテーブル分のコストがかかります。モデルに6つのテーブルを渡せば、6つ分のコストがかかります。テスト用スキーマで、正解データ付きの質問に対する平均を計測しました。tests/bench.py と同じ組み込み推定器を使用しています。
| スキーマ | オブジェクト数 | 毎回スキーマ全体を含める場合 | schemagateの平均 | 削減率 |
|---|---|---|---|---|
| コマース | 42 | 2,483トークン | 604 | 76% |
| 医療請求 | 27 | 1,568 | 543 | 65% |
| 請求データウェアハウス(スター型) | 51 | 3,312 | 880 | 73% |
| 銀行の台帳と取引 | 39 | 2,255 | 637 | 72% |
| IoTテレメトリー | 40 | 2,125 | 448 | 79% |
| 敵対的(4つのスキーマ、すべてを複製) | 260 | 16,095 | 444 | 97% |
重要なのは最後の行です。スキーマがどれだけ大きくなっても、選択されるテーブルは約6つに収まるため、スキーマが大きいほど削減効果も高まります。実際のデータベースは、最初の行ではなく最後の行に近いものです。
価格はご自身のものに置き換えてください。例として、260オブジェクトのスキーマに対して1日5,000件の質問があり、入力料金が100万トークンあたり3ドルの場合を考えます。スキーマ全体を含めると、16,095 × 5,000 × 30 = 月24億トークンで、約7,200ドルです。schemagate では、444 × 5,000 × 30 = 6,700万トークンで、約200ドルです。 ブラウザーデモ の統計情報の下には、編集可能な2つの入力欄があります。ご自身の利用量と料金を入力すると、どのような質問をしても、それに合わせて計算結果が更新されます。
ここでコストがかからず、ほかでは費用がかかるものがもう2つあります。セレクター自体はモデルを呼び出しません(BM25とハッシュ化された埋め込みを使い、オフラインでミリ秒単位で動作します)。また、オプションの説明は API キーの代わりに、すでに利用料金を払っている任意のチャットで作成できます。詳しくは APIキーを使わない場合をご覧ください。
このツールが解決する問題
LLM にデータベーススキーマを渡すと、2つの問題が起こります。
1つ目はコストです。ほとんどのシステムでは、質問のたびにスキーマ全体をプロンプトに貼り付けます。テーブルが20個なら問題ありませんが、2,000個では大きな負担になります。
2つ目はさらに深刻で、これがこのツールを書いた理由です。スキーマの選択はクエリの実行前に行われるため、行レベルセキュリティが機能する前に行われます。選択の段階でユーザーの ID を考慮しないと、モデルに呼び出し元が読み取れないテーブルが渡されます。モデルは適切な SQL を生成します。RLS または VPD がすべての行をフィルタリングします。ユーザーには「レコードが見つかりません」と表示され、それを信じてしまいます。
これはアクセス拒否のメッセージではありません。自信に満ちた口調の誤答であり、ユーザーにはその違いを見分ける方法がありません。これを避ける方法として私が知っているのは、まずユーザーの ID に基づいてカタログをフィルタリングすることだけです。
from schemagate import Catalog, Principal

cat = Catalog().bootstrap("postgresql://localhost/app")   # or: from schemagate.demo_schema import demo_catalog; cat = demo_catalog()
cat.hint("invoice_draft", "pre-issue drafts only, not real revenue")
cat.restrict("hr_compensation", ["payroll"])

sel = cat.select("revenue by month", top_k=6,
                 principal=Principal("okta:jdoe", roles={"finance"}))

sel.prompt_fragment()   # compact DDL, ready for the system prompt
sel.object_list         # [{'owner': ..., 'name': ...}]
sel.explain()           # why each object was picked
hr_compensation はその結果に含まれず、プロンプトのテキスト内にも名前が一切表示されません。
インストール
pip install schemagate
必要なものはこれだけです。依存関係は1つ(SQLAlchemy)で、API キーもモデルのダウンロードも不要です。デフォルトの埋め込み器はハッシュ化された n グラムベクトライザーで、オフラインで動作し、どのマシンでもバイト単位で同一の結果を返します。
追加機能はすべてオプションです:
pip install 'schemagate[postgres]'     'schemagate[oracle]'
pip install 'schemagate[mssql]'        'schemagate[mysql]'
pip install 'schemagate[anthropic]'    'schemagate[openai]'      'schemagate[gemini]'
pip install 'schemagate[huggingface]'
huggingface はキー不要で、マシンから何も外部に送信しない方法です。また、追加機能の中で容量が大きいのはこれだけです。初回使用時に約2 GBのホイールと3.1 GBのモデルをダウンロードします。意図的に schemagate[all] には含めていません。
docs/local-models.md に詳細があります。ダウンロード、初回に待つ読み込み、得意な用途、ホスト型モデルより不得意な点について説明しています。
すべてのリリースに署名があります。 ホイールには PEP 740 のアテステーションが付属しています。これは、そのファイルをビルドしたワークフロー、リポジトリ、コミットを明示する GitHub の署名です。手動でアップロードされるものはなく、盗まれる API トークンもありません。gh attestation verify <wheel> --repo ashishsinha1602/schemagate を使って、ご自身で検証できます。
クイックスタート
pip install schemagate            # add an extra for your driver, below
schemagate                        # opens http://127.0.0.1:8770 on the 42-object demo
PyPI 上のすべてのホイールには、ビルド元のコミットを明示する署名付きの来歴アテステーションが付属しています:
gh attestation verify <wheel> --repo ashishsinha1602/schemagate。
または、何もインストールせず、すべてのドライバーがイメージに含まれた状態で実行できます:
docker run -p 8770:8770 -e SCHEMAGATE_DATABASE_URL=postgresql://… ghcr.io/ashishsinha1602/schemagate
URL を省略すると、データ入りの42オブジェクトのサンプルスキーマで起動するため、自分のデータベースを接続する前に質問を試せます。
次に、ページで以下を行います:
- 接続。 URL を貼り付けます。
postgres://…、postgresql://…、mysql://…、oracle://…、JDBC 文字列のほか、Autonomous Database 用のウォレット形式も使えます。この接続を保存にチェックを入れて名前を付けると、次回の起動時に自動で再接続します。 - カタログ化。 設定 → モデル からプロバイダーを選び、キーを貼り付けて、モデルを保存します(保存されるため、再起動後に再入力する必要はありません)。次に、サイドバーでこのデータベースをカタログ化します。オブジェクトごとに1文をディスクにキャッシュするため、2回目の実行では費用がかかりません。
- 質問。 自分の言葉で質問を入力します。質問に答えるオブジェクト、モデルに渡される DDL、SQL、行が表示されます。
ドライバーは追加機能として提供されています。schemagate[postgres]、[oracle]、[mysql]、[mssql]、またはすべてを含む schemagate[all] を指定してください:
pip install 'schemagate[postgres]'
質問で誤ったテーブルが選ばれる場合
データベースごとに設定でき、再接続のたびに適用される方法が2つあります:
- ヒント(サイドバー → ヒント):オブジェクトごとに、あなた自身の言葉で説明します。"MyConvo campaigns:personal-inbox はユーザー自身のメールボックスから送信します。"
- 用語集(
POST /api/glossary):どこでも使われる単語を登録します。ここに登録した用語はカタログ化プロンプトに渡されるため、すべての説明であなたの語彙が使われ、その用語を含む質問にも展開されます。
ヒントはどこでも生成された説明より優先され、どちらも再カタログ化は不要です。
コマンド
すべてのサブコマンドとその用途です。schemagate <command> --help でも同じ内容を表示できます。
schemagate demo      [question]          run against the bundled 42-object schema
schemagate select    --url URL [question]  select against your own database
schemagate studio    [--url URL]         the Studio page, served locally
schemagate describe  --url URL           write AI descriptions for your objects
schemagate certify   URL                 end-to-end check on a real engine
demo と select
select は実際のデータベースを対象にした demo です。同じフラグを使用します。
schemagate demo "who reports to whom"
schemagate select --url postgresql+psycopg://user:pw@host/db "unpaid invoices"
schemagate select --schema APP --url "oracle+oracledb://ADMIN:pw@/?dsn=(description=(address=(protocol=tcps)(port=1522)(host=adb.us-phoenix-1.oraclecloud.com))(connect_data=(service_name=abc123_mydb_low.adb.oraclecloud.com)))" "unpaid invoices"   # Autonomous Database
| フラグ | 機能 |
|---|---|
--top-k N | 選択するオブジェクトの数(デフォルトは6) |
--principal SOURCE:ID | リクエストしているユーザー。例:okta:jdoe、db:APPUSER。名前空間が必要です |
--memory PATH|1 | 実行した質問→SQLのペアを記憶し、次回に利用します(ピン留め+動作例)。~/.schemagate/memory/ の場合は 1 を指定します。デフォルトではオフです |
--role ROLE | 呼び出し元が持つロール。繰り返し指定できます |
--prompt | 選択結果の代わりにプロンプトを表示します |
--explain | 各オブジェクトが選ばれた理由と、除外された内容を表示します |
--answer | SQLを作成して実行します(プロバイダーが必要です) |
--provider NAME / --model ID | 使用するモデルを指定します |
--limit N | --answer の行数上限 |
--restrict-from-grants | データベース独自の GRANT から可視性を取得します |
--rerank | 数学的に作成された候補リストをモデルに並べ替えさせます(統合版 Spider 80.3% → 96.5%、BIRD 88.6% → 96.7% の質問で正解のテーブルがすべて上位5件に含まれます。BENCHMARKS.md) |
--values | 個人情報を含まない短い列の値をサンプリングします |
--include / --exclude PATTERN | 反映する対象を絞り込みます(select のみ) |
--schema NAME、--no-fk、--config JSON、--sql SELECT | select のみ |
studio
schemagate                              # the demo, or your remembered connection
schemagate studio                       # empty, connect from the page
schemagate studio --demo                # the bundled sample schema
schemagate studio --url postgresql://localhost/app
schemagate studio --remember            # save the connection, reconnect next time
schemagate studio --forget              # delete the saved connection and exit
| フラグ | 機能 |
|---|---|
--url URL | ページからではなく、起動時に接続します |
--host / --port | デフォルトは 127.0.0.1:8770 |
--no-browser | ブラウザーを開きません |
--demo | 同梱のサンプルスキーマを開きます |
--remember | この接続を ~/.schemagate/connection.json(0600)に保存し、次回起動時に再利用します。データベースとウォレットのパスワードも含まれるため、指定がない限りオフです |
--forget | このファイルを削除して終了します |
--allow-connect / --no-connect | ページからデータベースに接続できるかどうかを指定します。ループバックではデフォルトでオン、それ以外のアドレスにバインドする場合はオフです |
--restrict-from-grants | 起動時に GRANT から可視性を取得します |
--values | 反映時に列の値をサンプリングします |
--include / --exclude / --config | select と同様です |
ページで、Catalogue this database はまだ説明のない項目を説明し、 Re-catalogue all はすべての項目を再度書き換え、Resync schema は 既存の説明を保持したままデータベースを再反映します。
describe
# with a key
schemagate describe --url postgresql://localhost/app --provider anthropic --model claude-sonnet-5

# without one: write the prompt out, paste it into any chat, apply the reply
schemagate describe --url postgresql://localhost/app --out prompt.txt
schemagate describe --url postgresql://localhost/app --apply reply.json
| フラグ | 機能 |
|---|---|
--out FILE | モデルを呼び出す代わりにプロンプトを書き出します |
--apply REPLY.json | その方法で生成した返信を適用します |
--all | 不足している項目だけでなく、すべてを再説明します |
--cache FILE | 生成した説明の保存先を指定します。再実行時は費用がかかりません |
--provider / --model | 使用するモデルを指定します |
--include / --exclude / --schema / --config | select と同様です |
certify
schemagate certify "postgresql+psycopg://user:pw@host/db"
反映と選択を行い、実際のエンジンが実行した内容を報告します。新しいデータベースやドライバーを信頼する前に実行すべきチェックです。
環境
| variable | what it does |
|---|---|
SCHEMAGATE_CONNECT_ARGS | create_engine(connect_args=...) に渡す JSON です。Autonomous Database のウォレットなど、URL では指定できない接続設定に使用します |
SCHEMAGATE_REMEMBER=1 | --remember を渡さずに接続を保存します |
SCHEMAGATE_HOME | connection.json の保存場所です(デフォルトは ~/.schemagate) |
ANTHROPIC_API_KEY、OPENAI_API_KEY、GEMINI_API_KEY / GOOGLE_API_KEY、OCI_COMPARTMENT_ID | --provider によって自動的に取得されます |
SCHEMAGATE_STUDIO_LOG=1 | Studio のリクエストをログに記録します |
SCHEMAGATE_VALUES=1 | MCP サーバー:起動時に列の値を読み込みます。--values と同じです(SCHEMAGATE_VALUES_BUDGET は秒数で、デフォルトは 30 です) |
SCHEMAGATE_RESTRICT_FROM_GRANTS=1 | MCP サーバー:データベースの GRANT に基づいて可視性を設定します。--restrict-from-grants と同じです(PostgreSQL、MySQL、Oracle) |
SCHEMAGATE_CATALOG_MAX_AGE | MCP サーバー:カタログを再読み込みするまでに使用できる秒数です。再読み込みに失敗した場合、成功するまでスコープ設定ツールは使用を拒否します(下記参照) |
SCHEMAGATE_MCP_RERANK=1 | MCP サーバー:select_schema で、サーバーのモデル(SCHEMAGATE_MCP_PROVIDER + SCHEMAGATE_MCP_MODEL)が上位 20 件を並べ替えます。--rerank と同じです。質問ごとにモデルを 1 回呼び出します。モデルを指定せずに設定すると、サーバーは起動しません |
選定方法
- SQLAlchemy を通じてスキーマをリフレクションします。ベンダー固有の SQL は一切使用しません。
- 名前、列、コメント、ヒント、ビュー定義をインデックス化します。最後の項目は見た目以上に重要です。ビューに表示されるのは出力列だけなので、
v_stock_shortfallは「不足」に関するものに見えても、検索対象となるreorder_pointは SELECT 文の中に埋もれています。 - BM25 とベクトル類似度を相互順位融合で組み合わせて検索します。どちらか一方では不十分です。ベクトル検索は正確な識別子を見落とし、BM25 は「こちらにお金を借りている」→
balanceを見落とします。 - 質問に出てこない結合テーブルも取得できるよう、外部キーをたどります。私の経験では、生成された SQL が構文上は正しくても実行できない原因として、これが最も大きなものです。
- 上記のすべての段階で、呼び出し元の ID を適用します。
数値
アクセス制御について、第三者のベンチマークで評価した結果です。 RBAC Text-to-SQL ベンチマーク (SIGMOD'27)では、各質問にロールと列レベルのポリシーが割り当てられ、著者独自の評価器で回答と拒否の結果が評価されます。claude-sonnet-4-5 を使用し、5 回試行しました。
| AC-F1 | 違反率 | 禁止データを読み取った SQL | |
|---|---|---|---|
| BIRD、schemagate | 90.1 | 5.4% | 0 |
| BIRD、論文で最高の結果(同じモデル、プロンプトにポリシーを記載) | 88.1 | 7.4% | 未報告 |
| Spider、schemagate | 93.0 | 5.1% | 0 |
| Spider、同じモデルを使用した論文の結果 | 93.0 | 4.6% | 未報告 |
| Spider、論文で最高の結果(DeepSeek V3.2-Reasoning) | 95.9 | 2.0% | 未報告 |
モデルには、制限対象のスキーマ部分が一切表示されません。注意事項とすべての列の説明は BENCHMARKS.md にあります。
もう 1 つのベンチマークでの結果です。 Spider-ACL(EACL 2026)では、19,624 件の質問とロールの組み合わせそれぞれについて、PostgreSQL 自身が許可した内容をラベル付けしています。claude-sonnet-5-5 を使用し、全 19,624 件で評価しました。
| 拒否の F1 | 誤許可 | ロールに許可されていないデータを読み取ったクエリ | |
|---|---|---|---|
| schemagate | 0.984 | 1.8% | 回答した 8,128 件中 0 件 |
| 論文で最高の結果(LoRA でチューニングした Mistral-7B) | 0.933 | -- | 未報告 |
論文で評価されたシステムは 2024~25 年のモデルです。詳細と制限事項は
BENCHMARKS.md にあります。2 つの結果をまとめた
技術レポート(PDF) と DOI 10.5281/zenodo.23446210 もご覧ください。
信頼していただかなくても確認できる、公開ベンチマークの結果です:
BENCHMARKS.md では、Spider と BIRD での schemagate の結果を掲載しています。スクリプトは benchmarks/ にあり、データは元の配布元からダウンロードしています。主な結果は、Spider の全データベースを 1 つの 876 テーブルのカタログに統合し、どのデータベースを参照すべきかのヒントを与えないプール設定です:
| Spider dev、876 テーブルを統合 | pip install schemagate | [huggingface] | [huggingface] + --rerank |
|---|---|---|---|
| top_k=5 | 76.7% | 80.3% | 96.5% |
| top_k=10 | 86.1% | 90.7% | |
| top_k=20 | 94.2% | 97.0% |
BIRD dev、1,534 問では、top_k=5 のデータベース単位で 96.7%、top_k=10 のプール設定で 91.3% です。top_k=5 のプール設定では、ハッシュ方式で 83.8%、[huggingface] で 88.6%、--rerank で 96.7% です。1.5.2 で再測定し、claude-haiku-5-5 でリランキングしました。1 問につき 1 回呼び出しています。
また、実際のデータウェアハウス向けに構築されたベンチマーク、Spider 2.0-lite では、162 のデータベース、8,255 のテーブルがあり、データベースあたりの中央値は 16 テーブル、最大は 785 テーブルです。使用可能な 247 問すべてを対象に、top_k=10 で 79.8% を達成しました。除外した問題はありません(正解テーブルを解決できた 233 問では 84.5%)。データベースはすでに大規模なため、統合は不要です。このページの以前のバージョンでは 82.9% と記載していましたが、Windows によってスキーマファイル数千件が気づかないうちに読み取り不能になっていた状態で測定した値でした。また、ローダーがベンチマークの列ごとの説明を 1 つのテーブル説明として読み込んでいることが判明したため、再測定が必要でした。どちらの再測定も完了しており、BENCHMARKS.md では訂正内容を削除せずに残しています。
エンドツーエンドで、各ベンチマークが実際に採点する指標では: schemagate と claude-opus-5 の組み合わせで、BIRD dev の実行精度は 68.0%(150 問中 102 問、シード指定のサンプル)で、97.3% の問題で実行可能な SQL が生成されます。BIRD dev で公表されている GPT-4 のベースラインは約 46% です。
これらはいずれもリーダーボードでの順位ではありません。順位を得るには保留テストセットでの評価が必要で、ここに記載した結果はどれも提出されていません。
以下の結果はすべて、私が作成したスキーマで測定したものであり、価値は低くなります。そのため、公開結果を先に示しています。
ライブラリには 6 つのテストスキーマが含まれています。python tests/bench.py を実行すると、これらの結果がすべて出力されます。テスト内容、発生した問題、原因が schemagate ではなくデータベースにあると判明した事項については、TESTING.md にすべて記録されています。
以下の数値はすべてこの実行で出力され、いずれかの値が一致しなくなると実行は失敗します。bench.py はこの表を読み戻して照合します。
ここでの recall@6 は、質問全体でマイクロ平均した、上位 6 件に取得された 正解テーブル の割合です。文字どおりの表現列ではスキーマ固有の用語を再利用した質問を使い、業務用語列では語彙の重複がない、人が使うような表現で同じ内容を質問します。どちらも重要ですが、結果は異なります。その違いを示すことが、この両方を掲載する目的です。
| スキーマ | オブジェクト数 | recall@6、文字どおりの表現 | recall@6、業務用語 |
|---|---|---|---|
| commerce | 42 | 100% | 50.0% |
| clinical claims | 27 | 100% | 46.7% |
| claims warehouse (star) | 51 | 100% | 50.0% |
| bank ledger and trading | 39 | 100% | 64.3% |
| IoT telemetry | 40 | 100% | 60.0% |
| hostile(4 つのスキーマにすべてのコピーを含む) | 260 | 100% | 85.7% |
| スキーマ全体で 19 件のケースにおいて、実テーブルがバックアップ/ステージング用コピーより上位 | 19/19 |
| 外部キーによる拡張なしの recall | 93.8% |
| プロンプトのトークン数、毎回スキーマ全体を使用 | 2,812 |
| プロンプトのトークン数、schemagate の平均 | 764(−72.8%) |
ハッシュ方式の埋め込み器で測定しています。追加機能なしの pip install schemagate で利用できるものです。schemagate[huggingface] にすると sentence-transformers に切り替わり、業務用語の数値は大きく向上します。保留パラフレーズ評価セットでは、tests/run_paraphrase_eval.py によると、全体の正解率はハッシュ方式で 58.6%、MiniLM で 82.8% です。この評価ハーネスでは、正解テーブルのいずれかが取得された場合に質問を正解とみなすため、この表より緩い条件です。そのため、数値をこの表と比較することはできません。同じ理由で、使用した埋め込み器も出力されます。
トークン数はベンチマークに組み込まれた推定器から取得するため、ネットワーク接続も追加インストールも不要で、同じ数値を再現できます。pip install tiktoken を実行すると、同じスクリプトで正確な cl100k_base のカウントに切り替わります。どちらの場合も比率は変わりません。
スキーマが1つではなく6つなのは、質問とテーブル名で語彙がたまたま一致するスキーマを使えば、どんな検索ツールでも実力以上によく見えてしまうからです。2つ目はまったく異なる分野です。3つ目は、意図的に問題を仕込んだ260個のオブジェクトです。すべてのテーブルに対する _archive と _stg のコピー、3つのスキーマにある同じテーブル名、8段階の外部キー連鎖、参照の循環、複合キー、320列のテーブル、100文字の識別子、スペイン語と日本語の名前が含まれます。4つ目は、どの質問にも複数のテーブルが候補になり、そのうち1つが正解となるよう構築された、保険金請求データウェアハウスのスター型スキーマです。同じファクトを4つの粒度で持ち、履歴テーブルを伴う緩やかに変化する会員ディメンション、5通りの方法で結合される1つの日付ディメンション、ブリッジテーブル、そして重要なテーブルの _bkp、_old、_v2、_tmp、stg_ のコピーが15個あります。5つ目は銀行です。3つの粒度の台帳、取引・ポジション・決済、日次テーブルと指定日時点のビューの両方を備えた為替、融資、そしてほとんどの呼び出し元が決して見てはならない KYC および AML テーブルが含まれます。6つ目は IoT フリートです。生データ・1分単位・1時間単位の粒度の読み取りデータ、月別のパーティションテーブルが6つ、3つのテーブルにまたがるアラームのライフサイクルが含まれます。6つとも架空のものです。このリポジトリには、実在するスキーマは一切ありません。
50%の行が正直な結果です。これを採用する前に読んでください。
50%の行と、その対処方法
デフォルトの埋め込みモデルが照合するのは意味ではなくサブワードです。「品切れになりそうなもの」と尋ねても、v_stock_shortfall は見つかりません。2つの文字列に共通点がないからです。一方、stock_shortfall について尋ねれば、非常に優れた結果を返します。
ユーザーが識別子のような形式で質問するなら、これで十分で、API キーも必要ありません。人が話すような言葉で質問するなら、カタログの説明を追加してください。方法は2つありますが、どちらも必須ではありません。
環境変数に API キーがあれば、指定しなくても自動で説明が追加されます。 質問に回答するすべての経路、つまり schemagate select、--answer、MCP サーバー、Studio の接続では、まずカタログを説明し、その結果を接続ごとに ~/.schemagate/descriptions/ にキャッシュします。オブジェクトの構造が変わった場合にのみ、説明を作り直します。自分で書いたヒントや、内容のあるデータベースコメントが上書きされることはありません。一方、スキーマの定型文でオブジェクト名を言い換えているだけのコメントは、含まれるすべての単語の効果を薄めていたため、置き換えられます。1,200オブジェクトのスキーマでの測定では、複雑な8つの質問のうち、実行可能な SQL を生成できる数は6件から8件に増えます。SCHEMAGATE_AUTO_DESCRIBE=0 で無効にできます。キーが設定されていなければ、API は呼び出されず、何も変更されません。
API キーがない場合
すでに使っている任意のチャットウィンドウ(ChatGPT、Gemini、Copilot、ローカルモデル)で説明を作成できます。schemagate がプロンプトを用意し、その回答を取り込みます。
schemagate describe --url postgresql://localhost/app --out prompt.txt
# paste prompt.txt into a chat; save its JSON reply as reply.json
schemagate describe --url postgresql://localhost/app --apply reply.json --config catalog.json
schemagate select   --url postgresql://localhost/app "things we're running out of" --config catalog.json
プロンプトに含まれるのはメタデータのみです。名前、型、コメント、外部キーが対象で、行データは含まれません。また、1回貼り付けるだけで、説明のないオブジェクトをすべて処理できます。回答は catalog.json の describe ブロックに保存され、restrict ブロックや hint ブロックと並びます。select、studio、MCP サーバー(SCHEMAGATE_CATALOG_CONFIG)はすべてこの内容を読み込みます。Python からも同じ方法で利用できます。cat.describe_prompt() と cat.describe({"v_stock_shortfall": "Items below their reorder level."}) を使います。
ローカルモデルを使う場合(キー不要)
pip install 'schemagate[huggingface]'
schemagate describe --url postgresql://localhost/app                     --provider local --model Qwen/Qwen2.5-1.5B-Instruct                     --cache .schemagate-cache.json
または、Studio で Settings → Model → Local (transformers) を選択します。キーを入力するフィールドは表示されません。キーは必要ないためです。
from schemagate.ai import SchemaDescriber, LocalProvider
cat.describe(SchemaDescriber(LocalProvider(), cache_path=".schemagate-cache.json"))
テーブルごとに1文を書く程度なら、1.5Bモデルでも十分な品質で対応できます。複数テーブルにまたがる SQL の作成には不十分ですが、Studio はどちらにも同じプロバイダーを使用します。そのため、キーがある場合はカタログの作成にはローカルモデルを使い、回答にはキーを使ってください。有効にする前にdocs/local-models.mdをお読みください。2つのダウンロード、一度だけ必要なロードの待ち時間、約3 GBの RAM、2回目以降は無料で使えるキャッシュ、そして弱いモデルによる不適切な説明が、説明対象のオブジェクトを埋もれさせなくなった理由について説明しています。
独自のキーを使う場合
from schemagate.ai import SchemaDescriber, AnthropicProvider

cat.describe(SchemaDescriber(AnthropicProvider(model="claude-sonnet-4-5"),
                             cache_path=".schemagate-cache.json"))
モデルがテーブルごとに1文を書き、ほかのスキーマテキストと同様にインデックス化します。付属のスキーマでは、識別子形式の質問の精度を変えずに、ビジネス用語を使った質問の正解率が50%から100%に上がります。
Anthropic、OpenAI、Gemini に対応しています。それ以外は CallableProvider 経由で利用できます。これは、ベンダーが SDK を変更した際に、私からのリリースを待たずに対応するための手段でもあります。
from schemagate.ai import (AnthropicProvider, OpenAIProvider, GeminiProvider,
                      CallableProvider, auto_provider, available_providers)

AnthropicProvider(model="claude-sonnet-4-5")                    # ANTHROPIC_API_KEY
OpenAIProvider(model="gpt-4.1-mini")                            # OPENAI_API_KEY
GeminiProvider(model="gemini-2.5-flash")                        # GEMINI_API_KEY
OpenAIProvider(model="…", base_url="http://localhost:11434/v1") # anything local
CallableProvider(lambda system, prompt: my_llm(system, prompt))

available_providers()      # ['AnthropicProvider'] — names, never key values
auto_provider(model="…")   # picks whichever key is set
model は必須です。数か月ごとにモデル ID が変わるため、デフォルトのモデル ID は設定していません。ハードコードすると、修正前のバージョンをインストールしたすべてのユーザーに、いずれ404エラーが発生するからです。
有効にする前に知っておいてほしいことが3つあります。
ネットワーク外に送信される情報。 テーブル名、列名、型、NULL 許容性、既存のコメント、外部キーです。データの行は1行も送信されません。ObjectDoc にはデータの行を保持できるフィールドがなく、どちらの点もテストで検証しています。describe() を呼び出さない限り、何も送信されません。
費用。 説明のないオブジェクトごとに、短い呼び出しを一度だけ行います。データベースのコメントやヒントがすでにあるオブジェクトは、デフォルトではスキップされます。結果は内容に基づいてキャッシュされるため、再実行は無料で、変更されたテーブルだけが再説明されます。費用が発生する前に確認するには、次のようにします。
describer.estimate_calls(docs)   # calls describe() would actually bill for
describer.preview(doc)           # the exact text that would be sent
失敗した場合の動作。 そのオブジェクトはスキップされ、カタログ作成は続行されます。見逃された項目は describer.failures に一覧表示されます。例外を発生させたい場合は strict=True を渡してください。手動で記述した hint() は常に生成された説明より優先されるため、不適切な説明を修正しても費用はかかりません。
エンベッダーが自動で選択されます
pip install schemagate では、ハッシュ化 n-gram ベクトライザーが使われます。オフラインで即座に動作し、どのマシンでもバイト単位で同一の結果になります。schemagate[huggingface] をインストールすると、代わりに文埋め込みモデルが自動的に使われます。フラグもベンチマークも不要で、選択する必要もありません。説明を付けずに、付属の6つのスキーマと98の質問で測定した結果は次のとおりです。
| recall@6 | |
|---|---|
| ハッシュ化 n-gram(基本インストール) | 90/98 |
all-MiniLM-L6-v2([huggingface]) | 93/98 |
改善が集中しているのは、ハッシュ化エンベッダーの弱点として記載されている部分、つまり人が話すような言い回しの質問です。その種類の質問を含むコマースのスキーマでは、15/18から18/18に向上します。
デフォルトにしていないのは、依存関係が1つ増えて torch が必要になり、同じテキストからどこでも同じベクトルが得られるという保証も失われるためです。以前のインデックスを再現する必要がある場合は、SCHEMAGATE_AUTO_EMBEDDER=0 を設定すると、ハッシュ化エンベッダーが使われます。
ホスト型エンベッダーに切り替えることもできますが、識別子が多いスキーマテキストでは、オフラインのものでも同等に優れていることが多く、クエリごとの費用もかかりません。
from schemagate.ai import APIEmbedder, OpenAIProvider

provider = OpenAIProvider(model="gpt-4.1-mini",
                          embed_model="text-embedding-3-small")
cat = Catalog(embedder=APIEmbedder(provider, dim=1536))
あなたの組織で使われる用語:用語集
質問によっては、どの識別子とも関連せず、説明やモデルでも確実につなげられないことがあります。「買い物客に返金したお金」は billing_credit_note です。
アクセスルールと同じ catalog.json に、一度だけ記述します。
{"terms": {"gave back": "billing_credit_note",
           "revenue": ["billing_invoice", "v_monthly_revenue"]}}
または、Python で cat.term("gave back", "billing_credit_note") と指定します。用語はフレーズとして照合され、複数形は同一視されます。また、最も具体的な用語だけが適用されます(「take things offline」は「offline」より優先されます)。これは質問時に適用されるため、再インデックスは不要です。また、アクセス範囲が広がることもありません。呼び出し元が読み取りを許可されていないテーブルの用語は、その呼び出し元には何の効果もありません。存在しないオブジェクトを指定する用語は、何もせずに無視されるのではなく、エラーになります。
58件のビジネス用語の質問を、同梱されている6つのスキーマで評価した結果(tests/run_terms_repair.py)から、この機能の目的を説明します。回答できなかった質問はすべて、その質問から取り出した短い用語を1つ追加するだけで解決し、ほかの質問に悪影響はありませんでした。ベース埋め込みモデルでは23件中23件、MiniLMでは11件中11件です。一方、事前にテーブル名だけをもとに作成した用語集では、保留中の質問に対する結果はほとんど改善しませんでした(ベース埋め込みモデルで26件中18件から19件、MiniLMでは26件中21件のまま。tests/run_terms_eval.py)。人々が使う言葉を予測するのは難しいためです。回答できなかった質問を見つけたら、その質問に合わせて用語を追加してください。
オントロジーの全体像:概念、ルール、階層
用語集の用語は、最もシンプルな概念です。完全な形式では、用語の意味を正確に示すため、モデルはもっともらしいだけの SQL ではなく、正しい SQL を記述できます。
{"ontology": {"concepts": {
  "revenue":  {"synonyms": ["turnover", "sales"],
               "maps": ["billing_invoice.total_net"],
               "filter": "billing_invoice.status = 'issued'",
               "definition": "Issued invoices only; drafts and void excluded.",
               "broader": ["money in"]},
  "money in": {"maps": ["v_monthly_revenue"]}}}}
概念名またはその同義語を使った質問では、その概念のオブジェクトが取り込まれ、意味は DDL の上に記述されます。
-- What the business terms in this question mean:
-- revenue (also: turnover, sales): main.billing_invoice.total_net; only where billing_invoice.status = 'issued'. ...
1 段階離れた概念(broader、またはより狭い概念)は、より弱いシグナルを追加します。名前を挙げたすべてを参照できない可能性のある呼び出し元には、意味を示す行を省略します。つまり、マッピング先のテーブルとカラム、およびルールや定義で言及されているテーブルやカラムです。そのため、概念が非表示の名前をプロンプトに再び持ち込むことはありません。
語彙の出どころ:
schemagate ontology import semantic_manifest.json --from dbt       --url ... --config catalog.json --save
schemagate ontology import model.yaml            --from snowflake --url ... --config catalog.json --save
schemagate ontology import glossary.csv          --from csv       --url ... --config catalog.json --save
schemagate ontology suggest history.jsonl        --url ... --config catalog.json         # review, then --save
schemagate ontology check                        --url ... --config catalog.json
suggest は、人々が尋ねた質問と、それに答えた SQL から概念を学習します(--memory は schemagate 独自のクエリメモリを読み込みます)。Collibra と Microsoft Purview のエクスポートから取得した CSV ヘッダーも、そのまま使用できます。
精度への影響を測定。
| 設定 | なし | あり | |
|---|---|---|---|
履歴から学習した概念(benchmarks/learn_concepts.py) | Spider dev、166 データベースをプール(876 テーブル)。各データベースの質問の半分から学習し、残り半分で評価:正解テーブルがすべて上位 5 件に入った割合 | 73.3% | 82.8%(+49 / −0、p<0.0001;MiniLM 79.1% → 85.9%) |
完全な用語集(benchmarks/bird_ontology.py、arm D) | BIRD dev、根拠を与えずに尋ねた 201 件の保留質問、実行精度、Claude Sonnet 5 | 44.8% | 54.7%(+28 / −8、p=0.001) |
定義を仕込んだテスト(benchmarks/planted_definitions.py) | 明白な解釈が誤りとなる 8 つの業務用語を仕込んだ SQLite(割引、返金、社内 SKU を差し引いた純売上;古いフラグではなく最近の注文に基づく「アクティブ」;30 日の猶予期間を設けた解約)、定義から回答を計算した 21 件の質問、実行精度、Claude Sonnet 5 | 4.8% | 71.4%(+14 / −0、p=0.0001);定義が引用先の用語も取り込む場合は 100%(21/21、+6 / −0) |
BIRD の規模感を示すと、各質問に固有の根拠を貼り付ける(BIRD の通常の設定)と 61.2% です。つまりオントロジーは、質問ごとに根拠を入力しなくても、その向上分の約 60% を実現します。これを使わない場合、同一条件で 2 回実行しても回答は 18 件異なります。効果が確認できなかった結果もあります。別の質問の根拠から構築した概念では 44.8% に対して 46.8% でしたが、これはそのばらつきの範囲内です。BIRD の根拠は、ほとんどが再利用されることの少ない一度限りの数式だからです。オントロジーは、実際に保持している定義に対して効果を発揮します。
レビューで提案された定義仕込みテストでは、最初に定義を記述し、期待されるすべての回答をその定義から計算するため、SQL が正しいかどうかを測定できます。テーブルが正しかったかどうかを測るものではありません。用語集なしで再実行したところ、回答に変化はありませんでした。用語集が最初に取りこぼした 6 件の質問には、共通のパターンがありました。「パートナー売上はパートナー注文の売上」というように、別の用語を通して定義された用語では、その用語自体は検索できても、それが依存する用語は検索できなかったため、モデルは売上の意味を推測していました。用語集なしでは回答を控えていた 4 件の質問でも、モデルは自信を持って推測していました。現在は、一致した概念が、その定義またはフィルターで引用されている概念も取り込みます(Ontology.with_cited が 3 段階先まで追跡し、各段階で可視性を適用)。同じ実行で 21/21 のスコアを達成しました。従属する用語が参照するビューに売上をコンパイルし、総額カラムも引き続きクエリ可能にした場合のスコアは 19/21 でした。また、誤答の 2 件はいずれも売上に関するものではありませんでした。差が生じたのは検索であり、モデルが与えられた定義を再導出したためではありません。
スキーマグラフを介した結合パス補完は測定しましたが、実装していません。Spider では、top_k=5 における 266 件の失敗のうち、ブリッジテーブルの欠落が原因なのはわずか 2 件です。外部キーの展開によって、ブリッジテーブルはすでに取り込まれているためです(benchmarks/join_paths.py)。
実際に使っている接続情報で接続する
多くの人は SQLAlchemy の URL を持っていません。ウォレットの zip ファイルや、設定ファイルにある JDBC 文字列、あるいはホストとポートを使っています。schemagate.connect は、そのどれからでも SQLAlchemy が必要とする 2 つの情報を用意します。
from sqlalchemy import create_engine
from schemagate import Catalog
from schemagate.connect import resolve

url, connect_args = resolve("jdbc:oracle:thin:@//host:1521/ORCLPDB1")
cat = Catalog().bootstrap(create_engine(url, connect_args=connect_args))
connect_args は省略できません。Autonomous Database には、名前に値する URL がありません。ウォレットのディレクトリ、ウォレットのパスワード、TNS エイリアスを 1 つの URL に格納する場所がないため、URL は oracle+oracledb://@ になり、接続情報はそれと別に渡されます。
url, connect_args = resolve({
    "kind": "wallet",
    "wallet": "~/Downloads/Wallet_mydb.zip",   # the zip as downloaded
    "alias": "mydb_high",
    "user": "ADMIN", "password": "...",
})
zip ファイルはその隣に展開されます。ドライバーは再接続のたびに読み込み直すためです。一時ディレクトリを使うと、接続は一度しか成功しません。
Studio でも同じことができます。辞書の代わりにドロップダウンを使います。
pip install "schemagate[all]"          # every driver, the model SDKs, MCP
schemagate
Oracle Cloud では OCI SDK を追加すると、API キーなしで OCI Generative AI を通じてカタログを作成できます。
pip install "schemagate[all,oci]"
別の項目としているのは、サイズが大きく異なるためです。OCI SDK は 488 MB、17,505 モジュールで、その他すべてを合わせた 217 MB を上回ります。
| 用意しているもの | 選ぶ項目 |
|---|---|
postgresql+psycopg://... | SQLAlchemy URL |
jdbc:oracle:thin:@//host:1521/SVC | JDBC URL |
Wallet_mydb.zip + mydb_high | Oracle ウォレット |
| ホスト、ポート、データベース | 名前でエンジンを指定 |
接続すると、Studio に同じ接続を再現するコマンドが表示されます。schemagate select ... --url ... の行と Python での同等のコードが表示され、パスワードは実際の値ではなく $DB_PASSWORD になります。ページ上で試してから、コマンドを取得してください。
localhost では、ページにアクセスできる人は、すでにそのマシンのシェルを使えるため、接続機能はそのまま使えます。Studio を別のアドレスで配信する場合は --allow-connect が必要です。ネットワーク上の誰もが使える URL 入力欄になり、サーバーからしか見えないホストへの接続を指示できるためです。--no-connect を指定すると、どこでも接続機能が無効になります。接続に失敗した場合は例外の型だけが報告され、その他の情報は表示されません。ドライバーのエラーには指定された URL が引用され、その URL にはパスワードが含まれるためです。
1 つの列を制限し、既存の ACL を読み取る
オブジェクトレベルのルールでは、よくあるケースに対応できません。テーブル自体は適切でも、その中の 1 つの列は適切ではないケースです。
from schemagate import Catalog, Principal

cat = Catalog().bootstrap("postgresql+psycopg://user:pw@host/db")
cat.restrict_column("employee", "salary", ["payroll"])
cat.index()

analyst = Principal("okta:jdoe")
print(cat.select("who reports to whom", principal=analyst).prompt_fragment())
その断片では salary は表示されません。REDACTED になったり、名前が変更されたりするわけではありません。列名そのものが情報開示になります。列の存在を知っているモデルは、その列について質問したり、その列を結合に使ったり、説明の中で言及したりできます。非表示にした列を指定する -- FK 行も削除されます。残しておくと、その識別子がそのまま再び表示されてしまうためです。
何を誰に表示したか
sel = cat.select("who reports to whom", principal=analyst)
sel.to_dict()
# {'question': 'who reports to whom',
#  'principal': 'okta:jdoe', 'roles': [], 'total_objects': 219,
#  'hits': [{'object': 'hr.employee', 'kind': 'TABLE', 'score': 0.031,
#            'reason': 'hybrid', 'columns_shown': 3, 'columns_withheld': 1}]}
これは、監査担当者が後から求める記録であり、後から再構築できない唯一の情報です。カタログもロールも変更され、質問内容も失われてしまうためです。記録には非表示にした列の数が含まれますが、列名は含まれません。非表示にした内容を列挙するログは、そのログを読める全員に情報を開示してしまいます。
GRANT から可視性を導出する
テーブルが40個なら、手書きの restrict マップで問題ありません。400個になると、データベースにすでに存在する ACL のコピーがもう1つでき、2つのコピーに食い違いが生じます。
schemagate select "what do we pay our doctors" \
  --url "postgresql+psycopg://user:pw@host/db" --restrict-from-grants
from schemagate.grants import restrict_from_grants
report = restrict_from_grants(cat, engine, report=True)
# then the half grants cannot see: objects under a row-level policy are
# flagged in the prompt, probed per role on PostgreSQL, and the views that
# bypass the policy are named -- docs/row-level-security.md
from schemagate.rls import restrict_from_policies
print(restrict_from_policies(cat, engine, report=True))
print(report)
# postgresql: 629 object(s) seen, 218 restricted, 1 public, 0 unmatched, 1 role(s) expanded
PostgreSQL と Oracle に対応しています。ネストされたロールは推移的に展開されるため、グループが、付与されたロールを継承する別のロールに対応しているユーザーも、そのオブジェクトにアクセスできます。GRANT の行がないオブジェクトは変更せず、report.objects_unmatched に記録します。何も表示されないことは拒否を意味しません。すべての情報を参照できない接続で初めて動作したとき、存在しないことを理由にアクセスを制限すると、正常に機能しているカタログを壊してしまいます。
GRANT を読み取るため、行レベルポリシーは検出できません。 Oracle 26ai での測定では、Virtual Private Database ポリシーによって行が1つも許可されない呼び出し元でも、ALL_TAB_PRIVS では SELECT 権限を保持し、ALL_TABLES にも表示され、すべての列とともにモデルに提示されます。情報が漏れることはありません。ポリシーはデータベースによって適用されます。ただし、プロンプトには、呼び出し元が1行も取得できないテーブル名が含まれます。docs/row-level-security.md には、測定結果、現時点での対処方法、修正内容を記載しています。
呼び出し元のロールの取得元
GRANT からは、どのロールがオブジェクトを参照できるかがわかります。もう一方の要素、つまりこの呼び出し元が保持するロールについては、これまでは呼び出し元の申告内容に任されていました。これは、独自のデータベースを使うデスクトップクライアントなら問題ありませんが、ホスト型サーバーでは確認がまったく行われません。カタログ設定の groups ブロックを使うと、すでに情報が保存されている場所からロールを読み取れます。そのため、クライアントが送信するロールは無視されます。
{"groups": {"sources": [
   {"type": "entra", "tenant": "contoso.onmicrosoft.com",
    "client_id": "…", "client_secret": "${ENTRA_CLIENT_SECRET}"},
   {"type": "native"}],
  "map": {"Payroll Team": "payroll"}}}
ソースは5種類あります。entra(Graph 経由の Microsoft Entra ID。推移的なグループメンバーシップに対応し、ID と表示名の両方を扱います)、native(データベース独自のロールグラフ。restrict_from_grants が読み取るものと同じビューを使い、ユーザーから上方向にたどるため、2段階の GRANT チェーンも解決できます)、sql(メンバーシップテーブル。バインドする :subject は1つです)、http(グループを JSON で返す任意のエンドポイント)、static(ファイル内のマッピング)です。各ソースが応答するのは、それぞれが扱うサブジェクトの名前空間だけです。結果は和集合になり、map でグループ ID をロール名に変換します。応答は ttl 秒間キャッシュされます。
応答できないソースがあった場合、それは匿名での選択として扱われず、その呼び出し元にエラーが返されます。「グループがない」と「問い合わせできなかった」は異なる応答であり、安全に判断材料にできるのは前者だけです。PostgreSQL 16、MySQL 8.4、Oracle Autonomous Database 26ai で実環境での動作を検証済みです。リゾルバーと GRANT によって制限されたカタログは、has_table_privilege および実際の SELECT の結果と一致します。docs/groups.md には、このブロック、各ソース、テスト内容を記載しています。
データベース
リフレクションには、SQLAlchemy の方言に依存しない Inspector のみを使用します。schemagate.introspect に手書きの SQL はなく、もし含まれていればテストでビルドが失敗するため、原理上は SQLAlchemy がサポートするどの方言でも動作します。
原理上動作することは証拠にならないため、スクリプトを用意しています。
python scripts/certify_dialect.py 'postgresql+psycopg://user:pw@host/db'
python scripts/certify_dialect.py 'oracle+oracledb://user:pw@host:1521/?service_name=FREEPDB1'
python scripts/certify_dialect.py 'mssql+pyodbc://user:pw@host/db?driver=ODBC+Driver+18+for+SQL+Server'
python scripts/certify_dialect.py 'mysql+pymysql://user:pw@host/db'
このスクリプトは schemagate_cert_ テーブルを3つ作成し、リフレクションを行い、選択と ID に基づくスコープ設定をエンドツーエンドで実行してから、テーブルを削除します。何か失敗すると、ゼロ以外の終了コードを返します。スクラッチスキーマを指定して実行してください。
| SQLite | 認定済み、10/10、CI で実行 |
| PostgreSQL | 認定済み、PostgreSQL 16 で 10/10 に加え、260 オブジェクトの全スイートを実行 |
| Oracle | Oracle AI Database 26ai(Autonomous Database)で実機認定済み、2026年9月:認定スクリプト 10/10、ネイティブ VECTOR(512, FLOAT32) ストアの適合性スイート、および方言スイートを実行。また、約700万行を含む127オブジェクト、3ドメインのスキーマでストレステストを実施 |
| SQL Server | SQL Server 2022(16.0.4295.3)で実機認定済み、10/10、プッシュのたびに CI で実行(サービスコンテナーに対して実行)、さらにエイリアス型、hierarchyid/sql_variant、および max_length がバイト単位であることを対象とする13件の実機方言テストを実施 |
| MySQL / MariaDB | MySQL 8.4.11 で実機認定済み、10/10、プッシュのたびに CI で実行(サービスコンテナーに対して実行)。さらに、3種類すべての権限レベル、ロールグラフ、および MySQL が報告できないロールのみの盲点を対象とする GRANT リーダースイートを実施。MariaDB では未実行 |
上記の各行は、いずれも実際のデータベースで確認済みです。まだ明言しておく価値があるのは、MariaDB については実行せず、MySQL から推測しているという点です。スクリプトを MariaDB に対して実行して、結果を教えてください。
同じチェックは、URL を環境変数に設定すれば pytest でも実行できます。方言の正式認定には、この方法で CI を実行します。
export SCHEMAGATE_POSTGRES_URL='postgresql+psycopg://…'
export SCHEMAGATE_ORACLE_URL='oracle+oracledb://…'
export SCHEMAGATE_MSSQL_URL='mssql+pyodbc://…'
export SCHEMAGATE_MYSQL_URL='mysql+pymysql://…'
pytest tests/test_dialects.py -v
エージェントからの使用
MCP サーバーは、渡された ID を信頼します。
principalとrolesはクライアントから渡され、認証されません。トークンも セッションもありません。トランスポートにアクセスできる人なら誰でも ロールを名乗り、そのロールで読み取り可能なデータを読めます。また、run_queryは行を返すため、これはスキーマだけでなく、実データも対象です。 stdio(呼び出し元が自分のデスクトップクライアント)経由で実行するか、 ユーザーを認証し、そのユーザーのprincipalを設定する仕組みの背後で HTTP 経由に実行してください。これはスコープ設定の仕組みであり、ロック ではありません。SCHEMAGATE_CATALOG_CONFIGにgroupsブロックを 設定すると、クライアントが ロール を名乗ることはできなくなります。 ロールはディレクトリまたはデータベースから取得され、リクエスト内の ロールは無視されます(docs/groups.md)。ただし、 サブジェクトは引き続きトランスポートから渡されたものです。または、OAuth を有効にすればロックになります。
SCHEMAGATE_MCP_OAUTH_ISSUERとSCHEMAGATE_MCP_OAUTH_AUDIENCEを設定すると、HTTP 経由のすべての リクエストに、ID プロバイダー(Entra ID、Okta、Auth0、Keycloak)が署名した トークンが必要になります。リクエストしたユーザーと、そのユーザーが持つ ロールはクライアントからではなく、常にそのトークンから取得されます。 ゲートウェイは不要です(docs/oauth.md)。
SQL を書くエージェントをすでにお持ちなら、ライブラリをコードに組み込むよりも、schemagate をツールとして呼び出させるのが最も手早い方法です。
MCP。 Cursor、Windsurf、Zed など、Model Context Protocol に対応するもの:
1行で設定でき、事前のインストールは不要です(uv が必要です)。demo は同梱のサンプルスキーマなので、接続先を指定する前でも動作します。
uvx --from "schemagate[mcp]" schemagate-mcp --url demo
Claude Code:
claude mcp add schemagate -- uvx --from "schemagate[mcp]" schemagate-mcp --url demo
ほかのクライアント(Claude Desktop、Cursor、Windsurf、Zed)をデータベースと接続する場合は、mcp の隣にデータベース用のドライバー追加パッケージを指定してください:postgres、mysql、mssql、または oracle(SQLite では不要です)。
{"mcpServers": {"schemagate": {
  "command": "uvx", "args": ["--from", "schemagate[mcp,postgres]", "schemagate-mcp"],
  "env": {"SCHEMAGATE_DATABASE_URL": "postgresql+psycopg://user:password@localhost/app"}}}}
パスワードを含む URL は、上記のように --url ではなく env に設定してください。コマンドの引数は、マシン上のすべてのプロセスから見えるためです。uv を使わない場合は、pip install 'schemagate[mcp,postgres]' を実行してから、schemagate-mcp を起動してください(python -m schemagate.mcp_server も引き続き使用できます)。
すべて読み取り専用の7つのツールです。select_schema(質問に必要なDDLを、呼び出し元の権限範囲で返します)、list_objects(呼び出し元に見えるオブジェクトを返します)、describe_object(1つのオブジェクトの完全なDDLを返します)、run_query(単一の読み取りクエリを実行します。呼び出し元に見えないオブジェクトが指定されている場合は拒否します)、answer、refresh_catalog、healthです。これらはprincipalとrolesを受け取ります。クライアントがこれらを省略した場合、呼び出し元は匿名として扱われ、制限のないオブジェクトだけが見えます。制限されたオブジェクトと存在しないオブジェクトは同じエラーを返すため、オブジェクトの存在が漏れることはありません。
すべての判断が記録されます。 これらのツールとrun_queryおよびanswerの各呼び出しについて、日時、ロールとともにどのプリンシパルが何を尋ね、何を提示されたか、保留されたオブジェクトと列の数、実行されたSQLと返された行数、呼び出しが拒否されたかどうかとその理由を1行に記録します。行データ、保留されたものの名前、データベースURLは決して記録しません。記録はメモリ内(直近500件。件数はhealthに表示)に保持されます。SCHEMAGATE_AUDIT_LOG=<path>を設定するか、=1を設定して~/.schemagate/audit.jsonlを指定すると、ファイルへの記録が有効になります。何も保存しないとうたうツールが、独断でファイルへの書き込みを始めることはありません。ログはファイルから運用者が確認するものであり、意図的にツールにはしていません。「最近の判断」をどのクライアントにも渡せるようにすると、ある呼び出し元の質問がすべて他の呼び出し元に渡ってしまうからです。
そして、その記録は何年後でも検証できます。 署名を有効にすると、各記録は直前の記録とチェーンでつながれ、NISTの耐量子署名標準(FIPS 204)であるML-DSA-65で署名されます。記録の編集、削除、挿入、並べ替えが行われると、schemagate audit verifyが行番号と理由を示して検出します。監査ログは何年も保管されるため、今日のRSAやECDSAの署名が将来偽造可能になるほどの時間に備えて、耐量子方式を採用しています。「このユーザーに対してモデルに給与テーブルが一度も表示されていないことを証明できますか?」という監査人の質問に対し、公開鍵を持つ人なら誰でも実行できる検証手段で答えられます。
pip install "schemagate[pq]"                       # PyCA cryptography >= 48 (OpenSSL)
schemagate audit keygen --out ./keys               # private key stays with the server
SCHEMAGATE_AUDIT_LOG=1 SCHEMAGATE_AUDIT_SIGNING_KEY=./keys/audit-signing-key.pem \
  python -m schemagate.mcp_server
schemagate audit verify ~/.schemagate/audit.jsonl --public-key ./keys/audit-signing-key.pub.pem
# OK  1204 signed records (ML-DSA-65), seq 0..1203, no edits, gaps or reordering
schemagate audit head ~/.schemagate/audit.jsonl     # keep this SEQ:HASH elsewhere
この機能が保証しないこともあります。ファイルに書き込める人は、最新の記録を削除できます。短くなったチェーンも有効なチェーンだからです。headを別の場所(チケットや別のシステムなど)に保管しておけば、ログがその位置に達していない場合、verify --head SEQ:HASHは失敗します。署名は暗号化ではありません。ログは以前と同じように読み取り可能であり、行データや保留されたものの名前も引き続き含まれません。証明されるのはschemagateが下した判断であり、その正しさは与えられたロールの正しさに左右されます。1つのサーバープロセスが1つのログを書き込みます。設定された鍵を読み込めない場合は、署名なしの証拠を書き込むのではなく、サーバーの起動を停止します。
実行されたSQLから学習します。 answerが実行可能なクエリを生成すると、その質問とクエリが記憶されます。行は決して記憶されません。次に似た質問が来ると、そのクエリが読み取ったテーブルが選択対象に固定され、DDLと質問の間に、実例としてそのペアがモデルに提示されます。どちらも呼び出し元から見える範囲を広げることはありません。固定されたテーブルも他の固定対象と同じ可視性チェックを受け、例はそこに記載されたすべてのテーブルがその呼び出し元に見える場合にのみ提示されます。保存されたクエリは、取り込み時と取り出し時の両方で読み取り専用として再チェックされます。SCHEMAGATE_MEMORY=<path>を設定するか、=1を設定して~/.schemagate/memory/<db>.jsonlを指定しない限り、メモリ内だけに保持されます。何も記憶されていない場合、プロンプトはこの機能が追加される前とバイト単位で同一です。CLIでは--memoryを指定し、Studioでは接続時に使用します。類似性判定にはカタログ独自のエンベッダーを使います。決定的でオフライン動作し、「似ている」という判定は弱いものです。意味ではなく表現の一致を見ますが、例はあくまで参考であり、固定対象にもゲートがあるため、これで問題ありません。
SCHEMAGATE_DATABASE_URL=demoを設定すると、同梱のスキーマを提供します。
SCHEMAGATE_VALUES=1はサーバーの--valuesに相当します。起動時に、短く個人情報を含まない列の一意な値を読み取り、モデルが'Card'ではなく'CARD'と書けるようにします。行を読み取るため、この設定は明示的に有効にしない限りオフです。SCHEMAGATE_VALUES_BUDGETで秒数の上限を設定できます(デフォルトは30です。大規模なスキーマを低速な接続先から読み込む場合は値を大きくしてください)。
1 台のデスクトップではなく、チーム向けにホストするには:
SCHEMAGATE_MCP_TRANSPORT=streamable-http SCHEMAGATE_MCP_PORT=8765 python -m schemagate.mcp_server
その前段に ID プロバイダーを配置すると、各ユーザー自身のトークンによって閲覧範囲が決まります。
SCHEMAGATE_MCP_OAUTH_ISSUER=https://login.microsoftonline.com/<tenant>/v2.0 \
SCHEMAGATE_MCP_OAUTH_AUDIENCE=api://schemagate \
SCHEMAGATE_MCP_OAUTH_RESOURCE=https://schemagate.example.com/mcp \
SCHEMAGATE_MCP_TRANSPORT=streamable-http SCHEMAGATE_MCP_HOST=0.0.0.0 python -m schemagate.mcp_server
サーバーが停止しないように設計されています。インデックスは起動後、メモリ上に保持されるため、データベースが停止してもサーバーは巻き添えで停止しません。select_schema は最後に正常に取得できたリフレクションから応答し続け、refresh_catalog は例外を発生させずに障害を報告します。
権限情報はどの程度古くてもよいですか? サーバーはカタログを構築するときに権限情報を読み込みます。設定ファイルの制限に加え、SCHEMAGATE_RESTRICT_FROM_GRANTS=1 の場合はデータベース自身の GRANT も読み込みます。デフォルトでは、refresh_catalog が呼び出されるまでこのカタログが使用されるため、データベースでの REVOKE がサーバーに反映されるのはそのときです。SCHEMAGATE_CATALOG_MAX_AGE=300 を設定すると、5 分より古いカタログは使用前に再読み込みされます。GRANT または REVOKE は次の呼び出し時ではなく、その時間内に反映されます。再読み込みに失敗した場合、サーバーは古い権限情報で応答し続けることはありません。再読み込みが成功するまで、select_schema、list_objects、describe_object、run_query、answer は「permissions are stale」というエラーを返します(再試行は最大 5 秒間隔です)。また、health は catalog_stale とその理由を示します。groups リゾルバーから取得する呼び出し元のロールには、独自の有効期限である ttl があります。すべてのツールはあらゆる例外を捕捉し、{"error": ...} を返すため、不正なリクエストがほかのクライアントのセッションを終了させることはありません。health はロードバランサーに現在の状態を知らせます。あるテストでは、すべてのツールに 125 種類の不正な入力を送り、その後も正常なリクエストが機能することを確認します。別のテストでは、実際のクライアントを使って stdio 経由で同じ検証を行います。MCP SDK 1.x と 2.x の両方で動作します。2.0 での名称変更によって一度クリーンインストールが失敗しましたが、現在はそのためのシムとテストがあります。
LangChain。 適切な BaseRetriever を実装しているため、組み合わせて使えます。
pip install 'schemagate[langchain]'
from schemagate.integrations.langchain import SchemagateRetriever, prompt_fragment

retriever = SchemagateRetriever(catalog=cat, top_k=6,
                           principal=Principal("okta:jdoe", roles={"finance"}))
chain = retriever | RunnableLambda(prompt_fragment) | your_sql_prompt | llm
プリンシパルは意図的に構築時にバインドされます。呼び出し元ごとにリトリーバーを 1 つ構築してください。リトリーバーにすでに ID が設定されていれば、チェーン側で ID の受け渡しを忘れることはありません。
jev4pg。 schemagate.integrations.jev4pg.ScopedCatalog は、jev4pg のテナントごとのカタログをラップします。これにより、プランナー、SQL バリデーター、セマンティック演算子には、各呼び出し元が読み取りを許可された情報だけが見えるようになります。docs/jev4pg.md を参照してください。
テキストの内容について質問する場合。 semantic_query(MCP、デフォルトでは無効)は、同じスコープチェックの下で SQL を実行し、その後、条件に合致するテキストを持つ行をモデルに判定させるか、各行について簡潔な回答を 1 つずつ生成します。docs/semantic-operators.md を参照してください。
Oracle Cloud での利用
Oracle AI Database 26ai でのライブ運用が認定されています。利用方法は 2 通りあり、どちらも API キーは不要です。カタログ作成は独自の OCI ID を使って OCI Generative AI 上で実行されるため、プロンプト(スキーマメタデータのみで、行データは含みません)は自分のテナンシー内にとどまります。
Cloud Shell から約 1 分、VM は不要です:
pip install --user 'schemagate[oracle,oci]'
schemagate describe --url 'oracle+oracledb://@' --provider oci \
    --model google.gemini-2.5-pro --config catalog.json
または、チーム向けに常時稼働する MCP エンドポイントをワンクリックで作成できます:

これにより、自分のテナンシーでスタックが読み込まれた Resource Manager が開きます。Always Free の対象となる VM で、作成される Autonomous Database、または既存のデータベースに対して MCP サーバーが稼働します。詳細と Terraform については oci/ を参照してください。
ご自身のマシンから OCI Generative AI を利用する
すべての処理はご自身の OCI アイデンティティで実行され、料金はご自身のテナンシに請求されます。データベースには何もインストールされません。Select AI プロファイルも、SELECT を超える権限付与もありません。
pip install 'schemagate[oracle,oci,mcp]'
Windows では OCI SDK のファイルパスが非常に長くなります。短いパス(python -m venv C:\sg)にインストールするか、長いパスを有効にしてください。有効にしないと、pip は途中で失敗します。
サインインは通常の OCI と同じです。API キー(Console ›
Profile › API keys)を使った ~/.oci/config、または OCI 内で実行する場合はリソースプリンシパル/インスタンスプリンシパルを使います。
権限はグループに対するポリシーが 1 つだけです。動的グループは不要で、データベースへの設定もありません。
allow group <your-group> to use generative-ai-family in compartment <compartment>
| 変数 | |
|---|---|
OCI_COMPARTMENT_ID | OCI Generative AI を有効にします(他のキーが設定されていない場合に選択されるプロバイダーです) |
OCI_REGION | Generative AI のリージョン。例:us-chicago-1、us-phoenix-1 |
SCHEMAGATE_DESCRIBE_MODEL | 自動説明に使用するモデルです。OCI では必須です。モデル ID はリージョンによって異なるため、デフォルト値はありません |
お使いのリージョンでオンデマンド提供されているモデルを選んでください。 リージョンのカタログには、専用クラスターのみで利用できるモデルも掲載されています。そのモデルを呼び出すと、404 Entity with key <model> not found で失敗します。別のモデルを選んでください(2026 年 9 月の us-phoenix-1 では、google.gemini-2.5-flash がオンデマンドで利用できましたが、掲載されていた複数の Llama モデルと Cohere モデルは利用できませんでした)。モデルが正しくなくても MCP サーバーは起動しますが、説明の生成はスキップされるため、ログを確認してください。
Autonomous Database 上の MCP サーバーを、値と説明付きで設定する場合:
{"mcpServers": {"schemagate": {
  "command": "python", "args": ["-m", "schemagate.mcp_server"],
  "env": {
    "SCHEMAGATE_DATABASE_URL": "oracle+oracledb://@",
    "SCHEMAGATE_CONNECT_ARGS": "{\"config_dir\": \"C:/wallet\", \"wallet_location\": \"C:/wallet\", \"wallet_password\": \"...\", \"user\": \"APP\", \"password\": \"...\", \"dsn\": \"mydb_high\"}",
    "SCHEMAGATE_VALUES": "1",
    "SCHEMAGATE_VALUES_BUDGET": "120",
    "OCI_COMPARTMENT_ID": "ocid1.compartment.oc1..…",
    "OCI_REGION": "us-phoenix-1",
    "SCHEMAGATE_DESCRIBE_MODEL": "google.gemini-2.5-flash"
  }}}}
SCHEMAGATE_VALUES_BUDGET の単位は秒です。デフォルトの 30 秒では、ウォレット経由で接続した大規模なスキーマの値の読み取りが途中で打ち切られることがあります。SH や、すべての Autonomous Database に付属する SSB サンプルを含め、Oracle 管理スキーマは除外されます。そのため、カタログにはご自身が所有するスキーマ、または権限を付与されたスキーマが含まれます。CLI から --answer --provider oci --model <id> を指定すると、同じモデルで SQL を生成し、同じ接続を介して読み取り専用で実行します。
Oracle でインデックスを保持する
MemoryStore はプロセスを起動するたびに再構築されます。数百個程度のオブジェクトなら問題ありませんが、長時間稼働するサービスには適していません。OracleStore は Oracle 23ai のネイティブな VECTOR 型でベクトルを保持するため、最近傍検索をデータベース内で実行できます。
from schemagate.stores.oracle import OracleStore

store = OracleStore(dsn="user/pw@host:1521/FREEPDB1", dim=512)
store.create_schema()                       # idempotent

cat = Catalog(store=store).bootstrap("oracle+oracledb://…")
アプリケーションのプールを再利用するには、dsn= の代わりに connection= を渡してください。自ら開いていない接続を閉じることはありません。
スコープの適用は、検索結果が返された後のフィルタリングではなく、スコアリング対象のサブクエリ内の述語として行われます。呼び出し元が参照できない行は、順位付けされることもデータベースの外に出ることもありません。
上記と同じ注意点があります。26 件のテストで SQL、バインド型、スコープ述語を固定し、すべての文を独立した Oracle パーサーで検証していますが、まだ稼働中の 23ai インスタンスでは実行されていません。実行するには、次のようにします。
export SCHEMAGATE_ORACLE_DSN='user/password@host:1521/FREEPDB1'
pytest tests/test_store_conformance.py -v
Oracle Cloud の Always Free ATP で十分です。
注意が必要な点
アーカイブとステージングの類似テーブルは処理されますが、その仕組みを把握しておいてください。 ウェアハウスに
orders、orders_bkp、stg_orders がある場合、コピー側の文書には短い文章の中に元のテーブルと同じ名前の単語が含まれるため、コサイン類似度では短い文書が高く評価されやすくなります。そのままにしておくと、元のテーブルにヒントを付けても、3 列の _tmp のコピーが、コピー元の 25 列のテーブルより上位になります。実際にそうなるのを見ました。そのため、実在するオブジェクト名に _bkp、_old、_tmp、_v2、_archive などを付けた名前のオブジェクトや、先頭に stg_/tmp_ を付けたオブジェクトは、影響を受ける元のオブジェクトより下位にランク付けされます。対象のオブジェクトが存在する場合に限ります。たとえば、pricing がなく pricing_v2 だけがある場合は、そのままです。同じスキーマ内に限ります。また、コピーの名前を直接指定した場合は適用されません。fact_claim_line_v2 を指定すれば、fact_claim_line_v2 が返されます。リストは DEFAULT_SHADOW_SUFFIXES と DEFAULT_SHADOW_PREFIXES です。Catalog(...) に独自のリストを渡すか、空のタプルを渡して無効にできます。検出結果は cat.shadows() で確認できます。
識別子の長さ。 PostgreSQL は、作成時に名前を 63 バイトで切り詰めます。これはデータベース側の処理であり、schemagate 側ではどうにもできません。
英語以外のスキーマにも対応しており、中国語、日本語、韓国語を含みます。また、アクセント記号は双方向で同一視されるため、facturacion で検索すると facturación が見つかります。ただし、英語の質問ではスペイン語の名前が付いたテーブルは見つかりません。語彙的な検索では埋められない差です。説明文があれば見つけられます。
top_k は厳密な上限ではありません。 選択後に外部キーの展開が行われ、結合テーブルが追加されます。これは意図的な動作です。含まれていないテーブルを参照する SQL は実行できないためです。ただし、それに合わせてプロンプトの予算を確保してください。
ステータス
v1.0。パブリック API は安定しています。
この README に記載されている名前、つまり Catalog とそのメソッド、Principal、Selection、schemagate CLI とそのフラグ、MCP ツール名、カタログ設定ファイル、LangChain リトリーバーは、2.0 まで破壊的変更なしで引き続き利用できます。アンダースコアで始まるものはすべて内部仕様であり、どのリリースでも変更される可能性があります。
この保証の対象外となるものが 2 つあります。完了と記載されるまで、下表で未完了となっている項目です。もう 1 つはランキングです。検索機能はリリースごとに調整されるため、質問に対して返されるテーブルのセットは 1.x の各バージョンで変わることがあります。変わらないのは、重要な部分です。呼び出し元が読み取れないテーブルが結果に含まれることはありません。
| リフレクション | SQLite、PostgreSQL 16、Oracle 26ai、MySQL 8.4、SQL Server 2022 で認定済み |
MemoryStore | 完了 |
| AI カタログ化 | 完了。偽のプロバイダーを使い、オフラインでテスト済み |
| CLI | 完了 |
Studio(schemagate studio とホスト型デモ) | 完了。テストでは実際のブラウザーを使用 |
| MCP サーバー | 完了。実際の MCP クライアント経由でテスト済み |
| LangChain リトリーバー | 完了。langchain-core に対してテスト済み |
OracleStore | 実装済みで静的検証済み。実環境での実行が必要 |
| pgvector ストア | 未着手 |
import schemagate ではプロバイダー SDK は一切インポートされません。これを確認するテストもあります。
デフォルトの埋め込みは、プロセス、マシン、Python のバージョンが異なっても安定しているため、キャッシュまたは永続化されたベクトルをそのまま利用できます。これは、異なる PYTHONHASHSEED の値を設定した新しいサブプロセスで埋め込み器を実行するテストで保証しています。以前この点に問題があり、ほかの方法では検出できなかったためです。
Apache-2.0。Ashish Sinha。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。