veritasgraph について
VeritasGraph は、ツリー型ナビゲーションとナレッジグラフ推論を組み合わせた GraphRAG MCP サーバーおよびエージェントフレームワークです。根拠を追跡できる文書 Q&A と統制された処理向けで、ローカルまたはクラウドで動作し、根拠がない場合は回答を控えられます。
主な機能
- 01ツリー構造とナレッジグラフによる検索
- 02出典付きのマルチホップ Q&A
- 03根拠がない場合の明示的な回答保留
- 04ローカルまたはクラウドでの実行
- 05統制されたエージェントのオーケストレーションと追跡
- 06グラフとエージェント用 Studio ワークスペース
活用シーン
- 01文書を基にした出典付き Q&A の構築
- 02グラフ内の関係を複数段階で検索
- 03統制されたエージェントワークフローのローカル実行
- 04オーケストレーション過程とツール呼び出しの確認
MCP 対応
VeritasGraph は MCP サーバーの起動口を備え、`python -m veritasgraph_mcp` で実行できます。Studio にはローカル MCP プロキシコネクターも含まれます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx veritasgraph-mcpVERITASGRAPH_MODELDefault local Ollama model for ingest/query (e.g. qwen3:latest).OLLAMA_HOSTLocal Ollama endpoint.STUDIO_DATA_DIRDirectory where the knowledge-graph snapshot is persisted.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
5掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| text | string | はい | 取り込むドキュメントの全文。 |
| model | string | いいえ | 使用するローカル Ollama モデル(デフォルトは $VERITASGRAPH_MODEL)。 |
| title | string | いいえ | 人が読みやすいドキュメントタイトル。 |
詳細
VeritasGraph — ガバナンスに対応したオンプレミス向け GraphRAG & エージェントフレームワーク
無計画なチャンク分割はやめましょう。ツリー検索の構造とナレッジグラフの推論を組み合わせ、ガバナンスに対応した AI エージェントに組み込みます。100%ローカルまたはクラウドで動作します。



🎯 従来の RAG は類似性に基づいて推測します。VeritasGraph は構造に基づいて推論します。 文書を見つけるだけではなく、つながりを理解し、ガバナンスに対応したエージェントで活用しましょう。
🌐 サイトを見る · ⭐ スターを付ける · 🍴 フォークする · 💬 議論する · 🐛 バグを報告する
python -m veritasgraph_mcp # from repo root (needs local Ollama for ingest/query)
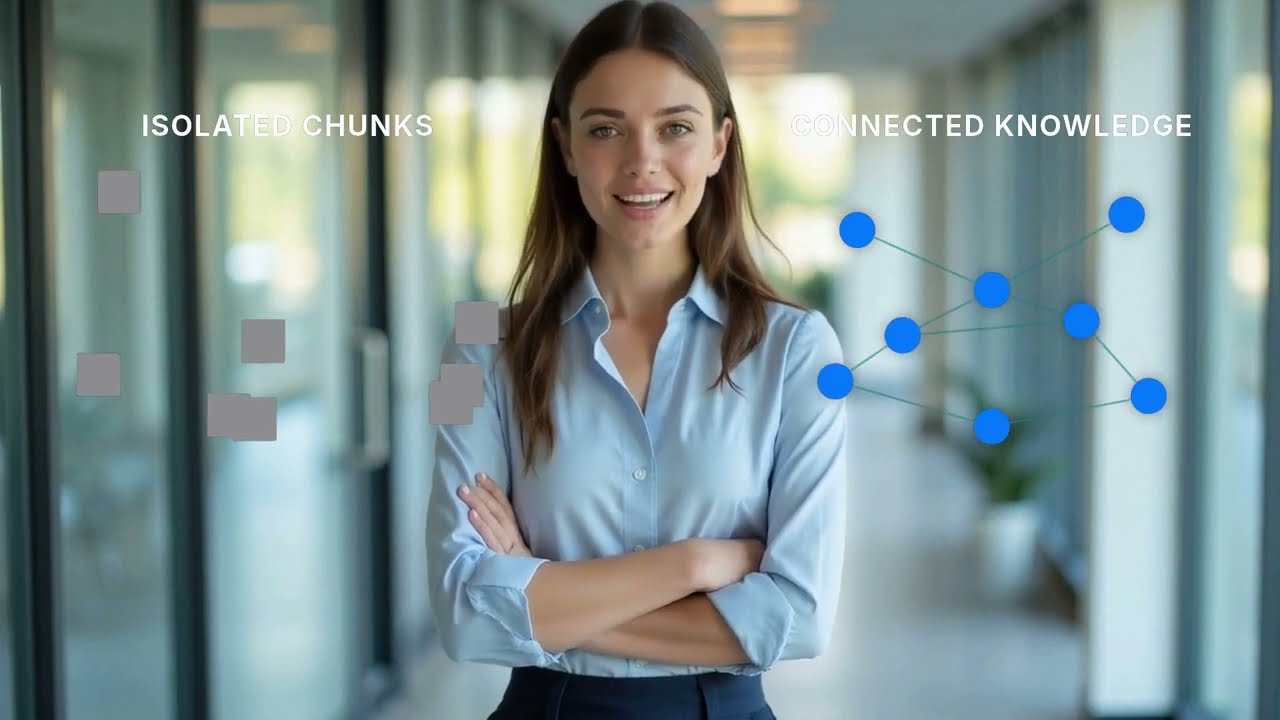
ベクトル RAG がディープリサーチで機能しない理由
- 出典の帰属はプロンプトではなくデータモデルです: 書き込み時に出典情報を保存することで、読み取り時の幻覚による引用を防ぎます。
- 決定論的な検索: グラフのトラバーサルは完全に再現可能であり、事実を示す証拠の追跡と、確率的な LLM 生成を切り分けます。
- 明示的な回答保留: エージェントはグラフ内で不足しているエッジを特定し、推測するのではなく「証拠が不十分です」と返します。
📚 おすすめガイド — オンプレミスでガバナンス対応 AI エージェントを構築する
自社のインフラストラクチャ上だけで、ガバナンスに対応した AI エージェントを設計、構築、公開するための完全なガイドです。
📄 ガイドを読む:オンプレミスでガバナンス対応 AI エージェントを構築する(PDF)
🚀 クイックスタート(2行、GPU不要)
pip install veritasgraph
veritasgraph demo --mode=lite
これで完了です。クラウド API(OpenAI/Anthropic)を使用するインタラクティブなデモで、ローカルモデルは必要ありません。
| モード | 最適な用途 | 必要条件 |
|---|---|---|
--mode=lite | 手早いデモ、GPU不要 | OpenAI/Anthropic API キー |
--mode=local | プライバシー、オフライン利用 | Ollama + 8GB RAM |
--mode=full | 本番環境、すべての機能 | Docker + Neo4j |
export OPENAI_API_KEY="sk-..."        # Lite: cloud APIs, zero setup
veritasgraph demo --mode=lite

veritasgraph demo --mode=local --model=llama3.2   # 100% offline with Ollama
veritasgraph start --mode=full                    # full GraphRAG pipeline
便利なリンク: ⚡ ライブドキュメント · 🎮 ライブデモ · 📖 記事 · 📄 研究論文
🏥 実装例 — MedTrust Agent
MedTrust Agent は、VeritasGraph のガバナンス付きエージェントアーキテクチャを医療および製薬のワークフローに適用した、完全で再現可能な実装例です。ゼロトラストで可観測な LLM エージェントフレームワーク(NEECON 2026 論文)です。
- ゼロトラストのコントロールプレーン: 最小権限の IAM と段階的な認可を備え、認可が成功するまではツールを実行しません。
- ガバナンス付きの回答:
[doc#chunk]による引用が必須です。引用のない回答は保留されるか、人間によるレビューに回されます。 - 改ざんを検知できる監査: 公開されたアンカーを備えた、鍵付きのハッシュチェーン型監査ログです。
- 誠実な評価: セキュリティは実行中のコードから直接測定します(未認可のアクションを100%ブロック、Wilson 95% CI)。回答品質は参考値として明確に表示します。69件のテスト、バージョン管理された40シナリオのテストスイート、ワンコマンドの再現スクリプトを備えています。
python -m medtrust.demo # end-to-end governed demo, 100% offline
📄 詳細な説明を読む: MedTrust Agent README
🧩 VeritasGraph を利用して構築
エンタープライズ向け GraphRAG、エージェントオーケストレーション、ファクトチェック、ガバナンス付き推論のために、VeritasGraph を基盤とするプロジェクトのエコシステムが拡大しています。
コミュニティのプロジェクトとインテグレーション
- MeAkash77 / VeritasGraph-Enterprise-GraphRAG-Verifiable-AI-Platform — エンタープライズ向けGraphRAGアダプターと、検証可能なAIプラットフォームのパターンです。
- PTP063 / veritas-graph — VeritasGraphのコンセプトを活用した派生プロジェクトおよび稼働中のデプロイです。
- RahulSagar2005 / multi-hop-rag — マルチホップ検索と推論のワークフローです。
- lukehungngo / agentwall — エージェントのセキュリティとガバナンスを重視した推論フローです。
- gajanan229 / Fact-checker-Agent — 証拠を重視したファクトチェックと説明のパターンです。
- Minh-Tam-Solution / EndiorBot — グラフを活用した推論を基盤とする、エンタープライズ向けチャットボットおよびAIエージェントのインテグレーションです。
- NistorDorinGabriel / Proiect_Licenta — VeritasGraphに着想を得たグラフ推論技術を拡張する、学術論文のプロジェクトです。
VeritasGraphを使って開発していて、ここで紹介されたい場合は、PRを送るか、リポジトリの概要と使用方法を簡潔に添えてご連絡ください。
� ライブデモ — Floorplan-KG の数量拾いデモ
建築図面に VeritasGraph を適用した、セットアップ不要のホスト型デモです。平面図の PDF をアップロードする(または同梱のサンプルを選ぶ)と、エンジンが部屋、寸法、開口部、設備、表を抽出し、知識グラフと数量拾いを作成します。これらはすべてクエリでき、元の図面シートまで追跡できる検証可能な来歴が付与されます。
🏗️ Floorplan-KG のデモを試す — 無料、ログイン不要。PyMuPDF/pdfplumber によるライブ抽出パイプラインを実行します。
- デモの内容: PDF → 構造化された部屋/寸法/表 → 知識グラフ → CSV/XLSX 形式の数量拾いエクスポート。抽出されたグラフについて、根拠に基づく Q&A を行う VeritasGraph アシストパネルも備えています。
- 重要な理由: ドキュメント RAG を支えるのと同じ、統制された帰属モデルをジオメトリにも適用します。測定された数量は推測値ではなく、それぞれ特定の図面シートと要素までたどれます。
- 出力例: 1 枚の住宅平面図から、200 ms 未満で約 17 室、約 2,400 平方フィートを取得します。
Studio はローカルのエージェント構築ワークスペース(FastAPI + シングルページ UI)です。独自のドキュメントから知識グラフを構築し、ツール、メモリ、データログ、ガードレール、headroom 方式のコンテキスト予算管理とともにエージェントに組み込むことができます。さらに、エージェントとライブでチャットし、オーケストレーションパイプラインの各段階を確認できます。すべてOllamaを使用して100%ローカルで実行されます。
🎮 Studio Live を試す — 実行中の最新 Studio トンネルに常にリダイレクトされる固定 URL です。
実行方法:
pip install -r requirements.txt
ollama serve & ollama pull qwen3:latest          # any local chat model
STUDIO_DATA_DIR="$PWD/studio_api/data" \
  uvicorn studio_api.main:app --host 127.0.0.1 --port 8200 --log-level warning
# Studio UI → http://localhost:8200/studio   ·   API docs → /docs
ワンコマンドのエンドツーエンドデモ(グラフを構築し、グラフ推論、メモリの呼び出し、PII の編集、ガードレールによるブロックを含む、完全に構成されたエージェントを実行します):
python3 demos/agent-studio/sample_pipeline.py --model qwen3:latest
内容 — Studio の全機能
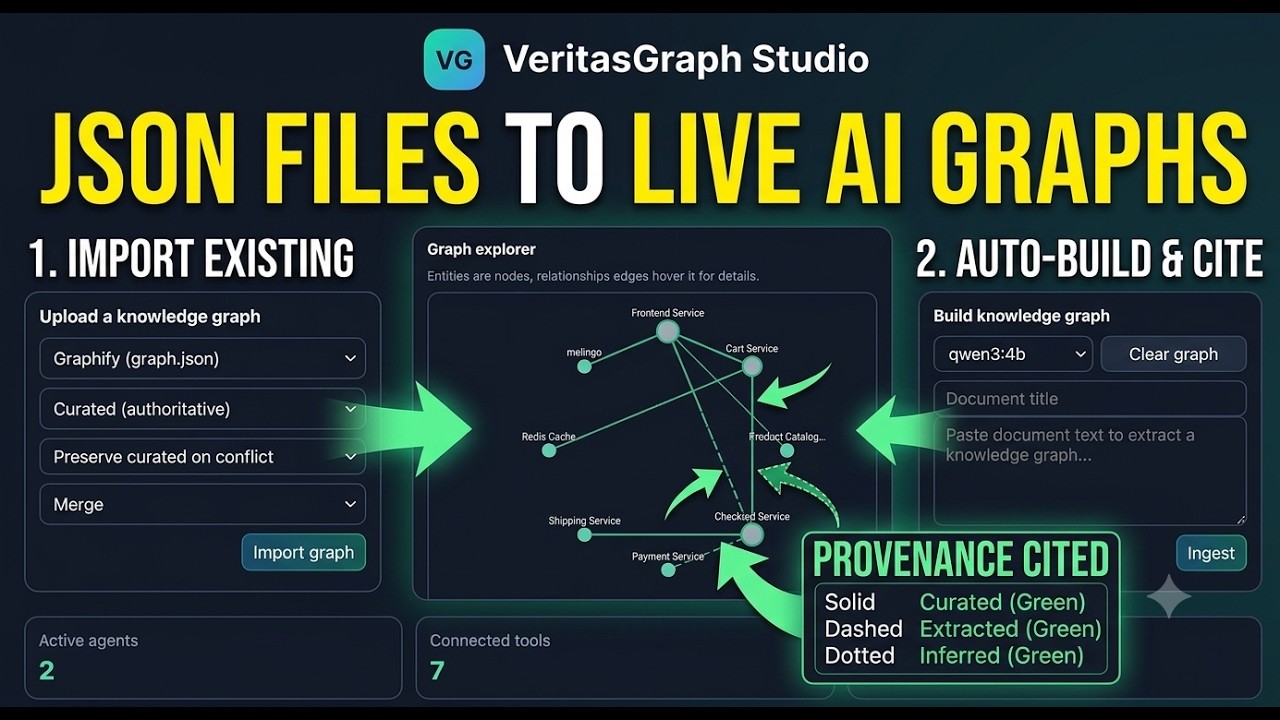
- 🧩 知識グラフビルダー&エクスプローラー — テキストを取り込み、エンティティ/関係をローカルで抽出し、根拠に基づいてノード/エッジを確認できます。
- 🔎 引用付きグラフ Q&A —
[doc#chunk]形式の出典帰属に裏付けられたマルチホップ回答を提供します。 - 🤖 エージェントワークスペース — モデル選択、プロンプト/ペルソナ設定、エージェントごとの機能切り替えを使って、エージェントを作成/編集できます。
- 🔀 統制されたオーケストレーションパイプライン — ターンごとに Guardrails → Memory → Knowledge Graph → Headroom budget → Tools → Data log の順に処理し、トレース全体を確認できます。
- 🧰 編集可能なツールカタログ — Studio から直接、ツールの追加、編集、有効化/無効化、テスト、削除ができます。
- 🌐 外部の実ツールに対応 — メソッド、認証ヘッダー、カスタムヘッダーを設定して、実際の HTTP エンドポイントを呼び出せます。
- 🔌 MCP ブリッジ連携 — ヘルス状態を考慮したプローブ機能付きのローカル MCP プロキシコネクター(例:Chrome DevTools MCP、Unity MCP)に対応します。
- 🛡️ ガードレール — PII の編集とポリシーによるブロックを制御でき、ガードレールによるブロックのメトリクスを確認できます。
- 🧠 メモリ + データログ — エージェントごとの短期メモリとインタラクションログの永続化に対応します。
- 📈 評価とファインチューニングのシミュレーション — 評価スイートを実行し、合格率の推移を追跡し、ファインチューニングジョブをキューに登録/監視できます。
- 💬 プレイグラウンド — 統制されたエージェントとの会話をライブで実行し、パイプラインのトレースを確認できます。
- 📊 KPI ダッシュボード — アクティブなエージェント、接続済みツール、評価の合格率、ガードレールによるブロック回数を表示します。
API とアーキテクチャについては studio_api/README.md、エンタープライズ向けテストシナリオについては docs/STUDIO_ENTERPRISE_TEST.md をご覧ください。
| # | 例 | 説明 | 実行 |
|---|---|---|---|
| 1 | sample_pipeline.py | Studio エージェントのパイプライン — 企業概要を取り込み → KG を構築 → 引用付きのマルチホップ Q&A → メモリの想起 → PII のマスキング → ガードレールによるブロック → 監査ログ。 | python3 demos/agent-studio/sample_pipeline.py |
| 2 | sample_tools_explorer.py | ツールカタログのシーダー — 17 個のツールを登録し、サンプルのエクスプローラーエージェントを作成します。冪等です。 | python3 demos/agent-studio/sample_tools_explorer.py |
| 3 | clinical-kg/ | 医療 AI — 臨床ナレッジグラフ — ノートの匿名化(セーフハーバー)、エンティティの抽出、矛盾の検出、ICD-10/RxNorm/SNOMED/LOINC への正規化、引用付きの患者 KG の構築を行います。 | cd clinical-kg/backend && python run.py |
| 4 | municipality-incident-chatbot/ | DMT 検査システム — CV 検証(YOLO/VLM)、KG に基づく振り分け、証拠の統合、案件登録を備えた市民向けインシデント報告。 | cd municipality-incident-chatbot && python cli.py |
🏥 例 3 — 医療 AI:HIPAA 準拠の臨床ナレッジグラフ
構造化されていない臨床ノートを、ガバナンスが確保された引用可能なナレッジグラフに変換します — 完全なオンプレミス環境で実行できます。
7 ステップのパイプライン:
| ステップ | 処理内容 |
|---|---|
| 匿名化 | 監査可能な再識別のため、封印された SurrogateVault を使用してセーフハーバーの正規表現によるマスキングを行います |
| 抽出 | セクションを考慮した NER、med-sig/検査値の解析、ConText 軸(否定、確実性、時間性、経験者) |
| 照合 | 概念ごとに言及をグループ化し、ノート間の矛盾(例:HPI の 「糖尿病なし」 と問題リストの 「T2DM」)を検出します |
| 正規化 | 言及をコード化された概念(ICD-10-CM、RxNorm、SNOMED CT、LOINC)にマッピングします |
| ナレッジグラフ | EVIDENCED_BY の出所エッジを持つ患者/受診/病状/薬剤/検査結果のノード |
| クエリ | NL → 構造化された CohortQuery → [doc#chunk] の引用を伴うマルチホップ探索 |
| ガバナンス | リリース対象コホートに対する k-匿名性 |
# Backend (FastAPI on :8300)
cd clinical-kg/backend
pip install -r requirements.txt
python run.py

# Frontend (Next.js dashboard on :3200)
cd clinical-kg/frontend
npm install && npm run dev
http://localhost:3200 を開き、サンプルノートを読み込む をクリックして、クエリを実行します。UI には 6 つのタブがあります:コホートクエリ、ノートの取り込み、患者、矛盾、グラフ、再識別リスク。
🏛️ 例 4 — DMT 検査システム:自治体インシデントチャットボット
市民が公共サービスに関するインシデントを報告できる AI チャットボットです。コンピュータービジョンで検証し、ナレッジグラフに基づいて回答します。
パイプラインの流れ: 市民の写真と説明 → KG による分類 → CV 検証(YOLO/VLM)→ 相互確認(CCTV、場所、過去の報告)→ 証拠の統合 → 案件登録。
対応するインシデント: ごみのあふれ · 放置車両 · 過密状態 · 違法駐車 (拡張可能)
cd municipality-incident-chatbot
pip install -r requirements.txt

# Interactive CLI
python cli.py
#   you> trash overflowing near the market | photo=garbage_overflow.jpg | zone=downtown

# Test suite
python -m pytest -q
| コンポーネント | ファイル |
|---|---|
| ナレッジグラフ(根拠付けと振り分け) | app/knowledge_graph.py |
| CV 検証(YOLO + VLM) | app/cv_service.py |
| 証拠の統合とスコアリング | app/fusion.py |
| チャットボットのオーケストレーター | app/orchestrator.py |
| アーキテクチャのドキュメント | 01_architecture.md |
エンタープライズシナリオ — Northwind Bank のコンプライアンステスト手順書に従い、現実的な金融サービスデータを使ったガイド付きの手順を実施してください。
API レベルの例と curl のレシピについては、studio_api/README.md を参照してください。
🌳 + 🔗 グラフ + ツリー:究極の検索
なぜ選ぶのか? VeritasGraph は、PageIndex の階層的な「目次」ナビゲーションに加え、ナレッジグラフの意味的推論も備えています。
Document Root
├── [1] Introduction
│   ├── [1.1] Background ←── Tree Navigation
│   └── [1.2] Objectives
├── [2] Methodology ←───────── Graph Links
│   └── relates_to ──────────→ [3.1] Findings
└── [3] Results
📊 機能比較
| 機能 | Vector RAG | PageIndex | VeritasGraph |
|---|---|---|---|
| 検索タイプ | 類似度 | ツリー検索 | 🏆 ツリー+グラフ推論 |
| 出典の明示 | ❌ 低い | ⚠️ 中程度 | ✅ 100%検証可能 |
| マルチホップ推論 | ❌ | ❌ | ✅ |
| ツリーナビゲーション(目次) | ❌ | ✅ | ✅ |
| セマンティック検索 | ✅ | ❌ | ✅ |
| セクション間のリンク | ❌ | ❌ | ✅ |
| ビジュアルグラフエクスプローラー | ❌ | ❌ | ✅ 組み込みUI |
| 100%ローカル/プライベート | ⚠️ 条件による | ❌ クラウド | ✅ オンプレミス |
| オープンソース | ⚠️ 条件による | ❌ プロプライエタリ | ✅ MITライセンス |

🎬 動作を見る
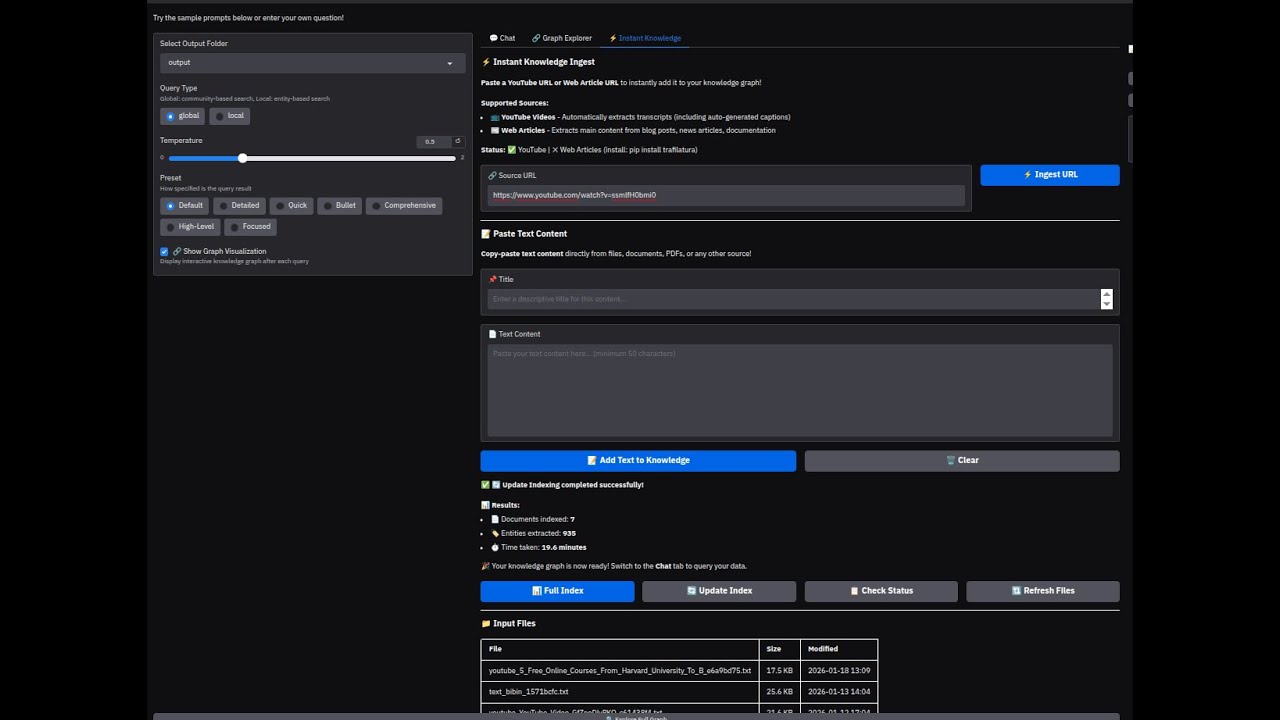
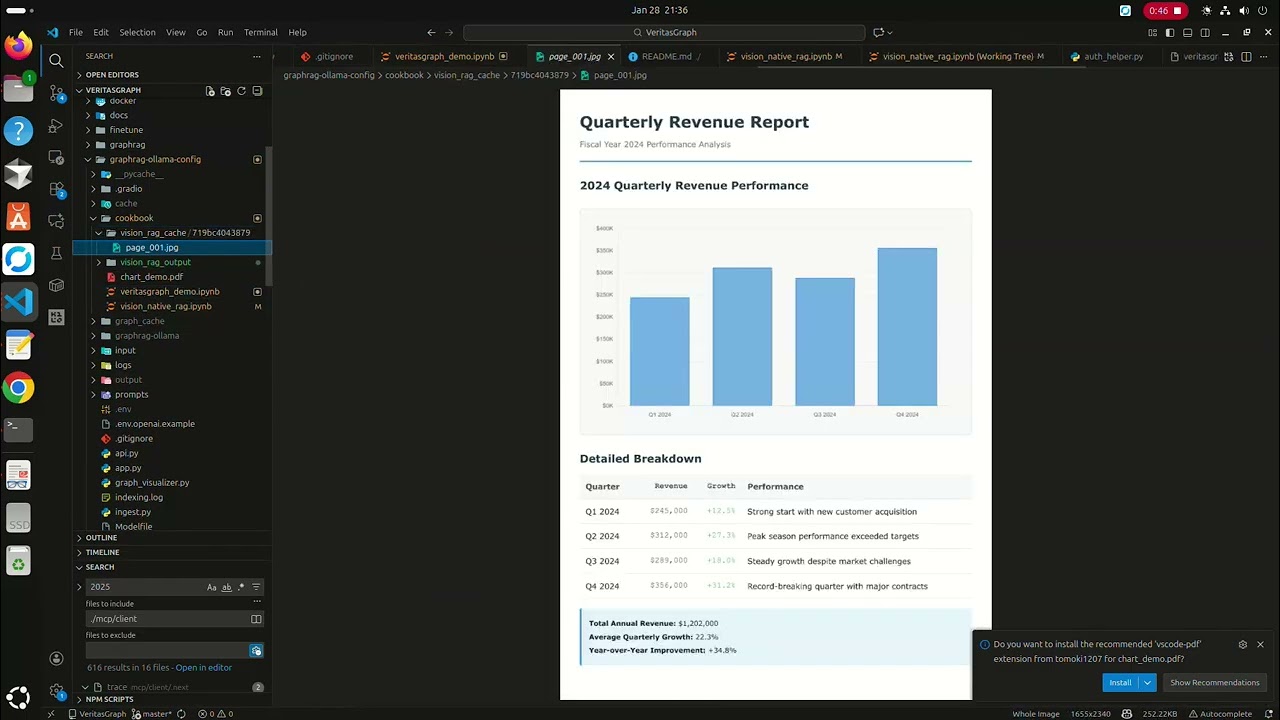
💡 表示されている内容: クエリによって、ナレッジグラフ全体にわたるマルチホップ推論が実行されます。つながりが見つかるたびにノードが点灯し、回答が見つかった内容だけでなく、方法も正確に示されます。
🔌 MCP サーバー — IDEエージェントをVeritasGraphに接続
VeritasGraphには、専用の**Model Context Protocol サーバー**が付属しています。これは、MCP向けの、ゼロトラストかつエアギャップ対応の初のエンタープライズGraphRAGサーバーです。 Claude Desktop、Cursor、VS Code、Windsurf、Cline、またはContinueを、JSON-RPC 2.0 stdio経由でGraphRAGエンジンに直接接続でき、外部へのデータ送信は一切ありません。
python -m veritasgraph_mcp # from repo root (needs local Ollama for ingest/query)
ツール:veritasgraph_ingest_document、veritasgraph_query([doc#chunk]形式の引用を含むマルチホップ回答)、veritasgraph_search_entities、veritasgraph_get_graph、veritasgraph_clear_graph。IDEへの登録方法を記載したコード例については、veritasgraph_mcp/README.mdをご覧ください。
🏥 VeritasGraph-MCP のユースケース — Azure 上の本番環境向け医療 AI
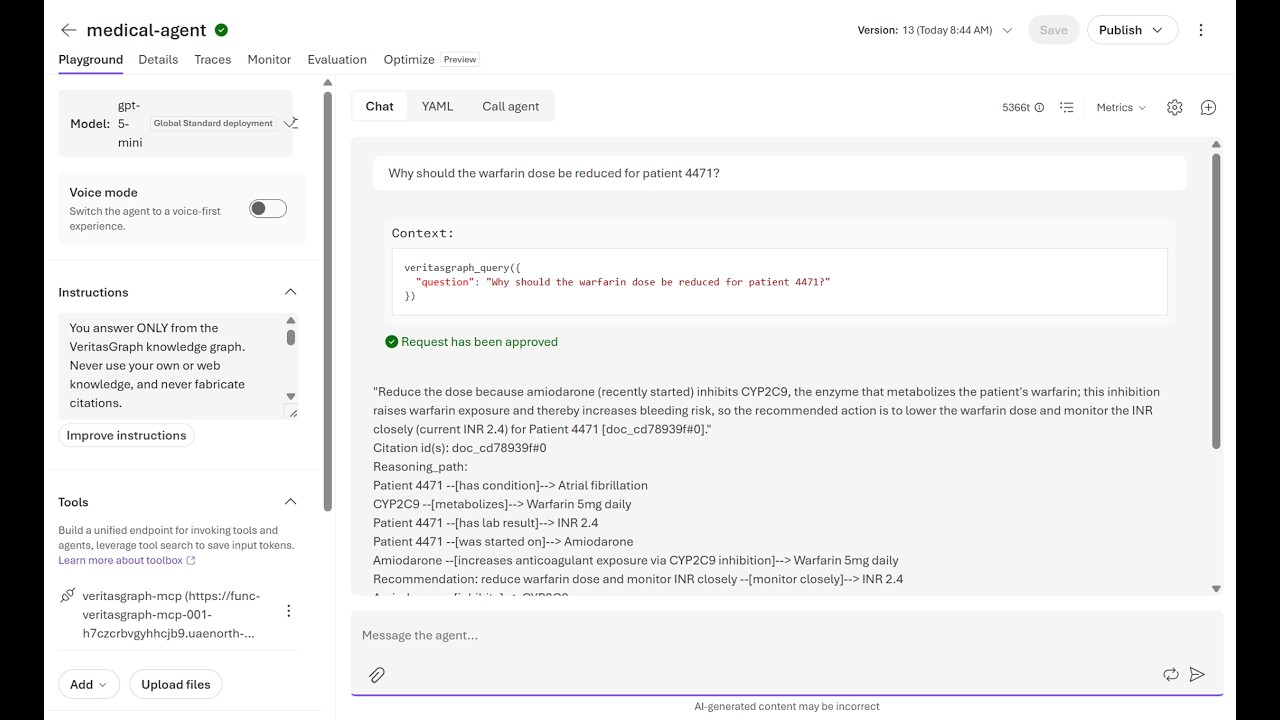
実環境へのデプロイ: Azure AI Foundry と連携する Azure Functions 上で稼働する VeritasGraph MCP サーバーです。検証可能な引用とコンプライアンスに対応したアーキテクチャを備えた、GraphRAG を活用する臨床意思決定支援を提供します。
📖 本番環境へのデプロイ手順
課題: Azure AI のデモの 90%は動作します。しかし、本番環境に投入されるものはほとんどありません。差を生むのはモデルではなく、アーキテクチャ、セキュリティ、状態管理、コンプライアンスです。
解決策: VeritasGraph をリモート MCP サーバーとしてデプロイし、Azure AI Foundry のエージェントから呼び出して、次の機能を活用しながら臨床上の質問に回答します。
- ✅ 複数ホップの GraphRAG 推論 — 別々のグラフエッジから回答を組み立てます
- ✅ 検証可能な引用 — すべての主張を
[doc#chunk]の出典までたどれます - ✅ 本番環境向けのアーキテクチャ — 外部化された状態、境界での ID 管理、可観測性を備えています
- ✅ コンプライアンス対応 — リージョンを固定し、PHI を考慮したガードレールとセマンティックレイヤーの RBAC を採用しています
アーキテクチャの主なポイント:
Foundry Agent / MCP client
   → Identity (Entra ID + function key)
      → Azure Functions (Flex Consumption, 4 mcpToolTrigger tools)
         → veritasgraph-mcp + graphrag_engine
            → Azure OpenAI (extraction + reasoning)
            → Knowledge Graph
         → Durable Azure Files mount (externalized state)
         → Storage + App Insights (observability)
本番環境から得られた主な教訓:
- 状態の外部化 — Flex Consumption ではメモリ内のグラフが消去されるため、Azure Files のマウント済み共有を使って解決しました
- 境界での ID 管理 — Entra ID を引き継ぎ、ユーザーに代わって Power BI RLS/Dataverse のロールを適用します
- 自己修正型エージェント — エラーとスキーマをフィードバックし、最大 3 回再試行します(例:DAX の生成)
- 設計段階からのコンプライアンス対応 — Foundry のガードレールが、PHI を漏えいさせるリクエストをモデルに到達する前にブロックします
- 可観測性のレイヤー — Application Insights、Foundry Traces、Evaluations、Alerts を活用します
クエリの実行例:
{
  "question": "Should we adjust warfarin for patient 4471 on amiodarone?",
  "answer": "Reduce the warfarin dose because amiodarone inhibits CYP2C9...",
  "citations": ["doc_warfarin_note#0", "doc_warfarin_note#1"],
  "reasoning_path": ["Amiodarone → CYP2C9", "CYP2C9 → Warfarin", "Warfarin → Bleeding Risk"]
}
技術スタック:
- コンピューティング: Azure Functions(Flex Consumption)— ゼロまでスケールし、イベント駆動型のスケールアウトが高速です
- 状態: Azure Files マウント — コールドスタートやスケールイベント後も状態を保持します
- 推論: Azure OpenAI(gpt-4-turbo/gpt-5-mini、切り替え可能)
- ID 管理: Entra ID + 関数キー/システムキー
- 可観測性: Application Insights + Foundry Traces
- コンプライアンス: リージョン固定のデプロイ、PHI を考慮したガードレール、Key Vault のシークレット
デプロイ済みシステム:
- 医療 MCP サーバー — 複数ホップの推論と
[doc#chunk]の引用に対応した臨床ナレッジグラフ - Power BI 自然言語エージェント — OAuth トークンを検証 → スキーマを検出 → DAX を生成 →
executeQueriesREST API 経由で実行し、プラットフォームが行レベルのセキュリティを適用します
リソース:
- 📄 完全ガイドを読む:概念実証から本番環境へ:実際にリリースできる Azure AI — アーキテクチャ、デプロイ、GraphRAG 推論、監査可能性、セマンティックレイヤーのアクセス制御、レジリエンス、可観測性、コンプライアンスを網羅した完全な手順です。
- 💻 Azure AI Foundry + VeritasGraph 実装リポジトリ — 本番環境へのデプロイ用コード、設定、サンプルです。
本番環境対応チェックリスト:
- ✓ 根拠に基づく — 回答にデータの引用を含めます(
[doc#chunk]) - ✓ 状態を外部化 — サーバーレスのメモリに依存しません
- ✓ 境界での ID 管理 — データには Entra ID + キーを使用し、ユーザーに代わってアクセスします
- ✓ 権限を適用 — データがモデルに到達する前に RLS/ロールを適用します
- ✓ レジリエント — 不正なパラメーター、スロットリング、ツールの失敗に対応します
- ✓ 可観測 — ログ、トレース、評価、コストアラートを備えています
- ✓ リージョン固定でコンプライアンスに準拠 — 推論はテナント内で行い、PHI に対応します
- ✓ Key Vault でシークレットを管理 — マネージド ID と最小権限を採用します
- ✓ 再現可能なデプロイ — リモートビルドと固定された設定を使用します
💡 主な洞察: 概念実証と本番環境の差を生むのはモデルではなく、アーキテクチャです。根拠を与え、状態を外部化し、セキュリティを確保し、観測可能にし、レジリエントにして、コンプライアンスを維持しましょう。
📖 Python API
from veritasgraph import VisionRAGPipeline

pipeline = VisionRAGPipeline()                 # auto-detects available models
doc = pipeline.ingest_pdf("document.pdf")
result = pipeline.query("What are the key findings?")
print(result.answer)
🌳 階層ツリーナビゲーション+グラフ検索
from veritasgraph import VisionRAGPipeline

pipeline = VisionRAGPipeline()
doc = pipeline.ingest_pdf("report.pdf")

# View the document's hierarchical structure (like a Table of Contents)
print(pipeline.get_document_tree())
# Document Root
# ├── [1] Introduction (pp. 1-5)
# │   ├── [1.1] Background (pp. 1-2)
# │   └── [1.2] Objectives (pp. 3-5)
# └── [2] Methodology (pp. 6-15)

# Navigate to a specific section (tree-based retrieval)
section = pipeline.navigate_to_section("Methodology")
print(section['breadcrumb'])   # ['Document Root', 'Methodology']

# Or use graph-based semantic search
result = pipeline.query("What methodology was used?")
# → answer with section context: "📍 Location: Document > Methodology > Analysis Framework"
🔧 カスタム設定と取り込みモード
from veritasgraph import VisionRAGPipeline, VisionRAGConfig

config = VisionRAGConfig(ingest_mode="document-centric")  # tables stay intact!
pipeline = VisionRAGPipeline(config)
doc = pipeline.ingest_pdf("annual_report.pdf")
| モード | 説明 | 最適な用途 |
|---|---|---|
document-centric | ページ/セクション全体をノードとして扱います(デフォルト) | ほとんどのドキュメント |
page | 各ページを1つのノードとして扱います | スライドデッキ、レポート |
section | 各セクションを1つのノードとして扱います | 構造化ドキュメント |
chunk | 従来の500トークン単位のチャンク | レガシーとの互換性 |
CLI
veritasgraph --version                                    # show version
veritasgraph info                                         # check dependencies
veritasgraph init my_project                              # initialize a project
veritasgraph ingest document.pdf --ingest-mode=document-centric   # Don't Chunk. Graph.
veritasgraph ingest https://youtube.com/watch?v=xxx       # auto-extract transcript
veritasgraph ingest https://example.com/article           # extract web article
インストール方法
pip install veritasgraph            # basic (includes lite mode)
pip install veritasgraph[web]       # Gradio UI + visualization
pip install veritasgraph[graphrag]  # Microsoft GraphRAG integration
pip install veritasgraph[ingest]    # YouTube & web-article ingestion
pip install veritasgraph[all]       # everything
🏛️ エンタープライズコンプライアンス — VeritasGraph + VeritasReason
GraphRAGは、ドキュメントに書かれている内容を説明するのに優れています。しかし、「前四半期に職務分掌ポリシーに違反した発注書はどれですか?」のようなエンタープライズの質問は、類似性検索ではなく、構造化レコードに対するルール評価の問題です。
このような用途向けに、VeritasGraphには姉妹モジュールの VeritasReason が用意されています。これは決定論的推論エンジン(前向き連鎖+Rete+SPARQL)で、トリプレットストアに対してポリシールールを適用し、W3C PROV-Oの来歴情報を含む監査可能な回答を返します。
 Policy PDFs ─┐                        ┌─ ingest_structured.py (SQL → triples + text)
              ▼                        ▼
      VeritasGraph GraphRAG      VeritasReason (TripletStore + RuleSet
      (quotes policy text)       + ForwardChainer + PROV-O)
              └──────────┬───────────────┘
                         ▼
             Compliance answer + violators table + clause citations
30秒でできるスモークテスト(インストール不要、標準ライブラリのみ)
python tests/test_policy_compliance_demo.py
小規模なインメモリのトリプルストアにダミーのERPデータを登録し、rules/sod_policy.yaml に定義された4つの職務分掌ルールを評価して、違反者とその引用を表示します。
✓ Reasoner fired. Detected 4 violation(s):
  po:PO-2204 SOD-01   Approved & paid by emp:E118
  po:PO-2301 SOD-02   Requested & approved by emp:E091
  po:PO-2317 SOD-03   $48,750.00 approved by emp:E091 (role:Manager, not Director)
  po:PO-2402 SOD-04   Vendor vendor:V77 related to approver emp:E140
または、パッケージ化されたデモをインストールして実行します。
pip install veritas-reason
veritasreason-policy-demo

同じパターンは、休暇ポリシー違反(HRIS勤怠データ)、経費報告書の不正(台帳+領収書)、臨床プロトコル違反(EHR+ガイドライン)、KYC/AML(取引+監視リスト)にも適用できます。ingest_structured.py でSQLからトリプルへのマッピングを定義し、rules/*.yaml にルールを記述して、自然な英語で質問します。詳しい手順については、veritas-reason/plan.md を参照してください。
🔗 インタラクティブなグラフの可視化
VeritasGraphには、エンティティと関係をリアルタイムで可視化するインタラクティブな2Dナレッジグラフエクスプローラー(PyVis)が含まれています。

| 機能 | 説明 |
|---|---|
| クエリ対応サブグラフ | クエリに関連するエンティティのみを表示します |
| コミュニティ別の色分け | ノードを所属コミュニティごとにグループ化します |
| 赤色のハイライト | クエリに関連するエンティティを赤色で表示します |
| ノードのサイズ | ノードが大きいほど、接続数が多いことを示します |
| インタラクティブ操作 | ドラッグ、ズーム、ホバーでエンティティの詳細を確認できます |
| グラフ全体のエクスプローラー | ナレッジグラフ全体を表示します |
⚙️ プロバイダーのサポート(OpenAI互換)
VeritasGraphは、OpenAI互換APIならどれでも使用でき、クラウドとローカルを自由に組み合わせられます。
| プロバイダー | APIベースURL | APIキー | モデルの例 |
|---|---|---|---|
| Ollama(デフォルト) | http://localhost:11434/v1 | ollama | llama3.1-12k |
| OpenAI | https://api.openai.com/v1 | sk-proj-... | gpt-4-turbo-preview |
| Groq | https://api.groq.com/openai/v1 | gsk_... | llama-3.1-70b-versatile |
| Together AI | https://api.together.xyz/v1 | your-key | Meta-Llama-3.1-70B-Instruct-Turbo |
| LM Studio | http://localhost:1234/v1 | lm-studio | (LM Studioで読み込んだモデル) |
Azure OpenAI、OpenRouter、Anyscale、LocalAI、vLLMもサポートされています。
cd graphrag-ollama-config
cp settings_openai.yaml settings.yaml
cp .env.openai.example .env       # edit with your provider settings
python -m graphrag.index --root . --config settings_openai.yaml
python app.py
⚠️ 埋め込みモデルはインデックス作成時と同じものを使用してください。
nomic-embed-text(768次元)でインデックスを作成した場合、クエリにも同じモデルを使用する必要があります。埋め込みモデルを切り替えるには、再インデックス作成が必要です。詳しくはOPENAI_COMPATIBLE_API.mdを参照してください。
🐳 デプロイ
5分でできるマジックオンボーディング(Docker)
1つのコマンドでフルスタック(Ollama + Neo4j + Gradio)を実行します:
cd docker/five-minute-magic-onboarding
# set your Neo4j password in .env, then:
docker compose up --build
サービス:Gradio UI → http://127.0.0.1:7860 · Neo4j → http://localhost:7474 · Ollama → http://localhost:11434。詳細は docker/five-minute-magic-onboarding/README.md をご覧ください。
チームと共有(無料)
| 方法 | 期間 | ローカル Ollama | セットアップ | 最適な用途 |
|---|---|---|---|---|
python app.py --share | 72時間 | ✅ | 1分 | 手軽なデモ |
| Ngrok トンネル | 無制限* | ✅ | 5分 | チームでの評価 |
| Cloudflare トンネル | 無制限* | ✅ | 5分 | チームでの評価 |
| Hugging Face Spaces | 永続 | ❌(クラウド LLM) | 15分 | 公開デモ |
*無料プランにはいくつかの制限があります。
🏗️ アーキテクチャ
graph TD
    subgraph "Indexing Pipeline (one-time)"
        A[Source Documents] --> B{Document Chunking};
        B --> C{"LLM Extraction<br/>(Entities & Relationships)"};
        C --> D[Vector Index];
        C --> E[Knowledge Graph];
    end
    subgraph "Query Pipeline (real-time)"
        F[User Query] --> G{Hybrid Retrieval Engine};
        G -- "1. Vector search for entry points" --> D;
        G -- "2. Multi-hop graph traversal" --> E;
        G --> H{Pruning & Re-ranking};
        H -- "Rich context" --> I{LoRA-Tuned LLM Core};
        I -- "Answer + provenance" --> J{Attribution Layer};
        J --> K[Attributed Answer];
    end
    style A fill:#f2f2f2,stroke:#333,stroke-width:2px
    style F fill:#e6f7ff,stroke:#333,stroke-width:2px
    style K fill:#e6ffe6,stroke:#333,stroke-width:2px
4つのステージ:
- ナレッジグラフの自動構築 — ドキュメントを
TextUnitsに分割し、(head, relation, tail)のトリプレットを抽出して、グラフ DB(Neo4j など)にノードとエッジを構築します。 - ハイブリッド検索エンジン — ベクトル検索で起点ノードを見つけ、マルチホップ走査で隠れた関係を明らかにし、枝刈りと再ランキングで最も関連性の高い事実を残します。
- LoRA チューニング済み推論コア — ローカルでホストされた LoRA チューニング済みのオープンモデルが、推論と出典帰属に向けた効率的なファインチューニングにより、出典を明示した回答を生成します。
- 出典帰属と来歴のレイヤー — ソース ID、チャンク、グラフノードを、構造化され追跡可能な JSON 出力に引き継ぎます。
オンプレミスの前提条件
ハードウェア: CPU 16コア以上 · RAM 64GB以上(128GB推奨) · VRAM 24GB以上の NVIDIA GPU(A100 / H100 / RTX 4090)。
ソフトウェア: Docker と Docker Compose · Python 3.10+ · NVIDIA Container Toolkit。
.env.example を .env にコピーし、環境に応じた値を設定してください。
VeritasGraph を選ぶ理由
- ✅ 完全なオンプレミス環境で安全 — データとモデルを100%管理できます。
- ✅ 検証可能な出典帰属 — すべての主張を出典までたどれます。
- ✅ 高度なグラフ推論 — 複雑なマルチホップの質問に回答します。
- ✅ 階層型ツリー + グラフ — PageIndex 形式の目次ナビゲーションとグラフの柔軟性を両立します。
- ✅ ガバナンスされたエージェント — Studio でガードレール、メモリ、ツール、コンテキストの予算管理を連携します。
- ✅ オープンソースで主権を確保 — MIT ライセンスで、ベンダーロックインはありません。
対象ユーザー: エンタープライズ検索、コンプライアンスアシスタント、リサーチコパイロット、科学文献の探索ツール、エージェントのメモリシステムを構築するエンジニアです。「答え」が、事実同士がベクトルインデックス内で近くに現れるかどうかだけでなく、事実同士がどのように つながっているか に左右されるあらゆる場面で活用できます。
🙌 謝辞
HopRAG、Microsoft GraphRAG、LangChain & LlamaIndex、Neo4j の基盤となる取り組みを活用しています。
🏆 受賞・引用
International Conference on Applied Science and Future Technology (ICASF 2025) で発表されました — 📄 感謝状。
@article{VeritasGraph2025,
  title={VeritasGraph: A Sovereign GraphRAG Framework for Enterprise-Grade AI with Verifiable Attribution},
  author={Bibin Prathap},
  journal={International Conference on Applied Science and Future Technology (ICASF)},
  year={2025}
}
スター履歴


MIT ライセンスのもとで公開されています。 ⭐ オープンソースのガバナンスされた GraphRAG のロードマップをチェックするには、リポジトリにスターを付けてください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。