bricksentry について
bricksentryは、Databricksのパイプライン変更について、リリース前にデータへの影響、下流の依存関係、ロールバック方法を確認します。データエンジニアやAIエージェント向けで、決定論的なポリシー判定とDuckDBでのローカルデモを備えています。
主な機能
- 01キー単位のデータ差分とスキーマ検査
- 02Unity Catalogの下流影響分析
- 03ポリシー判定とロールバックSQL
- 04コマンドライン、Python API、MCPサーバー、GitHub Action
- 05サンドボックスでの書き込みプレビュー
活用シーン
- 01プルリクエストでのパイプライン変更の確認
- 02テーブル編集前の下流影響の把握
- 03本番環境に触れない書き込みのプレビュー
- 04エージェント向けの決定論的な安全確認
MCP 対応
MCPサーバーは、下流アセットの確認、ロールバック計画の作成、一時クローンでの書き込みプレビュー、変更評価、差分の説明、安全なリリース可否の確認に使うツールを公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx bricksentry-mcpBRICKSENTRY_CONFIGPath to your bricksentry.yml (backend, tables and policy).DATABRICKS_HOSTDatabricks workspace URL, when using the Databricks backend.DATABRICKS_TOKENシークレットDatabricks access token, when using the Databricks backend.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
bricksentry へようこそ




AI 時代のデータ変更に対する安全性チェックです。
Databricks パイプラインと、それを編集する AI エージェントの変更を安全にします。変更を本番に反映する前に、データにどのような影響があるかを把握できます。
30 秒で試す · Databricks ノートブックを実行 · ドキュメント:bricksentry.org · LinkedIn
Databricks Champion の Brahmareddy が開発しました。Apache-2.0 ライセンスのオープンソースです。
名前の由来は? Bricks(レンガ)と entry(記録)を組み合わせた名前です。テーブルとパイプラインはレイクハウスを構成するレンガであり、それらへの変更はすべて記録になります。bricksentry は変更を一つずつチェックし、影響を報告して、反映される前に監視します。
30 秒で試す(Databricks は不要です)
pip install "bricksentry[duckdb]"
bricksentry demo
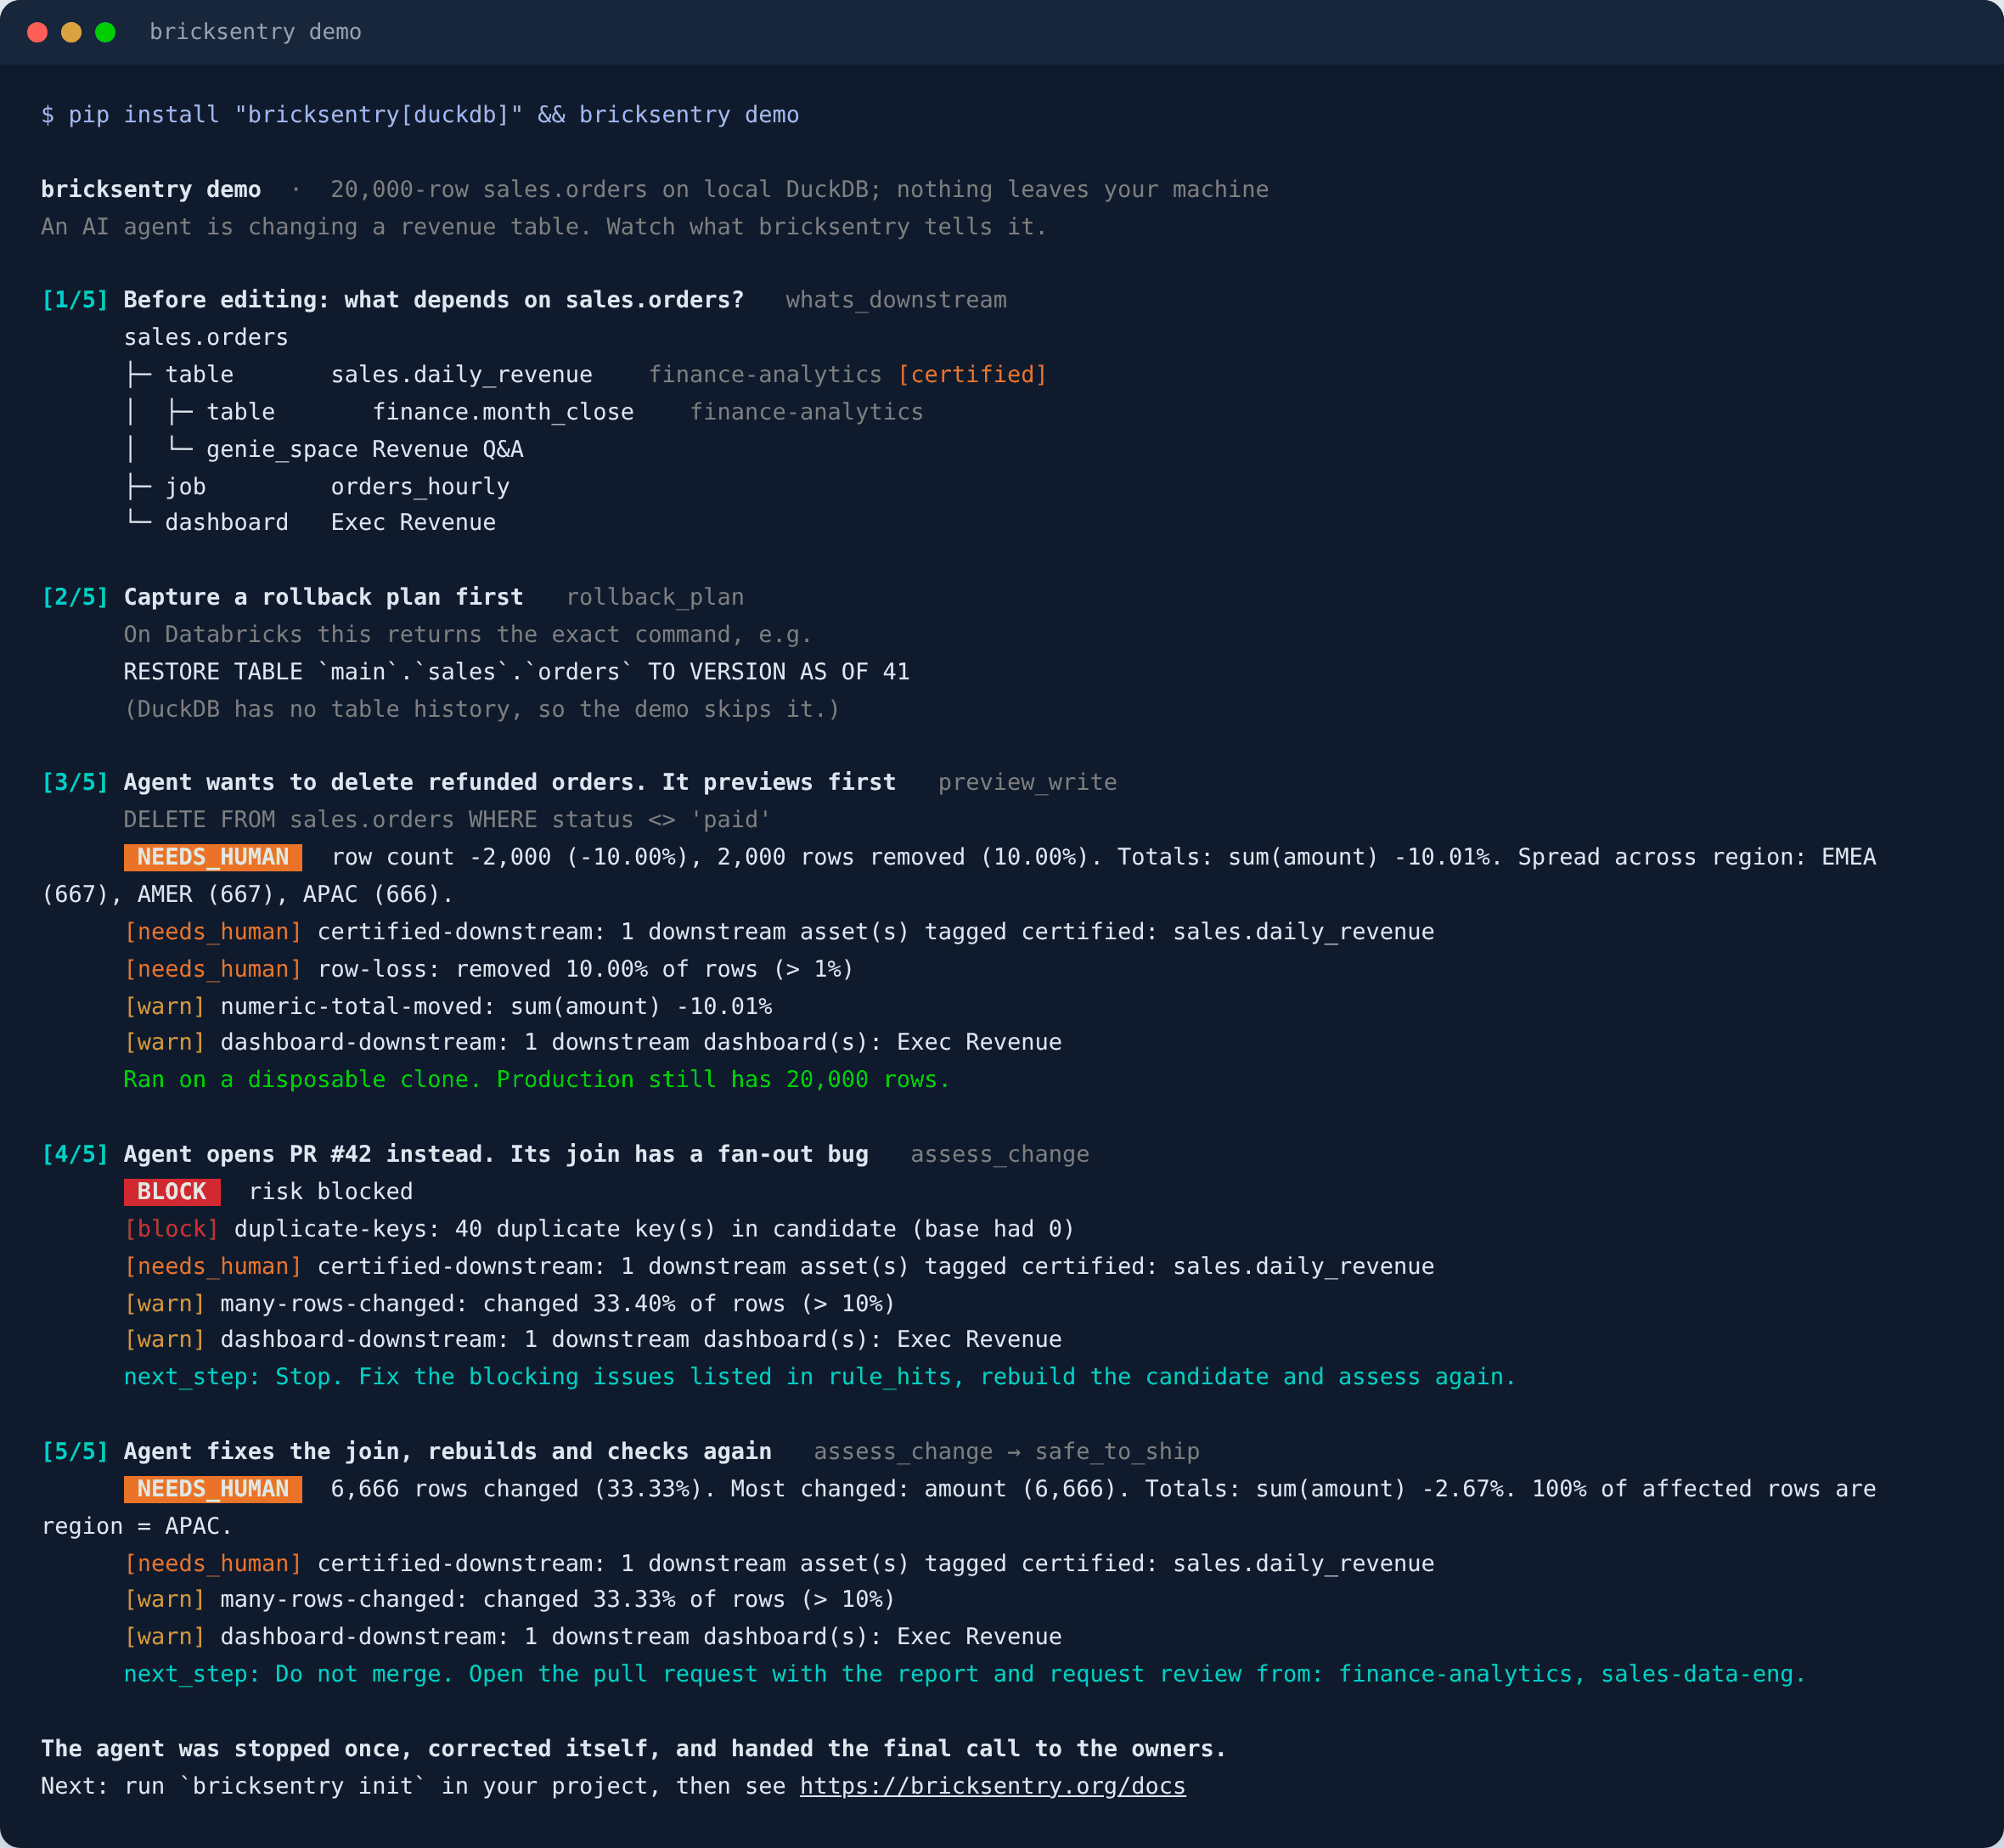
AI エージェントが、2 万行の売上テーブルを変更します。bricksentry はクローン上で DELETE の影響をプレビューし(本番環境には触れません)、40 件の注文が重複する結合を検出してプルリクエストをブロックし、修正版を下流にある認定テーブルのオーナーに通知します。すべて DuckDB 上でローカルに実行されます。
Databricks ワークスペースで実行する
直近のパイプライン実行では何が起きましたか?(10 分、読み取り専用)
テーブル確認ノートブック: ワークスペースで Workspace → Import → URL を開き、次の URL を貼り付けます。
https://raw.githubusercontent.com/bricksentry/bricksentry/main/examples/databricks/bricksentry_check_my_table.py
テーブル確認ノートブック の対象に、パイプラインが書き込む Delta テーブルを指定します。テーブルの履歴から最新のデータ変更(WRITE、MERGE、UPDATE、DELETE)を見つけ、変更前のバージョンと比較します。そして、変更が反映される前にレビュアーが確認できた判定内容を表示します。追加、削除、変更された行、重複キー、変動した合計値、テーブルに依存する要素、および変更を取り消すための RESTORE コマンドが確認できます。テーブルは読み取りのみで、比較にはスクラッチスキーマ内のシャロークローンを 2 つ使用し、処理の最後に削除します。
何か見つかった場合は、ぜひ検出内容を共有してください(テーブル名は不要です)。実際の結果をもとに、次に開発する機能を決めます。
デモデータを使ったガイド付きツアー
Databricks クイックスタートノートブック: ワークスペースで Workspace → Import → URL に移動し、次の URL を貼り付けます。
https://raw.githubusercontent.com/bricksentry/bricksentry/main/examples/databricks/bricksentry_quickstart.py
クイックスタートノートブックでは、選択したスキーマに小さなデモテーブルを作成し、Databricks で同じ一連の処理を実行します。Unity Catalog の影響範囲、実際の RESTORE ロールバック計画、シャロークローンでのプレビュー、ブロックされたプルリクエストとその修正を確認します。その後、自分のテーブルの1つを読み取り専用でチェックし、最後に作成したものをクリーンアップします。
SQL ウェアハウス、選択したスキーマに対する CREATE TABLE 権限、および影響範囲の確認に必要な system.access.table_lineage に対する SELECT 権限が必要です。Jupyter 版は bricksentry_quickstart.ipynb にあります。
できること
変更が本番環境に反映される前に、bricksentry は次の3つの問いに答えます。 人間向けにはプルリクエストのコメントで、エージェント向けには構造化 JSON で回答します。
- データにどのような影響がありますか? キーに基づくデータ差分を確認します。追加、削除、変更された行、スキーマ変更、列ごとの変更、数値の合計、重複キー、および変更が集中している「場所」(「影響を受ける行の100%が region = APAC」など)を確認できます。
- 誰に影響がありますか? Unity Catalog のリネージから、下流への影響範囲を確認します。所有者とタグを含むテーブル、ジョブ、ノートブック、Lakeflow パイプライン、ダッシュボード、クエリが対象です。列単位では、変更が加えられた列、その列にタグ(たとえば
pii)が付いているか、下流のどの列に影響するかを確認できます。 - 安全ですか?元に戻すにはどうすればよいですか? 決定論的なポリシー判定(
pass·warn·needs_human·block)と、正確なRESTORE TABLE … VERSION AS OF nロールバックを確認できます。
Databricks ワークスペースの場合:
pip install "bricksentry[databricks,mcp]"
bricksentry init        # writes bricksentry.yml and policy.yml
これが必要な理由
現在、パイプラインコードの多くは AI が作成していますが、そのコードがデータに与える影響のチェックは追いついていません。コードレビューでは、収益の3%が気付かないうちに変動することや、結合によってデータが増幅されることを検出できません。こうした問題を検出できるツールの多くは dbt のみに対応しているか、有料のプラットフォームを必要とします。Databricks の作業の大半は PySpark ノートブック、Jobs、Lakeflow パイプラインで行われるため、bricksentry はそれらに対応しています。
- SQL の解析ではなく、Unity Catalog のランタイムリネージを使用するため、PySpark ノートブックとジョブも対象になります。
- SQL プッシュダウン:すべての差分処理が SQL ウェアハウス上で実行されるため、Spark セッションは不要で、エージェントのループで使い続けられる低コストを実現します。
- 1つのエンジン、3つの利用方法:CLI と GitHub Action · Python API · MCP サーバー。
AI エージェント向け:MCP サーバー
エージェントを接続する最も手早い方法は、MCP と Databricks の追加機能を含む bricksentry をインストールする bricksentry-mcp パッケージを使うことです。uv を使えば、事前のインストールは不要です。
# Claude Code
claude mcp add bricksentry -- uvx bricksentry-mcp --config /full/path/to/bricksentry.yml
{
  "mcpServers": {
    "bricksentry": {
      "command": "uvx",
      "args": ["bricksentry-mcp", "--config", "/full/path/to/bricksentry.yml"]
    }
  }
}
この JSON は Claude デスクトップアプリ、Cursor、その他の MCP クライアントで動作します。クライアントはそれぞれ独自の作業フォルダーからサーバーを起動するため、bricksentry.yml にはフルパスを指定してください。アプリが uvx を見つけられない場合は、そのフルパスを使ってください(which uvx)。リポジトリを通じて設定を共有するには、claude mcp add -s project ... を実行すると .mcp.json に書き込まれます。Claude Code がリポジトリのルートから起動する場合は、相対パスを使用できます。設定ファイルがまだない場合は、uvx --from bricksentry bricksentry init を実行すると、初期設定ファイルが作成されます。
pip で bricksentry をすでにインストールしている場合は、pip install "bricksentry[mcp,databricks]" を実行し、代わりに bricksentry mcp --config /full/path/to/bricksentry.yml を実行してください。リモートエージェント向けには --transport streamable-http を追加します。
bricksentry は、io.github.bricksentry/bricksentry として公式 MCP Registry に登録されています。
| ツール | エージェントが取得できる情報 |
|---|---|
whats_downstream(table, depth, columns?) | オーナーとタグを含む下流アセットです。編集する前に呼び出してください。変更する列を渡すと、その列が影響を与える下流の列とそのタグを確認できます。 |
rollback_plan(table) | 復元用 SQL です。変更を加える前に取得してください。 |
preview_write(sql, target, keys?) | 使い捨ての浅いクローンに対して書き込みを 1 回実行します。本番環境には決して書き込まず、差分と判定結果を返します。 |
assess_change(tables, candidates?, pr?) | 本番環境と変更によって構築された候補を比較し、リネージとポリシーも確認します。判定結果と id を返します。 |
explain_diff(assessment_id or table) | 平易な言葉での要約です。 |
safe_to_ship(assessment_id) | safe_to_ship、その理由、および従うべき明示的な next_step を返します。 |
エージェント向けに設計されています。
- 判定に LLM は使いません。
policy.ymlのルールによって決定されるため、同じ変更には常に同じ回答が返ります。 - デフォルトでは読み取り専用です。 書き込みを行うのは
preview_writeだけで、サンドボックスクローンに対してのみ実行されます。ターゲットがクローンである単一の INSERT / MERGE / UPDATE / DELETE / CREATE OR REPLACE を受け付けますが、DROP、TRUNCATE、ALTER、GRANT、および複数のステートメントは拒否します。 - エラーは
{"error": ...}として返されるため、エージェントはクラッシュせずに処理を復旧できます。 - コストに上限があります。 決定論的なハッシュサンプリング(
sample_pct)、サンプル数の上限、深さと遡及期間を制限したリネージを使用します。サンプルを保護するためにテーブル全体のチェックサムも確認します。サンプルに変更が見つからなくてもテーブル間に差異がある場合は、すべての行を対象に差分を再確認するため、1 行だけの変更も見逃しません。 - 評価結果は JSON として保存されます(デフォルトは
~/.bricksentry/assessments)。そのため、別プロセスや新しいSentryからでもexplain_diffとsafe_to_shipを使用できます。
同じツールは bricksentry.agent_tools の通常の Python 関数としても提供されているため、MCP を使わずに LangGraph、OpenAI Agents SDK、または Databricks Agent Framework から利用できます。
一連の流れ全体を確認するには、bricksentry demo を実行してください(このページの先頭を参照)。bricksentry demo --report report.md を実行すると、レビュー担当者に表示されるプルリクエストのコメントも書き出されます。
ワークスペース内でホストする(Databricks Apps)
MCP サーバーを Databricks App として実行すると、ワークスペース内のすべてのエージェントが HTTPS 経由でアクセスできます。管理が必要なトークンはありません。アプリのサービスプリンシパルとして実行され、読み取り可能なデータは Unity Catalog の権限によって決まります。deploy/databricks-app は、2 つのコマンドでデプロイできる、そのまま使えるアプリ(app.yaml、Asset Bundle、権限設定)です。
databricks bundle deploy --var warehouse_id=<your-sql-warehouse-id>
databricks bundle run bricksentry_mcp
エージェントは https://<app-url>/mcp に接続します。このキットは --read-only を指定してサーバーを起動するため、preview_write は含まれず、アプリがデータを書き込むことはありません。それ以外のホストでは、bricksentry mcp --transport streamable-http --host 0.0.0.0 --port 8000 を実行すると、同じエンドポイントが提供されます。Unity Catalog の MCP Services は Databricks の外部でホストされるサーバー向けです。そのため、Databricks 内で bricksentry を実行するには Databricks App をおすすめします。詳しくはキットの READMEをご覧ください。
データエンジニア向け:CLI と CI
bricksentry init                                        # starter bricksentry.yml + policy.yml
bricksentry init --policy finance                       # ...or start from a policy template
bricksentry policies                                    # list the policy templates
bricksentry impact main.sales.orders                    # blast radius
bricksentry diff main.sales.orders main.sales_pr_42.orders
bricksentry preview main.sales.orders --sql "MERGE INTO {{target}} t USING updates u ON t.order_id = u.order_id WHEN MATCHED THEN UPDATE SET *"
bricksentry assess --from-git origin/main --pr 42 --format markdown --fail-on needs_human
bricksentry rollback main.sales.orders
終了コード:--fail-on 未満の場合は 0、同値以上の場合は 1、設定エラーの場合は 2 です。
GitHub Actions の場合。 たとえば Databricks Asset Bundle の ci ターゲットを使って、PR のパイプラインを PR ごとのスキーマにビルドし、次を追加します。
- run: pip install "bricksentry[databricks]"
- run: >
    bricksentry assess
    --from-git origin/${{ github.base_ref }}
    --pr ${{ github.event.pull_request.number }}
    --comment --output bricksentry-report.md
    --fail-on needs_human
  env:
    GITHUB_TOKEN: ${{ github.token }}
    DATABRICKS_HOST: ${{ secrets.DATABRICKS_HOST }}
    DATABRICKS_CLIENT_ID: ${{ secrets.DATABRICKS_CLIENT_ID }}
    DATABRICKS_CLIENT_SECRET: ${{ secrets.DATABRICKS_CLIENT_SECRET }}
    DATABRICKS_WAREHOUSE_ID: ${{ secrets.DATABRICKS_WAREHOUSE_ID }}
PR 内のファイルから変更されたテーブルを検出し、デモのファンアウトバグに対する次の例のように、PR コメントを 1 件投稿または更新します。
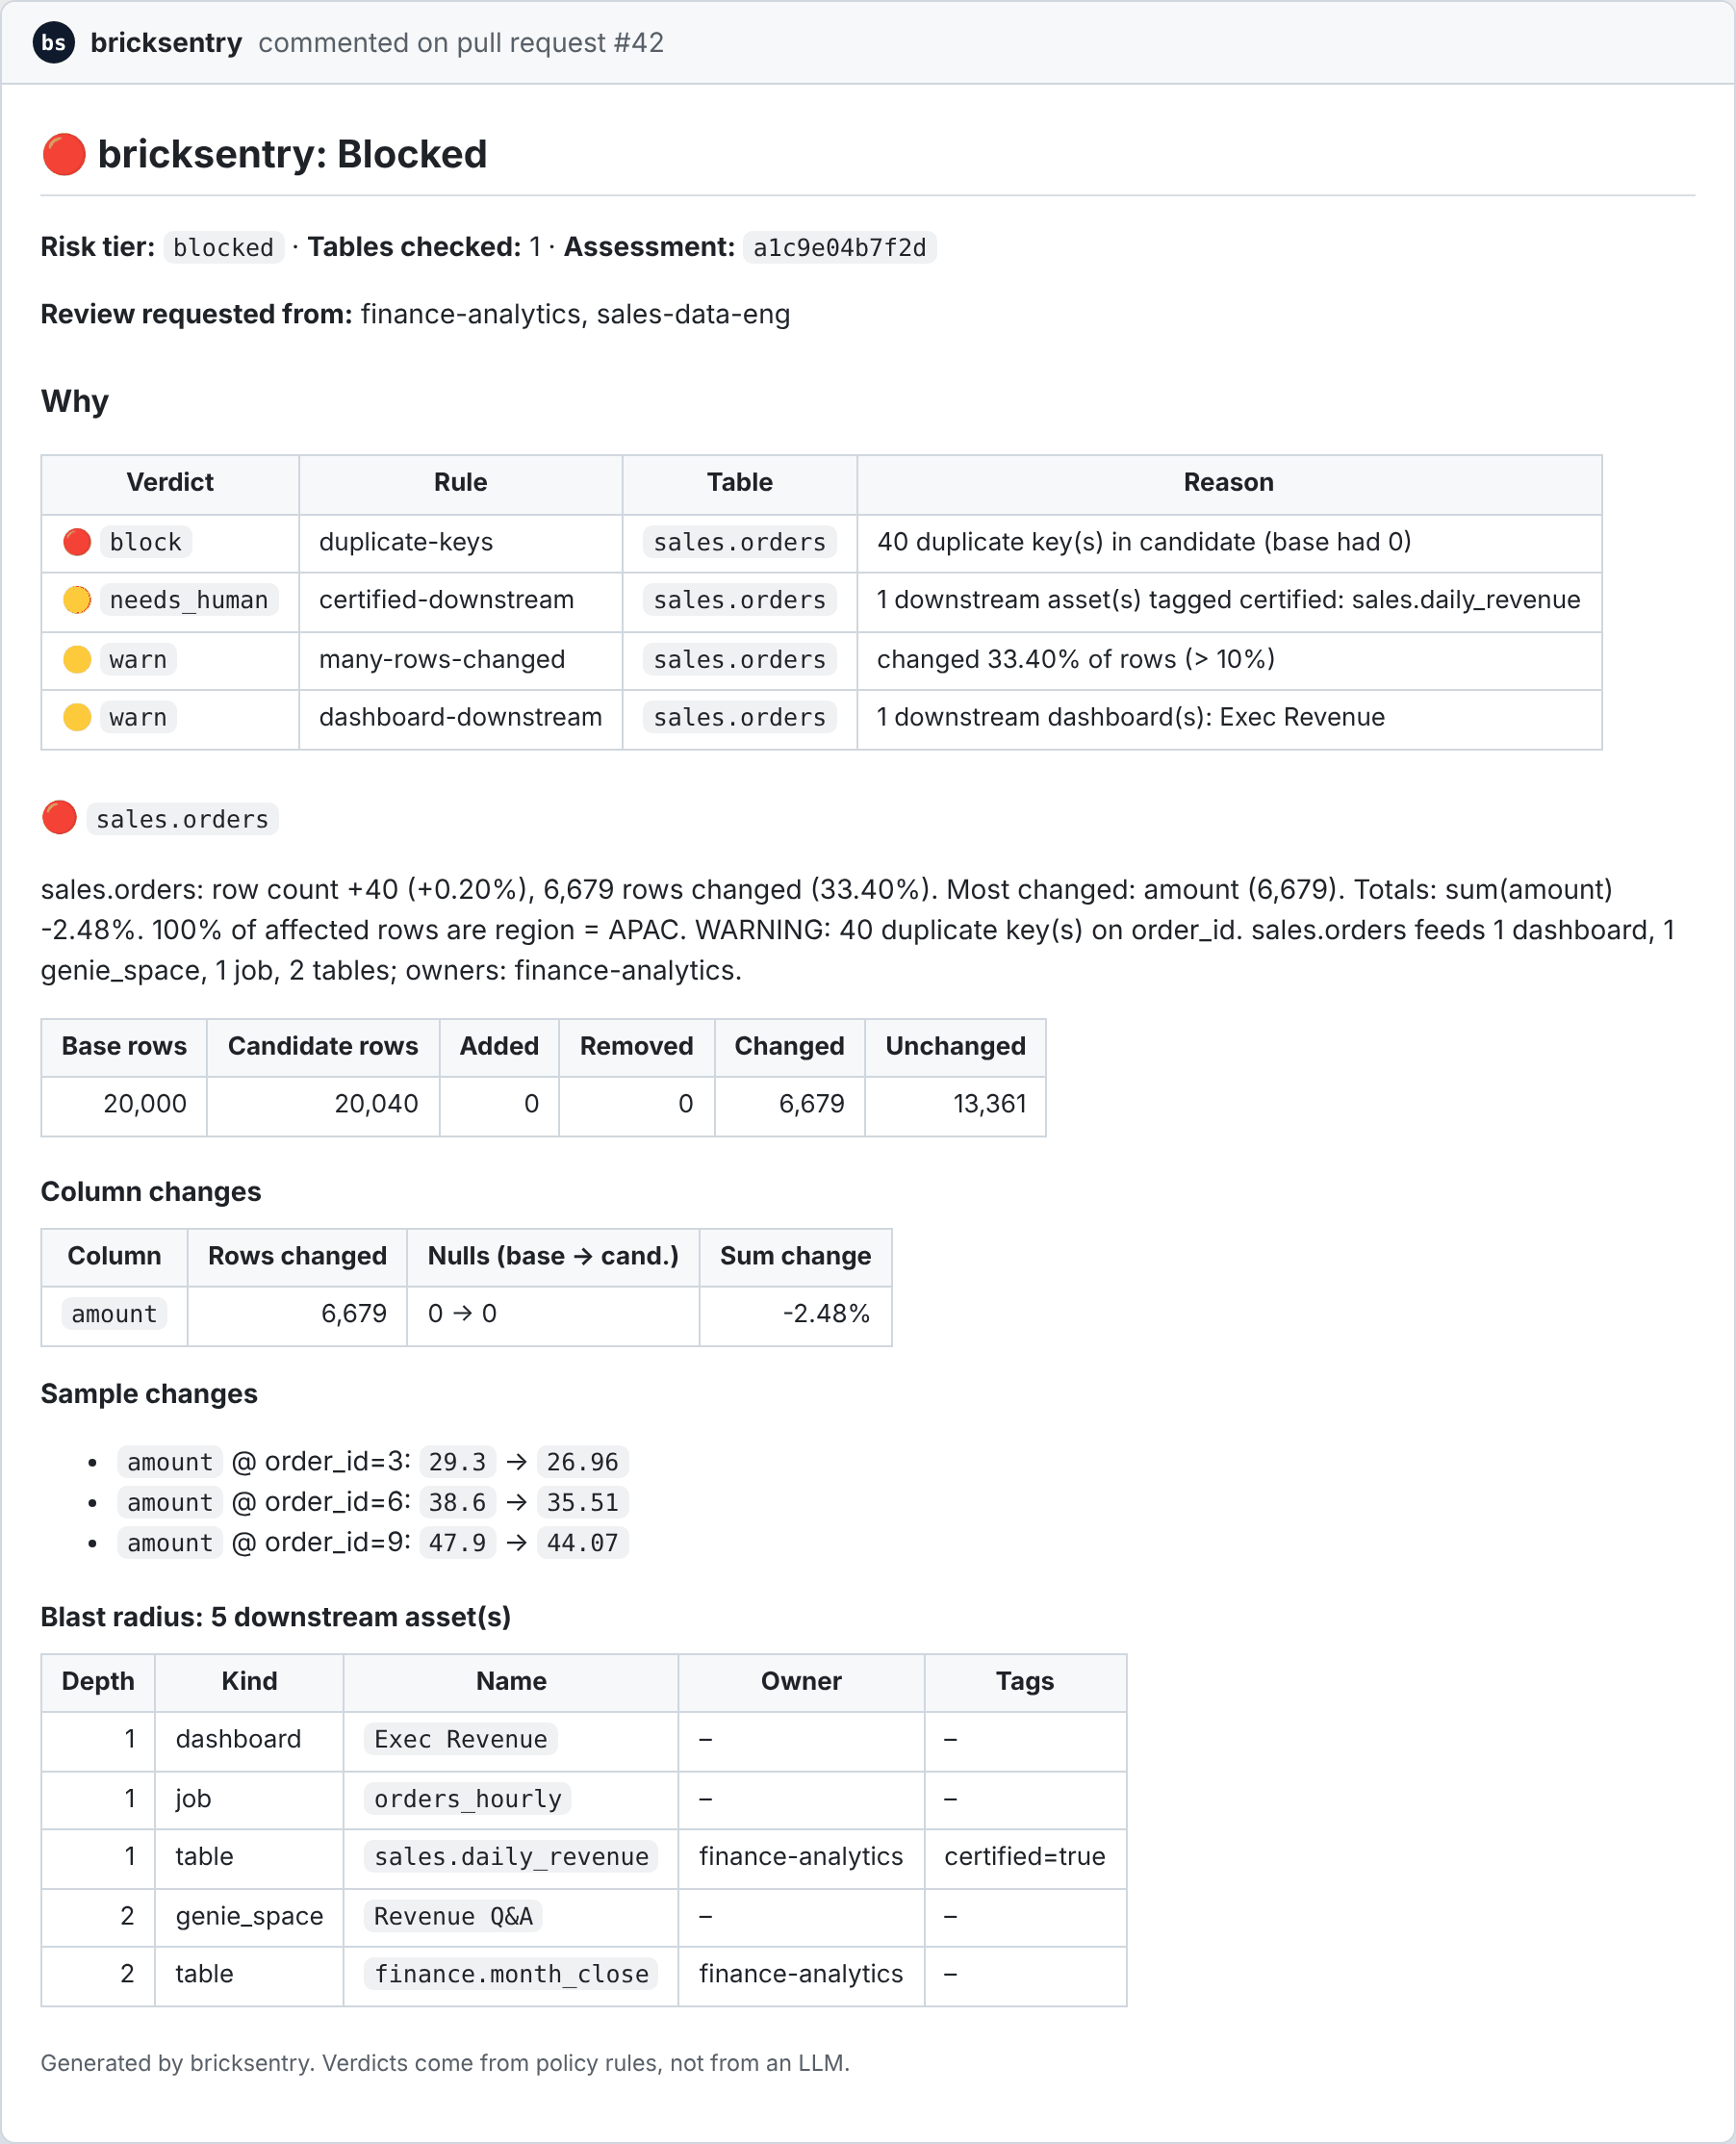
fetch-depth: 0 を指定してチェックアウトし、ジョブに pull-requests: write 権限を付与してください。
または、レポートをジョブのサマリーにも書き込む、同梱の GitHub Action を使います。
- uses: bricksentry/[email protected]
  with:
    config: bricksentry.yml
    fail-on: needs_human
.github/workflows/bricksentry.yml にコピーして使える、完全なワークフローです。
name: bricksentry
on: pull_request

permissions:
  contents: read
  pull-requests: write

jobs:
  check-data:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      # Build this PR's version of your pipeline into a per-PR schema first,
      # for example: databricks bundle deploy -t ci && databricks bundle run -t ci
      - uses: bricksentry/[email protected]
        with:
          config: bricksentry.yml
          fail-on: needs_human
          slack-webhook: ${{ secrets.SLACK_WEBHOOK_URL }}    # optional
          teams-webhook: ${{ secrets.TEAMS_WEBHOOK_URL }}    # optional
        env:
          DATABRICKS_HOST: ${{ secrets.DATABRICKS_HOST }}
          DATABRICKS_CLIENT_ID: ${{ secrets.DATABRICKS_CLIENT_ID }}
          DATABRICKS_CLIENT_SECRET: ${{ secrets.DATABRICKS_CLIENT_SECRET }}
          DATABRICKS_WAREHOUSE_ID: ${{ secrets.DATABRICKS_WAREHOUSE_ID }}
チェックを必須にするには、ブランチ保護ルールでこのジョブを必須のステータスチェックに設定します。そうすると、作成者またはエージェントの判断にかかわらず、needs_human または block の判定がマージを停止します。
Slack と Teams のアラート
判定が needs_human 以上の場合、bricksentry は判定、該当したルール、レビュー担当者、チェックの実行場所へのリンクを含む短いアラートを投稿できます。
# bricksentry.yml
notify:
  on: needs_human                         # alert at this verdict or worse
  slack_webhook: env:SLACK_WEBHOOK_URL    # Slack incoming webhook
  teams_webhook: env:TEAMS_WEBHOOK_URL    # Teams Workflows "webhook request" URL
  mentions:                               # optional: @-mention reviewers in Slack
    finance-analytics: S0123ABCD          # a user group id (starts with S)
    [email protected]: U0456EFGH              # a member id (starts with U)
その後、1 つのコマンドでセットアップを確認できます。内容が明確に示されたサンプルアラートを送信し、テーブルは読み取りません。
bricksentry test-alert
- Webhook URL は秘密にしてください。 CI のシークレットまたは環境変数に設定してください(
BRICKSENTRY_SLACK_WEBHOOKとBRICKSENTRY_TEAMS_WEBHOOKも使えます)。ファイルには記載しないでください。ファイル内に URL が見つかった場合、bricksentry が警告します。 - 実行へのリンク。 GitHub Actions では、アラートに PR または実行へのリンクが含まれます。Databricks ジョブでは、ジョブの実行へのリンクが含まれます。それ以外の場合は、
BRICKSENTRY_RUN_URL(またはnotify.run_url)を設定してください。 - メンション。 オーナーは Unity Catalog から取得します。
mentionsで Slack ID に対応付けると、アラートでそのユーザーに @メンションします。対応付けられていないオーナーはテキストで表示されます。Slack で ID を確認するには、ユーザーのプロフィールまたはユーザーグループのメニューから「Copy member ID」/「Copy group ID」を選択してください。 - 実行を中断することはありません。 Webhook が設定されている場合、
assessとpreviewは自動的にアラートを送信します(--no-notifyで無効化できます)。Python ではsentry.notify(assessment)を呼び出します。Slack または Teams が混み合っている場合、アラートは 1 回再試行されます。失敗時は Webhook URL を明かさずに報告され、判定は常にそのままです。
Python API
from bricksentry import Sentry

s = Sentry()                                   # reads ./bricksentry.yml
a = s.assess(["main.sales.orders"], pr="42")
print(a.verdict, a.notify)
print(a.tables[0].summary)

s.preview_write("DELETE FROM main.sales.orders WHERE status = 'test'", "main.sales.orders")
設定
backend: {type: databricks, warehouse_id: abc123}      # auth: standard Databricks SDK chain
sandbox_schema: main.bricksentry_sandbox
candidate_pattern: "{catalog}.{schema}_pr_{pr}.{table}"
sample_pct: 10                                         # sample_guard re-checks the whole table (on by default)
assessment_store: ~/.bricksentry/assessments           # or false to keep assessments in memory
lineage: {type: databricks, depth: 3, lookback_days: 90, column_depth: 2}   # also: exclude, exclude_dropped
tables:
  main.sales.orders:
    keys: [order_id]
    segment_by: [region]
    measures: [amount, quantity]   # totals worth checking (see below)
    paths: ["src/pipelines/orders/**", "resources/orders_job.yml"]
policy: policy.yml            # or builtin:<template>, see "Policy templates" below
Unity Catalog を使用しない場合(ローカルでの DuckDB 作業、テスト、その他のプラットフォームなど)は、代わりに設定でリネージを指定します。エッジは、あるテーブルを読み取るテーブルに対応付けます。列のエッジとタグは任意です。
lineage:
  type: static
  edges:
    main.sales.orders: [main.sales.daily_revenue, "dashboard:Revenue Overview", "job:finance_close"]
  owners:
    main.sales.daily_revenue: finance-team
  tags:
    main.sales.daily_revenue: {certified: "true"}
  column_edges:                       # "table.column" -> downstream "table.column"s
    main.sales.orders.amount: [main.sales.daily_revenue.revenue]
  column_tags:                        # table -> column -> tags
    main.sales.orders: {customer_email: {pii: ""}}
タイプミスは検出されます。sample_pc のような未知のキーがあると、黙って無視されるのではなく、正しいキーを示す警告(did you mean 'sample_pct'?)が表示されます。
チェック対象の合計値。 sum_change_pct_gt ルールとサマリーでは、メジャーが対象になります。デフォルトでは、キーと、名前が ID、コード、年などの日付部分、座標、評価、スコア、レートに見える列を除く、すべての数値列が対象です(sum(established_year) が 10% 減少しても、行が削除されたことを示すだけです)。テーブルごとに measures を指定すると対象を選べます。また、measures: all を設定すると、すべての数値列がチェックされます。列を指定するルール(when: {column: rating, sum_change_pct_gt: 1})では、その列が必ずチェックされます。
ポリシーの例
重大度ごとにルールを 1 つずつ設けた、小規模な policy.yml です。デフォルトは pass です。どのルールにも一致しない変更には、この判定が適用されます。
default: pass                       # no rule matched -> pass
notify_owners_on: needs_human       # tag downstream owners from this level up

rules:
  - name: type-change               # a column changed type -> warn
    when: {column_type_changed: true}
    then: warn

  - name: revenue-moved             # total revenue moved more than 2% -> a human signs off
    when: {column: amount, sum_change_pct_gt: 2}
    then: needs_human

  - name: duplicate-keys            # a join fanned out and duplicated keys -> block the PR
    when: {duplicate_keys: true}
    then: block
| 変更内容 | 判定 |
|---|---|
| フィルターの修正で 40 行が変わり、それ以外は変更なし | pass |
order_date が STRING から DATE に変更 | warn |
価格の修正で SUM(amount) が 3.1% 変動 | needs_human |
新しい結合で order_id が 40 件重複 | block |
複数のルールに一致した場合は、最も重大な判定が優先されます。完全なスターターポリシーは examples/databricks/policy.yml にあり、bricksentry init で作成できます。
ポリシーテンプレート
ポリシーを一から作成する代わりに、用意されたポリシーを使って始められます。
| テンプレート | 用途 |
|---|---|
agent-safe | AI エージェントが作成した変更向け:小規模で問題のない変更以外は、人による確認に回します |
default | バランス型:キーの重複をブロックし、行の減少、列の削除、PII、下流の認定済みテーブルは人による確認に回します |
strict | 本番環境の重要なパイプライン向け:小さな変更にも人による確認を求め、チェックの失敗はブロックします |
pii | 個人データを含むテーブル向け:pii タグ付きのテーブル、またはそこにデータを供給するテーブルへの変更は、人による確認が必要です |
certified | ダッシュボードや AI が利用する認定済みテーブルまたはゴールドテーブル向け |
finance | 収益や金額を扱うテーブル向け:合計値の変動を黙って見過ごさず、二重計上をブロックします |
policy: builtin:finance のように直接指定するか、bricksentry init --policy finance で編集可能なコピーを作成します。bricksentry policies finance を実行すると、ポリシーが表示されます。タグは Unity Catalog から取得するため、これらのテンプレートを適用するには、テーブルに pii または certified のタグを付けてください。
ポリシー条件
table(glob)・tag・downstream_tag・downstream_kind・downstream_count_gt・removed_pct_gt・added_pct_gt・changed_pct_gt・row_count_change_pct_gt・row_count_drop_pct_gt・column_removed・column_added・column_type_changed・duplicate_keys・null_keys・sum_change_pct_gt / null_increase_gt(column を指定可能)・changed_column(glob)・changed_column_tag・downstream_column_tag・any_change・diff_error・lineage_error
列の条件では、変更が加えられた列(値の変更、新しい NULL、削除または型の変更)のみを調べます。changed_column_tag: pii は、そのいずれかの列に Unity Catalog で pii タグが付いている場合に一致します。また、downstream_column_tag: certified は、lineage.column_depth ホップ(デフォルトは 2、0 で無効化)まで system.access.column_lineage をたどり、そのいずれかの列が certified タグ付きの列にデータを供給する場合に一致します。デフォルトポリシーでは、pii 列が変更されると人による確認を求めます。strict、agent-safe、certified でも、認定済み列にデータを供給する変更が対象になります。
when 内のすべての条件を満たす必要があります。一致するルールのうち、最も重大なものが判定を決定します。未知の条件は読み込み時に拒否されるため、タイプミスでルールが黙って無効になることはありません。
Databricks で必要な権限
- SQL ウェアハウスに対する
CAN USE。 - 評価するテーブルとその候補に対する
SELECT。 system.access.table_lineage(列レベルの影響を調べる場合はsystem.access.column_lineageも)と、所有者、テーブルタグ、列タグを取得するためのsystem.information_schemaに対するSELECT。リネージへのアクセス権がなくても bricksentry は差分を比較し、推測する代わりにlineage-unavailable警告(影響範囲は不明)を追加します。preview_write用のsandbox_schemaに対するCREATE TABLE。
既知の制限事項(v0.1.x)
- リネージは実行時に記録されます。 新しいテーブルには、まだ下流の履歴がありません。Unity Catalog は RDD 操作を記録せず、UDF では列レベルのマッピングが見えなくなります。列リネージにはソースからターゲットへの派生が記録されるため、フィルターまたは結合でのみ使用される列は表示されない場合があります。
- キーが必要です。 安定したキーのないテーブルは、まだ行単位で差分を比較できません(集計プロファイルモードを計画中です)。
- 変更されたテーブルの検出には、設定のパスグロブを使用します。 Asset Bundles の解析にはまだ対応していません。
- これまでに検証した Databricks ワークスペースは 1 つのみです(サーバーレス、2026 年 11 月、200 万行のテーブルで 0.1.4 を使用)。リネージ、Delta のロールバック計画、浅いクローンでのプレビュー、すべての判定レベル、変更行が 1 行だけでも検出するサンプリングガードを検証しました。自動テストでは DuckDB とモック SDK を使用しているため、お使いの環境で動作が異なる場合は、issue を作成してください。
ロードマップ
最優先事項:より多くのワークスペースでの検証です。 クラシックおよびサーバーレスコンピュート、AWS、Azure、GCP、システムテーブルへのアクセスが制限されたワークスペースが対象です。クイックスタートノートブックを実行した場合は、動作したかどうかにかかわらず、結果を共有してください。
次の予定:dbt のサポート。これにより、Databricks 上の dbt モデルでも同じ差分、影響範囲、判定を利用できます(0.2 で予定) · テーブルの自動検出に向けた Asset Bundle の解析 · キーのないテーブル向けの集計差分 · 判定への Lakeflow の期待値の組み込み · スケジュールされたドリフトチェックを行う bricksentry watch · Databricks App UI。
コントリビューション
実際のパイプラインに関するバグ報告が最も役立ちます。CONTRIBUTING.md を参照してください。脆弱性を非公開で報告する場合は、SECURITY.md をご覧ください。
ライセンス
Apache-2.0。Brahma - Databricks Champion が作成、保守しています。
商標
bricksentry は独立したオープンソースプロジェクトです。Databricks, Inc. または Functional Software, Inc.(Sentry)と提携、承認、後援関係にはありません。Databricks、Unity Catalog、Lakeflow は Databricks, Inc. の商標です。Delta Lake は Linux Foundation の商標であり、Apache Spark と PySpark は Apache Software Foundation の商標です。その他の名称は、それぞれの所有者の商標であり、互換性を説明する目的でのみ使用しています。ありがとうございます。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。