memdex について
memdexは、セッションをまたいで同じリポジトリを扱うAIコーディングエージェント向けのローカル共有メモリMCPサーバーです。要約、メモ、タスクの引き継ぎ、エージェント間メッセージをSQLiteファイルに保存し、クラウドを必要としません。
主な機能
- 01内容ハッシュに基づくファイル要約
- 02元ファイルの変更時にメモを通知
- 03エージェント間の編集確保・メッセージ・引き継ぎ
- 04作業とブロッカーを追跡するタスクツリー
- 05対応MCPクライアントの設定CLI
活用シーン
- 01新しいセッションへのプロジェクト情報の引き継ぎ
- 02複数エージェントによる編集の調整
- 03リポジトリのワークツリー間でメモや引き継ぎを共有
MCP 対応
stdio経由でMCPクライアントにプロジェクトメモリと連携ツールを提供します。`memdex connect`は対応クライアントのサーバー設定を書き込み、MCPハンドシェイクを検証できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
翻訳後に原文が更新されています。最新の内容は原文をご確認ください。
memdex
AI コーディングエージェントのための、共有できてトークンを節約するメモリ。
SQLite ファイル 1 つ。依存関係はゼロ。あらゆる MCP クライアントで使えます。Claude Code、Codex、Cursor、DeepSeek が同じ内容を記憶し、互いにやり取りできます。


クイックスタート · 仕組み · ツール · CLI · 設定 · 比較 · FAQ · 한국어
エージェントのセッションは、毎回何もない状態から始まります。同じ 3,000 トークンのファイルを読み直し、同じ検索を繰り返し、同じ落とし穴を再発見します。そのトークンのすべてに料金がかかります。複数のエージェントが 1 台のマシンで作業している場合、互いに学んだことを確認できず、別のエージェントが同じファイルを編集中であることにも気づけません。
memdex は、その両方を解決する小さな MCP サーバーです。
- 一度作成したファイルの要約は、そのファイルの内容が変わるまで有効です。 要約はパスではなく、内容の sha256 をキーにします。次のセッション、あるいは次のエージェントは、3,000 トークンのファイルの代わりに 100 トークンの要約を受け取り、要約が古くなった時点で通知されます。
- メモは古くなったことを把握します。 決定事項、落とし穴、引き継ぎには、その根拠となるファイルが記載されます。それらのファイルが変更されると、メモにフラグが付けられます。
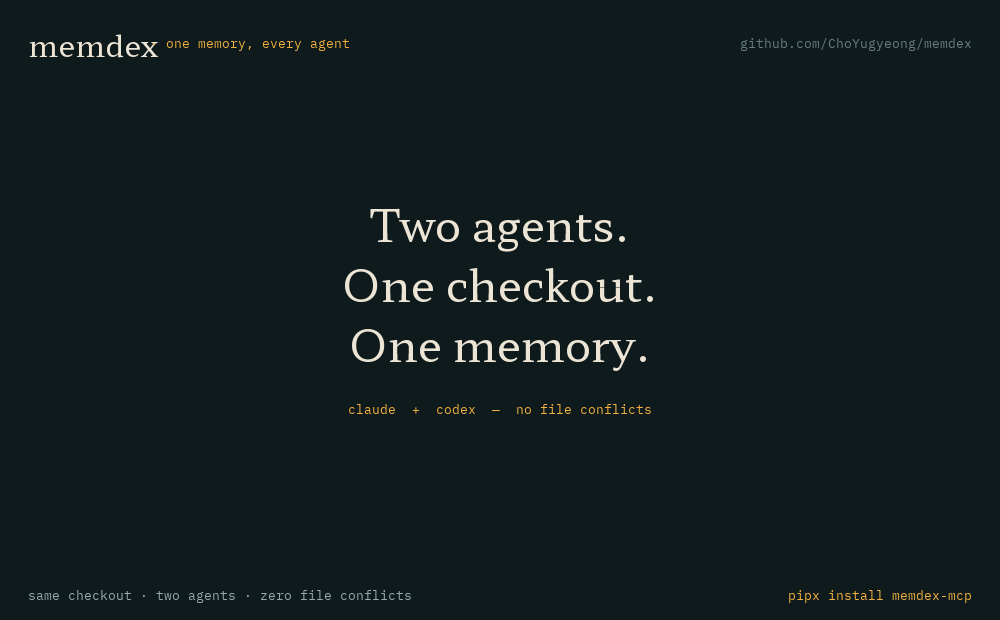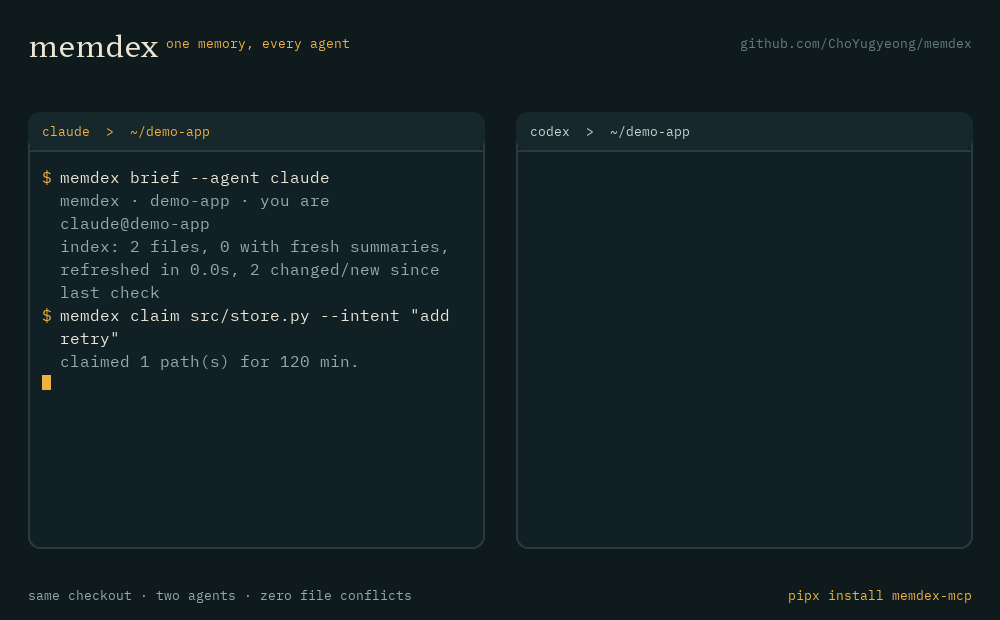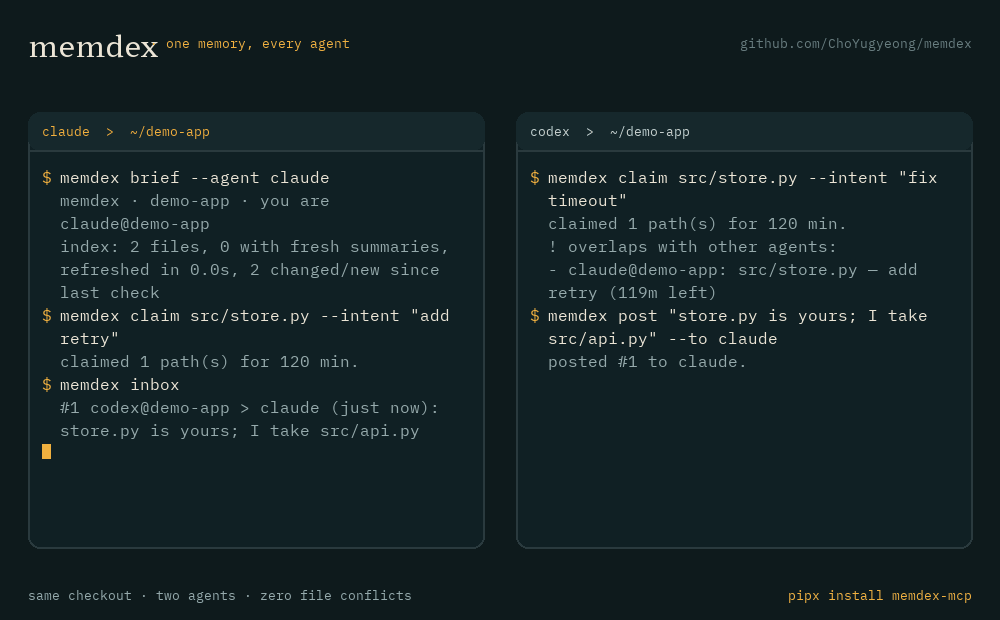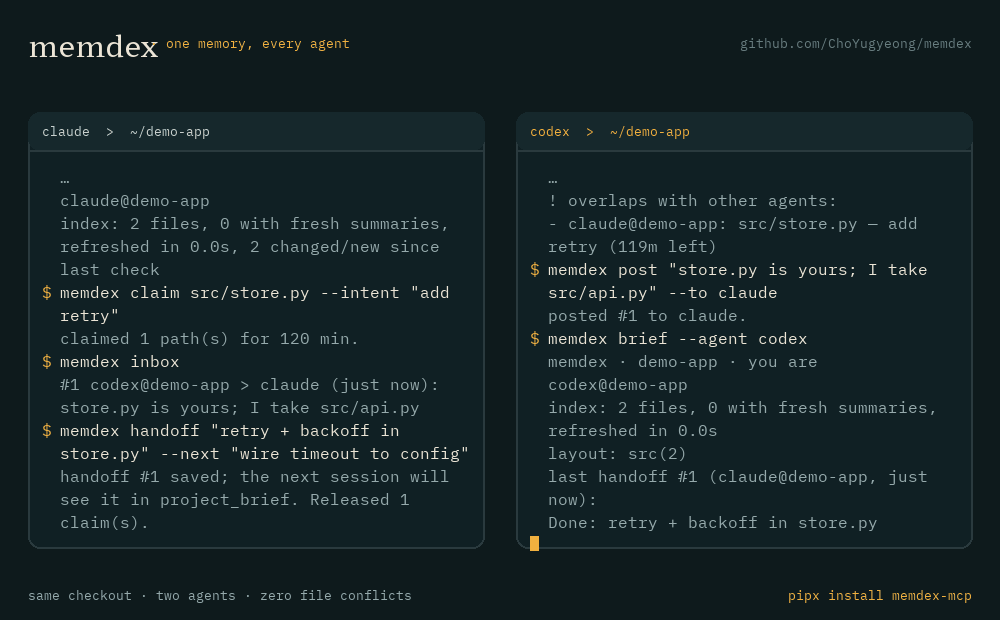
- エージェント同士が連携します。 編集する対象を
claimし、他のエージェントにpostし、自分のinboxを読み、次に作業する人のためにhandoffを残します。リポジトリ内のすべてのワークツリーで、1 つのメモリを共有します。
$ memdex file src/store.py
src/store.py · python · 444 lines · sha 3adeaf13
summary (claude@memdex, 2h ago, matches current content):
SQLite store. Tables: files, summaries (keyed by sha), symbols, notes, messages, claims, fts.
index() skips files whose stat is unchanged. search() fuses FTS5 and embeddings with RRF.
outline: class Store:53; method Store.index:101; method Store.search:280; …
この応答は 1.5 KB です。ファイルは 22 KB あります。生成にモデルは一切使っていません。
公式の MCP Registry では io.github.ChoYugyeong/memdex として、PyPI では memdex-mcp として掲載されています。
実際の 66 ファイルからなるサイトリポジトリで memdex bench を実行すると、すべてのファイルを読む場合は 154,105 トークン、アウトラインの場合は 3,471 トークンと計測されます。エージェントが要約を 1 つも保存する前の時点で、98%の削減です。自分のチェックアウトで memdex bench を実行してみてください。トークン数は chars / 4 による推定値であり、重要なのは比率です。
クイックスタート
pipx install memdex-mcp        # PyPI name is memdex-mcp; the command is `memdex`
memdex connect --agent claude  # write the MCP entry into the agents on this machine
Claude Code(ユーザースコープ、すべてのプロジェクト)— claude CLI が PATH 上にある場合、memdex connect がこの行を実行します。PATH 上にない場合は、この行を表示します。
claude mcp add memdex --scope user -e MEMDEX_AGENT=claude -- memdex serve
設定ファイルを保持するその他すべてのクライアント — Claude Desktop、Cursor、VS Code(GitHub Copilot)、Windsurf、
Zed、Cline、Gemini CLI、Codex CLI:memdex connect は、インストール済みのクライアントをそれぞれ検出し、設定に
mcpServers.memdex(VS Code では servers.memdex と type: stdio、Zed では
context_servers.memdex、Codex では [mcp_servers.memdex])をマージします。ファイルの残りの部分はバイト単位で
そのまま保持し、書き込む前に .bak を保存します。設定フォルダーが存在しないクライアントは未インストールとして報告され、そのままにされます。解析できない設定ファイルも一切変更されません。また、コメント付きの Zed 設定ファイルは、書き換えるとコメントが失われるため、貼り付け用のブロックを表示します。書き込まずにインストール済みおよび設定済みの状態を確認するには --list、書き込み内容を確認するには --dry-run、エントリを削除するには --remove を使います。
--serve-check は、セットアップが正しく完了したかを確認するための機能です。書き込み後、memdex は書き込んだばかりのエントリからサーバーを起動し、MCP で通信します(initialize の後に tools/list を実行します)。これにより、パスの誤り、インタープリターの不足、データベースを開けない問題を、エージェントで発生する前に検出できます。
+ serve-check memdex answered: 13 tools, protocol 2024-11-05
チームスコープ — リポジトリに設定を置くと、クローンした全員が memdex を利用できます。
memdex connect --project # .vscode/mcp.json and .mcp.json, written with a bare `memdex` command
コミットする設定にこのマシンの絶対パスは含められないため、プロジェクトスコープでは command: "memdex" を設定し、チームメイトの PATH から memdex を見つけられるようにする必要があります(pipx install memdex-mcp)。claude CLI が PATH 上にあり、--project を指定すると、CLI が .mcp.json 自体を書き込み(claude mcp add memdex --scope project …)、memdex は VS Code のファイルだけを書き込みます。これにより、1 つのファイルを 2 つのツールが管理することはありません。--no-claude は CLI 全体をスキップし、--client claude-code はその手順だけを実行します。
手動で設定する場合、または memdex が対応していないクライアントの場合:
{ "mcpServers": { "memdex": { "command": "memdex", "args": ["serve"], "env": { "MEMDEX_AGENT": "codex" } } } }
各エージェントにはそれぞれ MEMDEX_AGENT の名前を指定してください。ID は name@checkout になります(例:claude@myrepo-wt)。
memdex config --agent <name> は上記の設定例に加えて、プロジェクトの概要を自動で挿入する、オプションの Claude Code SessionStart フックも表示します。
以上です。サーバーは MCP の initialize 応答で独自の使用手順を送信するため、エージェントは追加のプロンプトなしでワークフロー(概要 → 読み取り前に file_summary → remember → handoff)を把握できます。
仕組み
          agents (Claude Code, Codex, Cursor, DeepSeek, …)
               │ MCP stdio        │ CLI
               ▼                  ▼
        ┌──────────────── memdex ────────────────┐
        │ project_brief · file_summary · where_is │
        │ read_snippet · search · remember        │
        │ handoff · post/inbox · claim            │
        ├─────────────────────────────────────────┤
        │ incremental index   outlines + symbols  │   only files whose size/mtime
        │ (stat → sha256)     (regex/ast, no LLM) │   moved are re-read
        ├─────────────────────────────────────────┤
        │ summaries keyed by sha256               │   valid until content changes
        │ notes with file refs → stale flags      │
        │ messages, cursors, claims (expiring)    │
        ├─────────────────────────────────────────┤
        │ SQLite WAL · FTS5 trigram · vectors     │   ~/.memdex/memdex.db
        └─────────────────────────────────────────┘
| 機能 | 参考にしたもの | |
|---|---|---|
| コンテンツハッシュによる要約キャッシュ | 要約はファイルの sha256 をキーにして保存されます。別のワークツリーやブランチに同じ内容があれば共有され、内容が変わると「要約はまだありません。以前の要約とアウトラインはこちらです」と表示されます。 | コンテンツアドレスストレージ |
| インクリメンタルインデックス | git ls-files(.gitignore を尊重)を実行し、サイズまたは更新日時が変わったファイルだけを読み込みます。800 ファイルのリポジトリなら、約 0.2 秒でインデックスを再作成できます。 | Everything の USN ジャーナル方式 |
| アウトラインとシンボルマップ | 30 以上の言語について、ドキュメント文字列/コメントの冒頭に加え、クラス、関数、行番号を取得します(Python は ast を使用し、それ以外は言語ごとの正規表現を使用します。tree-sitter やパーサーのインストールは不要です)。where_is を使えば、grep を繰り返す必要がありません。 | Serena/リポジトリマップ |
| 読み取り範囲の制限 | read_snippet はファイル全体ではなく、一致箇所または指定行の前後約 256 トークンを返します。 | Kensaku |
| 陳腐化を検知するメモ | remember はメモをファイルに関連付けます。ファイルに変更があると、search と project_brief に「⚠ 変更されました」と表示されます。メモは追記専用(supersedes)なので、同時に書き込んでも互いの内容が上書きされることはありません。 | Basic Memory、mem0 |
| エージェントの調整 | 期限切れと重複に関する警告付きの claim、エージェントごとのカーソルを備えた post/inbox、次のセッションが最初に確認する handoff を提供します。 | — |
| ハイブリッド検索 | FTS5 のトライグラム(韓国語、日本語、中国語に対応。2 文字の語句は LIKE にフォールバック)と、任意で利用できるローカル埋め込みを、逆順位融合で組み合わせます。 | claude-context |
| マシン全体のコンテンツ | Kensaku がインストールされている場合、search は PDF、Office ファイル、スクリーンショットの全文検索、OCR、セマンティック検索の結果も返します。 | Kensaku |
アウトラインに対応している言語:Python、JavaScript/TypeScript、Vue、Svelte、Go、Rust、Java、Kotlin、Scala、 C#、Swift、Dart、C、C++、Ruby、PHP、Lua、GDScript、Elixir、Clojure、Zig、Julia、R、Haskell、Groovy、 Protobuf、GraphQL、SQL、shell、PowerShell、Markdown。
memdex がランキング付けし、忘れる仕組み
増えるだけのメモリーは、メモリーがないのと同じくらい役に立ちません。ブリーフでは、何百ものメモから少数の行を選び出す必要があります。各メモには、ACT-R のベースレベル学習に基づく活性化値が付与されます。これは、使用のたびに t^-0.5 を合計した値です。そのため、先週 5 回読まれたメモは、昨日書かれて一度も参照されていないメモより上位になります。落とし穴と決定には事前値が付与され(無視した場合のコストが高いため)、--importance でメモの順位をさらに上げられます。
このスコアから、次の 3 つの仕組みが導かれます。
- ピン留めコア(
--pin):すべてのセッションで確認する必要がある、少数の事実のための、各ブリーフの先頭にある小さな固定枠です。エージェント自身が記述するシステムプロンプトです。 - 低活性化層:活性化値が −3 を下回ると、メモは保存され検索可能なままですが、ブリーフとデフォルト検索の予算を消費しなくなります。削除されるものはありません。
searchでは引き続き見つかります。活性化は検索の強さです。確認を繰り返し得ているメモは保存の強さを持ち、しばらく必要とされていなくてもブリーフに残ります(Bjork & Bjork 1992)。40 セッションにわたって使われた一方で、今月は使われなかった場合などです。 - 干渉:メモが置き換えられると、そのファイルを共有する残りのメモは、すでにどれかが誤りだと判明したため、順位が少し下がります(検索誘発性忘却、Anderson, Bjork & Bjork 1994)。順位が下がるだけで、非表示にはなりません。
- 再固定化:メモのファイルまたはシンボルが変更されている場合、
noteは⚠ changed sinceを出力し、note(id, "confirm")は参照先を現在のコードに付け直します。確認も使用としてカウントされるため、繰り返し再検証されるメモは順位を維持します。
古さはファイルごとではなく、シンボルごとに追跡されます。Store.claim に関するメモは、その関数が変更されると古くなりますが、同じファイル内のほかの関数が変更されても新鮮なままです。
メモを保存すると、memdex は単語 n-gram に対する 64 ビット SimHash を使って、プロジェクトのアクティブなメモと比較します。距離が 12 ビット以下の場合、重複している可能性のあるメモを示します(「#17 と類似しています — 置き換えてください」)。判断するのはエージェントです。memdex が独自にメモリーを統合することはありません。
ツール
| ツール | タイミング | 得られる情報 |
|---|---|---|
project_brief | セッション開始時 | 直近の引き継ぎ、落とし穴、決定事項、TODO、未読メッセージ、各自の編集対象です。インデックスを更新します。 |
file_summary | ファイルを読む前 | 内容が変わっていなければキャッシュされた要約を、変わっていれば古い要約(古いと表示)と無料の概要を返します。 |
file_summary_save | ファイルを読んだ後 | 内容のハッシュをキーとして、全員向けの 2〜6 行の要約を保存します。 |
where_is | 「X はどこで定義されていますか?」 | path:line kind name に一致する項目を返します。 |
read_snippet | ファイルの一部を読むとき | query または line の周辺にある、範囲を限定した部分を返します。 |
search | 何もない状態から調査を始める前 | メモ、引き継ぎ、要約を検索します。キーワード検索とセマンティック検索に対応し、利用可能な場合は Kensaku の検索結果も返します。 |
remember / note | 見落としやすい情報があるとき | note、decision、pitfall、todo を保存/読み取り/アーカイブします。必要に応じてファイルにリンクできます。 |
handoff | セッション終了時 | 完了事項/次の作業/決定事項/落とし穴を記録し、自分の申告を解除します。 |
post / inbox | ほかのエージェントとの連絡時 | 全体に通知するか、to: "deepseek" などを指定します。inbox は peek を指定しない限り、メッセージを既読にします。 |
claim | 編集前 | N 分間編集するパスを通知し、ほかのエージェントの申告と重複している場合は警告します。 |
12 個のツールスキーマは、リクエストごとに約 1,000 トークンを消費します。応答は短いプレーンテキストです。すべてのバイトがトークンになります。
CLI
シェルのみを使うエージェント、フック、人間向けに、ツールでできることはすべてコマンドとしても実行できます。
memdex brief --agent codex              # start of session
memdex file src/store.py                # cached summary + outline
memdex file src/store.py --summary "…"  # save a summary
memdex snippet src/store.py --query "def index"
memdex where_is index                   # where a symbol is defined
memdex search "locked"
memdex remember pitfall "WAL mode needed" --body "…" --files src/store.py
memdex remember decision "sqlite only" --importance 3 --pin
memdex claim src/store.py --intent "refactor"
memdex claim src/store.py --exclusive  # lock: other agents' claims on it are refused
memdex post "store.py is mine for an hour" --to claude
memdex inbox
memdex note 7                            # read it
memdex note 7 --confirm                 # it still holds: re-stamp its refs, clear the ⚠
memdex note 7 --pin                     # always at the top of the brief
memdex note 7 --archive                 # read a note, or archive it
memdex handoff "Done X" --next "Y" --pitfalls "Z"
memdex index                            # refresh the index for the current project
memdex export --out notes/              # notes as Markdown, one file each
memdex export --sync ../shared          # notes + summaries as JSON, for another machine
memdex merge ../shared                  # apply what the other machine exported (LWW by updated_at)
memdex digest                           # notes that say the same thing, for an agent to consolidate
memdex import                           # read AGENTS.md / CLAUDE.md into notes (cold start)
memdex stats
memdex bench                            # what the outlines save on this repo
memdex prune --dry-run                  # drop index rows of deleted projects
memdex doctor                           # database, schema, project index, optional integrations
memdex doctor --serve-check             # …and start the server to verify the MCP handshake
memdex connect --agent claude           # write the MCP entry into each installed client's config
memdex hook install                     # git pre-commit: refuse commits on a locked file
memdex skills                           # skills this machine's agents share
memdex skills scan                      # (re)read the SKILL.md files, register them
memdex skills show deploy               # print one skill so an agent can follow it
ロックと共有チェックアウト
友好的なエージェント同士ならアドバイザリークレームで十分ですが、git commit は阻止できません。この隔たりを埋めるコマンドが2つあります。
memdex claim src/store.py --exclusive --intent "rewrite the retry loop"
memdex hook install
--exclusive を指定するとクレームがロックになり、別のエージェントがそのパスに対してクレームを行うと拒否され、ロックが有効な間はそのエージェントのコミットも拒否されます。--force を指定するとクレームは記録され、その理由が相手に伝えられます。すべてのクレームには有効期限があるため、セッションが停止しても永久にロックアウトされることはありません。
memdex hook install は .git/hooks/pre-commit(memdex hook pre-commit を呼び出す小さな sh スクリプト)を書き込みます。ステージされたファイルのみをチェックし、ローカルデータベースのみを読み取ります。
$ git commit -m "retry loop"
memdex: commit blocked — these staged files are locked by another agent:
  src/store.py  ←  claude@memdex (rewrite the retry loop, 41m left)
アドバイザリークレームの場合、コミットは引き続き可能で、注記が表示されるだけです。古くなったと分かっているロックに対しては MEMDEX_ALLOW_LOCK=1 git commit … でチェックをスキップでき、hook install の --force は memdex が作成していないフックを置き換えます。
ただし、コミットでは手遅れです。その時点では、すでに編集が行われています。ツール実行前フックを公開するハーネスなら、編集そのものを拒否できます。Claude Code には PreToolUse があります。
memdex hook install --claude            # ~/.claude/settings.json
memdex hook install --claude --project  # ./.claude/settings.json
{"hooks": {"PreToolUse": [{"matcher": "Edit|Write|MultiEdit",
  "hooks": [{"type": "command", "command": "memdex hook pre-edit --agent claude"}]}]}}
このフックは、標準入力から Claude Code の JSON を読み取り、tool_input.file_path をプロジェクト相対パスに変換します。別のエージェントがそのパスを排他的にロックしている場合は、終了コード 2 で終了します(ブロックされ、標準エラー出力がモデルに表示されます)。
blocked: locked by deepseek@memdex (refactor, 40m left) — post to them or claim --force
アドバイザリークレームの場合は注記を表示して編集を許可し、チェックアウト外の編集は無視されます。また、MEMDEX_ALLOW_LOCK=1 でチェックを回避できます。インストーラーは既存の settings.json に設定をマージし(.bak としてバックアップを作成します)、解析できないファイルを書き換えることはありません。memdex config で同じスニペットを表示できます。
ロックは番号付きのリースです。付与されるロックにはすべてフェンシングトークンと、ロック取得時点のファイルの sha が付与されるため、以前のロックと区別できます。古い読み取りに基づいて計算された編集は、変更後の内容を上書きする代わりに拒否されます。
blocked: src/store.py changed since you claimed it (token 7, sha 3adeaf13 → b71f0c92).
Re-read the file, then re-stamp the lock:
  memdex claim src/store.py --exclusive --refresh
--refresh は自分のクレームに新しいトークンと現在の sha を再付与します。新しいロックを取得することも、他者のロックを上書きすることもありません。
自分のリポジトリで測定する
誰もが最初に尋ねるのは、「実際にどれくらい節約できるのか?」ということです。自分で実行してみましょう。
cd your-repo && memdex bench
your-repo: 812 files · 3.4 MB indexed in 0.21s (812 changed)
reading every file whole: ~871,000 tokens
outline instead:          ~96,120 tokens  (89% smaller; 640 files have symbols)
biggest wins (file → outline):
  src/generated/api.ts                            144.0 KB →    1.6 KB  ( 99% smaller)
  src/store.ts                                     22.2 KB →    1.0 KB  ( 95% smaller)
--json を指定すると、スクリプト用に同じ数値が出力されます。トークン数は chars / 4 として推定されます。重要なのは絶対値ではなく比率です。また、エージェントが実際の2〜6行の要約を保存するようになると、file_summary はさらに小さくなります。
メンテナンス
マシン上のすべてのプロジェクトで1つの SQLite ファイルを共有するため、ファイルは大きくなります。memdex prune は、存在しなくなったプロジェクトディレクトリのインデックス行を削除してから VACUUM を実行します。
memdex prune --dry-run     # report only
memdex prune               # drop stale file index, VACUUM
memdex prune --all         # also notes/messages/claims of missing projects (destructive)
設定
| 変数 | デフォルト | 意味 |
|---|---|---|
MEMDEX_AGENT | agent(または MCP クライアントの名前) | このエージェントの名前です。注記、メッセージ、クレームに表示されます。 |
MEMDEX_HOME | ~/.memdex | memdex.db の保存場所です。リポジトリ内に書き込まれることはありません。 |
MEMDEX_PROJECT | 現在のディレクトリ | サーバーをプロジェクト内で起動していない場合のプロジェクトルートです。 |
MEMDEX_EMBED | オフ | ollama:<model> を指定するとセマンティック検索が有効になります。例:ollama:bge-m3(多言語対応)。 |
MEMDEX_OLLAMA_URL | http://localhost:11434 | Ollama エンドポイントです。到達できない場合は、キーワード検索にサイレントフォールバックします。 |
MEMDEX_KENSAKU | PATH 上の kensaku-cli | Kensaku の CLI へのパス、または off です。 |
読み取られないもの: シークレットのように見えるファイル(.env*、*.pem、*.key、*secret*、*credential*、.npmrc、…)、バイナリ、ロックファイル、512 KB を超えるファイル、および git が無視するもの。
プロジェクトの識別方法: git の共通ディレクトリです。リポジトリのすべてのワークツリーで、注記、メッセージ、クレームを共有します。各ワークツリーは、それぞれ独自のファイルインデックスを保持します。
制限事項(導入前にお読みください)
memdex は、自身にできないことを正直に伝えています。docs/LIMITS.md では、以下の各項目について、解決するには何が必要か、また公開されている手法のうち、最も低コストで誠実な解決策は何かを記録しています。
- ベンチマークのベースラインは有利な設定です。
memdex benchは「すべてのファイルを丸ごと読む」方法と「アウトラインを取得する」方法を比較します。実際のエージェントは grep で検索して必要な範囲を読み取るため、削減率は 98% より小さくなります。代わりにmemdex statsは、利用状況を示すシグナル(最新の状態で提供された要約、別のエージェントが読んだメモ、変更後に再確認されたメモ、未読のメモ)を報告します。これが実態を正直に示す数値です。 確実に得られるメリットは、同じファイル、シンボル、落とし穴を誰も二度発見しなくてよいことです。 - マシン間で共有されるものはありません。 SQLite ファイルを 1 つ使い、ローカルでのみ動作します。チーム同期もクラウドも SSO もありません。これは意図的な設計ですが、チームのナレッジベースを置き換えることはできません。
- ロックが適用されるのは、memdex が指示を受けた場所であり、ファイルシステムではありません。
claim(exclusive=true)は他のエージェントによる claim を拒否し、pre-editフック(Claude Code)は編集を拒否し、pre-commit フックはコミットを拒否します。ただし、memdex が認識できない経路からエディターがバイトを書き込むのを止めることはできません。フックのないセッションや、チェックアウトの外部を編集するツールなら、書き込みは可能です。引き続き Git が信頼できる唯一の情報源です。 - 小さなリポジトリには不要な場合があります。 およそ 20 ファイル未満なら、手書きの
AGENTS.mdの方がどのツールよりも低コストです。 - 巨大なチェックアウトで最初に生成される brief は不完全です。 インデックス作成は 1 ファイルあたり約 0.4 ms(20,000 ファイルで約 8 s)ですが、新しいクローンを初めて読み込む際は、Windows ではウイルス対策ソフトが新しいファイルを 1 つずつスキャンするため、さらに時間がかかります。そのため brief は、呼び出しごとに最大
INDEX_BUDGET(2,000)ファイルまでインデックス化し、残りの数を表示します。次の brief で続きが処理されます。memdex indexに上限はなく、MEMDEX_INDEX_BUDGET=0で上限を解除できます。memdex briefが 1 回のバッチを超えてブロックすることはありません。 - まだ開発初期です。 メンテナーは 1 人です。スキーマ v5 は以前のすべてのバージョンからのインプレース移行に対応しています。新しいバージョンの memdex で書き込まれたデータベースは、サイレントに破損するのではなく、拒否されます。未完成な部分があることをご了承ください。
- アウトラインの解析はセマンティックではなく、正規表現レベルです。 Python では
astを使いますが、それ以外は言語ごとの正規表現を使います。一般的なコードでは良好な結果が得られますが、珍しい構文では見落としが生じることがあります。where_isは、それでも部分文字列検索にフォールバックします。
他のツールとの比較
memdex は意図的に小規模に作られています。以下のツールは、memdex が目指していない用途で優れた機能を提供しており、いくつかは memdex の着想源にもなりました。
| 主な用途 | 依存関係 | 関係 | |
|---|---|---|---|
| memdex | セッション間・エージェント間のメモリ:コンテンツハッシュによる要約、陳腐化を考慮したメモ、連携 | なし | — |
| Serena | 言語サーバーを使った高精度なシンボルのナビゲーションと編集 | 言語ごとの LSP サーバー | 両方を併用してください。Serena は編集に、memdex はメモリに使います。memdex の where_is は、正規表現レベルの代替機能です。 |
| Basic Memory | メモのグラフを備えた Markdown ナレッジベース | Python パッケージ、プロジェクト内の Markdown ファイル | memdex はメモをリポジトリの外部に保管し、ファイルハッシュと関連付けます。 |
| mem0 | ホスト型またはセルフホスト可能な、LLM アプリ向けのメモリレイヤー | ベクトル DB/LLM | memdex はローカル専用で、1 台のマシン上で動作するコーディングエージェントを対象としています。 |
| claude-context | コードベースのベクトル検索 | Milvus/Zilliz、埋め込み API | memdex はメモと要約を検索します。コード検索はキーワードとシンボルを使い、必要に応じて Ollama による埋め込みも利用できます。 |
| Kensaku | 人間とエージェント向けのデスクトップ検索:ファイル名、PDF/Office のテキスト、OCR、セマンティック検索 | Rust 製デスクトップアプリ | 互いに補完する関係です。memdex は Kensaku と連携し、マシン全体のコンテンツ検索を実現します。 |
FAQ
データがマシンの外に送信されますか? いいえ。SQLite ファイル、ローカルのサブプロセス、任意のローカル Ollama のみです。テレメトリーはありません。
要約を書くのは誰ですか? エージェントが、新しい要約のないファイルを読み込むときに書きます。サーバーの
指示では、2~6 行で書くよう求めています。自分で書くこともできます:memdex file path --summary "…"。
2 つのエージェントが同じファイルを編集するとどうなりますか? claim は警告を出しますが、ロックはしません。memdex は調整を行いますが、git に代わるものではありません。
コンテキストのコストはどれくらいですか? リクエストごとにツールスキーマで約 1,000 トークン、project_brief で数百トークンです(上限は 4,000 文字です。memdex brief --max-chars 0 ですべて表示できます)。
ファイルを再読み込みせずに済む最初の機会で、コストを回収できます。
何かが動きません。何を実行すればよいですか? memdex doctor です。データベースのパス、サイズ、スキーマバージョン、書き込み可能かどうか、現在のプロジェクトがインデックス化されているか、インストール済みエージェントのうちどれに MCP エントリがあるか、どの任意の連携機能が有効かを報告します。--serve-check を追加すると、エージェントと同じ方法でサーバーを起動して MCP で通信するため、「インストール済みだが起動できない」状態が謎のままにならず、✗ として表示されます:
✓ serve-check memdex answered: 13 tools, protocol 2024-11-05
メモリを確認または編集できますか? memdex export を実行すると、すべてのメモが Markdown ファイルとして書き出されます。データベースは通常の SQLite です。最初からやり直すには ~/.memdex を削除してください。
なぜベクトルデータベースだけを使わないのですか? コードでは埋め込みより正確な名前が有効です。メモを曖昧に思い出す場合には埋め込みが役立ちます。memdex はデフォルトでキーワードとシンボルを使い、必要に応じてベクトルを追加します。
ブランド
アイデンティティは Ledger Ribbon です。Hahmlet で書かれた、ファイルに残されたしおり。夜の台帳のインクに、琥珀色の一本線を添えています。
- ロゴ:
logo.svg· ダーク背景:logo-on-dark.svg· シンボル:symbol.svg - 色:Ledger Ink
#0e1a1c· Lamp Amber#f0b03f· Bone#ece5d6 - 書体:Hahmlet(ディスプレイ) · Gothic A1(テキスト) · Nanum Gothic Coding(等幅) — すべて OFL 1.1
- トークン:
tokens.css· ガイドライン:memdex-guidelines.pdf(13 ページ) ·docs/brand/にあるメモ
コントリビューション
git clone https://github.com/ChoYugyeong/memdex && cd memdex
pip install -e .
python -m unittest discover tests     # 165 tests, ~17 s, spawns real processes for the concurrency suite
基本ルールは簡潔です。ランタイム依存関係を追加しないこと、ツールの説明は簡潔に保つこと(リクエストごとにトークンを消費します)、すべてのアウトライン正規表現でグループ 1 にシンボル名をキャプチャすることです。CONTRIBUTING.md を参照してください。
memdex は Claude Code と DeepSeek が同じチェックアウトで作業し、memdex 自体を通じて連携しながら構築しました。
ライセンス
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。