Cluefinch MCP について
Cluefinch MCPは、設定したSearXNGインスタンスで検索する、AIエージェント向けのローカル優先ウェブ調査サーバーです。ページ取得、リンクのたどり直し、複数ソースの収集に加え、長文の段階的な読み込みに対応します。
主な機能
- 01SearXNGによる検索
- 02ウェブページの取得と整形
- 03長いページの段階的な読み込み
- 04ソース内リンクのナビゲーション
- 05複数ソースの収集と重複排除
- 06収集時の不足情報の報告
活用シーン
- 01言語やドメインでウェブソースを絞り込む
- 02長文の必要な箇所を読む
- 03ドキュメントのリンクやページ送りをたどる
- 04複数のURLやクエリから情報を集める
MCP 対応
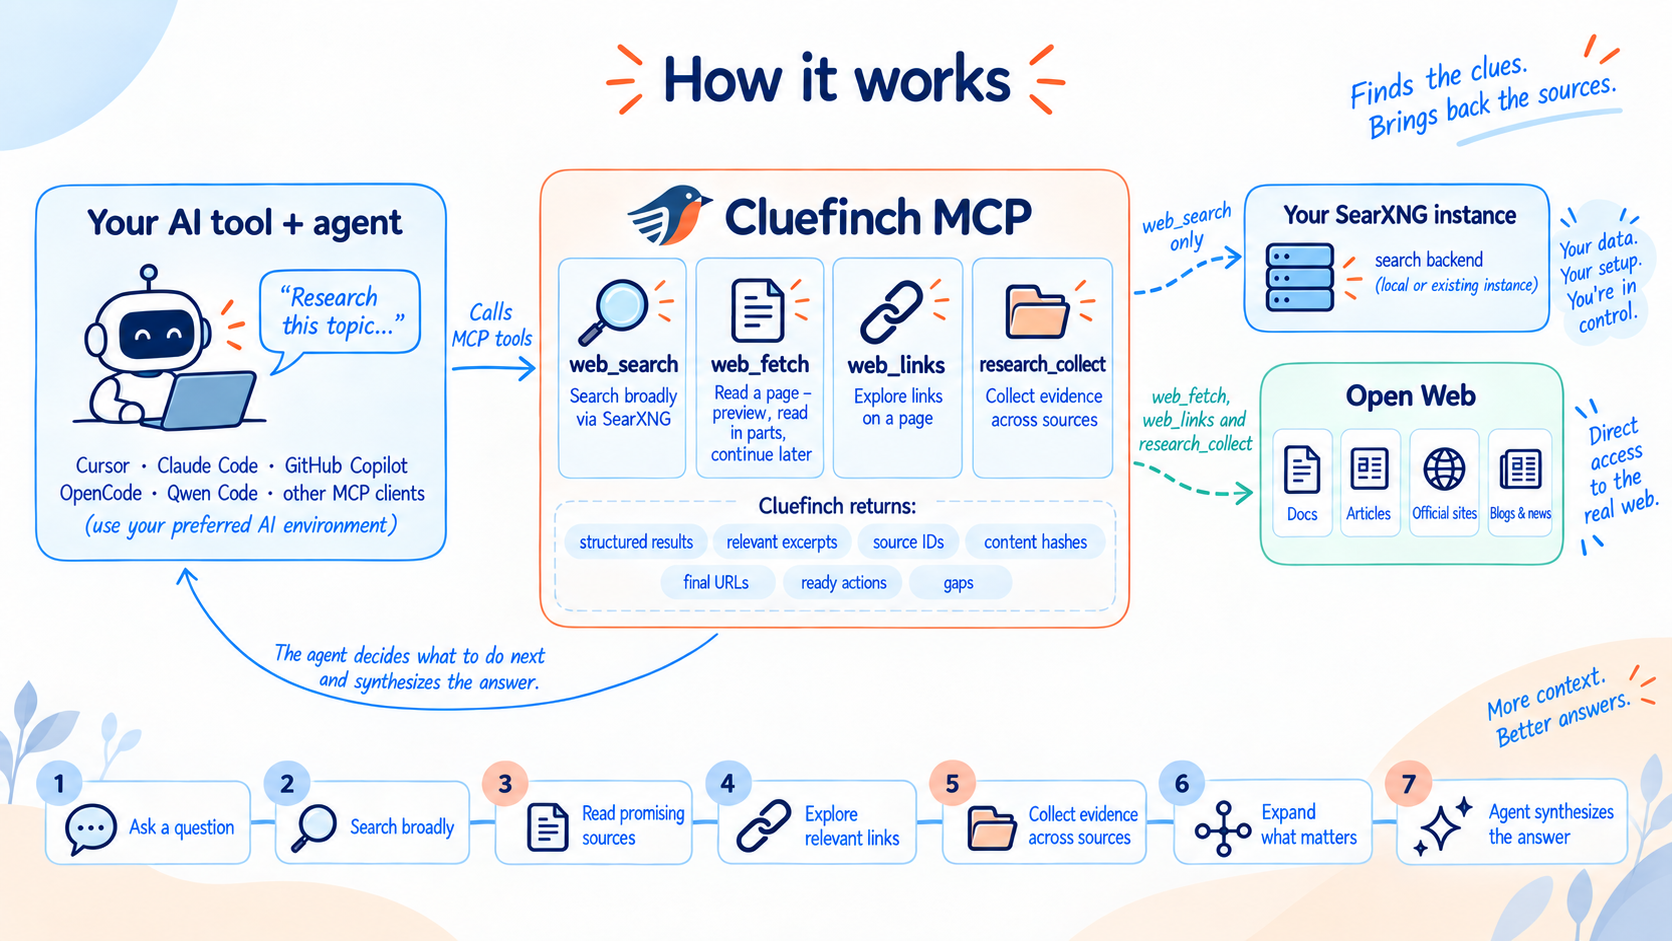
MCPクライアントにweb_search、web_fetch、web_links、research_collectの4つのツールを提供します。stdioでローカルサーバーとして動作し、検索バックエンドにSearXNGを使用します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
4掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| query | string | はい | 検索語。複数のクエリのバリエーションと取得済みの抜粋が必要な場合は、代わりに research_collect を使用してください。 |
| domain | any | いいえ | クエリに site:domain を含めます(例:docs.python.org)。ページ URL ではなくホスト名を使用してください。exclude_domains と組み合わせられます。 |
| engines | any | いいえ | 任意の検索エンジンのサブセット:google、google cse、brave、wikipedia、wikidata。省略すると、SearXNG のデフォルトが使用されます。 |
| language | any | いいえ | 言語/ロケール(例:en、ru)。省略すると、すべての言語が対象になります。 |
| time_range | any | いいえ | 任意の期間フィルター:day、week、month、year。 |
| max_results | integer | いいえ | 要求する候補数。デフォルトは 10、設定上限は 20 です。これは結果数の上限であり、検索のページネーションではありません。 |
| safe_search | any | いいえ | 0=オフ、1=中程度、2=厳格。省略するとプロバイダーのデフォルトが使用されます。 |
| exclude_domains | any | いいえ | -site: 演算子でドメインを除外します(例:['pinterest.com', 'example.org'])。プロバイダーによって対応状況が異なるため、返された URL を確認してください。 |
詳細
Cluefinch MCP
AI エージェントのためのディープリサーチ基盤です。
Cluefinch MCP は、Model Context Protocol(MCP)を通じてウェブを活用するための完全なツールキットを AI エージェントに提供します。
Cluefinch を使うと、エージェントはウェブを検索し、ページを読み、関連する情報源をたどって、徹底的な調査を行えます。
Cluefinch MCP によって、単一の事実の検索から複数の情報源にまたがる複雑な多段階の調査まで、インターネットを AI エージェントの作業環境の一部にできます。
Cluefinch MCP は完全無料で利用でき、有料サブスクリプションは不要です。ローカル LLM を使う AI エージェントにも、クラウドベースのモデルを使う AI エージェントにも対応しており、商用検索 API やクラウドホスト型ディープリサーチサービスのサブスクリプションも必要ありません。
Cluefinch MCP 独自の検索クエリ数や調査実行回数の制限はありません。
エージェントはウェブを効果的に活用するために必要なツールを利用でき、ツールの使い方はユーザーが管理できます。Cluefinch は MCP 対応の AI ツールと簡単に連携し、すでに利用しているワークフローにも適合します。
Cluefinch MCP でできること
ウェブ検索
Cluefinch MCP を使うと、エージェントはユーザー自身の SearXNG インスタンスを通じてインターネットを検索できます。
エージェントは検索クエリを作成して調整し、さまざまな検索エンジンを利用したり、言語やドメインで検索を絞り込んだり、必要に応じて追加のクエリや修正したクエリを発行したりできます。
ウェブ閲覧
役立つリンクが見つかったら、エージェントは Cluefinch MCP を通じてページを開き、モデルでの処理に適した、整形済みのテキストを取得できます。
大きなページを一度にすべてモデルのコンテキストに読み込む必要はありません。エージェントはページを分割して読み、特定の位置から続きを読むことができ、必要な場合にのみ追加のコンテキストを要求できます。
情報源のナビゲーション
役立つページを見つけた後、エージェントはその HTTP/HTTPS リンクを調べ、情報源独自の構造をたどって調査を続けられます。検索エンジンに戻ることなく、ドキュメントのセクションやレポートの章を移動し、ページ送りをたどり、関連ページを開き、一次資料にたどり着けます。
ディープリサーチ
Cluefinch MCP は、複数の情報源にまたがる調査ワークフローを実行するためのツールをエージェントに提供します。
エージェントは複数の調査経路を同時に追い、検索結果と既知の URL の両方を活用し、さまざまな情報源から資料を集め、長い文書の最も関連性の高い箇所を調べ、新たな疑問が生じるたびに調査を深められます。
調査プロセスはエージェントが主導します。次に何を検索するか、どの情報源を詳しく調べる価値があるか、収集した資料をどう解釈するか、回答を作成するのに十分な根拠がそろったかを判断します。
調査の深さは、簡単な製品情報の検索から複雑な多段階分析まで、タスク、モデル、ユーザーの指示によって異なります。
クイックスタート
Cluefinch MCP の利用には、Python 3.12.4 以降が必要です。
1. Cluefinch MCP をインストールする
python -m pip install cluefinch
インストール後、cluefinch 実行ファイルが環境変数 PATH を通じて利用できることを確認してください。
Windows の場合:
where.exe cluefinch
macOS および Linux の場合:
command -v cluefinch
cluefinch が見つからない場合は、インストールされた実行ファイルを含むディレクトリを PATH に追加してください。
2. SearXNG を起動する
Cluefinch は検索バックエンドとして SearXNG を使用します。独自の SearXNG インスタンスをまだお持ちでない場合は、リポジトリにすぐに使えるローカル設定の例が含まれています。
examples/searxng/compose.yamlexamples/searxng/settings.yml
この例を実行するには、Docker Compose に対応した Docker が必要です。
これらのファイルを別のディレクトリにダウンロードし、同じ場所にランダムな SEARXNG_SECRET を設定した .env ファイルを作成します。
macOS と Linux の場合:
printf 'SEARXNG_SECRET=%s\n' "$(openssl rand -hex 32)" > .env
Windows PowerShell の場合:
$secret = -join ((1..64) | ForEach-Object { '{0:x}' -f (Get-Random -Maximum 16) })
"SEARXNG_SECRET=$secret" | Set-Content -Encoding ascii .env
次に、Docker Compose で SearXNG を起動します。
docker compose up -d
デフォルトでは、ローカルの SearXNG インスタンスは次のアドレスで利用できます。
http://127.0.0.1:8081
3. Cluefinch MCP を AI ツールに接続する
Cluefinch は一般的な AI ツールに簡単に接続でき、標準的なローカル MCP サーバーとして stdio 経由で動作します。
すぐに使える接続例は、次のセクションに記載されています。
AI ツールとの統合
Cluefinch MCP は標準的なローカル MCP の stdio トランスポートを使用するため、ほとんどのクライアントでは cluefinch コマンドを指定するだけで使用できます。
以下に、一般的な AI ツールと Cluefinch を統合する最小限の例を示します。Cluefinch は、stdio 経由のローカル MCP サーバーに対応した他のクライアントでも使用できます。
以下の例では、上記のクイックスタートセクションと同じ http://127.0.0.1:8081 の SearXNG を使用しています。
SearXNG インスタンスでデフォルトのアドレスを使用していない場合は、クライアントの設定で MCP サーバーの環境変数として MCP_SEARCH_SEARXNG_URL を渡してください。
Cursor
プロジェクトの .cursor/mcp.json または Cursor のグローバル MCP 設定に Cluefinch を追加します。
{
  "mcpServers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
MCP 接続を再起動すると、Cursor が Cluefinch のツールを検出し、エージェントのタスクで使用できるようになります。
Claude Code
1 つのコマンドで Cluefinch を追加できます。
claude mcp add --scope user cluefinch -- cluefinch
接続を確認するには、次のコマンドを実行します。
claude mcp list
Codex
次のコマンドで Cluefinch を追加します。
codex mcp add cluefinch -- cluefinch
接続を確認するには、次のコマンドを実行します。
codex mcp list
VS Code の GitHub Copilot
.vscode/mcp.json にローカル MCP サーバーを追加します。
{
  "servers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
これで、エージェントモードの GitHub Copilot から、MCP ツールのセットとして Cluefinch を利用できるようになります。
OpenCode
opencode.jsonc に Cluefinch を追加します。
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "cluefinch": {
      "type": "local",
      "command": ["cluefinch"],
      "enabled": true
    }
  }
}
Qwen Code
ユーザーレベルの設定には ~/.qwen/settings.json を、特定のプロジェクトの設定には .qwen/settings.json を使用して、Cluefinch を追加します。
{
  "mcpServers": {
    "cluefinch": {
      "command": "cluefinch",
      "args": []
    }
  }
}
Qwen Code を再起動した後、/mcp コマンドで接続を確認できます。
OpenClaw
次のコマンドで Cluefinch を追加します。
openclaw mcp add cluefinch --command cluefinch
または、openclaw.json で手動設定します。
{
  "mcp": {
    "servers": {
      "cluefinch": {
        "command": "cluefinch",
        "transport": "stdio"
      }
    }
  }
}
接続を確認するには、次のコマンドを実行します。
openclaw mcp probe cluefinch
Hermes Agent
アクティブな Hermes プロファイルで使用している config.yaml ファイルに Cluefinch を追加します。
mcp_servers:
  cluefinch:
    command: "cluefinch"
    args: []
設定を保存した後、Hermes を再起動します。
エージェントの動作を設定する
エージェントは、利用可能な Cluefinch MCP ツールを使用して検索クエリを作成し、情報源を選択して、調査プロセスを管理します。AGENTS.md の指示、またはお使いの AI ツールの同等の設定を通じて、そのプロセスに独自のルールを定義できます。
これらの指示は、通常の検索と、複数の段階を踏む詳細な調査の両方を対象にできます。各 Cluefinch MCP ツールの使用方法も指定できます。
たとえば、エージェントに調査計画を最初に作成させ、web_search で複数の絞り込み検索を実行し、web_links で章や関連ページをたどり、一次情報を優先し、長い文書を web_fetch で段階的に読むよう指示できます。
複数の情報源からの収集と初期の絞り込みには、エージェントは research_collect を使用できます。また、すでに収集したコンテキストの再利用、矛盾する情報源の確認、追加検索の反復回数の制限、事実に基づく証拠と解釈の分離に関するルールも定義できます。
リポジトリには、この種の詳細な調査ワークフローのすぐに使える例を含む AGENTS.md ファイルがあります。これを出発点として、手早い調査向けに簡略化したり、ご自身のタスク、モデル、出力要件に合わせて調整したりできます。
Cluefinch MCP ツール
MCP レベルでは、Cluefinch はウェブ検索から特定の情報源の閲覧、さらに複数の情報源を対象とする調査まで、エージェントを支援する相互補完的な 4 つのツールを提供します。
web_search
web_search は、設定済みの SearXNG インスタンスを通じて検索を実行し、役立つ可能性のある情報源へのリンクを返します。
エージェントは、結果の数を調整したり、検索エンジンと言語を選択したり、セーフサーチを使用したり、検索対象を特定のドメインに限定したり、不要なドメインを除外したりできます。また、1 つ以上の SearXNG エンジンが応答しなかった場合、Cluefinch がそれを通知するため、エージェントは不完全な検索結果を完全なものと誤認しません。
web_fetch
web_fetch はウェブページを直接読み込みます。Cluefinch は指定された URL から HTML をダウンロードし、本文を抽出して Markdown に変換し、エージェントが必要とする部分だけを返します。
エージェントはまずページの短いプレビューを取得して情報源として役立つか判断し、必要な場合にのみ読み進めることができます。長い文書は、指定した位置から段階的に読むことができます。Cluefinch は next_start と、すぐに使える continuation アクションを返すため、エージェントが次の位置を手動で計算する必要はありません。コンテンツとともに、抽出済みテキストの保持された同じバージョンを安全に読み進めるために必要なメタデータも受け取れます。
web_links
web_links は HTML ページからナビゲーション用の HTTP/HTTPS リンクを抽出し、文書内の順序で返します。すでに見つけた情報源の構成、つまりドキュメントのセクション、レポートの章、ページネーション、付録、一次情報への参照、関連ページをエージェントが確認できます。
これは特に詳細な調査で役立ちます。質の高い情報源を見つけた後、エージェントはその構成を確認し、web_fetch で関連するセクションだけを開き、続いて research_collect で選択した複数の情報源から資料を収集できます。これにより、不要な検索を減らし、調査のコンテキストを維持しやすくなり、一次資料をさらに深く調べられます。
相対リンクは、文書のベース URL を使って絶対 URL に解決されます。必要に応じてリンクをオリジンで絞り込めます。また、大量のリンクは複数のリクエストに分けて段階的に取得できます。
Cluefinch は、保持されたリンク一覧にもバージョンを付与します。リクエスト間でページのナビゲーションが変更された場合でも、エージェントが古い一覧の古い位置から読み進めることはありません。
リンクの抽出では、リンク先へのリクエストは行われません。送信先に対する完全な安全性検証は、エージェントが後からその URL を取得することにした場合にのみ適用されます。
research_collect
research_collectは、複数のソースを一度に扱えるように設計されています。複数の検索クエリ、特定のURL、またはその両方を指定できます。
Cluefinchは利用可能なソースを収集し、リダイレクト後の最終URLに基づいてドキュメントの重複を排除し、長いドキュメントから最も関連性の高い箇所を特定します。選択された各箇所は、安定した位置情報を持つ抽出テキストの正確な一部分です。そのため、エージェントは後からその箇所に戻り、必要に応じて周辺のコンテキストを追加で取得できます。
各ソースには安定したsource_idが付与されます。また、到達できないURL、検索の失敗、最終ドキュメントの重複など、収集時の問題はgapsに明示的に報告されます。十分な資料が収集されたか、どのソースをさらに詳しく調べるべきかは、エージェントが判断します。
ツールのスキーマ、パラメーター、制限、レスポンスの仕様については、docs/REFERENCE.mdに記載されています。
Cluefinchの効率性と安全性を支える仕組み
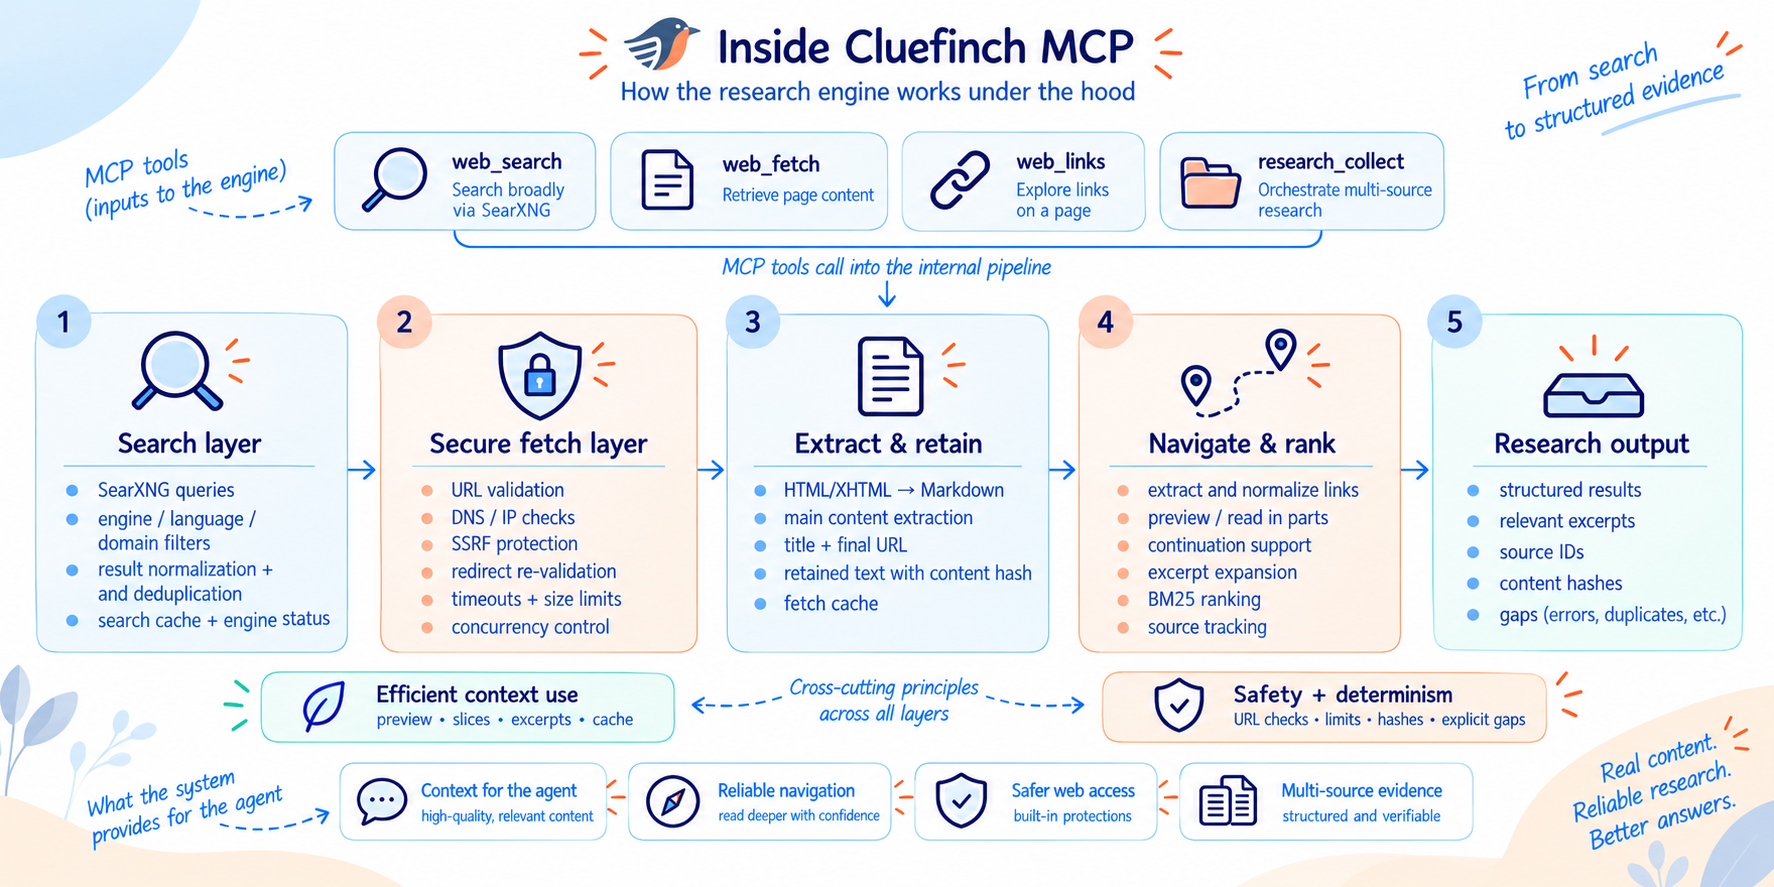
Cluefinchの4つのMCPツールの背後には、長いドキュメント、繰り返されるリクエスト、ネットワークの制約、外部コンテンツへの安全なアクセスを処理する検索レイヤーがあります。
コンテキストとトークンの効率的な利用
Cluefinchを使うと、ドキュメント全体をコンテキストに読み込むのではなく、現在のタスクに必要なページの一部だけをエージェントからモデルに送信できます。
抽出したドキュメントは、少しずつ読み進めることができます。エージェントは次のチャンクの位置を受け取り、コンテンツが実際に必要になったときだけ読み進めます。個別の調査箇所については、ドキュメント全体を読み直さずに、周辺のコンテキストを追加で取得することもできます。
ナビゲーションには保持された抽出テキスト内の位置を使うため、エージェントは以前に特定した箇所に正確に戻ることができます。これにより、モデルはコンテキストウィンドウをより効率的に使い、作業の現在の段階に関係するソースの部分だけにトークンを使用できます。
抽出テキストのバージョン管理
保持される抽出テキストの各バージョンには、content_hashが付与されます。
エージェントが読み進めるとき、またはexpected_content_hashを使って以前に選択した箇所の範囲を広げるとき、Cluefinchはそのハッシュを検証します。読み進める操作と範囲を広げる操作のすぐに使えるアクションでは、ハッシュが自動的に渡されます。ページのコンテンツが変更され、以前の位置情報を信頼できなくなった場合、ツールは古い位置から古い箇所を返すのではなく、変更を報告します。
これにより、内容が変化するソースをより確実に読み進められ、異なるバージョンのドキュメントからの箇所が気付かないうちに混在するリスクを軽減できます。
ソースの来歴と追跡可能性
Cluefinchはリダイレクト後の最終URLを保持し、最終ドキュメントのアドレスを基準にソースの重複を再度排除します。そのため、同じ資料につながる別々のリンクが、個別の独立したソースとして扱われることはありません。
正規化された各最終URLには安定したsource_idが付与され、調査プロセスの異なる段階でも同じソースを一貫して識別できます。
長いドキュメントについては、Cluefinchが抽出テキストを長さの上限がある箇所に分割し、BM25で関連性を順位付けします。選択された箇所は、位置情報を伴う抽出元テキストの正確な一部分として保持されるため、モデルが受け取ったソース資料を後から再確認し、周辺のコンテキストを追加できます。
隠れた前提ではなく、明示的な制限
Cluefinch は、取得したデータの完全性に影響する可能性のある状況を明示的に報告します。
一部のソースを取得または処理できない場合、research_collect は gaps を返します。web_search は、応答しなかった SearXNG エンジンを個別に報告します。ページを読む際、Cluefinch は、保持されているテキストがまだ残っている場合と、設定された保持上限により抽出した文書の末尾が破棄された場合も区別します。
これにより、不完全な取得が、部分的な結果を完全なものとして提示するのではなく、エージェントに明示されます。分析を続ける、あるいは回答を生成するのに十分な情報が集まったかどうかは、引き続きエージェントが判断します。
キャッシュとデータの再利用
検索結果と抽出したページは、プロセスごとのローカル TTL/LRU キャッシュに一時保存されます。キャッシュされたエントリが有効な間は、同じリソースを再度リクエストしても、HTTP リクエストは発生しません。キャッシュを再利用する前にもページ URL は検証されるため、DNS ルックアップが行われる場合があります。
同一の検索や同じページの取得が同時に行われた場合はまとめて処理されるため、エージェントの並列アクションによって重複したネットワークトラフィックが発生することはありません。
キャッシュはコンテキスト管理を補完します。段階的な読み込みによってモデルのトークンを節約し、ローカルキャッシュによって同じデータをインターネットから繰り返しダウンロードするのを防ぎます。
外部ページへの安全なアクセス
エージェントは検索結果や任意のウェブサイトからリンクを受け取る可能性があるため、Cluefinch はすべての URL を信頼できないものとして扱います。
コンテンツを取得する前に、Cluefinch は URL のスキーム、ホスト名、DNS の結果、最終的な IP アドレスを検証します。ローカル、プライベート、予約済み、マルチキャストなどの安全でないアドレスはブロックされます。検証はリダイレクト後と、接続の直前にも繰り返されます。Cluefinch は、元のホスト名を HTTP と TLS で保持しながら、検証済みの数値 IP アドレスに接続します。
また、Cluefinch はレスポンスと展開後のデータサイズ、リダイレクト数、ダウンロード時間、同時ネットワークアクティビティ、テキスト抽出に使用するリソースを制限します。同じホストへのリクエストの間隔も空けます。
これらの対策は、主に SSRF と制御されないリソース消費から保護することを目的としています。ウェブページのテキストは依然として信頼できないコンテンツであり、エージェントが自動的に指示として扱わないようにしてください。
検索とウェブページ取得の分離
Cluefinch は SearXNG を検索バックエンドとしてのみ使用します。候補となるソースの発見には役立ちますが、ウェブページを読むためのプロキシとしては使用しません。
エージェントが見つかった URL を開くと、Cluefinch は独自の保護された取得レイヤーを通じてページを直接取得します。発見と取得を分離することで、セキュリティ、キャッシュ、テキスト抽出、長文書の読み込みをそれぞれ独立して管理できます。
SearXNG は独立したサービスのままです。一方、Cluefinch MCP はユーザーの環境でローカルに実行され、独自のクラウド取得サービスや組み込みテレメトリーを必要としません。
調査例
実際の調査セッションを見て、AI エージェントが Cluefinch MCP を使って技術的な質問を調べ、独自に調査方針を決定し、調査の進行に応じて戦略を調整する様子を確認してください。
Cluefinch MCP の設定
Cluefinch MCP は、MCP_SEARCH_ をプレフィックスとする環境変数を使って、特定の環境やエージェントのワークロードに合わせて調整できます。
ほとんどの場合、デフォルト設定で十分です。主な設定は次のとおりです。
| 設定 | デフォルト | 用途 |
|---|---|---|
MCP_SEARCH_SEARXNG_URL | http://127.0.0.1:8081 | SearXNG のアドレス |
MCP_SEARCH_ENGINES | google,google cse,brave,wikipedia,wikidata | 明示的に指定できるエンジンのサブセット。engines を省略すると、SearXNG のデフォルトが使用されます |
MCP_SEARCH_MAX_RESULTS | 20 | 検索ごとの結果の最大数 |
MCP_SEARCH_MAX_SOURCES | 10 | research_collect が収集を試みるソースの最大数 |
MCP_SEARCH_MAX_QUERIES | 10 | 1 回の research_collect 呼び出しで実行できる検索クエリの最大数 |
MCP_SEARCH_MAX_FETCH_CHARS | 20000 | 返されるページフラグメント 1 つあたりの最大サイズ |
MCP_SEARCH_MAX_TEXT_CHARS | 100000 | 1 ページについて保持する抽出テキストの最大量 |
MCP_SEARCH_FETCH_CONCURRENCY | 3 | 同時に取得できるページの最大数 |
MCP_SEARCH_FETCH_TTL | 600 | ローカルキャッシュ内で取得済みページを保持する期間(秒) |
MCP_SEARCH_SEARCH_TTL | 300 | ローカルキャッシュ内で検索結果を保持する期間(秒) |
たとえば、SearXNG が別のアドレスで動作している場合は、次のように設定します。
export MCP_SEARCH_SEARXNG_URL=http://127.0.0.1:8888
同じ変数は、MCP クライアントのサーバー設定から直接渡すこともできます。
設定、デフォルト値、正確な動作の全一覧は、docs/REFERENCE.md に記載されています。
現在の制限事項
Cluefinch MCP は、HTTP/HTTPS 経由で一般的なウェブページを検索、取得するために設計されています。現行バージョンでは、フルブラウザーを実行せずに HTML/XHTML をサポートし、テキストを抽出できます。
Cluefinch MCP には、現在、次の機能は含まれていません。
- JavaScript のレンダリングやブラウザーの自動操作。
- PDF のテキスト抽出。
- 認証済みセッションや非公開ページへのアクセス。
- CAPTCHA やペイウォールの回避。
- ベクトル検索や埋め込みベースの検索。
- ホスト型 SaaS、REST API、組み込みテレメトリー。
ページの大部分が JavaScript に依存している場合や、認証なしでは利用できない場合、エージェントは代替となる HTML ソース、公開ドキュメント、ミラー、または別のアクセス可能なソースを探してください。
これらの制限は現行バージョンの Cluefinch MCP に適用され、アーキテクチャをローカルで予測可能な状態に保ち、利用者が制御できるようにするものです。
開発環境のセットアップ
ソースコードを扱うには、uv と Python 3.12.4 以降が必要です。
git clone https://github.com/cluefinch/mcp-server.git
cd mcp-server
uv python install 3.12
uv sync --locked
その後、作業ツリーからサーバーを直接実行できます。
uv run cluefinch
開発用のローカル SearXNG インスタンスが必要な場合は、すぐに使える設定例を使用してください。すでに独自の SearXNG インスタンスがある場合は、MCP_SEARCH_SEARXNG_URL でそのアドレスを設定するだけです。
主なプロジェクトのチェック項目は次のとおりです。
uv run ruff check mcp_search tests scripts
uv run ruff format --check mcp_search tests scripts
uv run pytest -q
uvx --from 'pyright==1.1.414' pyright --pythonpath .venv/bin/python mcp_search scripts
uv build
CI では、Ubuntu と Windows でサポート対象の Python バージョンをテストし、直接依存関係の下限も確認します。
ローカル開発環境、スモークテスト、IDE のセットアップ、エージェントの動作評価、公開可能なツリーの要件について詳しくは、docs/DEVELOPMENT.md を参照してください。
貢献、サポート、セキュリティ
変更の提案、問題の報告、またはプロジェクトへの貢献を希望する場合は、まず CONTRIBUTING.md をご確認ください。プルリクエスト、テスト、Developer Certificate of Origin(DCO)の要件について説明しています。
利用方法に関する質問やサポートについては、SUPPORT.md をご確認ください。
脆弱性またはその他のセキュリティ関連の問題を発見した場合は、通常の GitHub Issue で詳細を公開しないでください。責任ある報告の手順については、SECURITY.md に記載されています。
公開 Issue またはプルリクエストを作成する際は、シークレット、非公開の URL、非公開ページの内容、ローカルのキャプチャファイル、その他の機密データを公開しないでください。
ライセンス
Cluefinch MCP のオリジナルコードは、Apache License 2.0 の下で配布されています。
SearXNG は独立した外部サービスとして使用され、GNU AGPL-3.0 のライセンスが適用されます。Cluefinch MCP の Apache-2.0 ライセンスは、SearXNG、その依存関係、またはエージェントが取得したウェブページのコンテンツには適用されません。
サードパーティコンポーネントとそのライセンスに関する追加情報は THIRD_PARTY_NOTICES.md に記載されています。また、SearXNG の統合と配布に関する考慮事項については、docs/SEARXNG_COMPLIANCE.md に記載されています。
著作権および帰属に関する情報は、NOTICE をご確認ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。