footnote について
Footnote は、ERP や財務データを扱う AI アプリケーションを構築し、回答を元レコードに結び付けたいチーム向けの MCP サーバーです。型付き操作、エンティティ検証、SQL 集計、防改ざんの来歴ログを使い、モデルに数値を生成させません。
主な機能
- 01モデルによる SQL 作成を防ぐ型付き操作カタログ
- 02クエリ前のエンティティ検証
- 03SQL による集計
- 04結果とともにレコードリンクを返却
- 05ハッシュチェーン形式の来歴記録
- 06対応操作のない質問を拒否
活用シーン
- 01財務数値を元の請求書まで追跡
- 02リスク判断の根拠となる事実を確認
- 03来歴ログのエクスポートや検証
- 04根拠のない予測質問を拒否
MCP 対応
MCP を通じて、業務データ向けの固定された型付き操作カタログを公開します。結果には構造化コンテンツ、レコードリンク、来歴メタデータが含まれます。主張単位の引用にはホスト側の統合が必要です。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
npx -y @brick-byte/footnoteDATABASE_URLシークレットPostgres connection string. Omit to use the built-in SQLite sample database.PROVENANCE_DBPath to the SQLite provenance log. Defaults to in-memory, which discards the trail on exit.PROVENANCE_ACTORIdentity recorded against each provenance record. In production this comes from the request's auth.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Footnote

**ERP や財務データについて AI が回答する際に、数値の幻覚を防ぐ MCP サーバーです。**回答内のすべての数値は、その根拠となったデータベースの行までたどれます。読み取り時にクリックして確認でき、監査人向けにエクスポートでき、改ざんの痕跡も検出できます。
Claude Desktop、Cursor、Microsoft Agent Framework、Semantic Kernel (.NET)、LangChain、または独自のループなど、あらゆる MCP クライアントで動作します。
MCP サーバー、プロベナンスストア、そしてこの組み合わせの動作を示すデモ UI です。
最も手軽に試す方法:
// claude_desktop_config.json
{ "mcpServers": {
    "footnote": {
      "command": "npx",
      "args": ["-y", "@brick-byte/footnote"],
      "env": {
        "PROVENANCE_DB": "/path/to/provenance.db",
        "PROVENANCE_ACTOR": "your-name",
        // Omit for the built-in SQLite sample data.
        "DATABASE_URL": "postgres://user:pass@localhost:5432/erp"
      }
    } } }
または、デモ UI をローカルで実行します:
npm install
npm run demo      # http://localhost:4711
npm test          # 26 tests, including the invariants below
Node 22.5 以降が必要です(組み込みの node:sqlite を使用するため、データベースのインストールは不要です)。
Postgres はオプションです。同じスキーマ、シードデータ、クエリセットを Postgres でも実行でき、同じテスト一式が両方で合格する必要があります:
npm run db:up     # Postgres 17 in Docker, seeded from migrations/001_init.sql
npm run test:pg   # the identical 26 tests, against Postgres
npm run demo:pg   # the demo, against Postgres
問題点
言語モデルが生成するのは、もっともらしい続きであって、真実とは限りません。業務データベースを参照させると、どのクエリも返していない数値を、自信たっぷりに報告することがあります。そして、その捏造された数値は、実際の数値と見分けがつきません。どちらも同じ仕組みから出てくるためです。
よくある対策では、ここでは不十分です。不確実性のシグナルで検出できるのは曖昧なケースであり、流暢な誤答ではありません。同じモデルを使った検証器は、捏造を見抜くのと同じくらい簡単に、捏造を正しいと確認してしまいます。そして財務、在庫、調達の現場では、「モデルがそう言った」では、誰も行動に移せません。
有効なのは構造的な対策です。モデルに数値を生成させないことです。
アーキテクチャ
  question
     │
     ▼
  model ──────────► picks an operation from a catalog and supplies typed args
     │                (it cannot write SQL, cannot invent an operation)
     ▼
  contract layer ─► validates params, resolves entities against the database,
     │                rejects anything that does not exist
     ▼
  deterministic ──► executes the query; SQL does all aggregation
  core                returns values + the evidence behind each one
     │
     ▼
  provenance ─────► appends a hash-chained record, server-side,
  store               where the model cannot influence it
     │
     ▼
  host UI ────────► fills slots from structured output and renders each
                      claim as a clickable citation
モデルが担当するのは、翻訳と表現です。この2つはモデルが得意とする分野です。数値は記録システムから取得します。
適用される保証
以下はガイドラインではなく、テストです。いずれかが破られると、npm test は失敗します。
**数値は生成されません。**値は、操作の構造化出力からテンプレートのスロットにそのままコピーされます。回答内のすべての金額が、根拠のあるエビデンス付きクレームで裏付けられていること、また、提示された合計が引用されたレコードの合計と一致することを、テストで検証します。
**クエリを実行する前にエンティティを検証します。**捏造された顧客が指定された場合は、何も返さずにモデルに説明を補わせるのではなく、実在する候補を示す復旧可能なエラーを返します。
**集計は SQL で行います。**モデルが選ぶのは実行する集計方法であり、その結果ではありません。
**空の結果はコードで処理します。**これは捏造を引き起こす最大の要因です。文の途中でモデルに空の結果セットを渡すと、文を完成させるために何かをでっち上げます。代わりに、操作が明示的な emptyReason を設定します。
ルーティングできない質問には回答しません。「来四半期の収益はいくらになりますか?」に対応する操作がないため、回答は生成されません。拒否は失敗ではなく、第一級の結果です。
**プロベナンスはサーバー側で記録します。**モデルが自分自身のプロベナンスを報告することはありません。引用するかどうかをモデルの選択に委ねるプロベナンスには価値がありません。
**ログは改ざんを検出できます。**各レコードには、直前のレコードのハッシュが含まれています。npm run verify はチェーンをたどり、書き込み後に変更された最初のレコードを報告します。
**クエリの順序はテスト済みの契約です。**エンティティ抽出では最初の一致を使うため、listCustomers はレコード順で返す必要があります。名前順に並べ替えると、このプロジェクトが防ごうとしている失敗が起きます。流暢な文章に、実在する数値が実在する行を正しく引用して示されているのに、対象の会社だけが間違っている、という失敗です。これを正確に検証するテストがあります。
数字だけでなく、解釈も
より難しいのは判断です。「Bergmann はリスクにさらされています」は、照合できる行がない結論です。根拠のない解釈は、洞察のように受け取られ、レビューを通過してしまうため、根拠のない数値よりも危険です。
ここでの回答は、まず結論を述べ、その後、各前提を個別に引用された事実として提示します。
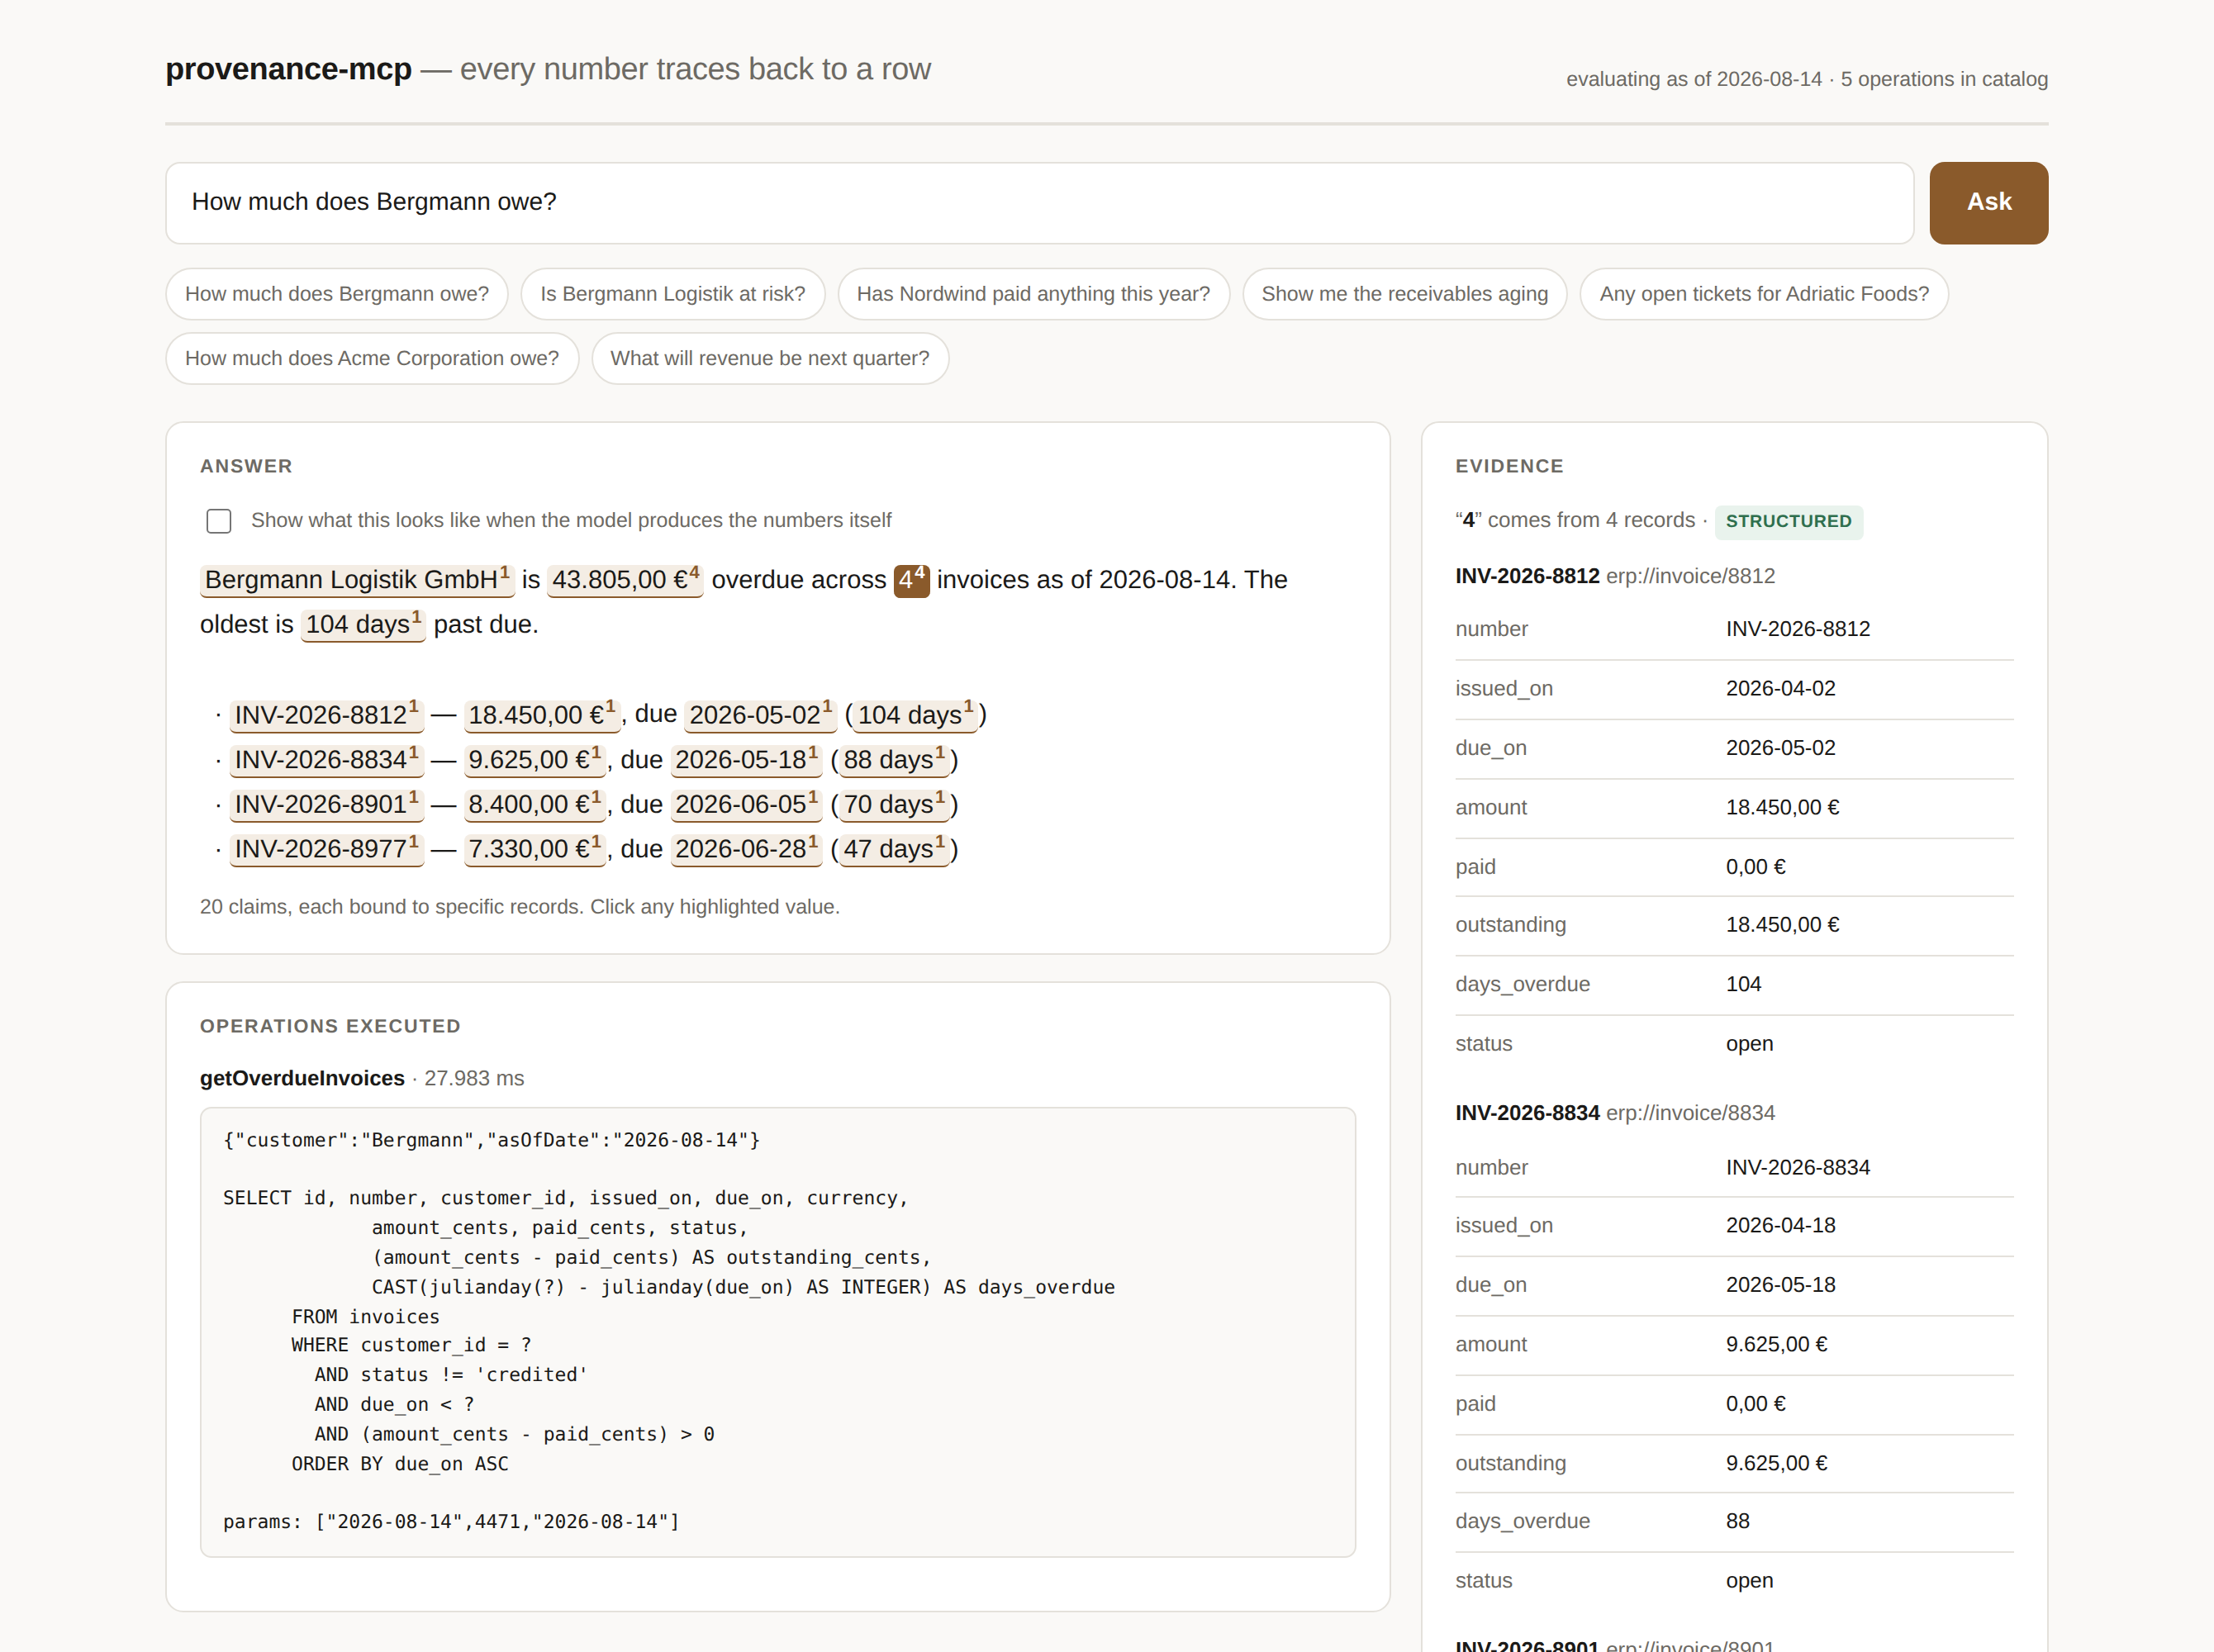
Bergmann Logistik GmbH shows two independent risk signals.
This is an interpretation — the underlying facts are:

  · 43.805,00 € overdue across 4 invoices, oldest 104 days past due
  · 2 open support tickets, 1 high severity
  · agreed payment terms of 30 days, account owned by Ana Kovač

The conclusion is the model's. Every fact above is a record you can open.
人は、入力内容を信頼しながら推論には異議を唱えることができます。
出典情報の記録形式
{
  "id": "…", "sequence": 1, "timestamp": "2026-08-14T09:12:04.000Z",
  "actor": { "id": "zoran", "role": "controller" },
  "question": "How much does Bergmann owe?",
  "answer": "Bergmann Logistik GmbH is 43.805,00 € overdue across 4 invoices…",

  // Each claim indexes a span of the answer and names its evidence.
  "claims": [
    {
      "text": "43.805,00 €",
      "span": { "start": 25, "end": 36 },
      "evidenceIds": ["invoice:8812", "invoice:8834", "invoice:8901", "invoice:8977"],
      "origin": "structured"        // never "generated" for a value
    }
  ],

  // The query, so the result is reproducible.
  "operations": [
    { "name": "getOverdueInvoices",
      "arguments": { "customer": "Bergmann", "asOfDate": "2026-08-14" },
      "query": { "sql": "SELECT …", "params": ["2026-08-14", 4471, "2026-08-14"] },
      "durationMs": 0.42 }
  ],

  // Field values, not just IDs — the export stands alone if the source moves on.
  "evidence": [
    { "id": "invoice:8812", "type": "invoice", "recordId": "8812",
      "uri": "erp://invoice/8812",
      "fields": { "number": "INV-2026-8812", "due_on": "2026-05-02",
                  "outstanding": "18.450,00 €", "days_overdue": 104 } }
  ],

  "previousHash": "0000…", "hash": "9aa2ba…"
}
重要なのは origin フィールドです。structured は、その値が操作の出力からコピーされたことを意味します。generated は、モデルがその値を生成したことを意味します。数値の場合、これこそがこのプロジェクトで防ごうとしていることです。
MCP の詳細
このサーバーは、この用途に必要なプロトコルの機能を使用します。
| 機能 | 用途 |
|---|---|
inputSchema | モデルはクエリ言語ではなく、型付きのカタログを取得します |
structuredContent | 値は文章とともに検証済みの JSON として返されるため、数値を生成トークン経由で往復させる必要がありません |
resource_link | 参照されたすべてのレコードが erp:// URI として返されます。クリック可能な引用を実現するディープリンクの基本要素です |
annotations.audience | レコードのリンクはユーザー向けとしてマークされます |
_meta | 出典情報の記録 ID とハッシュを保持するため、ホストは完全なトレースを取得できます |
isError | 捏造されたエンティティは回復可能なツールエラーであり、モデルが修正できます。プロトコルの障害ではありません |
MCP が提供しない機能と、このリポジトリが追加する機能:プロトコルには、この主張をその証拠に結び付ける仕組みがありません。プロトコルが渡すのはリンクだけです。主張と証拠の対応付けとその表示はホスト側で行われます。この対応付けこそが、実際の製品です。
stdio 経由で単独実行するには:
npm run mcp
claude_desktop_config.json の設定項目は、この README の先頭にあります。
ソースから実行する(開発用)
{ "mcpServers": {
    "footnote": {
      "command": "npx",
      "args": ["tsx", "--experimental-sqlite", "/path/to/footnote/src/mcp-server.ts"],
      "env": { "PROVENANCE_DB": "/path/to/provenance.db", "PROVENANCE_ACTOR": "your-name" }
    } } }
通常の MCP でできることと、ホストとの連携が必要なこと
Claude Desktop、Microsoft Agent Framework、Semantic Kernel、LangChain、独自のループなど、どの MCP クライアントからでも、今すぐこのサーバーを呼び出せます。これにより、次のことが可能になります。
- 型付き操作の固定カタログを利用できます。モデルが SQL を記述したり、操作を捏造したりすることはできません
- エンティティを検証できるため、捏造された顧客は空の結果ではなくエラーになります
- 集計はモデルではなく、SQL で行われます
- 質問に対応する操作がない場合、即興で答えるのではなく回答を拒否します
resource_linkエントリで、参照されたすべてのレコードを特定できます- 呼び出しごとに、ハッシュチェーンで連結されたサーバー側の出典情報ログを記録します
できないことは、主張単位でクリックできる引用の提示です。通常の MCP では、フレームワークが structuredContent とリソースリンクを受け取り、その後、独自のモデルが回答を作成します。その時点で、特定の主張と証拠の対応付けは失われ、数値は生成トークン経由で再び渡されます。
プロトコルにはその対応付けを保持する仕組みがないため、保持するにはホスト側での作業が必要です。src/web.ts と src/public/index.html が参照実装です。主張部分、引用チップ、レコードの解決を実装しています。およそ 200 行です。これをホストに移植すれば、もう半分の機能も実現できます。
デモで試す
| 質問 | 確認できること |
|---|---|
| Bergmann の債務はいくらですか? | すべての数値から、その根拠となる請求書をクリックして確認できます |
| Bergmann Logistik はリスクにさらされていますか? | 個別に引用された前提に基づく解釈を確認できます |
| 売掛金のエイジングを表示してください | SQL で計算されるポートフォリオ集計を確認できます |
| Acme Corporation の債務はいくらですか? | 捏造されたエンティティに対し、実在する代替候補を提示して回答を拒否します |
| 来四半期の売上はいくらになりますか? | 対応する操作がない場合、即興で答えるのではなく回答を拒否します |
**「モデル自身が数値を生成した場合の表示を見る」**を切り替えて比較できます。書式は同一で、文章は流暢ですが、数値はすべて誤っており、出力にはどの数値が誤っているかを示すものは何もありません。
レイアウト
migrations/001_init.sql  schema + seed, shared by both backends and Docker
src/database.ts     the Db seam — SqliteDb and PostgresDb behind one interface
src/db.ts           opens the ERP database, applies the migration
src/operations.ts   the catalog — the model's entire callable surface
src/compose.ts      slot-filling; claims and spans are emitted here
src/provenance.ts   append-only hash-chained store, export, verification
src/mcp-server.ts   MCP server over stdio
src/web.ts          demo host application
src/verify.ts       npm run verify / npm run export
test/run.ts         26 tests covering the invariants above, on both backends
docker-compose.yml  Postgres 17, seeded from the same migration
ERP の SQL を書き込むのは operations.ts のみで、単一の方言を使い、プレースホルダーには ? を使用します。
PostgresDb はこれらを $1..$n に書き換えます。また、エンジン間で実際に異なる唯一の式、つまり 2 つの日付の間の全日数を求める処理(SQLite では julianday()、Postgres では日付の減算)は、インライン化せず Db インターフェースの daysBetween として定義しています。ポートによって数値が予期せず変わる可能性があるのはここだけなので、この処理を切り離し、両方の環境で同じ日数が得られることをテストスイートで検証しています。
ステータスと制限事項
v0 であり、対応範囲を正直に示しています。
- 他者の AI に出所情報を追加することはできません。 回答が SAP Joule または Dynamics Copilot によるものなら、その検索パイプラインや表示方法にアクセスする手段はありません。このアプローチは、ビジネスデータ上に自分で構築する AI レイヤーに適用されます。
- ベンダーの引用機能はありますが、対応範囲は限られています。 2026 年 8 月現在、SAP、Microsoft、NetSuite、Salesforce はいずれも、ヘルプ記事、PDF、ドキュメントなどのナレッジコンテンツにたどり着ける引用機能を提供しています。しかし、数値をその根拠となるトランザクションに結び付ける汎用的な仕組みを提供しているベンダーはありません。数値による回答は、どこでも最も弱い部分です。
- デモの意図振り分けは、意図的に単純なキーワード照合にしているため、API キーなしでプロジェクトを実行できます。実際のデプロイではモデルがツール呼び出しを生成し、このコードが引き続きスロットを埋めます。重要なのは振り分けではなく、アーキテクチャです。
- 書き込みは対象外です。ERP で誤った読み取りを行うのは恥ずかしいことですが、誤った書き込みは台帳を破損させます。書き込みには、提案 → 検証 → 確認のフローが必要です。
- データ保持、アクセス制御、特定の ERP 向けの実用的なディープリンク解決機能は、最後に取り組む課題です。そして、実際の製品価値が生まれるのは、その最後の段階です。
知っておくべき先行事例
- OpenTelemetry GenAI semantic conventions — GenAI クライアントと MCP のスパン。まだ初期段階で、レコードレベルの出所情報には遠く及びません。
- OpenLineage — データセットとジョブのリネージュ。同じ考え方を一段下のレイヤーで、主張ではなくテーブルに適用しています。
- LLM の可観測性 — Langfuse、LangSmith、Arize、Datadog。アプリのデバッグを行うエンジニア向けのトレースであり、回答を読む人向けの出所情報ではありません。
ライセンス
MIT。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。