growmos について
growmosは、開発者やAIエージェント向けのリポジトリ単位のナレッジグラフ兼永続メモリツールです。文書やセッションから出典付きの事実を構築し、引用付きで回答します。複数のエージェントCLIに対応し、MCPサーバーとしても使えます。
主な機能
- 01文書からナレッジグラフを段階的に構築
- 02出典付きのエンティティと関係を保存
- 03エッジを引用してグラフを検索
- 04グラフの情報に基づく事実確認
- 05グラフの品質と網羅性を評価
- 06グラフのエクスポートとオフライン閲覧
活用シーン
- 01複数のエージェント間でコードベースの情報を共有
- 02アーキテクチャ上の決定と依存関係を追跡
- 03プロジェクトに関するエージェントの主張を検証
- 04コミット後に文書由来のグラフを更新
MCP 対応
growmosは依存関係のないstdio MCPサーバーとして動作し、コンテキスト、クエリ、検索、記憶、リンク、事実確認、タスク処理のツールをMCPクライアントに公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
12掲載時のツール一覧 · 2 週間前に更新
このツールにパラメーターはありません。
詳細
growmos


リポジトリとともに成長する、生きたナレッジグラフです。 人間とAI エージェントが共有する、出典情報を伴ったメモリーです。Claude Code、Codex、Grok、Cursor、Gemini、またはMCP対応の任意のCLIで、プラグアンドプレイで利用できます。依存関係はありません。MITライセンスです。
「各エージェントのメモリーは、コンテキストウィンドウとともに失われます。」 growmosはその基盤となるレイヤーです。 永続的でクエリ可能な世界モデルにより、今日のセッションは昨日の続きから取り組めます。 また、誰かのコンテキストウィンドウを介さずに、5つのエージェントがコードベースの全体像を共有できます。
Codicianが、Knowledge Graph Engineering for Multi-Agentic Systems: The Anthropic Playbookで解説されているナレッジグラフの手法(抽出 → 解決 → 構築 → クエリ、そのサイクルを閉じる評価ループを含む)を、オープンでツールに依存しない形で実装しました。手法の全容はMETHODOLOGY.mdをご覧ください。
   docs, ADRs, READMEs, sessions ──▶ 1. Extraction ──▶ 2. Resolution ──▶ 3. Assembly ──▶ 4. Querying
                                     (agent packet)    (agent packet)    (deterministic)  (grounded answers,
                                                                                            edge citations)
                     ▲                                                                            │
                     └──────────────── growmos remember / link / journal  ◀── agents develop ◀────┘
                                       evaluation loop: change prompt → growmos eval → watch F1 move
▶ ライブデモ — growmos自身のグラフを操作してみましょう · Apolloコーパスのデモ · サイト
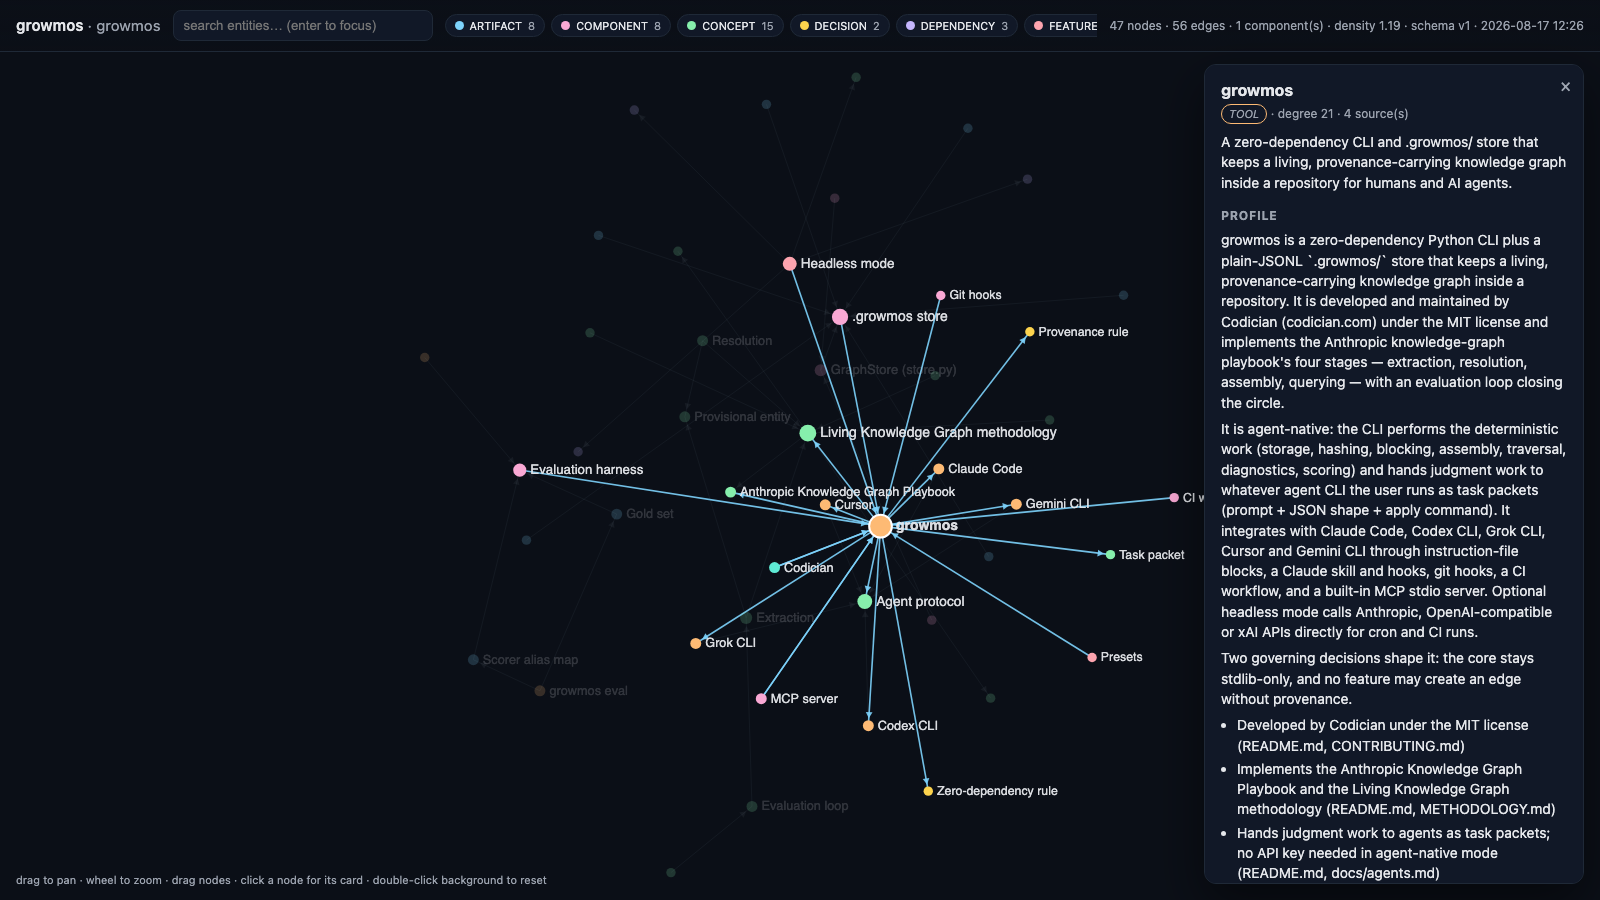
growmos view — 数日間開発を進めた後、グラフにはこのようなものが表示されます。次数に応じたサイズのハブ、種類ごとの色分け、出典情報付きのすべてのエッジ、クリックすると表示されるプロファイル。
マルチエージェントシステムと長時間にわたるコーディングセッションには、共通の弱点があります。コンテキストウィンドウが終わると、記憶も失われます。RAGは断片を提示できますが、事実をつなぎ合わせることはできません。ナレッジグラフは、ノードとしてのエンティティ、エッジとしての短い動詞句による関係、そしてすべてのエッジが持つ出典情報を備えています。これにより、「ADR-7で置き換えたものに依存しているのは何で、誰が担当しているのか?」といった複数ホップの質問をグラフの探索に変え、評価者に雰囲気ではなく正解を示し、再起動後も情報を保持できます。
growmosは、それをリポジトリ内の生きた有機体にします。
- 書いたものを取り込みます。 ドキュメント、ADR、README、設計メモ、セッションを取り込みます。コンテンツハッシュを使うため、変更されたものだけがパイプラインに戻されます(仕組みとして増分処理になります)。
- エージェントの成長とともに育ちます。
growmos remember/link/journalは、出典情報(session:2026-08-17)付きの1行で使える書き込み手段です。Gitフックはコミットごとに変更されたドキュメントをキューに追加します。 - 自ら解決します。 新しい名前を正規のエンティティ集合と照合し、一致しない名前は単一要素の暫定クラスターになります(情報が黙って失われることはありません)。その後、エージェントが説明を使って暫定エンティティをクラスタリングします(「Edwin Aldrin」→「Buzz Aldrin」)。
- 引用付きで回答します。
growmos queryは質問を中心としたkホップのサブグラフをシリアル化します。回答ではエッジIDを引用する必要があり、growmos checkはエッジに照らして主張を事実確認します。 - 手作業なしで自らを測定します。
growmos nextは、正解セットのパケット(エージェントがソースドキュメントから参照回答を作成)と、定期的なレビューパケット(1つのノードのエッジを出典と照合)も配布します。そのため、growmos eval(P/R/F1、未解決と解決済みの両方)、10項目のgrowmos doctorチェックリスト、ヘルスシグナル(コンポーネント、密度、圧縮度)がすべて自動で健全な状態に保たれます。すべての正解ファイルには、誰がレビューしたか(agent/human)が記録されます。人間はいつでも上書きできますが、その必要はありません。 - 自らを可視化します。
growmos viewは、自己完結型のオフライン対応インタラクティブエクスプローラーを開きます(フォースレイアウト、検索、タイプフィルター、ノードをクリックしてプロフィール、エッジ、出典情報を表示)。サーバーも依存関係も不要です。それ以外の用途にはgrowmos export --format html|json|dot|mermaid|cypher|sqlを使います。 - エージェントを前提に設計されています。 APIキーは不要です。CLIが決定論的な処理を行い、判断が必要な処理(抽出、解決、要約)は、すでに利用している任意のエージェントにタスクパケットとして渡します。タスクパケットには、プロンプト+JSON形式+正確な
growmos apply …コマンドが含まれます。オプションのヘッドレスモード(growmos ingest)では、Anthropic/OpenAI互換/xAI APIを呼び出し、cronとCIで実行できます。
インストール
pip install growmos # or: pipx install growmos / uv tool install growmos
Python ≥ 3.9、依存関係はありません。(ソースからの場合:pip install .)
60秒で始める
cd your-repo
growmos init                 # creates .growmos/, detects your agent CLI, wires it, scans docs
growmos next                 # → first task packet (extraction of README.md)
ここからは自動で動作します。
- Claude Code(フックあり):セッション開始時にブリーフが挿入され、作業が保留中の場合はループを実行するようエージェントに指示します。ターン終了時には
Stopフックがドキュメントをスキャンし、新しいパケットがあれば、グラフが最新状態になり、ジャーナルが記録されるまでエージェントの作業を続けさせます。こちらから依頼する必要はありません。 - Codex / Grok / Cursor / Gemini(フックなし):同じプロトコルが
AGENTS.md/.cursor/rulesにあります。「ブリーフに保留中の作業が示されていたら、終了する前にループを実行する」という内容です。エージェントはこれに従います。また、*"ナレッジグラフを成長させて"や"Xについてグラフは何と言っている?"*と伝えることもできます。 - キーボードの前に誰もいない場合: Gitフックがコミットごとに変更されたドキュメントをキューに追加し、cron/CI上の
growmos ingest(ヘッドレスモード)がAPIキーを使ってループ全体を実行します。
手動で実行する場合のループは次のとおりです。
growmos next                                 # packet: prompt + shape + apply command
#   … agent produces the JSON …
growmos apply extraction out.json --source src_ab12 --chunk 0
growmos next                                 # → resolution → profiles → gold set → review → "up to date"
growmos query "what depends on the Store and who decided that?"
growmos remember "Scheduler" --type COMPONENT --desc "Schedules jobs; depends on Store."
growmos link "Scheduler" "depends on" "Store"
growmos journal "Moved Store to Postgres (ADR-001)."
growmos check "(Alice Chen) --[owns]--> (Scheduler)"
growmos view                                 # open the interactive explorer in your browser
growmos status · growmos context · growmos doctor · growmos eval · growmos sample
エージェント CLI でプラグ&プレイ
| CLI | growmos init --agent … が書き込むもの | エージェントの使用方法 |
|---|---|---|
| Claude Code | CLAUDE.md ブロック、.claude/skills/growmos/SKILL.md、.claude/settings.json 内の SessionStart/Stop フック、.mcp.json | セッション開始時にコンテキストを注入し、グラフ関連の依頼でスキルが起動します。MCP ツールも利用できます |
| Codex CLI | AGENTS.md ブロック(+オプションの MCP サーバー) | Codex が AGENTS.md を読み込みます。ツールを使いたい場合は、MCP サーバーとして growmos mcp を実行します |
| Grok CLI / その他 | AGENTS.md ブロック、.mcp.json | AGENTS.md または MCP に対応するあらゆる CLI で利用できます |
| Cursor | .cursor/rules/growmos.mdc(alwaysApply) | すべてのチャットでルールが読み込まれます |
| Gemini CLI | GEMINI.md ブロック | 同じプロトコルです |
| 任意のファイル | growmos integrate file --file path/to/instructions.md | プロトコルブロックを任意の場所に追加します |
| git | growmos integrate hooks → post-commit、post-merge、post-checkout | 変更されたドキュメントを自動的にキューに追加します |
| CI | growmos integrate ci → .github/workflows/growmos.yml | すべての PR で doctor と eval を実行します |
| MCP | growmos integrate mcp → .mcp.json(+ .cursor/mcp.json) | あらゆる MCP クライアント向けのツール(以下を参照) |
growmos init --agent all は上記をすべて実行します。すべて冪等です(マーカーブロック、JSON のマージ)。
MCP サーバー(MCP 対応のあらゆるクライアント)
growmos mcp は依存関係ゼロの MCP stdio サーバーです。他の MCP サーバーと同じ方法で登録できます。growmos integrate mcp が設定を書き込むほか、自分で貼り付けることもできます。
{
  "mcpServers": {
    "growmos": {
      "command": "growmos",
      "args": ["mcp"]
    }
  }
}
| クライアント | 設定場所 |
|---|---|
| Claude Code | リポジトリ内の .mcp.json(growmos init / integrate claude が書き込みます)、または claude mcp add growmos -- growmos mcp |
| Cursor | .cursor/mcp.json(integrate cursor / integrate mcp が書き込みます) |
| Codex CLI | ~/.codex/config.toml:[mcp_servers.growmos] command = "growmos" args = ["mcp"] |
| Gemini CLI | ~/.gemini/settings.json → 上記と同様に mcpServers.growmos |
| Grok CLI / その他 | 各自の MCP 設定で、同じ JSON を使用します |
mcp-name: com.codician/growmos
公開されるツール:growmos_context、growmos_query、growmos_entity、growmos_search、
growmos_remember、growmos_link、growmos_journal、growmos_check、growmos_next、
growmos_apply、growmos_status、growmos_sample。登録すると、エージェントはシェルコマンドを実行せず、これらのツールを直接呼び出します。たとえば、「Store に依存しているものは?」 → growmos_query、「Scheduler が Kafka を使うようになったことを記録して」 → growmos_remember + growmos_link、「グラフを成長させて」 → growmos_next / growmos_apply を繰り返し実行します。
.growmos/ に格納されるもの(コミットしてください)
.growmos/
  config.json       include globs, caps (max_docs_per_run, max_entities_per_doc), provider
  schema.json       versioned entity types + predicate hints (bump on change; rows carry schema_version)
  state.json        the loop's state file: runs, pending re-summarizations, last sample/eval
  sources.jsonl     every document eaten: ref, sha256, status (pending|extracted|note|missing)
  mentions.jsonl    raw per-document extraction output (append-only provenance)
  entities.jsonl    canonical nodes (id, name, type, description, sources, mentions, provisional)
  aliases.jsonl     alias → entity (the alias map)
  relations.jsonl   edges: source, predicate, target, sources[], confidence (= corroborating docs)
  profiles/*.json   hub-node profiles (summary, key facts, time range), keyed to source-set hash
  prompts/*.md      the four playbook prompts + evaluator prompt — yours to tune
  eval/gold/*.json  hand-labelled gold sets · eval/aliases.json scorer alias map
  journal.md        the shared memo, append-only
プレーンな JSONL 形式なので、差分を確認しやすく、マージしやすく、grep で検索でき、表示(growmos view)やエクスポート(growmos export --format html|json|dot|mermaid|cypher|sql)も可能です。ストレージはインフラに関する判断であり、パイプラインに関する判断ではありません。同じスキーマを Neo4j や 3 つの Postgres テーブルに対応させられます。
設定と大規模プロジェクト
調整可能な設定はすべて .growmos/config.json(growmos config <key> [value])にあります。デフォルト値は一般的なリポジトリ向けです。大規模なリポジトリでは、次の 3 つの設定が重要です。
max_docs_per_run(デフォルトは 1 日あたり 50 件)— 暴走する無人の実行を抑えるための速度制限であり、上限ではありません。バックフィルを自分やエージェントが実行する場合は、growmos next --forceを使うか、growmos config max_docs_per_run 0を設定します。エージェントにもこの方法が伝えられるため、ここで止まることはありません。include/exclude— ナレッジとして扱うドキュメントを指定します(デフォルトでは README、ADR、設計ドキュメント。ソースコードは対象外です。エージェントはremember/linkを使って、コードの意味を記録します)。chunk_chars(6 000)— 長いドキュメントを処理する際の分割サイズです。
完全なリファレンス(すべてのキー、モノレポ、コストに関する注記):docs/configuration.md。
プリセット
growmos init --preset software|general|research|business — 同じプロンプトに、拡張されたエンティティ語彙(プレイブックの 5 つの基本タイプとドメイン別タイプ)を使用します。growmos remember --type NEWTYPE を使うと、実行中にスキーマを拡張できます(スキーマのバージョンが上がります)。
ヘッドレス/夜間モード(任意)
export ANTHROPIC_API_KEY=…    # or OPENAI_API_KEY / XAI_API_KEY, or GROWMOS_PROVIDER + GROWMOS_BASE_URL
growmos ingest --scan          # extraction (fast model) → resolution → profiles (reasoning model)
growmos query "…" --auto
プレイブックのモデル分担(大量の抽出には高速なモデル、判断にはより高性能なモデル)に従います。max_docs_per_run で実行件数を制限します(デフォルトは 1 日あたり 50 件。大規模なバックフィルを行う場合は growmos next --force または growmos config max_docs_per_run 0 を使用してください)。大規模なコーパスでは、プロンプトキャッシュとバッチ処理が次に取り組むべき自然な最適化です。
運用上の規律(組み込み済み)
- グラフをサンプリングする —
growmos sample(7 日後に doctor が警告します)。 - 抽出量を制限する —
max_docs_per_run(1 日あたり 50 件。壁ではなく、速度を上げるための制限です。growmos next --force、または大規模なバックフィルにはgrowmos config max_docs_per_run 0を使用してください)、max_entities_per_doc。 - スキーマをバージョン管理する —
growmos schema bump --note … --add-type …。 - 名前を決して失わない — 照合されなかった名前は、要素が 1 つだけのクラスターになります。
- すべてのエッジに出典情報を付与する — さらに、裏付けの件数も記録します。
- ソースセットが変わった場合にのみ再要約する — プロファイルにはソースセットのハッシュが含まれます。
- 接続性と密度を監視する —
growmos statusはコンポーネント/密度/圧縮率を表示します。
ドキュメント
- METHODOLOGY.md — ツールに依存しない、進化するナレッジグラフの方法論
- docs/agents.md — CLI ごとのセットアップとエージェントプロトコル
- docs/file-format.md — ストアのレイアウトと JSON の形式
- docs/evaluation.md — ゴールドセット、スコアリング、プロンプト調整のループ
- docs/configuration.md — すべての設定キー、大規模プロジェクト、モノレポ
- docs/headless.md — プロバイダーモード、cron、CI
- examples/apollo — プレイブックの Apollo コーパスを 1 つのスクリプトで再構築
貢献
PR を歓迎します。CONTRIBUTING.md をご覧ください。python -m unittest discover -s tests を実行してください。
MIT © 2026 Codician。Anthropic とは提携していません。実装されている方法論は、Anthropic が公開しているナレッジグラフのクックブックとエージェントパターンに関する文章を統合したものです。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。