Context Lens について
Context Lens は、ローカルファイル・フォルダー・GitHub リポジトリを AI アシスタント向けのセマンティック検索ナレッジベースに変換する MCP サーバーです。組み込みの LanceDB をベクトルストアとして使用し、クラウドサービスや API キーは不要です。
主な機能
- 01意味に基づくセマンティック検索
- 02組み込み LanceDB によるベクトル保存
- 03ローカルファイルと公開 GitHub リポジトリに対応
- 04ファイル種別に応じた構造认識チャンク分割
- 05データをローカルマシンに保存
活用シーン
- 01コードベースについて AI アシスタントに質問に答えさせる
- 02契約書やポリシー文書から条項を検索する
- 03インターネット接続なしで取り込み済み資料を参照する
MCP 対応
Context Lens は MCP サーバーとして動作し、Claude Desktop や Cursor などの MCP クライアントに add_document、search_documents、list_documents、remove_document などのツールを公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Context Lens
AI がキーワードを照合するだけでなく、意味を理解できるようにします。


Context Lens とは?
Context Lens は、あらゆるコンテンツを AI アシスタント向けの検索可能なナレッジベースに変換します。サーバーレスのベクトルストレージ(LanceDB)を内蔵したこの自己完結型の Model Context Protocol(MCP)サーバーにより、会話でセマンティック検索を利用できます。コードベース、ドキュメント、契約書、テキストファイルなど、あらゆるコンテンツを指定すれば、AI がそのコンテンツをすぐに理解し、質問に回答できるようになります。
従来のキーワード検索では、特定の単語を含むファイルが見つかります。正確な用語を使わなければ、コンテンツを見つけられません。
Context Lensは意味を理解します。「認証」について質問すると、ファイル内で「認証」という単語が使われていなくても、ログイン、資格情報、トークン、OAuth、アクセス制御に関するコードが見つかります。
実際の動作を見る
Context-Lens の仕組みを知りたいですか?楽しい使い方があります。Context-Lens について知るために、Context-Lens を使えます。
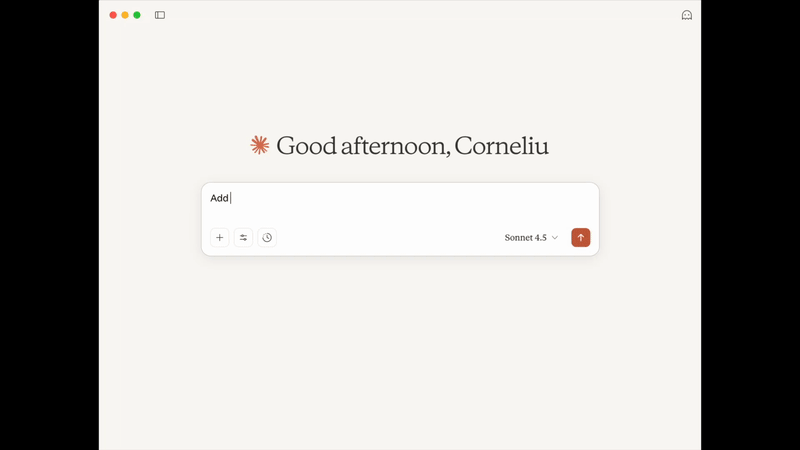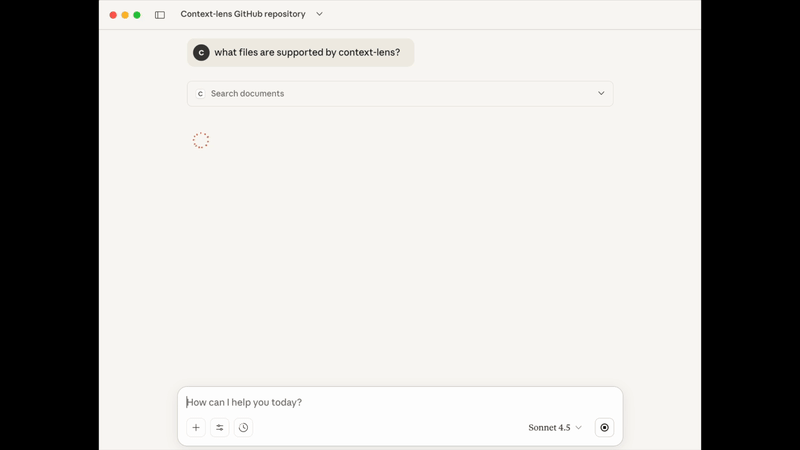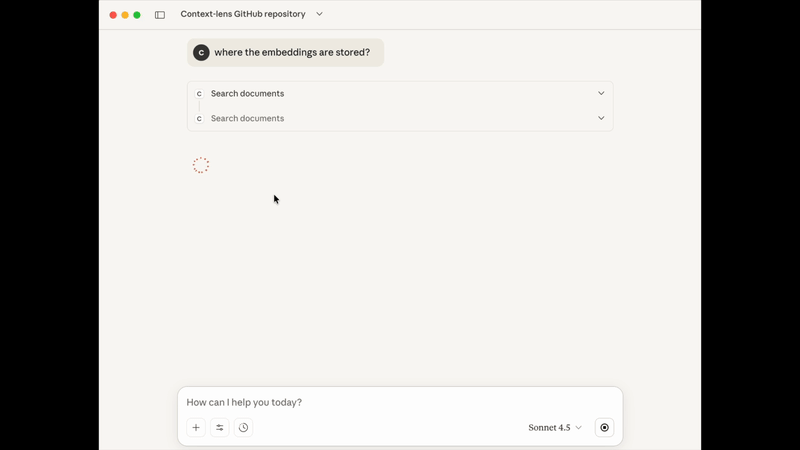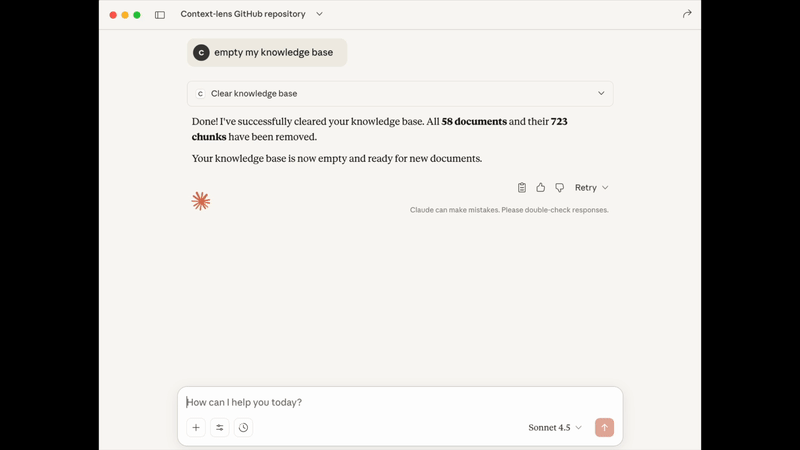
デモ:Claude Desktop と Context-Lens を使って、このリポジトリ自体にインデックスを作成し、検索しています。git clone もコードをスクロールして探す必要もありません。質問と回答だけです。
なぜ LanceDB なのか?
Context Lens は、最新のサーバーレスベクトルデータベースであるLanceDBを使用します。
- 🆓 完全無料でローカル - クラウドサービス、API キー、サブスクリプションは不要です
- ⚡ インフラ不要 - ディスク上のファイルだけで動作する組み込みデータベースです
- 🚀 高速で効率的 - Apache Arrow を基盤とし、ベクトル検索向けに最適化されています
- 💾 シンプルなストレージ - 単一ファイルのデータベースで、簡単にバックアップや移動ができます
「AI 埋め込み向けの SQLite」のようなものと考えてください。複雑さを伴わずに、ベクトル検索の力を活用できます。
機能
- 🔍 セマンティック検索 - キーワードだけでなく、意味を理解します
- 🚀 セットアップ不要 - インストール、設定、API キーは不要です
- 💾 サーバーレスストレージ - LanceDB を内蔵し、外部データベースは不要です
- 🔒 100%ローカルでプライベート - すべてのデータはお使いのマシン内にとどまります
- 📁 ローカルと GitHub - ローカルファイルまたは公開 GitHub リポジトリにインデックスを作成できます
- 🎯 スマートな解析 - より良い検索結果を得られるよう、言語を考慮してチャンク化します
アーキテクチャ
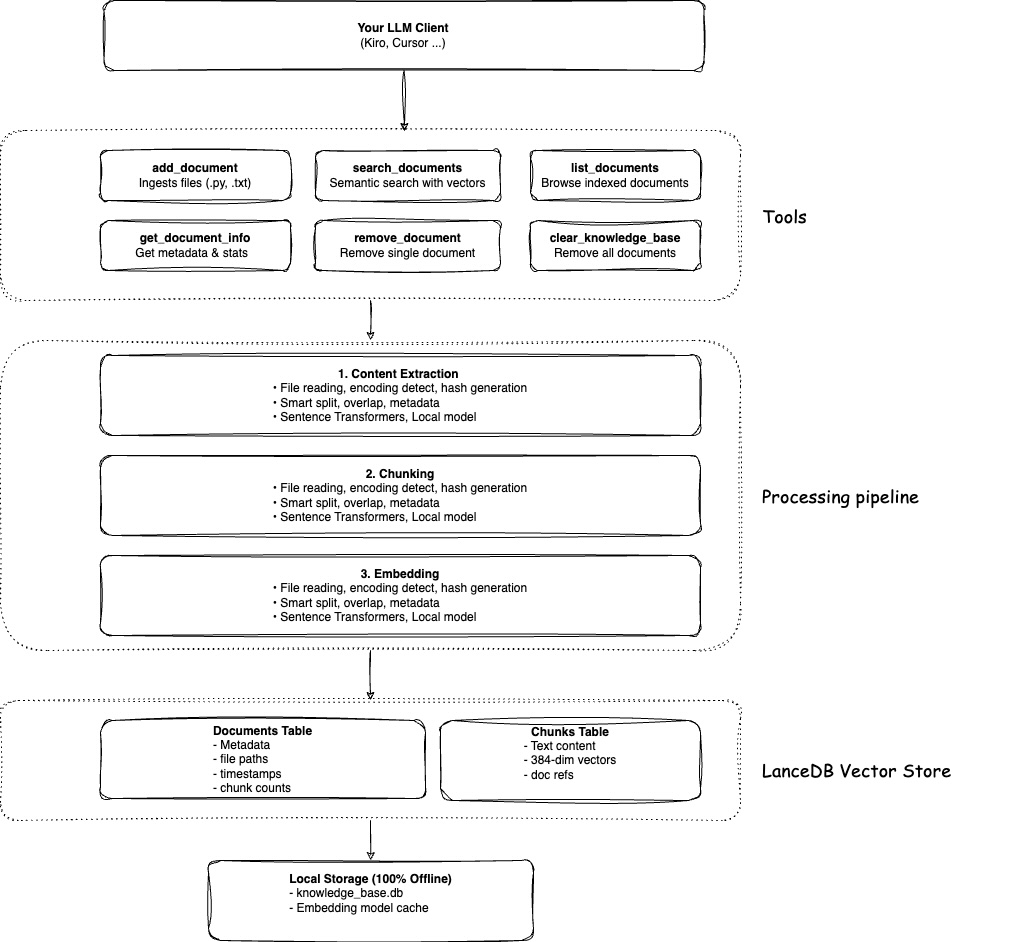
仕組み
Context Lens にコンテンツを追加すると、単にテキストをデータベースに放り込むわけではありません。実際の処理は次のとおりです。
スマートな読み込み: Context Lens はファイルの種類を検出し、専用のパーサーを使用します。Python ファイルは AST 解析で分析され、JSON は構造に従って解析され、Markdown は見出しごとに分割されます。これにより、コンテンツの自然な構造が保たれます。
意味のあるチャンク: 任意の文字数で分割するのではなく、完全な関数、論理的な段落、セクション全体など、コンテンツを適切にチャンク化します。コードが関数の途中で分割されることはありません。
セマンティックベクトル: 各チャンクは、ローカルの埋め込みモデルを使って 384 次元のベクトルに変換されます。これらのベクトルは単語だけでなく、意味を捉えます。「認証」と「ログインシステム」は、単語が一切共通していなくても、類似したベクトルになります。
ローカルストレージ: すべてのデータは、ディスク上のファイルだけで動作するサーバーレスベクトルデータベース LanceDB に保存されます。クラウドサービスも API 呼び出しも不要で、完全にプライベートです。
概念検索: 質問すると、それもベクトルに変換されます。Context Lens は類似したベクトル(意味が似ているもの)を持つチャンクを見つけ、関連度順に並べます。キーワードの一致ではなく、概念に基づいた回答を得られます。
技術仕様
| コンポーネント | 詳細 |
|---|---|
| 埋め込みモデル | sentence-transformers/all-MiniLM-L6-v2 |
| ベクトル次元数 | 384 次元 |
| モデルサイズ | 約 90MB(初回使用時にダウンロード) |
| チャンクサイズ | 1000 文字(デフォルト、設定可能) |
| チャンクの重なり | 200 文字(デフォルト、設定可能) |
| ベクトルデータベース | LanceDB(サーバーレス、ファイルベース) |
| ストレージ形式 | Apache Arrow 列指向形式 |
| 検索方法 | コサイン類似度 |
| 処理 | 100%ローカルで実行され、外部 API は呼び出しません |
📖 カスタマイズをご希望ですか? 設定オプションについては SETUP.md を、パフォーマンスベンチマークについては TECHNICAL.md をご覧ください。
クイックセットアップ
Kiro IDE
.kiro/settings/mcp.json に追加します。
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "autoApprove": ["list_documents", "search_documents"]
    }
  }
}
再読み込み:コマンドパレット → 「MCP: Reload Servers」
Cursor
.cursor/mcp.json に追加します。
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
その他の MCP クライアント
Claude Desktop、Continue.dev、その他の MCP 互換クライアントの場合:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
📖 詳細なセットアップ手順が必要ですか? すべてのクライアント、プログラムからの使用方法、設定オプションについては SETUP.md をご覧ください。
MCP レジストリ
Context Lens は、公式の Model Context Protocol Registry に io.github.cornelcroi/context-lens として公開されています。
📖 レジストリの詳細と検証: インストールの検証とレジストリ情報については REGISTRY.md をご覧ください。
プログラムからの使用
Context Lens を Python アプリケーションで直接使用します。
#!/usr/bin/env python3
import os
from dotenv import load_dotenv
from mcp import StdioServerParameters, stdio_client
from strands import Agent
from strands.models.openai import OpenAIModel
from strands.tools.mcp import MCPClient

def main():
    # Load environment variables from .env file
    load_dotenv()

    # Create MCP client for context-lens server
    mcp_client = MCPClient(
        lambda: stdio_client(
            StdioServerParameters(command="uvx", args=["context-lens"])
        )
    )

    # Create an agent with OpenAI model and MCP tools
    model = OpenAIModel(model_id="gpt-4o-mini")
    agent = Agent(model=model, tools=[mcp_client])

    print("Chatbot started! Type 'quit' to exit.")

    while True:
        user_input = input("\nYou: ").strip()

        if user_input.lower() in ['quit', 'exit', 'bye']:
            print("Goodbye!")
            break

        if not user_input:
            continue

        try:
            response = agent(user_input)
            print(f"Bot: {response}")
        except Exception as e:
            print(f"Error: {e}")

if __name__ == "__main__":
    main()
会話の例:
You: Add https://github.com/fastapi/fastapi to the knowledge base
Bot: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
Bot: FastAPI uses a sophisticated dependency injection system...
📖 全例: 完全なコードとその他のフレームワークについては、SETUP.md をご覧ください。
クイックスタート
プロジェクトを追加
You: Add all Python files from ./src to the knowledge base
LLM: ✓ Added 23 Python files with 156 chunks

You: How does the authentication system work?
LLM: The authentication system uses JWT tokens. The login flow starts in
     auth/login.py where credentials are validated, then a token is generated
     with the user's ID and expiration time...

You: Show me all the database models
LLM: Based on the codebase, here are the main database models:
     1. User model (models/user.py) - handles user accounts and authentication
     2. Post model (models/post.py) - manages blog posts with relationships...
オープンソースから学習
You: Add https://github.com/fastapi/fastapi to the knowledge base
LLM: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
LLM: FastAPI uses a sophisticated dependency injection system. The Depends()
     function in fastapi/dependencies.py analyzes function signatures and
     automatically resolves dependencies. Here's how it works...

You: Compare FastAPI's routing to Flask
LLM: FastAPI uses decorator-based routing similar to Flask, but with key
     differences: 1) Type hints for automatic validation, 2) Async support
     built-in, 3) Automatic OpenAPI documentation generation...
ドキュメントを分析
You: Add all contracts from ./legal/contracts
LLM: ✓ Added 12 contract documents with 487 chunks

You: Find all termination clauses
LLM: I found termination clauses in 8 contracts. Here's a summary:
     - Service Agreement: 30-day notice required for either party
     - Vendor Contract: Immediate termination for breach of confidentiality...

You: What are the payment terms across all contracts?
LLM: Payment terms vary by contract type:
     - Service contracts: Net 30 days from invoice date
     - Vendor agreements: 50% upfront, 50% on delivery...
URL からファイルを取得
You: Add https://raw.githubusercontent.com/fastapi/fastapi/master/README.md
LLM: ✓ Document 'README.md' added successfully with 42 chunks

You: What is FastAPI and what are its key features?
LLM: FastAPI is a modern, fast web framework for building APIs with Python 3.7+.
     Key features include:
     - Fast performance (on par with NodeJS and Go)
     - Automatic API documentation
     - Type hints for validation
     - Async support built-in...
📖 その他の例とクエリパターン: USAGE_GUIDE.md
スマートな解析とチャンク分割
Context Lens は単にテキストを無作為に分割するのではなく、コード構造を理解し、言語の境界を尊重したインテリジェントなチャンクを作成します。
違い: 汎用的なチャンク分割では、文字数に基づいてコードを任意に分割するため、関数の途中で分断されることがよくあります。スマート解析ではコード構造を理解し、完全で意味のあるチャンクを作成します。
対応ファイル形式
- 🐍 Python(
.py、.pyw)- 関数、クラス、インポート - ⚡ JavaScript/TypeScript(
.js、.jsx、.ts、.tsx、.mjs、.cjs)- 関数、クラス、インポート - 📦 JSON(
.json、.jsonc)- トップレベルのキー、ネストしたオブジェクト - 📋 YAML(
.yaml、.yml)- トップレベルのキー、リスト、マッピング - 📝 Markdown(
.md、.markdown、.mdx)- 見出し階層、コードブロック - 🦀 Rust(
.rs)- 構造体、トレイト、impl ブロック、関数 - 📄 その他のファイル(
.txt、.log、.cpp、.javaなど)- 段落や文をインテリジェントに分割
メリット
✅ 完全なコード単位 - 関数やクラスの途中で分割されることはありません
✅ コンテキストを保持 - ドキュメント文字列、コメント、構造がそのまま維持されます
✅ 検索性の向上 - 完全で理解しやすいコードスニペットを検索できます
✅ 自動処理 - 設定は不要で、ファイル拡張子に基づいて動作します
📖 仕組みをご覧になりますか? 詳しい例については PARSING_EXAMPLES.md をご覧ください。
追加できるもの
Context Lens は、複数のソースにあるテキストベースのファイルに対応しています。
- 📁 ローカルファイルとフォルダー - プロジェクト、ドキュメント、あらゆるテキストファイル
- 🌐 GitHub リポジトリ - パブリックリポジトリ、特定のブランチ、ディレクトリ、ファイル
- 🔗 ファイルの直接 URL - HTTP/HTTPS でアクセスできるあらゆるファイル
- 📄 ドキュメント - 契約書、ポリシー、研究論文、技術文書
対応ファイル形式: .py、.js、.ts、.java、.cpp、.go、.rs、.rb、.php、.json、.yaml、.md、.txt、.sh など(25 種類以上の拡張子)
ファイルサイズの上限: 10 MB(環境変数 MAX_FILE_SIZE_MB で設定可能)
例:
./src/- ローカルディレクトリ/path/to/file.py- ローカルの単一ファイルhttps://github.com/fastapi/fastapi- リポジトリ全体https://github.com/django/django/tree/main/django/contrib/auth- 特定のディレクトリhttps://example.com/config.yaml- ファイルの直接 URL/path/to/contracts/- 法的文書
📖 その他の例: USAGE_GUIDE.md
利用可能なツール
- 📥 add_document - ファイル、フォルダー、GitHub URL を追加
- 🔍 search_documents - すべてのコンテンツを対象にセマンティック検索
- 📋 list_documents - インデックス済みのドキュメントを閲覧
- ℹ️ get_document_info - ドキュメントのメタデータを取得
- 🗑️ remove_document - 特定のドキュメントを削除
- 🧹 clear_knowledge_base - すべてのドキュメントを削除
📖 詳しい例: USAGE_GUIDE.md
FAQ
GitHub の MCP サーバーとはどう違いますか?
用途が異なり、互いに補完し合います。
Context Lens が適している用途:
- 🧠 セマンティックな理解 - 「認証コードを探して」と検索すると、完全一致するキーワードがなくても、ログイン、認証情報、トークン、OAuth が見つかります
- 📚 コードベースの学習 - 「X はどのように動作しますか?」と質問すると、プロジェクト全体から概念的に関連する結果が得られます
- 🔍 パターンの発見 - 類似したコードパターン、エラー処理の手法、アーキテクチャ上の判断を見つけます
- 💾 オフライン開発 - インデックス作成後は、インターネット接続なしで動作します
- 🔒 プライバシー - すべての処理がローカルで行われ、外部サービスにデータが送信されません
GitHub の MCP サーバーが適している用途:
- 🔧 リポジトリ管理 - Issue の作成、PR の管理、CI/CD 操作への対応
- 📊 リアルタイムの状態確認 - GitHub から常に最新バージョンを取得します
- 🌐 GitHub 固有の機能 - GitHub のエコシステム(Actions、Projects など)と連携します
主な違い: Context Lens は一度クローンしてすべてにインデックスを作成し、高速なセマンティック検索をオフラインで行います。GitHub MCP はクエリごとに API を呼び出し、オンラインでリアルタイムにアクセスします。コードの理解には Context Lens、リポジトリの管理には GitHub MCP を使用してください。
初回実行が遅いのはなぜですか?
埋め込みモデル(約 100MB)は初回使用時にダウンロードされます。これは一度だけです。
API キーは必要ですか?
いいえ!Context Lens は完全にローカルで動作します。API キーもクラウドサービスも必要ありません。
データはどこに保存されますか?
Context-Lens は、プラットフォーム固有のディレクトリにデータを保存します。
- macOS:
~/Library/Application Support/context-lens/ - Linux:
~/.local/share/context-lens/ - Windows:
%LOCALAPPDATA%\context-lens\
環境変数 CONTEXT_LENS_HOME を設定すると、ベースディレクトリを変更できます。
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "env": {
        "CONTEXT_LENS_HOME": "/path/to/your/data"
      }
    }
  }
}
または、LANCE_DB_PATH(データベース)と EMBEDDING_CACHE_DIR(モデル)を使って、個別のパスを上書きできます。
非公開コードにも使えますか?
はい!すべての処理はローカルで行われます。外部サービスにデータが送信されることはありません。
ディスク容量はどのくらい使いますか?
モデルに約 100MB、テキストチャンクあたり約 1KB です。10MB のコードベースの場合、データベース容量は約 5~10MB です。
📖 その他の質問: TROUBLESHOOTING.md
ドキュメント
- 📖 セットアップガイド - すべてのクライアント向けの詳細なセットアップと設定オプション
- 📚 使用ガイド - 例、クエリ、ベストプラクティス
- 🎨 解析例 - スマート解析の仕組み
- 🔧 トラブルシューティング - よくある問題と解決策
- ⚙️ 技術的な詳細 - アーキテクチャ、技術スタック、パフォーマンス
- 📋 レジストリ情報 - MCP Registry の検証とインストール
- 🤝 貢献ガイド - 貢献方法、ロードマップ
- 📦 公開ガイド - MCP Registry への公開プロセス(メンテナー向け)
貢献
貢献を歓迎します!次の手順に従ってください。
- まず Issue を作成し、アイデアについて話し合います
- 作業を始める前に承認を得ます
- Issue を参照する PR を提出します
詳しくは CONTRIBUTING.md をご覧ください。
ライセンス
MIT License - 詳細は LICENSE をご覧ください。
役に立ったら、このリポジトリにスターを付けてください! ⭐
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。