Knowledge Graph RDBMS について
Knowledge Graph RDBMSは、SQLiteとPostgresを基盤とするラベル付きプロパティグラフデータベースです。組み込み型のグラフストレージやエージェントの記憶、追跡可能なデータを求める開発者向けで、書き込みの監査、再生、取り消しに対応します。
主な機能
- 01SQLiteのラベル付きプロパティグラフ
- 02複数オントロジーのルーティング
- 03ゲート付きの監査可能な書き込み
- 04イベントの再生と取り消し
- 05ライブラリ、CLI、MCPサーバー
活用シーン
- 01アプリケーションへのグラフストレージ組み込み
- 02エージェントの監査可能な記憶の保存
- 03宣言型データセットからのグラフ再構築
- 04リレーショナルデータの実体と関係によるモデル化
MCP 対応
MCPサーバーはクライアントにグラフデータへのアクセスを提供します。書き込みは安全ゲートを通り、CLIやライブラリと共通の経路でイベントログに記録されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx knowledge-graph-rdbmsKGRDBMS_HOMEStorage root for ontology databases and the event log. Defaults to ~/.kgrdbms.KGRDBMS_DEFAULT_ONTOLOGYName of the default ontology used when a tool call omits the `ontology` argument. Defaults to "default".ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
knowledge-graph-rdbms


完全に自分で所有できる、埋め込み型ナレッジグラフ — 1つの SQLite ファイルに収まります。
SQLite ネイティブ · コアは依存関係ゼロ · MCP 対応 · イベントソーシング · 変更を元に戻せます。
あらゆるものをエンティティとリレーションシップとしてモデル化できます — エージェントのメモリ、アプリのオントロジー、宣言型データセット、「データがグラフになった SQLite」など — Neo4j、RDF、Docker、別個のグラフサービスを実行する必要はありません。Cypher も JVM もサーバーも不要です。5つのテーブルと、コピー、調査、バージョン管理ができる1つのファイルだけです。
pip install "knowledge-graph-rdbms[mcp]"

# write a fact — auto-creates the graph in one SQLite file
kg node add person:ada --kind Person --name "Ada Lovelace"

# every write is logged; tail the log and roll any event back by id
kg events -n 5
kg revert <event_id>

# rebuild the graph as of any past moment — literal time travel
kg replay --upto 2026-01-01T00:00:00

# expose the whole graph to an AI agent over MCP
kg serve
   Agent / CLI / Python
            │
     gated + logged writes
            │
   SQLite label property graph
            │
    replay · revert · time-travel
Python 3.10+ · MIT · コアは依存関係ゼロ · ライブラリ + CLI + MCP
世界はテーブルの行ではなく、もの、そのものが属する種類、そしてもの同士の関係でできています。ラベル付きプロパティグラフは、まさにそれを捉え、それ以上のものはほとんど含みません。ノード(エンティティ)、型付きエッジ(リレーションシップ)、ラベル(集合)、そしてJSON プロパティ(その他すべて)です。事前に設計するスキーマはありません。事実を重ねることで意味が蓄積され、構造は記述対象のドメインと同じように柔軟なままです。
この柔軟性こそが、AI エージェントにとって自然な基盤となる理由です。エージェントにこのグラフへの MCP 接続を渡せば、エージェントならではの能力を発揮できます。ドメインを読み取り、学んだことをモデル化し、アイデアを結び付け、文章ではなく構造をもとに推論できます。すべての書き込みはゲートによって制御され、実行者が記録され、イベントログに追記されます。そのため、エージェントはグラフを自由に再構成できる一方で、変更の記録は手元に残ります。監査したり、任意の時点まで再生したり、1つのコマンドで変更をロールバックしたりできます。何を記録するだけでなく、なぜそうしたのかも記録するメモリ — エージェントが動作する場所ならどこへでも持ち運べる、1つの埋め込み可能なファイルです。ノートパソコン、CI ジョブ、サーバーレス関数、Pi などで利用できます。
頭の中に収まるほど小さく、あらゆるものをモデル化できるほど柔軟です。
目次
- 適した用途
- なぜ X ではないのか?
- 30秒でわかるアイデア
- 設計思想
- データモデル
- アーキテクチャ:3つの入口と1つのエンジン
- 複数のオントロジー:1つのコントロールプレーン
- ディスカバリー:クエリの前にスキーマを読む
- オントロジー間連携:フェデレーションとバックボーン
- イベントソーシング:グラフはプロジェクション
- 安全性ゲート:不変条件とポリシー
- インストール
- クイックスタート
- パフォーマンス
- RDF 相互運用:エクスポート、SPARQL、RDF-star
- コマンドリファレンス
- プロジェクト構成
- 開発
- ライセンス
適した用途
すべてを完全に所有したいグラフのために作られています。調査できるほど小さく、組み込みに十分な速さがあり、信頼できるほど透明です。
- 組み込みオントロジー — 1 つのアプリやサービスに同梱され、コピーしてバージョン管理できる 1 つのファイルに収まるナレッジグラフ。
- エージェントとアシスタントのメモリ — AI が MCP 経由で読み書きできる事実。完全な監査証跡と、1 コマンドでのロールバックに対応します。
- 宣言的データセット — ベースグラフを YAML/JSON の事実として記述し、クエリ可能なグラフに決定論的に再適用できます。
- 「SQLite だけれど、データがグラフ」 — リレーショナルな行が関係を表し始めたとき、それらに自然に適した場所です。
設計の中心は、読み取りが多く、書き込みは単一で、ノード数は数百万件未満です。SQLite 自体と同じく最適な用途を狙っています。つまり、1 つのファイル、プロセス内で動作し、実行するサーバーは不要です。これは、実際の作業の驚くほど多くをカバーします。この中心的な用途を超えるワークロードについては、パフォーマンスで性能曲線がどこで変わり、専用グラフエンジンの追加の複雑さが見合い始めるのかを具体的に示しています。
なぜ X ではないのか?
正直な比較です。適切なツールを選び、そのツールがこのツールである場合を正確に把握してください。
なぜ Neo4j ではないのか?
深いトラバーサル、複雑な Cypher のパターンマッチング、同時書き込み、またはクラスタ化されたグラフインフラストラクチャが必要なら、Neo4jを使ってください。小規模な組み込みグラフ、エージェントのメモリ、監査可能性、ローカルファーストな所有、SQLite の導入の簡潔さが必要なら、kgrdbmsを使ってください。
なぜ NetworkX ではないのか?
NetworkXは、メモリ内アルゴリズムに優れています。kgrdbmsは、永続ストレージ、CLI/MCP アクセス、イベント履歴、ロールバックに対応した、永続的なグラフ状態のためのものです。
なぜ RDFLib ではないのか?
RDFLibは、RDF グラフとリンクトデータのワークフロー向けです。kgrdbmsは、RDF をエクスポート/インポートの境界として扱うラベル付きプロパティグラフであり、トリプルストアではありません。
なぜ単に SQLite のテーブルを使わないのか?
一部のドメインは、長方形のテーブルではなく、エンティティと関係として表すのが自然だからです。kgrdbmsはストレージをシンプルに保ちながら、グラフに適したモデルを実現します。
30 秒でわかるアイデア
ラベル付きプロパティグラフに必要なプリミティブは 4 つだけです。
| プリミティブ | 内容 |
|---|---|
| ノード | 安定した ID、kind、表示用のname |
| エッジ | 2 つのノード間の、型付きで方向性のある関係 |
| ラベル | ノードに対する集合の所属(ノードごとに複数) |
| プロパティ | ノード または エッジに付与する、JSON 値のキー/バリューバッグ |
これらを SQLite に保存して、いくつかのインデックスを追加すれば、ナレッジグラフができあがります。このプロジェクトのその他すべて、つまりトラバーサル、追記専用の履歴、安全ゲート、CLI、MCP サーバーは、これら 4 つの事実を基盤に構築されています。
from kgrdbms import Graph

with Graph(path="demo.db") as g:
    g.add_node("person:ada", kind="Person", name="Ada Lovelace",
               labels={"Person"}, properties={"born": 1815})
    g.add_node("field:cs", kind="Field", name="Computer Science")
    g.add_edge("person:ada", "field:cs", "FOUNDED", properties={"year": 1843})

    print(g.shortest_path("person:ada", "field:cs"))
flowchart LR
    ada(["person:ada<br/>:Person<br/>born=1815"])
    cs(["field:cs<br/>:Field"])
    ada -->|"FOUNDED (year=1843)"| cs
設計哲学
1. 飾らないストレージは強みです。 SQLite は耐久性、トランザクション、インデックス、再帰クエリをすでに解決しています。これらを独自に作り直すことはありません。ファイルは1つだけで、バックアップするにはコピーし、内容を確認するには任意の SQLite ツールで開けます。
2. スキーマは画面に収まります。 テーブルは5つで、意外な仕掛けはありません。ストレージ層全体を読めば、あらゆる情報がどこに保存されるか正確に把握できます。巧妙さよりも読みやすさを重視します。
3. 状態はデータの純粋関数です。 クエリで取得するものは 射影 です。信頼できる情報源は、追記専用の事実ログと、任意で宣言するシードです。グラフ全体を再現できます。state = replay(seed + log)。この性質だけで、監査、取り消し、過去の状態への移動が無料で実現します。
4. 変更はゲートを通し、そのゲートは2層です。 エージェントに通信経由でグラフを書き換えさせるなら、ルールが必要です。一部のルールは 設定可能(ポリシー)ですが、交渉の余地がない(コンパイル時に組み込まれた不変条件)ルールもあります。意図的に仕組みとポリシーを分離しています。
5. 1つのエンジンに、複数の入口。 ライブラリの呼び出し、kg コマンド、MCP ツールはすべて、同じゲートとログを通る書き込みパスを経由して、同じファイルに書き込みます。「CLI 版」の真実と「MCP 版」の真実があるのではなく、真実は1つです。
6. 速度が必要なときだけ、速度に対価を払います。 個々の書き込みはすべて単独でコミットされます(デフォルトで安全です)。一括処理のパス(batch()、add_nodes、add_edges)を使えば、必要なときに約10倍のスループットを選択できます。
データモデル
グラフを構成するテーブルは5つです。ストレージ層はこれですべてです。
erDiagram
    nodes ||--o{ node_labels : "is labeled"
    nodes ||--o{ node_properties : "has"
    nodes ||--o{ edges : "from / to"
    edges ||--o{ edge_properties : "has"

    nodes {
        text id PK
        text kind
        text name
        text created_at
    }
    node_labels {
        text node_id FK
        text label
    }
    node_properties {
        text node_id FK
        text key
        text value_json
    }
    edges {
        text id PK
        text from_node FK
        text to_node FK
        text type
    }
    edge_properties {
        text edge_id FK
        text key
        text value_json
    }
重要な設計上のポイント:
- エッジは
(from_node, type, to_node)を一意キーとします。 同じ組み合わせを再追加すると、重複するのではなくプロパティが更新されます。設計上、冪等です。 - プロパティは JSON です。 値は保存した JSON 型のまま復元されます。整数、ブール値、リスト、ネストされたオブジェクトを扱えます。
- 外部キーは連鎖削除されます。 ノードを削除すると、そのラベル、プロパティ、関連するエッジも削除されます。これは SQLite によって強制されます。
slug()は自然言語の ID の重複を排除します。 slug 化したときに同じになる2つの文字列は、同じノードになります。これは、文章に含まれる概念を安定した ID に変換するための重要な仕掛けです。- ID は CURIE です。
person:ada-lovelace、company:appleのようなコンパクトな URI で、形式はprefix:referenceです。prefix は短く安定した型トークンで、reference は slug 化されます(slug(name, prefix="person")が生成します)。現在は単純な文字列のままで、リンクトデータの世界に公開する段階になって初めて完全な IRI に展開されます。そのため、相互運用性は事前に負担を払うのではなく、低コストで後から追加できる選択肢です。ID は アドレス であり、レコードではありません。ID には識別情報を、プロパティには変更可能な事実を格納します。
6つ目のテーブル graph_events には、追記専用の履歴が格納されます(以下を参照)。このテーブルも同じファイルと接続を共有します。
アーキテクチャ:3つの入口と1つのエンジン
flowchart TD
    subgraph doors["front doors"]
        CLI["kg<br/>(command line)"]
        MCP["kgrdbms-mcp<br/>(MCP server)"]
        LIB["import kgrdbms<br/>(library)"]
    end

    SVC["service.py — gated + logged write path"]
    GATE{"invariants.enforce<br/>then policy.mutation_check"}
    GRAPH[("SQLite file<br/>nodes · edges · labels · properties")]
    LOG[["graph_events<br/>(append-only log)"]]

    CLI -->|writes| SVC
    MCP -->|writes| SVC
    LIB -->|writes| SVC
    SVC --> GATE
    GATE -->|"pass"| GRAPH
    GATE -->|"record fact"| LOG

    CLI -.->|reads| GRAPH
    MCP -.->|reads| GRAPH
    LIB -.->|reads / fast bulk writes| GRAPH
CLI、MCP サーバー、独自の Python コードはすべて service.py 経由で変更を行うため、安全ゲートとイベントログの管理は1か所にだけ存在し、入口ごとに食い違うことはありません。
ゲートは、呼び出し時にモジュールを通じて invariants.enforce と policy.mutation_check を解決します。そのため、ポリシーを編集すると(またはテストで monkeypatch すると)、すべての入口に即座に反映されます。
ライブラリには、直接実行できる高速な非ログ記録パス(
g.add_node(...)、g.add_nodes(...))もあります。一括読み込みには適していますが、これらの書き込みはイベントログに記録されません。イベントソーシング の注意事項を参照してください。
多数のオントロジー:1つのコントロールプレーン
1つのグラフが エンジン です。コントロールプレーンによって、3つすべての入り口から、1つのエンジンを通じて 名前付きの多数のオントロジー にアクセスできます。それぞれが独自のSQLiteファイルを持ちます(ワークロードに応じて、独自のエンジン全体を持たせることもできます)。オントロジーを指定すると、リゾルバーがルーティングします。それ以外は何も変わりません。ゲート、ログ、service.py の書き込みパスはまったく同じで、どのグラフとログを使うかだけが名前によって選ばれます。
flowchart TD
    subgraph doors["front doors, now ontology-aware"]
        CLI["kg --ontology coffee …"]
        MCP["kg_node_get(ontology='coffee')"]
        LIB["resolve('coffee')"]
    end
    RES["resolver.py<br/>name → (backend, events, entry)"]
    IDX[["index.db<br/>the registry — itself a kg"]]
    REG{"backend registry"}
    SQ[("sqlite · live")]
    PG[("postgres · live")]
    NEO[("neo4j · stub")]

    CLI --> RES
    MCP --> RES
    LIB --> RES
    RES -->|"look up the name"| IDX
    RES -->|"open the engine"| REG
    REG --> SQ
    REG -.-> PG
    REG -.-> NEO
- レジストリ自体がkgです。 オントロジーはインデックスグラフ(
<root>/index.db)内のノードであるため、オントロジーの 一覧表示 はクエリ、登録 はアップサートです。新しいストレージ機構は必要ありません。データベースのためのデータベースです。 - デフォルトのオントロジーは従来のファイルです。 名前を省略すると、これまでと同じく
<root>/graph.dbが使われます。複数オントロジーへの対応は完全に追加的で、何も移動せず、既存のすべてのコマンドはこれまでどおり動作します。 - 分離はファイルシステムの形で実現されます。 各オントロジーは独自のイベントログを持つ独立したファイルです。「CoffeeがAdaを知らない」のは、別々のファイルだからです。テナントIDも、行のフィルタリングも、情報漏えいの余地もありません。
- エンジンはプラグイン可能です。 バックエンドは名前に登録されたファクトリーです。
sqliteとpostgresは利用可能で、neo4jはルーティングだけを行い、実装されるまでは明確にエラーになります。ほとんどのオントロジーは、依存関係ゼロのデフォルトである組み込みSQLiteのままです。一方、特定の負荷の高いオントロジーは、その 行数ではなくワークロード が高度化したときに、専用エンジンへ エスカレーション できます。「求めたときだけ速度に投資する」という理念#6を、バッチ処理からエンジン全体へと一般化したものです。 - 履歴を管理するのはエンジンではなく、コントロールプレーンです。 SQLite以外のオントロジーは、追記専用のイベントログをコントロールプレーンのSQLiteストア(
<root>/ontologies/<slug>/events.db)に保持します。エンジンは、リプレイや取り消しが適用される 投影 にすぎません。そのため、Postgresをバックエンドとするオントロジーでも、完全な監査/タイムトラベル/1コマンドでの取り消しを利用できます。グラフデータはPostgresに、履歴はSQLiteに保存されます。
pip install "knowledge-graph-rdbms[postgres]"     # the psycopg-backed engine
kg ontology create big --backend postgres \
   --location "postgresql://user:pass@host:5432/db" --stance inferential
kg --ontology big node add company:acme --kind Company --name Acme   # writes to Postgres
kg ontology create coffee --stance inferential       # register (lands in index.db)
kg ontology list                                     # the database of databases
kg --ontology coffee node add drink:latte --kind Drink --name Latte
kg --ontology coffee out drink:latte                 # scoped to that ontology
グラフを指定する方法は2つあり、MCPの ontology 引数に対応しています。--ontology NAME はリゾルバーを介してルーティングします(名前付き、登録済み、マルチエンジン対応)。一方、--db PATH はレジストリに触れず、指定した1つのファイルへ直接アクセスするためのエスケープハッチです。
ディスカバリー:クエリの前にスキーマを読む
自分で構築していないグラフは、中身がわかりません。どの kind が存在するのか、どのエッジタイプがあるのか、Person にどのプロパティキーがあるのか。schema() はすべてを 1回の読み取り で答えます。試しに呼び出して推測するのではなく、クエリの前に読むためのマップです。
kg schema             # kinds, edge types, labels, and property keys per kind — with counts
kg schema --samples   # + a few example ids per kind and the enum-like values a key takes
返されるのは、観測された語彙、つまりグラフに実際に存在するもののプロファイルであり、強制されるスキーマではありません(グラフは引き続きスキーマレスです)。MCPツール kg_schema には、エージェントが動き出す前にマップを読むよう、最初に呼び出す指示が含まれています。これは通常の読み取りです。純粋な GROUP BY 集計で、ゲートを通りません。他のすべての読み取りと同様に、次のセクションで説明するフェデレーション形式もあり、多数のオントロジーにまたがる語彙を一度に統合できます。
オントロジー間の処理:フェデレーションとバックボーン
コントロールプレーンは、1回の呼び出しにつき 1つ のオントロジーへルーティングします。その上に、多数のオントロジーを一度に扱うための2つの層があります。読み取りはフェデレーションされ、書き込みはバックボーンを経由します。
flowchart TD
    Q["kg fed node person:ada"] --> FED["federation.py<br/>multithreaded fan-out"]
    FED -.->|own thread + connection| O1[("people")]
    FED -.->|own thread + connection| O2[("papers")]
    FED -.->|own thread + connection| O3[("coffee")]
    O1 --> M["merge, tagged by source<br/>(identity-aware)"]
    O2 --> M
    O3 --> M

    L["kg link same-as …"] --> BB["backbone.py"]
    BB --> IDX[["index.db — the backbone<br/>Ref + Prefix nodes, SAME_AS edges<br/>gated + logged"]]
フェデレーション — オントロジー間のマルチスレッド読み取り
フェデレーション読み取りは ファンアウト です。各メンバーオントロジーをそれぞれ独自のスレッド(独自の接続)で開き、結果をソース別のタグ付きで統合します。SQLiteはクエリ中にGILを解放するため、N個のオントロジーを 並行して 読み取れます。「フェデレーション」専用のAPIはありません。すべての基本読み取りで、オプションの ontologies=[...] スコープを指定できます。
from kgrdbms import Federation

fed = Federation(["people", "papers", "coffee"])   # or Federation.all()
fed.schema()                 # unioned vocabulary + a per-ontology breakdown
fed.nodes_by_kind("Person")  # [Located(ontology, node), ...] — tagged by source
fed.node("person:ada")       # every occurrence across worlds, identity-merged
kg fed schema                # union vocabulary across ALL ontologies
kg fed node person:ada       # find an id across the federation (identity-aware)
フェデレーションは書き込みを行わず、メンバーを黙って除外することもありません(メンバーで例外が発生した場合は、その例外が伝播します)。parallel=False を指定すると、デバッグ用に逐次実行になります。
バックボーン — オントロジーをまたぐリンク
リーフエッジはオントロジーをまたげません。外部キーが1つのファイル内にあるためです。オントロジーをまたぐ構造が存在するのがバックボーンであり、新たなストレージは必要ありません。バックボーン自体が、種類を増やしていくインデックスグラフです。リンクは、エンドポイントごとに軽量なRefプロキシノード(IDは<ontology>::<node_id>、外部キーはインデックス内で満たされます)を作成し、エッジで結びます。プレフィックスレジストリはPrefixノードになります。どちらも同じゲート付きのログ記録対象となるservice経路を通るため、ドメインをまたぐアサーションも、リーフデータとまったく同じように監査可能、取り消し可能、再生可能です。
kg link add coffee drink:latte ENJOYED_BY people person:ada   # a typed cross-ontology edge
kg link same-as people person:ada wiki person:ada-lovelace    # "same real-world entity" (symmetric)
kg link cluster people person:ada                             # the transitive SAME_AS cluster
kg prefix add person https://kg.local/person/                 # CURIE prefix -> IRI (identity backbone)
アイデンティティの共有は、オントロジーごとにオプトインします。 デフォルトでは、アイデンティティはローカルです。2つのオントロジーにあるperson:adaは、バックボーン経由でリンクするまでは別々のノードです。--shared-identityを指定して作成したオントロジーは、アイデンティティのグローバルな共有を選択します。その場合、フェデレーションでは、そのようなオントロジー間で同じCURIEを持つノードを同一のエンティティとして扱い、マージします。
イベントソーシング:グラフはプロジェクションです
クエリ対象のグラフはキャッシュです。追記専用のイベントログが信頼できる情報源です。 ゲートを通るすべての変更で、取り消し可能な事実が記録されます。
flowchart LR
    SEED["genesis seed<br/>(optional, declarative)"] -->|"seed once"| PROJ
    LOG[["event log<br/>append-only, never deletes a row"]] -->|"replay in order"| PROJ[("graph projection<br/>what you query")]
    PROJ -->|"every gated mutation appends a fact"| LOG
ログから行が失われることはないため、次の3つの利点が同時に得られます。
- 監査は考古学です。 すべての変更にはタイムスタンプと実行者が記録されます。
kg eventsで履歴を確認できます。 - 取り消しは削除ではなくイベントです。
compensate()(CLI:kg revert <id>)は逆イベントを出力します。元の行は残るため、取り消されたことと、その実行者を確認できます。 - タイムトラベル。
replay(upto_ts=...)は、過去の任意の時点におけるプロジェクションを再構築します。
sequenceDiagram
    participant U as you
    participant L as event log
    participant G as graph projection
    U->>L: NODE_UPSERT person:ada
    L->>G: apply → ada exists
    U->>L: revert(that event)
    L->>L: append NODE_DELETE (compensates)
    L->>G: apply → ada gone
    Note over L: both rows remain — history is intact
設計による2つの書き込み経路
各書き込みを履歴とどのように関連付けるかを選べます。
- ログ記録経路 — CLI、MCP サーバー、
service.*が使用します。すべての変更はゲートを通り、ログに追記されるため、監査可能、取り消し可能で、replay()によって正確に再現できます。タイムラインが真実となる場合に使う経路です。 - 直接経路 —
g.add_node、g.add_nodes、g.batch()が使用します。書き込みはプロジェクションに直接反映されるため、一括読み込みやデータのステージングを最速で行えます。ただしログには記録されないため、ログから再構築するreplay()には含まれません。
ワークロードに応じて選んでください。生データの読み込み速度を優先するなら直接経路、履歴が必要ならログ記録経路を使います。両方を併用することもできます。kg importは単一のbatch()内でログ記録経路を実行するため、一括読み込みを高速に行い、完全に記録することもできます。
リプレイのシードは呼び出し可能なオブジェクトにすぎないため、ベースグラフをYAML/JSONで宣言し、ログに記録された差分を適用する前に、決定的に再シードできます。
from kgrdbms import Graph, EventLog, replay

def genesis(g):
    # re-create your declared base facts (e.g. parsed from YAML)
    g.add_node("root", kind="Root", name="root")

replay(graph, events, genesis=genesis)              # rebuild from seed + log
replay(graph, events, genesis=genesis, upto_ts=ts)  # ...as of an instant
仮想エッジ:保存しないリレーションシップ
イベントソーシングは、キュレーションされた事実には適したモデルですが、すでに運用ストアに最新かつ信頼できる形で存在する、高カーディナリティの機械生成リレーションシップ層には適していません。相関エッジを毎晩10万件グラフ(およびログ)にミラーリングするのは無駄であり、すぐに古くなります。
仮想エッジはこれを逆転させます。オントロジーに保存するのはバインディングのみです。つまり、エッジのTYPEと、外部ソースに対してインスタンスを解決するSQLです。トラバーサル時に、リゾルバーは現在のノードをパラメーターとしてクエリを実行し、エッジをその場で合成します。コピーはゼロ、常に最新、信頼できる唯一の情報源――グラフ独自の言葉で実現するオントロジーベースのデータアクセスです。
flowchart LR
    Q(["kg_edges('company:NVDA')"]) --> U{"union traversal"}
    STORE[("event-sourced graph<br/>curated, logged edges")] -->|"stored edges"| U
    U -->|"for each _VirtualEdge binding"| R["resolver<br/>runs bound SQL, ? = 'NVDA'"]
    R -.->|"parameterized query"| EXT[("operational store<br/>system-of-record")]
    EXT -.->|"rows → synthesized edges<br/>_virtual: true"| R
    R --> U
    U --> OUT[/"merged edge list<br/>stored + live"/]
# Bind CO_HELD_WITH to a query over the operational store (here, any DB-API source)
kg_virtual_edge_add(
    edge_type="CO_HELD_WITH",
    query="SELECT b AS to_id, shared FROM co_held WHERE a = ?",  # '?' sqlite, '%s' postgres
    dsn_env="OUROBOROS_DSN",          # credentials by reference — never in the graph
    source="id_slug",                  # company:NVDA -> bind "NVDA"
    target_id_template="company:{value}",
    prop_cols=["shared"], directions="both", ontology="market",
)

# now ordinary traversal unions stored + virtual edges; virtual ones carry _virtual:true
kg_edges("company:NVDA", direction="out", ontology="market")
# -> [{to: "company:AMD", type: "CO_HELD_WITH", properties: {shared: 12, _virtual: true}, …}]
安全かつシンプルに保つため、次の2つの特性があります。
- 読み取り専用。 仮想エッジは書き込まれないため、ゲート付き書き込み/イベントログ/補償処理の仕組み全体を回避できます。バインディングは設定であり、エッジはビューです。無効化、再生、取り消しの必要はありません。
- 補間せず、必ずパラメーター化。 SQLテンプレートはオペレーターが作成します。ノードごとの値は、文字列にフォーマットするのではなく、常にドライバー経由でバインドされます。認証情報は
dsn_env(環境変数名)を介して渡されるため、シークレットがグラフやバージョン管理に入り込むことはありません。
バインディングは予約された種類(_VirtualEdge)のノードとしてオントロジー内に保存されるため、オントロジーとともに移動し、スキーマと並行してバージョン管理されます。これはスキーマグラフとデータグラフを分離するための接点です。ポータブルなSQLiteオントロジーにはキュレーションされたスキーマ(型、コントラクト、原則)を保持し、データが格納された拡張部分はシステム・オブ・レコードから直接仮想化します。ETLもドリフトもありません。
flowchart TB
    subgraph SG["schema graph — portable SQLite ontology"]
        T["types · contracts · doctrine"]
        B["_VirtualEdge bindings<br/>(edge TYPE + SQL + dsn_env)"]
    end
    subgraph DG["data graph — virtualized extension"]
        E["live edges, resolved on traversal"]
    end
    SOR[("system-of-record<br/>operational store")]
    B -.->|"resolves against"| SOR
    SOR -.->|"synthesizes"| E
    T --- E
Icebergソース:レイクハウスを仮想化する
システム・オブ・レコードは、必ずしも運用データベースとは限りません。機械生成されたリレーションシップデータの多くは、オブジェクトストレージにあるApache Icebergテーブルをスナップショットでバージョン管理し、カタログで管理するレイクハウスに格納されます。source_type="iceberg"を設定すると、DuckDBをスキャンエンジンとして、Icebergから直接仮想エッジを解決できます。
kg_virtual_edge_add(
    edge_type="CO_HELD_WITH",
    query="SELECT b AS to_id, shared FROM co_held WHERE a = ?",  # '?' — DuckDB binds it
    source_type="iceberg",
    catalog={                          # pyiceberg catalog props; any value as
        "name": "lake",                #   "env:VAR" is resolved from the env, so
        "type": "rest",                #   tokens/keys never sit in the graph
        "uri":  "env:ICEBERG_REST_URI",
        "warehouse": "s3://lake/wh",
    },
    table="analytics.co_held",         # namespace.table — query uses the leaf name
    # snapshot_id=...,                  # optional: pin a version for time-travel
    source="id_slug", target_id_template="company:{value}",
    prop_cols=["shared"], directions="both", ontology="market",
)
この分割は、Iceberg独自のアーキテクチャを反映しています。pyicebergは識別とバージョン管理を担います。カタログを読み込み、namespace.tableを現在のメタデータポインター(または固定されたsnapshot_id)に対応付けます。これは、スキーマグラフが実際に必要とする層です。DuckDBはスキャンを担います。解決済みのテーブル(現時点ではフォーマットバージョン2。拡張機能の対応に応じて、より新しいバージョンも利用可能になります)を読み込み、バインディングのパラメーター化クエリに応答します。テーブルは名前付きのDuckDBビューとして公開されるため、クエリは通常のテーブル名を使って記述できます。SQLite/Postgresの場合とまったく同じであり、リゾルバーのバインド処理にも変更はありません。icebergエクストラを使ってインストールしてください(pip install 'knowledge-graph-rdbms[iceberg]')。
pyicebergが対応する任意のカタログを使用できます。catalog辞書を切り替えてください。
| カタログ | catalogの設定 |
|---|---|
| AWS Glue | {"type": "glue"}(リージョン/認証情報はAWS認証情報チェーンから取得) |
| S3 Tables(マネージドIceberg) | {"type": "rest", "uri": "https://s3tables.<region>.amazonaws.com/iceberg", "warehouse": "<table-bucket-arn>", "rest.sigv4-enabled": "true", "rest.signing-name": "s3tables", "rest.signing-region": "<region>"} |
| ローカル/SQLカタログ | {"type": "sql", "uri": "sqlite:///…", "warehouse": "file://…"} |
解決済みのメタデータがs3://上にある場合(S3 Tables、Glue、または通常のS3レイク)、オープナーはDuckDBのhttpfs/aws拡張機能と認証情報チェーンのシークレットを自動的に読み込みます。DuckDBは、sigv4を含め、ホストのAWSアイデンティティを使ってマネージドストレージを読み取ります。AWS S3 Tablesに対する実動テストはtests/test_iceberg.py::test_s3tables_live_resolveで確認できます(KG_ICEBERG_S3TABLES_ARNによるオプトイン)。
ツール:kg_virtual_edge_add、kg_virtual_edges_list、kg_virtual_edge_remove。
安全ゲート:不変条件とポリシー
グラフをリアルタイムで変更できるように公開すると、特に MCP 経由で AI エージェントに公開する場合、「誰が何を変更できるのか」が現実的な問題になります。ここでの答えは 2 つのレイヤーに分かれており、その順序が重要です。
flowchart LR
    REQ(["mutation request"]) --> INV{"invariants.enforce<br/>compiled-in rule violated?"}
    INV -->|yes| E1[/"InvariantViolation<br/>(cannot be configured away)"/]
    INV -->|no| POL{"policy.mutation_check<br/>configured rule denies?"}
    POL -->|yes| E2[/"PermissionError"/]
    POL -->|no| APPLY["apply to graph"]
    APPLY --> REC[("record reversible event")]
invariants.pyはメカニズムです。 ここに記述されたルールはポリシーより先にコードで適用され、設定で無効にしたり、通信経由で回避したりすることはできません。変更にはコードの変更と再デプロイが必要です。デフォルトでは何も適用されません。不変条件は本質的にドメイン固有だからです。policy.pyは設定です。 単一のmutation_check(ctx) -> Decision関数です。デフォルトでは制限がなく、すべてが許可されます。変更してはならない部分を保護するように編集してください。通常は 5〜10 行で十分です。
不変条件は最初に実行されるため、制限のない(または侵害された)ポリシーで、不変条件によって封じられたものを再び許可することはできません。これが両者を分ける理由です。
# policy.py — append-only example: callers may add, never delete or modify
def mutation_check(ctx):
    if ctx.operation in {"node_delete", "edge_remove", "graph_clear"}:
        return Decision.deny("policy is append-only; no deletions")
    return Decision.allow()
インストール
pip install knowledge-graph-rdbms            # core library + the kg CLI
pip install "knowledge-graph-rdbms[mcp]"     # + the MCP server
または、kg / kgrdbms-mcp コマンドをグローバルに PATH に追加するには(uv または pipx):
uv tool install "knowledge-graph-rdbms[mcp]"
# or, from a local checkout, editable:
uv tool install --editable "/path/to/knowledge-graph-rdbms[mcp]"
ストレージのデフォルトは ~/.kgrdbms/graph.db です。KGRDBMS_HOME 環境変数、コマンドごとの kg --db PATH、またはコード内の Graph(path=...) で変更できます。
クイックスタート
ライブラリとして
from kgrdbms import Graph

with Graph(path="demo.db") as g:
    g.add_node("person:ada", kind="Person", name="Ada Lovelace", labels={"Person"})
    g.add_node("field:cs", kind="Field", name="Computer Science")
    g.add_edge("person:ada", "field:cs", "FOUNDED", properties={"year": 1843})

    for edge, target in g.out("person:ada"):
        print(edge.type, "->", target.name)
    print(g.shortest_path("person:ada", "field:cs"))
一括読み込み — 書き込みは 1 件ごとにコミットされるため(毎回 fsync が実行されます)、一括処理では 1 つのトランザクションを使用すると約 10 倍高速になります。
# fastest: executemany under a single commit
g.add_nodes([
    {"id": "person:ada", "kind": "Person", "name": "Ada", "labels": ["Person"]},
    {"id": "field:cs", "kind": "Field", "name": "Computer Science"},
])
g.add_edges([("person:ada", "field:cs", "FOUNDED")])  # dicts / Edge objects work too

# or batch() — defer commits for any mix of writes, atomic rollback on error
with g.batch():
    for spec in many_specs:
        g.add_node(**spec)
CLI として
kg コマンドはコアインストールに含まれています(標準ライブラリの argparse を使用し、追加の依存関係はありません)。読み取りはグラフに直接アクセスします。書き込みは MCP サーバーと同じゲートとイベントログを経由するため、kg replay / kg revert が機能し、カスタムポリシーもコンソールで適用されます。
kg node add person:ada --kind Person --name "Ada Lovelace" \
    --label Person --prop born=1815 --prop fields='["math","cs"]'
kg node add field:cs --kind Field --name "Computer Science"
kg edge add person:ada field:cs FOUNDED --prop year=1843

kg out person:ada                 # outbound edges
kg path person:ada field:cs       # shortest path
kg nodes-by-kind Person
kg stats
kg schema                         # observed vocabulary — kinds, edge types, labels, keys-per-kind
kg schema --samples               # + example ids and enum-like property values per kind
kg --json node get person:ada     # machine-readable output for piping

kg events -n 10                   # tail the event log
kg revert <event-id>              # undo a mutation (compensating event)
kg replay                         # rebuild the projection from the log

kg import graph.json              # bulk {nodes, edges} import (gated + logged)

kg ontology create coffee --stance inferential   # register a named ontology
kg ontology list                  # the registry (database of databases)
kg --ontology coffee node add drink:latte --kind Drink   # route to it
kg serve                          # launch the MCP server (needs [mcp])
--prop key=value の値は、可能な場合は JSON として解析されます(born=1815 → int、ok=true → bool、tags='["a"]' → list)。それ以外の場合は通常の文字列として扱われます。--ontology NAME で名前付きオントロジーを指定できます(リゾルバー経由でルーティングされ、デフォルトはデフォルトのオントロジーです)。--db PATH は、指定したファイルに直接アクセスするための手段です。終了コード:0 正常 · 1 見つからない/入力不正 · 2 ポリシーによる拒否 · 3 不変条件違反。
MCP サーバーとして
pip install "knowledge-graph-rdbms[mcp]"
claude mcp add kgrdbms -- kgrdbms-mcp          # register with Claude Code
または、クライアント設定を手動で編集します(例:Claude Desktop)。
{ "mcpServers": { "kgrdbms": { "command": "kgrdbms-mcp" } } }
単一のエンジンを通じて、kg_ をプレフィックスとするツールを公開します。読み取りツール — kg_schema(語彙。最初に呼び出すことを想定)、kg_node_get、kg_find(種類および/またはラベルで検索)、kg_edges、kg_neighborhood、kg_shortest_path、kg_descendants — はそれぞれ、複数のオントロジーを 1 回の呼び出しで検索するための省略可能な ontologies=[...] を受け取ります。続いて、ゲートで制御される書き込み(kg_node_upsert、kg_edge_add、kg_edge_remove、kg_node_delete)、一括処理(kg_import — {nodes, edges} 全体を 1 回で取り込むため、エージェントは何十回ものツール呼び出しではなく、1 回の呼び出しでオントロジーを構築できます)、オントロジー間のバックボーン(kg_link、kg_links_of、kg_identity、kg_prefix_add、kg_prefix_resolve)、RDF 連携(kg_rdf_export、kg_rdf_import — 下記参照)、イベントログ(kg_events_tail、kg_event_revert、kg_replay)があります。すべての書き込みは不変条件とポリシーのゲートを通過し、記録されます。CLI と同じエンジン、同じファイルを使用します。すべてのツールは省略可能な ontology 名を受け取ります。また、kg_ontologies_list / kg_ontology_create / kg_ontology_delete でレジストリを管理できるため、エージェントは MCP 経由だけでオントロジーを検出、作成、切り替え、削除できます。
リモートでの提供(認証あり)
stdio は、1 つのローカルクライアント専用のパイプです。2 台目のノート PC、スマートフォン、Tailscale のようなプライベートメッシュ上のエージェントなど、ほかのマシンから 同じ グラフにアクセスするには、代わりに HTTP 経由で提供します。エンジンもファイルも同じで、変わるのは入り口のトランスポートだけです。これは完全に追加機能であり、フラグを指定しなければ kg serve は引き続きバイト単位で同じ stdio です。
# bind an HTTP transport; require a bearer token on every request
export KGRDBMS_MCP_TOKEN="$(python -c 'import secrets; print(secrets.token_urlsafe(32))')"
kg serve --transport streamable-http --host 0.0.0.0 --port 8970
--host/--portでバインドアドレスを指定します(デフォルトは127.0.0.1:8000で、ローカルホストのみです。バインド範囲を広げるには、常に明示的なオプトインが必要です)。--allow-host HOSTで、クライアントが接続する際のHostヘッダー値を宣言します。MCP トランスポートでは DNS リバインディング対策がデフォルトで有効なため、ローカルホスト以外にバインドする場合は、クライアントが使用するホスト名/IP を指定する必要があります(バインドホストとローカルホストは常に許可されます)。複数回指定できます。host:*形式では任意のポートに一致します。前段のプロキシですでに検証している場合は、特別な値--allow-host '*'を指定して Host のチェックを無効にできます。例:--allow-host graph.example.com:*。KGRDBMS_MCP_TOKENが設定されている場合、HTTP トランスポート(streamable-http、sse)は、一致するAuthorization: Bearer <token>ヘッダーのないリクエストを拒否します(比較は定時間で行われます)。トークンは環境変数から読み取られ、フラグでは指定しません。そのため、シェルの履歴やプロセス一覧に残りません。stdio では無視されます。- 新たな依存関係はありません。 チェックは標準ライブラリ(
hmac)のみを使う小さな ASGI ラッパーで、すでに[mcp]extra がインストールするuvicorn/starletteの上で動作します。認証は接続に対して行われます。接続済みのクライアントが 何を 変更できるかは、不変条件とポリシーゲート が引き続き制御します。
クライアントを URL に接続します。Claude Code はリモート HTTP MCP にネイティブで対応しています。
claude mcp add --transport http kgrdbms https://your-host:8970/mcp \
  --header "Authorization: Bearer $KGRDBMS_MCP_TOKEN"
{ "mcpServers": { "kgrdbms": {
    "type": "http",
    "url": "https://your-host:8970/mcp",
    "headers": { "Authorization": "Bearer ${KGRDBMS_MCP_TOKEN}" }
} } }
トークンは接続を認証しますが、暗号化はしません。プレーンな http:// ポートをインターネットに公開するのではなく、トランスポートセキュリティを提供するネットワーク(WireGuard/Tailscale メッシュ、または TLS リバースプロキシ)経由で実行してください。
パフォーマンス
すべての数値は bench/benchmark.py によるもので、単発の測定ではなく全分布(p50〜p99)を報告します。以下のグラフは、そのデータを bench/charts.py で直接描画したものです。両方を 1 つのコマンドで、ご自身のマシン上で実行できます。
(掲載値:Apple Silicon、CPython 3.14、SQLite 3.50。参考値であり、性能を保証するものではありません。)
| 操作 | スループット |
|---|---|
node(id) ポイント検索 | 約 120,000 / 秒 |
add_node(呼び出しごと、永続化あり) | 約 17,000 / 秒 |
batch() 内での add_node | 約 157,000 / 秒 |
add_nodes([...]) 一括処理 | 約 189,000 / 秒 |
replay()(イベント数/秒) | 約 26,000 / 秒 |
書き込み — バッチ処理による効果
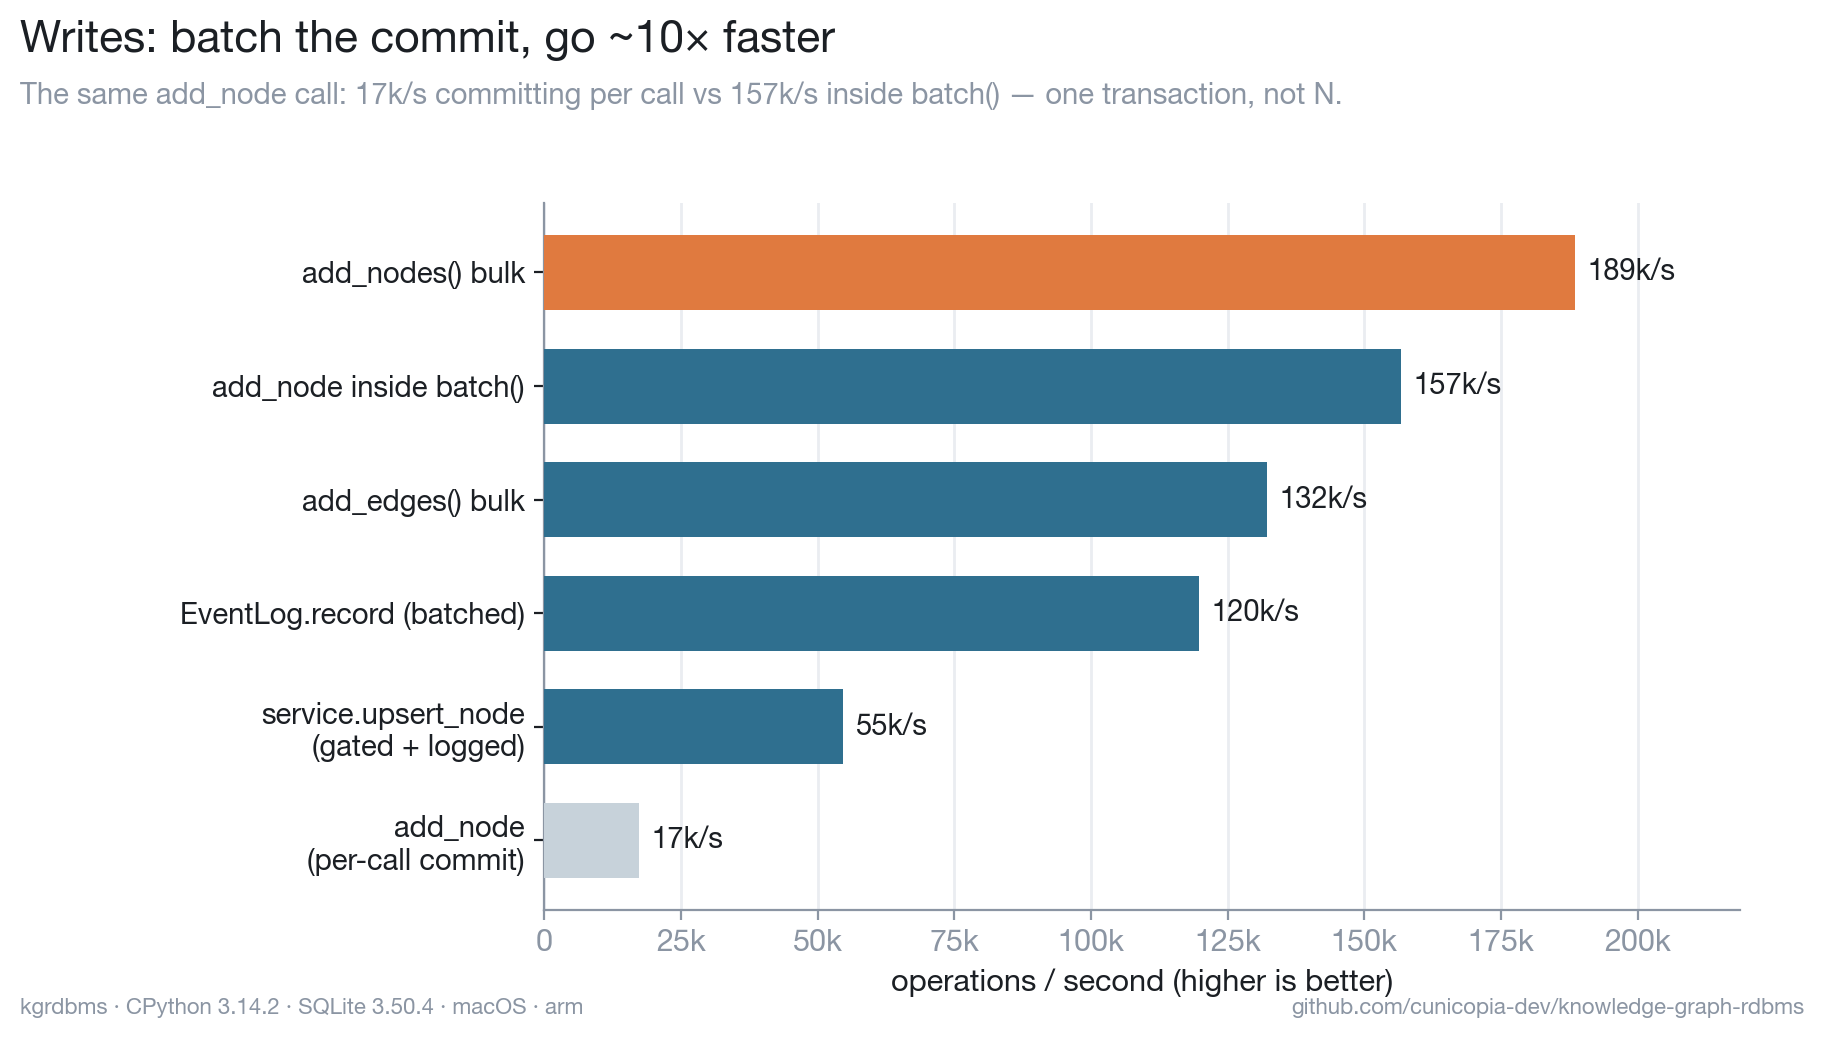
単一の書き込みは、耐久性を確保するためにそれぞれ単独でコミットされます。一括読み込みを batch()/add_nodes/add_edges で囲むと、呼び出しごとのコミットが 1 つのトランザクションにまとまり、約 10 倍高速になります。エンジンは同じで、バッチ処理が始まることを伝えるだけです。不変条件とポリシーのチェック、および書き込みごとのイベント記録を行うゲート付きのログ記録パス(CLI と MCP サーバーが使用)でも、毎秒数万件を処理できます。
読み取り — 高速で、長い遅延も正直に表示
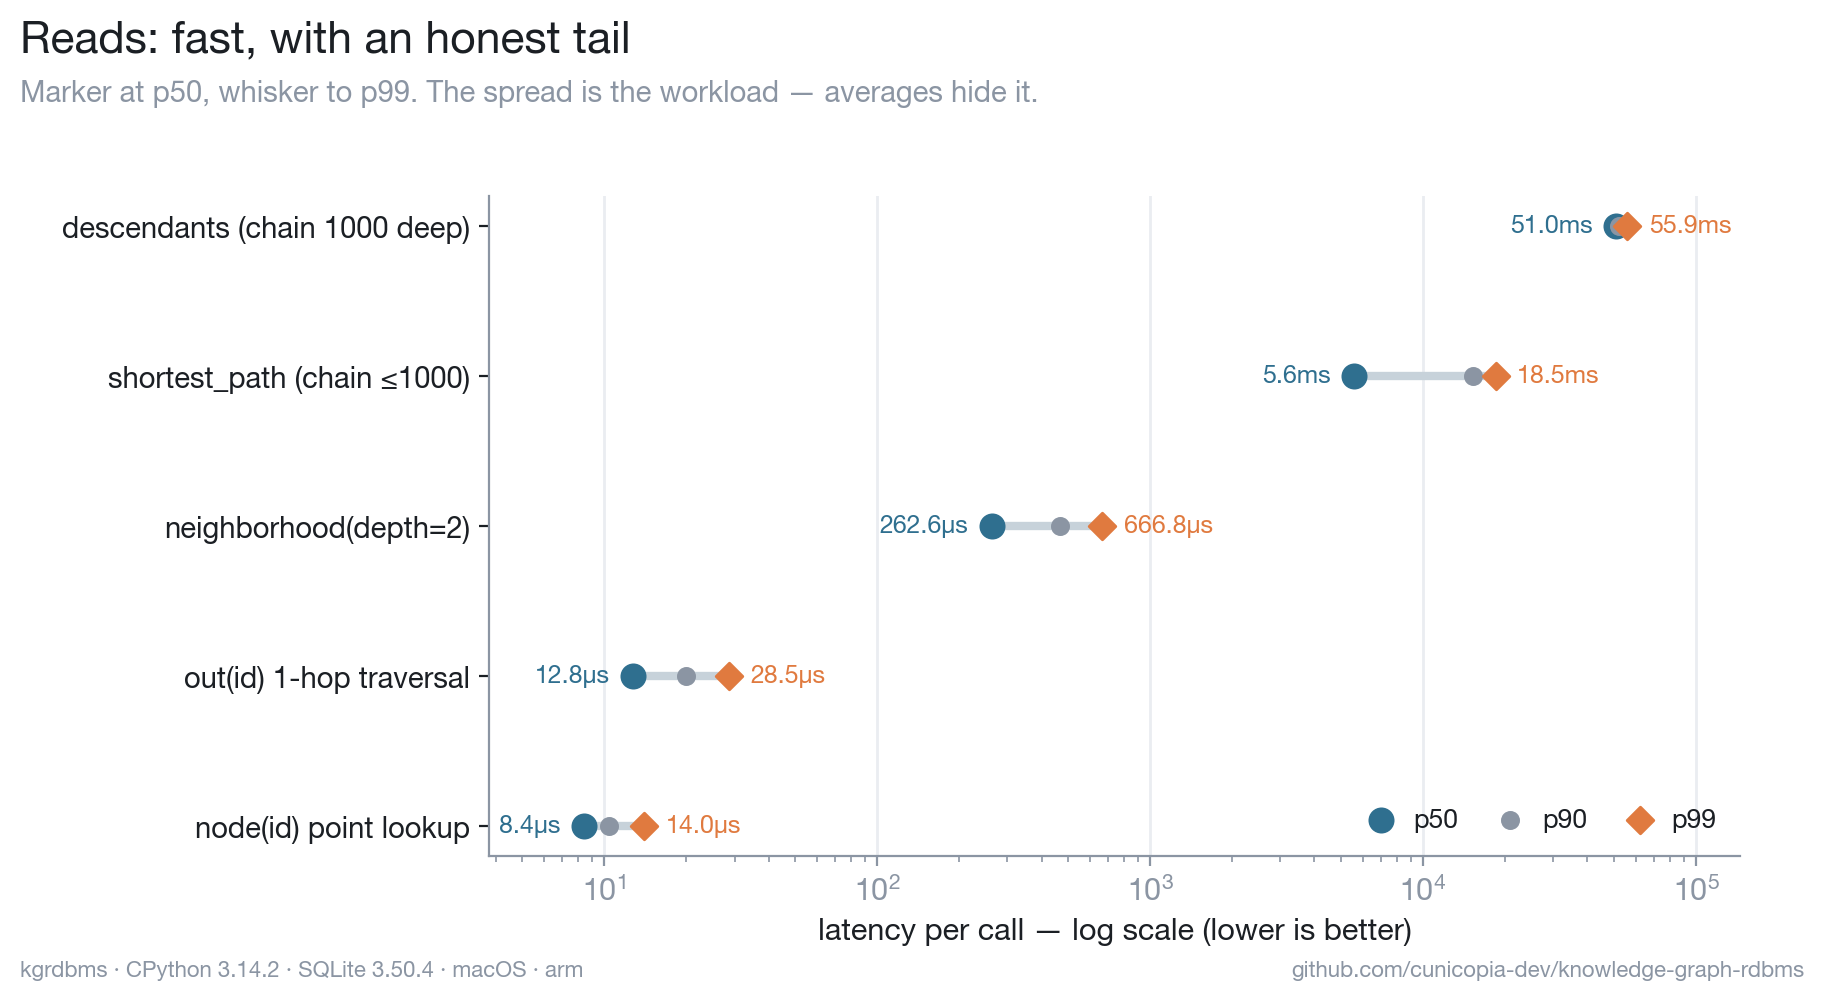
ポイント検索は 1 桁のマイクロ秒で完了し、複数ノードの読み取りでは一定数のクエリで結果セット全体を取得します(N+1 の分散はありません)。このグラフでは意図的に p50 → p99 を示しています。ランダム化された shortest_path のエンドポイントにより、短い経路もあればチェーン全体にわたる経路もあり、平均値ではその長い遅延が埋もれてしまうためです。
ランタイムについて
kgrdbmsはPython製ですが、パフォーマンス面でこれは意図的に問題にならないようにしています。同じSQLiteエンジンがCPython、Node、Bunで動作するため、両者の差は純粋なバインディングのオーバーヘッドにすぎません。2倍未満であり、処理によって優位なランタイムが変わることもありません。
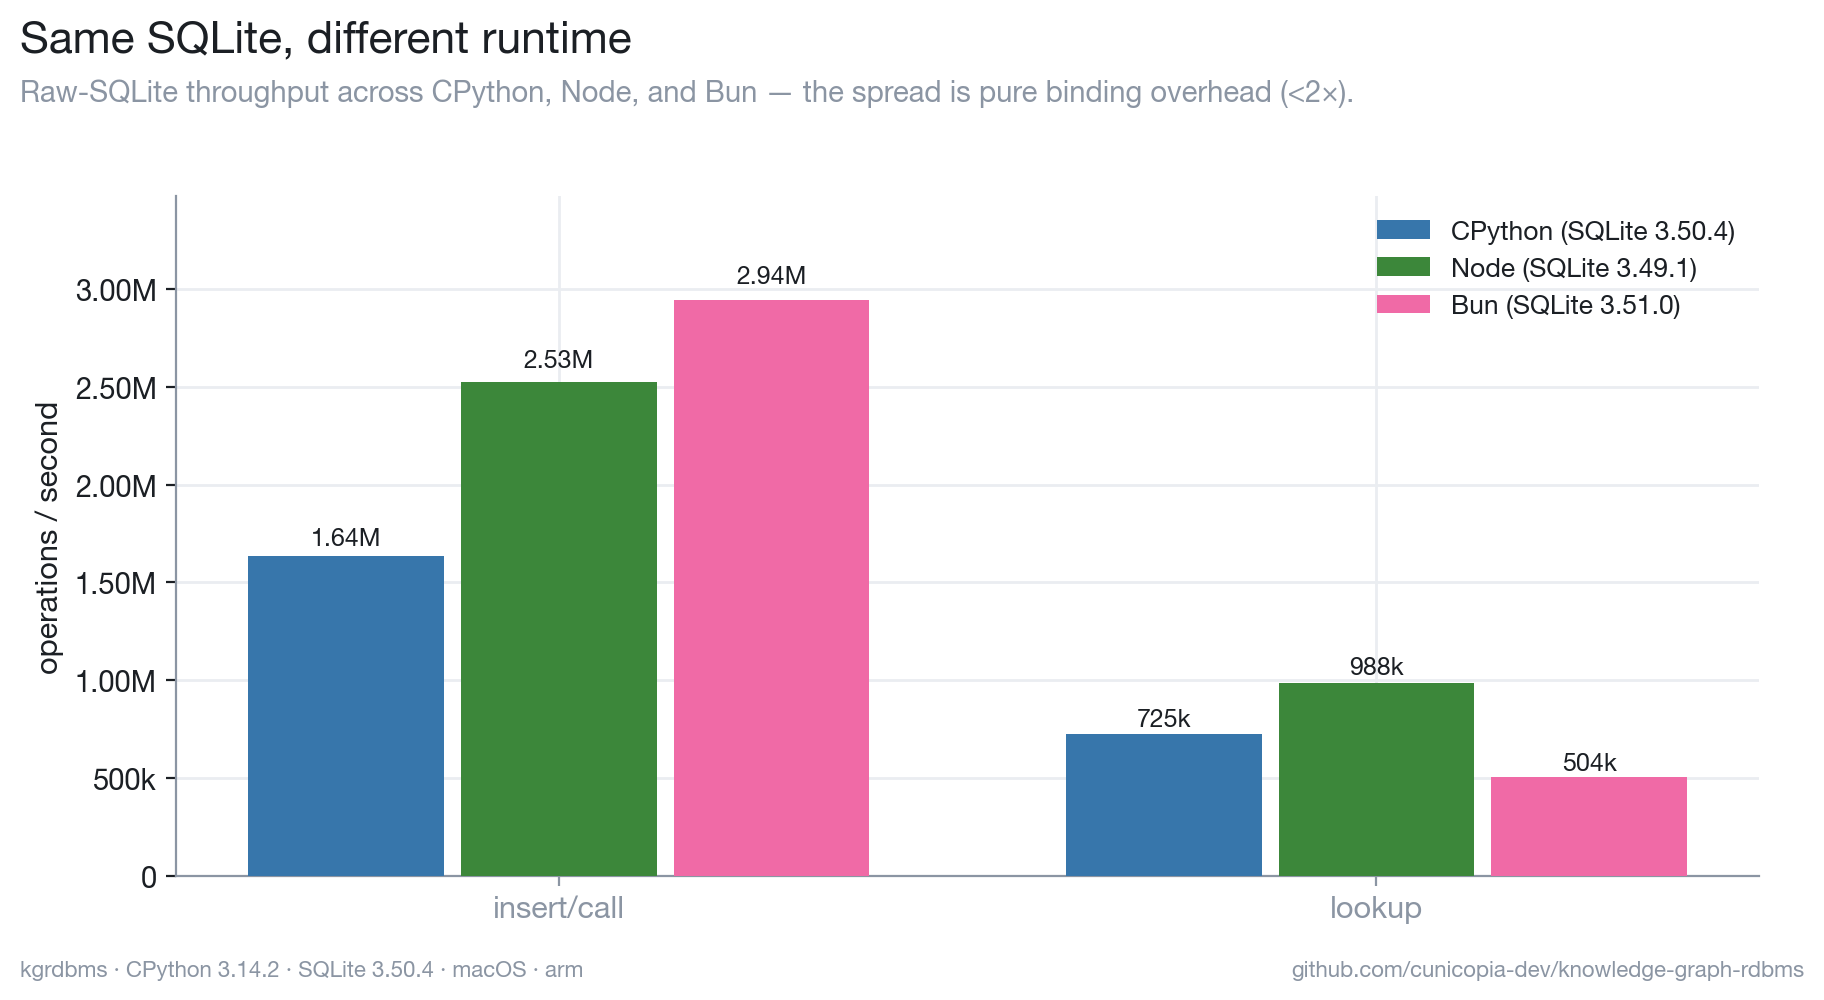
実際に大きな差を生んだのは言語ではなく、トランザクションのバッチ処理(上記の約10倍)でした。python bench/runtimes/compare.pyで再現できます。
性能の分岐点
Neo4jと比較しました。同じグラフ、同じクエリ、同一の手法を使用しています(完全なベンチマークハーネスと再現手順はbench/neo4j/を参照してください)。
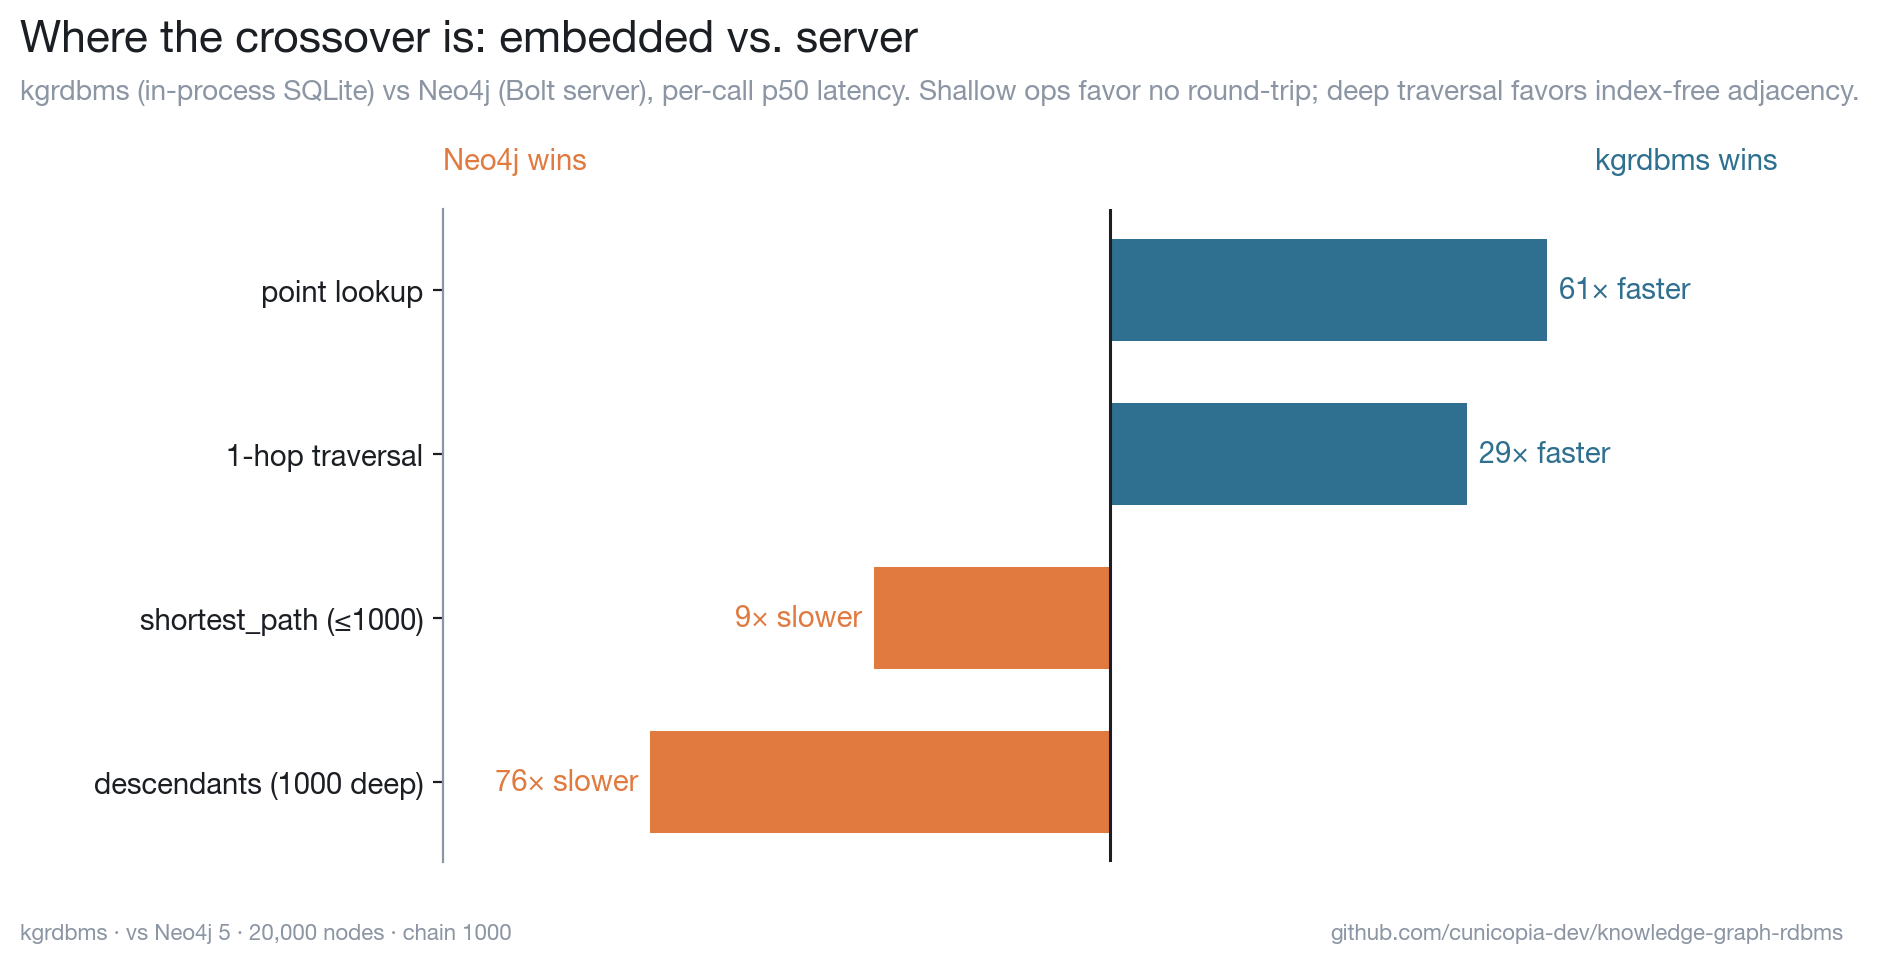
クエリはBツリーインデックス上のSQLにコンパイルされるため、探索の各ホップはインデックス検索です。ポイント読み取りや浅い探索では、非常に低コストです。ここでのインプロセス検索は約7µsですが、Neo4jに同じクエリを送ると、データに触れる前にBoltの往復(約0.4ms)が発生します。そのため、エージェントのメモリでよく使われる小規模で頻繁な処理では、組み込みグラフが30~60倍高速です。
専用エンジンが優位になるのは、行数ではなくワークロードの探索が深くなる場面です。
- 深く、分岐数の多い探索。 インデックスフリーの隣接関係では、ノード間を直接ポインターでたどります。深さ1,000の探索にかかる時間は、kgrdbmsでは約52ms(再帰CTE+行のハイドレーション)ですが、Neo4jでは約0.7msです。Neo4jは独自の往復時間予算内でポインターをたどるため、逆に76倍の差がつきます。
- 複雑なパターンマッチング。 Cypherのプランナーは、固定された探索APIでは試みない方法で、複数パターンのクエリを最適化します。
- 並行書き込みとスケールアウト。 SQLiteは単一ファイルのため、同時に書き込めるのは1つのライターだけです。クラスター化されたエンジンはそうではありません。
目安として、読み取り中心で浅い探索なら、ノード数が数百万台前半までは十分に得意分野です。深い探索やパターン中心の処理では、専用エンジンの複雑さに見合う価値が生まれます。分岐点はワークロードによって変わり、万能な単一の数値はありません。そのため、私たちは自分たちの環境で測定しました。皆さんもご自身の環境で測定できます。
SQLiteと稼働中のPostgresエンジンの比較
postgresは稼働中のバックエンドなので、両方のエンジンで同じ処理スイートを実行し、往復時間のコストを直接確認できます(bench/postgres/)。組み込みSQLiteは、小規模で頻繁な処理で30~60倍高速です。ポイント検索はインプロセスですが、Postgresではローカルホストへの往復が発生します。例外は、サーバー側の単一クエリとして実行される深い探索です。再帰CTEを使うdescendantsではPostgresが優位(約0.5倍の時間)になります。一方、同じチェーンに対するホップごとのBFSを使うshortest_pathは67倍遅くなります。同じ探索でも結論が逆になるのは、処理がネットワークを何回行き来するかだけで決まります。Postgresが真価を発揮するのは並行性とスケールであり、シングルスレッドのレイテンシではありません。コントロールプレーンを使えば、1つのオントロジーをPostgresに移行しつつ、負荷の高い浅い探索は組み込みのままにできます。
RDF 相互運用性:エクスポート、SPARQL、RDF-star
このストアはラベル付きプロパティグラフのままです。ここでの RDF は境界形式であり、ストレージモデルではありません。トリプルストアも、OWL も、組み込みの SPARQL エンジンもありません。このプロジェクトでは、後から導入するコストが最も高い唯一の RDF の考え方、つまり安定した識別子(CURIE ノード ID)だけを採用しています。CURIE が実際の IRI に展開されるのはここです。
kg rdf export                         # Turtle, to stdout (RDF-star edges)
kg rdf export --format ntriples --out graph.nt
kg rdf import graph.nt                 # back in — gated, logged, replayable
エクスポートに依存関係はありません。プレフィックスのバインディングによって IRI が保存時とまったく同じ形に戻るため、ノード ID は CURIE として往復します。
@prefix person: <https://kg.local/person/> .
@prefix kg:     <https://kg.local/vocab#> .

person:ada a kg:Person ;
    kg:name "Ada Lovelace" ;
    prop:born "1815"^^xsd:integer ;
    rel:influences person:grace .

<< person:ada rel:influences person:grace >> prop:since "2020"^^xsd:integer .
最後の行が興味深いところです。通常のトリプルにはエッジのプロパティを付与する場所がありません。--edge-strategy で、それらの扱いを決めます。
| 戦略 | エッジ {since: 2020} の変換結果 | 使用する場面 |
|---|---|---|
rdf-star(デフォルト) | << :ada :influences :grace >> :since 2020 | star 対応ストア(Stardog、Jena 4.3+、Oxigraph) |
reification | s/p/o と各プロパティを含む rdf:Statement ノード | rdflib と、あらゆる RDF 1.1 ツール |
lossy | 単純なトリプル。プロパティは破棄されます(件数を報告) | トポロジーだけが必要な場合 |
SPARQL には対応していますか? はい。エクスポートに対して、あらゆるストアで使えます。クエリエンジンは組み込みません(依存関係なし、SPARQL なしという設計に反するため)。代わりに、実際のエンジンでクエリできるグラフを出力します。
import rdflib
from kgrdbms import rdf

# rdflib is RDF 1.1 — no star — so emit reification for it:
ttl = rdf.export(graph, "turtle", rdf.IriContext(edge_strategy="reification"))
store = rdflib.Graph(); store.parse(data=ttl, format="turtle")
store.query("SELECT ?s ?o WHERE { ?s <https://kg.local/rel/influences> ?o }")
rdf-star エクスポートに対する SPARQL-star を使う場合は、Turtle を star ネイティブなストア(Stardog、Jena、Oxigraph、GraphDB)に渡します。Turtle/外部 RDF のインポートにはオプションの追加パッケージが必要です(pip install "knowledge-graph-rdbms[rdf]"。これにより rdflib がインストールされます)。N-Triples のインポートとすべてのエクスポートには、引き続き依存関係がありません。インポートした RDF は、ほかのすべての書き込みと同じ、制御およびログ記録を通る経路を使うため、監査や再生が可能です。
コマンドリファレンス
| コマンド | 機能 |
|---|---|
kg stats | ノード/エッジの数とデータベースのパス |
kg schema [--samples] | 観測された語彙:種類、エッジタイプ、ラベル、種類ごとのキー |
kg node add ID --kind K … | ノードを作成または更新します(ゲート制御+ログ記録) |
kg node get ID | ノードを取得します |
kg node del ID | ノードを削除します(エッジも連鎖的に削除) |
kg node set-prop ID KEY VAL | プロパティを1つ設定します |
kg node add-label ID LABEL | ラベルを追加します |
kg edge add FROM TO TYPE | エッジを追加します |
kg edge rm FROM TO TYPE | エッジを削除します |
kg nodes-by-kind KIND | 指定した種類のノードを一覧表示します |
kg nodes-by-label LABEL | 指定したラベルを持つノードを一覧表示します |
kg out ID [--type T] | 出方向のエッジ |
kg in ID [--type T] | 入方向のエッジ |
kg path FROM TO | 最短の無向パス |
kg neighbors ID [--depth N] | Nホップ以内のノード |
kg descendants ID TYPE | 1つのエッジタイプに沿って到達可能なノード |
kg events [-n N] | イベントログの末尾を表示 |
kg revert EVENT_ID | イベントを取り消します(補償イベント) |
kg replay [--upto TS] | ログからプロジェクションを再構築します |
kg import FILE | {nodes, edges}を一括インポートします(ゲート制御+ログ記録) |
kg rdf export [--format F] | Turtle/N-Triples(RDF-star)にシリアライズします |
kg rdf import FILE | RDFを読み込みます(ゲート制御+ログ記録) |
kg ontology list | 登録済みオントロジー(レジストリ)を一覧表示します |
kg ontology create NAME … | オントロジーを登録します(--backend、--stance、--shared-identity) |
kg ontology delete NAME [--purge] | オントロジーの登録を解除します(--purgeはデータも削除します) |
kg fed schema [--samples] | すべてのオントロジーにわたる語彙の統合(マルチスレッドで分岐処理) |
kg fed stats | フェデレーション全体のノード/エッジ数 |
kg fed nodes-by-kind KIND / nodes-by-label LABEL | オントロジーをまたいだノードを、ソースのタグ付きで表示 |
kg fed node ID | フェデレーション全体からIDを検索します(アイデンティティを考慮) |
kg link add FROM_ONT FROM TYPE TO_ONT TO | オントロジー間のエッジ(基盤) |
kg link same-as A FROM B TO | 2つのノードが同じエンティティであることを表明します(対称) |
kg link of ONT ID | ノードに接続するオントロジー間リンク |
kg link cluster ONT ID | 推移的なSAME_ASアイデンティティクラスター |
kg prefix add P IRI_BASE | CURIEプレフィックスをIRIベースに紐付けます |
kg prefix expand CURIE / contract IRI | レジストリを介したCURIE ↔ IRI変換 |
kg serve [--transport T] | MCP サーバーを実行します |
任意のコマンドに--jsonを追加すると、機械可読形式で出力されます。--ontology NAME(リゾルバー経由でルーティングされます。デフォルト:デフォルトのオントロジー)または--db PATH(レジストリを迂回し、指定した1つのファイルを直接対象にする手段)でグラフを指定します。
プロジェクト構成
kgrdbms/
├── graph.py        # the label property graph over SQLite (no internal deps)
├── events.py       # append-only event log: record, compensate, replay
├── policy.py       # configurable mutation policy (permissive by default)
├── invariants.py   # compiled-in invariants, checked before policy (no-op default)
├── service.py      # the shared gated + logged write path
├── resolver.py     # control plane: ontology name → (backend, events, entry) + the index
├── federation.py   # cross-ontology reads: multithreaded fan-out, identity-aware merge
├── backbone.py     # cross-ontology links + prefix/IRI registry (lives in the index graph)
├── backends/       # pluggable engine registry
│   ├── base.py     #   GraphBackend protocol + raising stub skeleton
│   ├── sqlite.py   #   live engine (adapter over Graph)
│   ├── postgres.py #   live engine (psycopg; jsonb + recursive CTEs); [postgres] extra
│   └── neo4j.py    #   stub (deep-traversal escalation)
├── rdf.py          # RDF boundary: Turtle/N-Triples export + import (RDF-star); rdflib only for [rdf] import
├── cli.py          # the `kg` command (stdlib argparse)
└── mcp_server.py   # the MCP server (optional [mcp] extra)
graph.pyは内部モジュールを一切インポートしないため、単体で利用できる依存関係不要のLPGです。それ以外のすべての機能はその上に構築されます。service.pyが依存するのはGraphBackendプロトコルのみで、特定のエンジンには依存しません。
開発
git clone <repo> && cd knowledge-graph-rdbms
uv venv && uv pip install -e ".[dev]"
pytest                       # 107 tests
python bench/benchmark.py    # benchmark with p50–p99 (see bench/README.md)
ライセンス
MIT。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。