yt-mem-ai について
yt-mem-aiは、アシスタントやMCPホスト向けのローカルYouTubeライブラリです。動画を文字起こしして検索可能にし、要約、タイムスタンプ付きハイライト、Q&A、ダイジェスト、リールを作成できます。
主な機能
- 01字幕またはオフラインWhisperで文字起こし
- 02文字起こしをローカル保存して検索
- 03動画横断でタイムスタンプ付き箇所を検索
- 04チャンネル登録を追跡してダイジェスト作成
- 05要約、Q&A、プレゼンテーションを生成
- 06ハイライト文書や動画リールを作成
活用シーン
- 01個人の動画ライブラリから話題を検索
- 02タイムスタンプで重要箇所を振り返る
- 03新着動画をダイジェストにまとめる
- 04動画から要約やプレゼンテーションを作る
MCP 対応
yt-ai-mcpサーバーは、analyze_videoなどの型付きツールで動画ライブラリ機能を公開します。MCPホストでは一般的な動画ワークフローのプロンプトも利用できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
yt-mem-ai — AI アシスタント向けのローカル YouTube メモリー
Claude、Codex、Cursor、または任意の MCP ホストに、YouTube を代わりに視聴する機能を追加します。動画の文字起こしや記憶、チャンネル登録の追跡を行い、そのすべてを要約、タイムスタンプ付きハイライト、Q&A、ダイジェスト、動画リールに変換できます。 すべてお使いのマシン上で動作し、クラウドサービスも API キーも必要ありません。
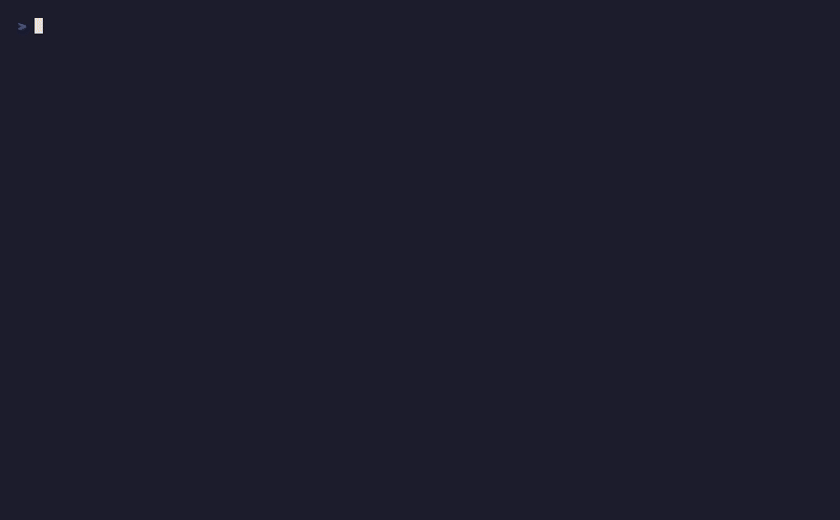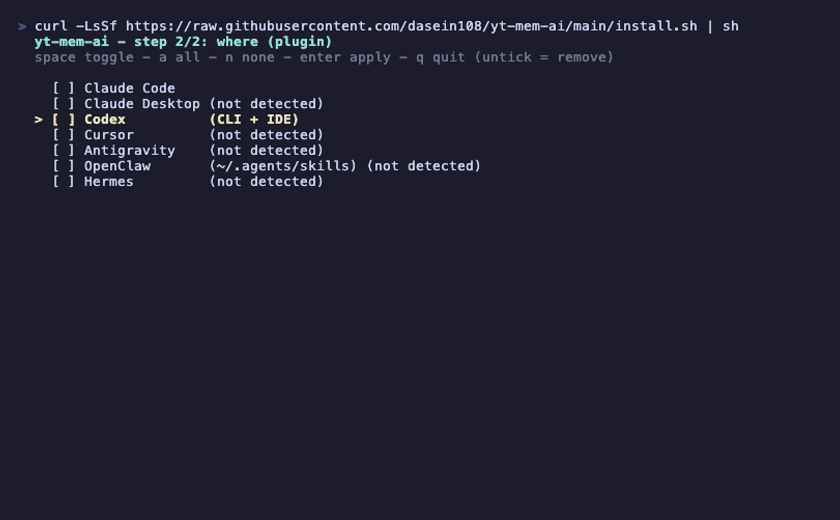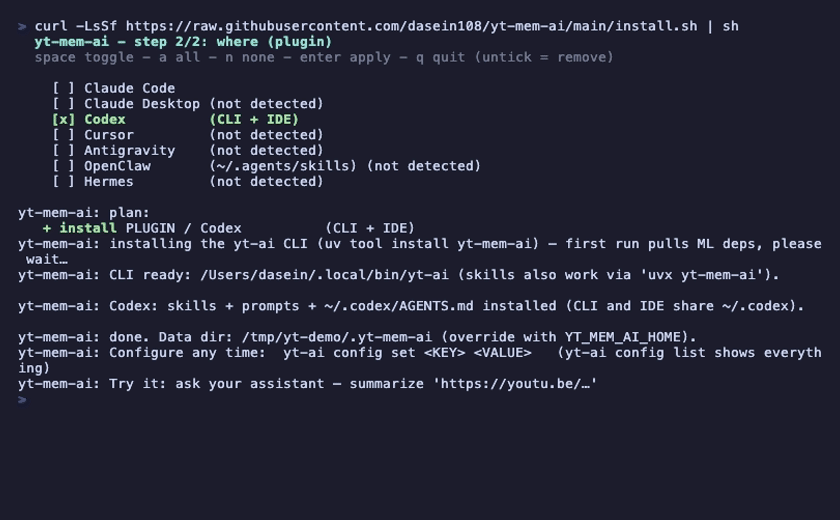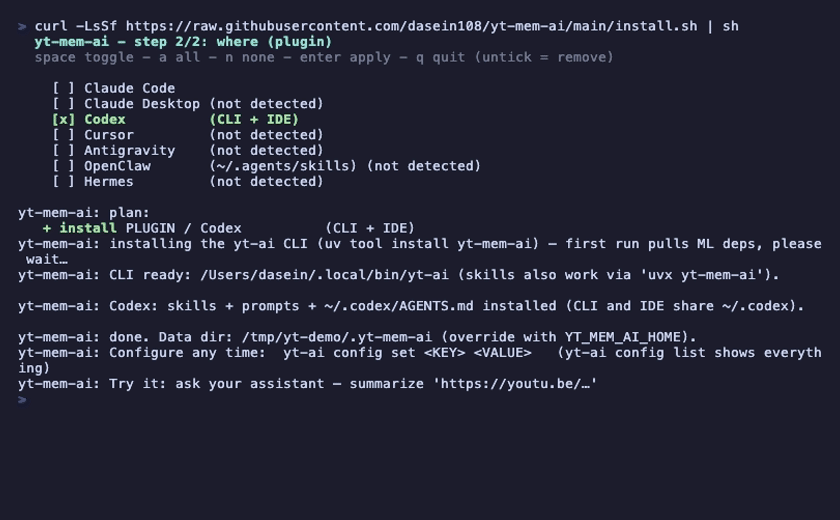
コマンドは 1 つ、質問は 2 つ。ここでは Codex にスキルを組み込んでいます。
例 — 「この動画からプレゼンテーションを作って」 (Andrej Karpathy:Vibe Coding から Agentic Engineering へ、Sequoia、30 分)→ 13 枚のスライド、PDF、 引用にはすべて文字起こしのタイムスタンプが付いています。1 回のリクエストで動画を取り込んでスライドにできます。
目次
機能
- 🎧 あらゆる動画を文字起こし — YouTube の字幕がある場合はそれを使用し(高速で、あらゆる言語に対応)、ない場合はオフラインの Whisper を使用します。
- 🧠 視聴した内容を記憶 — すべての文字起こしをローカルに保存してインデックス化するため、ライブラリをいつまでも検索できます。データがマシンの外に出ることはありません。
- 🔎 該当する箇所を特定 — 「あの動画で X について何と言っていた?」と尋ねると、該当するタイムスタンプとともに回答します。
- 📡 チャンネル登録を追跡 — 新しい動画を取得し、その日の分を 1 つのダイジェストにまとめます。
- ✍️ 文章の作成はアシスタントにおまかせ — 要約、ハイライト、Q&A、スライドデッキを、動画と同じ言語で、すでに利用料金を支払っているモデルを使って作成します。
- ❤️ 好みを学習 — 動画に「いいね」または「よくないね」を付けると、自分のライブラリからおすすめを受け取れます。
- 🎬 メディアも作成 — クリック可能なハイライト資料、静止画、編集済みのスーパーカットリールを作成します。
- 🔌 お使いのツールで動作 — Claude Code、Claude Desktop、Codex、Cursor、Antigravity、OpenClaw、Hermes に対応。スキルと MCP のどちらを使うかは選べます。
インストール方法
1. アシスタントを接続 ⭐
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh | sh
対話型ウィザードが開きます。希望するものを選び、アプリにチェックを付けて、Enter キーを押してください。
step 1/2 — what (pick one)     step 2/2 — where (tick any)
> Plugin  skills + CLI         [x] Claude Code    [ ] Claude Desktop
  MCP     typed tools          [x] Codex          [ ] Cursor
                               [ ] Antigravity    [ ] OpenClaw   [ ] Hermes
プラグインを使うと、「この動画を要約して」のような通常のリクエストにアシスタントが対応できるようになります。MCPでは、代わりに一連のツールを利用できます。迷ったら、まずはプラグインをお使いください。ウィザードを再実行して、もう一方を追加できます。
必要なものをすべてインストールし、すでに利用できるアプリにはチェックを付けます。チェックを外した項目は削除されます(最初に実行内容が表示され、確認を求められます)。その後、アプリを再起動して、summarize 'https://youtu.be/…' を試してください。
希望するものが決まっている場合は、質問をスキップできます。
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh \
  | sh -s -- --plugin --claude-code --codex
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh \
  | sh -s -- --mcp --claude-desktop --cursor
ホスト:--claude-code --claude-desktop --codex --cursor --antigravity
--openclaw --hermes、または --all。すべてのフラグとアンインストールについては、
integrations/README.mdをご覧ください。エージェントに任せる場合は、
integrations/PROMPT.mdを任意のアシスタントに貼り付けてください。
2. MCP を手動で設定 — 設定エントリを 1 つ追加するだけで、自動インストール
事前のインストールは不要です。ホストが初めてサーバーを起動するときに uvx がパッケージを取得し、その後はキャッシュに保存されます。ホストの MCP 設定に次の内容を追加してください。
{
  "mcpServers": {
    "yt-mem-ai": {
      "command": "uvx",
      "args": ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
    }
  }
}
設定はこれだけです。パスも env ブロックも必要ありません。設定は
~/.yt-mem-ai/config.env に保存され、エージェントは config_set ツールを使って自分で設定できます(または yt-ai config set を使って設定できます)。
| ホスト | JSON の追加先 |
|---|---|
| Claude Desktop | macOS ~/Library/Application Support/Claude/claude_desktop_config.json · Windows %APPDATA%\Claude\claude_desktop_config.json — アプリを再起動してください |
| Claude Code | claude mcp add -s user yt-mem-ai -- uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp |
| Cursor | ~/.cursor/mcp.json(Cursor を再読み込みしてください) |
| Antigravity | ~/.gemini/config/mcp_config.json(再起動してください) |
| Codex | ~/.codex/config.toml — TOML 形式です。以下を参照してください(または codex mcp add yt-mem-ai -- uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp) |
| OpenClaw | openclaw mcp add yt-mem-ai --command uvx --arg --from --arg 'yt-mem-ai[mcp]' --arg yt-ai-mcp(または ~/.openclaw/openclaw.json → mcp.servers) |
| Hermes | ~/.hermes/config.yaml の mcp_servers: 以下 — YAML 形式です。以下を参照してください |
# ~/.codex/config.toml
[mcp_servers.yt-mem-ai]
command = "uvx"
args = ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
# ~/.hermes/config.yaml
mcp_servers:
  yt-mem-ai:
    command: "uvx"
    args: ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
    enabled: true
アプリを再起動するとツールが表示されます。各ツールの機能については、使い方を参照してください。
何も表示されない場合、またはホストがタイムアウトした場合 最初の起動時には依存関係をダウンロードするため、ホストの起動チェックに間に合わないことがあります。
uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp --helpを一度実行してから、アプリを開き直してください。それでもホストが起動できない場合は、絶対パスを指定してください。uv tool install 'yt-mem-ai[mcp]'を実行し、which yt-ai-mcpの結果をcommandに指定して、"args": []を使用します(GUI アプリからは~/.local/binがPATHに含まれていないことがよくあります)。
3. Claude Desktop — スキル(アプリ内)
Desktop はプラグインをディスクではなく Claude のアカウントに保存するため、こちらでインストールすることはできません。アプリ内での操作は 1 分ほどで完了します。
カスタマイズ(左サイドバー)→ プラグイン → 個人用プラグイン → + → マーケットプレイスを追加 → リポジトリから追加 →
https://github.com/dasein108/yt-mem-ai→ 追加 →yt-mem-aiをインストール
次に、*「https://youtu.be/…」を要約して*と尋ねてください。同じ手順でアンインストールできます。同じプラグインは claude.ai と Cowork でも使えます。スキルよりツールを使いたいですか?上記の MCP 設定は Desktop でも使えます。こちらはスクリプトで設定できます。
スキルを手動で設定 — Codex、Cursor、Antigravity、OpenClaw、Hermes
各ホストはユーザースコープのディレクトリから SKILL.md ファイルを読み込みます。Codex
~/.codex/skills/(CLI と IDE で共有、v0.117.0+)、Cursor ~/.cursor/skills/、
Antigravity ~/.gemini/skills/、OpenClaw ~/.agents/skills/、Hermes
~/.hermes/skills/(ここでは /yt と /yt-agent として使用できます)。
# from a checkout
cp -R skills/yt skills/yt-agent ~/.codex/skills/

# without a checkout
for s in yt yt-agent; do
  mkdir -p ~/.codex/skills/$s
  curl -LsSf "https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/skills/$s/SKILL.md" \
    -o ~/.codex/skills/$s/SKILL.md
done
Codex の追加設定:/yt-* プロンプト(integrations/codex/prompts/*.md →
~/.codex/prompts/)と integrations/codex/AGENTS.md → ~/.codex/AGENTS.md。
詳細ガイド:skills/README.md。
4. CLI 単独での使用
スキルから実行できますが、単独のツールとしても十分に使えます。
uvx yt-mem-ai --help          # zero-install run
uv tool install yt-mem-ai     # or install the persistent `yt-ai` command
Python 3.11+ と uv が必要です。ffmpeg は
supercut / frame でのみ必要です。
デスクトップ UI は別のリポジトリにあります: yt-mem-ai-desktop — この パッケージに依存し、独自のローカル REST API を実行します。
はじめに
インストールして、ホストを再起動しましたか? これで準備完了です。アシスタントに話しかけるだけで、スキル(または MCP プロンプトと analyze_video)が取り込みを行います。
「https://youtu.be/dQw4w9WgXcQ を要約して」 → 動画を取り込み(字幕 → whisper)、動画と同じ言語でエグゼクティブサマリーと重要なポイントを作成します。
「その動画の見どころをタイムスタンプ付きで教えて」 → セマンティック検索を基に、動画内の該当箇所へ直接リンクする 3~8 個の場面(
watch?v=…&t=123s)を提示します。
「検索拡張生成について、何を見たっけ?」 → ライブラリ内のすべての文字起こしを検索し、該当箇所を引用します。
「登録チャンネルを処理して、今日のダイジェストを作成して」 → 新しい動画を見つけて取り込み、
digests/<DATE>.mdを作成します。
ターミナルを使いますか? 同じ初回実行は次のとおりです。
yt-ai fetch 'https://www.youtube.com/watch?v=VIDEO_ID'   # ingest one video
yt-ai search "what was said about embeddings"            # search your library
yt-ai status                                             # what's in the store
すべてのデータは ~/.yt-mem-ai/(ライブラリ、ログ、ダウンロード)に保存されます。
初回の実行には時間がかかりますが、これは想定どおりです。 インストール時に ML スタック(torch、LanceDB、sentence-transformers。ディスク上で約 1 GB)がダウンロードされ、最初の
fetchまたはsearchでは埋め込みモデルもダウンロードされます。動画に字幕がない場合は、Whisper モデル(small、約 460 MB)もダウンロードされます。字幕がある場合は必要ありません。これらはすべてキャッシュされるため、動画ごとではなく一度だけ実行されます。同じ理由で、GUI ホストでは初回の MCP 起動がアプリの起動チェックより長くかかることがあります。ターミナルで一度uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp --helpを実行してキャッシュを準備してから、アプリを再度開いてください。
毎日のルーティン
yt-ai discover               # what's new in your subscriptions
yt-ai fetch-pending          # transcribe today's batch
その後、アシスタントに 「登録チャンネルを処理して」 と指示すると、動画ごとの要約と
digests/<DATE>.md が作成されます。さらに、必要に応じて
yt-ai compile --out compilations/$(date +%F).md を実行すると、その日の見どころをクリック可能なリンクとしてまとめられます。
使い方
アシスタントへの話しかけ方(スキルとプロンプト)
このプラグインには 2 つのスキルが付属しています。MCP ホストでは同じ手順がプロンプト(yt_summarize、yt_highlights、yt_qa、yt_presentation、yt_digest、
yt_review、yt_group)として利用できるため、スキルに対応していなくても機能は失われません。
| スキル | 用途 |
|---|---|
yt | エントリーポイント。あらゆる操作と一連のパイプライン(毎日のルーティン、単一動画)に対応し、分析を yt-agent に委ねます |
yt-agent | 各種シナリオに対応します。動画 1 本 → 要約/見どころ/Q&A/プレゼンテーション、登録チャンネル → 毎日のダイジェスト、複数動画の横断レビュー、動画グループ |
| 指示 | 実行内容 | 保存先 |
|---|---|---|
「<url> を要約して」 | 取り込み → エグゼクティブサマリーと重要なポイント | チャット、ストア内の save_summary |
「<url> の見どころを教えて」 | タイムスタンプ付きで動画内に直接リンクする 3~8 個の場面 | チャットとストア |
「<url> について Q&A」 | 根拠に基づく 3~6 組の質問と回答 | チャットとストア |
「<url> からプレゼンテーションを作成して」 | --- で区切られたスライドデッキ | slides/<id>.md |
| 「登録チャンネルを処理して」 | 検出 → 取り込み → 動画ごとの分析 | digests/<DATE>.md |
| 「今週見た動画を振り返って」 | 複数動画を横断したテーマ別のエッセイ | reviews/<DATE>.md |
「これらの動画を分析して:<ids/urls/channel>」 | 一連の動画を取り込み → 動画ごとの分析と統合 | groups/<label>.md |
スキルがデータベースに直接アクセスすることはありません。CLI を呼び出すため、どのホストでも同じワークフローを実行できます。インストールするか、手動で貼り付けてください。
skills/README.md。
MCP ツール
yt-ai-mcp サーバーは、エンジン全体を型付きツールとして公開します。analyze_video
は、動画を取り込み、トランスクリプトを返すワンステップの入り口です。これを使って、
モデル自身が要約を作成できます。
| カテゴリ | ツール | 説明 |
|---|---|---|
| 分析 | analyze_video | 動画を取り込み、トランスクリプト(タイトル、チャンネル、言語、既存の要約も含む)を返します。要約/ハイライト/質疑応答の依頼では、まずこれを呼び出してください。 |
| 取り込み | fetch | 1 本の動画をダウンロードし、文字起こしして、埋め込みを生成します(force、captions_only、prefer_whisper)。 |
discover | 登録フィードから新しいアップロードを取得します(差分取得。after、deep、min_duration)。 | |
fetch_pending | 指定した日付以降に検出された動画をすべて一括で取り込みます。 | |
channel_list | チャンネルの最近のアップロードを列挙します(取り込みは行いません)。 | |
| ライブラリ | search | すべてのチャンクを対象に、タイムスタンプ付きでハイブリッド検索/ベクトル検索/全文検索を実行します。 |
show | 1 本の動画のメタデータと完全なトランスクリプトを表示します。 | |
list_videos | ステータス/日付/チャンネル別に、保存済みの動画を一覧表示します。 | |
status | ライフサイクルのステータス別に件数を表示します。 | |
| 要約 | save_summary | 要約、ハイライト、質疑応答を保存します。これにより、compile と supercut で利用できます。 |
| 好み | like / dislike | 1 本の動画へのフィードバックを記録します。 |
recommend | 好評価した動画との類似度に基づいて、未評価の動画をランク付けします。 | |
| メディア | compile | 分数の上限内で、該当箇所へのリンク付きハイライト文書を作成します。 |
supercut | ハイライトの選択内容を、ラベル付きの 1 本の mp4 にレンダリングします(ffmpeg とネットワークが必要です)。 | |
frame | 指定したタイムスタンプの静止フレームを取得します。 | |
| 設定 | config_list / config_get | 設定、値、それぞれの取得元を確認します(シークレットはマスクされます)。 |
config_set / config_unset | チャットから設定を変更します(プロキシの認証情報、Cookie 用ブラウザー、埋め込みモデルなど)。 | |
| メンテナンス | reembed | 埋め込みモデルの変更後に、ライブラリ全体の埋め込みを再生成します。 |
サーバーの詳細、プロンプト一覧、未加工の設定については、integrations/mcp/README.md を参照してください。
CLI コマンド
yt-ai fetch <url>            # download + transcribe + embed + store one video
yt-ai fetch <url> --captions-only  # captions only: no audio download / no whisper (fails if none)
yt-ai transcript <url>       # same pipeline
yt-ai discover               # new subscription uploads (--after/--deep/--min-duration/--json); incremental by default
yt-ai fetch-pending          # batch-fetch pending 'discovered' videos (since --since, default today; --limit)
yt-ai list                   # list stored videos (--status/--since/--json)
yt-ai show <video_id>        # metadata + transcript (--json)
yt-ai status                 # counts by status
yt-ai search "<query>"       # semantic search (--hybrid/--fts/--vector, -k N)
yt-ai save-summary <id> "<summary>" --highlights '<json>' --qa '<json>'  # persist a summary (used by skills)
yt-ai like <video_id>        # mark liked (feeds recommendations)
yt-ai dislike <video_id>     # mark disliked
yt-ai recommend              # rank your unrated fetched videos by taste (--limit/--json)
yt-ai compile                # deep-linked highlights doc, budget-bounded (--since/--max-minutes/--json/--out)
yt-ai supercut               # video reel of highlights, re-downloaded + labeled (--since/--max-minutes/--out/--keep-clips)
yt-ai frame <video_id> --at <ts>  # still frame at a timestamp (seconds or H:M:S) → frames/<id>_<s>s.png
yt-ai reembed                # re-embed all chunks with the current YT_EMBEDDING_* config
yt-ai channel-list <url>     # list a channel's recent uploads (--limit/--from/--to/--json); enumerate only
yt-ai config list            # get/set any .env setting: config get/set/unset/path (reconfigure from CLI or chat)
使用例
ケース:10 部構成の YouTube コースから、教科書全編の PDF を作成。
examples/defi-crypto-options.pdf — シリーズ «DeFi. Бесплатный
вводный курс по крипто-опционам»(@Menaskop)をもとに作成した、96 ページのロシア語の教材です。
パイプライン:シリーズの動画 10 本を特定 → ru-orig の字幕を取得(yt-dlp
+ブラウザー Cookie。Whisper は不要)→ 動画ごとに構成化された要約を作成 → 共通の
骨子(用語集、表記法、図版カタログ)を整備 → 書き直した 10 章(約 28.5k 語)
+描き直したベクター図版 47 点を作成 → Typst で組版・レンダリング。
単なる要約ではありません。各動画へのディープリンク、実例、図解、用語集を含む、第一原理から解説した章です。
設定
開始するために必要な設定はありません — デフォルトでは、ストア、ログ、ダウンロードファイルが
~/.yt-mem-ai/ の下に保存され、ローカル埋め込みモデルが使用されます。必要に応じて調整してください。
| 設定 | 内容 |
|---|---|
YT_STORE_PATH | LanceDB ディレクトリ |
YT_EMBEDDING_BACKEND | local(sentence-transformers)または openai |
YT_EMBEDDING_MODEL | 例:英語以外のライブラリには paraphrase-multilingual-MiniLM-L12-v2 |
OPENAI_API_KEY | openai 埋め込みバックエンドの場合のみ |
YT_COOKIES_BROWSER | chrome/firefox/… — YouTube の「ボットではないことの確認が必要です」という問題を解決します |
YT_CAPTION_LANGS | 優先する字幕の言語(デフォルトは en。利用可能な任意のトラックにフォールバックします) |
WEBSHARE_PROXY_*、YT_USE_WEBSHARE | 任意のローテーションプロキシ |
YT_CHUNK_TARGET_S | 埋め込みのチャンク長 |
CLI またはエージェントから設定 — .env を手動で編集する代わりに、
yt-ai config(または MCP の config_* ツール)を使うと、エージェントがチャットから自身を再設定できます。
yt-ai config list                  # every setting, value, and source
yt-ai config set WEBSHARE_PROXY_USERNAME <user>
yt-ai config set WEBSHARE_PROXY_PASSWORD <pass>
yt-ai config set YT_EMBEDDING_MODEL paraphrase-multilingual-MiniLM-L12-v2
yt-ai config get OPENAI_API_KEY    # secrets masked (--reveal to show)
set はデフォルトでグローバル設定ファイル(~/.yt-mem-ai/config.env)に書き込むため、
MCP サーバーは作業ディレクトリに関係なく設定を読み込めます。--project を指定すると
./.env に書き込みます。優先順位は、プロセス環境変数 > プロジェクトの .env > グローバル設定ファイルです。また、
config list では各値の取得元を確認できます。
内部の仕組み
以下はすべて任意で読める内容です。内部構造、調整方法、開発者向けの補足を説明します。
仕組み
yt-dlp → captions (or Whisper) → chunks → embeddings → LanceDB
                                                          ↓
                     your assistant reads + writes summaries back
CLI が重い I/O 処理を担い、ストアを管理します。スキルと MCP ツールは薄い呼び出し元です。動画は
discovered → downloaded → transcribed → summarized と進みます。ライブ配信には終端の stream ステータスが設定され、バッチ取り込みではスキップされます(必要に応じて yt-ai fetch <url> で文字起こしできます)。ストレージは埋め込み型の LanceDB(videos、channels、transcripts、chunks、summaries、
feedback)で、チャンクごとのベクトルと全文検索インデックスを備えています。これによりハイブリッド検索が可能になります。
コマンドの詳細
評価とおすすめ — 取得済みの動画に「いいね」または「よくないね」を付けると、yt-ai recommend が、動画の文字起こしの埋め込みを使って、気に入った動画との類似度から、よくないねを付けた動画の類似度を差し引いて、残りの動画をランキングします。何も「いいね」していない場合は、公開日時が新しい順に表示します。
discover は差分を取得します — 1 回のフラットな呼び出しでフィードの最新エントリーを取得し(YT_DISCOVER_FEED_LIMIT で上限を設定)、各エントリーにおおよそのタイムスタンプを付与します。その後、前回実行時の最終取得日時から 1 時間の重複期間(YT_DISCOVER_OVERLAP_S)を差し引いた日時より新しいものだけを残すため、時刻が時間単位に丸められていても境界の動画を取りこぼしません。処理済みの動画は除外されます。--after YYYY-MM-DD を指定すると、カットオフ日時を上書きできます。
compile と supercut の違い — compile は、その日のハイライトを Markdown のディープリンク(watch?v=ID&t=<start>s)として、新しい動画から順に、--max-minutes(デフォルトは 20 分)の範囲内で出力します。すぐに実行でき、--out を指定しない限り標準出力に表示します。supercut は各ハイライトの該当箇所を 720p で再ダウンロードし、ラベルを重ねてからすべてを連結し、supercuts/<date>.mp4 と、ソース(および失敗後にスキップされたクリップがあればその情報)を一覧にしたサイドカーファイル .refs.md を作成します。時間がかかり、ネットワーク接続と ffmpeg が必要ですが、共有できます。
埋め込み、プロキシ、その他の調整
埋め込み: YT_EMBEDDING_BACKEND=local|openai。ローカルでは sentence-transformers(YT_EMBEDDING_MODEL、デフォルトは all-MiniLM-L6-v2)を使用します。英語以外のライブラリでは、paraphrase-multilingual-MiniLM-L12-v2(384 次元、50 以上の言語)を設定すると、言語をまたいだセマンティック検索が機能します。openai では text-embedding-3-small|large を使用します(OPENAI_API_KEY が必要です)。モデルを変更した後は、yt-ai reembed を実行して既存のライブラリを移行してください(すべてのチャンクを再埋め込みします。再取得は行いません)。
プロキシ/VLESS: YT_USE_WEBSHARE のデフォルトは オフ です。すでにシステムレベルのプロキシ/VPN(VLESS/Xray など)を実行している場合は、オフのままにしてください。トラフィックはそのトンネルを通ります。Webshare プロキシを重ねると、認証済みのサブスクリプションフィードが機能しなくなります(CONNECT トンネルが 405 を返します)。ほかにプロキシがなく、YouTube によって生の IP アドレスがレート制限される場合にのみ、YT_USE_WEBSHARE=true を設定してください。検出の調整項目:YT_DISCOVER_FEED_LIMIT(最新 N 件の上限。デフォルトは 60)、YT_DISCOVER_OVERLAP_S(増分取得の重複時間。デフォルトは 3600)、YT_DISCOVER_TIMEOUT_S。
チェックアウトした状態で作業していますか? uv sync --extra dev を実行します。設定を ~/.yt-mem-ai/config.env ではなくプロジェクト内に保持する場合は、その後 cp .env.example .env を実行してください。
Python パッケージとして使用する
yt-mem-ai は通常のライブラリです。CLI は、直接呼び出せる run_* コアの上に構築された薄い Typer シェルです。すべてローカルで動作します。サーバーも API キーも不要です(openai 埋め込みバックエンドを選択した場合を除きます)。
pip install yt-mem-ai # or: uv add yt-mem-ai
from dataclasses import replace
from pathlib import Path

from yt_mem_ai.config import load_config
from yt_mem_ai.cli import open_store, run_fetch, run_search, run_list, run_save_summary
from yt_mem_ai.store import db as store

# Config comes from ~/.yt-mem-ai/config.env < ./.env < process env.
# Override any field in code (Config is a frozen dataclass):
cfg = replace(load_config(), store_path=Path("~/.yt-mem-ai/lance").expanduser())

db = open_store(cfg)          # opens LanceDB + creates tables/indexes once
                              # pass db=... to every run_* call to reuse it

# 1. Ingest: download → transcribe (captions → whisper) → chunk → embed → store
video_id = run_fetch("https://www.youtube.com/watch?v=dQw4w9WgXcQ", cfg, db=db)
# captions only (no audio download, no whisper):
# video_id = run_fetch(url, cfg, db=db, captions_only=True)

# 2. Read what was stored
video = store.get_video(db, video_id)
text = store.get_transcript_text(db, video_id)
print(video.title, video.channel, video.duration_s, len(text or ""))

for c in store.list_chunks(db, video_id)[:3]:
    print(f"[{c['start_s']:.0f}s] {c['text'][:80]}")

# 3. Semantic search across the whole library (hybrid | vector | fts)
for hit in run_search(cfg, "retrieval augmented generation", mode="hybrid", k=5, db=db):
    print(hit["video_id"], hit["start_s"], hit["text"][:100])

# 4. Bring your own LLM: summarize the transcript however you like, then persist
summary_md = my_llm(text)                       # any model / provider
run_save_summary(
    cfg, video_id, summary_md,
    highlights_json='[{"t": 42, "text": "key moment"}]',
    qa_json='[{"q": "What is it about?", "a": "..."}]',
    db=db,
)
print(store.get_summary(db, video_id))

# 5. Library queries
for v in run_list(cfg, status="transcribed", since="2026-01-01", db=db):
    print(v.video_id, v.published_at, v.title)
同じ形式を持つその他のコア(run_x(cfg, ..., db=db)):run_discover、run_fetch_pending、run_channel_list、run_recommend、run_feedback、run_compile、run_supercut、run_frame、run_reembed。より低レベルの要素もインポートできます。yt_mem_ai.download.download、yt_mem_ai.transcript.get_transcript、yt_mem_ai.store.embeddings.build_embedder/chunk_segments、yt_mem_ai.store.db(LanceDB の CRUD + search_chunks)。
ストアは通常の LanceDB なので、直接開くこともできます。
import lancedb
from pathlib import Path
tbl = lancedb.connect(Path("~/.yt-mem-ai/lance").expanduser()).open_table("chunks")
df = tbl.to_pandas()      # video_id, start_s, end_s, text, vector
ロギング
CLI は、構造化された JSON イベントを logs/common.jsonl(obs.log_event/blog 経由)に書き込みます。1 行につき 1 つのオブジェクトが記録され、形式は {ts, source, level, event, msg, ...ctx} です。パスは YT_LOG_FILE で変更できます。このファイルは Git の対象外です。jq で確認できます。
jq -c 'select(.level=="error")' logs/common.jsonl   # every error
tail -f logs/common.jsonl | jq -c '{ts,event,msg}'  # live tail, compact
テスト
uv run pytest -q                       # offline unit tests (fake embedder)
YT_RUN_INTEGRATION=1 uv run pytest -q  # + real sentence-transformers integration
リリース(メンテナー向け)
バージョンは Git タグから取得されます(hatch-vcs)。タグ付け、ビルド、公開を行います。
git tag -a vX.Y.Z -m "vX.Y.Z" && git push origin vX.Y.Z
uv build                                # → dist/ (sdist + wheel)
sh scripts/publish.sh dist/yt_mem_ai-X.Y.Z*   # uploads to PyPI
scripts/publish.sh は必要に応じて .env(Git の対象外)から UV_PUBLISH_TOKEN を読み込むため、毎回エクスポートする必要はありません。.env に UV_PUBLISH_TOKEN=pypi-… を一度追加してください(.env.example を参照)。同等の方法として、set -a; . ./.env; set +a; uv publish dist/* を実行できます。トークンが漏えいした場合は、PyPI でローテーションしてください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。