Groundline について
Groundlineはエンジンやベンチ試験のデータを分析し、再現可能な計算に基づく所見を数値単位で検証します。監査可能なレポートを必要とする試験データ分析者向けで、コマンドラインツールまたはMCPサーバーとしても動作します。
主な機能
- 01試験をフェーズに分割
- 02センサー、限界値、バルブ、振動を確認
- 03シミュレーション予測とデータを比較
- 04証拠台帳に計算を記録
- 05証拠に照らして所見の数値を検証
- 06レポート内の計算を再現
活用シーン
- 01エンジン燃焼試験データの分析
- 02センサー状態と限界値超過の確認
- 03試験データとシミュレーションの比較
- 04レポートの所見を監査・再現
MCP 対応
GroundlineはMCPクライアントに`open_run`、`list_analysis_tools`、`run_analysis`、`verify`、`write_html_report`の5つのツールを提供します。MCPクライアントが分析を計画する場合も、Groundlineの検証ルールが適用されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
5掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| run_path | string | はい | |
| limits_path | any | いいえ | |
| reference_path | any | いいえ |
詳細
Groundline
英語 | 简体中文
エンジン試験データのための検証可能な AI エージェントです。レポート内のすべての数値は、再現可能な計算までたどることができます。
ライブデモ:実際の静的燃焼試験の証拠を使って、ブラウザー上で検証器をだまして誤った数値を通せるか試してみてください。
名前は grounded(すべての数値に出典がある)と redline(限界値のチェック)に由来します。
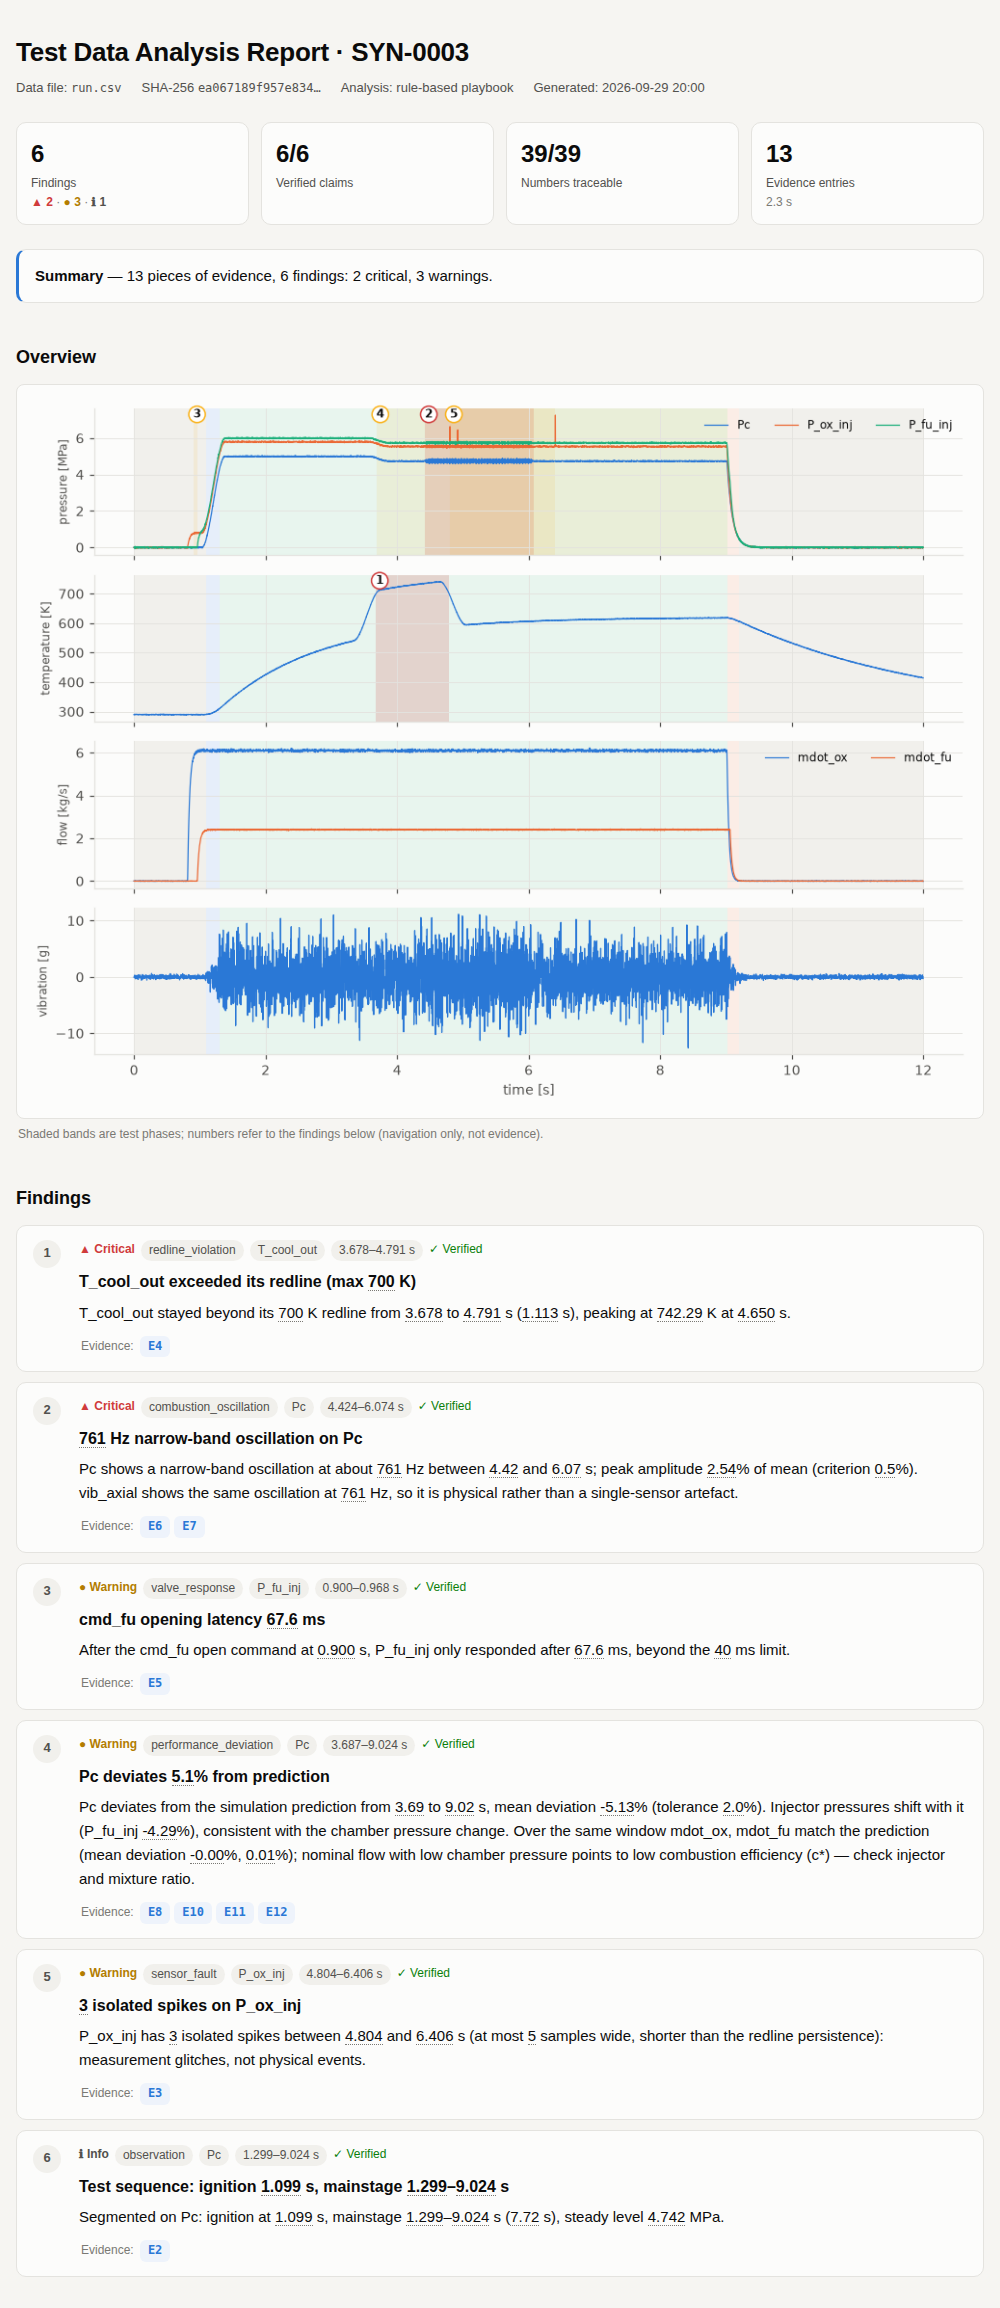
エンジンの高温燃焼試験(またはあらゆるベンチ試験)のデータを Groundline に渡すと、試験をフェーズに分割し、センサーの状態、限界値、バルブ応答、振動を確認し、シミュレーション予測と比較して、解析レポートを作成します。一般的な「AI 解析」とは異なり、次のような特徴があります。
- すべての数値は決定論的なツールから得られます。 LLM が生データを見ることはありません。どのツールを呼び出してどのように詳しく調べるかを判断し、その結果を読みやすい所見にまとめるだけです。
- すべてのツール呼び出しは証拠台帳に記録されます。 台帳にはパラメーター、データファイルの SHA-256、ツールのソースコードのハッシュ、結果、図が記録されます。所見で引用できるのは、これらの記録(E1、E2、...)のみです。
- すべての所見に含まれるすべての数値を検証器が確認します。 タイトルや記述内の各数値が、引用先の証拠に含まれている必要があります(丸め、および s↔ms、分数↔%の換算は許可されます)。見つからない数値にはレポート上で赤い波線が付き、LLM エージェントには拒否理由が返され、修正の機会が一度与えられます。検証器は数値の 意味 も確認します。数値の後に書かれた単位(s、Hz、%、bar、N·s など)は証拠フィールドの単位と一致する必要があり、「ピーク」「継続時間」「平均」「インパルス」などの語で導入される数値は、その役割に対応するフィールドから取得されている必要があります(意味検証を参照)。
- すべての所見を再現できます。
groundline reproduce report.jsonは、生データに対して台帳のすべての記録を再実行し、結果を一つずつ比較します。
ステータス:v0.1 プロトタイプです。ベンチマークでは、組み込みの合成データ生成器によるデータを使用しています。公開されている実試験データは実例として整理したものです。固体モーターの静的燃焼試験(HANARO)、液体エンジンの高温燃焼試験(Triton)、およびチーム独自のレポートと照合した4件のハイブリッドモーター高温燃焼試験(UVic MULE-1)があります。いずれにも限界値、バルブ指令、シミュレーション予測は付属していないため、これらのチェックは引き続き合成データのみで検証されています。
クイックスタート
pip install -e ".[all]"        # minimal install needs only numpy/scipy/pandas/matplotlib: pip install -e .

groundline demo                  # generate a synthetic hot-fire with anomalies and analyse it with the rule agent
open groundline_demo/report.html
groundline reproduce groundline_demo/report.json   # 13/13 evidence entries reproduced exactly
独自のデータを解析します(1列目に時刻を含む CSV。NI TDMS にも対応しています)。
groundline analyze path/to/run.csv --reference sim.csv --limits limits.json
limits.json の形式については、groundline synth が作成するサンプルを参照してください。限界値、限界値の継続時間、許容されるバルブ遅延、振動のしきい値、シミュレーションからの逸脱に対する許容範囲が含まれています。
生の DAQ エクスポートには、通常、Groundline のレイアウトがありません。groundline ingest を使うと、簡単な JSON マッピングからその形式に変換でき、マッピングの下書きも作成できます。
groundline ingest raw_log.csv                         # writes raw_log/map.json and lists what it guessed
groundline ingest raw_log.csv --map raw_log/map.json  # writes raw_log/run.csv + meta.json
groundline analyze raw_log/run.csv
下書きでは、Chamber Pressure (psi) のようなヘッダー、または列名の上にある単位の行から単位を読み取ります(単位の行が1セルずれている場合は位置も補正します)。また、時刻の列を特定し、燃焼室圧力に Pc という名前を付け、複数の推力ロードセルを合計して F_thrust とし、単位と名前から各チャンネルの種類を割り当てます。次に、分からない項目をマッピングに設定します。名前、時間範囲、等間隔グリッド(grid_hz)、ギャップを補間できる最大時間(max_gap_s。これを超えると、欠落が見えるように試験データは NaN のままになります)、およびチャンネルごとの scale/offset です。以下の Triton と UVic の例はこの方法で変換されており、以前に手作業で作成した変換と完全に一致することを確認できます。下書きを確認してから使用し、試験結果を description に含めないでください。LLM エージェントが読み取るためです。
LLM の使用
ルールエージェント(デフォルト)は固定チェックリストで、モデルを必要としません。LLM エージェントでは、モデルが分析を計画し、相互確認を行い、所見を自ら記述します。
最も簡単な設定方法は、プロジェクトのルートに .env を置くことです(.gitignore に含まれているため、コミットされることはありません)。
cp .env.example .env      # fill in OPENAI_API_KEY; change GROUNDLINE_AGENT / GROUNDLINE_LLM_MODEL as needed
groundline config         # show the configuration in effect (keys masked)
groundline demo           # from now on every command uses the agent and model from .env
Groundline は現在のディレクトリから上位のディレクトリをたどって .env を探します。コマンドライン引数と、シェルですでに設定されている環境変数が優先されます。.env を使わず、環境変数や引数を使用することもできます。
# OpenAI
export OPENAI_API_KEY=sk-...
groundline analyze run.csv --agent openai --model gpt-4o-mini

# Any OpenAI-compatible endpoint: Qwen, DeepSeek, vLLM, a local Ollama ...
export GROUNDLINE_LLM_BASE_URL=http://localhost:11434/v1   # e.g. Ollama
export GROUNDLINE_LLM_MODEL=qwen2.5:32b
groundline analyze run.csv --agent openai

# Anthropic
export ANTHROPIC_API_KEY=...
groundline analyze run.csv --agent anthropic --model claude-sonnet-5-5
LLM エージェントのベンチマークでは、検出率に加えて、Groundline は最初のドラフトで検証器が検出した捏造数値、修正ラウンド後の結果、トークン使用量も記録します。
groundline eval --agent openai --model gpt-4o-mini --n 10 --lang en --out eval_openai.json
結果ファイルは実行ごとに書き込まれます。実行が失敗した場合(タイムアウト、API クォータの枯渇など)、同じ --n、--seed、--suite を指定して --resume eval_openai.json を実行すると、完了済みの実行は保持され、残りだけが実行されます。
公式 OpenAI エンドポイントでは、Responses API が自動的に使用されます(gpt-5.6-sol などの推論モデルは、そこでのみ推論とツール呼び出しを同時に行えます)。推論の強度は GROUNDLINE_LLM_REASONING_EFFORT で設定します。他の OpenAI 互換サービスでは Chat Completions が使用されます。GROUNDLINE_OPENAI_API=responses|chat を指定すると、いずれかを強制できます。デフォルトでは temperature は送信されません。GROUNDLINE_LLM_TEMPERATURE で設定できます。--agent anthropic を指定した場合、同じ変数で推論の強度(low … max)を設定し、エージェントのステップ間でプロンプトのプレフィックスがキャッシュされます。
テストデータは通常、機密性が高いため、このインターフェースはオンプレミスでのデプロイを想定して構築されています。モデルが参照するのはツール出力の要約のみで、元データは参照しません。
MCP サーバーとして
Groundline は MCP Registry に io.github.fhs1220888/groundline として掲載されています。レジストリからインストールするクライアントは uvx groundline mcp で実行します。手動で追加する場合(Claude Desktop、Cursor など)は、次のようにします。
{
  "mcpServers": {
    "groundline": { "command": "uvx", "args": ["groundline", "mcp"] }
  }
}
ローカルのチェックアウトからは、groundline mcp(または groundline-mcp)を実行すると、同じサーバーが標準入出力で起動します。
公開されるツールは open_run、list_analysis_tools、run_analysis、verify、write_html_report の5つです。任意の MCP クライアント(Claude Desktop、Cursor、自作のエージェントなど)がプランナーとして動作できます。検証ルールは変わりません。
分析ツール
| ツール | 内容 |
|---|---|
describe_data | チャンネル、サンプルレート、単位、NaN 数 |
segment_phases | チャンバー圧力の10%/90%を基準に、実行をテスト前、始動、メインステージ、停止、テスト後に分割し、バルブ指令時刻を記録します |
check_sensor_health | NaN の欠損区間、信号の固定、孤立したスパイク(局所ロバスト σ) |
check_redlines | 持続条件と5 msの平滑化を用いてレッドラインをチェックします。短いグリッチは抑制された過渡現象としてカウントされます |
measure_valve_response | バルブ指令から応答チャンネルが変化するまでの遅延を、許容値と比較します |
detect_oscillation | スライディングウィンドウ FFT:周波数、振幅(平均値に対する%)、狭帯域振動の開始/終了 |
compare_reference | シミュレーション予測との比較:平均偏差、RMSE、持続的な偏差の区間 |
pulse_metrics | 固体モーター推力などのパルス形状チャンネルについて、ピーク、作用時間、積分値(全インパルス)、平均値を測定します |
check_thrust_pressure_ratio | チャンバー圧力に対する推力(どちらもベースラインより上)は、推力係数×スロート面積に比例します。エンジン燃焼中に50%を超える変化がある場合、フラグを立てます(スロートの侵食や故障、またはセンサーの不具合) |
channel_stats / plot_window | 詳細調査のための統計とプロット |
groundline tools を実行すると、パラメーターの詳細な説明が表示されます。
ベンチマーク
合成ジェネレーターでは、既知の異常を6種類、常に正解データ付きで注入できます。燃焼振動、冷却材の過熱、センサーの値の固定または欠落、測定値のスパイク、燃料バルブの遅れ、燃焼室圧力の低下(c*効率の低下)です。これにより、エージェントを定量評価できます。
groundline eval --n 50 --seed 1000
ランダムに選んだ50回の実行でのルールベースエージェントの結果:
| 異常 | n | 再現率 | カテゴリ精度 | 開始時刻の誤差(中央値) |
|---|---|---|---|---|
| 振動 | 15 | 100% | 100% | 12 ms |
| 過熱 | 22 | 100% | 100% | 0 ms |
| センサーの値の欠落 | 10 | 100% | 100% | 0 ms |
| センサーのスパイク | 8 | 100% | 100% | 0 ms |
| バルブの遅れ | 15 | 100% | 100% | 0 ms |
| 燃焼室圧力の低下 | 14 | 100% | 100% | 112 ms |
全体の適合率は100%で、正常な4回の実行では誤検出は0件でした。検出結果134件中134件を検証済みで、数値946件中946件に根拠がありました。
この6種類の異常と検出器は同時に作成されたため、上の表は主に、ツールがジェネレーターによる注入を想定して作られた異常を検出できることを示しています。以下のLLMの結果の後に示す2つのベンチマークでは、その前提を段階的に取り除いて評価します。
同じシードの最初の14回の実行(--n 14 --seed 1000、正常な実行2回と6種類すべての異常を含む)におけるLLMエージェント(gpt-5.6-sol、Responses API)の結果:
| 指標 | ルールベースエージェント | gpt-5.6-sol |
|---|---|---|
| 再現率/カテゴリ精度 | 100%/100% | 100%/100% |
| 適合率 | 100% | 95%(誤検出1件) |
| 正常な実行での誤検出 | 0 | 0 |
| 初稿での数値の捏造 | — | 0 / 376 |
| 1回の実行あたり | 1.6 s | 22 s、入力約19k/出力1,400トークン |
誤検出の1件は、バルブの遅れが原因の冷却材温度の遅れを、バルブの遅れに起因するものとせず、別個の性能偏差として報告したものです。実行回数は14回で、評価は1回のみであり、モデルの出力は非決定的なため、これらの数値は大まかな目安として扱ってください。
最初の評価では、適合率はわずか36%でした。「誤検出」37件のうち35件は、「バルブ応答は制限内」や「振動は検出されませんでした」といった合格したチェック項目を、モデルが異常カテゴリに分類したものでした。プロンプトにルールを1つ追加した後(「observation以外のカテゴリは異常が見つかったことを意味する。合格したチェックにはobservationを使用する」)、適合率は95%に上昇しました。評価方法は変更していません。
実際のモデルでのソースタグ
同じ14回の合成実行(シード1000~1013、英語、低い推論労力でのgpt-5.6-sol)について、すべての数値にソースフィールドのタグを付けるよう指示した場合と、指示しなかった場合の結果:
| タグあり | タグなし | |
|---|---|---|
| 再現率/適合率 | 100%/91%(誤検出2件) | 100%/95%(誤検出1件) |
| 正常な実行での誤検出 | 0 | 0 |
| 最終レポートでタグ付けされた数値 | 236 / 240(98%) | — |
| 初稿での誤ったタグ | 0 | — |
| 初稿で阻止された数値 | 0 / 242 | 0 / 314 |
| トークン数、14回の実行 | 入力277k/出力18.5k | 入力296k/出力17.5k |
| 1回の実行あたりの時間 | 21 s | 20 s |
タグ付けに測定可能なコストはかからず、モデルはほぼすべての数値に正しくタグを付けました。そのため、数値ごとに照合するフィールドは1つだけです(以下の、誤ったフィールドに置かれた値を使うベンチマークでは、タグなしの場合は67%、タグありの場合は99.9%の確率で誤りを検出します)。3件の誤検出はいずれも、バルブの遅れが原因の冷却材温度の遅れを独立した偏差として報告するという、同じ既知の間違いです。両方の条件で同じ1回の実行(シード1010)に発生し、タグありの場合に限り、もう1回の実行(シード1001)でも発生しました。実行回数が14回では、これは測定可能な差ではありません。タグ付きのレポートでは、数値の数が少なくなっています(312件に対して240件)。
今回の数値を出す前に、テストによってこちら側の間違いを2つ発見できました。ツールの結果はresultでラップされて届くため、モデルはE3.result.issues[0].countのようなタグを書いており、スモークテストで11件中6件のタグが拒否されていました。現在はそのようなパスも受け付けるようになり、タグが誤っている場合のメッセージには、その値が実際に一致するフィールドが示されます。また、1126.95 Hzの振動を「1.127 kHz」とした値は、kHzが既知の単位ではなかったためフラグが立ちました。現在はkHzも既知の単位になっています。
実際のテストでの LLM エージェント
実際の各テストにタグを付けて、gpt-5.6-sol を1回実行しました。チームの報告およびルールエージェントと比較すると、次のとおりです。
- UVic 2024-12-12:記録は燃焼室圧力がまだ上昇中の状態で終了しているため、性能と安定性は評価できません。カットオフ時に複数チャンネルで同時過渡現象が発生し、熱電対が故障しています。チームの報告と同じです。
- UVic 2025-01-18:燃焼室圧力のオフセット、故障した燃焼室熱電対、重複した圧力チャンネル、およびメインステージを通じて安定していた F/Pc が、その後に乖離していることを検出しました。
- UVic 2025-02-08:F/Pc の整合性チェックの失敗を検出しましたが、スロートを指摘するのではなく、「センサーの影響を受けている」と判断しています(燃焼室圧力に大きなオフセットがあります)。ルールエージェントはスロートの変化を考えられる原因の一つとして挙げていますが、どちらも何が壊れたのかは判断できません。
- UVic 2025-09-20:飽和した燃焼室圧力、故障した3つの熱電対、および停止直前の過渡現象を検出し、ピーク値は信頼できないと判断しました。
- Triton:DAQ の共通の欠落、飽和したレギュレーターセンサー、停止後に回復しない燃焼室圧力、孤立したスパイク、および警告としての 127 Hz イベントを検出しました。
- HANARO:公称どおりの燃焼と、推力チャンネルの燃焼していない期間のギャップを検出しました。
すべての検出結果を検証済みです。ここに至るまでに、2つの修正を行いました。
- 自分たちのテストにあったリーク。 最初の UVic 実行では、各チームの報告(「ノズルスロートインサートが破損した……」など)を説明に引用したメタデータを使用しており、
describe_dataは説明をモデルに渡します。そのため、2025-02-08 の報告では「報告されたノズル/スロートのハードウェア故障と一致」と述べていました。現在、報告はメタデータから除外されています(prepare.pyとこのドキュメントには残しています)。上記の結果は、クリーンな条件で再実行したものです。ルールエージェントは説明を読み取らないため、その結果には影響していません。 - プロンプトルールを2つ追加。 最初の Triton 実行では、停止後に回復しない燃焼室圧力が報告から漏れ(読み取ったセンサー健全性の結果には記載されていました)、0.58%の振動を重大と判定しました。このため、すべてのセンサー健全性の問題を報告に含めること、振動を重大とするのは基準値の2倍以上の場合に限ることをルールに追加しました。14件の合成実行では、新しいプロンプトによって再現率は100%、適合率は95%(既知の冷却材遅れによる誤検出1件)に維持され、数値の97%にタグが付与され、誤ったタグはありませんでした。
以前の2回の実行では、同じ検証器の誤警報に対処する修正が必要でした。「最大値は5180.25 psi」という記述が stuck_value フィールドにタグ付けされていました。現在は、タグ付けされた数値が同じオブジェクト内で同一の値を持つ兄弟フィールドにも一致するようになり、最大値で固定される問題には channel_max フィールドが付与されます。
現実的なスイート:実際のログに見られる異常とノイズ
groundline eval --suite realistic は、Triton と UVic のログで見つかった7つの異常と、それぞれの正解データを追加します(すべてのチャンネルでの DAQ 欠落、飽和したトランスデューサー、停止後に高い値で固定された燃焼室圧力、真空未満のゼロオフセット、重複チャンネル、故障チャンネル、60 Hz の商用電源ハム)。また、報告してはならないノイズも含まれます(レッドライン未満の起動時オーバーシュート、停止時のウォーターハンマー、ADC の量子化)。従来のスイートは、シードごと変更されていません。ルールエージェントを100回実行(--n 100 --seed 2000)した結果、13種類すべてで再現率、適合率、カテゴリ精度が100%となり、公称値の15件では誤検出が0件、検出結果257件すべてが検証済みです(詳細)。
スイートの構築により、3つの未解決点が明らかになり、修正されました。商用電源ハムは燃焼不安定として報告されていました(点火前から存在する線は、現在はピックアップとして報告されます)。記録が停止直後に終了する場合、停止後に固定された燃焼室圧力が見逃されていました。また、重複チャンネルによって性能偏差の誤検出も生じていました。ただし、最初の表と同様、これらの異常は修正後に作成されたため、このスイートは測定というより回帰テストです。
ハイブリッドベンチマーク:実際のログにおける既知の異常
groundline hybrid-bench は背景を実データのままにし、異常だけを合成します。実際の燃焼ログに既知の大きさと時刻の異常を1つ注入してルールエージェントを実行し、同じ設定で未加工のログを使った結果と比較します。これにより、ログ自体に含まれる実際の問題は評価に加算も減算もされません(注入した異常がその問題のいずれかに重なる場合は「マスク」されます)。背景データ:Triton の高温燃焼ログ、および UVic MULE-1 2025-01-18(HANARO は使用できません。燃焼室圧力が 10 Hz で記録されており、推力チャンネルには記録全体にわたって欠落があります)。サイズと背景ごとに5件ずつ、合計270件です(詳細)。
| 注入した異常 | サイズごとの検出数 | |
|---|---|---|
| Pc の振動(定常 Pc に対するゼロ・ピーク値、基準値 0.5%) | Triton:0.25% 0/5、0.5% 1/4、1% 5/5、2% 5/5、4% 5/5 · UVic:0.25–1% 0/15、2% 2/5、4% 4/5 | |
| レッドラインを超える Pc(超過時間、継続時間 10 ms) | 5 ms 0/10、10 ms 0/10、20 ms 10/10、50 ms 10/10、200 ms 10/10 | |
| 予測値を下回る Pc(定常 Pc に対する割合、許容誤差 2%) | Triton:1% 0/5、2% 0/5、3–8% 15/15 · UVic:マスク(Pc に既知のゼロオフセットがあるため) | |
| 推力の単一サンプルスパイク(局所ノイズの標準偏差単位、基準値 12) | 6σ 0/10、12σ 3/10、24σ 9/10、48σ 8/10 | |
| 推力チャンネルの欠落 | 10 ms~1 s:40/40 | |
| 推力チャンネルの凍結(最小 50 ms) | 20 ms 4/10、50 ms~1 s:30/30 |
270件のうち、注入によって新たな誤検知が発生したケースはありませんでした。 レッドライン、逸脱、欠落、凍結の各チェックは、実際のノイズに対して仕様どおりに動作します。振動の検出性能はエンジンによって異なります。Triton の液体エンジンでは、約0.5%の基準値以上で機能します。一方、燃焼が粗い UVic ハイブリッドでは、広帯域の燃焼ノイズにより数パーセント未満の線スペクトルが隠れてしまいます。このために追加した0.5秒ウィンドウでの2回目の探索により、UVic の2~4%における検出数は2/10から6/10に増加しました。24σおよび48σでの見逃しは、Triton の起動時の圧力イベント中、または DAQ の欠落箇所の隣に配置されたスパイクです。このような箇所では、意図的にスパイク検出の感度を下げています。4件の20 msの「検出」は、フラットラインチェックではなく、段差からの復帰時にスパイクチェックが作動したものです。
groundline hybrid-bench --agent openai(または anthropic)を実行すると、同じケースを LLM エージェントで実行します。LLM の回答は実行ごとに異なるため、各ケースはその背景でのクリーンな実行すべて(注入の種類ごとに1回)とまとめて比較します。別のチャンネルであっても、クリーンな実行ですでに同じカテゴリとチェックの検出が同じ時刻にあった場合、新しい検出は誤検知として数えません。新しい検出として数えるのは、その時間ウィンドウがクリーンな検出の範囲を超えた場合のみです。たとえば、LLM が注入した振動を近くの実イベントと統合し、1つの広い検出として報告することがあります。各ケースにはエージェントの検出結果が保存されるため、エージェントを再実行せずにスコアを再計算できます。また、--resume を指定すると、失敗したケースだけを再実行します。
モデルのリーダーボード
groundline leaderboard は、複数のエージェント/モデルを同じ合成実行で評価し、1つの表にまとめます(leaderboard/LEADERBOARD.md)。モデルは JSON ファイルに記載します。examples/leaderboard.json には、ルールエージェント、gpt-5.6-sol、および Ollama 経由でローカル実行する Qwen2.5 7B/3B が記載されています(14B の実行にはより多くのメモリが必要です)。既存の groundline eval の結果は、再実行せずに "from" を使ってインポートできます。結果は実行ごとに保存されるため、中断したリーダーボードは停止したところから再開します。
groundline leaderboard examples/leaderboard.json            # all models
groundline leaderboard examples/leaderboard.json --only "qwen2.5-7b (本地)"
重要な列は初回ドラフトで出典のない数値です。つまり、引用された根拠に含まれていないため、検証器が最初の提出時に止めた数値です。言い換えると、検証器がなければレポートに含まれていた数値です。再現率はすべての実行を対象に算出します。モデルがクラッシュした実行や、何も提出しなかった実行に含まれる異常も、見逃しとして数えます。
2026-09-29 の結果(--n 14 --seed 1000。ローカルモデルは、16k のコンテキストを設定した 16 GB の MacBook Pro 上で Ollama を使用して実行。生データは docs/results/leaderboard/ にあります)。
| モデル | 提出されたレポート | 再現率(厳密/緩やか) | 適合率 | 通常実行時の誤検出 | 出典のない初稿の数値 | 検証後も誤っている項目 | 秒/実行 |
|---|---|---|---|---|---|---|---|
| ルールエージェント | 14/14 | 100% / 100% | 100% | 0 | – | 0 | 1.3 |
| gpt-5.6-sol | 14/14 | 100% / 100% | 95% | 0 | 0 / 376 (0%) | 0 | 22 |
| Qwen2.5 7B | 11/14 | 5% / 50% | 5% | 0 | 25 / 98 (26%)、意味が誤っているものがさらに2件 | 数値26件、指摘事項19件 | 478 |
| Qwen2.5 3B | 13/14 | 0% / 0% | – | 0 | 1 / 1 | 数値1件、指摘事項4件 | 28 |
厳密な再現率では、指摘事項のチャネルフィールドと時間範囲が一致する必要があります。緩やかな再現率では、チャネルが記入されていなくても、カテゴリが正しく、時間に矛盾がない指摘事項も数えます(モデルは問題を見つけたものの、構造化フィールドに入力しませんでした)。
Qwen2.5 7Bは、結果が大きく異なる3回の実行を行いました(提出されたレポート数は11 / 7 / 11、当時の採点による出典のない初稿の数値は15% / 12% / 23%)。表には最後の実行結果を示しており、現行の検証器で再採点した値(26%)です。証拠台帳を保存し、新しい検証器で再検証できたのは、この実行が初めてでした。
監査した2回目の実行では、検証器が7Bの初稿で検出した10個の数値を1つずつ確認し、同じシードから証拠を再計算しました。
- 4件は捏造された値でした:49.9994 kgの流量積分を「約60」と記載したもの、最大偏差約10.3%を2.29%と記載したもの、出典のない継続時間2件(「0.86 s」「lasting 2 s」)。
- 6件は実際の値でしたが、誤った証拠を根拠としていました:そのうち2件(メインステージの開始時刻と終了時刻)は、冷却材がメインステージ全体を通してレッドラインを超えていたという誤った主張の裏付けに使われましたが、実際に超えていたのは3.95~5.91 sの間だけでした。
- 誤警報はありませんでした:検出された数値はすべて実際の問題でした。3Bの実行では、テストID「SYN-1013」を数値として読み取った誤警報が1件ありましたが、修正済みです。
最後の実行では、意味検証がさらに4件の数値を検出しました。これらには出典がありましたが、意味が誤っていました。根拠付けのみを行う検証器なら、すべてを通してしまっていたでしょう。この4件はすべて実際の問題です。
- 「約0.2 s続いた」:0.2は流量積分の値であり、継続時間ではありません。これはまさに「たまたま無関係な数値と一致する、でっち上げの数値」という抜け穴です。
- 「平均偏差0.069%」:証拠中の0.069はMPa単位の絶対偏差であり、パーセンテージではありません。
- 「kg·s」として示された流量積分2件:流量の積分はkg単位の質量です。
実際の出力に対して初めて実行した際、意味検証はさらに4件の数値を検出しました。監査の結果、これは検証器自体のバグだと判明しました。「MPa·s」や「kg/s·s」のような複合単位を最初の単位までしか読み取っていなかったのです。現在は複合単位全体を読み取り、単位を約分します(kg/s·s = kg)。修正後は、gpt-5.6-solが記述した60個の数値にも、ルールエージェントが記述した1,884個の数値にも、誤警報はありません。
これらの結果は、検証器の限界も示しています。
- 修正ラウンドを行っても、小規模モデルの問題は解決しません。 最後の実行では7Bは修正ラウンドを9回行いましたが、検証後も問題のある数値が26件残りました。検証器の役割は問題を指摘すること(レポート内の赤い波線)であり、モデルに正解させることではありません。
- データの読み違いは検出されません。 7Bは定常的な酸化剤の流れを「鋭いパルス」と表現しました。引用した数値はすべて実在し、対応するフィールドとも一致していたため、検証器には検出できません。意味検証を導入する前は、捏造された「合計11 s」も、証拠中の数値のいずれかとたまたま1%以内で一致したため通過していました。この抜け穴を塞ぐのが意味検証です。
- 小規模モデルは、数値を捏造するだけでなく、タスクを完了できないことがほとんどです。 7Bはどの実行でも、ステップ数または時間の制限内にレポートを提出できないテストが複数ありました。3Bはほとんどの場合、空のレポートを提出しました。何も言わないモデルは何も捏造しません。実行ごとのばらつきが大きく、サンプル数も少ないため、これらの数値は大まかな目安として扱ってください。 **これらの数値は参考程度に捉えてください。**ルールエージェントはこの合成データ生成器と組み合わせて調整されているため、満点を取れても、パイプラインに矛盾がないことを示すだけで、実データを処理できることを示すものではありません。このベンチマークの主な用途は次のとおりです。
- LLM エージェントの比較、および数値をどのくらい頻繁に捏造するかの評価。
- ツールの変更時にリグレッションを検出すること。
- より難しいシナリオへの対応:連動する異常、現実的なノイズスペクトル、センサードリフト、実際のテストデータとの比較。
実データの例:HANARO 固体モーター静止燃焼試験
examples/hanaro_knsb/には、SNU Rocket Team HANARO による公開 KNSB 固体モーター静止燃焼試験(2025年)のデータが含まれています(データ提供元:snu-hanaro/static-fire-toolkit、MIT License)。元のファイルはraw/に変更せず保存されており、prepare.pyで Groundline の入力形式に変換します。
- 推力は、不規則な時刻にサンプリングされたロードセルから取得されており、タイムスタンプが重複しています。重複値を平均し、信号を 100 Hz のグリッドに補間します。どの生サンプルからも 25 ms を超えて離れたグリッド点は NaN のままにし、欠落フレームが見えるようにしています。
- 公開ファイルにはロードセルの校正定数が含まれていないため、HANARO 自身が処理した推力に直線を当てはめ、電圧をニュートンに変換しています(R² = 0.9999)。
- 圧力は推力 DAQ と同期していない別のロガーから取得されており、サンプリングレートは約 10 Hz です。クロックオフセットは、圧力と推力の相関が最大になるシフト(+5.652 s、相関係数 0.9995)です。
- HANARO はケース内圧力や推力の上限値を公開していないため、レッドラインはなく、シミュレーションによる予測もありません。
python examples/hanaro_knsb/prepare.py        # regenerate run.csv / meta.json / limits.json
groundline analyze examples/hanaro_knsb/run.csv
HANARO 独自の処理結果とルールエージェントの比較:
| Groundline | HANARO の処理結果 | |
|---|---|---|
| 最大推力 | 2222.2 N | 2221.7 N |
| 全インパルス | 6362 N·s(ピークの 10% における作動時間、3.91 s) 6391 N·s(2% の場合、4.12 s) | 6411 N·s(4.35 s の計測区間) |
推力の校正は HANARO の曲線に合わせているため、ピーク値が一致するのは当然です。独立した検証項目は、クロックの同期、作動時間、インパルスです。
測定上の問題も 2 件見つかりましたが、どちらも燃焼の範囲外です。推力チャンネルにはデータの欠落が 285 箇所あり、間隔の中央値は 0.67 s です。規則的な間隔であることから、DAQ フレームが周期的に欠落している可能性があります。また、点火の約 121 s 前に推力の孤立したスパイクがあります。
LLM エージェント(gpt-5.6-sol)はこのデータについて 3 件の所見を出し、いずれもルールエージェントの所見(シーケンス、推力性能、推力チャンネルの欠落とスパイク)と一致しました。25 個の数値はすべて根拠に基づいており、最初のドラフトで捏造された数値はありません。また、Pc がわずか 10 Hz で記録されており振動を捉えられないことを独自に指摘し、代わりに推力チャンネルの 5–50 Hz 帯域を確認しました(振動は見つかりませんでした)。リクエストは 4 回、入力トークンは約 13k です。
このデータにより、合成液体エンジンのみに基づいていた複数の前提が明らかになり、修正されました。
- 低速チャンネルを高速グリッドに補間した後、振動検出ではナイキスト周波数を超える帯域を検索し、スパイク検出では実際のサンプルをすべてスパイクとして扱っていました。現在、ツールは
meta.jsonからnative_rate_hzを読み取り、チャンネル固有のサンプリングレートに基づいて判定します。 - 量子化された静かな信号(点火前の安定した周囲圧力など)では、残差の中央値が 0 になるため、ノイズフロアも 0 となり、1 段階の揺らぎがスパイクとして数えられていました。
- 燃焼の前後で変化しないセンサーは「固定」ではありません。現在は、燃焼と重なるフラットラインのみを報告します。
- 繰り返し発生する数百件のフレーム欠落は、個別に報告するのではなく、1 件の所見として報告します。
- 点火時の推力の急上昇が振動帯域の最も低いビンに入り込み、「5 Hz の振動」として報告されていました。そのビンにピークが位置するウィンドウは、現在はフラグ付けされません。
- 最大推力、作動時間、全インパルスを計測する新しい
pulse_metricsツール。
変更後も、合成ベンチマークでのルールエージェントの再現率と適合率は 100% で、偽陽性は 0 件です。
実データの例:Triton 液体エンジンのホットファイア
examples/triton_lox/ は、圧送式 LOX/燃料液体エンジン Triton の公開ホットファイア試験(2025年4月11日、データは aidenmccollum/Triton-Hotfire-Analysis)を Groundline の入力データに変換します。このリポジトリにはライセンスがないため、データは Groundline にコピーしていません。prepare.py がデータをダウンロードし(コミットを固定)、ローカルに run.csv を書き出します。どちらも git の管理対象外です。データは約 1.94 kHz の DAQ ログ 1 件で、チャンネルは 25 個あります。内訳は、推力ロードセル 3 個、燃焼室・マニホールド・タンク・レギュレーターの圧力、タンク重量、熱電対です。レッドライン、バルブ指令、シミュレーションによる予測は付属していません。
python examples/triton_lox/prepare.py        # downloads the log, keeps 120-180 s, 2 kHz grid, dropouts left as NaN
groundline analyze examples/triton_lox/run.csv
セグメンテーション結果は、チーム独自の解析区間(ログ上の 148.35~153.35 秒)と一致しています。点火は 148.41 秒、メインステージは 148.43~153.16 秒、推力作用時間は 148.41~153.54 秒です。ピーク推力は 1144 lbf、作用時間中の平均推力は 846 lbf、総力積は 4344 lbf·s です(ベースラインを除去した 3 個のロードセルの合計)。この試験について、これらの値を照合できる公開基準値はありません。
また、データに含まれる計測上の問題も検出しました。
- シャットダウン後も燃焼室圧力がベースラインに戻らず、試験前は 13.8 psi だったのに対し、ログ終了まで約 223 psi を示しています(定常レベルの 63%)。一方、推力と両方のマニホールド圧力は大気圧に戻っています。
- 燃料レギュレーターの上流圧力は、丸 1 分間ずっと最大値の 5180.25 psi を示しています。フルスケールで飽和している可能性が最も高いです。
- 24 個すべてのチャンネルで同じタイミングにデータが欠落しています。最大 42 ms の欠落が 192 回あり、DAQ フレームのドロップと考えられます。
- 点火時には 5 種類のセンサーで 20 ms 以内にスパイクが発生し、その約 0.5 秒後には燃焼室圧力が 467 psi まで上昇するスパイクが約 30 ms 続きます(+20%)。Groundline は、これらの同時発生したスパイクを、物理現象か干渉かを判断せずに 1 件のイベントとして報告します。
Groundline が初めて扱った液体エンジンのデータであり、ルールエージェントの初回実行では 131 件の指摘が出ました。そのうち 87 件は、1 個のセンサーが値を固定したことによるものでした。そこで明らかになった問題と、その後の変更点は次のとおりです。
- 短い欠落のたびに値の固定状態が分割され、別々のフラットラインとしてカウントされていました → フラットライン内の短い欠落では分割しないようにし、チャンネルの最大値または最小値に固定された値は、飽和の可能性が高いとマークします。
- すべてのチャンネルに共通する欠落が、チャンネルごとに報告されていました → DAQ のドロップアウトとして 1 回だけ報告します。
- シャットダウン後に高い値で固定された燃焼室圧力センサーを検出できず、「シャットダウン」がログ終了まで続いていました(ピークの半分を超えた値で固定されていたため、定常レベルの平均にも含まれていました) → ベースラインに戻らない状態を確認する処理を追加しました。トレースが落ち着いた位置でテールオフを終了し、ピーク付近のプラトーから定常レベルを求めます。
- 起動時の過渡現象が、単一の 50 ms ウィンドウに基づく 59 Hz および 134 Hz の「振動」として「重大」と報告されていました → 振動として扱うには 3 ウィンドウ以上続く必要があります。より短いピークは短時間イベントとして記載します。
- 複数種類のセンサーに同時に発生したスパイクが「物理現象ではなく計測上の不具合」と判定されていました → 単一のセンサーでは説明できない 1 件のイベントとして報告します。
変更後の指摘は 18 件となり、すべて検証済みです(数値は 105 件)。合成ベンチマークと HANARO の結果は変わっていません(新しい定常レベル推定と、その後に追加したベースライン相対のしきい値により、HANARO の点火境界とメインステージ境界が最大 150 ms 移動しました)。燃焼中は Pc、LOX マニホールド、推力に約 126 Hz の成分が現れます。これは実際の成分ですが小さく(平均で Pc の約 0.1%)、デフォルトの 0.5% 基準を超える 0.15 秒間を Groundline が警告としてフラグ付けします。
実データの例:UVic MULE-1 ハイブリッドモーター、チーム自身のレポートとの照合
examples/uvic_mule/ は、UVic Rocketry の N2O/パラフィンハイブリッドモーター MULE-1 の4回の高温燃焼試験(UVicRocketry/Propulsion-Test-Data)を Groundline の実行データに変換します。液体エンジンではなくハイブリッドエンジンですが、液体エンジンのような酸化剤供給系(ランタンク、流路、バルブ、インジェクター)を備え、約450 Hzのログがあります。特に価値があるのは、チームが各試験で何が起きたかを記録している点です。リポジトリにはライセンスがないため、Triton の場合と同様に、prepare.py でログをダウンロードし、コミットはしません。
python examples/uvic_mule/prepare.py          # all four hot fires
groundline analyze examples/uvic_mule/2025-01-18/run.csv
| 試験 | チームのレポート | Groundline(ルールエージェント) |
|---|---|---|
| 2024-12-12 | イグナイターの配線がショートし、両方のバルブが電源を失い、エンジン点火直後にDAQが停止 | 「燃焼中に記録が停止」:Pcは317.48秒に上昇し始め、ログは317.53秒で終了しているため、性能は報告されません。T_post_combの信号はありません |
| 2025-01-18 | 「初の完全に正常な高温燃焼試験」。推力は約25%低く、原因は不明。燃焼室の熱電対は未設置/破損 | 燃焼室の熱電対は両方とも機能していません(−273.1 °C:センサーの断線)。Pcは真空圧より低い値を示しています(中央値−25.4 psi):ゼロオフセットです。P_n2_lineとP_run_tankはサンプルごとに完全に同一ですが、レポートでは言及されていません。配線または設定のエラーです。主燃焼中のF/Pcは安定しています(9%)が、燃焼終了時には62%ずれており、Pcが24~171 psiを示す一方で推力は約330 Nのままです |
| 2025-02-08 | ノズルのスロートインサートが破損(約7 mm拡大)、ライナーが砕け、安定燃焼せず、推力が低かった | 燃焼中にF/Pcが79%変化(1.54 → 2.76 N/psi):スロートの拡大、またはセンサーの故障を示す特徴です。Pcにはオフセットがあり、始動時には複数のチャンネルで同時にスパイクが発生しています |
| 2025-09-20 | レポートなし | 燃焼中にPcが2021 psiで飽和したため、区間判定は推力にフォールバックしました(1.16~5.67秒、動作時間4.51秒、1268 N·s)。停止時の10 ms、2343 Nの推力スパイクは、ピークではなくスパイクとして認識されます。熱電対3本が機能していません |
このデータからは、推力が予測を25%下回ったこと(予測値が公開されていないため)、02-08に「スロートの変化またはセンサー」以外の何が壊れたか、あるいは01-18の燃焼終了時の不一致が圧力ポートと燃焼のどちらに起因するかは判断できません。
Triton と同様に、最初の実行には教訓となる誤りがありました。ノイズの小さな信号や点火時に途切れたログからフェーズを検出したこと、単にプラグが抜けていたセンサーを「飽和」と判定したこと、飽和したPcに基づいて区間を判定したこと、停止時の10 msの衝撃を最大推力として扱ったこと、サブウィンドウの振動検索でクラッシュしたことです。変更点は以下のとおりで、いずれも汎用的な変更です。
- 区間判定:試験前のベースラインに対する相対しきい値を使用(オフセットの影響を受けないようにする)、主燃焼から逆方向に検索して点火を検出、Pcに明確なパルスが見られない場合は推力にフォールバック、燃焼中にログが終了した場合はフラグを設定;
- センサーの状態:記録全体で値が1つだけなら「信号なし」とし、飽和とは扱わない。物理的にあり得ない読み取り値(真空圧より低い圧力、絶対零度より低い温度が少なくとも0.5秒続く)、サンプルが同一のチャンネルも検出;
- 新しいツール
check_thrust_pressure_ratio:燃焼室圧力に対する推力は推力係数とスロート面積の積に比例するため、エンジンの燃焼中は一定であるはずです。このツールは準定常状態のウィンドウのみを使い、変化が主燃焼中に起きたかどうかを示します; - パルス指標:パルスは0.1秒の中央値に基づいて特定するため、短い衝撃がピークと誤認されることはありません。
回帰テスト:合成ベンチマークは変更なし(再現率と適合率は100%、134/134を検証済み)、HANAROの推力結果も変更なし(2222.2 N、6362 / 6391 N·s。ベースライン相対しきい値により、点火と主燃焼の境界は最大150 ms移動)、Tritonも変更なしです。ツールの結果にフィールドが追加されたため、ベリファイアのベンチマークは最大で1ポイント変化しました。
意味検証
「引用した証拠にその数値が含まれている」ことだけを確認する方法には、2 つの抜け道があります。どちらも上記の 7B の結果で見られました。実在する数値を誤った箇所に使うケース(引用した数値はすべて実在しますが、意味が違います)と、証拠に含まれる無関係な数値と、丸めの範囲内でたまたま一致する架空の数値を使うケースです。
そこで検証器は、証拠中の各数値がどのフィールド(peak、duration_s、freq_hz など)に由来するかとその単位を記憶し、文中の各数値を次の要素と併せて読み取るようになりました。
- 単位:s/ms が付いた数値は時間フィールドとのみ一致し、Hz は周波数フィールド、% はパーセンテージフィールドとのみ一致します。bar、K、N·s などの物理単位は、ツールが報告した単位と一致する必要があります。複合単位は全体として読み取り、約分します(kg/s·s = kg)。記載された単位によってスケールも決まります。0.8 s のフィールドは 800 ms と記載できますが、0.8 ms とは記載できません。「3 spikes」「3 个」のような個数を表す語は、個数フィールドまたはリストの長さに基づく必要があります。
- 役割を表す語:「peak/duration/mean/impulse/frequency/deviation/latency」(または中国語での同等語)の直後に置かれた数値は、その役割に合った名前のフィールドに由来する必要があります。この語が判定対象になるのは、数値に直接続く場合のみです。「continuously above the 700 K redline」では、その語は超過の様子を表しており、「10% of the peak」はピークに対する割合です。どちらもこのチェックの対象になりません。範囲の両端(1.27–9.02 s)も役割のチェック対象外です。代わりに、範囲の先頭の数値には末尾に記載された単位が適用されるため、1.27 も時間である必要があります。また、時間範囲の終点は始点より前であってはなりません。
- カテゴリ:異常カテゴリ(レッドライン違反、振動、センサーの故障、バルブ応答、性能偏差)に分類された所見は、該当するツールが、その所見と同じチャンネルでその異常を実際に報告した証拠を引用する必要があります。合格したチェックは観察事項として分類しなければなりません。これが、上記の最初の LLM 実行で適合率が 36% だった原因です。保存済みの実行結果を再検証したところ、今でも 7B モデルで最もよく見られる誤りでした。「valve response normal」や「no significant oscillation」を異常として分類したり、単なるピーク値を性能偏差として分類したりしています。このモデルの主張のうち 5 件に新たにフラグが立ちました。gpt-5.6-sol の主張にも、ルールエージェントの主張にもフラグは立っていません。
これは引き続き、文字列とフィールドの決定論的な照合です。判定のために別の LLM を呼び出すことはありません。
ソースタグ。 数値がどのフィールドに由来するかを推測する方法には限界があります。テキストだけでは、どちらも「時間」である 2 つの数値を区別できない場合があるためです。そこで数値の直後に、単位と併せて角括弧でフィールド名を記載できます。例:742.3 K [E4.violations[0].peak_value]、3 spikes [len(E3.issues[0].spikes)]、3.86 [E6.events[0].t_start]–6.01 s [E6.events[0].t_end]。タグ付きの数値は、指定されたフィールドとのみ照合されます(値、単位、役割を表す語、範囲の順序)。誤ったフィールドを示すタグや、その所見が引用していない証拠を示すタグにはフラグが立ちます。通常の参照である [E4] はそのままです。HTML レポートでは、タグは対応する証拠エントリへのリンクになります。LLM エージェントには、すべての数値にタグを付けるよう指示されます(GROUNDLINE_CITE_NUMBERS=0 を指定すると無効になります)。MCP クライアントも同じことができます。タグのない数値は、これまでどおりチェックされます。
単位変換も、フィールドの種類に紐付けられるようになりました。s ↔ ms は時間に限り、分数 ↔ % は単位のない割合に限られます。802 Hz の周波数が、記載された 8(×0.01)と「一致」することはなくなり、0.5 % のしきい値が「50 %」と一致することもありません。
検証器自体のベンチマーク(groundline verifier-bench):正しいルールエージェントの所見を起点に、既知の 3 種類の誤りのうち 1 つを意図的に混入させるため、一度に数値を 1 つだけ変更し、検証器が何を検出するかを集計します。比較対象は、「引用した証拠にその値が含まれている」ことだけを確認する方式、タグなしテキストに対するすべてのチェック、すべての数値にソースタグを付けた場合のすべてのチェックです。合成実行は 100 件で、中国語と英語をそれぞれ 50 件ずつ実施します。
| 埋め込んだ誤り | 件数 | グラウンディングのみ | グラウンディング+意味解析 | ソースタグ付き |
|---|---|---|---|---|
| 捏造された値(−30%~+50%の範囲で変更) | 1372 | 89% | 98% | 100% |
| 実際の値だが場所が誤っている(同じエビデンスの別のフィールド) | 1444 | 0% | 67% | 99.9% |
| 単位の誤り(s ↔ Hz、% → s など) | 1174 | 0% | 98% | 100% |
| 変更されていない正しい指摘(誤検知) | 268 | 0% | 0% | 0% |
タグなしの場合、誤った場所に置かれた値に対する67%は、2つのケースに分かれます。異なる種類のフィールドへの入れ替え(継続時間をピーク圧力に置き換えるなど)は92%の確率で検出されます。同じ種類のフィールドへの入れ替え(ある時刻を別の時刻に置き換えるなど)は、文中に役割を示す語がある場合、入れ替えによって時間範囲が崩れる場合、またはs/msのスケールが合わなくなる場合に限り、34%の確率で検出されます(範囲、スケール、件数、換算のルールを追加する前は、全体で45%、69%、13%でした)。これがテキストだけを読む場合の限界です。ソースタグがあれば、埋め込んだ3,990件の誤りのうち、2件を除くすべてが検出されます(残る2件は、入れ替えられた値が丸めの範囲内で引用先のフィールドと一致するものです)。LLM エージェントが数値に確実にタグを付けるかどうかは、まだ測定されていません。上記のベンチマーク実行は、タグ付けの指示が加わる前のものです。
また、役割を示す語のルールはルールエージェントの文テンプレートを基に作成されているため、同じテンプレートで測定した上記の誤検知率は楽観的です。独立したテキストでは、gpt-5.6-sol が作成した2件のレポート(指摘9件、数値60件。HANARO の実データレポートを含む)に対して新しい検証器が誤検知を出すことはありませんでした。また、範囲、スケール、件数、換算のルールを追加した後、保存済みの gpt-5.6-sol と Qwen のベンチマーク実行を再検証しても(gpt-5.6-sol の主張123件、数値798件)、gpt-5.6-sol の判定に変化はありませんでした。7B のドラフトでは、さらに2つの数値を止めましたが、どちらも誤りでした。合計インパルス19.4に×0.01を掛けた値とのみ一致する「0.2 s」という継続時間と、×1000でスケールされ、パーセンテージとして記載されたMPa単位の平均偏差です。誤検知率をより確実に推定するには、異なるモデルによる実レポートをさらに集める必要があります。
LLM ベンチマークの実行では、各実行の指摘がエビデンス台帳とともに保存されます。検証器を改善した後は、モデルを再実行せずに groundline reverify <results.json> で再採点できます。上記の最後の7B実行(docs/results/leaderboard/)は、この方法で再採点されました。
設計上の注意点
- LLM は算術演算を行いません。 システムプロンプトでは、指摘に含まれるすべての数値をエビデンスから取得するよう求めています。「偏差5%」と述べるには、モデルは
compare_referenceを呼び出してその数値を取得する必要があり、2つの数値を自ら引き算してはなりません。 - ルールエージェントも検証器を通過する必要があります。 開発中、検証器は、どのエビデンスにも記載されていない「5 samples」というハードコードされた値がルールテンプレートにあることを検出しました。修正では検証器を緩めず、基準をツール出力に含めました。
- 原因を特定する指摘。 流量が予測と一致していてもチャンバー圧力が低い場合、レポートでは低いc*効率を原因として示します。燃料バルブの遅れによって点火が遅れる場合、その結果生じる温度の遅れは、別の問題として報告するのではなく、バルブの遅れに起因するものとして示します。
構成
src/groundline/
  synth.py           synthetic hot-fire data with ground-truth anomalies
  io.py              CSV / TDMS I/O
  session.py         Session and the evidence ledger
  tools.py           deterministic analysis tools (the only source of numbers)
  findings.py        findings and the grounding verifier
  semantics.py       semantic verification: units and role words against evidence fields
  agent.py           rule agent, LLM agent (OpenAI Responses / compatible endpoints / Anthropic)
  report.py          self-contained HTML report and report.json
  reproduce.py       evidence reproduction
  evaluate.py        benchmark and re-verification
  leaderboard.py     multi-model leaderboard
  verifier_bench.py  benchmark of the verifier itself (planted errors)
  hybrid.py          hybrid benchmark: known anomalies injected into real logs
  ingest.py          raw CSV logs to runs, from a (drafted) mapping
  mcp_server.py      MCP server
  config.py          .env loading
  cli.py             command line
ロードマップ
- より多くの実際の液体エンジン試験データを使って基準を検証し、しきい値を調整します。可能であれば、レッドライン、バルブ指令、シミュレーション予測を含めます(公開されている固体モーターと液体エンジンの例を1件ずつ収録しています)
- 偏差の原因帰属:シミュレーションと測定値が一致しない場合、考えられる原因(物理、メッシュ、境界条件、製造、センサー)と確認方法を列挙します
- 複数回の実行を比較し、傾向を分析します
- LLM エージェントのリーダーボードと検証器のベンチマーク
- より難しい合成シナリオ(複合異常、現実的なノイズスペクトル、センサードリフト)
- 試験レポートのテンプレート(Word/PDF エクスポート)
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。