Homestead Memory について
Homestead Memory は、エージェントの操作を検証可能な台帳に記録し、プレーンな Markdown のメモリーを管理するローカルファーストの Python ツールです。ハッシュチェーンで改ざんを検出し、LLM の判定ではなく機械的なルールでメモリーの整合性を確認します。
主な機能
- 01ツールの判断と結果をハッシュチェーンで記録
- 02記録の編集、削除、並べ替え、書き込み欠落の検出
- 03署名付きチェックポイントと第三者検証可能な証拠パック
- 04Markdown メモリーの整合性とポイズニングの検査
- 05メモリーの検索、質問、取り込み、蒸留
活用シーン
- 01エージェントのツール呼び出し履歴の検証
- 02第三者検証用の証拠パックの共有
- 03Markdown メモリーの劣化や根拠のない主張の確認
- 04Codex セッション記録のインポート
MCP 対応
README では MCP 対応環境で連携できると述べていますが、公開する MCP ツールやリソースの説明はありません。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
9掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| k | integer | いいえ | パッセージ数 |
| type | enum | いいえ | 質問の種類(デフォルト:自動分類)temporal-reasoning | knowledge-update | multi-session | default |
| query | string | はい |
詳細
homestead-memory



心を借りるのはやめましょう。
AI エージェントが実際に何をしたのかを記録する、改ざんの痕跡が残る記録をローカルファイルに保存します。 あなたを信用していない人でも検証できます。 改ざん防止ではなく、改ざんの痕跡が残る仕組みです。 防げることと防げないことをご覧ください。
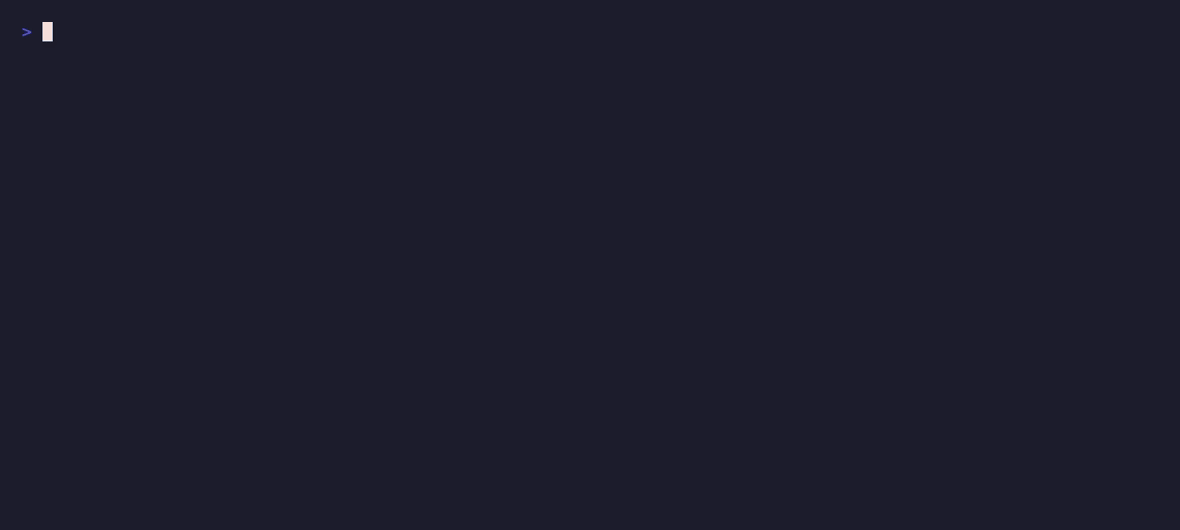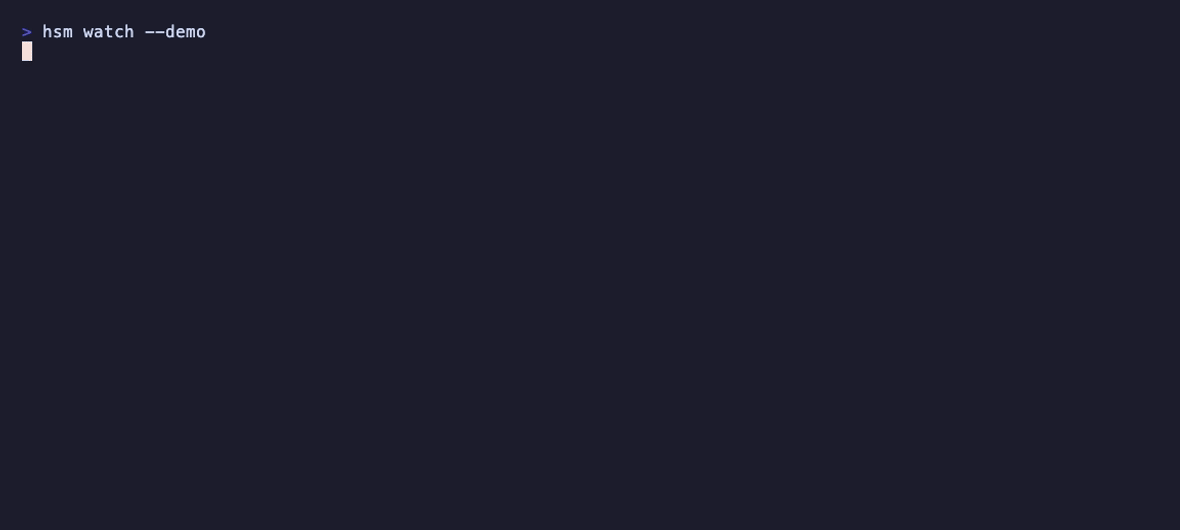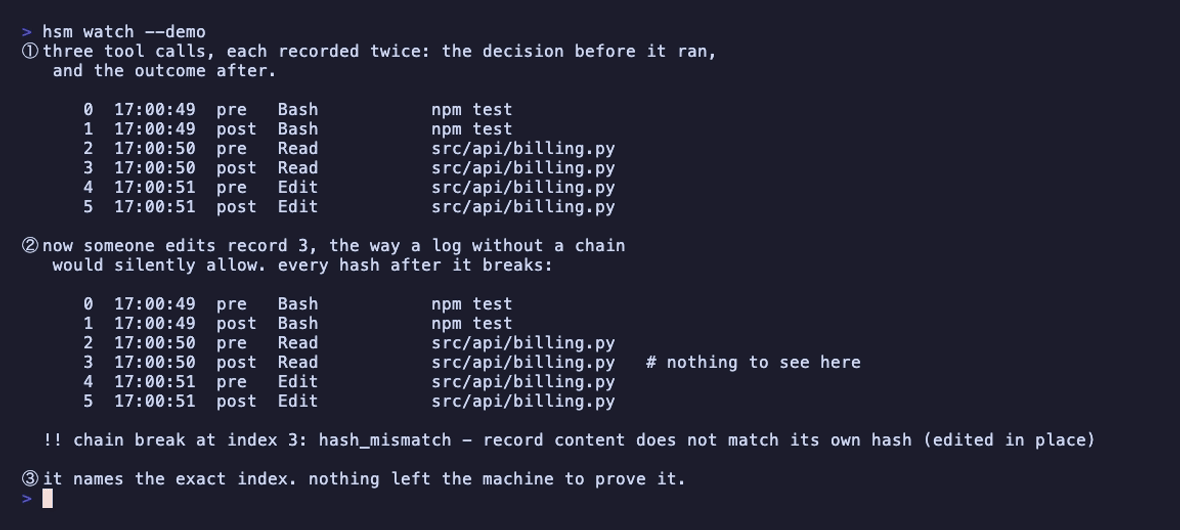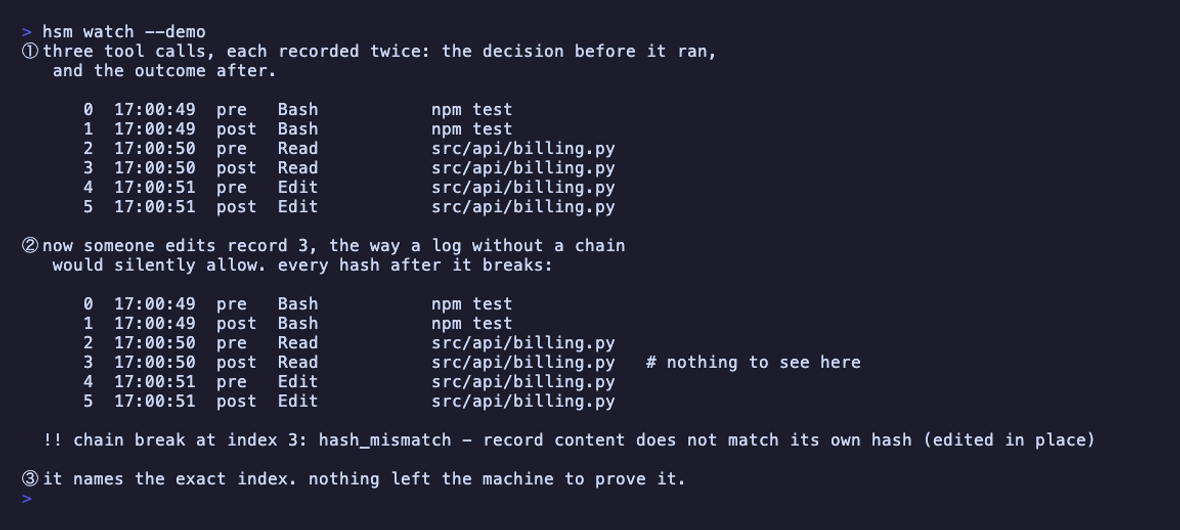
エージェントはひそかに失敗します。実行結果は成功と報告され、ツールは 200 を返すのに、依頼したことは実行されていません。たいてい、それに反する記録はありません。このツールは記録を残し、各エントリーをその前のエントリーとハッシュチェーンでつなぎます。偽造された記録を検知する様子を、今すぐご覧ください。
pip install homestead-memory      # Python 3.10+, macOS / Linux / Windows

hsm watch --demo
#      0  14:02:11  Bash    npm test
#      1  14:02:19  Read    src/api/billing.py
#      2  14:02:24  Edit    src/api/billing.py
#
# ② now someone edits record 1…
#   !! chain break at index 1: hash_mismatch
#      record content does not match its own hash (edited in place)
#   exit 1  ·  gate it in CI like a test
No matching distribution foundと表示されますか? macOS に標準搭載されているpython3は、今も Python 3.9 の場合があります。このツールには 3.10 以降が必要です。パッケージに問題があるわけではありません。新しい Python を使うか、インストール自体を省略してください。uvx --from homestead-memory hsm watch --demo(uv が適切な Python を取得してくれます。)
独自のエージェントを記録する
hsm hook --install     # prints a Claude Code hook; you paste it, nothing is edited for you
hsm watch              # what your agent did, in order
各記録は直前の記録とハッシュチェーンで結ばれているため、記録を編集、削除、並べ替えすると、その後のすべてのハッシュが無効になります。hsm watch は正確なインデックスで不整合を報告し、ゼロ以外の終了コードで終了します。署名を付けると、チェーンを一から完全に再構築した場合も検出できます。
両方のフェーズを記録するからこそ、これは単なるログではなく証拠になります。 フックはツールの実行前に判断を、実行後に結果をキャプチャします。結果だけを記録しても何が起きたかは示せますが、事前に何かが許可されていたことは示せません。 the IETF Agent Audit Trail draft が述べているように、「実行後にのみ記録される拒否は、その拒否が実際に適用された証拠にはなりません」。
hsm export --format aat # the same ledger as draft-sharif-agent-audit-trail-01
このドラフトはEU AI Act第12条に明示的に対応しており、既存の形式を置き換えるのではなく、ネイティブ形式と併せて出力するため、ディスク上の既存のものは何も変更されません。異なる点は明記しています。このドラフトではECDSA P-256を指定しており、AATエクスポートではこれを使用します。一方、ネイティブのEvidencePackはEd25519を維持するため、検証ツールは標準ライブラリのみで動作し、受信者は何もインストールする必要がありません。
AATエクスポートを利用する前に、次の点をご確認ください。 このドラフトは個人によるInternet-Draftであり、採択済みの標準ではありません。作業部会の後ろ盾はなく、通常どおり「IETFによる承認を受けていない」と明記されています。著者はさらに、改訂版00および01全体を対象とするIPR開示7558を提出し、「すべての実装者に対する、合理的かつ非差別的なライセンス(ロイヤリティ/料金が発生する可能性あり)」を宣言しています。料金が発生する可能性のあるRANDライセンスはロイヤリティフリーではなく、このパッケージはMITライセンスであり、特許ライセンスは付与されません。相互運用性には価値があるため、このエクスポートを提供しています。また、実装者が何を引き受けることになるのか、著者に明確化を求めています。回答が得られるまでは、--format aat は利便性のための機能として扱い、コンプライアンスプログラムの基盤にしないでください。ネイティブの台帳とEvidencePackにはこのような開示はなく、このREADMEの以降の説明が対象としているのはそれらです。
コストはツール呼び出しあたり約124msです(中央値。M3 Proで4KBのツール応答を使用して測定したp95は138ms)。0.4.0以降、フックは両方のフェーズを記録するため、呼び出しごとに新しいプロセスとして2回実行されます。ツールの実行前と後にそれぞれ1回ずつで、約61msと63msです。100回の呼び出しを行うセッションでは、実行全体にわたって約12秒かかります。そのほとんどは記録処理自体ではなく、Pythonインタープリターの起動とインポートにかかる時間です。ループ処理でこれが大きすぎる場合は、フックをインストールしないでください。実際に確認する前に判断できるよう、数値をここに示しています。
以前のリリースでは68msと記載していました。これはPostToolUseのみを記録していた時点では正しい数値でした。判断フェーズを記録することで、台帳は単なる観測記録ではなく、強制執行の証拠になりますが、そのために2つ目のプロセスが必要です。私たちに都合のよい数値ではなく、より大きな数値を示しているのは、他の数値をここに掲載しているのと同じ理由です。
これはプラットフォームではなく、ファイルです。 エージェントの可観測性ツールはこれよりはるかに多機能で、デプロイが必要です。セルフホスト可能なツールでは、本番環境で複数のサービスと約16 GBのRAMが最低限必要だと説明されています。これはpip installとフックを1行設定するだけで、JSONLファイルがディスク上に作成されます。用途が異なります。ダッシュボード、評価、スパン分析が必要なら、そうしたツールを使ってください。grepで検索でき、証明可能な記録が必要なら、これを使ってください。
シークレットらしい値は編集され、ペイロードは先頭200文字に切り詰められます。証拠を編集後も保持できるよう、元データ全体のSHA-256は保存されます。これはリスク軽減策であり、保証ではありません。パターンリストですべてを網羅することはできません。
hsm export --evidence # a pack anyone can verify with no install at all
このパックには、記録、署名、公開鍵、整合性レポート、および第三者が全体を読んで実行できる標準ライブラリ製の検証ツールが含まれています。署名は、どの鍵を期待すべきかを事前に把握している場合にのみ送信元を証明できることなど、証明できない事項も明記しています。
何を防ぎ、何を防げないのか
改ざん耐性であり、改ざん防止ではありません。この違いは重要なので、明確に説明します。
検知できること:
-
レコードがその場で編集された場合。ハッシュが一致しなくなり、
hsm watchがインデックスを示します。 -
レコードが削除または並べ替えられた場合。その後のハッシュがすべて不一致になります。
-
書き込みが気づかれないまま破棄された場合。破棄は記録され、報告されます。握りつぶされることはありません。
-
すべてのハッシュを再計算した人物が、チェーン全体を一から再構築した場合。ただし、
hsm checkpointを実行し、期待する署名者を固定し、その人物があなたの鍵を持っていない場合に限ります。この3つすべてが重要です。鍵を固定せずに検証したチェックポイントは、自己申告にすぎません。隣にある鍵に対して署名を検証するため、攻撃者自身の鍵で再署名された再構築チェーンも検証に通ります。鍵が固定されていない場合、hsm verify --deepはその旨を表示するようになりました。hsm verify --deep --signer <your pubkey> # or the checkpoint is self-asserted -
EvidencePack を誰かに渡した後に変更されたもの。相手はインストールも、こちらから何かを受け取ることもなく検証できます。
**チェックポイントが対象にするのは、その時点までの記録であり、それ以降ではありません。**最後のチェックポイント後に追加されたレコードは、正しくチェーンを再構築した偽造に置き換えても、検証に通る可能性があります。署名は、作成時に存在しなかったレコードを対象にできないためです。hsm verify は、対象外のレコードが何件あるかを知らせます。頻繁にチェックポイントを作成しないと、対象外の末尾部分が増えていきます。
検知できないこと:
- **署名鍵を持つ攻撃者。**鍵は台帳と同じマシン上の
~/.config/homestead-memory/ed25519_keyにあります。ファイルを書き換えられる人は、通常その鍵も読み取れるため、書き換えた内容に再署名して検証を通せます。これが脅威モデルに当てはまる場合は、hsm checkpoint --exportを実行し、攻撃者が管理できない場所にその行を公開して、後からhsm checkpoint --verifyで台帳を照合してください。ヘッドハッシュからレコードの内容は分からないため、公開しても情報は漏れません。 - **嘘をつくツール。**以下をご覧ください。
- フックをインストールしなかった場合など、そもそも台帳に記録されなかったもの。
hsm checkpoint            # sign the current head
hsm checkpoint --export   # one line to publish where an attacker cannot reach
hsm checkpoint --verify   # check this ledger against a line you published earlier
hsm watch は、チェックポイントが台帳のどこまでを対象としているかを報告し、チェックポイントを検証できなくなった場合は失敗します。最後のチェックポイント以降に追加されたものはすべて対象外なので、頻繁にチェックポイントを作成してください。
ハーネスが報告した内容を記録します
フックが受け取るのは、ツールが何をしたかについてハーネスが伝えた内容です。独立した観察ではありません。
ツールが何もしていないのに成功を報告した場合、まさにそれこそがこの仕組みで検知しようとしている問題です。主張の永続的な記録を残し、それを現実と照合できるためです。しかし、ツールが実際に「何を」したかについて虚偽の報告をすれば、台帳にはハッシュチェーンと署名が付いた虚偽が忠実に記録されます。
この記録が証明するのは、記録が改ざんされていないことです。ハーネスが真実を語るようになるわけではありません。
OpenTelemetry、署名付きログ、Langfuseだけではだめなのか
もっともな疑問ですが、これらはほとんどの場合、別の目的に使うものです。
- OpenTelemetry は、はるかに豊富なトレース機能と、この仕組みにはないエコシステムを提供します。改ざん耐性を備えるようには作られておらず、スパンは通常、マシンの外に出ます。必要なら両方を使ってください。OpenTelemetry は「何が起きたかを詳細に」、こちらは「編集されていないことを証明できるか」に答えます。
- ログファイルへの署名でも、目的の大部分は達成できます。すでに実施しているなら、これが不要な場合もあります。違いはレコード単位のチェーンにあり、ファイル全体を無効にするのではなく、変更された行を特定できること、そして受け取った人が何もインストールせずに検証できるパックを提供できることです。
- Langfuse、Braintrust、Phoenix は、ダッシュボード、評価、スパン分析を備えた可観測性プラットフォームです。こちらには決して備わらない機能です。また、デプロイも必要です。セルフホスト可能な製品では、いくつものサービスと約 16 GB の RAM を必要とする本番環境の最低要件が記載されています。こちらはフックの1行と JSONL ファイルだけです。ダッシュボードが必要なら、これらを使ってください。
これらにはなく、こちらが提供するのは、あなたを信頼することも、何かをインストールすることも、データをマシンの外に出すこともなく、第三者が検証できる記録を作成することです。
読み書きするメモリもあなたのものです
エージェントが読み書きするメモリも、同じツールが管理します。プレーンな Markdown なので、内容を読んだり、
git diff で確認したり、そのまま離れたりできます。LLM による判定ではなく機械的なチェックで、自身の劣化、改ざん、ポイズニングを検知し、
0~100 のスコアを付けて、ゼロ以外の終了コードを返します。そのため、テストスイートのように CI や cron のゲートとして使えます。
npm install -g @tobilu/[email protected]  # optional hybrid retrieval runtime

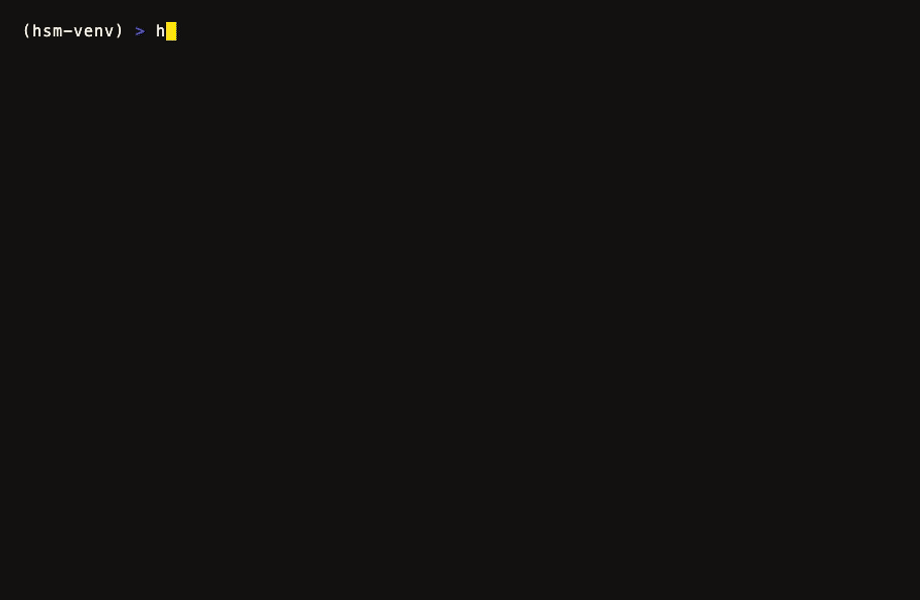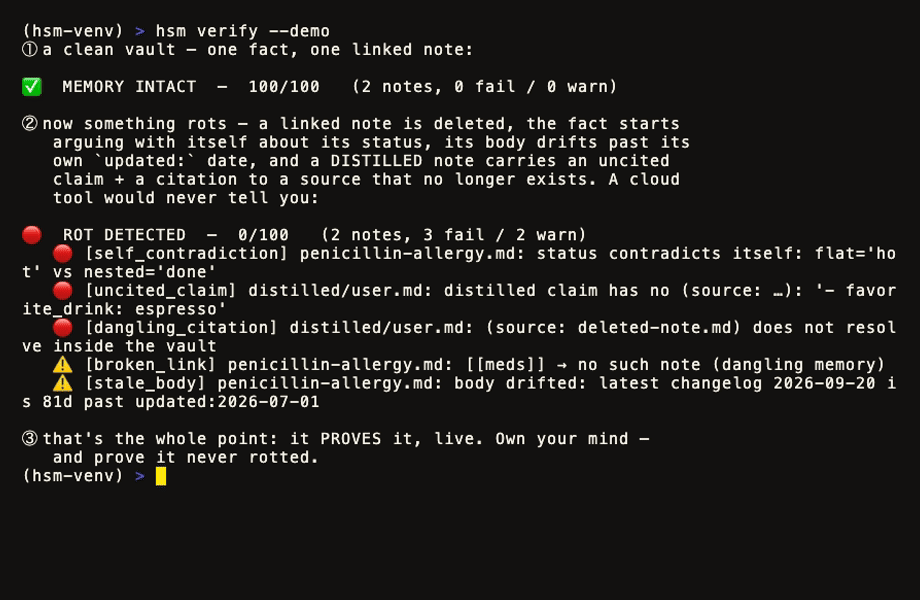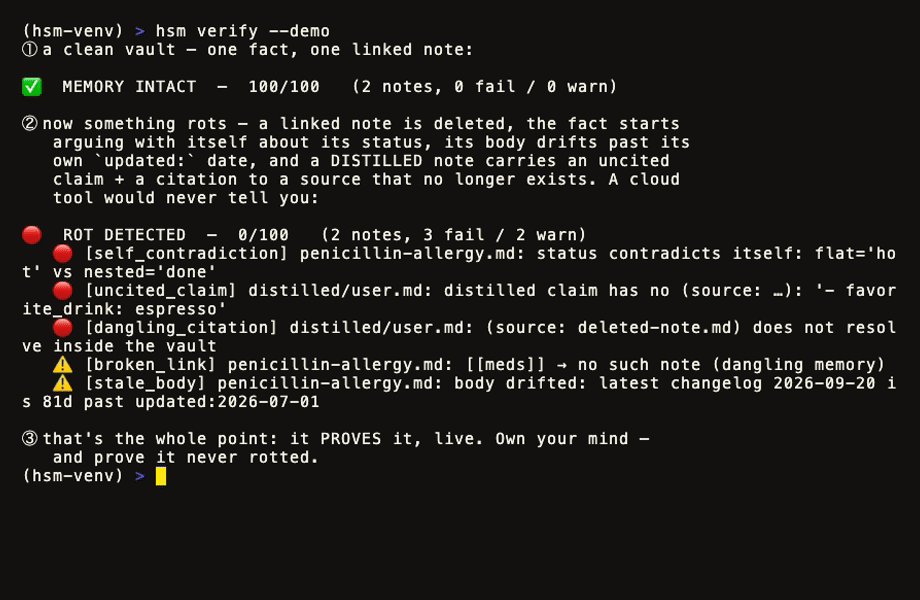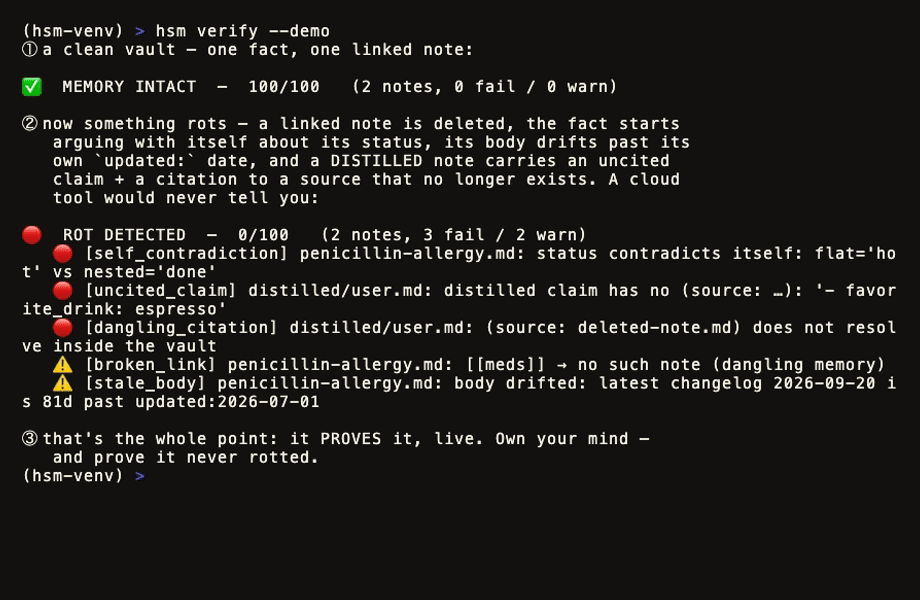
hsm verify --demo
# ① a clean vault           ✅  MEMORY INTACT — 100/100
# ② rot is planted…         🔴  ROT DETECTED —   0/100
#    🔴 [self_contradiction] the note argues with itself about its own status
#    🔴 [uncited_claim]      a distilled claim has no source citation
#    🔴 [dangling_citation]  a cited source no longer exists
#    ⚠️  [broken_link]        a reference points at a note that isn't there
このスコアリングはRotBenchに基づいており、自己申告ではなく数値を再現できるよう、オープンな仕様として公開されています。
現時点で、キャプチャに対応しているのは Claude Code のみです。 以下の MCP 連携は MCP が動作する場所ならどこでも使えますが、すべてのツール呼び出しを記録するフックは、Claude Code の PreToolUse と
PostToolUse を使用します。Cursor と Codex にはそれぞれ独自の仕組みが必要で、まだ実装されていません。
Codex はフックではなくインポートによって、0.4.1 からサポートされています。
hsm import-session --dry-run     # newest Codex session, writes nothing
hsm import-session -n 5          # the five most recent
計測時、Codex のツールフックは codex exec で発火しませんでしたが、ロールアウトファイルには入力、出力、ペアリング ID を含むすべての呼び出しが記録されます。インポートされた行には
meta.source=codex-rollout が付与され、hsm watch ではその横に (imported) と表示されます。後からファイルから読み取った行が、発生時に記録された行に見えてしまうことがないようにするためです。
Codex のフックはシェルのみですが、カバレッジは高い水準にあります。Codex には Read、Edit、Write 専用のツールがなく、シェル経由でファイルを操作するためです。60 セッション、848 件のツール呼び出しを計測したところ、その 94% が exec でした。このプロジェクトが当初誤っていた 2 つの見解を含む、推論の全容は docs/CODEX_CAPTURE.md に記載されています。
クイックスタート(60 秒)
hsm init   ./my-vault          # scaffold or adopt any markdown folder
hsm ingest ./my-vault          # index it (hybrid BM25+vector via qmd, optional)
hsm ask    "what did I decide about X?"
hsm ask    "what did I decide about X?" ./my-vault --budget 1200 --json
hsm search "what did I decide?" ./my-vault --retrieval balanced --json
hsm qmd start                  # persistent loopback runtime; no shared global index
hsm verify ./my-vault          # the integrity gate — the whole point
hsm distill ./my-vault         # optional: build the cited, verifiable fact layer
hsm history <note> --as-of 2026-06-01   # what was true THEN (temporal layer)
hsm serve                      # local HTTP API (auth'd, loopback-only)
Python エージェントでは、SDK を直接使用できます。
from homestead_memory import connect

memory = connect("~/my-vault", agent="my-agent")
memory.remember("user", "city", "Berlin")
memory.ask("what city is the user in?")
ローカル HTTP API のドキュメントは docs/openapi.yaml を参照してください。
検索プロファイル
Homestead は qmd を専用のキャッシュディレクトリと設定ディレクトリで使用します。qmd のグローバルインデックスに対して、メンテナンスを実行することはありません。構造化された結果にはすべて、engine、
retrieval_mode、degraded、reason、elapsed_ms、index_age_seconds が含まれます。
| プロファイル | 動作 | 用途 |
|---|---|---|
fast | BM25 のみ | 正確な名前、パス、低遅延の調査 |
balanced | 語彙検索 + ベクトル検索、LLM リランカーなし | フックと通常のエージェントコンテキスト |
quality | 語彙検索 + ベクトル検索 + リランカー | 明示的な高価値の調査クエリ |
検索経路は、永続的な qmd MCP、専用の qmd CLI、読み取り専用の直接スキャンの順です。hsm qmd doctor、hsm qmd refresh、hsm qmd status を実行すると、他の qmd コレクションには触れずに、ランタイムの状態を確認できます。
更新は明示的かつ差分的に行われます。.hsm/refresh-state.json の下にアトミックなチェックポイントを書き込み、外部の QMD ランタイムや正常でない QMD ランタイムを拒否し、QMD の処理中はライブハートビートを出力します。また、埋め込み処理の保留中ベクトルがゼロになった後にのみ、ボルトのフィンガープリントをコミットします。読み取りによって暗黙的に更新が実行されることはありません。QMD を利用できない場合、検索は読み取り専用スキャンにフォールバックし、劣化したエンジンと理由を報告します。
Linux/systemd のリファレンスデプロイについては、deploy/reference/ を参照してください。
ルーター配下のメモリ
ルーターは、homestead-memory が同じボルトを維持したまま、提供するモデルを切り替えられます。モデル名は単なるランタイム引数です。書き込み時には、agent フィールドに name@model として出所が記録されます。
from homestead_memory import connect
from homestead_memory.adapters.openai_compat import MemoryChat

memory = connect("~/my-vault")

def remember_reply(response, memory, agent):
    memory.remember(
        "conversation",
        "last_reply",
        response.choices[0].message.content,
        source="chat",
        agent=agent,
    )

chat = MemoryChat(openai_compatible_client, memory, remember_fn=remember_reply)
chat.create(model="claude-sonnet-4.7", messages=[{"role": "user", "content": "brief me"}])
chat.create(model="glm-4.7", messages=[{"role": "user", "content": "continue"}])

memory.history("conversation")  # agents include [email protected] and [email protected]
LiteLLM でも、事前呼び出し時に注入するヘルパーと成功時のロガーを使って、同じパターンを利用できます。
from homestead_memory import connect
from homestead_memory.adapters.litellm_memory import MemoryLogger, inject_memory

memory = connect("~/my-vault")
messages = inject_memory([{"role": "user", "content": "brief me"}], memory)

# LiteLLM callback registration style depends on your app setup.
logger = MemoryLogger(memory, agent_name="assistant")
MCP はすでにハーネスレベルのルーターより上位にあります。バックエンドモデルを切り替える claude-code-router 形式のセットアップでも、メモリはモデルの外部にあるため、homestead-memory は設定不要で動作し続けます。その後、history() と verify は、記録されたすべての事実を、書き込んだ正確な name@model に紐づけます。
統合
アダプターは、現行リリースで以下に示す公開フレームワークインターフェースを対象としており、それらの API の進化に伴ってバージョンの更新が必要になる場合があります。コアは標準ライブラリのみを使用します。利用するフレームワーク用の追加パッケージだけをインストールしてください。
ユニバーサルツールは、呼び出し可能オブジェクトまたは JSON Schema の関数ツールを登録できるあらゆるオーケストレーターで利用できます。
from homestead_memory import connect
from homestead_memory.adapters.tools import recall_tool, remember_tool, tool_specs, verify_tool

memory = connect("~/my-vault", agent="my-agent")
tools = [remember_tool(memory), recall_tool(memory), verify_tool(memory)]
specs = tool_specs(memory)  # name, description, parameters
LangGraph BaseStore(対象:langgraph>=0.2):
from homestead_memory import connect
from homestead_memory.adapters.langgraph_store import HomesteadStore

store = HomesteadStore(connect("~/my-vault", agent="langgraph"))
graph = builder.compile(checkpointer=checkpointer, store=store)
CrewAI のストレージ/メモリ(対象:crewai>=0.70、ストレージ形式の
save/search/reset):
from homestead_memory import connect
from homestead_memory.adapters.crewai_memory import HomesteadCrewAIStorage

storage = HomesteadCrewAIStorage(connect("~/my-vault", agent="crewai"))
storage.save("Researcher found the supplier shortlist", metadata={"task": "supplier_shortlist"})
AutoGen autogen_core の Memory プロトコル(対象:autogen-core>=0.4):
from autogen_core.memory import MemoryContent, MemoryMimeType
from homestead_memory import connect
from homestead_memory.adapters.autogen_memory import HomesteadAutoGenMemory

memory = HomesteadAutoGenMemory(connect("~/my-vault", agent="autogen"))
await memory.add(MemoryContent(content="Use metric units", mime_type=MemoryMimeType.TEXT))
OpenAI Agents SDK の Session プロトコルまたは関数ツール(対象:
openai-agents>=0.0.1):
from homestead_memory import connect
from homestead_memory.adapters.openai_agents import HomesteadSession, function_tools

memory = connect("~/my-vault", agent="openai-agents")
session = HomesteadSession(memory, session_id="user-123")
agent_tools = function_tools(memory)
Claude Code / Desktop / Cursor(MCP:メモリツール。アクションの記録には非対応):
claude mcp add homestead-memory -- hsm mcp ~/my-vault
# tools: memory_ask · memory_search · memory_verify · memory_history ·
#        memory_ingest · memory_distill
これが存在する理由
「デバイス上で動作する」ことは、今や当たり前です。どのメモリツールもローカルに保存します。検証するものはありません。 メモリはひそかに劣化します。メモが矛盾し、抽出された「事実」は出典を失い、本文は自身の変更履歴から乖離し、現在の値が古い値に埋もれてしまいます。気付くのは数週間後です。エージェントが、3月に事実でなくなったことを自信満々に伝えてきたときに。
劣化は、あくまで受動的な障害にすぎません。メモリは改ざん(書き込まれた後に事実が編集されること)や、汚染(信頼できない入力によって、実際には真実でなかった「メモリ」が挿入されること。これは2026年に名付けられた攻撃分類です)も受けます。homestead-memory は、これら3つすべてを機械的に検出します。保管庫に署名すれば、1バイトでも編集すると署名が無効になります。抽出された主張には、解決可能な出典の引用が必須です。引用がなければ破棄されます。想起ベンチマークは、モデルが記憶しているかを測定します。RotBench は、メモリを信頼できるかを測定します。 benchmarks/ROTBENCH.md を参照してください。
homestead-memory は、次の3つの約束を中心に構築されています。
- Markdown が主役です。 人が読めるファイルそのものがメモリです。インデックスと投影データは派生物であり、いつでも破棄できます。いつでも離れられます。これはあなたのフォルダーです。Google の Open Knowledge Format(
hsm export --format okf)に加え、Mem0/Zep とのインポート/エクスポートに対応しています。OKF に準拠し、署名と検証の機能を備えています。 - 信頼よりも検証を重視します。 整合性は機械的なチェックで算出される数値(RotBench、0~100)であり、LLM に自分自身の課題を採点させません。
benchmarks/ROTBENCH.mdを参照してください。 - 抽出を監査可能にします。 オプションの蒸留レイヤー(
docs/DISTILL_SPEC.md)は、コードで検証された逐語的な引用とともに、エンティティの事実を抽出します。主張には実在する出典の引用が必要です。引用がなければ破棄されます。矛盾がある場合は、変更履歴に行を追加します(update current_crm: "Salesforce" -> "HubSpot" (source: chat-042.md))。黙って上書きすることはありません。監査できる抽出だからこそ、信頼できます。
2つの陣営(本プロジェクトの位置づけ)
| 抽出陣営(Mem0、Zep) | 逐語陣営(MemPalace、本プロジェクト) | |
|---|---|---|
| 書き込みコスト | ターン/エピソードごとに LLM を呼び出す | $0(埋め込みのみ。蒸留は任意) |
| 情報 | 損失のある要約 | 損失のない生テキスト |
| 監査可能性 | 抽出器を信頼する | 引用がなければ破棄。機械的に検証 |
| 整合性スコア | — | RotBench を毎回実行後に公開 |
正直な数値(LongMemEval)
全 500 問の _s セット(妨害データを含む 48 セッションのヘイスタック)で測定し、公式のタイプ別判定方法でスコアを算出しました。リーダーには glm-5.2、独立した判定者には deepseek-v4-pro を使用しています。再現方法:benchmarks/README.md。
失敗も含む全実行履歴:benchmarks/RESULTS.md。
| 指標 | 値 |
|---|---|
| 検索再現率@k | 85%(証拠が top-k に提示された割合) |
| QA 精度(公式の方法論) | 52.8% |
| クエリあたりのコンテキストトークン数 | 約 5.2k |
| RotBench | 99.4 / 100(構築されたベンチマーク用ボルトの完全性であり、任意のボルトについての主張ではありません) |
RotBench の行は注意して読んでください。このスコアは、このハーネスが構築するボルトを評価するものです。つまり、今回の実行についての結果であり、あなたのボルトが 99 点を取る保証ではありません。実際の作業用ボルトで実行すると、通常はその点数にはならず、それがこのツールの正常な動作です。スコアの評価対象と対象外については、benchmarks/ROTBENCH.md を参照してください。
主張すること、しないこと:再現率は最高水準で、リーダーに依存しません。QA は正直に言って中程度です。公開されているシステムは、自社のハーネスではより高い数値を自己報告しています(Mem0 94.4%、Zep 独立評価 63.8%)。その代わりに、ハーネス、判定者、そしてすべての失敗した実験を公開しています。ここにある数値は、自分で実行できないハーネスから得たものではありません。
設計
- クロスプラットフォーム。 署名に使用する
cryptographyを除き、純粋な Python です。CI 対応 OS:ubuntu / macos / windows。パックに同梱されている検証ツールは標準ライブラリのみで動作するため、受信者は何もインストールせずにパックを検証できます。重要なのはこの点です。 - 明示的に縮退します。 qmd 2.1+ は任意です。MCP が失敗した場合は専用の CLI にフォールバックし、qmd が失敗した場合は読み取り専用スキャンにフォールバックします。機械可読な出力では、エンジンと理由を明示し、高速な経路が動作したように見せかけることはありません。
- デフォルトでローカル。 HTTP API はベアラー認証と DNS リバインディング保護を使用してループバックにバインドされ、MCP サーバーは stdio(クライアントが起動)で動作します。外部への通信はありません。
- 時間軸対応。 変更履歴の行を検索できます:
hsm history note --as-of DATE。
ステータス
v0.5、公開開発中です。ロードマップ:ROADMAP.md。ベンチマークを打ち破るには:benchmarks/ROTBENCH.md。敵対的なフィクスチャもマージされます。
MIT © Kinetic Labs Inc. · FuckBigTech / HOMESTEAD プロジェクト。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。