Graph-MIND について
Graph-MIND(Turnbookとして配布)は、複数のAIエージェントを使う人向けのローカル長期記憶システムです。会話をモデル呼び出しなしで逐語保存し、アプリやセッションをまたいで関連する発言を検索できます。
主な機能
- 01会話の逐語保存
- 02エージェントやアプリ間の記憶共有
- 03単語・意味・時刻によるローカル検索
- 04秘密情報のマスキングと削除
- 05記憶のエクスポートとインポート
活用シーン
- 01別のエージェントセッションでの決定を確認
- 02過去のコード変更や個人的な情報を検索
- 03複数のPC間でプロジェクトの記憶を共有
- 04特定のプロジェクトの会話をエクスポート
MCP 対応
MCP サーバーとして、MCP クライアントに記憶ツールを提供します。インストーラーは対応する AI アプリにも接続し、会話を自動保存できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
6掲載時のツール一覧 · 4 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| tags | any | いいえ | |
| scope | string | いいえ | |
| title | any | いいえ | |
| content | string | はい | |
| entities | any | いいえ | |
| modality | any | いいえ | |
| memory_id | any | いいえ | |
| retention | any | いいえ | |
| attributes | any | いいえ | |
| confidence | any | いいえ | |
| importance | any | いいえ | |
| source_ref | string | いいえ | |
| memory_type | string | いいえ | |
| source_type | string | いいえ | |
| effective_at | any | いいえ | |
| memory_class | any | いいえ | |
| related_memory_ids | any | いいえ | |
| supersedes_memory_id | any | いいえ |
詳細
Turnbook
セッションが終わると、あなたの AI はすべてを忘れてしまいます。これは覚えていて、記憶の保存に LLM を呼び出すこともありません。
LongMemEval で 88.8%。記憶の保存にモデルのトークンを一切消費しません。自分の PC で動作します。




月曜日にあるエージェントと何かを決めます。水曜日に別のエージェントに尋ねても、覚えています。
英語 · 한국어
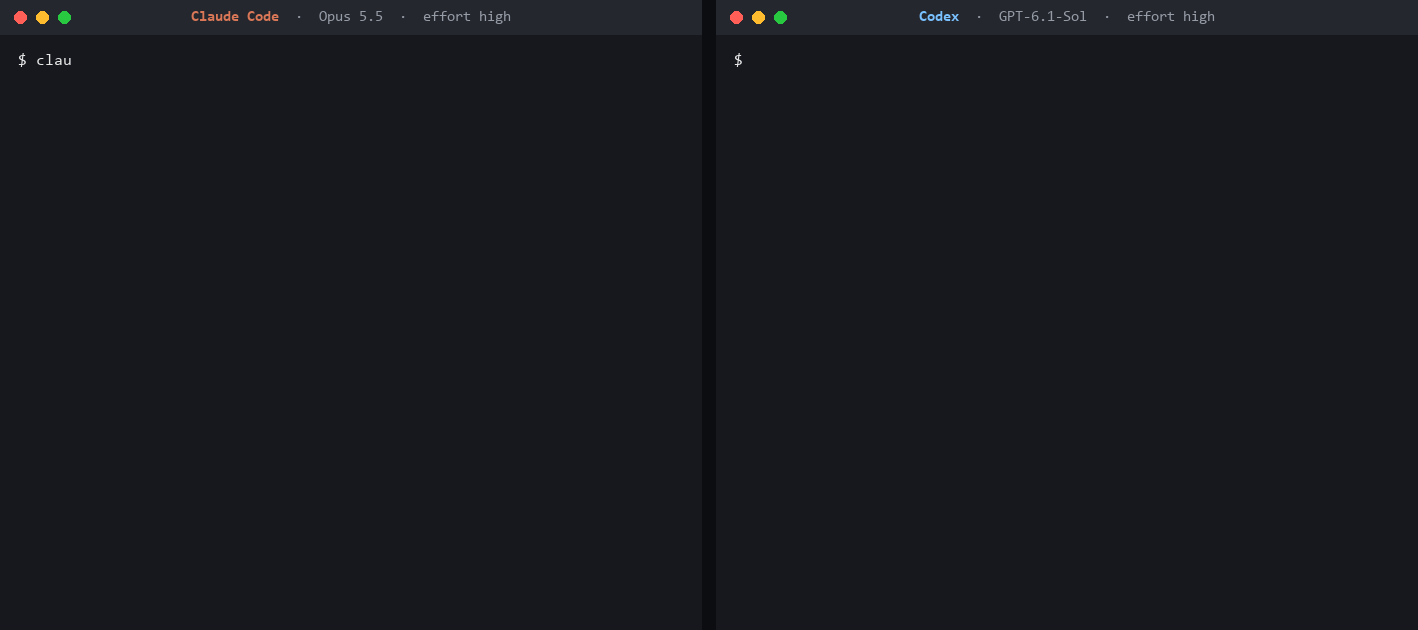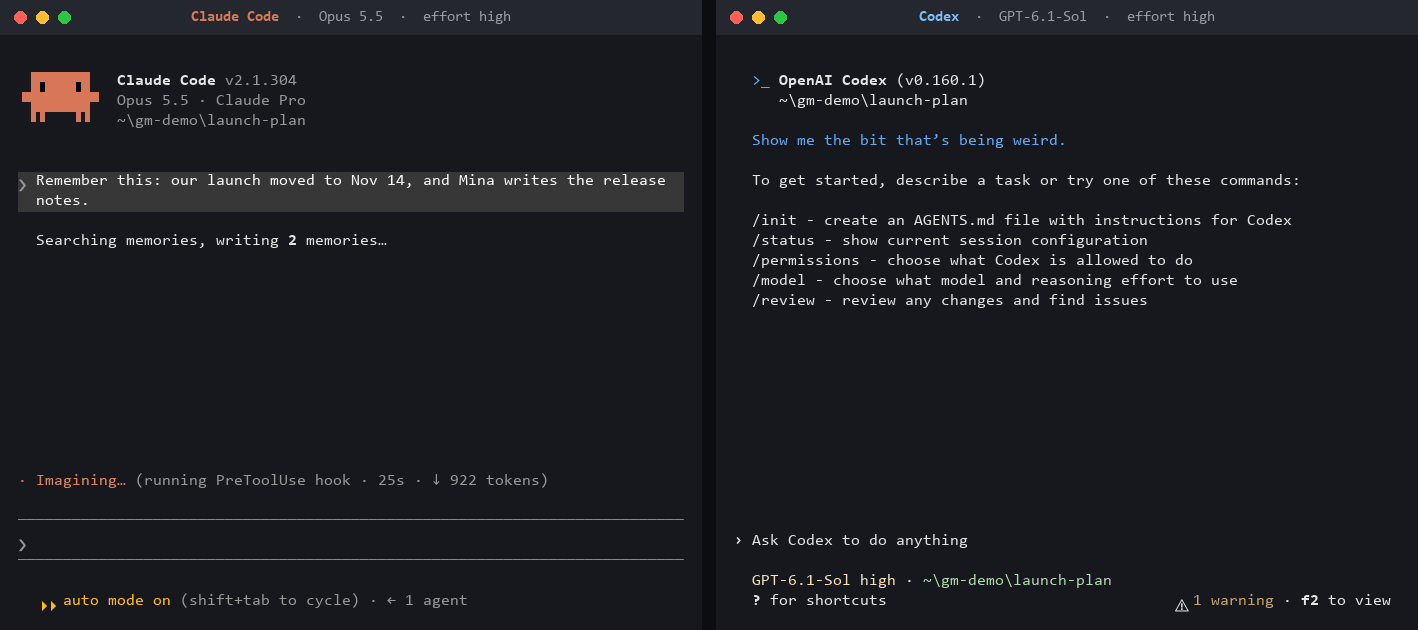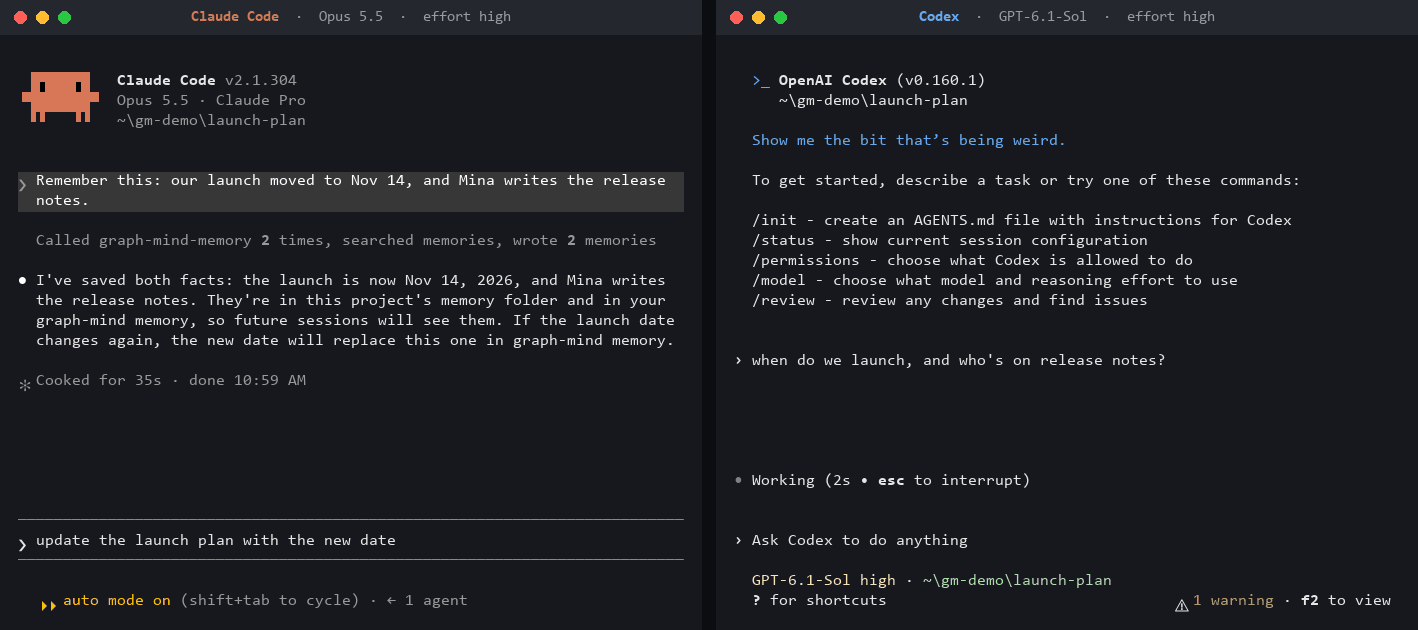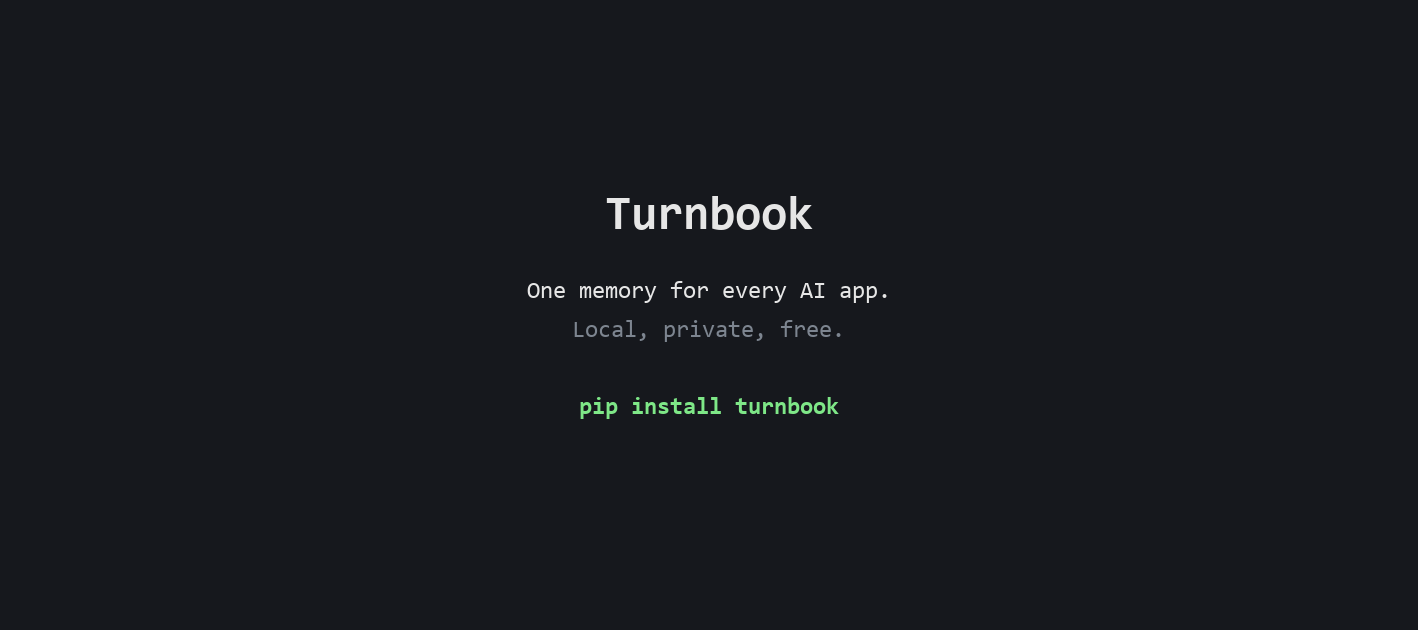
1 台の PC でのライブ録画:Claude Code(Opus 5.5、effort high)と Codex(GPT-6.1-Sol、effort high)が、同じ Turnbook の記憶を共有しています。モデルの思考時間は早送りされています。
インストール
Windows: Turnbook-Setup.cmd をダウンロードして ダブルクリックするか、PowerShell で次を実行します。
irm https://raw.githubusercontent.com/goyohan0611-png/turnbook/main/scripts/install.ps1 | iex
macOS / Linux:
curl -LsSf https://raw.githubusercontent.com/goyohan0611-png/turnbook/main/scripts/install.sh | sh
Python は不要で、ほかに設定することもありません。その後、AI アプリを再起動してください。すでに Python をお使いの場合は、
pip install turnbook && turnbook-install を実行してください。詳細:docs/install.md。
MCP クライアントを手動で接続する
pip install turnbook の実行後:
{
  "mcpServers": {
    "turnbook": {
      "command": "python",
      "args": ["-m", "graph_mind.mcp_server"]
    }
  }
}
Claude Code:claude mcp add turnbook -- python -m graph_mind.mcp_server。これでツールのみが使えるようになります。turnbook-install を実行すると、すべての会話も自動的に保存されます。
試してみる
しばらくいつもどおり作業してから、新しいセッション、別のアプリ、または別のモデルを開いて、次のように尋ねてみてください。
- 「昨日はどこまで進みましたか?」
- 「請求サービスにはどのデータベースを選びましたか?その理由は?」
- 「先週、認証ミドルウェアにどんな変更を加えましたか?」
- 「私の犬の名前は何ですか?」(何気なく一度だけ話した事実でも答えられます)
手動でタグ付けしたり保存したりする必要はありません。すべてのやり取りはすでに保存されており、エージェントが質問に答えるために必要なものだけを取り出します。
できること
- ターミナル内のすべてのエージェントが共有する、ひとつの記憶。 どのコーディングエージェントやモデルを使っていても、すべてのエージェントが同じ記憶を読み書きします。エージェントやモデルを切り替えても、記憶はそのままです。
- オーケストレーション向けに設計されています。 オーケストレーターが複数のエージェントを同時に実行すると、それぞれが作業中に同じ記憶へ書き込むため、あるエージェントの決定を次のエージェントが引き継げます。各記憶には、どのアプリとセッションから作成されたかが記録されます。
- 会話を一言一句そのまま記憶し、保存先はご自身の PC です。保存はデータベースへの書き込みであり、モデルの呼び出しもトークンも必要ありません。過去の情報に基づく質問では、回答に必要な数千トークン分の情報をエージェントに返します。韓国語と英語に対応しています。
- PC 間で共有できるひとつの記憶。
turnbook folder shareを実行し、もう一方の PC でturnbook folder <code>を実行します(コマンドは AI が提示します。記憶が勝手に移動することはないため、ウェブページから移動させられることもありません)。社内ネットワークまたは Tailscale を使い、TLS 経由で、PC から送信される前にすべての行を暗号化します。 - 記憶をファイルにして他の人に渡せます。
turnbook export FILEは記憶全体を書き出します。--project FOLDERを指定すると、そのフォルダー内で行われた会話だけを書き出します。受け取った人はturnbook import FILEを実行します。 - 記憶はあなたのものです。 アカウントも、独自のクラウドも、テレメトリーもありません。保存前に秘密情報をマスキングし、「先ほど入力したパスワードを削除して」と指示すれば、すべての場所から削除します。docs/privacy.md
- 必要ならチームでも使えます。 プロジェクトの決定事項や進捗をチームメイトの AI と共有できます。個人の記憶は共有されません。ファイルは Slack と GitHub に保存されます。docs/teams.md
対応アプリ
インストーラーが以下を検出して接続します。新しいアプリをインストールした後は、インストーラーを再度実行してください。
| アプリ | 保存される会話 | 方法 |
|---|---|---|
| Claude Code | すべてのターン | トランスクリプトを読み取ります |
| Codex CLI | すべてのターン | トランスクリプトを読み取ります |
| Cursor | すべてのターン | トランスクリプトを読み取ります |
| Copilot CLI | すべてのターン | トランスクリプトを読み取ります |
| Claude Desktop (Cowork) | すべてのターン | セッションファイルを読み取ります |
| Gemini CLI | すべてのターン | フックを使用します。また、回答の前に関連する記憶を追加します |
| OpenCode | すべてのターン | プラグインを使用します。また、モデルを問わず、回答の前に関連する記憶を追加します |
| Claude Desktop chat、Windsurf、VS Code Copilot、Cline、LM Studio | モデルが保存する内容 | MCP ツール |
その他の MCP クライアントもツール経由で利用できます。上記の手動設定をご覧ください。
仕組み
flowchart LR
    A["Claude Code · Codex · Cursor<br/>Gemini CLI · OpenCode · ..."] -- "transcripts, hooks, plugin" --> C["capture service<br/>(runs in the background)"]
    C -- "verbatim turns,<br/>secrets masked" --> S[("your memory<br/>on this PC")]
    S --> I["local search<br/>words + meaning + time"]
    A -- "a question that needs the past" --> I
    I -- "the few turns that answer it<br/>(~3k tokens)" --> A
- 保存にコストはかかりません。 ターンは発言されたままの形で保存されます。書き込み時にモデルが要約や抽出を行うことはないため、保存時に情報が失われたり作り出されたりすることはなく、トークンも消費しません。
- 検索は PC 上で実行されます。 単語検索、多言語埋め込みモデル(mpnet、int8。ONNX、GPU 不要)、発言された時刻を組み合わせ、履歴全体のダンプではなく、元のターンを含む短い情報をエージェントに返します。
- 考えるのは、すでにお使いのモデルです。 Turnbook がモデルに根拠となる情報を渡し、モデルが回答します。モデルの性能が向上すれば、記憶を変更しなくても回答の質が向上します。
動作しますか?
LongMemEval は、長期チャットメモリの公開ベンチマークです。過去約50セッションにわたる500問で評価します。以下のすべてのシステムで、回答モデル(gpt-5-mini)、プロンプト、公式の gpt-4o 判定モデルは同じで、異なるのはメモリだけです。
| 正解率 | メモリの保存に使ったモデルのトークン数 | 回答モデルが読むテキスト | |
|---|---|---|---|
| Turnbook | 88.8%(全500問) | 0 | 3.4k トークン |
| agentmemory | 80.4%(同じ499問) | — | 約16.5k トークン |
| MemPalace 3.10.0 | 57.5%(40問) | 0 | — |
| Mem0 2.2.1(オープンソース) | 52.5%(40問) | 1問あたり約640,000 | — |
agentmemory の499問では、Turnbook は89.0%でした。40問では85.0%でした。agentmemory 独自の指標による検索のみの評価(検索結果の上位5件に回答を含むセッションがある場合):Turnbook は98.5%、agentmemory は95.2%でした。 これらの実行では0.9.9以前の埋め込みモデルを使用しました。100問のサンプルでは、現在のモデルは同じ頻度以上で回答を含むセッションを見つけます(上位5件で99.0%対97.9%)。
メモリが増えた場合
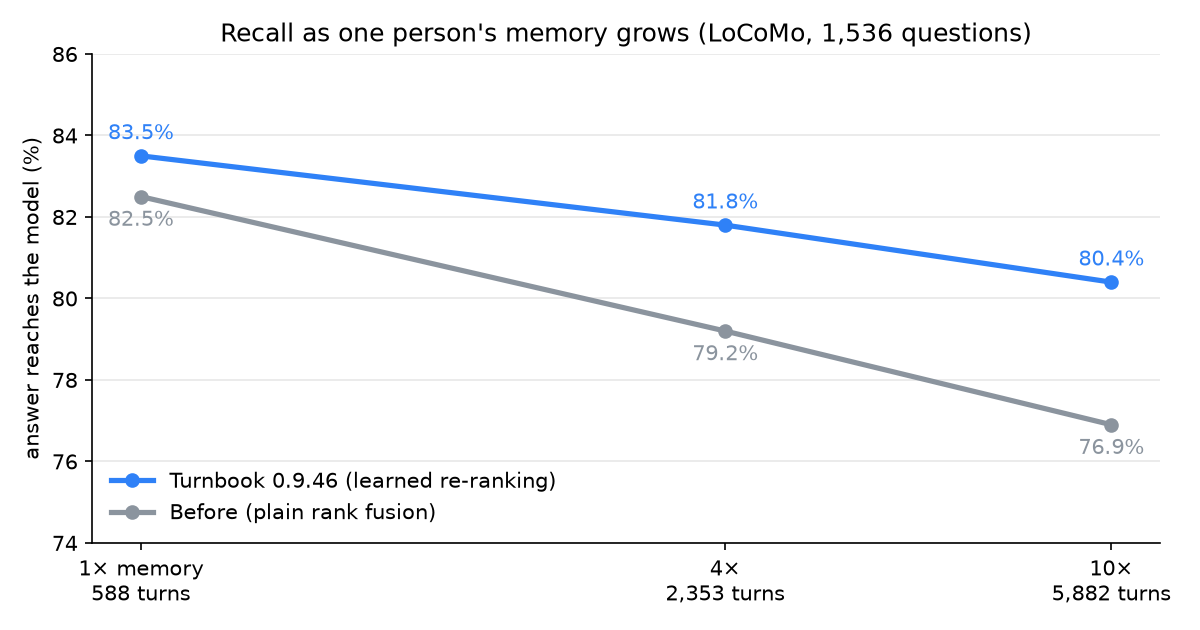
メモリが増えるにつれて、想定した会話と似た過去の会話が増えるため、想起は難しくなります。0.9.46以降のTurnbookは、固定の重み付けではなく、学習した小さなスコアを使って検索結果を並べ替えます。LoCoMo(1,536問)で、各人のメモリに他の会話を保存して10倍に増やしたところ、回答がモデルに届いた質問の割合は、以前は5.6ポイント低下し(82.5% → 76.9%)、現在は3.1ポイント低下しました(83.5% → 80.4%)。各会話のスコアは、他の9人から学習した重みで算出しました。追加された会話は他の人のものであるため、同じ人の履歴よりも区別しやすい可能性があります。LongMemEvalでは、同じ変更により、モデルに届いた回答の割合が97.5%から98.3%に上がりました。
すべての質問、回答、判定は research/runs/ にあります。手法、失敗例、再実行の方法については、docs/benchmarks.md をご覧ください。
FAQ
PCの動作が遅くなりますか? 新しいデータがないとき、バックグラウンドサービスが使用するのはCPUコア1つの約2%と、メモリ約650 MBです。その大部分を検索モデルが占めます。メモリ検索は約20 ms(GitHub ランナーでの95パーセンタイルは41 ms)かかります。アプリの起動後、最初の検索には約1.3秒かかります。検索モデルが変わるアップデートの後は、メモリを一度再読み込みします。速度は通常の半分で、11,000件の場合は約1時間かかります。
費用はかかりますか? かかりません。API キーも、Turnbook 自身によるモデル呼び出しも不要です。過去の情報が必要な質問では、AI アプリが約3kトークンのパケットを読み込みます。
PCの外にデータが送信されますか? メモリを自分の他のPCやチームと共有しない限り、送信されません。テレメトリーもありません。シークレット(API キー、パスワード、カード番号など)は保存前にマスクされます。
CLAUDE.md やアプリ内蔵のメモリとの違いは何ですか? これらはモデルが書いたメモをアプリごとに保持します。Turnbook は、会話の各ターンを発言どおりに保持し、PC上のすべてのアプリとモデル間で共有します。
韓国語に対応していますか? はい。韓国語と英語の会話、およびどちらの言語での質問にも対応しています。英語だけで話された内容について韓国語で質問した場合、ほとんどの場合は見つかりますが、必ずとは限りません。
削除するにはどうすればよいですか? turnbook-uninstall を実行すると、すべてのアプリとの接続を解除し、サービスを停止します。--purge を追加しない限り、メモリは ~/.graph-mind に残ります。
メモ
ベータ版です。 Windowsで毎日使用しています。macOSとLinuxではCIですべてのテストに合格していますが、まだ日常的な使用実績はありません。
その他
MCP ツール · メモリを3Dで確認
(turnbook-view) · 変更履歴 · セキュリティ ·
開発:pip install -r requirements.txtを実行し、その後python -m unittest discover -s testsを実行します。
コントリビューションを歓迎します。ライセンス:Apache-2.0。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。