seo-audit-console について
SEO Audit Console は、Claude を使う SEO コンサルタントや社内マーケター向けの MCP サーバーです。Google Search Console のデータとサイトのクロール結果を結合し、流入への影響を基準に問題を順位付けして修正案を示します。
主な機能
- 01Search Console データとクロール結果の統合
- 02流入機会に基づく監査項目の順位付け
- 03技術 SEO の修正案の生成
- 04ダッシュボード表示と HTML レポート出力
- 05任意の競合・被リンクデータの追加
活用シーン
- 01想定クリック数に基づく技術課題の優先付け
- 02表示回数に対してクリックが少ないページの調査
- 03顧客向け SEO 監査レポートの作成
- 04競合比較と被リンク調査
MCP 対応
Claude Desktop または Claude Code に接続する MCP サーバーとして、SEO 監査、クロール、Search Console、ダッシュボード、レポートの機能をツールとして公開します。DataForSEO と Majestic の機能はオプションです。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
npx -y @houtini/seo-audit-consoleGOOGLE_APPLICATION_CREDENTIALSシークレットPath to the Google service-account JSON key with Search Console access.SAC_DATA_DIRDirectory for per-property SQLite databases and reports. Defaults to ~/Documents/seo-audit-console.DATAFORSEO_USERNAMEDataForSEO API username (optional, enables SERP/keyword/domain/market/recon checks).DATAFORSEO_PASSWORDシークレットDataForSEO API password (optional).DATAFORSEO_CACHE_DAYSTTL for the DataForSEO response cache, in days. Default 20.MAJESTIC_API_KEYシークレットMajestic API key (optional). Enriches link_intersect with Trust Flow + Topical Trust Flow and re-sorts prospects by real authority.MAJESTIC_CACHE_DAYSTTL for the Majestic response cache, in days. Default 30.CRUX_API_KEYシークレットChrome UX Report API key (optional, free Google Cloud key). Switches on sync_crux: real-user Core Web Vitals (LCP, INP, CLS) and the crux-field-* checks.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
SEO Console - Claude 向けのテクニカル/コンテンツ/リサーチ/機会分析 SEO 監査 MCP サーバー
自社の Search Console データとサイトのライブクロールを基に、Claude 内で実行できる、対話型のテクニカル SEO 監査です。



20年間で私が受け取ってきたテクニカル SEO 監査のほとんどは、クローラーの見解にすぎません。そして、クローラーが把握できるのは全体の半分だけです。サイトに何が書かれているかはわかります。しかし、Googleがそれに対して何をしたのか、つまり、どの検索クエリでランクインし、どのページがインプレッションを獲得し、クリックがどこに集まったのかはわかりません。
このツールは、もう半分の情報を加えます。SEO Audit Console は Claude 内で動作し、Google Search Console の履歴を取得してサイトを適切にクロールし、両方の情報を結び付けます。そのため、すべての指摘に、対処した場合に得られる可能性のあるトラフィックが示されます。111項目のチェックを、チェック内容がどれほど深刻に聞こえるかではなく、修正によって取り戻せるクリック数を基準に順位付けし、301ルールやJSON-LD、内部リンクなどの修正案も作成します。基本的な監査に必要なのは自社の Search Console だけです。競合分析やリンク構築に関する質問が出てきたら、後から DataForSEO と Majestic を追加できます。データはお使いのマシンから外部に出ません。
Houtini が開発しました。 私たちは、データ収集、クロール、データの統合、チェックといったデジタルマーケティングの面倒な作業を自動化し、チームが人間の力を必要とする分析、戦略、クライアント業務に集中できるようにしています。このプラグインは、その考え方をテクニカル SEO 監査に応用したものです。
MCP を初めて使う方、または始め方がわからない方へ。 **はじめにガイド**では、まっさらなマシン(Node も Git もなく、サービスアカウントを聞いたこともない状態)から初めての監査までをご案内します。誰もが見落としがちな手順も含め、各ステップをスクリーンショット付きで説明しています。正直なところ、10分で完了します。
you  › run an SEO audit on mysite.com

     ⣾ search console  1.8M rows synced (19s - incremental)
     ⣾ crawl           868 pages · HTTP/2 · robots-polite · 8 parallel
     ⣾ link graph      internal PageRank · click depth · in-degree
     ✓ 143 checks · 220 findings · ranked by expected clicks per dev-hour

     #1  CTR far below position-expected     /pricing                   XL
     #2  Page losing clicks (trend)          site-wide                  XL
     #3  Keyword cannibalisation             "project management app"   L
     #4  Robots-blocked page earning traffic /category/guides           L

you  › generate the fix for #1 ▍
クイックスタート
npm で公開されているため、クローンやビルドは不要です。Node.js 20 以降と、ご自身が所有する Search Console プロパティが必要です。
Claude Desktop - claude_desktop_config.json にこれを追加してから、Claude を再起動してください。
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "npx",
      "args": ["-y", "@houtini/seo-audit-console"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "DATAFORSEO_USERNAME": "",
        "DATAFORSEO_PASSWORD": "",
        "MAJESTIC_API_KEY": "",
        "CRUX_API_KEY": ""
      }
    }
  }
}
最初の行は必須です。それ以外は任意です。キーを引用符の間に貼り付けるか、空のままにしてティアをオフにしてください。DataForSEO と Majestic は有料ティアです。CRUX_API_KEY は、Chrome UX Report API に制限した無料の Google API キーで利用する Core Web Vitals のフィールドです。空の場合はオフになります。your-key-here、<your key>、changeme などのテンプレート文字列も空として扱われ、サーバーのログにその旨が 1 行で表示されます(例:MAJESTIC_API_KEY looks like a placeholder; Majestic tier disabled.)。そのため、オンになると思っていたティアがオフのままの場合は、ログを確認してください。
Claude Code - コマンド 1 つで設定できます(利用する場合は、同じ方法で --env DATAFORSEO_USERNAME=… なども追加してください)。
claude mcp add seo-audit-console --env GOOGLE_APPLICATION_CREDENTIALS=C:/path/to/service-account.json -- npx -y @houtini/seo-audit-console
GOOGLE_APPLICATION_CREDENTIALS だけでコア監査全体を実行できます。見落としやすい手順があります。JSON キーは Google Cloud サービスアカウントに属しており、ツールがデータを参照できるように、そのアカウントのメールアドレスを Search Console のプロパティのユーザーとして追加する必要があります。Getting started では、スクリーンショットを交えて手順を説明しています。また、Claude Desktop 拡張機能をワンクリックでインストールする方法や、ソースからビルドする方法も紹介しています。
その後、Claude に 「プロパティを一覧表示して」、「mysite.com を更新して」、「SEO 監査を実行して」 などと尋ねてください。
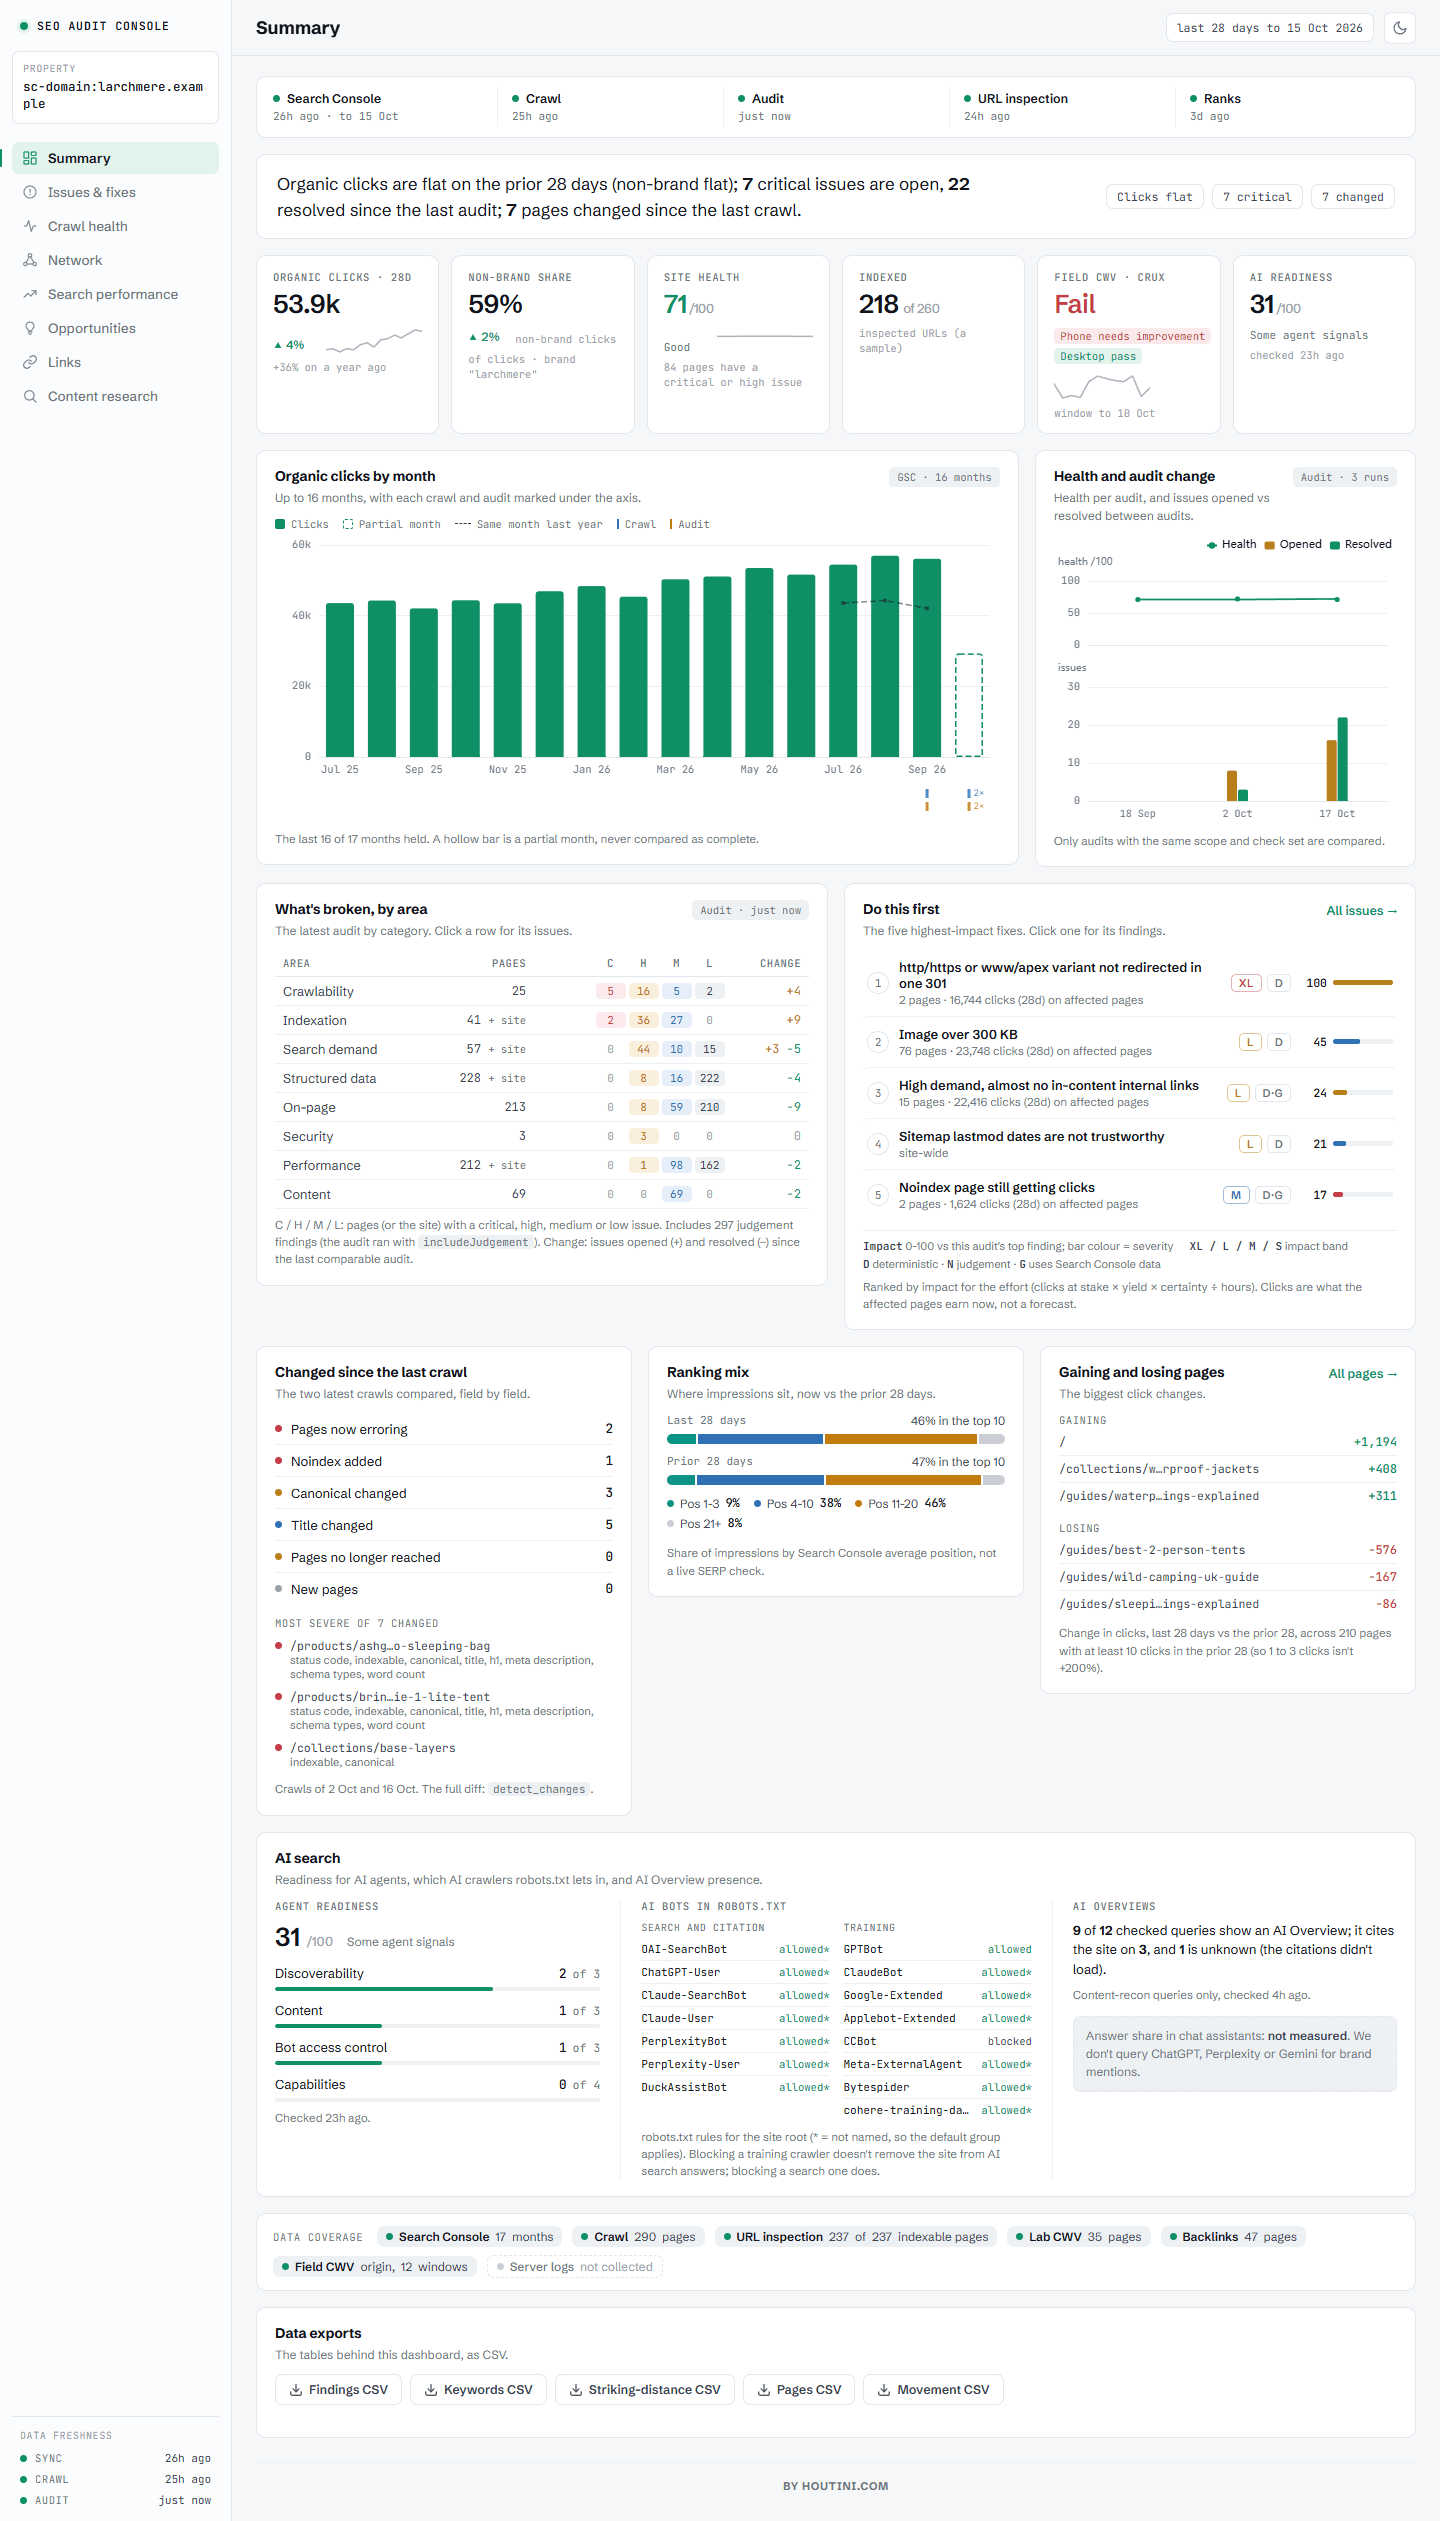
ダッシュボードを開く
プロパティを更新または監査すると、3 つの方法で結果を確認できます。
| 目的 | Claude への依頼 | 表示されるもの |
|---|---|---|
| チャット内で手早く確認する | 「mysite.com のダッシュボードを表示して」 | 会話内に描画されるダッシュボード(get_dashboard) |
| ブラウザーで完全なダッシュボードを表示する | 「mysite.com のダッシュボードを開いて」 | http://127.0.0.1:53817/dashboard?siteUrl=… のようなリンク(open_dashboard)。クリックしてください。ローカルデータベースをリアルタイムで読み込むため、更新のたびに再読み込みしてください |
| クライアントに送るものを作成する | 「mysite.com のレポートをエクスポートして」 | 単体で使える HTML ファイル 1 つ(export_report) |
更新、クロール、同期、監査が完了すると、ダッシュボードが更新されたこととブラウザーのリンクが返信に含まれるため、依頼しなくても確認できることがよくあります。リンクはご利用のマシン上でのみ有効で(127.0.0.1 でのみ応答します)、ポートはサーバーを起動するたびに変わるため、最新の返信にあるリンクを使用してください。ダークモードにするには &theme=dark を、スクリーンショット用に数値をぼかすには &redact=1 を追加してください。
Docker または Docker MCP gateway で実行していますか? ブラウザーのリンクはコンテナー内のポートを指すため、ブラウザーからアクセスできません。同じデータボリュームを使って、ダッシュボードを固定ポートの独立した小さなコンテナーとして実行してください。
docker run -d --name seo-audit-dashboard --restart unless-stopped -p 127.0.0.1:8788:8788 -e SAC_DATA_DIR=/data -e SAC_DASHBOARD_BIND=0.0.0.0 -e SAC_DASHBOARD_PORT=8788 -v seo-audit-data:/data node:22-slim npx -y -p @houtini/seo-audit-console seo-audit-dashboard
次に http://127.0.0.1:8788/dashboard?siteUrl=sc-domain:mysite.com を開いてください。MCP サーバーが書き込み先としているボリューム名を使用してください。Windows の Git Bash では、/data が Windows パスに書き換えられないよう、コマンドの先頭に MSYS_NO_PATHCONV=1 を付けてください。詳しくは dashboard.md をご覧ください。
マニュアル
この README では、概要とクイックスタートを紹介します。詳しい説明はマニュアルをご覧ください。
| ページ | 内容 |
|---|---|
| はじめに | インストール、GSC サービスアカウントの設定(そして誰もが見落とす手順)、Claude Desktop と Claude Code の設定、初めての監査、トラブルシューティング |
| ツールリファレンス | すべてのツールの機能、入力、結合、プロンプトの例 |
| チェックレジストリ | 143 件すべてのチェックと、それぞれの検出内容、D/N ラベル、修正方法 |
| 構成 | 結合キー、粒度、データを横断して独自の質問をするための 14 個のレシピ |
| 競合分析 | 競合分析のワークフロー、DataForSEO の設定、Majestic Trust Flow ティアを使ったリンクの重複分析、実際の費用 |
| SEO Recon | ページの順位が下がっている理由:ライブ SERP と AI Overview の引用判定、競合との差分、追跡可能なタスク台帳 |
| DataForSEO 関数 | DataForSEO を利用するすべてのツールを API モジュール別に分類:Keywords、SERP、Labs、Backlinks、OnPage。それぞれのエンドポイントと費用 |
| Majestic 関数 | オプションの Trust Flow ティア:追加される機能と、link_intersect および pull_backlinks での利用方法 |
| ポートフォリオ | 管理するすべてのドメインを 1 ページに表示(所有ドメイン+監視対象):実測値と推定値、Domain Rank、AI での言及、要対応項目、ドメイン概要、見積もり付きで予算上限を設定した更新 |
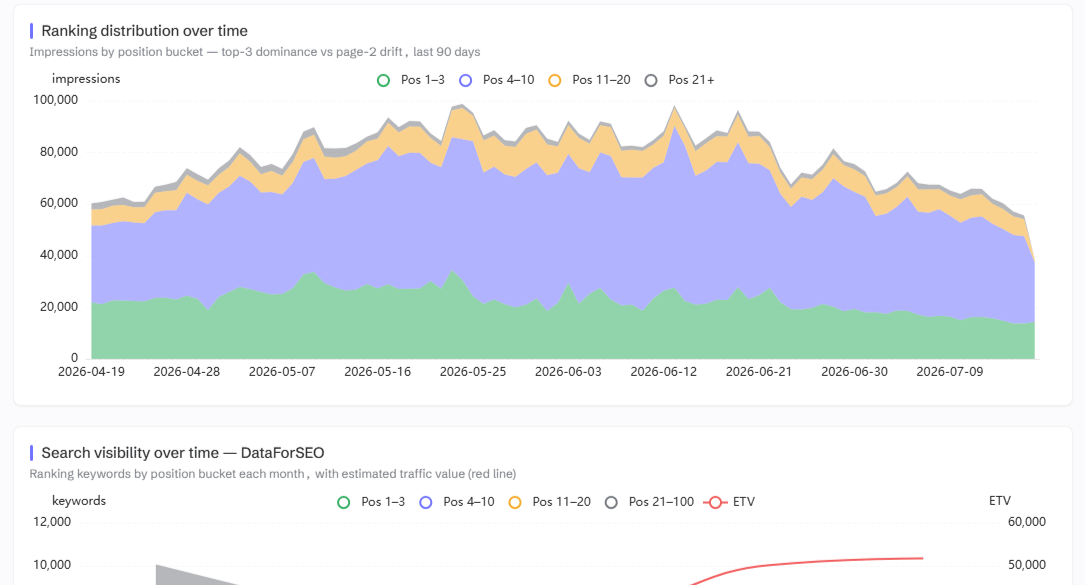
| ダッシュボードとレポート | 8 つのタブ、各チャートの内容、ブラウザーダッシュボード(Docker 用のスタンドアロン版も含む)、共有可能なエクスポート |
20 年経っても、驚くほどほとんど変わっていません
2006 年にクライアント向けに作成していたテクニカル監査は、構成上、今でもほとんどの代理店が販売している監査と同じです。クローラーが実行され、テンプレートが埋まり、60 ページの PDF が出てきます。クローラーが検出できるすべての項目が深刻度順に並ぶものの、どの指摘が利益につながり、どれが見た目だけの問題なのかはわかりません。
変わったのは、できることです。Google はすべてのサイト所有者に、検索の実態を完全に記録したデータを提供しています。どのクエリで、どのページが、何回表示され、何位にランクインしたかがわかります。クロールではサイトに何が書かれているかがわかります。Search Console では、それに対して Google が何をしたかがわかります。そして私の経験では、この 2 つのデータセットの差に、回復可能なトラフィックのほとんどすべてが隠れています。
そこで、これを作りました。SEO Audit Console は、Model Context Protocol サーバーです。Search Console の履歴とサイトのファーストパーティクロール(必要に応じてDataForSEOも)を統合し、Claude Desktop 内で内容を確認できる、優先順位付けされた根拠のある監査を提供します。貼り付けてすぐ使える修正案も提示します。すべての指摘は実際のデータポイントに基づいています。
すべての根底にある考え方は、ひとつです。
クロールが示すのは意図です。Search Console が示すのは現実です。その食い違いにこそ、利益があります。
単純なクローラーなら、ページが 404 であることを教えてくれます。有用ではありますが、それだけです。これなら、その 404 がホームページの内部 PageRank の 15% を流出させていること、そのページが以前は月 10,000 クリックを獲得していたことがわかり、修正用の 301 ルールまで作成します。さらに、15 万回表示されているのに掲載順位が 3 位、クリック率が 0.2% のページを見つけます。タイトルを書き換えれば数千クリックを獲得できる可能性があり、それを見た目だけの指摘よりも上位にランク付けします。クローラーが売りにするのは深刻度です。数値を動かすのは成果です。
これはどんな方に向けたものですか?
収集とチェックを自動化して、考える時間を確保したいSEOコンサルタントの方。ありふれた監査に4桁の金額を提示された社内マーケターの方。そして、質の高い監査で何を確認するのかを学びたい初心者の方です。各指摘に根拠が示されるため、このツールは学習にも役立ちます。
実行環境についてひとこと。手軽に始めるならClaude Desktopですが、私の考えではこのツールを使うならClaude Codeが最適です。一連の作業を最後まで完結できるからです。チャットクライアントでは、監査結果として301ルールが提示され、どこかに貼り付けることになります。Claude Codeなら、同じセッションでサイトのリポジトリ、ターミナル、Gitを利用できます。監査で問題を見つけ、修正を書き、コードベースに適用してコミットし、再クロールで検証できます。問題の発見から修正のデプロイまで、ひとつの会話で完了します。
インターフェースを覚える必要はありません。Claudeに "run an SEO audit on mysite.com" と入力すれば実行されます。できることを忘れたら、"run seo_audit_help" と尋ねると、使用例のプロンプト付きでメニュー全体が表示されます。
このアプローチは有効ですか?
はい。クロール結果とGSCのデータを統合するのは目新しい手法ではなく、これこそが適切な方法です。あるサイトでは、クロール対象をSearch ConsoleのURLから設定したことで、GSCが認識しているページのカバー率が29%から70%に上がりました。追加されたページはどれも、従来のクロールでは気づかれないまま見落とされていたページです。そのうち数ページは、内部リンクがまったくないにもかかわらず、トラフィックを獲得していました。同じサイトでは、増分同期によりデータ更新にかかる時間が33分から19秒になりました。これは、「四半期ごとに監査する」か「気になったときにいつでも監査する」かの違いです。
監査でチェックする内容
run_audit は結合したデータに対して143 件のチェックを実行し、優先順位を付けたリストを返します。すべてを一面に並べるのではなく、各指摘に影響するトラフィックを添えた優先順位リストです。チェックの分類は次のとおりです。
| 分類 | 検出する内容 |
|---|---|
| クロール可能性とインデックス登録 | リンク切れ、リダイレクトの適切さ(チェーン、ループ、評価を引き継ぐ一時リダイレクト、インデックス登録できないページやホームページへのリダイレクト、リダイレクトされずに削除された公開中ページ)、存在しない URL が 200 を返す状態(ソフト 404 の設定)、http/https または www/エイペックスの重複 URL が 301 で統一されていない状態、孤立ページ、インデックス肥大化、スパイダートラップ、robots によってブロックされながらトラフィックを獲得しているページ、インデックス登録を別のホストに委ねる canonical、Google が無視する hreflang(無効なコード、自己参照なし、ロケールの重複、canonical との競合)、およびすべての URL がインデックス登録できない理由 |
| ページ上の要素と構造化データ | タイトル、メタ情報、H1、alt テキストに加え、約 30 種類のリッチリザルトを対象にしたローカルバリデーター。必須フィールドのみをチェックするため、Google が無視するプロパティについて警告することはありません。ストアの場合は、200 から 404 になった商品ページや、商品リスティングに必要な情報が欠けている Product マークアップも対象です |
| ページの容量とアセット | クロールから把握した、各ページが読み込むすべてのもの。エラーを返す CSS、JavaScript、フォントファイル、<head> 内のレンダリングを妨げるスクリプトとスタイルシート、キャッシュ期間が設定されていない静的ファイル、画像切れ、300 KB を超える画像、WebP の方が小さくなる JPEG/PNG(ブラウザーに配信される状態で測定)。実ユーザーの Core Web Vitals は CrUX から取得します |
| 推移(期間ごとの GSC) | クリック数が減少しているページ、順位が下落しているページ、消失したクエリ、さらに注力する価値のある上昇中のページ、前年比で劣化している古いコンテンツ |
| 統合したデータからの指摘 | カニバリゼーション、上位表示が目前のページ、ゴーストページ、デッド URL へのトラフィック、クリックのないページに浪費されている内部評価、すでに順位を獲得しているクエリを含まないタイトル |
| AI 検索への対応状況 | 順位を獲得しているのにコンテンツ内で使われていないフレーズ、コンテンツが一つのまとまりで回答していないクエリ、検索時にきれいに分割できないコンテンツ |
| アクセシビリティ | HTML から直接判定できる axe-core ルールのサブセット。アクセシブルな名前のないリンクやボタン、ラベルのないフォームフィールド、ピンチズームの無効化、正の tabindex、重複する id に加え、alt テキスト、見出しの順序、lang の欠落も対象です |
| JavaScript のレンダリングと重複 | 必要に応じて実行します。Response vs Render(render_pages)はヘッドレス Chromium で各ページをクロールし、JavaScript の実行後にのみ存在するコンテンツやリンク、JavaScript による変更(canonical、タイトル、どちらかの方向への noindex、削除されるサーバーレンダリング済みコンテンツ)を検出します。また、意味的な重複に近いページを検出する機能(find_duplicates)は、同じ内容を伝えるページを見つけます。どちらもローカルで実行され、API 費用はかかりません |
各チェックにはD(deterministic:バイト列に基づく判定)またはN(judgement:判断による判定)のラベルが付いています。後者はデフォルトで無効です。「the judgement findings」と尋ねると確認できます。誤った指摘は、指摘がないよりも悪いというのが私の考えです。そのため、ヒューリスティックなチェックの実行には許可が必要です。チェックごとの全項目はマニュアルに記載されています。
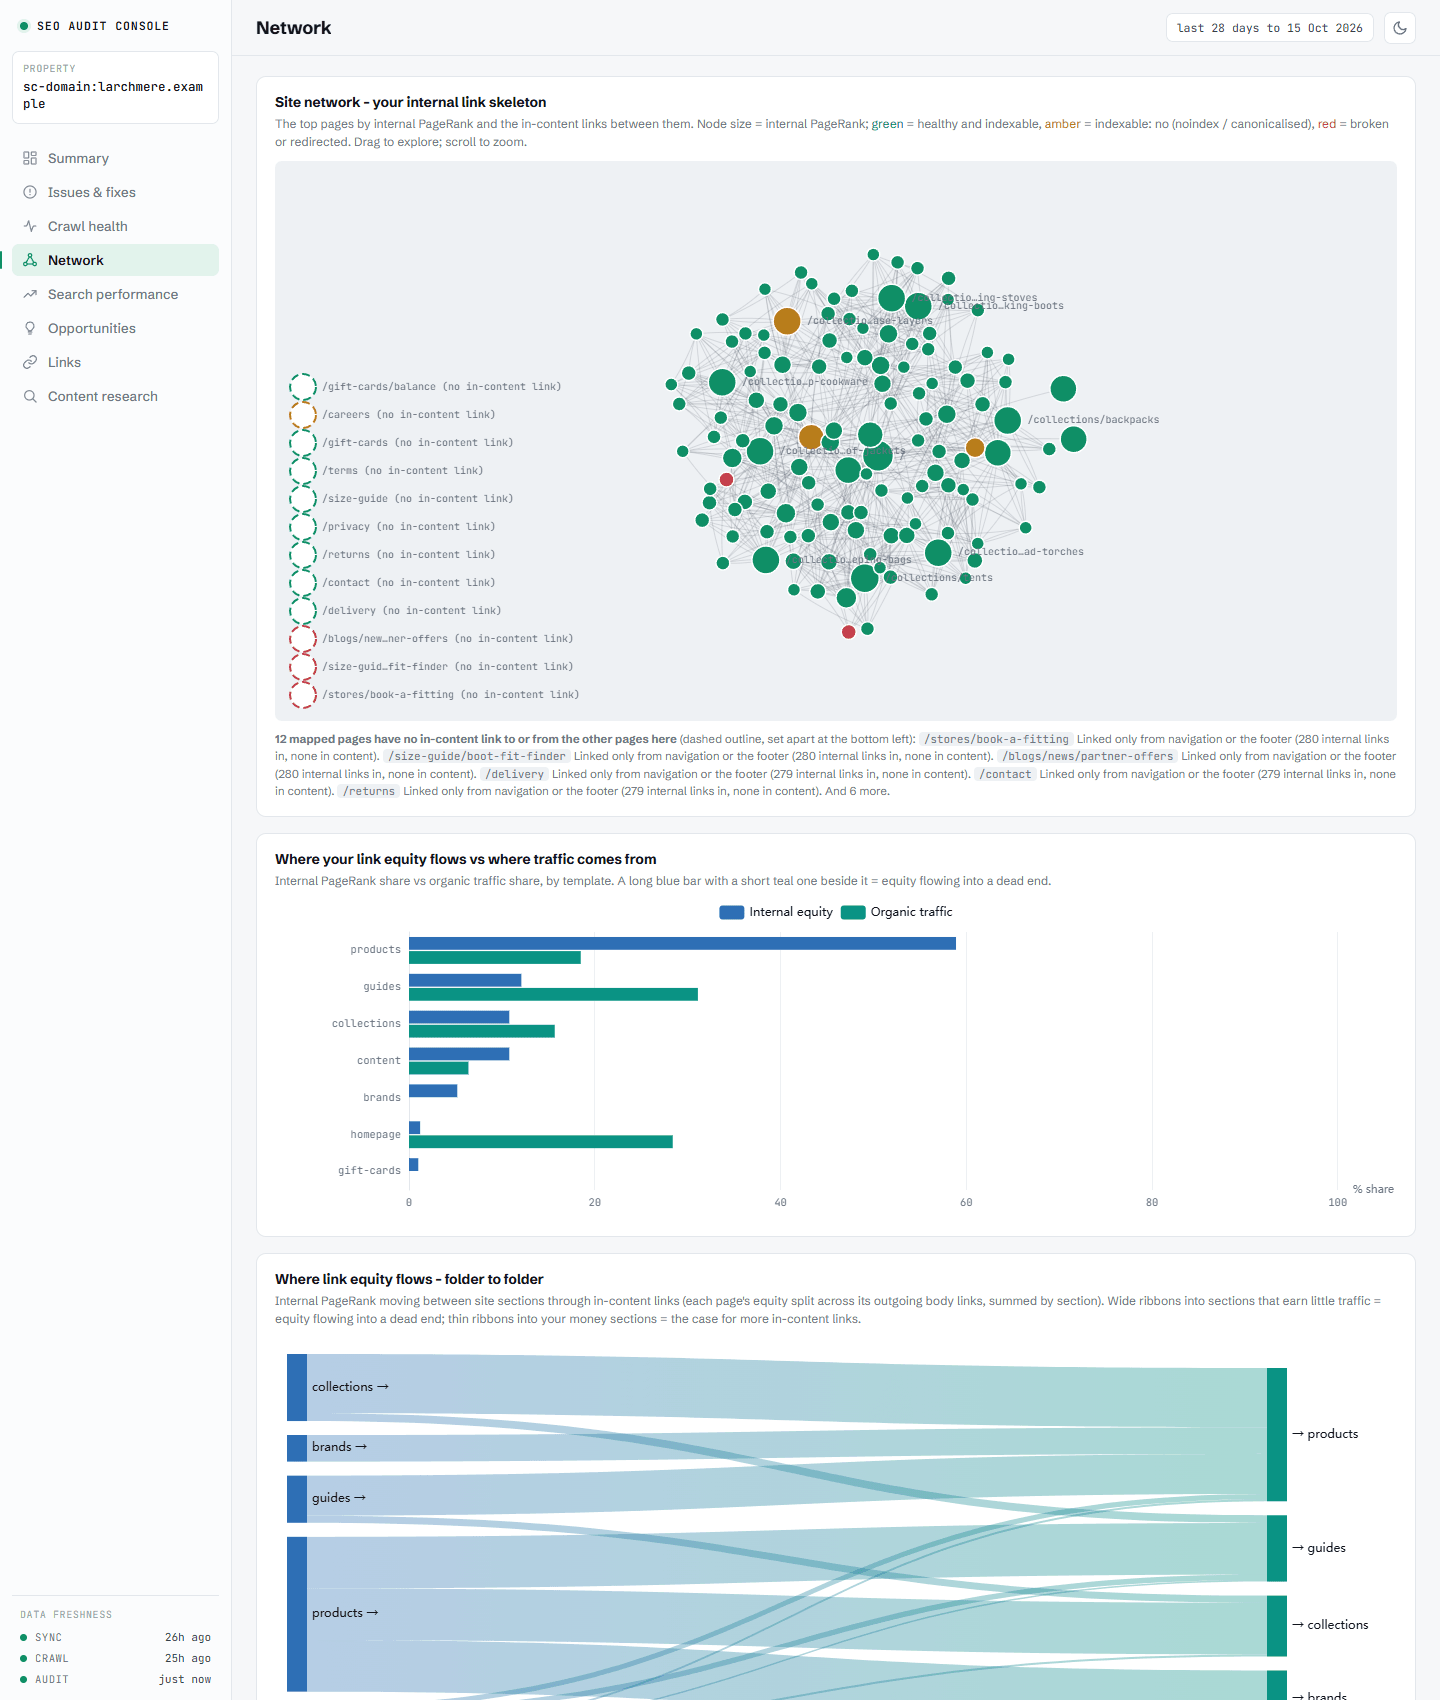
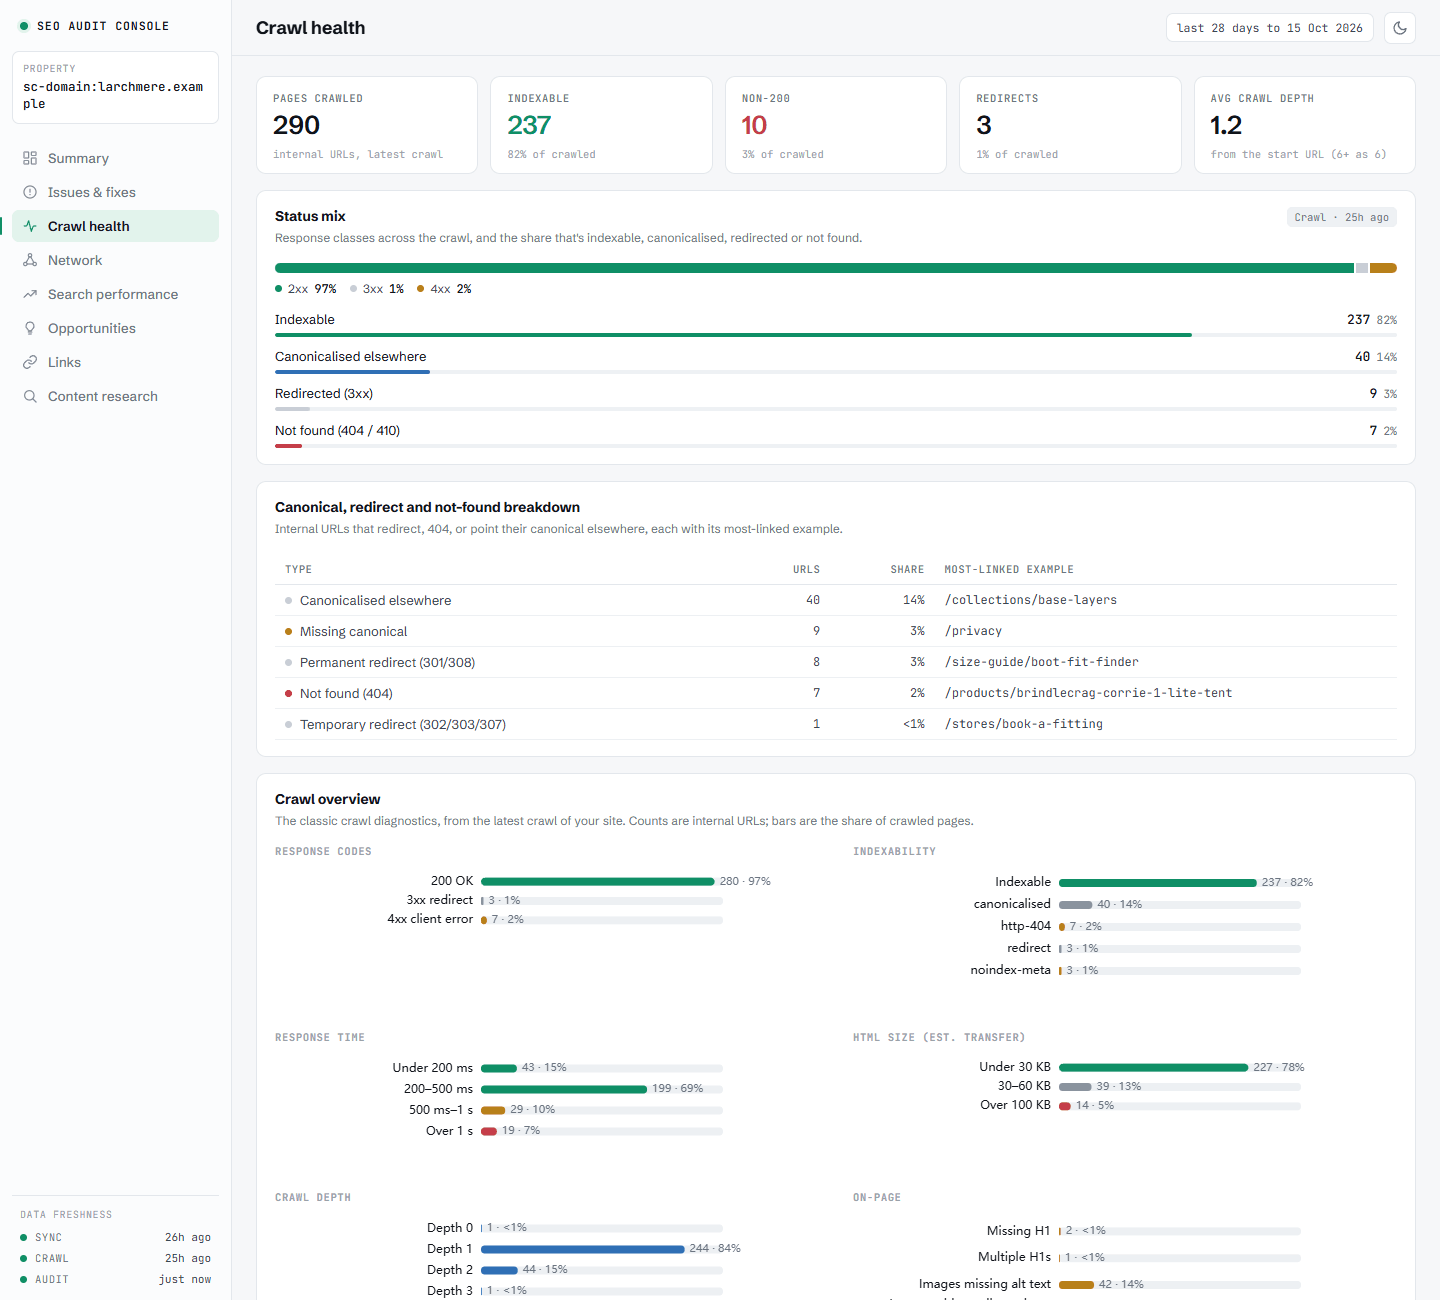
また、昔ながらのデスクトップ SEO クローラーに慣れ親しんでいる方なら、ダッシュボードの「Crawl health」タブに懐かしさを感じるでしょう。レスポンスコード、インデックス登録の可否とその理由、クロール深度、最も容量の大きい画像、サーバーエラー、遅いページが、すべて見やすい統計バーで表示されます。同じ診断情報を、各 URL の Search Console の数値と並べて確認できます。タブごとの概要はdashboard.mdをご覧ください。
クロールの仕組みを正しく理解する
監査で問題が起きやすいのはクロールです。そのため、このクロールがほかとどう違うのかを理解する価値があります。クローラーが自分自身を欺いた後始末をする仕事を、これまで十分に経験してきました。これは本格的な SEO クローラーです。たまたま Search Console の履歴もそばにあるだけです。
ページを3つの方法で発見します。 リンクをたどり、XML サイトマップを読み込み、そして重要なのが、Google がすでにトラフィックを送っているすべての URL を、GSC データから直接取得してクロールを開始する方法です。カバレッジがサイトマップの正確さに左右されなくなります。また、これこそが見えないページを発見する方法でもあります。Google がランキングしている URL にサイト内の構造からアクセスできない場合でも、その URL はクロールされ、不整合が検出結果になります。
「何を」だけでなく「なぜ」も記録します。 インデックス登録できない URL ごとに、その理由(404、noindex、X-Robots ヘッダー、別の URL を正規 URL として指定、robots によるブロック、HTML 以外)を保存します。「このページはランキングされない」は事実ですが、「このページは、誰も覚えていないプラグインが X-Robots ヘッダーを設定したためランキングされない」なら修正できます。
だまされないようにしています。 サイト外へ移動するリダイレクト(Shopify の OAuth フローのことです)は、ページとして保存せず、リダイレクトアウトとして記録します。HEAD リクエストでは実際のリクエストと異なるステータスが返ることがあるため、常に HEAD ではなく GET を使用します。ただし、画像、PDF、アセットでは本文の取得を中断するため、バイトデータをダウンロードせずにステータスとサイズを記録します。
無遠慮にならず、すばやく動作します。 オリジンが対応している場合は HTTP/2 を使用し、gzip と brotli をネゴシエートし、キープアライブ接続を再利用します。速さはサーバーに過度な負荷をかけるのではなく、効率性によるものです。robots.txt を仕様どおりに正しく尊重します(仕様上、ボット固有のグループは * を置き換えますが、多くの商用クローラーはここを誤ります)。また、内部検索、ファセットフィルターの組み合わせ、ログインフローなどの不要なものはスキップします。これは、自分が所有するサイトのためのクローラーです。礼儀正しくアクセスすることが大切です。
ホストから求められたら、速度を落とします。 429(または Retry-After を伴う 503)が返ると、クロールの同時実行数を半分にし、Retry-After が示す時間だけ待機して、その URL をキューの後ろに回し、さらに2回再試行します。正常な応答が返れば、ワーカーを追加します。ヘッダーから Shopify ストアを判別し、控えめな設定で開始します。最後までレート制限が続いた URL は、ステータスなしで rate limited として保存され、壊れたページとして扱われることはありません。クロールのステータスには、その件数が表示されます。
クロールだけでは発見できないこともテストします。 各クロールの最後に、最大5件のサイトプローブを実行します。存在しないはずの URL を2つ調べ(サイトが404を返すか、200を返してソフト404になるか)、さらにホームページと深い階層のページについて、http/https と www/ルートドメインの組み合わせを確認します(正規ホストへの301が1回で完了するか、それとも分散するか)。また、各ページが読み込むスタイルシート、スクリプト、フォント、画像について、ファーストパーティかサードパーティか、head 内か body 内かをすべて記録します。これらのデータはダウンロードしません。headResources:true を指定すると、ステータス、サイズ、キャッシュについてヘッダーのみの確認を追加します。
測定できなかった項目も明示します。 データが収集されていないチェック(headResources クロール前のアセットチェック、render_pages 実行前のレンダリングチェック、sync_crux 実行前のフィールド Core Web Vitals など)は、監査で not collected として、収集を行うステップとともに一覧表示されます。空のテーブルが問題なしを意味することはありません。
クロール後は、実際のリンクグラフを計算します。ナビゲーションリンクとフッターリンクの重みを下げた内部 PageRank、body 内のリンクだけを数えたホームページからのクリック深度、ページごとの被リンク数です。このグラフは、孤立ページ、エクイティの漏出、内部リンクが不足しているページのチェックに使われます。また、ツールが内部リンクを提案する際のリンク元候補のランキングにも使われます。
ワークフローの概要
ここに挙げたものは、どれも私が実際に使っている手順で、それぞれ1つのプロンプトで実行できます。処理の詳細を含む拡張版は、リンク先のマニュアルページにあります。
- 最初の監査。 「Refresh sc-domain:mysite.com」、続いて 「Run an SEO audit on mysite.com」。中規模サイトなら20分で、通常、上位5件の指摘だけで残り85件を合わせた以上の価値があります。次に 「generate the fix for #1」 と依頼します。→ getting-started.md
- サイト全体のキーワード最適化。 問うべきなのは「どのキーワードを狙うべきか?」ではなく、「すでに順位を獲得しているのに、コピーで十分に伝えられていないのはどこか?」です。「Score the passages on mysite.com」 を実行すると、順位を獲得しているすべてのページに対し、小規模なローカル関連性モデルを実行します。「draft the missing content for /page」 と依頼すれば、何もでっち上げないよう根拠に基づき、サイト独自の語調で修正案を作成します。→ tools.md
- カニバリゼーション。 「Show me the cannibalisation findings with evidence」。しきい値は、偶発的なロングテールの重複がカウントされないよう調整されているため、統合するか差別化するかの判断を数値に基づいて行えます。→ checks.md
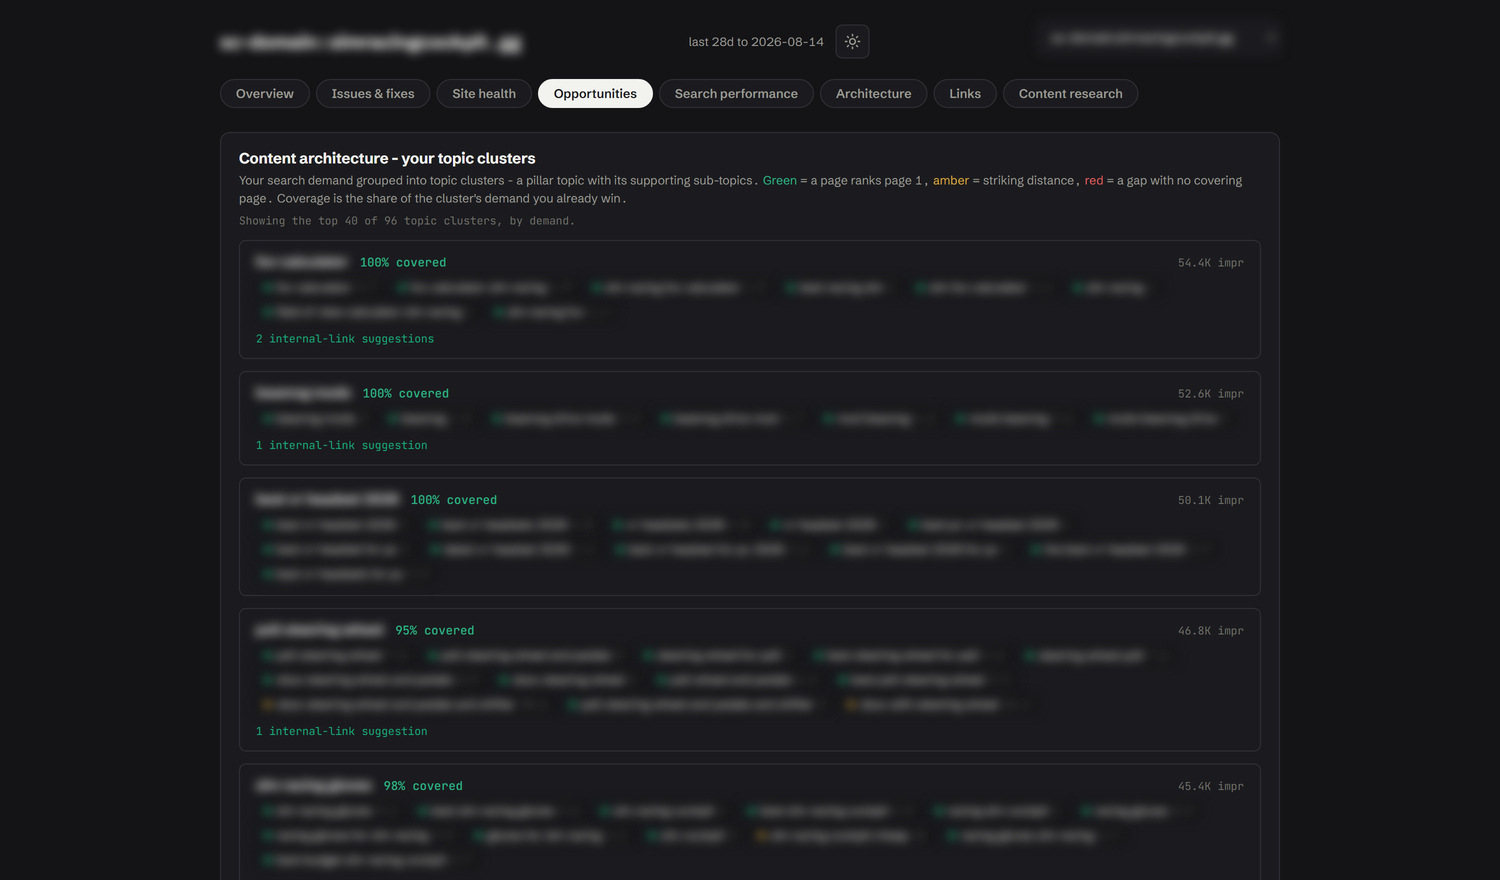
- コンテンツ計画。 「Suggest new pages for mysite.com」 は、Googleがすでに示している需要を掘り起こします。「what topics should mysite.com cover?」 は、まだ捉えられていない需要をマッピングします。組み合わせれば、四半期分の計画になります。→ competitive.md
- テンプレート戦略。 「List the page templates」。大規模サイトは5万ページではなく、十数種類のテンプレートが繰り返し使われています。テンプレートを1つ修正すれば、クラスター全体を改善できます。→ tools.md
- モニタリングと移行。 「Detect changes on mysite.com」 は、直近2回のクロールの差分を重大度別に表示します。移行中なら、火曜日に紛れ込んだ noindex を見つけるか、3週間後の役員会議でトラフィックグラフの説明をするかの違いになります。私は後者を経験しました。→ tools.md
- AI検索への対応状況。 「Check agent readiness for mysite.com」。ウェブには静かに第2のオーディエンスが増えていますが、これを確認するSEOツールはほとんどありません。→ tools.md
- 独自の質問。 4つのデータセットは3つの結合キーを共有しています。最も価値の高い分析は、自分で組み立てるものです。「AI Overviewsに引用された後、クリック数が減ったページはどれ?」 という質問は、ここでは1つのプロンプトで済みますが、ほかでは機能として存在しません。→ composition.md
- レポート作成。 チャットで 「Show me the dashboard」、ブラウザーでライブ版を表示するなら 「serve the dashboard」、クライアントに送れる自己完結型のHTMLファイルとして出力するなら 「export the report」 と依頼します。→ dashboard.md
- コンテンツ機会レポート。 文章を書くことを仕事にしているなら、まず見るべきページはこれです。「Content opportunities for mysite.com」 は、次に書くべきもの(表示回数はすでに獲得しているのに、勝てるページがない需要)、更新すべきもの(クリックが減り続けているページ)、書き直すべきスニペット(順位は高いのにクリックが少ないもの)、強化すべきクラスター(4〜20位にあり、ひと押しで収益につながるもの)を返します。各項目はすべて自サイトのSearch Consoleデータに基づいており、キーワード案をでっち上げることはありません。「draft the brief for row 1」 と依頼すれば、どの項目も根拠に基づくアウトラインにできます。→ competitive.md
- 市場規模の推定と優先順位付け。 「Size the market: mysite.com vs rival1.com and rival2.com」。キーワード全体、月間総需要、トピッククラスターごとのシェア・オブ・ボイスを、ドメインごとにキャッシュされた1回の呼び出しで取得します。かつては有料SEOスイートが必要だった、エンゲージメントのきっかけとなる分析です。→ competitive.md
- コンテンツ調査 - このページが順位を落としている理由は? 「Run content recon on mysite.com」 は、表示回数が最も多く、3〜15位に位置するページ(ひと押しで順位を上げられるページ)を対象に、それぞれのGoogle SERPを取得し、AI Overview が自サイトを引用しているかを確認します。重要なのは、率直な判定です。順位は高いのに引用されていない 場合、問題はデータの正確性か鮮度であり、書き直しではありません。無料のブラウザープロファイルによる取得でアクセス可能な競合を確認し(Redditは独自のJSON経由)、確認すべき上位動画を一覧表示し、ギャップを、注釈を加えて再測定できる追跡型ToDoボードに記録します。→ recon.md
- 実質的な権威性で並べ替えるリンク獲得候補の調査。 「Link intersect for mysite.com vs rival1.com, rival2.com」 は、競合にはリンクしていて自サイトにはリンクしていないドメインを返します。フォロー済みリンクを優先し、スパムを除外したアウトリーチリストです。Majestic キーを追加すると、Trust Flow に基づいて再度並べ替え、各候補のトピカル・トラスト・フローを表示します。これによりディレクトリは除外され、残るのは自サイトのトピックに関連する権威性の高い候補だけです。→ Majestic、以下
DataForSEOでできること(および費用)
上記の機能はすべて、Search Consoleのデータだけで利用できます。ただし、GSCで把握できるのは、すでに検索結果に表示されている検索だけです。「この市場の規模はどれくらい?」や「競合が上位表示されていて、自分のサイトが上位表示されていないキーワードは?」といった問いに答えるには、サードパーティのデータが必要です。それがDataForSEOです。検索ボリューム、リアルタイムの検索順位、競合データ、Lighthouseの実行を利用できる従量課金制のAPIです。サブスクリプションは不要です。API呼び出しの費用は1セント未満から数セントで、20日間キャッシュされ、実行されるのはリクエストしたときだけです。私の場合、月々の利用料は数ドル程度です。
競合分析機能を利用できるようになります。任意のドメインのオーガニック検索でのビジビリティ概要、任意のサイトの上位ページと検索順位の高いキーワード(そのうちAI Overviewに表示されるものも含む)、コンテンツギャップ、トピックのギャップ、検索意図、ラボで測定したCore Web Vitals、バックリンクを確認できます。また、コンテンツ調査も可能になります。recon_targetsは、順位が落ちたページについてGoogleのライブSERPを取得し、AI Overviewに引用されているかを確認して、なぜ順位で後れを取っているのかを示します。ワークフローとセットアップの詳細については、competitive.mdをご覧ください。
ポートフォリオ機能もDataForSEOを利用します。所有するプロパティと、追跡対象のドメインを横断して1つの表にまとめます。オーガニックキーワードとトラフィック、参照ドメイン、Domain Rank、AIでの言及(Google AI Overviews + ChatGPT)に加え、Search Consoleで測定したクリック数と監査の健全性も表示します。「要対応」タブとドメイン別の概要も利用できます。各数値には、実測値か推定値かが明記され、更新前には費用が提示されるため、事前に確認できます(週次プランで8ドメインをライブ実行した場合、費用は$0.22です)。詳細については、portfolio.mdをご覧ください。
DataForSEOで利用できる機能のうち、もう1つは独立したセクションで説明します。リンク関連の作業では、任意で利用できる別のサービスも使えるためです。
リンクの交差分析とMajestic Trust Flowの階層
リンク構築は、見込み先リストそのものが戦略となる唯一の分野です。そのため、link_intersectは勘に頼らず、根拠に基づいてリストを作成します。競合他社のセット(自社を除く)を対象にDataForSEOのdomain_intersectionを1回呼び出すと、競合他社にはリンクしていて自社にはリンクしていないドメインがすべて、見込み先ごとに集約されて返されます。自社の競合のうち何社にリンクしているか、リンクがフォローされているか、最悪のスパムスコア、アンカーテキストの構成がわかります。セットではなく1社だけを指定すれば、もうひとつの定番の問い、「会社Xが持っていて、自社にはないリンクは何か?」に答えます。
これでリストは手に入ります。しかし、優先順位はわかりません。そして、リンクの見込み先探しがこれまでずっと失敗してきたのは、まさにここです。DataForSEOはドメインランクで並べ替えますが、これはリンクの量を示す指標です。そのため、ディレクトリやアグリゲーター、プレスリリース配信ドメインが上位に並びます。技術的には権威があっても、売り込み先としては価値がありません。私の知る限り、すべてのリンクビルダーが、このリストに1週間を費やした経験があります。
MAJESTIC_API_KEYを設定すると、納得できる順序に変わります。 Majesticは、今日のSEOツールの大半が登場する前からウェブのリンクグラフをクロールしてスコアリングしており、代表的な2つの指標は、まさにこの問題を解決するものです。
- Trust Flow(0-100) - 信頼できるサイトのシードセットから伝播される、編集上の権威性です。ドメインがどれだけリンクを集めたかではなく、誰がそのドメインを保証しているかを測定します。これがディレクトリに強い理由です。テストでは、DataForSEOで227にランク付けされたドメインのTrust Flowが0でした。量の指標だけでは、これを見抜けません。
- Topical Trust Flow - ランク付けされたトピックで示す、その権威性の対象分野です。トップトピックが
Recreation/AutosのTrust Flow 45のドメインは、自動車部品を販売しているなら優れたリンク先ですが、Health/Nutritionなら売り込みが無駄になります。これは、強いリンクと関連性のあるリンクの違いであり、クライアントに見せても通用するアウトリーチリストを作る列です。
キーを設定すると、条件を満たす見込み先すべてに情報が追加され、表にTrust Flow列と各ドメインの主要トピックが加わり、リスト全体がTrust Flow順に並べ替えられます。
you  › link intersect for mysite.com vs rival1.com, rival2.com

     Prospect domain     Links to  Trust Flow  Link    Spam  Backlinks  Top topic
     enthusiast-mag.com  2/2       54          follow  2     31         Recreation/Autos
     club-forum.org      2/2       41          follow  0     12         Recreation/Autos
     free-link-list.net  2/2       0           follow  28    904        –
(出力の形式を示す例です。名前は架空です。)同じ3つの見込み先で、基礎となるDataForSEOのデータも同じです。バックリンクが最も多いのはどれかにも注目してください。DataForSEOの方法で並べ替えると、最初にメールを送ることになるのはディレクトリでした。
link_intersectを使うには、DataForSEOのBacklinksサブスクリプションが必要です。これはSERP/Keywords/Labs APIとは別のサブスクリプションです。有効化されていない場合、ツールはコードを表示するのではなく、わかりやすい言葉でその旨を伝えます。
この階層は利用枠を慎重に扱います。情報の追加は1回の呼び出しにつき100ドメイン単位(1単位ほど)で行い、enrichLimit(デフォルトは100)で上限を設定します。情報を追加できる数より多くの見込み先が条件を満たした場合は、スコアが一部しか付いていないリストを渡すのではなく、その旨と上限を引き上げる方法を応答で知らせます。リクエストは直列化され、各応答はMAJESTIC_CACHE_DAYSを通じて30日間キャッシュされます。2週間以内に同じ質問を2回すれば、2回目の費用はかかりません。
オプションです。本当に任意です。キーがなくても、link_intersectは引き続き実行され、ドメインの信頼度に基づいてフォローされているリンクを優先して並べ替えます。Majesticを使えば、「100個のドメインはこちら」が「メールを送る価値がある20個はこちら。その理由はこちら」に変わります。プランと料金ページでキーを取得してください。ワークフローの全容はcompetitive.mdをご覧ください。
Trust FlowとTopical Trust Flowは、Majestic(Majestic-12 Ltd)の商標です。この階層は、独自のキーを使って、
link_intersectまたはpull_backlinks(ダッシュボードのTrapped authorityレポート用に、自社の被リンクページにTrust Flowを追加します)を実行したときに限りMajestic APIを呼び出します。このツールのその他の機能がMajestic APIにアクセスすることはありません。
インストールの概要
3つのステップです。上記のクイックスタートは短縮版で、注意点も含めた詳しい手順はgetting-started.mdをご覧ください。
- 入手する: 手早く済ませるなら、MCP の設定で
npx -y @houtini/seo-audit-consoleを指定します。ビルドは不要です。または、このリポジトリをクローンして、ソースを使う場合はnpm installとnpm run buildを実行します。どちらの場合も Node ≥ 20 が必要です。 - Search Console に接続する: Google Cloud のサービスアカウントを作成し、JSON キーをダウンロードします。そして、見落としやすい手順として、Search Console でプロパティのユーザーにサービスアカウントのメールアドレスを追加します。 画像付きの手順が必要ですか? 最初から設定するで全手順を確認できます。
- MCP クライアントから接続する:
GOOGLE_APPLICATION_CREDENTIALSを設定したうえで、公開パッケージを使う場合はnpx -y @houtini/seo-audit-console、ソースからビルドした場合はnode /path/to/seo-audit-console/dist/index.jsを指定します。Claude Desktop と Claude Code で動作し、必要な環境変数はこの1つだけです。
サーバーが読み込むすべての環境変数を、1つのブロックにまとめています。最初の変数は必須で、それより下はすべて任意です。使用する変数だけ設定し、それ以外は空文字列のままにするか、削除してください。値が空の場合はそのサービスが無効になります。また、your-key-here のようなテンプレート文字列が残っている場合も無効になり、サーバーのログにその旨が1行表示されます。
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "npx",
      "args": ["-y", "@houtini/seo-audit-console"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "SAC_DATA_DIR": "",
        "DATAFORSEO_USERNAME": "",
        "DATAFORSEO_PASSWORD": "",
        "DATAFORSEO_CACHE_DAYS": "20",
        "MAJESTIC_API_KEY": "",
        "MAJESTIC_CACHE_DAYS": "30",
        "CRUX_API_KEY": ""
      }
    }
  }
}
ソースからビルドした場合は、起動時の2行を "command": "node" と "args": ["C:/path/to/seo-audit-console/dist/index.js"] に置き換えてください。env ブロックは同じです。
GOOGLE_APPLICATION_CREDENTIALS でコア監査全体を利用できます。DataForSEO を追加すると市場データを利用でき、MAJESTIC_API_KEY を追加すると link_intersect の結果が Trust Flow 順に並べ替えられます。また、CRUX_API_KEY(任意。フィールドデータの Core Web Vitals 用。Chrome UX Report API に制限した無料の Google API キー)を追加すると、実ユーザーの LCP、INP、CLS を取得できます。おそらく必要になることのない高度な設定(再ランキングのデバイス、Majestic のサンドボックスホスト、ダッシュボードサーバーのバインド、ポート、自動起動設定)も含めた各項目の詳細は、getting-started.mdをご覧ください。
次に、「list properties」で接続を確認し、「refresh」を実行してから、「run an SEO audit」を実行します。
0.16.0 へのアップグレード
0.16.0 では、Search Console の行の保存方法が変更されます。segments:true を指定した同期で取得されるデバイス別および国別の行は、専用テーブル(search_analytics_segments)に保存され、search_analytics には全地域の合計のみが保存されるため、同じ日の合計が二重に計上されることはありません。手作業は不要ですが、両方の形式のデータが保存されたデータベースで、アップグレード後の初回同期時に行われる処理を把握しておいてください。
- まずデータベースをバックアップします。 同じ場所に
<database>.bak-<date-time>が作成されます。バックアップは完全なコピーなので、5 GB のデータベースなら 5 GB の.bakファイルが作成されます。 - 開始前に空きディスク容量を確認します。 バックアップ用の容量に加えて、データベースの半分の容量と 256 MB が必要です。容量が足りない場合、移行は保留されます。同期は従来の形式のまま実行されます(ビューで各日を1回だけ集計するため、合計は正しく保たれます)。応答には「storage migration deferred: needs N GB free」と表示され、データは移動されません。容量が確保された後の同期で移行されます。
- その後、行を日ごとのバッチで移動します。 5.5 GB のデータベースでは、バックアップを含めて3分半弱かかりました。処理が中断された場合は、次の同期で中断した箇所から再開され、処理中も数値は正しく読み取れます。
- 最後に、容量を回収します。 圧縮するまではデータベースファイルのサイズは変わりません。「vacuum the mysite.com database」と依頼してください(
data_storageのpruneをvacuumとともに実行します)。5.5 GB のテスト用データベースでは、4.4 GB まで縮小しました。数値に問題がないことを確認したら、.bakファイルを手動で削除してください。自動削除は行われません。
一方の形式しか保存されたことがないデータベース(多くの場合、segments を指定せずに同期したデータベース)は、バックアップもデータ移動も行わず、初回起動時に移行済みとしてマークされます。リリースのその他の変更については、変更履歴をご覧ください。
Docker と Docker MCP gateway
クロール、同期、更新はバックグラウンドジョブとして実行されます。ツールはすぐにジョブ ID を返し、check_crawl_status をポーリングしている間も処理は続行されます。通常どおり実行する場合(npx、または Claude Desktop から node dist/index.js)、サーバープロセスは長時間稼働し、自身で処理を行います。以下の内容は適用されません。
Docker MCP gateway は、次の 2 点で異なります。
- 起動。 gateway はワーカーコンテナ内でサーバーを実行します。カタログエントリに
longLived: trueが指定されていない場合、ツール呼び出しのたびに新しいワーカーを起動します。指定されている場合は、クライアント接続ごとに 1 つのワーカーを起動します。node:22-slimからnpxで起動したワーカーは、応答する前にパッケージをインストールするため、60~90 秒かかります。これは Claude Code がツール呼び出しを待つ時間を超えます。そのため、seo_audit_helpも含め、すべての呼び出しがタイムアウトします。解決するには、パッケージを事前インストールしたイメージを用意し、longLived: trueを指定します(以下の手順 1)。 - ジョブ。 gateway は、切断時、ルーターの再作成時、アイドル状態のワーカーの回収時などに、自由にワーカーを入れ替えます。ワーカー内で実行中のジョブは、ワーカーとともに終了します。解決するには、処理をワーカーの外に移し、gateway が操作しない、長時間稼働する ジョブランナー コンテナで実行します(手順 2 と 3)。
2026 年 10 月に gateway(0.16.2)で計測:
| カタログエントリ | 新しい接続での初回呼び出し | 以降の呼び出し |
|---|---|---|
node:22-slim + npx、longLived なし | 88~108 秒 | 88~108 秒(毎回) |
node:22-slim + npx、longLived: true | 75~80 秒 | 即時 |
ビルド済みイメージ、longLived なし | 2 秒 | 2 秒 |
ビルド済みイメージ、longLived: true | 2 秒 | 即時 |
1. イメージをビルドし、カタログエントリの参照先に設定します。 イメージとランナーのリリースを一致させるため、バージョンを固定します。
FROM node:22-slim
RUN npm install -g @houtini/[email protected]
ENTRYPOINT ["seo-audit-console"]
このファイルがあるフォルダーで docker build -t seo-audit-console:0.17.0 . を実行します。次に、カタログエントリで image: seo-audit-console:0.17.0 を設定し、command: 行を削除します(イメージのエントリーポイントがサーバーを起動します)。さらに longLived: true を追加します。gateway はローカルイメージを --pull never で実行するため、ビルドしたイメージが使われます。リリースごとにイメージを再ビルドし、カタログエントリのタグを変更してください。
ランナーを使うには、残り 2 つの手順を実行します。
SAC_JOB_RUNNER=externalを指定して起動する MCP サーバーは、データディレクトリ内の_jobs.dbに各ジョブをキュー登録するだけで、そのステータスを読み取ります。- ランナー(同じ npm パッケージに含まれる
seo-audit-runner)は、キューに入ったジョブを取得して実行し、進捗を同じデータベースに書き戻します。
ワーカーは使い捨て可能になります。クロールの途中でルーターを再作成しても、ランナー内でクロールが続行されます。
2. 手順 1 でビルドしたイメージから、gateway のカタログエントリと同じ認証情報を使い、同じデータボリューム上でランナーを起動します。
docker run -d --init --name seo-audit-runner --restart unless-stopped \
  -v mcp-sac-data:/data -v mcp-sac-creds:/creds:ro \
  -e SAC_DATA_DIR=/data -e GOOGLE_APPLICATION_CREDENTIALS=/creds/gsc.json \
  -e DATAFORSEO_USERNAME -e DATAFORSEO_PASSWORD -e MAJESTIC_API_KEY -e CRUX_API_KEY \
  --entrypoint seo-audit-runner seo-audit-console:0.17.0
値を指定しない 4 つの -e NAME フラグは、シェルからそれらの変数を引き継ぐため、キーがコマンドラインに表示されません。使用しないものは省略してください。Windows の Git Bash では、コマンドの前に MSYS_NO_PATHCONV=1 を付けてください。そうしないと、MSYS が /data と /creds を Windows のパスに書き換えます(PowerShell では不要です)。--init を付けると、docker stop によってランナーにクリーンな SIGTERM が届きます。docker logs seo-audit-runner を実行すると、ランナーの起動と、取得したすべてのジョブを確認できます。(イメージがなくても、node:22-slim npx -y -p @houtini/[email protected] seo-audit-runner で実行できます。ランナーは長時間稼働するコンテナなので、npx によるインストールは初回起動時の 1 回だけです。)
3. gateway をキュー登録方式に切り替えます。 このサーバーのカタログエントリの env に SAC_JOB_RUNNER=external を追加します。longLived: true はそのままにしてください。 ランナーを使うと、ワーカーが入れ替わってもジョブが継続します。longLived を指定すると、呼び出しの合間もワーカーが起動した状態に保たれます。これらは異なる問題を解決するもので、併用できます(テスト済み:longLived ワーカー経由でキューに登録された同期処理を、ランナーが取得して完了しました)。
表示内容。 ジョブは、ランナーが取得するまで queued: waiting for the job runner と表示され、取得後はこれまでどおり running と表示されます。ジョブが1分以上キューに残り、ランナーからのチェックインがない場合は、その旨がステータスに表示され、上記の docker run コマンドが出力されます。ランナーのハートビートがない状態が約2分続くと、queued (no runner) と表示され、data_storage のプルーニングや修復を妨げなくなります。通常の1日後のプルーニングまでは一覧に残ります。デフォルトでは、1つのランナーが一度に1つのジョブを実行します。SAC_RUNNER_CONCURRENCY を設定すると同時に複数のジョブを実行できますが、同じプロパティのジョブが同時に実行されることはありません。更新するには: 新しいリリース用のイメージをビルドし(手順1、新しいタグを使用)、カタログエントリのタグを変更して、ゲートウェイを再起動し、新しいイメージからランナーを再作成します(docker rm -f seo-audit-runner を実行してから、再度 docker run コマンドを実行します)。ランナーとゲートウェイは同じリリースを使用してください。ランナーの停止時に実行中だったジョブは interrupted として記録されるため、再実行してください。
ゲートウェイで引き続き npx を使う場合は、 新しいワーカーが起動するたびにパッケージをインストールするため、各クライアント接続の最初の呼び出しはタイムアウトすることがあります(longLived: true を指定すると、以降の呼び出しは高速です)。サーバーはこのケースを検知します。コンテナー内で npx によって起動された場合、ここを案内する警告をログに出力します。この警告は、ゲートウェイの docker logs で確認できます。
アップグレード後は、MCP クライアントを再起動してください。 クライアントは接続時に一度だけツールリストを読み込み、その後はそのリストを保持します。Claude Desktop または Claude Code を(Windows ではトレイから完全に)再起動するまでは、新しいリリースで追加された sync_crux などのツールは、サーバーに存在していても表示されません。
ランナーを使わない場合は、 以前の方法も引き続き使えます。カタログエントリに longLived: true を指定する(またはゲートウェイに --long-lived を指定する)か、ボリュームをマウントして docker run -i --rm を実行すると、セッション中は1つの stdio プロセスが起動し続けます。どちらの場合も、名前付きボリュームにデータディレクトリと認証情報をマウントしてください(例:-v seo-audit-data:/data -e SAC_DATA_DIR=/data および -v seo-audit-creds:/creds:ro -e GOOGLE_APPLICATION_CREDENTIALS=/creds/service-account.json)。これにより、監査結果とジョブ一覧が再起動後も保持されます。
サーバー自体の公開イメージはありません。手順1のイメージには、公開済みの npm パッケージがインストールされています。このリポジトリの独自ビルドを実行するには、Dockerfile(docker build -t seo-audit-console .)を使用してください。エントリーポイントは stdio サーバーの node dist/index.js です。
すべてのジョブは、データディレクトリ内の _jobs.db に記録されます。ジョブを実行中のプロセスが完了前に終了した場合、ジョブは消えずに理由とともに interrupted と表示され、完了したジョブの結果は再起動後も読み取れます。
ゲートウェイはサーバーコンテナーのポートを公開しないため、ジョブの後にサーバーが起動するブラウザーダッシュボードには、マシンからアクセスできません。サーバーは、ダッシュボードのポートが公開されていないコンテナー内で実行されていること(SAC_DASHBOARD_PORT と併せて SAC_DASHBOARD_BIND=0.0.0.0 が設定されていないこと)を検知し、リンクの代わりに、スタンドアロンダッシュボードを起動するコマンドを表示します。get_dashboard を使えばチャット内に引き続き表示できます。また、ブラウザーのタブで表示するには、スタンドアロンダッシュボード seo-audit-dashboard を、公開ポートを設定して同じデータボリューム上の2つ目のコンテナーとして実行できます。コマンドはdashboard.mdに記載されています。
ツール一覧
簡単にまとめたものです。各ツールの詳しい説明、入力項目、プロンプトの例はツールリファレンスを参照してください。
| ツール | 説明 |
|---|---|
refresh_property | GSC 同期、クロール、検査、順位履歴、CrUX フィールドデータを 1 つのジョブで同期します |
sync_gsc · start_crawl · inspect_urls · track_ranks · sync_crux | 個別の処理を単独で実行します(sync_crux:Chrome UX Report の実ユーザーによる Core Web Vitals。CRUX_API_KEY があれば無料で利用できます) |
check_sync_status · check_crawl_status | 時間のかかるジョブの進捗を確認します |
run_audit · query_audit · list_checks | スコア付き監査 · エビデンス付きの個別チェック · チェック一覧 |
query_data | 生テーブルに対する読み取り専用クエリです。データベース内で集計し、行ではなく回答を返します |
open_dashboard | プロパティのライブダッシュボードへのブラウザーリンクです。同期やクロールが完了すると、それぞれからリンクが提示されます |
probe_urls · triage_404s | 任意の URL をライブでテストします(リダイレクト、canonical、キャッシュ、大文字・小文字/スラッシュ/ホストのバリエーション) · 404 リストをリダイレクトマップにします |
fix_finding | そのまま貼り付けて使える修正案(JSON-LD / 301 / 内部リンク) |
detect_changes | 直近 2 回のクロール間で変更された内容を確認します |
check_agent_readiness | AI エージェント対応度を 0~100 で評価し、コピーして使える修正案を提示します |
list_templates · suggest_pages | テンプレートのクラスター · 実際の需要に基づく新規ページのアイデア |
score_passages · draft_content | ローカルでの関連性スコアリング · 根拠に基づくライティングブリーフ |
find_duplicates · render_pages | 意味的に重複する類似ページ(ローカルモデル) · ヘッドレス Chromium での Response と Render の比較(Playwright は任意) |
resolve_entities | Wikidata のエンティティと、それらの間にあるリンクの不足箇所 |
keyword_volume · related_terms · search_intent | DataForSEO のキーワードデータ |
youtube_discovery · news_discovery · topic_trend · trend_categories | コンテンツ調査:トピックで上位表示されている動画(文字起こしツールと併用) · 最近のニュース掲載状況/鮮度 · キーワード、カテゴリ全体、またはカテゴリ内の語句に関する Google Trends の期間別関心度(上昇/下降/季節性、ブレイクアウトしたトピックやクエリを含む) · Trends のカテゴリコードを無料で検索 |
competitors_domain · page_intersection · topic_gaps | 競合 · コンテンツギャップ · トピックギャップ |
domain_visibility · top_pages · ranked_keywords | 任意のドメインのオーガニック検索概要、上位ページ、順位付きキーワード(AI Overview が表示されるキーワードには aioOnly を指定できます) |
page_lighthouse · pull_backlinks | ラボでの CWV · リアルタイムのステータス付き被リンクプロファイル |
link_intersect | 競合にはあるが、自社にはないリンクを、優先順位を付けたアウトリーチリストとして表示します(フォローリンクを優先し、ドメインの信頼度順に並べます。Majestic Trust Flow で並べ替えると、ディレクトリ由来のノイズを抑えられます) |
market_sizing · serp_features | 指定した競合とのシェア・オブ・ボイス · ボリューム別の AI Overview/スニペット/動画の表示状況 |
keyword_list · content_opportunities | キーワードリストを分類します(自社が保有/弱い/不在) · コンテンツマーケター向けレポート |
recon_targets · save_recon_todo · recon_todos | コンテンツ調査: ページが順位を落としている理由(ライブ SERP + AI Overview)→ 追跡・注釈可能な ToDo ボード |
portfolio · refresh_portfolio · schedule_portfolio_refresh · get_portfolio | ポートフォリオ: 管理しているすべてのドメイン(保有中 + 監視中)を、実測値と推定値とともに 1 つの表に表示 · 更新(見積もりを先に提示) · 月間予算の上限を設定してスケジュール · チャットで表示 |
get_dashboard · serve_dashboard · export_report | チャット内ダッシュボード · 同じ内容をローカルのブラウザータブで表示 · 共有可能な HTML |
get_dashboard_data · get_portfolio_data · get_domain_overview | 内部用:ダッシュボードのウィジェットがこれらを通じてデータを取得します。直接使用しないでください |
composition_cookbook | 独自の分析に使うデータサーフェスのマップとレシピ |
data_storage | プロパティごとのディスク使用量と行数、確認後に実行するデータ削除、インデックス修復を伴う整合性チェック |
normalize_url · data_location · list_properties · seo_audit_help | ユーティリティとヘルプメニュー |
内部での仕組み
- 結合キー(
url_key)。 GSC のpageとクロールのurlは、同じキーに正規化されます。HTTPS を強制し、www と apex を統一し、トラッキング用のパラメーターを取り除くなどの処理を行います。すべての結合はこのキーを基準にしています。これが仕組みの要です。 - プロパティごとに SQLite データベースを1つ使用(WAL、プリペアドステートメント)。データはお使いのマシン内に保管されます。
- 一度スコアを付け、期待値で並べ替えます。
(expected clicks × yield × certainty) / effort。カバリングインデックスを使用しているため、GSC のテーブルが数百万行に達しても監査は高速です。 - 履歴を大切に扱います。 クロールや同期では、新しいデータが届き始めるまで以前のスナップショットを削除しません。クロール中にサイトが停止しても、データが失われることはありません。
- 所有サイトのみを対象とし、修正はドライランで実行します。 ご自身が管理するサイトをクロールし、ジェネレーターは成果物を生成します。サイトに書き込むことはありません。ここだけは譲れない一線です。
プライバシーとデータ
Search Console のデータとクロールデータは、SAC_DATA_DIR 内のローカル SQLite ファイルに保存されます。パッセージスコアリングモデルもローカルで動作します。マシンの外部に送信されるのは、お客様が実行する API 呼び出しだけです。Google(ご自身の GSC と、CRUX_API_KEY を設定している場合は Chrome UX Report。オリジンとトップページの URL が送信されます)、および設定している場合は DataForSEO と Majestic(link_intersect は見込み客のドメイン名を送信し、pull_backlinks はご自身の被リンクページ URL を送信します)が対象です。これらはすべてお客様のキーを使い、要求に応じて呼び出され、同じ呼び出しが繰り返されないようローカルにキャッシュされます。コンテンツ調査での競合サイト取得では、仲介サービスを介さず、公開ページに直接リクエストします。クロールでは、ご自身のサイト以外にもアクセスする場合が1つあります。各クロールの後、ページに含まれる外部リンクを確認します(リンク先 URL ごとに HEAD リクエスト、または範囲を指定した GET リクエストを送信します。checkExternal:false で無効にできます)。また、無料の追加機能は公開ソースからデータを取得します。ローカルモデルは Hugging Face から一度だけダウンロードされ、resolve_entities は Wikidata にクエリを送り、news_discovery は Google News フィードを読み込みます。テレメトリーはありません。一切ありません。
今後の予定
現在、以下の機能をおおよそこの順番で開発しています。
- テンプレート別の構造化データの機会。 「スキーマがありません」(最近のストアの多くは十分なスキーマを備えています)ではなく、「このテンプレートならレビューの星評価や FAQ のリッチリザルトを獲得できるのに、対応していません」といった提案です。
- ページごとのコンテンツスコアカード。 上位のクエリだけでなく、コンテンツに不足しているすべてのランキング対象フレーズを一覧にする専用テーブルです。
- エージェント対応の拡充。 WebMCP に関するアドバイザリー(サイトがエージェントに公開できるツールアクション)と、エージェントコマースのプロトコルです。
- 印刷可能なレポート。 スライド資料ではなく、クライアントに渡せる正式な A4 文書です。
- ソースレベルのパーサーチェック。 多くのツールが手を付けないレイヤーです。
<head>の解析を気付かれないまま壊す要素や、本文へ移動されて無視されるディレクティブを検出します。(raw と rendered の差異の検出はすでに利用できます。上記の JavaScript レンダリングをご覧ください。)
ツールに検出してほしい、変わったエッジケースはありますか?ぜひ教えてください。GSC とクロールを組み合わせたチェックも、まさにそのようにして生まれました。
Houtini について
Houtini の目的はただ1つ、チームが単純作業に費やしている時間を取り戻すことです。Search Console のエクスポート、クロールの実行、スプレッドシートの相互照合、先月からの変更点の再確認。どれも人が行う必要はありませんが、戦略、クライアント、成果につながる業務に使うべき時間を奪っています。そこで、私たちはまさにその作業を自動化します。SEO Audit Console は、同じ理念に基づいて開発されたツール群の1つです。機械がデータを収集し、統合し、チェックできるなら、機械が行うべきです。
ご質問、ライセンスに関するお問い合わせ、自動化したい作業などは、こちらまでご連絡ください:[email protected]
クレジット
SEO Audit Console は、いくつかのサードパーティサービスを利用しています。ご自身の Search Console へのアクセスを除き、すべて任意で、各サービスはお客様自身が用意したキーを使ってのみ呼び出されます。
- Google Search Console - ご自身の検索パフォーマンスの履歴(必須の認証情報はこれだけです)。
- DataForSEO - SERP、キーワード、Labs、バックリンクのデータ:キーワードの検索ボリューム、競合サイトの実績、順位履歴、および
link_intersectのドメイン重複データです。従量課金制で、任意です。 - Majestic -
link_intersectの拡張機能で Trust Flow と Topical Trust Flow を提供し、実際の編集上の権威性に基づいてリンク候補を並べ替えます。Trust Flow と Topical Trust Flow は Majestic(Majestic-12 Ltd)の商標です。任意です。プランページでキーを取得してください。
better-sqlite3、cheerio、Apache ECharts、およびデバイス上で文章をスコアリングするローカルの ms-marco cross-encoder(Transformers.js経由)を使って構築されています。この処理でお使いのマシンからデータが外部に送信されることはありません。
コントリビューション
Issue や PR を歓迎します。チェックレジストリ(src/audit/checks.ts)は拡張しやすいように設計されています。各チェックは結合済みデータを読み取るだけの純粋な処理で、根拠を含む検出結果を返すため、チェックの追加は比較的独立して行えます。エンドツーエンドのスモークテスト(npm run smoke)と機能ごとのプローブ(npm run probe:*)を用意しているので、変更が適切か確認できます。PR を提出すると、コントリビューションがプロジェクトの LICENSE(Apache-2.0)の条件に基づいてライセンスされることに同意したものとみなされます。
ライセンス
Apache License 2.0。 商用利用を含め、自由に使用、変更、再配布できます。詳細な条件については LICENSE をご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。