claude-real-video について
claude-real-video(crv)は、動画をシーン変化に基づくキーフレームとタイムスタンプ付きの文字起こしに変換し、任意の LLM が読める形で出力するローカル動画処理ツールです。LLM に動画の内容を分析させたいユーザーに向いています。固定間隔のサンプリングと異なり、シーンが変化した場面を残し、ほぼ同じフレームを除去します。
主な機能
- 01シーン変化に基づくキーフレーム抽出と重複除去
- 02タイムスタンプ付きの Whisper 音声文字起こし(任意)
- 03yt-dlp による URL 入力とローカルファイル入力への対応
- 04--from / --to による時間範囲の指定
- 05--adaptive と --text-anchors などの抽出モード
- 06MANIFEST.txt とローカル viewer.html の出力
活用シーン
- 01Claude や他の LLM に動画の内容を分析させる
- 02長い会議や録画の特定区間を分析する
- 03汎用の動画キーフレーム抽出ツールとして利用する
MCP 対応
本プロジェクトはエージェントスキルおよびコマンドラインツールとして提供されており、README には MCP サーバーや MCP インターフェースについての記載はありません。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
claude-real-video


▶ 100秒のデモ: ChatGPT と Gemini は動画を見られますが、Claude は見られません。crv が動画をフレームとタイムスタンプ付きの文字起こしに変換すると、Claude はどんな回答をするのでしょうか。
▶ 60秒のピクセル映像 — 音声あり(GitHub の mp4) · AI エージェントが「LLM は動画を本当に理解するにはどうすればよいか?」と検索し、鍵を見つけて、視覚を解き放ちます。
60秒の実際のデモ — 実際のインストール、実際の実行、実際のビューアー。
Claude — またはあらゆる LLM — に動画を実際に見せましょう。
pip install "claude-real-video[whisper]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video   # one command, installs the skill into Claude Code, Cursor, Codex, Copilot, Gemini CLI & 50+ agent hosts
Claude Code プラグインマーケットプレイス(自動更新を有効にする場合は、/plugin → Marketplaces で設定してください):
/plugin marketplace add HUANGCHIHHUNGLeo/claude-real-video
/plugin install claude-real-video@claude-real-video
あとは動画のリンクをエージェントに貼り付けて、質問してください。(CLI のみで使う場合は、crv "<url>" を実行するだけです。pip でインストールすれば使えます。)
名称について: crv は claude-real-video(PyPI パッケージ)の略称です。有料アドオンの crv Pro は、Capafy で「llm-real-video Pro」という名称で販売されています。
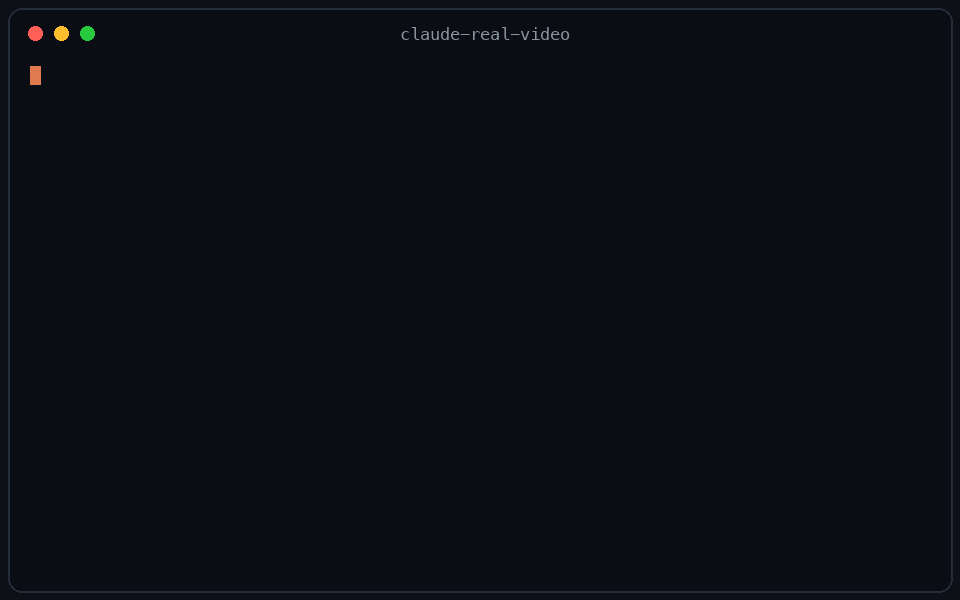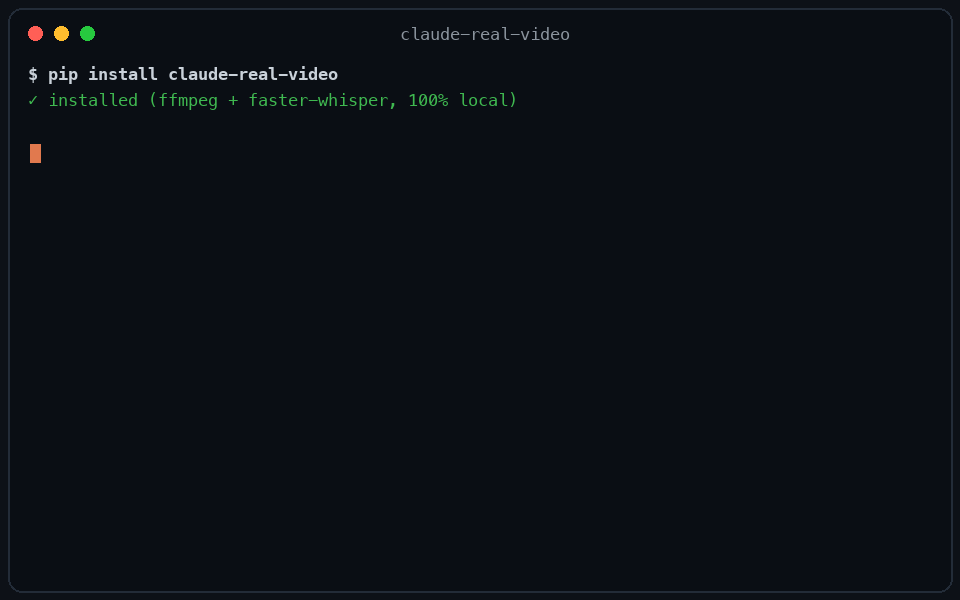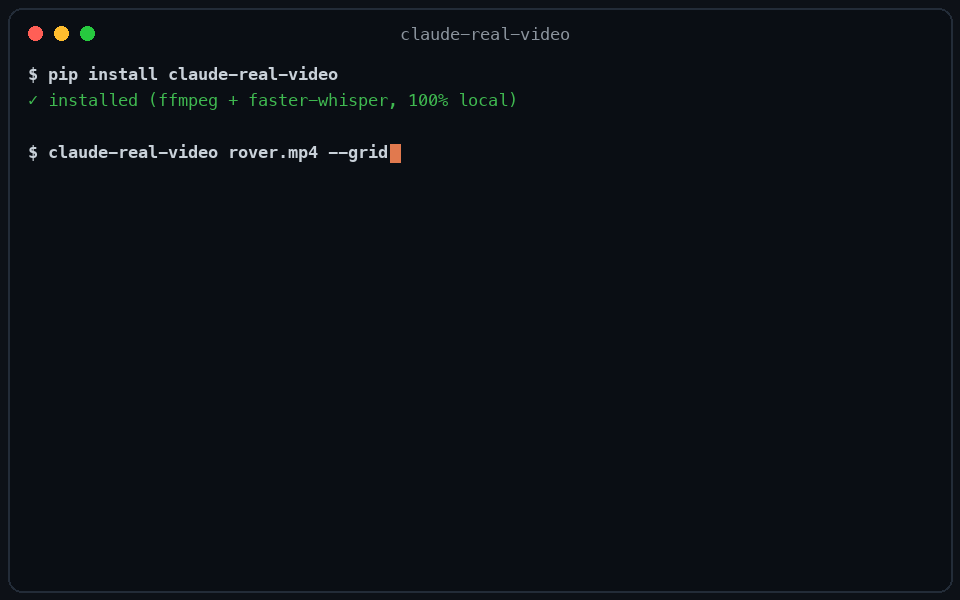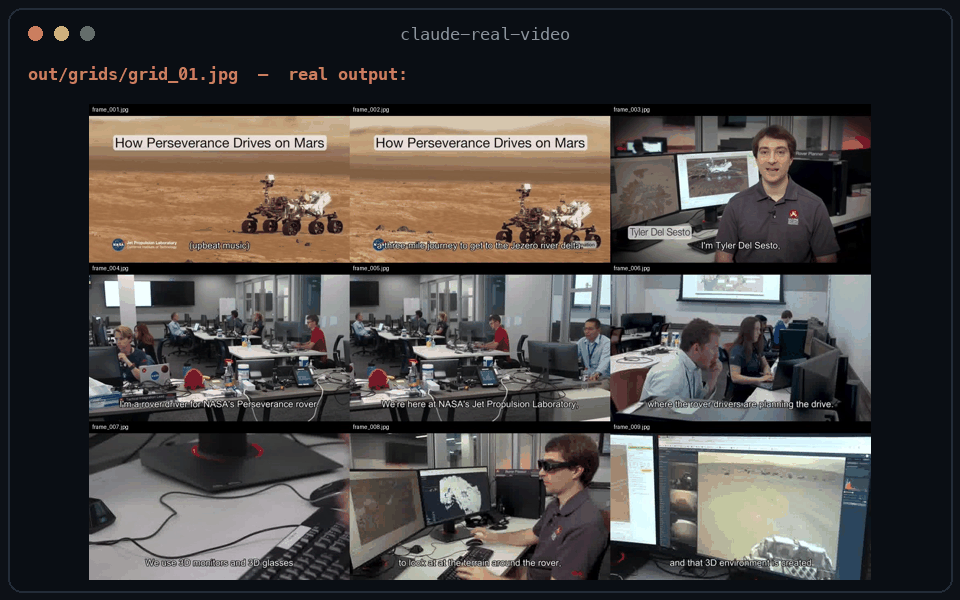
▶ 新作:40秒の映像 — AI エージェントが動画を見ることを学んだ(そして動かなくなった)
同じ58秒のクリップ:1 fps で固定サンプリングすると 58フレーム。crv はそのうち実際に異なる 26フレーム を残し、
--gridで 3つのコンタクトシート にまとめます。トークンを節約し、見落としを防ぎます。
この無料版では、AI が動画を 見る ことができます。 crv Pro では、動画を 理解 できるようになります。撮影方法(カットのリズム、カメラの動き)に加え、フレームからは分からない情報をタイムスタンプ付きのタイムラインで確認できます。ジェスチャー、表情、声の高さの変化、感情、音のイベントなどです。価格は一度限りの $29 — Capafy で入手するか、Lemon Squeezy でカード決済してください。
Codex CLI をお使いですか? ▶ 36秒のデモ · Real Video for Codex は、Codex 向けに独立して動作するビルドです。Codex に動画について質問すると、1つのコマンドを実行し、チャプター、タイムコード付きの文字起こし、そして無料版では含まれない 画面上のテキスト を記載した
SUMMARY.mdを読み込みます。そのため、話者の説明だけでなく、12:40 にスライドに表示されていた設定ブロックを引用でき、hh:mm:ss形式で回答します。ダウンロード、フレーム抽出、文字起こし、テキスト認識はすべてお使いのマシン上で実行され、このツール自体に API キーもアカウントも必要ありません。Codex スキルと、自己診断用のcrv-easy doctorが付属します。Python 3.10~3.14 に対応し、macOS または Windows 11 でネイティブに動作します。価格は一度限りの $9.90:Capafy で入手するか、Lemon Squeezy でカード決済してください。 ほとんどの AI ツールは、動画を実際に 見て いるわけではありません。YouTube のリンクを ChatGPT に貼り付けても、画像ではなく文字起こしを読み取ります。Claude は動画ファイルを受け付けません。動画をネイティブに読み取れる Gemini でさえ、動画を Google に送信して固定間隔(デフォルトでは 1 fps)でフレームをサンプリングするため、素早いカットを見逃します。
claude-real-video は異なる方法で処理し、処理はローカルで実行されます。URL またはファイルを指定すると、実際に 重要な フレーム(固定数ではなく、シーンが変わるたび)を抽出し、ほぼ同じフレームを取り除き、音声を文字起こしして、どの LLM でも読み取れる整ったフォルダーを作成します。すべての処理はお使いのマシン上で行われます。外部に送信されるのは、その後 LLM に貼り付けるよう あなたが 選んだフレームやテキストだけです。
crv "https://www.youtube.com/watch?v=..."
# → crv-out/frames/*.jpg  +  frames.json (per-frame timestamps)  +  transcript.txt/.json  +  MANIFEST.txt
その後、フレームと MANIFEST.txt を Claude/ChatGPT/Gemini に渡して、自由に質問できます。
ターミナルは不要です — crv-web を実行するとローカルページが開きます(繁体字中国語/簡体字中国語/英語)。YouTube または Reels のリンク、あるいはファイルパスを貼り付けて、「Analyze」をクリックし、結果ビューアーを開きます。動画の分析と出力の生成はお使いのマシン上で実行され、元の動画がアップロードされることはありません。(その後、抽出したフレームや文字起こしをクラウド LLM に貼り付けると、そのデータは提供元に送信されます。)
モデルが見る内容を先に確認したい場合は、--viewer を追加してください。ローカルの viewer.html(動画+キーフレームのグリッド+文字起こし)が作成され、ダブルクリックで開けます。ネットワーク接続も追加インストールも不要です。
動画の一部だけが重要な場合(90 分の通話に含まれる 10 分間の画面共有など):--from 28:00 --to 43:00。ffmpeg はファイル全体をデコードせずにシークし、Whisper は指定範囲のみを処理します。また、フレーム予算もその範囲内で使われます。ただし、crv が報告するすべてのタイムスタンプは、同僚に伝えられる元動画のタイムコードです。
意味を持つのが小さな文字の場合(ターミナル、スプレッドシート、IDE など):--frame-width 1600。フレームの 選択 が難しい部分であり、crv はすでにそれを行います。1920 ピクセル幅の画面録画を 640px で処理すると、適切な場面が見つかっても、見つける価値があった細部が失われてしまいます。
ゆっくり変化するコンテンツ(アニメーションのチュートリアル、徐々に変形する映像、ゆっくりしたパンなど):--adaptive を追加してください。固定しきい値ではなく、前後のフレームとの移動範囲を基準にフレームを選ぶため、単一のフレームでは変化が急激に現れない 2~3 秒のスクワッシュ&ストレッチも捉えられます。
文字の多いコンテンツ(講義スライド、画面録画、トークヘッド形式の解説など):--text-anchors を追加してください。字幕キューのタイムスタンプに追加フレームを強制的に設定するため、シーンがほとんど変化しなくても、各発話に対応する映像が得られます。サイドカーの .srt/.vtt または埋め込み字幕トラックが必要です。映像に焼き付けられた字幕は検出できません。強制されるフレームは最大で 1 秒あたり 1 枚です。シーン検出には影響しません。
複数の話者が登場するコンテンツ(インタビュー、ポッドキャスト、会議など):--speakers を追加してください。文字起こしの各行に話者ラベル([SPEAKER_00]、[SPEAKER_01]、…)が付くため、モデルは誰が何を話したかを把握できます。ローカルの話者ダイアライゼーションモデルを実行します(45 MB、ダウンロードは初回のみ、アカウントやトークンは不要です)。pip install "claude-real-video[speakers]" でインストールしてください。
LLM の処理を行わない場合も、汎用動画キーフレーム抽出ツールとして利用できます — シーン変化の検出と重複排除を行い、ダウンロードが必要な ML モデルはありません。
Claude Code、またはその他のコーディングエージェントをお使いですか? 1 つのコマンドでスキルをインストールできます (Claude Code、Cursor、Codex、Copilot、Gemini CLI、その他の agentskills.io 互換ホストで動作します)。
pip install "claude-real-video[whisper]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video
あとは、動画のリンクをエージェントに貼り付けて質問するだけです。
手動インストール(クローン+コピー)
git clone https://github.com/HUANGCHIHHUNGLeo/claude-real-video.git
mkdir -p ~/.claude/skills && cp -r claude-real-video/skills/claude-real-video ~/.claude/skills/
視聴する 理由 を伝え、見つかった内容を保存しましょう:
crv "https://youtu.be/..." --why "find the pricing strategy" --kb ~/notes
--why を使うと、一般的な要約ではなく、関心のある内容に焦点を当てて分析します。
--kb を使うと、結果が自分のノートフォルダーに日付付きのメモとして保存されるため、crv-out の中で埋もれません。
0.10.x の新機能 — 重要な部分だけを分析できます:
crv long-meeting.mp4 --from 28:00 --to 43:00
--from/--to を指定すると、長い動画から一部の区間を切り出せます。ffmpeg はファイル全体をデコードせずにシークし、トランスクリプトとフレーム数の上限もその区間に合わせます。報告されるタイムスタンプはすべて元動画のタイムコードなので、元動画を引用する際にもそのまま使えます。
実測値
3 分の 640x360 動画(benchmark/jfk-rice.mp4)を Mac mini M4 のローカル CPU で実行した実測値です。フレーム抽出と重複排除のみを行い(--no-transcribe)、画像トークン数は Anthropic の (width x height) / 750 で推定しています。640x360 の場合、1 フレームあたり 307 トークンです。
| モード | 保持したフレーム数 | 実行時間 | 推定画像トークン数 |
|---|---|---|---|
| デフォルト(シーン変化+1 秒の下限) | 170(180 枚から抽出) | 23.5 秒 | 約 52k |
--max-frames 80 | 80 | 23.4 秒 | 約 25k |
--adaptive(ゆっくりした変化も検出) | 270 | 36.8 秒 | 約 83k |
Dedup v0.7.16 — 小さな被写体の高速な動きが見逃されなくなりました。 割合ベースの比較では、フレームの 1% 未満しか占めない被写体は構造的に検出できません(画素の 8% を変化させることはできないためです)。ユーザーによる動画 2,181 本の一括実行で問題が見つかり、3 つ目の「アクションチャンネル」を追加して修正しました。再現用の合成例 — 静止した 1280x720 の映像内で、40x90 px の被写体(フレームの 0.4%)が 65 フレーム中最後の 10 フレームだけで高速に移動します。
| 保持したフレーム数 | 動きを捉えたフレーム数 | |
|---|---|---|
| v0.7.15 | 2 | 10 枚中 1 枚 |
| v0.7.16 | 11 | 10 枚中 10 枚 — 軌跡全体を捉えます |
なぜ単にフレームをサンプリングしないのですか?
「LLM に動画を見せる」スクリプトの多く(Gemini 独自のパイプラインも含む)は、一定間隔でフレームを取得します。たとえば 1 秒に 1 枚です。そのため、静止した画面録画は過剰にサンプリングされ、高速なカットが続く動画はサンプリング不足になります。claude-real-video はより賢く処理します。
| 一定間隔のサンプリング | claude-real-video | |
|---|---|---|
| フレームの選択 | N 秒ごと | シーン変化の検出+密度の下限 |
| 繰り返しのショット(A-B-A カット) | 毎回再送信 | スライディングウィンドウ方式の重複排除により、各ショットを 1 回だけ送信 |
| 静止したスライド(10 分) | ほぼ同一のフレーム約 600 枚 | 1 枚にまとめます(重複排除) |
| 高速なカットが続く動画 | サンプル間のフレームを見逃す | 視覚的な変化をそれぞれ捉えます |
| 音声 | 無視されることが多い | 言語を検出する Whisper のトランスクリプト |
| 処理を行う場所 | 他者のクラウドで行われることが多い | お使いのマシン上(その後、LLM と共有する内容を自分で選べます) |
| 入力 | 通常はローカルファイルのみ | URL(yt-dlp)またはローカルファイル |
モデルには、より少数で意味のあるフレームを入力できます。コンテキストのコストを抑えながら、理解を深められます。
インストール
pip install "claude-real-video[whisper]"   # recommended: frames + dedup + audio transcription
pip install claude-real-video              # core only (frames + dedup)
pip の追加機能は自動ではインストールされません。[whisper] がないと、音声からテキストへの変換は行われません(字幕が付属する動画では、引き続きトランスクリプトを取得できます)。
システム要件:ffmpeg
ffmpeg / ffprobe はフレームの抽出と音声に使用され、pip ではインストールできません。一度インストールしてください。
| OS | コマンド |
|---|---|
| macOS | brew install ffmpeg |
| Linux | sudo apt install ffmpeg(またはお使いのディストリビューションのパッケージマネージャー) |
| Windows | winget install Gyan.FFmpeg — または choco install ffmpeg — またはビルドをダウンロードして、その bin\ フォルダーを PATH に追加します |
PATH に追加されていることを確認してください。
ffmpeg -version
文字起こしには whisper CLI([whisper] エクストラでインストールするか、pip install openai-whisper でインストール)を使用します。Whisper も ffmpeg に依存しています。
より高速で、幻覚のない文字起こし(推奨): [fast] エクストラをインストールすると、crv は自動的に faster-whisper に切り替わります。同じモデル、同じ出力ファイルのまま、数倍高速になります。また、Silero VAD(音声アクティビティ検出)で判定するため、音楽のみ、または無音の音声では、Whisper にありがちな架空の字幕ではなく、「音声なし」と正しく記録します。新しいフラグを覚える必要はありません。
pip install 'claude-real-video[fast]'
両方がインストールされている場合は faster-whisper が優先されます。faster-whisper が失敗しても、crv は自動的に whisper CLI にフォールバックします。
Apple Silicon(M1–M4):GPU での文字起こし。 [mlx] エクストラをインストールすると、crv は mlx-whisper を通じて Mac の GPU 上で Whisper を実行します。faster-whisper で約 6 分かかる 21 分の講演が、同じ文字起こし結果のまま、M4 では約 1 分で完了します。最初に Silero VAD で判定するため、音楽や無音が架空の字幕になることはありません。判定処理または mlx を実行できない場合、crv は faster-whisper、次に CLI へとフォールバックします。 @blazejp83 による貢献(#28)。
pip install 'claude-real-video[mlx]'
macOS、Windows、Linux で動作します — Python 3.10 以降。
使い方
# A YouTube / Instagram / TikTok / ... link
crv "https://www.instagram.com/reel/XXXX/"

# A local file, English transcript, output to ./out
crv lecture.mp4 -o out --lang en

# Frames only, no transcription
crv clip.mp4 --no-transcribe

# A login-gated video (your own / authorised use): pass a Netscape cookie file
crv "https://..." --cookies cookies.txt
python -m claude_real_video ... も crv の別名として使用できます。
オプション
| フラグ | デフォルト | 意味 |
|---|---|---|
-o, --out | crv-out | 出力ディレクトリ |
--overwrite | オフ | 出力ディレクトリにある以前の解析結果を置き換えます(これを指定しない場合、動画が混在しないよう、空でない出力ディレクトリへの書き込みは拒否されます) |
--scene | 0.30 | シーン変化の感度(値が小さいほどフレーム数が増えます) |
--fps-floor | 1.0 | N 秒ごとに少なくとも 1 フレームを取得します |
--from / --to | ファイル全体 | 動画の一部だけを解析します(90、1:30、0:01:30.5)。報告されるタイムスタンプはソースのタイムコードのままです。ウィンドウによって解析範囲は変わりますが、時刻は変わりません。また、フレーム数の上限と文字起こしの対象はファイル全体ではなくウィンドウに従います |
--frame-width | 640 | 抽出フレームの幅。アスペクト比は維持されます。意味が小さな文字(ターミナル、スプレッドシート、情報量の多いダッシュボード)にある場合は大きくしてください。フレームが大きいほど、出力サイズとモデルのコストが増えます |
--max-frames | 自動:clamp(150, window×1.5, 600) | フレーム総数の上限(明示的な値が常に優先されます) |
--adaptive | オフ | 適応型のシーン検出です。各フレームを前後のフレームと比較することで、固定しきい値では見逃すゆっくりした変化(2~3 秒のスクワッシュ/ストレッチ、徐々に移動するパン)を検出します |
--text-anchors | オフ | 字幕キューのタイムスタンプ(サイドカーの .srt/.vtt または埋め込みトラック)に追加フレームを強制的に設定します。ピクセルより速く意味が変わる動画向けです。強制フレームは最大で 1 秒につき 1 枚です |
--speakers | オフ | ローカルの話者ダイアライゼーションを使って、文字起こしの各行に話者([SPEAKER_00] …)を付けます。pip install "claude-real-video[speakers]" が必要です。45 MB のモデルが一度ダウンロードされます |
--lang | auto | Whisper の言語(en、zh、auto、...) |
--whisper-model | base | 文字起こしに使う Whisper モデル(tiny/base/small/medium/large/turbo — base は高速です。より高精度な文字起こしをお求めですか? --whisper-model turbo を追加するだけです。枝刈りされた large-v3 で、品質をわずかに犠牲にして large より大幅に高速です。初回に 1.6GB をダウンロードし、メモリを約 6GB 使用します) |
--dedup-threshold | 8 | フレームを新規として扱うために変化が必要なピクセルの割合(値が大きいほどフレーム数が減ります。安定化ローカル検出器のしきい値もこれに応じて変わります) |
--dedup-window | 4 | 直近に保持した N フレームと比較します。モデルがすでに見たショットは、別の映像を挟んでも再び現れません(1 = 連続フレームのみ) |
--report | オフ | 除外されたフレームを ./dropped に保存し、すべての採用/除外判断を視覚化した report.html を書き出します |
--no-transcribe | オフ | 音声をスキップします |
--keep-audio | オフ | 音声モデルが聴けるように、サウンドトラック全体(audio.m4a)も保存します |
--viewer | オフ | viewer.html も書き出します。1 つのローカルページで動画、キーフレーム、文字起こしを閲覧できます(ダブルクリックで開きます) |
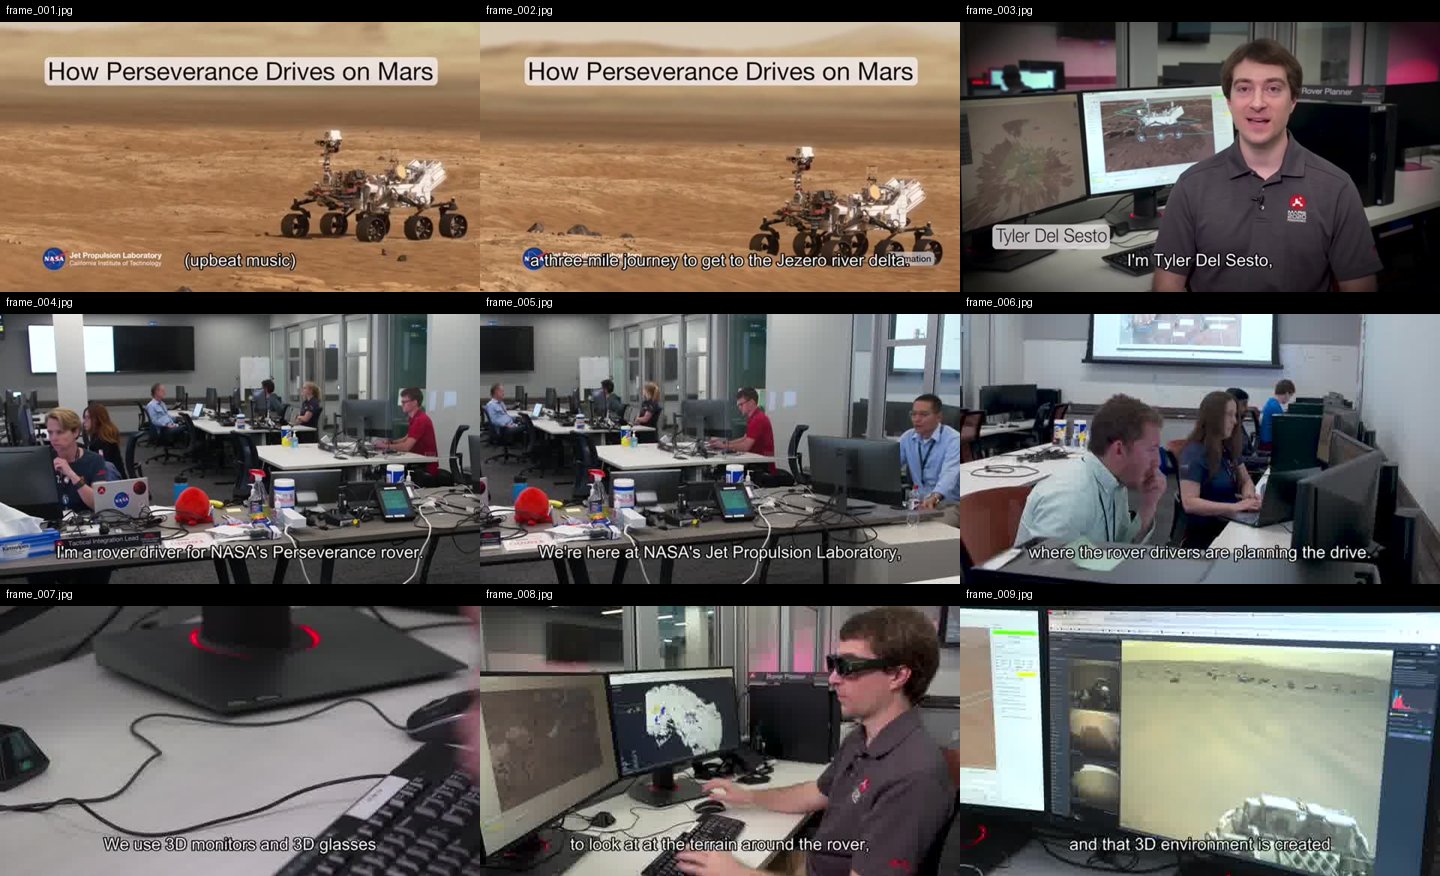
--grid | オフ | 保持したフレームを 3x3 のコンタクトシート(./grids)に並べて出力します。連続したフレームを並べると、モデルが動きや進行を追いやすくなります |
--why | – | 動画を見る目的です。例:--why "find the pricing strategy"。MANIFEST.txt に記録されるため、モデルは一般的な要約ではなく、その視点から解析します |
--kb | – | 解析結果を日付付きの Markdown ノートとしてこのフォルダー(Obsidian の保管庫、ノート用ディレクトリなど)にも保存します。crv-out の中で埋もれることなく、ナレッジベースに追加できます |
--cookies | – | ログインが必要なソース用の Netscape クッキーファイル |
--cookies-from-browser | – | chrome、safari、firefox、edge のいずれかを指定し、自分のブラウザーからログイン用クッキーを直接読み込みます(自分のアカウントでのみ使用してください) |
--grid の出力例
1 枚のコンタクトシートには、連続する 9 枚のキーフレームが順番に並び、各セルにファイル名が表示されます。モデルは、ばらばらの静止画ではなく、一連の流れを読み取ります。
メモリー — 視聴したすべての動画について質問する
すべての分析結果はローカルでインデックス化されるため(文字起こしの行と画面上のテキストをタイムスタンプ付きで保存)、出力フォルダーひとつに限らず、ライブラリー全体を対象に質問できます:
crv-ask "pricing strategy"   # → which video, which second, the exact line
crv-ask 定價                  # CJK works — trigram FTS with a substring fallback
crv-ask --list               # everything you've watched, newest first
crv-ask --stats              # where the index lives, how big it is
crv-ask --prune 200          # keep the newest 200 videos, reclaim the space
同じソースを同じオプションで再実行しても、再処理は行われません。crv は「視聴済み」と表示し、既存の分析結果を示します(計測では 0.04 秒で、数秒かかる処理より高速でした)。オプションを変更した場合や --overwrite を指定した場合は、通常どおり再分析されます。
すべてのデータはローカルに保存されます。SQLite ファイルは ~/.crv/memory.db ひとつだけです(CRV_MEMORY_DB で変更できます)。権限はユーザーのみに限定され、埋め込みもネットワーク通信もありません。初めて何かがインデックス化されると、crv はその旨を示す1行を表示します。まったく使いたくない場合は、CRV_NO_MEMORY=1 を設定してください。
MCP サーバー(Claude Desktop/Cursor/任意の MCP クライアント)
crv は MCP サーバーとしても動作するため、MCP クライアントから動画を直接視聴するように依頼できます。同じローカルパイプラインを使用し、クラウドは一切使いません。ツールは5つあります。watch_video、get_frames、search_memory(視聴済みのすべての動画を対象に質問)、list_watched(再視聴の前に確認)、get_transcript(単語のみ。フレームは含まれないため、長い講演でも画像トークンを消費しません)。
pip install 'claude-real-video[mcp]'
Claude Code:
claude mcp add crv -- crv-mcp
Claude Desktop — claude_desktop_config.json に追加します:
{ "mcpServers": { "crv": { "command": "crv-mcp" } } }
ツール:watch_video(source, max_frames, language, transcribe) は、タイムスタンプ付きの文字起こしと最初のバッチのキーフレーム画像を返します。get_frames(source, start_index, count) は、残りのフレームをページごとに取得します。分析結果は ~/.cache/crv-mcp にキャッシュされるため、同じ動画について追加で質問する際はすぐに応答できます。
mcp-name: io.github.HUANGCHIHHUNGLeo/claude-real-video
Claude Code でエンドツーエンドの動作を検証済みです(モデルはツールを通じてテスト動画のフレームを正しく説明しました)。Claude Desktop と Cursor は同じ MCP stdio プロトコルを使用します。設定は上記のとおりです。問題が発生した場合は、issue を作成してください。
Python から使用する
from claude_real_video import process

r = process("https://youtu.be/...", "out", lang="en")
print(r.frame_count, r.transcript_path)
仕組み
- 取得 — URL の場合は
yt-dlpを使用します(Cookie は任意)。ローカルファイルの場合はコピーします。 - 抽出 — 1 回の時系列
ffmpeg selectパスで、すべてのシーンチェンジに加えて密度の下限(--fps-floor秒ごとに最低 1 フレーム)を確保するため、高速なカットもゆっくりした画面収録もカバーできます。 - 重複排除 — 直近の
--dedup-window枚の保持フレームを対象に、3 つのチャンネルで判定します。これにより、A-B-A のカットアウェイでも、モデルがすでに見たショットを再送信しません。グローバルチャンネルは実際のピクセル差分を測定します(知覚ハッシュではなく、縮小した RGB を使用します。ハッシュは単色や輝度が等しい色相の変化を判別できないためです)。--dedup-thresholdは、変化が必要な割合です。安定ローカルチャンネル(v0.7.4)は、グローバルチャンネルでは検出できないものを捉えます。細いペンのストローク、字幕やテキストカードの切り替わり、全体では約 0%の差分に平均化される小さな UI 更新などです。より細かなシグネチャを使って、直近に保持されたすべてのフレームと大きく異なる領域(1px のずれを許容し、フィルムグレインやフレームの揺れには反応しません)があり、かつ変化が収まっている状態を探します。つまり、動きの途中ではなく、新たに安定した状態を検出します。また、クールダウンを設けているため、毎秒一時停止するような継続的な動き(なびく旗、漂う煙など)が繰り返し検出されることはありません。動画の終了時の状態が失われないよう、最後のフレームはまだ動いていても評価されますが、ほかのフレームと同様に両方のコントラスト条件を満たす必要があります。--reportを指定すると、調整用に、差分率とともに各フレームの保持・除外判定(安定ローカルで保持されたフレームにはラベルが付きます)を示すreport.htmlが出力されます。 - テキスト — 動画にすでに字幕がある場合(ローカルファイルの隣にある
.srt/.vttのサイドカーファイル、または埋め込み字幕トラック)は、それをトランスクリプトとして使用します。再文字起こしより高速で正確です。字幕がない場合に限り、音声に対してWhisperを使用します(音声がない場合は問題なくスキップされます)。 - 音声(任意、
--keep-audio)— 元のサウンドトラック全体(audio.m4a:音楽+音声+効果音。可能な場合はロスレスでコピー)を保存します。トランスクリプトに含まれるのは言葉だけですが、音声ファイルがあれば、音声を聴けるモデル(Gemini、GPT-4o、…)が音楽や声のトーンを実際に聴くことができます。 - タイムスタンプ — 保持された各フレームの元動画での時刻は、抽出 → 重複排除 →
--max-framesによる間引き → 名前変更の全パイプラインを通じて保持され、frames.json(file/timestamp_sec/timestamp/selection_reason)に書き込まれます。視覚的な根拠をframe_012 @ 00:03:41のように引用したり、フレームをtranscript.jsonのセグメントと照合したり、マップを動画 RAG パイプラインに渡したりできます。viewer.htmlでは、任意のキーフレームをクリックして「ここから動画を再生」を選べます。 - マニフェスト —
MANIFEST.txtにモデル向けの情報がすべて要約されます。
これにより、モデルは動画を見て(キーフレーム)、読んで(トランスクリプト)、さらに --keep-audio を指定すれば動画の音声全体を聴くことができます。トランスクリプトはどのモデルでも読めるプレーンテキストです。このツールは字幕を動画に焼き付けません。字幕の焼き付けは表示上の選択であり、動画を AI が読み取れるようにするために必要なことではありません。
注意事項
- 権利を持つコンテンツのみをダウンロードしてください。
--cookiesオプションは、ご自身が認証済みでアクセスできるコンテンツ向けです。リポジトリに認証情報を含めないでください。 - 動画ごとに出力フォルダーを 1 つ使用してください。すでに解析結果が含まれているフォルダーへの再実行は拒否されます(2 つの動画が混在するのを防ぐためです)。置き換える場合は
--overwriteを渡してください。
crv Pro — 動画がどのように撮影されたかを理解する
無料ツールでは、AI にキーフレームと文字起こしを提供します。動画の内容を知るには十分です。**crv Pro は、それ以外のすべてを追加します。撮影方法、編集方法、話し方、そして動画から受ける印象です。**すべてお使いのマシン上で計算され、どの LLM でも読めるプレーンテキストとして出力されます。
- カメラとテンポ(
--motion) — 各ショットに、静止、パン、チルト、ズーム、手持ちなどのラベルを自動付与します。ショットごとの長さ、1 分あたりのカット数、冒頭・中盤・終盤のテンポをまとめたショット一覧を生成します。動きの多いショットでは、0.2 秒間隔の連続フレームを取得します。 - サウンドと感情(
--senses) — 声の感情、トーンの推移、音声イベント(笑い声、SFX、環境音)をセグメントごとにタイムスタンプ付きで記録します。ボーカルと音楽は自動で分離されます。感情分析にはクリアな音声を使い、音楽には独自の BPM とエネルギーのトラックを付与します。会話のない映像(MV、映画)では、色や光からムードを読み取ります。 - インタラクティブビューアー(
--viewer) — 分析ごとに、動画、クリックすると該当時点に移動するイベントタイムライン、再生に合わせてハイライトされる文字起こしを含む、単独で動作するウェブページを生成します。英語/繁體中文/简体中文に対応しています。 - 2 つのレポートを 1 つのフラグで(
--ai-report) — ご自身の API キーを使って、撮影方法に関するレポートと、内容に関するレポートを生成します。 - 分析レポート(
--breakdown) — フック分析、テンポの推移、カメラワーク、そしてご自身の LLM が詳細な分析を完成させるための評価基準を生成します。 - ライブラリ全体にわたる記憶(
crv-pro-ask) — Pro が分析したすべての動画を、カメラや音声の特徴から検索できます。--camera zoom(これまでに分析したすべてのズーム)、--track emotion --label angry、--rhythm(カット数/分のランキング)を使えます。無料版のcrv-askは単語を検索しますが、こちらでは無料版が取得しない測定値を検索できます。
買い切り価格 $29:
- Capafy で購入(即時ダウンロード、ライセンスキー付き):https://capafy.ai/agent/llm-real-video-pro-let-any-llm-watch-videos/5451082151
- クレジットカードで購入(Lemon Squeezy のチェックアウト、即時ダウンロード):https://leoaido.lemonsqueezy.com/checkout/buy/ff552000-adc0-49f1-8eec-5e8ada1905a1
- 製品ページとデモ:https://leoaido.com/crv-pro/
開発の様子を追っていますか? オープンソースツールから初めての有料顧客までの道のりを、公開しながら記録しています — X の @LeoAidoAI。
FAQ
LLM に動画を見せたり分析させたりするには、どのツールが最適ですか?
「見る」が何を意味するかによります。1 本のクリップについて回答を 1 つ得られればよく、アップロードしても構わない場合は、ホスト型のマルチモーダルモデル(例:Gemini)が最短の方法です。Claude、GPT、Gemini、ローカルモデルなど、どの LLM でも動画を再現可能な形で、ローカルに分析させたい場合は、シーンを考慮したキーフレームとタイムスタンプ付き文字起こしを前処理パイプラインで用意し、引用可能な根拠としてモデルに渡す方法が適しています。このパイプラインを、何もお使いのマシンから外に送信せず、1 つのコマンドで実行するのが claude-real-video です。均等なフレームサンプリング(1 fps)ではカットを見逃すか、コンテキストウィンドウを埋め尽くしてしまいます。シーンを考慮した抽出なら、情報を含むフレームを保持できます。
Claude に動画を理解させるにはどうすればよいですか?
Claude は動画ファイルを直接取り込めません。次の方法が有効です。
pip install "claude-real-video[fast]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video   # or install via the Claude Code plugin marketplace
その後、Claude Code で Analyze this video: /path/to/video.mp4 を実行します。このスキルは、シーンを考慮したキーフレーム、タイムスタンプ付き文字起こし(transcript.json)、フレームからタイムスタンプへの対応表(frames.json)、およびフォルダーの読み方をモデルに伝える MANIFEST.txt を抽出します。これにより Claude は推測する代わりに、frame_012 @ 00:03:41 のように引用できます。
claude-real-video とは何ですか?
MIT ライセンスの Python CLI(crv)で、動画を LLM が実際に読み取れる形式に変換します。シーンを考慮したキーフレーム(重複排除や名前変更後も保持される、元動画の正確なタイムスタンプ付き)、小さな被写体の動きを取りこぼさないスライディングウィンドウ方式の重複排除、話者ラベルを任意で付けられるローカル Whisper 文字起こしを備えています。YouTube の URL またはローカルファイルに対応し、すべてローカルで実行されます。字幕を読むだけでは動画を見たことにはならず、文字起こししか読まないモデルは映像に関するあらゆる内容を幻覚するため、このツールが作られました。
開発者について
AI を活用して運営する、Leo Huang の一人会社が開発しています。 このようなツールを開発する中で、実際に何が壊れ、何がうまくいくのかを発信しています: https://x.com/LeoAidoAI
ライセンス
MIT
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。