Infrawise について
Infrawiseはコード、クラウドインフラ、データベーススキーマを静的解析し、AIコーディングエージェントに具体的なインフラ情報を提供します。AWSやデータベースを使い、インフラを踏まえた分析や提案を求める開発チーム向けです。
主な機能
- 01コード、インフラ、スキーマの解析
- 02関数とテーブル・サービスの関連付け
- 03全件スキャンやインデックス不足の検出
- 04データベースインデックス定義の提案
- 05AWSサービスと関連性の確認
- 06解析のキャッシュと変更ファイルの更新
活用シーン
- 01関数のデータベースアクセスパターンを確認する
- 02危険なスキャンやインデックス不足を探す
- 03コード変更前にAWSリソースを確認する
- 04CIで重大度のしきい値に基づき検査する
MCP 対応
Infrawiseは、スキーマ、サービス間の関係、検出事項、インデックス提案などのインフラスナップショットと分析結果をMCPツールとして提供します。エディター連携用stdioとHTTPエンドポイントに対応します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Infrawise
AI コーディングアシスタントが、ついにインフラを把握できるようになります。


Infrawise は、AI コーディングアシスタントにインフラの確定的な知識を提供します。
コードベース、クラウドインフラ、データベーススキーマを静的に分析し、そのコンテキストを MCP 経由で公開します。これにより、Claude Code などのツールはソースファイルだけから推測するのではなく、実際のテーブル、インデックス、クエリパターン、サービス間の関係を把握できます。
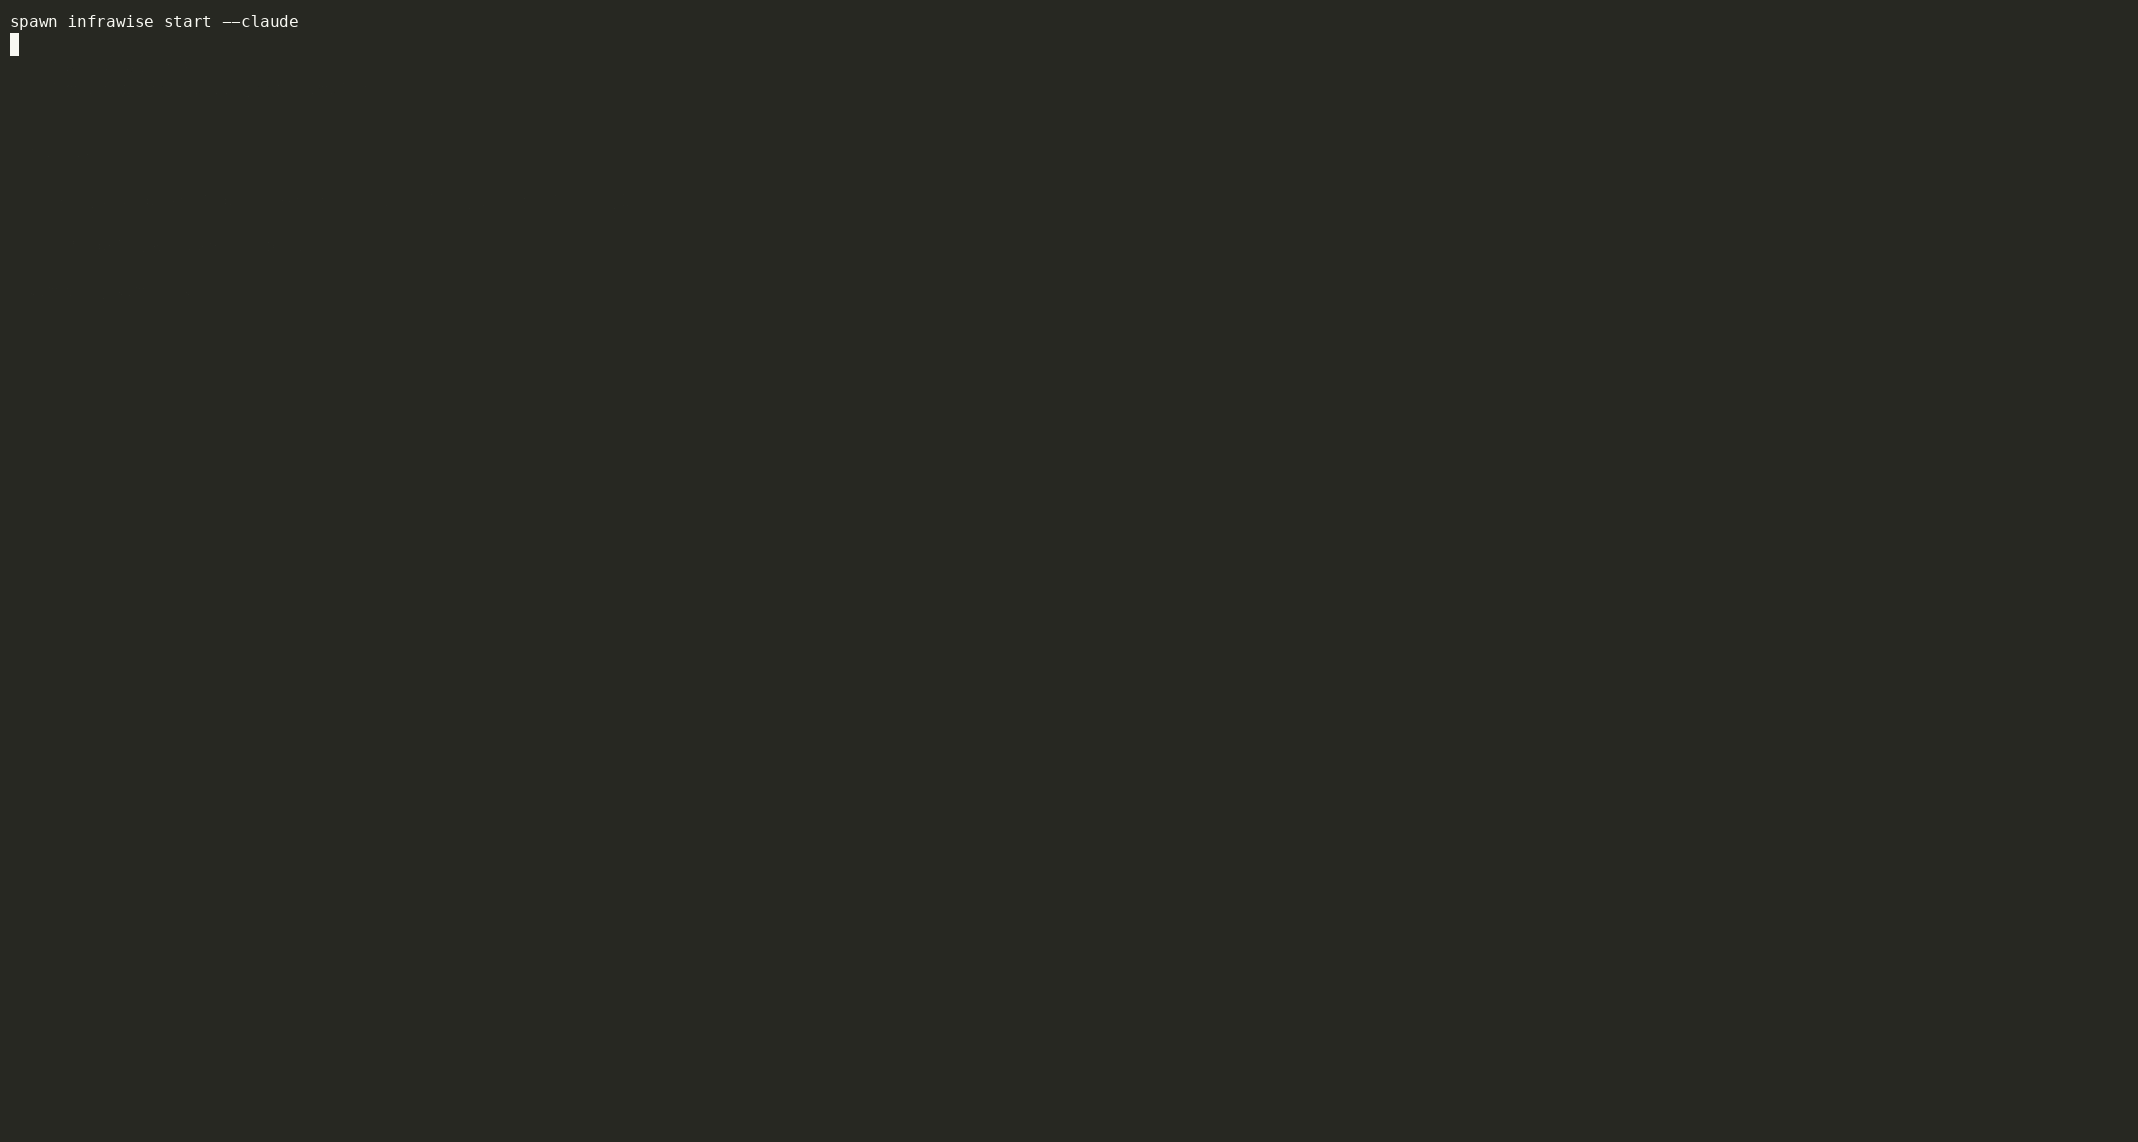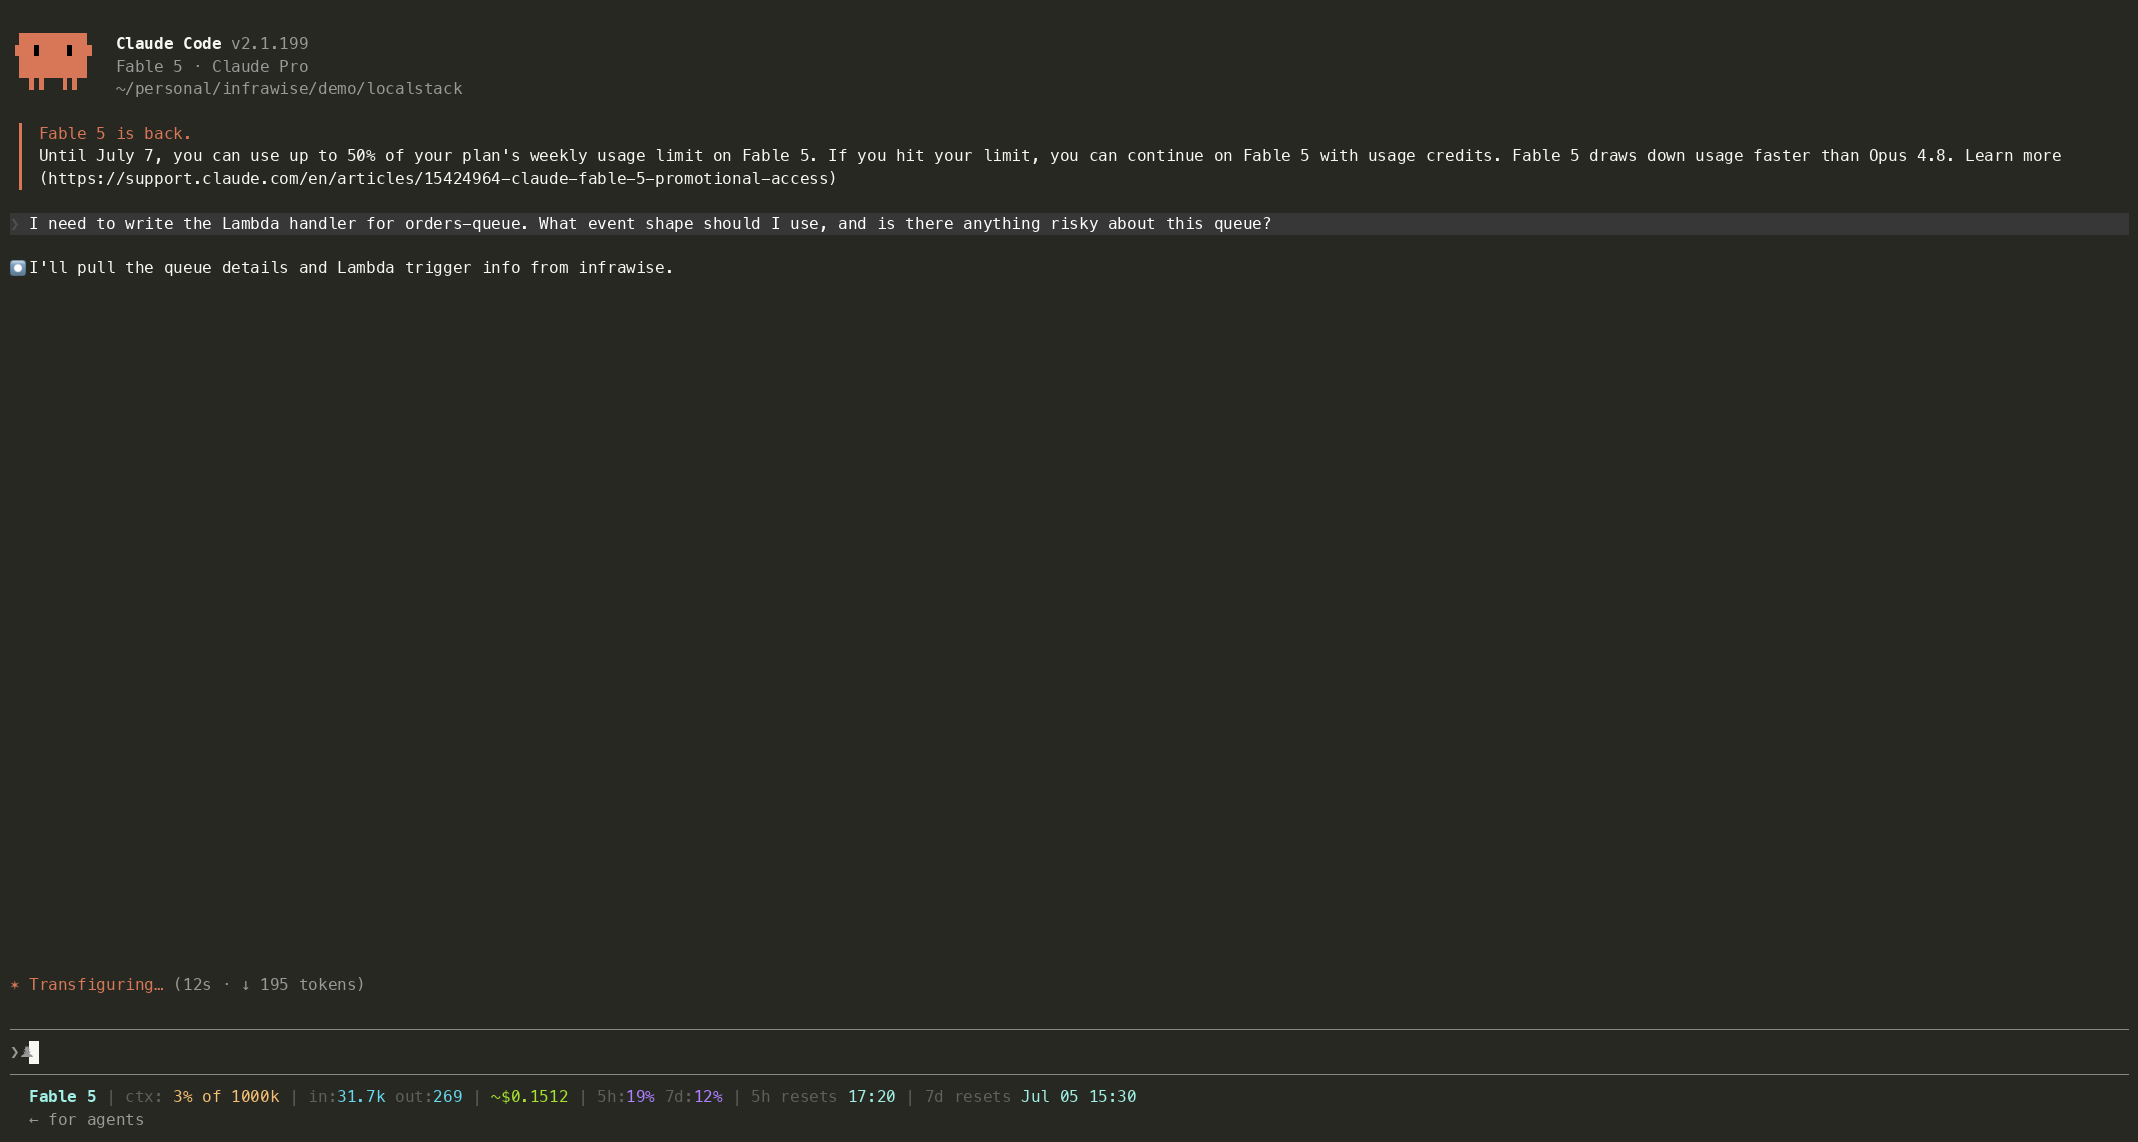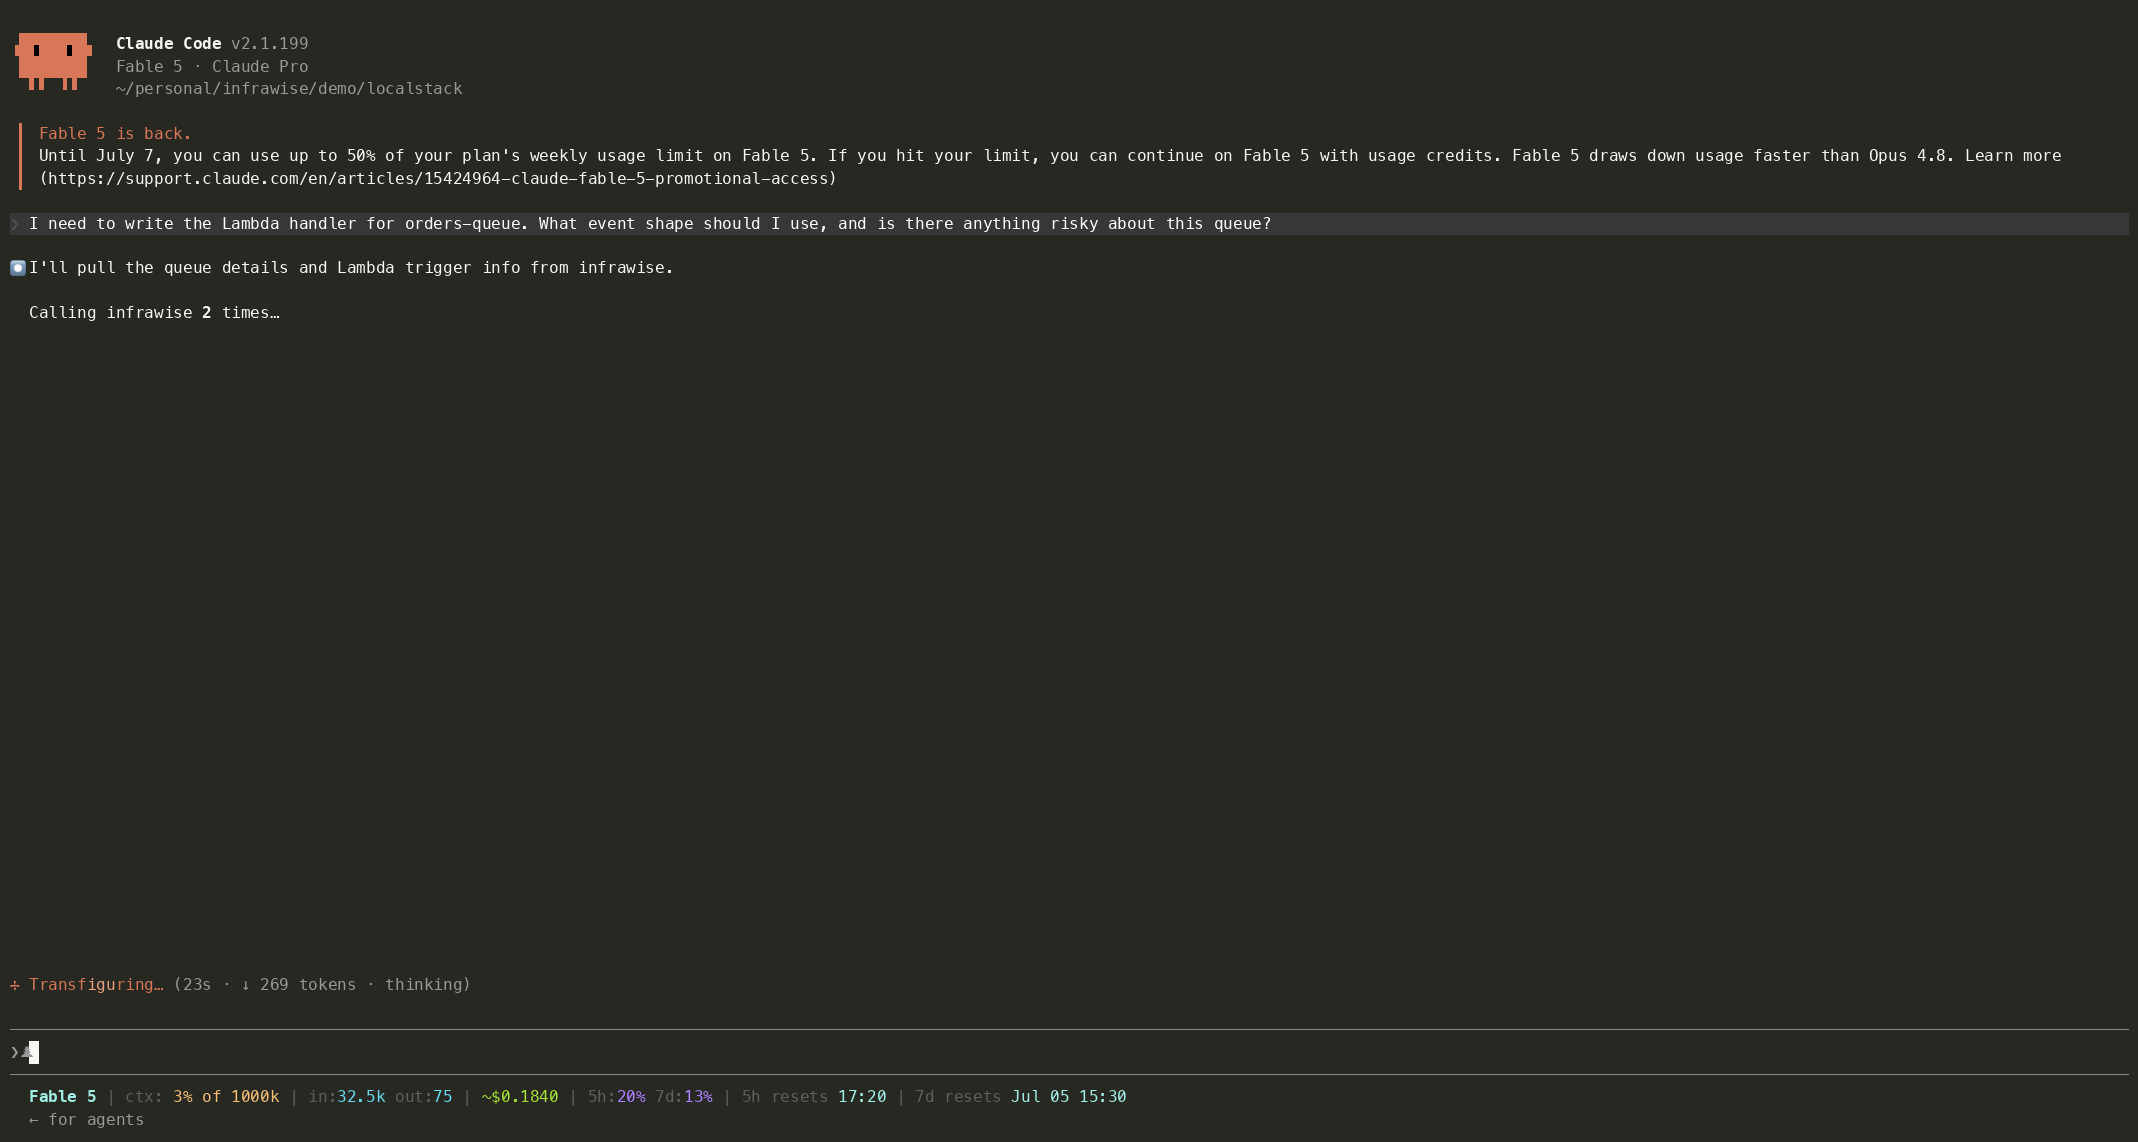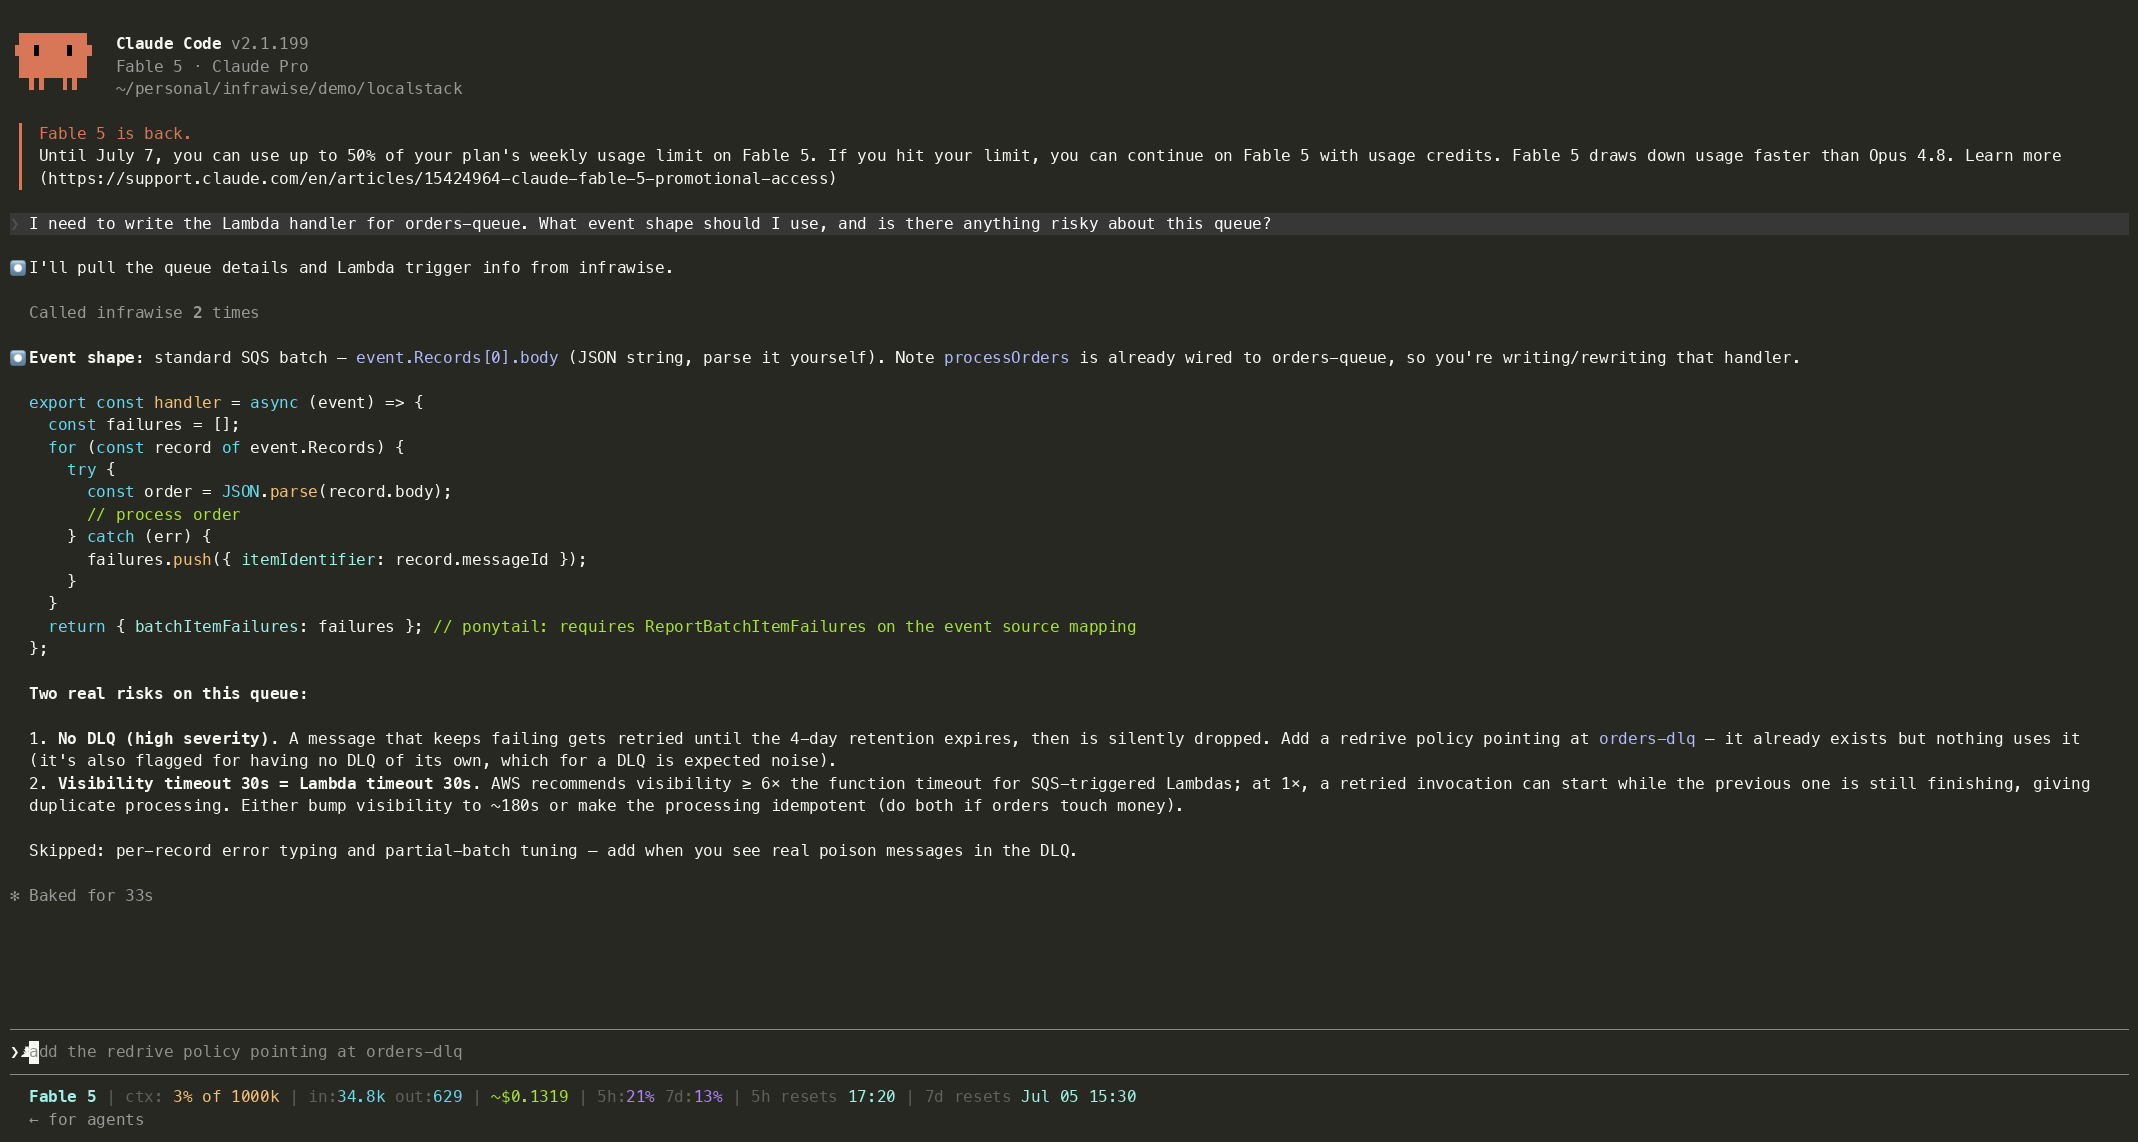
なぜこれが必要なのか
新しいソフトウェア開発者が間違ったコードを書くのではありません。Claude Code が間違ったコードを書き、それがそのままリリースされてしまうのです。Infrawise は、Claude Code が生成した出力と本番環境のインシデントの間に立つ唯一の存在です。
AI コーディングアシスタントはソースファイルを読めますが、インフラについて確定的な知識を持っていません。どの GSI が存在するのか、テーブルがどのようにパーティション分割されているのか、どの関数がすでにスキャンを実行しているのか、どこにインデックスがないのかもわかりません。そのため、推測で答えます。
Infrawise は、推測をインフラを考慮したコンテキストに置き換えます。
Infrawise がない場合、AI アシスタントは次のような提案をするかもしれません。
- 5,000 万行ある Orders テーブルに
.scan()を提案する - すでに存在する
statusの GSI の追加を勧める - クエリコストを低く抑える必要があるのに、
SELECT *を記述する - 5 つの関数がすでに同じパーティションキーに大量のアクセスをしていることに気づかない
Infrawise があれば、次のことを把握できます。
- テーブルの正確なスキーマ、パーティションキー、ソートキー、GSI
- どの関数がどのテーブルにどのようにクエリするか
- すでに重大度「高」として警告されているパターン
- 汎用的なアドバイスではなく、テーブルに対応した正確な
CREATE INDEXSQL または GSI 設定
Infrawise が対象としないもの
Infrawise は、AI エージェントフレームワーク、インフラストラクチャのプロビジョニングツール、オブザーバビリティプラットフォーム、クラウド管理ダッシュボードではありません。
AI を活用した開発のための、決定論的なインフラストラクチャインテリジェンスレイヤーです。
インストール
Node.js 22 以降が必要です(node --version)。
npm install -g infrawise
インストールせずに使用することもできます。
npx infrawise start --claude
クイックスタート
cd your-project
infrawise start --claude
これで完了です。Infrawise は次の処理を行います。
- 環境を調査して
infrawise.yamlを生成します(初回のみ。AWS プロファイルが複数ある場合に限り、使用するプロファイルを尋ねます) - AWS サービス、データベース、コードベースをスキャンします
.mcp.jsonを作成し、以降の起動時にエディターが自動接続するようにします- 22 個すべての MCP ツールを利用できる状態で Claude Code を開きます
以降は毎回、次のようにします。
claude # no infrawise command needed — editor manages the connection
分析結果は 24 時間キャッシュされます。infrawise serve --stdio(エディターによって自動的に起動されます)は、スナップショットを読み込んだり分析を実行したりせずに接続し、ツール一覧を取得します。最初のインフラストラクチャツール呼び出しでキャッシュが読み込まれます。キャッシュがないか期限切れの場合、その呼び出しは新しい分析が完了するまで待機します。同時に行われる呼び出しでは、最初の分析が共有されます。最初の呼び出しで待機しないようにするには、エディターを開く前に infrawise start を実行してキャッシュを準備してください。ファイルの監視は、スナップショットの読み込み後に開始されます。HTTP の serve は、引き続きスナップショットを読み込んでから待ち受けを開始します。
最初のコード更新後、サーバーは TypeScript プロジェクトをメモリ内に保持し、変更されたファイルと、それらを推移的にインポートするファイルのみをスキャンします。Python ファイルの保存時は、変更された Python ファイルのみをスキャンします。ファイルの追加や削除はスナップショットに反映され、保存処理は 2 秒間まとめて実行され、更新中に行われた編集はキューに追加されます。tsconfig*.json を変更すると、スキャナーが再構築されます。クロスリソースの検出結果を維持するため、IaC の抽出、グラフの構築、アナライザーの実行は引き続きスナップショット全体に対して行われます。クラウドのメタデータはキャッシュされたままです。設定や CLI フラグは不要です。
Findings (3 total)

1. [HIGH] Full table scan detected on DynamoDB table "Orders"
   listAllOrders() scans without any filter — reads every item in the table.
   Recommendation: Replace Scan with Query using a partition key or add a GSI.

2. [MEDIUM] PostgreSQL table "users" has no index on column "email"
   No matching leading-column index was observed for "email"; verify with EXPLAIN.
   Recommendation: CREATE INDEX CONCURRENTLY idx_users_email ON users(email);

3. [MEDIUM] DynamoDB table "Sessions" accessed by 6 distinct code paths
   High access concentration may create hot partition issues at scale.
AI コーディングアシスタントでの使用
Claude Code(推奨)
infrawise start --claude
プロジェクトのルートに .mcp.json を書き込み(すでに設定されている MCP サーバーがあれば、それらを統合して)、Claude Code を開きます。Claude Code は起動のたびに .mcp.json を自動的に読み込み、infrawise serve --stdio プロセスを管理します。サーバーの起動やポートの設定は不要です。
Infrawise は Claude Code プラグインとしてもインストールできます。同じ MCP サーバーを登録しますが、プロジェクトに infrawise.yaml が必要です。これは infrawise start によって作成されます。
/plugin marketplace add Sidd27/infrawise
/plugin install infrawise@infrawise
Cursor
infrawise start --cursor
.cursor/mcp.json を書き込み(既存の MCP サーバーがあれば、それらを統合して)、Cursor を開きます。Cursor の MCP パネルで、infrawise の 22 個すべてのツールを利用できます。
VS Code
infrawise start --vscode
.vscode/mcp.json を書き込み(既存の MCP サーバーがあれば、それらを統合して)、VS Code を開きます。MCP サーバーパネルから Copilot のエージェントモードでツールを利用できます。
任意のエディター(フラグなし)
infrawise start
.mcp.json を書き込み(既存の MCP サーバーがあれば、それらを統合して)、終了します。お好みのエディターを開き、MCP サーバーコマンドとして infrawise serve --stdio --config /path/to/infrawise.yaml を指定してください。
HTTP トランスポート(代替手段)
エディターやワークフローで stdio ではなく HTTP MCP エンドポイントが必要な場合:
infrawise serve # starts server at http://localhost:3000/mcp
エディターの MCP 設定に追加します。
{
  "mcpServers": {
    "infrawise": {
      "url": "http://localhost:3000/mcp"
    }
  }
}
MCP ツール
すべてのツールは読み取り専用として注釈付けされています(readOnlyHint: true、openWorldHint: false)。そのため、注釈に対応した MCP クライアントであれば、確認プロンプトなしで呼び出せます。
| ツール | 提供する内容 |
|---|---|
get_infra_overview | 完全なスナップショット — サービス、件数、重大度の高い検出事項、configured フラグ(データの経過時間とソースごとのステータスは、すべての応答の dataHealth ブロックに含まれます) |
get_graph_summary | インフラストラクチャグラフ全体 — すべてのノード、エッジ、検出事項 |
get_table_schema | 指定したテーブル/コレクションの列レベルのスキーマ — 型、PK、FK、インデックス、DynamoDB のキー/課金モード、コストシグナル(行データは含まれません) |
analyze_function | 特定の関数の問題 — スキャン、インデックスの欠落、N+1、トリガーイベントの形状、IAM 権限の不足を検査します。同名のファイルが複数ある場合は、それぞれ別の一致結果として返します。オプションの file 入力で特定のファイルに限定できます。リンクできなかった Lambda 関数の名前とその理由(unresolvedLambdas)も返します |
suggest_gsi | DynamoDB テーブルと属性に対する正確な GSI 設定 — すでに該当するインデックスがある場合は、その名前を提示します |
postgres_index_suggestions | 実際のテーブルに対する正確な CREATE INDEX SQL |
suggest_mongo_index | MongoDB コレクションとフィールドに対する正確な createIndex コマンド |
mysql_index_suggestions | MySQL テーブルに対する正確な ALTER TABLE ADD INDEX SQL |
get_queue_details | SQS キュー — DLQ のステータス、暗号化、FIFO の種類、可視性タイムアウト、メッセージ数 |
get_api_routes | API Gateway API(REST、HTTP、WebSocket)— ルート、HTTP メソッド、パス、Lambda 統合 |
get_topic_details | SNS トピック — サブスクリプション数、プロトコル、フィルターポリシー(サブスクリプションごとに必要なメッセージ属性) |
get_secrets_overview | Secrets Manager — 名前、ローテーションのステータス、コードから推定したキー名(値は一切含まれません) |
get_parameter_overview | SSM Parameter Store — 名前、型、ティア(値は一切含まれません) |
get_lambda_overview | Lambda 関数 — ランタイム、メモリ、タイムアウト、実行ロール ARN、トリガー(SQS/SNS/DynamoDB/Kinesis/MSK/EventBridge/S3)、環境変数のキー名、コストシグナル、Lambda 関数をソースにリンクできなかった理由(unresolvedLink) |
get_eventbridge_details | EventBridge ルール — 名前、状態、スケジュール/イベントパターン、ターゲット関数 |
get_s3_overview | S3 バケット — バージョニング、暗号化、パブリックアクセス、イベント通知 |
get_log_errors | CloudWatch ロググループの名前と保持期間(メタデータのみ。メッセージ本文は含まれません) |
get_stack_outputs | ローカルの IaC ファイルから解析したスタック出力とスタック間エクスポート。孤立した cdk.out テンプレートには古さを示すフラグが付きます |
get_cognito_overview | Cognito ユーザープール — MFA 設定、アプリクライアントの認証フロー、OAuth 設定、トークンの有効期間(シークレットは一切含まれません) |
get_stream_details | Kinesis ストリーム(シャード、保持期間、容量モード)と MSK クラスター(状態、Kafka バージョン、ブローカー) |
get_cache_overview | ElastiCache クラスター — エンジン、転送中/保存時の暗号化、レプリケーショングループ、フェイルオーバー、コストシグナル(データは読み取られません) |
get_cloudfront_overview | CloudFront ディストリビューション — ビヘイビアごとのパスパターン、オリジン(S3 またはカスタム、解決済みの API Gateway 名)、キャッシュポリシー、ビューワープロトコルポリシー |
すべての応答には、固定形式の dataHealth ブロックが含まれます。インフラストラクチャを読み取った時刻と、その経過時間、回答の根拠となる各ソースのステータス、その後 cdk.out が合成されたかどうか、更新コマンドが記載されます。すべてのキーは常に存在するため、フィールドがないことから何かを推測する必要はありません。空の結果と失敗を区別できない場合、「DLQ が必要なキューはありません」と読めてしまいますが、実際には「SQS が一度も一覧表示されていません」という可能性があります。 |
Infrawise は状況を報告しますが、判断を下すものではありません。質問が特定時点の情報を求めるものであれば maxAgeSeconds を渡すと、データが条件を満たしているかどうかが通知されます(参考情報です。データは引き続き返され、条件を満たしているかどうかが表示されます)。実行中のサーバーは各ツール呼び出しのたびにキャッシュを再確認するため、セッションを開いたままでも、次の質問時に最新の infrawise analyze の結果が反映され、再起動は不要です。infrawise analyze と infrawise check は同じソース警告を表示し、いずれかのソースを読み取れなかった場合、その実行をクリーンとは判定しません。
データの経過時間はドリフトそのものではなく、その代理指標です。変更されていないアカウントの3日前のスナップショットは正確ですが、terraform apply の前に取得した5分前のスナップショットは正確ではありません。Infrawise がデータの古さを扱う方法では、この代理指標が誤解を招く状況と対処方法を説明しています。データ鮮度のリファレンスには、フィールドごとの一覧表と freshness 設定キーが記載されています。
CLI リファレンス
| コマンド | 説明 |
|---|---|
infrawise start | 主なコマンド — 環境を調査し、設定を生成して分析を実行し、エディターの MCP 設定を書き込みます |
infrawise start --claude | 上記と同じ処理を行い、その後 Claude Code を開きます |
infrawise start --cursor | 上記と同じ処理を行い、その後 Cursor を開きます |
infrawise start --vscode | 上記と同じ処理を行い、その後 VS Code を開きます(.vscode/mcp.json に統合します) |
infrawise start --interactive | 自動検出の代わりに、ガイド付きセットアップウィザードを実行します |
infrawise start --rediscover | infrawise.yaml と .infrawise/ を削除してから、再調査と再分析を行います |
infrawise analyze | 抽出の進捗状況と過去の実行に基づく所要時間の見積もりを表示し、全項目を再スキャンします。大規模なインフラストラクチャ変更後に便利です |
infrawise check | CI ゲート — 分析を実行し、検出結果がしきい値の重大度に達した場合はゼロ以外の値で終了します |
infrawise serve | MCP サーバーを起動します — デフォルトでは HTTP を使用し、エディターとの統合には --stdio を指定します |
infrawise doctor | 診断用の手段 — AWS/DB アクセス、設定、リポジトリのスキャンを検証します |
infrawise analyze のオプション
| フラグ | 説明 |
|---|---|
-c, --config <path> | infrawise.yaml のパス(デフォルト:infrawise.yaml) |
-r, --repo <path> | スキャンするリポジトリ(デフォルト:現在のディレクトリ) |
--no-cache | キャッシュの読み書きをスキップします |
-o, --output <path> | 検出結果を Markdown レポートとして保存します。例:report.md |
--severity <level> | 指定したレベル以上の検出結果のみを表示します:high | medium | low |
# Export a shareable findings report
infrawise analyze --output report.md

# Only show high-severity issues
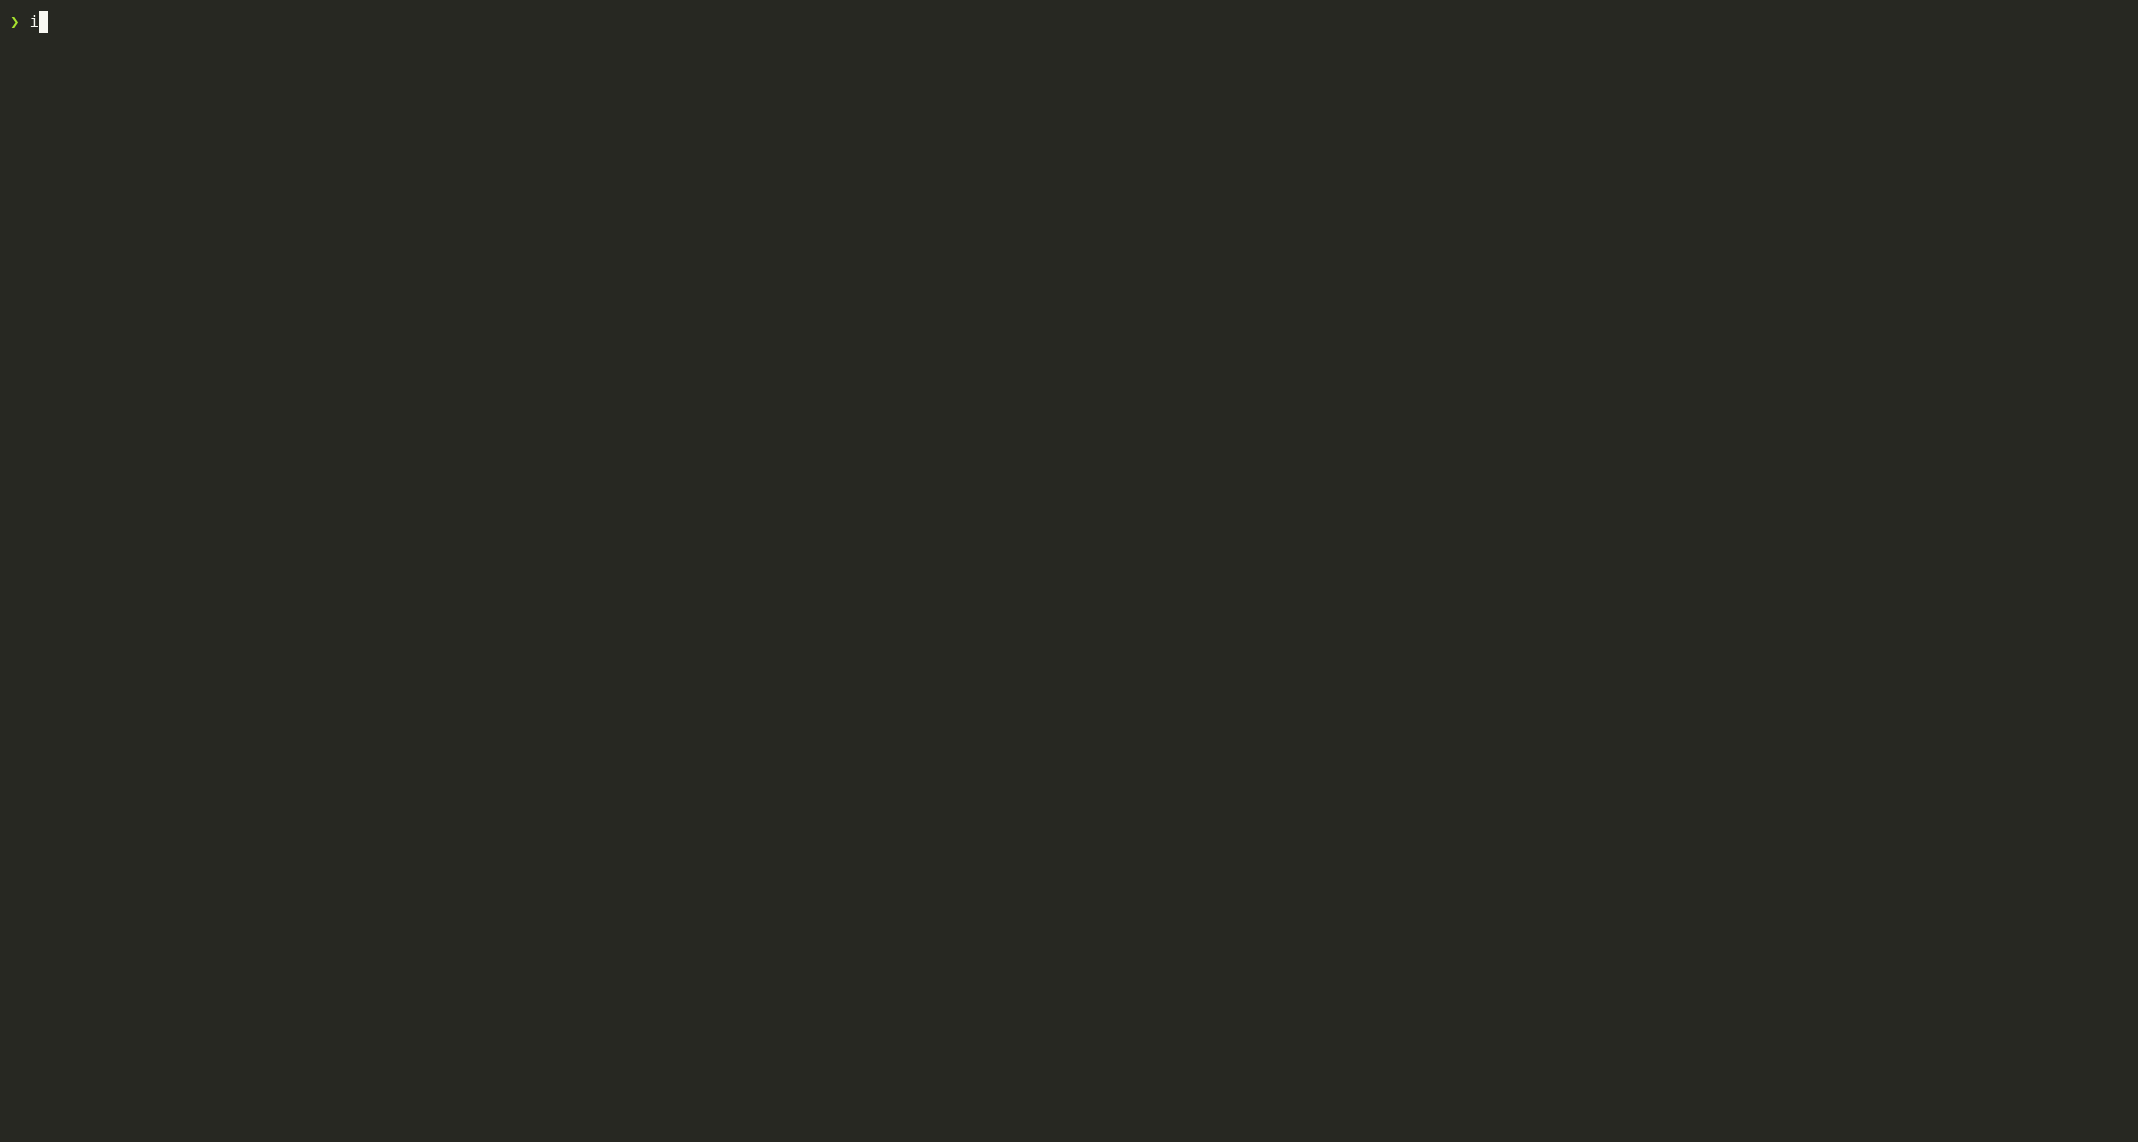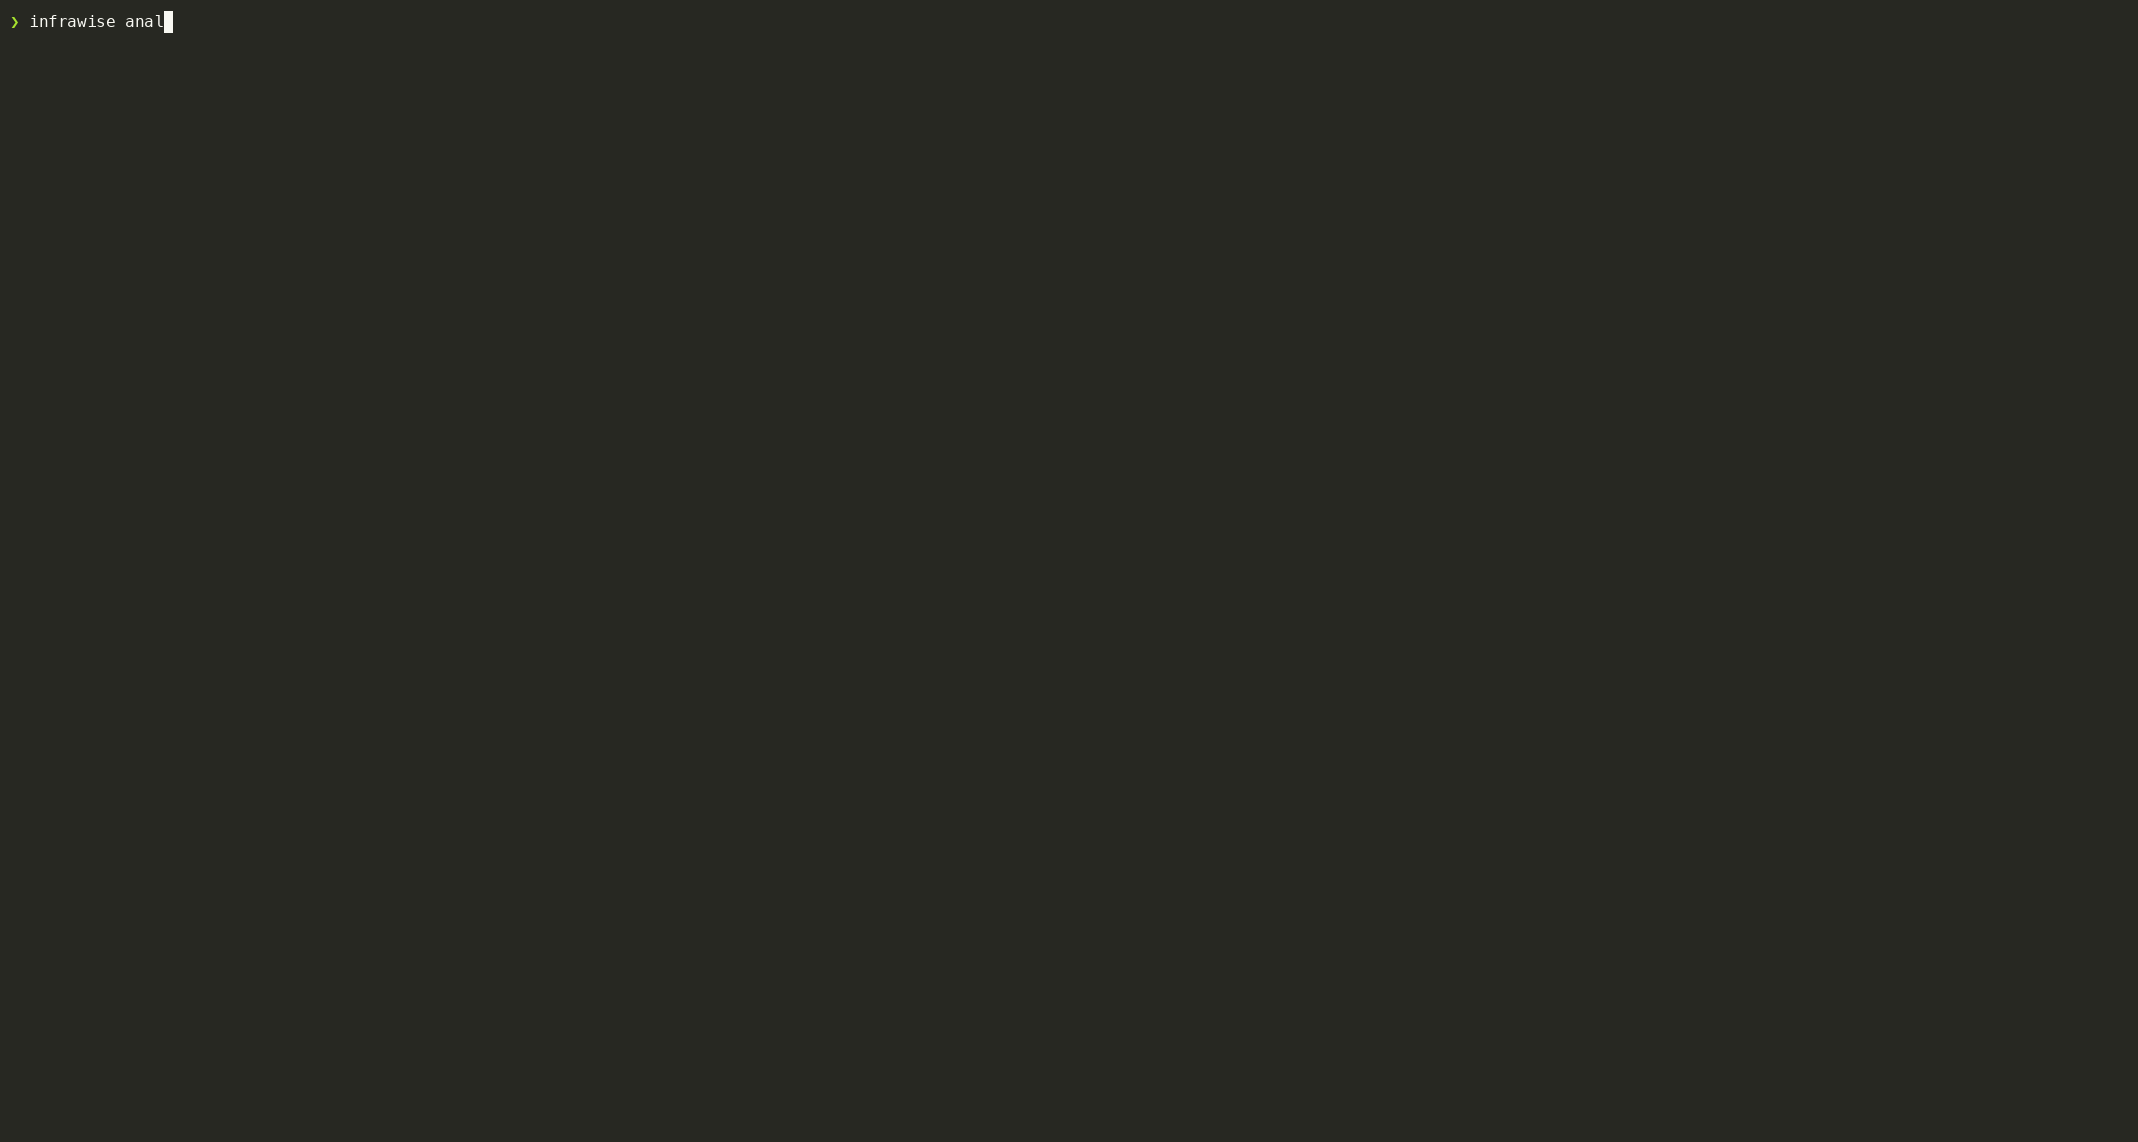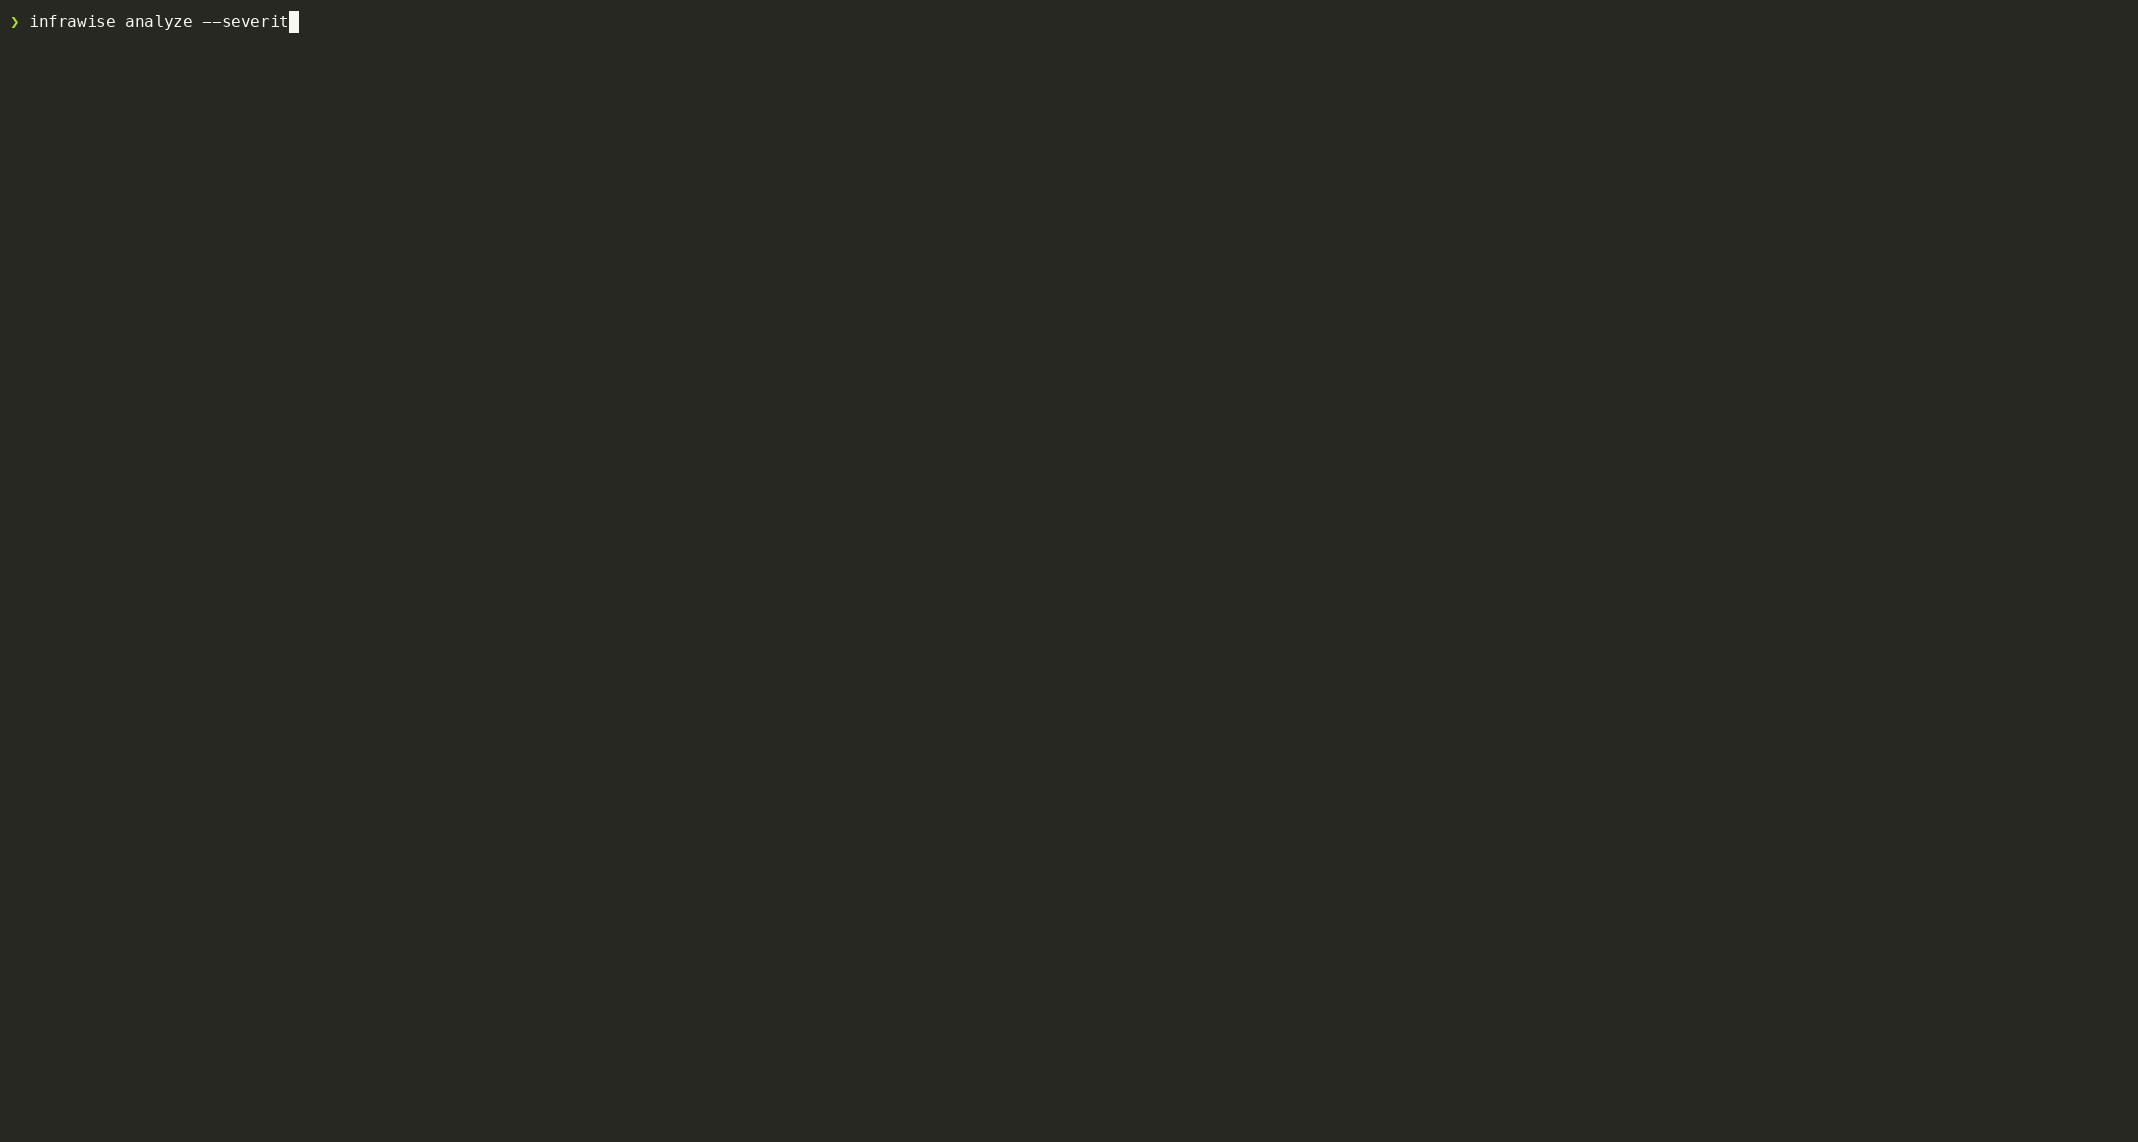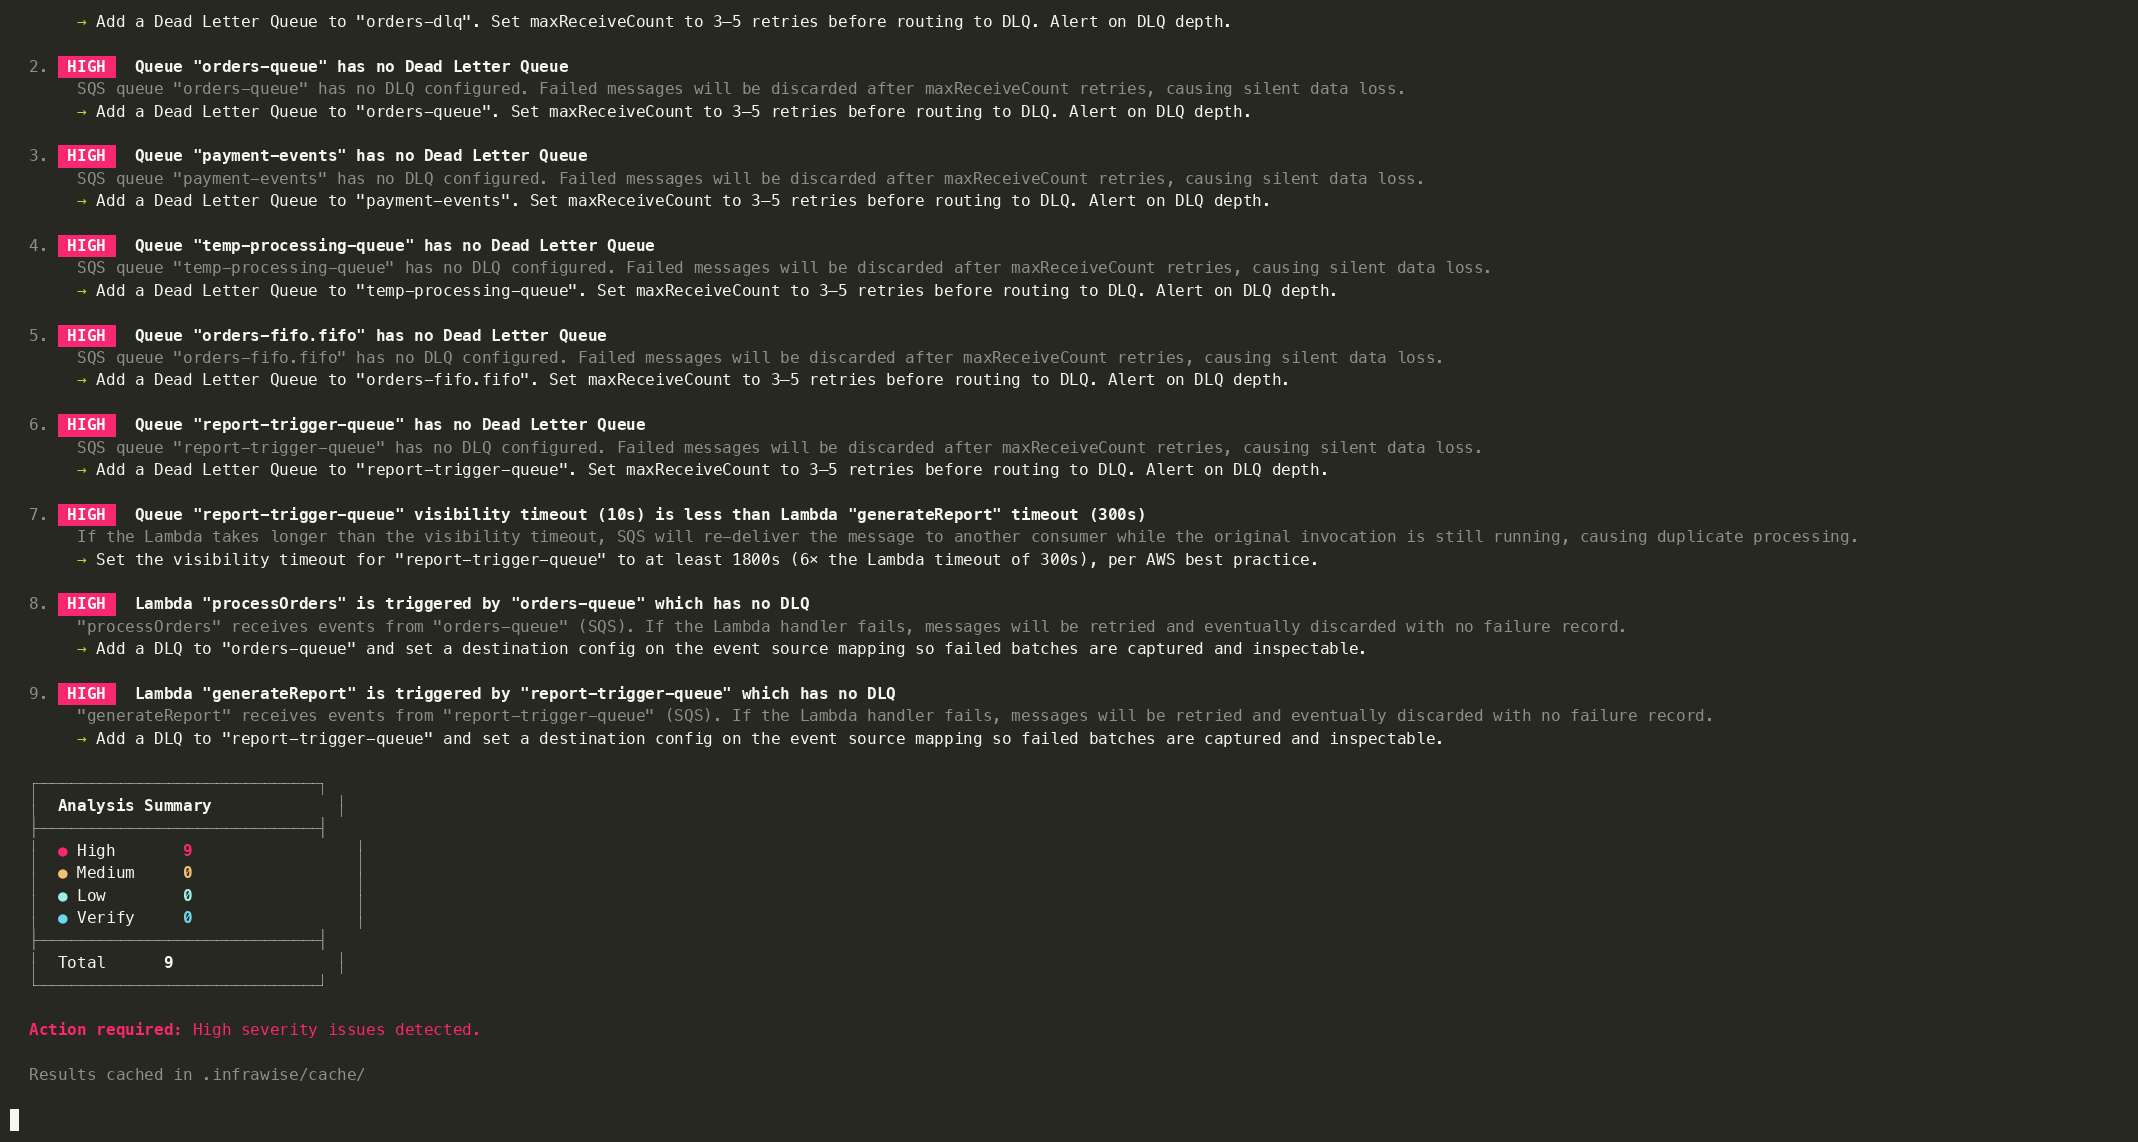
infrawise analyze --severity high

# High-severity issues only, saved to a file
infrawise analyze --severity high --output report.md
infrawise check オプション(CI/CD)
check は新しい分析を実行し、ブロッキング対象の指摘事項がある場合はゼロ以外の終了コードを返します。そのため、AI エディターがなくてもパイプラインのゲートとして使用できます。
| フラグ | 説明 |
|---|---|
-c, --config <path> | infrawise.yaml のパス(デフォルト:infrawise.yaml) |
-r, --repo <path> | スキャンするリポジトリ(デフォルト:カレントディレクトリ) |
--fail-on <level> | ビルドを失敗させる重大度:high(デフォルト) | medium | low |
--allow-incomplete | ソースの読み込みに失敗した場合や、一部しか読み取れなかった場合でも、明示的に成功を許可します |
# Block a deploy if any high-severity finding exists (exit 1)
infrawise check

# Stricter gate — fail on medium and above
infrawise check --fail-on medium
infrawise serve オプション
| フラグ | 説明 |
|---|---|
-c, --config <path> | infrawise.yaml のパス(デフォルト:infrawise.yaml) |
--stdio | HTTP の代わりに stdio トランスポートを使用します(.mcp.json 経由でエディターから利用) |
-p, --port <number> | リッスンするポート(HTTP のみ、デフォルト:3000) |
設定
infrawise.yaml は infrawise start(またはガイド付きウィザードを使う場合は infrawise start --interactive)によって生成され、リポジトリのルートに配置されます。各サービスでは enabled: true を明示的に指定する必要があります。infrawise は、設定に記載されていないサービスには接続しません。
接続文字列では ${ENV_VAR} による置換に対応しているため、パスワードをコミットする必要はありません。
postgres:
  enabled: true
  connectionString: postgresql://infrawise_ro:${DB_PASSWORD}@host:5432/mydb
完全な例:
project: payments-service

aws:
  profile: default # AWS profile from ~/.aws/credentials
  region: ap-south-1

dynamodb:
  enabled: true
  includeTables: # omit to include all tables
    - Orders
    - Users

postgres:
  enabled: true
  connectionString: postgresql://infrawise_ro:${DB_PASSWORD}@host:5432/mydb

mysql:
  enabled: false
  connectionString: ''

mongodb:
  enabled: false
  connectionString: ''

sqs:
  enabled: true

sns:
  enabled: true

ssm:
  enabled: true
  paths: [] # filter by prefix e.g. ["/myapp/prod"]

secretsManager:
  enabled: true

lambda:
  enabled: true
  includeFunctions: # omit to include all functions
    - myFunction
    - anotherFunction

eventbridge:
  enabled: true

rds:
  enabled: false

s3:
  enabled: false

apiGateway:
  enabled: false

cognito:
  enabled: false

kinesis:
  enabled: false

msk:
  enabled: false

elasticache:
  enabled: false

cloudfront:
  enabled: false

runtimeSignals:
  enabled: false # Lambda throttles/errors + queue age via CloudWatch metrics
  windowHours: 24

cloudwatchLogs:
  enabled: false
  logGroupPrefixes: []
  windowHours: 24

analysis:
  hotPartitionThreshold: 5
  hotPartitionThresholds:
    high-traffic-table: 12

freshness:
  suggestRefreshAfterHours: 6 # when MCP responses start hinting to re-analyze
AWS のセットアップ
Infrawise は読み取り専用です。DynamoDB 用の最小限の IAM ポリシー:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["dynamodb:ListTables", "dynamodb:DescribeTable"],
      "Resource": "*"
    }
  ]
}
サポートされているすべてのサービスに適用する完全なポリシー、有効にするサービスのみに対象を絞る方法、および一時的に対象を絞った認証情報にセッションポリシーを使用する方法については、AWS セットアップガイドをご覧ください。
SSO プロファイルを使用する場合は、infrawise の実行前にログインしてください。
aws sso login --profile myprofile
PostgreSQL のセットアップ(任意)
infrawise 用の読み取り専用ユーザーを作成します。
CREATE USER infrawise_ro WITH PASSWORD 'yourpassword';
GRANT CONNECT ON DATABASE yourdb TO infrawise_ro;
GRANT USAGE ON SCHEMA public TO infrawise_ro;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO infrawise_ro;
Amazon RDS の場合:セキュリティグループで、ご利用のマシンの IP からポート 5432 へのインバウンドアクセスを許可してください。
分析機能
Infrawise には 2 つの分析レイヤーがあります。
インフラストラクチャ分析(すべての言語)
AWS API、データベーススキーマのイントロスペクション、IaC ファイルから分析します。アプリケーションコードには依存しません。
| サービス | チェック内容 |
|---|---|
| DynamoDB スキーマ | テーブル、GSI、パーティションキー、請求モード、コストの兆候(プロビジョニング済みキャパシティ) |
| PostgreSQL / MySQL スキーマ | テーブル、インデックス、カラム型 |
| MongoDB スキーマ | コレクション、インデックス |
| SQS | DLQ の欠落、暗号化されていないキュー、大量のバックログ、FIFO の検出、可視性タイムアウトがコンシューマー Lambda のタイムアウトより短い(高)場合、または AWS 推奨の 6× より短い(中)場合 |
| SNS | サブスクリプションのフィルターポリシー — サブスクリプションごとに必要なメッセージ属性 |
| Apache Kafka(kafkajs) | コードからプロデューサー/コンシューマーのトピックマッピングを分析 — 任意のブローカーに対応(セルフホスト、Confluent、Redpanda、MSK)。MSK Lambda トリガーとは別です |
| Secrets Manager | シークレットローテーションの欠落 |
| Lambda | デフォルトメモリ(128 MB)、長いタイムアウト、トリガー(SQS/SNS/DynamoDB/Kinesis/MSK/EventBridge/S3)、トリガー元の DLQ 欠落、コストの兆候(スロットリングの証拠がない高メモリ使用) |
| S3 | パブリックアクセスのブロック(検証)、バージョニングの欠落、暗号化の欠落 |
| EventBridge | ルール、スケジュール、イベントパターン、ターゲット Lambda 関数 |
| API Gateway | REST、HTTP、WebSocket API — ルート、メソッド、Lambda 統合 |
| RDS | パブリックアクセス可能、バックアップなし、暗号化なし、削除保護なし、シングル AZ、コストの兆候(本番環境用に見えないインスタンスでの Multi-AZ) |
| CloudWatch Logs | 保持ポリシーが設定されていないロググループ |
| Cognito | ユーザープールとアプリクライアントの設定 — 認証フロー、OAuth 設定、トークンの有効期間、クライアントシークレットの有無 |
| Kinesis / MSK | ストリーム(シャード、保持期間、キャパシティモード)と MSK クラスター(状態、Kafka バージョン、ブローカー) |
| ElastiCache | 転送中の暗号化の欠落、レプリケーションのない単一ノードクラスター、コストの兆候(ノード数が 3 を超える場合) |
| CloudFront | 暗号化されていない HTTP でトラフィックを配信するビヘイビア(allow-all ビューワープロトコルポリシー) |
| ランタイムシグナル(オプトイン) | CloudWatch メトリクスから取得する Lambda のスロットリング/エラーと、古いキューメッセージ |
| Terraform / CloudFormation / CDK | IaC とデプロイ済みの状態との差分、スタック出力、スタック間エクスポート |
コード相関分析(TypeScript / JavaScript / Python)
ts-morph による AST 分析を使用して、どの関数がどのテーブルをどのように呼び出しているかを検出します。
Python リポジトリは、同梱の標準ライブラリ ast スキャナーでスキャンします(python3 が PATH に必要です。利用できない場合は警告を表示してスキップします)。boto3 クライアントと dynamodb.Table() リソース、cursor.execute による SQL、pymongo コレクション、kafka-python/confluent-kafka のプロデューサーとコンシューマーを検出します。言語は自動的に判定されます。TypeScript と Python のスキャンは、それぞれ該当するファイルが存在する場合にのみ実行されます。
| アナライザー | 重大度 | 検出内容 |
|---|---|---|
| フルテーブルスキャン(DynamoDB) | 高 | フィルターなしの .scan() 呼び出し |
| GSI の不足 | 中 | 対応する GSI がない属性へのクエリ |
| ホットパーティション | 中 | 同じテーブルにアクセスする 5 つ以上の異なるコードパス |
| インデックスの不足(PostgreSQL) | 中 | インデックスのないテーブルへのクエリ |
| N+1 クエリ | 高 | ORM ループによるクエリパターンの繰り返し |
| 大規模 SELECT | 低 | SELECT * の使用 |
| MySQL インデックスの不足 | 中 | インデックスのない MySQL テーブルへのクエリ |
| MySQL フルテーブルスキャン | 高 | MySQL クエリにおけるフルテーブルスキャンパターン |
| Mongo インデックスの不足 | 中 | セカンダリインデックスのないコレクションへのクエリ |
| コレクションスキャン | 高 | フィルタープレディケートなしの find() 呼び出し |
| パイプライン:コンシューマー内のスキャン | 高 / 要確認 | イベントによってトリガーされる Lambda ハンドラー内のフルスキャン(Lambda とコードの関連付けが IaC で証明される場合は「高」、名前の一致による場合は「要確認」) |
| パイプライン:テーブルアクセスの繰り返し | 中 / 要確認 | 1 つのサービスパイプライン内で、同じテーブルを 2 つ以上の関数が読み取る |
| パイプライン:DLQ ホップの不足 | 中 | デッドレターキューがない中間パイプラインキュー(プロデューサーとコンシューマーがあるもの) |
他の言語を使用するプロジェクトでも、インフラストラクチャレベルのアナライザーを最大限に活用できます。コード相関分析(関数とテーブルのマッピング、N+1 パターン)は現在、TypeScript、JavaScript、Python に対応しています。
スキャナーは、DynamoDB 用 AWS SDK v3/v2、PostgreSQL 用 pg/Prisma/Knex、MySQL 用 mysql2/Knex、MongoDB 用 driver/Mongoose、SQS/SNS/SSM/Secrets/Lambda 用 AWS SDK v3、Kafka トピック用 kafkajs(プロデューサー/コンシューマー)に対応しています。
動作の仕組み
- Infrawise がリポジトリとインフラストラクチャのメタデータをスキャンします
- グラフエンジンがサービス、スキーマ、インデックス、クエリパターンをマッピングします
- ルールベースのアナライザーが、インフラストラクチャおよびクエリのアンチパターンを検出します
- 生成されたコンテキストが MCP を通じて公開されます
- AI コーディングアシスタントがコード生成時にこのコンテキストを照会します
決定論的分析
Infrawise は、インフラストラクチャの分析に LLM を使用しません。抽出と分析はすべて、AST 解析、スキーマのイントロスペクション、ルールベースのアナライザー、グラフ相関によって決定論的に行われます。LLM は MCP を通じて生成されたコンテキストを利用する場合にのみ使用されます。
セキュリティ
- 読み取り専用 — AWS やデータベースへの書き込みは行わず、DDL も実行しません
- ローカル優先 — すべての処理はお使いのマシン上で実行され、外部サーバーには何も送信されません
- テレメトリなし — データ収集は一切ありません
- 認証情報 — 既存の AWS 認証情報チェーンを使用し、infrawise が認証情報を保存することはありません
🔒 セキュリティとプロジェクト名に関する注記
このパッケージが、一部のサプライチェーンセキュリティスキャナーで「誤解を招く命名」として警告されることがあります。これは「infra」という接頭辞を理由に、自動ツールが誤検知したものです。このプロジェクトは完全に安全で、独立しており、商標を持ついかなる企業とも関係ありません。
アーキテクチャの概要

ソースの構成
src/
  types.ts      Shared type definitions
  core/         Config (Zod + YAML), logger (Pino), local cache
  graph/        Graph engine — nodes, edges, builder
  adapters/
    aws/        DynamoDB, S3, Lambda, SQS/SNS/SSM/Secrets/EventBridge/RDS/APIGateway, CloudWatch
    db/         PostgreSQL, MySQL, MongoDB
    iac/        Terraform, CDK, CloudFormation (local file parsing)
  analyzers/    39 rule-based analyzers
  context/      Repository scanner (ts-morph AST + Python stdlib-ast subprocess)
  server/       Fastify MCP server (@modelcontextprotocol/sdk, Streamable HTTP)
  cli/          CLI commands (Commander.js)
現在の制限事項
- コードレベルの相関分析は TypeScript、JavaScript、Python に対応しています(Python では PATH 上に python3 が必要です)。
- 動的に構築されるクエリは、静的に解決できない場合があります。
- ランタイムトレースはまだ実装されていません。
- 静的スキャンは認識されたパターンを対象とします。抽出された操作とグラフのサイズは、引き続きメモリ使用量に影響します。
ロードマップ
機能ロードマップは、Infrawise v1 プロジェクトボードで管理されています。機能リクエストや賛成票をお待ちしています。
デモ
2 つのデモでは、実際の AWS API を Docker 内でローカルにエミュレートし、コストゼロかつ実際の AWS アカウントなしで infrawise を実行します。
demo/floci/は Floci を使用します。Floci は MIT ライセンスのエミュレーターで、CloudFront、API Gateway v2、RDS、Cognito、Kinesis、ElastiCache、MSK など、infrawise がサポートするすべてのサービスに対応しています。認証トークンもサインアップも不要です。まずはこちらをお試しください。demo/localstack/は LocalStack のコミュニティエディションを使用し、主要なサービスに対応しています。
どちらもポート 4566 を使用するため、同時に実行せず、どちらか一方を実行してください。
コントリビューション
新しいサービスアダプターやアナライザーの追加方法、PR チェックリストなど、詳しい手順については CONTRIBUTING.md をご覧ください。
リリース
リリース前に pnpm check:docs を実行してください。README.md/AGENTS.md/llms.txt のバージョンまたは MCP ツール一覧が src/server/index.ts と異なる場合、コマンドは失敗します。
pnpm release patch    # 0.1.2 → 0.1.3  (bug fixes)
pnpm release minor    # 0.1.2 → 0.2.0  (new features, backwards compatible)
pnpm release major    # 0.1.2 → 1.0.0  (breaking changes)
pnpm release 1.5.0    # explicit version
package.json のバージョンを更新し、コミット、タグ付け、プッシュを行い、コミットメッセージからリリースノートを作成して、GitHub のドラフトリリースを作成します。その後、GitHub でドラフトを公開すると npm への公開が開始されます。
ライセンス
MIT
分析の信頼性と更新ポリシー
check は、重大度のしきい値を下回るチェックが完了した場合は終了コード 0、ブロック対象の検出事項がある場合は終了コード 1、抽出が不完全な場合やアナライザーが失敗した場合は終了コード 2 を返します。ソースの取得失敗や部分的な取得は、デフォルトでブロック対象になります。--allow-incomplete を指定すると、ブロック対象の検出事項がない場合に限り、成功を明示的に許可します。--severity は analyze のレポート出力のみを絞り込み、CI ポリシーは変更しません。
リレーショナルスキーマには、順序付きのインデックス columns、method、partial、valid のメタデータが含まれます。SQL 分析では、サポート対象のフィルター列とインデックスの先頭列を比較します。これにより、関連のない主キーによって不足しているアクセスパスが見えなくなることはありません。検出事項は静的な警告であり、実際に観測されたクエリプランではありません。部分インデックス、式インデックス、およびサポートされていない述語は、EXPLAIN を使った手動確認が必要です。述語のメタデータにはクエリ値は保持されません。
すべてのレスポンスには dataHealth.codeCoverage が含まれ、認識された操作の件数、未解決の参照件数、サポートされていない SQL の件数、および制約事項が示されます。これらの件数は、認識されたパターンのみを対象とします。ラッパー、動的な名前、サポートされていない構文は検出されない場合があります。get_graph_summary には、認識された未解決の参照が一覧表示されます。エッジがないからといって、実行時のアクセスがないことの証明にはなりません。
get_log_errors は、保持に関するメタデータのみを返すようになりました。errorCount: null、topErrorPatterns: []、errorsObserved: false となります。互換性のための名前であり、エラーのサンプリングを意味するものではありません。ログメッセージ本文を取得することはありません。以前にサンプリングしたパターンが提供されないよう、古いキャッシュは無効化されます。
初期スナップショットの読み込み後に、オプションでバックグラウンド更新を行う場合は次のとおりです。
freshness:
  suggestRefreshAfterHours: 6
  refreshIntervalMinutes: 15
refreshIntervalMinutes は任意の設定で、1~1440 分の範囲で指定できます。ツールのリクエスト間に、クラウド、データベース、コードの全分析を実行します。更新はソース更新と直列化され、API/DB のコストが発生する場合があります。また、設定が変更されると、再起動するまでスケジュール設定が停止します。サーバーの実行中はスナップショットの古さを一定範囲に抑えますが、デプロイを即座に検出するものではありません。デプロイの境界を正確に反映するには、デプロイ後に infrawise analyze --config infrawise.yaml を実行してください。すでに実行中の MCP セッションには、次回の呼び出し時に更新済みのキャッシュが反映されます。
アシスタントでの利用を改善するには、アシスタントのワークフローに従ってください。実際のエディター実行を pnpm eval:assistant traces.json で評価するには、評価手順を参照してください。再現可能なパフォーマンスおよび結果の同等性チェックには pnpm benchmark を使用してください。ベンチマークの方法を参照してください。合成コントロールは、測定されたモデル品質スコアではありません。
analyze_function が found: false を返した場合、それは認識されたグラフに存在しないという意味であり、ソースコードにも存在しないと証明されたわけではありません。存在しないと断定する前に、ソースの健全性、ラッパー、動的参照を確認してください。セッションの更新に失敗した場合は、以前のグラフを保持したまま dataHealth.codeCoverage.refreshError に表示されます。
実行時メトリクスの読み取りが不完全な場合は、ソースの健全性に記録され、デフォルトで check をブロックします。アクティビティがゼロとは解釈されません。
検証コマンド:pnpm test:demo は、シード済みのローカルデータベース、インデックスのメタデータ、カバレッジ、CI の終了コードをテストします。pnpm test:demo --background は、時間指定の更新も検証します。先にデータベースのデモを起動し、シードしてください。
大規模リポジトリのメモリ使用量
TS/JS のスキャンでは、遅延評価される非同期ジェネレーターを使用し、最大 32 ファイルまたはソース 512 KiB までのバッチを順次処理します(これらの上限を超える対応ファイルは単独でスキャンされます)。各バッチの AST は次のバッチに進む前に解放されます。ウォッチセッションでは、プロジェクト全体のコンパイラー AST ではなく、抽出した操作と依存関係のパスを保持します。インポートされた依存関係の型や標準ライブラリの宣言は読み込みません。設定されたソースの選択に従い、解析前に依存関係フォルダー、宣言ファイル、および一般的な生成物の出力先(dist、build、.next、.nuxt、.output、coverage)を除外します。
2 MiB を超えるソースファイルは、不完全なコードカバレッジとしてソースの健全性レポートにパスが記録されますが、読み取り可能なファイルは引き続きスキャンされます。check は、--allow-incomplete を明示的に指定しない限り、解析が不完全な場合に終了コード 2 を返します。メモリ使用量は抽出された操作とインフラストラクチャグラフに応じて増加します。これは、無制限の規模のリポジトリに対応することを保証するものではありません。通常のスキャンでは、Node のヒープサイズを増やす必要はありません。pnpm test:memory を実行すると、フルスキャン、増分編集、共有インポートの更新、実際の analyze CLI を含む、256 MiB ヒープでの再現可能な回帰テストを実行できます。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。