Postgram について
Postgramは、個人や小規模の信頼できるチーム向けにセルフホストする、知識・生産性バックエンドです。人とAIエージェントで記憶、文書、タスク、関係データを共有できます。ハイブリッド検索、ナレッジグラフ、Markdownフォルダー同期を備え、一時的なセッションコンテキストと長期記憶を分けます。
主な機能
- 01記憶、人物、プロジェクト、タスクの型付き保存
- 02全文検索とベクトル検索の組み合わせ
- 03ナレッジグラフによる関係の表現
- 04セッションコンテキストと長期記憶の分離
- 05ローカルMarkdown文書の同期
- 06ブラウザーUI、REST API、CLI
活用シーン
- 01複数のエージェント間で共有するプロジェクト情報の検索
- 02文書、人物、タスク、記憶の横断検索
- 03GTD形式のタスクとカンバンビューの管理
- 04古いセッションコンテキストの整理と長期記憶への抽出
MCP 対応
Streamable HTTPのMCPエンドポイントを通じて、同じコーパスにアクセスするツールをエージェントに提供します。MCPツールにはセッションコンテキストの整理機能があり、リモート接続にはHTTPSとOAuthの設定が必要です。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
docker run -i --rm -e DATABASE_URL -e OPENAI_API_KEY -e EMBEDDING_PROVIDER -e EMBEDDING_BASE_URL -e ADMIN_MFA_SECRET_KEY -e ADMIN_SETTINGS_ENCRYPTION_KEY ghcr.io/ivo-toby/postgram@sha256:29b61fb302bd52862b8eba43305ee2aa4fc072d5f9188652f1fe6324f49d5391DATABASE_URLシークレットPostgreSQL connection URL for a database with the pgvector extension enabled.OPENAI_API_KEYシークレットRequired only when OpenAI is selected for embeddings or extraction.EMBEDDING_PROVIDEREmbedding provider: openai or ollama.EMBEDDING_BASE_URLOllama embedding endpoint when EMBEDDING_PROVIDER is ollama.ADMIN_MFA_SECRET_KEYシークレットStable random value of at least 32 characters used to protect admin MFA seeds.ADMIN_SETTINGS_ENCRYPTION_KEYシークレットStable 32-byte base64url key used to encrypt provider secrets saved in the admin UI.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ghcr.io/ivo-toby/postgram@sha256:29b61fb302bd52862b8eba43305ee2aa4fc072d5f9188652f1fe6324f49d5391Streamable HTTPツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細

Postgram
人間とAIエージェントのための、セルフホスト可能な生産性・ナレッジバックエンドです。
ウェブサイト · クイックスタート · MCP ガイド · REST API · デモ
Postgram は、あなたやエージェントが作業に使うデータを、メモ、ドキュメント、タスク、人物、プロジェクト、やり取り、意思決定、エージェントのメモリなど、すべて一か所に保存します。人間はブラウザー UI と CLI を使い、エージェントは MCP、REST、または CLI を通じて同じデータを利用します。
Postgram は単なるエージェントメモリレイヤーではありません。型付きのソースオブジェクトを保持し、GTD スタイルのタスク管理と Markdown フォルダーの同期をサポートします。また、全文検索とベクトル検索をナレッジグラフと組み合わせ、短期的なエージェントの作業コンテキストと永続的なメモリを分離します。
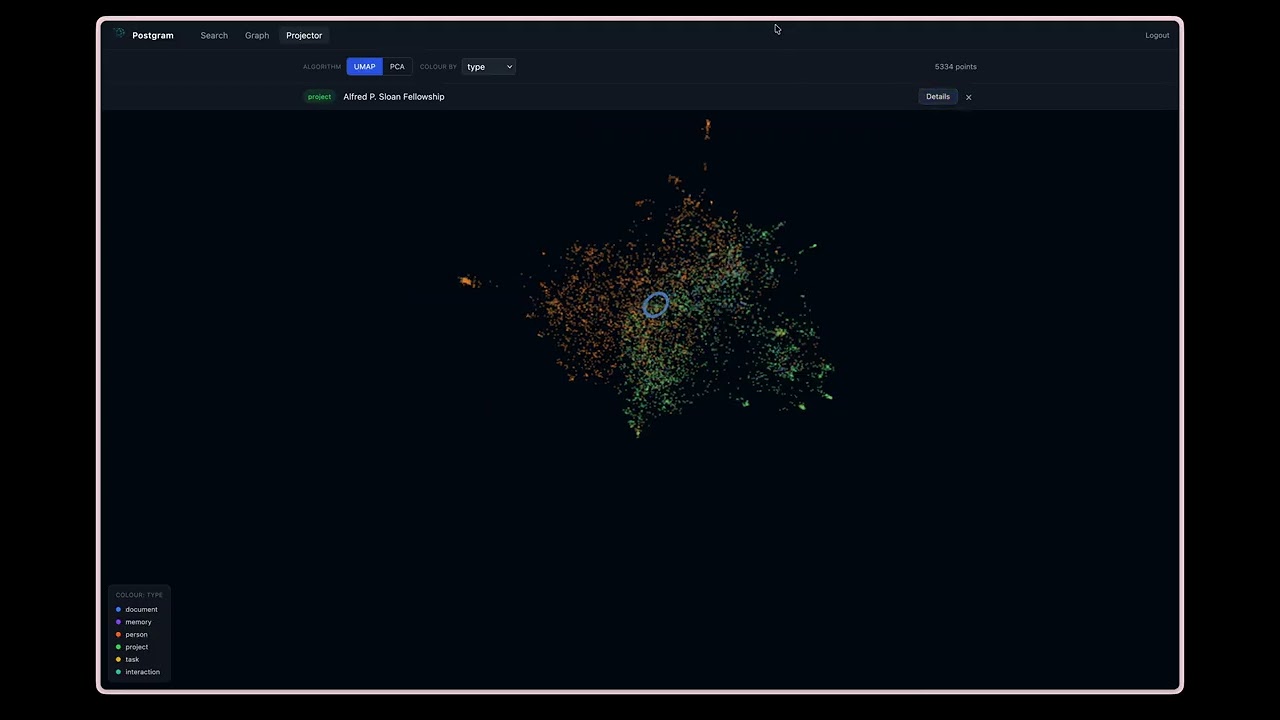
デモを見る |

メモリ、ドキュメント、人物、プロジェクト、タスクを横断して検索 |
Postgram を選ぶ理由
- ツールを横断するひとつのプライベートデータベース。 特定のエディターやホスト型メモリプロバイダーに縛られることなく、異なるエージェントやデバイスから同じデータにアクセスできます。
- 内容を確認できるソースデータ。 不透明なチャットの要約ではなく、型付きエンティティを保存することで、自分で検索、編集、リンク、アーカイブ、削除できます。
- グラフを展開する前に検索。 ハイブリッド検索で関連するエンティティを見つけ、エッジの要約によって、関連するグラフのコンテキストをたどる価値があるかどうかをエージェントに伝えます。
- 作業コンテキストと永続的なメモリを分離。 セッションコンテキストには独自のスコープとライフサイクルがあり、整理の際にアーカイブしたり、選択したコンテキストを永続的なメモリに抽出したりできます。
- 運用者による制御。 PostgreSQL の実行場所、使用を許可する埋め込み・抽出プロバイダー、API キーの受取人、保持するデータを選択できます。
Postgram は、ローカル環境または単一の VM でデプロイを実行する個人や、信頼できる少人数のチーム向けに構築されています。ホスト型サービスでもマルチテナントの SaaS プラットフォームでもありません。ナレッジ抽出は任意であり、付属の Docker Compose 設定では、API と UI のポートはデフォルトでループバックにバインドされます。
クイックスタート(Docker Compose)
Git、Docker、Docker Compose が必要です。Node.js 22 以降が必要なのは、ローカル開発または pgm CLI のインストール時のみです。gpg が必要なのは、暗号化された CLI バックアップを利用する場合のみです。
-
Postgram をクローンします。
git clone https://github.com/ivo-toby/postgram.git cd postgram -
初回起動前に、使用する埋め込み方法を選択します。ローカルのデフォルト設定を使用する場合は、Docker ホストに Ollama をインストールして起動し、Postgram のデフォルトの埋め込みモデルを取得します。
ollama pull bge-m3代わりにホスト型の OpenAI 埋め込みを使用する場合は、Compose の起動前に有効なキーを含む
.envファイルを作成します。OPENAI_API_KEY=<your-openai-key> -
スタックを起動します。
docker compose up -d --build初回起動時に、PostgreSQL 用とインストールシークレット用の永続 Docker ボリュームが作成されます。デフォルトの Compose 設定では
.envファイルは不要です。 -
一度だけ使用するブートストラップトークンを確認します。
docker compose logs mcp-server \
  | grep 'Bootstrap token:' \
  | tail -n 1
トークンの平文が表示されるのは、初回起動時の元のログのみです。API コンテナを再作成したり、ログを破棄したりする前に保存してください。
-
http://127.0.0.1:3000/admin を開き、トークンを貼り付けて、最初の管理者を作成し、MFA を登録して、オンボーディングの手順に従います。
-
Admin の Config タブで、選択したプロバイダーを確認します。ステージング設定を追加または変更した場合は、保存、検証、適用を行います。Admin で再起動が必要と表示された場合は、
mcp-serverを再起動します。docker compose restart mcp-serverDocker ホストで Ollama を実行する場合、そのベース URL は
http://host.docker.internal:11434です。オプションの LLM 関係抽出はデフォルトで無効になっており、OpenAI、Anthropic、Ollama、または OpenAI 互換エンドポイントを使用できます。初回起動後に埋め込みプロバイダー、モデル、または次元数を変更するには移行作業が必要であり、単純な設定の適用では変更できません。 -
ヘルスチェックを行い、Admin の Overview タブで API キーを作成します。以下のスモークテストでは、
readとwrite、エンティティタイプmemory、可視性personalを許可してください。curl -fsS http://127.0.0.1:3100/healthレスポンスに
"status":"ok"と"postgres":"connected"が含まれていることを確認してください。 -
CLI をインストールし、認証済みの書き込みと検索を検証します。エンリッチメントは非同期のため、検索の前に
pgm queueで保留中の作業がないことを確認してください。npm install -g @ivotoby/postgram-cli export PGM_API_URL=http://127.0.0.1:3100 export PGM_API_KEY='<plaintext-api-key>' pgm store "Postgram quick start is working" \ --type memory \ --visibility personal \ --tags quickstart pgm queue pgm search "quick start"
埋め込みにアクセスできない場合でも、Postgram は起動して書き込みを受け付けますが、プロバイダーが利用可能になるまでエンリッチメントと検索は失敗します。詳しい手順については、完全なクイックスタートとトラブルシューティングガイドをご覧ください。
ChatGPT、Claude、または他のリモート MCP クライアントからアクセスするには、Postgram を HTTPS の背後に配置し、OAuth を有効にして、MCP 統合ガイドに従ってください。ループバック開発用ポートをインターネットに直接公開しないでください。
できること
Postgram では、次のことができます。
- 型付きエンティティ(
memory、person、project、task、interaction、document)の永続ストレージ - 非同期エンリッチメントを備えた、キーワード検索とベクトル検索のハイブリッド検索
- エンティティ間の型付き有向エッジを持つナレッジグラフ
- LLM を活用した関係抽出(OpenAI、Anthropic、または Ollama)
- マニフェスト比較による、ローカルの Markdown リポジトリからのドキュメント同期
- ナレッジ作業用のブラウザーインターフェースと、保護機能を備えた管理インターフェース
- 埋め込み済みエンティティの UMAP および PCA 投影
- GTD スタイルの記録、タスク整理、カンバンビュー
- スコープ設定された API キー認証と可視性制限
- アプリケーションや自動化からアクセスするための REST API
- エージェントネイティブなツールアクセスを可能にする Streamable HTTP MCP エンドポイント
- 人間とエージェント向けの CLI(
pgm) - コンテナ内で実行する管理者向け CLI(
pgm-admin) - Talon SQLite 移行ツール
- 暗号化バックアップのサポート
- 変更操作および特権操作の監査ログ
仕組み
Postgram はサービスレイヤーを中心に構築された TypeScript Node.js アプリケーションです。
主なコンポーネント:
- 永続化とベクトル検索に PostgreSQL と
pgvector - HTTP サーバーに Hono
- エージェント向けのツールアクセスに Streamable HTTP 経由の MCP
- Commander で構築された CLI/管理用 CLI
- チャンク分割、埋め込み、LLM による抽出を行うバックグラウンドのエンリッチメントワーカー
大まかな処理の流れ:
- クライアントがエンティティを保存または更新します
- エンティティが即座に書き込まれます
- エンリッチメントが非同期で実行されます:チャンク分割、埋め込み、必要に応じて LLM による抽出
- チャンクと埋め込みがバックグラウンドで生成されます
- 抽出された関係からエッジが作成されます(抽出が有効な場合)
- 検索クエリでは、キーワード検索とベクトル検索を組み合わせた取得と逆順位融合が使用され、必要に応じてグラフが拡張されます
主な機能
1. 型付きナレッジストレージ
次の情報を含む構造化ナレッジオブジェクトを保存します。
type(memory、person、project、task、interaction、document)contenttagsvisibility(personal、work、shared)status- 任意の JSON メタデータ
メモリの役割
Postgram は、memory エンティティに次の 2 つの役割をサポートしています。
durable_memory:判断、好み、制約、根本原因、完了した作業の概要など、今後のエージェントが信頼すべき長期的なメモリです。session_context:直近の会話を再開するための作業コンテキストです。セッションコンテキストは呼び出し元のクライアントに限定され、セマンティック検索用に埋め込みが作成されます。また、グラフ抽出ではスキップされます。
「このスレッドではどこまで進みましたか?」にはセッションコンテキストを使います。「今後のエージェントが事実として覚えておくべきことは何ですか?」には耐久性のあるメモリを使います。
CLI ユーザーは pgm memory session-context でセッションコンテキストを記録し、pgm search --memory-role session_context で検索できます。
運用担当者は pgm-admin memory groom で古くなったセッションコンテキストを整理できます。
1 つのクライアントを対象にする場合は --client-id <client-id> を、すべてのセッションコンテキストスコープをまとめて処理する場合は --all-clients を使います。--all-clients でも各クライアントのスコープは個別に保たれます。これは運用上の一括処理であり、クライアント間の統合ではありません。
--older-than <duration> のデフォルトは 7d で、30m、4h、7d、0d などの値を指定できます。--dry-run を指定すると、LLM を呼び出さずに対象となるメモリをプレビューできます。整理の候補数にデフォルトの上限はありません。処理対象を限定するには --limit <n> を指定してください。
--mode archive --yes は、対象となる作業コンテキストをそのままアーカイブします。
--mode promote --yes は、設定済みの抽出用 LLM を使って、各セッションコンテキストのメモリを昇格するかどうかを判断します。昇格したメモリは新しい durable_memory エンティティに要約され、元のコンテキストはアーカイブされます。また、metadata.promoted_to と promoted_to エッジに出所が記録されます。
認証済みのユーザーとエージェントは、自分のクライアントスコープに限定されたセッションコンテキストのみを整理できます。
pgm memory groom --dry-run --older-than 7d
pgm memory groom --older-than 14d --topic postgram --tag session-context --yes
通常の CLI では PGM_API_KEY からスコープが導出されます。--client-id、--all-clients、昇格モードは指定できません。アーカイブには --yes が必要です。任意のフィルターとして --topic、--session-id、繰り返し指定可能な --tag を使用できます。
MCP クライアントは、同じセルフスコープで groom_session_context ツールを使用できます。
{
  "mode": "dry_run",
  "older_than": "7d",
  "topic": "postgram",
  "session_id": "optional-session-id",
  "tags": ["session-context"]
}
MCP の mode は dry_run または archive です。昇格は引き続き管理者のみが実行できます。
定期メンテナンスを行う場合は、Postgram コンテナーにアクセスできるホストから整理を実行してください。この cron の例では、3 日ごとの 03:17 にすべてのクライアントスコープを対象としてセッションコンテキストを評価し、JSON 出力をログに追記します。ラッパーは cron が TTY を提供しないことを検出し、非対話モードで実行します。
17 3 */3 * * cd /path/to/postgram && ./bin/pgm-admin --json memory groom --all-clients --older-than 7d --mode promote --yes >> /var/log/postgram-memory-groom.log 2>&1
LLM による昇格を行わず、対象となる作業コンテキストをアーカイブする場合は、代わりに --mode archive --yes を指定してください。対象となる集合を確認するには、まず同じコマンドに --dry-run を付けて実行してください。
運用担当者は、耐久性のあるメモリの内容を変更せずに、その品質を確認することもできます。
./bin/pgm-admin memory groom-durable --dry-run --older-than 30d
./bin/pgm-admin memory groom-durable --mode mark --yes --older-than 30d
耐久性のあるメモリの整理では、metadata.memory_role がないレガシーのメモリ行も含め、アクティブな durable_memory 行を選択し、keep、needs_grooming、archive、superseded に分類します。マークモードでは、結果、理由、確認日時、LLM による提案があればそれらを metadata.durable_grooming に書き込みます。内容の書き換え、ステータスの変更、行のアーカイブ、重複の統合は行いません。
マークした行を実際に整理するには、整理ラベルを適用します。
./bin/pgm-admin memory apply-durable-grooming --dry-run
./bin/pgm-admin memory apply-durable-grooming --yes
適用モードのデフォルトは auto です。needs_grooming のメモリは、保存済みの提案または設定済みの抽出用 LLM を使って書き換えられます。一方、archive と superseded のメモリはアーカイブされます。書き換え時には古いチャンクが消去され、埋め込みの拡充処理が再度キューに登録されます。バッチを絞り込むには、--mode rewrite または --mode archive に加えて、--status、--topic、--tag、--visibility、--limit を使用してください。
2. 非同期の拡充
コンテンツを持つエンティティは、最初に保存され、その後で拡充されます。各エンティティは enrichment_status を追跡します。値は pending、completed、failed のいずれかです。失敗したエンティティは、5 分のバックオフを挟んで最大 3 回再試行されます。
3. ハイブリッド検索
検索では、ベクトル近傍とクエリの語彙素に一致するチャンクを取得し、チャンクの重複を除去したうえで、相互順位融合(RRF)で順位付けします。
1 / (60 + vector_rank) + 1 / (60 + keyword_rank)。片方の検索経路に候補がない場合、その項の値はゼロです。キーワード検索では、クエリを空白で区切られた語に分割します。各語の simple 語彙素は AND で結合し、空でない語同士は OR で結合することで、ABC-1234 のような複合識別子を保持します。そのため、長いクエリでも、完全な語を1つ含むチャンクが候補に入る場合があります。複数語のクエリでは、英語辞書ベクトルが空の語(単独の英語ストップワード)を除外します。単一語の場合は、そのベクトルが空でも語を保持します。一致判定と順位付けには、引き続き PostgreSQL の simple 設定を使用します。広範な検索では HNSW インデックスを使用して候補を選択します。絞り込まれた小規模な集合では正確な距離で順位付けし、HNSW の候補スキャンで目標数に達しない場合も、正確な順位付けにフォールバックします。キーワードの解析では、複数語のクエリから英語ストップワードを除外した後、最初の24個の異なる空でない語のクエリを保持します。一方、埋め込みには元のクエリ全文を使用します。
キーワード候補の生成は、保持されたすべての語を対象とした完全な AND 検索から始まり、認可済みの GIN ヒットを最大200件まで取得します。上限に達した場合、それをキーワード候補プールとして使用し、ほかの検索はすべて省略します。保持された語が1つの場合も、同じ検索を再利用します。そうでなければ、認可済みの OR 検索を最大201件まで行い、全体の和集合が200チャンクのプールに収まるかを確認します。和集合が200チャンク以下であれば、語ごとの検索は行わず、全件を使用します。201件ヒットした場合は、語ごとに独立して検索し、既存の希少度/複合語の選択方法で200チャンクのプールを構成します。このフォールバックでは、完全な AND 検索のヒットを先頭に残します。語彙素の重複を除去するのは完全な AND クエリのみであり、語彙 OR のスコアリングは変更されません。上限付きの検索で上限を超える認可済みヒットがある場合、順序が定まらないその検索結果の構成は変動することがあります。そのため、この限られたプール内での ts_rank_cd とキーワード順位は近似値です。これは、ベクトル順位が候補検索によって制限されるのと同様です。
完全な AND 検索でプールが埋まらず、OR 検索が上限に達した場合、6つの一般的な語のうち5つに一致するような条件を満たす部分一致でも、上限付き検索の候補に含まれないことがあります。これは現在の制約として許容されており、評価の結果によっては、今後、交差検索を追加する可能性があります。
threshold は0から1までのコサイン類似度の下限です。候補は、ベクトル類似度がこの下限以上であるか、チャンクが保持された異なるキーワードの少なくとも半数(切り上げ)に一致すると、条件を満たします。ABC-1234 のような複合識別子を含む単一語クエリでは、保持された1つの語に一致する必要があります。部分一致のキーワード候補も、ベクトルの下限またはこの一致率の条件を満たせば対象になります。返される
score は相対的な RRF 順位の値であり、確率やパーセンテージではありません。similarity は引き続き生のコサイン値です。任意の新しさ乗数では、実際の30日間の半減期を使用します。両方の検索経路で1位の候補は、新しさ補正前のスコアが約 0.03279 になります。最終スコアが同じ場合は、キーワード順位、ベクトル順位、安定した識別子の順に優先します。検索には到達可能な埋め込みプロバイダーが必要です。プロバイダーが利用できない場合、書き込みは成功しますが、復旧するまでエンリッチメントと検索は失敗します。結果には次の内容が含まれます。
- 相対的な RRF スコア付きの順位付け結果
- コサイン類似度
- 新しさを反映した RRF スコア
- 一致したチャンクテキスト
- 任意の1ホップのグラフ近傍(
expand_graphパラメーター)
Migration 017 では、to_tsvector('simple', chunks.content) に対する式 GIN インデックスが追加されます。通常のトランザクション型 CREATE INDEX では、マイグレーション中も読み取りを継続できますが、マイグレーションのコミットまでは chunks への書き込みが待機します。テーブルヒープは書き換えません。マイグレーションランナーは CREATE INDEX CONCURRENTLY を使用できないため、起動のタイミングを適切に設定してください。
エンティティは、型付きの方向付きエッジで接続できます。
- 関係の種類:
involves、assigned_to、part_of、blocked_by、mentioned_in、related_to、または任意のカスタムタイプ - エッジには信頼度スコアが設定されます(手動の場合は1.0、抽出の場合はLLMが割り当てます)
- 設定可能な深度(1~3ホップ)で
expandによるグラフ探索ができます UNIQUE(source_id, target_id, relation)によってエッジの重複を防止します- エッジは
link/unlinkで手動作成するか、LLM抽出パイプラインで自動作成します

5. LLM抽出
有効にすると、エンリッチメントワーカーはLLMを使用してエンティティのコンテンツから関係を抽出します。抽出されたエンティティ名は既存のエンティティと照合され、エッジが自動的に作成されます。
対応プロバイダー:
| プロバイダー | モデルのデフォルト値 | 必要な環境変数 |
|---|---|---|
| OpenAI | gpt-4o-mini | OPENAI_API_KEY |
| Anthropic | claude-haiku-4-5-20251001 | ANTHROPIC_API_KEY |
| Ollama | llama3.2 | OLLAMA_BASE_URL(デフォルト:http://localhost:11434) |
これらは設定のデフォルト値であり、モデル品質の推奨値ではありません。グラフ抽出は制約付きの構造化出力タスクです。特に小規模なローカルモデルを使用する場合は、大規模なバックフィルを実行する前に、ご自身のコーパスで生成されたエッジを検証してください。

6. ドキュメント同期
Markdownファイルを含むローカルディレクトリをpostgramに同期します。
pgm sync ~/Documents/personal-notes
pgm sync ~/Documents/cf-notes --repo cf-notes --quiet
CLIはディレクトリ内の.mdファイルを走査し、SHA-256ハッシュを計算して、完全なマニフェストをサーバーに送信します。サーバーは保存済みの状態との差分を取り、ドキュメントエンティティを作成、更新、またはアーカイブします。--dry-runとcronによるスケジュール実行に対応しています。
7. アクセス制御
APIキーには、次の制限を設定できます。
- スコープ:
read、write、delete、sync - 許可されるエンティティタイプ
- 許可される可視性レベル
8. タスク管理
タスクは第一級のエンティティであり、次の便利な操作を利用できます。
- 作成(GTDコンテキストと期限を指定)
- 一覧表示(ステータスとコンテキストで絞り込み)
- 更新
- 完了(完了時刻を記録)
9. 複数のインターフェース
同じサービスレイヤーを、次のインターフェースから利用できます。
- REST API
- Streamable HTTP MCPエンドポイント
pgmCLIpgm-adminCLI(./bin/pgm-admin)- Chromeおよび
Firefox向けのブラウザー拡張機能 — REST API経由で現在のページまたは選択したテキストを取り込む、ワンクリックのウェブクリッパーです。
npm run -w @ivotoby/postgram-browser-extension-chrome package(またはFirefox版の同等コマンド)でビルドし、各パッケージのREADMEに従って展開済みの拡張機能をインストールします。
リポジトリの構成
src/
  auth/            API key validation and auth middleware
  cli/             CLI for humans/agents and admin CLI
  db/              Pool and migrations
  migrate-talon/   Talon import path
  services/        Business logic (entities, search, edges, sync, extraction)
  transport/       REST and MCP adapters
  types/           Shared types
  util/            Errors, audit, logging

ui/                User-facing web UI and Admin UI
cli/               Published @ivotoby/postgram-cli package
docker/            Container entrypoint and secret bootstrap scripts
bin/               Local operator wrappers

packages/
  browser-extension-chrome/   Chromium web clipper (MV3)
  browser-extension-firefox/  Firefox web clipper (MV3)

tests/
  contract/        REST and MCP contract tests
  integration/     Service and CLI integration tests
  unit/            Pure logic tests
要件
- 推奨されるデプロイにはDockerとDocker Compose
pgmCLIまたはローカル開発にはNode.js 22+- エンリッチメントと検索には、到達可能なOpenAIまたはOllamaの埋め込みプロバイダー
任意:
- OpenAI APIキー(OpenAIの埋め込みまたは抽出用)
- Anthropic APIキー(LLM抽出用)
- Ollama(ローカルでの埋め込みまたはLLM抽出用)
gpg(暗号化されたCLIバックアップ用)
Dockerセットアップの詳細
1. Docker Compose を起動する
docker compose up -d --build
デフォルトの Compose パスでは、.env を手動で編集する必要はありません。初回実行時に、以下を含む永続的な postgram_secrets Docker ボリュームが作成されます。
- アプリコンテナで使用する Postgres パスワード
- 暗号化された管理者 TOTP シード用の
ADMIN_MFA_SECRET_KEY - DB に保存されるプロバイダーシークレット用の
ADMIN_SETTINGS_ENCRYPTION_KEY
既存の Docker インストール環境で、すでに .env に POSTGRES_PASSWORD が設定されている場合、この変更後の初回起動時には、異なるデータベースパスワードを生成する代わりに、従来のパスワードが postgram_secrets/postgres-password にコピーされます。アップグレード後の初回起動時は、古い .env の値をそのまま残してください。
デフォルトでは、API は 127.0.0.1:3100 に、UI は 127.0.0.1:3000 にバインドします。複数のローカルスタックを実行する場合は、シェルで POSTGRAM_API_PORT=<port> または UI_PORT=<port> を指定して上書きしてください。
Compose で既存の Postgres クラスターを使用するには、運用担当者向けの例のように、Compose オーバーライドで mcp-server に POSTGRES_HOST、POSTGRES_PORT、POSTGRES_DB、POSTGRES_USER を設定し、postgres 依存関係を削除します。外部クラスターでパスワード認証が必要な場合は、.env に POSTGRES_PASSWORD を設定してください。パスワードなしのローカル認証を使用する場合は、POSTGRES_PASSWORD= を空のままにしてください。分割された設定を完全にバイパスするには、DATABASE_URL を設定することもできます。
埋め込みについては、OPENAI_API_KEY が設定されている場合、Compose は OpenAI をデフォルトとして維持します。OpenAI キーも明示的な EMBEDDING_PROVIDER も指定されていない場合、コンテナのエントリーポイントはローカルの Ollama 埋め込みを選択するため、プロバイダーシークレットの設定前でも、クリーンなスタックを起動できます。
2. 初回の管理者セットアップを完了する
初回起動時に、API コンテナはトークンを含む、明確な一度限りのブートストラップバナーを出力します。
Postgram first admin setup
Bootstrap token: ...
Open http://127.0.0.1:3000/admin and paste this token.
コンソールをスクロールしてしまった場合は、同じ一度限りのブートストラップトークンを、信頼できるローカルの運用担当者用チャネルから確認してください。
docker compose logs mcp-server | grep 'Bootstrap token:' | tail -n 1
次に、http://127.0.0.1:3000/admin を開き、最初の管理者ユーザーを作成して、MFA 登録を完了してください。ブートストラップトークンは、Postgres にハッシュのみの状態で保存され、24 時間後に期限切れとなり、最初の管理者が作成されると無効になります。Postgres の接続先を変更した場合は、最新のブートストラップトークンのログ行をコピーしてください。古いログ行は以前のデータベースに属している可能性があり、拒否されます。
MFA を使用したログインが完了すると、管理ダッシュボードでは、完了するか意図的にスキップするまで、ガイド付きオンボーディングフローが開きます。このガイドでは、運用担当者向けのわかりやすい言葉で、セットアップ手順を説明します。
- ブートストラップ、管理者ログイン、MFA 確認によって保護される内容
- プロバイダー設定、埋め込みの次元数、抽出モデル、書き込み専用のプロバイダーシークレットの関係
- 保存したプロバイダー設定を検証して適用するタイミング
- 切り替えの前にバックアップ/復元を段階的に行う理由
- メンテナンスのドライラン、再抽出、再埋め込み、エッジのプルーニングの仕組み
オンボーディングの進捗は、サーバー側の Postgres に保存されます。既存の pgdata ボリュームが保持されている限り、ブラウザーの更新、タブを閉じる操作、ログアウト後の再ログイン、Docker コンテナの再起動を行っても、最後に保存されたステップから再開できます。スキップまたは完了した後も、オンボーディングのタブはダッシュボードから引き続き利用できます。
ローカルの Docker テストでは、データベースボリュームを保持してください。
docker compose up -d --build
docker compose restart mcp-server postgram-ui
オンボーディングの再開動作をテストする際は、docker compose down -v を使用しないでください。このコマンドは、pgdata Postgres ボリュームを含む名前付きボリュームを削除し、データベースとともにサーバー側のオンボーディング状態もリセットします。
3. ヘルスを確認する
curl http://127.0.0.1:3100/health
期待される結果:
status: "ok"postgres: "connected"
4. プロバイダーを設定して API キーを作成する
サポートされている標準的な手順では、ブラウザーで管理ダッシュボードを使用します。
- Onboarding タブ:Docker を優先するセットアップガイドを再開、スキップ、または完了します。
- Config タブ:プロバイダー設定と、書き込み専用のプロバイダーシークレットを保存します。
- Overview タブ:Postgram API キーを作成し、ヘルス、キュー、統計情報、設定/モデル/ジョブのステータス、監査レコードを確認します。
- Maintenance タブ:安全なドライランのプレビューを実行し、破壊的な適用を行う前にジョブのステータスをポーリングします。
- Backup タブ:データのみを含む PostgreSQL カスタムダンプと、値をマスキングしたランタイム設定を含む gzipped v2 アーカイブをダウンロードします。復元は意図的に段階的に行われます。サーバーは従来の v1/フルスキーマアーカイブを拒否し、
pg_restore --listに含まれる承認済みの Postgram テーブルデータエントリーのみを受け入れます。バンドルされたマイグレーションから信頼済みのスキーマを作成し、受け入れたデータを新しいデータベース名に復元します。オペレーターが切り替えを承認する前に、ヘルスチェックが実行されます。復元したデータベースに問題がある場合は、以前のPOSTGRES_DBまたはDATABASE_URLの設定に戻してmcp-server/postgram-uiを再起動し、ロールバックします。この緊急対応では、古いデータベースは変更されません。
通常の Docker のセットアップとメンテナンスでは、起動/ブートストラップ後に pgm-admin を使う必要はありません。pgm-admin CLI については、緊急時の復旧、マイグレーションの埋め込み、生 SQL の確認、高度なオペレータージョブ向けに、以下で引き続き説明します。
Docker シークレットのバックアップと障害時の動作
postgram_secrets Docker ボリュームは、データベースのバックアップとは別にバックアップしてください。データベースのバックアップには、暗号化されたプロバイダーシークレットと暗号化された TOTP 認証要素が含まれますが、それらの復号に必要なインストールキーは含まれません。
ADMIN_MFA_SECRET_KEY を紛失または置き換えると、既存の TOTP 認証要素を検証できなくなります。ADMIN_SETTINGS_ENCRYPTION_KEY を紛失または置き換えると、保存済みのプロバイダーシークレットを復号できなくなります。誤った設定キーを使うと、プロバイダー設定の読み取りでは引き続き値がマスキングされ、プロバイダーの適用/ランタイムでのシークレットの使用はフェイルクローズします。オペレーターは元のキーを復元するか、意図的なローテーション/復旧手順の後にプロバイダーシークレットを再保存する必要があります。
Docker Compose では、シークレットファイルが存在しない場合、空の postgram_secrets ボリュームに限り生成されます。永続化されたシークレットファイルが無効な場合、サーバーがバインドする前にコンテナーの起動が失敗します。オプションの環境変数による上書きも引き続き使用できますが、それらの値はデータベースのバックアップやブラウザーのストレージに保存しないでください。
環境変数
サーバー
| 変数 | 必須 | デフォルト | 説明 |
|---|---|---|---|
DATABASE_URL | Compose 以外 | Docker secret file + Postgres env | Postgres 接続文字列全体です。未設定の場合、Compose は生成された Postgres パスワードシークレットから構築します。 |
POSTGRES_HOST | いいえ | postgres | DATABASE_URL が未設定の場合に使用する Compose の Postgres ホストです。既存のクラスターを使用する場合は、host.docker.internal または別のホスト名に上書きします。 |
POSTGRES_PORT | いいえ | 5432 | DATABASE_URL が未設定の場合に使用する Compose の Postgres ポートです。 |
POSTGRES_DB | いいえ | postgram | DATABASE_URL が未設定の場合に使用する Compose の Postgres データベースです。 |
POSTGRES_USER | いいえ | postgram | DATABASE_URL が未設定の場合に使用する Compose の Postgres ユーザーです。 |
POSTGRES_PASSWORD | いいえ | Docker secret file | DATABASE_URL が未設定の場合に使用する Compose の Postgres パスワードです。外部ホストの場合、明示的に空の値を指定するとパスワードなしの URL が構築されます。 |
ADMIN_MFA_SECRET_KEY | 管理者のセットアップ | Docker secret file | 管理者の TOTP シードを暗号化するために使用する、32 文字以上の固定シークレットです。未設定の場合、Compose が postgram_secrets に生成して永続化します。 |
OPENAI_API_KEY | 条件付き | EMBEDDING_PROVIDER=openai、または(EXTRACTION_ENABLED=true かつ EXTRACTION_PROVIDER=openai)の場合に必須です。それ以外の場合は任意です。 | |
ADMIN_SETTINGS_ENCRYPTION_KEY | 管理者が管理するシークレットを保存する場合 | Docker secret file | データベース内のプロバイダーシークレットを暗号化するために使用する、32 バイトの base64url インストールキーです。未設定の場合、Compose が postgram_secrets に生成して永続化します。データベースのバックアップとは別に保管してください。 |
PORT | いいえ | 3100 | HTTP/MCP サーバーのポート |
POSTGRAM_API_PORT | いいえ | 3100 | API/バックエンド用の Docker Compose ホストポートです。コンテナーのリッスンポートは 3100 のままです。 |
UI_PORT | いいえ | 3000 | UI 用の Docker Compose ホストポートです。 |
OAUTH_ENABLED | いいえ | false | ネイティブのリモート MCP コネクター向けに、OAuth 認可コード、PKCE、動的クライアント登録のルートを有効にします。 |
PUBLIC_BASE_URL | 条件付き | OAuth メタデータとコールバック URL 用の公開 HTTPS オリジンです。OAUTH_ENABLED=true の場合に必須です。例:https://postgram.example.com。 | |
LOG_LEVEL | いいえ | info | pino のログレベル |
ENRICHMENT_POLL_INTERVAL_MS | いいえ | 1000 | エンリッチメントワーカーのポーリング間隔 |
Embeddings
| 変数 | 必須 | デフォルト | 説明 |
|---|---|---|---|
EMBEDDING_PROVIDER | いいえ | openai(Compose が自動選択) | openai または ollama を指定します。OPENAI_API_KEY が設定されている場合、Compose は OpenAI を選択し、設定されていない場合は明示的に指定されていない限り Ollama を選択します。 |
EMBEDDING_MODEL | いいえ | プロバイダーごと | デフォルト:text-embedding-3-small(openai、1536 次元)、bge-m3(ollama、1024 次元) |
EMBEDDING_DIMENSIONS | いいえ | プロバイダーごと | 有効な embedding_models の行と一致させる必要があります。変更するには ./bin/pgm-admin embeddings migrate --target-dimensions <N> --yes を実行します。 |
EMBEDDING_BASE_URL | provider=ollama の場合 | OLLAMA_BASE_URL にフォールバック | Embedding のホストです。LLM 抽出用のホストとは独立しているため、Embedding と推論で異なるマシンを指定できます。 |
EMBEDDING_API_KEY | いいえ | EMBEDDING_BASE_URL 用の任意のベアラートークンです。 | |
EMBEDDING_TIMEOUT_MS | いいえ | 15000 | 1 回の Embedding プロバイダー呼び出しに対する厳密なタイムアウトです。停止した呼び出しによってリクエストが遅延する時間を制限します。 |
QUERY_EMBEDDING_CACHE_SIZE | いいえ | 512 | Postgres を利用したキャッシュの前段で保持する、プロセス内のクエリ Embedding 数です。 |
QUERY_EMBEDDING_CACHE_SECRET | いいえ | HMAC を使ってクエリダイジェストにキーを設定します。設定しない場合、ダイジェストはキーなしの sha256 となり、データベースを読み取れる人が、推測したクエリが実行されたかを辞書攻撃で確認できる可能性があります。クエリテキストをエンティティの内容より機密性の高い情報として扱う場合は設定してください。意味のある保護にするには、データベースの外部に保管する必要があります。変更すると、既存のキャッシュ行は無効になります。 | |
QUERY_EMBEDDING_CACHE_RETENTION_DAYS | いいえ | 30 | 永続化されたクエリ Embedding を削除する経過日数です。1 時間ごとの削除処理では、クライアントごとに新しい順で 2,000 件のみが保持されます。 |
Postgram が Docker で動作し、Ollama が Docker ホスト上で直接動作している場合は、EMBEDDING_BASE_URL に http://host.docker.internal:11434 を使用してください。コンテナ内の localhost はホストマシンではなく、Postgram コンテナを指します。
Ollama への新規インストールと OpenAI からの移行手順については、specs/002-local-embeddings/quickstart.md を参照してください。
LLM Extraction
| 変数 | 必須 | デフォルト | 説明 |
|---|---|---|---|
EXTRACTION_ENABLED | いいえ | false | LLM による関係抽出を有効にします |
EXTRACTION_MEMORY_MODE | いいえ | embed_only | type=memory のグラフ抽出を制御します。embed_only は、グラフ/エンティティ抽出を行わず、埋め込みを通じてすべてのメモリを検索可能にします。extract_durable は durable_memory のみを抽出し、extract_all は永続メモリとセッションコンテキストメモリの両方を抽出します。 |
EXTRACTION_PROVIDER | いいえ | openai | LLM プロバイダー:openai、anthropic、ollama、または openai-compatible |
EXTRACTION_MODEL | いいえ | プロバイダーごと | モデル名(デフォルト:OpenAI は gpt-4o-mini、Anthropic は claude-haiku-4-5-20251001、Ollama は llama3.2、OpenAI 互換は gpt-4o-mini) |
EXTRACTION_BASE_URL | プロバイダーが openai-compatible の場合 | /v1 パスを含む、OpenAI 互換のチャット補完 API のベース URL です。Postgram は /chat/completions を追加します。例:http://host.docker.internal:8000/v1。 | |
EXTRACTION_API_KEY | いいえ | EXTRACTION_BASE_URL 用の任意のベアラートークンです。 | |
EXTRACTION_AUTO_CREATE_ENTITIES | いいえ | false | true の場合、抽出時に、参照された対象がまだ存在しないときはスタブエンティティを作成します(例:文書に記載された人物の person エンティティが自動的に作成されます)。auto-created タグが付与され、メタデータには元の文書が記録されます。 |
EXTRACTION_AUTO_CREATE_TYPES | いいえ | person,project,interaction | 自動作成の対象となるエンティティタイプのカンマ区切りリストです。ユーザーが作成したものとして扱うため、document、task、memory は意図的にデフォルトから除外されています。 |
EXTRACTION_AUTO_CREATE_MIN_CONFIDENCE | いいえ | 0.7 | エンティティを自動作成するために必要な、抽出ごとの最小信頼度(0~1)です。ノイズを減らすには値を上げ、より密なグラフにするには値を下げてください。 |
ANTHROPIC_API_KEY | プロバイダーが anthropic の場合 | Anthropic API キー | |
OLLAMA_BASE_URL | いいえ | http://localhost:11434 | Ollama サーバーの URL |
EXTRACTION_REASONING_EFFORT | いいえ | 未設定 | minimal | low | medium | high。推論モデル(o-series、gpt-5、gpt-oss)について、OpenAI と Ollama に reasoning_effort として渡されます。設定すると、EXTRACTION_DISABLE_THINKING=true が OpenAI に送信する暗黙の minimal を上書きします。 |
LLM_REQUEST_TIMEOUT_MS | いいえ | 120000 | LLM 呼び出しごとのタイムアウト上限(ミリ秒)です。低速なローカルモデル(例:gpt-oss:120b-cloud)を実行する場合は、この値を大きくしてください。 |
EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED | いいえ | false | セマンティックな隣接ノードのリンクを有効にします(以下を参照)。 |
EXTRACTION_SEMANTIC_NEIGHBORS_MAX | いいえ | 10 | エンティティごとに作成する隣接エッジの最大数です。 |
EXTRACTION_SEMANTIC_NEIGHBORS_MIN_SIMILARITY | いいえ | 0.65 | エンティティが隣接ノードとして適格となるためのコサイン類似度の最小値(0~1)です。ノイズを減らすには値を上げ、隣接ノードが少なすぎる場合は値を下げてください。適切な値は埋め込みモデルの類似度分布によって異なります。調整する前に ./bin/pgm-admin link-neighbors --all --dry-run を実行して、実際のスコアを確認してください。 |
セマンティックな近傍エンティティのリンク:LLM による抽出処理では、ソースコンテンツ内で明示的に名前が挙げられているエンティティのみが見つかります。同じ取り組みに関する週次キックオフミーティング、同じ戦略を扱う Wiki ページ、同じプロジェクトに関する決定メモなど、テーマ上は関連していても名前が挙げられていないエンティティは見つかりません。EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED=true の場合、LLM による抽出後に第 2 の処理が実行され、ナレッジストアを検索して、保存済みのチャンク埋め込みがソースエンティティ自身の埋め込みとコサイン類似度の高いエンティティを取得し、related_to でリンクします。追加の LLM 呼び出しや埋め込み API 呼び出しは不要です。ソースエンティティのチャンクは、抽出前に実行されるエンリッチメント処理ですでに保存されています。この処理で作成されたエッジには source = 'semantic-neighbor' が設定されるため、LLM が抽出したエッジと区別できます。LLM の処理ですでにリンクされたエンティティは除外されます。同じペアに対して、より強い型のエッジを、より弱い related_to エッジが覆い隠すのを防ぐためです。 |
近傍エッジのバックフィルとメンテナンス:./bin/pgm-admin link-neighbors コマンドを実行すると、セマンティックな近傍エンティティの処理を直接実行できます。LLM 呼び出しや抽出キューは使わず、保存済みチャンクのコサイン類似度だけを使用します。既存のグラフのバックフィルや、新しいエンティティの追加後に定期的なメンテナンスジョブとして実行する場合に使用してください。
# Backfill all enriched entities (safe to re-run — edges are upserted).
./bin/pgm-admin link-neighbors --all

# Only documents:
./bin/pgm-admin link-neighbors --type document

# Single entity:
./bin/pgm-admin link-neighbors --id <uuid>

# Preview what would be linked and at what similarity — no edges created:
./bin/pgm-admin link-neighbors --id <uuid> --dry-run
./bin/pgm-admin link-neighbors --all --dry-run

# Tune the similarity threshold or edge cap:
./bin/pgm-admin link-neighbors --all --min-similarity 0.75 --max-neighbors 5

# Process in bounded batches (oldest-first):
./bin/pgm-admin link-neighbors --all --limit 500
エッジを確定する前に実際のコサイン類似度スコアを確認するには、--dry-run を使用してください。新しい埋め込みモデル向けに --min-similarity を調整する場合に特に便利です。出力には各エンティティと、類似度の生スコアを含む候補の近傍エンティティが表示されます。
同時に LLM による抽出も再実行したい場合(たとえば EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED=true を有効にした後)は、代わりに reextract を使用してください。ワーカーが LLM による処理と近傍エンティティの処理をまとめて実行します。
./bin/pgm-admin reextract --all
注:reextract の --clean-edges が削除するのは source='llm-extraction' のエッジのみです。semantic-neighbor エッジには影響しません。すべてをクリーンな状態にするには、次のようにします。
DELETE FROM edges WHERE source = 'semantic-neighbor';
定期的なメンテナンスジョブとしてのスケジュール設定:link-neighbors は低コストで(LLM 呼び出しなし)、冪等性がある(エッジは複製されずにアップサートされる)ため、新しいエンティティの追加に合わせて近傍グラフを最新の状態に保つ週次 cron ジョブとして適しています。毎週日曜日の 02:00 に実行する cron エントリの例:
0 2 * * 0 cd /path/to/postgram && ./bin/pgm-admin link-neighbors --all
または Docker Compose を使用する場合:
./bin/pgm-admin link-neighbors --all
自動作成されたエンティティ:EXTRACTION_AUTO_CREATE_ENTITIES=true の場合、ドキュメントで言及される前には存在しなかったエンティティが、content に抽出された名前を設定され、tags に auto-created を含む状態で挿入されます。また、metadata.auto_created_by = 'llm-extraction' が設定され、作成のきっかけとなったドキュメントを示す metadata.source_entity_id が付与されます。通常の埋め込みキューに追加されて検索可能になりますが、意図的に抽出キューからは除外されています。コンテンツが名前だけの場合、コンテキストなしで LLM に「アリスは何と関係がありますか?」と尋ねると、根拠のない新しい仮エンティティをループ状に作り出してしまうからです。確認またはクリーンアップするには、次のようにします。
pgm list --tags auto-created --type person
# or wholesale prune:
docker compose exec postgres psql -U postgram -d postgram -c \
  "DELETE FROM entities WHERE 'auto-created' = ANY(tags);"
CLI
| 変数 | 必須 | 説明 |
|---|---|---|
PGM_API_URL | はい | サーバー URL |
PGM_API_KEY | はい | 認証用の API キー |
Admin CLI
| 変数 | 必須 | 説明 |
|---|---|---|
DATABASE_URL | はい | 管理操作用の直接 DB 接続 |
バックアップ
| 変数 | 必須 | 説明 |
|---|---|---|
DATABASE_URL or PGM_DATABASE_URL | はい | データベース接続 |
PGM_BACKUP_PASSPHRASE | --encrypt の使用時 | GPG 暗号化パスフレーズ |
サーバーの実行
ビルド済み Docker イメージ
GitHub Container Registry からプルします。
docker pull ghcr.io/ivo-toby/postgram:latest
イメージはマルチアーキテクチャに対応しています(linux/amd64、linux/arm64)。利用可能なタグは次のとおりです。
latest—mainの最新ビルドmain—latestと同じで、ブランチ名を明示したものsha-<short>— 特定のコミットに固定
このリポジトリの docker-compose.yml はデフォルトでローカルビルドを行います。代わりにビルド済みイメージを使用するには、mcp-server サービスの build: . を image: ghcr.io/ivo-toby/postgram:latest に置き換えてください。
ローカル開発
npm run dev
本番環境と同様の方法でローカル実行します。
npm run build
npm start
サーバーが公開するエンドポイントは次のとおりです。
- REST API:
http://127.0.0.1:3100/api - MCP エンドポイント:
http://127.0.0.1:3100/mcp - ヘルスチェックエンドポイント:
http://127.0.0.1:3100/health
認証
http://127.0.0.1:3000/admin の管理ダッシュボードで API キーを作成します。キーのプレーンテキストはブラウザーに一度だけ表示され、閉じるか再読み込みすると復元できません。
CLI で使用するためにエクスポートします。
export PGM_API_URL=http://127.0.0.1:3100
export PGM_API_KEY='<plaintext-key>'
REST API の概要
エンティティのエンドポイント
POST /api/entities— エンティティを保存GET /api/entities/:id— エンティティを取得PATCH /api/entities/:id— エンティティを更新DELETE /api/entities/:id— エンティティを論理削除GET /api/entities— エンティティの一覧を取得
検索
POST /api/search— RRF スコアを使用したキーワードとベクトルのハイブリッド検索(expand_graphとinclude_contentに対応)
REST 検索では、後方互換性のため、デフォルトでエンティティの全コンテンツを保持します。include_content: false を指定すると、全結果やグラフ近傍のコンテンツを展開またはシリアライズせずに、一致したチャンクを返します。その他の REST ルートは、引き続き従来どおりの完全な JSON レスポンスを返します。コンパクト JSON と TOON は、MCP と CLI のトランスポート層で利用できる便利な機能です。
タスク
POST /api/tasks— タスクを作成GET /api/tasks— タスクの一覧を取得PATCH /api/tasks/:id— タスクを更新POST /api/tasks/:id/complete— タスクを完了
ドキュメントの同期
POST /api/sync/diff— ローカルのマニフェストとサーバーを比較し、アップロードおよび削除するパスを返すPOST /api/sync/upload— ファイルの内容を一括アップロードPOST /api/sync/finalize— 孤立した項目をアーカイブし、古い一致項目を復元POST /api/sync— 1 回のリクエストでプッシュ(MCP および小規模な同期用に維持)GET /api/sync/status/:repo— 同期状態を取得
pgm sync は 3 フェーズのプロトコル(diff → バッチ単位の upload → finalize)を使用するため、大規模なリポジトリでも単一の過大なペイロードを送信しません。各アップロードバッチは、先に上限に達した方に応じて、約 50 ファイルまたは約 4 MB までです。
ナレッジグラフ
POST /api/edges— エッジを作成DELETE /api/edges/:id— エッジを削除GET /api/entities/:id/edges— エンティティのエッジ一覧を取得GET /api/entities/:id/graph— グラフの近傍を展開
キュー/エンリッチメント
-
GET /api/queue— エンリッチメントと抽出のキュー状態を取得します。?include_failures=true(任意で&failure_limit=Nを指定。デフォルトは 20、最大 100)を渡すと、最新の失敗したエンティティとエラーメッセージも取得できます。例:{ "embedding": { "pending": 0, "completed": 120, "failed": 0, "retry_eligible": 0, "oldest_pending_secs": null }, "extraction": { "pending": 2, "completed": 98, "failed": 3 }, "failures": [ { "id": "…", "type": "document", "kind": "extraction", "error": "llm context exceeded", "path": "notes/long.md", "updatedAt": "2026-04-22T10:12:33Z" } ] }
すべての /api/* ルートには Authorization: Bearer <api-key> が必要です。
MCP の概要
MCP は以下の Streamable HTTP エンドポイントで提供されます。
http://127.0.0.1:3100/mcp
公開されているツール:
store、recall、search、update、delete、queuestore_session_context、groom_session_contexttask_create、task_list、task_update、task_completesync_push、sync_statuslink、unlink、expand
MCP ツールの動作は意図的に REST のインターフェースに合わせていますが、 トークンを多く消費する出力は、デフォルトで簡潔なエージェント向けレスポンスを返します。
- 書き込みの確認応答(
store、store_session_context、update、タスクの 書き込み、link)は、メタデータやタイムスタンプ全体を返す代わりに、簡潔な ID/ステータス/バージョンを返します。 search、task_list、expandはデフォルトで簡潔な行/グラフのペイロードを返します。簡潔な検索結果には、結果全体や隣接コンテンツではなく、一致したチャンクが含まれます。また、低コストでたどれるようにedges.countとedges.relationsが含まれる場合があります。full_response: trueを渡すと、エンティティの全コンテンツを含む、REST 形式の完全なペイロードを取得できます。- リスト形式のツール(
search、task_list、expand)にtoon: trueを渡すと、MCP レイヤーから簡潔な TOON テキストを受け取れます。
検索は情報を見つけるためのステップです。簡潔な ID、相対 RRF スコア、一致したチャンクを確認し、全コンテンツが必要な選択済みエンティティに対してのみ recall を呼び出します。検索スコアは並べ替えに使う数値であり、パーセンテージではありません。呼び出し元がベクトルのシグナルを必要とする場合は、完全なレスポンスでコサイン similarity を利用できます。簡潔な edges の概要に含まれるのは件数と関係ラベルのみで、隣接コンテンツは含まれません。ユーザーが原因、来歴、判断、依存関係、ブロッカー、所有権、関与、議論の参加者、関連コンテキスト、またはグラフベースの曖昧性解消を必要とする場合は、expand_graph または expand を使用してください。一致したチャンクにすでに記載されている直接的な事実を確認するためだけに展開するのは避けてください。
基盤となる API は引き続き JSON を使用します。簡潔化と TOON は MCP/CLI のハンドラー内でのみ行われます。
ネイティブのリモートコネクター(ChatGPT と Claude)
ローカルの MCP クライアントは静的なベアラー API キーで接続できます。カスタムコネクター/開発者モードを利用できる ChatGPT アカウントと、Claude のコネクター UI は、クライアント設定に静的な API キーヘッダーを保存せずに、OAuth を通じて公開されている Postgram エンドポイントに接続できます。
OAUTH_ENABLED=true
PUBLIC_BASE_URL=https://postgram.example.com
ChatGPT または Claude で、${PUBLIC_BASE_URL}/mcp をコネクター URL として追加してください。クライアントは /.well-known/oauth-protected-resource/mcp を検出し、/oauth/register を通じて登録し、/oauth/authorize を開いて、/oauth/token から OAuth トークンを受け取ります。エンドポイントには、インターネットからアクセスできる HTTPS が必要です。
認可ページでは、既存の Postgram API キーを一度だけ求められます。その承認を通じて発行されるトークンは、API キーのスコープ、client_id、許可されたエンティティタイプ、許可された可視性を引き継ぎます。元の API キーが失効すると、そこから派生した OAuth アクセストークンとリフレッシュトークンは機能しなくなります。既存の Authorization: Bearer <api-key> クライアントと /mcp?apiKey=... は、これまでどおり変更なく動作します。
CLI(pgm)
npm からインストール
npm install -g @ivotoby/postgram-cli
次に、一度だけ設定します。
export PGM_API_URL=http://<postgram-host>:3100
export PGM_API_KEY=<your-api-key>
# or persist them in ~/.pgmrc as JSON: { "api_url": "...", "api_key": "..." }
ソースから実行する(開発用)
リポジトリのルートから TypeScript のエントリーポイントを直接実行します。ビルド手順は不要で、ローカルの変更がすぐに反映されます。
npx tsx cli/src/pgm.ts <command>
# e.g.
npx tsx cli/src/pgm.ts sync ~/Documents/personal-notes --repo personal-notes
エンティティコマンド
pgm store "decided to use pgvector" --type memory --tags decisions
pgm search "database decisions"
pgm search "database decisions" --type memory          # filter by entity type
pgm search "who worked on embeddings" --expand-graph   # include graph neighbours
pgm search "database decisions" --json                 # matched chunks for agents
pgm search "database decisions" --json --full-response # complete legacy search response
pgm search "database decisions" --limit 5 --toon       # compact discovery output
pgm recall <selected-entity-id>                         # complete selected content
pgm list --json                                        # compact JSON rows
pgm list --json --full-response                        # full API-shaped rows
pgm list --toon                                        # compact TOON rows
pgm expand <id> --json                                 # compact graph JSON
pgm expand <id> --toon                                 # compact TOON graph
pgm recall <id>
pgm list --type memory
pgm update <id> --content "updated text" --version 1
pgm delete <id>
タスクコマンド
pgm task add "set up monitoring" --context @focus-work --status next
pgm task list --status next
pgm task update <id> --status waiting --version 1
pgm task complete <id> --version 2
ドキュメント同期
pgm sync ~/Documents/personal-notes
pgm sync ~/Documents/cf-notes --repo cf-notes --dry-run
pgm sync ~/Documents/personal-notes --quiet  # for cron
ナレッジグラフ
pgm link <source-id> <target-id> --relation involves
pgm expand <entity-id> --depth 2
pgm unlink <edge-id>
バックアップ
pgm backup --encrypt --output /tmp/postgram-backups/
管理 CLI(pgm-admin)
サポート対象の Docker での基本的な手順では、ブラウザーの管理ダッシュボードを使って、初期セットアップ、プロバイダーの設定、API キーの作成、ステータスの確認、安全なメンテナンスのドライランを行います。pgm-admin は、緊急時の復旧、埋め込みの移行、SQL の直接確認、高度な運用ジョブで引き続き利用できます。
簡単な CLI の手順では、リポジトリに含まれる bin/pgm-admin ラッパーを使います。コンテナーが起動している場合は docker exec で pgm-admin を実行し、起動していない場合は docker compose run --rm にフォールバックします(初回起動時の移行や、起動時の次元チェックにより起動が拒否されている場合に便利です)。
./bin/pgm-admin <command> [args...]
cron などの非対話型自動化では、TTY の割り当てを試みないように、Docker を -T 付きで呼び出します。
docker compose exec -T mcp-server /app/docker-entrypoint.sh pgm-admin <command>
例:
./bin/pgm-admin key create --name local --scopes read,write,delete --visibility personal,work,shared
./bin/pgm-admin stats
./bin/pgm-admin embeddings migrate --target-dimensions 1024 --dry-run
docker compose stop mcp-server
./bin/pgm-admin embeddings migrate --target-dimensions 1024 --yes
docker compose up -d mcp-server
Admin で埋め込みプロバイダー、モデル、または次元を変更した場合は、この移行シーケンスを実行する前に、対象の設定を保存、検証、適用してください。ラッパーは、mcp-server の実行中に --yes を拒否します。これは、稼働中のエンリッチメントワーカーが以前のメモリ内プロバイダーを使って再埋め込みキューを処理するのを防ぐためです。サービスの実行中でも、ドライランは安全に実行できます。
日常的な使用に便利なシェルエイリアス(Docker ホストの ~/.bashrc または ~/.zshrc に追加してください):
alias pgm-admin='/path/to/postgram/bin/pgm-admin'
# then just: pgm-admin stats
サービス名やコンテナー名が異なる場合は、環境変数で上書きします。
PGM_SERVICE=mcp-server PGM_CONTAINER=my-postgram-mcp-server-1 ./bin/pgm-admin stats
ラッパーを使わない場合の同等の直接コマンド(参考):
docker compose exec -T mcp-server /app/docker-entrypoint.sh pgm-admin <command>
# or, when the container is down:
docker compose run --rm mcp-server pgm-admin <command>
すでに実行中のコンテナー内でコマンドを実行する場合、エントリーポイントが必要です。エントリーポイントは、DATABASE_URL などの Docker 管理値を再構成します。これらの値はサーバープロセスにはエクスポートされていますが、通常の docker compose exec の環境には存在しません。
主なコマンド:
-
key create、key list、key revoke -
audit— 監査ログを照会します -
model list、model set-active -
reembed --all— エンティティを再埋め込み対象としてマークします(必要に応じて--type <type>を指定できます。同じトランザクション内でアクティブな埋め込みモデルを切り替えるには、--model <id>と組み合わせます) -
reextract --all—extraction_status = 'pending'にリセットし、保存されているextraction_errorを消去して、ワーカーが抽出を再試行するようにします(例:より優れた LLM に切り替えた後)。主なフラグ:--type <type>— 特定のエンティティタイプに対象を限定します--only-failed— 以前の抽出に失敗したエンティティのみを再キューイングします--no-edges-only— LLM が抽出したエッジがないエンティティのみを再キューイングします。すでに正しくリンクされているエンティティを再処理せず、対象を絞ったメンテナンスを行う場合に便利です(大きなドキュメントで、エッジが生成されなかったものを検出するには--type documentと組み合わせます)--clean-edges— 対象エンティティの既存のsource='llm-extraction'エッジを削除してから再キューイングします。既存のエッジに追加するのではなく、クリーンな状態からやり直します--limit <n>— キューに追加するエンティティ数の上限を設定します(古いものから順)
ユーザーが作成したエッジ(
source != 'llm-extraction')には一切触れません。 -
improve-graph— エンティティを再抽出対象としてキューに追加します。実行ごとのモデル/プロバイダーの上書き設定を行に保存することもできます。ワーカーは環境変数で設定されたデフォルトの代わりにこの上書き設定を使用し、成功後に消去します。デフォルトでは既存のエッジを保持し(削除しません)、重複するエッジの信頼度は新しい実行の値で上書きされます。主なフラグ:--all、--type <type>、--id <uuid>— キューに追加する対象を指定します--model <name>— 例:claude-sonnet-4-6。行ごとに保存されます--provider <name>—openai | anthropic | ollama | openai-compatible。行ごとに保存されます--no-edges-only— LLM が抽出したエッジのないエンティティのみをキューに追加します--clean-edges— キューに追加する前に、既存の LLM エッジを削除します--limit <n>— キューのサイズに上限を設定します
グラフ全体の処理コストをかけずに、欠落箇所を対象にする一般的なメンテナンス実行例:
./bin/pgm-admin improve-graph --type document --no-edges-only --provider ollama --model <model> -
prune-edges --below <threshold>—confidenceがしきい値を下回るエッジを削除します。デフォルトではsource='llm-extraction'に限定されます。すべてを対象にするには--source any、特定のソースを対象にするには--source <name>を指定します。安全にプレビューするための--relation <name>と--dry-runに対応しています。 -
validate-edges— LLM-as-judge による品質チェックを実行します。各source='llm-extraction'のエッジ(--sourceで変更可能)について、設定済みの抽出用 LLM に、ソースコンテンツがその関係を裏付けているかを確認します。無効、または--min-confidence(デフォルトは0.4)を下回ると判断されたエッジを削除します。エッジのメタデータにlast_validated_atを記録し、--skip-validated-days(デフォルトは7)以内に検証済みのエッジはスキップするため、同じ作業を繰り返さずに保守用 cron として実行できます。フラグ:--limit <n>(デフォルトは 100)、--force、--dry-run。EXTRACTION_ENABLED=trueと、通常のEXTRACTION_PROVIDER/EXTRACTION_MODEL環境変数が必要です。エッジごとに LLM 呼び出しが約 1 回発生します。 -
sql "<statement>"— データベースに対して生の SQL ステートメントを実行します。位置引数を受け付けるほか、複数行のクエリを標準入力から読み込むこともできます。SELECT の結果はタブ区切り(--jsonを指定した場合は JSON)で出力されます。DML コマンドでは、影響を受けた行数が出力されます。./bin/pgm-admin sql "SELECT id, type, extraction_status FROM entities LIMIT 5" ./bin/pgm-admin sql --json "SELECT COUNT(*) FROM edges WHERE source = 'llm-extraction'" # pipe multi-line SQL from a file cat fix.sql | ./bin/pgm-admin sql -
stats— エンティティ数、チャンク数、DB サイズ -
embeddings migrate— 埋め込みの次元数を切り替えます(specs/002-local-embeddings/quickstart.mdを参照してください)
グラフのメンテナンス
ナレッジグラフは、LLM による抽出でエンティティ同士がリンクされるにつれて、時間とともに構築されます。プロバイダーの変更、max_tokens の上限到達、モデルの停止などの後にエッジが欠落したり、更新が必要になったりすることがあります。管理 CLI には、グラフ全体を再処理せずに対処できるツールがあります。
欠落箇所の特定
抽出が完了したものの、エッジが生成されなかったエンティティは、サイレント障害を示す主な手がかりです。
./bin/pgm-admin sql "
  SELECT id, char_length(content) AS chars, created_at
  FROM entities
  WHERE type = 'document'
    AND extraction_status = 'completed'
    AND NOT EXISTS (
      SELECT 1 FROM edges WHERE source_id = id AND source = 'llm-extraction'
    )
  ORDER BY chars DESC
  LIMIT 20
"
対象を絞った再抽出(削除なし)
エッジのないエンティティだけを再キューに入れます。他のエンティティの既存のエッジには影響しません。
# Using the default extraction model
./bin/pgm-admin reextract --type document --no-edges-only

# Using a local Ollama model (zero API cost)
./bin/pgm-admin improve-graph --type document --no-edges-only --provider ollama --model <model>
全件再抽出
すべてをやり直す場合(たとえば、より性能の高いモデルに切り替えた場合):
# Wipe and redo — gives a clean slate
./bin/pgm-admin reextract --all --clean-edges

# Or scope to documents only
./bin/pgm-admin reextract --type document --clean-edges
信頼度による刈り込み
古いモデルや性能の低いモデルが残した、信頼度の低いエッジを削除します。
./bin/pgm-admin prune-edges --below 0.5 --dry-run   # preview
./bin/pgm-admin prune-edges --below 0.5             # apply
エッジの検証
LLM-as-judge によるチェックを実行し、ソースコンテンツに裏付けられていないエッジを削除します。
./bin/pgm-admin validate-edges --dry-run --limit 200
./bin/pgm-admin validate-edges --limit 200
キューの進行状況の監視
pgm queue                              # via pgm CLI
./bin/pgm-admin sql "SELECT extraction_status, COUNT(*) FROM entities GROUP BY 1"
Talon の移行
docker compose cp /path/to/talon.sqlite mcp-server:/tmp/talon.sqlite

docker compose exec -T mcp-server \
  node dist/migrate-talon/index.js /tmp/talon.sqlite \
  --api-base-url http://127.0.0.1:3100 \
  --api-key "$PGM_API_KEY"
便利なフラグ:--dry-run、--thread <id>、--batch-size <n>、--skip-embeddings
テスト
npm test            # all tests
npm run lint        # eslint
npm run build       # typecheck
npm run test:coverage
npm run benchmark:search -- --assert  # 5k-entity/6k-chunk latency gate
npm run benchmark:quality -- --assert # synthetic search relevance gate
検索ベンチマークでは、6 つのプロファイルについて p50/p95 レイテンシーを報告します。
cold_unique_queries(すべてのクエリでプロバイダーへのラウンドトリップが発生)、
memory_cache_hit、database_cache_hit(プロセス内キャッシュは空で、永続キャッシュのみが応答可能)、
long_keyword_query(上限付きチャンク GIN キーワードブランチ)、
pasted_query(異なる入力語が 300 個あり、そのうち 24 個を保持)、
underfilled_hnsw_fallback(狭いタグ付きフィクスチャに対して HNSW を強制実行した後、正確な検索にフォールバック)
です。また、各プロファイルで実行された埋め込みプロバイダー呼び出しの回数と、ハイブリッド SQL の
EXPLAIN (ANALYZE, BUFFERS) の概要も報告します。埋め込みプロバイダーを一定の遅延でスタブ化するため、
測定するのは SQL の実行時間とキャッシュヒット率です。実際のプロバイダーのレイテンシーについては
何も示しません。
実際の長いキーワード検索用フィクスチャと HNSW の strict iterative-scan 設定の完全なプランを取得するには、 次を実行します。
npm run benchmark:search -- --explain-output /tmp/search-plans.json
品質ベンチマークでは、公開合成コーパスを対象に、カテゴリ別の nDCG@5、MRR、recall@10 を報告します。
非公開の評価ラベルを実行するには、SEARCH_QUALITY_LABELS にローカルの JSONL ファイルを設定し、
--private を指定して、無視対象のデフォルトパス
benchmarks/fixtures/private-search-quality.labels.jsonl を使用し、明示的な DATABASE_URL を設定します。
このモードでは、設定されたデータベースとラベルファイルのみを読み込みます。データベースへのデータ投入、
リセット、変更は行いません。スコープ付きメモリの場合は、--client-id <client> を指定するか、
実際のクライアント ID を SEARCH_QUALITY_CLIENT_ID に設定してください。非公開モードではデータベースへの
読み取り専用アクセスが強制され、設定された埋め込みプロバイダー、モデル、次元がアクティブな ID と
一致することが検証されます。
ベンチマークでは、公開ラベルと非公開ラベルのどちらにも、デフォルトで正確な検索戦略が使われます。
そのため、公開ベースラインと --assert のゲート実行では、ANN の近似に左右されずに関連性を測定できます。
近似検索を確認するには、--strategy auto または --strategy hnsw を指定してください。
非公開ラベルはバージョン管理の対象外にしてください。
対象を絞ったテストスイート:
npx vitest run tests/unit/
npx vitest run tests/integration/
npx vitest run tests/contract/
現在の状況
Postgram は 1 人のメンテナーが積極的に開発しており、個人用デプロイで日常的に使用されています。 エンティティの保存、タスク管理、Markdown 同期、ハイブリッド検索、ナレッジグラフのトラバーサル、 メモリのライフサイクル、OAuth、ユーザー向け Web UI、保護された Admin UI が実装されています。 このプロジェクトは、マルチテナント規模ではなく、個人や小規模チームでのセルフホスト向けに意図的に 最適化されています。
備考と制限事項
- Postgram は個人/小規模チーム向けの規模に最適化されています
- Compose 以外のデプロイでは、デフォルトで OpenAI の埋め込みを使用します。Compose では、キーが設定されている場合は OpenAI を選択し、設定されていない場合はローカルの Ollama を選択します。検索を行うには、選択されたプロバイダーに接続できる必要があります。
- LLM による抽出は任意で、デフォルトでは無効です
- バックアップの暗号化には
gpgが必要です
Claude Code スキル
独自のエージェントから pgm を使用するための、ポータブルな Claude Code スキルは
skill/postgram/SKILL.md にあります。skill/postgram/ ディレクトリを
独自プロジェクトの .claude/skills/(またはユーザーレベルの ~/.claude/skills/)にコピーすると、
エージェントは pgm store、pgm search、pgm link などをいつ呼び出すべきか判断できるようになります。
CLI が PATH にあり、PGM_API_URL と PGM_API_KEY が設定されていることを前提とします。
このリポジトリでは、スキルファイルを意図的に .claude/ の下に置いていないため、配置先を自分で決められます。
グローバル CLAUDE.md の最適化
セッションをまたいで Postgram を最大限に活用するには、グローバルな ~/.claude/CLAUDE.md に Postgram に対応したガイダンスを追加してください。すぐに使えるテンプレートが
templates/CLAUDE.md に用意されています。検索するタイミング(タイプフィルターを使用)、コンパクトな edges.count/edges.relations の確認方法、expand_graph を使うタイミング、保存するタイミング、リンクするタイミング、一般的な原則を説明しています。該当するセクションを自分の CLAUDE.md にコピーすると、頼まなくても Claude が MCP ツールを積極的に使い、ナレッジを保存したり呼び出したりするようになります。デフォルトの検索フローでは、まず一致したチャンクをコンパクトな形で検索し、完全な内容が必要な選択済みエンティティだけを呼び出します。
広範なナレッジ活用を避ける必要があるコーディングエージェントには、
templates/AGENTS.coding.md または templates/CLAUDE.coding.md を使用してください。Postgram の利用を、セッションコンテキストの記憶と永続的な開発メモリーに限定します。
リリースと CI
CLI パッケージは、main へのマージのたびに
@ivotoby/postgram-cli
として npm に公開されます。公開は semantic-release
v25 と、cli をスコープに指定した Conventional Commits(例:feat(cli): ...)によって行われます。
cli スコープのないコミットでは、CLI のバージョンは更新されません。ワークフロー:
.github/workflows/release-cli.yml。
公開には、リポジトリシークレット NPM_TOKEN として保存された npm の Automation token を使用します。公開時に --provenance フラグを渡すため、すべてのリリースで Sigstore 署名付きのプロベナンス証明書が生成されます。
初回セットアップ:
- npmjs.com で:アバター → Access Tokens → Generate New Token → Automation
- GitHub リポジトリで:Settings → Secrets and variables → Actions → New repository secret
→ 名前を
NPM_TOKEN、値を手順 1 のトークンに設定 - 以降の公開はワークフローによって自動的に行われます。
サーバーの Docker イメージは、main へのマージのたび、および semver タグの
プッシュ時に、ghcr.io/ivo-toby/postgram に公開されます(マルチアーキテクチャの amd64 と arm64 に対応)。ワークフロー:
.github/workflows/docker.yml。組み込みの
GITHUB_TOKEN を使用するため、追加のシークレットは不要ですが、リポジトリで packages:write
権限を有効にする必要があります。
公式 MCP Registry
Postgram は
公式 MCP Registry に
io.github.ivo-toby/postgram として公開されています。
server.json のレジストリメタデータには、公開されている GHCR
イメージと Streamable HTTP エンドポイントが記載されています。
レジストリへのリリースは、意図的に手動で行う運用になっています。server.json を変更したら、
main の docker-publish ワークフローが完了するまで待ち、その後
publish-mcp-registry ワークフローを実行してください。このワークフローは、公式パブリッシャーからのダウンロードを検証し、現在のマルチアーキテクチャ対応 main イメージをダイジェストで固定して、メタデータを検証し、GitHub OIDC で認証してから公開します。メタデータを更新して公開する前に、server.json のトップレベルにある version を引き上げてください。レジストリでは公開済みの各バージョンが不変として扱われます。
ライセンス
Postgram では、意図的に複数のライセンスを採用しています。
- サーバー、Admin CLI、ブラウザー UI は、 GNU Affero General Public License v3.0 only の下でライセンスされています。
- 公開されている
pgmCLI、skill/およびtemplates/に含まれるポータブルなエージェント連携機能、packages/browser-extension-chrome/およびpackages/browser-extension-firefox/に含まれるブラウザー拡張機能は、MIT License の下でライセンスされています。 docs/のドキュメント本文とこの README は、 Creative Commons Attribution 4.0 International の下でライセンスされています。- コードおよびドキュメントのライセンスは、Postgram の名称、ロゴ、その他のブランド識別子を商標として使用する権利を付与するものではありません。 商標ポリシーをご覧ください。
AGPL は商用利用を許可しています。ネットワークコピーレフト条項により、変更を加えた Postgram サービスを運用する場合、そのサービスとネットワーク経由でやり取りするユーザーに、対応するソースコードを提供する必要があります。適用範囲の正確な境界と実践的な例については、LICENSING.md をご覧ください。
CONTRIBUTING.md に記載された手順に従うコントリビューションを歓迎します。コントリビューションをマージする前に、コントリビューターは
Postgram Contributor License Agreement に同意する必要があります。
関連ドキュメント
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。