MarkIndex について
MarkIndexは、大規模なMarkdownライブラリを文書構造に沿ってインデックス化し、エージェント向けに読み取り専用の検索機能を提供します。中国語・英語混在のBM25検索と行番号付きの原文により、埋め込みやベクトルデータベースなしで根拠を追跡できます。
主な機能
- 01Markdownからセクションツリーを作成
- 02SQLiteでファイルを増分インデックス化
- 03中英混在のBM25検索
- 04文書、アウトライン、原文の閲覧
- 05行番号付きの原文を返却
- 06応答サイズを抑えたツール結果のページ分割
活用シーン
- 01大規模なMarkdownマニュアル群の検索
- 02法律やガイドラインの関連セクションの特定
- 03行番号付き引用のための文章取得
- 04エージェントにローカル文書への構造化アクセスを提供
MCP 対応
MarkIndexは、文書の閲覧、構造と内容の参照、インデックス検索を行う5つの読み取り専用ツールを備えたMCPサーバーを提供します。先にインデックスを作成し、対象ライブラリを指定してサーバーを起動します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
MarkIndex


エージェント向けの、大規模な長文 Markdown ドキュメントライブラリを対象とした、ベクトルを使わず構造を優先する検索です。
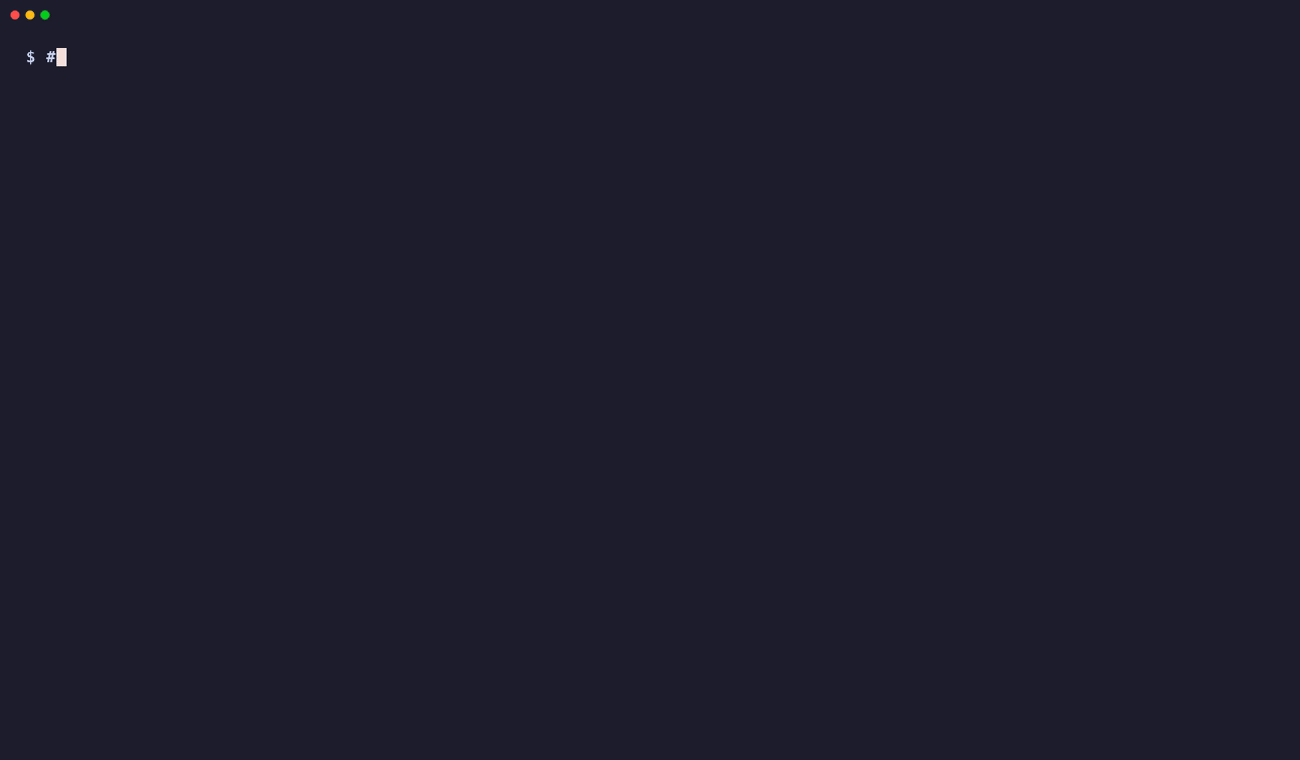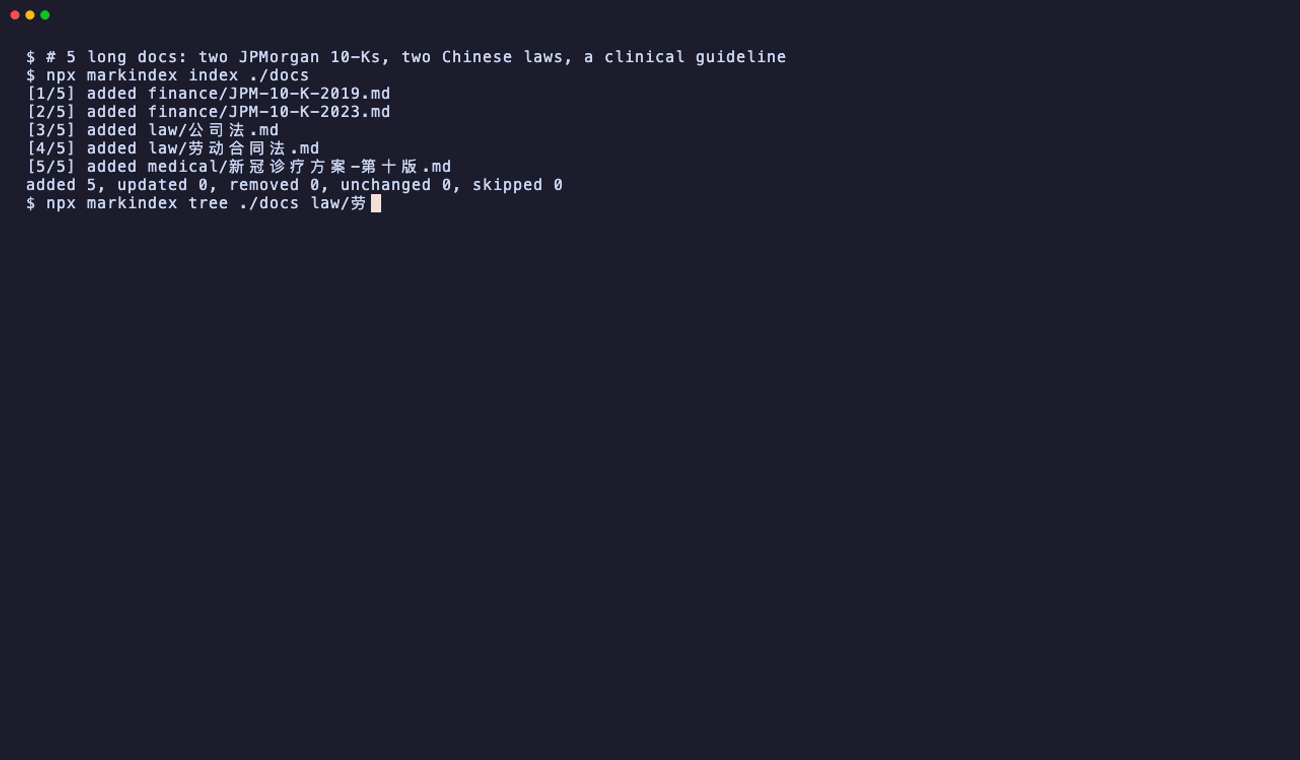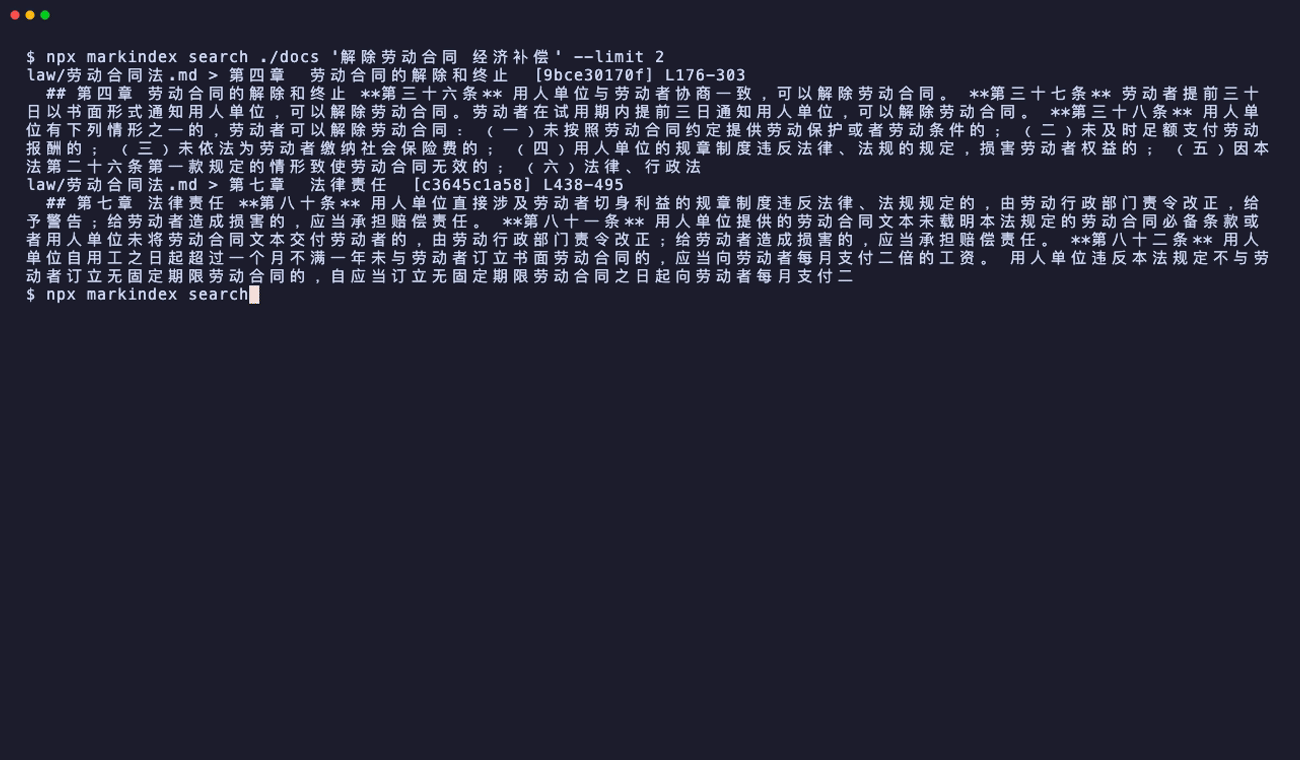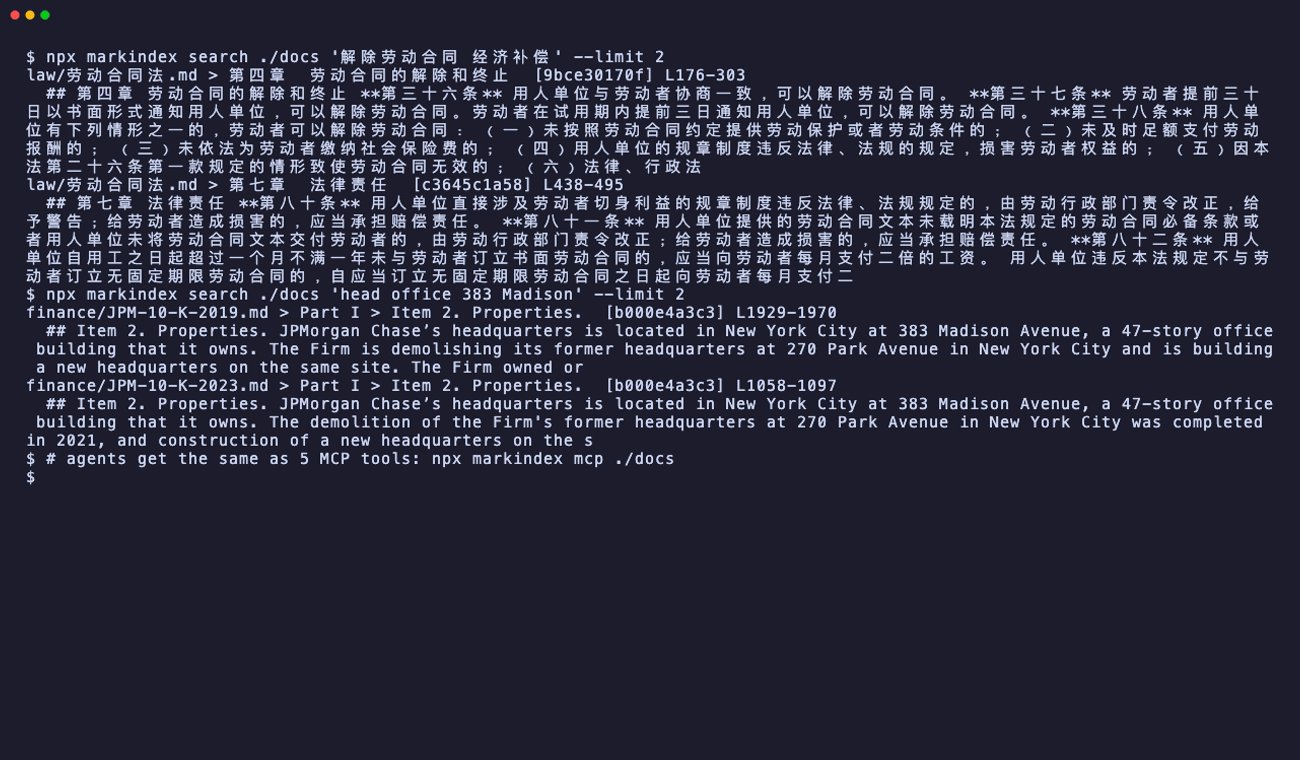
MarkIndex はすべての Markdown ファイルをそれぞれのセクションからなるツリーに解析し、ツリー、元の行、そして中国語と英語が混在する BM25 インデックスを 1 つの SQLite ファイルに保存します。さらに、エージェントが 5 つの読み取り専用ツールを使って「ライブラリ → フォルダー → ドキュメント → セクション」をたどり、行番号付きで元のテキストを読めるようにします。埋め込みも、ベクトルデータベースも、チャンク分割の推測も不要です。ドキュメント本来の構造がインデックスとなり、すべての根拠を [doc_path, L<start>-<end>] として引用できます。
VectifyAI/PageIndex に着想を得た MarkIndex は、Markdown に特化した独立した非公式の TypeScript 実装です。VectifyAI とは提携しておらず、同社からの承認も受けていません。
中国語の説明:README.zh-CN.md
Why
- チャンク優先ではなく、構造を優先します。 専門的な長文ドキュメント(申請書、ガイドライン、法律、マニュアルなど)は、すでに著者によって構成されています。そのアウトラインをたどればコンテキストが保たれ、回答の説明や引用が容易になります。一方、任意のチャンク分割とベクトル類似度では、セクションが分断されます。
- 決定的で、インデックス作成に LLM を使いません。 解析(正規表現ではなく mdast)、ツリーの構築、トークンコストに基づくツリーの最適化では、モデルを呼び出しません。同じ入力からは常に同じツリーが生成されます。LLM はオプションで、ノードの要約、ドキュメントの説明、組み込みの
retrieve()ループにのみ使用されます。 - Markdown を適切に処理します。 Setext 見出し、最初の見出しより前の前書き、見出しのないドキュメント、フロントマター、コードフェンス内の
#、見出しレベルの飛び越し、BOM / CRLF に対応します。すべてのソース行は必ず 1 つのノードに属し、大きすぎるセクションはブロックの境界で分割されてchunkノードになります。 - 中国語でも使えるキーワード検索フォールバック。
Intl.Segmenterによる単語分割(中国語、英語、混在テキスト、およびC++、ISO-27001、v2.1のような識別子)を使った BM25 に加え、第 2 段階の検索としてトライグラム部分文字列インデックスを備えています。 - 予算内に収まるツールの応答。 ツールは例外をスローせず、
next_stepsの案内を含む JSON エンベロープを返します。95 000 文字の予算を超えないよう、大きなアウトラインやセクションはページ分割されます。
Install
npm install markindex          # library + CLI (Node.js >= 22.12)
npx markindex --help
ソースからインストールする場合:
git clone https://github.com/jackjin1997/markindex.git && cd markindex
npm install && npm run build
node dist/cli.js --help          # or `npm link` to get a `markindex` command
LLM 機能(要約、retrieve()、エージェントモードの評価)を使う場合に限り、任意で利用する AI SDK provider をインストールします。たとえば npm install @ai-sdk/anthropic を実行し、API キー(ANTHROPIC_API_KEY など)を設定してください。npx を使いローカルにインストールしない場合は、プロバイダーを同じ一時環境に追加します。
npx -p markindex -p @ai-sdk/anthropic markindex index ./docs --summary-model anthropic:claude-sonnet-5-5
CLI
# Build or incrementally update the index (stored in <root>/.markindex/index.db)
markindex index ./docs
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5 --estimate   # cost estimate, no LLM calls
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5             # with node summaries
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5 --summary-rpm 50 --summary-tpm 40000   # rate-limited
markindex index ./docs --json                                                   # machine-readable report
markindex index ./docs --no-setext                                              # converter output with `---` page breaks
markindex index ./docs --ignore 'drafts/' --ignore '*.tmp.md'                   # extra ignore patterns (repeatable)

# Inspect one document's section tree
markindex tree ./docs guides/setup.md --depth 3

# Keyword search (BM25 + trigram fallback)
markindex search ./docs "离职 补偿"
markindex search ./docs "ISO-27001 audit" --folder policies --limit 5 --json

# Serve the library to agents over MCP (stdio, read-only)
markindex mcp ./docs
markindex mcp ./docs --reindex-on-start

# Measure retrieval quality on your own documents (see "Evaluation")
markindex eval ./docs --questions questions.jsonl --mode bm25 --out report.json
markindex eval ./docs --questions questions.jsonl --mode agent --model anthropic:claude-sonnet-5-5 --out report.json
markindex eval ./docs --questions questions.jsonl --mode agent --model anthropic:claude-sonnet-5-5 --rpm 50 --tpm 40000
レート制限。 呼び出しは常に、並列実行数(eval では --concurrency、要約では 8)と AI SDK の再試行によって制限されます。再試行では、429/5xx レスポンスの retry-after/retry-after-ms がすでに考慮され(最大 60 秒)、これらの値に従います。プロバイダーのクォータを超えないようにするには、クライアント側の制限を追加してください。index では --summary-rpm/--summary-tpm、eval(エージェントモード)では --rpm/--tpm を指定します。rpm は、任意のスライディング 60 秒間におけるリクエスト数を制限し、tpm は推定入力トークン数を制限します。どちらの制限も、実行中のすべてのドキュメント(index)またはすべての質問(eval)で共有され、待機中の呼び出しは順番に処理されます。入力トークン数はプロンプトテキストから推定されます(CJK 文字は約 1 文字につき 1 トークン、それ以外は約 4 文字につき 1 トークン)。そのため、実際のクォータより余裕を持たせてください。出力トークンとツール定義はカウントされません。tpm を超える単一のリクエストも、単独で処理されます。ライブラリでは、summarizeDocument/indexLibrary({ summary }) または retrieve() に rateLimit: { requestsPerMinute, inputTokensPerMinute } を渡してください。同じオブジェクトを再利用すると、1 つの予算を共有できます。
--summary-model/--model には <provider>:<model> を指定します。MarkIndex は @ai-sdk/<provider> を動的にインポートするため、使用するプロバイダーだけをインストールすれば構いません。すべてのコマンドで --db <file> を指定すると、別のインデックスファイルを使用できます。インデックスはローカルディスクに置いてください。ライターロックではハードリンクを使用し、SQLite は WAL モードで動作するため、exFAT、SMB/NFS 共有、その他のネットワークボリュームではどちらも安定して動作しません。ドキュメントがそのような場所にある場合は、移動せずにそのまま置き、--db にローカルパスを指定してください(例:--db ~/.cache/markindex/docs.db)。
インデックス作成は増分方式です。ファイルをコンテンツハッシュで比較し、新規または変更されたドキュメントのみを再構築します(ドキュメントごとに 1 トランザクション)。削除されたファイルは除去され、要約はノードのコンテンツハッシュでキャッシュされます。スキャン対象のファイルは .md と .markdown(.mdx は対象外)です。除外されるのは、ライブラリ独自の .gitignore ファイル(ルート以下のすべての階層にあるもの。グローバル git 除外と .git/info/exclude は読み込まれません)に一致するパス、ルートにある任意の .markindexignore ファイル(同じ構文を使用し、.gitignore には含めたくないルールを指定します)、および --ignore <pattern> オプション(gitignore 構文を使用し、ルートからの相対パスで指定します。複数回指定可能。ライブラリ API では ignore: string[]。mcp --reindex-on-start でも指定可能。先頭の ./ は削除され、先頭の / は gitignore と同様にルートを基準とします。また、絶対ファイルシステムパスと ../ は拒否されます)です。これらの指定による除外のみが追加されます。.markindexignore または --ignore の ! ルールでは、.gitignore で除外されたパスを再び含めることはできません。無視対象になったドキュメントは、次回の実行時にインデックスから除去されます。
.git や .markindex などのドットディレクトリはスキップされ、シンボリックリンクはたどりません。一度に実行できるライターは 1 つです(2 つ目の index は即座に失敗します)。MCP サーバーなどのリーダーがブロックされることはありません。古いバージョンの MarkIndex、または異なるツリーパラメーターでインデックスが作成されていた場合、次回の index 実行時にすべてのドキュメントが再構築されます(出力では full rebuild: …、レポートでは rebuilt)。キャッシュ済みの要約は再利用されます。
PDF/HTML コンバーターによるページ区切り。 コンバーターは、ページの最後の段落の直後に単独の --- 行を出力することがよくあります。CommonMark ではこれを setext 見出しとして解釈するため、段落全体がレベル 2 の見出しになります。index は、テキストが複数行にわたる、または 120 文字を超える setext h2 見出しを検出すると警告します(標準出力には warning <path>: …、JSON レポートには warnings が出力されます)。このようなライブラリでは --no-setext を指定してください(mcp --reindex-on-start でも指定可能。ライブラリ API では setext: false)。この場合、--- はテーマ区切りとなり、=== は通常のテキストになります。この設定はインデックスに保存されるため、後続の実行でフラグを指定しなくても(index、mcp --reindex-on-start、Library.index())、設定は維持されます。再び有効にするには --setext(setext: true)を指定してください。設定を変更すると、インデックスが再構築されます。
ライブラリの使用
import { openLibrary } from 'markindex'

// Index (or update) a folder, then open it read-only for agents.
const writer = openLibrary({ root: './docs', readonly: false })
await writer.index() // { added, updated, removed, unchanged, skipped, summaryErrors, warnings }
writer.close()

const lib = openLibrary({ root: './docs' })
const envelope = await lib.callTool('search_documents', { query: 'termination notice period' })
console.log(JSON.parse(envelope)) // { success: true, data: { results: [...] }, next_steps: {...} }
Vercel AI SDK を使用する場合(エージェントがツールを操作)
import { generateText, stepCountIs } from 'ai'
import { anthropic } from '@ai-sdk/anthropic'
import { AGENT_INSTRUCTIONS, createAiSdkTools, openLibrary } from 'markindex'

const lib = openLibrary({ root: './docs' })
const { text } = await generateText({
  model: anthropic('claude-sonnet-5-5'),
  system: AGENT_INSTRUCTIONS, // browse first, read structure, cite [doc_path, L<start>-<end>]
  tools: createAiSdkTools(lib),
  stopWhen: stepCountIs(15),
  prompt: 'What notice period applies when an employee resigns?',
})
組み込みのエビデンス取得
retrieve() はモデルループ内で同じツールを実行し、エビデンスのみ(行範囲を指定してインデックスから読み直した原文 — モデルが生成したテキストではありません)と、使用状況および停止した理由を返します。
import { anthropic } from '@ai-sdk/anthropic'
import { openLibrary, retrieve } from 'markindex'

const lib = openLibrary({ root: './docs' })
const { evidence, usage, stopReason } = await retrieve(lib, 'What notice period applies when an employee resigns?', {
  model: anthropic('claude-sonnet-5-5'),
  maxSteps: 12,
  maxInputTokens: 200_000,
  rateLimit: { requestsPerMinute: 50, inputTokensPerMinute: 40_000 }, // optional, client-side
})
for (const e of evidence) console.log(`${e.docPath} L${e.startLine}-${e.endLine}`, e.titlePath.join(' > '))
低レベルの構成要素もエクスポートされています。parseMarkdown、buildTree、optimizeTree、openStore、
indexLibrary、searchNodes、summarizeDocument、estimateSummaryCost、TOOL_CONTRACT、createMcpServer。
MCP のセットアップ
まずインデックスを作成し(npx markindex index /path/to/docs)、その後サーバーを登録します。MarkIndex は
公式 MCP Registry にも io.github.jackjin1997/markindex として掲載されているため、レジストリ対応の
クライアントはそこからインストールできます(起動時には npx markindex mcp <docs_dir> --reindex-on-start を実行します)。
Claude Code
claude mcp add markindex -- npx markindex mcp /path/to/docs
Cursor(~/.cursor/mcp.json またはプロジェクト内の .cursor/mcp.json)
{
  "mcpServers": {
    "markindex": {
      "command": "npx",
      "args": ["markindex", "mcp", "/path/to/docs"]
    }
  }
}
サーバーは AGENT_INSTRUCTIONS を MCP の指示として送信し、すべてのツールを読み取り専用としてマークします。
ツール
| ツール | 機能 |
|---|---|
browse_documents | フォルダー内のサブフォルダーとドキュメント(パス、タイトル、説明、トークン数)をページ分けして一覧表示します。既定の探索ツールです。 |
get_document | 1 つのドキュメントのメタデータ、フロントマター、サイズ、および read_structure_first(15 000 トークンを超える場合は true)を返します。 |
get_document_structure | セクションの概要(ノード ID、タイトル、行範囲、トークン数、要約 — 本文なし)を、depth レベル(既定値は 2)で返します。必要に応じて 1 つのノードのサブツリーのみを指定できます。part でページ分けされます。 |
get_node_content | 行番号付きの 1〜20 個のノードの原文 Markdown(123│ …)を返します。長いノードはページ分けされます。 |
search_documents | タイトル、統合された小見出し、要約、テキストを対象に BM25 キーワード検索を行い、トライグラムによるフォールバックも備えています。folder または doc_path で範囲を指定します。ブラウジングで行き詰まったときの次の手段です。 |
すべてのツールは { success: true, data, next_steps } または { success: false, error, code, details, next_steps } を JSON 文字列として返し、例外をスローしません。未知のドキュメントパスには類似名の候補が返され、古いノード ID には「構造を再取得する」よう案内が返されます。スキーマに一致しない引数(型の誤り、未知のフィールド、1 024 文字を超える文字列)には、lib.callTool から INVALID_INPUT エンベロープが返されます。ただし MCP および AI SDK 経由では、ツールの実行前にトランスポートが同じスキーマに対して引数を検証するため、そのようなエラーは JSON エンベロープではなく、トランスポート独自のエラー(MCP ツールエラー/AI SDK の無効なツール入力エラー)として返されます。
セキュリティと信頼
- 読み取り専用で、ライブラリの範囲内に限定されます。 ツールは指定されたライブラリのインデックスのみを読み取り、範囲外のファイルは読み取らず、書き込みも URL の取得も行いません。パスとノード ID はディスク上ではなく、インデックス内で照会されます。
- ドキュメントは信頼できない入力です。 ツールの出力はドキュメントの生テキストであり、LLM の要約や説明はそこから生成されます。ドキュメントには、エージェントを誘導するためのテキスト(プロンプトインジェクション)が含まれることがあります。ツールの返す内容はすべて指示ではなくデータとして扱ってください。特に、ライブラリにサードパーティーやユーザー提供のファイルが含まれる場合や、エージェントが操作を実行するツール(送信、書き込み、実行)も備えている場合は注意してください。
- 要約と
retrieve()は、ドキュメントのテキストを設定したモデルプロバイダーに送信します。インデックス作成だけではネットワーク呼び出しは行われません。
設計上の注意点
- ツリー。 トップレベルの mdast 見出しがセクションを定義します。最初の見出しより前のテキストは
prefaceノードになり、見出しのないドキュメントは 1 つのルートノードになります。ノード ID は祖先のタイトル階層と兄弟内の順序番号から生成される短いハッシュであるため、アウトラインが変わらない限り安定します。 - ツリーの最適化。 マージ/展開パスは、ページをトークンに置き換えた PageIndex の
tree_optimize.pyコストモデルを移植したものです。サブツリー全体を読むコストが、そのサブツリーを経由してルーティングするコスト(ルーティングコストR = 150トークン)以下の場合、そのサブツリーは親にマージされます。マージされた見出しはkeyItemsとして保持され、ノード自身のテキストがMAX_NODE_TOKENS(8 000)を超える場合は、Markdown のブロック境界で決定的に分割され、子chunkノードになります。コストモデルの考案については PageIndex に謝意を表します。 - 検索。 インデックス化されるのはノード自身のテキストのみであり、サブツリーは対象外です。そのため、親と子が重複して数えられることはありません。タイトルの重みは 10 倍、マージされた見出しは 5 倍、要約は 2 倍、本文は 1 倍です。
- ツールの契約。 1 つの zod 契約(名前、説明、スキーマ)が、AI SDK アダプター、MCP サーバー、
retrieve()に使われます。説明とエージェント向けの指示は PageIndex のagent_tools.py(ページ → 行範囲)をもとに調整され、スナップショットテストで固定されています。 - トークン。 カウントは概算です(CJK 文字は 1 トークン、その他の文字は 4 文字で 1 トークン)。実際のトークナイザーを注入することもできます。デフォルト値は
src/config.tsにあります。
評価
markindex eval は、検索が適切なセクションに到達したかを測定します。ライブラリフォルダーと、正解位置(ドキュメントパス+行範囲、またはタイトル階層)が含まれる JSONL 形式の質問ファイルを指定すると、BM25 ベースラインと LLM エージェントについて、全体および言語ごとのヒット率、トークンコスト、ステップ数、根拠のサイズ/適合率を報告します(--max-evidence-lines <n> を指定すると、ヒットした根拠を最大 n 行に制限します)。質問ファイルの形式、ヒットの判定ルール、開発用コーパス(公開ドキュメント 329 件、約 3,800 万トークン。英語の申請書やガイドラインに加え、中国語の法律や百科事典の記事を含む)、ベースラインの結果、規模のベンチマークについては、eval/README.md を参照してください。
主な結果(n = 30、Claude Code sonnet を 5 つの MarkIndex MCP ツールのみに制限): 質問 30/30 件で正解の文章が見つかりました(1 位での正答率は 93.3%)。平均 15 行を引用し、引用行の 88.6%が正解範囲内でした。同じ質問に対する BM25 の上位 5 件では、ヒット率が 73.3%、引用行数が 209 行(適合率 12.8%)でした。質問 1 件あたりのエージェントのターン数は約 3 回です(詳細と留意事項)。
開発
npm install
npm test            # vitest
npm run typecheck
npm run build
npx tsx eval/fetch-corpus.ts   # download the evaluation corpus (eval/corpus, not committed)
npx tsx eval/bench.ts          # scale benchmark
npx tsx eval/claude-code-eval.ts --root eval/corpus --questions eval/questions.jsonl --per-lang 10 --out cc.json
                               # agent eval with Claude Code over MCP (spends Claude usage; eval/README.md §7)
リリース
リリースは、npm Trusted Publishing(OIDC、npm トークン不要、プロベナンス付与)を通じて.github/workflows/publish.ymlから npm に公開されます。package.json の version を更新し、CHANGELOG.md の [Unreleased] の内容を新しいバージョンの項目に移してプッシュした後、タグ v<version> を付けて GitHub Release を作成します。このワークフローは、タグと package.json のバージョンが一致していることを確認し、型チェックとテストを実行して、ビルドと公開を行います。
ライセンス
MIT。PageIndex も MIT ライセンスで提供されています。MarkIndex には PageIndex のコードは含まれていませんが、ツリーのコストモデルを移植し、エージェントツールの説明、指示、プロンプトを調整しています。謝意を表します。著作権とライセンスに関する通知については、THIRD_PARTY_NOTICES.md を参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。