duckduckgo について
duckduckgo は Apify がホストするスクレーパーを通じて、構造化された DuckDuckGo 検索結果を提供します。SERP データを必要とする開発者やアシスタント向けで、地域別の結果や通常の検索一覧以外の要素も取得できます。
主な機能
- 01通常検索とリッチ結果の抽出
- 0240以上の地域と言語の組み合わせに対応
- 03セーフサーチと日付による絞り込み
- 04上限を指定した複数ページ取得
- 05ページ情報を含む構造化 JSON の返却
活用シーン
- 01検索順位の継続的な監視
- 02地域ごとの検索結果の比較
- 03ニュース、広告、関連検索の収集
- 04アシスタントへの検索データ提供
MCP 対応
Apify のホスト型 MCP サーバーは、DuckDuckGo スクレーパーを MCP クライアント向けのツールとして提供します。専用 Actor の MCP URL と Apify 認証を使って有効化できます。
設定
リモートサーバーはインストール不要です。クライアントを選んで設定をコピーするか、ワンクリックで導入できます。
https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankingsclaude mcp add --transport http johnisanerd-duckduckgo https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankings{"mcpServers":{"johnisanerd-duckduckgo":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankings"}}}Cursor で開く{"servers":{"johnisanerd-duckduckgo":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankings"}}}VS Code で開く{"mcpServers":{"johnisanerd-duckduckgo":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankings"}}}{"mcpServers":{"johnisanerd-duckduckgo":{"serverUrl":"https://mcp.apify.com/?tools=johnvc/DuckDuckGo-Scraper-for-serp-rankings"}}}コマンドはターミナルで実行し、JSON は各クライアントの MCP 設定に貼り付けて再起動します。認可が必要なサーバーは初回接続時にログインを求めます。
ツール
詳細
🦆 DuckDuckGo API:DuckDuckGo の検索結果を整理された JSON で取得
DuckDuckGo API を利用する、最も効率的で信頼性が高く、開発者に使いやすい方法です。
アクターページ: apify.com/johnvc/DuckDuckGo-Scraper-for-serp-rankings 入力スキーマ: apify.com/johnvc/DuckDuckGo-Scraper-for-serp-rankings/input-schema
DuckDuckGo API は、任意のクエリで DuckDuckGo を検索し、整理された JSON を返します。検索結果の各ページは 1 つの項目として返され、オーガニック検索結果(タイトル、リンク、スニペット、順位、サイトリンク)、広告、ナレッジグラフパネル、ニュース検索結果、インライン画像、インライン動画、関連検索に加えて、ページごとのメタデータが含まれます。40 種類以上の地域と言語の組み合わせ、安全検索レベル、日付フィルター、自動ページネーションに対応しています。DuckDuckGo は検索結果をパーソナライズしないため、実行のたびに一貫した結果を得られます。
動画による解説
クイックスタート
前提条件
- Python 3.11 以降
- Apify アカウントと API キー(こちらから無料のキーを取得)
-
リポジトリをクローンする
git clone https://github.com/johnisanerd/Apify-DuckDuckGo-Search-Scraper.git cd Apify-DuckDuckGo-Search-Scraper -
UV で依存関係をインストールする
# Install UV if you do not have it: curl -LsSf https://astral.sh/uv/install.sh | sh # Install project dependencies: uv sync -
API キーを設定する
cp .env.example .env # Edit .env and add your Apify API key # Get your free API key at: https://apify.com?fpr=9n7kx3 -
サンプルを実行する
uv run python duckduckgo-search-scraper.py
代替方法:API キーを直接設定する
export APIFY_API_TOKEN="your_api_key_here"
uv run python duckduckgo-search-scraper.py
この DuckDuckGo API を使う理由
検索結果ページ全体を網羅。 1 回の呼び出しで、オーガニック検索結果、広告、ナレッジグラフパネル、ニュース、インライン画像、インライン動画、関連検索を含む、DuckDuckGo の検索結果ページ全体を構造化データとして取得できます。オーガニック検索結果のリンクだけでなく、ページ全体を取得できます。
一貫性のある、パーソナライズされないスナップショット。 DuckDuckGo は検索結果をパーソナライズしないため、繰り返し実行しても比較可能な SERP が返されます。ランキング分析や経時的なモニタリングに最適です。
地域に合わせた設定とフィルタリング。 40 種類以上の地域と言語の組み合わせを指定でき、安全検索レベルを設定し、日付(過去 1 日、1 週間、1 か月、1 年、またはカスタム期間)で絞り込めます。
予測しやすい従量課金制。 料金は実行ごと、および処理したページごとに発生し、月額料金はありません。ページ数の上限でコストを直接管理できます。
自動化が簡単。 Python から数行で呼び出すか、MCP ツールとして読み込めば、Claude や Cursor などのアシスタントが必要に応じて DuckDuckGo 検索を実行できます。
機能
主な機能
- キーワード検索:DuckDuckGo で検索し、検索結果ページ全体を抽出
- ローカライズ:40 種類以上の地域と言語の組み合わせに対応
- 安全検索の制御(厳格、中程度、オフ)
- 日付フィルタリング:相対期間またはカスタム日付範囲に対応
- 複数ページのページネーション:ページ数の上限を設定可能
データ品質
- 構造化されたオーガニック検索結果:タイトル、リンク、スニペット、順位、表示リンク、日付、サイトリンクを含む
- 豊富な検索結果ブロック:広告、ナレッジグラフ、ニュース、インライン画像、インライン動画、関連検索
- ページごとのメタデータ:検索結果件数とページネーションの詳細を含む
- 一貫した JSON 構造:すべてのクエリで同じ形式
- ページごとの課金:大規模な検索でも料金が明確
使用例
基本的な例
1 つのキーワードを 1 ページだけ検索します。API を試すうえで最も低コストな方法です。
{
  "query": "machine learning",
  "max_pages": 1
}
応用例
英国向けにローカライズし、安全検索を厳格に設定して、過去 1 週間の検索結果を 2 ページ取得します。
{
  "query": "machine learning",
  "localization": "uk-en",
  "safe": "strict",
  "date_filter": "w",
  "max_pages": 2
}
入力パラメーター
| パラメーター | 型 | 必須 | デフォルト | 説明 |
|---|---|---|---|---|
query | string | はい | - | 検索クエリです。 |
localization | string | いいえ | us-en | 地域と言語のコードです(例:uk-en、fr-fr、de-de、ja-jp。40 以上に対応)。 |
safe | string | いいえ | moderate | セーフサーチのレベルです:strict、moderate、または off。 |
date_filter | string | いいえ | (なし) | d(過去 1 日)、w(1 週間)、m(1 か月)、y(1 年)、またはカスタム範囲 YYYY-MM-DD..YYYY-MM-DD。 |
max_pages | integer | いいえ | 2 | 取得する最大ページ数です(0 = 上限なし)。 |
output_file | string | いいえ | (なし) | 結果を保存する任意のファイル名です。省略した場合は自動生成されます。 |
出力形式
クエリ machine learning の実際のデータセット項目です。各検索結果ページが 1 つの項目となります。最初の結果のサイトリンクは、読みやすさのためにここでは一部省略しています。
{
  "query": "machine learning",
  "localization": "us-en",
  "safe_search": -1,
  "max_pages": 1,
  "search_timestamp": "2026-05-29T09:56:11.848097",
  "total_results_found": 11,
  "pages_processed": 1,
  "page_number": 1,
  "search_metadata": {
    "localization": "us-en",
    "localization_name": "United States (English)",
    "safe_search": -1,
    "safe_search_description": "Moderate",
    "max_pages": 1,
    "pagination_limit_reached": true
  },
  "pagination_info": {
    "total_pages": 1,
    "max_pages_set": 1,
    "pagination_stopped_by_limit": true,
    "results_per_page": { "first_page": 11, "subsequent_pages": 50 }
  },
  "organic_results": [
    {
      "position": 1,
      "title": "Machine Learning Tutorial - GeeksforGeeks",
      "link": "https://www.geeksforgeeks.org/machine-learning/machine-learning/",
      "date": "Apr 15, 2026",
      "snippet": "Machine learning is a branch of Artificial Intelligence that focuses on developing models and algorithms that let computers learn from data without being explicitly programmed for every task.",
      "favicon": "https://external-content.duckduckgo.com/ip3/www.geeksforgeeks.org.ico",
      "sitelinks": [
        {
          "title": "Gradient Descent in Linear Regression",
          "link": "https://www.geeksforgeeks.org/machine-learning/gradient-descent-in-linear-regression/"
        }
      ]
    },
    {
      "position": 2,
      "title": "Machine learning - Wikipedia",
      "link": "https://en.wikipedia.org/wiki/Machine_learning",
      "snippet": "Machine learning (ML) is a field of study in artificial intelligence concerned with the development and study of statistical algorithms that can learn from data and generalize to unseen data.",
      "favicon": "https://external-content.duckduckgo.com/ip3/en.wikipedia.org.ico"
    }
  ],
  "ads": [],
  "knowledge_graph": [],
  "news_results": [],
  "inline_images": [],
  "inline_videos": [],
  "related_searches": []
}
MCP ツールとして使用する
DuckDuckGo API を MCP ツールとして読み込むと、アシスタントから呼び出せるようになります。MCP サーバーの URL では、この Actor のみが事前に読み込まれます。
https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings
ブラウザーで OAuth 認証を行うか、Apify API トークン(Python の例で使用するものと同じ APIFY_API_TOKEN)を使用してください。トークンは https://console.apify.com/settings/integrations で取得できます。無料の Apify アカウントは https://apify.com?fpr=9n7kx3 で作成できます。
Claude Cowork Desktop にインストールする
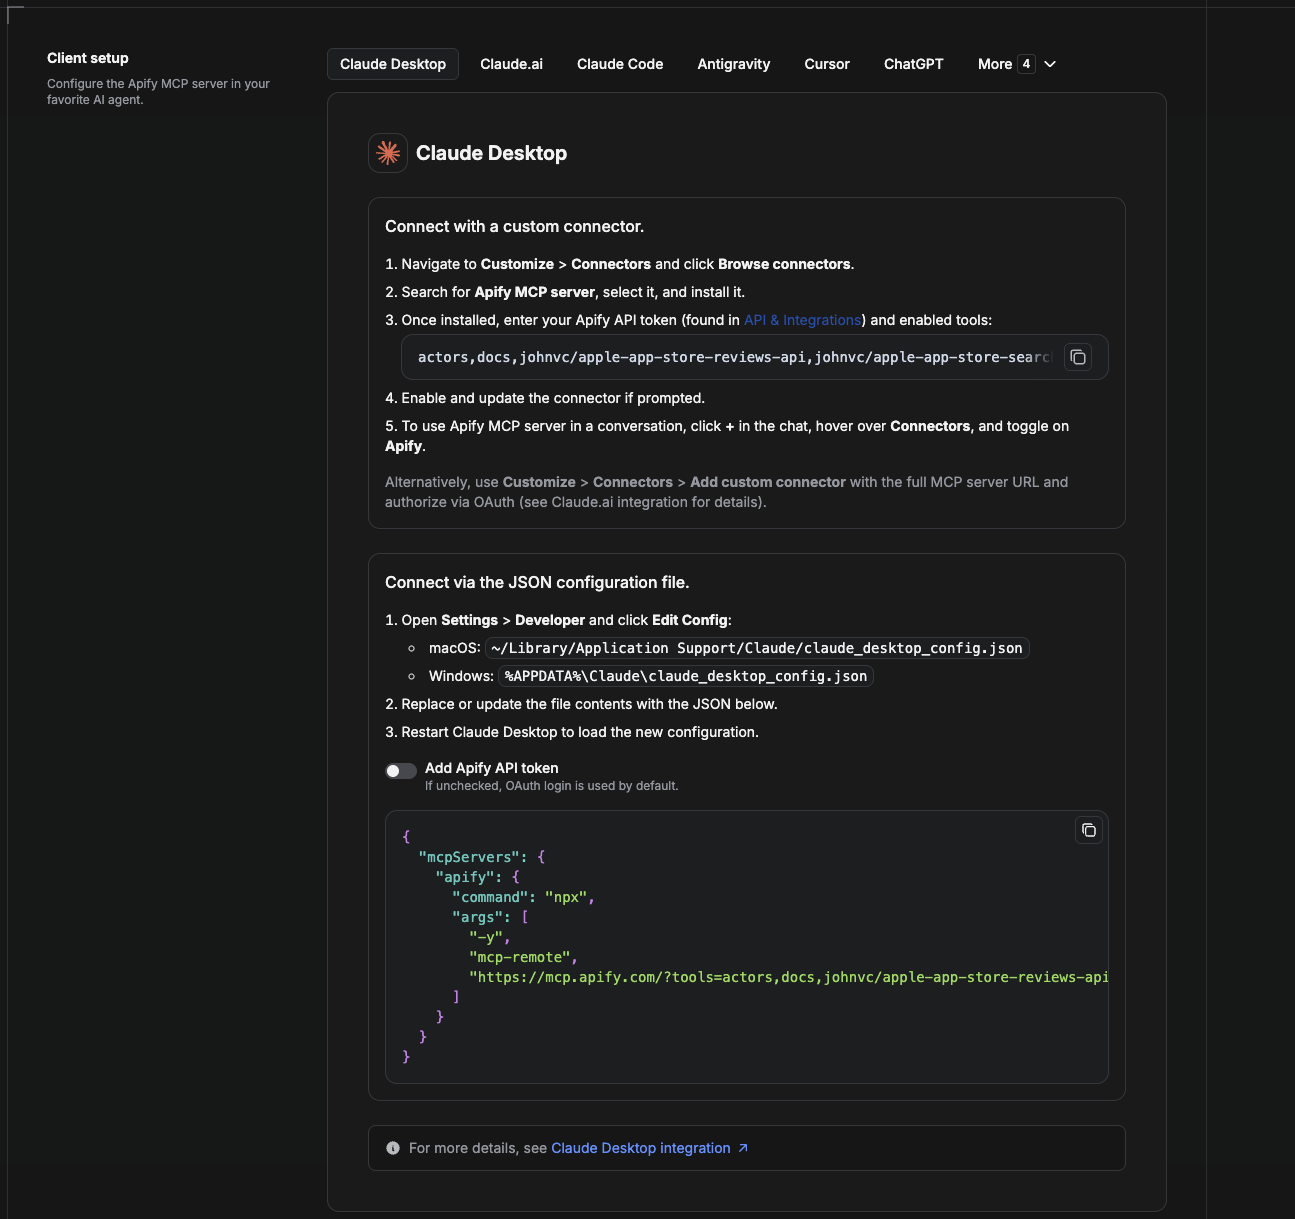
Cowork はデスクトップアプリの自動化モードです。DuckDuckGo API をツールとして使用できるようにするには、Apify MCP サーバーをコネクターとして追加します。
- Claude デスクトップアプリを開き、Settings → Connectors に移動します(または Settings → Developer → Edit Config を選択して、
claude_desktop_config.jsonを直接編集します)。- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
- macOS:
- この Actor のみが事前に読み込まれた Apify MCP サーバーを追加します。
{
  "mcpServers": {
    "apify": {
      "command": "npx",
      "args": [
        "-y",
        "mcp-remote",
        "https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings"
      ]
    }
  }
}
- アプリを再起動します。Cowork が初めてツールを呼び出すときに、ブラウザーで OAuth プロンプトを完了するか、コネクターの設定に Apify API トークンを追加して OAuth を省略します。
- Cowork のチャットでツールが利用可能になっていることを確認し、DuckDuckGo API を実行するよう依頼します。
デスクトップアプリをダウンロードして無料トライアルを開始:https://claude.ai/referral/uIlpa7nPLg 詳しい情報:https://docs.apify.com/platform/integrations/claude-desktop
Claude Code にインストールする
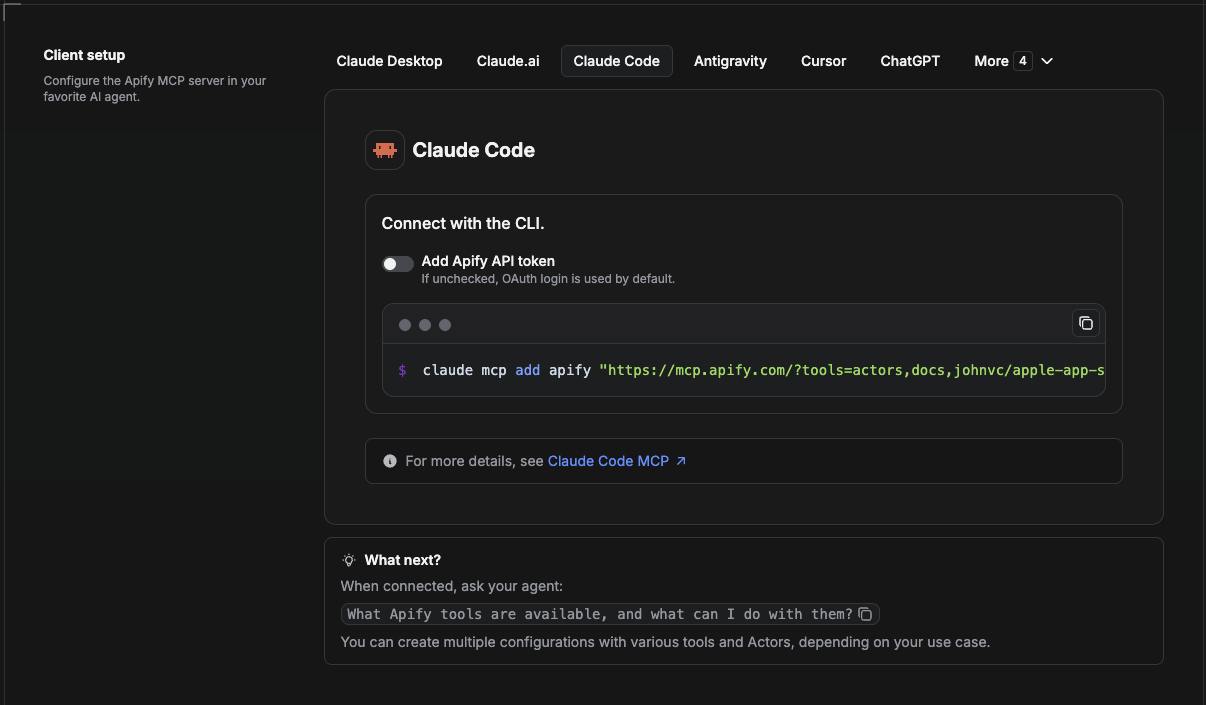
Claude Code はコマンドラインツールです。1 つのコマンドで Actor の MCP サーバーを追加できます。
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings"
ブラウザーでの OAuth の代わりにトークンを使用する場合:
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings" \
  --header "Authorization: Bearer YOUR_APIFY_TOKEN"
次に claude mcp list で確認するか、セッション内で /mcp を実行します。Claude Code に DuckDuckGo API を呼び出すよう依頼してください。
Claude Code を無料でお試しください:https://claude.ai/referral/uIlpa7nPLg Claude Code MCP のドキュメント:https://code.claude.com/docs/en/mcp
Claude(ウェブサイト)にインストールする
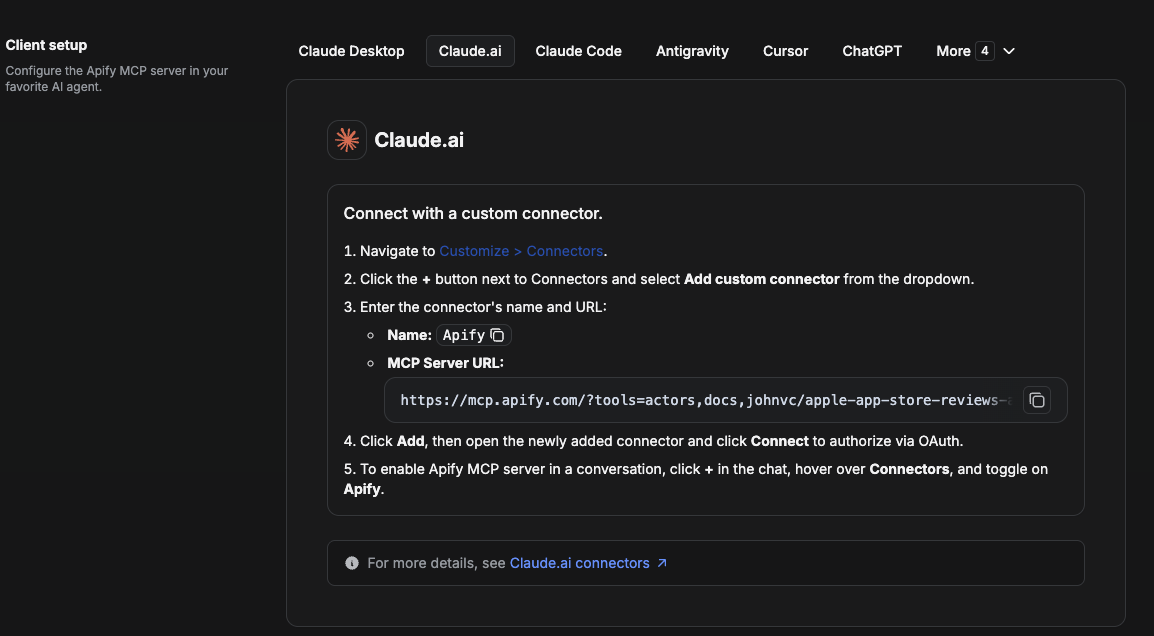
claude.ai では、Apify をコネクターとして追加した後、この Actor のツールのみを有効にします。
- Settings → Connectors → Browse connectors に移動し、Apify MCP server を検索します。インストールします(プロンプトが表示された場合は、有効化または更新します)。
- 接続時に Apify API トークンで認証し、ツール
johnvc/DuckDuckGo-Scraper-for-serp-rankingsを有効にします。 - 任意のチャットで + → Connectors を開き、Apify をオンにします。
- または、Add custom connector を選択し、完全な MCP URL
https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankingsを貼り付けます。プロンプトが表示されたら OAuth を使用します。 - Claude に DuckDuckGo API を実行するよう依頼します。
ウェブで Claude を開く:https://claude.ai/referral/uIlpa7nPLg
Cursor にインストールする
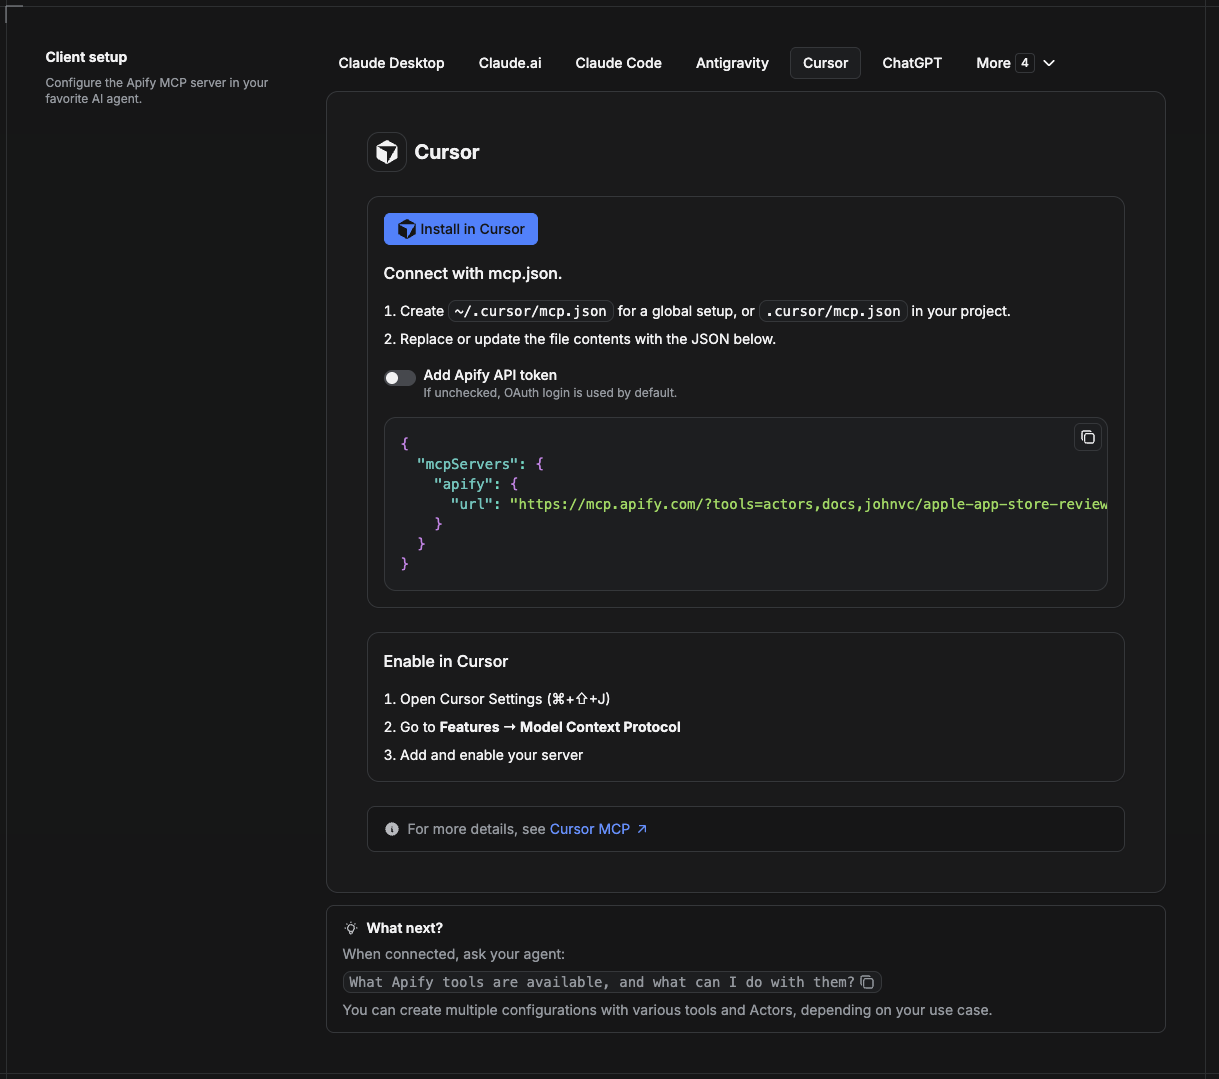
Cursor は、プロジェクトファイル .cursor/mcp.json から MCP サーバーを読み込みます。
- プロジェクト内に
.cursor/mcp.jsonを作成します:
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings"
    }
  }
}
- ブラウザー OAuth ではなくトークン認証を使用する場合は、ヘッダーを追加します:
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings",
      "headers": { "Authorization": "Bearer YOUR_APIFY_TOKEN" }
    }
  }
}
- Cursor → Settings → MCP を開き、apify サーバーが接続されていること(緑色の点)を確認します。
- Composer または Chat で、DuckDuckGo API を呼び出すよう Cursor に依頼します。
Cursor をまだお使いでない方は、こちらから入手できます:https://cursor.com/referral?code=XQP4VBLI3NNX
ChatGPT にインストールする
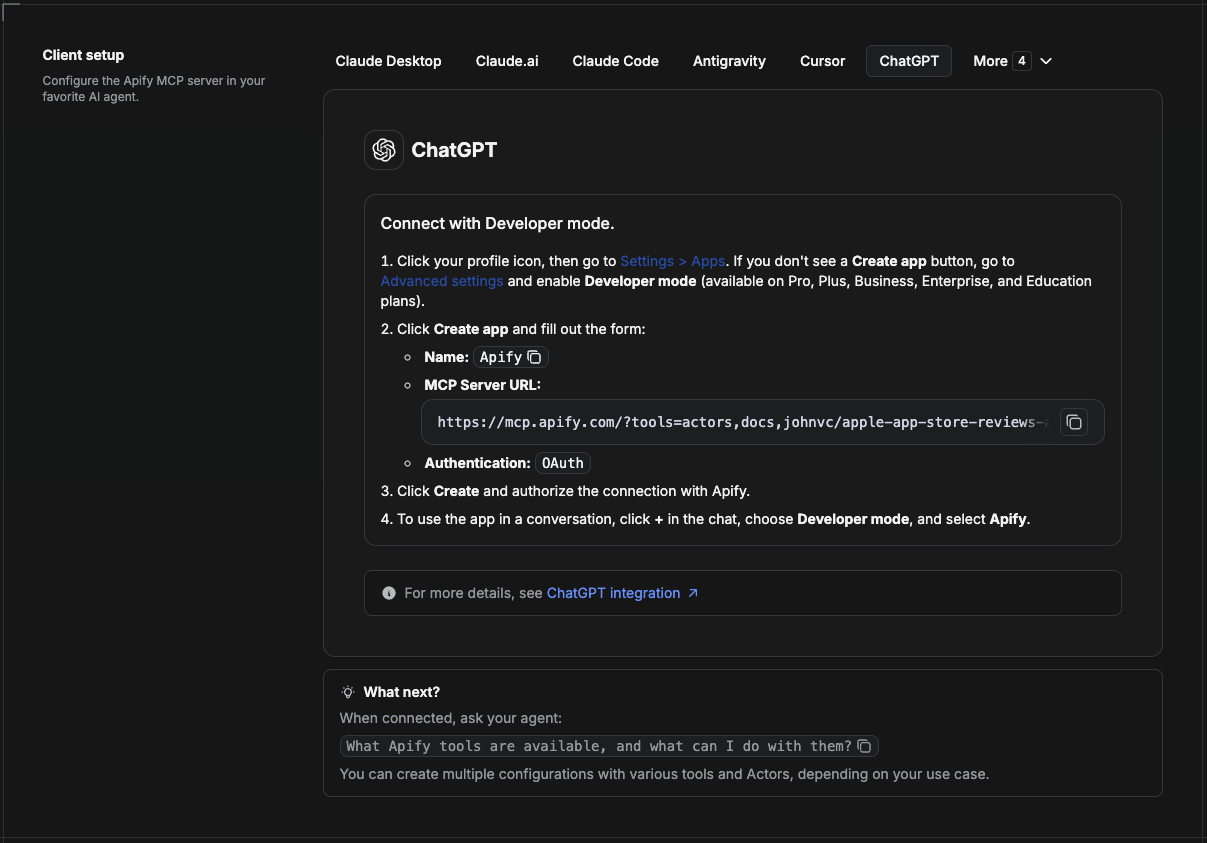
ChatGPT は、Developer mode を通じて Apify MCP サーバーに接続します(ChatGPT Pro、Plus、Business、Enterprise、Education プランで利用できます)。
- プロフィールアイコンをクリックし、Settings > Apps に移動します。Create app ボタンが表示されない場合は、Advanced settings を開いて Developer mode を有効にします。
- Create app をクリックし、フォームに入力します:
- Name: Apify
- MCP Server URL:
https://mcp.apify.com/?tools=actors,docs,johnvc/DuckDuckGo-Scraper-for-serp-rankings - Authentication: OAuth
- Create をクリックし、Apify との接続を認証します。
- 会話でアプリを使用するには、チャット内の + をクリックし、Developer mode を選択してから Apify を選びます。
詳しくはこちら:https://docs.apify.com/platform/integrations/mcp
DuckDuckGo API を活用して、信頼性の高い構造化された結果で検索と SEO のワークフローを強化しましょう。
🤖 この Actor について AI アシスタントに質問する
DuckDuckGo Scraper について、選んだ AI に送信できるプロンプトを開きます:
- 💬 ChatGPT
- 🧠 Claude
- 🔍 Perplexity
- 🅒 Copilot
最終更新日:2026.10.27
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。