
yandex-per-result について
yandex-per-resultは、Yandexの検索結果を構造化JSONで取得するホスト型MCPサーバー兼APIです。地域別ドメイン、言語・地域指定、ページネーション、複数の結果タイプに対応し、ページ単位で課金されます。
主な機能
- 016つのYandexドメインを検索
- 02言語と地域を指定
- 03結果タイプを個別に選択
- 04日付または並び順で絞り込み
- 05ページ数上限を設定してページネーション
活用シーン
- 01地域間の検索結果を比較
- 02ロシア語の検索結果を調査
- 03広告やナレッジグラフ項目を確認
- 04画像や動画の検索結果を収集
MCP 対応
ホスト型MCPサーバーは、Yandex Search APIをアシスタントなどのMCPクライアント向けツールとして公開します。Apify MCP URLで接続し、OAuthまたはApify API tokenで認証します。
設定
リモートサーバーはインストール不要です。クライアントを選んで設定をコピーするか、ワンクリックで導入できます。
https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-resultclaude mcp add --transport http johnisanerd-yandex-per-result https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-result{"mcpServers":{"johnisanerd-yandex-per-result":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"}}}Cursor で開く{"servers":{"johnisanerd-yandex-per-result":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"}}}VS Code で開く{"mcpServers":{"johnisanerd-yandex-per-result":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"}}}{"mcpServers":{"johnisanerd-yandex-per-result":{"serverUrl":"https://mcp.apify.com/?tools=johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"}}}コマンドはターミナルで実行し、JSON は各クライアントの MCP 設定に貼り付けて再起動します。認可が必要なサーバーは初回接続時にログインを求めます。
ツール
詳細
English | Русский
🔍 Yandex Search API:クリーンな JSON で検索結果を取得、ページ単位の課金
結果の種類を問わず、ページごとに一律料金がかかります。Yandex Search API を開発者向けに使いやすくした方法です。
Actor ページ: apify.com/johnvc/yandex-scrape-yandex-search-results-at-scale---per-result 入力スキーマ: apify.com/johnvc/yandex-scrape-yandex-search-results-at-scale---per-result/input-schema
この Yandex Search API は、実行ごとに Search Start の初回料金がかかり、さらに取得した結果ページごとに一律料金がかかります。そのため、料金は有効にした結果の種類の数ではなく、取得するページ数に応じて変わります。ロシアおよび東欧・中央アジアの複数の市場で主流の検索エンジンである Yandex にクエリを送信し、結果の種類ごとにページあたり 1 件の、クリーンで構造化された JSON を返します。各アイテムには検索パラメーター、結果数、オーガニック検索結果、広告、ナレッジグラフ、インライン画像、インライン動画の配列が含まれます。地域ドメイン、言語と地域のターゲティング、ページネーションに対応しています。
この Actor は当初、結果ごとの課金でした。既存のリンクが引き続き機能するよう、URL とこのリポジトリ名には「per-result」が残っています。現在はページごとの課金で、別の Yandex リスティングである Yandex のスクレイピングと同じ料金です。
動画による解説
クイックスタート
前提条件
- Python 3.11 以降
- Apify アカウントと API キー(こちらから無料のキーを取得)
-
リポジトリをクローン
git clone https://github.com/johnisanerd/Apify-Yandex-Pay-Per-Result.git cd Apify-Yandex-Pay-Per-Result -
UV で依存関係をインストール
# Install UV if you do not have it: curl -LsSf https://astral.sh/uv/install.sh | sh # Install project dependencies: uv sync -
API キーを設定
cp .env.example .env # Edit .env and add your Apify API key # Get your free API key at: https://apify.com?fpr=9n7kx3 -
サンプルを実行
uv run python yandex-pay-per-result-scraper.py
代替方法:API キーを直接設定
export APIFY_API_TOKEN="your_api_key_here"
uv run python yandex-pay-per-result-scraper.py
この Yandex Search API を使う理由
ページごとの一律料金。 返される結果の種類にかかわらず、ページ単位で一度だけ課金されます。選択した条件で結果が返されなかったページは課金されないため、探索的な調査、キーワードのテスト、クエリによって結果の密度が異なるワークロードに適しています。
独立した検索インデックス。 Yandex は、独自のランキング、地域コンテンツ、他では再現されていないキリル文字言語への対応を備えたウェブインデックスを管理しています。ロシア語の調査、東欧市場の調査、比較 SEO において、独自の情報源となります。
複数のドメインに対応。 yandex.ru、yandex.com、yandex.com.tr、yandex.by、yandex.kz、yandex.uz を対象にし、lang と lr を組み合わせることで、地域インデックスと言語のバリエーションを細かく制御できます。
豊富な結果の種類。 オーガニック検索結果に加えて、各ページから広告、ナレッジグラフのエントリー、インライン画像ブロック、インライン動画カルーセルが構造化された出力で返されます。
予測しやすい従量課金制。 課金はページごとに加えて、実行ごとに Search Start の初回料金がかかります。サブスクリプションは不要で、max_pages の上限により料金を管理できます。
自動化が簡単。 Python から数行で呼び出すことも、MCP ツールとして読み込むこともできます。Claude や Cursor などのアシスタントが、必要に応じて Yandex 検索を実行できます。
機能
主な機能
- Yandex 検索:対応する 6 つの地域ドメインで検索
- 結果の種類を自由に選択:オーガニック検索結果、広告、ナレッジグラフ、インライン画像、インライン動画を個別に切り替え可能。有効にする種類を増やしても、ページごとの料金は変わりません
- 言語と地域の制御:
langとlrを使用 - 並べ替えと新しさのフィルター:
sort_mode(関連度または日付)とperiod(すべて、1 日、過去 2 週間、1 か月) - 複数ページの並列ページネーション:設定可能な
max_pages上限 - ページごとの課金:実行ごとに Search Start の初回料金がかかり、その後、返されたページごとに一律料金がかかります
データ品質
- ページごとに結果タイプあたり1項目を返し、
item_typeとresult_countでタグ付けします - 位置、タイトル、リンク、スニペット、表示リンクを含む
organic_results配列 - 結果数とメタデータは各項目にエコーされます
- 広告、ナレッジグラフ、画像、動画用の 個別の配列
- すべてのクエリで 一貫した JSON 形式
使用例
基本的な検索
{
  "text": "machine learning tutorial",
  "max_pages": 1
}
言語と地域を指定した地域別ドメイン
{
  "text": "машинное обучение учебник",
  "yandex_domain": "yandex.ru",
  "lang": "ru",
  "lr": "213",
  "max_pages": 1
}
入力パラメーター
| パラメーター | 型 | 必須 | デフォルト | 説明 |
|---|---|---|---|---|
text | string | はい | - | 検索クエリです。site:wikipedia.org python のように、Yandex がサポートする任意の演算子を使用できます。 |
include_organic_results | boolean | いいえ | true | オーガニック検索結果(item_type が organic)を返します。 |
include_ads | boolean | いいえ | false | 広告がある場合は有料広告(item_type が ads)を返します。 |
include_knowledge_graph | boolean | いいえ | false | ナレッジグラフカードがある場合は返します(item_type が knowledge_graph)。 |
include_inline_images | boolean | いいえ | false | インライン画像一覧(item_type が inline_images)を返します。 |
include_inline_videos | boolean | いいえ | false | インライン動画カルーセル(item_type が inline_videos)を返します。 |
yandex_domain | string | いいえ | yandex.com | Yandex のドメインです。例:yandex.ru、yandex.com.tr(6 種類に対応)。 |
lang | string | いいえ | (ドメインのデフォルト) | 言語コードです。例:en、ru。複数の言語を指定する場合は、カンマ区切りにします。 |
lr | string | いいえ | (ドメインのデフォルト) | 国または地域の ID です。例:84(USA)、213(モスクワ)、225(ロシア)。 |
max_pages | integer | いいえ | 2 | 取得する最大ページ数です。0 は無制限を意味します。選択したすべての結果タイプに適用されます。 |
sort_mode | string | いいえ | relevance | 結果の並べ替え順です。relevance または date(新しい順)を指定します。 |
period | string | いいえ | all | 新しさの期間です。all、day、last_two_weeks、month を指定します。 |
output_file | string | いいえ | - | 結果の保存に使用する任意のファイル名です。 |
出力形式
ページに存在する選択済みの結果タイプは、それぞれ独立したデータセット項目として返され、item_type(organic、ads、knowledge_graph、inline_images、inline_videos)と result_count でタグ付けされます。各項目は結果 1 件として課金されます。以下に、machine learning tutorial の代表的な organic 項目を示します(ここでは organic_results 配列を 1 件の結果に絞っています)。
{
  "item_type": "organic",
  "result_count": 10,
  "text": "machine learning tutorial",
  "yandex_domain": "yandex.com",
  "lang": "en",
  "lr": "84",
  "max_pages": 1,
  "search_timestamp": "2026-05-29T11:51:33",
  "total_results_found": 10,
  "pages_processed": 1,
  "page_number": 1,
  "search_domain_description": "United States",
  "search_language_description": "English",
  "results_per_page": 10,
  "organic_results": [
    {
      "position": 2,
      "title": "Machine Learning Tutorial - GeeksforGeeks",
      "link": "https://www.geeksforgeeks.org/machine-learning/machine-learning/",
      "snippet": "Machine Learning is mainly divided into three core types: Supervised Learning: Trains models on labeled data to predict or classify new, unseen data.",
      "displayed_link": "geeksforgeeks.org > machine-learning > machine"
    }
  ],
  "ads_results": [],
  "knowledge_graph": [],
  "inline_images": [],
  "inline_videos": []
}
各ページ項目には検索パラメーターと結果数がエコーされ、organic_results にすべてのオーガニック検索結果(位置、タイトル、リンク、スニペット、表示リンクを含む)が列挙されます。また、動画やニュースの結果には duration と date が含まれる場合があります。さらに、ads_results、knowledge_graph、inline_images、inline_videos の配列が個別に返されます。
MCP ツールとして使用する
Yandex Search API を MCP ツールとして読み込み、アシスタントから呼び出せるようにできます。MCP サーバーの URL には、この Actor のみがあらかじめ読み込まれています。
https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result
ブラウザーで求められた場合は OAuth で認証するか、Apify API トークン(Python の例で使用しているものと同じ APIFY_API_TOKEN)で認証してください。トークンは https://console.apify.com/settings/integrations で取得できます。無料の Apify アカウントは https://apify.com?fpr=9n7kx3 で作成できます。
Claude Cowork デスクトップにインストールする
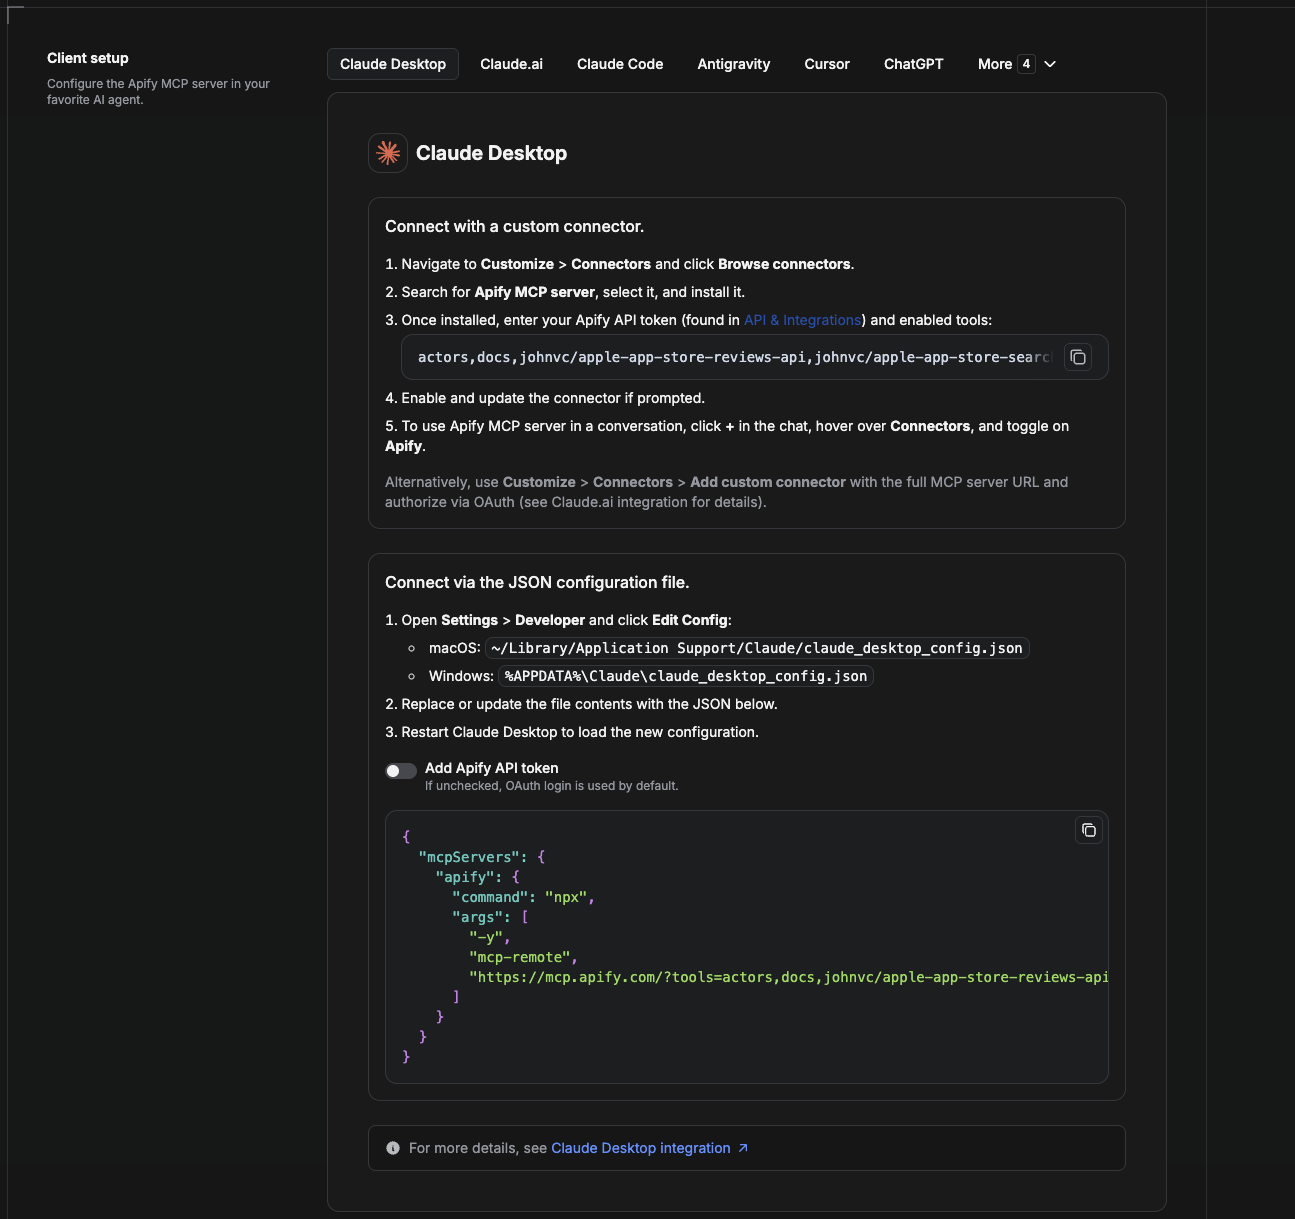
Cowork はデスクトップアプリの自動化モードです。Yandex Search API をツールとして使えるようにするには、Apify MCP サーバーをコネクターとして追加します。
- Claude デスクトップアプリを開き、Settings → Connectors に移動します(または、
claude_desktop_config.jsonを直接編集するには Settings → Developer → Edit Config に移動します)。- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
- macOS:
- この Actor のみを事前読み込みした Apify MCP サーバーを追加します。
{
  "mcpServers": {
    "apify": {
      "command": "npx",
      "args": [
        "-y",
        "mcp-remote",
        "https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"
      ]
    }
  }
}
- アプリを再起動します。Cowork が初めてツールを呼び出したときに、ブラウザーで OAuth プロンプトを完了するか、コネクターの設定に Apify API トークンを追加して OAuth を省略します。
- Cowork のチャットでツールが利用可能であることを確認し、Yandex Search API を実行するよう依頼します。
デスクトップアプリをダウンロードして無料トライアルを開始:https://claude.ai/referral/uIlpa7nPLg 詳しいヘルプ:https://docs.apify.com/platform/integrations/claude-desktop
Claude Code にインストールする
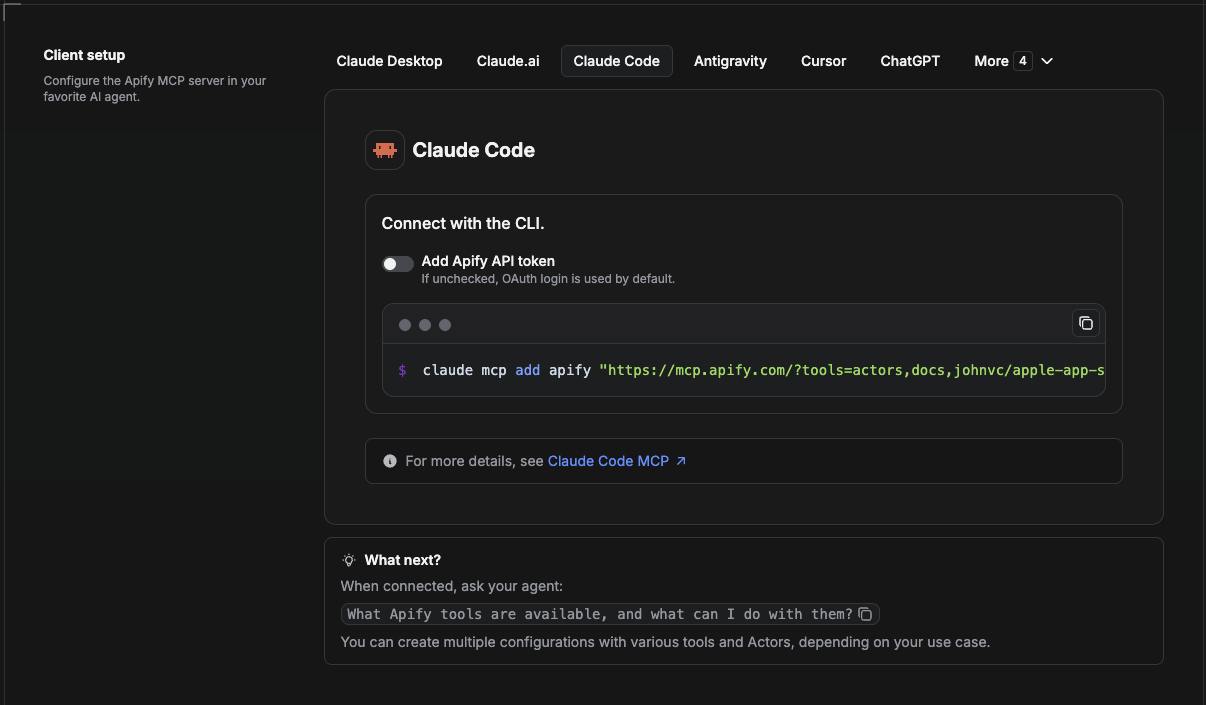
Claude Code はコマンドラインツールです。次のコマンドで Actor の MCP サーバーを追加します。
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"
ブラウザーでの OAuth の代わりにトークンを使用する場合:
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result" \
  --header "Authorization: Bearer YOUR_APIFY_TOKEN"
その後、claude mcp list で確認するか、セッション内で /mcp を実行します。Claude Code に Yandex Search API を呼び出すよう依頼します。
Claude Code を無料でお試しください:https://claude.ai/referral/uIlpa7nPLg Claude Code MCP ドキュメント:https://code.claude.com/docs/en/mcp
Claude(ウェブサイト)にインストールする
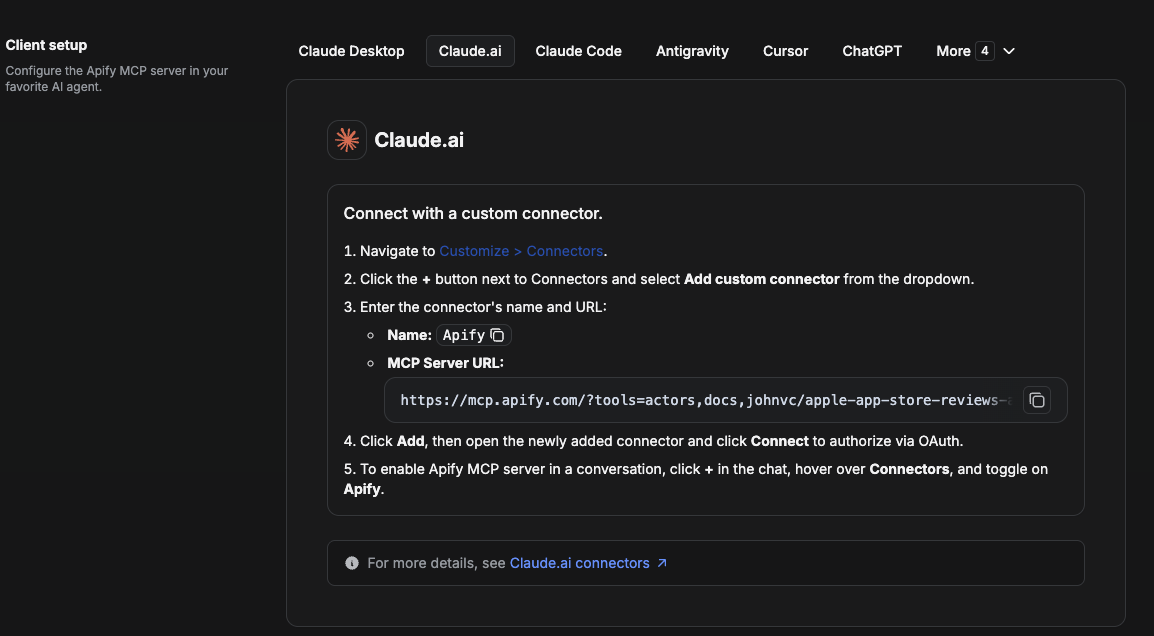
claude.ai では、Apify をコネクターとして追加し、この Actor のツールのみを有効にします。
- Settings → Connectors → Browse connectors に移動し、Apify MCP server を検索します。インストールします(求められた場合は有効化または更新します)。
- 接続時に Apify API トークンで認証し、ツール
johnvc/yandex-scrape-yandex-search-results-at-scale---per-resultを有効にします。 - 任意のチャットで + → Connectors を開き、Apify をオンにします。
- または、Add custom connector を選択して、完全な MCP URL
https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-resultを貼り付けます。求められた場合は OAuth を使用します。 - Claude に Yandex Search API を実行するよう依頼します。
ウェブで Claude を開く:https://claude.ai/referral/uIlpa7nPLg
Cursor にインストールする
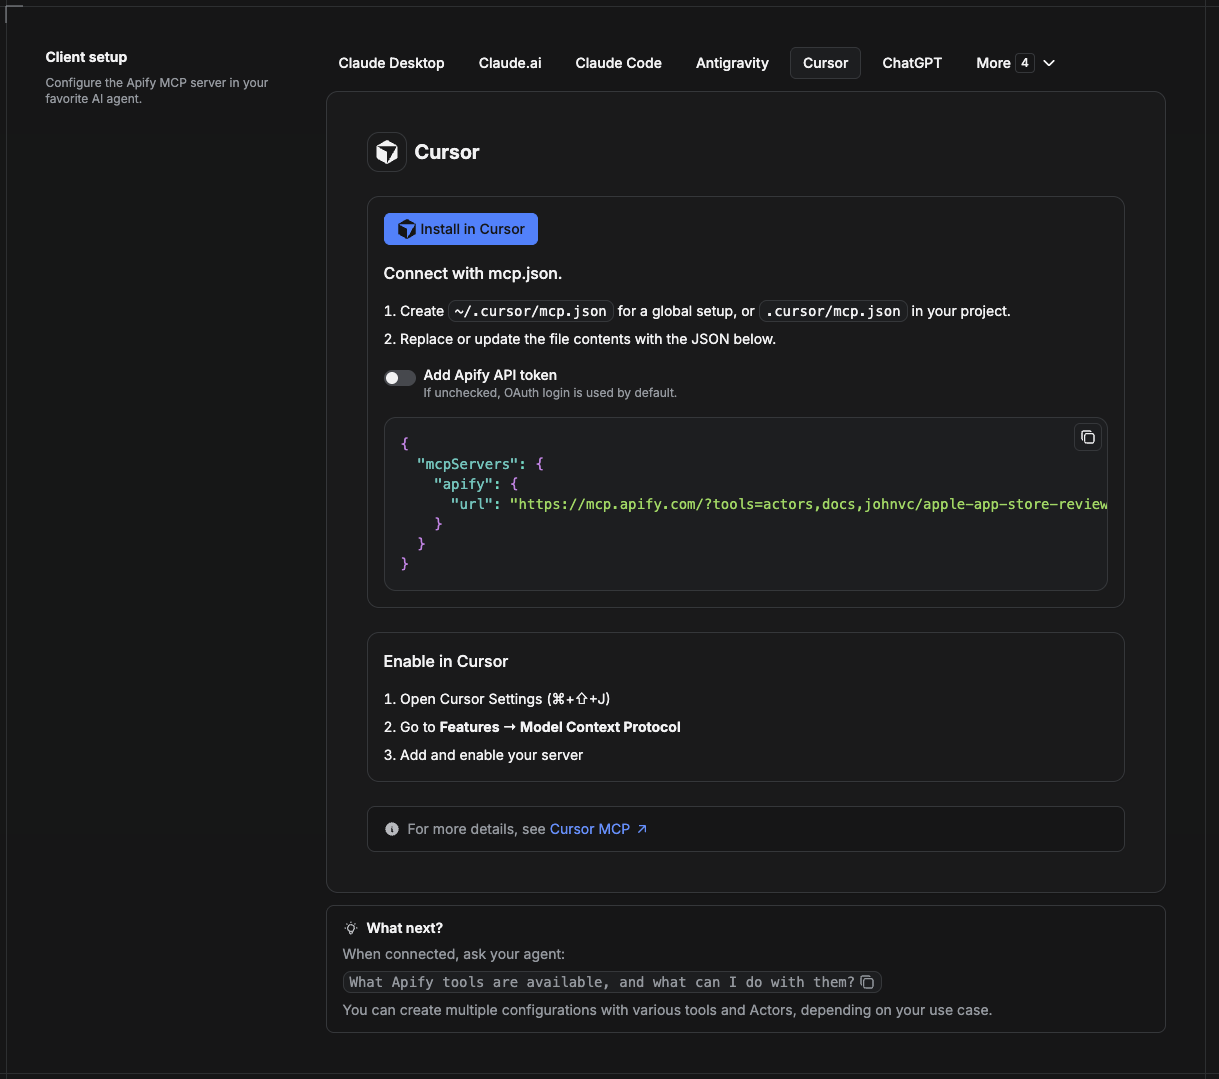
Cursor は、プロジェクトファイル .cursor/mcp.json から MCP サーバーを読み込みます。
- プロジェクト内に
.cursor/mcp.jsonを作成します。
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result"
    }
  }
}
- ブラウザーでの OAuth の代わりにトークン認証を使用する場合は、ヘッダーを追加します。
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result",
      "headers": { "Authorization": "Bearer YOUR_APIFY_TOKEN" }
    }
  }
}
- Cursor → Settings → MCP を開き、apify サーバーが接続されていること(緑色の点)を確認します。
- Composer または Chat で、Cursor に Yandex Search API を呼び出すよう依頼します。
Cursor を初めて使いますか?こちらから入手してください:https://cursor.com/referral?code=XQP4VBLI3NNX
ChatGPT にインストールする
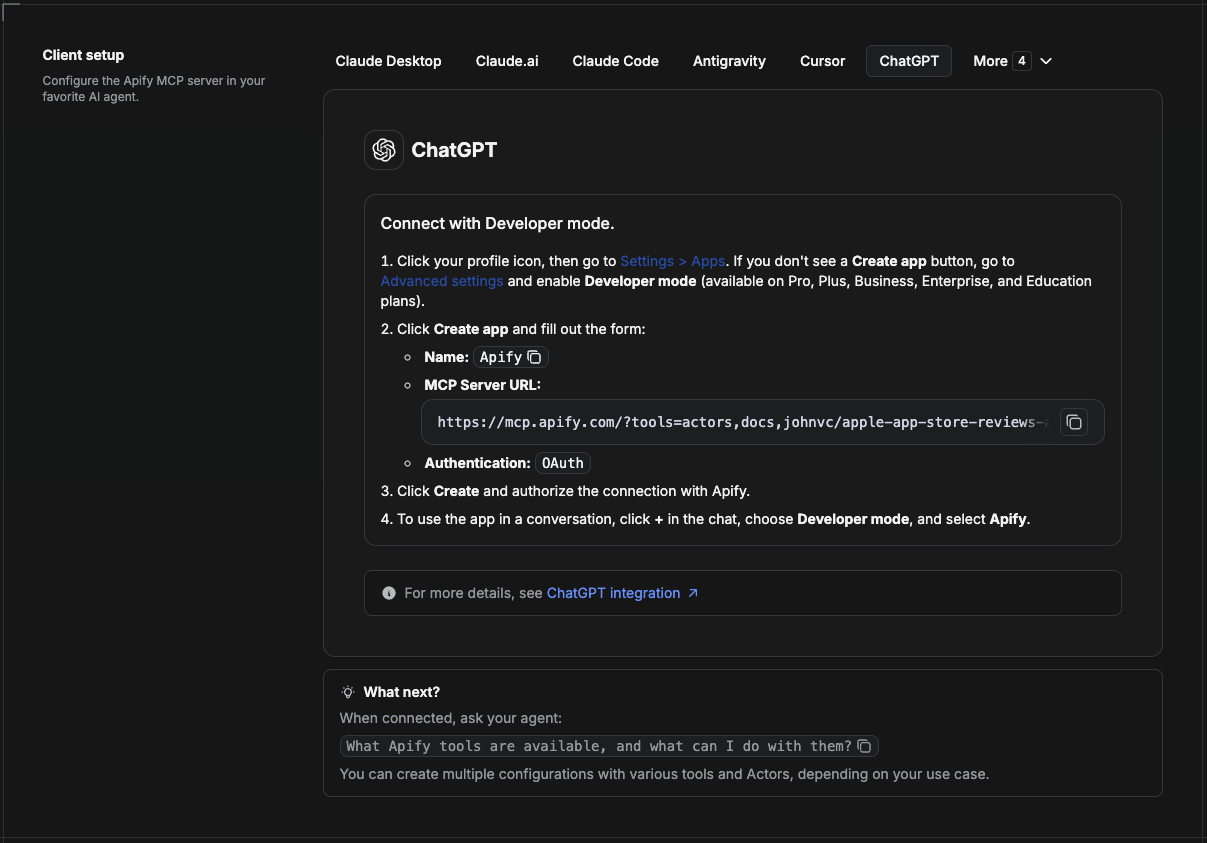
ChatGPT は、開発者モードを通じて Apify MCP サーバーに接続します(ChatGPT Pro、Plus、Business、Enterprise、Education プランで利用できます)。
- プロフィールアイコンをクリックし、Settings > Apps に移動します。Create app ボタンが表示されない場合は、Advanced settings を開いて Developer mode を有効にします。
- Create app をクリックして、フォームに入力します。
- Name: Apify
- MCP Server URL:
https://mcp.apify.com/?tools=actors,docs,johnvc/yandex-scrape-yandex-search-results-at-scale---per-result - Authentication: OAuth
- Create をクリックし、Apify との接続を認証します。
- 会話でアプリを使用するには、チャット内の + をクリックし、Developer mode を選択してから Apify を選びます。
詳しくはこちら:https://docs.apify.com/platform/integrations/mcp
信頼性の高い構造化された結果を使って、SEO 調査、市場分析、多言語コンテンツ分析を支援する Yandex Search API です。
注目のタスク
Apify Store ですぐに実行できるサンプルです。
🤖 この Actor について AI アシスタントに質問する
お好みの AI で、Yandex Search API に関するすぐに送信できるプロンプトを開きます。
- 💬 ChatGPT
- 🧠 Claude
- 🔍 Perplexity
- 🅒 Copilot
最終更新日:2026.10.27
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。