footnote-mcp について
footnote-mcpは、エージェントや調査ワークフロー向けのウェブ調査MCPサーバーです。複数エンジンでの検索、情報抽出、ブラウザー操作に加え、出典に基づく主張の検証と文字オフセット付き引用に対応します。
主な機能
- 01APIキー不要の複数エンジン検索
- 02テキスト、表、リンク先ファイルの抽出
- 03取得した出典テキストに基づく主張検証
- 04文字オフセット付き引用の返却
- 05Chromiumによる動的ページの操作
活用シーン
- 01複数の検索エンジンを使ったテーマ調査
- 02ウェブ表データの抽出と比較
- 03出典ページに基づく記述の検証
- 04動的コンテンツを含むページの操作
MCP 対応
stdioで通信し、検索、抽出、検証、ブラウザー操作の45種類のツールをMCPクライアントに提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
45掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| num | integer | いいえ | 返す結果の最大数 |
| lang | string | いいえ | 言語コード:en、ru など。 |
| query | string | はい | 検索クエリ |
| provider | string | いいえ | auto | auto+marginalia | searxng | tavily | brave | google | wiby | marginalia | scrape |
| semantic | boolean | いいえ | ローカルの bge-m3 埋め込みを使用して、意味に基づいて結果を再ランキングします |
詳細
footnote-mcp — 主張検証機能を備えたウェブ調査用 MCP サーバー
検索、データ抽出を行い、すべての主張をソースページと照合して検証します。
生テキストや Markdown を返す検索 API(Tavily、Exa)やスクレイパー(Firecrawl)とは異なり、footnote-mcp は検証を目的として構築されています。すべての主張を生のソーステキストと照合し、文単位の引用と文字オフセットを付けて検証します。API キーは一切必要ありません。
Cursor に追加 · Claude Desktop のセットアップ
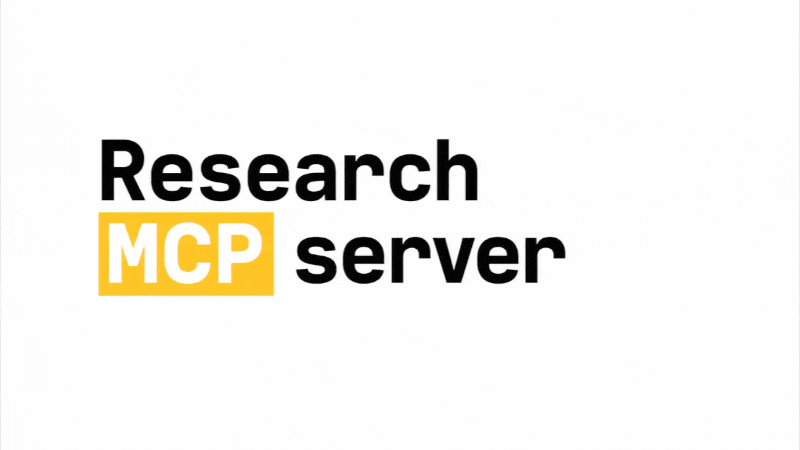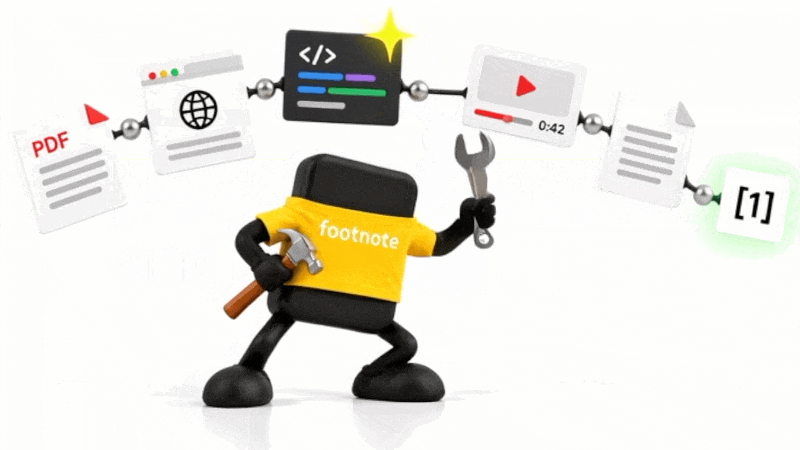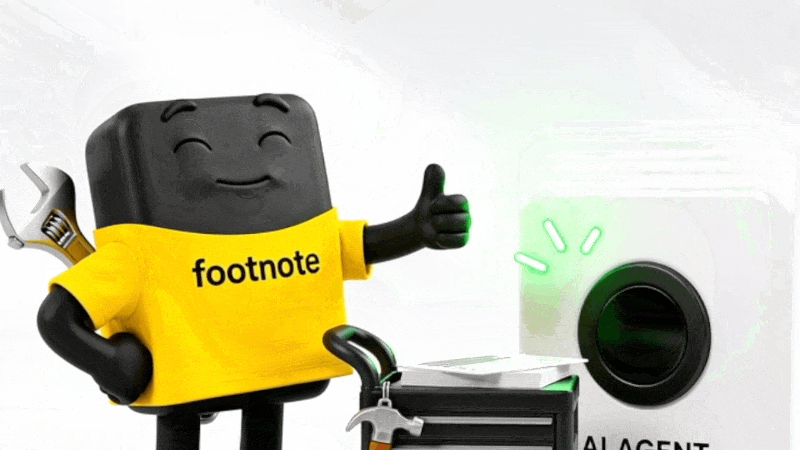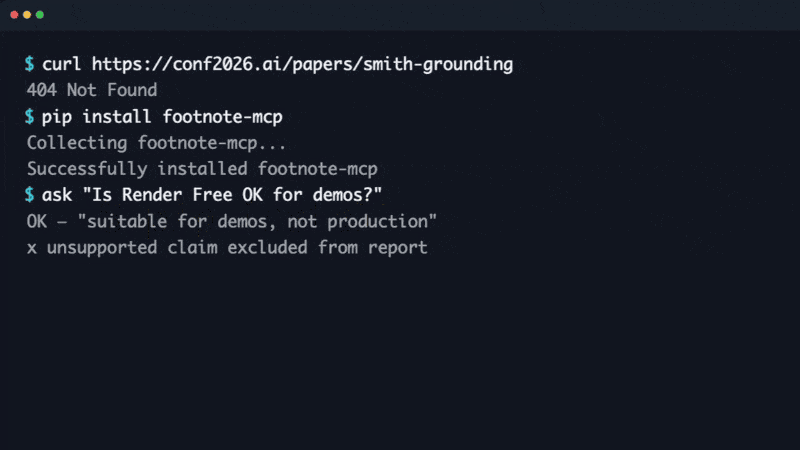
API キーなしで実行可能 · 45 個のツール · MIT ライセンス
クイックスタート
pip install footnote-mcp
python -m playwright install chromium   # browser tier for JS-heavy and blocked pages
footnote-mcp は stdio 経由で MCP と通信します。クライアントから接続してください。Claude Desktop の
claude_desktop_config.json、または Cursor の ~/.cursor/mcp.json を指定します。
{"mcpServers": {"footnote": {"command": "footnote-mcp"}}}
利用開始に API キーは不要です。クライアントを再起動し、startup_health_check を実行するよう依頼してください。
このツールは、抽出機能、PDF とスプレッドシートのパーサー、ブラウザー、OCR、キャッシュディレクトリがこのマシンで利用可能かどうかを、それぞれ1行で報告します。これにより、オプションの機能が不足している場合、調査タスクの途中ではなく、開始時点で把握できます。
プロバイダーのルーティング、キー、セマンティック再ランク付けについては、docs/search-backends.md をご覧ください。
API キーを設定せずにウェブを検索する
アシスタントに何かを調べるよう依頼すると、web_search は API キー不要のプロバイダー(Bing、
DuckDuckGo、Brave、Wiby)と、設定済みのキーがあるプロバイダーを同時に検索し、結果を重複排除して統合し、1つのランキングにまとめます。
各検索結果には、その結果を返した検索エンジンと関連度スコアが含まれます。そのため、2つの独立したインデックスが一致したページと、1つの検索エンジンだけが見つけたページを区別できます。スニペットはあくまで発見の手がかりであり、この段階では証拠ではありません。証拠については、次の2つのセクションで説明します。
ページからテーブルやファイルを抽出し、構造化された行にする
web_extract_tables は、ページ内の HTML テーブルを列名と行に変換します。各データセットには取得元の URL と正確な総件数が付くため、結果が途中で切れている場合も、完全な結果であるかのように見せず、そのことを明示します。Wikipedia の売上テーブルを指定すれば、読み返す必要のある大量のテキストではなく、並べ替えや比較が可能な Rank、Name、
Industry、Revenue、Employees をフィールドとして取得できます。
ページ上に表示されず、リンク先にあるデータにも対応しています。web_detect_downloads は、ページに添付された
CSV/TSV/XLS/XLSX/PDF/JSON を検出し、web_parse_file で解析できます。また、web_fetch_json には API エンドポイントを直接指定できます。
ソースが実際に主張を裏付けているか検証する
通常の検索ツールにはない機能です。evidence_entailment は主張とソーステキストを比較して判定を返し、corroborate_claim は抜粋を横断して照合し、locate_claim_span は文字オフセット付きで根拠となる文を返します。
主張が 「2023年、ノルウェーの新車乗用車に占めるバッテリー式電気自動車の割合は82.4%だった」 で、ソースに 「2023年にノルウェーで新規登録された乗用車のうち、バッテリー式電気自動車が占める割合は82.4%でした」 と記載されている場合、判定結果は、エージェントが解釈する必要のある段落ではなく、そのまま利用できる値として返されます。
{"status": "supported", "score": 0.778, "reason": "token overlap heuristic", "backend": "heuristic"}
デフォルトのバックエンドは決定論的かつオフラインで動作し、別のモデルにひそかに判定を委ねることはありません。確信が持てない場合は、照合した箇所とともに needs_review を返します。それらは、あなた自身、または呼び出し元のアシスタントが確認できます。呼び出し元のアシスタントは、すでに両方のテキストを受け取っています。必要に応じて、ローカル LLM 判定器(backend="ollama")とローカル NLI モデル(backend="local_nli")も利用できます。デフォルトの決定論的処理の精度測定結果については、benchmarks/REPORT.md をご覧ください。
仕組み
検索スニペットは発見のためのものであり、証拠として使うことはありません。発見では複数の独立したインデックスを統合します。
取得は段階的に進み、プレーン HTTP、任意のプロキシ、ヘッドレス Chromium、任意のホスト型スクレイピング API の順に試し、実際のコンテンツが返される最も低コストの段階で停止します。抽出ではテキスト、テーブル、リンク先のファイルを取得し、それぞれのソース URL とともにキャッシュします。検証はその後にのみ実行され、取得したテキストと主張を照合してから、証拠として扱います。web_deep_search はこの一連の処理をまとめて実行します。要件を分解し、未解決のギャップを再検索して、候補がどの段階で失われたかを示すファネル付きの証拠台帳を返します。
query → merged discovery → fetch ladder → extract (text · tables · files) → verify vs source → evidence
カテゴリ別の全45ツール
検索(8)
web_search— ゼロキーのプロバイダー(Bing、DuckDuckGo、Brave、Wiby)と、任意の従量課金 API を利用したマルチエンジン検索web_search_recent— 期間(1日、1週間、1か月、1年)を指定した最新情報の検索web_deep_search— 証拠台帳とファネル診断を備えた、反復的な複数ステップの調査ループpapers_search— Crossref と arXiv を利用した学術論文の検索encyclopedia_search— Wikipedia と Wikidata のエンティティ検索、および読み取り専用の SPARQLgithub_search— 公開リポジトリ、コード、イシュー、コミットの検索archive_search— Wayback Machine と Common Crawl を利用した過去のスナップショット検索generate_search_queries— 対象を絞った演算子付きクエリ(site:、filetype:csv)の生成
取得(4)
web_read— URL を取得し、テキストを抽出してソースの品質を評価し、スナップショットをキャッシュweb_fetch_authenticated— カスタム Cookie またはセッションヘッダーが必要なページを取得web_archive_fetch— 消失または変更された URL について、最も近い Wayback Machine のスナップショットを取得web_crawl— 開始 URL からリンクをたどる幅優先クロール
抽出(15)
web_extract_tables— HTML テーブルを、ソース URL 付きの型付き列と行に解析web_detect_downloads— リンクされたデータファイル(CSV、TSV、XLS、XLSX、PDF、JSON、XML)を検出web_parse_file— 表形式データと PDF ドキュメントをダウンロードして解析web_fetch_json— REST API の直接のエンドポイントから JSON を取得して解析check_date_completeness— カレンダーおよび市場のスケジュールに基づき、時系列の日付の連続性を検証resolve_units— 通貨、単位、通貨ペアを正規化validate_unit_rows— 単位または通貨が矛盾する行を検出して除外reconcile_time_series— キーに基づいて系列を整列し、差分を計算して、欠損エントリや外れ値を検出export_dataset— 統合した行を CSV、XLSX、または JSON ファイルとして保存tool_spec_propose— タスク固有の抽出レシピ仕様を提案tool_code_generate— Python 抽出レシピのひな形を生成tool_code_validate— AST の安全な許可リストに照らしてレシピコードを検証tool_code_run_sandboxed— 制限付きサブプロセス内で抽出コードを実行tool_promote— 検証済みのレシピをローカルメモリに保存recipe_registry— 登録済みの抽出レシピを一覧表示、確認、実行、削除
検証(8)
evidence_entailment— ソーステキストが主張を含意しているかを評価(ヒューリスティック、Ollama、または NLI)corroborate_claim— 複数の抜粋を用いて、主張への合意または矛盾を照合locate_claim_span— 文字オフセットと包含スコアを付けて、裏付けとなる文を特定classify_source— ドメインを分類(公式、アグリゲーター、ブログ、フォーラム、インタラクティブ、ブロック)source_cache_get— キャッシュ済みのページスナップショットと来歴メタデータを取得source_cache_put— ページのコンテンツとメタデータを永続キャッシュに保存build_research_debug_report— クエリ、ソース、検証のギャップに関する簡潔な診断レポートstartup_health_check— パーサー、ブラウザーランタイム、OCR、キャッシュディレクトリの利用可否を確認
パラメーターとスキーマの詳細:docs/tools.md。
要件
- macOS、Linux、または Windows 上で Python 3.10 以降 — CI では6つの組み合わせすべてを実行します
- ブラウザーティアとブラウザーツールには、
python -m playwright install chromiumによる Chromium が必要です - stdio に対応する MCP クライアント。Claude Desktop と Cursor の設定を記載しています
- オプション(
semantic: trueの場合):Ollama デーモン、または同じ bge-m3 の重みをプロセス内で実行するためのrequirements-embed.txt— Docker など、デーモンが存在しない環境で利用できる唯一のオプションです - オプション:
web_screenshotとスキャンした PDF の OCR に使うシステムのtesseractバイナリ - API キー不要、アカウント不要、ホスト型サービス不要
制限事項
- オフラインの含意ヒューリスティックは、数値および事実に関する主張で100%のスコアを達成しますが、ラベル付きデータセット全体では83%です。純粋に意味的な否定や言い換えには
backend="ollama"が必要です。 - ベンチマークランナーには Windows でタスクごとの厳密なタイムアウトがありません。Windows には
signal.setitimerがないため、これを基盤とするベンチマークランナーでは、ハングしたタスクが保護されずに実行され続けます。サーバー自体には影響しません。 - API キー不要のプロバイダーはスクレイピングを使うため、結果は IP アドレスによって異なります。検索が拒否されるとプロキシ経由で再試行され、Bing と Brave ではヘッドレス Chromium も使われます。DuckDuckGo は Chromium にエラースタブを返すため、クールダウンを待つか、何もできません。
- セマンティック再ランキングはベストエフォートです。利用可能な埋め込みランタイムがない場合、元の順位がそのまま返されます。
- 生成されたレシピは、
csv、datetime、html、json、math、re、statisticsのみをインポートできるサブプロセスで実行されます。また、eval、exec、open、__import__は拒否されます。これはバリデーターであり、強固なサンドボックスではありません。 - ホスト型 HTTP サーバーは、ユーザーごとのレート制限をメモリ上に保持します。サーバーを再起動するとリセットされます。
設定
サーバーが受け取るフラグは --headed の1つです。このフラグを指定すると、Chromium のウィンドウが表示され、非表示で実行する代わりにブラウザーを確認できます。繰り返し失敗するページでブラウザーティアが動作する様子を見るのに便利です。
{"mcpServers": {"footnote": {"command": "footnote-mcp", "args": ["--headed"]}}}
環境変数
すべての変数は任意です。無料枠(Bing、DuckDuckGo、Brave、Wiby)の結果が先に返され、無料の結果が FOOTNOTE_MIN_FREE_RESULTS を下回った場合にのみ、従量課金のプロバイダーが呼び出されます。有料検索はデフォルトではなく、フォールバックです。キーがなくてもほとんどのクエリには影響せず、範囲の狭い検索や珍しい検索で、結果が追加されずに少なくなるだけです。
| 変数 | 設定した場合の動作 | 未設定の場合の動作 |
|---|---|---|
FOOTNOTE_SEARXNG_URL | セルフホストの SearXNG が無料枠に加わり、従量課金されません | 無料枠は Bing、DuckDuckGo、Brave、Wiby です |
TAVILY_API_KEY | Tavily が従量課金のローテーションに加わります | スキップされ、呼び出されません |
BRAVE_API_KEY | スクレイピングした Brave と併せて、Brave Search API がローテーションに加わります | キー不要のスクレイピングした Brave のみが使用されます |
GOOGLE_API_KEY と GOOGLE_CSE_ID | Google Programmable Search がローテーションに加わります | スキップされ、呼び出されません |
FOOTNOTE_MIN_FREE_RESULTS | 従量課金のフォールバックを呼び出す無料結果のしきい値 | 3 |
FOOTNOTE_PROVIDER_STRATEGY | merge はすべてのプロバイダーを呼び出し、cost_aware は必要な場合にのみ従量課金のプロバイダーを呼び出します | cost_aware |
GITHUB_TOKEN | github_search が認証済みのレート制限で実行されます | 未認証のレート制限が適用されます |
FOOTNOTE_RESEARCH_MODEL | web_deep_search でのクエリ計画と事実抽出に使用する Ollama モデル | プランナーなしで実行されます |
FOOTNOTE_EMBED_MODEL | semantic: true の再ランキングに使用する埋め込みモデル | bge-m3 |
FOOTNOTE_EMBED_BACKEND | ollama はデーモンが必要です。local は同じ重みをプロセス内に読み込みます(requirements-embed.txt) | auto:デーモンが実行中ならデーモンを使用し、そうでなければプロセス内で実行します。それもできない場合はランキングに変更はありません |
FOOTNOTE_BROWSER_FALLBACK | 0 にすると Chromium ブラウザーへのフォールバックが無効になります | 有効 |
FOOTNOTE_SEARCH_CACHE_TTL | 検索キャッシュの TTL(秒単位。0 で無効) | 86400 |
FOOTNOTE_PROXIES | リクエストに使用する、カンマ区切りのプロキシ URL | 直接接続 |
FOOTNOTE_SCRAPE_API | キーを指定して利用するホスト型スクレイパーへのフォールバック(firecrawl または scrapingbee) | ブラウザー層が最後のフォールバックです |
FOOTNOTE_SOURCE_CACHE | 生のキャッシュページを保存するディレクトリ | ~/.footnote-mcp/source_cache/ |
一覧とデフォルト値については、.env.example、docs/fetching.md、docs/search-backends.md をご覧ください。
Docker、uvx、ソースからのインストール、OCR、テスト
Docker
docker run -i --rm ghcr.io/kazkozdev/footnote-mcp:latest # bundles Chromium and Tesseract
{"mcpServers": {"footnote": {"command": "docker",
  "args": ["run", "-i", "--rm", "ghcr.io/kazkozdev/footnote-mcp:latest"]}}}
uvx / pipx / ソースからのインストール
uvx footnote-mcp
pipx install footnote-mcp
python3 -m venv .venv && source .venv/bin/activate && pip install -e .
これらはいずれもブラウザーを取得しません。python -m playwright install chromium も一度実行してください。実行しない場合、ブラウザー層とブラウザーツールは利用できません。
OCR とローカル NLI
pytesseract にはシステムバイナリが必要です(brew install tesseract)。backend="local_nli" を指定した evidence_entailment には、pip install -r requirements-nli.txt と FOOTNOTE_NLI_MODEL が必要です。
テスト
python -m pytest -q                              # offline; no network or keys
RUN_LIVE_WEB_TESTS=1 python -m pytest -m live    # opt-in live search


コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。