mcp-retriever について
mcp-retrieverは、ウェブ検索、ページ抽出、サイトクロール、引用付きリサーチを提供するMCPサーバーです。複数のプロバイダーを設定でき、キーはクライアント設定ではなく専用の認証情報ファイルに保存します。
主な機能
- 01複数の検索プロバイダーの結果を統合
- 02ページ抽出とサイトクロール
- 03対象となる404/410ページにWaybackスナップショットを利用
- 04使用上限とプロバイダーのクールダウンを設定
- 05プロバイダーキーをクライアント設定の外に保存
活用シーン
- 01複数プロバイダーの検索結果を統合して順位付け
- 02ページ内容の抽出やサイトのクロール
- 03利用できないページのアーカイブ版を取得
- 04キーをクライアント設定に含めずプロバイダーを設定
MCP 対応
MCPクライアントに検索、ページ読み取り、サイトクロール、リサーチ機能を公開します。セットアップウィザードでクライアント設定を行い、プロバイダーキーは別に保存します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
1掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| limit | integer | いいえ | 返す最大行数(デフォルト:200、最大:500) |
| offset | integer | いいえ | 行オフセット(1 始まり、デフォルト:1) |
| result_id | string | はい | Retriever ツールが返す不透明な結果 ID |
| byte_offset | integer | いいえ | 選択した行内の UTF-8 バイトオフセット。next_byte_offset を変更せずに渡します(デフォルト:0) |
詳細
mcp-retriever
Web 検索、ページ抽出、引用付きリサーチを提供する 1 つの MCP サーバーです。 独自のプロバイダーを使って結果を組み合わせ、API キーを クライアント設定に保存せずに利用できます。
- まとめて検索: 2 つまたは 3 つのプロバイダーにクエリを送信し、URL の重複を除去して、
web_search_fusedでランキングを統合します。 - さらに詳しく読む: ページを抽出し、サイトをクロールします。アーカイブへのフォールバックが有効な場合は、 Wayback Machine のスナップショットから 404/410 ページを復元します。
- 使用量を管理: プロバイダーが報告する使用量に対する任意の支出上限、クールダウン、大量の結果へのページ分けされたアクセスに対応しています。
Tavily、Brave、Exa、You.com、SearXNG、GitHub、Linkup、 Firecrawl、Context.dev に対応しています。使用するものだけを設定してください。
Context.dev は、Web 検索、ai_search による調査済みの回答、
context_news によるニュース検索、スクレイピング、ブランドツールに対応しています。
そのハイライトは検索ツールと読み取りツールで利用できます。Exa 検索には lite タイプが追加され、
Firecrawl 検索カテゴリは developer、gov、research、pdf です。詳細は、
2026-10-19 に確認された
設定
をご覧ください。
クイックスタート
Node.js 22+ とプロバイダーのキー、または独自の SearXNG インスタンスが必要です。
npx -y mcp-retriever setup
プロバイダーを選択し、キーを安全な場所に保存して、MCP クライアントに接続します。 ウィザードでは Claude Desktop と Cursor の設定項目が作成されます。また、Claude Code と Codex のコマンド/設定も表示されます。 課金対象となるキーの確認には同意が必要です。
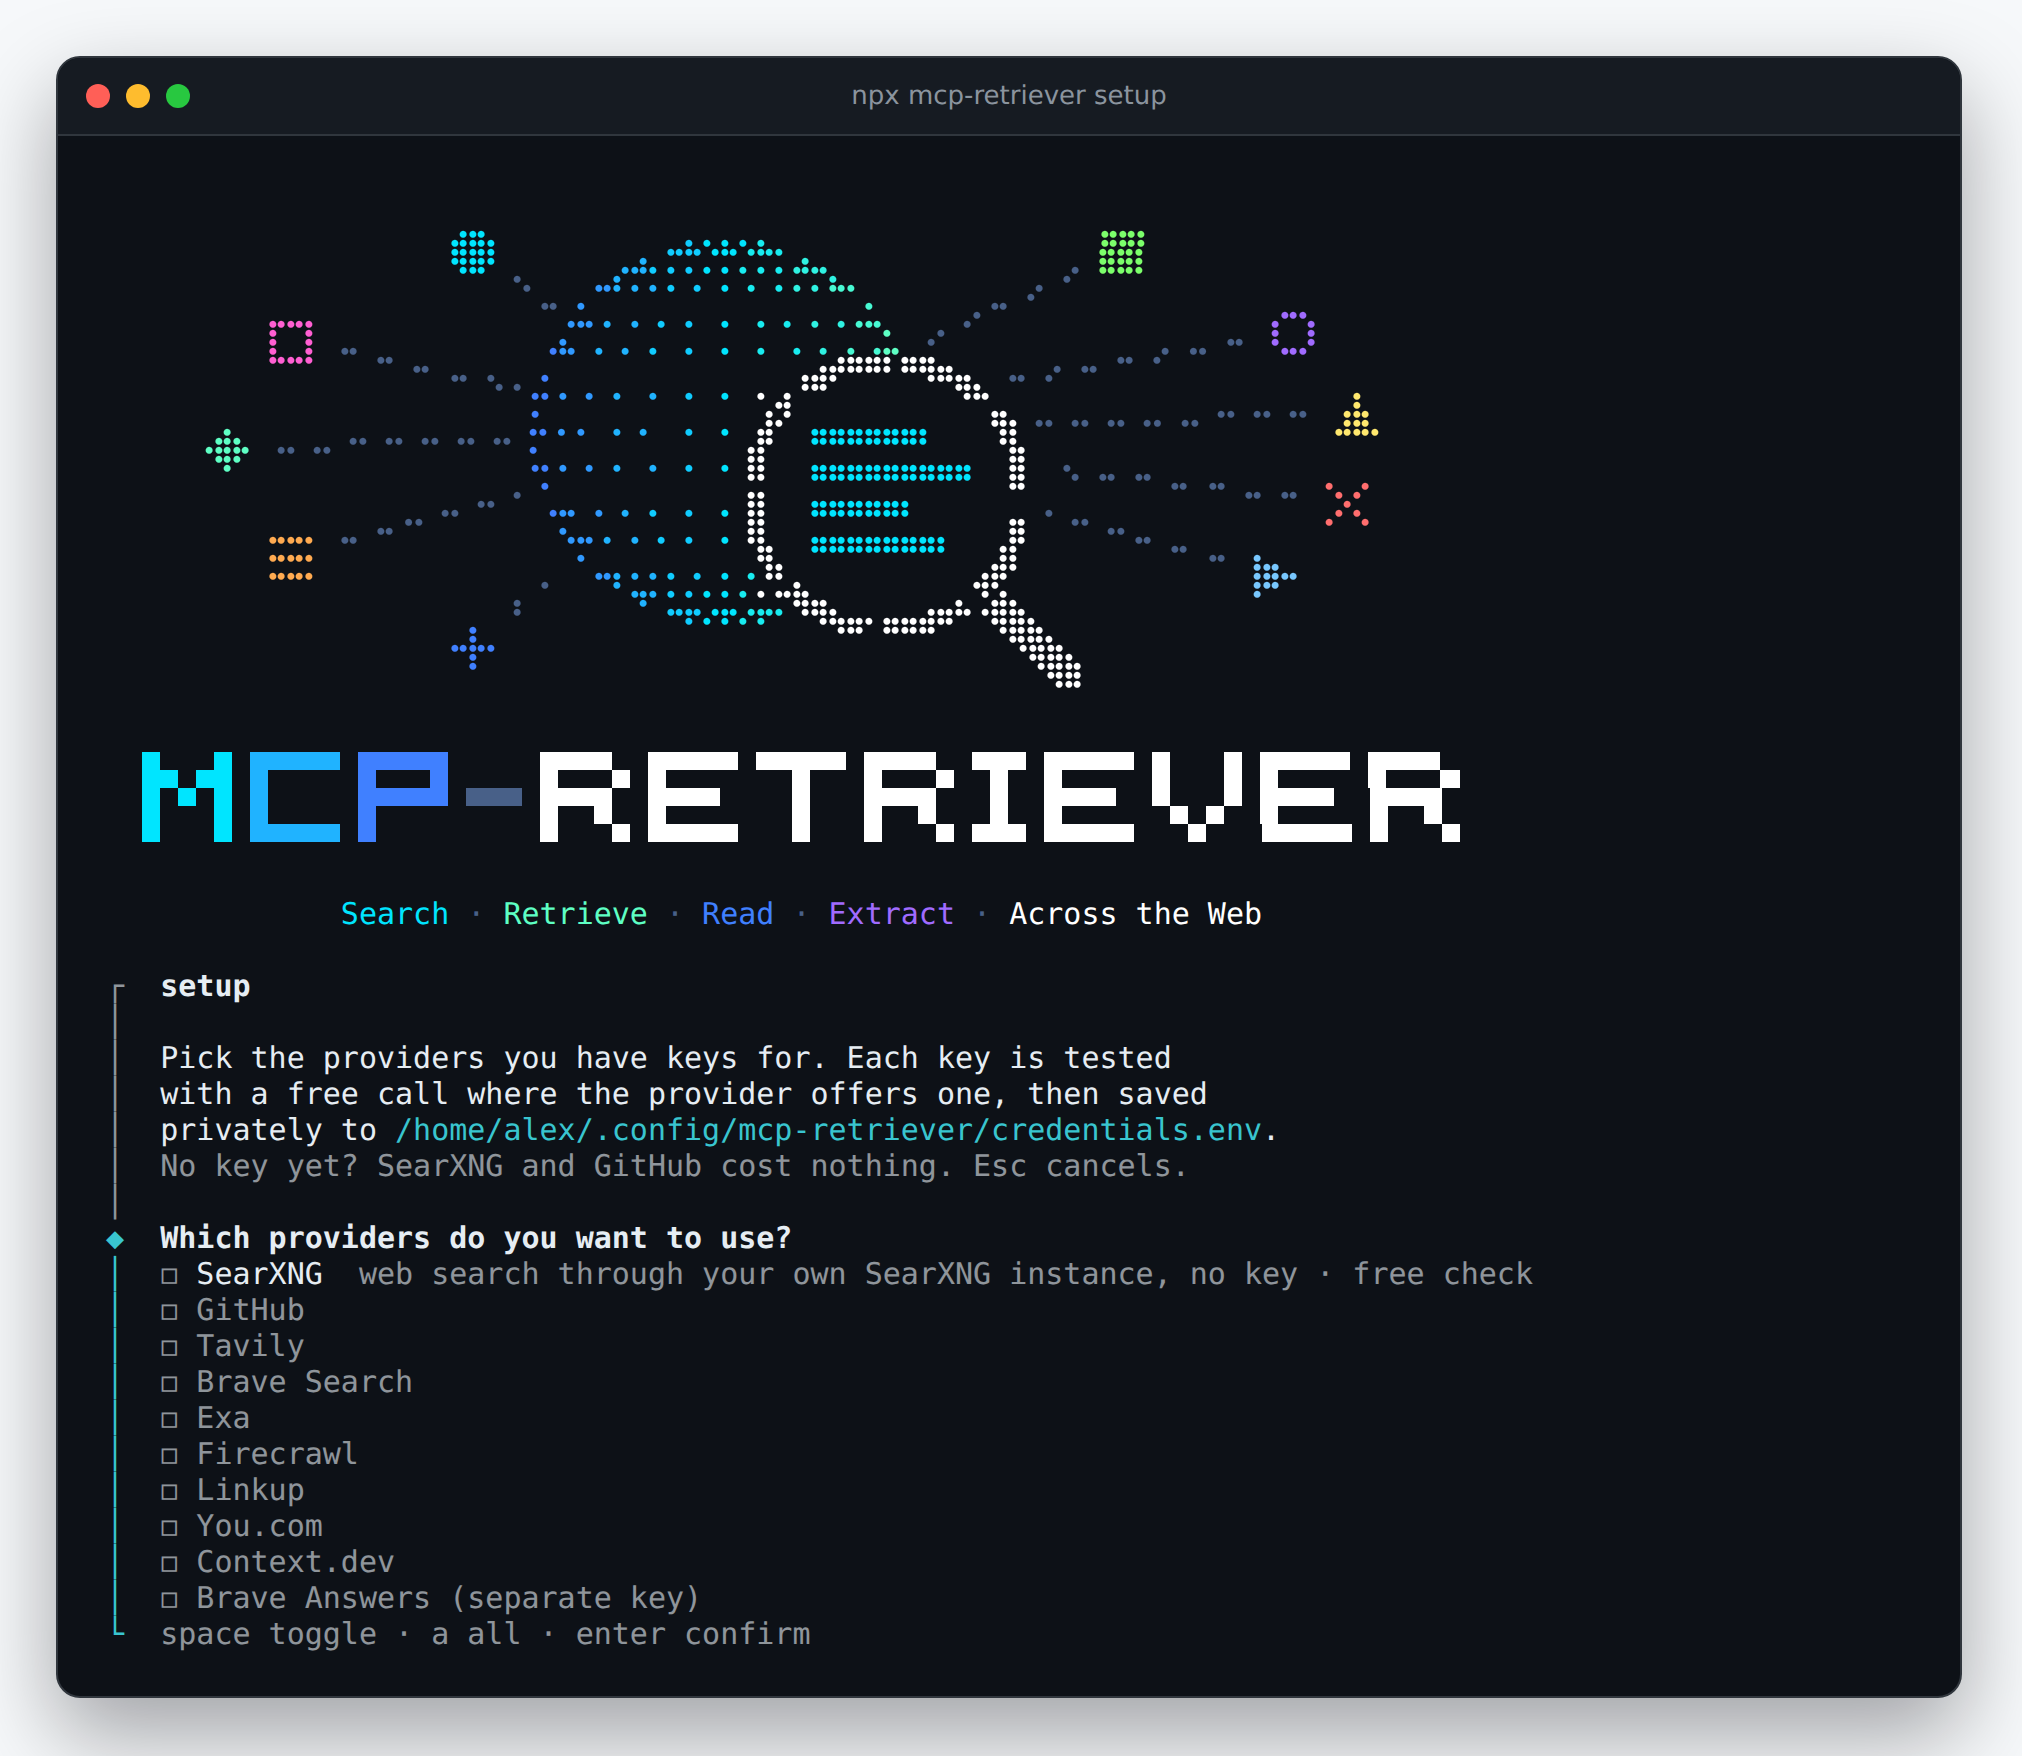
キーはクライアント設定ではなく、~/.config/mcp-retriever/credentials.env に保存されます。
セットアップ後にクライアントを再起動してください。
クライアントの接続とキーの管理
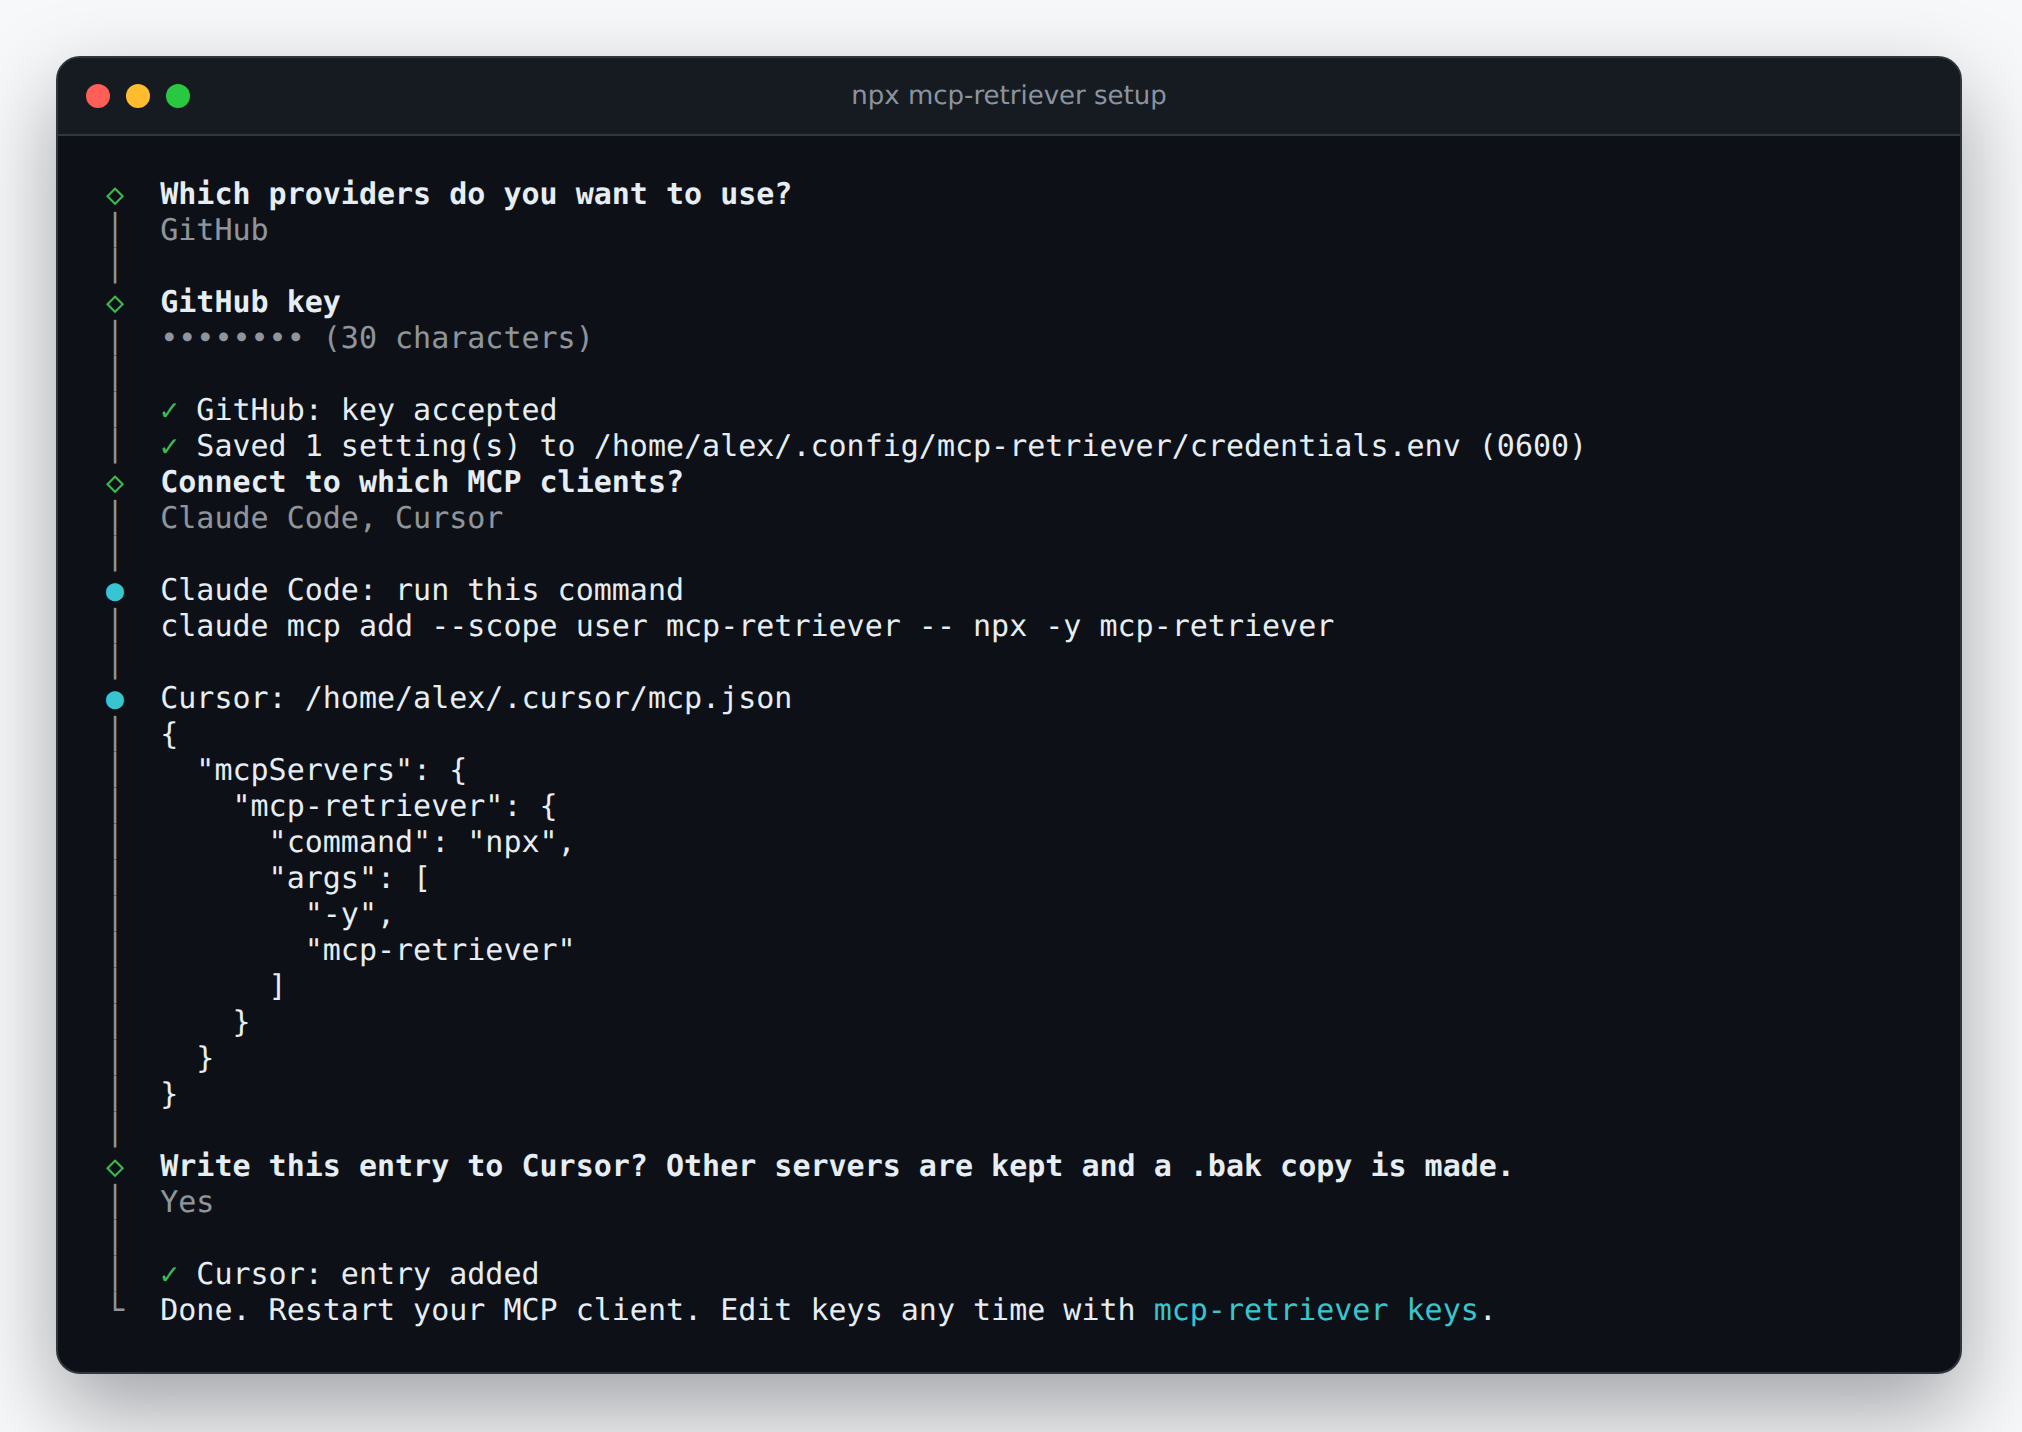
キーの追加、テスト、削除:
npx mcp-retriever keys
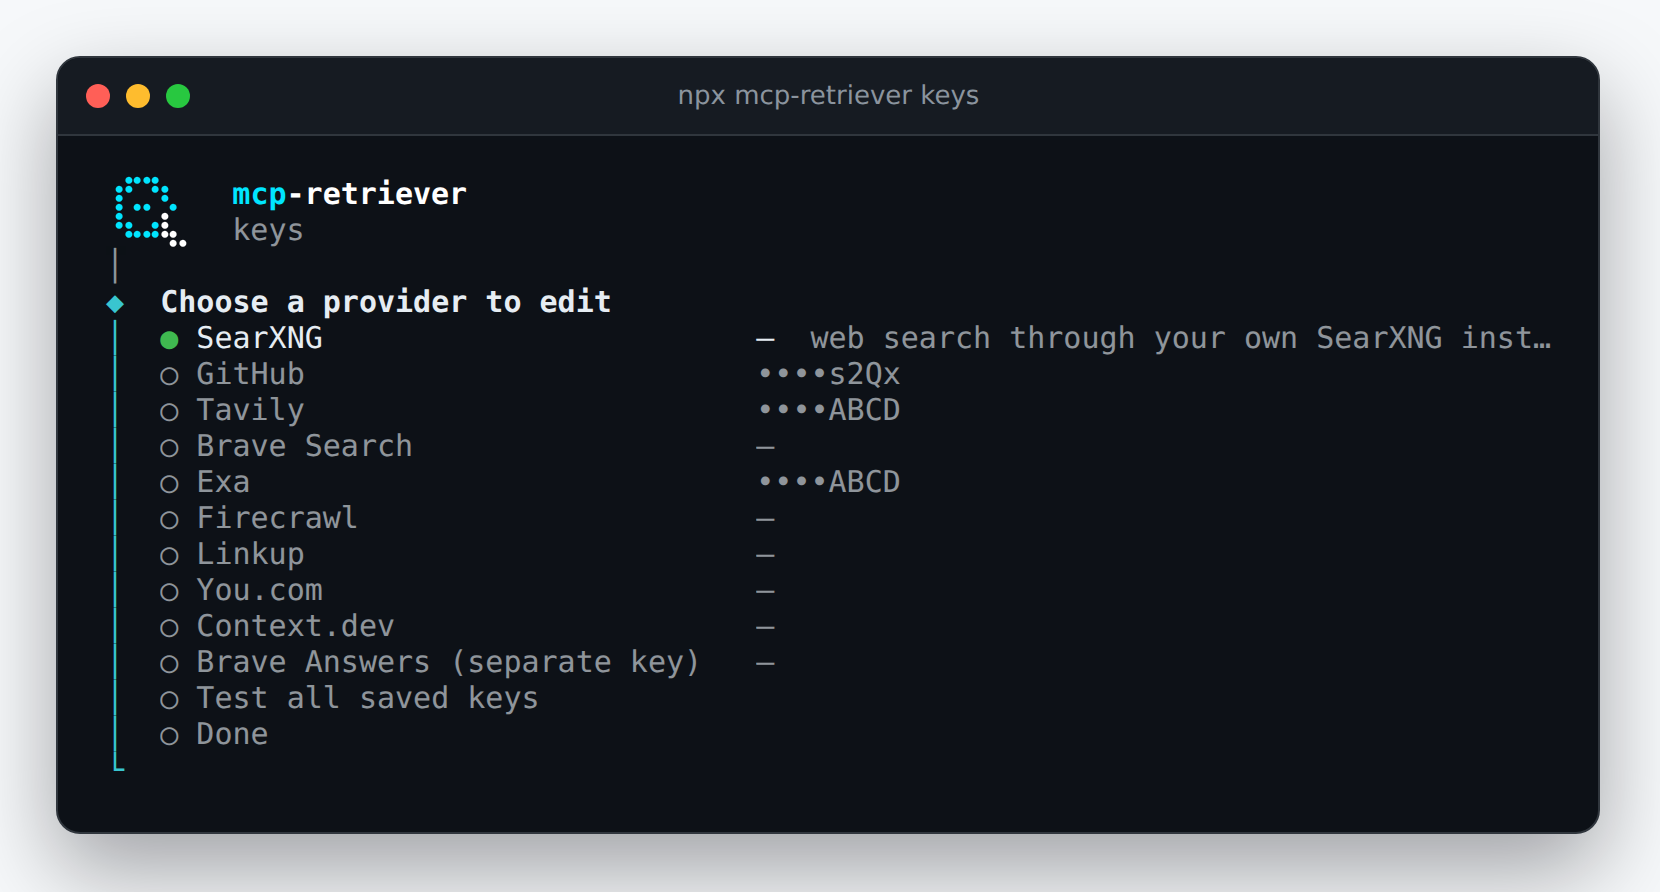
スクリーンショットは、フィクスチャの認証情報とモックされたキー確認応答を使ったデモセッションを示しており、 プロバイダーに対する実際の検証ではありません。
使用例
設定済みの検索プロバイダーを 2 つ指定して、web_search_fused を呼び出します。
{
	"query": "reciprocal rank fusion hybrid search",
	"providers": ["brave", "exa"],
	"limit": 3
}
結果には、ソースとなるプロバイダーと統合されたランキングが含まれます。プロバイダーに障害が発生した場合は、 利用可能な結果がプロバイダーごとのステータスとともに返されます。
ドキュメント
- 設定: キー、クライアントの手動設定、プロバイダー、支出管理。
- 検索と読み取り: ページの取得と大量の結果の処理。
- ツールグループ: 公開する機能を選択します。
- デプロイ: リモート HTTP アクセスと運用。
- コントリビューション: ソースからビルドし、チェックを実行します。
各サーバーインスタンスは、1 つの信頼境界を共有します。相互に信頼されていないクライアント間で、 その結果ストアを使用しないでください。支出上限は、推定コストではなく プロバイダーが報告する使用量に基づきます。
ライセンスと由来
MIT。
以前は mcp-omnisearch という名前でした。Scott Spence の
mcp-omnisearch を引き継いだ、メンテナンス中のフォークです。
このフォークをアップグレードする際は、OMNISEARCH_* 設定を RETRIEVER_* に、
omnisearch:// リソースを retriever:// に、_meta.omnisearch を
_meta.retriever に変更してください。~/.cache/mcp-retriever/results に移行するときは、
古い結果ストアと支出台帳を保持してください。Docker/MCPO クライアントでは
/omnisearch も /retriever に変更する必要があります。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。