memtether について
memtetherは、複数のAIクライアントで共有するSQLiteベースのローカルメモリハブです。出典、二時点履歴、競合の審査、検証可能なハッシュ連鎖監査ログを扱い、検索機能とMCPサーバーも備えています。
主な機能
- 01クライアント間で共有するSQLiteメモリ
- 02出典管理とハッシュ連鎖監査
- 03過去の内容を保持する訂正
- 04二時点クエリと競合審査
- 05決定的検索とハイブリッド検索
活用シーン
- 01AIクライアント間でメモリを共有
- 02事実の出典と変更履歴を追跡
- 03過去に把握していた情報を照会
- 04競合するメモリを審査して訂正
MCP 対応
エージェントがメモリを検索・管理するためのMCPサーバーとツールを提供し、訂正、退役、タイムライン照会などを実行できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
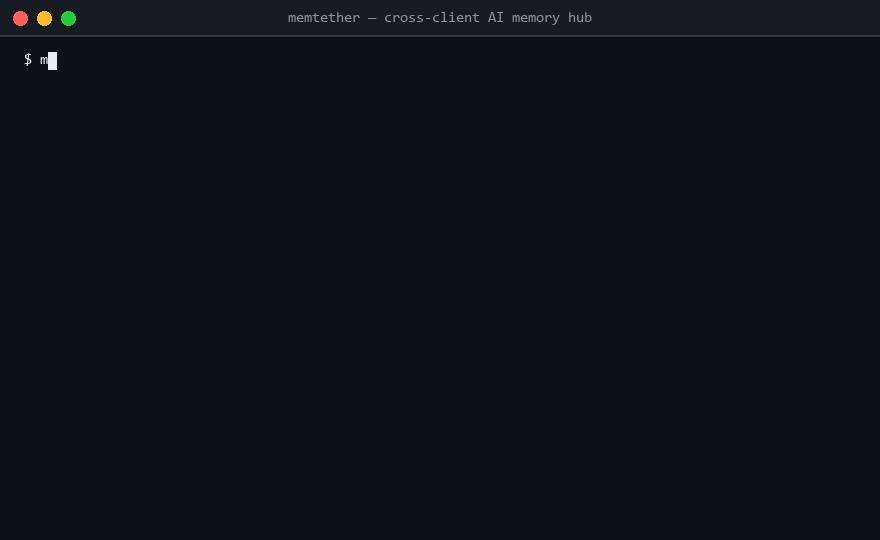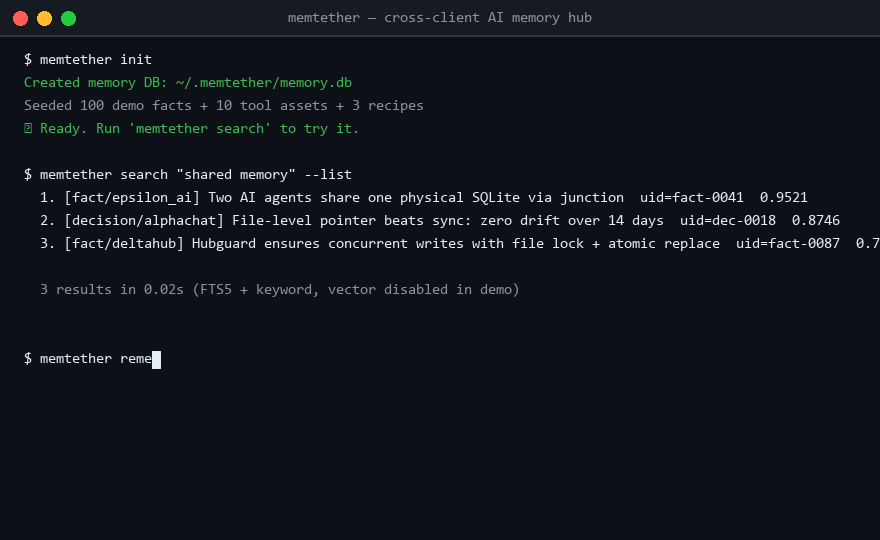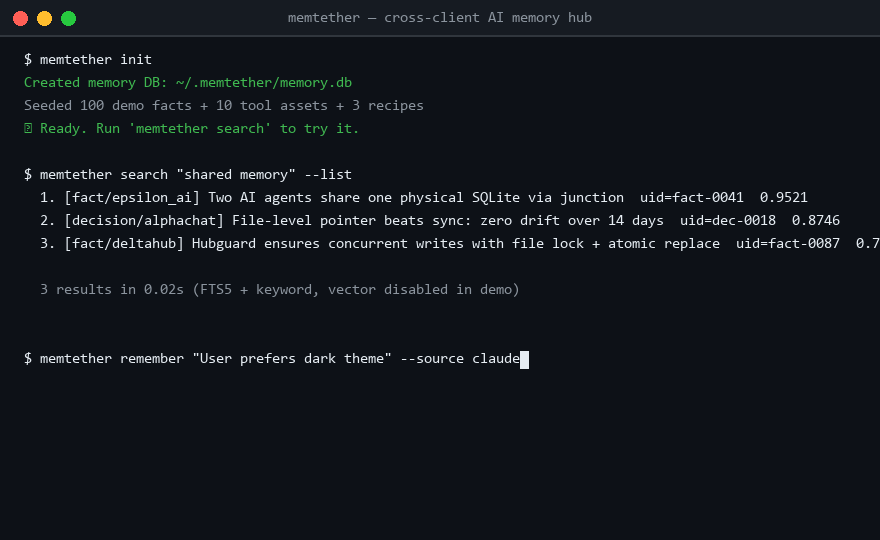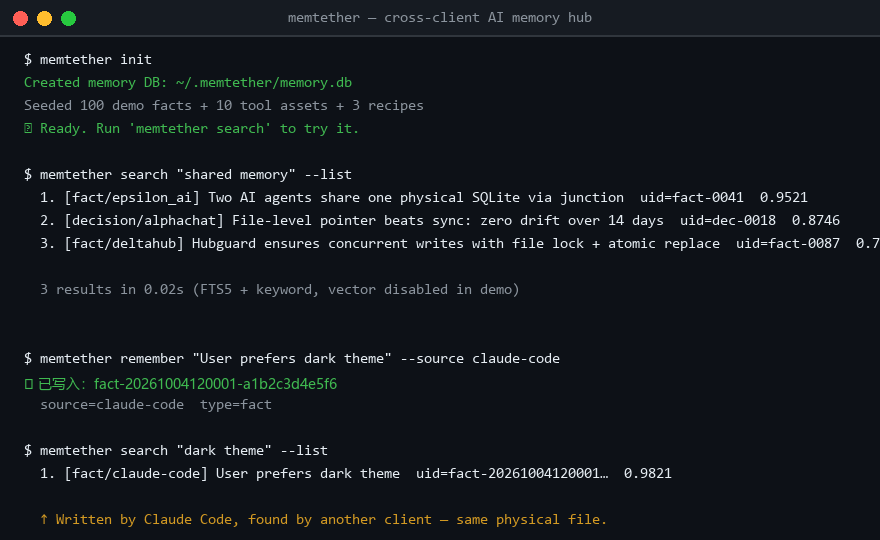
MemTether — AIメモリの監査役
エージェントは物事を記憶します。その記憶を誰が監査するのでしょうか?
MemTetherは、複数のクライアントで動作するAIエージェント向けの、ローカルファーストなメモリハブです。ほとんどのメモリシステムが検索精度を競うなか、MemTetherが重視するのはガバナンスです。各事実を書き込んだのは誰か、いつ有効になったのか、何に取って代わったのか、人間が裁定した競合はどれかを記録し、誰でも検証できる改ざん検知可能なハッシュチェーンを備えています。コードも依存関係も必要ありません。検索機能(SGMによる決定論的なSQLルーティング+ハイブリッド埋め込み)もありますが、これが主役ではありません。監査し、訂正し、信頼できるエージェントメモリこそが主役です。
mem0、Zep、またはLettaから移行しますか?examples/mem0_migration.pyでは、mem0のJSONエクスポートからの完全な往復移行を紹介しています。mem0 SDKは不要です。
$ memtether court fact-20261007-abc
+============================================================+
| MEMTETHER MEMORY COURT - CASE FILE                          |
| 1. CONTENT    Clash proxy port is 7897                      |
| 2. TEMPORAL   valid: 10-05 → present | known: 10-05 → now   |
| 3. PROVENANCE #1 remember by=codex → #2 correct by=user     |
| 4. CONFLICTS  case #3: vs fact-...old verdict=superseded    |
| 5. INTEGRITY  chain: PASS (3 anchors, 42 entries hashed)    |
+============================================================+
概要
- AIクライアント同士で情報を共有できませんか? エージェントはそれぞれ独自のメモリを保持します。MemTetherはファイルレベルのポインターを介して、クラウドも同期も使わずに、全員で共有する統制された頭脳を提供します。
- AIが書き込むべきでない情報を書いてしまいますか? すべてのメモリに、ソースの識別情報とハッシュチェーンによる監査証跡が付与されます。データベースが改ざんされるとチェーンがそれを検知します。
python examples/audit_chain_demo.pyを実行して、赤く表示される様子をご覧ください。 - AIが考えを変えましたか? 訂正によってデータが削除されることはありません。双時制の置換により、誰が・何を・いつ・なぜ変更したのかを永久に保持し、過去の任意の時点について照会できます。
自分で実行してみましょう:
$ python examples/audit_chain_demo.py
写入 25 条记忆(自动生成 2 个审计锚点)...
篡改前 verify_chain: PASS {'anchors': 2, 'entries_covered': 20}
模拟攻击者直接改库...
篡改后 verify_chain: FAIL {'reason': 'chain hash mismatch'}
✅ 哈希链成功检测到篡改!

> Note: ntries_covered: 20 with 25 writes is expected — the hash chain anchors every 10 audit entries, so the last 5 writes sit in the unanchored tail until the next batch. Tampering with an *anchored* entry is what turns verification red.
mem0からの移行
すでにmem0をお使いですか?examples/mem0_migration.pyでは、mem0のJSONエクスポート → MemTether Exchange v1 → ライブ検索 → mem0形式への復元という完全な往復処理を紹介しています。mem0 SDKは不要です。双時制フィールドには、temporal_source="backfilled"と正直に明記されます。
パフォーマンス(マイクロベンチマーク、n=200、ローカルSQLite)
| 操作 | p50 | p95 | p99 |
|---|---|---|---|
| remember(挿入) | 28.7ms | 34.6ms | 117.8ms |
| search(SGMエンティティ) | 33.1ms | 39.5ms | 41.6ms |
| search(キーワード) | 32.2ms | 35.0ms | 135.0ms |
| correct(置換) | 50.8ms | 54.7ms | 54.7ms |
再現方法:python _dev/benchmarks/bench_latency.py --n 200
ドキュメント
内部では、置換チェーン(訂正によってデータが削除されることはありません)、双時制タイムスタンプ(事実が真実だった時点と、システムがそれを学習した時点)、人間が裁定する競合解決、およびEU AI Act第12条の記録保持要件を念頭に設計されたハッシュチェーン監査ログを備えています(適合性は認証されていません)。
物理的なSQLiteデータベースは1つだけで、ファイルレベルのポインターを介してすべてのAIクライアントで共有されます。クラウドなし。API料金なし。同期デーモンなし。検索可能で、Gitで管理でき、あなたのものです。そして監査可能です。
mem0(66.6K★)、Zep/Graphiti(31.5K★)、agentmemory(29.2K★)と比較すると、これらのシステムは古い値を上書きするか削除します。MemTetherの置換チェーンは、ソースの帰属情報とQ値ランキングを含め、完全な履歴を保持します。 EAF検索:LongMemEval 500Qで厳密一致率75.7%(対応ありの差分+19.4ポイント、McNemar検定 p=7.8e-7)。
MemTether の比較
| MemTether | memora (731★) | memtrace (486★) | icarus (290★) | mem0 (66K★) | |
|---|---|---|---|---|---|
| 置き換えチェーン(訂正しても削除されない) | ✅ 強制 | ❌ | ❌ | ✅ | ❌ 上書き |
| 証拠チェーン(改ざんを検出可能、ブラウザーで検証可能) | ✅ court CLI + zip | ❌ | ❌ | ❌ | ❌ |
| 人間による競合の裁定(判断を記録) | ✅ conflicts CLI | ❌ | ❌ | ❌ | ❌ |
| 二時点管理(valid_from ≠ recorded_at) | ✅ ファクト行を100%網羅 | ❌ | ✅ ナレッジグラフのエッジで対応(ファクトごとの行ではない) | ❌ | ❌ |
| ソースの帰属(誰が書いたかを強制) | ✅ レジストリ + 拒否 | ❌ | ❌ | ✅ プロベナンス | ❌ |
| 二時点管理(ファクトごとの行) | ✅ | ❌ | ❌ | ❌ | ✅ グラフのエッジのみ |
| 競合検出(ルールベース + 人間によるレビュー) | ✅ 候補生成ツール | ❌ | ❌ | ❌ | ❌ |
| MCP サーバー | ✅ | ✅ | ✅ | ❌ | ✅ |
| 23以上のクライアントアダプター | ✅ 自動検出 | ❌ | ❌ | ❌ | ❌ |
| 評価の完全性フレームワーク | ✅ 5パターン | ❌ | ❌ | ❌ | ❌ |
| CI:9ジョブ / 567テスト | ✅ | ? | ? | ? | ✅ |
| 言語 | Python | ? | Rust | ? | Python |
「各セルは、2026-10-07時点でプロジェクトの公開ドキュメントに記載された機能の有無を示しています。MemTether の差別化要因は、単一の機能ではなく、すべてのガバナンス要件をローカルファーストのデプロイで組み合わせていることです。」
成果物バンドルには、質問ごとの記録が含まれています。


mcp-name: io.github.lanbass869-cell/memtether

インストール · 使い方 · MemTether を選ぶ理由 · ベンチマーク · アーキテクチャ · セキュリティ · よくある質問
- MemTether の再現 - すべての主張をコマンドで検証できます
- 創設メンバー10名チャレンジ - 10枠、14日間、結果を正直に公開
- ドキュメント(中国語) - 中国語の再現方法 / チャレンジ
クイックスタート
pip install memtether -i https://pypi.org/simple/
memtether init    # creates DB + connects all detected AI clients
これだけです。MemTether は、お使いのマシン上の Claude Code、Cursor、Windsurf、Codex、Gemini CLI など、さらに18のクライアントを検出し、MCP 設定を書き込んで検証します。
中国のユーザー向け:
pip install memtetherがNo matching distributionで失敗する場合、清華大学のミラーが PyPI の更新に追いついていない可能性があります。次を使用してください:pip install memtether -i https://pypi.org/simple/
その他のインストール方法
# One client at a time
memtether setup claude-code
memtether setup cursor
memtether setup gemini-cli    # run `memtether setup list` for all 23

# With semantic search (local embedding, no cloud):
pip install "memtether[vector]"          # 1. deps (chromadb, onnxruntime)
memtether download-models                # 2. weights (bge-m3-int8 ~560MB, or --profile bge-small-zh ~46MB)
python -m memsearch --rebuild            # 3. build the vector index
# Skip any of these and search gracefully degrades to keyword + BM25.

# With REST API server + web dashboard
pip install "memtether[server]"
memtether dashboard

# Docker
docker-compose up

> **Security note**: the REST API is unauthenticated unless you set MEMTETHER_API_KEY. Only expose port 8080 to trusted networks — on a shared machine, set the key in .env before docker-compose up.
> **`memtether init` caveat**: auto-detection works for clients in standard install paths. Clients in custom locations may be missed or falsely reported — use `memtether connect verify` to confirm, and see docs/ADAPTERS.md for manual MCP config.
MemTether を選ぶ理由
他のどのメモリシステムにもない機能:訂正しても削除されない
# Monday: Claude Code writes
$ memtether remember "Deploy to port 8080" --source claude-code

# Wednesday: you correct it via Cursor
$ memtether correct fact-xxx "Deploy to port 9090" --reason "port changed"

# Friday: another agent searches
$ memtether search "deploy port" --list
  1. [fact] Deploy to port 9090 (active)          ← current truth
     Old "port 8080" is superseded, not deleted.
     Full chain: memtether timeline fact-xxx
すべてのメモリには、valid_from / valid_to(業務時間)と recorded_at / invalidated_at(システム時間)があります。「火曜日の時点で、システムは何を把握していたか」をクエリできます。
他との違い
| MemTether | engram | mem0 | agent-memory | |
|---|---|---|---|---|
| ストレージ | ファイルポインター経由のSQLite | SQLite(Goバイナリ) | クラウドAPI | Markdownファイル |
| 新しい事実による置き換え | ✅ 二時点管理、削除しない | ❌ | ⚠️ 部分対応 | ✅ |
| 出典の帰属 | ✅ すべての事実にタグ付け | ❌ | ❌ | ❌ |
| Q値フィードバック | ✅ 使用された記憶の順位が上がる | ❌ | ❌ | ❌ |
| 汚染対策 | ✅ OWASP LLM01/02/06 | ❌ | ⚠️ 忠実性チェック | ❌ |
| クライアント間の連携 | ✅ ファイルレベルのポインター(23個のアダプター) | ✅ MCP | ✅ API | ✅ CLI |
| クラウド必須 | ❌ | 任意 | ✅ | ❌ |
cognee / zep / letta との機能比較
| 機能 | MemTether | cognee | zep | letta | Engram* |
|---|---|---|---|---|---|
| ローカル優先 | ✅ | ❌ | ❌ | ⚠️ セルフホスト可能 | ✅ |
| 設定不要 | ✅ | ❌(Neo4j) | ❌(Docker) | ⚠️ | ✅ |
| 単一ファイルDB | ✅ | ❌ | ❌ | ❌ | ✅ |
| REST API | ✅(14エンドポイント) | ✅ | ✅ | ✅ | ❌ |
| MCP サーバー | ✅ | ❌ | ✅ | ✅ | ❌ |
| Webダッシュボード | ✅ | ❌ | ✅ | ✅ | ❌ |
| 置き換えチェーン | ✅ | ❌ | ❌ | ⚠️ | ❌ |
| 二時点管理 | ✅ | ❌ | ❌ | ❌ | ✅ |
| 出典の帰属 | ✅ | ❌ | ⚠️ | ❌ | ❌ |
| Q値による順位付け | ✅ | ❌ | ❌ | ❌ | ❌ |
| 汚染対策 | ✅ | ❌ | ❌ | ❌ | ❌ |
| Markdownとしてエクスポート | ✅ | ❌ | ❌ | ❌ | ✅ |
| クライアントアダプター23個 | ✅ | ❌ | ❌ | ❌ | ❌ |
| ガバナンスレイヤー | ✅ | ❌ | ⚠️ | ❌ | ❌ |
アーキテクチャ
Claude Code ────┐                  ┌──── Cursor
                │   symlink /      │
Codex ──────────┤   junction       ├──── Windsurf
                │                  │
Gemini CLI ─────┤                  ├─── WorkBuddy
                └───────┬──────────┘
                        │
                        ▼
              ┌──────────────────┐
              │   memory.db      │  ← One physical SQLite
              │   (WAL mode)     │
              ├──────────────────┤
              │ FTS5 trigram     │  ← BM25 full-text
              │ ChromaDB + bge-m3│  ← Semantic (optional)
              │ RRF fusion       │  ← Multi-path merge
              │ 4-factor rerank  │  ← Z-score + sigmoid
              │ Supersession     │  ← Never delete
              │ Bi-temporal      │  ← T-axis + T'-axis
              │ Q-Value          │  ← Usage-based ranking
              │ Hubguard         │  ← Concurrent write lock
              │ Poisoning guard  │  ← OWASP LLM defense
              └──────────────────┘
技術的な詳細
| コンポーネント | 技術 | 目的 |
|---|---|---|
| データベース | SQLite(WALモード) | 単一ファイル、設定不要、クロスプラットフォーム |
| 全文検索 | FTS5 trigram + トリガー | O(1) BM25検索、SQLレベルでの同期 |
| ベクトル | ChromaDB + bge-m3(1024次元) | セマンティック検索、ローカル埋め込み |
| 融合 | Reciprocal Rank Fusion(K=60) | 複数経路の検索結果を統合 |
| 再ランキング | 4要素(sem .45 + rec .25 + freq .05 + imp .10) | Zスコア + シグモイド |
| ガバナンス | 置き換え + 二時点管理 + 矛盾検出 | 削除しない |
| 並行処理 | Hubguard(ファイルロック + アトミック書き込み) | プロセス間で安全 |
| セキュリティ | memtether_guard(OWASP LLM01/02/06) | 汚染対策 |
| API | FastAPI REST(14エンドポイント)+ MCP サーバー(10ツール) | あらゆる言語に対応 |
| パッケージング | PyPI + Docker + 23個のクライアントアダプター | pip install memtether |
クライアントを接続する
# All detected clients (recommended)
memtether init

# One at a time
memtether setup claude-code
memtether setup cursor
memtether setup windsurf
memtether setup codex
対応クライアント(23): Claude Code、Claude Desktop、Cursor、Windsurf、VS Code、Zed、JetBrains、Cline、Roo Code、Kilo Code、Continue、Cody、Amazon Q、Gemini CLI、Neovim、Codex CLI、WorkBuddy(CN + Intl)、CodeBuddy、ZCode、DSH、OpenClaw、Agents-Neutral
メモリー操作
memtether remember "User prefers dark theme" --source claude-code
memtether search "theme" --layer L0    # First sentence only
memtether search "theme" --layer L1    # First 3 sentences
memtether search "theme"               # Full content (L2, default)
memtether profile --subject user       # What we know about this user
memtether correct <uid> "Updated"      # Supersede, never delete
memtether retire <uid> --reason "..."  # Retire (content preserved)
memtether provenance <uid>             # Full audit trail for one fact
memtether conflicts --stats            # Review conflict candidates
memtether court --verify               # Verify the audit hash chain
memtether stats
memtether export-md --out ./backup     # Export as markdown
memtether backup                       # Point-in-time DB backup
memtether reconcile --dry-run          # SQLite <-> vector drift report
memtether import-docs ./docs           # Cold-start from a directory
memtether remember-batch mems.json     # Batch write from JSON
memtether demo                         # Generate a synthetic demo DB (no real data)
memtether dashboard                    # Web UI
すべてのサブコマンド(20個)は memtether --help で確認できます。
同じ操作は MCP 経由でも実行できます。AI エージェントからメモリーを直接管理できます:
# Via MCP: correct_memory / retire_memory / pin_memory / as_of_query / timeline / profile
# Your agent calls these tools — no CLI needed:

# Agent corrects a fact (supersedes old, creates new)
→ correct_memory(old_uid="fact-xxx", new_content="Deploy to 9090", reason="port changed")

# Agent queries what the system knew last Tuesday
→ as_of_query(at="2026-10-15", kind="known")

# Agent walks the full audit chain
→ timeline(uid="fact-xxx")

# Agent asks "what do we already know about this user?"
→ profile(subject="user")          # deterministic, no LLM, fully traceable
同じ操作は MCP(correct_memory、retire_memory、
pin_memory、as_of_query、timeline、profile)経由でも利用でき、エージェントは
CLI を使わずにメモリーを管理できます。
階層的な想起(L0 / L1 / L2)
検索のたびに、同じヒットを3つの深さで返せます。エージェントはまず低コストの 一行要約を確認し、実際に必要なヒットに限って全文を取得できます:
memtether search "deploy port" --layer L0   # first sentence only (~1 line)
memtether search "deploy port" --layer L1   # first 3 sentences
memtether search "deploy port"              # L2 = full text (default)
2,200件の事実を含む本番DBでの測定結果(limit=5):L0の文字数コストはL2の
10%、L1は**44%**です。この分割は純粋な決定論的関数であり、LLMも
ハルシネーションも発生しません。また、L2はレイヤー導入前の動作とバイト単位で
完全に一致します。
決定論的なユーザープロフィール
memtether profile --subject user           # human-readable
memtether profile --subject user --json    # machine-readable
1つの対象について判明している情報すべてを集約します(種類/出典ごとの件数、期間、
信頼度の高い事実、システムプロンプトにそのまま貼り付けられるL0ダイジェスト)。
supermemoryのget_profileやhonchoのget_representationとは異なり、これは
LLMの呼び出しを一切行いません。同じDBからは常に同じプロフィールが生成され、
各行はuidまでたどれます。
memtether export-md --out ./backup     # Export as markdown
memtether dashboard                    # Web UI
ベンチマーク
LongMemEval(500 問、全件実行、2026-10-02)
| 指標 | スコア | 備考 |
|---|---|---|
| 厳密一致(全体) | 62.6% | 209/334(該当するもの) |
| LLM 判定(全体) | 55.7% | 264/474 |
| 複数セッションの厳密一致 | 48.8% | 39/80 |
| 複数セッションの LLM 判定 | 60.0% | 72/120 |
| EAF | 75.7% | 253/334 — 複数セッション 32.5%→60.0% |
| 種類 | n | 厳密一致 | LLM 判定 |
|---|---|---|---|
| knowledge-update | 78 | 76.6% | 62.5% |
| multi-session | 133 | 48.8% | 60.0% |
| single-session-assistant | 56 | 40.4% | 41.1% |
| single-session-preference | 30 | N/A | 43.3% |
| single-session-user | 70 | 86.4% | 85.7% |
| temporal-reasoning | 133 | 60.7% | 40.5% |
結果は独自のハーネスを使用しています。mem0 が報告した数値と直接比較することはできません。
LoCoMo(1986 問、MemEval ハーネスによる全件実行、2026-10-14)
| システム | Token F1(LoCoMo) |
|---|---|
| PropMem | 0.605 |
| OpenClaw | 0.557 |
| Full Context | 0.542 |
| MemTether | 0.523 |
| Hindsight | 0.489 |
| Graphiti | 0.416 |
| Memory-R1 | 0.389 |
| SimpleMem | 0.358 |
| Mem0 | 0.344 |
| MemU | 0.299 |
MemTether は Token F1 で 10 件中 4 位です。Graphiti、mem0、SimpleMem、MemU、Hindsight を上回り、命題インデックス方式の PropMem とチャンク方式の OpenClaw に次ぐ結果です。
カテゴリ別のスコアは、マルチホップ 0.556、オープンドメイン 0.820、事実 0.357、時間 0.264、推論 0.206 です。再現するには、MemEval / LoCoMo ハーネス用の MemTether アダプターがこのリポジトリの scripts/bench_memtether_adapter.py に含まれています。公開済みの memtether パッケージをインポートし(ローカルパスの注入なし)、MemEval ハーネスとともに pip install memtether を実行するだけで利用できます。
テストスイート
| テスト | 結果 |
|---|---|
| pytest | 567 件成功、4 件スキップ(CI では tests/ ディレクトリ全体を実行) |
| hard_bench | 62/62 |
| e2e_verify | 13/13 |
| refuse_bench | 26/26(語形ゲート、09-25 キャリブレーション、既知の見落とし箇所:同一語形で属性が異なる場合) |
| check_packaging | ✅ |
セキュリティ
- ポイズニング対策:
memtether_guardがプロンプトインジェクション、コード実行、機密情報(OWASP LLM01/02/06)を検出。12 個のルール - 入力検証:コンテンツ ≤10K、タイプの許可リスト、ソース形式、信頼度の範囲、スコープの許可リスト
- スコープの分離:
shared/private/restricted - 並行処理:Hubguard のファイルロック + アトミック書き込み(WAL モード)
- SQL:すべてパラメーター化。f-string SQL は使用しません
なぜ単なる Markdown ファイルではだめなのでしょうか?
エージェントは Markdown を使った作業が得意で、memtether export-md を使えば Markdown にエクスポートできます。しかし、生の Markdown ファイルでは「誰が書いたのか、いつ有効だったのか、何に置き換わったのか」という問いに答えられず、ソースの帰属を強制したり、改ざんを検出したりすることもできません。
| プレーンな Markdown | MemTether | |
|---|---|---|
| この事実を書いたのは誰ですか? | ❌ 記録されない | ✅ ソース + タイムスタンプ |
| 何に置き換わりましたか? | ❌ 上書きされる | ✅ 置換履歴 |
| これは現在の真実ですか? | ❌ grep ではすべてのバージョンが返される | ✅ ステータス + valid_from/valid_to |
| 気づかれずに改ざんできますか? | ✅(保護なし) | ❌ ハッシュチェーンで検出 |
| 並行書き込みの安全性 | ❌ 最終書き込みが優先 | ✅ Hubguard のファイルロック |
| 検索 | grep(完全一致のみ) | SGM + ベクトル + BM25 + 再ランキング |
いつでも Markdown にエクスポートできます。ただし、ガバナンスされたデータベースを信頼できる唯一の情報源として維持してください。
既知の制限事項
tether_connect detectは、ソースが同じでパスが異なる構成を「未接続」と誤って報告する場合があります- DSH の高度なカスタマイズ(
cordis.patch.yml)は安全に書き換えられません。プレビューにはplanを使用してください - セマンティック検索にはオプションの依存関係(
chromadb、onnxruntime)が必要です。これらがない場合、キーワード検索に機能が低下します - Windows を優先しています。macOS/Linux でも動作するはずですが、十分にはテストされていません
- mem0/zep 用の交換アダプターは実験的なもので、対応するライブラリのインストールが必要です
REST API
memtether dashboard   # starts server + opens browser
# or: uvicorn api_server:app --port 8820
14 個のエンドポイント:/ /health /remember /search /stats /correct /retire /list /timeline/{uid} /absorb /qvalue /dashboard /court/verify /court/{uid}
コントリビューション
CONTRIBUTING.md をご覧ください。
ライセンス
MemTether が役に立ったら、GitHub で ⭐ を付けてください — ほかのエージェントが見つけやすくなります。
トラブルシューティング
| 症状 | 対処方法 |
|---|---|
memtether init の後に no AI client detected と表示される | 標準以外のパスにあるクライアントでは、MCP の手動設定が必要です — docs/ADAPTERS.md をご覧ください |
書き込み中に database is locked と表示される | WAL モードがデフォルトです。長時間の読み取り処理がロックを保持している可能性があります — 5 秒後に再試行してください(busy_timeout は設定済みです) |
書き込み時に source not registered と表示される | オープンソースモードではフェイルオープンです。レジストリファイル(agents.json)で帰属を強制するには、クライアントを agents.json に追加するか、MEM_SOURCE_FALLBACK を設定してください |
embedding search failed の警告が表示される | オプションの chromadb/bge モデルがありません — pip install memtether[semantic] を実行してインストールするか、無視してください(キーワード検索へのフォールバックが機能します) |
| 手動編集後にメモリチェーンが FAIL になる | これは意図的な動作です。監査ハッシュチェーンがデータベースへの直接変更を検出します。バックアップから復元するか、memtether court <uid> を実行して確認してください |
ロードマップ
計画中の作業と明示的な非目標については、ROADMAP.md をご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。