Hybrid Recursive Ladder について
Hybrid Recursive Ladderは、長い時系列範囲を少ないソースリクエストで集計するクエリ計画ライブラリ、CLI、API、MCPサーバーです。カレンダー階層で範囲を分割して出力粒度を保ち、ソースデータとローカルにマテリアライズしたデータを組み合わせられます。
主な機能
- 01カレンダー階層による再帰的な範囲分割
- 02取得レベル別の連続セグメント統合
- 03区間集計の出力セグメントへの折り畳み
- 04カバレッジに基づくローカル優先読み込み
- 05ローカルデータの検証と修復
活用シーン
- 01バケット数に制限のあるAPIで長期間を集計
- 02細粒度ダッシュボードのリクエスト数を削減
- 03キャッシュ済みデータと未カバー範囲を組み合わせて取得
MCP 対応
オプションのMCPサーバーは、MCP対応クライアントに `ladder_meta`、`ladder_decompose`、`ladder_sum`、`ladder_verify` ツールを公開します。設定なしでデモデータを使って実行できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx hybrid-recursive-ladder-mcpHL_SOURCESource backend: demo (default), thingsboard, or postgres.HL_TB_URLThingsBoard base URL, for example http://localhost:9090.HL_TB_USERNAMEThingsBoard username; pair with HL_TB_PASSWORD.HL_TB_PASSWORDシークレットThingsBoard password.HL_TB_TOKENシークレットThingsBoard access token, used instead of username and password.HL_PG_DSNシークレットPostgreSQL DSN for the local materialized store.HL_TIMEZONEIANA timezone for calendar boundaries; default Asia/Shanghai.HL_FINESTFinest ladder level: minute, hour, day, or month.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
4掲載時のツール一覧 · 2 日前に更新
このツールにパラメーターはありません。
詳細
ハイブリッド再帰ラダー
バケット数に上限のある時系列 API 向けのクエリ計画。 バケットごとに数千件のクエリを実行する代わりに、少数のソースリクエストで長期間のデータを集計します。
言語: English · 简体中文 · 日本語 · 한국어 · Español · Français · Deutsch · Português · Русский · العربية · हिन्दी
アルゴリズム仕様 · API リファレンス · ベンチマーク · 関連研究 · 公開情報 · ドキュメント一覧


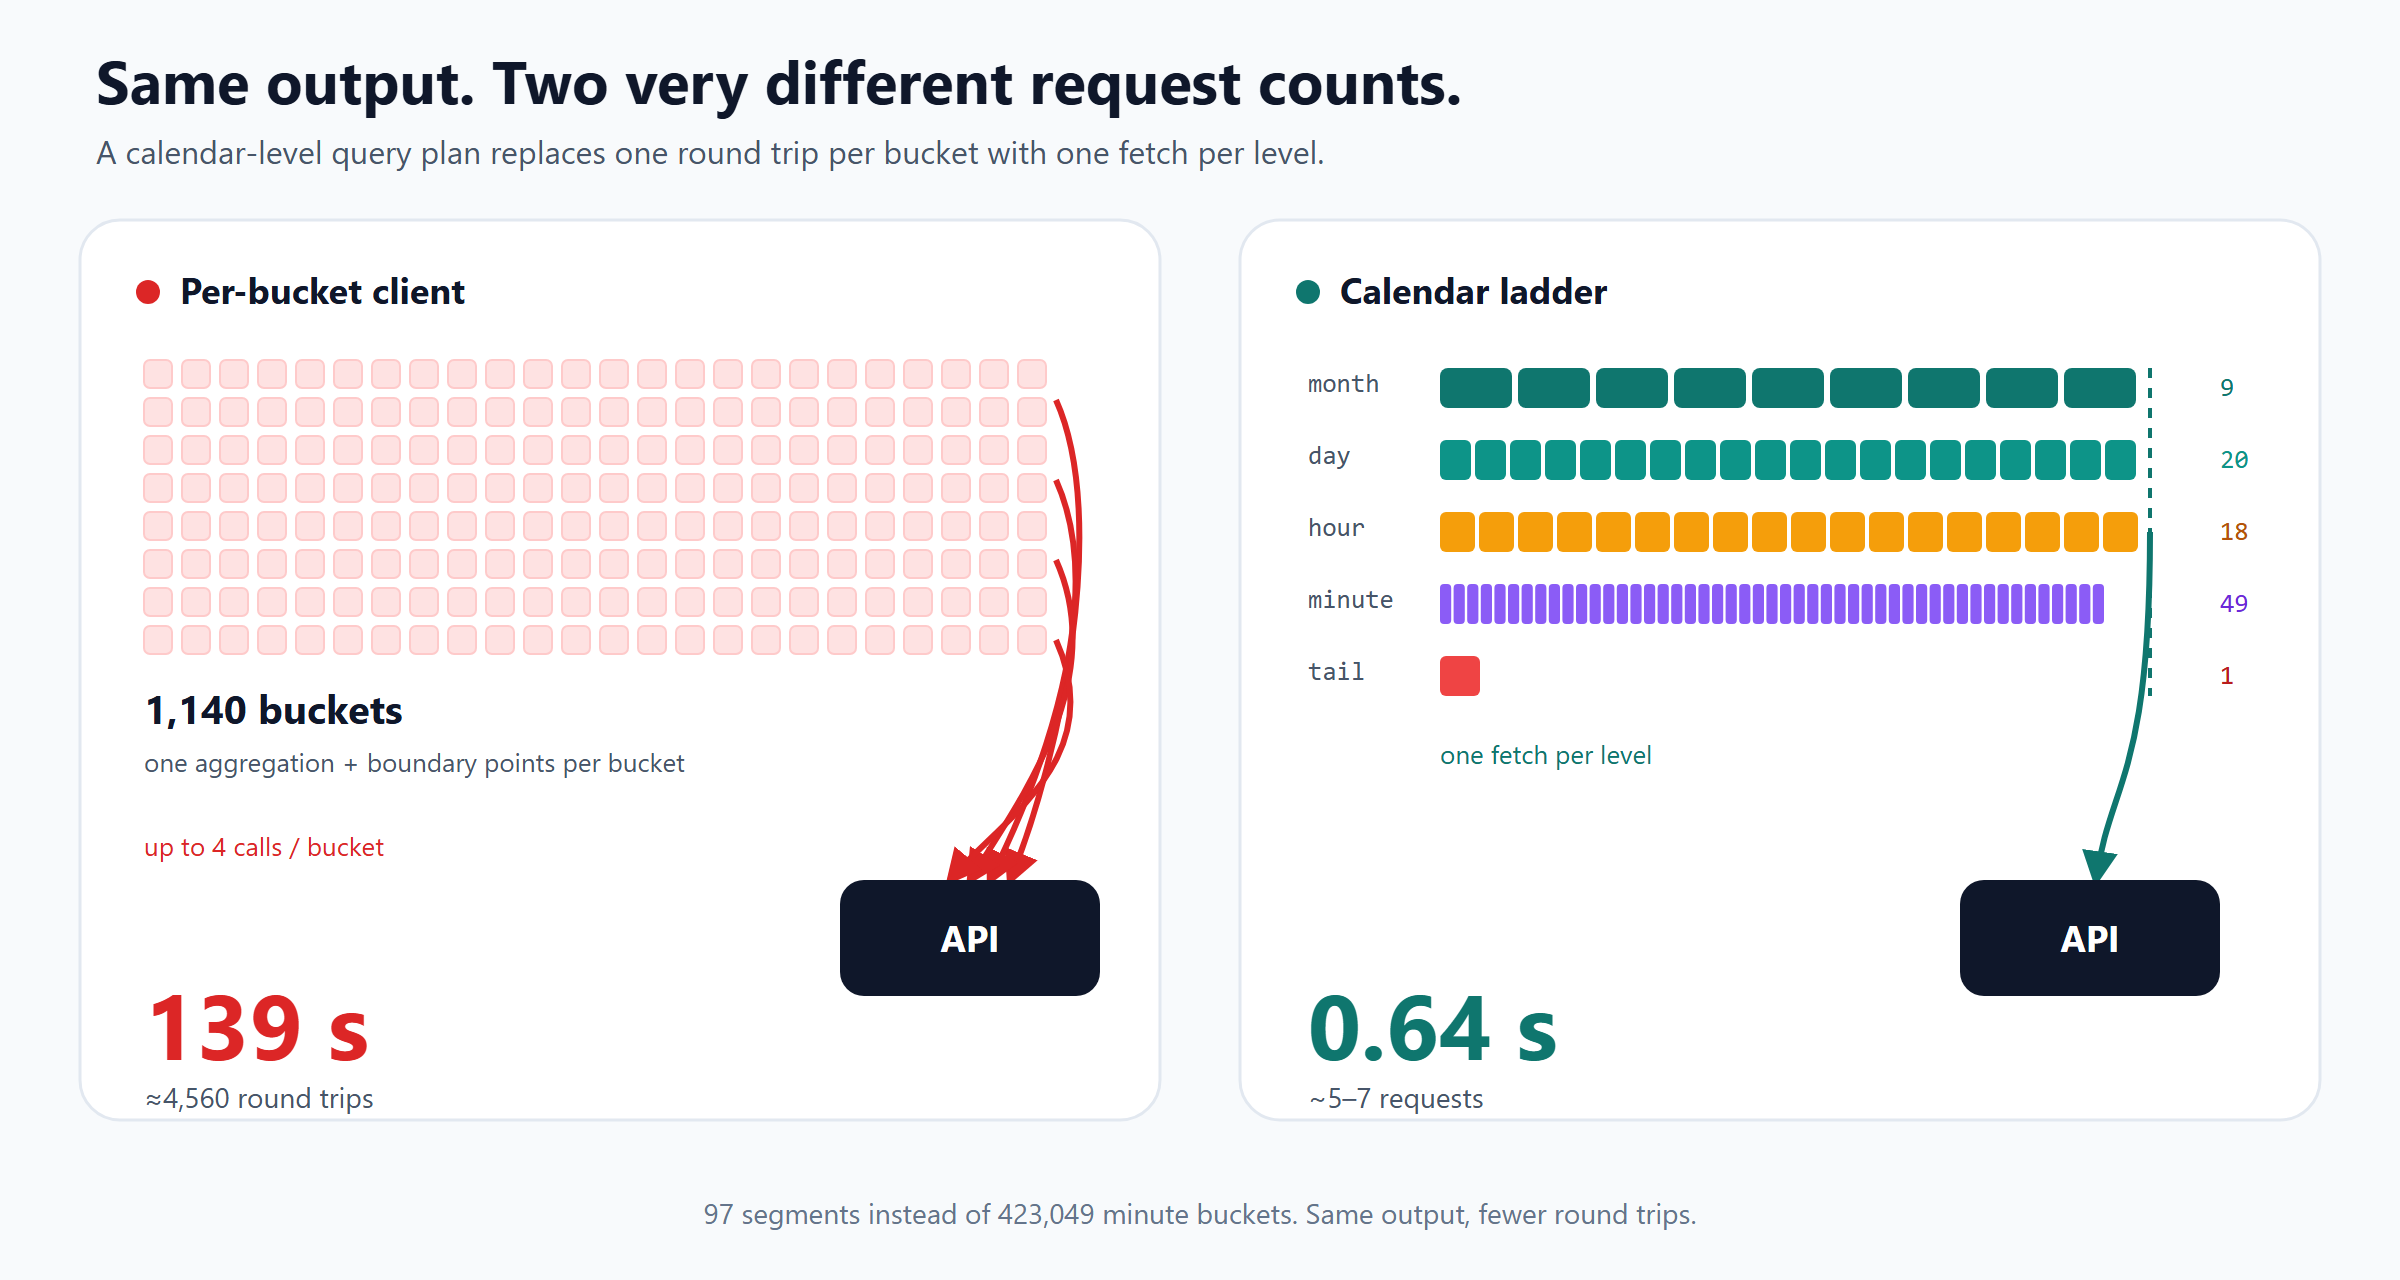
出力の粒度は同じです。バケットごとのクライアントは行ごとに 1 回のラウンドトリップが必要ですが、ラダーは各レベルを 1 回ずつ取得します。
## この仕組みがある理由ほとんどの時系列 API では、リクエストごと、バケットごと、または往復通信ごとに料金が発生します。単純に「統計バケットごとにクエリを 1 回送る」クライアントでは、2 日間の分単位の範囲が 2,880 個のバケットになり、それぞれに最大 4 回の HTTP 呼び出しが必要になります。本番環境の ThingsBoard デプロイメントでは、1,140 個のバケットを VPN 経由で処理するのに 139 秒かかりました。
ボトルネックは計算ではなく、ネットワークの往復回数です。
よくある 3 つの解決策はいずれも、何かを犠牲にします。
| 解決策 | 代償 |
|---|---|
| 粗い間隔を 1 つ指定する | ダッシュボードに必要な分単位または日単位の行が失われます |
| 事前に集計する(連続集計、ロールアップテーブル) | データソースへの書き込みアクセス、またはデータソースの制御が必要です |
| ページネーションする | ページ数は変わらず、境界ケースが増えます |
このラダーアルゴリズムは別の方法を取ります。**出力の粒度は維持しながら、出力単位ごとのリクエストをやめます。**連続した範囲の区間集計を返せるデータソースなら、1 回のリクエストで複数の出力セグメントを埋められます。
仕組み
- 分解 —
[start, end)を、月から設定された最細レベルまでの完全な暦単位に分解します。完全な単位だけを出力し、左右の部分的な端は次の細かいレベルに回します。 - グループ化 — 同じ取得レベルが必要な場合に限り、隣接するセグメントをまとめます。時間と分は分単位の連続範囲を共有できますが、月と日は共有できません。
- 取得 — 各最大連続範囲を、次に細かい集計単位で 1 回取得します。月は日単位、日は時間単位、時間は分単位、分は分単位です。
- 集約 — 返されたバケットをローカルで出力セグメントに集約します。
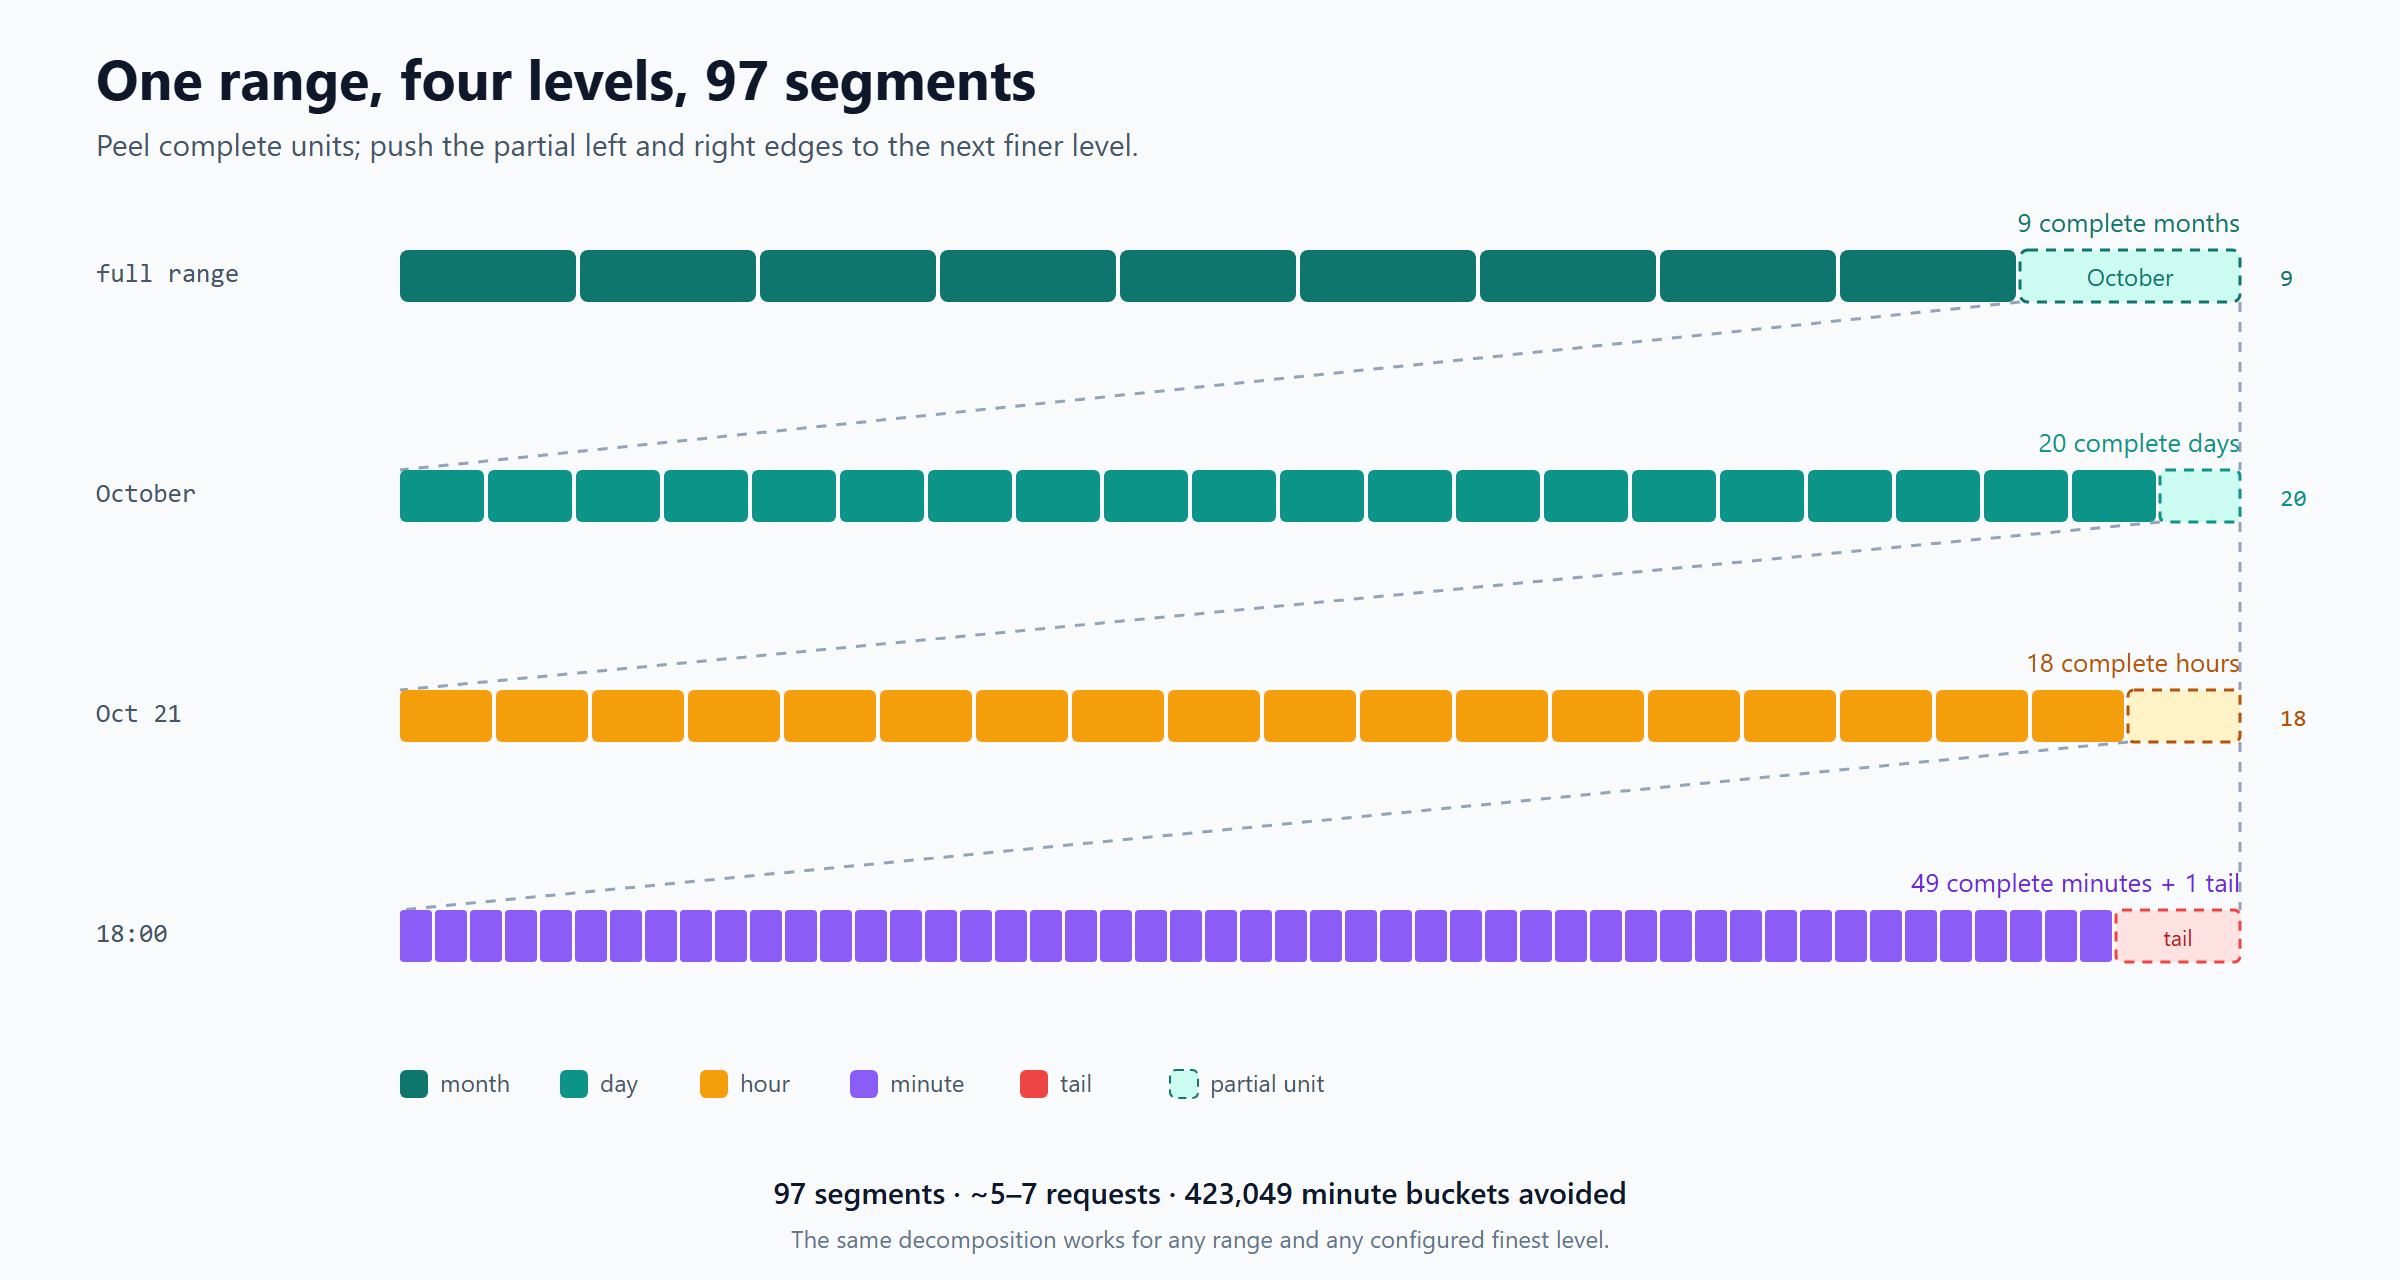
2026-01-01 00:00:00 → 2026-10-21 18:49:59 の場合、423,049 個の分単位バケットではなく、97 個のセグメントになります。一般的な 10 か月のクエリに必要な集計リクエストは、およそ 5~7 回です。
ルール
- 左閉右開 —
[start, end)。 - 完全な単位のみ — 月、日、時間、分は、そのレベルの範囲内に完全に収まる場合にのみ出力されます。
- 端の再帰処理 — 部分的な端は次に細かいレベルに回されます。1 分未満の端数は独立した末尾セグメントになります。
- ローカルカレンダー — 境界には設定された IANA タイムゾーンを使用します(デフォルトは
Asia/Shanghai)。 - タイル分割 — セグメントは順序どおりに並び、連続して重複せず、その和集合は厳密に
[start, end)になります。
リクエスト数の上限
バケットサイズが Δ で、1 リクエストあたり K 個のバケットを取得する、期間 T の取得範囲の場合:
requests(run) = ceil(T / (K * Δ))
細粒度の処理は、両端の 2 つの部分単位に限られます。デフォルトの階層では、N <= N_month + 639 で、再帰の深さは最大 4 です。リクエスト数は O(N_month / K + 1) であり、分単位バケット数ではなく、粗い単位の数に応じて増加します。形式的な命題は docs/algorithm.md の §5.3~5.5 にあります(中文)。
クイックスタート
pip install hybrid-recursive-ladder

hybrid-ladder demo
hybrid-ladder decompose --start 2026-01-01 --end 2026-10-21T18:49:59
デモでは 15 分間隔の合成データを作成し、120 日間の範囲を分解して、その半分を実体化したうえで、ローカル優先の混合クエリを実行し、合計が一致することを検証します。データベースもネットワークも設定も必要ありません。
任意の追加機能:
pip install "hybrid-recursive-ladder[thingsboard]"   # ThingsBoard source (httpx)
pip install "hybrid-recursive-ladder[postgres]"      # local store (psycopg 3)
pip install "hybrid-recursive-ladder[api]"           # FastAPI HTTP API
pip install "hybrid-recursive-ladder[mcp]"           # MCP server
pip install "hybrid-recursive-ladder[all]"           # everything
コアの分解処理には、サードパーティ依存関係がありません(Windows で信頼性の高い IANA タイムゾーンを使うための tzdata のみ必要です)。
使用方法
| 形式 | エントリーポイント | 最適な用途 |
|---|---|---|
| Python ライブラリ | from hybrid_ladder import ... | サービスやパイプラインへの組み込み |
| CLI | hybrid-ladder ... | 一時的な調査、スクリプト、cron |
| HTTP API | hybrid-ladder serve | 言語に依存しない統合、非同期タスク |
| MCP サーバー | hybrid-ladder mcp | AI エージェントとMCP互換クライアント |
| エージェントスキル | skills/hybrid-recursive-ladder/ | Claude/ZCode形式のスキルのインストール |
Python ライブラリ
from hybrid_ladder import LadderEngine, MemorySource

source = MemorySource()
source.add("device-1", "energy", [(ts, 1.0) for ts in range(0, 86_400_000, 60_000)])

engine = LadderEngine(source)
result = engine.sum([("device-1", "energy")], 0, 86_400_000)

print(result.grand_total)                 # 1440.0
print(result.rows[0].segments[0].label)   # 1970-01-01 00:00
print(result.rows[0].empty_count)         # 0
エンジンは2つの小さなプロトコルに依存します。TimeSeriesSource(interval_agg、
raw_series)とPointStore(sum_ranges、series、coverage、
upsert_points、...)です。組み込みの実装は、MemorySource/MemoryStore、
ThingsBoardSource、PostgresStoreです。別のソースを追加する方法については、
docs/architecture.md(中文)をご覧ください。
CLI
# Demo data
hybrid-ladder sum --series demo-chiller-1:energy --start 2026-01-01 --end 2026-02-01

# ThingsBoard, local-first
export HL_TB_URL=https://tb.example.com
export HL_TB_TOKEN=...
export HL_PG_DSN='postgresql://user:[email protected]:5432/telemetry'
hybrid-ladder sum --source thingsboard --series <device>:<key> \
  --start 2026-01-01 --end 2026-10-21T18:49:59 \
  --mode mixed --materialize

# Verify and repair the local copy
hybrid-ladder verify --source thingsboard --series <device>:<key> --start ... --end ...
hybrid-ladder repair --source thingsboard --series <device>:<key> --start ... --end ...
HTTP API
hybrid-ladder serve --port 8000
# OpenAPI docs: http://127.0.0.1:8000/docs
curl "http://127.0.0.1:8000/v1/decompose?start_ts=1767196800000&end_ts=1792512599000"

curl -X POST http://127.0.0.1:8000/v1/ladder/sum \
  -H 'content-type: application/json' \
  -d '{"series":[{"entity":"demo-chiller-1","key":"energy"}],
       "start_ts":1767196800000,"end_ts":1777564800000,"mode":"tb"}'
# → {"code":0,"data":{"task_id":"...","async":true}}

curl http://127.0.0.1:8000/v1/tasks/<task_id>
APIは成功時に{"code":0,"data":...}、エラー時に{"code":1,"detail":...}を返します。
すべてのエンドポイントについてはdocs/api.md(中文)をご覧ください。
MCP サーバー
pip install "hybrid-recursive-ladder[mcp]"
hybrid-ladder mcp
ツール:ladder_meta、ladder_decompose、ladder_sum、ladder_verify。設定なしの場合はデモデータを提供するため、エージェントはすぐに試すことができます。クライアント設定の例:
{
  "mcpServers": {
    "hybrid-ladder": {
      "command": "hybrid-ladder",
      "args": ["mcp"],
      "env": {
        "HL_SOURCE": "thingsboard",
        "HL_TB_URL": "https://tb.example.com",
        "HL_TB_TOKEN": "...",
        "HL_PG_DSN": "postgresql://..."
      }
    }
  }
}
エージェントスキル
skills/hybrid-recursive-ladder/を、エージェントのスキルディレクトリ(例:~/.claude/skills/または
~/.zcode/skills/)にコピーしてください。このスキルでは、ラダーを使うタイミング、CLI/APIの呼び出し方法、nullと0.0およびsourceの解釈方法をエージェントに教えます。
ローカル優先モード
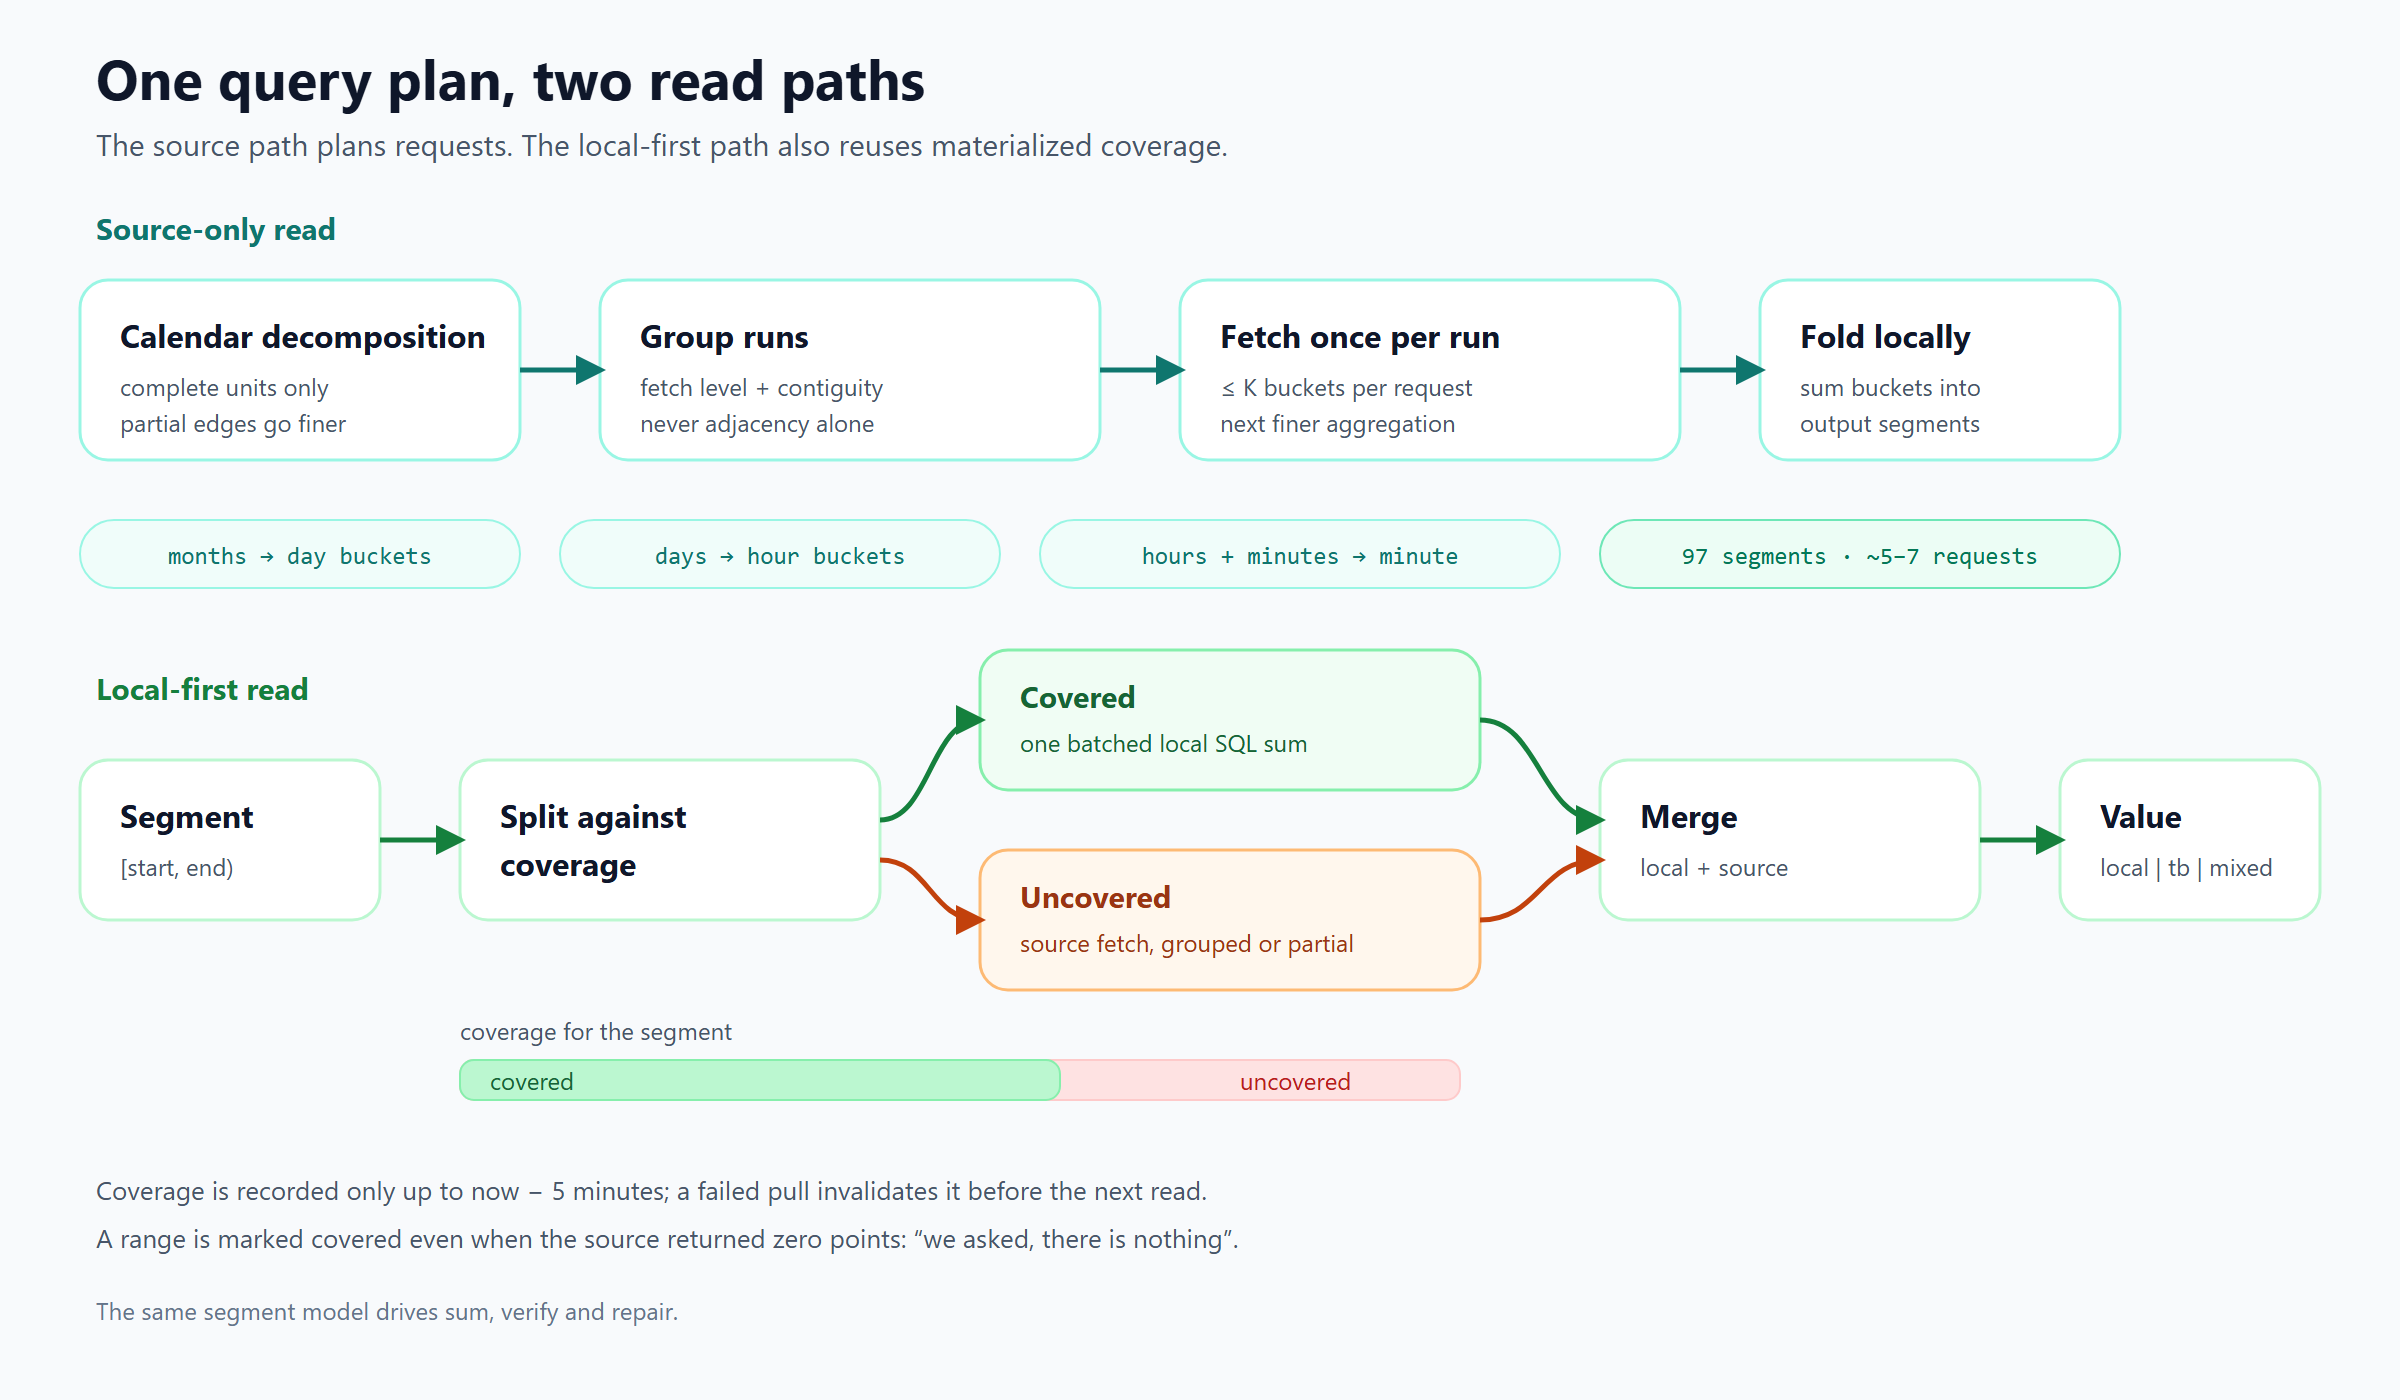
ローカルのポイントストアがある場合、同じセグメントをマテリアライズ済みのカバレッジに基づいて分割します。カバー済み部分は1回のバッチローカルクエリから取得し、未カバー部分はソースから取得します。一部がカバーされているセグメントでは、不足している範囲だけを取得します。
from hybrid_ladder import LadderEngine, MemoryStore
from hybrid_ladder.sources.thingsboard import ThingsBoardSource

source = ThingsBoardSource("https://thingsboard.example.com", token="...")
store = MemoryStore()               # or PostgresStore("postgresql://...")
engine = LadderEngine(source, store)

# Pull raw points once; coverage is recorded.
engine.materialize([("device-id", "energy")], start_ms, end_ms)

# Repeated queries read local data and fetch only uncovered sub-ranges.
result = engine.sum_mixed([("device-id", "energy")], start_ms, end_ms)
print(result.source, result.source_counts)   # "local" / "mixed" / "tb"
print(result.rows[0].tb_ranges)              # ranges still missing locally

# Compare with the source, then repair if needed.
report = engine.verify([("device-id", "energy")], start_ms, end_ms)
if report["diff_segments"]:
    engine.repair([("device-id", "energy")], start_ms, end_ms)
カバレッジはnow - 5 minutesまでしか記録されません。処理中の末尾部分は常に信頼対象外です。ソースからポイントが1つも返されなかった場合でも(「問い合わせた結果、データがなかった」)、範囲はカバー済みとして記録されます。書き換えの前にカバレッジはクリアされるため、プルに失敗しても、不完全なデータを示す古いカバレッジが残ることはありません。
検証では、ソース(正)とローカルストアをセグメントごとに比較し、差異のあるセグメントだけをポイント単位まで掘り下げて(added/removed/changed)確認します。修復ではローカルの範囲を削除し、トランザクションサイズのウィンドウ単位でソースから再取得した後、カバレッジを再記録します。
保証と制限
| 値 | 意味 | 表示形式 |
|---|---|---|
null | セグメント内にサンプルがありません | — |
0.0 | サンプルが存在し、合計がゼロです | 0 |
| number | サンプルの合計 | 数値 |
各セグメントには、cnt(観測されたポイント/バケット数)、expected(セグメントに含まれるはずのバケット数。ソースセグメントの場合)、source(local、tb、mixed、empty、uncovered)が含まれます。cnt が expected に比べて少ない場合、データは疎です。合計値の算術的な正確さは変わりませんが、より少ないポイントに基づいています。
保証
sumは正確です。すべてのセグメントの合計は、範囲内のソースポイントの合計と一致します。近似やサンプリングはありません。- セグメントは範囲を隙間なく分割します。長さゼロのセグメントはありません。
nullと0.0は、どこでも区別されます。- マテリアライズ処理は冪等です。実行が重なっても、タイムスタンプが重複することはありません。
- このアルゴリズムはソースの読み取りのみを行います。ThingsBoard への書き込みは一切行いません。
制限
- v0.0.6 では合計のみです。
avgにはsumとcountによる重み付けが必要で、meter_deltaには各セグメントの最初の値が必要です(ThingsBoard にはFIRSTがありません)。そのため、これらのルールはまだ対象になっていません。 - データの完全性と算術的な正確さは異なります。 サンプルが欠落すると、合計は実際の合計より低くなります。
cnt/expectedで欠落を把握できますが、補完は行いません。 - ThingsBoard の制限: 受け付けられるバケット数は約 700 個、800 個は拒否されます(ドキュメントにある 1000 個という値は信頼できません)。アダプターのデフォルトは 500 個です。生系列はリクエストあたり最大 10,000 ポイントです。同じ分内の重複ポイントは
COUNTによって集約されます。 - 再起動するとプロセス内タスクは失われます。結果は再計算可能で、マテリアライズ済みデータは失われません。
- DST ゾーン: カレンダー境界はサポートされていますが、ソースバケットは固定サイズです。そのため、日/時の折り返しは
Asia/Shanghaiなどの固定オフセットのゾーン向けに設計されています。DST の切り替わり前後では、hourまたはminuteで取得してください。
過去の修正とバージョンに関する注記は CHANGELOG.md にあります。
パフォーマンス
本番環境の ThingsBoard デプロイから取得した値です(ネットワークとデータ密度によって変わります)。
| クエリ | セグメント数 | ソースリクエスト数 | 所要時間 | 結果 |
|---|---|---|---|---|
| 2 日間、分単位 | 69 | 約 4 | 0.64 s | 2,217,024.0(生データ 2,566 ポイントと一致) |
| 1 年間、日単位 | 42 | 約 4 | コールド時 1.18 s/ウォーム時 0.20 s | 36,012,018.25 |
| 10 か月間、混合レベル | 97 | 約 5~7 | 1 秒未満 | 423,049 個の分バケットを回避 |
| ローカル読み取り、42~90 セグメント | — | 0 | 9~19 ms | 1 つの SQL 文 |
| 混合読み取り(ローカル 3 セグメント+ソース 1 セグメント) | 4 | 1 | 0.31 s | ソースのみの場合と一致 |
手法と注意事項については、docs/benchmarks.md(中文)を参照してください。
位置付けと先行研究
これは、区間集計エンドポイントを読み取れるものの、ソースへの書き込みや再設定ができない環境向けのクエリ計画手法です。新しい時系列データベースでも、集計に関する新たな一般理論でもありません。カレンダーの混合基数分解、正準区間分解、ロールアップ、マルチ解像度集計を組み合わせます。
最も近いシステムには、RRDtool/Whisper(マルチ解像度アーカイブ)、BTrDB(階層型の時間分割サマリー)、TimescaleDB の階層型連続集計、Druid の期間粒度があります。Prometheus や Grafana などのクエリ側システムは均一なステップを 1 つ選択しますが、このラダーは 1 つのクエリ内で複数のカレンダーレベルを計画します。
詳しい比較、過去のアルゴリズム、根拠のある新規性に関する説明については、関連研究と位置付け(中文)をご覧ください。この手法は公開開示(中文)として公開されています。また、技術記事では、本番環境のベンチマークとリクエスト数の根拠を解説しています。
プロジェクト、開発、ロードマップ
プロジェクト構成
src/hybrid_ladder/
  core.py          pure decomposition, folding, coverage splitting
  engine.py        source/mixed/local reads, materialize, verify, repair
  models.py        Segment, SeriesRef, LadderConfig, QueryResult
  protocols.py     TimeSeriesSource / PointStore
  sources/         memory.py, thingsboard.py
  stores/          memory.py, postgres.py
  api.py           FastAPI app
  cli.py           hybrid-ladder CLI
  mcp_server.py    MCP tools
  tasks.py         in-process task registry
  demo.py          deterministic demo data
tests/             unit + API + adapter tests
docs/              algorithm, architecture, API, benchmarks, prior art
skills/            agent skill package
examples/          runnable examples
git clone https://github.com/MagicSquarekey/hybrid_recursive_ladder_algorithm.git
cd hybrid_recursive_ladder_algorithm
python -m venv .venv && source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -e ".[dev]"
ruff check .
pytest
オプションの PostgreSQL 統合テスト:
export HL_TEST_PG_DSN='postgresql://user:[email protected]:5432/testdb'
pytest -m integration
ロードマップ: avg および meter_delta のルール、InfluxDB/Prometheus/ClickHouse アダプター、Celery/RQ タスクバックエンド、OpenTelemetry メトリクス、PyPI の信頼済み公開。
引用
@software{hybrid_recursive_ladder_2026,
  author  = {MagicSquarekey},
  title   = {Hybrid Recursive Ladder: Query Planning for Bucket-Limited Time-Series APIs},
  year    = {2026},
  version = {0.0.6},
  license = {MIT},
  doi     = {10.5281/zenodo.23683292},
  url     = {https://github.com/MagicSquarekey/hybrid_recursive_ladder_algorithm}
}
バージョン DOI:10.5281/zenodo.23683292。
すべてのバージョンに共通するコンセプト DOI:10.5281/zenodo.23556605。
CITATION.cffには、GitHub の「このリポジトリを引用」ボタンで使用されるものと同じメタデータが記載されています。
ライセンス
MIT © 2026 MagicSquarekey
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。