jobd について
jobdは、自分で管理する複数マシンで計算ジョブを実行する開発者向けのキュー兼スケジューラーです。空きVRAMやRAM、CPUなどに基づいてジョブを振り分け、エージェント向けのMCPインターフェースも備えています。
主な機能
- 01空きVRAMとホスト性能による振り分け
- 02複数マシンでの永続ジョブキュー
- 03優先度によるプリエンプトとチェックポイント猶予
- 04状態・ログの確認とジョブのキャンセル
- 05ジョブ配列とスイープに対応
活用シーン
- 01空きVRAMが十分なホストへの学習ジョブの割り当て
- 02ターミナルを閉じた後もジョブを実行・確認
- 03MCP経由でエージェントからジョブを管理
MCP 対応
jobd-mcpはキュー機能を9種類のツールとして公開し、MCPクライアントからジョブやWorkerの送信、確認、キャンセル、管理を行えます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx jobdJOBD_URLBase URL of the jobd broker the MCP server talks to. Defaults to http://127.0.0.1:8765.JOBD_API_TOKENシークレットBearer token; must match the broker's JOBD_API_TOKEN. Required unless the broker runs with JOBD_ALLOW_NO_AUTH=1.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
jobd
jobd は、AI エージェントが自分の数台のマシンにジョブを送信し、振り分け、管理できる MCP サーバー付きのジョブブローカーです。task-spooler や pueue のようなものですが、Tailscale または LAN 上のすべてのマシンを対象にし、空き VRAM のあるワーカーに各ジョブを振り分けます。クラウド、Kubernetes、Slurm は不要です。




# from any machine on your tailnet:
job submit --project myproj --gpu --vram-required 16 --wait -- python train.py
# → routed to whichever worker has ≥16 GB VRAM free, streamed back to your terminal
VRAM の振り分けでは、ホストごとに GPU を 1 基追跡します。ワーカーが報告するのは GPU インデックス 0 の空きメモリのみです。
開発の背景
- VRAM に基づく振り分け。 各ジョブは、実行時の空き VRAM、RAM、CPU、機能タグ、アーキテクチャ/OS が要件に合うワーカーに割り当てられるため、どのマシンが空いているかを推測する必要はありません。
- チェックポイント保存猶予期間付きのプリエンプション。 優先度の高いジョブは実行中のジョブをプリエンプトできます。
SIGTERMを送信し、ワークロードがJOBD_CHECKPOINT_DIRに状態を保存するための猶予期間を設けた後、SIGKILLを送信します。プリエンプトされたジョブは再実行されません。再開するには、チェックポイントを指定して新しいジョブを送信してください(docs/preemption.md)。 - セッション終了後も維持。 ジョブはシェルではなくブローカーに保存されます。ジョブを送信し、ノート PC を閉じて、翌日に状況を確認できます。
- エージェント向けに設計。 MCP サーバーにより、AI エージェントはツール呼び出しでジョブを送信、監視、管理できます(ベンチマークが示すこと)。
- 自分のものとして使えます。 自分が所有するマシン上でブローカープロセスを 1 つ実行します。アカウント、テレメトリー、GPU 時間ごとの課金はありません。オンライン接続が必要なのは、任意の自動更新スクリプトのみです(運用手順書)。
代わりに…を使わない理由
| ツール | できること | 代わりに jobd を使う理由 |
|---|---|---|
nohup / tmux / ssh | 1 台のマシンでコマンドを実行します | キュー、VRAM を考慮した振り分け、プリエンプション、どこで何が実行されたかの記録がありません |
| task-spooler | 1 台のマシン上のジョブキュー | jobd はすべてのマシンにまたがるキューを備え、実行時の VRAM/CPU 適合度に基づいて振り分けます |
| Pueue | 実績のある単一マシン向けキューデーモン | Pueue の README では分散実行は対象外とされています。jobd は GPU 対応機能を加えたそのレイヤーです |
| HyperQueue | HPC をルーツとする、単一バイナリのマルチマシンスケジューリング | GPU 数は数えますが、VRAM は追跡しません。プリエンプション/チェックポイントの取り決めやエージェントインターフェースもありません |
| Slurm | データセンター級のスケジューリング | 個人所有のマシン 2~3 台で構築・運用するには大がかりです |
| SkyPilot / dstack | クラウドと自分のマシンで実行します | SkyPilot の「既存マシン」モードは、マシンに Kubernetes(k3s)をインストールします。dstack はすべてのホストで Docker とパスワードなしの sudo を必要とします |
| Modal | サーバーレス GPU コンピューティング | 自分のマシンではなく、Modal のマシンで実行します |
| Ray | 分散コンピューティング。Ray Jobs では Ray クラスター上で任意のシェルコマンドを実行できます | まず Ray クラスターを構築して実行する必要があります |
インストール
pip install jobd               # broker + CLI
pip install "jobd[mcp]"        # adds the MCP server
pip install "jobd[worker]"     # adds the worker daemon (jobd-worker)
Python ≥ 3.11 が必要です。scripts/install-worker.sh は、専用の venv と生成された設定ファイルを備えたワーカーを ~/jobd-worker にセットアップします。
クイックスタート(単一ホスト)
# 1. start the broker (binds 127.0.0.1:8765 by default)
JOBD_ALLOW_NO_AUTH=1 jobd          # no-auth is fine for a loopback-only broker

# 2. in another shell, install + start a worker pointed at it
pip install "jobd[worker]"
JOBD_URL=http://127.0.0.1:8765 JOBD_WORKER_HOST=local jobd-worker

# 3. submit a job and wait for it
job submit --project demo --wait -- echo hello
job list
job logs <id>
マルチホスト構成(Docker ブローカー、systemd ワーカー、Tailscale バインディング、共有認証トークン)については、docs/security.md と docker-compose.yml および scripts/ 内のテンプレートを参照してください。稼働中のフリートにワーカーを追加するには、コマンドを 1 つ実行します。
job fleet add user@newbox      # ssh in, install pinned to the broker's version,
                               # wire systemd units + the self-update timer,
                               # verify it registers. `job fleet status` shows drift.
運用開始後の作業(ヘルスチェック、ワーカーのドレイン、アップグレード、トークンのローテーション、バックアップ)については、docs/runbook.md を参照してください。
動作の仕組み

ブローカー(FastAPI + SQLite)はキューを保持し、マッチャーを実行してプロジェクトごとの優先度を解決します。各ホストに 1 台ずつ配置されたワーカーはブローカーをポーリングするため、ワーカーへの着信接続はありません。各ワーカーは稼働中の容量をハートビートで通知し、実行可能なジョブを取得してログをストリーミングで返し、プリエンプションに対応します。送信した argv はそのまま実行されます(shell=False)。例外は job submit --stdin と MCP の jobd_submit ツールで、コマンド文字列を bash -c <string> として実行します。設計に関する説明は、docs/ARCHITECTURE.md を参照してください。
CLI
job submit -p PROJ [options] -- CMD...       # queue a job
job list [--state STATE] [--project P]       # queue + recent jobs
job status ID | A<id> [--watch]              # one job, or an array's aggregate
job logs ID [-n BYTES]                       # tail captured output
job wait ID                                  # block until terminal
job cancel ID  /  job preempt ID             # stop a job
job adopt --pid N -p PROJ [--gpu]            # track a process started outside jobd (Linux)
job workers                                  # fleet snapshot + health
job projects list | set NAME PRI | nudge NAME DELTA
job audit [--project P] [--since 24h]        # event history
ジョブ配列とスイープ、--explain によるドライラン、job adopt、および pueue/task-spooler のコマンド対応表については、docs/cli.md を参照してください。
MCP / エージェント連携
jobd-mcp は、キューを 9 つのツールとして公開します:jobd_submit、jobd_status、jobd_logs、jobd_list、jobd_cancel、jobd_preempt、jobd_events、jobd_workers、jobd_worker_delete。docs/agent-cookbook.md では、ジョブの見守り、プリエンプション、スイープ、ジョブがスケジュールされない理由の確認方法を説明しています。
Claude Code の場合:
claude mcp add jobd \
  --env JOBD_URL=http://127.0.0.1:8765 \
  --env JOBD_API_TOKEN=<your-token> \
  -- jobd-mcp
その他の MCP クライアントの場合:
{
  "mcpServers": {
    "jobd": {
      "command": "jobd-mcp",
      "env": {
        "JOBD_URL": "http://127.0.0.1:8765",
        "JOBD_API_TOKEN": "<your-token>"
      }
    }
  }
}
JOBD_API_TOKEN はブローカーのトークンと一致している必要があります。一致しない場合、すべての呼び出しが 401 を返します。examples/claude-code-hooks/ には、負荷の高いコマンドを jobd 経由で送信するようエージェントに促す(または強制的にブロックする)オプションのフックがあります。
ベンチマークが示す内容
ライブブローカーに関する38の質問を使い、各3回の実行で、サーバーを使うClaudeと、jobd独自のjob CLIを使うClaudeを比較しました。Claude Haiku 5.5では、サーバーは毎回38問すべてに正解し、CLIは29問に正解しました。これは事前登録済みの勝利です(Holm調整済みMcNemar検定 p = 0.008)。Sonnet 5.5では36対30、Opus 5.5では38対37で、いずれも有意差はありませんでした。3つのモデルすべてで、サーバーの回答はより低コストかつ高速でした。Sonnetでは、コストは0.20倍、時間は0.17倍でした。
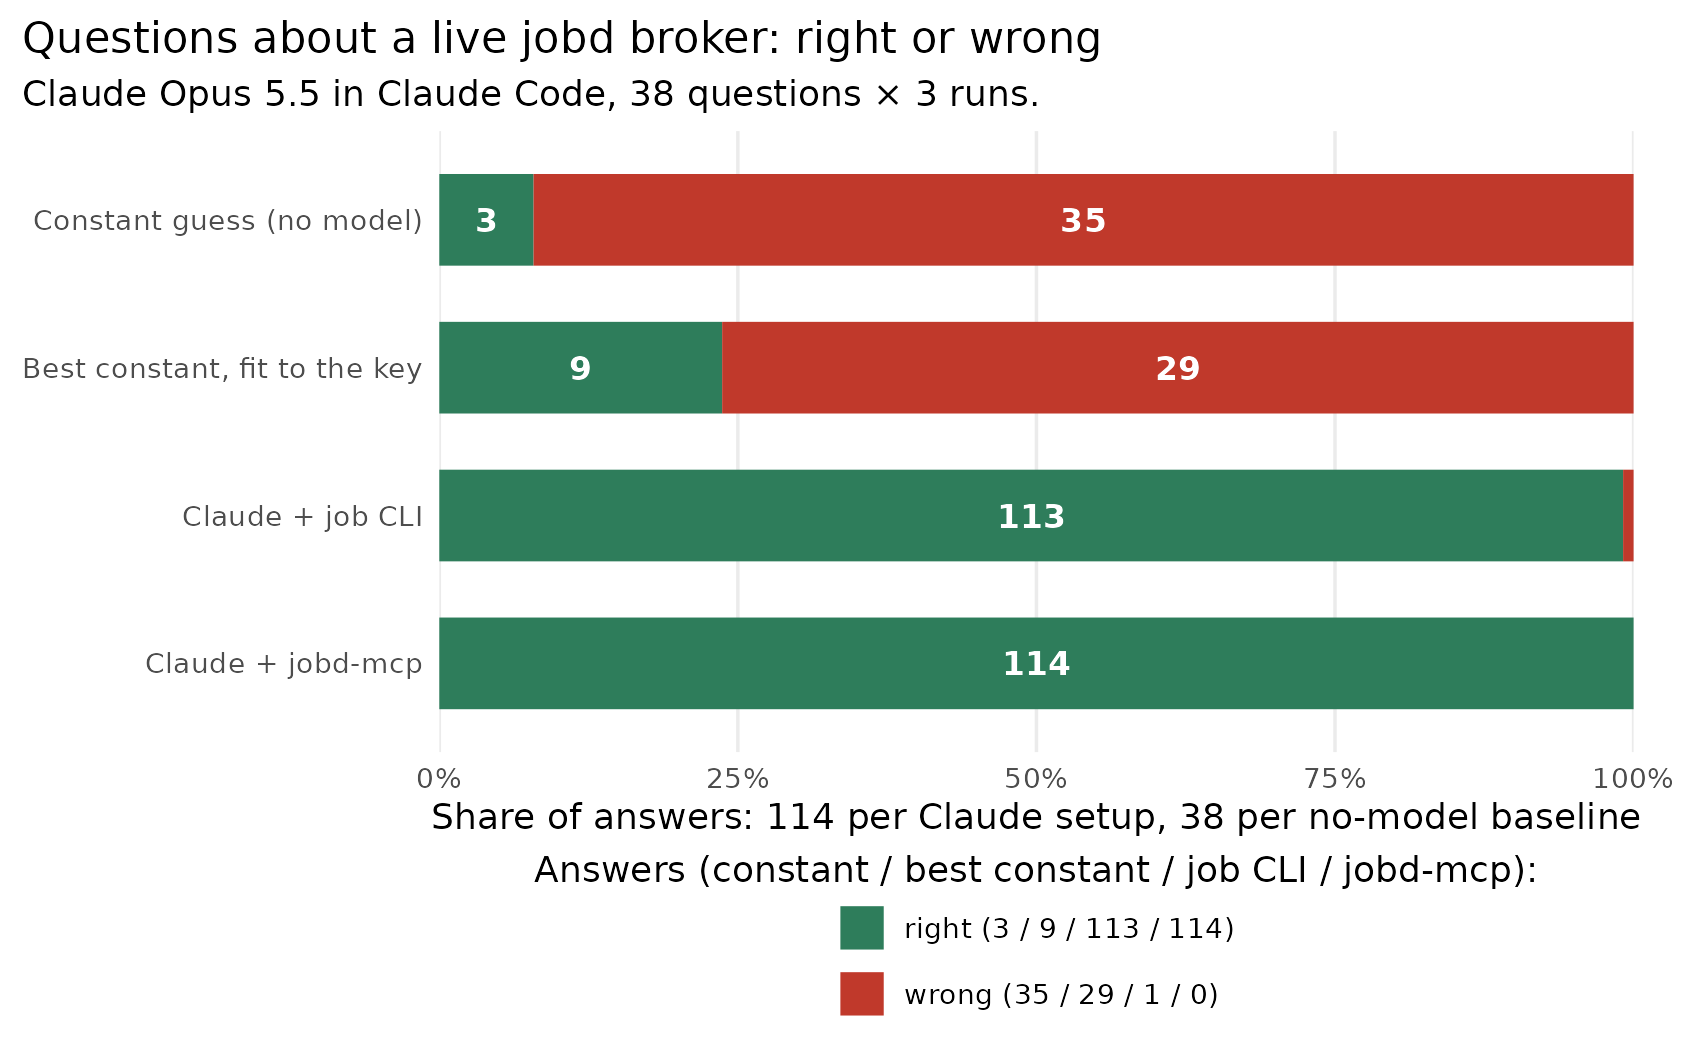
このグラフはOpus 5.5の実行結果(2026-10-18)です。この実行では、サーバーの回答コストの中央値は0.20倍(95% CI 0.15~0.28)で、所要時間は0.16倍(0.13~0.20)でした。また、38問すべてでより低コストかつ高速でした。これらは副次評価項目であり、jobd_listにfinished_atウィンドウを追加する未リリースのコミットで測定しました。より簡単な以前のセットでは、どちらの構成も123問中123問正解しました。
質問の作成とベンチマークの実施は私たち自身で行いました。第三者による再実行も歓迎します。手法、対照条件、制限事項についてはbenchmarks/agent_qaをご覧ください。HaikuとSonnetの実行結果については2026-10-20 re-runをご覧ください。
対応プラットフォーム
| コンポーネント | Linux | macOS | Windows |
|---|---|---|---|
ブローカー(jobd) | テスト済み | 想定 | 想定(WSLを推奨) |
CLI(job)/MCP(jobd-mcp) | テスト済み | 想定 | 想定 |
ワーカー(jobd-worker) | テスト済み | 機能低下 | 未テスト |
CIはGPUランナーなしのUbuntuで実行します(VRAM関連のパスはモックを使ってテストします)。また、systemdユーザーインスタンスがない場合でもワーカーはジョブを実行しますが、メモリー上限、プロセス回収、プリエンプションの保証は無効になります。
設定
- 設定ファイル(
projects.yaml、profiles.yaml、classifier.yaml)はすべて任意で、JOBD_CONFIG_DIRから読み込まれます。docs/projects-yaml.mdをご覧ください。 - **環境変数:**すべての
JOBD_*変数についてはdocs/configuration.mdをご覧ください。 - 並行実行(ワーカーごとに複数のジョブを実行):docs/concurrency.md。ログとジョブ記録の保持についてはdocs/runbook.mdをご覧ください。
セキュリティ
ブローカーはループバックまたはTailscaleのテールネット上で実行し、公開インターフェースでは決して実行しないでください。3つの制御を重ねて適用します。
- **バインド:**デフォルトでは
JOBD_HOSTは127.0.0.1です。Tailscaleアドレス(100.64.0.0/10)を設定し、0.0.0.0は決して設定しないでください。ブローカーはこの設定を強制しません。 - **送信元IP:**ループバックおよび
100.64.0.0/10以外からのリクエストには403が返されます(JOBD_DISABLE_TAILNET_ACL=1を設定すると無効になります)。 - **トークン:**各ホストで
JOBD_API_TOKENを設定してください。JOBD_ALLOW_NO_AUTH=1はループバック専用ブローカー向けです。それ以外のアドレスにバインドすると、テールネット上で認証なしのコード実行が可能になります。
/livez、/readyz、/metricsは、送信元IPチェックとトークン認証のどちらも適用されません。/metricsにはすべてのワーカーのホスト名とバージョンが表示されるため、ブローカーをポートフォワードしないでください。脅威モデルとトークンのローテーションについてはdocs/security.mdをご覧ください。
License
MIT; see LICENSE.
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。