cogvault について
cogvaultは、LLMを使わずにプレーンなMarkdownを索引する、エージェント向けローカルメモリサーバーです。意味検索とキーワード検索を組み合わせ、テナントごとのディレクトリを分離できます。編集可能なMarkdownがデータの基準です。
主な機能
- 01Markdownベースのメモリ
- 02ベクトル検索とBM25の併用
- 03テナントディレクトリの分離
- 04増分索引
- 05時間減衰とMMRの任意適用
活用シーン
- 01エージェントのセッション間で決定事項を参照
- 02既存のMarkdownノートを検索
- 03複数エージェントのメモリを分離
- 04正解付きクエリで検索結果を評価
MCP 対応
MCPサーバーは、ハイブリッド検索を行うcogvault_recallと、事実をMarkdownカードとして保存・索引するcogvault_recordを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx cogvaultCOGVAULT_MODELEmbedding model override; otherwise .cogvault.toml in the tenant, then the multilingual defaultCOGVAULT_LOGRecall log: 'off' to disable, or a path to relocate the JSONL logローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細




30秒で始める
Claude Code プラグイン — MCP サーバーと、いつメモリを呼び出し、いつ記録するかをエージェントに伝えるスキルを組み合わせています:
/plugin install cogvault --marketplace NBibikov/cogvault
2.1.275 より前の Claude Code の場合:/plugin marketplace add NBibikov/cogvault を実行し、続いて
/plugin install cogvault@cogvault を実行します。
メモリは ~/.cogvault/memory に保存されます(場所を変更するには COGVAULT_TENANT を設定してください)。プラグインによって
/cogvault:remember が追加されます。
任意の MCP クライアントで1行(uv が必要です):
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Claude Desktop、Cursor、Windsurf、Cline — JSON 設定
claude_desktop_config.json、~/.cursor/mcp.json、またはクライアントの MCP 設定に追加します:
{
  "mcpServers": {
    "cogvault": {
      "command": "uvx",
      "args": ["cogvault", "mcp", "--tenant", "~/agent/memory"]
    }
  }
}
すでに Markdown のメモリをお持ちですか? テナントの保存先に指定するだけで使えます。インポートは不要です。Claude
Code の自動メモリもそのまま動作します(frontmatter の type、[[links]] などすべて):
M=~/.claude/projects/<project>/memory
uvx cogvault index  --tenant $M --ignore MEMORY.md   # first pass embeds, later passes are incremental
uvx cogvault search --tenant $M "how do we deploy"
MCP サーバーは起動時に自動でインデックスを作成します。CLI の search は既存のインデックスを読み取ります。
--ignore MEMORY.md を指定すると、インデックスファイルが参照先のカードと競合するのを防げます。
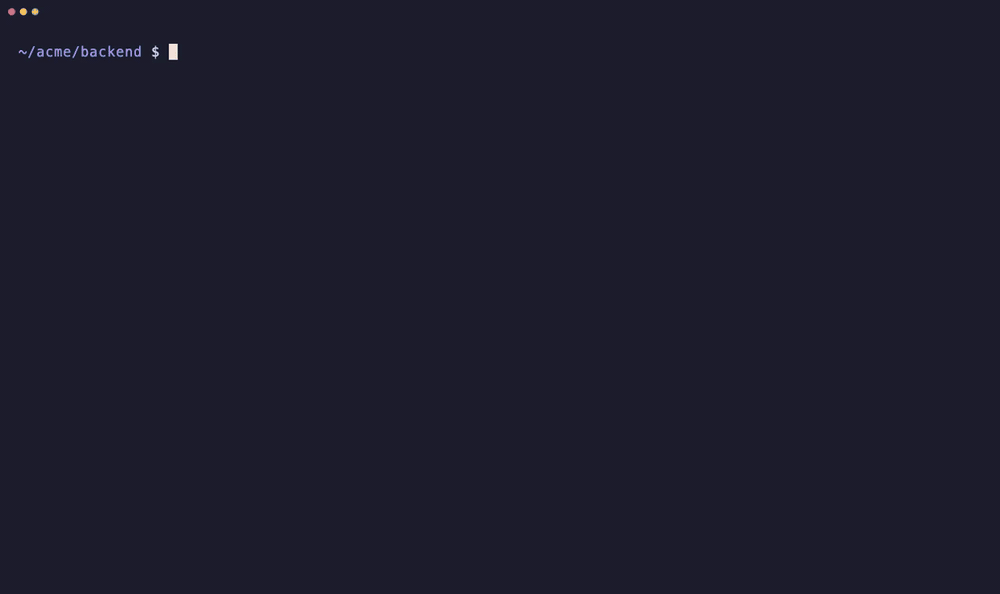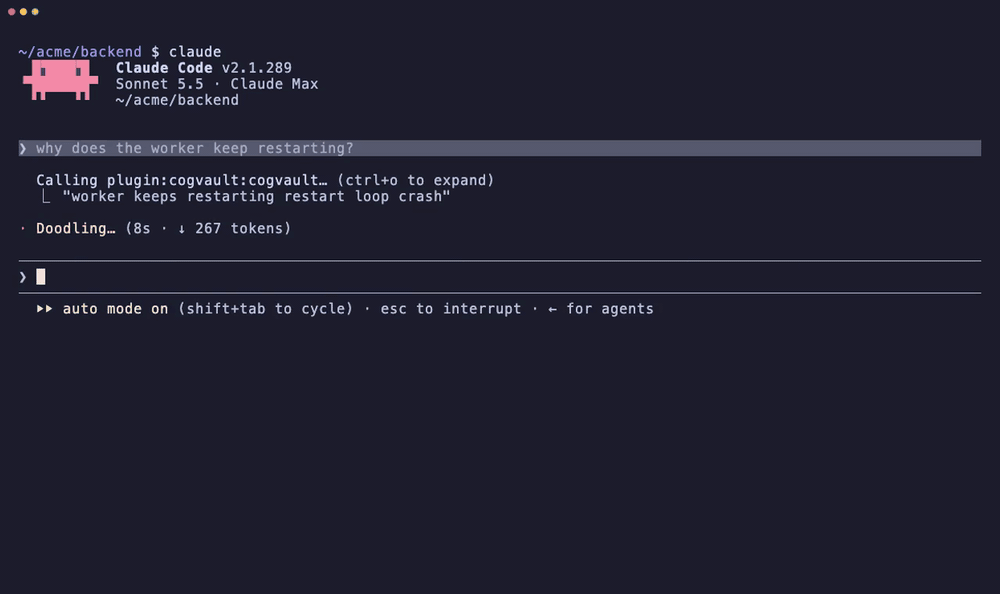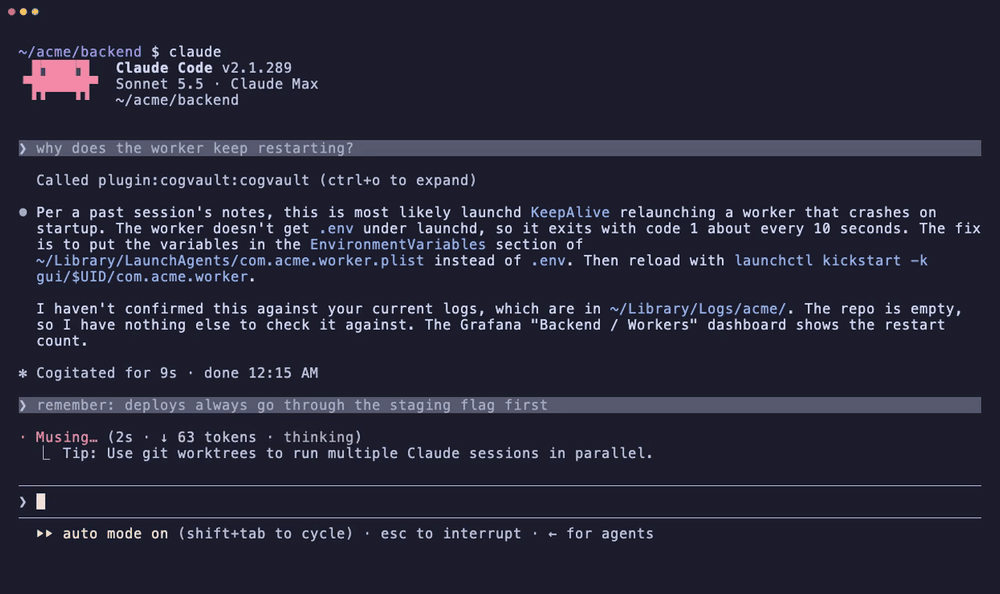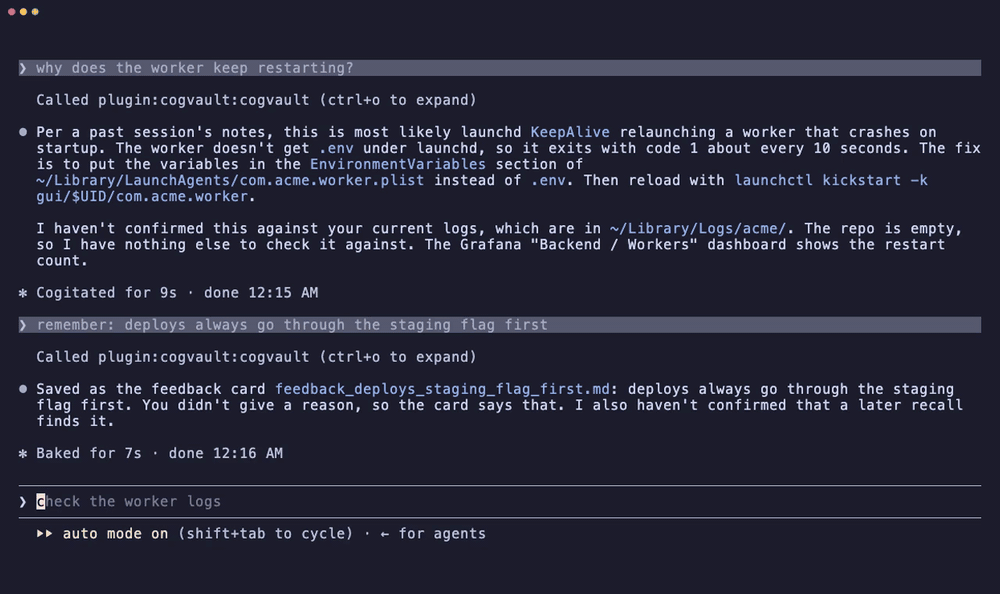
実際のセッションでの未編集の回答です(Sonnet、プラグインをインストール済み、6枚のカードからなるデモ用メモリ)。待ち時間のみ短縮しています。
選ばれる理由
多くの「AI エージェントメモリ」ツールは、作業内容を不透明なデータベースや、読めないグラフに要約する自律型 LLM デーモンを必要とします。決定事項、バグ修正、インフラの詳細を確実に呼び出すことだけが必要なコーディングエージェントのフリートには、それは適切な選択ではありません。
cogvault はその逆を選びます:
- Markdown ファイルが信頼できる唯一の情報源です。 ファイルを開いて編集し、
git diffで差分を確認できます。SQLite インデックスは派生キャッシュにすぎません。削除しても、ファイルから再構築されます。 - 1つのライブラリで複数のテナントに対応します。 各エージェントには、それぞれのディレクトリを使って分離されたメモリ名前空間が割り当てられます。プロセスは埋め込みモデルをそれぞれ一度だけ読み込み、利用するすべてのテナントで共有します。stdio MCP サーバーの場合、これは中央デーモンではなく、エージェントのセッションごとに1つの小規模プロセスが起動することを意味します。
- LLM は処理に介在しません。 取り込みと検索は決定論的です。エージェント自体が LLM なので、記憶するために別の LLM は必要ありません。
- ローカルで、プライベートで、オフラインです。 FastEmbed はデバイス上で動作します。データがマシンの外に出ることはありません。
比較
各プロジェクトの README とドキュメントを 2026-10-05 に確認しました。
| cogvault | basic-memory | mem0 | Graphiti | Letta Code | |
|---|---|---|---|---|---|
| 情報の正本 | Markdown ファイル | Markdown ファイル | ベクトル DB(Qdrant / pgvector) | グラフ DB(Neo4j、FalkorDB、…) | エージェントごとの Git リポジトリ内の Markdown |
| 保存や想起に LLM が必要か | いいえ | いいえ(リランカーは任意) | はい(デフォルトでは add() が事実を抽出します) | 取り込みに必要です | はい — エージェントが自身のメモリを編集します |
| 検索 | ベクトル + BM25、RRF、減衰、MMR | 全文検索 + ベクトル、リランキングは任意 | セマンティック + BM25 + エンティティ | セマンティック + BM25 + グラフ | ファイル検索。ハイブリッド検索は任意 |
| インフラ | 1 つのプロセス、SQLite ファイル | 1 つのプロセス、SQLite(Postgres も任意で利用可能) | ライブラリ、または Docker + Postgres サーバー | グラフデータベース | Letta バックエンド |
別のものを選ぶ場合: LLM に事実を要約・統合してほしい場合(mem0)、エンティティ間の関係が重要な場合(Graphiti)、エージェント自身にメモリを管理させたい場合(Letta)、または Obsidian 同期やホスト型の選択肢を備えた、同じ Markdown の考え方に基づく、より高機能なノートアプリが必要な場合(basic-memory — cogvault に最も近いもの)。
cogvault を選ぶ場合: 複数のエージェントを実行し、それぞれのメモリを個別のディレクトリに分離して、1 つのプロセスで管理したい場合、想起を決定論的かつオフラインで行いたい場合、そしてその性能を 測定 したい場合です。cogvault eval はエージェントの実際のクエリに対する想起をスコア化し、cogvault analyze は想起しようとしてできなかった内容を一覧表示します。
仕組み

想起の仕組み

ハイブリッド検索では、セマンティック(ベクトル)とキーワード(BM25/FTS5)のランキングを Reciprocal Rank Fusion で統合し、その後、任意で 時間減衰(古い記憶より最近の記憶を優先)と MMR (上位結果の多様性を確保し、よく似た結果ばかりにならないようにする)を適用します。各カードからは最良のチャンクだけが選ばれるため、長いファイル 1 つが結果一覧全体を占めることはありません。
ベンチマーク

合成した質問ではなく、実際の再現トラフィックで測定しています。稼働中の6つのエージェントテナントのクエリログから抽出した66件(58%がウクライナ語、残りは英語)を、どの設定でも返されなかった回答を含む実際のカードと照合して判定しました。1件はメモリ内に回答がなく、ギャップとして数えるため、採点対象は65件です。各設定は、同じテナントのコピーを使い、cogvault 0.11.0で最初から再インデックスしました。
| 設定 | hit@1 | hit@5 | MRR@10 |
|---|---|---|---|
multilingual-e5-small、chunk_chars = 700、要約チャンクあり | 0.57 | 0.91 | 0.70 |
multilingual-e5-small、chunk_chars = 700、要約チャンクなし | 0.55 | 0.86 | 0.69 |
paraphrase-multilingual-MiniLM-L12-v2(組み込みのデフォルト) | 0.54 | 0.80 | 0.66 |
bge-small-en-v1.5(英語のみ) | 0.57 | 0.77 | 0.65 |
数値からわかること、わからないこと:
- hit@1は同等です。 4つすべてが0.54~0.57の範囲に収まり、95%ブートストラップ区間はほぼ完全に重なっています。実際のエージェントクエリはカードのタイトルに似ているため、通常は名前だけで正しいカードが見つかります。
- 差が出るのは上位5件です。 要約チャンクを使ったe5-smallは、クエリの91%で回答を上位5件に含めます。これは、混在言語のメモリでデフォルトのMiniLMが80%、英語のみのbgeが77%であるのと比べた結果です。5件の結果を読むエージェントが実際に体感するのはこの違いです。
- 65件のクエリは、まだ小規模なサンプルです。 約0.1未満の差はノイズとして扱ってください。集計値は
assets/benchmark.jsonにあります。クエリは非公開で、各テナント内にとどまります。
再ランキング
クロスエンコーダーはクエリと各候補カードを一緒に読み取るため、同じトピックに関するカードを選ぶだけでなく、質問に答えるカードを判別できます。rerank = "BAAI/bge-reranker-v2-m3-int8"を指定すると、cogvaultはハイブリッド検索の上位10件を各カードファイルの先頭800文字で採点し、並べ替えます。同じ65件のクエリ(cogvault 0.12.0、e5-small+要約チャンク)での結果です。
| hit@1 | hit@5 | MRR@10 | |
|---|---|---|---|
| ハイブリッド検索のみ | 0.60 | 0.88 | 0.70 |
| ハイブリッド検索+再ランカー | 0.80 | 0.91 | 0.85 |
再ランカーによって17件のクエリが改善し、3件が悪化しました。hit@1の改善幅の95%ブートストラップ区間は+0.09~+0.34です。コストは約2 GBのRAMと、Apple MシリーズCPUでの再現1回あたり1~2秒です。そのため、共有デーモンとcogvault eval(--no-rerankを指定すると再ランカーなしで採点)でのみ実行されます。
ご自身のメモリでも同じチェックを実行できます。判定済みクエリを<tenant>/.cogvault-golden.jsonl({"query": "...", "relevant": ["file.md"]}。relevantが空の場合は既知のギャップ)に入れ、cogvault eval --tenant DIRを実行してください。
埋め込みモデルの選択
エージェントのメモリは、英語だけとは限りません。初期設定は多言語対応なので、すぐに問題が起きることはありませんが、利用環境の言語構成に合ったモデルを選んでください(COGVAULT_MODEL を設定するか、Config(model=...) を指定します)。モデルを切り替えると、インデックスは自動的に再構築されます。
モデル(COGVAULT_MODEL) | 次元数 | サイズ | 実クエリの hit@5* | キリル文字/多言語 | 用途 |
|---|---|---|---|---|---|
paraphrase-multilingual-MiniLM-L12-v2 (デフォルト) | 384 | 0.22 GB | 0.80 | ✅ 対応 | 複数言語が混在する環境。安全なデフォルト |
BAAI/bge-small-en-v1.5 | 384 | 0.13 GB | 0.77 | ❌ キリル文字のベクトルが壊れます | 英語のみのメモリ |
intfloat/multilingual-e5-small | 384 | 0.47 GB | 0.91 | ✅ GB あたりで最高(512 トークンのウィンドウ) | 複数言語が混在する環境。chunk_chars = 700 を使用 |
intfloat/multilingual-e5-large | 1024 | 2.24 GB | 未測定 | ✅ 最高 | 最高品質。RAM に余裕がある場合 |
*上記のベンチマークより:英語とウクライナ語が混在するメモリを対象に、実際のクエリ 65 件で測定。cogvault 0.11.0。英語のみのメモリでは bge-small-en が適していますが、ウクライナ語のコンテンツでは関連性のマージンが負になり(回答よりも無関係な項目が上位になるため)、英語以外のメモリには安全に使用できません。自分のボルトで cogvault eval を実行して判断してください。
COGVAULT_MODEL=BAAI/bge-small-en-v1.5 cogvault index --tenant ~/agent/memory
テナントごとにモデルを固定して、各コマンドで COGVAULT_MODEL を設定する必要がないよう、モデル設定をデータとともに保持してください(設定を一度忘れると、モデルの不一致によってインデックス全体が警告なしに再埋め込みされます)。テナントのルートに .cogvault.toml を配置します。
# ~/agent/memory/.cogvault.toml
model = "BAAI/bge-small-en-v1.5"
# optional: recursive = true, strip_frontmatter = true, ignore_globs = ["Templates/*"]
これで、cogvault search --tenant ~/agent/memory "…" は環境変数なしで適切なモデルを使用します。優先順位:明示的な --model / $COGVAULT_MODEL > .cogvault.toml > 組み込みのデフォルト。
インストール
uv tool install cogvault        # CLI on PATH
# or
pip install cogvault
または、インストールせずに uvx cogvault … で必要なときに実行できます。初回実行時に埋め込みモデルがダウンロードされます(約 0.2~0.5 GB、マシンごとに 1 回)。
Claude Code に MCP サーバーとして 1 行で追加できます:
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
公式 MCP Registry に io.github.NBibikov/cogvault としても掲載されています。各 GitHub リリースには、ホイールが添付されています。
クイックスタート
# index a tenant's markdown memory
cogvault index --tenant ~/agent/memory

# search (hybrid semantic + keyword)
cogvault search --tenant ~/agent/memory "how do I restart the worker service"

# enable temporal decay (recent wins) and tune diversity
cogvault search --tenant ~/agent/memory "deployment steps" --half-life 30 --mmr 0.5

# only cards of one frontmatter type (user / feedback / project / reference / …)
cogvault search --tenant ~/agent/memory "hard rules for deploys" --type feedback
メモリーカード
cogvault は、次の 2 つの簡易的な Markdown 規約に対応しています(どちらも任意です。通常のファイルも問題なくインデックス化できます)。
- フロントマターの
type— フラット形式(type: reference)とネスト形式(metadata:→type: reference)のどちらにも対応しています。インデックス作成時に解析され、検索時にフィルタリングできます(--type、MCP のtypeパラメーター、search(card_type=...))。各検索結果にはtypeフィールドが含まれます。フロントマターのないカードではnullになります。 [[wiki-links]]— リンク先がインデックス化され、検索結果のトップ項目には、インデックスに存在するリンク先カードのrelatedリストが含まれます(リンク切れは除外され、ファイル名の拡張子を除いた部分で完全一致する項目が対象です)。
MCP サーバーとして(Claude Code、Cursor、あらゆる MCP クライアント)
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
2 つのツールを公開します。
cogvault_recall— このエージェントのメモリを自然言語でハイブリッド検索します。任意のtypeパラメーターで、フロントマターのカードタイプを 1 つに絞り込めます。検索結果のトップ項目には、[[wiki-links]]から作成されたRelated:行が含まれます。cogvault_record— 情報を保存します。Markdown カードとして書き込まれ、インデックス化されます
フォルダーツリーのインデックス作成(Obsidian の保管庫、ナレッジベース)
デフォルトでは、テナントは .md ファイルだけを含むフラットなディレクトリです。ネストされた保管庫
(たとえば Obsidian の 01-Projects/…、フロントマター、スキップするフォルダーがある場合)では、次のオプションを有効にしてください。
cogvault index --tenant ~/vault \
  --recursive \
  --strip-frontmatter \
  --ignore ".obsidian/*" --ignore ".trash/*" --ignore "Templates/*"
--recursiveはサブディレクトリを走査します。ファイルはテナントからの相対パスを保持するため、 別々のフォルダーにあるTasks.mdという名前のノートが衝突することはありません。--strip-frontmatterは、先頭の YAML--- … ---ブロックを削除し、そのキーが埋め込みに 影響しないようにします。--ignore GLOB(繰り返し指定可能)は、テナントのルートからの相対パスをスキップします。
同じフラグは search と mcp にもあり、ライブラリでは Config(recursive=True, strip_frontmatter=True, ignore_globs=(...)) として指定できます。インデックス作成は
増分方式です。初回はすべてを埋め込み、以降は変更されたファイルのみを再埋め込みします。
(参考:ノート約 3,500 件の保管庫では約 9,500 チャンクとなり、初回のインデックス作成は約 3~4 分、
その後のウォーム状態での検索は 1 桁ミリ秒です。)
ライブラリとして
from cogvault import Vault, Config

vault = Vault("~/agent/memory", Config(half_life_days=30))
vault.reindex()
for hit in vault.search("where are credentials stored"):
    print(hit["score"], hit["file"], hit["snippet"])
テナントの健全性を保つ
cogvault doctor --tenant DIR は、検索精度をひそかに低下させる問題を報告します。フロントマターや
タイプがないカード、旧形式のタイムスタンプ付きファイル名、フロントマター内にネストされたフロントマター、
重複した name: スラッグ、解決先のない [[links]] などです。リンクはフロントマターの name:、
ファイル名の拡張子より前の部分、いずれの区切り文字形式でも、またカードタイプのプレフィックスの有無を問わず
解決されます。コード内のリンクやテナント外のファイルへのパスは対象に含まれません。
cogvault repair --tenant DIR は、機械的に修復できる問題を修正します(デフォルトではドライラン、
書き込みには --apply を指定します)。ネストされたフロントマターのラップを解除し、欠落しているタイプを推定し、
card-<timestamp>-….md を <type>_<slug>.md に名前変更して、それへのすべての参照(MEMORY.md を含む)を書き換え、
フロントマターのない <type>_*.md カードに最小限のフロントマターを追加します。健全なカードには手を加えず、
修復されたカードの mtime は維持されるため、時間経過による減衰はリセットされません。
有効性のログ記録
各検索結果は、メモリーが実際に役立っているかを測定できるよう、JSONL 形式の 1 行として記録されます。
cogvault analyze はログをレポートに変換します。
cogvault analyze            # recalls, latency, per-tenant hit distance, weakest hits, card writes
cogvault analyze --json     # machine-readable
cogvault analyze --since 7  # only the last 7 days (or --since 2026-10-05)
重要なのは 最も弱いヒット のセクションです。各テナントでベクトル距離が最も大きい 10%を示します。
検索結果として 何か は返されたものの(ハイブリッド検索ではほとんどの場合、何らかの結果が返されます)、
おそらく答えではないクエリです。この一覧は、エージェントが検索しようとしたものの見つけられなかった内容、
つまり埋めるべきメモリーのギャップを示します。無効にするには COGVAULT_LOG=off を設定し、
保存先を変更するには COGVAULT_LOG=/path.jsonl を設定してください。
マルチテナントのフリート
1 つのプロセスを複数のテナントに向けます。各ディレクトリは独立した名前空間であり、
テストスイート(test_multi_tenant_isolation)で検証されています。B を A のディレクトリに向けない限り、
エージェント B がエージェント A のメモリーを検索することはありません。

各 MCP クライアントはそれぞれ独自の cogvault mcp を起動します。デーモンがない場合、これらのプロセスはそれぞれ埋め込みモデル(約 1 GB)を読み込み、リランカーを読み込めるものはありません。cogvault daemon はすべてのテナント向けに各モデルを一度だけ読み込み、Unix ソケット(~/.cache/cogvault/daemon.sock、モード 600)経由で提供します。cogvault mcp と cogvault search は自動的にデーモンを検出して処理を転送するため、MCP プロセスのメモリ使用量は約 40 MB にとどまります。デーモンが停止している場合は、従来どおりリランカーなしでプロセス内検索を行い、クエリログに daemon-fallback イベントを 1 件記録します。
cogvault daemon            # run in the foreground
cogvault daemon --status   # ping it: version, loaded models, tenants served
デーモンは、検索または再インデックスが 10 分間行われないとモデルをアンロードし、次のリコール時に再読み込みします(その呼び出しに約 1.5 秒追加されます)。--idle-unload SECONDS または $COGVAULT_IDLE_UNLOAD を設定してください(0 にするとモデルを読み込んだままにします)。e5-small とリランカーでの測定値は、読み込み時が約 1.8 GB、アンロード時が約 0.4 GB です。ONNX Runtime は 4 スレッド($COGVAULT_THREADS、0 = すべてのコア)を使用し、CPU メモリアリーナを使わないため、完全な再インデックス時のピークメモリは約 1 GB で、処理後に数 GB が保持されることはありません。デーモンの停止中に起動したシムは、自身でモデルを読み込む前に最大 60 秒間デーモンを待機し、デーモンが再び応答すると、読み込んだモデルを直ちに解放します。
リランカーには独自のスレッド数設定があります($COGVAULT_RERANK_THREADS。デフォルトは Apple silicon ではパフォーマンスコア数、それ以外では 4)。これはリコール時にのみ実行され、リコールのレイテンシの大部分を占めます。P コア 10 個の場合、リコールの p50 は 4 スレッド時の 2.3 秒から 1.65 秒に短縮され、onnxruntime 1.31 では 1.05 秒になりました(このバージョンでは 4 スレッド時のリコールも 1.5 秒に短縮されました)。
macOS では、RunAtLoad と KeepAlive を設定して launchd で実行します(プログラム引数は cogvault daemon)。cogvault をアップグレードしたら、デーモンを再起動してください。
launchctl kickstart -k gui/$(id -u)/<label>。
設計上の留意点
| 決定事項 | 理由 |
|---|---|
| Markdown を信頼できる唯一の情報源とする | 人が読みやすく、git でバージョン管理でき、編集可能で、データベースに閉じ込められません |
SQLite + sqlite-vec + FTS5 | インフラ不要のハイブリッド検索。ポータブルな .db ファイル 1 つで、再構築も可能です |
| FastEmbed(デフォルトは多言語 MiniLM、384 次元) | プロセス内 ONNX。サーバーも API キーも不要で、約 220 MB です |
| コンテンツハッシュキャッシュ | 再インデックス時に埋め込みを生成するのは、変更されたチャンクだけです |
| RRF + 減衰 + MMR | グラフデータベースを使わずに、精度、新しさ、多様性を実現します |
| 1 つのプロセスで複数のテナントに対応 | 単一ユーザー向けのデスクトップサイドカーではなく、フリート向けのインフラです |
| WAL + 増分再インデックス | 1 つが書き込み中でも複数のエージェントが読み取れます。埋め込みを再生成するのは変更されたファイルだけです |
| オプションの共有デーモン | フリート全体で各モデルのコピーは 1 つだけです。デーモン停止時、クライアントはプロセス内処理にフォールバックします |
ロードマップ
- インポーター(他のストアにある既存のメモリを移行)
- 差し替え可能な埋め込みモデル(Ollama、OpenAI 互換エンドポイント)
- カードごとの時間的有効期限
valid_until - オプションの FastMCP トランスポート
ライセンス
MIT — あなたのメモリ、あなたのファイル、あなたのインフラ。永久に。
図は assets/make_graphics.py から手作業で作成した SVG です。python assets/make_graphics.py --png で再生成できます。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。