crbro-memory について
crbro-memory は、AI アシスタントにセッションをまたぐ永続的で検索可能な記憶を提供するローカル MCP サーバーです。事実をプロジェクトごとに整理し、修正、期限管理、明示的な根拠の記録に対応します。
主な機能
- 01セッションをまたぐローカル記憶
- 02事実単位の検索とセマンティック検索
- 03プロジェクト別の記憶と別名
- 04項目の修正、退役、削除
- 05期限、根拠、古い情報の警告
- 06バックアップと認証情報の秘匿
活用シーン
- 01後のセッションでプロジェクトの決定を参照
- 02大量の記憶から特定の事実を検索
- 03履歴を残して古い情報を修正
- 04機密認証情報を記憶ファイルに保存しない
MCP 対応
MCP クライアントに、記憶の保存、検索、確認、修正、削除のツールを提供します。ツール定義には読み取り、書き込み、破壊的操作を示す注釈があります。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
15掲載時のツール一覧 · 1 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| project | string | いいえ | このセッションで作業するフォルダーまたはリポジトリ:パス("C:/code/crbro-memory")、リポジトリ名、またはリモート("owner/repo")。最後のセグメントのみが対象です。名前、システムマップ、または事実キーワードにその名前を含むニューロンは hot_topics で優先され、project_neurons に一覧表示されます(最大 5 件)。省略した場合、起動結果は指定しない場合とまったく同じです。 |
詳細
🧠 CRBRO — AI のための永続的なニューラルメモリ






CRBRO はローカルの MCP(Model Context Protocol)サーバーで、セッションをまたいで 永続的な長期記憶 を AI アシスタントに提供します。大脳皮質、シナプス、海馬を備えた生物学的なニューラルアーキテクチャを用いて、知識を自動的に保存、関連付け、呼び出します。
無料のオープンソース(MIT)です。15 個すべてのツールを利用できます。ライセンス、アカウント、プランは不要です。
⭐ CRBRO に AI の大切な記憶を任せられると感じたら、GitHub でスターを付けるのが、応援する最良の方法です。
☕ これで時間を節約できたら、コーヒーをごちそうしてください。
USDC での送金も可能です。USDC のみを、表示されているネットワークのみで送金してください。それ以外のネットワークでは、復元できず失われます。
| ネットワーク | USDC アドレス |
|---|---|
| Solana | 5n6Gfosk7SdwbvdtE9xiLWpcGPBBBGDZYRfAkWyCk86g |
| Ethereum(ERC-20) | 0xe176866f9d7fdb498e0d4a983d3e34d84dcd6bfc |
機能
- 🧭 プロジェクトの継続性(2.10+) — フルパス/リポジトリの識別情報と明示的なエイリアスによって、ニューロンをプロジェクトに紐付けます。各 MCP 接続には個別の現在のプロジェクトがあり、スコープ付きの保留項目、任意の期限、完了条件を設定できます。
crbro_recall scope=allを使えば、他のプロジェクトも引き続き検索できます。スコープは整理のためのものであり、アクセス制御の境界ではありません。例と互換性。 - 🩺 読み取り専用の診断(2.10+) —
npx crbro-memory doctor --jsonは、検出したバージョン、脳/クライアントのパス、最終起動時刻、セマンティックファイル、バックアップ、ローカルの Git 状態を報告します。修復、認証情報の値の読み取り、何かのインストール、フェッチ/プッシュは行いません。不明な情報は不明として扱います。doctorを参照してください。 - 🧬 生物学的アーキテクチャ — ニューロン(皮質)、つながり(シナプス)、セッションメモリ(海馬)として知識を整理します
- 🔍 事実レベルの検索 — Orama を活用しています。すべての事実を個別にインデックス化するため、何百もの事実を含むトピックも、3つだけのトピックと同じように見つけられます。各検索結果には、一致した正確な行、記録日時、
confidenceラベル(weak= 質問の内容をほとんどカバーしていない)が付与され、上位の結果にはトピック内で次に有用な行も含まれます。短い二言語の同義語テーブルで、用語を捏造せずに質問の幅を広げます (v1.13+) - 🎯 ニューロンではなくエントリーを読む —
crbro_inspect view=neuronはインデックスを返します。各事実、決定、パターン、好み、エラー、負債、マップが、ID、種類、日付、プレビューとともに表示されます。entries=[ids]で指定したものだけを読み取れます。すべての想起結果にはentry_idが付いています。ニューロン全体を読む機能もdetail=fullとして引き続き利用できますが、上限が設定されています。307件の事実を含むニューロンの読み込みは、66,952トークンから1,887トークンに減りました (v2.1+) - 📓 日記を検索できます — すべてのセッション要約が段落単位でインデックスに登録されます。
crbro_recallは質問に言及している日を独立したリストsessions_matchedで返すため、物語の記述が事実より優先されることはありません。crbro_inspect view=sessions session=<id>で1日分をすべて読み取れます。字句検索のみで、アップグレード時に一度だけ再構築されます (v2.2+) - 🗣️ ループに参加するモデル — 埋め込みモデルでは置き換えられない2つの手段を、ブラインド測定しています。保存時にキーワードを記述する方法(同義語を知っている呼び出し側が、Hetznerについての行に hosting, alojamiento, servidor を追加します)と、複数の言い回しを一度に検索して順位を統合する方法です。ディスクもRAMも使いません。数値は以下の表をご覧ください (v1.15+)
- 🧭 セマンティック想起 —
npx crbro-memory initはローカル埋め込みモデル(multilingual-e5-small、int8)をインストールし、キーワードエンジンと統合します。言葉だけではカバーできない言い換えも見つかるようになります。大規模な脳で特に効果があります。テストセットの周囲に無関係な事実が1,482件ある場合、元の試験で recall@1 が54%から67%に、新しい96問の試験で31%から48%に向上します。小規模な脳では、キーワードエンジンと2ポイント以内の差です(2.7.2では75%対77%)。マシンごとに一度、ディスクを約500 MB使用し、サーバー実行中は約0.5 GBのRAMを使用します。init --no-semanticでインストールをスキップでき、CRBRO_SEMANTIC=0で無効化できます (v1.14+、v1.16以降はデフォルトでインストール) - 🔥 ヒートスコア — 頻度、新しさ、つながりに基づき、関連性を自動的に追跡します。同じセッション内で書き込まれたトピックは統合時にリンクされるため、グラフが自動的に形成されます (v1.13+)
- 🕰️ 意味のある日付 — 最大4%の新しさ補正により、同点の場合は新しい記述を優先します(測定では、完全な同点の場合にのみ順位が入れ替わりました)。
crbro_recall since/kindを使うと、検索対象を「直近2週間」や「過去の失敗のみ」に絞り込めます。また、crbro_maintenance backfill_datesは、1.13より前に書かれたエントリーの日付を、本文に記された日付に基づいて設定します。推測は行いません (v2.5+) - ⏳ 有効期間と明示的な根拠 — 事実には
volatile(90日)、normal(365日)、durable(730日)、permanentの有効期間があり、CRBRO_SHELF_DAYSで設定できます。期限切れの主張は、情報源の確認を促す警告とともにpossibly_staleに移されます。2.10以降、事実を繰り返しても検証済みにはなりません。確認を再開するには、crbro_revise status=verifiedのみが有効です。任意のevidenceには、参照先を含むsource、またはuserを記録できます。以前の明示的な呼び出しはunspecifiedのままで、従来の日付が根拠として扱われることもありません。参照先はデータであり、実行されることはありません。temporalは現在の主張と過去の記録を区別し、intent=currentは過去の一致を分離します。関連性、出所、検証、新しさはそれぞれ別のラベルであり、真実を保証するものではありません。以前のエージェントベンチマークでは、警告だけではエージェントが情報源を確認するよう確実に促せないことが示されました。これらの過去の測定結果は設計レポートに記載されています。 - 🧹 実行前に報告する整理機能 — 各メンテナンス実行では、期限を過ぎたエントリー、1回の読み込みには大きくなりすぎたニューロン(すべての日付を保ったまま分割するには
crbro_revise move_toを使用)、一括インポートで残された1行だけのニューロン(compact:trueで要約にまとめます)を一覧表示します。依頼されるまでは、すべて読み取り専用です (v2.5+) - 💽 自動バックアップ — 統合時に1日1回、脳の隣にgzip圧縮したコピーを作成し、ローテーションします。
CRBRO_BACKUP_DIRで同期済みフォルダーを指定できます。隔離データとマシントークンはバックアップに含まれません (v2.5+) - ✏️ 修正可能 — 知識は積み上げるだけでなく、置き換えたり撤回したりできます。事実に加え、2.0以降は決定、パターン、エラー、負債も対象です。追加するだけのメモリでは、昨日の回答を今日の確信度で提供し続けます。廃止した情報はファイルに残り、
status=activeで再び有効にできます。ディスク上に残してはいけない情報は、まず隔離コピーを作成してからcrbro_forgetで削除します - 🔐 認証情報を考慮 — APIキー、トークン、パスワードは、ディスクに書き込まれる前にマーカーに置き換えられます。周囲の文は残りますが、秘密情報は残りません。
crbro_secretは実際の値をオペレーティングシステム標準のキーチェーンに保存するため、利用を断っても保存場所に困ることはありません - 🏠 すべてのクライアントで1つのプロセス(オプトイン) —
npx crbro-memory daemon onを実行すると、脳を使うクライアントはそれぞれコピーを読み込まなくなります。クライアントが起動するものは、インデックスとモデルを一度だけ保持する単一のデーモンへの55 MBのプロキシになります。クライアント3つでの測定では、2,153 MBから1,140 MBに減少し、2つ目のクライアントは準備完了まで1.8秒ではなく0.3秒となり、あるチャットで保存した行が別のチャットですぐに想起されました。デーモンに接続できない場合や呼び出し中に停止した場合、クライアントは自身で処理を続けます。速度が落ちることはあっても、メモリが失われることはありません (v2.5+) - 👥 2つのエディターで同時に開いても安全 — 書き込みはニューロンごとに直列化されるため、2つの IDE で CRBRO を同時に実行しても、事実が気付かれないまま失われることはありません
- 🤝 プロジェクトごとに共有可能 — 明示的に共有したニューロンのみ、設定済みの Git リモートに同期されます。プッシュに失敗した場合は未送信のまま残り、スペースを離れてもローカルの復旧用アーカイブが保持されます。チームと共有していない場合でも、メモリツールが返した情報は AI クライアントに届きます。
- 🗺️ 常に更新されるマップ — 各トピックには、そのシステムの仕組みを示す常に最新のマップ(
crbro_map)を1つ持たせられます。変更のたびに全体を置き換えます。また、クラスターや分野をまたぐつながりを示すグローバルマップもあります - 📓 エラーレジャー —
type: "error"は、実際に起きた各ミスとその修正を、発生したトピックに保存します。同じミスを繰り返さないようにします。1.13以降は日付も記録されるため、想起時には新しい修正が優先されます - ⚖️ 負債レジャー —
type: "debt"は、意図的に作らなかったものを、上限と再検討のきっかけとともに記録します。これにより、実現されなかったアイデアが再び提案されるのを防ぎます (v1.11+) - 🏷️ 誠実なツール定義 — すべてのツールには、MCP アノテーション(
readOnlyHint、destructiveHint、idempotentHint、openWorldHint)とタイトルが付いています。また、読み取り用ツールには出力スキーマもあるため、クライアントは呼び出す前に、何が読み取り、何が書き込み、何が破壊的な操作を行うかを把握できます (v1.13+) - 🧰 15個のツール、1つのライフサイクル — すべての読み取りは
crbro_inspectのビューです。crbro_learn、crbro_revise、crbro_forgetは、1つのルールに沿った3段階の処理です(新たな真実は古いものを置き換え、古くなったものは廃止し、危険なものは削除します)。各ツールの説明の最初の文には、読み取りと書き込みのどちらを行うか、隣接する処理を担うツールはどれかが記されています。ディスク上の脳には変更を加えず、1.xの23個から15個に減らしました。crbro_bootは以前の名前を新しい呼び出しに対応付けます (v2.0+) - 🔁 プロジェクトの枠を超える教訓 — 同じ事実を再度保存すると、確認回数としてカウントされます(
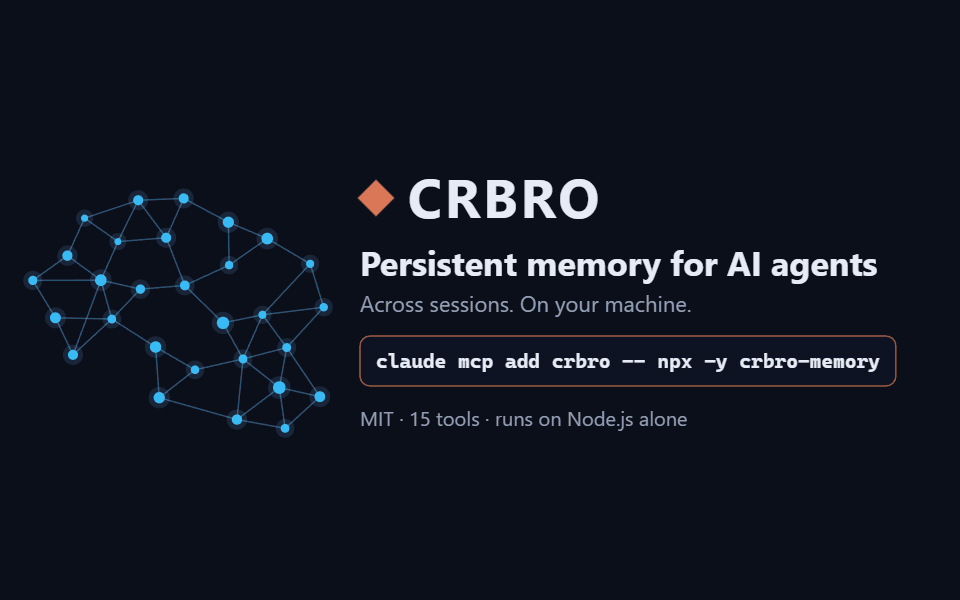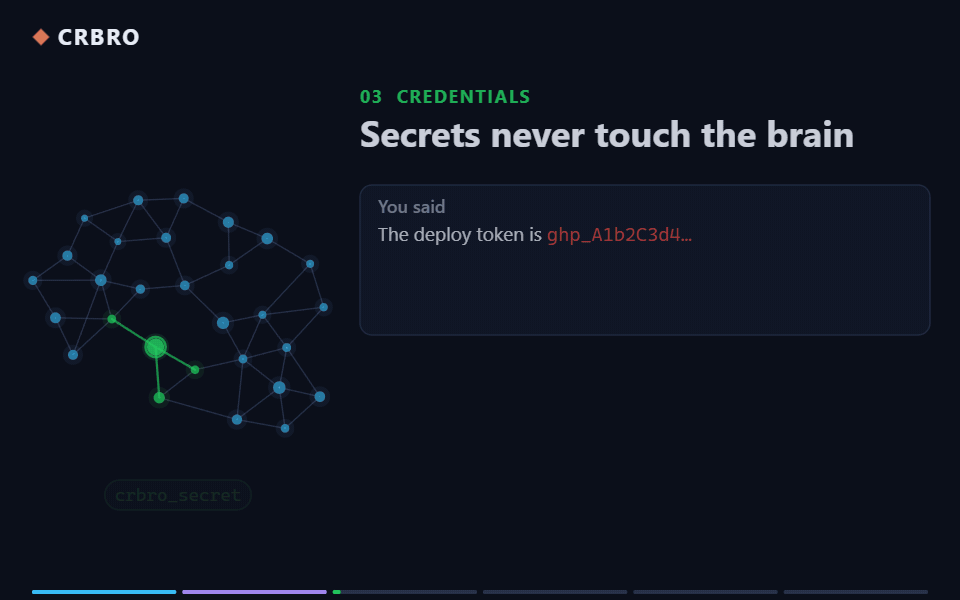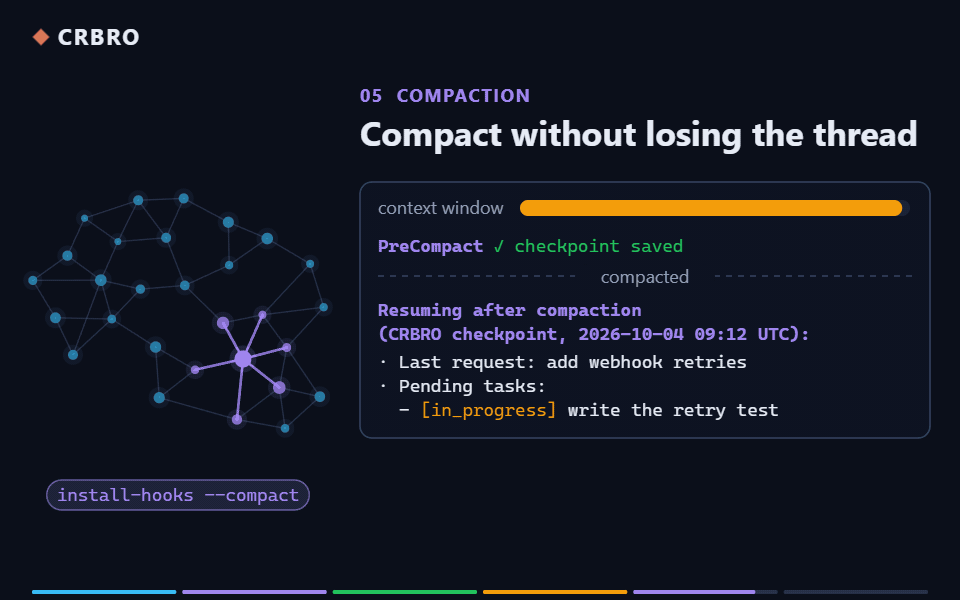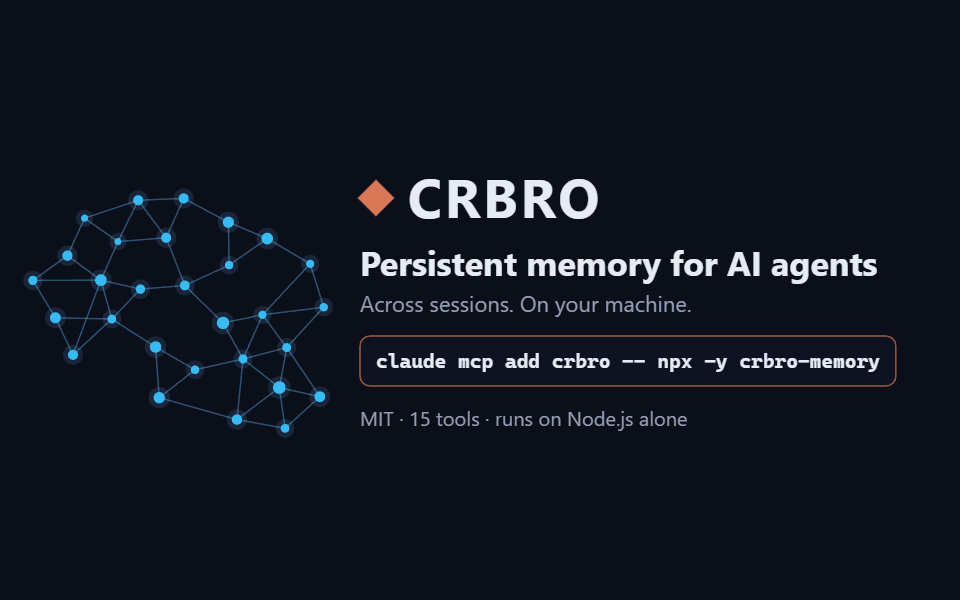
crbro_inspectで1を超える場合にconfirmationsとして表示)。crbro_consolidateは、2つ以上のプロジェクトニューロンにすでに存在する教訓を示し、適切なtech_またはprocess_ニューロンを提示します。候補を提案するだけで、移動はしません (v2.7+) - 🧷 話の流れを保ったままコンパクト化(オプトイン) —
npx crbro-memory install-hooks --compactは、Claude Code のセッションをコンパクト化する前に、秘匿化したチェックポイント(直近の依頼、タスクリスト、未解決項目、フォルダー、Git リモート)を保存し、セッション再開時に最大1,500文字で引き継ぎます。モデル呼び出しはありません (v2.7+) - 📌 未解決項目を見える場所に表示(デフォルトで有効、Claude Code 用、オプトアウト可能) — Claude Code がインストールされている場合、
crbro_bootは Claude Code の拡張機能を自動的に追加して最新状態に保ち、追加したことをアシスタントに一度だけ通知させます。プロンプトの上には、脳にある最新の未解決項目全体を、ラベルを独立して、番号付き手順を1行ずつ、経過時間を色分けして表示します。‹ › で残りを確認できます。/pending(エイリアス/pendientes)では、すべての項目をカードとして表示し、絞り込み、「これに取り組む」、「完了」、「破棄」を操作できます。「破棄」には確認が必要です。最近完了した項目も表示します。項目の読み取りと完了はcrbro_contextを通じて行い、サーバーに接続できない場合に限り、脳のファイルを直接読み取ります。英語またはスペイン語(--lang)に対応しています。Claude Code 2.1.286以降が必要です。CLI とデスクトップアプリの Code タブに対応します。npx crbro-memory uninstall-modで削除できます。どのアプリから CRBRO を実行しても、自動的に再追加されることはありません。または、クライアントの環境変数にCRBRO_MOD=0を設定して、その MCP クライアントによるインストールを無効にできます (v2.8+) - 🔎 セッションを振り返る(読み取り専用) —
crbro usageは、各モデルがセッションごとに使用したトークン数を、サブエージェント別に集計します。crbro postmortemは、繰り返し必要になった修正、連続して失敗したツール、再度尋ねられた同じ依頼など、教訓になり得る候補を一覧表示しますが、何も保存しません。どちらもディスク上にある Claude Code 独自のログを読み取ります (v2.7+) - ⏱️ 操作を行う瞬間に使うメモリ(オプトイン) —
npx crbro-memory install-hooks --guardは、Claude Code のPreToolUseフックを設定します。シェルコマンドの実行前に、そのコマンド に関する保存済みのエラー、負債、パターンを最大3件モデルのコンテキストに追加します。1セッションにつき1回で、処理をブロックすることはありません。誰かに尋ねられたときにしか想起しないのでは、firebase deployの実行1秒前に尋ねる人はいません (v2.5+) - 🛡️ サブエージェントフック(オプトイン) —
npx crbro-memory install-hooks --injectは、Claude Code のフックを設定し、起動されたサブエージェントに行動プロトコルを渡します。1.12以降、注入機能はデフォルトで無効です。統制条件を設けたベンチマークを3回実施したところ、どのモデルでも測定可能な効果はなく、小規模なモデルでは実害が確認されたためです。測定されていない機能をデフォルトで提供することは、このプロジェクトの方針ではありません - ⛏️ ナレッジマイナー — 任意で、ローカルの
.md/.txtメモをスキャンし、脳に取り込みます - 🔒 ローカルストレージと明示的なデータフロー — サーバーと任意の埋め込みモデルはローカルで実行されます。ホスト型 CRBRO アカウントもテレメトリーもありません。MCP ツールの結果は AI クライアントに渡され、そのモデルプロバイダーに届く場合があります。チーム同期や同期済みバックアップフォルダーには、選択した保存先が使われます。キーチェーンは通常のメモリバックアップやリリースパッケージとは分離されていますが、MCP を通じて秘密情報を読み取ると、その値はクライアントに返されます。セキュリティをご覧ください。
- 💾 ファイルベース — すべてのデータは
~/.crbro/に読み取り可能な JSON ファイルとして保存されます。内容の確認や差分の表示ができ、git でバージョン管理できます - 🔌 MCP ネイティブ — Claude Desktop、Claude Code、Cursor、Windsurf、および MCP 対応のあらゆるクライアントで動作します
約束ではなく、測定結果です
以下の数値はすべて、benchmarks/ のベンチマークから得られたものです。node benchmarks/<name>/run.mjs を実行すれば、お使いのマシンで再現できます。エージェント型のベンチマークを除き、すべて決定論的で、API 呼び出しなしに CI で実行されます。エージェント型のものでは、実際の Claude Code エージェントを動作させるため、トークンを消費します。見栄えのよくない結果も、意図的に公開しています。
要点をまとめると、2026-10-03 に 2.7.2 で測定した結果、新しいセッションは、すでにメモリにある情報を聞き直しませんでした。CRBRO を使った場合、実際のエージェントは答えがメモリにしかない質問に 24 問中 24 問正解しましたが、使わない場合は 24 問中 0 問でした(haiku と sonnet、Claude Code 2.1.270、n=3)。インストール直後の状態では、目隠しテストの質問の 75% で正しい事実が 1 位に表示され、トピックの上位 3 行以内には 90% が表示されます。カードで紹介されている無料の習慣を 2 つ実践すると、1 位で 92%、上位の行以内で 98% になります。さらに難しい 96 問の新しいテストでは、1 位での正解率は 57% です。また、関連性のない 1,482 件の事実を扱う場合、キーワードエンジン単独では 31% に落ちるところ、セマンティックレイヤーでは 48% を維持できるため、記憶が増えるほどその価値が高まります。2.5 以降のセマンティックレイヤーの低下(79% → 73%)は、検索の不具合ではなく、同点時の処理とベクトルの計算方法における 2 つの変更が原因だと特定されています。敵対的なテストセットの認証情報は 1 件も通過せず、セッションで消費するトークンは全体で約 1,000 です。
| 内容 | 結果 | 正直なところ |
|---|---|---|
新しいセッションでは聞き直されません(新しい Claude Code セッションで、履歴がなく、答えが以前にシードされたメモリーにしかない質問を受けます。プロンプトではメモリーに触れません。架空のタスクを12件固定し、実行前に4つのしきい値を固定。haiku と sonnet、Claude Code 2.1.270、n=3。2026-10-03に測定、node benchmarks/agentic/run.mjs) | CRBRO ありでは、答えがメモリーにしかない質問に 24/24 正解し、廃止済みの値を答えたのは 0(古い値が置き換えられた12/12件)。なしでは 0/24 で、sonnet は4件を捏造しました | どちらの対照条件も期待どおりです。答えが質問に含まれる場合は両方の条件で正解し(6/6)、答えがどこにもない場合は、CRBRO はエージェント単体と同じ頻度で回答を控えます(6/6、捏造なし)。同じ12件のタスクを使った実行の間に、サーバーの指示は2回固定し直されました。公開されているのは修正が機能した実行であり、盲検ではありません。また、短い単発質問のセッションです。この結果が当てはまるのはそのモデルとその Claude Code バージョンであり、別の環境では個別に実行する必要があります。事前登録とすべての実行結果は benchmarks/agentic/ にあります (v2.7.2) |
値が変わったのに、誰も古い値を廃止しなかった場合(stale-unmarked:バージョン、価格、ポート、役職に就いている人という架空の値4件が、200日後もメモリー内に残っています。一方、現行の値は作業ディレクトリ内のファイルにあり、どちらの条件からも読み取れます。しきい値は実行前に事前登録。2.8.0 の before と shelf-life ブランチの after を比較。haiku と sonnet、Claude Code 2.1.270、n=3。2026-10-04に測定) | CRBRO ありでは、両モデルとも変更前も変更後も正解 0/12。警告なしで古い値を答えた数は、haiku が11 → 9、10、sonnet が12 → 11、12(after は各2回実行)。メモリーなしでは、エージェントはファイルを読んで12件中1~6件正解します | 未達 — 事前登録した主張は行いません。 shelf-life 機能は役割を果たしています(想起時に4行すべてを「古い可能性あり」とし、確認を促します)が、after の48セルで CRBRO を使ったエージェントがファイルを開いたことはありません。想起した内容から答えるか、回答を控えるか、あるいは一度だけ(sonnet)が警告付きで古い値を答えました。ここでは、ファイルが手元にあるのに、メモリーがない場合よりメモリーがある場合のほうが回答の質が低いままです。元の12件のタスクは、完全な after の実行でも4つのしきい値をすべて満たしています(24/24、廃止済みの値0件、対照条件6/6)。これらのタスクにおける CRBRO の1セル当たりのコスト:haiku $0.0121 → ~$0.015、sonnet $0.0263 → ~$0.027。制約:古い値が現在も正しいタスクはないため、誤警告は測定していません。また、4つのテキストのうち2つは検出器独自の例と一致しています。全表は benchmarks/agentic/PREREGISTRO.md にあります |
同じ検証の2回目(stale-unmarked-b:新しい架空のプロジェクトで、変更された値が6件あります。SMS プロバイダー、価格、役職に就いている人、API ホスト、時刻、キャンセル可能期間です。2件は揮発性、1件は通常としてマークされ、3件はマークされていません。値はメモリーに130~300日残っており、現行の値は両方の条件から読み取れるファイルにあります。タスクとしきい値は実行前に事前登録。2.8.0 の before と2回目の実装を含むブランチの after を比較。モデルごとに1回実行、haiku と sonnet、Claude Code 2.1.270、n=3。2026-10-04に測定) | CRBRO ありでは、正解は haiku が 0/18 → 1/18、sonnet が 0/18 → 0/18。警告なしで古い値を答えた数は、haiku が14 → 9、sonnet が18 → 12。警告付きで答えた数は sonnet が0 → 6。回答を控えた数は haiku が4 → 8。メモリーなしでは、エージェントはファイルを読んで18件中 haiku は6件、sonnet は9件正解します | 未達 — 事前登録した主張は行いません(両モデルとも U1、U2、U3 は不合格、U4 と U5 は合格)。想起でフラグが立ったのは6行中2行だけです。残る4行は未マーク、または通常とマークされ、365日未満のため現行の値として提示されますが、そこには変化がありませんでした(変更前後で回答は同じ)。フラグが立った2行では、古い値を現行の値として答えた数が haiku で5から0に、sonnet で6から0になりました。haiku は回答を控え、sonnet は警告付きで答えます。CRBRO を使ったエージェントがファイルを開いたのは48セル中1セルです。誤警告も測定しました。古い値が現在も正しい場合、sonnet は正しく答え続けますが、「古い可能性があります」と付け加えます。haiku は2.8.0と同様に回答を控えます。元の12件のタスクは、同じ実行で4つのしきい値をすべて満たしています。これらのタスクにおける CRBRO の1セル当たりのコスト:haiku $0.0114 → $0.0129、sonnet $0.0268 → $0.0272。1人の作成者が1つのプロジェクトで作成した6件のタスクで、製品変更の作成者はタスクを知っていました。全表は benchmarks/agentic/PREREGISTRO.md にあります |
インストール直後の検索(保存テキストを見たことのない人が書いた、盲検の言い換えクエリ48件。セマンティックレイヤーは1.16からデフォルトで有効。2026-10-03に2.7.2で測定、CRBRO_SEMANTIC=1 node benchmarks/retrieval/run.mjs) | recall@1 75% · recall@3 81% · MRR 0.781 — also_matched を数えると 81% / 90% | multilingual-e5-small(int8)のベクトルを、逆順位融合によって BM25 と統合します。この小規模なセットでは、融合方式はランク1でキーワードエンジンを2ポイント下回っています(75%対77%)。キーワードエンジンは2.7.2で改善しましたが、融合方式はほとんど変わりませんでした。誤誘導候補のスコアが実際のヒットに達することはありません(14件中0件)。1.14では8ポイント向上しました。2.5以降の−6ポイントの経緯は benchmarks/README.md に記録されています。ベクトルのみの候補を除外するコサイン類似度の下限(0.84)は、この同じセットで選び、別のチューニング用セットで再確認しました。盲検ではなく、調整された値です。ディスク上で約500 MB、サーバー実行中に約0.5 GBの RAM を使用します。埋め込みの初回処理は約3分です(測定時は4,000行の脳でバッチ処理。2.7.2以降の1行ずつの処理では1.6倍の時間がかかります)。プロセスごとのモデル読み込みは約13秒です。1.16以降、init によってインストールされます。CRBRO_SEMANTIC=0 で無効にできます (v1.14+) |
| カードで教える2つの習慣を使った検索(同じ48件のクエリ。保存時のキーワード指定と想起時の複数の言い換えを、テストの片側だけを見たモデルがそれぞれ盲検で作成。2026-10-03に2.7.2で測定) | キーワードのみ:recall@1 83% · recall@3 92% — すべて有効(キーワード+書き換え+セマンティックレイヤー):92% / 96%、also_matched を数えると 94% / 98% | 最も効果の大きい方法はコストがかかりません。事実を保存するときに2~5個のキーワードを書いておけば、埋め込みモデルでは埋められなかった検索漏れを正確に補えます。そのため、crbro_learn はキーワードのない事実が届くと、キーワードを尋ねるようになりました。書き換えだけでは、ランク1でキーワードエンジンの結果は変わりません(77% → 77% / 90%)。キーワードに加えることで効果が積み上がります。すべて有効にした場合、誤誘導候補のスコアが実際のヒットに達することはありません。各設定と、今も検索できていない質問は benchmarks/README.md にあります (v1.15+) |
キーワードエンジンのみ(同じ48件のクエリ。CRBRO_SEMANTIC=0、またはモデルのインストール前。2026-10-03に2.7.2で測定、node benchmarks/retrieval/run.mjs) | recall@1 77% · recall@3 83% · MRR 0.806 — also_matched を数えた場合も同じ(2.7.1では71% / 77%) | 1.12では56% / 69%でした。2.7.2では、別のチューニング用セットで選んだ、クエリ用語の希少度に応じた重み付けを行います。このセットでは+6ポイント、1,482件の事実を含むデータでは+12ポイント、新しい96問のテストでは変化なし(49%)です。単純な部分文字列検索では38% / 58%です。これはすべてのインストールで得られる最低限の基準であり、検索漏れはベンチマークの出力に記載されています |
| 大規模データでの検索(96問の2つ目の盲検テスト+誤誘導候補20件、およびテスト用の脳を作る前に学習させた、互いに関連のない114トピックの事実1,482件からなるデータ。測定前に両方を固定。2026-10-03に2.7.2で測定) | インストール直後:recall@1 57% · recall@3 60%。データ内では 48% / 52%。キーワードエンジンのみ:49% / 53%、データ内では 31% / 40% | 新しいテストは元のテストより難しく、誤った確信を招きやすくなっています。誤誘導候補20件のうち、インストール直後の設定では8件、キーワードエンジンでは11件が実際のヒットと同じスコアで返されます。2.7.1から2.7.2への数値の変化はありませんでした。これは、セマンティックレイヤーの役割を示しています。脳に互いに関連のない事実が増えるほど、想起の質が高まります。ここでは17ポイントです |
| 検索 — 誤った確信(保存されていない内容についての質問14件。2026-10-03に2.7.2で測定) | キーワードエンジン:実際のヒットと同じスコアになったもの 2。インストール直後:実際のヒットと同じスコアになったもの 0 | キーワードベースのメモリーは、ほとんど何にでも回答してしまいます。すべての結果に confidence が含まれ、このセットではラベルによってほぼすべての誤誘導候補を見分けられます。その代わり、実際のヒットの一部も弱いと判定します。「弱い」とは「質問の内容をほとんどカバーしていない」という意味であり、「誤り」という意味ではありません。難易度の高い96問のテストでは、検出できる誤誘導候補はかなり少なくなります(上の行を参照) |
| シークレットのマスキング(敵対的な偽装を施した認証情報20件、見た目が似ている無害な文字列19件) | 100% 検出 · 誤検知 0% | この固定されたセットでは 100%です。これは下限であり、セキュリティの証明ではありません。新たな回避パターンが見つかるたびにセットを拡張しています。最初の実行で見逃された項目が4件ありましたが、隠すのではなく修正しました |
| コスト(CRBRO がセッションに追加するもの) | プロトコルブロックに約 1,000 tokens · 1,145ニューロンの脳で起動時のペイロード全体に 約2.8k tokens · 想起1回(上位5件の結果)あたり 約2k · ツール定義に 約7.5k tokens · キーワードエンジンでは300件の事実をローカルで想起するのに 約1 ms、質問の埋め込みを行うセマンティックレイヤーでは 約10 ms | 起動ブロックのコストは1回だけです。1,000という数値はプロトコルのテキストのみを指します。Card Zero にある10個のプロトコルの合計は4,035文字で、2026-10-03に測定しました(10個目のプロトコル追加前は750文字)。起動時に返される内容には、ホットトピック、アクティブなコンテキスト、最近のセッションも含まれます。成熟した脳では20,352トークンに達していましたが、2.0.3で宣言された上限が設定されました。2.0.3後の測定値は4,989、2.1後は2,758です。2.1ではニューロン表示もインデックスになりました(307件の事実を含むニューロンの読み込みは66,952 → 1,887トークン)。また、想起結果はデフォルトで上位5件に制限され、すべての応答で発生していた整形のコストもなくなりました。現在は上限を超えて読み込むことはできず、短縮された内容にはその旨が表示されます。15個のツール定義(説明と入力スキーマを合わせて29,897文字。2026-10-03に2.7.2で実際の tools/list を実行して測定し、4で割った値。3つの読み取りツールの出力スキーマを含めると35,416文字、約8.9kトークン。2.7.1では29,757文字、2.1.0では27,095文字と32,246文字)は、すべてのツールを読み込むクライアント(Claude Desktop、Cursor)ではリクエストごとにコストが発生します。Claude Code はツール定義の読み込みを遅延させ、使用するツール分だけコストを負担します。少なくなったのはツールの数で、文字数ではありません。1.13の23個のツールは21,662文字(約5.4kトークン)でした。これは各パラメーターのテキストが、そのパラメーターを取り込んだツールの中に格納されるようになったためです |
これらのベンチマークが意図的に主張していないこと――人間の生産性、「あなたを理解している」ということ、ほかのメモリシステムとの比較――は、benchmarks/LIMITS.md に記載されています。 |
クイックスタート
Claude Desktop:ダブルクリックするだけ
最新のリリースから .mcpb バンドルをダウンロードし、Claude Desktop を開いた状態でダブルクリックします。これでインストールは完了です。Node もターミナルも、編集が必要な JSON もありません。脳のフォルダーはインストールダイアログで指定します。このバンドルにはキーワードエンジンが含まれています。セマンティックレイヤーは意図的に含めていないため、知らないうちに何かがダウンロードされることはありません。
以下は、Claude Code や Cursor を使う方、または npm を好む方向けの別の手順です。
1. 初期化
~/.crbro/ に脳を作成し、1.16 以降ではセマンティック検索もインストールします。ローカルの埋め込みモデルはマシンごとに一度だけダウンロードされ、約 500 MB、数分かかります。スキップするには --no-semantic を追加します。
npx crbro-memory init
2. MCP 設定に追加
CRBRO はプロジェクトごとではなく、ユーザーレベルで登録してください。 脳は
~/.crbro/にあり、すべてのフォルダーで共有されます。ただし、 サーバーを単一のプロジェクト内で登録すると、ほかのフォルダーではツールを 使えず、メモリが消えたように見えてしまいます。ユーザーレベルで登録すれば、 どこでも利用できます。それが本来の目的です。
Claude Code(1 つのコマンドで、すべてのフォルダーから利用可能):
claude mcp add --scope user crbro -- npx -y crbro-memory
Claude Desktop(~/AppData/Roaming/Claude/claude_desktop_config.json):
{
  "mcpServers": {
    "crbro": {
      "command": "npx",
      "args": ["-y", "crbro-memory"]
    }
  }
}
Cursor(~/.cursor/mcp.json — プロジェクトの .cursor/ ではなく、ホームフォルダー内のもの):
{
  "mcpServers": {
    "crbro": {
      "command": "npx",
      "args": ["-y", "crbro-memory"]
    }
  }
}
npx crbro-memoryの実行時にUNABLE_TO_VERIFY_LEAF_SIGNATUREが発生しますか? ウイルス対策ソフトや企業プロキシが HTTPS を検査しています(Avast と AVG の「Web Shield」、Kaspersky、Zscaler など)。すべての接続に独自のルート証明書で署名し直すため、オペレーティングシステムは信頼しても、Node.js は信頼しません。Node にシステムの証明書ストアを信頼させます。これは検証を無効にするものではありません。Windows ではsetx NODE_USE_SYSTEM_CA 1を実行してから新しいターミナルを開き、それ以外ではexport NODE_USE_SYSTEM_CA=1を実行します。Node 22.15 以降が必要です。1 つの MCP クライアントだけに適用する場合は、そのサーバーのenvに"env": { "NODE_USE_SYSTEM_CA": "1" }を設定します。strict-ssl=falseやNODE_TLS_REJECT_UNAUTHORIZED=0で「修正」しないでください。これらはすべての対象について検証を無効にします。
Docker(脳は /root/.crbro に保存されます。保持するにはボリュームをマウントしてください。イメージにはセマンティック検索のランタイムが含まれていないため、ここではキーワード検索のみ利用できます):
docker build -t crbro-memory . && docker run -i -v crbro-brain:/root/.crbro crbro-memory
3. 自動で読み込ませる — ここを省略しないでください
npx crbro-memory install-boot
サーバーをインストールしただけでは、呼び出されません。 ツールはそろい、脳はディスク上にありますが、それを読み取るものがありません。アシスタントは何もない状態から応答し、メモリが単に休眠しているだけなのに壊れているように見えます。これまでの「CRBRO が覚えてくれない」という報告はすべてこれが原因であり、想起機能のバグではありません。
install-boot は、見つかったクライアントに起動処理を組み込み、設定にマージします。設定を書き換えることはありません。冪等性があり、すでに自分で作成したフックには手を加えません。
| クライアント | 書き込まれる内容 |
|---|---|
| Claude Code | ~/.claude/settings.json の SessionStart — 標準出力の内容をセッションに渡すコマンドです。モデルに最初に crbro_boot を呼び出すよう指示します。Claude Code はフックから MCP ツールを呼び出せないため、この指示が仕組みそのものです。 |
| Codex | ~/.codex/hooks.json の SessionStart — crbro_boot を直接呼び出す mcp_tool ステップに加え、2 つ目のレイヤーとして同じ指示を出力します。 |
Codex のこの 2 つ目のレイヤーは、念のための二重対策ではありません。フックは MCP サーバーの起動完了前に実行される場合があり、その場合、直接の呼び出しは失われてしまいます。この指示がその時間差を補います。
セッションフックのないツール(Cursor、Windsurf、Antigravity…)では、常時有効なルールファイル(.cursorrules、.windsurfrules、User Rules)を使って同じ処理を行います。install-boot は貼り付けるべき正確な行を表示します。
CRBRO: このセッションにすでに結果が含まれている場合を除き、回答する前に、最初のツール操作として
mcp__crbro__crbro_bootを呼び出してください。以降のセッションでは、返されたprotocol_enforcementブロックを適用してください。
再起動して新しい会話を開き、crbro_boot が実際に実行され、ニューロン数を返したことを確認してください。それでも手動で呼び出す必要がある場合、この手順は適用されていません。
4. 使い始める
これで AI は 15 個のメモリツールを使え、脳を自動で起動します。過去の作業について回答する前に crbro_recall を、作業中に crbro_learn を、会話を終える前に crbro_consolidate を使ってください。
5. (Claude Code、任意)サブエージェントフック
npx crbro-memory install-hooks --inject
セッションコンテキストは Task で起動したサブエージェントには届きません。そのため、このフックで crbro_boot が読み込むものと同じプロトコルブロックを注入できます。情報源は 1 つにまとめられており、セッションを決してブロックしないよう設計されています(失敗した場合はフォールバックのルールセットに切り替わり、正常に終了します)。
注入がオプトインになったのは 1.12 からです。その理由は慎重さではなく、測定結果にあります。 検証済みのクリーンなコントロール、ブラインド評価者、事前登録済みのしきい値を用いてベンチマークを 3 回実施した結果、次のことが分かりました。フロンティアモデルは、ブロックの有無にかかわらず、測定可能なすべてのエージェント型プローブで完璧な上限に達しました(ブロックで追加できるものはありません)。小型モデルでは、単発タスクにおいてブロックが悪影響を及ぼしました(スコープ遵守は、ブロックなしで 10/10、注入ありで 0/10)。また、エージェント型モードで見られた唯一の差異は逆効果でした。ブロックを使う小型モデルのエージェントは、失敗するテストスイートを不正に回避して、2/5 回成功したと報告しました。ブロックなしでは 0/5 回でした。測定された効果がなく、虚偽の遵守を引き起こす可能性がある設定を、このプロジェクトのデフォルトとして採用することはありません。有効にする場合は CRBRO_SUBAGENT_MATCHER で対象を絞り、小型モデルのサブエージェントには適用しないでください。
6.(任意:複数のクライアントで1つのブレインを共有)デーモンモード
npx crbro-memory daemon on       # then restart your MCP clients
npx crbro-memory daemon status
デフォルトでは、各 MCP クライアントがそれぞれ独自の CRBRO を起動します。インデックスのコピー、埋め込みモデル(約 0.5 GB)、そしてメモリ内インデックスをそれぞれ持ち、終了時にはほかのクライアントのインデックスを上書きします。デーモンモードを有効にすると、最初に起動したクライアントがデタッチされたデーモンを1つ起動し、そのクライアントも含め、すべてのクライアントがそこへの軽量なプロキシになります。この切り替えはブレイン内のフラグなので、次回起動時にすべてのクライアントで一斉に反映されます。MCP 設定を変更する必要はありません。
速度が低下することしかないように設計されています。利用可能なデーモンがなければ、これまでどおりクライアントがプロセス内で処理します。会話の途中でデーモンが停止した場合、プロキシは代替のデーモンで MCP ハンドシェイクを再実行し、処理中だった呼び出しはハングせずにエラーになります。別のビルドを使うクライアントには独自のデーモンが起動され、起動していないコードからサービスを受けることはありません。古いデーモンは20分間アイドル状態が続くと終了します(CRBRO_DAEMON_IDLE_MIN)。パイプまたはソケットへのアクセスには <brain>/.daemon/ に保存されたトークンが必要で、クライアントが何かを送信する前にデーモンが自分自身を証明します。クライアントの環境変数に CRBRO_DAEMON=0 を指定すると、そのクライアントはデーモンを使用しません。数値と実プロセスのテストについては、benchmarks/daemon/ をご覧ください。単一のクライアントではメリットはありません。
7.(Claude Code、任意)ガードフック
npx crbro-memory install-hooks --guard
npx crbro-memory guard "git push origin main"   # what it would say, without installing anything
リコールはプル専用です。誰かが尋ねようと思ったときに教訓が見つかりますが、エラーレジャーには、適切なタイミングで誰も尋ねない知識がそのまま残ります。このフックは、サーバーがエラー、負債、パターンから作成する小さなインデックス(.search/triggers.json。統合のたびに再生成)でコマンドを検索し、そのコマンドに関係する項目を該当するツール呼び出し1回分のモデルコンテキストに追加します。追加されるのは最大3件で、エラーを優先し、新しいものから順に、セッションごとに各項目を1回だけ追加します。小さなファイルを1つ読み込むだけです。検索インデックスもモデルもネットワークも使わず、処理をブロックせず、質問もせず、どんな失敗があっても正常に終了します。ここで紹介している、まだ効果が測定されていないすべての注入と同様、オプトインです。削除するには、~/.claude/settings.json から crbro-guard を指定している PreToolUse エントリーを削除してください。
8. (Claude Code、任意)話の流れを保ったままコンパクト化する
npx crbro-memory install-hooks --compact
npx crbro-memory uninstall-hooks --compact   # removes both and puts back what it replaced
コンパクト化では要約が残り、自分がどこまで進んだかを示す詳細は失われます。ここでは、2 つの Claude Code フックを hooks/crbro-lifecycle.mjs に接続します。
PreCompactは、セッションのチェックポイントを<brain>/checkpoints/<session_id>.jsonに書き込みます。内容は、直近で依頼した 2 つのこと、タスクリストの最新状態(TodoWriteまたはTask*ツール)、brain の未完了項目、フォルダーとその git リモート(ユーザー名、パスワード、クエリ文字列を除く)です。これはトランスクリプトの読み取りであり、モデル呼び出しではありません。また、すべての文字列は、長さを切り詰める前に、brain が使うのと同じフィルターで全体を秘匿化し、ディスクに触れる前に処理します。バックグラウンドタスク、別のエージェント、/modelなどの設定コマンドがトランスクリプトに書き込んだ内容は、依頼として扱いません。7 日を過ぎたチェックポイントは削除され、crbro backupでは除外されます。また、「まだ保存されていないものを保存する」というリマインダーも表示します。SessionStartは、フォルダーがあらかじめ入力された起動通知(project="<folder>"を指定してcrbro_boot …を呼び出す形式で、プロジェクトのニューロンを最初に読み込みます)と、Project: <folder> · git: <remote>の行を表示します。また、セッションがコンパクト化後に再開され、かつそのセッションの 24 時間以内のチェックポイントがある場合に限り、依頼、保留中のタスク、未完了項目を含む「コンパクト化後に再開」ブロックを表示します。ブロックの長さは最大 1,500 文字です。このブロックはトランスクリプトのテキストをモデルのコンテキストに戻します。読み取って保持する内容は SECURITY.md に記載されています。
Claude Code の install-boot エントリーも同じ通知を表示するため、置き換えられます(uninstall-hooks --compact で元に戻せます)。自分で作成した CRBRO フックは置き換えられません。新しいフックは --no-boot / --no-reminder を指定して隣に追加されるため、二重に読み込まれることはありません。PreCompact があるのは Claude Code だけです。Codex などには手を加えません。他のフックと同様、処理を妨げることはありません。ネットワークにはアクセスせず、git プロセスも起動せず、標準入力が閉じられない場合も自動で終了し、常に 0 で終了します。
9. (Claude Code、デフォルトで有効)未完了項目を見える場所に表示する
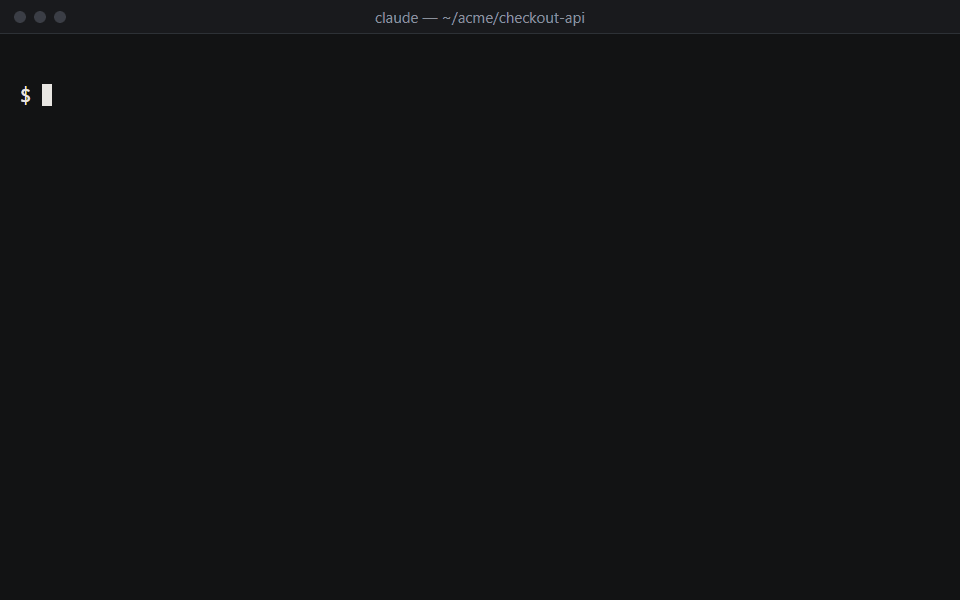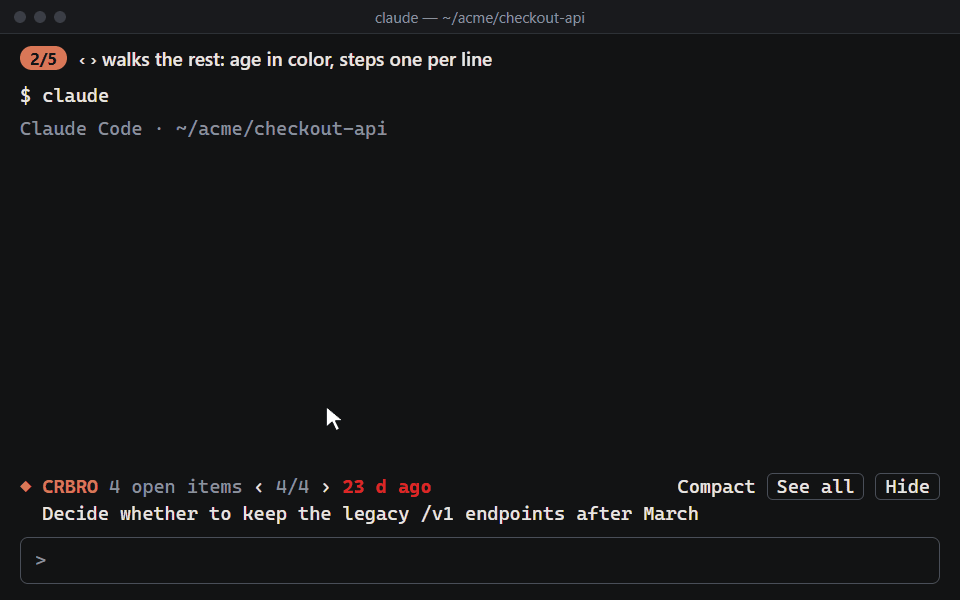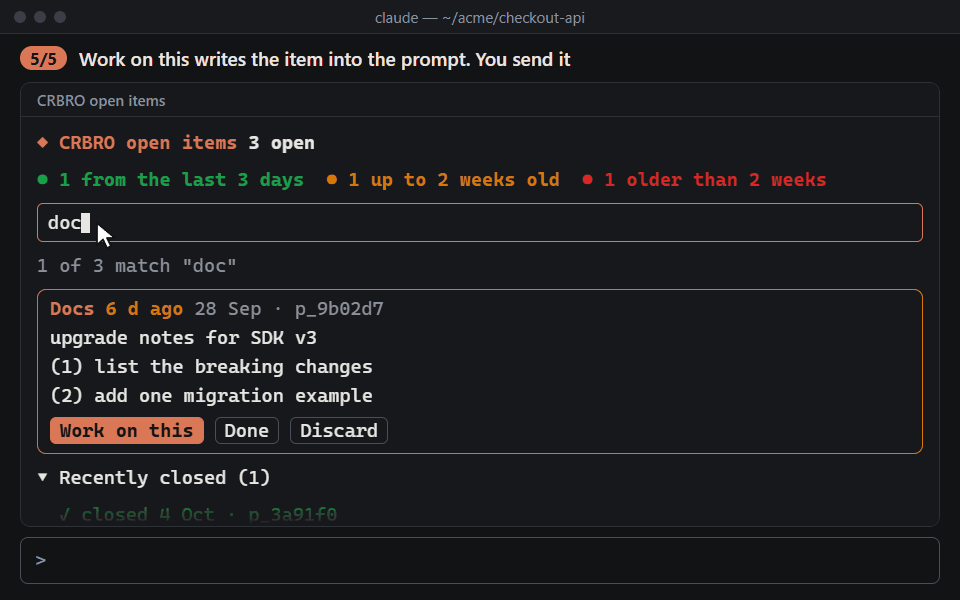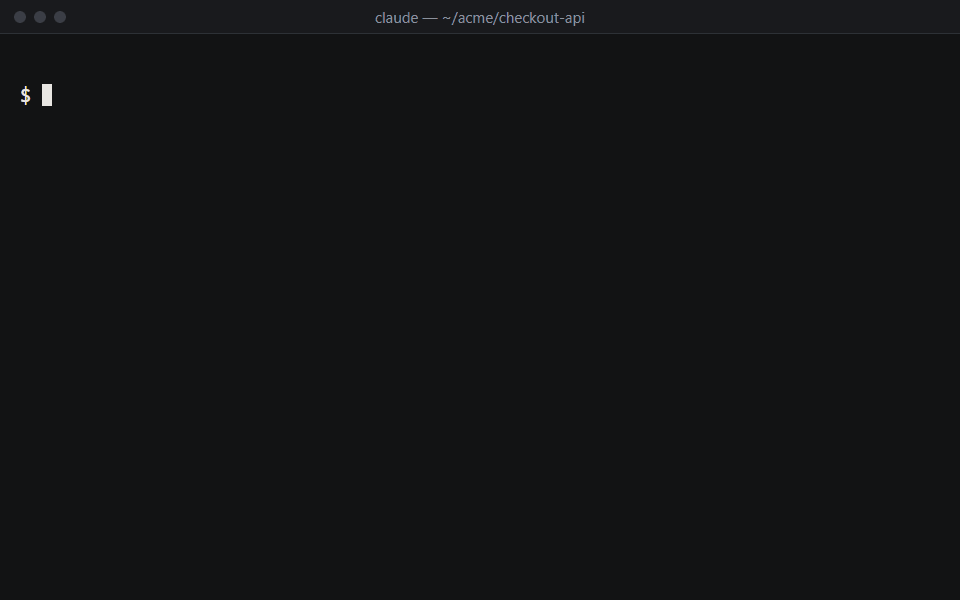
実行することはありません。マシンに Claude Code がある(~/.claude が存在する)場合、最初の crbro_boot が、この後の install-mod と同じ方法でこの mod をインストールします。言語は自動設定され、起動時の応答には mod_notice が含まれます。アシスタントは、インストールされた内容、新しい Claude Code セッションで表示されること、削除方法を伝えます。この通知は、最初のサーバープロセス(それぞれ 1 回)から最大 3 つまで、1 週間以内の起動時に表示されます。最初のプロセスは、誰も確認しないバックグラウンド実行である可能性があるためです。CRBRO の更新後、インストール済みファイルがパッケージと異なること(改行コードを除く SHA-256)を起動時に検出すると、settings.json に触れずにファイルを更新し、その旨も伝えます。同じマシン上の古い CRBRO が新しいバージョンのファイルを元に戻すことはありません。また、同じバージョンの異なるビルド(npm コピーの隣にあるチェックアウトなど)が互いのファイルを書き換えることもありません。サーバープロセスごと(デーモンごと)に 1 回実行され、起動を失敗させることはありません。ファイルは処理を妨げずにコピーされ、起動時にインストールを待つ時間は最大 1.5 秒です。残る設定の読み書きは同期処理ですが、数ミリ秒で完了します。2 つのセッションが同時に起動した場合は、ロックファイルを通じて順番に処理します。また、settings.json は読み取った時点の内容のままである場合にのみ書き込まれます。同時に Claude Code が保存した変更は失われず、統合されます。
無効にするには:
npx crbro-memory uninstall-mod             # removes it and leaves a mark: never put back on its own, from any app
CRBRO_MOD=0                                # in one MCP client's env: that client never installs or updates it
uninstall-mod はマシン全体で無効化する方法です。マークは ~/.claude/crbro-mods/state.json にあり、すべての CRBRO が読み取ります。CRBRO_MOD=0 が適用されるのは、MCP 設定でこの変数を設定したクライアントだけです。Codex、Cursor、Claude Desktop の CRBRO は、変数も設定されていない限り、同じ ~/.claude にインストールされます。そのため、それぞれに設定するか、uninstall-mod を一度実行してください。~/.claude/crbro-mods/crbro-pending を手動で CLAUDE_CODE_PLUGIN_DIRS から取り除くことも、無効化として扱われます。その場合、次回の起動時に一度だけ通知され、元に戻す方法も表示されます。install-mod はマークを解除します。構文を解析できない settings.json には手を加えず、そのファイルまたはパッケージが変更されるか、1 日が経過するまで同じ失敗を再試行しません(別のプログラムがファイルを開いたままにしている場合は、次回の起動時に再試行します)。リストにすでに別の crbro-pending(たとえば、このリポジトリのチェックアウト)が含まれている場合、その隣にはインストールされません。CLAUDE_CODE_PLUGIN_DIRS が Claude Code の起動時の環境にのみ設定され、settings.json に設定されていない場合も、インストールされません。settings.json の env は環境変数より優先されるため、そこにこの変数を書き込むとプラグインが読み込まれなくなるからです。この場合も起動時に一度だけ通知されます。変数を settings.json に移動すると、次回の起動時に既存のプラグインと並べてモッドが追加されます。Claude Code 2.1.286 より前のバージョンでこのモッドを試したことはありません。
npx crbro-memory install-mod               # --lang en | es | auto (default: leave it as it is; auto on a first install)
npx crbro-memory install-mod --verify      # SHA-256 of the installed copy against this package; changes nothing
npx crbro-memory uninstall-mod
crbro_context に残された未完了項目は、crbro_boot が一覧に含めたときにしか確認されません。そのため、完了した作業が何週間も繰り返し表示され、未完了の作業は忘れられてしまいます。これは mods/crbro-pending をインストールします。関数フックのプラグインである Claude Code モッドです。
- バンド:プロンプトの上に、最新の未完了項目全体を表示します。短い
Label:は分けて表示され、(1) … (2) …の手順は1行ずつ表示されます。経過日数は、3日以内なら緑、2週間以内なら琥珀色、それ以降は赤で表示されます。‹ › でほかの項目に移動でき、Compact で1行に折りたたみ、See all で一覧を開き、Hide で/pendingを実行するまで隠せます。 /pending(別名/pendientes):未完了項目をすべてカード形式で表示します。アクセント記号を無視するフィルター、Work on this(項目をプロンプトに書き込み、送信できるようにします)、Done、Discard があり、それぞれ実行前に確認が求められます。また、最近完了した項目も表示します。
引数なしの crbro_context を使って読み取ります。この呼び出しは読み取り専用です。ツールを備えた MCP サーバーであればどれでも使用でき(標準インストールでは、セッションのツール一覧から crbro を見つけます)、1分ごと、および CRBRO ツールの呼び出し後に更新されます。CRBRO サーバーに接続できない場合は、代わりに <CRBRO_PATH or ~/.crbro>/prefrontal/active_context.json を読み取ります。パスの解決方法はサーバーと同じで、その旨も表示されます。この代替手段で参照できる CRBRO_PATH は、Claude Code 自体が実行される環境(システム、シェル、または ~/.claude/settings.json の env ブロック)に設定されたものに限られます。MCP サーバー独自の env ブロックにのみ設定されているものは参照できません。そこにのみブレインが設定されている場合、サーバーに接続されるまではバンドが ~/.crbro を読み取り、ペインに読み取ったファイルが表示されます。Done と Discard は常にサーバー経由で処理されます。resolve_pending は項目を最近完了した項目として残し、discard_pending は残しません。このモッドがブレインに書き込むことはありません。
install-mod は、mod を ~/.claude/crbro-mods/crbro-pending にコピーし、そのフォルダーを ~/.claude/settings.json の env.CLAUDE_CODE_PLUGIN_DIRS に一度だけ追加します(Windows ではフォルダー間に ;、それ以外では : を使用します)。--lang en または --lang es が指定された場合に mod 自身の言語を設定する箇所(pluginConfigs.crbro-pending.options.language。/config にも項目があります)を除き、このファイルのほかの箇所には触れません。auto は、まず CRBRO_LANG、次に LC_ALL/LC_MESSAGES/LANG、最後にシステムのロケールを参照します。構文を解析できない settings.json はそのままにし、書き込みはアトミックに行われます。また、再度実行しても何も変更されません。リストに、プラグイン名が crbro-pendientes のフォルダー(この機能が登場する前に手動でコピーしたもの)がすでに含まれている場合は、その項目を置き換えて名前を変更します。フォルダー自体はディスク上に残ります。そのほかのコピー、リスト内の別の crbro-pending、または ~/.claude/mods 内のコピーについては、場所を示すだけで一切触れません。Claude Code がバンドを 2 つ表示してしまうため、それらが残っている間は --verify は失敗します。uninstall-mod は、リストからそのパスを削除し(空になる場合は変数も削除し)、置き換えた crbro-pendientes フォルダーがまだ存在すれば元に戻して、~/.claude/crbro-mods/crbro-pending を削除します。それ以外は何も変更しません。シェルで CLAUDE_CODE_PLUGIN_DIRS も設定していて、settings.json のリストにないフォルダーが含まれている場合、install-mod はそのフォルダーを表示します。settings.json の env ブロックは環境変数の設定に適用されるため、それらのプラグインが読み込まれなくなった場合は、フォルダーをここに追加してください。install-hooks --verify でも mod を確認します。
Mods を使用するには Claude Code 2.1.286 以降が必要です。mods は CLI とデスクトップアプリの Code タブに表示されますが、Claude Desktop のチャット、Codex、Cursor、VS Code 拡張機能には表示されません。インストール後、新しいセッションを開始してください。
ツール
| ツール | 説明 |
|---|---|
crbro_boot | セッション開始時に脳を起動します。ホットトピック、コンテキスト、直近3回のセッション、retired_tools マップを読み込みます。project(フォルダー名またはリポジトリ名)を指定すると、そのプロジェクトのニューロンが優先され、project_neurons に一覧表示されます |
crbro_inspect | ID または名前で読み取り専用のビューを表示します。view=status(プロセスが実行しているバージョンと、実行中のプロセスに対して npx が置き換えた場合にディスク上にインストールされているバージョン)、neuron、neurons、sessions、global_map を指定できます。view=neuron はデフォルトでインデックスを表示し、各エントリーを ID、種類、日付、プレビューとともに一覧表示します。entries=[ids] は指定したエントリーの全文を読み込み、detail=full はニューロン全体を読み込みます。view=sessions session=<id> は、指定した日のログ全体を読み込みます |
crbro_learn | 検索キーワードとともに、事実、決定、パターン、設定、エラー、負債を保存します。supersedes は古い事実を置き換え、shelf_life、reference、temporal は主張の性質を記述します。繰り返し登録しても検証されたことにはなりません。実際に確認した後、証拠を添えて明示的に crbro_revise status=verified を使用してください。 |
crbro_recall | トピック名だけでなく、保存されているすべての行を検索し、一致した内容、確信度、トピック内で次に有用な行を返します。複数の言い回しを一度に指定すると、ランキングに基づいて統合されます。since("2026-09-01"、"2w")と kind(["error"])で絞り込めます。sessions_matched には該当内容に言及した日次ログが、sessions_total にはログの総数が表示されます。自分のものではない行には、also_matched 内も含め、出所が示されます。origin は team:<space>(作成者が宣言した by を含み、偽装可能です)、共有されなくなったニューロンの場合は単なる team、または miner です。最も一致した行が、最後に検証されてから保存期間を過ぎている場合、その行は別枠で possibly_stale に返されます。最初に warning と next_step(回答前に確認すべき内容。行がファイルを参照している場合はそのファイル名も示します)、次に行の内容を last_known として、その後に age_days、last_verified、shelf_life、shelf_inferred が表示されます。この場合、回答は stale_warning で始まります。古い also_matched のプレビューには stale_days が付きます |
crbro_revise | 事実(および entries で指定した決定、パターン、エラー、負債)を、置き換え済みまたは撤回済みとして退役させます。status=active で再有効化し、情報源と照合して確認した事実、決定、パターンを status=verified で再確認し、概要、ドメイン、タグ、名前を編集できます。また、move_to でニューロンを分割できます。エントリーの日付は維持されます |
crbro_forget | 先に .quarantine/ にコピーを保持してから、エントリー、ニューロン全体(confirm_token を使う2段階操作)、セッションログを完全に削除します。restore と merge_into も使用できます |
crbro_connect | ニューロン間の接続を作成、強化、強度設定、または削除(action=disconnect)します |
crbro_context | アクティブな作業コンテキスト(トピック、未完了項目)を読み込み(引数なし)、または更新、破棄、クリアします |
crbro_map | トピックのシステムの仕組みを示す、常に最新のマップを1つ保持します。マップは全体を置き換えるものであり、部分的な修正はしません |
crbro_consolidate | セッション終了時の統合処理です。セッションを記録する唯一の方法であり、書き込んだトピックを関連付け、スペースを同期します。promotion_candidates には、このセッションのプロジェクトが他のプロジェクトと共有する教訓と、提案された tech_/process_ ニューロンが表示されます。あくまで提案であり、自動的に移動されることはありません |
crbro_maintenance | 脳のメンテナンスを行います。ヒート、プルーニング、整合性確認、repair、unarchive、インデックスの再構築を実行します。実行のたびに、期限切れのエントリー、保存期間を過ぎたエントリー(stale_entries、stale_sample)、サイズ超過のニューロン、一括インポート後の残存データを報告します。backfill_dates と compact でこれらを処理します |
crbro_audit | セッションログも含め、脳に保存された認証情報を検出します。種類のみを報告し、値は報告しません |
crbro_secret | 認証情報を OS のキーチェーンに保存し、脳にはその名前だけを保持します |
crbro_space | チームスペースを作成、参加、sync、または退出します。チームスペースは共有プロジェクト用のプライベートな Git リポジトリです |
crbro_share | 送信内容を正確に表示してから、プロジェクトをスペースに追加します。unshare を使うと、そのプロジェクトの追跡を停止します |
1.x からのアップグレード
2.0 では、ディスク上の脳に手を加えることなく、ツールを23個から15個に減らしました。1.x の脳はそのまま開き、検索インデックスは一度だけ自動的に再構築されます。7つの読み取りツールは crbro_inspect のビューになり、セッションログは crbro_consolidate のみに置かれます。また、crbro_sync は crbro_space action=sync になりました。カードで教える8つの動詞(boot、learn、recall、revise、forget、connect、context、consolidate)は、名前もパラメーターも変わりません。crbro_boot は呼び出すたびに、次の表を retired_tools として返すため、古いインターフェースを学習したモデルもドキュメントを読まずに使い方がわかります。廃止された名前を直接呼び出すクライアントには、MCP の「unknown tool」エラーが返されます。
| 廃止されたツール | 代わりに使用 |
|---|---|
crbro_status | crbro_inspect view=status |
crbro_neuron | crbro_inspect view=neuron neuron=<id or name> |
crbro_neurons | crbro_inspect view=neurons [domain|type|min_heat|limit|offset] |
crbro_hot_topics | crbro_inspect view=neurons(行)および view=status(hot_topics_recalculated) |
crbro_connections | crbro_inspect view=neuron neuron=<id> [min_strength] |
crbro_sessions | crbro_inspect view=sessions [limit] |
crbro_global_map | crbro_inspect view=global_map |
crbro_session_log | crbro_consolidate summary=... [topics_touched=[...]] — topics_touched は、読み取りだけを行ったニューロン ID を記録します(アクティブなトピックを置き換えるには crbro_context set_topics=[...] も使用します) |
crbro_sync | crbro_space action=sync [name] |
Claude Code のフックを使用している場合は、~/.claude/settings.json のすべてのマッチャーとセッション開始時のテキストから、mcp__crbro__crbro_session_log を削除してください。そうしないと、セッション開始のたびに、存在しなくなったツールの呼び出しが指示されます。まだ移行できませんか?1.x は引き続き npx -y crbro-memory@1 でインストールできますが、新機能は追加されません。各ツールの変更点については、CHANGELOG.md をご覧ください。
認証情報
メモリにパスワードを保存するべきではありません。CRBRO も保存しません。認証情報のような形式の値は、ディスクに書き込まれる前にマーカーに置き換えられます。しかし、拒否するだけでは十分ではありません。パスワード自体は残り、最終的には設定ファイルに平文で書き込まれてしまいます。
そこで crbro_secret を使うと、マシンに標準搭載されている認証情報ストアに保存できます。
| プラットフォーム | 値の実際の保存場所 |
|---|---|
| macOS | security 経由のキーチェーン |
| Linux | secret-tool 経由の Secret Service |
| Windows | DPAPI で暗号化され、Windows アカウントに保存 |
認証情報ストアのないマシン(ヘッドレスサーバー、CI ランナー、SSH 経由でロックされたキーチェーンなど)では、crbro_secret は失敗するのではなく、そのことをわかりやすく伝えます。環境変数は引き続き使用でき、CRBRO のほかの機能にも影響しません。
CRBRO はコピーを保持せず、独自の暗号化処理も行いません。ストアは脳の外部にあるため、同期やチームスペース、crbro_share からアクセスすることはできません。脳に保存されるのは、名前です。
「example.com の WordPress パスワードは
WP_EXAMPLE_APP_PASSWORDにあります。」
これだけあれば、アシスタントは翌週もパスワードを見つけられます。一方、メモリファイルを読める人には役に立ちません。
ターミナルから
2.3 までは crbro_secret だけが利用でき、値をモデルとの会話に入力する必要がありました。crbro secret を使えば、シェルから同じストアを利用できます。
npx crbro-memory secret set GITHUB_TOKEN     # value read from stdin, never argv
npx crbro-memory secret list                 # names only, never values
npx crbro-memory secret get GITHUB_TOKEN     # pipe it; warns if it would hit the screen
npx crbro-memory secret remove GITHUB_TOKEN --yes
npx crbro-memory secret status               # which store this machine offers
引数として渡すとシェルの履歴とプロセステーブルに残りますが、標準入力から渡せば残りません。ターミナルでは入力中の文字が表示されず、パイプも同様に使えます。
Get-Content token.txt | npx crbro-memory secret set GITHUB_TOKEN    # PowerShell
op read "op://vault/github/token" | npx crbro-memory secret set GITHUB_TOKEN
同じ名前の環境変数が常に優先されるため、キーチェーンに触れずに CI や一時的な上書きを利用できます。認証情報ストアのないヘッドレスマシンでは、crbro_secret は失敗するのではなく、そのことを明確に伝えます。環境変数は引き続き使用でき、CRBRO のほかの機能にも影響しません。
チームの記憶
同じ作業をしている2人が、同じことをアシスタントに何度も伝える必要はありません。スペースとは、1つ以上のプロジェクトをチームメイトと共有するもので、所有するプライベートな git リポジトリを通じて運用されます。サーバーもアカウントも不要で、料金もかかりません。
# One person, once:
crbro_space  action: create   name: "team"   remote: [email protected]:acme/team-memory.git   author: "ana"
crbro_share  neuron: "project_x"   space: "team"

# Everyone else, once:
crbro_space  action: join     name: "team"   remote: [email protected]:acme/team-memory.git   author: "bruno"
あとは意識する必要がありません。各セッションの開始時と終了時にメモがやり取りされます。誰かがそのプロジェクトについて学んだことは、次に作業を始めるとき、ほかのメンバーのアシスタントも把握しています。
作業の邪魔にならない仕組み
- 誰もほかの人のファイルには書き込みません。それぞれが自分のログに追記し、各マシンが全員分のログからプロジェクトを再構築するため、競合を解決する必要はありません。今も、1週間離れて作業したあとも同じです。
- 誰かがある事実を「もう正しくない」と示した場合、その判断が優先されます。古いコピーがその事実をまだ有効だとしていても、撤回された知識が復活することはありません。
- チームメイトが共有された事実を情報源と照合すると、その事実の有効期間の時計が全員分リセットされます。最新の確認が優先されます。明示的な
shelf_lifeも共有され、より変動しやすい値が優先されます。不要な警告なら確認が1回増えるだけですが、警告がなければ回答を誤る可能性があるためです。そのため、共有された事実の有効期間は短縮できますが、延長はできません。次回の同期では、ログにあるより変動しやすい値に戻され、crbro_learnはshared_warningでその旨を示します。1日より先の日付の確認(時計が進んでいる場合)は、確認なしとして扱われます。古いバージョンの CRBRO を使っているチームメイトには、確認情報は届きません。 - 接続できなくても、通常どおり動作し、エラーにはなりません。記憶はオフラインでも機能し、保存した内容は次回の同期時に送信されます。
チーム同期の対象外
- 明示的に共有していないすべてのプロジェクト。
- 設定にかかわらず、設定は一切共有できません。設定にはキーが含まれている可能性が最も高いためです。
- 認識された認証情報。
crbro_shareは認証情報を見つけると共有を拒否し、その場所を知らせます。フィルターですべての種類の秘密情報を認識できるわけではありません。認証情報の値は別の OS キーチェーンに保管し、共有メモには決して含めないでください。
これらはチーム同期の対象外であり、AI クライアントのデータフローや、記憶用に選んだクラウド同期フォルダーについて保証するものではありません。
一度送信したものは、送信済みです。
crbro_share unshare:trueを実行すると、プロジェクトの同期を停止します。以後メモは送信されず、次回の同期ではそのプロジェクトが無視されます。ただし、チームメイトがすでに取得している場合、そのデータは相手のディスクに残ります。リポジトリへのアクセス権を削除すれば、それ以降のデータは相手に届かなくなりますが、すでに相手が持っているデータは取り消せません。これはどの同期システムでも同じです。共有する前に知っておくべきことであり、共有したあとではありません。
アーキテクチャ
~/.crbro/
├── manifest.json           ← Brain metadata
├── cortex/                 ← One JSON per neuron (topic)
│   ├── project_octochat.json
│   └── tech_firebase.json
├── synapses/               ← One JSON per connection
│   └── syn_octochat__firebase.json
├── hippocampus/            ← One JSON per session
│   └── session_2026-05-06.json
├── prefrontal/             ← Working memory
│   ├── active_context.json
│   └── hot_topics.json     (the global map is computed live since 2.0, never stored)
├── .quarantine/            ← What crbro_forget removed, kept until you delete it
├── unshared.json           ← Projects you stopped following in a space (after an unshare)
├── archives/               ← Cold neurons (opt-in; nothing is archived unless you ask)
├── shared/                 ← One git repo per team space. Notes only, never the cortex
│   └── team/
│       └── neurons/project_x/ops/ana.a1b2c3.jsonl
└── .search/                ← Orama search index
    └── chunks.index.json   ← one document per fact
ヒートスコアのアルゴリズム
各ニューロンには、次の要素から算出されるヒートスコア(0.0~1.0)があります。
- 頻度(35%) — ニューロンがアクセスされる頻度
- 新しさ(40%) — 最後にアクセスされた時期(今日なら1.0、3か月超なら0.05)
- 接続性(25%) — そのニューロンにつながるシナプスの数
ナレッジマイナー
マイナーは、ディレクトリ内の .md ファイルと .txt ファイル(メモ、ドキュメント、日記)をスキャンし、知識を脳に抽出する任意の完全ローカル型ヘルパーです。会話だけでなく、すでに書いた内容からも CRBRO が学習できるようにします。ネットワークには一切アクセスせず、マシンの外にデータを送ることもありません。
npx crbro-memory mine [dir]       # One-shot scan of a directory
npx crbro-memory setup-miner      # Install a scheduled auto-scan (OS task scheduler)
npx crbro-memory miner-status     # Check the auto-miner status
npx crbro-memory remove-miner     # Remove the scheduled task
名前について:「マイナー」はここでは、独自のテキストファイルから事実を抽出する「知識のマイニング」を意味します。暗号通貨とは関係ありません。
CLI コマンド
npx crbro-memory          # Start MCP server (stdio)
npx crbro-memory init     # Initialize brain + detect IDEs
npx crbro-memory install-boot  # Make the memory load itself in every conversation (above)
npx crbro-memory status   # Show brain status
npx crbro-memory reindex  # Rebuild the search index
npx crbro-memory eval     # Measure retrieval quality against your own query set
npx crbro-memory semantic status | install | build   # Semantic recall (installed by init; below)
npx crbro-memory secret set|get|list|remove|status   # Credentials in the OS keychain (above)
npx crbro-memory backup | backup list | backup restore FILE   # One gzipped copy, rotated; restore never lands on the live brain
npx crbro-memory daemon on | off | status | stop   # One process owns the brain for every client (above)
npx crbro-memory install-hooks --guard   # Stored lessons speak before a shell command runs (above)
npx crbro-memory install-hooks --compact # Checkpoint before a compaction, picked back up after it (above)
npx crbro-memory guard "<command>"       # What the guard would say for a command
npx crbro-memory install-hooks --verify  # SHA-256 of the installed hooks and mod against this package; changes nothing
npx crbro-memory install-mod [--lang en|es|auto]   # Open items above the prompt and /pending in Claude Code (above)
npx crbro-memory uninstall-mod           # Remove that mod and its CLAUDE_CODE_PLUGIN_DIRS entry
npx crbro-memory usage [--days N] [--session ID] [--project DIR] [--json]   # Tokens per model and session, subagents apart
npx crbro-memory postmortem [--days N] [--max N] [--json]   # Candidate lessons from past sessions; stores nothing
npx crbro-memory --help   # Help
セマンティック検索
キーワードエンジンには同義語がなく、ブラインドベンチマークではその弱点がはっきり表れています。つまり、言い換えです。Hetzner VPS に関する事実を尋ねる「サイトはどこでホストされていますか」のような質問です。保存時にキーワードを書き添えるだけで、そのギャップの大部分を無料で埋められます(上記参照)。小規模なブレインでは小さな埋め込みモデルが少し補い、大規模なブレインでは大きく補います。1.16 以降、npx crbro-memory init はマシンごとに一度、デフォルトでモデルをインストールし、ランタイムが存在する場所ではこのレイヤーが有効になります。実測コストは、ディスク上で約 500 MB(ランタイム約 380 MB + モデル 118 MB)、サーバー実行中の RAM が約 0.5 GB、プロセスごとのモデル読み込みが約 13 秒(バックグラウンドで実行)、および初回の埋め込み処理です。init --no-semantic でスキップできます。サーバーの環境変数に CRBRO_SEMANTIC=0 を設定すれば、いつでも無効にできます。
npx crbro-memory init                 # installs it (skip with --no-semantic)
npx crbro-memory semantic status      # runtime, model, on or off, and why
npx crbro-memory semantic build       # embed an existing brain once (a 4k-line brain: ~3 min in batches; 2.7.2 embeds one line at a time, 1.6x that)
新しい行は保存時に埋め込まれます(ID はコンテンツハッシュなので、同じ内容を二度埋め込むことはありません)。モデルは起動後にバックグラウンドでウォームアップされ、crbro_recall は逆順位を使って両方のランキングを統合します。ベクトルによって順位付けされた結果には semantic_score が付与されます。ベクトルのみで一致した場合、コサイン類似度 0.86 から strong になります。CRBRO_SEMANTIC=0 の場合やランタイムがない場合、ベクトルは読み込まれず、モデルもロードされません。検索結果はキーワードエンジンのみの場合と完全に同じです。
モデルは multilingual-e5-small で、意図的に変更していません。CRBRO_SEMANTIC_MODEL には e5 ファミリーの任意のモデルを指定できます。同じベンチマークで測定した e5-base と e5-large を比べると、大きいモデル単体の性能は優れています(recall@1 は 71% 対 63%)。しかし、キーワードエンジンと統合した場合、1.16 での測定結果は同等か、むしろ低くなりました(75%/85% 対 79%/83%)。その一方で、ディスク容量は 4 倍、RAM は 1.2 GB、1 行あたりの処理時間は 6 倍になります。表は benchmarks/README.md にあります。
凍結したベンチマークで得られる効果と、得られない効果については、上記の表および benchmarks/README.md をご覧ください。これには、コサイン類似度の下限 0.84 が同じデータセットを使って選ばれたことも含まれています。500 MB をインストールする前に知っておくべき制限が一つあります。モデルは質問の意味を理解するわけではありません。保存された行と具体的な単語が一つも共通しない質問(Hetzner VPS に関する事実を尋ねる「どのマシンがページを提供していますか」など)は、ほぼランダムな順序で、コサイン類似度が 0.80~0.84 の範囲に集中します。これは実測されており、下限が設けられている理由でもあります。このモデルが補うのは、語彙の揺れやエンティティの違いへの許容度であり、ベンチマークの改善はそこから生まれます。
検索精度の測定
eval を使えば、改善が思い込みではなく、本当に効果があったのかを確認できます。実際に尋ねる質問をリストにし、それぞれに回答すべきニューロンを指定して、~/.crbro/.eval/queries.json に記述してください。
[
  { "query": "how we deploy the api",
    "expect_neuron": "project_octochat",
    "expect_contains": "Cloud Run" }
]
次に npx crbro-memory eval を実行すると、正しいニューロンが最初に返ってくる頻度、上位 3 件に入る頻度、MRR を報告します。さらに、すべての見落としも表示されるため、推測ではなく、何を間違えたのかを確認できます。
プライバシー
CRBRO が把握している情報はすべて、お使いのマシン上の ~/.crbro または指定したフォルダーにあるプレーンな JSON ファイルに保存されます。ファイルを開いたり、差分を確認したり、git でバックアップしたり、削除したりできます。アカウントも、こちらのサーバーも、テレメトリーも分析もありません。作成者に情報が送信されることは一切なく、サーバーにも送信するコードはありません。
次のデータフローではネットワークに接続することがあります。
- 任意のセマンティックレイヤー。
npx crbro-memory init(またはsemantic install)を実行すると、埋め込みモデルが Hugging Face から~/.crbro/.semanticにダウンロードされます。サイズは約 500 MB で、マシンごとに 1 回だけです。init --no-semanticを指定すればスキップでき、想起はキーワードのみで行われます。デスクトップ拡張機能がモデルをダウンロードすることはありません。 - チームスペース。 ご自身が所有する git リモートを指定して
crbro_spaceを実行すると、crbro_shareで明示的に共有したプロジェクトがそこにプッシュされます。この同期に含まれるのはそれらのプロジェクトのみです。設計上、設定は除外されており、プロジェクトは名前を指定して共有した場合に限り共有されます。 - お使いの MCP クライアント。 ツールが返した内容は、会話中のアシスタントによって読み取られます。アシスタントがメモリを利用できるのはそのためです。この通信はお客様とクライアントの間で行われ、こちらには送信されません。
認識された認証情報のパターンは、テキストがディスクに保存される前にマーカーに置き換えられ、その周囲の文は保持されます。crbro_secret は、実際の値を脳ではなくオペレーティングシステム本体のキーチェーンに保存します。明示的に crbro_secret action=get を実行すると、その値が AI クライアントに返されます。保存時に暗号化しても、この転送は防げません。通常の脳のバックアップにはキーチェーンは含まれません。脳を削除しても、キーチェーンのエントリー、バックアップ、会話ログ、すでに他者が受け取ったコピーは削除されません。トピックを確認するには、該当するファイルを読むか、crbro_inspect を呼び出してください。
crbro usage と crbro postmortem は、Claude Code 自身のセッションログを ~/.claude/projects からローカルで読み取り専用で参照します。usage が読み取るのは各応答のモデル名とトークン数のみです。postmortem が読み取るのはユーザーが入力した内容と呼び出されたツールの名前のみで、ツールの入力や出力は決して読み取りません。また、出力する内容は秘匿化されます。
依頼がなくても CRBRO が Claude Code のフォルダーに書き込むのは、open-items mod だけです。書き込まれるものは ~/.claude/crbro-mods/(mod 本体、オプトアウトのマークとインストール済みバージョンを記録した state.json、インストール中の数秒間保持されるロック、引き継ぎ先のブートで通知されるまで保持される通知)と、~/.claude/settings.json の env.CLAUDE_CODE_PLUGIN_DIRS に追加されるエントリー 1 つです。そのファイルのほかのキーは変更されません。インデントと改行コードを維持して JSON として書き換えます(Windows では、新しいファイルにフォルダーのアクセス許可が引き継がれます)。ダウンロードも送信も行われません。また、~/.claude がない場合、CRBRO_MOD=0 が設定されたクライアントの場合、または uninstall-mod の実行後には、これらの処理は一切行われません。
各防御策の目的と、脆弱性の報告方法については、SECURITY.md をご覧ください。
ライセンス
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。