nanomem について
nanomemは、時間とともに変わる事実を扱うアプリ向けの組み込みメモリストア兼MCPサーバーです。改訂履歴を保持して置き換えられた事実を示し、ファイルベースの保管庫で検索や過去の状態の照会ができます。
主な機能
- 01変化する事実の改訂履歴
- 02置き換えられた事実の表示
- 03履歴と変更の照会
- 04ファイルベースの永続保管庫
- 057つのMCPツール
活用シーン
- 01変更された事実の現在値を回答
- 02過去の時点の記録内容を確認
- 03最近の変更や古くなった認識を確認
- 04アシスタントとスクリプトで保管庫を共有
MCP 対応
MCPサーバーは、記憶の追加と検索、履歴や過去の状態の参照、変更や変動性の追跡、統計の確認に使う7つのツールを提供します。検索結果のテキストでは、置き換えられた事実が示されます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx nanomemNANOMEM_VAULTPath to the memory vault file. Defaults to ~/.nanomem/memory.dat.NANOMEM_PASSWORDシークレットPassphrase to encrypt the vault at rest. Leave UNSET for a plaintext vault; setting it to an empty string is refused rather than silently producing one.ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
7掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| text | string | はい | 記憶する情報です。 |
| entity | string | いいえ | この内容が示す属性。例:'employer'、'home_address'、'phone'。同じ属性の新しい値を書き込むたびに、必ず同じ値を渡してください。これにより、どの記述がどの記述に取って代わるかを nanomem が判定できます。本当に分からない場合に限り省略してください。その場合、語彙タグ付け器が推測しますが、叙述的な表現(「転職して、今は…で働いています」など)では推測の精度が低くなります。 |
| source | string | いいえ | ソース識別子(例:user_chat、doc.pdf)。 |
| timestamp | number | いいえ | この事実が有効だった時点の Unix 秒数。既定値は現在時刻です。 |
詳細
nanomem



変化する事実のための組み込みストアです。
アプリケーションが記憶する事実は、文書ではありません。後から訂正されるものです。人は引っ越し、転職し、電話番号を変えます。ベクトルストアは両方の記述を保持し、質問に近い表現のものを返します。そのため、アシスタントは2年前に離れた住所を自信たっぷりに繰り返してしまいます。nanomem は変更の履歴を保持し、どちらが最新かを把握します。
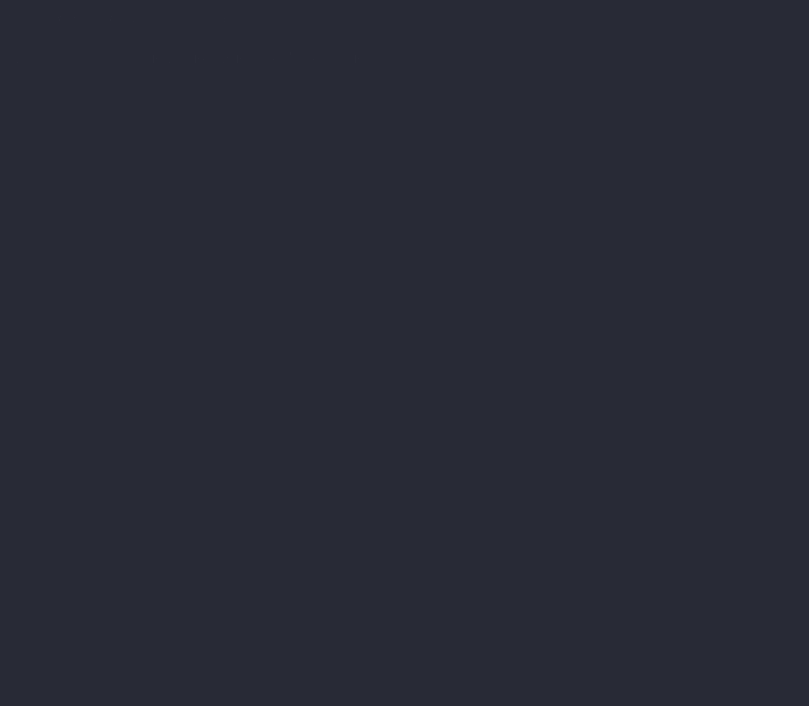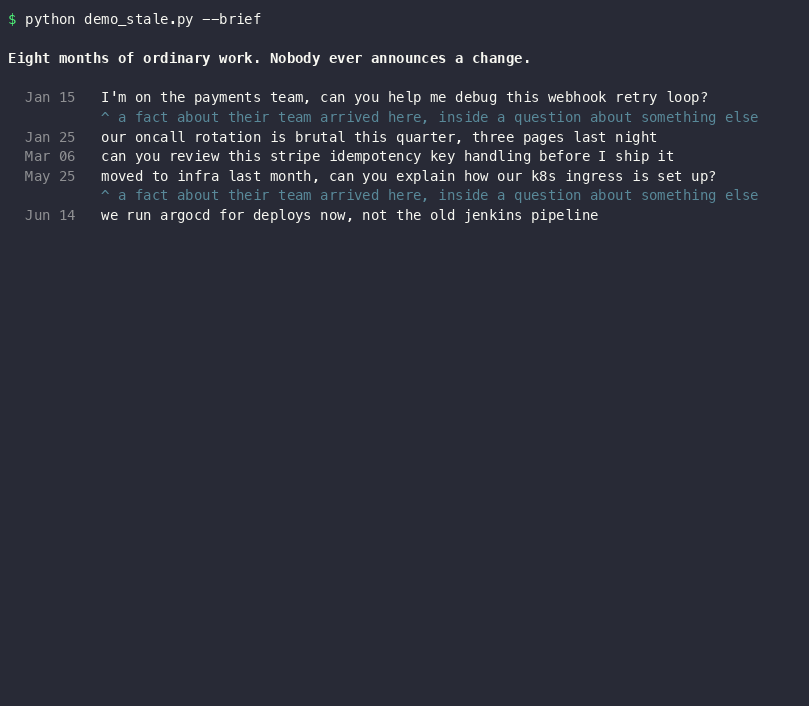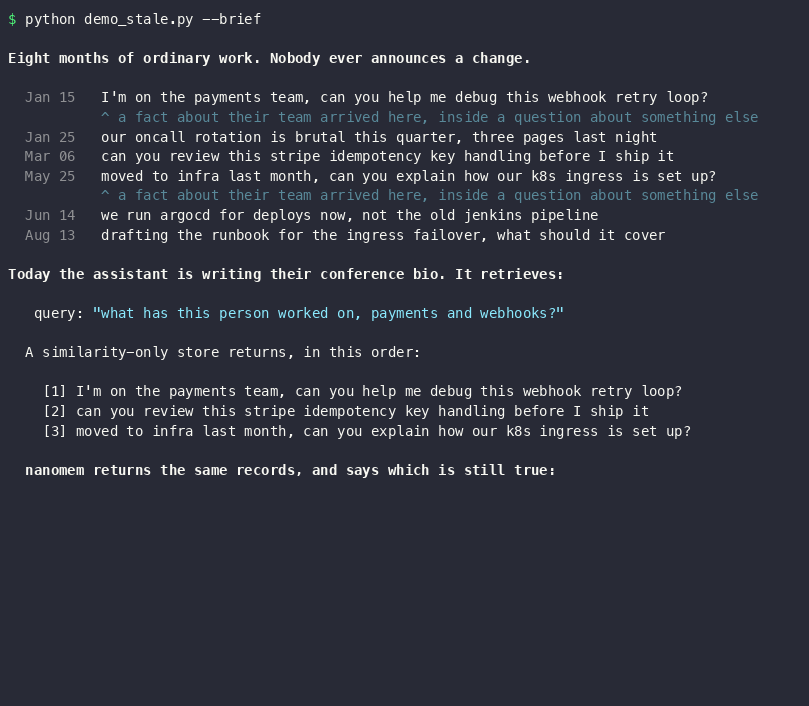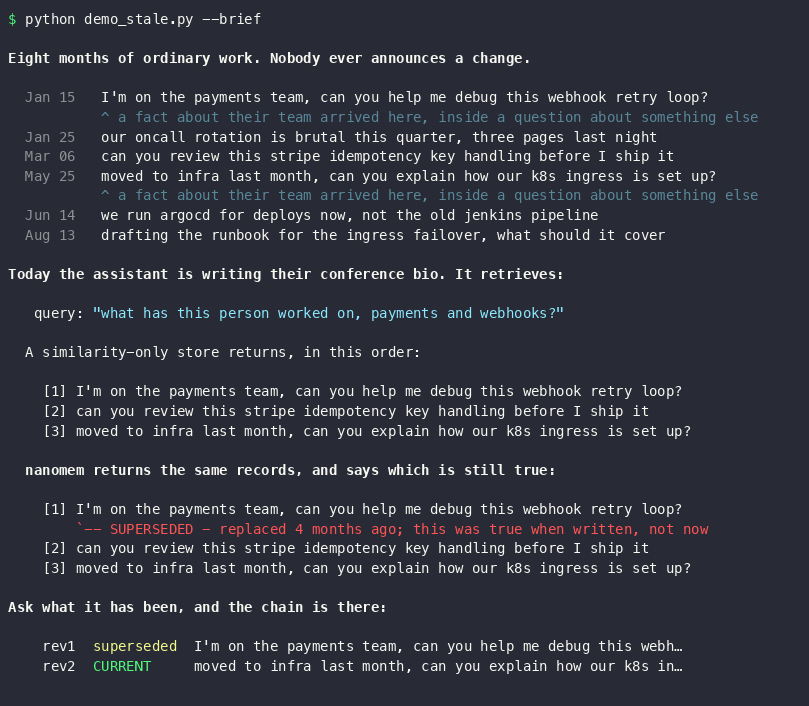
8か月分の何気ないチャットの中で、チームに関する事実は何気なく一度だけ変更されました。
質問が古い職務に近い表現になっているため、類似度検索では今も古い記述が最初にランク付けされます。そこで nanomem は、そうではないふりをせず、ラベルを付けて返します。ローカルの Ollama(nomic-embed-text)で demo_stale.py を実行した実際の結果です。python3 assets/record_demo.py で再生成できます。ラベルはモデルが付けたものではありません。埋め込みエンドポイントにまったく接続できない状態で同じデモを実行しても、改訂順から計算されるため、SUPERSEDED の行はそのまま表示されます。
エビデンス — FAISS、sqlite-vec、Chroma との比較(劣る点も含む)、書き込み途中にプロセスを強制終了した場合の動作、そしてインストールしたコピーでこれらの主張の大半を再検証する pytest コマンドについて説明します。
クイックスタート — 変更を把握できるメモリーをアシスタントに追加する
pip install nanomem
これを MCP クライアントの設定に追加してください。macOS では claude_desktop_config.json は ~/Library/Application Support/Claude/ にあります。
{
  "mcpServers": {
    "nanomem": {
      "command": "nanomem-mcp"
    }
  }
}
設定はこれだけです。ボルトの保存先はデフォルトで ~/.nanomem/memory.dat です。別の場所に保存するには、NANOMEM_VAULT を設定するか、--vault /some/path.dat を渡してください。
クライアントを再起動し、後で変わることを伝えてみてください。
「私が Acme Corp で働いていると覚えておいてください。」 (1週間後)「実は引っ越しました。今は Globex で働いています。」 「私はどこで働いていますか?その前はどこで働いていましたか?」
アシスタントは Globex と答え、以前は Acme で働いていたことも伝えられます。2つ目の文が質問に近い表現だったからではなく、nanomem が変更の履歴を保持し、どちらが最新かを把握しているからです。*「3月にはこれについてどう考えていましたか?」*と尋ねても、答えられます。
7つのツールがあります。nanomem_add、nanomem_search、nanomem_history、
nanomem_as_of、nanomem_changes、nanomem_volatility、nanomem_stats です。これにより、アシスタントは事実が以前どうだったか、過去のある時点でメモリーが何を正しいと考えていたか、先週何が変わったか、そして自身のどの記憶が古くなったかを尋ねられます。
ボルトは通常のファイルです。CLI または Python スクリプトから同じパスを指定すれば、アシスタントが書き込んだ内容を読み取れます。書き込みは返信が送信される前にディスクに保存されるため、別のプロセスからすぐに確認でき、サーバーを停止しても内容は失われません。
0.7.17 まではそうではありませんでした。サーバーは正常終了時にしかフラッシュせず、MCP クライアントは SIGTERM でサーバーを停止します。nanomem_add を20回呼び出して、毎回 "Stored …" と返信された後に SIGTERM を送ると、ボルトに残る行はゼロでした。以前のバージョンを使っていた場合、正常に終了しなかったセッションでアシスタントが「記憶」した内容は、何も書き込まれていませんでした。
または Python から使う
pip install nanomem
import time
from nanomem import Vault

DAY, now = 86400, time.time()
job = {"entity": "employer"}

v = Vault("memory.dat")
v.add("I work at Acme Corp.",                    metadata=job, timestamp=now - 300*DAY)
v.add("I moved jobs, I now work at Initech.",    metadata=job, timestamp=now - 155*DAY)
v.add("I switched again, I work at Globex now.", metadata=job, timestamp=now - 10*DAY)

print(v.search("where do I work")[0]["text"])
# I switched again, I work at Globex now.

for r in v.history("where do I work"):
    print(r["revision"], r["superseded"], r["text"])
# 1 True I work at Acme Corp.
# 2 True I moved jobs, I now work at Initech.
# 3 False I switched again, I work at Globex now.

print(v.search("where do I work", as_of=now - 200*DAY)[0]["text"])
# I work at Acme Corp.

f = v.volatility()[0]
print(f["entity"], f["n_revisions"], round(f["median_interval"]/DAY))
# employer 3 145
ディスク上のファイルは1つ。実行時依存関係は1つ(numpy)。サーバーもデーモンも、再構築が必要なインデックスもありません。検索は厳密です。近似インデックスではなく、コサイン類似度をすべて走査します。そのため、再現率は構造上100%であり、興味深い質問はすべて、順位付けではなく時間に関するものになります。
回答が途中で切れたことを知らせます
search は最大 top_k 件のレコードを返します。呼び出し元が内容を確認できないモデルの場合に特に重要な、返さなかったレコードについても知らせるようになりました。
r = vault.search("revenue of every company in every year", top_k=3, min_score=0.6)

len(r)                      # 3   — it is a list; every existing caller is unchanged
r.truncated                 # True
r.n_above_floor             # 21  — how many cleared your min_score
r.explain()                 # "This answer is incomplete -- showing 3 of 21 records
                            #  scoring at or above your min_score of 0.60. ..."
複数の部分からなる質問では、役立つのは、まったく結果が得られなかった部分がどれかという情報です。
r = vault.search("What is Acme revenue? ... What port does staging use?")
r.unanswered_sub_queries    # the clauses that got no slot
情報のある内容が切り捨てられなかった場合、explain() は "" を返すため、無条件で追加しても安全です。MCP の nanomem_search ツールもまさにそのようにしています。
min_score がある場合にのみ通知します。 デフォルトの 0.0 では、すべてのレコードがしきい値を超えるため、「101 件中 3 件を表示」は、答えが実際には 1 件だけのクエリも含め、これまでのすべてのクエリで成り立ってしまいます。毎回発生するシグナルには意味がありません。どちらの場合も、件数は r.n_above_floor に残ります。
件数の計算にコストはかかりません。スキャンは網羅的に行われるため、top_k を適用する行にはすでに両方の数値があり、これまでは破棄されていただけです。
もはや真実ではない回答に印を付けます
タイムスタンプでわかるのは、レコードが書かれた時点です。それが今も真実かどうかはわかりません。10 年前に書かれた事実が今も有効なこともあれば、先週書かれた事実がすでに古くなっていることもあります。その違いは、後のレコードによって置き換えられたかどうかです。それを把握しているのが改訂チェーンです。
変更された事実を検索すると、その値が複数返されます。チェーンとはそういうものだからです。現在は、それぞれの値に状態が示されます。
for h in vault.search("where do I work", top_k=3):
    print(h["superseded"], h["text"])
# False  I switched again, I work at Globex now.
# True   I moved, I work at Initech.
# True   I work at Acme Corp.
ask() はその情報をプロンプトに含めるため、モデルは文章を書く前に、どの事実が古くなっているかを知らされます。MCP ツールは、アシスタントが読むテキストに印を付けます。
[2] (2025-08-17) [SUPERSEDED - replaced 8 months ago; this was true
    when written, not now]: I moved, I work at Initech.
10 年前の事実でも、一度も変更されていなければ何も印は付きません。どのチェーンにも属さないレコードでは、superseded は False ではなく None です。そこでは「置き換えたものがない」とは、真実ではなく不明だからです。
属性が何を表すかを伝えます
上記の metadata={"entity": "employer"} は実際に役立っており、ここで重要なことはほかにほとんどないため、説明する価値があります。
属性名を指定すれば、nanomem はその 3 つの文が同じ事実だと認識し、チェーンとして保持します。省略すると、テキストから字句タグ付け器が推測します。各アームで 100 個のチェーンを測定したところ、平易な表現のチェーンでは 100 個中 70 個で各メンバーに同じ正しいタグが付きましたが、物語調の表現では 100 個中 0 個でした。上記の例では「I moved jobs, I now work at Initech.」に career ではなく location とタグを付けます。「moved」が「work at」より強く作用するため、チェーンは気付かれないまま 2 つに分かれます。
そのため、アプリケーション独自の属性がある場合は、それを宣言してください。ベクトルストアにはできない nanomem の機能はすべて、どの文が同じ事柄について述べているかを把握することに基づいています。そして、そのことを知っているのはタグ付け器ではなく、あなたです。
パッケージ 0.8.3 · エンジン 3.4.6 · コンテナ形式 3 · アリーナキャッシュ形式 4。
ライセンス:Apache-2.0。 商用利用、改変、クローズドソース製品への組み込みが可能です。再配布する場合は LICENSE ファイルと NOTICE ファイルを添付し、変更内容を明記してください。また、プロジェクト名や作者名を使って自分の製品を推奨しないでください。義務はそれだけです。
nanomem は 0.6.0 から 0.7.22 まで AGPL-3.0-or-later で、商用ライセンスも併用していました。この組み合わせによって守られるものは、遠ざけてしまうユーザーより価値が低いものでした。多くの企業は社内規定で AGPL を禁止しており、多くの開発者は読まずに採用を見送ります。旧条件で配布されたコピーには引き続きその条件が適用され、置き換えられた両方の文書も同梱されています。 LICENSE.agpl-3.0-or-later.md および LICENSE.preview-v1.0.md。 0.6.0 までは、ホイールのメタデータに Apache-2.0 と記載されている一方で、LICENSE ファイルには All Rights Reserved と記載されていました。この矛盾は 0.6.0 で解消され、以後解消された状態が続いています。
デモを実行する
cd nanomem_standalone
python3 demo.py          # stores, updates, searches, prints real stats()
python3 demo_stale.py    # the one worth seeing: a fact going stale over 8 months
どちらかに --brief を追加すると、説明文を省いて計算結果の行だけを表示します。このファイルの冒頭にある録画は、このオプションを使ったものです。
demo_stale.py は、誰も変更を告知しない、ごく普通の作業セッションを8か月分収録したものです。チームに関する情報は2回登場しますが、どちらも別の話題についての質問の中で触れられます。その後、アシスタントがプロフィールを書き、類似度検索では質問の表現が以前の仕事に似ているため、古いチームの情報が最初に表示されます。さらに nanomem は、その情報を SUPERSEDED - replaced 4 months ago のラベル付きで返します。表示される行はすべて計算結果です。冒頭のセッションを編集して、もう一度実行してみてください。
いくつかの事実を保存し、そのうち1つを更新して改訂処理を示し、引用付きで検索を実行します。また、ドキュメント数、ファイルサイズ、測定された active_heap_ram_kb、ファイルが暗号化されているかどうか(デフォルトでは暗号化されません)を含む、ボルトの実際の stats() を表示します。
テストを実行する
python3 -m pytest -q
ネットワーク接続なしで845件のテストを実行できます。
test_security.py はありません。この README の以前のバージョンでは、「ディスク上に平文がまったく存在しないことを証明する」ために実行するよう案内していましたが、そのファイルは一度も存在せず、その主張も誤りでした。ボルトは、パスフレーズを設定しない限り平文ファイルです。自分で確認するには、次のコマンドを実行してください。
python3 -m nanomem.cli init demo.dat
python3 -m nanomem.cli add "the office wifi password is hunter2" --vault demo.dat
strings demo.dat | grep hunter2          # plaintext vault: it is there
python3 -m nanomem.cli rekey --vault demo.dat --new-password-stdin
strings demo.dat | grep hunter2          # password mode: it is not
自分のスクリプトから使う
from nanomem import Vault

with Vault("my_knowledge.dat") as vault:            # plaintext by default
    doc_id = vault.add("Server backup runs daily at 02:00 UTC")
    vault.add("The staging database is on port 5433")

    hits = vault.search("When does the backup run?")
    print(hits[0]["text"], hits[0]["cosine"])
add() はドキュメント ID を返すので、後からその ID を使って get、update、delete を実行できます。暗号化されたボルトの場合は、password="…" を渡すか、NANOMEM_PASSWORD を設定してください。
埋め込みモデルは自由に選べます。 デフォルトでは、ローカルの Ollama 互換デーモン上で nomic-embed-text を使用しますが、任意のモデルを任意の次元数で利用できます。次元数はモデル自体から調べられ、ボルトのサイズはその戻り値に基づいて決まります。
Vault("m.dat", embed_model="all-minilm")                    # 384-d
Vault("m.dat", embed_model="mxbai-embed-large")             # 1024-d
Vault("m.dat", embed_model="text-embedding-3-small",
      base_url="https://api.openai.com/v1/embeddings")      # 1536-d
Vault("m.dat", embedder=MyOwnEmbedder())                    # anything with
                                                            # .embed/.embed_batch/.dim
base_url= または NANOMEM_EMBED_URL を指定すれば、任意の場所に接続できます。EmbeddingProvider に dim= を渡すと、次元数の調査を完全に省略できます(エアギャップ環境へのインストール向け)。既存のボルトの次元数は、指定した値より常に優先されるため、後から別のモデル名を指定しても、気づかないうちにボルトを破損することはありません。警告が表示され、ファイル固有の次元数が維持されます。その場合、このハンドルで使える機能は一部に限られます。エンコーダーは指定したモデルのままなので、新しいベクトルが必要な呼び出し――add、update(text=)、search、history――は、ファイルの次元数に合ったモデルで再度開くまで例外を発生させます。読み取りは引き続き動作し、delete、prune、compact、forget_superseded も引き続き実行でき、ファイルも書き換えます。その動作は、次元数が一致するハンドルを通した場合とまったく同じです(8つの操作で測定した結果、違いは0件でした)。バージョン0.7.20までは「すべての呼び出しで例外が発生する」と説明されていたため、レビュー担当者が通常の prune を、気づかないうちにデータを破壊する操作だと誤解する原因になりました。データは失われませんが、何もなかったかのように処理が続くわけではありません。
デーモンを使わない場合は代替手段があります。どのようなものか知っておく価値があります。768次元の決定論的な字句エンコーダーで、単語と文字のトライグラムをハッシュ化しますが、意味は考慮しません。「the server is up」と「the server is down」の類似度は 0.783、「I drive a car」と「I own an automobile」の類似度は 0.286 です。反対の意味の語句は同じように見え、同義語は無関係に見えます。オフラインでもパイプラインを実行でき、スモークテストには適していますが、埋め込みモデルの代わりにはなりません。また、ニューラルネットワークの重みは同梱されていません。
ベクトルストアとの違い
nanomem は追記専用ログなので、事実の現在の値だけでなく、これまでのすべての値を保持します。そのため、ベクトルインデックスでは表現できない4つの問いに答えられます。どの問いについても、ベクトルインデックスには回答に必要な履歴が保存されていないためです。
with Vault("memory.dat") as v:
    v.history("where do I work")          # every value, oldest first, current last
    v.search("where do I work",
             as_of=1735689600.0)          # the answer as the memory stood back then
    v.changes(since=1735689600.0)         # what was written in a window, no query
    v.volatility()                        # how often each fact actually changes
Python では as_of と since に Unix タイムスタンプを指定します。以下の CLI では YYYY-MM-DD も使用できます。history() は各値をタイムスタンプと superseded フラグとともに返します。最後の項目が現在の値です。一度も変更されていない事実は項目を1つ返します。これは回答であり、空の結果ではありません。
volatility()に注目してください。変更履歴を読み取り、各事実について、何回言い直されたか、変更間隔の典型的な長さ、現在の値が確認されないままどれくらい経過したかを報告します。これにより、エージェントは自身のどの信念が古くなったかを把握し、再度確認できます。
fact             restated   changes every   last confirmed
mobile_phone            4          195 d           2237 d   ← ask again
employer                3          807 d             47 d
モデルもクエリも使わず、常駐する2つのカラムのタイムスタンプの差分を、検索経路を経由せずに取得します。staleness()はこれを確率に変換しますが、assume_memoryless=Trueを渡さない限りNoneを返します。事実ごとの発生率がコーパス全体で単一の発生率を上回ったのは、その前提に合うよう生成されたデータの場合だけだったため、デフォルトでは有効になっていません(evidence/staleness_calibration.json)。
この仕組みの限界。 2つのレコードが同じ事実として扱われるのは、nanomemが同じ属性だと判断できる場合に限られます。そのためには語彙またはクエリが必要です。語彙を使わない5つのシグナルを測定したところ、自宅と職場の住所のような類似属性を区別する精度は、すべて偶然と同程度でした(evidence/grouping_signal_results.json)。正規化された言い回しでは、100件のチェーンのうち70件で、各メンバーに同じ正しいタグが付与されます。一方、物語的な言い回し(「週末にその行を移したので、連絡先は…」)では100件中0件でした(evidence/temporal_drift_results.json)。アプリケーション側で独自の属性が分かっている場合は、それを宣言してください。 書き込み時にmetadata={"entity": "employer"}を渡し、group_floor_sim=0.45を設定すると、タグ付けが苦手とするまさにその言い回しで、トップ1のスコアが19.0ポイント向上します(floor_retune_results.json)。タグ付け機能に頼る場合は、どちらも変更しないでください。同じ設定により、そちらでは13.9ポイント低下します。
書き込みを行うすべての場所で宣言してください。Pythonではmetadata={"entity": ...}、MCPのnanomem_addツールではentity、nanomem addでは--entityを指定します。0.7.12までは後者の2つが存在せず、多くの呼び出し元が統合している2つのインターフェースは、そのことを示す手段がないままタグ付け機能に固定されていました。
宣言できない場合の代償。 タグ付け機能が推測したグループでは、どの値が現在のものかについてsearchとhistoryの結果が食い違うことがあります。historyはタグ付けされたチェーンを解決して改訂カウンターを読み取りますが、searchは関連性の下限も適用するため、最新の値が古い値より質問から遠い言い回しだと、最新の値が除外されることがあります。推測されたグループの最新メンバーを除外する方法は測定の結果、採用されませんでした。3ペルソナのチャットセットで**-19.4ポイント**の低下となり、0.40から0.80まで調べても、片方の代償を払わずにもう片方を得られるしきい値は見つかりませんでした(evidence/floor_current_value_results.json)。つまり、これは見落としではなく、意図的なトレードオフです。
0.7.12では、historyが正式な情報源であり、searchより優先すべきだとこのセクションで説明していました。これは誤りであり、その主張は撤回されました。history自体が実際より短いチェーンを返すことがあり、最悪の場合はsuperseded=Falseの1エントリーだけを返すこともありました。このライブラリでは、これは「この事実は一度も変更されていない」という意味です。この切り詰めは0.7.14と0.7.15で修正されました。宣言されたチェーンは現在、保持しているすべての改訂を返し、changes()もそれと一致します。
残るのは、この食い違いそのものです。0.7.16までは、このセクションに**「エンティティを宣言すれば食い違いは解消されます」**と記載されていました。根拠は、3件のチェーンが3/3のスコアを記録したことでした(evidence/entity_declaration_results.json)。しかし、3回目の独立したブラックボックスレビューで、エンティティを宣言しても解消されないチェーンが見つかり、この主張は誤りでした。測定では見えない問題もありました。その3件では、すべての改訂で属性が明示的に言い直されていたため(「現在はInitechで働いています」)、チェーンのメンバー同士が近いまま保たれていました。改訂1で属性を示し、後続の改訂では暗に言及する場合――「机はKestrel Houseの3階にあります」、続いて「今はMaple Wharfのビルに駐車しています」――メンバー同士の隔たりが広がり、現在の値を優先するための持ち上げ幅は、その隔たりに必要な大きさを下回っていました。エンティティを宣言していたにもかかわらず、search[0]は2つ前の机の場所を返し、history()は正しい場所を返しました。
0.7.16 では、8 つのアームと 2 つの埋め込みモデルを対象としたスイープで、この上限が引き上げられています
(evidence/revision_lead_cap_results.json)。問題を引き起こした表現を使った 12 個のチェーンを、それぞれ単独でボルトに格納し、2 つのタイムスタンプ条件で測定しました。
宣言されたチェーンで、search の top-1 が history の現在の値と一致する割合 | 0.7.15 | 0.7.16 |
|---|---|---|
| 後続のリビジョンが暗黙的に言及する場合、実際のモデル(24 ケース) | 41.7% | 100.0% |
| オフラインのフォールバックエンコーダーで同じチェーンを使用(12) | 25.0% | 75.0% |
| 表現が変化する生成データセット(100) | 71.0% | 100.0% |
また、left to the tagger は 2/3 のままで変化はなく、依然として 3 個のチェーンのみで測定されています
(evidence/entity_declaration_results.json)。
エンティティを宣言することでチェーンが解決可能になり、実際の埋め込みモデルでは、これらのデータセットで search と history の結果が一致するようになります。
これは保証ではありません。ここで測定した 12 個のオフラインエンコーダーチェーンで残った失敗は、すべて同じ原因によるものです。そのエンコーダーは語彙ベースであり、最新のリビジョンが質問から遠く離れた位置に埋め込まれるため、関連性フィルターによって結果から完全に除外されます。そもそも返されなかったレコードを、ランキングのブーストで上位にすることはできません
(失敗 6 件中 6 件、revision_lead_cap_results.json のアーム H)。
これはこのコーパスでの原因であり、ほかに原因がないという意味ではありません。同じ形状のチェーンを構築した独立したレビュアーは、別の種類の失敗を測定しました。最新のリビジョンは返され、ブーストも適用されて max_boost に達しているものの、チェーンを先頭にするために必要なリフト(約 0.68)が 0.60 の上限を超えていました。上限を引き上げればそれらは修正されますが、ここで測定した失敗は修正されません。そのため、公表されたスイープでは、このアームは 0.60 から 1.50 まで横ばいになっています。同じ形状の 2 つのコーパスでも、語彙ベースのエンコーダーではこれほど結果が異なることがあるため、75.0% はそのまま受け止めてください。これは 12 個のチェーンの測定値であり、フォールバックの特性を示すものではありません。tests/test_revision_lead_cap.py は、チェック対象のデータセットで上限に達した場合に失敗します。照合には、フィルターされていないビューである changes() を使用してください。
これを使った RAG の構築
検索が中核であり、生成は任意です。追加の依存関係は不要で、指定した任意のエンドポイントに標準ライブラリの urllib を使用します。
v.search("what port does staging use?", top_k=3)     # retrieval only
v.ask("What port does staging use?", llm="llama3.2") # -> {question, answer, citations}
v.ingest_file("runbook.md")                          # chunk + store a document
nanomem proxy は、メモリを挿入する OpenAI 互換の /v1/chat/completions も提供します。既存のアプリでプロバイダーの代わりに nanomem を指定すれば、コードを変更せずにメモリを利用できます。
プロバイダー。 ask()/chat() に base_url= と api_key= を渡すか、Vault に設定します。リクエスト形式はベース URL によって決まります。
| Ollama(デフォルト) | http://localhost:11434 → ネイティブの /api/generate |
| OpenAI、Groq、Together、Mistral、DeepSeek、OpenRouter、Fireworks | /v1 で終わる任意のベース URL |
| LM Studio、vLLM、llama.cpp | :1234、:8000、:8080 |
| Anthropic | https://api.anthropic.com/v1 → /v1/messages、x-api-key |
| Azure OpenAI | /chat/completions で終わるデプロイ URL 全体を渡します |
埋め込みは NANOMEM_EMBED_URL から取得します(デフォルトは Ollama の nomic-embed-text)。ルーティングは URL 内の部分文字列ではなく、解析されたポートによって決まります。0.6.1 より前は、ホスト名 web8000.internal が誤ってルーティングされ、Anthropic への POST が /v1/chat/completions に送られて 404 になっていました。
CLI
python3 -m nanomem.cli init company.dat
python3 -m nanomem.cli add "DB port is 5433" --vault company.dat
python3 -m nanomem.cli search "DB port" -k 3 --vault company.dat
python3 -m nanomem.cli history "DB port" --vault company.dat
python3 -m nanomem.cli search "DB port" --as-of 2026-03-01 --vault company.dat
python3 -m nanomem.cli changes --since 2026-01-01 --vault company.dat
python3 -m nanomem.cli stats --vault company.dat
python3 -m nanomem.cli rekey --vault company.dat --new-password-stdin
add はドキュメント ID と、処理にかかった時間を出力します。
実測した動作
検索は厳密な線形スキャンです。スキャン対象のテキストについて、全件を対象とした fp32 コサインスキャンと同じ結果を返します。1,190 件のコーパスでは、上位 4 件の順序に違いはありませんでした(0/120 件、evidence/exactness_v3r2.json)。そのため、レイテンシーはコーパスの規模に応じて増加します。
スキャン対象のテキストは decompose によって変わります。デフォルトは True です。 複数の節を含む質問は分割され、各サブクエリーを全件スキャンした後、最良のヒットが交互に並べられます。そのため、結果は各節に対する全件検索の回答であり、文全体に対する全件検索の上位 k 件ではありません。複数の節を含む質問では、この2つの結果は異なります。これが分解の目的です。2つの部分からなる質問の両方に回答できるようになります。文字列全体を1つのクエリーとして扱い、上記の厳密性の主張を最初から最後まで適用したい場合は、decompose=False を渡してください。
| コーパス | p50 | recall@4 | exhaustive numpy と同じ? | FAISS flat と同じ? | インデックス | ドキュメントあたりの RSS |
|---|---|---|---|---|---|---|
| 1,190 | 0.052 ms | 68.3 % | はい | はい | 2.5 MB | — |
| 10,000 | 0.345 ms | 70.4 % | はい | はい | 22.0 MB | 8.4 KB |
| 71,433 | 1.762 ms | 60.6 % | はい | はい | 155.9 MB | 8.8 KB |
evidence/scale_results_v3r4.json、headtohead_v3.json、rss_v3r4.json。Apple M4 Pro/Python 3.12、nomic-embed-text 768 次元、ランダムな挿入順、保留した質問 500 件を使い、取り込み → クローズ → 再オープン → 検索の手順で計測しています。(これらのドキュメント内の evidence/… パスはすべて、このフォルダーではなくリポジトリのルートからの相対パスです。JSON ファイルと、それらを書き出したスクリプトはルートにあります。)
「全件検索と同じ」の列は再現率を示します。1,190 件では順序も一致しています(上位 4 件の順序に違いは 0/120 件)。10,000 件と 71,433 件では、タイブレークにわずかな違いがあります。質問 500 件中、それぞれ 2 件と 5 件で、コサイン値の差は最大 2.2e-05 でした。これは、ディスク上のベクトルが fp16 であるためです(evidence/verify_round3_v3r3.json)。
スコアも同じ意味で厳密ですが、それ以上ではありません。形状の異なる2つの float32 行列積は、加算の順序が異なるため、ヒットに付与されるスコアは、使用する BLAS によって最下位ビットの1~2ビット分だけ異なる場合があります。同じクエリーで Apple Accelerate と OpenBLAS を比較したところ、差は 2.98e-08、つまり 2 ulp でした。それによって回答が変わることはありません。4,000 件のドキュメントを対象に、128 次元と 768 次元で比較した場合、|fp32 − fp64| の最大誤差は 2.01e-07 でした。一方、4位と5位の間の最小差は 4.46e-06 と20倍以上大きく、k = 1、4、10 のいずれでも、判定不能だったクエリーは 150 件中 0 件でした(evidence/screen_exactness_results.json)。したがって、「全件スキャンと同じ結果を返す」という主張は、返されるドキュメントとその順序についてのものです。ただし、順位を実際に区別できないドキュメント同士では、コーパスに忠実なタイブレーク情報が存在しないため例外です。ドキュメントに添えられた浮動小数点数のビットパターンが同じであるという主張ではありませんし、そもそもそのような主張はできません。
常駐メモリーは、ドキュメントあたりおよそ8~9 KBです。以前のドキュメントでは「< 500 KB RAM」または「160 KB active heap」と記載していましたが、これらは stats() が出力する定数であり、実測値ではなかったため、削除しました。
書き込み時間は、保管庫が大きくなってもほぼ一定です。埋め込み処理を除くと、4,000 件の追加のうち最初の 500 件では平均 19.81 µs、最後の 500 件では 19.32 µs でした(evidence/headtohead_v3.json)。
1件のレコードの削除では、全体をアトミックに書き換えます。1,000 件では 7.5 ms、10,000 件では 70.5 ms です(evidence/rewrite_cost_v3r4.json)。3.0 ではトゥームストーンを使用しません。
ドキュメント
- USER_MANUAL.md — ハブと、実測性能の全テーブル
- USER_MANUAL_PERSONAL.md — チャット、プロファイル、プライバシー
- USER_MANUAL_DEVELOPER.md — SDK、CLI、並行処理、移行
- SERVICES_AND_API_SPECIFICATION.md — REST エンドポイントと制限
- MULTIHOP_REASONING_AND_TOPOLOGY_GUIDE.md — ブリッジと、うまくいかなかったこと
- CHANGELOG.md — 0.1.x からの破壊的変更
オプションのパスワードモードを利用する前に、nanomem.THREAT_MODELをお読みください。このモードは、Python 標準ライブラリを使用して構成された scrypt、SHAKE256 キーストリーム、HMAC-SHA256 タグを使用します。AES ではなく、「256 ビット暗号化」でもなく、監査も受けていません。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。