mockcrowd について
mockcrowdは、実際のオンライン投稿をもとにしたAIペルソナの議論でアイデアを評価する、創業者や製品チーム向けのコマンドラインツールです。一般的な対照案との比較を通じ、反対理由や確信度、支払い意向を報告します。
主な機能
- 01実際の投稿に基づくペルソナ
- 02対照案とのブラインド投票
- 03議論のシミュレーションと再投票
- 04確信度と主な反対理由の報告
- 05バックテストと実績の記録
活用シーン
- 01開発前の製品アイデア比較
- 02価格設定ごとの支払い意向の確認
- 03層別の懸念点の把握
- 04無料機能やアプリの評価
MCP 対応
MCPサーバーは、アイデア検証、レポート取得、過去の実行や利用可能なAIバックエンドの一覧表示、結果記録のツールを公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
5掲載時のツール一覧 · 今日に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| free | boolean | いいえ | |
| idea | string | はい | |
| brain | string | いいえ | |
| model | any | いいえ | |
| price | any | いいえ | |
| agents | integer | いいえ | |
| rounds | integer | いいえ | |
| sources | any | いいえ | |
| audience | any | いいえ | |
| voices_file | any | いいえ |
詳細
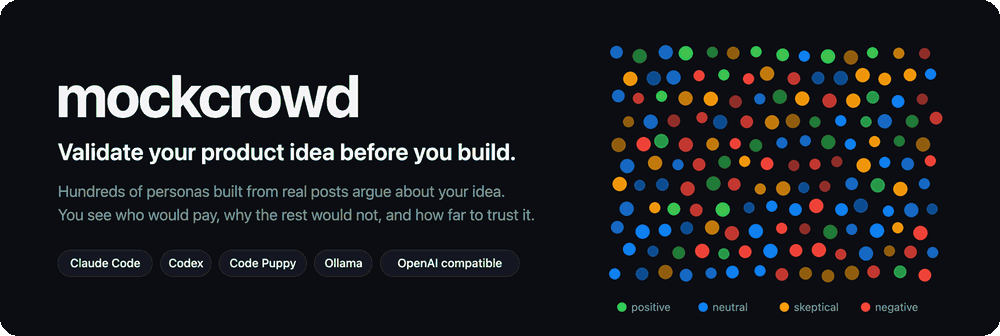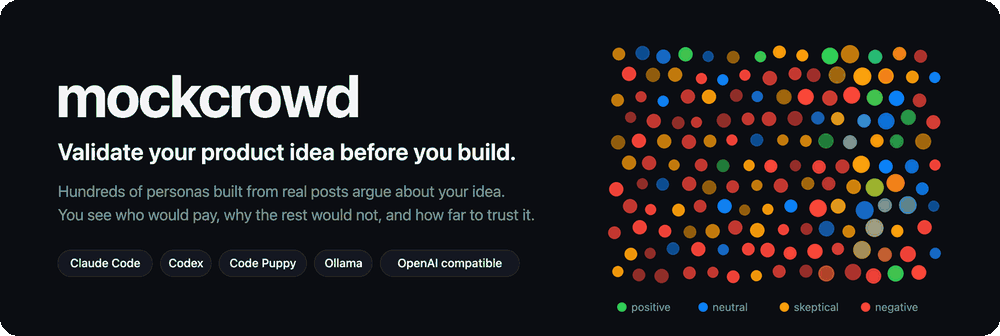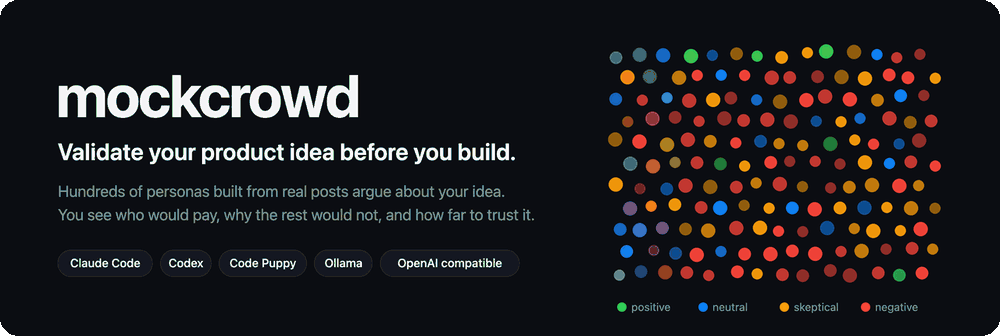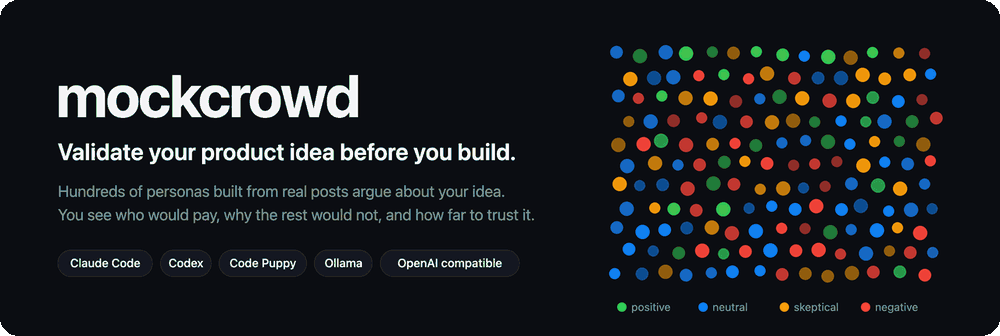



構築を始める前に、製品のアイデアを検証しましょう。 mockcrowdは、Reddit、Hacker News、Blueskyの実際の投稿から数百人のAIペルソナを作成し、模擬的なRedditスレッドでアイデアについて議論させます。そして、実際に購入する人の数、そうしない理由、結果をどの程度信頼できるかを伝えます。
すでにお使いのAIを使って、お使いのマシン上で実行できます。Claude Code、Codex、Code Puppy、Ollama、またはOpenAI互換APIに対応しています。
mockcrowd validate "An app that scans your vinyl records with the phone camera to catalog your collection and track prices" --price "\$3.99/month"
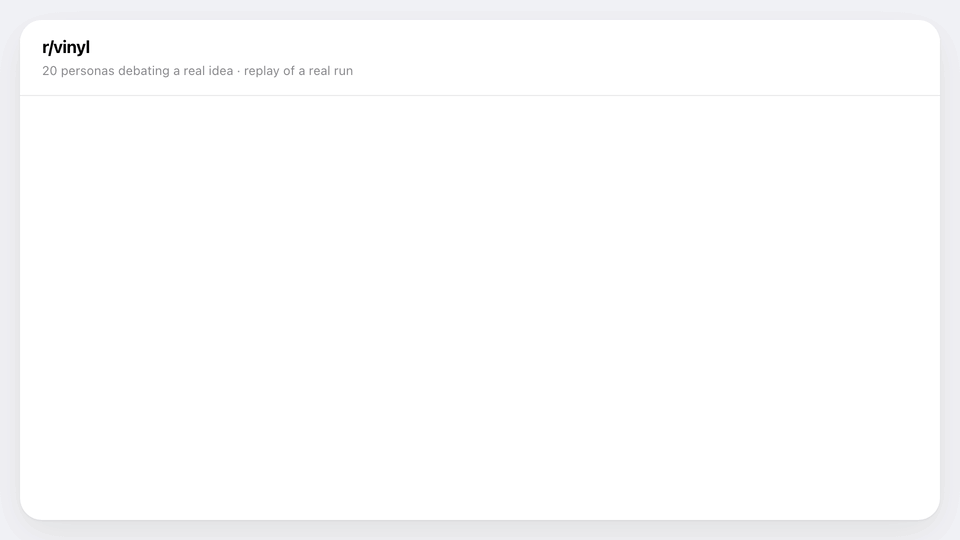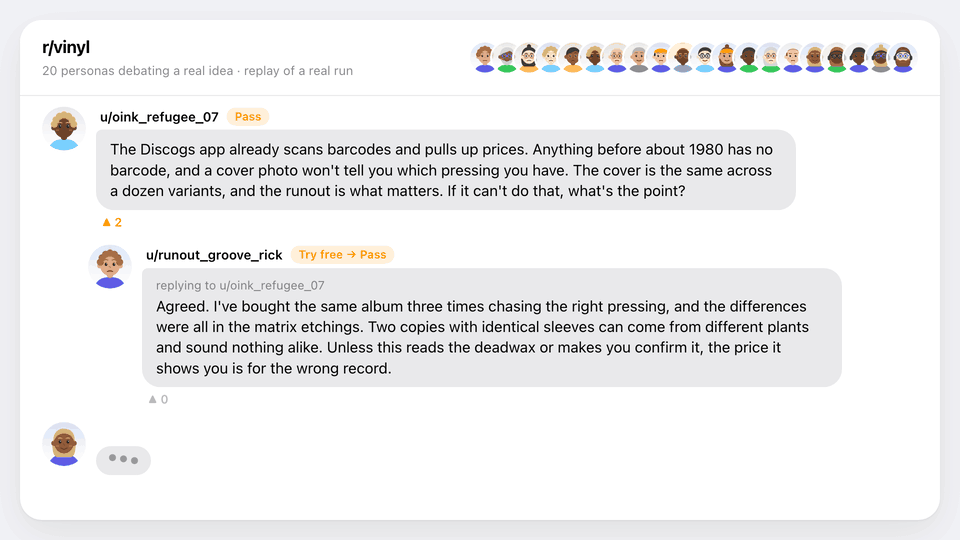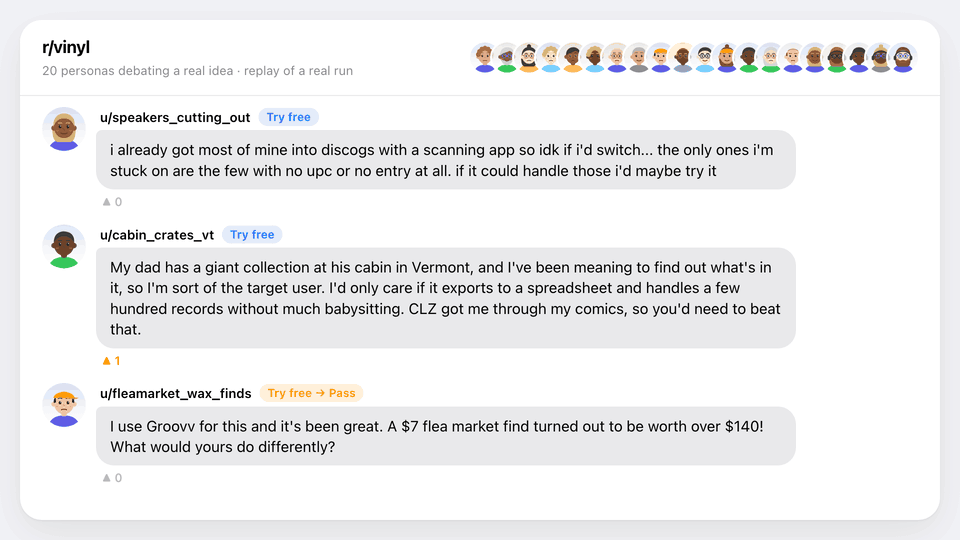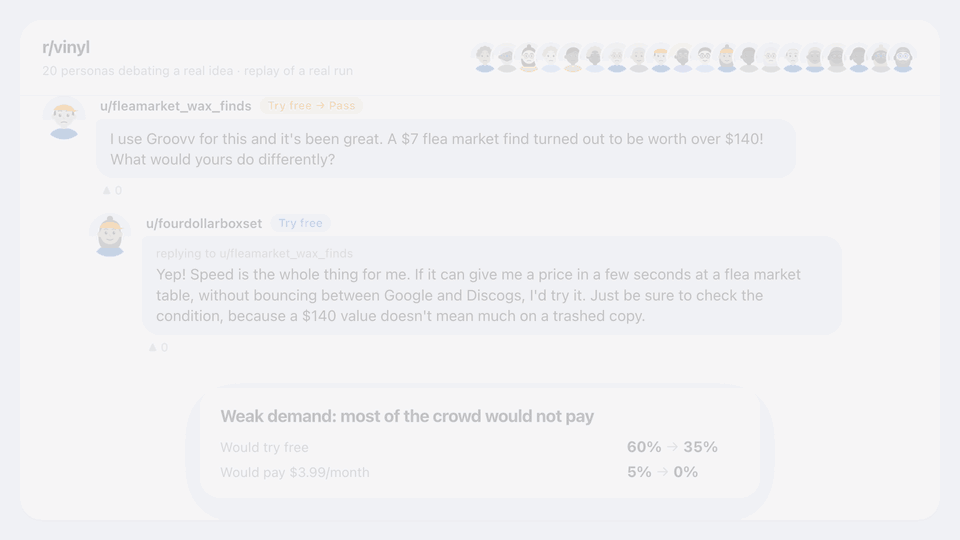
小規模なテスト実行(ペルソナ20人、議論1ラウンド、Claude、Hacker NewsとBlueskyの声)から得られた実際の出力:
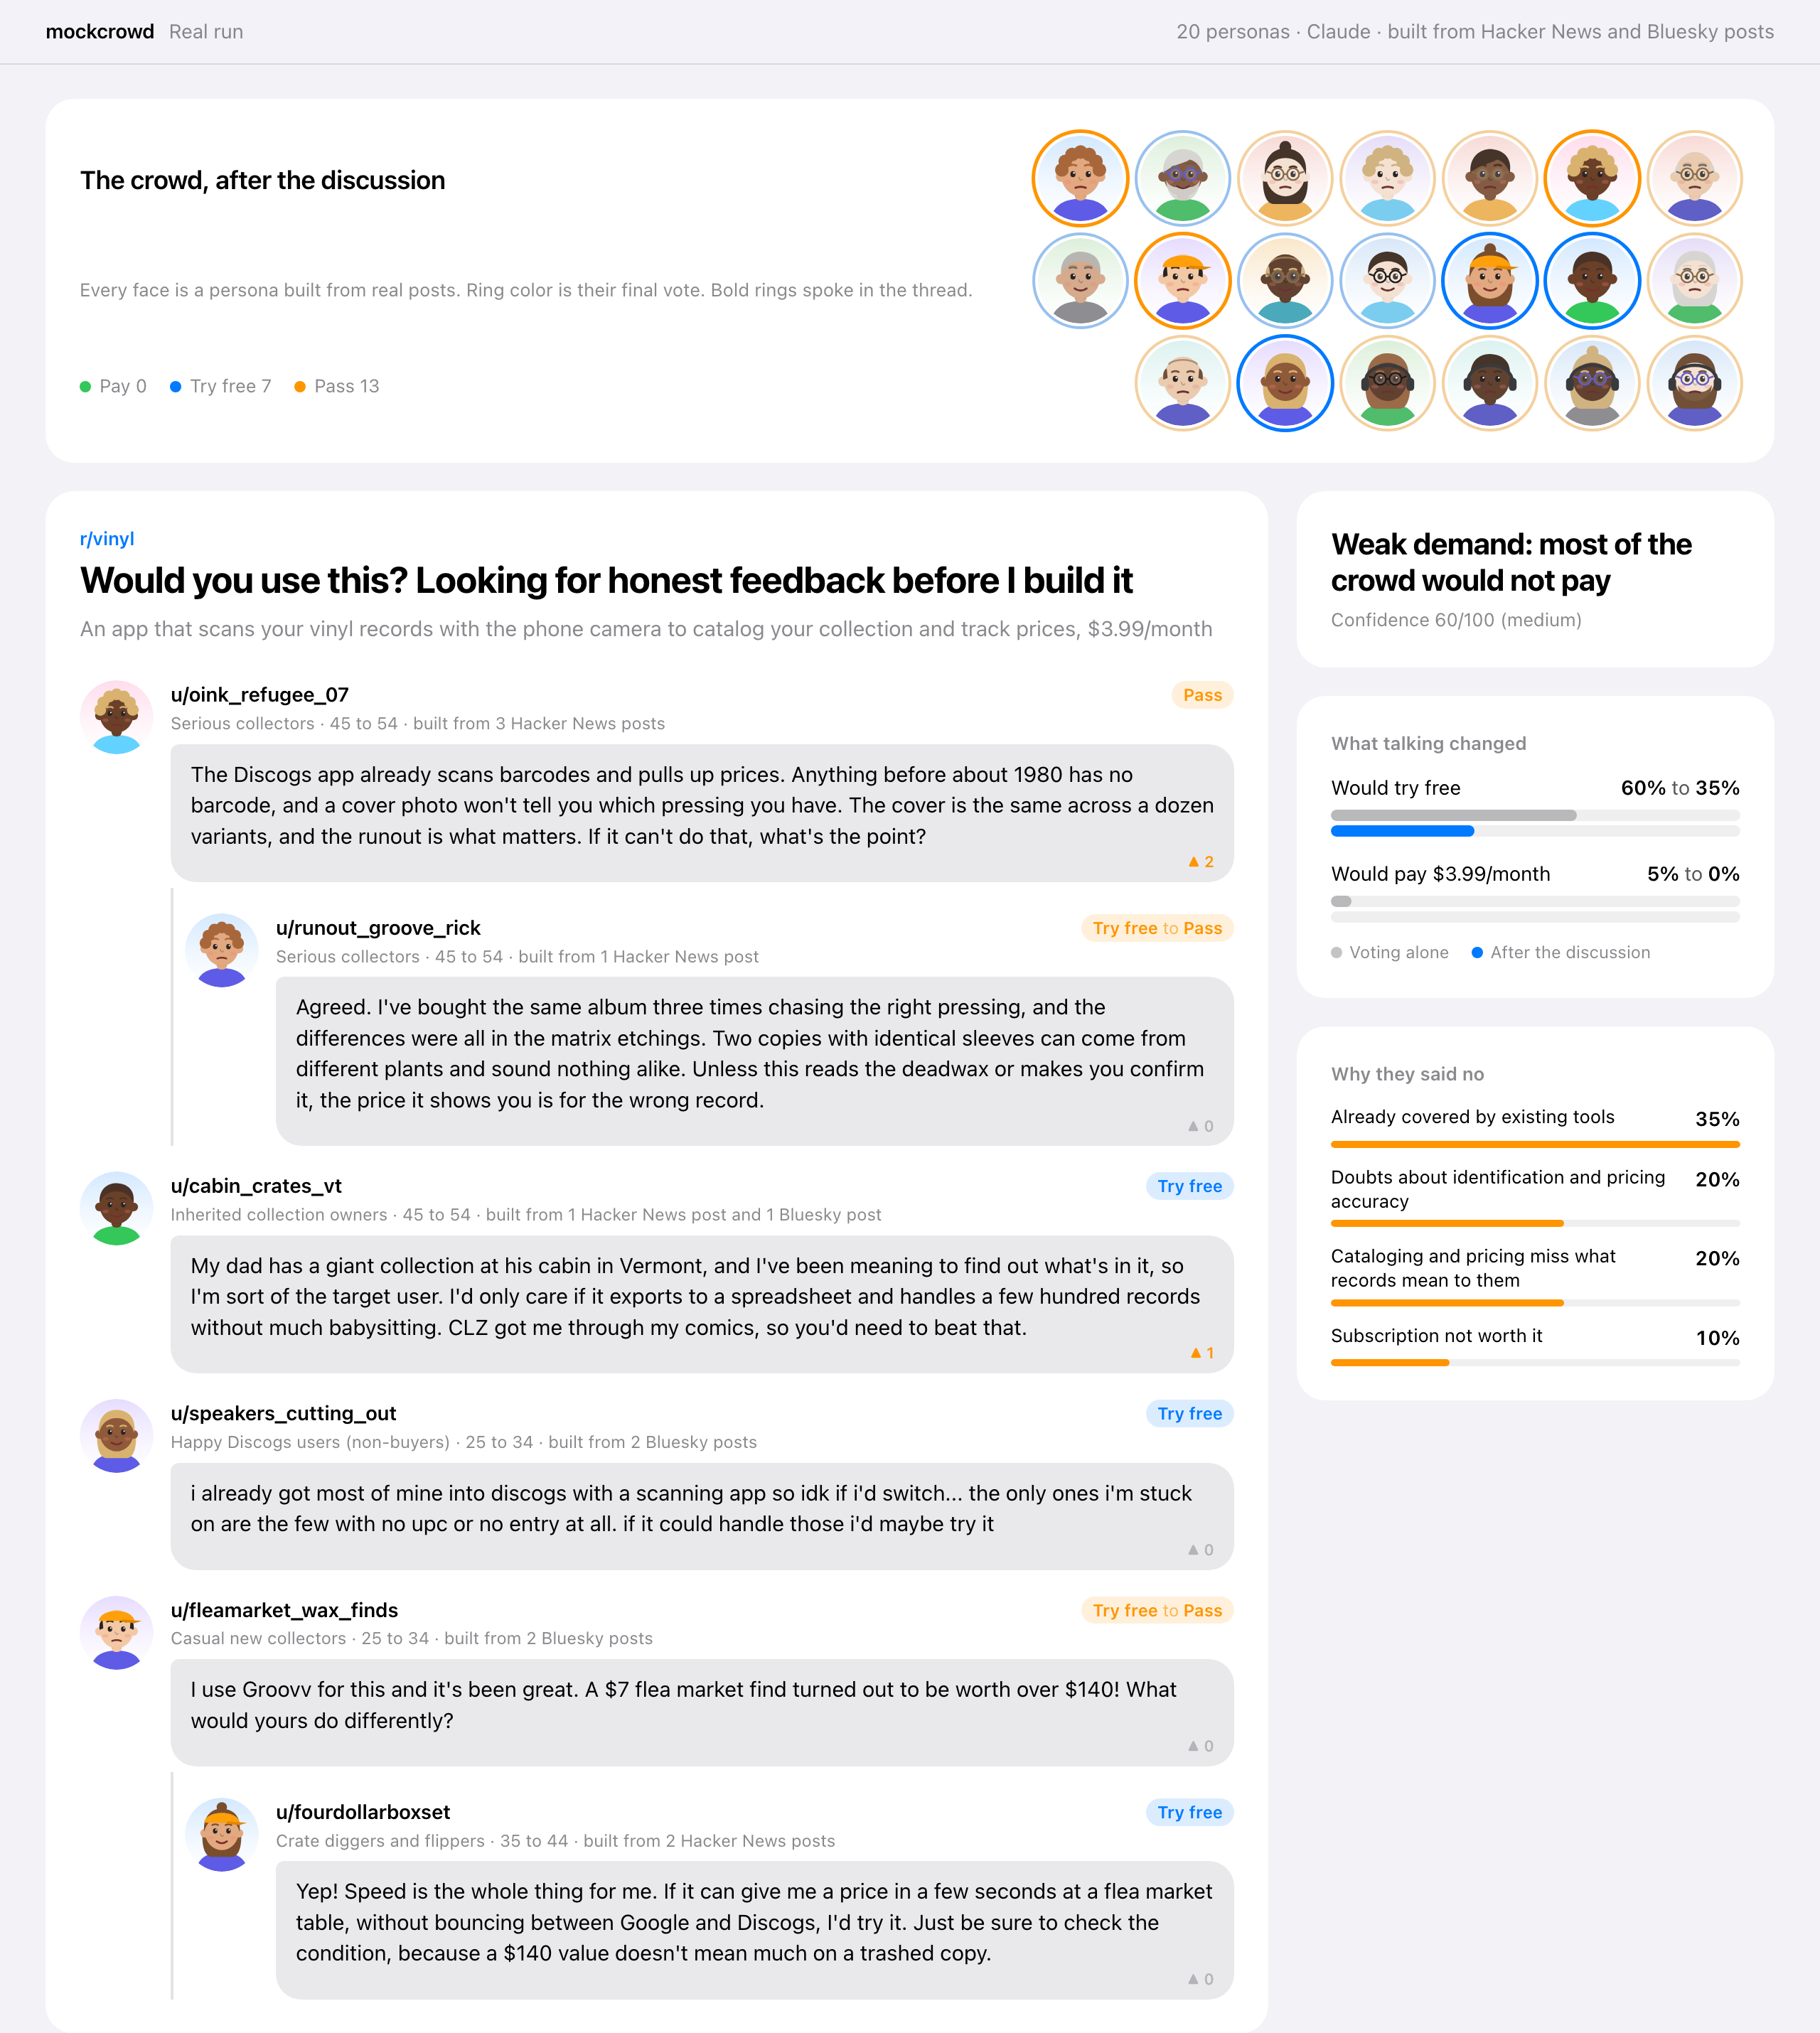
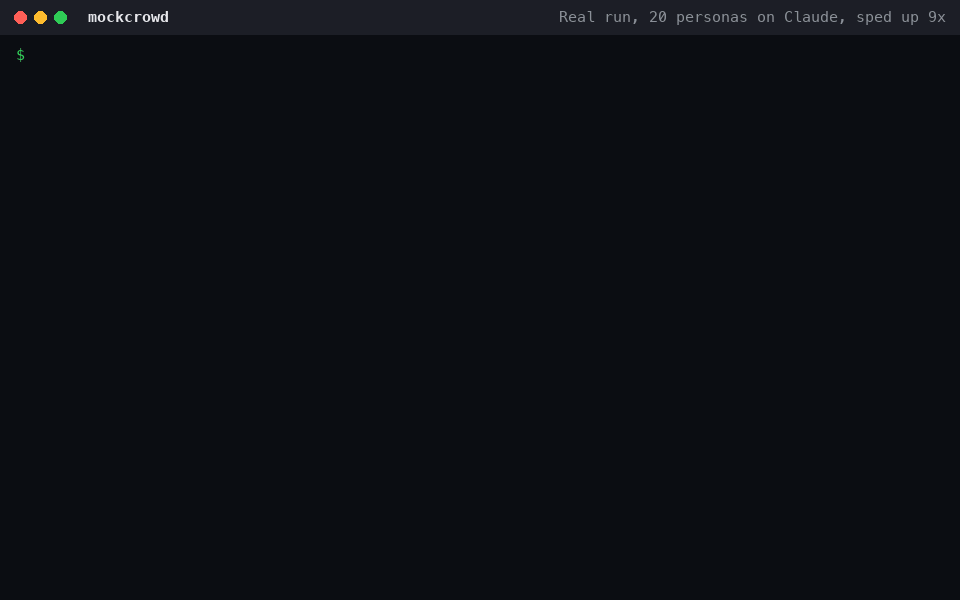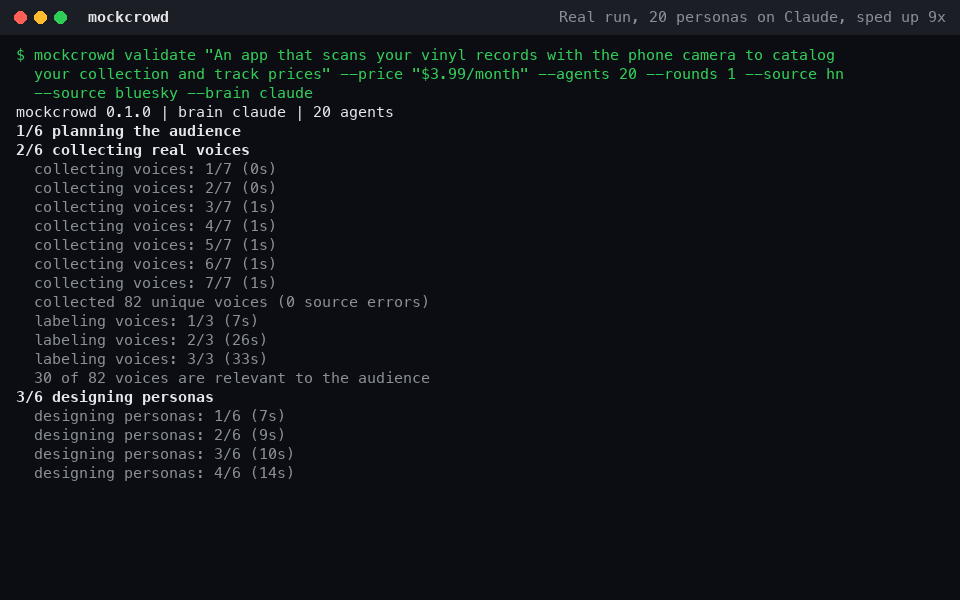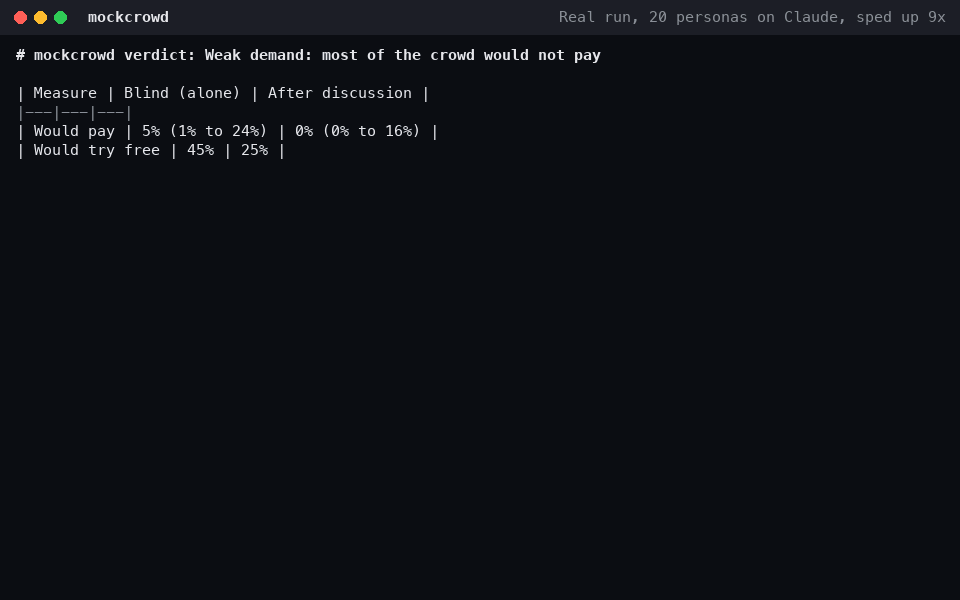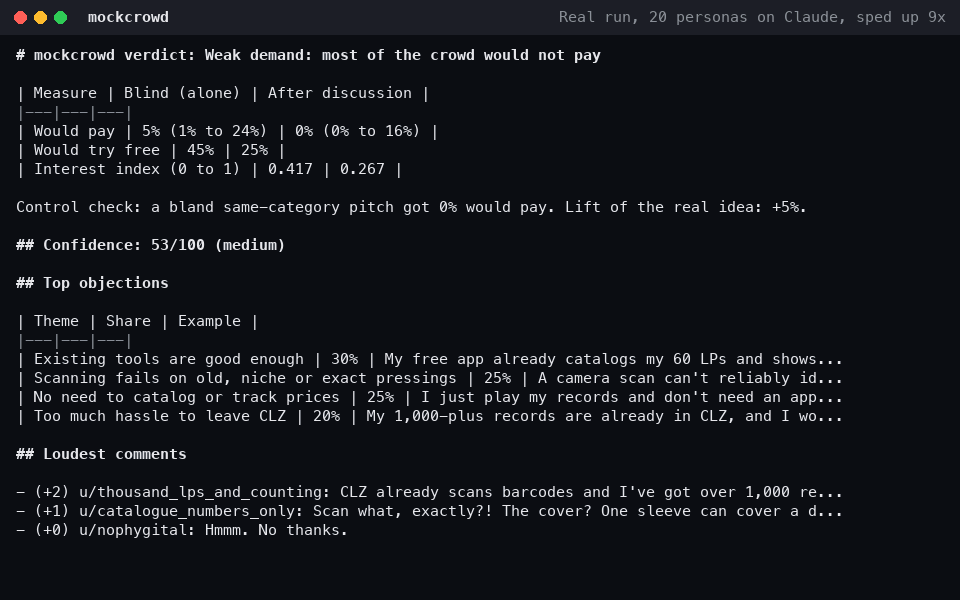
単独で回答した場合、60%が無料なら試すと答え、5%が購入すると答えました。議論の後は、35%が試すと答え、購入すると答えた人はいませんでした。1か月かけて構築する前に知っておきたいのは、まさにこうしたことです。
異なる点
| LLMに「これを買う人はいますか?」と尋ねる問題点 | mockcrowdが行うこと |
|---|---|
| モデルは同調的で、何にでも肯定的に答えます | すべてのペルソナが、同じブラインド投票で平凡な対照案も評価します。判定に使うのは生の肯定率ではなく、対照案に対する上昇分です。 |
| 作り上げたペルソナの発言は、宣伝文句のように聞こえます | すべてのペルソナは実際の投稿をもとに作られ、その投稿を引用します。群衆の態度の構成(肯定的、中立、懐疑的、否定的)は、それらの投稿で測定した割合に合わせられます。 |
| 一つの声しかなく、社会的な相互作用もありません | Reddit風の議論です。約20人のペルソナによるスレッド、ランキング形式のフィード、固定されたアクション(コメント、返信、賛成票、反対票、何もしない)を備え、OASISの設計に従っています。人々が話す前と後の投票結果を確認できます。 |
| ツールの判定が正しいか知る方法がありません | 結果が判明している製品(クラウドファンディングの記録や、よく知られた失敗例)を使った評価とバックテストに加え、ご自身で記録した結果も利用できます。 |
インストール
pip install mockcrowd
# or: uv tool install mockcrowd
mockcrowd brains        # shows which AI it can use
Python 3.10以降が必要です。依存関係は小さなパッケージ1つ(certifi)です。
mockcrowdは1日1回PyPIを確認し、新しいバージョンがあると1行だけ表示します。何かをインストールすることはありません。アップグレードするには、pip install -U mockcrowdまたはuv tool upgrade mockcrowdを実行してください。確認を無効にするには、MOCKCROWD_NO_UPDATE_CHECK=1を設定します。
ブレインを選ぶ
mockcrowd は最初に見つかったブレインを使用します。または、--brain で指定したブレインを使用します。
| ブレイン | 実行方法 | セットアップ |
|---|---|---|
claude | Claude Code プランで claude -p を実行 | Claude Code をインストール済み |
codex | ChatGPT または API プランで codex exec を実行 | Codex CLI をインストール済み |
code-puppy | 設定済みのモデルで code-puppy -p を実行 | Code Puppy をインストール済み |
ollama | ローカルモデルを使用。無料でプライベートですが、速度は遅めです | ollama serve を実行し、その後 --model <name> を指定 |
openai | OpenAI 互換の任意のエンドポイント(OpenAI、OpenRouter、LM Studio、vLLM) | MOCKCROWD_API_BASE、MOCKCROWD_API_KEY、--model |
Claude は最初から最後まで実際に実行してテスト済みです。Codex、Code Puppy、Ollama、OpenAI のアダプターは各ツールのドキュメントに記載されたフラグと API に対してテスト済みですが、まだ実環境での実行は行っていません。報告を歓迎します。Claude と Code Puppy はツールを無効にして実行されます。Codex は読み取り専用のサンドボックスで実行されます。書き込みはブロックされますが、読み取りは可能なため、マシンに機密ファイルがある場合は、ほかのものを優先してください。
--model は、指定したとおりにそのまま渡されます。ペルソナを 500 件使用する実行では、1 回の呼び出しでペルソナのバッチまたはスレッド全体を処理するため、LLM の呼び出し回数はおよそ 100~150 回です。より高速で低コストのモデルを使うと、実行時間を短縮できます。OPENAI_API_KEY は api.openai.com を使う場合にのみ使用されます。ほかのエンドポイントでは MOCKCROWD_API_KEY が必要です。
実際のユーザーの声
| ソース | キーが必要 | 備考 |
|---|---|---|
| はい。無料です | reddit.com/prefs/apps で「script」アプリを作成し、REDDIT_CLIENT_ID と REDDIT_CLIENT_SECRET を設定します。Reddit はキーなしのリクエストをブロックします。無料での利用は非営利目的に限られます。 | |
| Hacker News | いいえ | Algolia 検索 API を通じたコメント |
| Bluesky | いいえ | 公開投稿の検索 |
| GitHub | いいえ | 開発者が対象の場合のみ、イシューと上位コメントを取得します。レート制限を引き上げるには GITHUB_TOKEN を設定します。 |
| App Store | いいえ | --source appstore で有効にします。最後にテストした際、Apple の公開レビュー取得フィードからレビューは返されませんでした。 |
| その他すべて | X、Threads、Instagram、Discord、アンケート、サポートチケット、インタビューメモ:投稿をファイルに保存し、--voices posts.jsonl(JSONL、CSV またはテキスト)を渡します。 |
取得に失敗したソースはすべてレポートに記載され、根拠が乏しい場合は信頼度スコアが下がります。
コーディングエージェントから使う
mockcrowd install-skill                    # Claude Code: ~/.claude/skills/mockcrowd
mockcrowd install-skill --dir <skills dir> # any agent that reads SKILL.md files
次のように依頼します:「月額 $3.99 のレコードコレクションアプリのアイデアを検証して」。エージェントが mockcrowd を実行し、ソースがブロックされた場合は、独自の Web ツールで投稿を収集して渡すことができます。
任意の AI エージェントから使う(MCP)
pip install "mockcrowd[mcp]"
claude mcp add mockcrowd -- mockcrowd mcp   # Claude Code
ほかの MCP クライアント(Cursor、Codex、Claude Desktop、独自のエージェント)も、stdio 経由で mockcrowd mcp コマンドを実行して起動できます。
{"mcpServers": {"mockcrowd": {"command": "mockcrowd", "args": ["mcp"]}}}
インストールせずに常に最新リリースを実行するには、uvx を使用します:{"command": "uvx", "args": ["--python", "3.12", "mockcrowd[mcp]@latest", "mcp"]}。
| ツール | 機能 |
|---|---|
validate_idea | アイデアについてクラウドを実行し、判定結果、支払う意思と無料で試す意思の割合、リフト、信頼度、主な反対意見、およびレポート全文を返します |
get_report | 過去の実行のレポート |
list_runs | 判定結果付きの過去の実行一覧 |
record_outcome | 実行後に実際に起きたことを記録します。バックテストのケースになります |
list_brains | 利用可能な AI バックエンドを確認します |
エージェントでの実行は、処理をすばやく終えるため、デフォルトでペルソナ 60 件、ラウンド 1 回に設定されています。
無料のアイデアとオープンソースの機能
オープンソースの機能や無料アプリのように、誰も料金を支払わないものには、--free を追加します。クラウドには支払う意思ではなく利用する意思を尋ね、議論後の関心度を特徴のない対照群と比較して判定します。実際の機能リクエストを使ってバックテストするには、--exclude github.com/owner/repo/issues/123 を追加します。クラウドには、評価対象のイシューが表示されなくなります。
コマンド
mockcrowd validate "idea" [--price P | --free] [--audience A] [--agents 500] [--rounds 2]
                          [--voices file.jsonl] [--no-live] [--source reddit|hn|bluesky|github|appstore]
                          [--exclude TEXT]
                          [--question "choice:first:Which feature first?:scan|alerts|wishlist"]
                          [--brain auto|claude|codex|code-puppy|ollama|openai] [--model M]
mockcrowd collect "idea" -o voices.jsonl   # only gather real posts
mockcrowd runs                             # list past runs
mockcrowd report <run-id> [--json]
mockcrowd outcome <run-id> --demand high|medium|low --note "what really happened"
mockcrowd eval --suite quick|full|backtest [--gate]
実行結果は ~/.mockcrowd/runs/<run-id>/ に report.md および run.json(すべてのユーザーの声、ペルソナ、投票、コメントを含む)として保存されます。
実行の仕組み
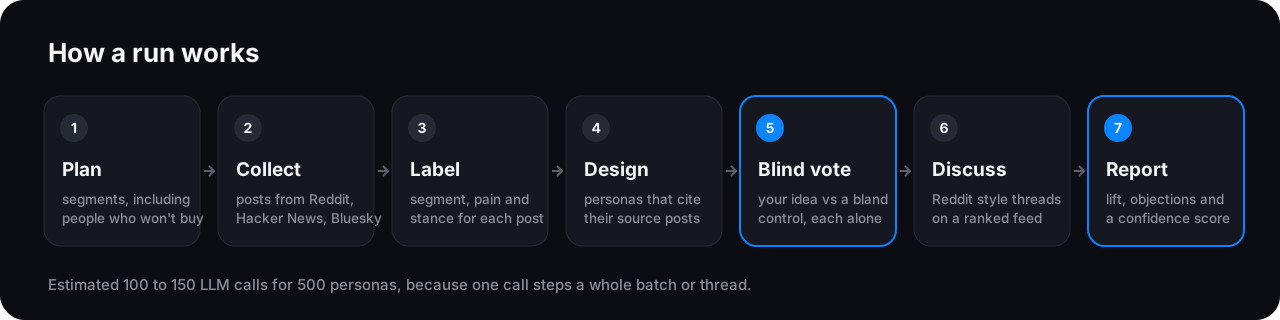
- 計画。 ブレインがアイデアを読み取り、セグメント(購入しない人も含む)、サブレディット、検索クエリをリストアップします。
- 収集。 上記のソースから実際の投稿を収集します。
- ラベル付け。 各投稿にセグメント、関連性、課題の深刻度、スタンスを割り当てます。関連性のない投稿は除外します。
- 設計。 実際の投稿のサンプルから、投稿に示されたセグメントの割合とスタンスの構成に沿って、ペルソナをバッチごとに作成します。各ペルソナは、参照した投稿を引用します。
- ブラインド投票。 各ペルソナが単独で、関心度、無料なら試すか、料金を支払うか、最大の懸念点に加え、入力した独自の質問に回答します。実際のアイデアと、特徴のない対照案をランダムな順序で並べて提示します。
- 議論。 さまざまなペルソナ約20人によるスレッドで、ランキング形式のフィードを使い、各ラウンドで各人が1つのアクションを行います。
- 最終投票とレポート。 95%区間を含む割合、対照案との差、議論後の変化、セグメント別の結果、懸念点のテーマ、信頼度スコアを示します。
評価と継続的な改善
mockcrowd eval はシミュレーター自体を評価し、~/.mockcrowd/evals/history.jsonl に結果を追記します。--gate を指定すると、いずれかの指標が過去の最高値を5ポイント超下回った場合に終了コード1で終了します。
| 指標 | 評価内容 |
|---|---|
| grounding, citation_valid | ペルソナが実際の投稿に基づいて作られているか、引用先が存在するか |
| mix_fidelity | 群衆のスタンスの構成が実際の投稿と一致しているか |
| diversity | ペルソナ同士が互いのコピーになっていないか |
| control_lift, agreeableness | 群衆が特徴のないアイデアを高く評価していないか |
| persuasion_drift | 議論によって投票結果がどれだけ動いたか |
| stability | 投票を再実行しても同じ結果になるか |
| realism | 評価者が実際の投稿とペルソナのコメントを見分けられないか |
| backtest_accuracy, backtest_auc | 成功例が失敗例より高く評価されるか |
| leakage | ブレインが記憶から認識するバックテスト対象の製品数 |
バックテストには13件のケースが含まれています。うち6件は、クラウドファンディングまたはユーザー増加で記録を達成した事例(たとえば Pebble Time、Exploding Kittens、Flow Hive)で、7件はよく知られた失敗例(たとえば Juicero、Quibi、Fire Phone)です。各ケースには出典が記載されています。ピッチは匿名化されており、leakage 指標は、それでもモデルがどれだけの頻度でケースを認識するかを報告します。
あなたの実績が、最も強いシグナルです。 テストまたはローンチ後に、mockcrowd outcome <run-id> --demand ... を実行してください。その実行結果がバックテストケースになり、今後の信頼度スコアには、あなたのケースに似たケースで mockcrowd がどの程度の結果を出したかが反映されます。
正直な限界
- これはシミュレーションです。アイデアの優先順位付け、懸念点の発見、実際にテストする内容の選定に使い、収益予測には使わないでください。
- ペルソナはオンラインに投稿する人々を反映しています。そうした人々は、ほとんどの購入者より声が大きく、意見が強い傾向があります。
- バックテスト対象の製品は有名なため、モデルがその結末を知っている可能性があります。leakage 指標に注意してください。
- 判定しきい値は初期設定です。バックテストでは、あなたのブレインで成功例と失敗例をどれだけ適切に区別できるかが報告されます。
クレジット
シミュレーションの設計は、CAMEL-AI による OASIS(Apache 2.0)に従っています。シード素材から世界を構築し、シミュレーションするというアイデアは、MiroFish に着想を得ています。どちらのプロジェクトのコードも含まれていません。NOTICE を参照してください。
ライセンス
Apache 2.0
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。