kairn について
Kairnは、AIエージェント向けのローカルファーストなナレッジエンジンで、ナレッジグラフとコンテキストルーティングによりセッションをまたいで情報を保存・検索します。関連情報を段階的に開示し、時間とともに減衰する経験記憶も扱います。
主な機能
- 01型付き関係によるグラフ構築
- 02キーワードに基づくコンテキストルーティング
- 03要約から詳細への段階的な開示
- 04時間経過で減衰する経験の保存
- 05確信度に応じた知識の振り分け
- 06ワークスペースごとのSQLiteデータ分離
活用シーン
- 01セッションをまたいだ決定や解決策の記憶
- 02プロジェクト内の関連知識の検索
- 03トピックに応じたグラフと経験の想起
- 04ワークスペースごとのプロジェクト記憶の分離
MCP 対応
Kairnはstdio MCPサーバーとしてMCPクライアントに接続し、知識グラフと経験記憶の保存、検索、想起に使う22個のツール、読み取り専用リソース、セッション管理用プロンプトを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Kairn
30秒の紹介動画をGitHubでご覧ください。
AI アシスタント向けの、コンテキストを理解するナレッジエンジンです。
ステータス:1.0 未満です。 2026年2月から日常的に使用されており、Linux、macOS、Windows で実行できるテストスイート(開発を参照)と、公開済みの LongMemEval-S ベンチマーク(0.3.0 より前に測定)があります。1.0 までは、リリースごとにインターフェースが変更される可能性があります。フィードバックや問題の報告を歓迎します。
ほかのツールは、AI に記憶を与えます。Kairn は、インテリジェントなコンテキストルーティングを備えたナレッジグラフを提供します。何を、いつ、どれだけ読み込むべきかを判断するため、AI は情報に圧倒されず、集中力を保てます。
pip install kairn-ai
kairn init ~/brain
kairn serve ~/brain
Claude Code と Codex の設定はそれぞれ1行で済みます。--init を指定すると、初回起動時に ~/brain とそのデータベースが作成されるため、kairn init を実行しなくても使えます。
claude mcp add kairn -- kairn serve --init ~/brain
codex mcp add kairn -- kairn serve --init ~/brain
また、Python のセットアップが不要なワンクリックバンドルとしてインストールすることもできます。最新リリースから
.mcpb ファイルをダウンロードし、Claude Desktop などのバンドル対応アプリで開いてください。
ほかのクライアントについては、以下のクイックスタートをご覧ください。Kairn を初めて使う場合は、最初の5分をご覧ください。
インストール方法
| 方法 | 対象 | コマンド |
|---|---|---|
| PyPI | Python を利用できるすべての方と、すべての MCP クライアント | pip install kairn-ai |
MCP Bundle(.mcpb) | Claude Desktop などのバンドル対応アプリ。Python のインストールは不要です | リリースからダウンロードして開く |
| Claude Code | 1行で設定。PyPI からインストールします | claude mcp add kairn -- kairn serve --init ~/brain |
| Codex | 1行で設定。PyPI からインストールします | codex mcp add kairn -- kairn serve --init ~/brain |
バンドルには、Kairn のソースコードは含まれていません。kairn-ai を依存関係として宣言し、ホストが uv で解決するため、バンドルでのインストールも pip install も同じコードを実行します。バンドルのインストール時にデータベースの保存場所を設定できます。デフォルトは ~/.kairn で、データベースがマシンの外に送られることはありません。
Kairn を選ぶ理由
AI との会話は、毎回ゼロから始まります。過去の洞察、決定、パターンはすべて失われます。既存の記憶ツールは、関係性を表現したり、適切なタイミングで適切なコンテキストを提示したりできない、フラットなキーと値のペアを保存します。
Kairn は異なります。
- コンテキストルーター+段階的な開示 - キーワードに基づいて関連するサブグラフを自動で読み込みます。まず要約を提示し、必要な場合にのみ詳細へと掘り下げます。これを実現するほかのツールはありません。
- FTS5 を備えたナレッジグラフ - フラットなストレージではありません。ノード間の型付き関係(
depends-on、resolves、causes)に出典情報の追跡機能があり、すべてのデータを全文検索できます。 - 経験の減衰+自動昇格 - 経験は時間の経過とともに関連性が薄れます(生物学的な減衰モデル)。頻繁にアクセスされる経験は、恒久的なナレッジへ自動的に昇格します。AI は重要でないことを自然に忘れていきます。
- 22個の MCP ツール - Claude Code、Codex、Claude Desktop、Cursor、VS Code、Windsurf、およびあらゆる MCP クライアントで動作します。5種類の関係性を判定する
kn_judgeと、読み取り専用のヘルス診断を行うkn_doctorが含まれます。 - ワークスペースごとの分離 - 各ワークスペースは、それぞれ独立した SQLite ストアです。チームでのデプロイ向けに、JWT 認証とロールベースのアクセス制御(owner / maintainer / contributor / reader)を備えています。
クイックスタート
Claude Desktop
macOS では ~/Library/Application Support/Claude/claude_desktop_config.json に、Windows では %APPDATA%\Claude\claude_desktop_config.json に追加します。
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
Cursor
.cursor/mcp.json に追加します。
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
VS Code
.vscode/mcp.json に追加します:
{
  "servers": {
    "kairn": {
      "type": "stdio",
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
Windsurf
~/.codeium/windsurf/mcp_config.json に追加します:
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
エディターを再起動してください。MCP セクションに Kairn の 22 個のツールが表示されます。
最初の 5 分間
最初から最後まで、ガイドに沿って初回実行します:
pip install kairn-ai
kairn init ~/brain              # creates the workspace + database (optional: serve --init does it on first start)
上記のワンライナー(またはクライアントのクイックスタート用スニペット)を追加してから、クライアントを再起動します。接続したら、アシスタントに何かを覚えさせてみましょう:
「分析サービスでは、同時書き込みが必要だったため、SQLite ではなく Postgres を選んだことを覚えておいてください。」
内部では kn_learn が呼び出され、次のような JSON エンベロープが返されます(実際の実行結果を kairn learn 経由で取得したものです。これはツールを CLI でミラーリングしたものです):
{"_v": "1.0", "stored_as": "node", "node_id": "002d9c22", "experience_id": "d0710c2f", "type": "decision", "confidence": "high", "namespace": "knowledge", "candidates": []}
新しいセッションを開始し、同じ内容を思い出すように依頼します。kn_recall が呼び出され、説明し直さなくても、保存した内容が表示されます:
{"_v": "1.0", "count": 2, "results": [
  {"source": "node", "id": "002d9c22", "name": "Decision: we chose Postgres over SQLite for the analytics service beca", "type": "learned_decision", "description": "we chose Postgres over SQLite for the analytics service because we needed concurrent writers", "relevance": 1.0, "relevance_kind": "match"},
  {"source": "experience", "id": "d0710c2f", "type": "decision", "content": "we chose Postgres over SQLite for the analytics service because we needed concurrent writers", "confidence": "high", "relevance": 1.0, "relevance_kind": "recency"}
]}
kn_learn は永続的なグラフノードと、時間とともに減衰する経験の両方を保存しました(信頼度が高い場合は両方が保存されます。信頼度による振り分けを参照してください)。kn_recall は、3 語のトピックから両方を見つけました。
relevance を読む前に relevance_kind を確認してください。 上記のどちらの行も 1.0 ですが、意味は同じではありません。match は語彙的な一致の強さ(bm25)を表します。経験の recency は時間減衰を表し、その行が数秒前に作成されたため 1.0 になっています。一致度が高いという意味ではありません。3 つ目の値 similarity は、セマンティック検索の経路における埋め込みのコサイン類似度です。また、unscored は、サーフェスにランキング情報がなく、一定値が補われた行を示します。種類が異なる値は比較できないため、relevance だけを基準に結果を混在させて並べ替えないでください。kn_recall の min_relevance にも同じ注意が必要です。ノードには一致の強さ、経験には新しさをしきい値として適用するため、1 つの数値で 2 つの尺度を扱います。経験のみを扱う kn_memories と kn_prune では、新しさが対象になります。また、kn_prune では削除が行われます。
スモークテストとして、いつでも kairn status ~/brain を実行できます。ノード数、エッジ数、経験数を示す JSON 統計ブロックが出力されれば、ワークスペースは正常です。手作業ではなく、すべてのコア機能をスクリプトで一通り試したい場合は、kairn demo ~/brain を実行してください。ノードの作成、クエリ、経験の保存、学習、想起、コンテキストを約 30 秒で順に実行します。
どのツールを使うか
22 個のツールすべてを初日から把握するのは大変です。ほとんどのセッションでは、次のツールだけで十分です。
| したいこと | 使うツール | 理由 |
|---|---|---|
| 新しいこと(決定事項、注意点、パターン、解決策)を記憶する | kn_learn | デフォルトの入り口です。永続ノード(信頼度が高い場合)または減衰する経験(信頼度が中〜低の場合)に自動で振り分けられるため、自分で判断する必要はありません |
| ユーザーが明示した好みを、表明された瞬間に記録する | kn_preference | 専用の好み記録経路です。呼び出すモデルであるあなたが、好みを明示的な一文で表現します。あらゆる種類の中で最も長い半減期で保存されます |
| 永続性があるとすでに分かっている、名前付きの概念を追加する | kn_add | 減衰を完全にスキップします。日々の経験ではなく、構造的な知識に使います |
| 信頼度や減衰を明示的に制御して、一度限りの経験を記録する | kn_save | kn_learn が内部で使用する低レベルのプリミティブです。信頼度や減衰を自分で設定したい場合に使います |
| テキスト、種類、タグ、名前空間で永続的な知識グラフを検索する | kn_query | 減衰する経験ではなく、ノードを探している場合に使います |
| 保存した経験を関連度と減衰に基づいて並べ替えて検索する | kn_memories | グラフノードではなく、経験の内容(解決策、注意点、回避策)を探している場合に使います |
| トピックに関連するすべての情報を 1 回の呼び出しで表示する | kn_recall(フラットリスト)または kn_context(サブグラフ。段階的な開示:まず概要を表示し、必要に応じて全詳細を表示) | 答えがノードか経験かまだ分からない場合は、Kairn に両方を検索させます |
その他のすべて(kn_crossref、kn_related、kn_connect、kn_judge、kn_project/kn_projects/kn_log、kn_idea/kn_ideas、kn_promote_pending、kn_prune、kn_remove、kn_status、kn_doctor)は高度な使い方です。基本を把握したら、以下の完全な 22 Tools リファレンスをご覧ください。
22 Tools(kn_ プレフィックス)
すべてのツールは JSON レスポンスを返す MCP プロトコルに準拠しています。
グラフ(6)
| ツール | 説明 |
|---|---|
kn_add | 知識グラフにノードを追加します |
kn_connect | ノード間に型付きエッジを作成します(緩いモードの語彙) |
kn_judge | 5 種類の動詞による判定エッジを記録します(厳密モード:conflicts_with / supersedes / compatible / scoped / related) |
kn_query | テキスト、種類、タグ、名前空間で検索します |
kn_remove | ノードまたはエッジを論理削除します(安全に元に戻せます) |
kn_status | グラフの統計、健全性、システムの概要を表示します |
プロジェクトの記憶(3)
| ツール | 説明 |
|---|---|
kn_project | プロジェクトを作成または更新します |
kn_projects | プロジェクトを一覧表示し、アクティブなプロジェクトを切り替えます |
kn_log | 進捗または失敗の記録を残します |
経験の記憶(5)
| ツール | 説明 |
|---|---|
kn_save | 減衰を設定して経験を保存します |
kn_preference | 発言時にユーザーが明示した好みを記録します(最も長い半減期) |
kn_memories | 減衰を考慮して経験を検索します |
kn_prune | 期限切れの経験を削除します |
kn_promote_pending | アクセス頻度の高い経験を永続ノードに昇格させます |
アイデア(2)
| ツール | 説明 |
|---|---|
kn_idea | アイデアを作成または更新します |
kn_ideas | ステータスやカテゴリでアイデアを一覧表示または絞り込みます |
インテリジェンス(5)
| ツール | 説明 |
|---|---|
kn_learn | 信頼度に基づいて振り分けながら知識を保存します |
kn_recall | 関連する過去の知識を表示します |
kn_crossref | 現在のワークスペースで、過去の類似した解決策を探します |
kn_context | キーワードから関連するサブグラフを段階的に開示します |
kn_related | グラフをたどって(BFS)、接続されたノードを探します |
診断(1)
| ツール | 説明 |
|---|---|
kn_doctor | 読み取り専用のヘルスチェック(ロックモード、FTS5 の整合性、昇格待ちの件数、名前空間の乱立、孤立したエッジ)を実行します。チェックごとの判定と全体の要約を含む構造化された結果を返します |
リソースとプロンプト
リソース(MCP クライアント向けの読み取り専用コンテキスト):
kn://status- グラフの概要、アクティブなプロジェクトkn://projects- 最近の進捗を含むすべてのプロジェクトkn://memories- 関連性の高い最近の経験
プロンプト(セッション管理):
kn_bootup- アクティブなプロジェクト、最近の進捗、重要な記憶を読み込む(セッション開始時)kn_review- セッションを要約し、次のステップを提案する(セッション終了時)
仕組み
アーキテクチャ
Any MCP Client (Claude, Cursor, VS Code)
        │
        ▼ MCP Protocol (stdio)
FastMCP Server (22 tools)
        │
   ┌────┼────┐
   ▼    ▼    ▼
Graph  Memory  Intelligence
Engine Engine  Layer
   │    │      │
   └────┼──────┘
        ▼
   SQLite + FTS5
   (per-workspace)
減衰モデル
経験の関連性は指数関数的に低下します。
relevance(t) = initial_score × e^(-decay_rate × days)
| 種類 | 半減期 | 備考 |
|---|---|---|
| solution | 120 日 | 安定しており、長く持続します |
| pattern | 90 日 | アーキテクチャに関する知識 |
| decision | 100 日 | コンテキストに依存します |
| workaround | 40 日 | 一時的な回避策は速く薄れていきます |
| gotcha | 70 日 | 厄介な落とし穴は関連性を保ちます |
| preference | 180 日 | 長く持続するユーザー設定。初期推定値であり、テールでの調整はまだ行われていません |
半減期は推測ではなく、本番環境の経験ストアにおける実際のアクセスのテールに基づいて調整されています(例外が 1 つあります。preference は新しい種類で、まだアクセス履歴がないため、実データが蓄積されるまでは文書化された初期推定値が使われます)。
kn_learn による信頼度に応じた振り分け:
high→ 永続ノードと経験(減衰なし)medium→ 減衰率 2 倍の経験low→ 減衰率 4 倍の経験- 自動昇格:アクセスが 5 回以上 → 永続ノード
- ノードのアクセス追跡:
kn_recall、kn_context、kn_crossrefはアクセスされたノードを記録し、減衰と昇格のパイプラインに反映します
ベンチマーク
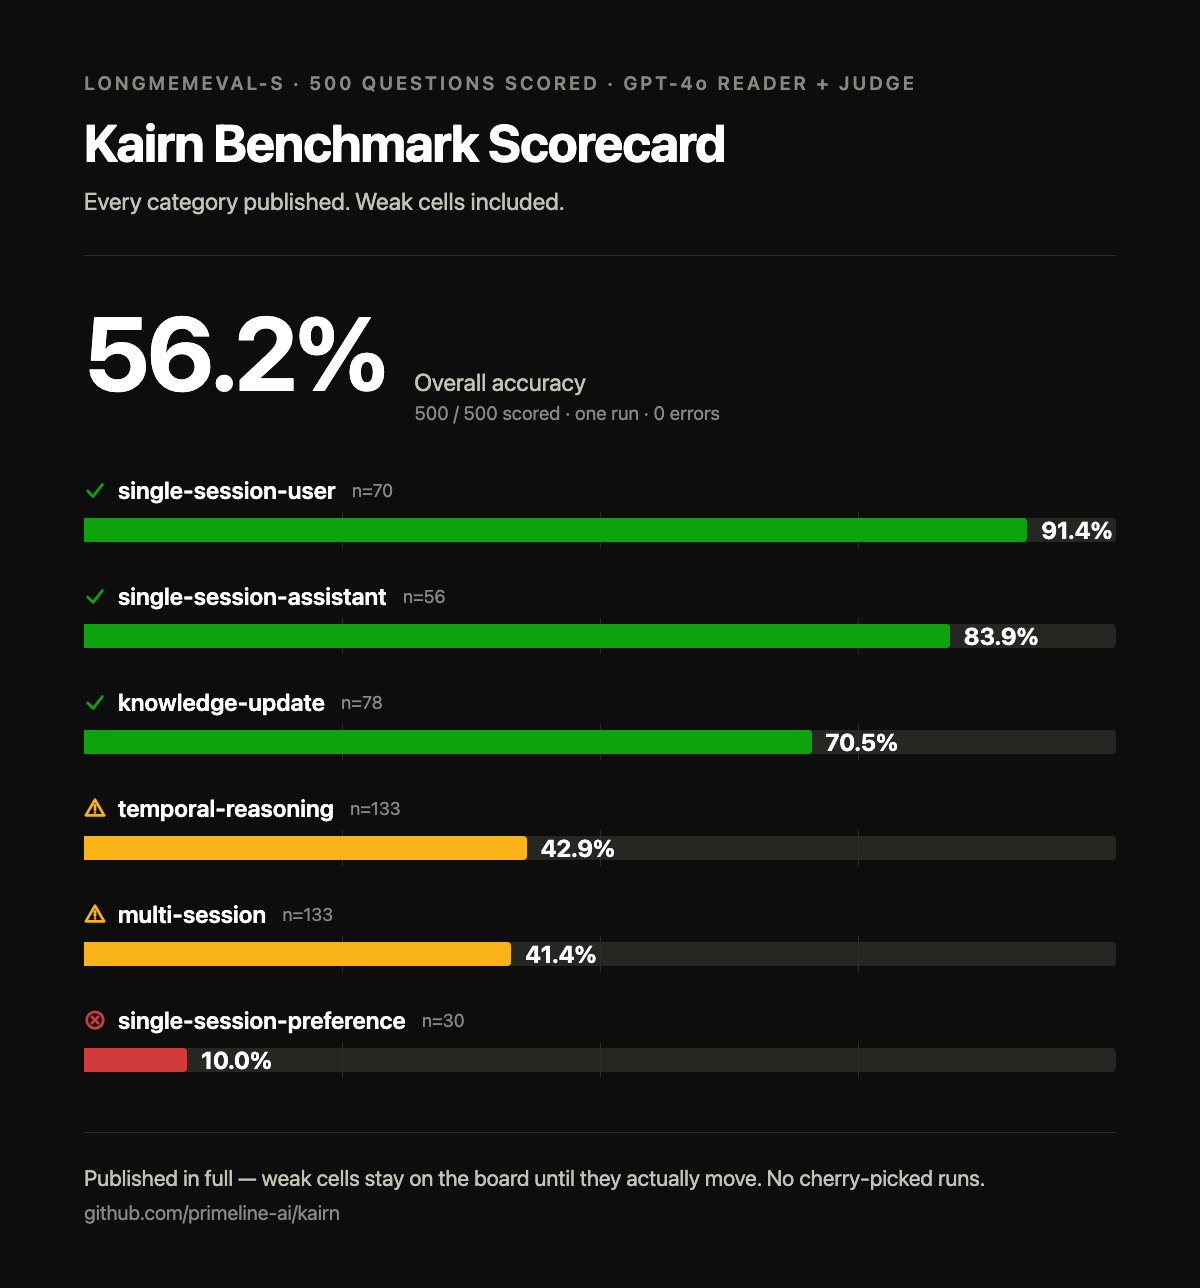
Kairn は 2026-06-12 の実行で LongMemEval-S の全体スコア 56.2% を達成しました(500/500 問を採点、 GPT-4o reader + judge、単一実行、エラー 0 件)。以下は、低い結果も含めたカテゴリ別の実測値です。各赤色のセルから診断結果を確認できます。
| カテゴリ | n | 正解率 | 診断 |
|---|---|---|---|
| single-session-user | 70 | 91.4% | - |
| single-session-assistant | 56 | 83.9% | - |
| knowledge-update | 78 | 70.5% | - |
| temporal-reasoning | 133 | 42.9% | 理由 |
| multi-session | 133 | 41.4% | 理由 |
| single-session-preference | 30 | 10.0% | 理由 |
500 問には、回答を控えるのが正解となる棄権パターンが 30 問含まれています。これらは上記のカテゴリに含まれており、別途採点されています。Kairn はその 96.7% で正しく回答を控えています。
この実行でのクエリあたりの検索レイテンシは約 1.4 ms でした(FTS5、プロセス内、ネットワークなし)。プロトコル、誠実性に関する注記、再現手順については、BENCHMARKS.md をご覧ください。
これらの数値は 2026-06-12 に測定されたもので、0.3.0 の検索機能の変更(マッチを考慮した経験スコアリング、網羅性で重み付けしたノード関連性)より前のものです。0.3.0 ではまだ再測定されていません。弱点セルは、数値が実際に改善するまで掲載し続けます。恣意的に選んだ実行結果や、非公開のカテゴリはありません。
CLI
kairn init [<path>]            # Initialize workspace; defaults to ~/.kairn
kairn serve [<path>]           # Start MCP server (stdio); defaults to ~/.kairn
kairn serve --init [<path>]    # Create workspace if needed and start MCP server; defaults to ~/.kairn
kairn status <path>            # Graph stats
kairn demo <path>              # Interactive tutorial
kairn benchmark <path>         # Local performance benchmarks (latency, not LongMemEval)
kairn token-audit <path>       # Audit tool token usage
kairn import git <path> <repo>...  # Import git commit history (zero-LLM, offline)
kairn import claude-code <path>    # Import Claude Code session history (zero-LLM, offline)
履歴のインポート
kairn import git <workspace> <repo>... は、$0 で 1 つ以上のローカル git リポジトリから Kairn ストアにデータを取り込みます。LLM の呼び出しもネットワークへの接続もありません。Conventional Commit の接頭辞はエクスペリエンスタイプに対応します(fix: → solution、feat:/refactor:/perf: → pattern、それ以外 → decision)。マージコミットはスキップされます。インポートしたエクスペリエンスは、通常のナレッジとは別の専用の imported-git 名前空間に格納されるため、常に区別でき、問題のあるインポートは完全に取り消せます。
kairn import git ~/brain ~/code/my-project --dry-run   # Preview first
kairn import git ~/brain ~/code/my-project              # Then import for real
kairn import git ~/brain ~/code/proj-a ~/code/proj-b --since 2026-01-01
冪等性があるため、再実行時にはまだインポートされていないコミットのみが取り込まれます。リポジトリの履歴が増えても、安心して再実行できます。
Claude Code のトランスクリプト
kairn import claude-code <workspace> は、既存の Claude Code セッション履歴から Kairn ストアにデータを取り込みます。こちらも $0 で、完全にオフラインで実行できます。--root を指定しない場合は ~/.claude/projects をスキャンします。--root PATH を指定すると、ほかのフォルダーを繰り返し上書き先として指定できます。インポートしたエクスペリエンスは専用の imported-claude-code 名前空間に格納されるため、通常のナレッジと区別でき、問題のあるインポートは取り消せます。
kairn import claude-code ~/brain --dry-run              # Review exactly what would be stored
kairn import claude-code ~/brain                        # Import (prompts once before writing)
kairn import claude-code ~/brain --root ~/other/projects --since 2026-01-01 --yes
保存される内容(粗粒度モード): 1 セッションにつき 1 つのエクスペリエンス。セッションのタイトルと、そのセッションで最初に送信したプロンプトが保存されます。これは、細かな意思決定ごとに抽出するのではなく、詳細度を抑えて精度を高める意図的な設計です。LLM を使わないルールベースの抽出では、記録された意思決定と通常の計画に関するやり取りを確実に区別できないため、import claude-code はノイズの多い断片ではなく、セッション単位の簡潔な参照情報をインポートします。完全なトランスクリプトのアーカイブではなく、一度きりの移行でもありません。冪等性があり、履歴が増えるにつれて再実行することを想定しています。
プライバシー。 保存されるすべての文字列は、最初に決定論的なシークレットの秘匿処理にかけられます(API キー、Authorization/Bearer ヘッダー、password=/token=/secret= の代入、一般的なベンダーのキー形式、秘密鍵ブロック、URL に埋め込まれた認証情報)。ツールの出力とツール呼び出しのブロックは読み取らず、ご自身のプロンプトテキストのみを対象とします。秘匿処理は多層防御の一部であり、それだけが制御手段ではありません。実際に実行する場合(ドライランではない場合)は明示的な確認が必要で、--dry-run を実行すると、書き込み前に秘匿処理後のテキストを正確に確認できます。秘匿処理の範囲はルールセットで定められているため、初回の実インポート前に --dry-run で確認することをおすすめします。データがマシンの外に送信されることはありません。
プラグインとしてインストールする
プラグインには uv が必要です。
Claude Code:
claude plugin marketplace add primeline-ai/kairn
claude plugin install kairn@kairn
Codex:
codex plugin marketplace add primeline-ai/kairn
codex plugin add kairn@kairn
すでに claude mcp add kairn または codex mcp add kairn で Kairn を追加している場合は、先に claude mcp remove kairn または codex mcp remove kairn でそのエントリーを削除するか、インストール方法を 1 つだけ残してください。どちらも kairn という名前を使用するためです。
機能の内容と codex exec の承認に関する注意事項については、プラグインの README を参照してください。
設定
KAIRN_WORKSPACE=~/brain               # Sets where config.yaml is read from and where 'kairn workspace' keeps team data; 'kairn serve' opens the store at the given path, or ~/.kairn without one, regardless of KAIRN_WORKSPACE
KAIRN_JWT_SECRET=<your-secret>        # Required for team features
KAIRN_LOG_LEVEL=WARNING               # Level of Kairn's log lines on stderr: DEBUG, INFO, WARNING, ERROR or CRITICAL; default INFO; overrides log_level in config.yaml
設定は <workspace>/config.yaml に保存されます。kairn init はこのファイルを書き込みますが、serve --init は書き込まないため、serve --init から開始した場合は手動で作成してください。ファイルがない場合はデフォルト設定が適用されます。セマンティック検索はオプトイン方式で、デフォルトでは無効です。ローカルの Ollama サーバーの埋め込みを使って検索結果を再ランク付けするため、保存されたコンテンツがマシンの外に送信されることはありません。
semantic_recall: true
embedding_model: bge-m3                 # ollama pull bge-m3
embedding_host: http://localhost:11434
semantic_recall_floor: 0.5              # cosine floor below which semantic recall abstains
semantic_recall_top_n: 30               # keyword candidates reranked by embeddings
experience_min_match: 0.0              # match floor for experience recall, 0.0-1.0; 0 turns it off
開発
git clone https://github.com/primeline-ai/kairn
cd kairn
pip install -e ".[dev,team]"
pytest tests/ -v --cov
ruff check src/ && ruff format src/
プロジェクト構成
src/kairn/
├── server.py              # FastMCP server + 22 tools
├── cli.py                 # CLI commands
├── config.py              # Configuration
├── core/
│   ├── graph.py           # GraphEngine (6 tools)
│   ├── memory.py          # ProjectMemory (3 tools)
│   ├── experience.py      # ExperienceEngine (4 tools)
│   ├── ideas.py           # IdeaEngine (2 tools)
│   ├── intelligence.py    # IntelligenceLayer (5 tools)
│   └── router.py          # ContextRouter
├── storage/
│   ├── base.py            # Storage interface
│   └── sqlite_store.py    # SQLite + FTS5 implementation
├── models/                # Data models
├── events/                # Event bus
└── auth/                  # JWT + RBAC (team feature)
パフォーマンス
この表を鵜呑みにせず、ご自身で測定してください。
kairn benchmark ~/brain --nodes 100
Apple M4 Pro でノード数 100 にしてこのコマンドを 1 回実行した結果:
| 操作 | 測定値 |
|---|---|
| 挿入 | ノードあたり 0.7ms(1,479 ops/sec) |
| FTS5 クエリ | 0.2ms(5,552 ops/sec) |
| グラフ走査 | 6.0ms(166 ops/sec) |
1 台のマシンでの 1 回の実行結果なので、仕様値ではなく、おおよその傾向として捉えてください。そのため、コマンドを表の上に掲載しています。kn_connect と kn_crossref は、以前はベンチマークで得られない数値とともに掲載されていましたが、推定値を載せるのではなく削除しました。
使用プロジェクト
| プロジェクト | Kairn の用途 |
|---|---|
| Quantum Lens | インサイトの永続的な保存、分析をまたいだパターンの追跡、レンズの有効性指標 |
| Claude Code Starter System | セッションメモリ、プロジェクトの状態、学習内容の永続化 |
ライセンス
MIT
PrimeLine エコシステムの一部
| ツール | 機能 | 詳細 |
|---|---|---|
| Evolving Lite | 自己改善型の Claude Code プラグイン — メモリ、委任、自己修正 | ブログ |
| Kairn | AI 向けのコンテキストルーティング機能を備えた永続的なナレッジグラフ | ブログ |
| tmux Orchestration | ハートビート監視機能を備えた Claude Code の並列セッション | ブログ |
| UPF | 敵対的な強化を取り入れた3段階の計画 | ブログ |
| Quantum Lens | 多角的な分析のための7つの認知レンズ | ブログ |
| PrimeLine Skills | Claude Code 向けの本番環境品質のワークフロースキル5種 | ブログ |
| Starter System | 軽量なセッションメモリと引き継ぎ | ブログ |
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。