SuperLocalMemory について
SuperLocalMemory は、AI エージェントやチーム向けのローカル優先型メモリサーバーです。決定事項や文書をアクセス制御と出典付きで保存・検索し、メッシュを介してエージェントやウェブボット間で共有できます。答えが見つからない場合は、その旨を明示します。
主な機能
- 01ローカル優先の記憶保存と検索
- 02出典付きの回答
- 03画像と文書の検索
- 04ロールとワークスペースによるアクセス制御
- 05エージェント間のメモリメッシュ
- 06監査記録と取り消し可能な変更
活用シーン
- 01セッションをまたいだプロジェクト決定の検索
- 02PDF やスクリーンショット内の情報検索
- 03エージェントやボット間のコンテキスト共有
- 04アクセス制御付きのチームメモリ管理
MCP 対応
MCP 対応エージェントにメモリ機能を公開します。README にはエージェントクライアントへの接続が記載されていますが、MCP ツールやリソースの詳細は示されていません。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
58掲載時のツール一覧 · 今日に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| kind | string | いいえ | |
| tags | string | いいえ | |
| scope | any | いいえ | |
| content | string | はい | |
| project | string | いいえ | |
| speaker | string | いいえ | |
| agent_id | string | いいえ | |
| replaces | any | いいえ | |
| importance | integer | いいえ | |
| profile_id | string | いいえ | |
| session_id | string | いいえ | |
| shared_with | string | いいえ | |
| session_date | string | いいえ | |
| idempotency_key | string | いいえ |
詳細
あらゆる AI エージェントのための、ガバナンスの効いたメモリブレイン。あなたのマシン上で動作し、決して知ったかぶりをしません。
あなたとチームが使うすべてのエージェントで、メモリをひとつに — Claude Code、Codex、Cursor、Copilot、Antigravity、Hermes、ChatGPT、Web 版 Claude、Grok Bot、Muse、そして MCP に対応する、またはコマンドを実行するあらゆるハーネスに対応します。意思決定、ドキュメント、スクリーンショット、PDF を、頼み方に応じて呼び出せます。会社のデータとして適切に管理され、ローカルのエージェントと Web ボットが互いにやり取りするメッシュを通じて共有され、誠実に回答します。答えがなければ、エージェントは自信たっぷりの推測ではなく、「それは SuperLocalMemory にありません。」 と伝えます。




インストール · 動作を見る · デモ全編 · すべての機能 · ドキュメント · Web サイト
⭐ SuperLocalMemory によってエージェントの推測を防げているなら、リポジトリにスターを付けてください。ほかの開発者が見つけやすくなります。
エージェントはセッションのたびにすべてを忘れてしまいます。よくある対策 — 保存ボタン付きのベクトルストア — は、かえって状況を悪化させます。 保持している情報に答えがない場合でも、常に何かを返し、エージェントはそれを前提にしてしまいます。これはメモリのブレインであり、ただの入れ物ではありません。保存された内容(誰が、何を、いつ、どのプロジェクトで)を理解し、時間が経っても正確さを保ち、誰が閲覧できるかを管理し、知ったかぶりをしません。その仕組みは 4 本の arXiv 論文で説明されています。
モード A では、中核となる記憶と想起にモデルプロバイダーへの呼び出しは不要です。API キーも、クラウドアカウントも、Docker も必要ありません。データを外部に送信するかどうかは自分で選べます。ドキュメントには、何が送信されるかを正確に記載しています。
インストール
最も簡単な方法は、AI エージェントにインストールを任せることです。 以下のブロックを Claude Code、Codex、Cursor、またはコマンドを実行できる任意のエージェントにコピーしてください。セットアップガイドを読み、質問を1つして、すべてをセットアップし、動作するものを教えてくれます。覚える必要のあるターミナルコマンドはありません。
Install SuperLocalMemory on this computer for me. Follow
https://github.com/qualixar/superlocalmemory/blob/main/SETUP_FOR_AGENTS.md
step by step and show me what each step printed. Ask me only one question,
before turning on anything optional: whether I also want to find my pictures,
screenshots and PDFs by describing them. Connect SuperLocalMemory to the agent
I am using. When you finish, run slm doctor and tell me in plain words what works.
AI エージェントを使わない場合は、ターミナルで1行(macOS および Linux)。Python を同梱してすべてをセットアップし、見つかった AI ツールに接続してダッシュボードを開きます。事前に Python や npm を用意する必要はありません。
curl -fsSLo get-slm.sh https://raw.githubusercontent.com/qualixar/superlocalmemory/main/scripts/get-slm.sh && sh get-slm.sh
最初から画像やドキュメントも追加するには、末尾に sh get-slm.sh --media を付けてください。スクリプトをダウンロードしてから実行するため、実行前に内容を確認できます。Windows の場合は、上記のエージェント向けプロンプト、または以下の npm や pip を使用してください。
ターミナルを使いたい場合は、どちらの方法でも同じセットアップができます。このマシン上にテキストメモリが作成され、希望すれば画像やドキュメントも追加されます。
npm は主要な方法です(Node 18 以降)。SLM はパッケージ専用の仮想環境にインストールされます。
npm install -g superlocalmemory   # add --media to also turn on pictures and documents
slm setup                         # pick Mode A to keep everything on this machine
slm connect claude-code           # or codex, cursor, windsurf, zed, claude-desktop, jetbrains, opencode ...
pip はもう一つの主要な方法です(Python 3.12~3.14)。有効化する Python 仮想環境にインストールします。
python3 -m venv .venv
source .venv/bin/activate         # Windows: .venv\Scripts\activate
python -m pip install superlocalmemory   # or, without a venv: pipx install superlocalmemory
slm setup
slm connect claude-code
slm media enable                  # optional: pictures and documents (about 1.5 GB; needs 16 GB of memory)
uv:uv tool install --python 3.12 superlocalmemory を実行すると、slm が独立したツールとしてインストールされます。有効化は不要です。詳しくはLinux のインストールをご覧ください。
Claude Code プラグイン: claude plugin marketplace add qualixar/superlocalmemory を実行し、続けて claude plugin install superlocalmemory@qualixar を実行します。Codex: slm connect codex を実行し、続けて slm codex install を実行します。
2つのモデルで、1つのメモリ。 テキストの検索には、小型のローカルテキストモデル(nomic)を使用します。画像やドキュメントを有効にすると、2つ目のローカルモデル(Google の EmbeddingGemma 2)がそれらを読み取り、1回の検索で両方が返されます。画像モデルは30分間使用されないとアンロードされるため、テキストだけで作業している間はメモリを占有しません。詳細:画像とドキュメント、はじめに、エージェントのセットアップ手順。
リポジトリをクローンした場合:./scripts/install.sh install(macOS、Linux)または .\scripts\install.ps1 -Action Install(Windows)を実行します。Windows、Linux、Apple Silicon 搭載 Mac で動作します(プラットフォーム)。
30秒の使用例
$ slm remember "We deploy the API blue-green; rollback is a DNS flip." --kind decision
Queryable ✓ 1 facts
$ slm remember "Staging DB is Postgres 16 on port 5433."

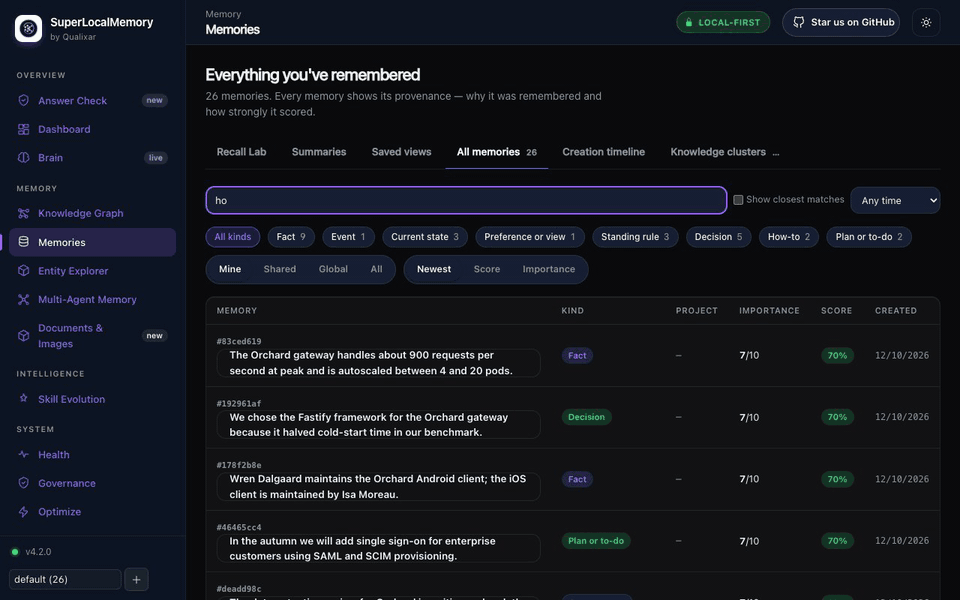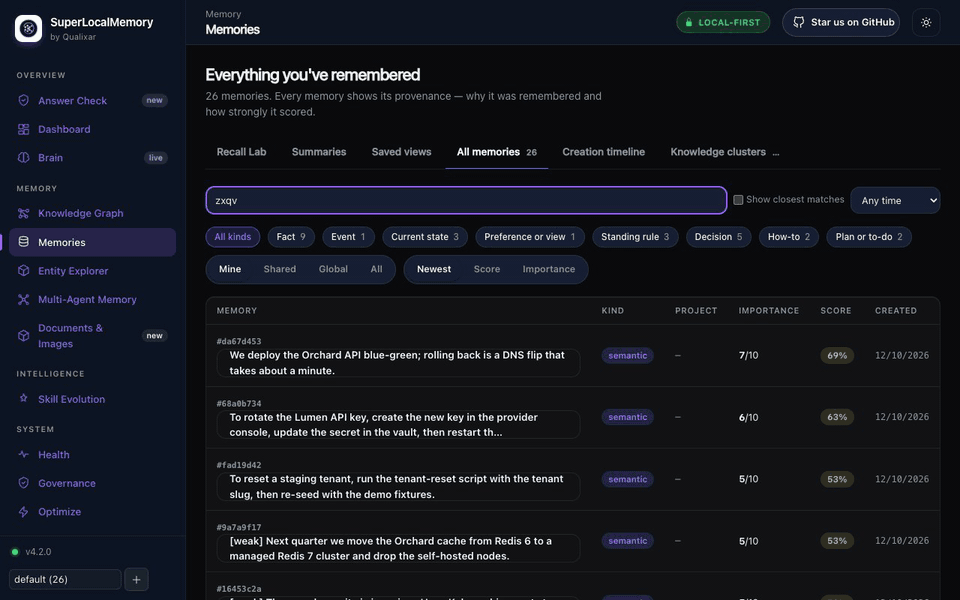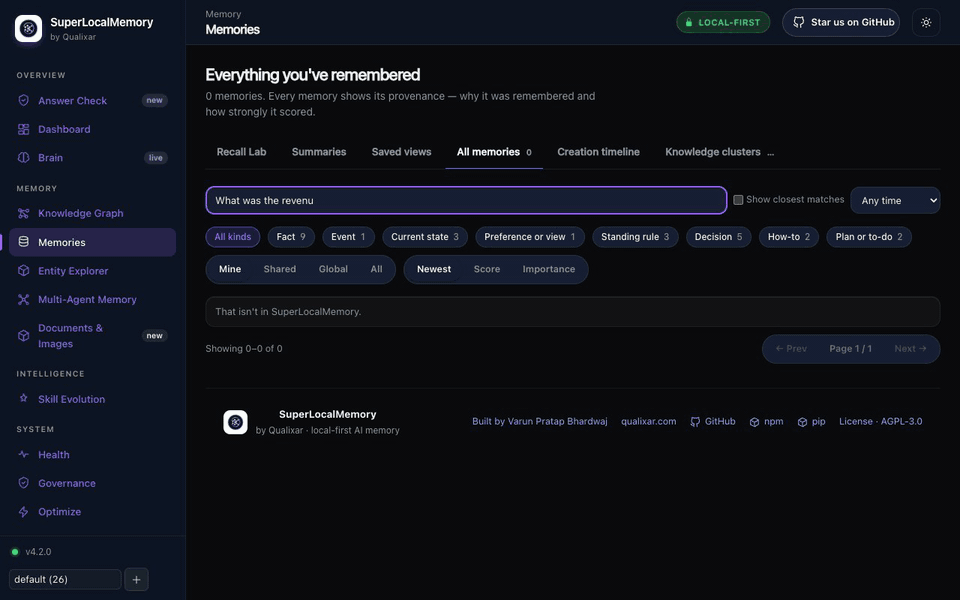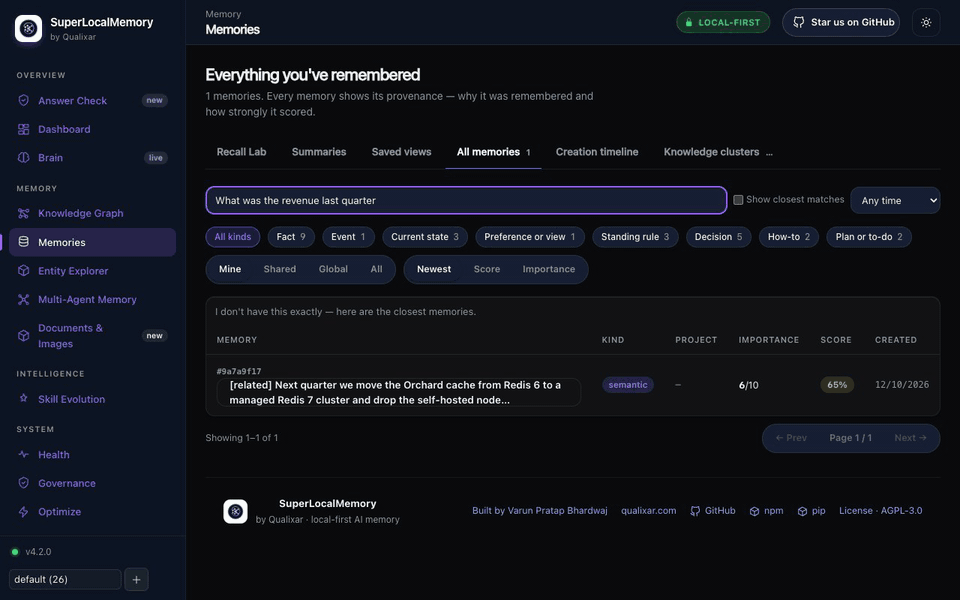
$ slm recall "how do we roll back the API"
  1. [0.67] We deploy the API blue-green; rollback is a DNS flip.

$ slm recall "zxqv plorth wimble"
  That isn't in SuperLocalMemory.

$ slm remember "Staging DB moved to Postgres 17 on port 5434." --replaces <id>
Replaced ✓ 1 fact(s). To undo: slm review-correction ... rollback 1
$ slm recall "which port does staging postgres use"
  1. [0.68] Staging DB moved to Postgres 17 on port 5434.
Mode A を新規インストールしたときの実際の出力を一部抜粋しています。スコアはメモリの順位を示すもので、確率ではありません。
SuperLocalMemory が選ばれる理由:12の強み
1. わからないことを認識します。 検索結果は毎回、3つのレベルのいずれかで返されます。裏付けのある回答、*「これに完全に一致する情報はありません。近いメモリはこちらです」と表示される最も近いメモリ、または該当する情報がない場合の「これは SuperLocalMemory にありません」*です。起動直後は、まだ準備中であることと見つかった内容を表示するため、本当は「まだ準備できていない」のに「空です」と伝えることはありません。エージェントが誤ったメモリをもとに処理を進めるのを防ぎます。
2. Mac の外に出ないセカンドオピニオン。 Apple Silicon 搭載 Mac では、SLM が小型のオンデバイスモデル Laya をインストールし、見つかったメモリが質問に実際に答えているかを判定します。クラウドを利用したい場合、または Mac を使っていない場合は、同じ確認をオンラインで行う Jev を利用できます。実行されるのは、同意にチェックを入れた後だけです。
3. ドキュメントやスクリーンショットが、質問できるナレッジベースになります。 写真、スクリーンショット、PDF を保存しておけば、「四半期の数値が載ったスライド」のように説明して、数週間後に見つけられます。画像モデルは  Google の EmbeddingGemma 2 で、お使いのコンピューター上で動作します。1つのモデルがテキストと画像の両方を読み取るため、説明から画像を見つけられます。OCR もローカルで実行され、PDF の各ページは画像とテキストの両方でインデックス化されます。また、回答にはファイル名とページ番号が記載されます。生成モデルがファイルを見ることはありません。
4. KarpathyのLLMウィキのアイデアを組み込み、検索も維持。 Andrej KarpathyのLLMウィキのパターンは、生のドキュメントをインデックスと健全性チェックを備えた整理済みのナレッジベースに変えます。SLMはすでに保存しているデータを使ってこれを実現します。すべてのファイルについて、関係する人物、プロジェクト、日付を記録したドキュメントインデックスと、空のページ、リンクされていないドキュメント、重複したページ、矛盾する事実を見つけるドキュメント健全性チェックを備えています。その一方で、何かを見つける必要が生じたときのために、本格的なハイブリッド検索も維持します。
5. 自分で記憶を管理します。 記憶の健全性チェックは、古い記憶をバックグラウンドで分析し、日付、名前、プロジェクト、種類を説明します。常に情報を追加するだけで、あなたが書いた内容には手を加えません。移動や削除はすべて修正を待ってから行われ、元に戻すを使えば元どおりにできます。
6. 保存するだけでなく、ガバナンスを備えています。 保存するたびに受け入れチェックを通過し、レシートが発行されます。読み取りでは、ロール、ワークスペース、スコープが常に尊重されます。消去は、要約、キャッシュ、インデックス、画像ミラーなど、すべてのコピーに適用され、検証可能なレシートが発行されます。すべての操作はハッシュチェーンで連結された監査ログに記録されます。後付けではなく、チームとGDPRを念頭に構築されています。
7. 時間の感覚を備えた記憶。 すべての事実について、それが起きた時点とSLMが学習した時点が記録されます。先月は何が真実だったのか、ある日付より前にSLMは何を知っていたのかを尋ねられます。訂正すると事実が置き換わり、いつでも元に戻せます。使われない記憶は、人間の記憶と同じように薄れていきます。
8. コンテキストウィンドウを決して圧迫しません。 階層型の想起により、エージェントは1行の概要、事実、または周辺の完全なコンテキストを、設定した厳格なトークン予算内で取得できます。エージェントは必要なときだけexpandで詳細を掘り下げます。また、キャッシュと元に戻せる圧縮により、同じ出力に二度料金を払わずに済みます。
9. 多数のエージェントで、1つの脳を共有。 書き込みごとに、実行したエージェントが記録され、記憶の汚染を防ぐための信頼スコアも付与されます。これにより、10個のエージェントが記憶を共有しても汚染されません。
10. エージェント同士が、インターネット越しでも会話できます。 SLM-Meshを通じて、コンピューター上のエージェントとウェブ上のボットが、ようやく1つの会話を共有できるようになります。Claude Code、Codex、Hermesのセッションは、1台でも複数台でも、メッセージ、待機、ロック、共有状態をやり取りできます。そのため、あるエージェントから別のエージェントへ作業を引き継いだり、2つのエージェントが同じファイルを同時に編集するのを防いだりできます。さらに、あなたが許可したボットであるChatGPT、ウェブ版Claude、Grok Bot、Museも同じメッシュに参加します。ブラウザー上のボットは、ノートパソコン上のエージェントに名前を指定してメッセージを送り、返信を読み取れます。すべてのメッセージにはデータであることを示すラベルが付き、指示として扱われることはありません。ウェブボットは、次のターンが始まると新しいメッセージを読み取ります。
11. 毎日学習し、気づかれないうちに性能が落ちることはありません。 報告された結果はすべて学習に活用されます。ランキングは、実際に役立った記憶を学習し、安定した習慣は新しいセッション向けのソフトプロンプトになり、エージェントのスキルは評価され、改良されます。新しいランカーが昇格するのは、統計的に妥当な勝利が確認された場合だけで、性能が落ちれば自動的にロールバックされます。作業は、独立したゲートを通過した場合にのみ終了する有界ループとして実行され、エージェントの自己申告だけで終了することはありません。また、複数ステップのパイプラインは有界ループを使った有界グラフとして実行され、完了した実行結果は読み取り専用の証拠としてSLMに保存されます。
12. 雰囲気ではなく、科学に基づいています。 すべてのレイヤーを裏付ける4本のarXiv論文があります。情報幾何学に基づく検索、生物学に着想を得た忘却、記憶の汚染に対するベイズ的信頼性評価、そしてコストを測定したガバナンス付き記憶です。中核となる数理処理は言語モデルなしで実行され、公開ベンチマークでは測定方法が正確に示されています。
SuperLocalMemoryは、QualixarのAI信頼性エンジニアリングの取り組みの一部です。観測可能で、有界であり、自分が知らないことを正直に示すエージェント向けの記憶を実現します。
動作を確認する
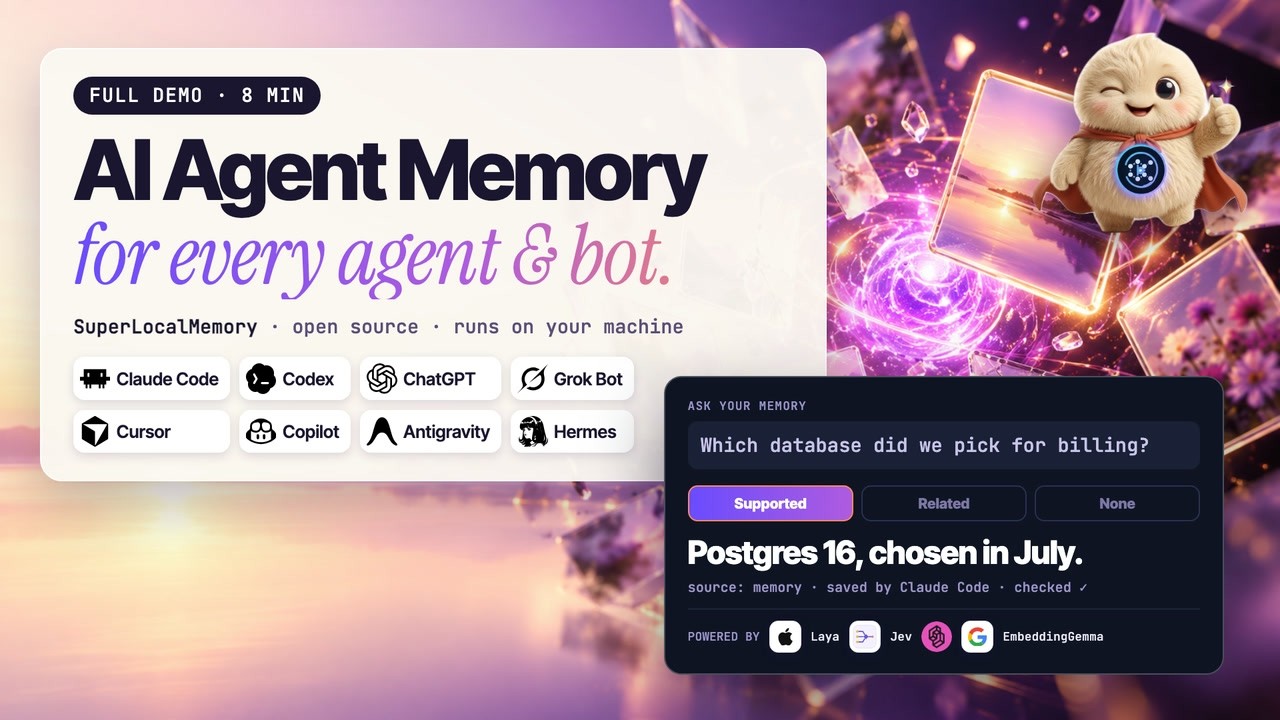
8 分間のデモ全編:コーディングエージェントやボットが、すべてのタブで 1 つのメモリを共有します。
アプリに SuperLocalMemory を追加する
アプリストアを待つ必要はありません。以下のすべてのアプリで、GitHub リポジトリ qualixar/superlocalmemory から SuperLocalMemory を直接、2 つの手順で追加できます。
手順 1、各コンピューターで一度だけ実行します。 SuperLocalMemory をインストールします:npm install -g superlocalmemory(または pipx install superlocalmemory)。以後、メモリはこのコンピューターに保存されます。
手順 2、使用する各アプリで実行します:
| アプリ | 操作 |
|---|---|
| Claude Code(ターミナルとデスクトップアプリ) | /plugin marketplace add qualixar/superlocalmemory と入力し、続けて /plugin install superlocalmemory@qualixar と入力します |
| Claude Desktop | slm connect claude-desktop を実行し、Claude Desktop を再起動します |
| ChatGPT、ウェブ版 Claude、Muse、Composio | ダッシュボード(slm dashboard)を開く → Web access → オンにしてから、表示されたリンクをそのアプリのコネクターとして追加します(手順) |
| Codex(ターミナルとデスクトップアプリ) | codex plugin marketplace add qualixar/superlocalmemory --ref main を実行し、続けて codex plugin add superlocalmemory-codex@qualixar を実行します |
| Cursor(エディターと Agents ウィンドウ) | slm connect cursor を実行し、Cursor を再起動します |
| VS Code(エディター内の Copilot チャット) | SuperLocalMemory 拡張機能をインストールします(最新リリースの .vsix:Extensions → ... → Install from VSIX) |
| VS Code Agents ウィンドウ、GitHub Copilot CLI | slm connect copilot-cli を実行します。スキルを使用するには、Agents ウィンドウの Plugins 画面で qualixar/superlocalmemory を追加します |
| Antigravity | agy plugin install "$(npm root -g)/superlocalmemory/antigravity-plugin" を実行します |
| Grok CLI | grok plugin install 'qualixar/superlocalmemory#plugin' を実行します |
| Grok Bot | Grok の Plugins 画面でマーケットプレイス qualixar/superlocalmemory を追加し、superlocalmemory を追加します |
| Muse CLI | slm connect muse を実行し、続けて muse plugins install "$(npm root -g)/superlocalmemory/muse-plugin" と muse plugins approve superlocalmemory を実行します |
| Hermes(ターミナルとデスクトップアプリ) | hermes plugins install 'https://github.com/qualixar/superlocalmemory.git#hermes-plugin' を実行し、続けて slm upgrade-hosts --host hermes --apply を実行します |
| OpenClaw | slm connect openclaw を実行します |
| Windsurf、Zed、JetBrains、Gemini CLI、OpenCode、Continue | slm connect <app> を実行します。例:slm connect windsurf |
| その他の MCP 対応アプリ | コマンド slm、引数 mcp でサーバーを追加します |
SuperLocalMemory を追加したら、アプリを再起動します。その後、「このプロジェクトについて何を覚えていますか?」 のように尋ねてみてください。プラグインガイドに各アプリの詳細が記載されており、slm doctor で設定を確認できます。
エージェントに対応
あらゆるハーネス、あらゆるボットに、ひとつのメモリを。 MCP(slm mcp、または http://127.0.0.1:8765/mcp/)を使用する、あるいはコマンド(slm remember、slm recall)を実行できるハーネスであれば、どれでもSuperLocalMemoryを利用できます。パッケージに含まれるプラグインはすぐに使えるサンプルであり、対応範囲の限界ではありません。
| ホスト | 接続方法 | 利用できる機能 |
|---|---|---|
| Claude Code | claude plugin install superlocalmemory@qualixar | MCP、16個のスキル、4個のエージェント、/slm-loop、セッションおよび想起フック |
| Codex | slm connect codexを実行し、続けてslm codex install | MCP、16個のスキル、4個のエージェント、/slm-loop、ライフサイクルフック |
| GitHub Copilot(VS Code、Visual Studio、JetBrains、CLI) | slm connect vscode-copilot --here | MCP、エージェントルール、16個のプロンプト、4個のエージェント、フック |
| Antigravity | 同梱プラグインをagy plugin installでインストール | MCP、16個のスキル、4個のエージェント、/slm-loop、フック |
| Hermes | ネイティブプラグインをインストールし、slm upgrade-hosts --host hermes --applyを実行してメモリサーバーを使用できるようにします | 16個のスキル、アドバイザーエージェント、/slm <command>、想起およびセッションフック |
| VS Code | SuperLocalMemory拡張機能(リリースページの.vsix) | エージェントのツール一覧にメモリサーバーが追加されます。編集は不要です |
| Grok CLI | slm connect grok-cliを実行し、続けて同梱プラグインをgrok plugin installでインストール | MCP、16個のスキル、4個のエージェント、セッションおよび想起フック |
| VS Codeのエージェントウィンドウ、GitHub Copilot CLI | slm connect copilot-cliを実行。プラグイン画面からスキルとエージェントを追加します | MCP、16個のスキル、4個のエージェント |
| OpenClaw | slm connect openclaw | MCP、14個のスキル |
| Muse CLI | slm connect museを実行し、続けて同梱プラグインをmuse plugins installでインストール | MCP、16個のスキル、4個のエージェント、/slm-loop、セッションおよび想起フック |
| Grok BotおよびCursor形式のホスト | qualixarプラグインマーケットプレイスを追加 | 複数のボットで共有するコンピューター向けに設計された軽量プラグイン(ガイド) |
| Cursor、Windsurf、Zed、JetBrains、Gemini CLI、Claude Desktop、OpenCode、Continue | slm connect <name> | そのツール独自の設定でMCPを利用できます |
| ChatGPT、Claude on the web、Muse、Composio | ダッシュボードから任意のWebアクセスを設定します。アプリごとにサインインし、読み取り専用または読み取りと保存を選択できます。いつでもアプリを削除できます | Webからローカルメモリを利用できます。データベースがコンピューターの外に出ることはありません(ガイド) |
| LangGraph、LangChain、LlamaIndex、CrewAI、AutoGen、Semantic Kernel、Microsoft Agent Framework、Google ADK、OpenAI Agents | フレームワークアダプター | 独自のコード内でメモリを利用できます(アダプター) |
| その他すべて | 汎用エージェントルールを貼り付け、CLIまたはMCPを使用できるようにします | あらゆるエージェントでメモリを適切に扱えるようになります |
プラグインがエージェントに教えること。 すべてのプラグインは共通のソースから作られているため、どのホストでも同じ16個のスキル(想起、記憶、セッション、ガバナンス、スコープとプロファイル、ナレッジグラフ、メッシュ、制限付きループ、キャッシュ、圧縮、Webアクセス、画像、ボット用コンピューター向けの2つのスキル)と、4個のエージェント(メモリアドバイザー、最適化アドバイザー、ガバナンスアドバイザー、ループランナー)を利用できます。フックはセッション開始時、ツール使用後、セッション終了時に実行されます。また、すべてのフックはフェイルオープンで動作するため、フックの問題によってエージェントがブロックされることはありません。プラグイン、スキル、フック
SLMのすべての機能
分からないときは、分からないと伝えるリコール
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 誠実な3つの回答段階 | サポート対象、最も近い記憶(最大3件、ラベル付き)、または 「SuperLocalMemory にはありません。」。メモリーを自動で注入するフックが注入するのは、サポート対象の回答のみです | リコール |
| ウォームアップ中であることを明示 | モデルの読み込み中は、キーワード検索で見つかった内容とともに、"SuperLocalMemory はまだウォームアップ中です — 結果が不完全な場合があります。数分後にもう一度お試しください。" と表示します | リコール |
| 階層型リコール | depth は 0(1 行の概要)、1(事実)、2(出典、セッション内の前後の項目、関連エンティティ、訂正を含む)に設定できます。max_tokens で上限を設定でき、expand で 1 件の結果を詳しく調べられます | 階層型リコール |
| ハイブリッド検索 | セマンティック検索、キーワード検索(BM25)、エンティティグラフ、時間検索、連想検索(Hopfield)、拡散活性化、画像の各チャネルを統合して再ランク付けします。slm trace で各チャネルのスコアを確認できます | リコール |
| 9 種類のメモリー | 事実、イベント、ステータス、意見、ルール、決定、手順、計画、訂正。「何を決定したか」という質問では決定を優先し、確認済みのルールと決定は各セッションの開始時に読み込まれます | メモリーの種類 |
| 過去の状態を確認 | --valid-at(その時点で真だったこと)、--known-as-of(その時点で SLM が知っていたこと)、--window 7d | リコール |
| 精密なフィルター | プロジェクト、エージェント、対象、種類、完全一致するタグで絞り込みます。結果が空の場合はその理由を示します | リコール |
| 訂正 | --replaces で古い事実を置き換えます。古い事実は保持され、元に戻すこともできます。編集はレビュー済みの訂正を通じて行い、ロールバックできます | 訂正 |
| 要約と保存済みビュー | メモリー ID を引用するセッション、日、プロジェクトの要約と、「今週何をリリースしたか」のような保存済みビュー | リコール |
| プロンプトインジェクション対策 | リコールされたテキストは信頼できない証拠として扱います。秘密情報をマスキングし、偽造されたマーカーを無効化し、出所情報を付与します | セキュリティ |
回答チェック:Laya と Jev
|
Laya — お使いの Mac 上で動作 Apple Silicon 向けの小型オンデバイスモデル(約 1.1 GB)です。セットアップ時にデフォルトでインストールされ、アップグレード後にも利用が提案されます。データがマシンの外に送信されることはありません。 |
TypeSafe または OpenRouter を通じて、ご自身のキーを使用し、Windows、Linux、macOS で同じチェックを実行できます。質問と上位 3 件のメモリーを送信しますが、同意にチェックを入れた後に限られます。自動で有効になることはありません。 |
 Jev — オンライン、あらゆるコンピューターで利用可能
判定結果は、独自の時間予算が設定されたサポート判定への入力の 1 つです。Answer Check タブでは、判定結果、処理時間、メモリーに回答がなかった頻度を確認できます。質問が保存されることはありません。回答チェック
ドキュメント、画像、メモ
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 説明から見つける画像 | PNG、JPEG、GIF、WebP に対応します。Google の EmbeddingGemma 2 がローカルで動作し、テキストと画像を同じ検索空間に配置するため、言葉で画像を見つけられます。OCR(Mac では Apple Vision、それ以外では RapidOCR)により、画像内のテキストも検索できます。位置情報は読み取りません | 画像とドキュメント |
| ページ単位の PDF | 各ページは画像とテキストの両方でインデックス化されます。回答には、出典となったファイルとページがサムネイル付きで示されます | 画像とドキュメント |
| ドキュメントインデックス | 保存されているすべてのドキュメントと、そのページ、および記載されている人、プロジェクト、日付の一覧です | 画像とドキュメント |
| ドキュメントの健全性チェック | 読み取れるテキストがないページ、何にもリンクされていないドキュメント、重複したページ、事実が矛盾しているドキュメントを検出します | 画像とドキュメント |
| フォルダーと Obsidian vault | slm sources add ~/Notes --kind obsidian を実行すると、読み取る内容を表示した後、Markdown、canvas ファイル、PDF、画像を読み取り専用でメモリにミラーリングします | CLI |
| ChatGPT やスマートフォンから | ChatGPT にファイルを添付するか、接続済みの Web アプリにワンタイムアップロードリンクの発行を依頼すると、ファイルがコンピューターに直接ストリーミングされます | Web アクセス |
| データは自分の手元に | 画像は専用のストアに保存され、コンピューターの外に出ることはありません。メモリを消去すると、その画像も消去されます。デフォルトでは無効で、ワンクリックで有効にできます。16 GB のメモリが必要です | コンプライアンス |
メモリの健全性
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 自動説明 | コンピューターがアイドル状態のとき、古いメモリにイベントの日付、名前、プロジェクト、タグ、種類が入力されます。追加のみで、書いた内容は編集されず、自分で設定した値が上書きされることもありません | メモリの健全性 |
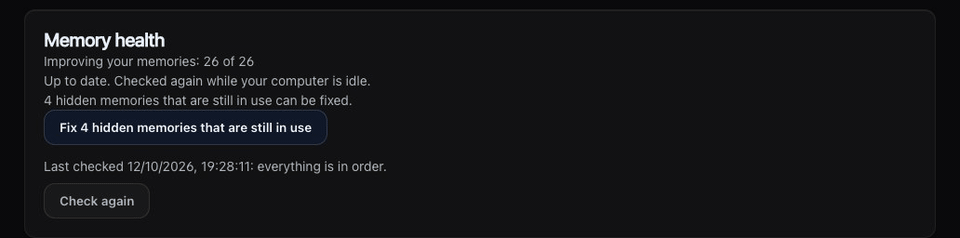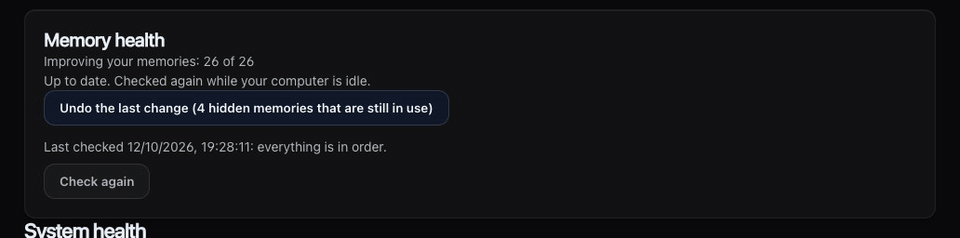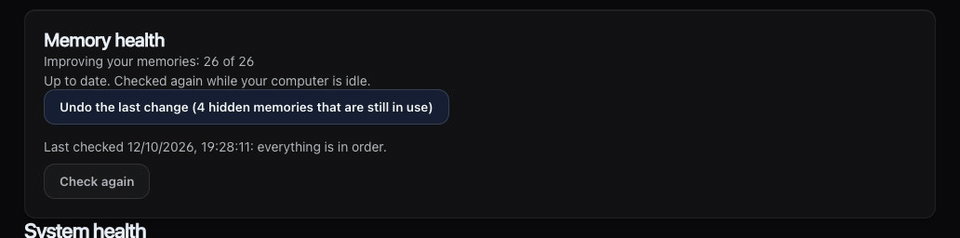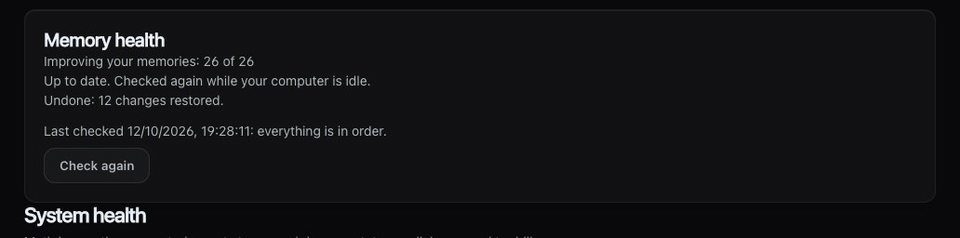
| 修復と元に戻す | エンティティへの不要なリンク、使用中の非表示メモリ、完了しなかった保存など、何かを移動または削除する修復は、修復を実行するまで保留されます。実行はすべて元に戻せます | メモリの健全性 |
| スタブバッジ | レシートやセッションの定型文はスタブバッジ付きで一覧に残りますが、回答には使われません | メモリの健全性 |
| ストアの健全性 | slm doctor では、メモリの検索しやすさと説明の有無を確認できます。slm db integrity と slm db repair(元に戻す機能付き)で、ストアを健全な状態に保てます | トラブルシューティング |
生き続ける脳
| 機能 | 内容 | ドキュメント |
|---|---|---|
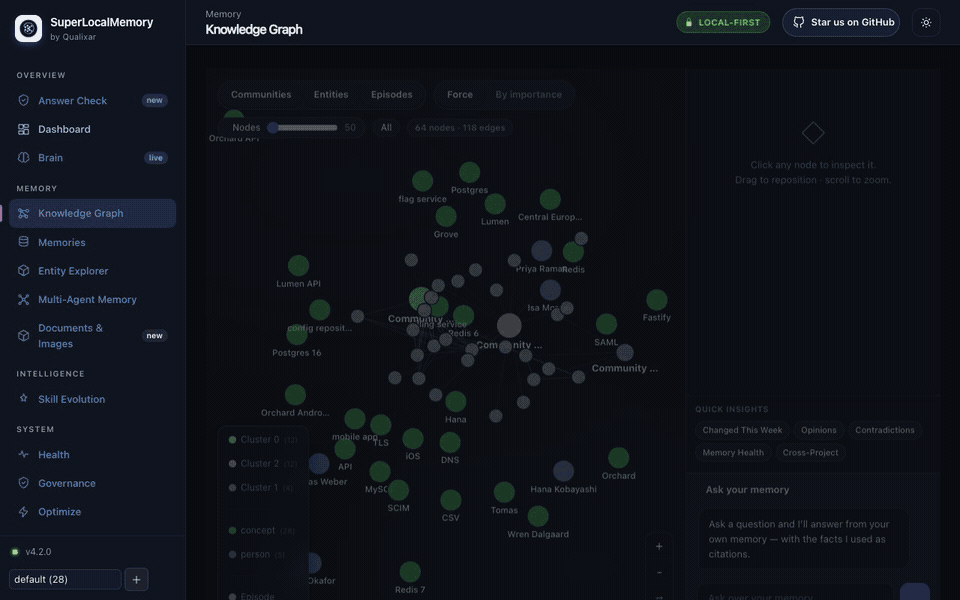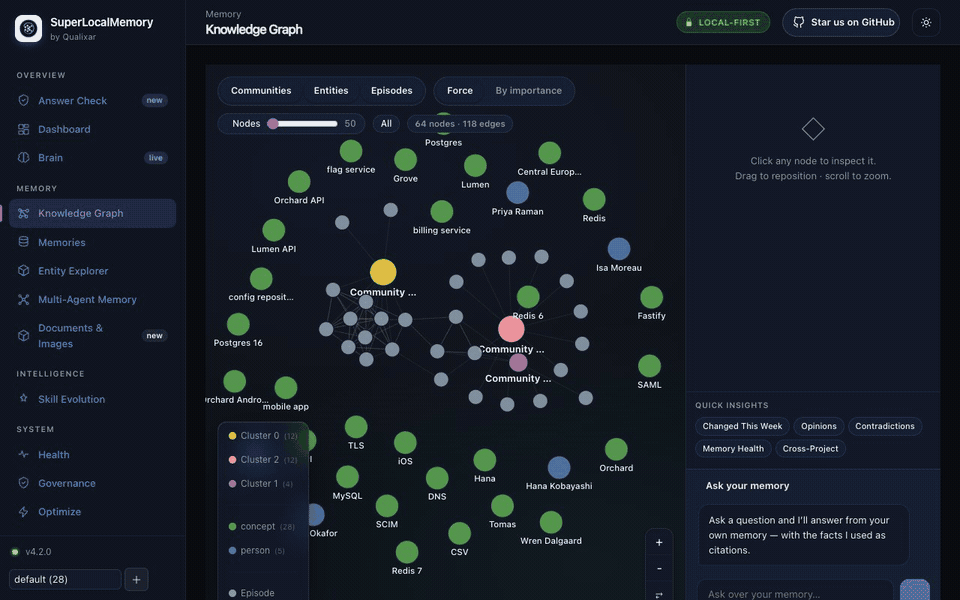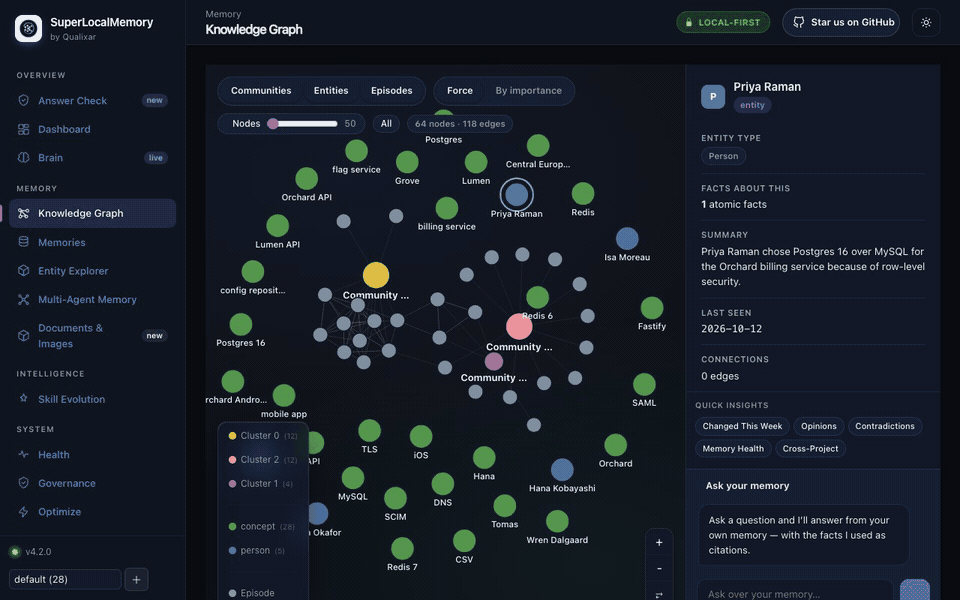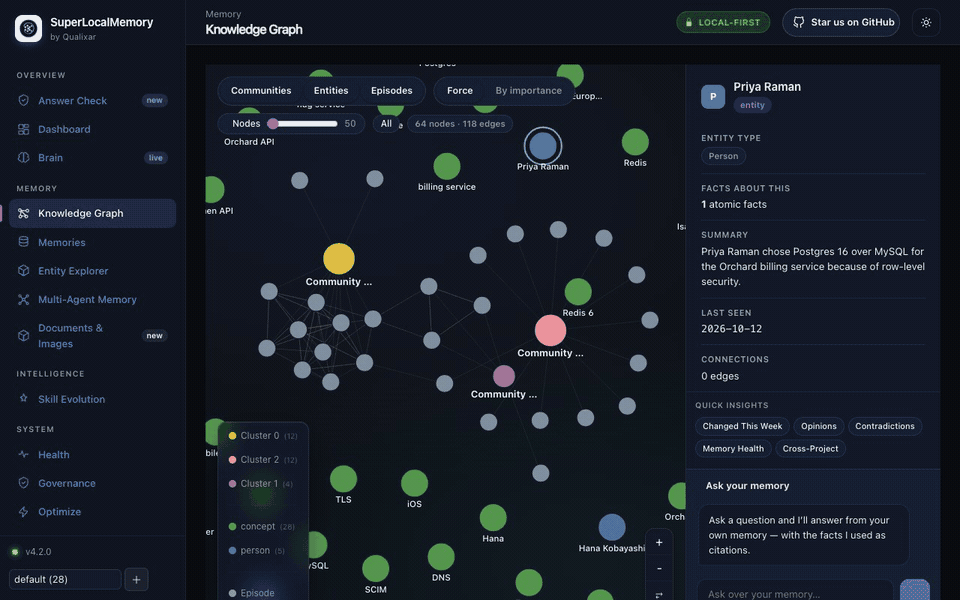
| ナレッジグラフ | 記憶から人物、プロジェクト、ツールを特定し、別名、場面、タイムラインとともに表示します。エンティティエクスプローラーでは、知識の変化を確認できます | アーキテクチャ |
| コードグラフ | リポジトリをインデックス化し、影響範囲、呼び出し元、意味に基づくコード検索について質問できます | MCP ツール |
| 忘却を役立てる | エビングハウスの保持サイクルとランジュバンのライフサイクルによって、参照されなくなった記憶をアーカイブへ移します。薄れていく記憶はビット数を減らして量子化され、ひとつの要旨にまとめられます | 研究 |
| ランキング学習(オプトイン) | バンディットアルゴリズムとランキング学習モデルが結果から学習します。新しいランキングモデルは統計的に有効な勝利を収めた場合にのみ昇格し、性能が低下すると自動的にロールバックされます | 設定 |
| ソフトプロンプトとスキルの進化(オプトイン) | 安定した動作パターンを新しいセッション用のソフトプロンプトにします。エージェントのスキルは、ブラインド検証のもとで評価・改訂されます | スキルの進化 |
ガバナンスとコンプライアンス
| 制御 | 内容 | ドキュメント |
|---|---|---|
| ロールとワークスペース | ワークスペースごとに管理者、メンバー、閲覧者を設定できます。あるワークスペースでのロールが別のワークスペースに影響することはありません。メンテナンスと承認は、自分が所属する場所でのみ実行されます | チーム |
| 会社モード | すべての読み取りと書き込みに、サインインしたユーザーが記録されます | 会社モード |
| スコープ | デフォルトは個人用です。共有とグローバルは選択した場合にのみ有効になり、プロファイルをまたぐ記憶の呼び出しはデフォルトで拒否されます | スコープ |
| GDPR | 検証可能な受領証とともに、すべてのストアと派生コピーを対象とするエクスポート(第15条・第20条)と消去(第17条)を実行します | コンプライアンス |
| 監査と保持 | 改ざんされると検証に失敗する、ハッシュチェーン方式の監査証跡。プロファイルごとの保持ルールと、EU AI Actへの対応状況レポートも備えています | コンプライアンス |
| バックアップと復元 | GitHub または Google Drive へのクラウドバックアップを、アップロード前に暗号化して実行します。ストアを更新する前に復元ポイントを作成します。復元時には安全コピーを保持し、失敗した場合はロールバックします | クラウドバックアップ、復元ポイント |
認証取得ではなく、コンプライアンスプログラムを支援するエンジニアリング上の制御です。
複数のエージェントで、ひとつのメモリを共有
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 書き込み元を記録した、信頼性の高い書き込み | すべてのメモリにエージェントが記録されます。ベイズ信頼度スコアでメモリ汚染を防ぎます | 研究 |
| SLM-Mesh | 1 台または複数のマシン上で、セッション間のメッセージ、待機、ロック、共有状態を利用できます | マルチマシン |
| 互いに会話するボット | 許可すると、ChatGPT、ウェブ上の Claude、Grok Bot、Muse がメッシュに参加します。ピアの一覧表示、名前を指定したボットへのメッセージ送信、受信トレイの読み取りができます。メッセージにはデータとしてラベルが付けられ、指示として扱われることはありません | ボットメッセージ |
| 上限付きループとグラフ | 「完了」とは独立したゲート(テスト、リンター、スキーマなど)を通過したことを意味し、エージェントの自己申告ではありません。各反復は監査可能なメモリとして保存されます。複数ステップのグラフはBounded Loopsで実行でき、SLM は完了した実行結果を読み取り専用の証拠として保持します | Bounded Loops ブリッジ |
コンテキストの節約
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 完全一致キャッシュ | ツールの出力とファイルの読み取り結果を TTL 付きでキャッシュします。キャッシュにヒットすると、同じ呼び出しを省略できます | 最適化 |
| 可逆圧縮 | 大きな出力を安全に圧縮し、ID を指定して元の内容をそのまま復元できます | 最適化 |
| 3 つの利用方法 | プロキシ(slm wrap claude)、MCP ツール、またはスキルを通じて利用できます。slm optimize savings で節約量を確認できます | プロキシの設定 |
モード、ダッシュボード、スケーリング
| 機能 | 内容 | ドキュメント |
|---|---|---|
| 3 つのモード | A: 言語モデルを一切使いません。B: このマシン上のモデルを使います(Ollama では Google Gemma 3 4B がデフォルトで、モデル選択画面から Gemma 4 を選択できます。または、ローカルの OpenAI 互換サーバーを利用できます)。C: 独自のエンドポイントまたはクラウドプロバイダーを使います | 設定 |
| ダッシュボード | 検索、ナレッジグラフ、Entity Explorer、回答チェック、メモリの健全性、ドキュメントと画像、接続済みアプリ、ボットメッセージ、ガバナンスを利用できます:slm dashboard | ダッシュボード |
| スケーリングエンジン | SQLite と sqlite-vec が正規のデータソースです。オプションの LanceDB と CozoDB のコピーは、SQLite と一致した場合にのみ提供されます | スケーリングエンジン |
| 永続的な書き込み | 保存のたびに raw → queryable → complete と進み、レシートが発行されます。失敗しても証拠は保持され、再試行されます。負荷が高いときのテキスト保存はキューに入れられ、拒否されることはありません | アーキテクチャ |
| モデルの切り替え | 想起を継続しながら、埋め込みモデルをバックグラウンドで変更できます。1 ステップでロールバックできます | CLI |
| ネットワーク経由のリモートアクセス | slm remote は TLS 経由で他のコンピューターにメモリを提供します。クライアントごとに取り消し可能なキーを 1 つ使用します | デプロイ |
MCP メモリーサーバー:ツールプロファイル
特に設定しない場合、すべてのアプリ、プラグイン、拡張機能には full(58 個のツール:メモリー、SLM-Mesh、最適化、ループのすべて。画像が有効な場合はさらに 5 個)が適用されます。MCP ツールの合計数を約 100 個に制限しているホストでも、ほかのサーバー用の余裕を残せる設定です。すべてのアプリに一度に適用するには、次のコマンドを実行してアプリを再起動します。
slm tools                # current set, and how many tools each set has
slm tools set power      # any name below; `slm tools set default` goes back to full
特定のアプリだけ変更するには、そのアプリの MCP 設定で SLM_MCP_PROFILE を設定します(slm connect <app> --profile <name> で設定できます)。この設定は、そのアプリに保存されている選択内容より優先されます。アプリごとの詳細
| プロファイル | ツール | 用途 |
|---|---|---|
core | 19 | 記憶、想起、展開、セッション、最適化、修正内容の確認 |
code | 39 | Core にコードグラフ、メモリーの種類、Brain のエビデンス、プロファイル切り替え、上限付きループを追加 |
mesh | 9 | SLM-Mesh の連携のみ |
full(デフォルト、未設定時) | 58 | メモリー、種類、Brain、最適化、スキルの進化、メッシュ、ループ、ビュー、要約(画像とドキュメントが有効な場合は 63 個) |
power | 70 | Full に管理、ライフサイクル、診断を追加(画像とドキュメントが有効な場合は 75 個) |
whole | 110 | 登録されているすべてのツール |
stdio:{"command": "slm", "args": ["mcp"]} · HTTP:http://127.0.0.1:8765/mcp/ · MCP ツール
実際の画面
| メモリーの健全性:修復と元に戻す | ナレッジグラフ |
|---|---|
 |  |
| エンティティエクスプローラー | 回答チェックの実例 |
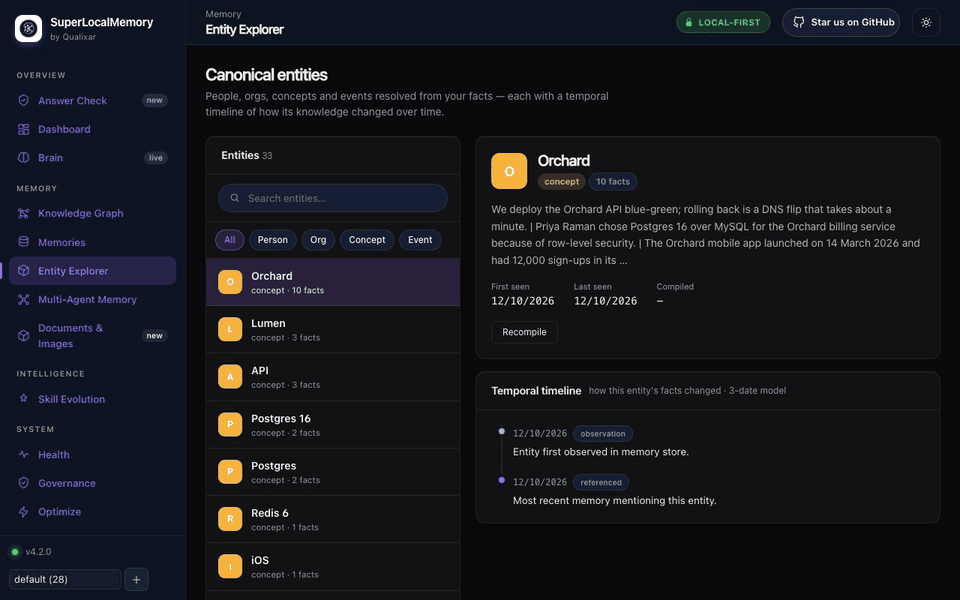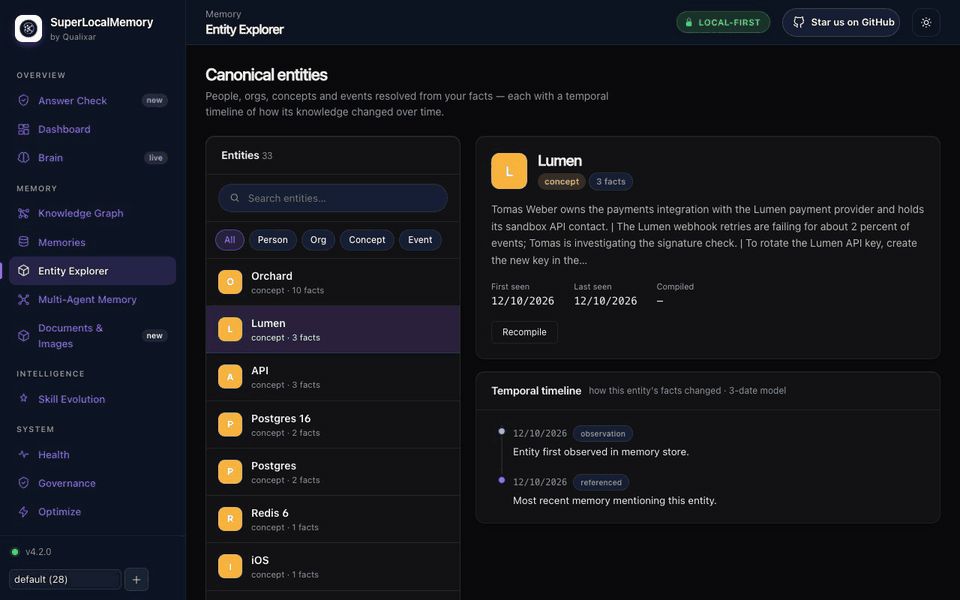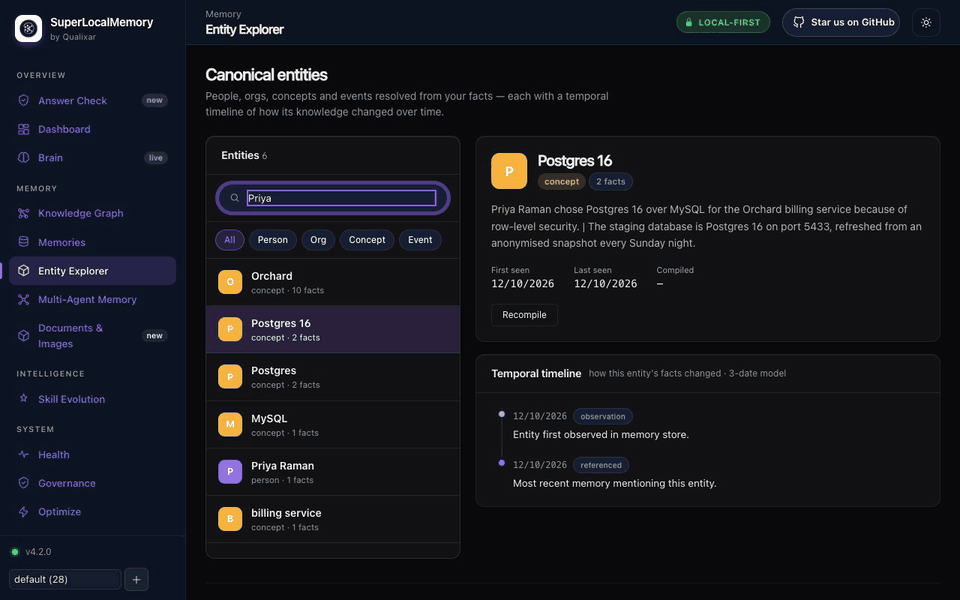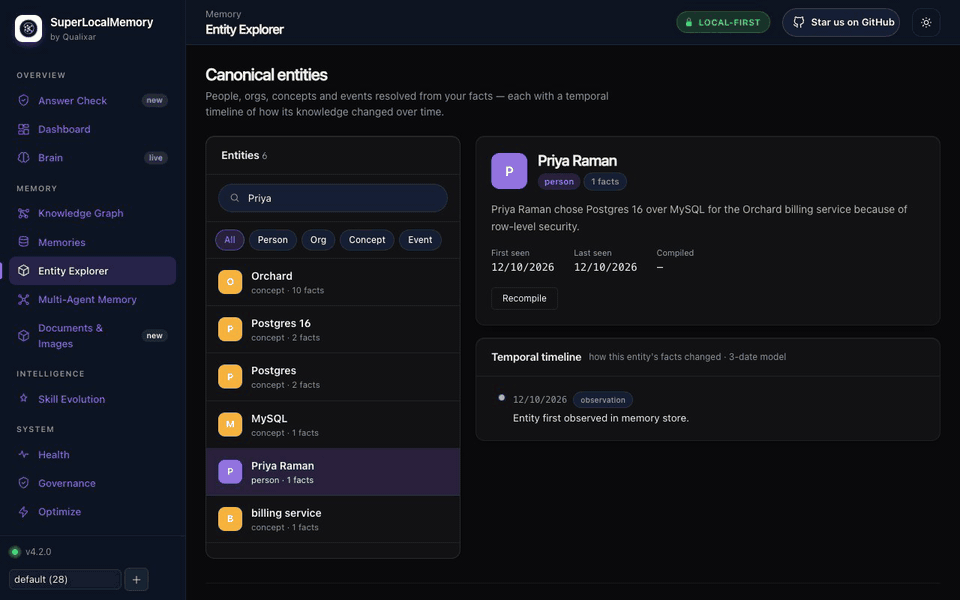 | 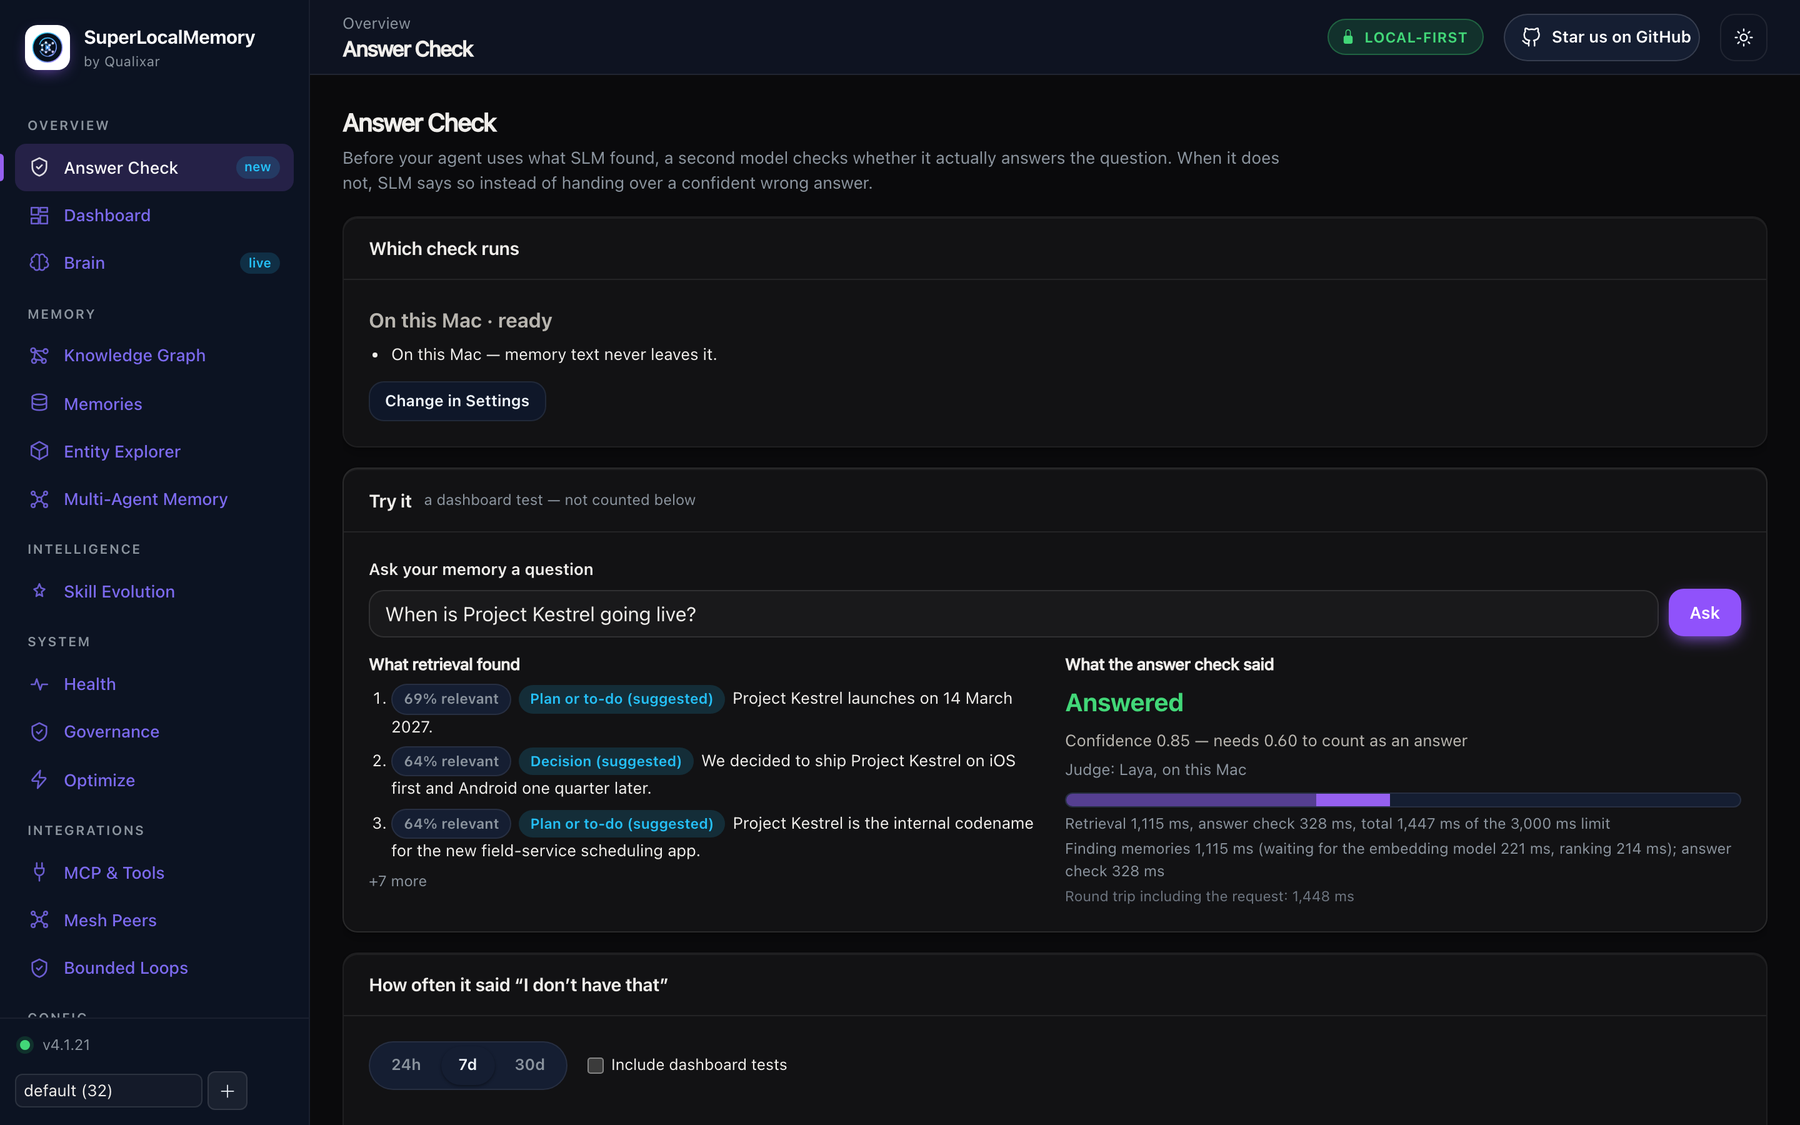 |
架空のメモリーを使ったテスト環境で録画しています。8 分間の完全なデモでは、すべてのペインを紹介しています。
アーキテクチャ
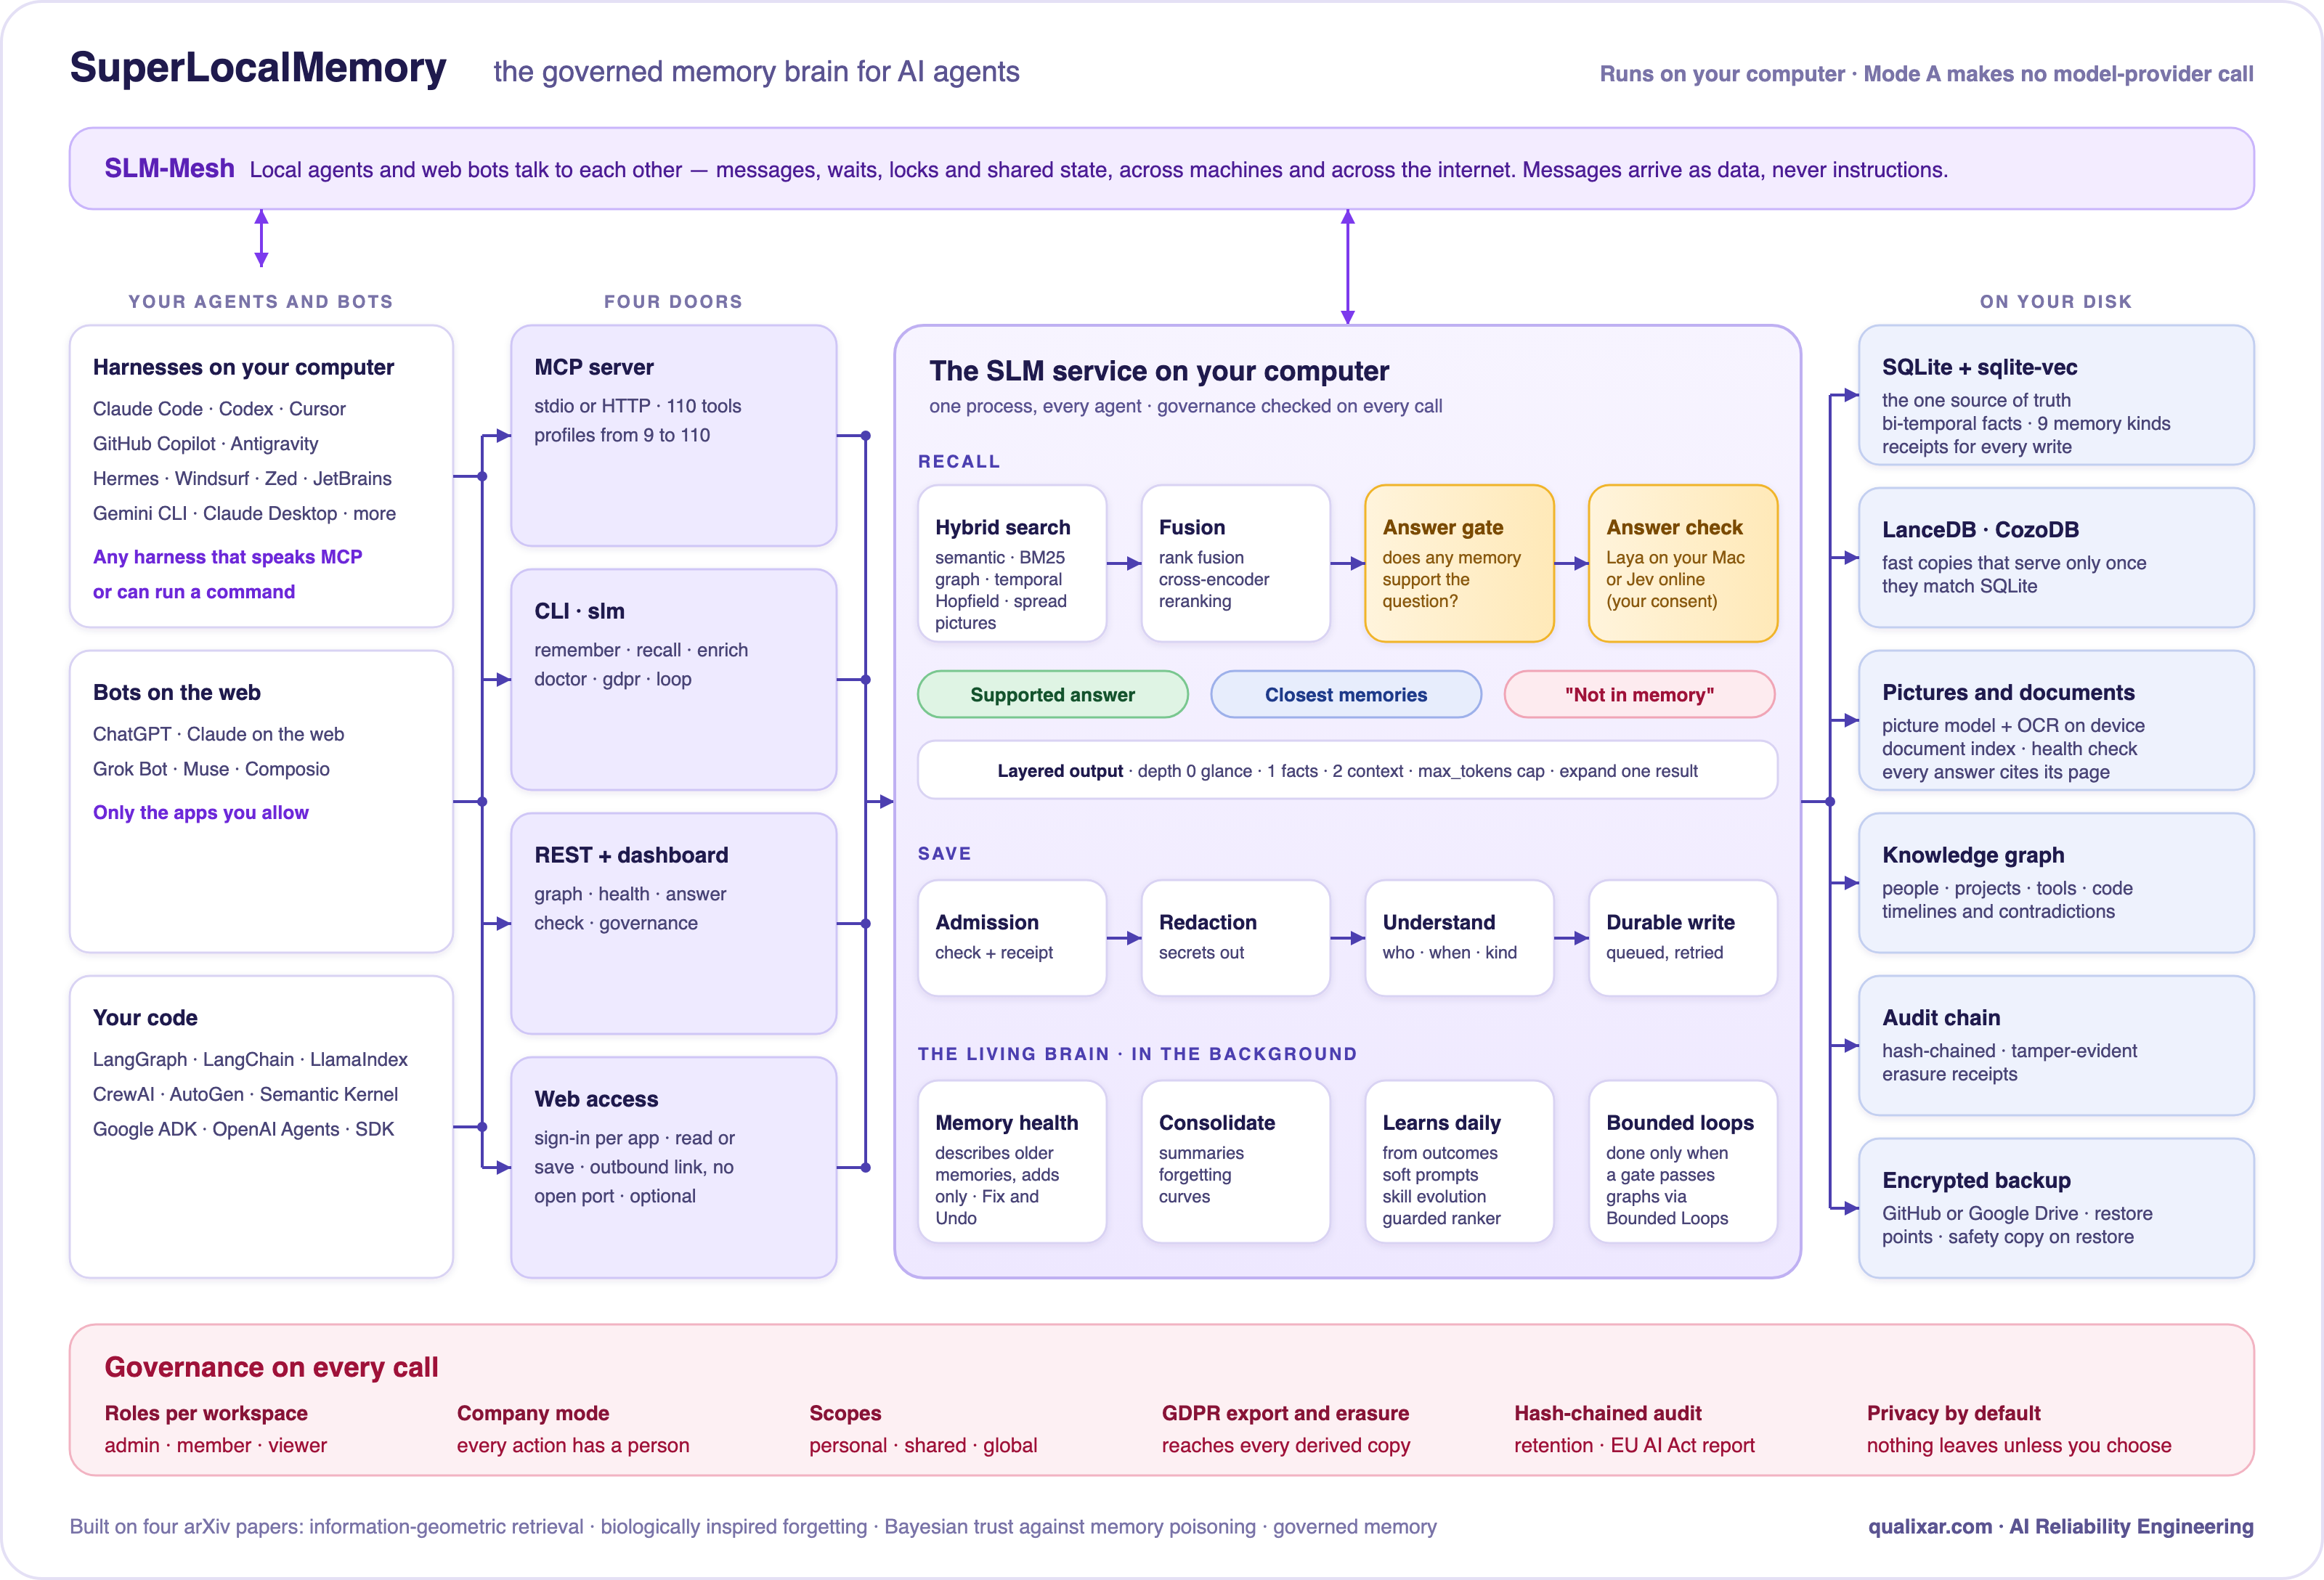
無料のローカルコアだけで完全に動作し、ウェブアクセスは任意です。アーキテクチャの詳細
プライバシー
データを送信する機能を有効にしない限り、情報がコンピューターの外に送信されることはありません。また、各機能では送信される情報が明確に示されます。
| 送信される情報 | 送信される条件 |
|---|---|
| 質問と上位3件のメモリー | オンラインで回答を確認するJevを有効にし、同意にチェックを入れた場合 |
| メモリーのテキスト | Mode C、クラウド埋め込みモデルまたはリランカー、別のコンピューター上のモデル、あるいはJev kind typing(個別の同意が必要)を選択した場合 |
| 暗号化されたバックアップファイル | GitHubまたはGoogle Driveのバックアップに接続した場合 |
| メッシュメッセージ | メッシュピアを設定した場合、またはウェブアプリがボットにメッセージを送信できるようにした場合 |
| ウェブアプリからのツール呼び出し | Web accessを有効にしてアプリを追加した場合。データベースはコンピューター上に保存されます |
画像、ドキュメント、Laya、Mode Aから情報が送信されることはありません。メモリーのテキストに含まれる秘密情報は、外部へのすべての送信経路でマスキングされます。セキュリティポリシー
ベンチマーク
これらの数値は公開済みのアーキテクチャ論文(arXiv:2603.14588)に基づいています。論文で紹介されたSLMの検索コアは現在も稼働しています。現在のパッケージで新たに実行した結果ではありません。
| 構成(アーキテクチャ論文) | LoCoMo | 対象範囲 |
|---|---|---|
| Mode A、検索 + GPT-4.1-miniによる回答 | 74.8% | 10件の会話、1,276件の質問 |
| Mode A、生の結果(LLMを一切使用しない) | 60.4% | 10件の会話、1,276件の質問 |
| Mode C、クラウド埋め込み + GPT-4.1-mini | 87.7% | 1件の会話(Conv-30)、81件の質問 |
LoCoMoのスコアを比較できるのは、対象データ、回答モデル、評価者が一致している場合に限られます。評価方法とアブレーション
研究
Varun Pratap Bhardwajによる4本のarXivプレプリントで、SLMについて説明しています。
- SuperLocalMemory 4.0: AIエージェントのためのガバナンス対応メモリーオペレーティングシステム。Garima SinghおよびArun Pratap Bhardwajとの共著。arXiv:2608.08253
- SuperLocalMemory V3.3: 生きた脳、arXiv:2604.04514
- SuperLocalMemory V3: LLMを使わないエンタープライズエージェントメモリーのための情報幾何学的基礎、arXiv:2603.14588
- メモリー汚染に対するベイズ信頼防御を備えた、プライバシー保護型マルチエージェントメモリー、arXiv:2603.02240
引用にはCITATION.cffまたはGitHubの「このリポジトリを引用」をご利用ください。
ドキュメント
開始: はじめに · IDE のセットアップ · プラグイン · クイック検証 使い方: 想起 · メモリの健全性 · 回答のチェック · 画像とドキュメント · 自動メモリ · ウェブアクセス · 最適化 リファレンス: CLI · MCP ツール · 設定 · トラブルシューティング · コンプライアンス · Wiki · リリースノート
アップグレード
npm update -g superlocalmemory    # or: pipx upgrade superlocalmemory, uv tool upgrade superlocalmemory
slm restart && slm doctor
slm upgrade-hosts                 # preview plugin and IDE updates; nothing changes until you --apply
アップグレードによってメモリが移動または削除されることはありません。また、ストアを更新する際には、最初に復元ポイントが作成されます。ホストのアップグレード
プラットフォームのサポート
| SuperLocalMemory | Laya(デバイス上での回答チェック) | |
|---|---|---|
| Apple Silicon macOS | 対応 | 対応、デフォルトでインストール済み |
| 64-bit Windows | 対応 | 非対応(オンラインチェックの Jev は動作します) |
| 64-bit Linux(x86-64、ARM64) | 対応 | 非対応(Jev は動作します) |
| Intel Mac、32-bit Windows | ビルド済みインストーラーなし | — |
Python 3.12+、npm には Node 18+ が必要です。画像とドキュメントには 16 GB のメモリが必要です。
スターの履歴
貢献とライセンス
Issue とプルリクエストを歓迎します:CONTRIBUTING.md。セキュリティに関する報告:SECURITY.md。AGPL-3.0-or-later の下でライセンスされています。商用ライセンスについては、COMMERCIAL-LICENSE.mdをご覧ください。
 ### Qualixar が開発
SuperLocalMemory は、Qualixar の Varun Pratap Bhardwaj が開発しています。Qualixar は AI 信頼性エンジニアリングに取り組んでおり、AI エージェントが実際の作業を安心して任せられるほど信頼できる存在となるよう、メモリ、コントラクト、テスト、ループを提供しています。
組み合わせれば、さらに強力に。 SuperLocalMemory は記憶を担います。Jev Decision Layer は、エージェントが範囲内で行う選択を型付きで検証します。Bounded Loops は、独立したゲートを通過した場合にのみ作業を終了します。これらを組み合わせることで、Qualixar はエージェントに AI 信頼性エンジニアリングの環境全体を提供します。信頼できるメモリ、根拠を示せる判断、そして完了が証明された作業です。
SLM がエージェントの記憶を保つのに役立つなら、リポジトリにスターを付けてください。ほかの開発者に見つけてもらうための方法です。

Qualixar のその他のプロジェクト: Qualixar OS · SkillFortify · SLM Mesh · AgentAssert · AgentAssay · Bounded Loops · Jev Decision Layer · SLM MCP Hub
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。