orionbelt-semantic-layer について
orionbelt-semantic-layerは、分析チームやエージェント向けのセマンティック・コンテキストレイヤーです。YAMLで指標やビジネスルールを定義し、方言別SQLにコンパイルします。複数ファクトのクエリ計画やリネージを備え、複数のインターフェースからモデルを利用できます。
主な機能
- 01YAMLによるセマンティックモデルとルール
- 02方言別SQLへのコンパイル
- 03複数ファクトのクエリ計画
- 04クエリとモデルのリネージ
- 05REST、SQL、MCPインターフェース
活用シーン
- 01分析ツール間で共通指標を定義
- 02エージェントがタスク別モデルとクエリを送信
- 03複数ファクトクエリのファントラップ結合を防止
- 04結果の参照元テーブルと結合を追跡
MCP 対応
stdioまたはHTTP経由のMCPで、AIエージェントにセマンティックモデル、クエリ機能、ビジネスルールなどのコンテキストを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
OrionBelt® セマンティック・コンテキストレイヤー、ルールエンジン、セマンティックサイドカー
共通のメトリクスを定義するか、一連の質問を YAML でモデル化します。エージェントや BI ツールが、単一のセマンティックコンパイラーを通じてクエリを実行できます。
既存のシステムを置き換えるのではなく、その傍らで動作するセマンティックサイドカーです。



LLM に生のスタースキーマに対する SQL を書かせると、遅かれ早かれ 2 つのファクトテーブルを結合し、売上高が 8 倍に膨らんだ数値を返します。もっともらしく見えるため、誰も気づきません。
OrionBelt はセマンティック・コンテキストレイヤーとルールエンジンを備え、**セマンティックサイドカー**として動作します。ユーザーまたはエージェントは、ディメンション、メジャー、メトリクス、結合を YAML で宣言し、単一タスク向けにスコープを限定することも、共有モデルとして維持することもできます。OrionBelt は実際の AST を介してそれらを方言ごとの SQL にコンパイルし、ファントラップを生む結合経路をブロックする Composite Fact Layer プランナーを通じて、複数のファクトを扱うクエリをルーティングします。クエリでは "Total Revenue" by "Country" のように指定し、物理テーブルとカラムのマッピングはモデル内に保持します。
BI ツールを間に挟む必要はありません。実行時のロックインもありません。すでにお使いの環境に接続するだけです。
質問をモデル化する
エージェントは、回答に必要な質問だけをモデル化できます。 POST /v1/oneshot/batch を使うと、タスク固有の OBML モデルと複数の独立したクエリを 1 回のリクエストで送信できます。OBSL はモデルを検証し、クエリをコンパイルまたは実行して、該当する場合は SQL、説明、警告、エラーとともに、それぞれ識別可能な結果を返します。
「国別の売上高、月別売上高、平均注文額」を調べる場合、エージェントは関連するカラムと計算を一度定義し、それらを使って 3 つの質問を行います。新しく読み込んだモデルは、デフォルトではバッチ処理後に削除されます。persist_model: true を指定すると、後続の質問に備えてセッション内に保持されます。同じコンパイラーが、このワークフローと長期間利用する共有モデルの両方をサポートします。
完全な例についてはエージェントワークフローガイドを参照するか、ワンショット API の仕様をご覧ください。
四つの接続方法
同じモデルを、すでにお使いのあらゆる接続先で利用できます。接続先は四つで、そのすべての背後に一つのモデルがあります。
| 接続先 | ポート | 通信方式 | 接続方法 |
|---|---|---|---|
| PostgreSQL wire | 5432 | Postgres protocol | ATTACH 経由の DuckDB、Tableau、フェデレーションソースとしての Dremio、Power BI、Superset、DBeaver、Metabase、psql |
| Arrow Flight SQL | 8815 | gRPC + Arrow | adbc_scanner 経由の DuckDB、Flight SQL JDBC/ODBC ドライバー経由の Tableau と Power BI、ADBC クライアント(Python、Go、Java) |
| REST | 8000 | HTTP + JSON | 独自のコード、ノートブック、curl、および 8 PEP 249 ドライバー(ここでコンパイルした後、ウェアハウス上で直接実行されます) |
| MCP | stdio / HTTP | Model Context Protocol | AI エージェント:Claude、Cursor、Copilot、Windsurf |
どちらの SQL 接続先も OBSQL を使用するため、SELECT "Region", "Total Sales" FROM sales_model は、どちらの接続先から利用しても同じクエリです。ADBC は Flight SQL 接続先を利用する方法であり、それ自体が第五の接続先というわけではありません。また、DuckDB はどちらの SQL 接続先も利用できるクライアントです。
八つの出力先
BigQuery、ClickHouse、Databricks、Dremio、DuckDB/MotherDuck、MySQL、PostgreSQL、Snowflake にコンパイルできます。モデルの背後にあるウェアハウスは、前面にある接続先とは独立しています。つまり、四つの接続先のどれからでも、八つの方言のどれに対しても利用できます。
以下は TPC-DS クエリ 98 です。同じ列に対する二つのメジャーは、1 行だけ異なります。Class Revenue は、クエリが要求する粒度より粗い粒度に固定されています。
measures:
  Store Sales Amount:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum

  Class Revenue:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum
    grain: {mode: FIXED, keepOnly: [Class]}   # <- pin to Class, ignore query grain

metrics:
  Revenue Ratio:
    expression: "{[Store Sales Amount]} * 100.0 / {[Class Revenue]}"
この grain の 1 行が、以下の SUM(...) OVER (PARTITION BY "Class") になります。
クエリではビジネス概念を指定します。テーブルも、結合も、SQL もありません。
select:
  dimensions: [Item ID, Item Description, Category, Class, Current Price]
  measures: [Store Sales Amount, Revenue Ratio]
where:
  - {field: Category, op: inlist, value: [Sports, Books, Home]}
  - {field: Order Date, op: between, value: ["1999-02-22", "1999-03-24"]}
pip install orionbelt-semantic-layer
obsl compile tpcds.obml.yml -q Q98.yml -d duckdb
WITH "base" AS (
  SELECT
    "Item"."i_item_id" AS "Item ID",
    "Item"."i_item_desc" AS "Item Description",
    "Item"."i_category" AS "Category",
    "Item"."i_class" AS "Class",
    "Item"."i_current_price" AS "Current Price",
    CAST(SUM("Store Sales"."ss_ext_sales_price") AS DECIMAL(18, 2)) AS "Store Sales Amount",
    SUM("Store Sales"."ss_ext_sales_price") AS "Class Revenue"
  FROM "main"."store_sales" AS "Store Sales"
  LEFT JOIN "main"."item" AS "Item"
    ON "Store Sales"."ss_item_sk" = "Item"."i_item_sk"
  LEFT JOIN "main"."date_dim" AS "Date"
    ON "Store Sales"."ss_sold_date_sk" = "Date"."d_date_sk"
  WHERE
    "Item"."i_category" IN ('Sports', 'Books', 'Home')
    AND "Date"."d_date" BETWEEN '1999-02-22' AND '1999-03-24'
  GROUP BY ALL
)
SELECT
  "Item ID" AS "Item ID",
  "Item Description" AS "Item Description",
  "Category" AS "Category",
  "Class" AS "Class",
  "Current Price" AS "Current Price",
  "Store Sales Amount" AS "Store Sales Amount",
  "Store Sales Amount" * 100.0 / NULLIF(SUM("Class Revenue") OVER (PARTITION BY "Class"), 0) AS "Revenue Ratio"
FROM "base" AS "base"
ORDER BY
  "Category" ASC,
  "Class" ASC,
  "Item ID" ASC,
  "Item Description" ASC,
  "Revenue Ratio" ASC
結合経路、集約に対するウィンドウ関数、NULLIF ガード、テーブル名のいずれも記述していません。-d duckdb を -d snowflake に変更するだけで、同じ 2 つのファイルを Snowflake 用に、または 8 つの方言のいずれか用にコンパイルできます。
これは主張ではなく、検証済みです。 40 個の TPC-DS クエリを単一の OBML モデルに対してビルドし、各エンジンのリファレンス SQL と行ごとに比較しています。sf=1 の DuckDB では 40 個中 39 個、sf=10 の ClickHouse では 40 個中 37 個が一致します。残る差異はすべて、コンパイルエラーではなくリファレンス側のバリエーションに起因し、それぞれ記録されています。検証結果、または examples/tpcds_queries/ のクエリをご覧ください。
すべてのエンジンで同じ答え
8つのエンジン向けにコンパイルするのは簡単です。エンジンごとに結果が異なるため、関数名の表記だけを統一するレイヤーでは、その違いがダッシュボードやエージェントにそのまま伝わってしまいます。OrionBelt は答えを統一します。
| 式 | エンジンの動作 | OrionBelt が返す値 |
|---|---|---|
x / 0 | あるエンジンでは inf、4つではエラー、残りでは NULL | どこでも NULL |
浮動小数点数に対する round(2.5) | ClickHouse、PostgreSQL、MySQL はタイの値を偶数に丸めて 2 を返す | どこでも 3 |
greatest(1, NULL, 3) | 4つのエンジンは NULL を無視して 3 を返す | どこでも NULL |
length('äbcd') | ClickHouse と MySQL はバイト数を数えて 5 を返す | 4文字 |
a がオブジェクトの場合の json_value(doc, '$.a') | 4つのエンジンはシリアライズされた JSON を返す | NULL:パスがスカラー値に到達しませんでした |
各行はベンダーのドキュメントから導き出したものではなく、稼働中のエンジンに対して実行し、結果を検証しています。expressionMode: portable を設定すると、ポータブルカタログにない関数はエラーになるため、モデルが誤ってエンジン依存を持ち込むことはありません。
オープンで追跡可能
セマンティックモデルは行き止まりであってはならず、数値はその出どころを説明できるべきです。
- Apache Ossie の双方向対応。 OSI(Open Semantic Interchange)は、ポータブルなセマンティックモデルのオープン標準であり、現在は Apache Ossie(インキュベーション中) として開発されています。OrionBelt は、REST、CLI(
obsl convert)、UI を通じて、OBML と Ossie を双方向に変換し、どちらの方向でもスキーマを検証します。このコンバーターはスタンドアロンパッケージ(pip install osi-orionbelt)としても提供されており、上流へのコントリビューションが進められています。 - すべての成果物とすべてのクエリに対応するリネージ。 ディメンション、メジャー、メトリック、ルールが何を基に構築されているかを示します。クエリについては、プランナーが実際に選んだ結合、複数ファクトにわたる
UNION ALLの各部分、existsサブクエリを、列とテーブルに至るまで確認できます。JSON、Mermaid、Turtle 形式で、REST、CLI(obsl lineage)、UI を通じて利用できます。 - 標準グラフとしてのモデル。 読み込まれたモデルはすべて RDF(OWL、SHACL、SKOS、PROV)としてエクスポートでき、読み取り専用の SPARQL クエリに応答します。そのため、「この列を参照しているメジャーはどれか?」 はコード検索ではなくクエリで確認でき、リネージのリンクも同じグラフにつながります。
OrionBelt の位置づけ
OrionBelt はプラットフォームではなく、サイドカーです。YAML モデルを正しい SQL にコンパイルし、すでにお使いのプロトコル経由で公開します。クラスターを実行したり、キャッシュを管理したり、クラウドの採用を求めたりすることはありません。
次のような場合は OrionBelt をお選びください。
- エージェントが一連の質問に対応する小規模なモデルを作成し、モデルとクエリをまとめて送信し、必要に応じて後続の分析にも再利用する必要がある場合。
- エージェントがデータをクエリし、誤った数値が気づかれないまま使われることが許されない場合。複数ファクトのクエリは Composite Fact Layer プランナーに送られ、ファントラップの結合経路を静かに合算してしまうのではなく、ブロックします。
- 指標の定義をレビュー可能な YAML にまとめ、モデルレイヤーで JavaScript や Python を使わずに済ませたい場合。
- BI ツールから、すでに付属している Postgres ドライバー経由で接続し、新しいコネクターのインストールやベンダーのランタイムを介さずに済ませたい場合。
- 複数のエンジンにまたがってセルフホストし、すべてのエンジンで同じモデルをコンパイルして、同じ答えを得たい場合。
- 数値の根拠として、どの列、どのテーブル、どの結合経路がクエリに使われたのかを示す必要がある場合。
- モデルを一つのツールに閉じ込めず、Apache Ossie 経由または RDF グラフとして、ツール間で移動させる必要がある場合。
次のような場合は、別のものをお選びください。
- 大規模で同時実行数の多いダッシュボード向けに、事前集計やキャッシュを調整する必要がある場合。Cube には、その領域での長年にわたる本番環境での実績がありますが、OrionBelt にはまだありません。
- 指標がすでに dbt にあり、チームもそこでの運用に満足している場合。MetricFlow を使えば、指標をそのまま dbt に置いておけます。
- サービングレイヤーではなく、探索的な分析言語を求めている場合。Malloy のほうが適しています。
事前にモデルが読み込まれたライブデモをお試しください。または、Colab ノートブックを開き、TPC-H データに対して実行してください。
コンテキストレイヤーとは?
セマンティックレイヤーは、数値の計算方法、つまりどのテーブル、どの結合、どの集計を使うかを利用者に伝えます。コンテキストレイヤーはさらに、その数値が何を意味し、ビジネスが何を期待しているのかも伝えます。エージェントが推測するのではなく、参照できる形式で示します。OrionBelt では、このコンテキストは指標と同じモデルに含まれます。
- ビジネスルール は、モデルのディメンション、メジャー、指標に対する条件を定義します。たとえば、誰を高価値のクライアントとみなすか、どのカテゴリで赤字販売を避けるべきかなどです。ルールエンジンは各ルールを、その対象または違反を報告するクエリにコンパイルし、REST、MCP、CLI(
obsl rules evaluate)、UI 経由で、1 つのルールまたはすべてのルールを評価します。 - 外部概念マッピング は、データオブジェクト、ディメンション、メジャー、指標、ルールを、組織がすでに管理している概念(schema.org、FIBO、内部語彙など)に出典情報付きで結び付けます。
- OBSL グラフ は、読み込まれたすべてのモデルを RDF として公開するため、その成果物、結合、ルール、概念リンクを SPARQL でクエリできます。
- リネージ は、ディメンション、メジャー、指標、ルール、クエリが、テーブルやプランナーが選択した結合に至るまで何に基づいて構築されているかを示します。JSON、Mermaid、または OBSL グラフにリンクされた Turtle として、API、CLI(
obsl lineage)、UI から確認できます。 - 各成果物の説明、同義語、オーナーによって、エージェントはユーザーが実際に使う語彙を参照できます。
エージェントは、クエリツールと並んで、MCP および REST 経由ですべてにアクセスできます。そのため、数値を計算するモデルが、その数値を説明することもできます。次のセクションでは、モデル内のルールと概念リンクを紹介します。
指標だけではなく、意味を
Total Sales が合計であることしか知らないモデルでは、高価値のクライアントとは何か、あるいは赤字のカテゴリがバグなのか事実なのかを、エージェントが推測する余地が残ります。2.30 以降、モデルはそれらも保持するようになりました。ビジネスルール、組織が管理するオントロジーへのリンク、そして RDF グラフとしてのモデルそのものによって、OrionBelt はセマンティックレイヤーであると同時にコンテキストレイヤーにもなっています。数値だけでなく、その背後にある意味をエージェントに伝えます。
ビジネスルールは、SQL を使わずにモデル独自のディメンション、メジャー、メトリクスに対する条件を定義します。ルールエンジンは、それぞれのルールを検出結果を報告するクエリにコンパイルします。分類ルールまたは適格性ルールでは対象メンバーを、検証ルールまたは制約ルールでは違反を返します。
rules:
  Non-Negative Margin:
    type: validation
    severity: error
    description: Every product category must sell for at least what it cost
    grain: [Product Category]
    condition: {field: Gross Margin, op: ">=", value: 0}
このルールはメトリクスを参照するため、集計ルールです。あらゆるクエリと同じプランナーを通じて、マルチファクトも含め、カテゴリの粒度における HAVING になります。POST /v1/rules/{name}/evaluate はこのルールに該当するカテゴリを返し、POST /v1/rules/evaluate はすべてのルールを実行してひとつのレポートにまとめます。
オントロジーリンクは、SKOS のマッピング関係と来歴情報を使って、アーティファクトを組織がすでに管理している概念に結び付けます。
ontology:
  prefixes:
    schema: "https://schema.org/"

dataObjects:
  Products:
    externalConceptMappings:
      - concept: schema:Product
        relation: exact
        justification: curated
リンクによって SQL が変わることはありません。変わるのは、問い合わせ可能な内容です。読み込まれたモデルはすべて RDF グラフでもあるため、「どのアーティファクトが schema.org Product を意味するか」は SPARQL クエリで調べられます。ディスカバリー API では、REST 経由でも同じ情報を取得できます(/concept-mappings、その /namespaces、および未対応項目の一覧である /unmapped)。
エージェントにとって、これは推測するか、調べて確認するかの違いです。MCP 経由では、list_rules、evaluate_rule、find_concept_mappings が execute_query と並ぶツールとして利用できます。
ガイド:ビジネスルール、外部概念マッピング、OBSL グラフと SPARQL。
目次
質問をモデル化する · 4 つの入力方法 · 8 つの出力方法 · オープンで追跡可能 · コンテキストレイヤーとは? · 指標だけではなく、意味を · 30 秒で試す · Claude Desktop / MCP · OrionBelt を選ぶ理由 · 機能 · 例 · ドキュメント · ロードマップ · 商用利用 · 開発
30 秒で試す
オプション A:ライブデモ(インストール不要)
ライブデモを開く — 事前にサンプルモデルが読み込まれた Gradio UI です。クエリを貼り付け、方言を選ぶと、すぐに SQL が表示されます。
API エクスプローラー:Swagger UI | ReDoc
PostgreSQL ワイヤープロトコルのインターフェースを試してみませんか? Cloud Run は HTTPS 専用のため、公開デモではポート 5432(pgwire)や 8815(Flight SQL)を公開できません。同じデモを 2 つのコマンドでローカルに起動できます。組み込みの
orionbelt_1_commerceDuckDB データセットと、OBSQL の全インターフェースが含まれています。docker run --rm -d --name orionbelt-demo \ -p 8080:8080 -p 5432:5432 -p 8815:8815 \ -e PGWIRE_ENABLED=true \ -e FLIGHT_ENABLED=true \ ralforion/orionbelt-semantic-layer-api:latest # REST + Gradio UI: http://localhost:8080/ui # pgwire(psql / DBeaver / Tableau / Power BI などに対応): psql "host=localhost port=5432 user=obsl dbname=orionbelt_1_commerce sslmode=disable" \ -c 'SELECT "Client Name", "Total Sales" LIMIT 5' # Flight SQL のスモークテスト: uv run python examples/obsql.py 'SELECT "Client Name", "Total Sales" LIMIT 5' docker stop orionbelt-demoコンテナには
PGWIRE_AUTH_MODE=trust(デフォルト)が設定されているため、localhostでの利用には安全ですが、パブリックインターネットに公開するのは安全ではありません。外部に公開するデプロイでは、AUTH_MODE=api_key(v2.12.0 で追加)を設定してください。これにより、pgwire は共有キーのストアを使って SCRAM-SHA-256(または TLS 経由のクリアテキスト)で認証を行います。
オプション B:Google Colab(インストール不要)
 — TPC-H データを使ったインタラクティブなノートブックです。モデルを調べ、さまざまな方言のクエリをコンパイルし、DuckDB に対して実行して、結果を確認できます。Python 3.12 のランタイムが必要です。
オプション C:PyPI からインストール
pip install orionbelt-semantic-layer
次に、Python REPL に貼り付けます。
from orionbelt.parser import ReferenceResolver, TrackedLoader
from orionbelt.compiler.pipeline import CompilationPipeline
from orionbelt.models.query import QueryObject, QuerySelect

model_yaml = """
version: 1.0
dataObjects:
  Orders:
    code: ORDERS
    columns:
      Price: { code: PRICE, abstractType: float }
      Country: { code: COUNTRY, abstractType: string }
dimensions:
  Country:
    dataObject: Orders
    column: Country
    resultType: string
measures:
  Total Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]}"
"""

loader = TrackedLoader()
raw, source_map = loader.load_string(model_yaml)
resolver = ReferenceResolver()
model, result = resolver.resolve(raw, source_map)

query = QueryObject(select=QuerySelect(dimensions=["Country"], measures=["Total Revenue"]))
pipeline = CompilationPipeline()
output = pipeline.compile(query, model, "postgres")
print(output.sql)
出力:
SELECT
  "Orders"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE") AS NUMERIC(18, 2)) AS "Total Revenue"
FROM ORDERS AS "Orders"
GROUP BY "Orders"."COUNTRY"
環境ファイルは不要です。コンパイルパイプラインはステートレスです。
サーバーを起動する:
orionbelt-api                              # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
orionbelt-ui                               # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true orionbelt-api          # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true orionbelt-api          # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
オプション C2:uv でインストール
uv pip install orionbelt-semantic-layer
uv run orionbelt-api                       # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
uv run orionbelt-ui                        # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true uv run orionbelt-api   # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true uv run orionbelt-api   # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
obsl CLI を使う(サーバー不要。プロセス内でコンパイルします):
obsl validate model.yaml                                  # lint a model (exit 1 on error, CI-friendly)
obsl compile model.yaml -q query.json -d snowflake        # print the generated SQL
obsl compile model.yaml --sql 'SELECT "Region", "Sales" FROM model'  # ... or from an OBSQL string
obsl describe model.yaml                                   # overview of data objects + artefacts
obsl diagram model.yaml                                    # Mermaid ER diagram
obsl convert obml-to-osi model.yaml                        # OBML -> OSI (and osi-to-obml)
obsl execute -q query.json --server http://host           # run against a deployed model (omit MODEL)
すべてのコマンドについては、CLI ガイドを参照してください。
BI ツールを使わずに Flight SQL のインターフェースをスモークテストする:
uv run python examples/obsql.py 'SELECT version()'
uv run python examples/obsql.py 'SHOW TABLES'
uv run python examples/obsql.py 'SELECT "Region", "Total Sales" FROM sales LIMIT 5'

# Multi-model deployment? Pick the model with -m:
uv run python examples/obsql.py -m sales 'SHOW TABLES'
uv run python examples/obsql.py --list   # discover loaded models via REST
30 秒で OBSQL を試す
OBSQL — OrionBelt Semantic QL — は、BI ツールやユーザーが実際に記述する SQL インターフェースです。裸のラベル、MEASURE() マーカー、または一致する集計ラッパーを使用します。集計の一致を検証し、WITH ROLLUP / WITH CUBE に対応しています。生のデータウェアハウス SQL に逃げる手段はありません。Arrow Flight SQL(v2.4 以降)と PostgreSQL ワイヤープロトコル(v2.5 以降)で、同じ言語を使用できます。
PGWIRE_ENABLED=true uv run orionbelt-api &

# Every BI tool already ships a Postgres ODBC/JDBC driver — point yours at :5432
psql "host=localhost port=5432 user=obsl dbname=sales sslmode=disable" \
  -c 'SELECT "Region", "Total Sales" LIMIT 5'

# All three measure forms compile to the same vendor SQL:
psql "..." -c 'SELECT "Region", "Total Sales"        FROM sales LIMIT 5'  -- bare
psql "..." -c 'SELECT "Region", MEASURE("Total Sales") FROM sales LIMIT 5'  -- explicit marker
psql "..." -c 'SELECT "Region", SUM("Total Sales")   FROM sales LIMIT 5'  -- matching aggregate
文法の全容については、OBSQL リファレンスを参照してください。
オプション D:Docker
ステージ 1 — 設定なしで起動(モデルは後から API または UI 経由で読み込みます):
docker run -p 8080:8080 ralforion/orionbelt-semantic-layer-api
API を確認するには、http://localhost:8080/docs を開いてください。
ステージ 2 — docker compose を使った実用的なセットアップ:
# docker-compose.yml
services:
  api:
    image: ralforion/orionbelt-semantic-layer-api:2.36.0
    ports: ["8080:8080"]
    env_file: .env
    volumes:
      - ./models:/app/models:ro
    environment:
      MODEL_FILES: /app/models/my-model.obml.yml

  ui:
    image: ralforion/orionbelt-semantic-layer-ui:2.36.0
    ports: ["7860:7860"]
    environment:
      API_BASE_URL: http://api:8080
docker compose up -d
環境変数の全項目については、.env.template を参照してください。
Docker に関する注意事項:
- コンテナ内の
API_SERVER_HOSTはすでに0.0.0.0に設定されているため、上書きは不要です。- Docker では stdio 経由の MCP は動作しません。コンテナ環境でデプロイする場合は、MCP HTTP クライアントを使用してください。
- モデルを
/app/models(または任意のパス)にマウントし、起動時に読み込むにはMODEL_FILES(カンマ区切りのパス)を設定してください。- 本番環境では、
:latestではなくバージョンタグ(:2.36.0)を固定してください。
Claude Desktop / MCP
MCP サーバーは、REST API に処理を委譲する独立した軽量クライアントです。
Claude Desktop の claude_desktop_config.json に追加します。
{
  "mcpServers": {
    "orionbelt": {
      "command": "uvx",
      "args": ["orionbelt-semantic-layer-mcp"]
    }
  }
}
Copilot、Cursor、Windsurf でも動作します。設定方法の詳細は、MCP リポジトリをご覧ください。
OrionBelt を選ぶ理由
| OrionBelt | dbt Semantic Layer | Cube | Malloy | |
|---|---|---|---|---|
| モデル形式 | YAML(OBML) | dbt モデル上の YAML | YAML または JavaScript | Malloy 言語 |
| ランタイム | セルフホスト可能なサービス | dbt Cloud | Cube Core(セルフホスト可能)または Cube Cloud | ライブラリ、および Publisher サーバー |
| ライセンス | BUSL-1.1(Apache 2.0 に移行) | 定義はオープンソース、ランタイムは dbt Cloud 上 | Apache 2.0 のコア + Cube Cloud | オープンソース |
| クエリインターフェース | PostgreSQL ワイヤープロトコルおよび Arrow Flight SQL 上の OBSQL、REST、MCP、DB-API ドライバー、CLI | GraphQL、JDBC(Cloud) | SQL API(PostgreSQL ワイヤープロトコル)、REST、GraphQL | Malloy 言語、Publisher の REST および MCP |
| 複数ファクトのクエリ | UNION ALL の脚(CFL)、ファントラップ経路は拒否 | 共有エンティティ上での FULL OUTER JOIN | ファクトごとのサブクエリを共有ディメンション上で結合 | 単一ルートのソース |
| すべてのエンジンで同じ結果 | 固定され、実行されます(x/0、丸め、NULL、JSON) | エンジンのセマンティクスを継承 | エンジンのセマンティクスを継承 | 一部を正規化:greatest / least は引数のいずれかが NULL の場合に NULL を返し、round はゼロから遠ざかる方向に丸め、length は文字数を返します。x / 0 はエンジンに委ねられ(DuckDB では inf)、また「すべての関数について、すべての方言間で完全な互換性が保証されるわけではありません」 |
| リネージ | 成果物ごと、クエリごとに、列や選択された結合まで追跡 | セマンティックモデルとメトリクスのカタログ DAG。クエリごとのリネージはなし | Cube Cloud Metadata API:カタログ連携向けに、データベース名と SQL 式を含め、キューブやメンバーからソーステーブルまで追跡。クエリごとのリネージはなし | 公開された情報なし |
| 相互運用 | Apache Ossie の双方向対応、SPARQL を使った RDF としてのモデル | なし | Cube CLI と Platform API を介した Apache Ossie のインポートおよびエクスポート(2026 年 10 月、CLI はプレビュー版で、アクセスには Cube サポートへの問い合わせが必要) | なし |
| モデル内のビジネス上の意味 | 調査結果を報告するクエリにコンパイルされるルール、外部オントロジーへの SKOS リンク | 列レベルのデータテスト、自由形式の meta | 自由形式の meta(ai_context) | 注釈(解釈なし) |
各ツールの優位な点も含む、双方向の詳細な比較:dbt、Cube、Malloy、LookML、AtScale。
機能
セマンティックモデリング
- OBML 形式 — データオブジェクト、ディメンション、メジャー、メトリクス、結合を含む YAML ベースのセマンティックモデル
- スキーマ横断クエリ — 複数のデータベースとスキーマにまたがるデータオブジェクトを、単一のモデルでモデリング
- 静的モデルフィルター — モデルに組み込まれ、結合の拡張時に自動適用される必須の WHERE 条件
- ビジネスルール — SQL を使わず、ディメンション、メジャー、メトリクスに対する宣言的な
rules(分類、適格性、検証、制約)。ルールの検出結果を報告するクエリにコンパイルされ、個別または一括でテストしてレポートにまとめられます。UI の「ビジネスルール」タブから一覧表示および評価できます - OBSL グラフと SPARQL — 読み込まれたすべてのモデルを RDF グラフとしてエクスポートし、読み取り専用の SPARQL クエリを実行できます。外部概念マッピングにより、データオブジェクト、ディメンション、メジャー、メトリクスを SKOS マッチとしてビジネスオントロジー(FIBO、schema.org、企業用語集)に関連付けます
- OSI 相互運用性 — OBML と Open Semantic Interchange 形式の双方向変換に対応。現在はApache Ossie(インキュベーション中)として開発されています
SQL コンパイル
- 8 種類の SQL 方言 — BigQuery、ClickHouse、Databricks、Dremio、DuckDB/MotherDuck、MySQL、Postgres、Snowflake
- AST ベースの生成 — カスタム SQL AST により、正確でインジェクションに安全な SQL を生成します(文字列テンプレートは使用しません)
- スター・スキーマと CFL — マルチファクトクエリ向けの Composite Fact Layer による自動結合解決
- データ型と精度 — 方言ごとの型レンダリングと精度の上限設定を伴う自動 CAST ラッピング
- 表示形式 — メジャー/メトリクスに数値書式パターン(
#,##0.00、0.00%)を設定し、ロケールに応じて表示 - タイムゾーン設定 — データベースのセッションタイムゾーンを自動検出し、
defaultTimezoneをフォールバックとして使用。ISO 8601 形式でシリアライズします - sqlglot による検証 — 生成後に、サポートされているすべての方言で構文をチェックします
統合インターフェース
- REST API — モデル管理、検証、コンパイル、実行のための FastAPI エンドポイント
- MCP サーバー — Claude、Copilot、Cursor、Windsurf 向けの別個の軽量クライアント
- AI 統合 — LangChain、OpenAI Agents SDK、CrewAI、Google ADK、Vercel AI SDK、n8n、ChatGPT
- Gradio UI — モデル編集、クエリテスト、ER 図表示のためのインタラクティブなウェブインターフェース
- DB-API 2.0 + Flight SQL — DBeaver、Tableau、Power BI 向けの PEP 249 ドライバーと Arrow Flight SQL サーバー。Flight インターフェースを BI ツールなしでテストできる、小さなターミナル CLI
examples/obsql.pyが付属します - クライアントとしての DuckDB(v2.27.1 以降)- 通常の DuckDB シェルから、どちらのインターフェース経由でもレイヤーにクエリを実行できます。
ATTACH ... (TYPE postgres)でモデルをテーブルとしてマウントできます(SELECT ... FROM obsl.sales.model。最初にSET pg_use_text_protocol = trueを 1 回実行)。コミュニティ拡張機能のadbc_scannerを使えば、Arrow のまま Flight SQL 経由で実行できます。ガバナンス対象のメジャーをローカルテーブルと結合し、CREATE TABLE ASで保存できます。ガイド - PostgreSQL ワイヤープロトコル(v2.5.0 以降)—
:5432でネイティブの Postgres プロトコルインターフェースを提供します。すべての BI ツールには Postgres ODBC/JDBC ドライバーがすでに付属しているため、ユーザー側では「既存の接続先を OBSL に向けるだけ」で利用できます。Tableau、DBeaver、Superset、Power BI、通常のpsql、そしてフェデレーションされた Postgres ソースとしての Dremio(Dremio → OBSL → 必要に応じて Dremio のレイクハウスに戻る、ひと回りする構成)
エージェント向け API
- ワンショットモデル+クエリ:タスク固有の OBML と独立したサブクエリを
POST /v1/oneshot/batchに送信し、クエリごとの結果を取得できます。また、後続の問い合わせに備えてモデルを保持することもできます。エージェントのワークフローを参照してください。 - モデル読み込み時のヘルス情報 — モデルを読み込むたびに、孤立した dataObject、ファントラップのリスク、到達不能なディメンションを含む
healthブロックが返されるため、エージェントは防御的な2回目のリクエストを省略できます。 - クエリプランエンドポイント —
POST /query/planは、SQL のコンパイルや実行を行わずに、プランナーの解釈(プランナーの選択、物理テーブル、結合経路、would_compile)を返します。include_database_explainを有効にすると、ウェアハウスの生の EXPLAIN が追加されます。 - 構造化された警告 — API 全体のすべての
warningsリストで、安定した{code, severity, message, path, hint, context}形式と、文書化されたコード分類を使用します。エージェントはメッセージを解析するのではなく、コードに基づいて分岐できます。 - ファジー検索による
/findの補完 — 検索で完全一致も同義語の一致も見つからない場合、決定的なレーベンシュタイン距離とトライグラムによるフォールバックで、スコアと理由を含む類似候補を返します。 - ディメンション値の検索:
POST /v1/valuesは、ディメンションが持つ値を一覧表示または検索します(完全一致、前方一致、部分一致、ファジー検索の順)。これにより、エージェントは推測ではなくデータに基づいてフィルター値を設定できます。モデルの静的フィルターが適用され、valueSearch: falseにすると列の値は非公開になります。 - モデルの例 — 任意の OBML
examples:ブロックに標準的なクエリを定義できます。GET /examples(?intent=によるフィルタリング対応)を使うと、エージェントは1回のリクエストでモデルが回答するように設計された内容を見つけられます。
最新度に基づく結果キャッシュ
- ソースレベルの最新度コントラクト —
dataObjectエントリにrefresh:ブロック(間隔/ハートビート/静的)を宣言します。キャッシュは呼び出し元の推測ではなく、クエリが参照した物理テーブルのコントラクトからクエリの TTL を導出します。 - ハートビートによる無効化 — 物理テーブルに対して
POST /v1/heartbeatを1回実行すると、あらゆる dataObject とセッションにわたり、そのテーブルに依存するすべてのキャッシュ済みクエリが無効になります。 - DuckDB メタデータ+Parquet 結果 — 型を正確に保つシリアライズ、遅延有効期限切れ、LRU による容量整理に対応したファイルベースのキャッシュです。
CACHE_BACKEND=fileで有効化できます。 - Cube/dbt/Looker のパターンを逆転 — コントラクトは意味的な抽象化ではなくソースに置かれます。そのテーブルを読み取るすべてのキューブ/エクスプロア/保存済みクエリで、単一の信頼できる情報源を維持できます。
開発者エクスペリエンス
- ソース位置エラー — 検証エラーには YAML の正確な行と列が表示されます。
- ER 図 — ズームとダウンロード(MD/PNG/Turtle)に対応したインタラクティブな Mermaid 図です。
- セッション管理 — TTL の適用範囲内で、スレッドセーフなモデル分離を行うセッションです。
- JSON Schema — IDE の自動補完に対応する OBML とクエリの完全なスキーマです(
yaml-language-server)。
例
セマンティックモデルを定義する(OBML)
# yaml-language-server: $schema=https://raw.githubusercontent.com/ralforion/orionbelt-semantic-layer/main/schema/obml-schema.json
version: 1.0
dataObjects:
  Customers:
    code: CUSTOMERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Country:     { code: COUNTRY, abstractType: string }

  Orders:
    code: ORDERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Order Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Price:             { code: PRICE, abstractType: float }
      Quantity:          { code: QUANTITY, abstractType: int }
    joins:
      - joinType: many-to-one
        joinTo: Customers
        columnsFrom: [Order Customer ID]
        columnsTo: [Customer ID]

dimensions:
  Country:
    dataObject: Customers
    column: Country
    resultType: string

measures:
  Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]} * {[Orders].[Quantity]}"
    dataType: "decimal(18, 2)"
REST API 経由でコンパイルする
# Create a session
curl -s -X POST http://localhost:8080/v1/sessions | jq .session_id
# -> "a1b2c3d4"

# Load the model
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/models \
  -H "Content-Type: application/json" \
  -d '{"model_yaml": "..."}' | jq .model_id
# -> "abcd1234"

# Compile a query
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/query/sql \
  -H "Content-Type: application/json" \
  -d '{"model_id":"abcd1234","query":{"select":{"dimensions":["Country"],"measures":["Revenue"]}},"dialect":"postgres"}' \
  | jq -r .sql
生成された SQL(Postgres)
SELECT
  "Customers"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE" * "Orders"."QUANTITY") AS NUMERIC(18, 2)) AS "Revenue"
FROM WAREHOUSE.PUBLIC.ORDERS AS "Orders"
LEFT JOIN WAREHOUSE.PUBLIC.CUSTOMERS AS "Customers"
  ON "Orders"."CUSTOMER_ID" = "Customers"."CUSTOMER_ID"
GROUP BY "Customers"."COUNTRY"
方言固有の SQL を生成するには、dialect を bigquery、clickhouse、databricks、dremio、duckdb、mysql、または snowflake に変更します。
Gradio UI
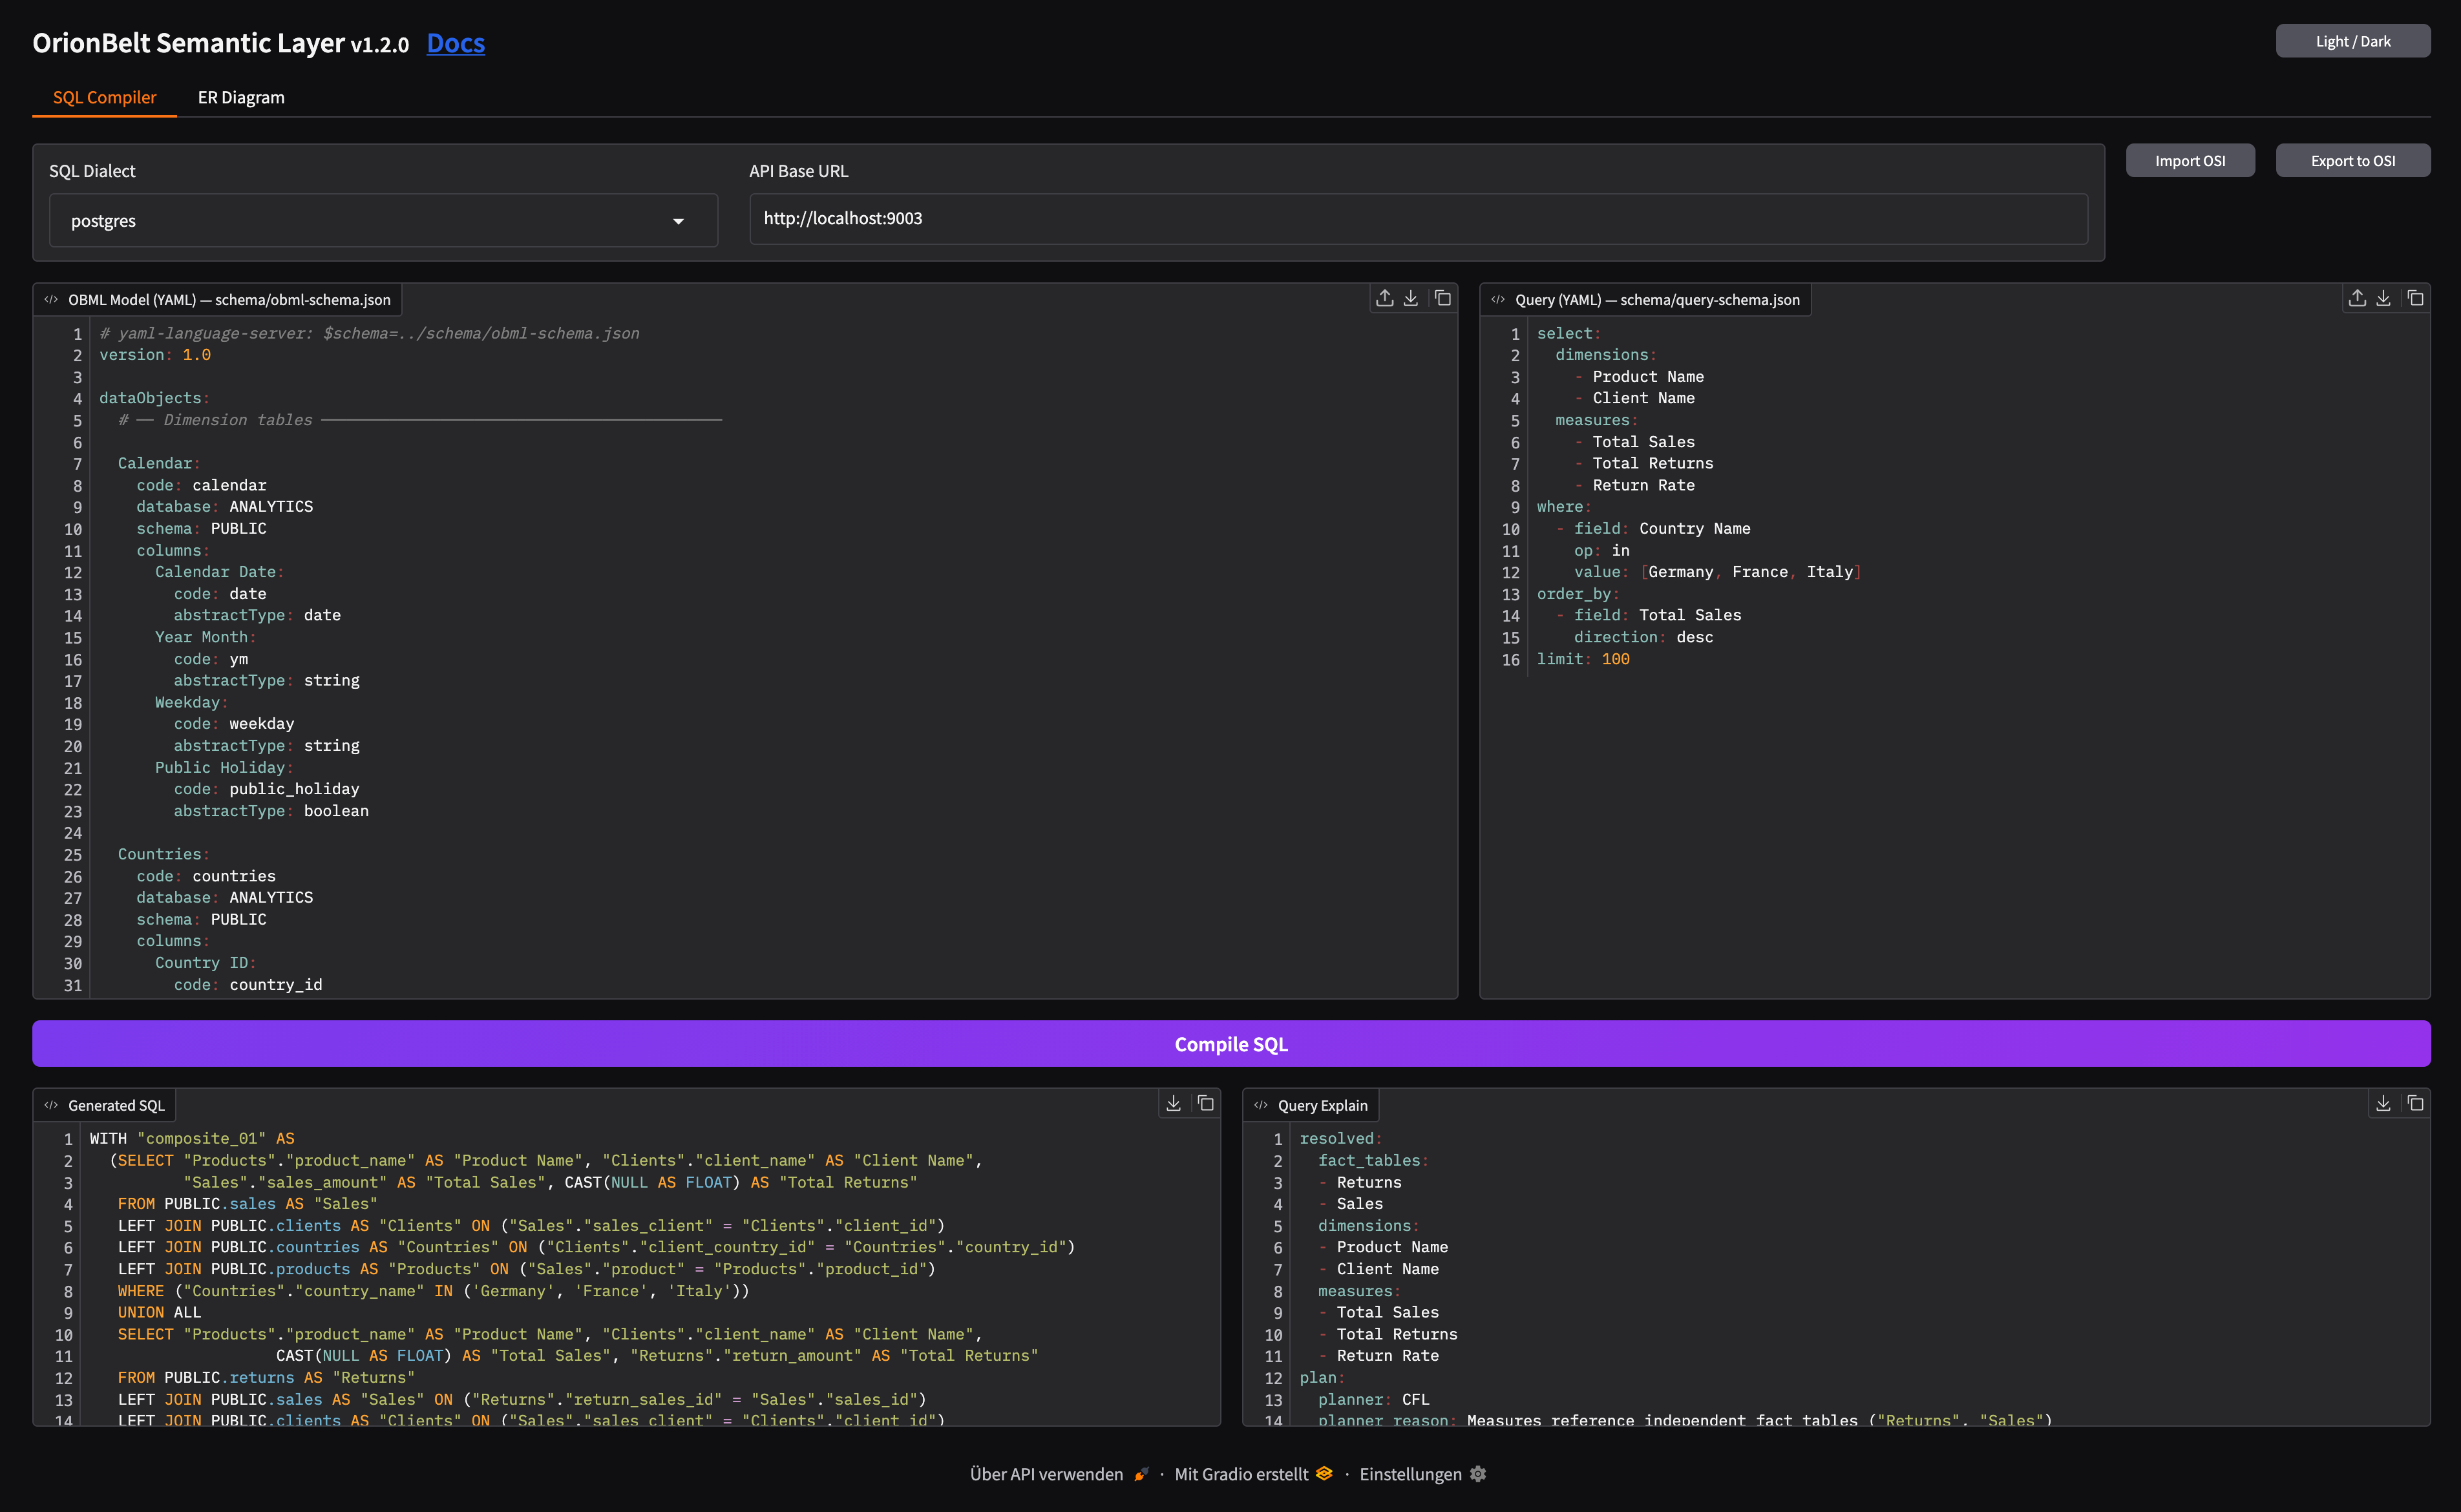
- SQL コンパイラー — OBML モデルとクエリエディターを並べて表示し、構文を強調表示します。8 種類の方言を選択でき、ワンクリックでコンパイルし、整形済み SQL 出力とクエリの実行計画を表示します
- クエリ実行 — 接続済みデータベースに対してコンパイル済みクエリを実行し、ロケールに応じた数値形式の結果、レスポンスメタデータパネルを表示できます。また、TSV のダウンロードとクリップボードへのコピーも可能です(
QUERY_EXECUTE=trueが必要です) - ER 図 — ズーム、列の表示切り替え、ダウンロード(MD/PNG/Turtle)が可能なインタラクティブな Mermaid ER 図
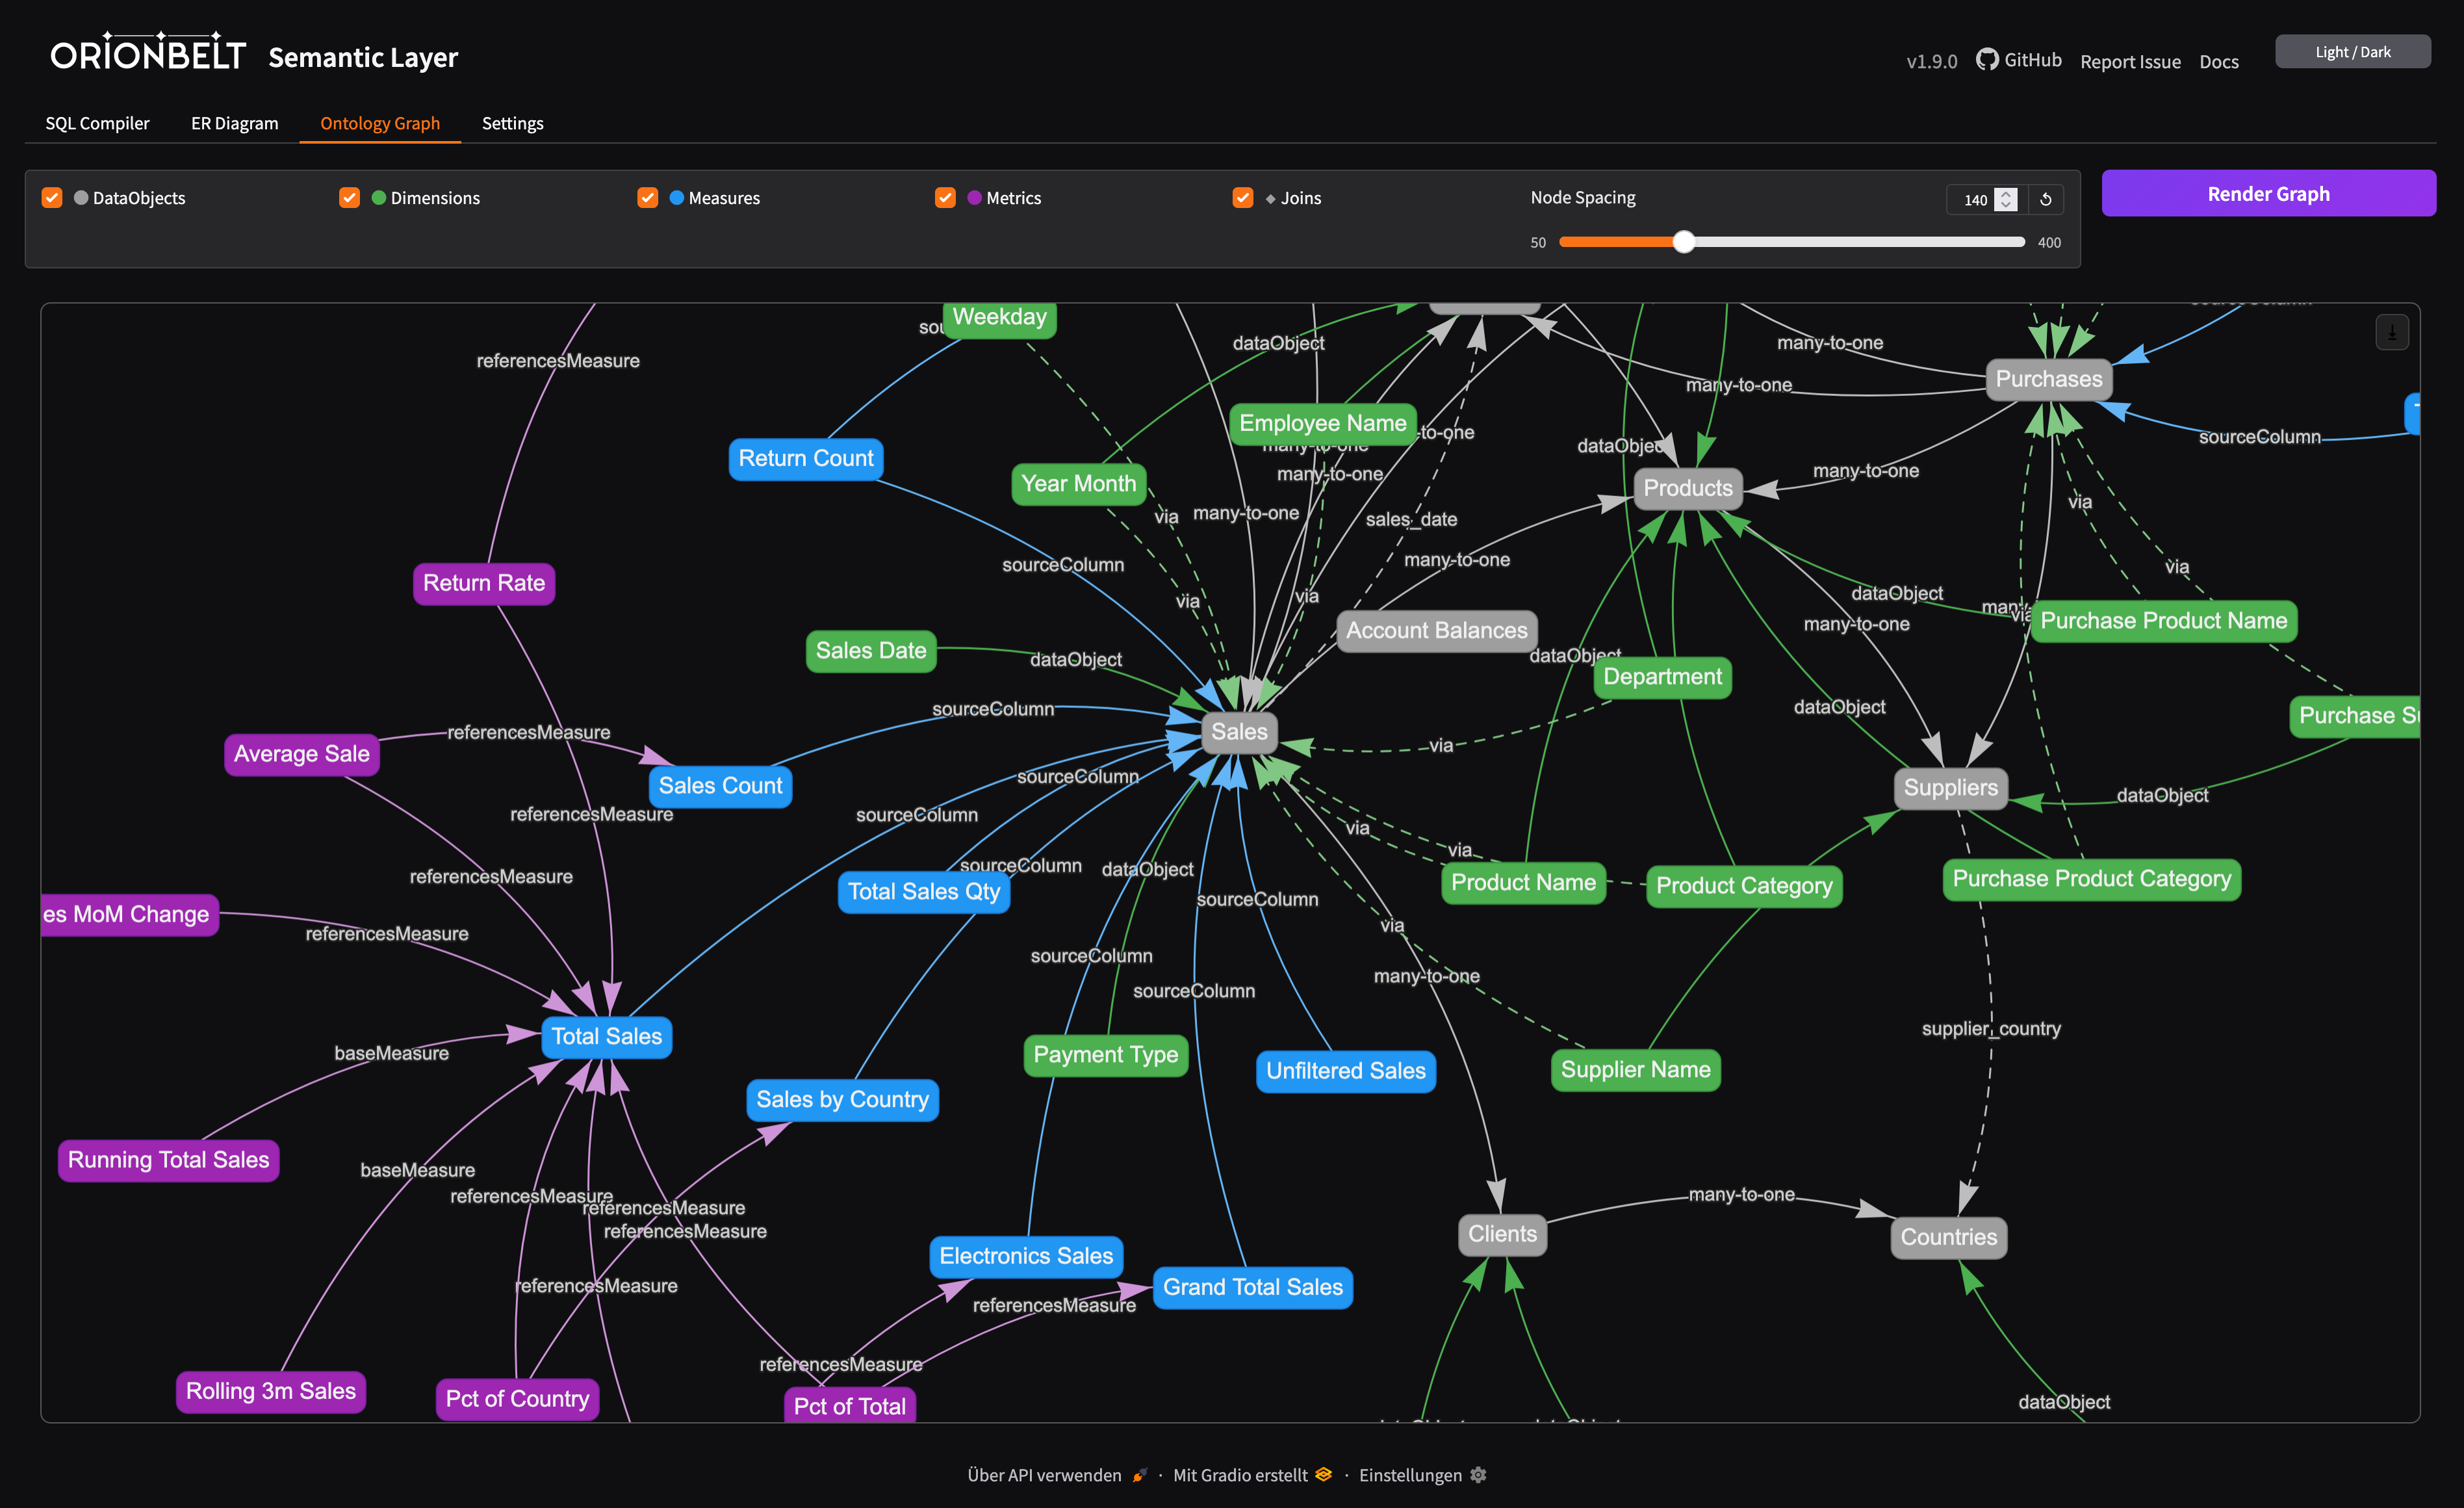
- オントロジーグラフ — OBML グラフ(データオブジェクト、ディメンション、メジャー、指標、結合)をインタラクティブな vis-network で可視化します。レイヤーの表示切り替えとノード間隔の調整が可能です
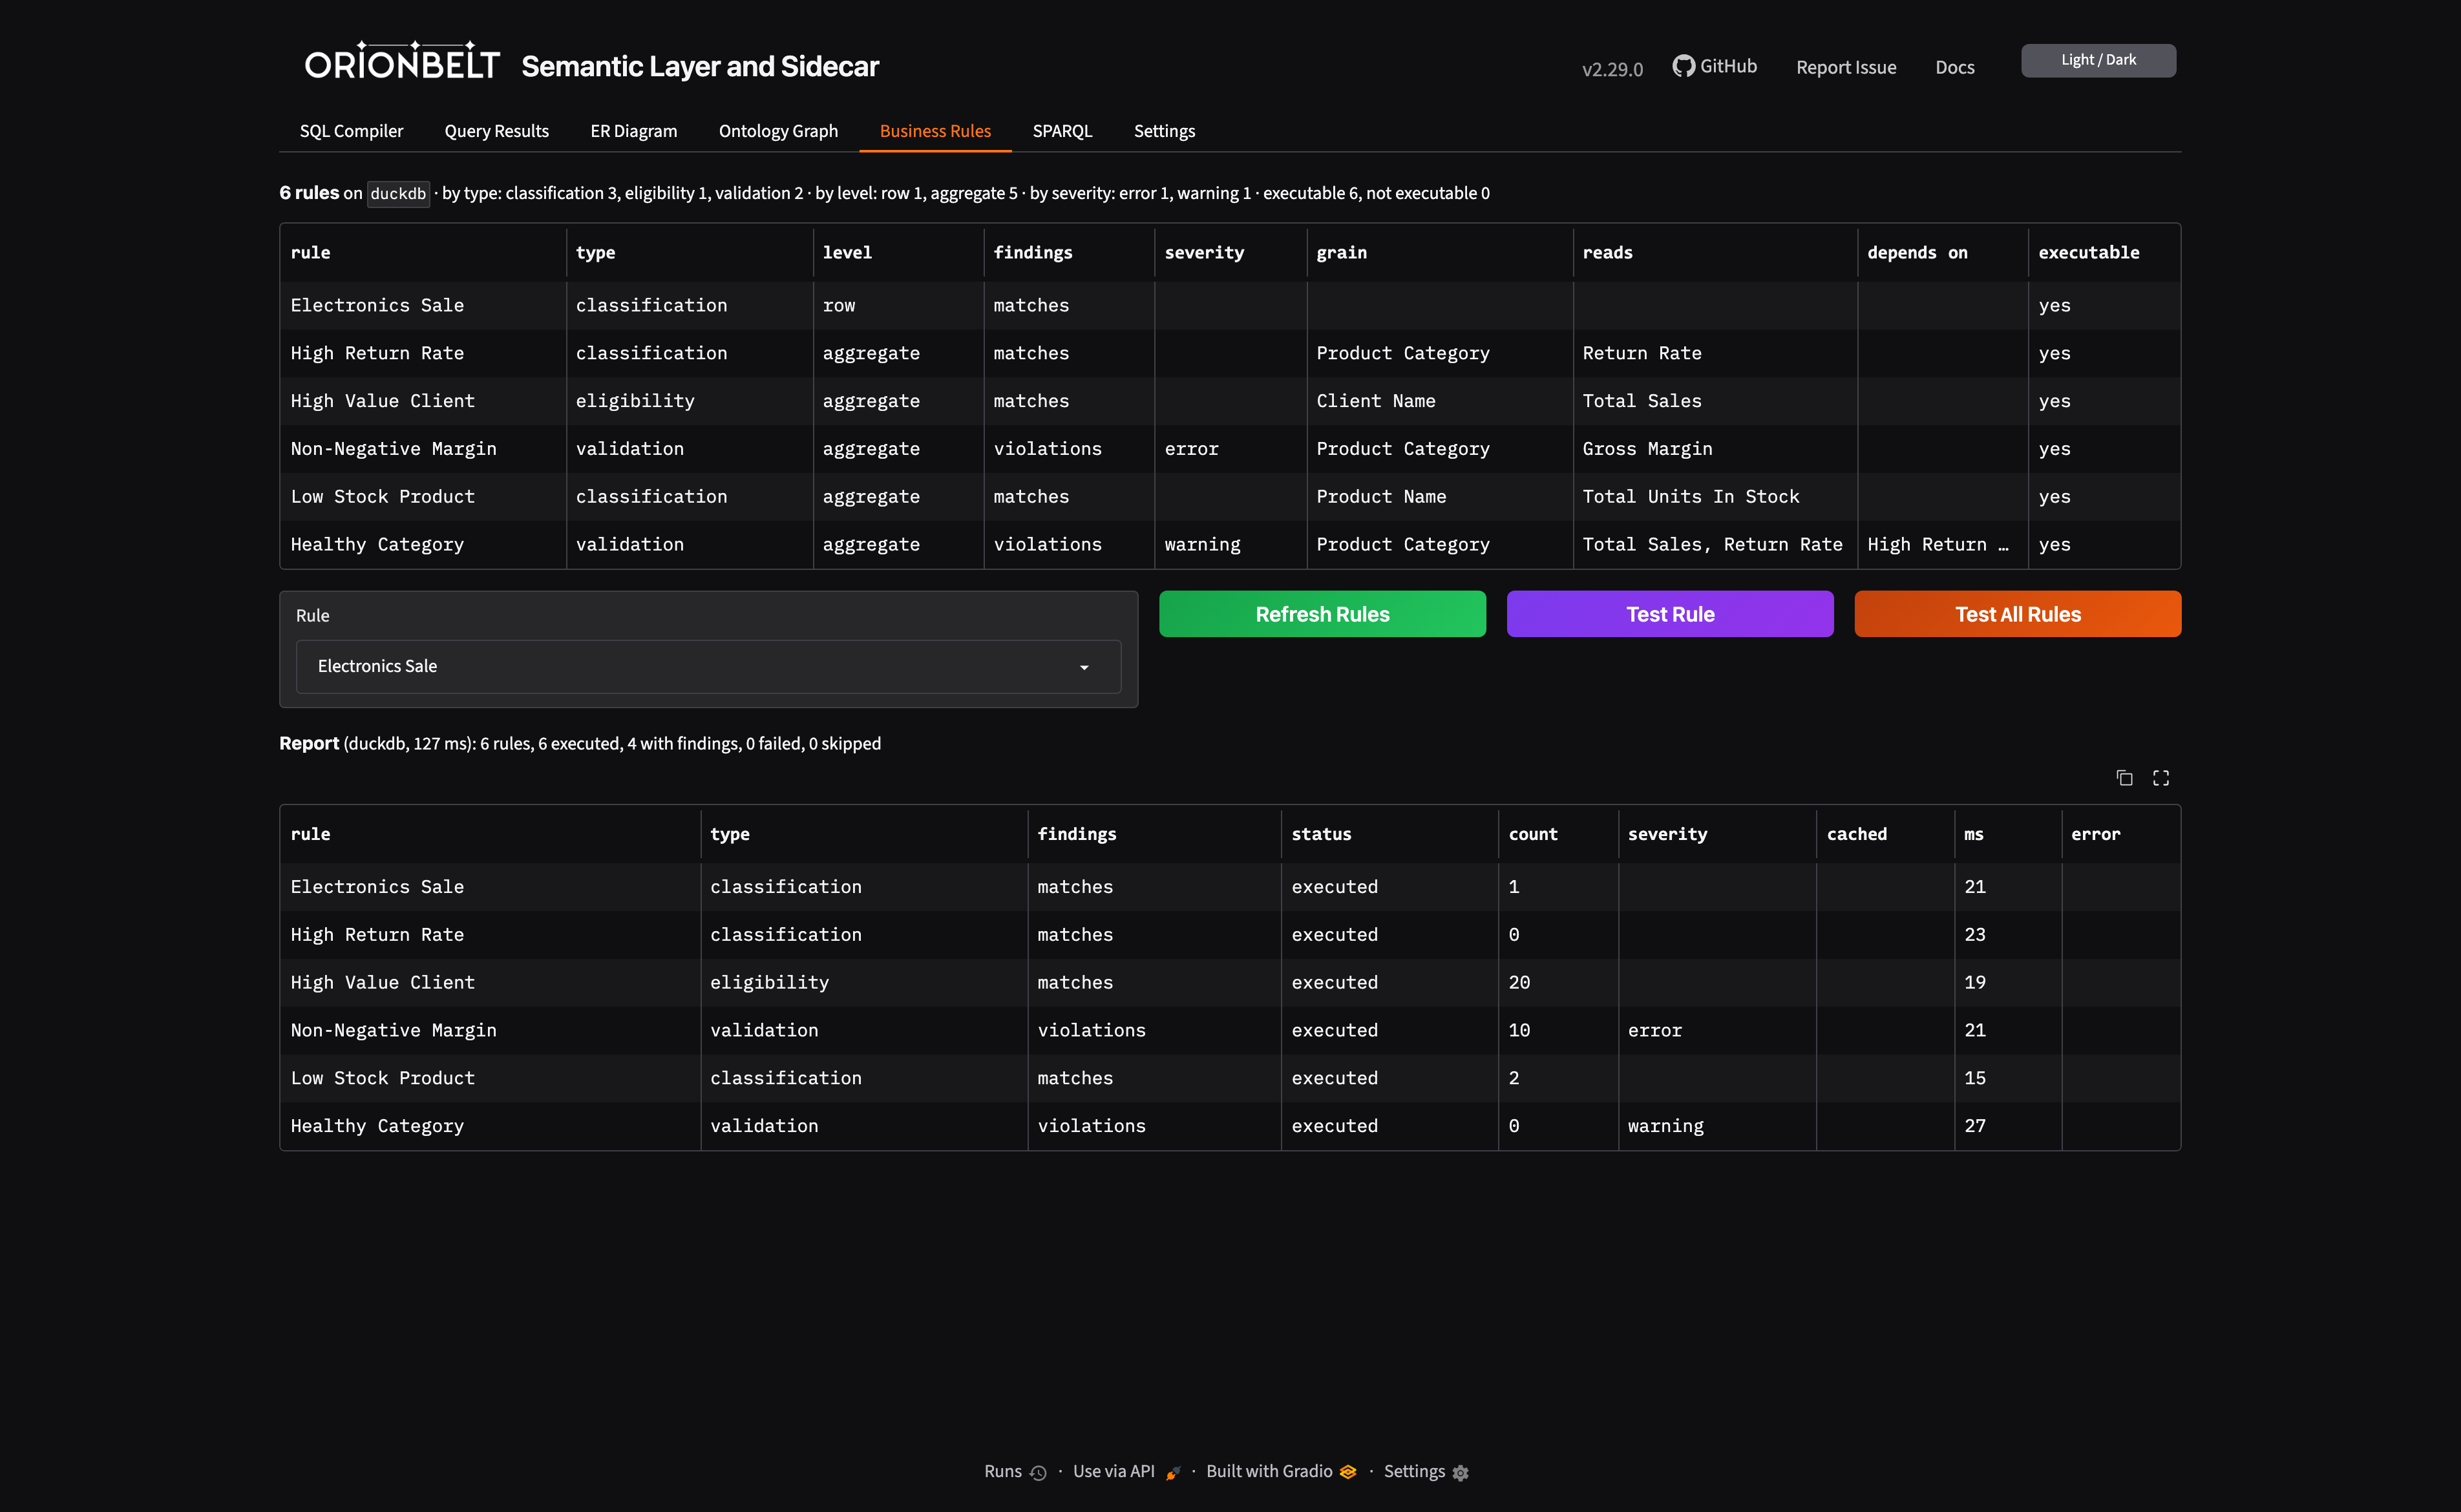
- ビジネスルール:統計情報付きでモデルのルールを表示します。行をクリックしてルールを選択すると、OBML 定義を表示して、そのルールまたはすべてのルールをテストし、レポートを生成できます
- SPARQL:モデルの OBSL グラフに対する読み取り専用の SELECT / ASK を実行できます。SPARQL 構文を強調表示するエディターと、そのまま実行できるサンプルのギャラリーを備えています
- エディターツールバー — すべてのコードエディターで、クリア、元に戻す、やり直し、アップロード、ダウンロード、コピーの各ボタンを使用できます
- OSI のインポート/エクスポート — OBML と OSI の形式を相互に変換します
- ダークモード/ライトモード — ヘッダーボタンで切り替えられ、設定はセッションをまたいで保持されます
組み込みモード — API サーバーの /ui に UI をマウントします:
pip install orionbelt-semantic-layer && orionbelt-api
# -> UI at http://localhost:8000/ui
スタンドアロンモード — API と UI を別々のプロセスとして実行します:
orionbelt-api                                              # API on :8000
orionbelt-ui                                               # UI on :7860 (connects to API on :8000)
API_BASE_URL=http://remote-api:8080 orionbelt-ui           # point UI to a remote API
ドキュメント
| トピック | リンク |
|---|---|
| ドキュメントサイト全体 | ralforion.com/orionbelt-semantic-layer |
| インストール | getting-started/installation |
| クイックスタート | getting-started/quickstart |
| Docker とデプロイ | getting-started/docker |
| 開発 | getting-started/development |
| OBML モデル形式 | guide/model-format |
| クエリ言語 | guide/query-language |
| SQL 方言 | guide/dialects |
| 期間比較指標 | guide/period-over-period |
| トレンド分析(rank / lag / lead / ntile、パーティション化された移動平均、統計集計) | guide/trend-analysis |
| コンパイルパイプライン | guide/compilation |
| OBSL グラフと SPARQL | guide/obsl |
| ビジネスルール | guide/business-rules |
| 外部概念マッピング | guide/concept-mappings |
| Gradio UI | guide/ui |
| AI 統合 | guide/integrations |
| OSI 相互運用性 | guide/osi |
| REST API エンドポイント | api/endpoints |
| DB-API ドライバーと Flight SQL | drivers |
| アーキテクチャ | reference/architecture |
| 設定 | reference/configuration |
| 販売モデルの解説 | examples/sales-model |
| 複数方言の出力 | examples/multi-dialect |
| 複数ファクト:販売と返品 | examples/multi-fact |
| TPC-DS ベンチマーク | examples/tpcds |
| クイックスタートノートブック | examples/quickstart.ipynb |
| 比較:概要 | comparison/ |
| 比較:dbt Semantic Layer との比較 | comparison/dbt |
| 比較:Malloy との比較 | comparison/malloy |
| 比較:LookML / Looker との比較 | comparison/lookml |
| 比較:Cube との比較 | comparison/cube |
| 比較:AtScale との比較 | comparison/atscale |
ステータスとロードマップ
| ステータス | 分野 |
|---|---|
| リリース済み | 8 種類の SQL 方言、REST API、MCP サーバー、Gradio UI、DB-API ドライバー、Flight SQL、PostgreSQL wire protocol (v2.5.0+) — Tableau / DBeaver / Superset / Power BI / psql / フェデレーションされた Postgres ソースとしての Dremio、OBSL/SPARQL、双方向のスキーマ検証を備えた OSI v0.2 相互運用性、AI 統合(LangChain、CrewAI、ADK など)、モデルの継承と extends、データ型と数値精度、タイムゾーン設定、粒度とフィルターコンテキストのオーバーライド、トレンド分析 — パーティション化されたローリングウィンドウ、ランク/ラグ/リード/ntile 用の MetricType.WINDOW、9 種類の統計集計(CORR、COVAR_、REGR_、STDDEV_、VAR_)、REST / Flight / pgwire / UI 全体の 統合認証(v2.12.0) — 共有キー保管庫を使用する AUTH_MODE=api_key、pgwire の SCRAM-SHA-256 + 平文認証、Artefacts Composability Resolution(ACR、v2.14.0):これまでのクエリを指定すると、追加可能なディメンション/メジャー/メトリクス(CFL 候補を含む)を返す composables エンドポイント。ガイド付きクエリ構築を実現します |
| 予定 | OIDC / SSO 認証とトークンごとの認可スコープ、自動化と CI/CD 用 CLI、DDL ビュー生成(クエリから CREATE VIEW を生成)、追加の方言、追加の BI ツール統合、事前集計/マテリアライゼーションレイヤー |
商用プラン
OrionBelt Semantic Layer は Apache-2.0 への移行まで BUSL-1.1 に基づいてソースを利用可能にしています。無料配布版は、リリース済みの v2.6 の機能範囲を完全に網羅し、セルフホスト環境での本番利用に対応しています。本番サポート、マネージドランタイム、または組み込み分析のライセンス条件を希望するチーム向けに、RALFORION は以下を提供しています。
- 組み込み分析ライセンス — OBSL を商用製品に組み込んで提供するための再ライセンス条件
- 商用クラウドサービス — SLA 付きのマネージド OrionBelt ランタイム
- エンタープライズ機能 — エンタープライズ環境へのデプロイに合わせた機能
- コンサルティング + サポート — 導入、モデリング、本番サポート
詳細については RALFORION d.o.o. までお問い合わせください。
関連プロジェクト
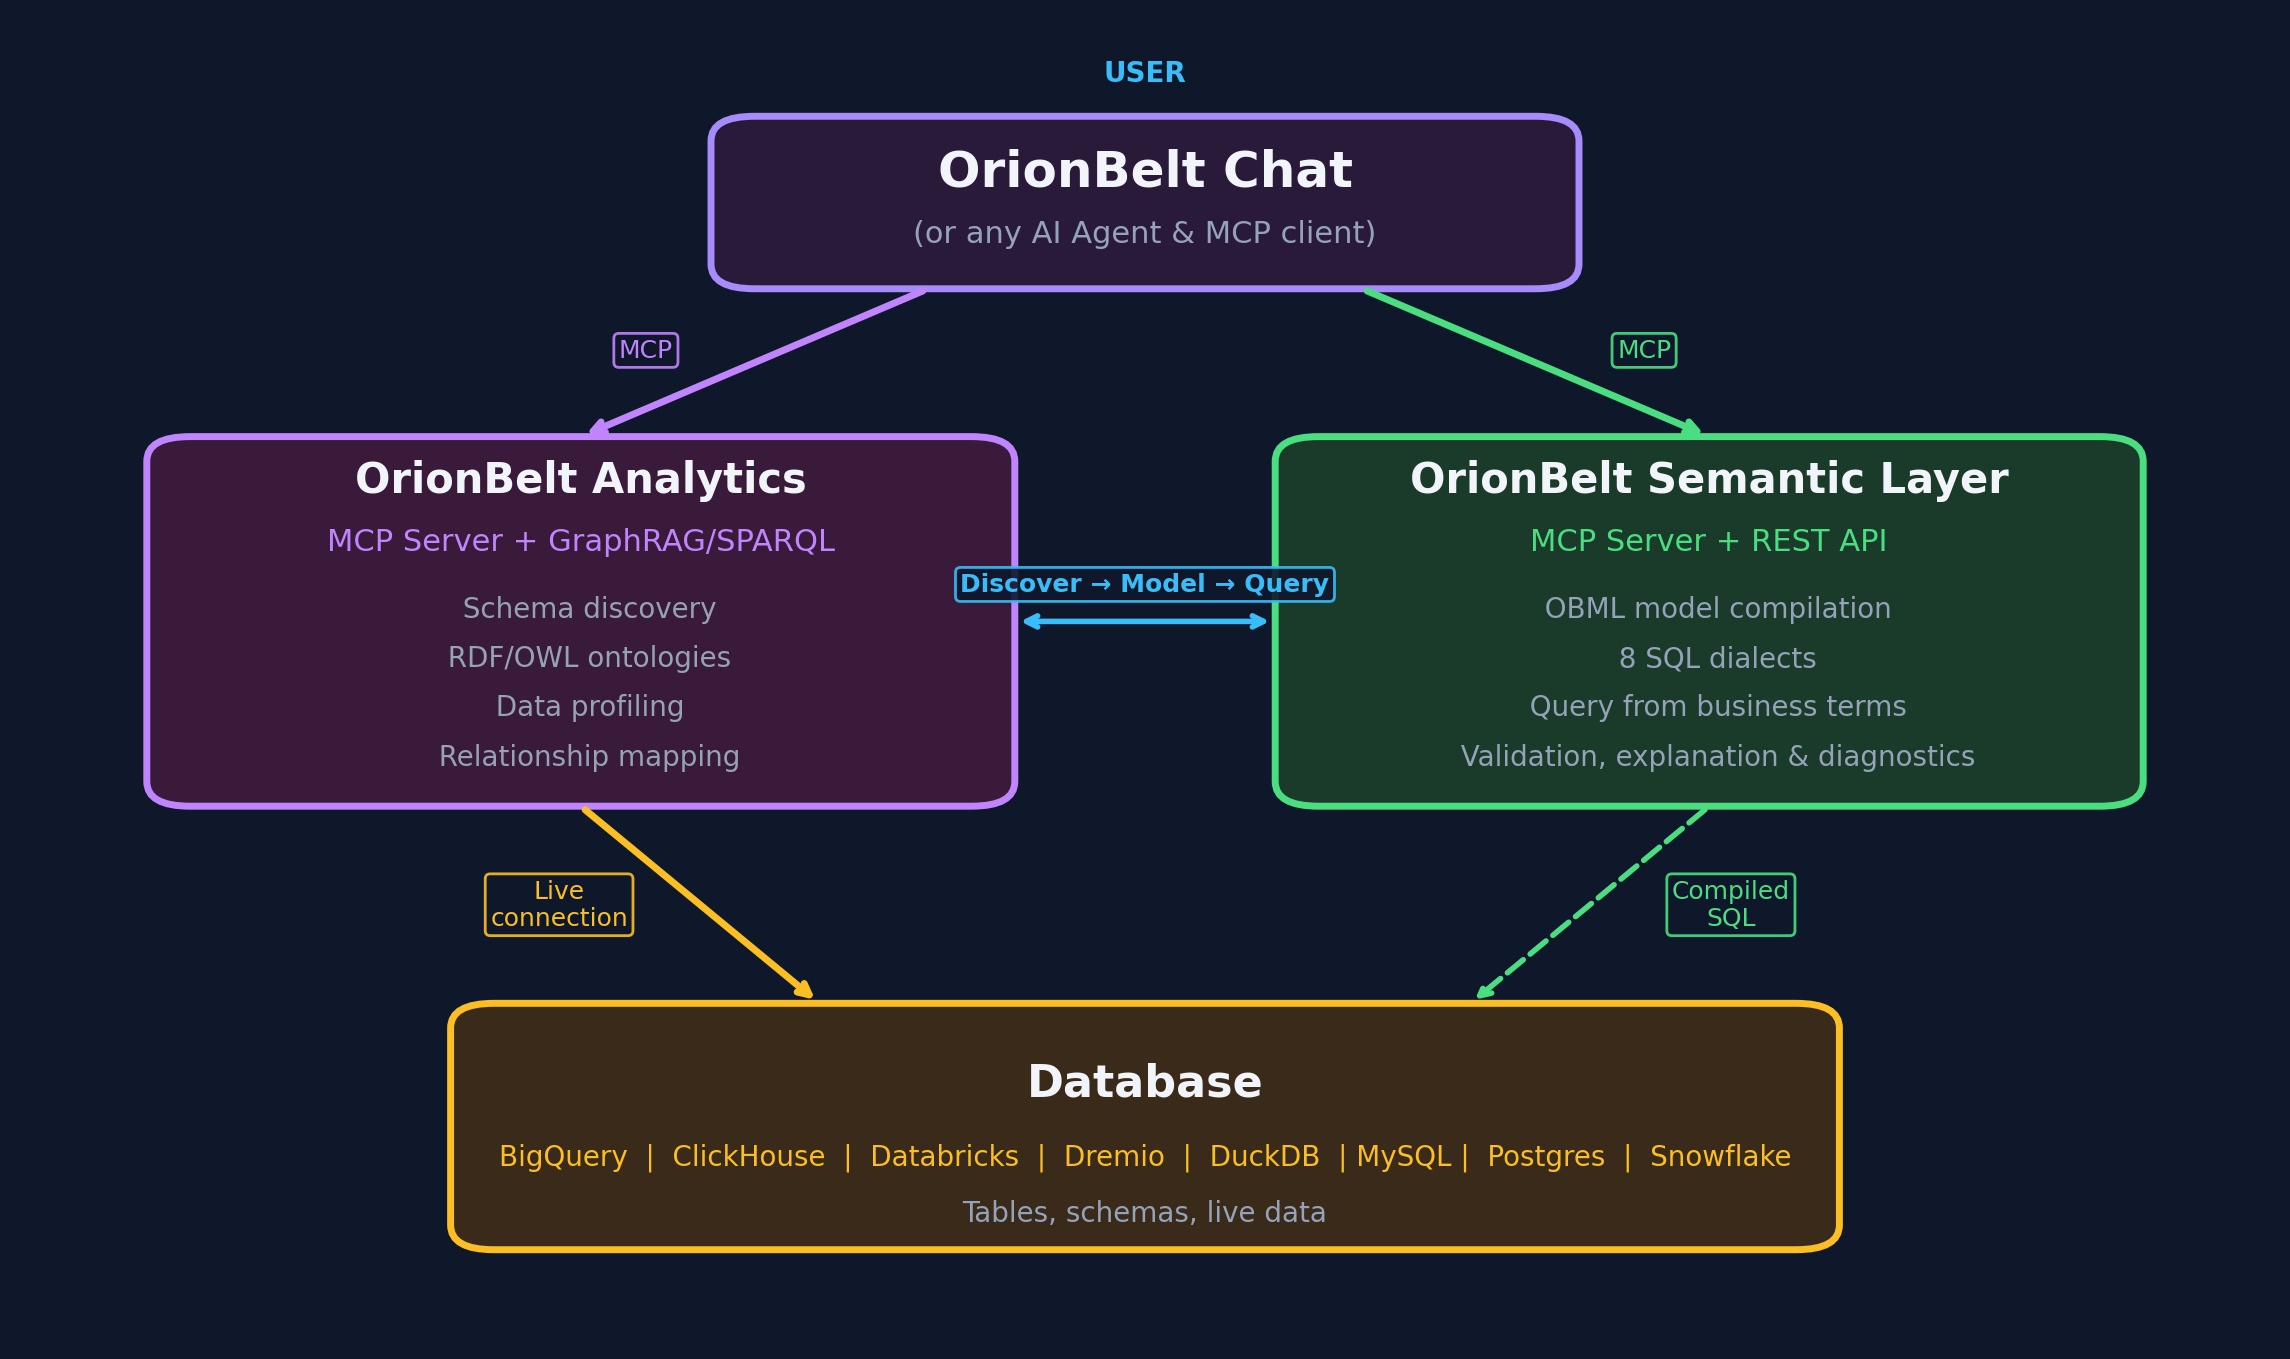
OrionBelt Analytics
リレーショナルデータベースのスキーマを分析し、RDF/OWL オントロジーを生成する、オントロジーベースの MCP サーバーです。OrionBelt Semantic Layer と組み合わせることで、AI アシスタントはオントロジーを通じてデータ環境を探索し、安全で方言を認識した分析用 SQL を生成できます。
開発
OrionBelt への貢献、またはソースからの実行:
git clone https://github.com/ralforion/orionbelt-semantic-layer.git
cd orionbelt-semantic-layer
uv sync                           # install all deps (dev, docs, ui, flight, drivers)
uv run orionbelt-api              # start API on :8000
# Quality
uv run pytest                     # run tests
uv run ruff check src/            # lint
uv run ruff format src/ tests/    # format
uv run mypy src/                  # type check

# Docs
uv sync --extra docs && uv run mkdocs serve  # docs on :8080

# CI workflows
./scripts/check-action-pins.sh              # verify every Action pin
./scripts/check-action-pins.sh --offline    # skip the upstream tag lookups
GitHub Actions のピン留め
.github/workflows 内のすべての uses: は、タグではなく40文字のコミット SHA にピン留めされています。これは、v7 のようなタグは可動ラベルであり、ジョブの開始時に所有者が指し示しているコミットが実行されるためです。各 SHA の横にある # vX.Y.Z コメントは、その SHA が切り出された正確なパッチリリースを示します。メジャータグはアップストリームの更新ごとに移動するため、パッチリリースである必要があります。
ピン留めによって実行されるコードは固定されますが、参照が読みづらくなるため、scripts/check-action-pins.sh が SHA とそのコメントの整合性を保ちます。このスクリプトはすべての uses: 行を調べ、コミット SHA、ALLOWED_OWNERS の許可リストに含まれる所有者、正確なパッチバージョンのコメントを必須とし、さらに git ls-remote でそのタグをアップストリームから解決して、タグが指すコミットとピン留めされたコミットが一致しない場合は失敗します。コンテナーアクションはダイジェストでピン留めする必要があります。ローカルの ./ アクションはスキップされます。--offline はネットワークに接続せず、SHA とコメントの形式のみをチェックします。
このチェックは CI の pins ジョブで実行されます。また、公開を行うワークフロー(Docker、PyPI、ドキュメント)では、チェックアウト後の最初のステップとして実行されるため、ピン留めが検証されていないステップでビルドされた成果物がタグからリリースされることはありません。ALLOWED_OWNERS への所有者の追加は、慎重に判断する必要があります。SHA が自身のタグと一致していても、そのアクションがこのリポジトリにふさわしいかどうかは分かりません。
ライセンス
Copyright © 2026 RALFORION d.o.o.
OrionBelt® は RALFORION d.o.o. の登録商標です。
Business Source License 1.1(SPDX:BUSL-1.1)の下でライセンスされています。ライセンス対象の著作物は、2030-03-16 に Apache License 2.0 に移行します。
OrionBelt が再配布するサードパーティの著作物とその利用条件は、THIRD_PARTY_NOTICES.md に記載されています。
このプロジェクトに貢献することで、Contributor License Agreement に同意したものとみなされます。
商用ライセンスに関するお問い合わせ先:[email protected]
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。