Graphiti Local について
Graphiti Localは、エージェントのメモリー向けのローカル優先の時間知識グラフで、CLIと読み取り専用のMCPアクセスを提供します。更新案は人が確認して承認するまで別キューに保留されます。
主な機能
- 016つの読み取り専用MCPツール
- 02時間知識グラフの検索
- 03人による確認付き更新キュー
- 04検索と取り込み用CLI
- 05Ollamaによるローカル推論
- 06LadybugDB、FalkorDB、Neo4jに対応
活用シーン
- 01エージェント向けにプロジェクトの決定事項を検索
- 02適用前に抽出した事実を確認
- 03Markdownやテキストをグラフに取り込み
- 04現在の事実や履歴を検索
MCP 対応
グラフ情報の検索に使う6つの読み取り専用ツールをMCPクライアントに公開します。書き込みはMCP経由ではなく、人が確認して承認する別のワークフローで行います。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
Graphiti Local
エージェントのためのローカルメモリです。エージェントが学習する内容は、人が承認します。
読み取り専用の6つのMCPツール、またはkg CLIを使って、プロジェクトの決定事項を取得できます。
提案された更新は、人が承認して適用するまで別のキューに保留されます。
ローカル推論にはOllamaを使い、グラフは組み込みのLadybugDBに保存します。ローカル環境のセットアップにDockerもクラウドAPIキーも必要ありません。
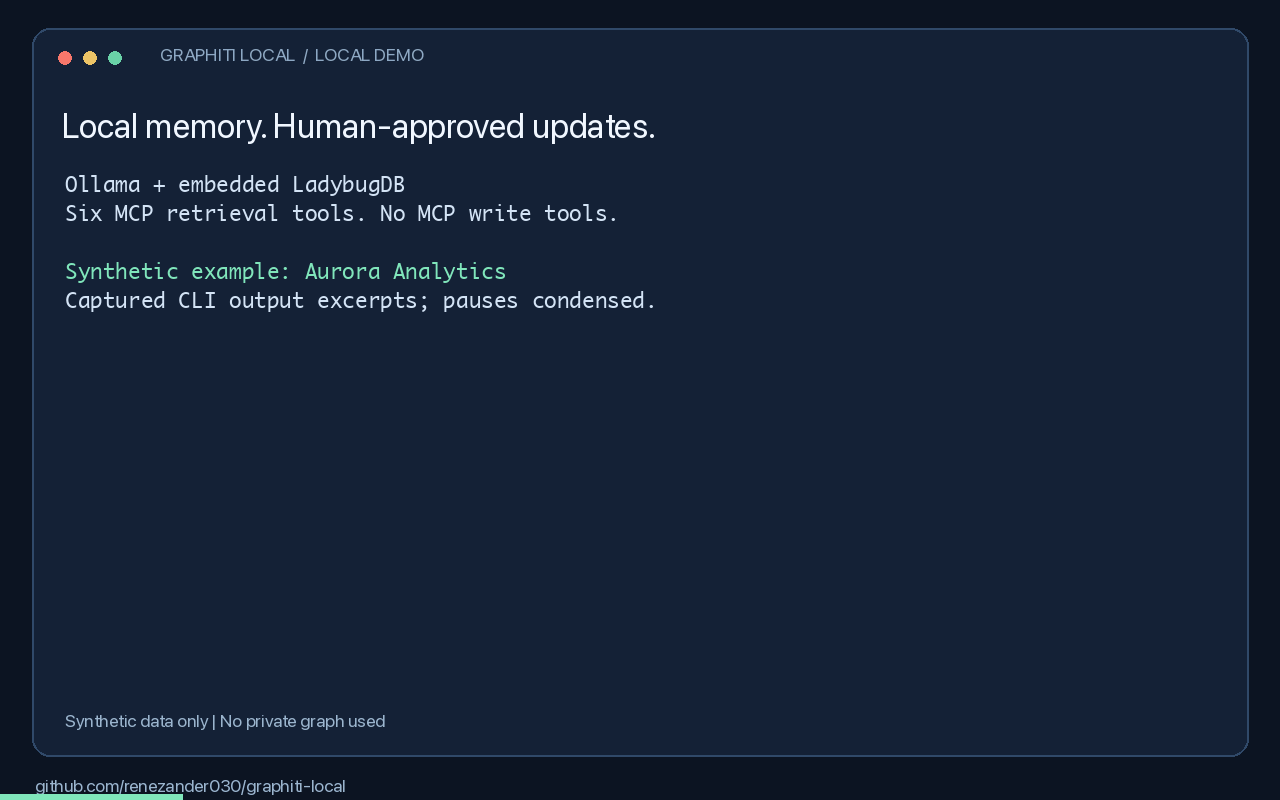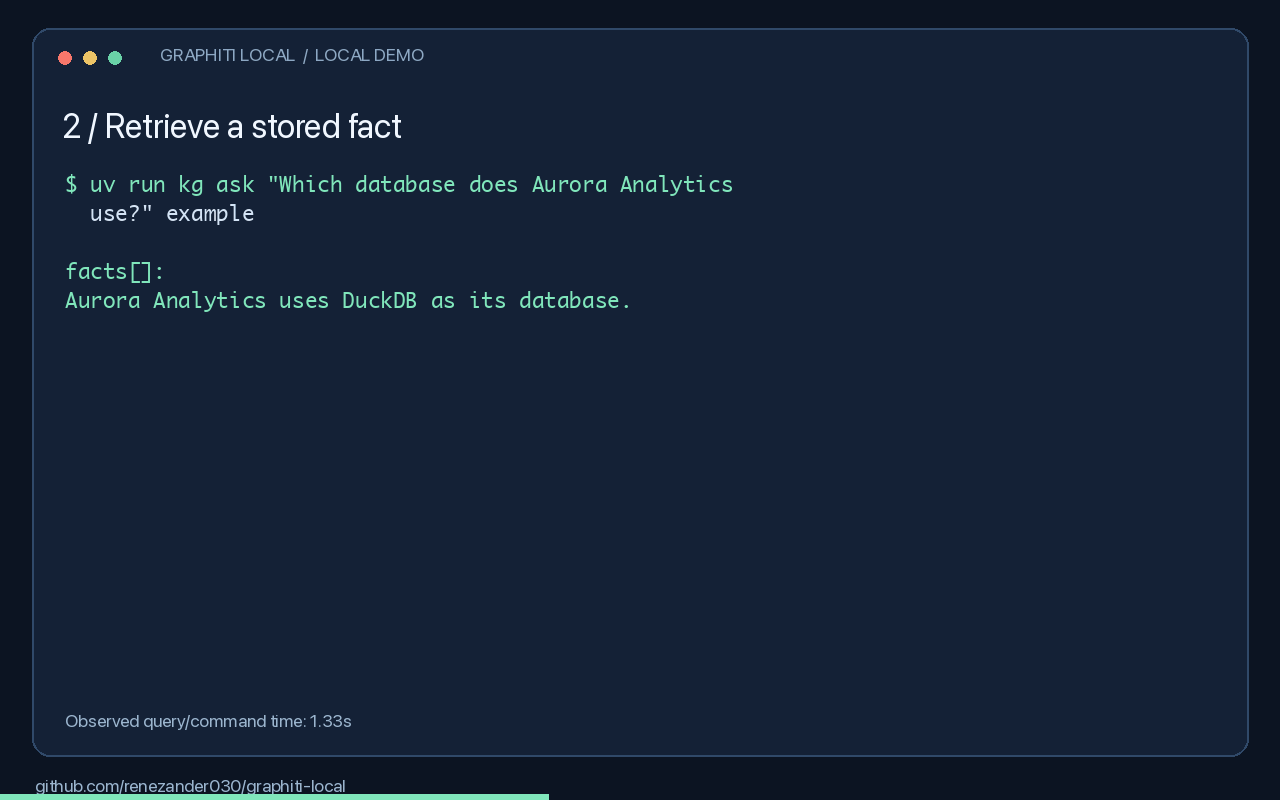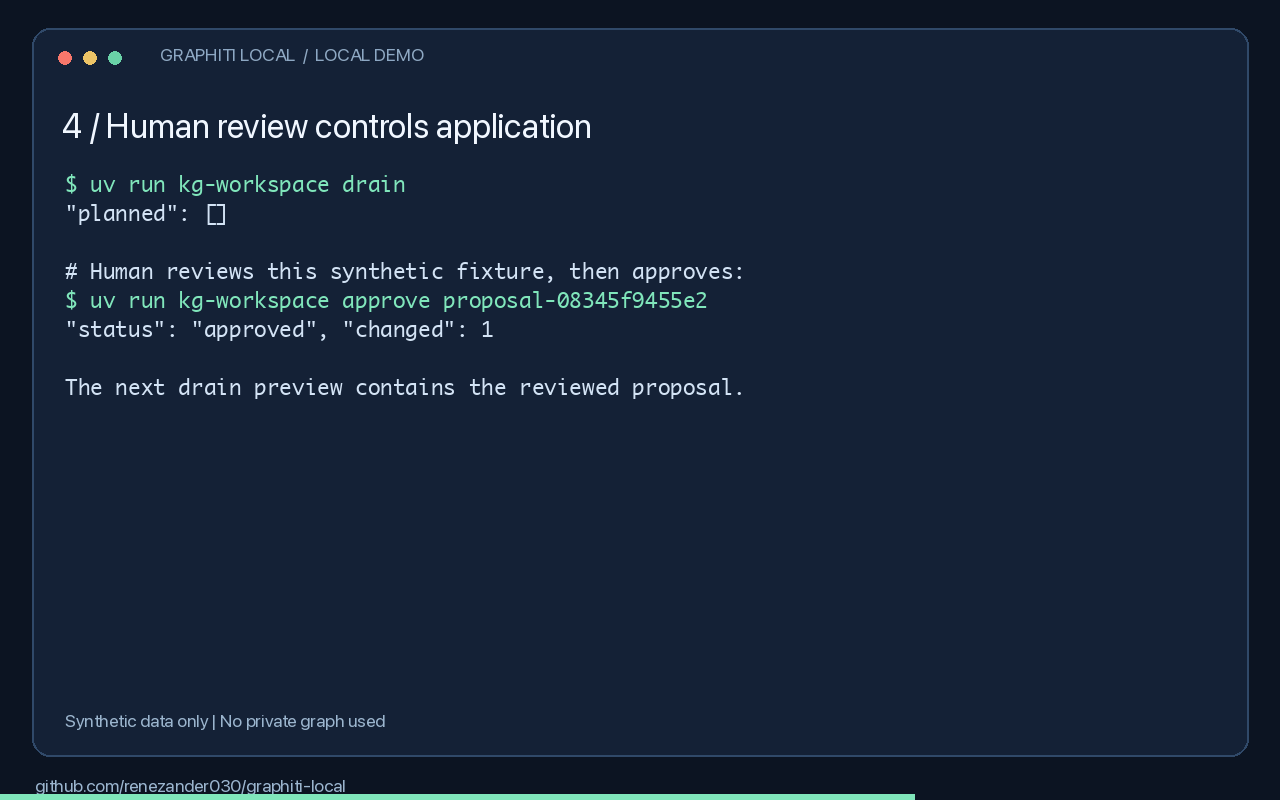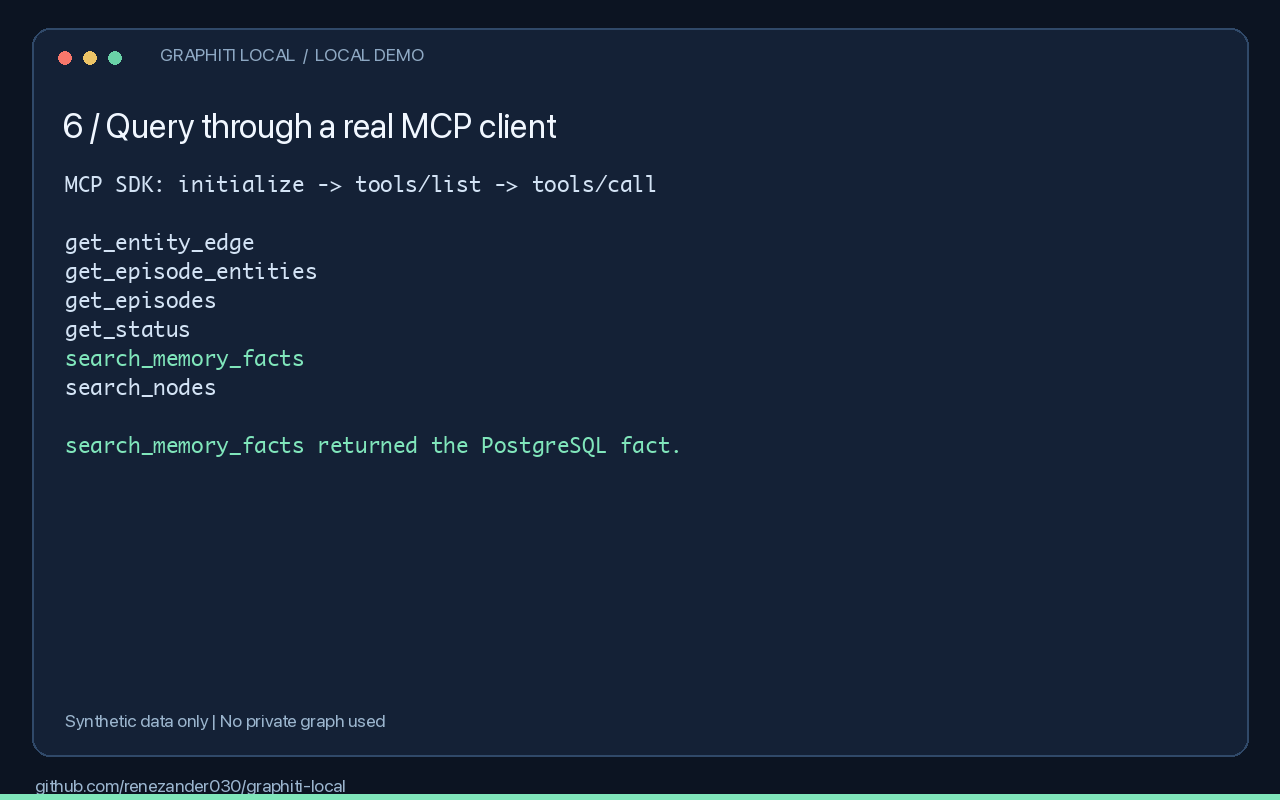
一時停止を短縮した出力例です。測定結果と制限事項。
1つのコマンドで試す
uvx --from git+https://github.com/renezander030/graphiti-local kg-demo
パッケージに同梱された小規模な合成グラフに対して質問に回答します。Ollamaも、モデルのダウンロードも、データベースのセットアップも不要です。キーワードだけで検索するため、モデルに接続することはありません。引数として質問を渡すと、独自の質問をできます。
これは読み取り専用のパスです。独自のテキストからグラフを構築するには、モデルが必要な情報抽出が必要です。詳しいセットアップ手順は以下をご覧ください。
ローカル環境で試す
uvと Ollamaをインストールし、Ollamaを起動します。セットアップのダウンロードにはインターネット接続が必要です。bashまたはzshで次のコマンドを実行します。
git clone https://github.com/renezander030/graphiti-local.git
cd graphiti-local
uv sync --frozen
ollama pull qwen2.5:7b
ollama pull nomic-embed-text
export GRAPHITI_LOCAL_CONFIG="$PWD/config/ollama.example.yaml"
export KG_WORKSPACE_DIR="$PWD/workspace/local-demo"
export KG_LADYBUG_PATH="$KG_WORKSPACE_DIR/graph.ladybug"
uv run --frozen kg-ladybug-setup --database "$KG_LADYBUG_PATH" --apply
uv run --frozen kg doctor
uv run --frozen kg-ingest examples/local_memory_demo.jsonl --apply
uv run --frozen kg ask "Which database does Aurora Analytics use?" example
合成サンプルはDuckDBを返します。完全なチュートリアルに沿って、PostgreSQLを提案し、その更新を確認して適用し、MCPクライアントから取得してみてください。モデルによる情報抽出は誤る可能性があるため、返された事実と有効期間のタイムスタンプを確認してください。
設定済みのグラフに触れる前に情報抽出の内容を確認するには、kg-ingest INPUT --review-output review.jsonlを実行してスナップショットを確認し、生成されたreview.jsonl.review.jsonlファイル内のすべての事実にaccept、refuse、またはcontestedのいずれかを指定します。表示される復元コマンドは、未解決の判断があると処理を拒否し、承認された事実のみを含むチェックサムで封印されたスナップショットを昇格させます。検索ではデフォルトで最新の事実を返します。過去の情報を明示的に表示するには、kg ask --historyを使います。
kg-ingestでは、Markdown/テキストファイルやディレクトリツリーも直接指定できます。大きなドキュメントは安定したテキスト境界で分割されます。一時的な書き込みエラーが発生した場合は、同じエピソードIDを使って再試行します。ワークスペース内のingest-receipts.jsonlとingest-failures.jsonlで、正常に書き込まれた内容と、対応が必要な内容を正確に確認できます。
Ladybugで複数ユーザーを利用する
各ユーザーにグループを割り当て、各グループ専用のLadybugファイルを用意します。
graph:
  groups: [alice, bob]
database:
  provider: ladybug
  ladybug:
    layout: per-group          # default: single, one file for every group
    directory: ./workspace/groups
server:
  transport: streamable-http
  auth:
    tokens:
      - {name: alice, token: "${ALICE_TOKEN}", groups: [alice]}
      - {name: bob, token: "${BOB_TOKEN}", groups: [bob]}
各ファイルには、そのグループのSHA-256を名前として付けるため、グループIDからディレクトリ外を参照することはできません。読み取り、kg ask、ドレインはいずれも、対象グループのファイルだけを開きます。aliceに付与されたトークンでBobのファイルを開くことはできません。読み取り時にはグループを1つ指定するか、トークンに設定された単一のグループが使われます。1つのデータベースサーバー内でテナントを分離するには、FalkorDBまたはNeo4jを使用してください。
用途に合っていますか?
人による明示的な確認を挟むローカルエージェントメモリに適しています。エージェントがMCP経由で書き込む必要がある場合や、ローカルセットアップなしでホスト型サービスを使いたい場合には適していません。FalkorDBとNeo4jにも対応しています。
このツールがワークフローに役立った場合は、リポジトリにスターを付け、セットアップ結果を共有してください。
René Zanderがメンテナンスしています。同氏は時間的知識グラフを用いたAIエージェント向けのコンテキストレイヤーを構築しています。
Graphitiを基盤とする独立したコミュニティプロジェクトです。Zepとは提携しておらず、Zepによる推奨も受けていません。Apache-2.0。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。