
ownvoice について
OwnVoiceは、pocket-tts用のLoRA音声アダプターを学習し、アダプターとメタデータをローカルに保存するPython CLIです。音声クリップで音声生成をファインチューニングしたい人向けで、学習前にCPUで互換性を確認できます。
主な機能
- 01CPUのみでのLoRA互換性チェック
- 02WAVクリップからのアダプター学習
- 03類似度に基づく利用可否判定
- 04アダプターとメタデータのローカル保存
- 05保存済みアダプターによる音声生成
活用シーン
- 01学習前のpocket-ttsのLoRA対応確認
- 02音声録音からのアダプター学習
- 03保存済み音声アダプターでの音声生成
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
OwnVoice
pocket-tts 用の LoRA 音声アダプターをトレーニングして、その成果を手元に残せます。API のサブスクリプションではなく、自分のディスク上のファイルとして保存できます。


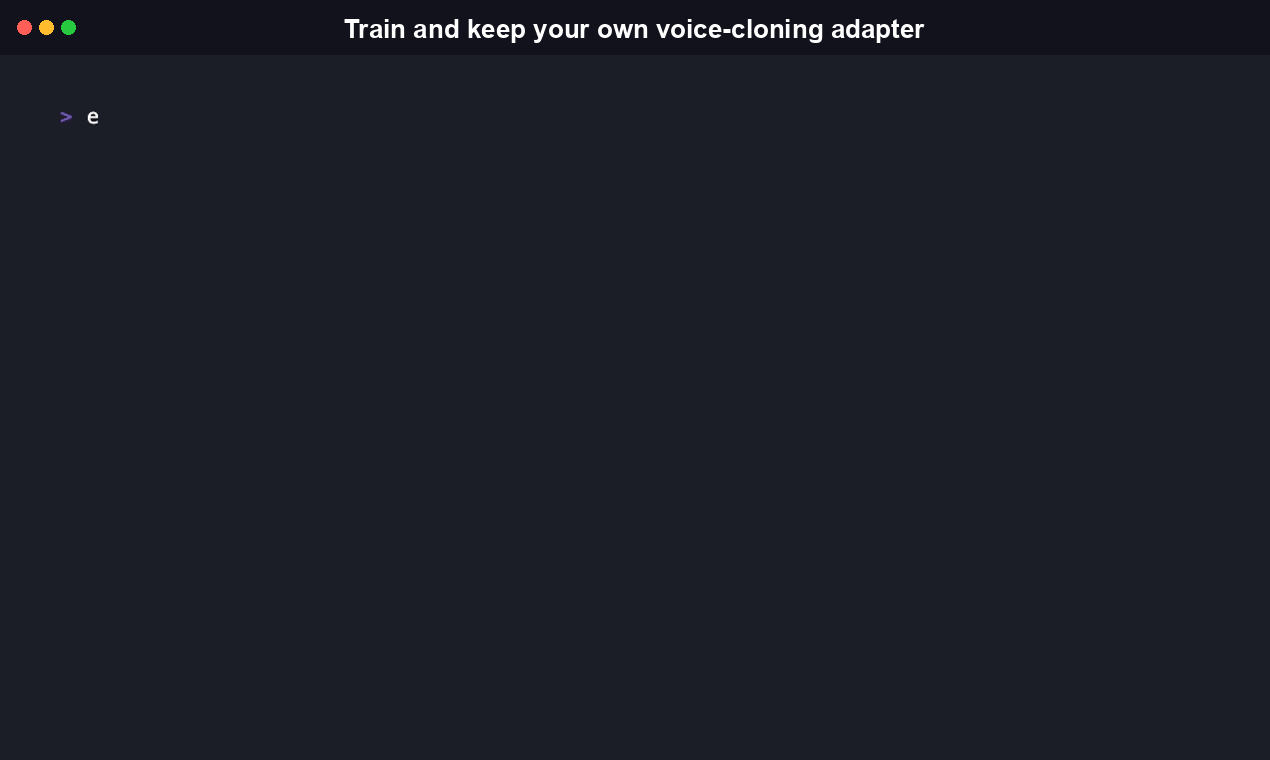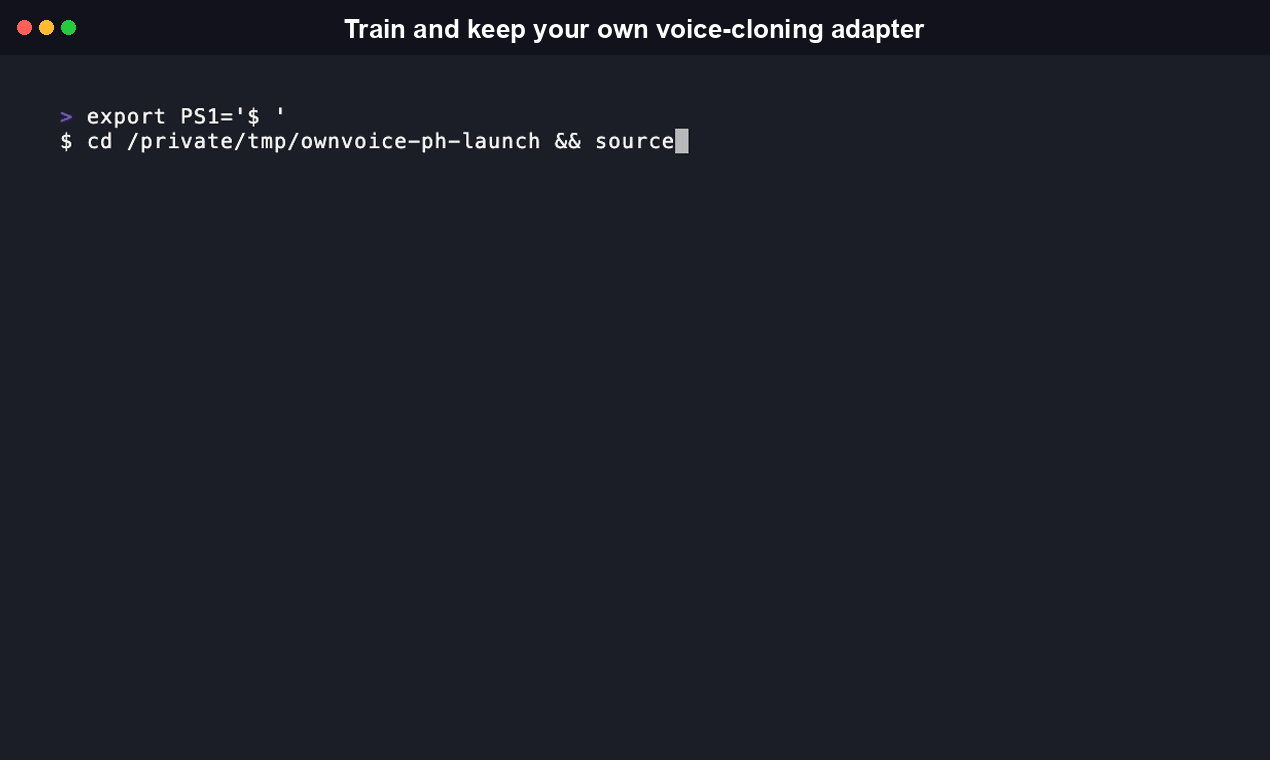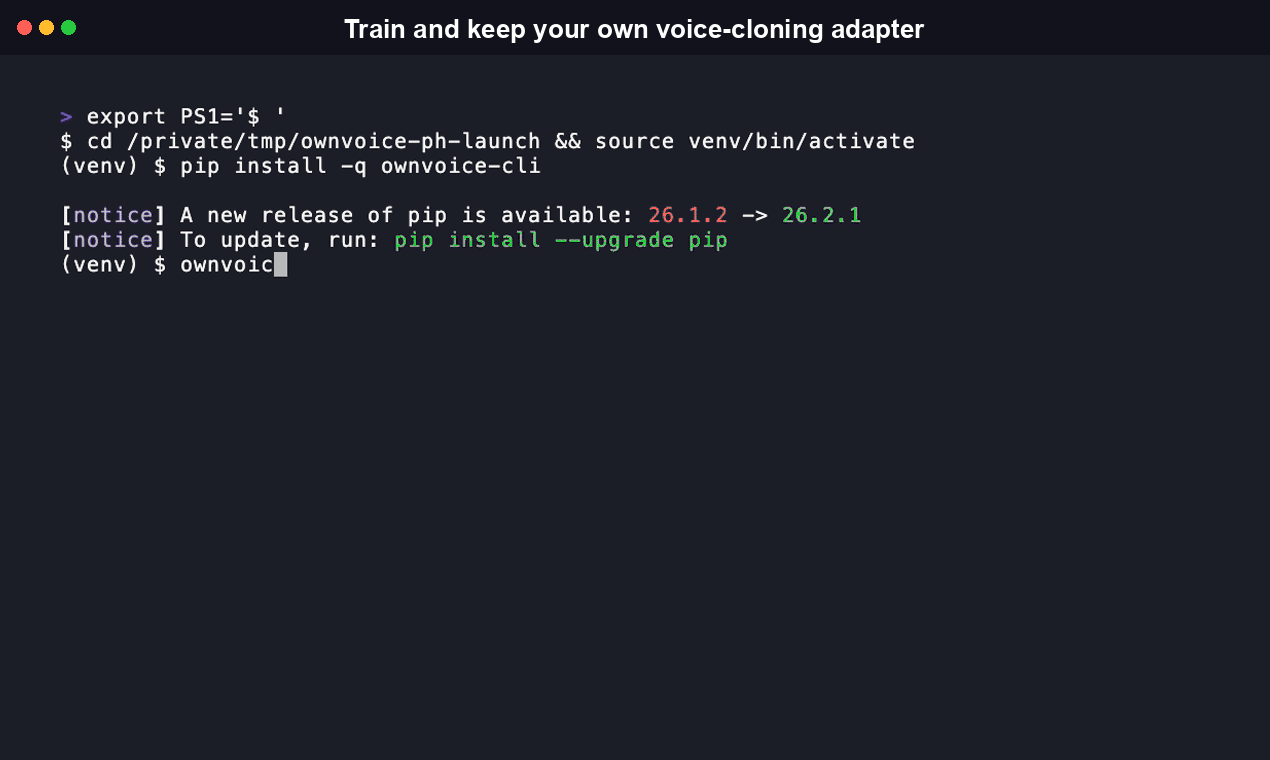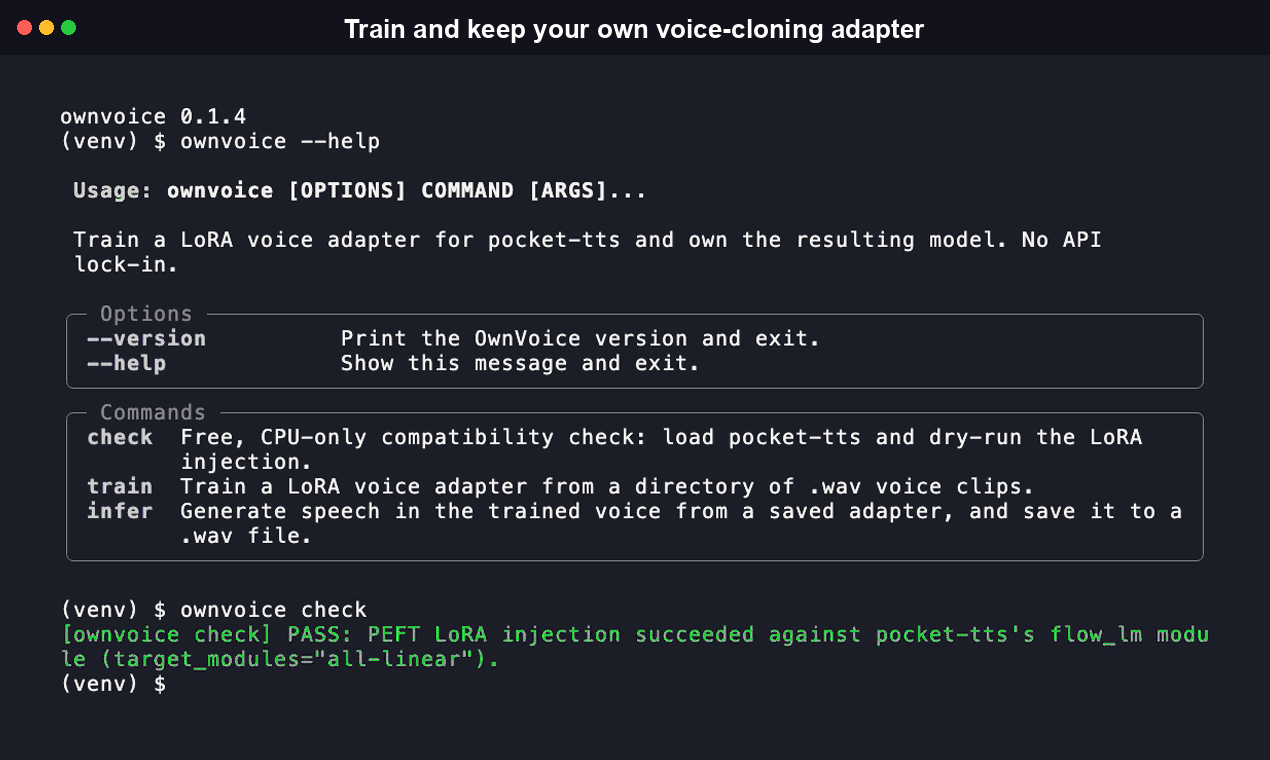
pip install ownvoice-cli
Python 3.11 以降が必要です。npx / agent-sandbox を利用する方法については、以下のインストールをご覧ください。
目次
- インストール
- クイックスタート
- CLI リファレンス
- 機能
- 仕組み
- 同等のツールとのセットアップ時間のベンチマーク
- OwnVoice が生まれた理由
- OwnVoice ではないもの
- 同意と悪用
- 実装状況
- よくある質問
- コントリビューション
- ライセンス
インストール
pip install ownvoice-cli
npx / エージェントネイティブ環境: OwnVoice は Python/PyTorch の CLI であるため、npm パッケージは薄いラッパーであり、Node による再実装ではありません。すでに PATH にある uv または pipx を使って本物の CLI を起動します。これは、Node ツールチェーンを標準とするコーディングエージェントのサンドボックスや CI ランナーで便利です。npm パッケージは PyPI 側に合わせて ownvoice-cli に改名されました(以前の単なる ownvoice は現在非推奨です)。
npx ownvoice-cli check
npm ラッパーと PyPI パッケージ(ownvoice-cli)はどちらも公開済みのため、上記のコマンドは現在そのまま使えます。
Torch と CUDA: ownvoice check は GPU をまったく必要とせず、pocket-tts 自体の CPU 対応設計に合わせて CPU で実行できます。実際のアダプターのトレーニングは、NVIDIA GPU があると大幅に速くなります。GPU がある場合は、まず pytorch.org/get-started/locally の手順に従って CUDA 版の PyTorch をインストールし、その上に OwnVoice をインストールしてください。そうすれば、pip が誤って CPU 専用のホイールを取得することを防げます。Apple Silicon または CPU のみのマシンでは、標準の pip install による torch のインストールで問題ありません。ownvoice check と ownvoice infer は通常どおり動作し、ownvoice train はエポックごとの処理に時間がかかるだけです。
クイックスタート
1. ownvoice check、無料の初日検証
録音したり GPU を借りたりする前に、PEFT の LoRA 注入が pocket-tts の実際のモデル構造で動作することを確認します。完全無料で、CPU のみを使い、トレーニングも GPU も必要ありません。
$ ownvoice check
[ownvoice check] PASS: PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules="all-linear").
失敗した場合、OwnVoice は生のスタックトレースではなく、モデルの実際のモジュールツリーを表示します。そのため、何が一致しなかったのかを正確に確認して報告できます。
$ ownvoice check
[ownvoice check] FAIL: PEFT LoRA injection failed against pocket-tts's flow_lm module structure: <error detail>. Please post an honest blocker (this error plus the module tree above) as a comment on https://github.com/kyutai-labs/pocket-tts/issues/30 rather than working around it silently, that issue is exactly where this gap needs to be visible.

Module tree (for debugging / for the issue #30 blocker post):
<root>: FlowLMModel
input_linear: Linear
transformer: StreamingTransformer
transformer.layers.0.self_attn.in_proj: Linear
transformer.layers.0.self_attn.out_proj: Linear
...
2. ownvoice train
トレーニングしたい音声を、きれいな音質で5~10分録音します(自分の声を使い、自分の同意を得てください。詳しくは同意と悪用をご覧ください)。録音をいくつかの .wav クリップに分割して1つのディレクトリにまとめ、OwnVoice に指定します。
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] USABLE ADAPTER
Usable adapter (similarity 0.812 >= 0.75). Try it now:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
必須なのは --voice-clips だけです。ほかのフラグにはすべて適切な既定値があります(以下のCLI リファレンスをご覧ください)。
実行が完了しても類似度の基準を満たさなかった場合、終了コードは 0 のままです。クラッシュではなく、次に取るべき具体的な手順が示されたラベル付きの結果です。
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] BELOW THRESHOLD
Below threshold (similarity 0.612 < 0.75). The adapter was still saved, try more/cleaner voice clips, more epochs, or a higher --lora-rank, then re-run. You can still listen to it:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
終了コードが0以外になるのは、データ読み込みの問題(使用可能なクリップがない場合)か、捕捉された PEFT 注入の失敗だけです。実行が完了すると必ず adapter.safetensors と metadata.json(トレーニング設定、類似度スコア、タイムスタンプ)が出力ディレクトリに書き込まれます。どちらも手元に保管できるファイルで、再び使う際にサーバーとの通信は必要ありません。
3. ownvoice infer
$ ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "Hello, this is my own voice."
[ownvoice infer] Wrote ownvoice-output.wav
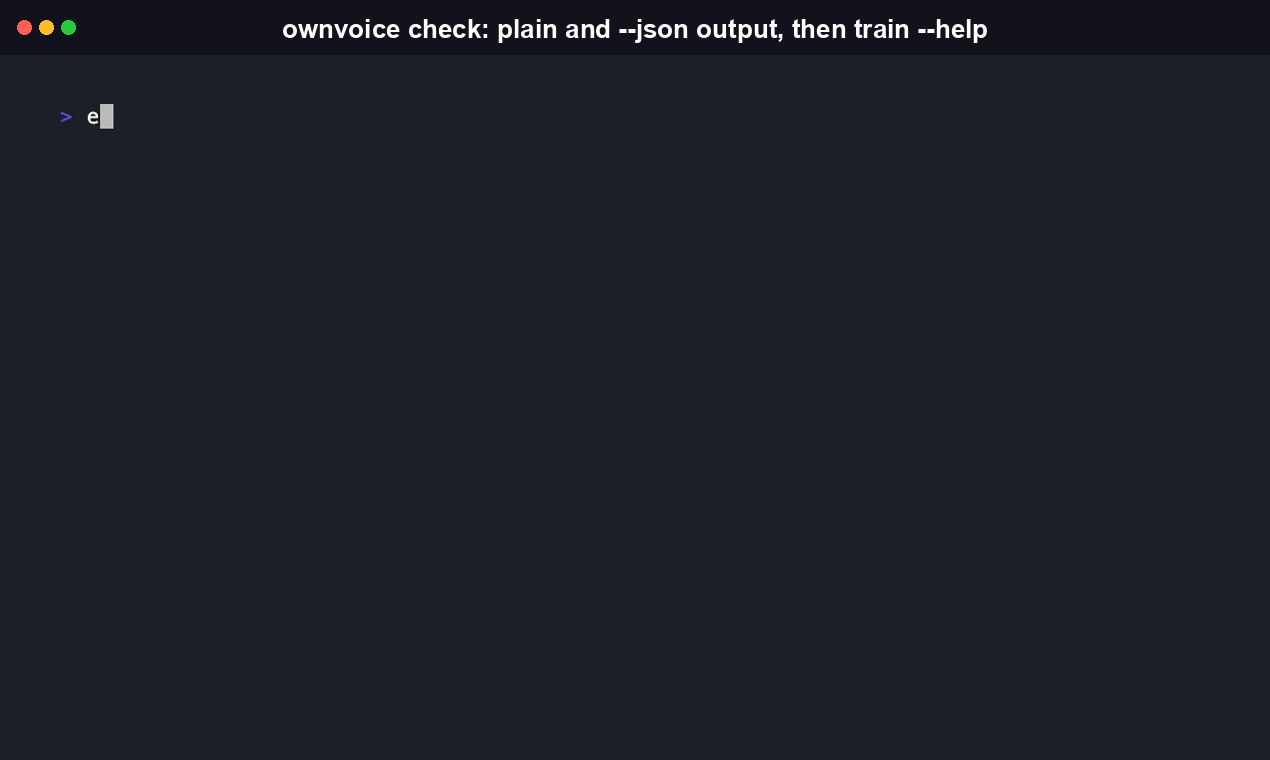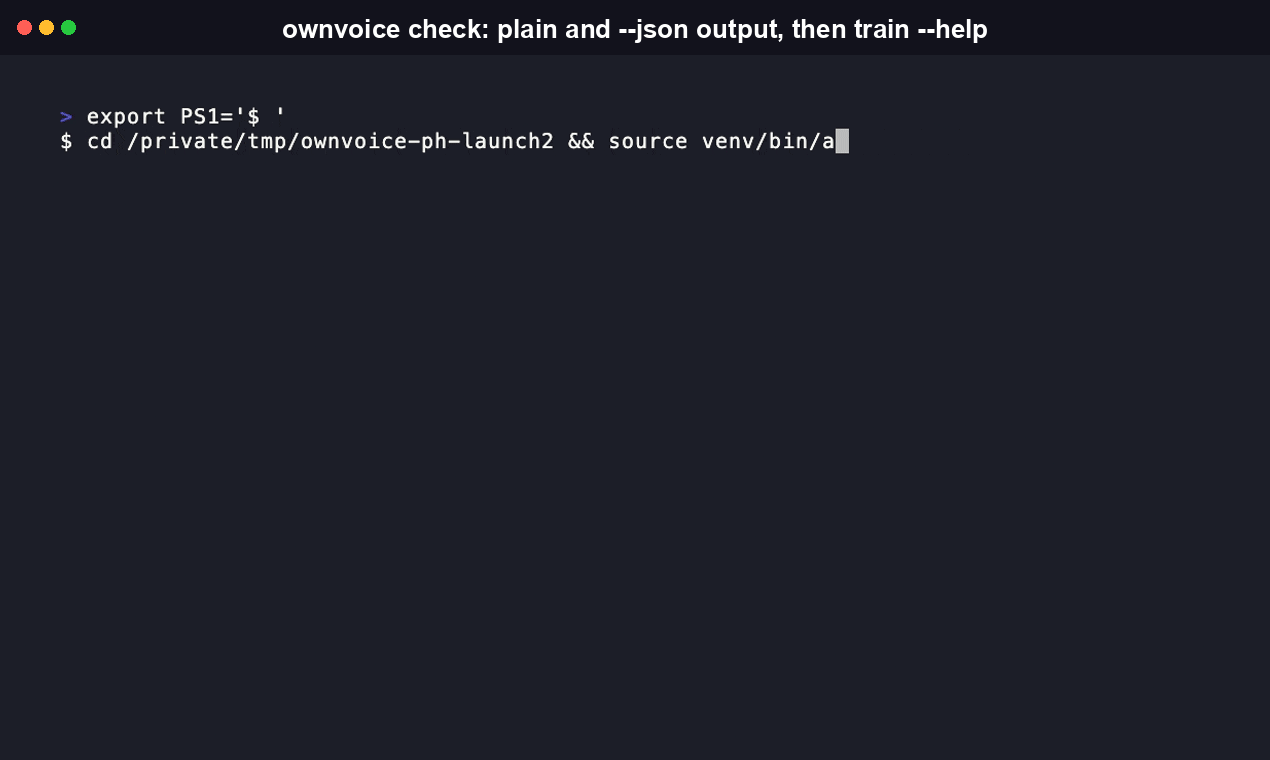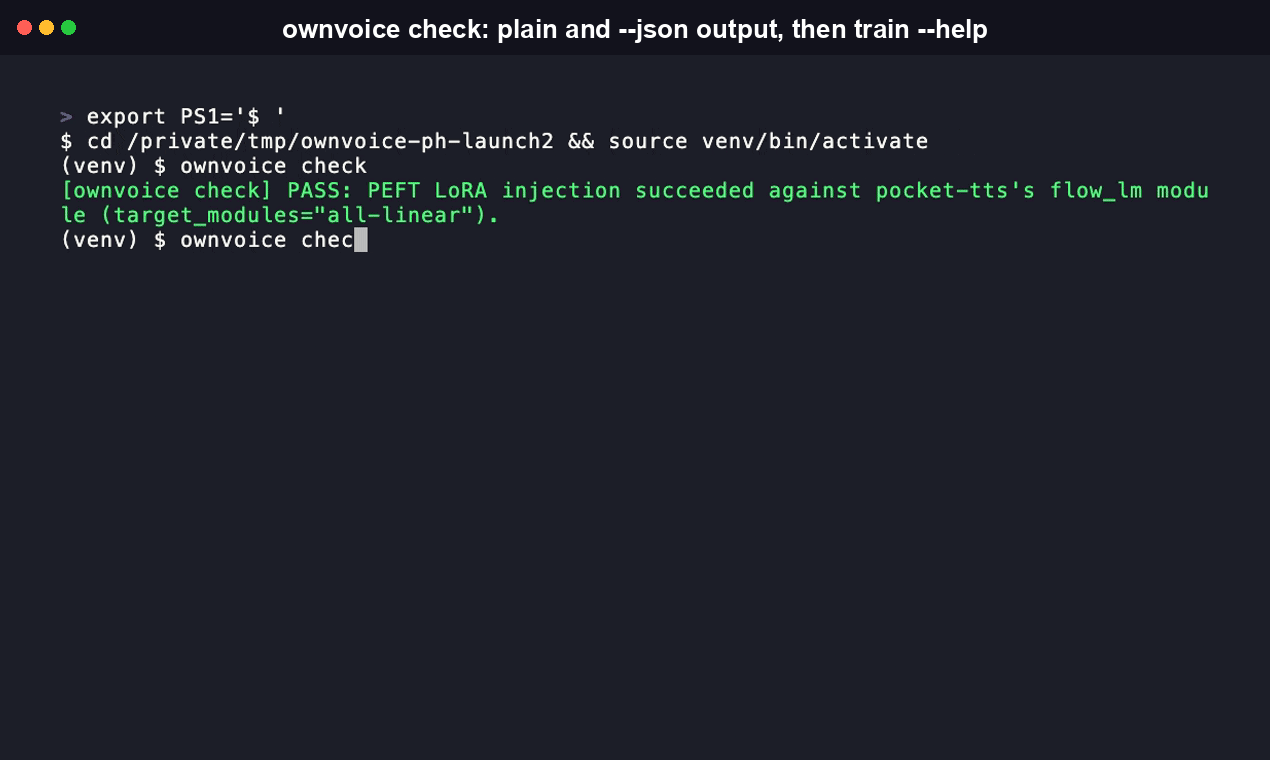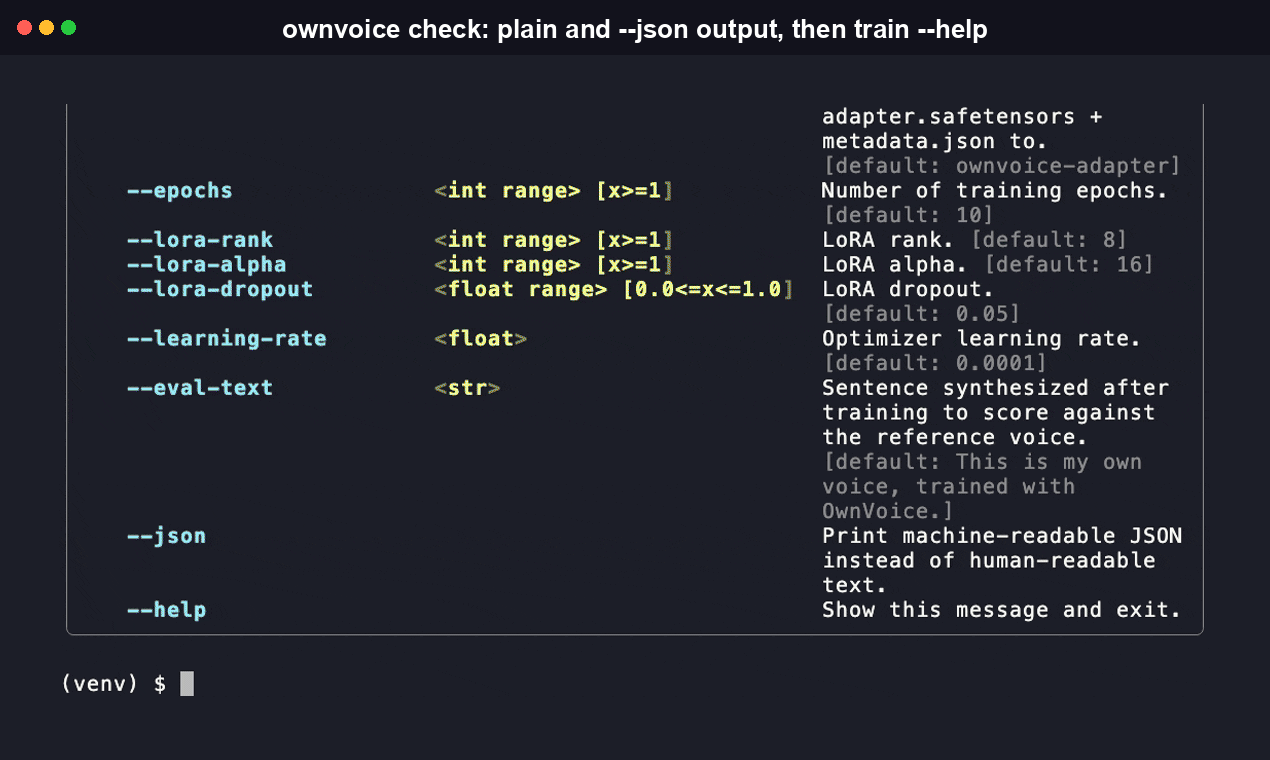
各サブコマンドでは、構造化された機械解析可能な出力モードを利用できる --json もサポートしています。人がターミナルを読む代わりに、スクリプトやエージェントからプログラムで ownvoice を呼び出す場合に便利です。
$ ownvoice check --json
{"success": true, "message": "PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules=\"all-linear\").", "module_tree": null}
CLI リファレンス
以下のリファレンスは、各サブコマンドの実際の --help 出力(PyPI の ownvoice-cli 0.1.2)から抜粋しています。
グローバル
ownvoice [OPTIONS] COMMAND [ARGS]...
| フラグ | 説明 |
|---|---|
--version | OwnVoice のバージョンを表示して終了します。 |
--help | ヘルプメッセージを表示して終了します。 |
ownvoice check
無料の CPU のみを使用する互換性チェックです。pocket-tts を読み込み、LoRA の注入をドライランします。GPU もトレーニングも必要ありません。
| フラグ | 説明 |
|---|---|
--json | 人が読みやすいテキストの代わりに、機械可読な JSON を出力します。 |
--help | ヘルプメッセージを表示して終了します。 |
ownvoice train
.wav 音声クリップのディレクトリから LoRA 音声アダプターをトレーニングします。必須なのは --voice-clips のみです。
| フラグ | 型 | デフォルト | 説明 |
|---|---|---|---|
--voice-clips | ディレクトリ、必須 | – | トレーニングに使用する .wav 音声クリップの録音が入ったディレクトリです。 |
--out | パス | ownvoice-adapter | adapter.safetensors と metadata.json の書き込み先ディレクトリです。 |
--epochs | 整数、>=1 | 10 | トレーニングのエポック数です。 |
--lora-rank | 整数、>=1 | 8 | LoRA のランクです。 |
--lora-alpha | 整数、>=1 | 16 | LoRA のアルファ値です。 |
--lora-dropout | 浮動小数点数、0.0–1.0 | 0.05 | LoRA のドロップアウト率です。 |
--learning-rate | 浮動小数点数 | 0.0001 | オプティマイザーの学習率です。 |
--eval-text | 文字列 | "This is my own voice, trained with OwnVoice." | トレーニング後に合成し、参照音声と比較して評価する文です。 |
--json | フラグ | オフ | 人が読みやすいテキストの代わりに、機械可読な JSON を出力します。 |
--help | フラグ | – | ヘルプメッセージを表示して終了します。 |
ownvoice infer
保存済みアダプターを使ってトレーニング済みの声で音声を生成し、.wav ファイルに保存します。
| フラグ | 型 | デフォルト | 説明 |
|---|---|---|---|
--adapter | パス、必須 | – | トレーニング済みの adapter.safetensors ファイルへのパスです。 |
--text | 文字列、必須 | – | トレーニング済みの声で合成するテキストです。 |
--out | パス | ownvoice-output.wav | 出力する .wav ファイルのパスです。 |
--reference-audio | パス | 録音済みの参照音声 | トレーニング時に OwnVoice が metadata.json に記録した参照クリップを上書きします。 |
--json | フラグ | オフ | 人が読みやすいテキストの代わりに、機械可読な JSON を出力します。 |
--help | フラグ | – | ヘルプメッセージを表示して終了します。 |
特長
- GPU に費用をかける前に、無料で互換性を確認できます。
ownvoice checkは pocket-tts を読み込み、CPU のみで学習を行わずに、実際のflow_lmモジュールツリーに対する PEFT の LoRA 注入をドライランします。失敗した場合はスタックトレースではなく実際のモジュールツリーを出力するため、問題があれば見逃されず、報告できます。 - 推測ではなく、利用可能かどうかを客観的に判定できます。 学習を実行するたびに、生成されたテスト発話を 16kHz モノラルにリサンプリングし、Resemblyzer のコサイン類似度で参照クリップと比較します。
0.75以上ならUSABLE ADAPTER、それ未満ならBELOW THRESHOLDと表示されます。これはクラッシュではなく、明確にラベル付けされた判定結果であり、どちらの場合も終了コードは0です。 - すべてのサブコマンドで構造化出力を利用できます。
check、train、inferはすべて--jsonを受け付け、色付きのターミナルテキストの代わりに、機械で解析可能なオブジェクトを 1 つ返します。実際に確認したところ、ownvoice check --jsonは{"success": true, "message": "...", "module_tree": null}を返します。 - 保存するファイルは 2 つだけで、サーバーとの往復もありません。 学習が完了すると、
adapter.safetensors(学習済みの重み。デフォルトの--lora-rank 8では数 MB)とmetadata.json(学習設定一式、類似度スコア、エポックごとの損失、タイムスタンプ)がディスクに保存されます。後からいつでもownvoice inferで読み込め、ネットワーク呼び出しは不要です。 - 意図的に、ベースモデルは 1 つだけです。 OwnVoice がラップするのは pocket-tts のみです。コードベースの「単一ターゲットを前提とした設計」という方針に沿って、2 つ目のベースモデル用の抽象化レイヤーはありません。これにより、LoRA 注入経路(pocket-tts の実際の
flow_lmレイヤーに対するtarget_modules="all-linear")を汎用化せず、正確に保っています。
仕組み
voice clips (wav)
      |
      v
  data.py   --validate format/duration-->  clean clip set
      |
      v
  train.py  --PEFT LoRA (target_modules="all-linear")--> adapter.safetensors + metadata.json
      |
      v
  infer.py  --generate test utterance--> synthesized audio
      |
      v
  score.py  --resample to 16kHz mono--> Resemblyzer cosine similarity
      |
      v
  CLI report (>= 0.75 = usable adapter, below triggers a labeled next-step message)
ownvoice/data.py は音声クリップのディレクトリを読み込み、検証します。ownvoice/train.py は pocket-tts の凍結されたベースモデルを読み込み、PEFT(target_modules="all-linear")を使ってその flow_lm トランスフォーマーに LoRA アダプターを注入し、学習ループを実行して、アダプターとマニフェストを保存します。ownvoice/infer.py は保存済みのアダプターをベースモデルに読み込み直し、音声を生成します。ownvoice/score.py は torchaudio.transforms.Resample で音声を 16kHz モノラルにリサンプリングし、Resemblyzer で話者の類似度をスコアリングします。
OwnVoice は意図的に単一モデル専用です。対象範囲に 2 つ目のベースモデルが含まれないため、抽象化レイヤーは設けず、pocket-tts のみをラップします。
セットアップ時間のベンチマークと類似ツールとの比較
| ツール | 最初に動作するセットアップまでの時間 | 特筆すべき設計上の選択 | ソース |
|---|---|---|---|
| kokoro-tts | 2 分未満 | pip install git+... でインストールし、すぐに CLI で音声を合成。ファインチューニングには非対応 | kokoro-tts README |
| Unsloth | 学習開始まで 1 分未満 | 1 コマンドで学習を開始(uv pip install) | Unsloth ドキュメント |
| pocket-tts | 数秒 | --voice <wav> によるゼロショットのクローン作成。学習機能はなし | pocket-tts README |
| OwnVoice | 動作確認済みの学習環境まで 2 分未満 | ownvoice check:GPU に費用をかける前に、無料・即時・CPU のみで PEFT との互換性を検証 | このリポジトリ |
OwnVoice の学習には、実際に GPU 時間がかかります。これは正直に表示され、偽のプログレスバーで隠されることはありません。Unsloth と同じく、業界で一般的な方式です。OwnVoice が 2 分未満に短縮するのは、その前のすべて、つまりお使いの環境が実際に動作することの確認です。
OwnVoice が存在する理由
pocket-tts は、Kyutai が提供する、MIT ライセンスで公開された、CPU で動作する優れたローカルテキスト読み上げモデルです。開発元のメンテナーは、ファインチューニング用のコードを近いうちに公開する予定はないと明言しています。issue #30 では、メンテナーの @vvolhejn が「TTS モデルと STT モデルのファインチューニング用コードを近い将来に公開する予定はありません」と書いており、このスレッドには、まさにこれを求める18人のリアクションが寄せられています。OwnVoice は、この特定の不足を補う小規模なスタンドアロン CLI です。自分の音声録音をいくつか指定すると、手元に保存して自分で実行できる LoRA アダプターを学習します。
ホスト型サービスではなく、課金も使用状況の追跡もありません。学習スクリプト、推論スクリプト、スコアリングスクリプトを、3つの CLI コマンドから実行できるようにまとめたものです。
OwnVoice が提供しないもの
pocket-tts には、ゼロショット音声クローニングがすでに標準搭載されています。.wav ファイルを --voice に渡す(または Python から get_state_for_audio_prompt() を呼び出す)だけで、学習ステップなしにその声を複製できます。それだけで十分な場合は、よりシンプルで高速な pocket-tts を直接お使いください。
OwnVoice が対象とするのは、より限定的なケースです。音声を学習済みの重みに恒久的に組み込み、実行時に参照音声クリップを配布したり再処理したりする必要がないようにします。また、独立した大規模ベンチマークはまだ行われていませんが、学習目的に基づくと、単一クリップのゼロショット埋め込みよりも、多数の生成で一貫性の高い出力が期待できます。これは、issue #30 で18人が求めていた具体的な不足であり、pocket-tts がすでに得意としていることに対して OwnVoice が追加するのはこの点だけです。
同意と悪用
このツールは、使用する権利のある音声から声を複製します。明示的な同意なく、他人や公人の声を複製しないでください。このバージョンの OwnVoice には、一括生成や自動スケーリングの機能はありません。これにより、個々の悪用事例が及ぼす影響を小さく抑えています。
実装状況
これは公開されたばかりの初期段階のリリースです。ownvoice check、CLI 引数の解析、音声クリップの検証、類似度スコアの計算ロジック、アダプター/マニフェストの保存と読み込み処理は実装済みで、テストスイート(pytest)でカバーされています。LoRA の注入は、pocket-tts の実際のソースコードを基に構造的に検証した後、実際にも確認しました。CPU 上で pocket-tts の実際にダウンロードした重みに対して ownvoice check を実行し、PEFT の target_modules="all-linear" による注入が正しく成功しました。その後、学習から生成までの一連の処理も、実際にエンドツーエンドで検証しました。読み込み済みの pocket-tts の重みに対する実際の 2 エポックの LoRA 学習で、有限かつ NaN ではないフローマッチング損失が得られ、生成されたアダプターを使って ownvoice infer から、無音ではない実際の .wav ファイルを生成できました。この検証により、単純なアプローチにあった実際の問題が 2 つ明らかになり、修正しました。(1)pocket-tts が公開している推論専用の PyPI パッケージでは、独自のドキュメントで可能と説明されているにもかかわらず、FlowLMModel.forward() を通じて学習損失を計算する方法が実際には公開されていません。そのため、OwnVoice は flow_lm の実際のサブモジュールからフローマッチング損失を直接計算します。(2)generate_audio() の呼び出し前に base_model.flow_lm を PEFT でラップされたモデルに差し替えると、pocket-tts 内部の KV キャッシュ状態の検索が機能しなくなります。差し替えはまったく必要ありません。PEFT の LoRA 注入によって、すでに base_model.flow_lm がインプレースで変更されているためです。知っておくべき外部要因による制限が 1 つあります。一般公開されている pocket-tts の重み(kyutai/pocket-tts-without-voice-cloning)は、生の参照クリップのパスや URL を受け付けません。OwnVoice はクリップを事前に読み込み、リサンプリングすることで回避していますが、このチェックポイントでの音声クローニングの忠実度は、OwnVoice のバグではなく、ベースモデルの既知の制限です。kyutai の最高品質のクローニング用重みについては、huggingface.co/kyutai/pocket-tts でアクセスをリクエストしてください。さらに信頼する前に、ご自身で ownvoice check を実行し、ソースコードを読んでください。このプロジェクトがまだこれほど初期段階にあることを踏まえると、それが適切な懐疑心です。
よくある質問
OwnVoice とは何ですか? pocket-tts だけを使うのではだめですか?
OwnVoice は pocket-tts 用の LoRA アダプターを学習し、adapter.safetensors と metadata.json としてお使いのディスクに保存します。pocket-tts のメンテナー自身が、ファインチューニング用コードは当面のロードマップに含まれていないと述べているため、OwnVoice が開発されました(issue #30 を参照)。アダプターを学習した後は、それを使うために OwnVoice を再び使う必要はありません。ownvoice infer がアダプターをベースモデルに読み込むだけです。
pocket-tts に組み込まれている --voice <wav> によるゼロショットの音声クローンとはどう違いますか?
pocket-tts には、学習なしで単一の参照音声から声をクローンする機能がすでにあります。CLI では --voice <wav>、Python では get_state_for_audio_prompt() を使います。OwnVoice はその手軽さと引き換えに、恒久的に使える学習済みアダプターを作成します。これにより、実行時に参照音声を持ち歩かなくても音声を生成できます。また、(トレーニング目標に基づくもので、大規模な独立ベンチマークはまだ行われていませんが)単一音声クリップからのゼロショット埋め込みよりも、生成を繰り返したときの出力が安定します。用途にゼロショットで十分であれば、よりシンプルで高速な pocket-tts を直接お使いください。
インストールに必要なものは何ですか? Apple Silicon や CPU のみのマシンでも動作しますか?
Python 3.11 以降が必要です。その後、pip install ownvoice-cli を実行してください。ownvoice check と ownvoice infer は GPU がまったく不要で、pocket-tts 自体の CPU 対応設計と同様に、Apple Silicon や CPU のみのマシンでも問題なく動作します。ownvoice train も CPU で実行できますが、エポックごとの所要時間は長くなります。NVIDIA GPU をお持ちで学習を高速化したい場合は、先に PyTorch の CUDA 版をインストールしてください。
OwnVoice は kokoro-tts や Unsloth とどう違いますか?
kokoro-tts なら 2 分以内に音声合成を始められますが、ファインチューニング機能はありません。Unsloth なら 1 分以内に学習を始められますが、TTS 専用ではなく、汎用の LLM ファインチューニングフレームワークです。OwnVoice はどちらよりも用途を絞っています。ベースモデルは 1 つ(pocket-tts のみ)、用途は 1 つ(音声アダプター)です。さらに、無料の ownvoice check ステップを実行すると、GPU に費用をかける前に、お使いの環境で PEFT の LoRA 注入が実際に動作することを確認できます。この 2 つのツールには、これに相当するチェック機能がありません。
学習が完了したのに「BELOW THRESHOLD」と表示されました。これはバグですか?
いいえ。これはラベル付きの結果であり、クラッシュではありません。ownvoice train はどちらの場合も終了コード 0 で終了します。コサイン類似度が 0.75 の基準を下回っていても、アダプターはディスクに保存されます。OwnVoice は、より多くの音声クリップやノイズの少ない音声クリップを使う、エポック数を増やす、または --lora-rank を大きくすることを明確に案内し、その後、再実行を促します。コマンドが実際にゼロ以外の終了コードで失敗するのは、読み込み可能な音声クリップがない場合と、PEFT の注入エラーを捕捉した場合の 2 つだけです。
OwnVoice と、OwnVoice が生成するアダプターは、商用利用できますか?
OwnVoice 自体のコードは MIT ライセンスです(LICENSE を参照)。pocket-tts のコードパッケージも MIT ライセンスですが、OwnVoice が実際にダウンロードして学習に使うモデルウェイトである kyutai/pocket-tts-without-voice-cloning と、アクセス制限付きの kyutai/pocket-tts は MIT ではなく CC-BY-4.0 ライセンスです。CC-BY-4.0 では商用利用が認められていますが、Kyutai の表示が必要です。学習するアダプターはすべてこれらのウェイトをもとに作られるため、それを使って商用製品を公開する前に、この表示要件をご確認ください。
このツールで、誰の声をクローンできますか? クローンできるのはご自身の声、または本人の明示的な同意を確認できた他人の声だけです。同意なしに著名人の声をクローンしてはいけません。上記の 同意と不正利用 をご覧ください。このバージョンの OwnVoice には、一括生成機能や自動スケーリング機能がないため、単一の不正利用事例による影響範囲を小さく抑えられます。
MCP サーバー
OwnVoice にはModel Context Protocolサーバーが付属しているため、MCP 互換のエージェントは、シェルを介して実行してテキストを解析する代わりに、stdio 経由でownvoice check/train/inferを直接実行できます。
pip install "ownvoice-cli[mcp]"
MCP クライアントの設定に追加してください(例:Claude Desktop のclaude_desktop_config.json)。
{
  "mcpServers": {
    "ownvoice": {
      "command": "ownvoice-mcp"
    }
  }
}
このサーバーは、run(args: list[str]) -> dictという単一のツールを公開します。このツールは、指定された argv で実際のownvoice CLI をシェル経由で実行し、結果を構造化 JSON として返すため、呼び出し元は--jsonモードを含め、人間向け CLI とまったく同じ動作を得られます。呼び出し例:run(args=["check", "--json"])は{"result": {"success": true, "message": "...", "module_tree": null}}を返します。ゼロ以外の終了コード、起動失敗、サブプロセスのタイムアウトは、例外として発生するのではなく、常に{"error": "..."}として返されます。
コントリビュート
Issue と PR を歓迎します。全体を通じてライセンスは MIT です。このプロジェクトが対象とする実際の課題の解決に協力したい場合は、上流への貢献が最も有用です。具体的には、軽量な LoRA アダプターのトレーニングスクリプトをkyutai-labs/pocket-tts本体に提供することです。詳細はissue #30で議論されています。
ライセンス
MIT。LICENSEを参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。