
workloadtruth について
WorkloadTruthは、GPUのテレメトリーからワークロードを学習・推論・アイドルに分類するCLIとMCPサーバーです。運用担当者やエージェントによる申告内容の確認を想定し、検証可能なルールとハッシュチェーン付き監査ログを備えています。
主な機能
- 01テレメトリーによる分類
- 02検証可能なルール閾値
- 03継続監視とハッシュチェーンログ
- 04SyntheticおよびNVMLバックエンド
- 05回避耐性ベンチマーク
活用シーン
- 01GPUジョブと申告種別の照合
- 02推論から学習への変化の監視
- 03ローカル分類記録の確認と検証
MCP 対応
stdioのMCPサーバーは、ワークロード分類、合成データによる回避ベンチマークの実行、ローカル監査ログの検証を行うツールを公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
WorkloadTruth




インストール • クイックスタート • CLI リファレンス • 比較 • FAQ
テレメトリーだけから、GPU ワークロードを TRAINING、INFERENCE、IDLE に分類します。ワークロードのコード変更も、ジョブの自己申告ラベルも不要です。
run:ai、Slurm、Kubernetes GPU オペレーターなど、現在広く使われているすべての GPU スケジューラーでは、ジョブの送信時にトレーニングか推論かを 申告 する必要があります。しかし、どれも検証しません。WorkloadTruth は GPU テレメトリー(使用率、メモリパターン、消費電力)を読み取り、独立して判定するため、誤ったラベルが付いたジョブや正常に動作していないジョブが見過ごされません。
インストール
# Real NVIDIA GPU telemetry (requires an NVIDIA driver on the host)
pip install "workloadtruth-cli[nvml]"

# Try it without a GPU, using the synthetic backend
pip install workloadtruth-cli

# npm launcher (thin wrapper around the PyPI package, see "Why two registries")
npx workloadtruth-cli --help
メモ
npm パッケージはランチャーであり、単独でインストールできるものではありません。
npx workloadtruth-cliは PATH から実際のworkloadtruthバイナリを実行するため、先に PyPI パッケージ(pip install workloadtruth-cli)をインストールしておく必要があります。
クイックスタート
# No GPU required. Classify a synthetic "training" telemetry trace.
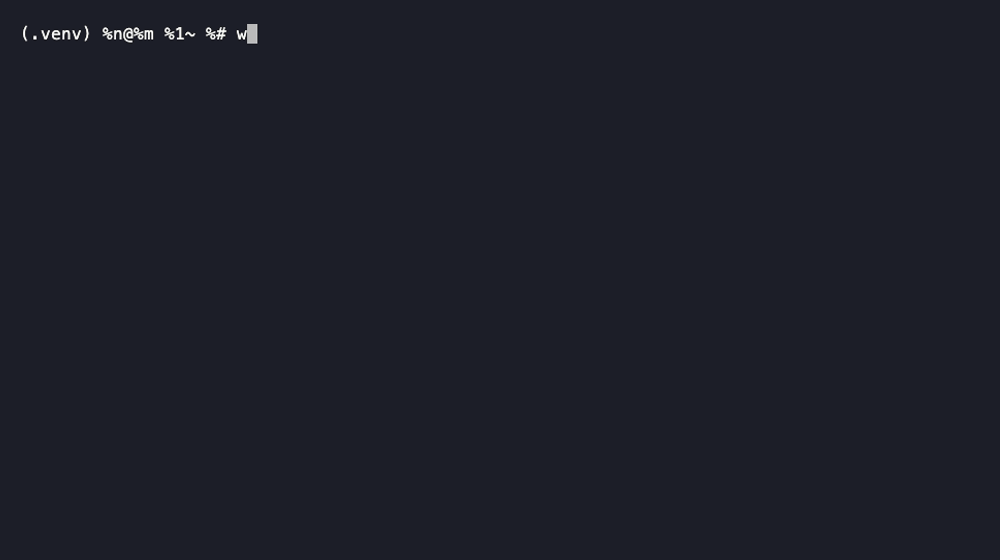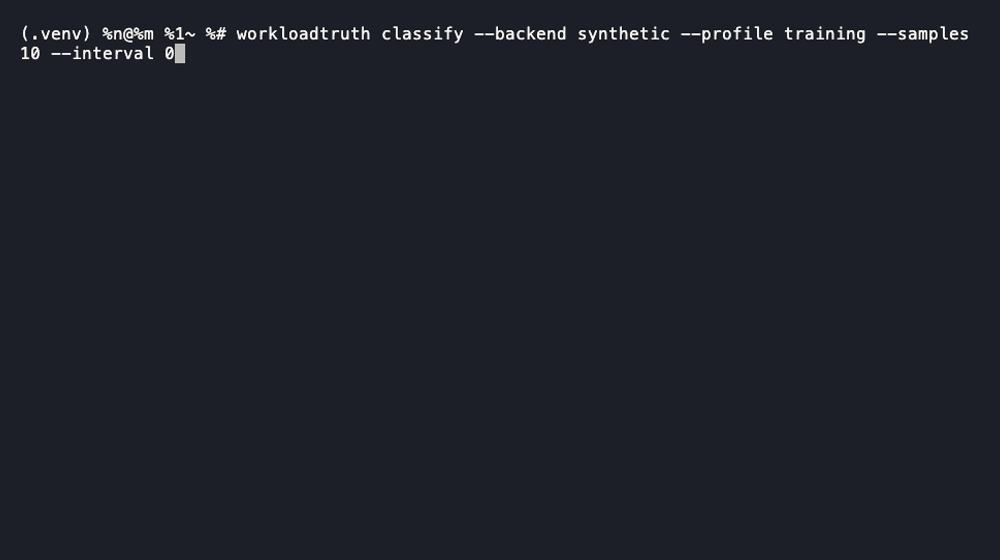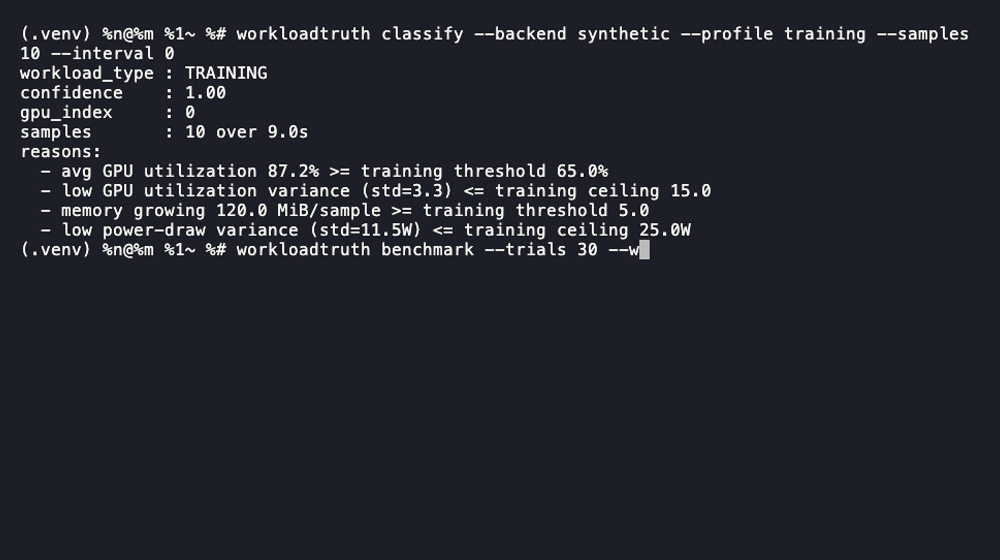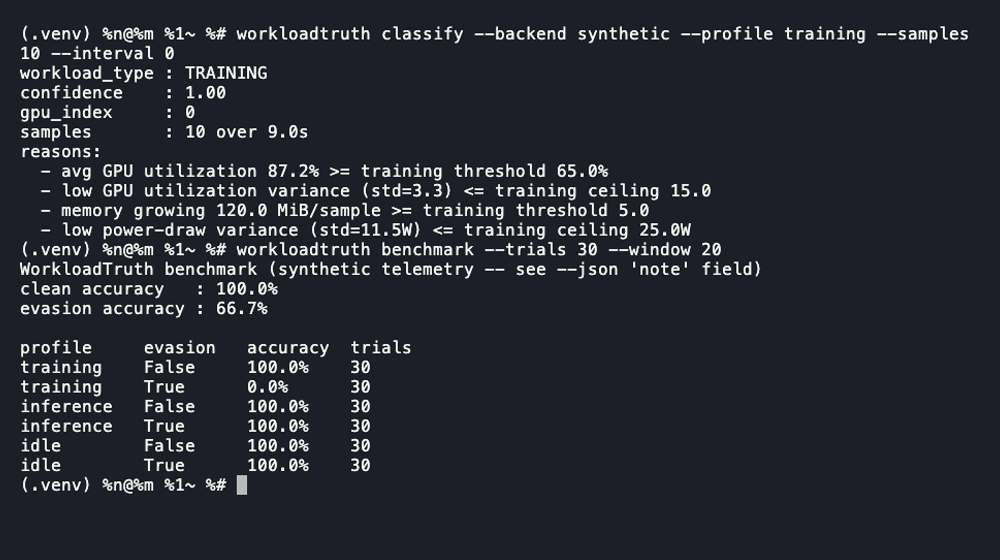
$ workloadtruth classify --backend synthetic --profile training --samples 10 --interval 0
workload_type : TRAINING
confidence    : 1.00
gpu_index     : 0
samples       : 10 over 9.0s
reasons:
  - avg GPU utilization 87.8% >= training threshold 65.0%
  - low GPU utilization variance (std=3.4) <= training ceiling 15.0
  - memory growing 120.0 MiB/sample >= training threshold 5.0
  - low power-draw variance (std=9.4W) <= training ceiling 25.0W

# Real hardware
$ workloadtruth classify --backend nvml --samples 10 --interval 1 --json
すべてのコマンドで --json を指定すると、スクリプトやエージェント向けの機械可読な出力に切り替わります。
簡単なまとめ
- 用途: コスト配分を誤った GPU ジョブ(低優先度の「推論」として課金されているのに、実際には本格的なトレーニングを実行しているジョブ)や、許可されていないワークロードの変更(承認なしにライブトラフィック上でトレーニングを開始する推論エンドポイント)の検出
- 対象外: コンプライアンスや規制監査のためのツール。現在、この種の監視を義務付ける規制はありません。詳しくは、以下のWorkloadTruth の対象外をご覧ください
- 先行研究: arXiv:2606.19262(ICML 2026)を基盤とし、引用しています。詳しくは先行研究との関係をご覧ください
分類の仕組み
WorkloadTruth に現在搭載されているのは、ルールベースの分類器のみです。テレメトリーウィンドウから抽出した 4 つの特徴量(GPU 使用率の平均と分散、メモリ増加の傾き、消費電力の平均と分散)に対する、文書化され、確認可能な一連のしきい値です。各しきい値は src/workloadtruth/classifier/rules.py に名前付き定数として定義され、その判断の根拠をコメントで説明しています。ブラックボックスはありません。
--experimental(ML ベースの分類器)はフラグとして用意されていますが、偽の結果を提供するのではなく、説明とともに明確にエラーになります。arXiv:2606.19262 の学習済みモデルとデータセットは公開されておらず、このプロジェクトのビルド環境には実際のトレーニングデータを収集するための NVIDIA GPU がありません。ML 分類器をここに搭載するのは、実際のデータセットを開示したうえで学習し、ルールベースのベースラインを上回ることが独立して確認された場合に限ります。それまでは搭載しません。
ベンチマーク
workloadtruth benchmark は、ドキュメント化された合成 GPU テレメトリートレース(正確なプロファイルパラメーターについては synthetic_backend.py を参照)に対する分類器の精度を、通常の状態と、オペレーターが学習ジョブを推論のように見せかける状況を模した意図的な回避変換(利用率の変動を抑え、メモリー増加を平坦化し、人為的なアイドル時間を挿入)を適用した状態の両方で測定します。
これは合成データで実行され、実際の NVIDIA ハードウェアでは実行されないため、arXiv:2606.19262 の実機での数値とは直接比較できません。 以下では、両方の結果を並べて報告し、1 つの数値にまとめていません。
| arXiv:2606.19262(実機、NVML) | WorkloadTruth(合成トレース、セルあたり300試行) | |
|---|---|---|
| 通常時の精度 | 98.2% | 100.0% |
| 回避時の精度 | 43-87% | 全体で66.7% |
回避時の全体的な数値からは、実際の調査結果が見えません。ワークロードの種類ごとに分けると、WorkloadTruth のルールベース分類器は、回避された学習ワークロードに対して現在は**完全に欺かれています(精度0%)**が、回避された推論およびアイドルトレースに対する精度は維持しています(どちらも100%)。GPU 利用率を抑えるだけで、現在のこの分類器には学習ジョブが推論として判定されます。
| プロファイル | 通常時の精度 | 回避時の精度 |
|---|---|---|
| 学習 | 100.0% | 0.0% |
| 推論 | 100.0% | 100.0% |
| アイドル | 100.0% | 100.0% |
これは脚注ではなく、ベンチマークスイートが明らかにし、追跡するために存在する、具体的に開示されたギャップです。利用率の変動だけを見るルールベース分類器は、簡単に回避できます。マルチシグナル融合、またはデータが得られた段階での実際の学習済み分類器によってこのギャップを埋めることは、今後のロードマップであり、解決済みの問題ではありません。ご自身で再現するには、次のコマンドを実行してください。
workloadtruth benchmark --trials 300 --window 30 --json
CLI リファレンス
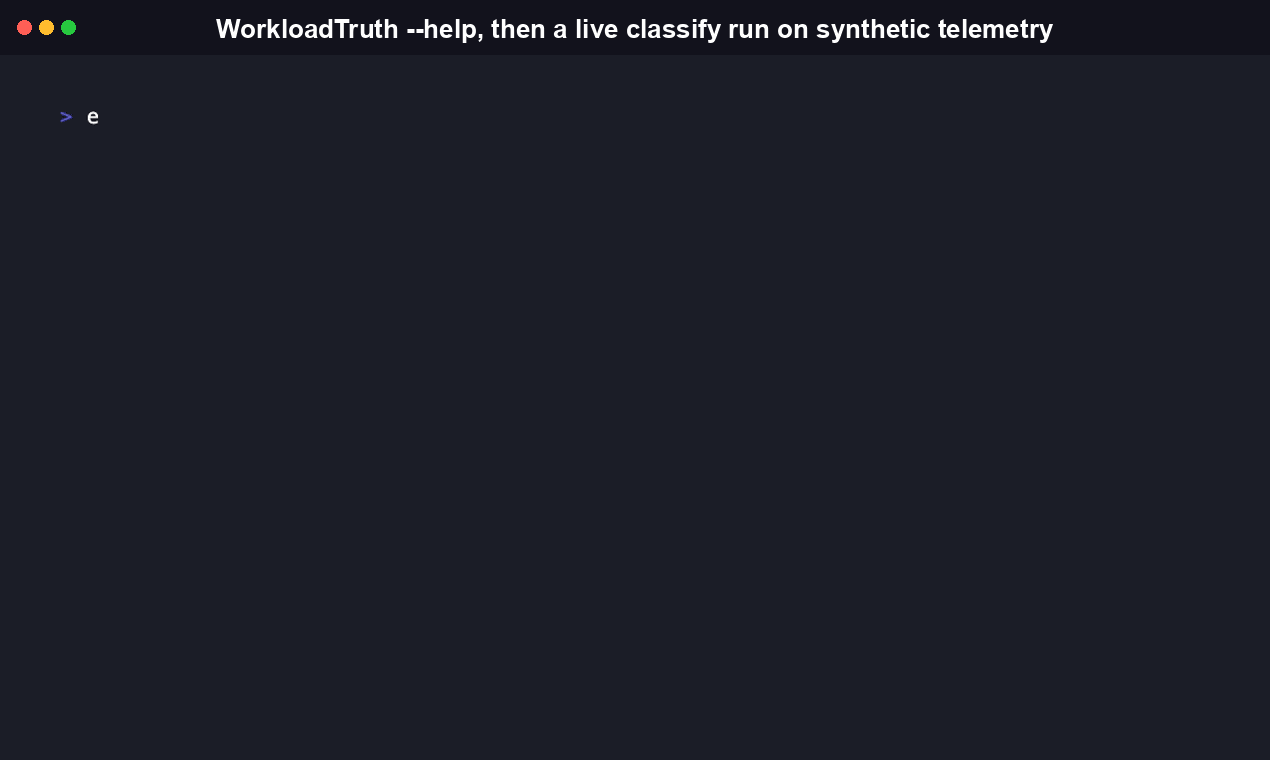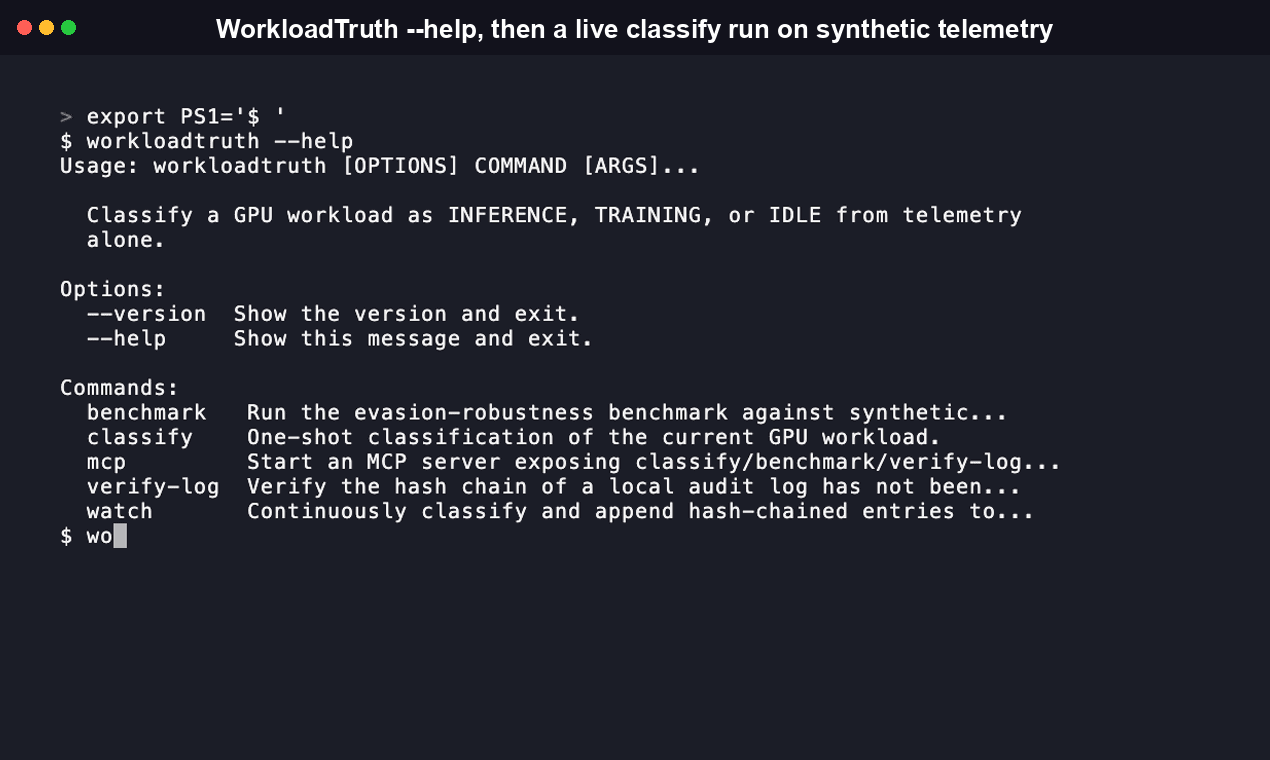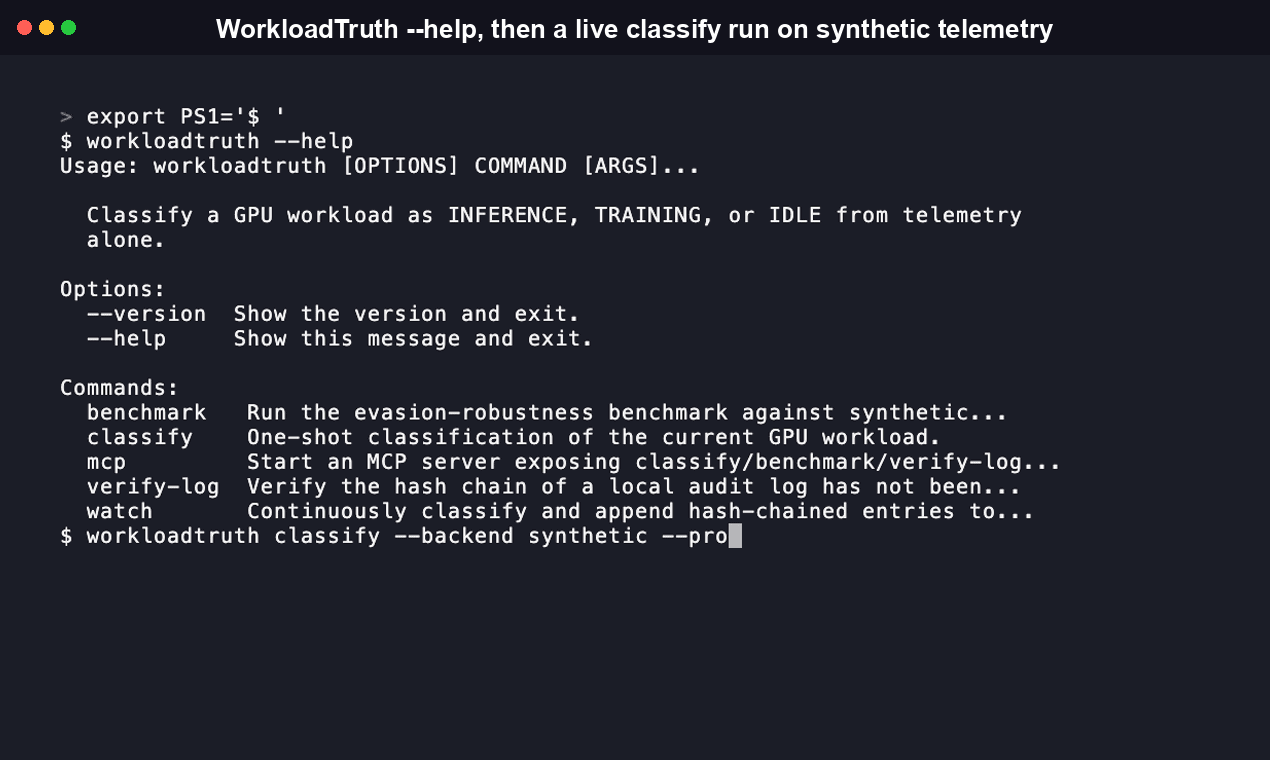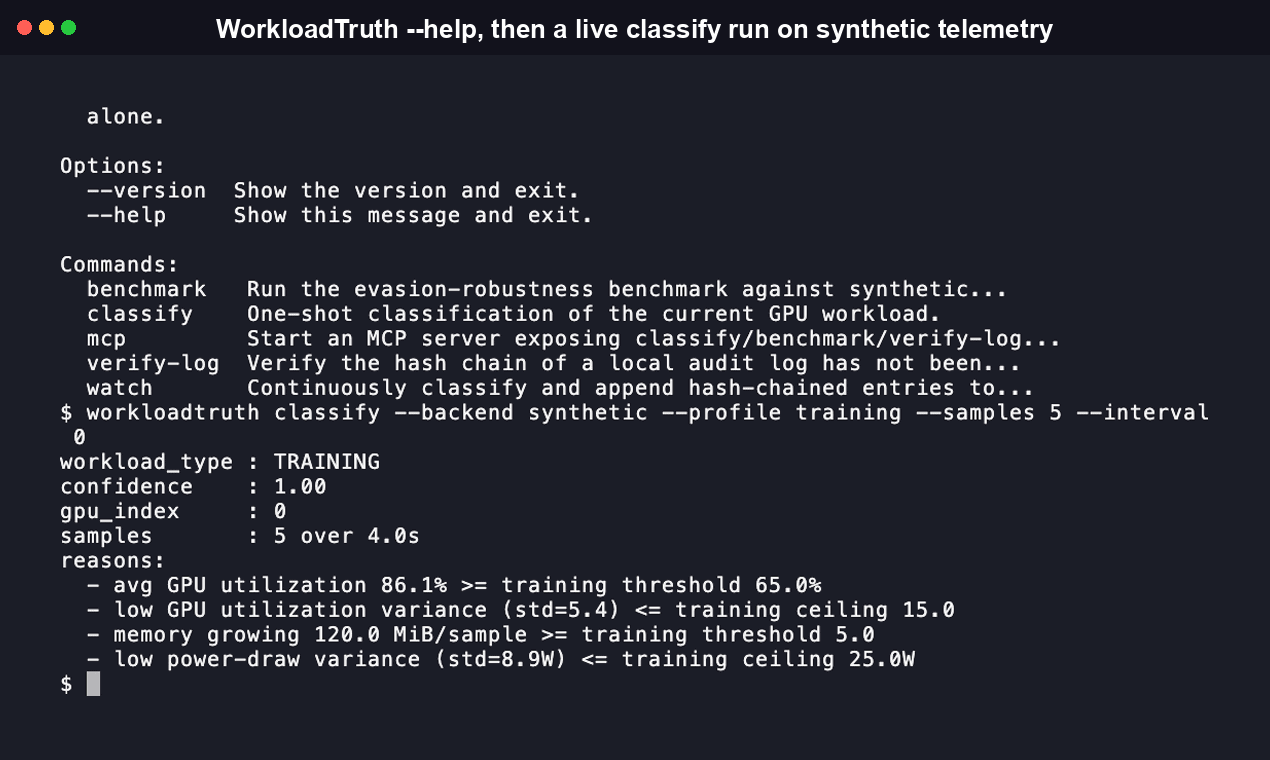
$ workloadtruth --help
Usage: workloadtruth [OPTIONS] COMMAND [ARGS]...

  Classify a GPU workload as INFERENCE, TRAINING, or IDLE from telemetry
  alone.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  benchmark   Run the evasion-robustness benchmark against synthetic...
  classify    One-shot classification of the current GPU workload.
  mcp         Start an MCP server exposing classify/benchmark/verify-log...
  verify-log  Verify the hash chain of a local audit log has not been...
  watch       Continuously classify and append hash-chained entries to...
| コマンド | 用途 |
|---|---|
classify | 1 回限りの分類です。--backend synthetic|nvml、--profile(synthetic のみ)、--gpu-index、--samples、--interval、--experimental(まだ利用できません)、--json を指定できます。 |
watch | 継続的に分類し、各ウィンドウでハッシュチェーンされたエントリーをローカルの監査ログに追記します。--window(ウィンドウあたりのサンプル数)、--iterations(0 = 無期限に実行)、--log-file、--json を指定できます。 |
benchmark | 回避耐性ベンチマークを実行します(上記を参照)。--trials、--window、--json を指定できます。 |
verify-log | すべての監査ログエントリーのハッシュを再導出し、チェーンが改ざんされていないことを確認します。--log-file、--json を指定できます。 |
mcp | エージェントが呼び出せるツールとして classify_workload、run_benchmark、verify_audit_log を公開する MCP サーバー(stdio)を起動します。--backend を指定できます。Python 3.10 以降で pip install "workloadtruth-cli[mcp]" が必要です(下記を参照)。 |
すべてのコマンドで --json を使用できます。フラグの詳細については、workloadtruth <command> --help を参照してください。
MCP サーバー
WorkloadTruth は Model Context Protocol サーバーを提供しており、AI エージェント(Claude、Cursor、または MCP 互換クライアント)は、人が手動で CLI を実行しなくても、GPU ワークロードの分類、回避耐性ベンチマークの実行、監査ログの検証を直接行えます。
追加機能をインストールします:
pip install "workloadtruth-cli[mcp]"
MCP クライアントの設定に追加します(Claude Desktop の場合は claude_desktop_config.json)。サーバーは別のコンソールスクリプトではなく、workloadtruth mcp サブコマンドで起動します:
{
  "mcpServers": {
    "workloadtruth": {
      "command": "uvx",
      "args": ["--from", "workloadtruth-cli", "workloadtruth", "mcp"]
    }
  }
}
サーバーは stdio 経由で 3 つのツールを公開します:
classify_workload(backend="nvml", profile="training", gpu_index=0, samples=10, interval_seconds=1.0, write_to_audit_log=False):GPU テレメトリーをサンプリングし、TRAINING、INFERENCE、またはIDLEに分類します。backendは"nvml"(実機)または"synthetic"(文書化された合成トレース。GPU は不要)です。オプションで、結果をハッシュチェーン付き監査ログに追記します。run_benchmark(trials=50, window=30):合成テレメトリーを使って回避耐性ベンチマークを実行し、通常時と回避処理で難読化された状態におけるプロファイルごとの精度を返します。verify_audit_log(log_file="workloadtruth.log.jsonl"):ローカル監査ログのハッシュチェーンを再計算し、改ざんされているかどうかを報告します。
GPU を使わず、合成トレースをトレーニングとして分類する呼び出し例:
classify_workload(backend="synthetic", profile="training", samples=10, interval_seconds=0)
-> {"workload_type": "TRAINING", "confidence": 1.0, "gpu_index": 0, ...}
トランスポートは stdio なので、ホストする必要はありません。MCP クライアントが workloadtruth mcp をローカルサブプロセスとして起動します。また、リポジトリのルートには .well-known/agent.json マニフェストも用意されており、A2A 形式の検出に対応しています。このマニフェストには、CLI と MCP の両方のインターフェイス、およびそれらを提供するパッケージが記載されています。ソース: src/workloadtruth/mcp_server.py 。
監査ログ
workloadtruth watch は、分類ウィンドウごとにハッシュチェーン付きのエントリを workloadtruth.log.jsonl に追記します。各エントリのハッシュには、そのエントリ自身の内容と直前のエントリのハッシュが含まれるため、後から編集、並べ替え、削除を行うと、その箇所から先のチェーンが壊れます。workloadtruth verify-log はすべてのハッシュを再計算し、壊れたリンクがあれば最初の箇所を報告します。
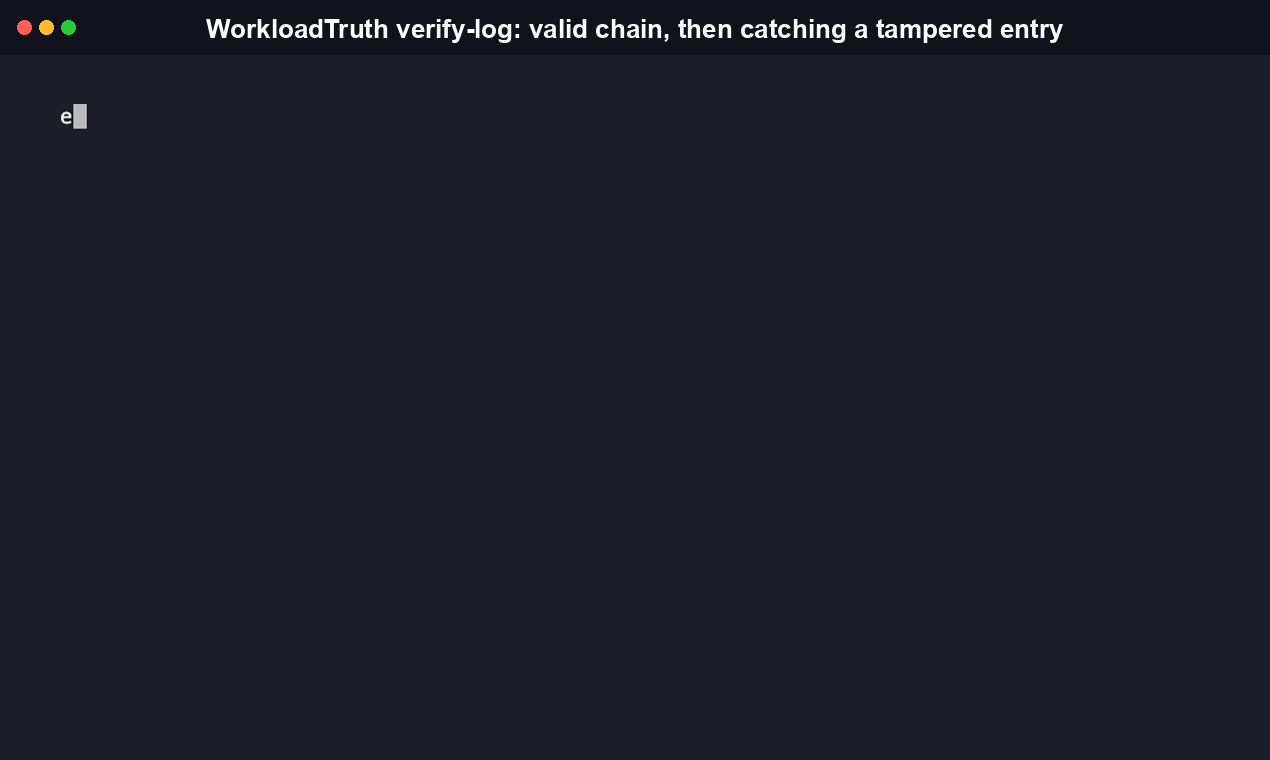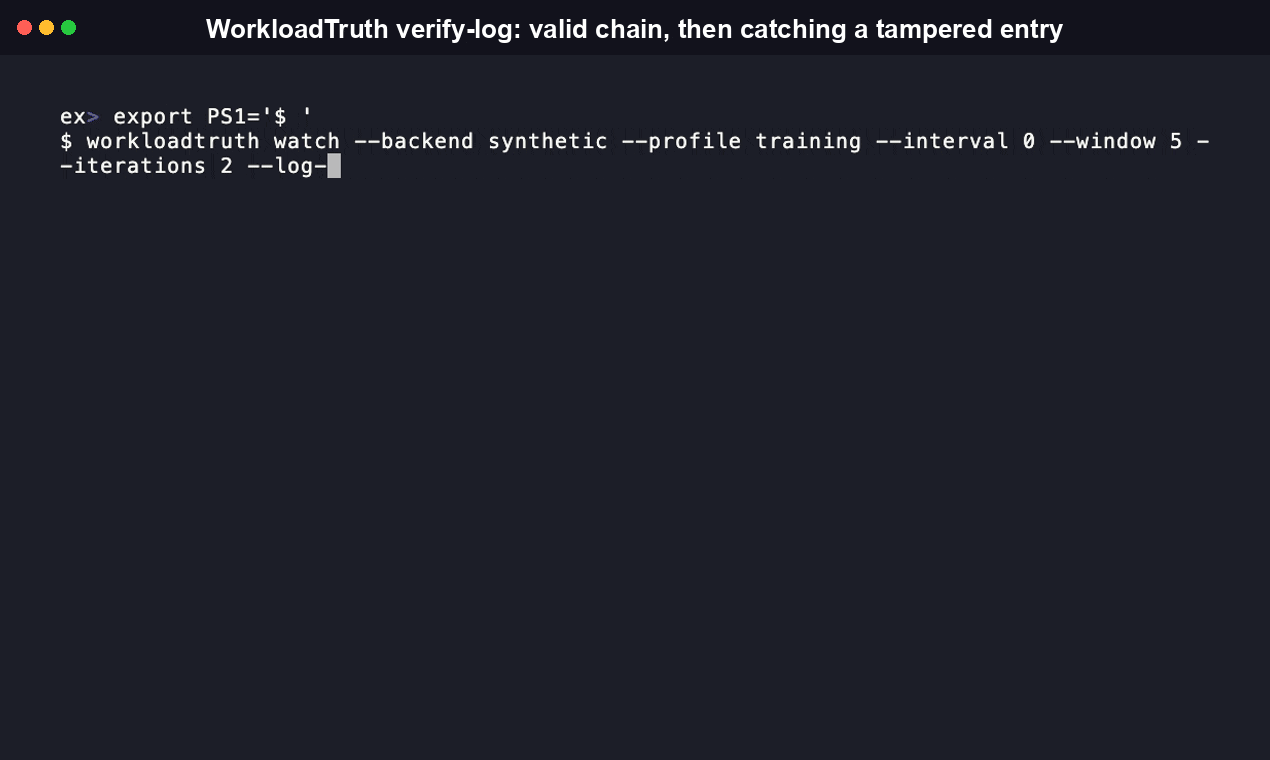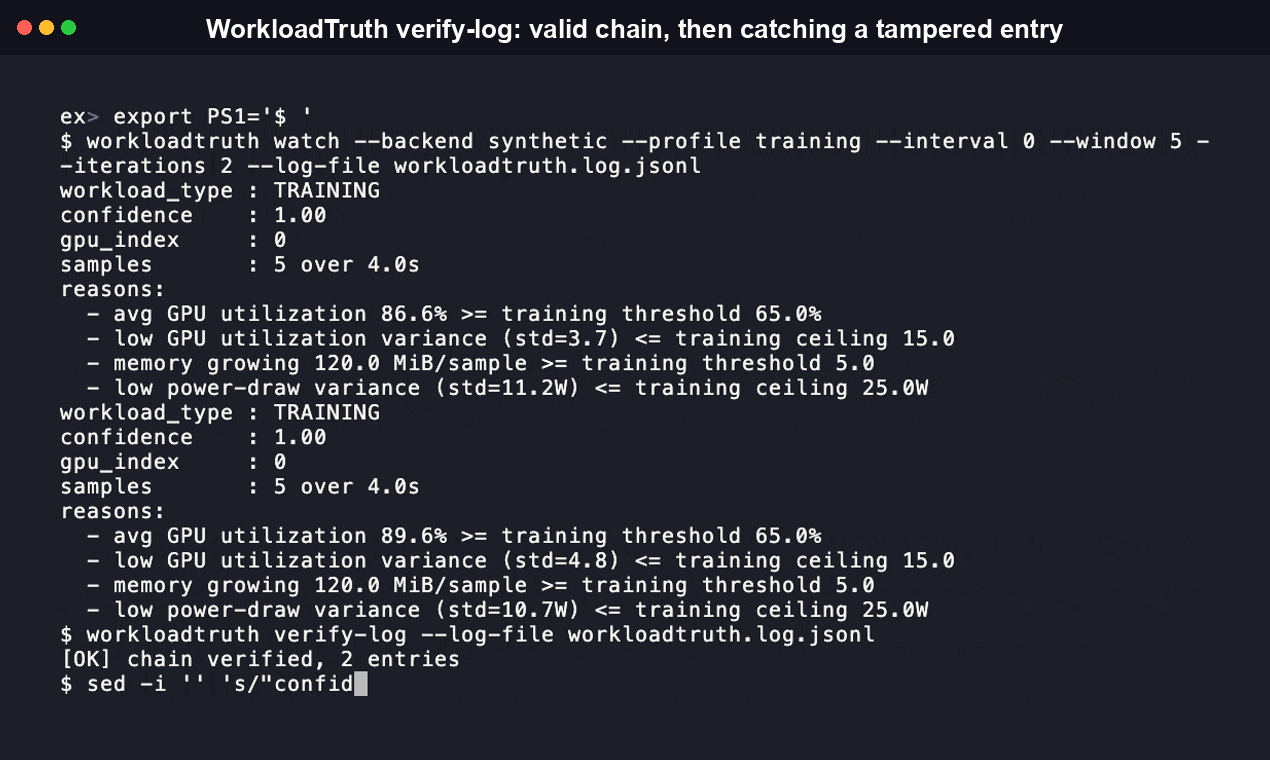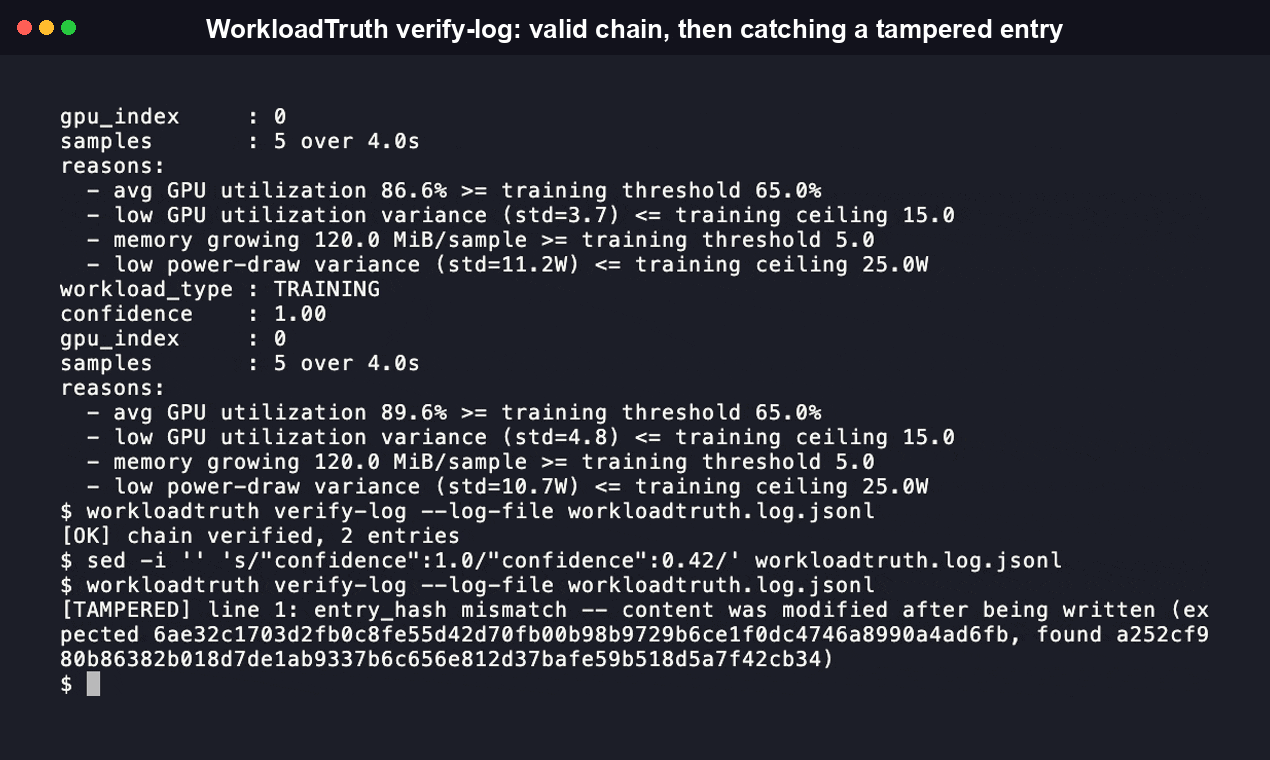
これにより、何がいつ分類されたか、およびその後ローカルの記録が気付かれないうちに改変されていないことを証明できます。分類そのものが正しかったことを証明するものではなく、規制遵守の証拠にもなりません。詳しくは以下をご覧ください。
2 つのレジストリがある理由
WorkloadTruth の実装言語は Python です。NVML へのアクセス(pynvml/nvidia-ml-py)は、NVIDIA GPU のテレメトリーを読み取るための成熟した公式手段であり、最も近い先行研究(arXiv:2606.19262)でも使用されています。npm パッケージ(workloadtruth-cli)は薄いランチャーであり、再実装ではありません。PyPI からインストールされた実際の workloadtruth バイナリを見つけて実行するため、分類器を 2 つの言語で重複実装することなく、npm を優先するエージェント向けツールで npx workloadtruth-cli を使用できます。npm パッケージはランチャースクリプトのみを提供し、分類器本体を含まないため、PyPI パッケージとは独立してバージョン管理されています。
比較
| WorkloadTruth | NVIDIA DCGM / dcgm-exporter | run:ai | Weights & Biases | |
|---|---|---|---|---|
| GPU テレメトリーを読み取る | はい(NVML 経由) | はい(ソース) | はい | はい |
| ワークロードの種類を自動的に分類する | はい | いいえ、生のメトリクスのみを公開 | いいえ、ジョブ送信時にユーザーがワークロードの種類を宣言 | いいえ、設計上、トレーニング実行単位であり、分類機能はありません |
| ローカルのハッシュチェーン監査証跡 | はい | いいえ | いいえ | いいえ |
| 回避耐性ベンチマーク | はい(文書化済み、再現可能) | 該当なし | 該当なし | 該当なし |
| NVIDIA GPU が必要 | nvml バックエンドの場合のみ必要です。synthetic バックエンドは GPU なしで動作します | はい | はい | いいえ(一般的なシステムメトリクス) |
各プロジェクトの公式ドキュメントを直接確認しました:DCGM exporter のドキュメント、run:ai の推論概要、W&B のシステムメトリクスのドキュメント。これらのいずれも、テレメトリーのみからワークロードの種類を分類することはありません。WorkloadTruth はこのギャップを埋めます。
WorkloadTruth とは何か、なぜ存在するのか
WorkloadTruth はオープンソースのコマンドラインツール兼 MCP サーバーであり、GPU レベルのテレメトリー(使用率、メモリーパターン、消費電力)のみを用いて、実行中の GPU ワークロードを TRAINING、INFERENCE、IDLE のいずれかに分類します。ワークロード自体のコードを変更する必要はなく、自己申告されたジョブラベルにも依存しません。
WorkloadTruth が存在するのは、主流の GPU スケジューラーがすべて、ジョブの所有者に送信時点でジョブの種類を申告させる一方、その申告とハードウェア上で実際に行われている処理を照合しないためです。このギャップは、現実に二つの結果をもたらします。コストの誤配分(実際には本格的なトレーニングを実行しているジョブが、低優先度の「推論」料金でスケジュールされること)と、許可されていないワークロードの変更(推論エンドポイントがライブトラフィック上でひそかにトレーニングを開始すること)です。WorkloadTruth はこの検証のギャップを現時点で解消し、ハードウェアテレメトリーから AI のトレーニング実行を検証する実際の学術研究の流れを、初めてオープンかつインストール可能な形で実装したものでもあります(以下を参照)。
先行研究との関係
WorkloadTruth の中核技術である、テレメトリーからトレーニングと非トレーニングの GPU アクティビティを分類する手法は、新しいものではありません。実際に進行中の研究の流れを直接応用したものです。
- Yonadav Shavit(Harvard)、「What does it take to catch a Chinchilla?」(2023):大規模なトレーニング実行を検証するための、ハードウェアレベルの「トレーニング記録」を提案しました。
- GovAI、「Computing Power and the Governance of AI」(2024):コンピュートガバナンスの仕組みを調査し、明確に探索的なものとして提示しており、推奨される政策としては扱っていません。
- 「Hardware-Enabled Mechanisms for Verifying Responsible AI Development」(2025):オンチップのアテステーションを提案する、ハードウェアセキュリティ研究者による論文です。
- Rahman & Tajdari、「Detecting Hidden ML Training With Zero-Overhead Telemetry」(ICML 2026 Technical AI Governance workshop):動作する NVML テレメトリー分類器を示しています。難読化されていないワークロードでの精度は 98.2%で、このプロジェクトの中核となる分類技術に直接関連する先行研究です。
WorkloadTruth が追加するもの: このプロジェクト独自の調査時点(2026-07-19)では、この研究の流れに属するオープンソースでインストール可能な実装は存在せず、学術的なプロトタイプのみでした。WorkloadTruth は、その研究をパッケージ化したものです。実際に使える CLI、MCP サーバー、ハッシュチェーン監査ログ、再現可能な回避耐性ベンチマークをオープンに開発しています。論文の分類技術を改善したとは主張していません。上記のベンチマークのセクションを参照してください。現在のルールベースの分類器は、測定対象の唯一の観点において、論文の ML アプローチよりもはるかに回避されやすくなっています。
WorkloadTruthではないもの
- コンプライアンスまたは規制監査ツールではありません。 現時点で、推論/トレーニングの分類や報告を義務付ける法律はありません。将来、これに反する主張をする場合は、制定済みの具体的な規制を明示します。執筆時点では、そのような規制はありません。
- コンテンツ検査ツールではありません。 WorkloadTruthが読み取るのはGPUレベルのシグナル(使用率、メモリ、電力)のみです。モデルの重み、トレーニングデータ、プロンプト、生成結果を検査することはありません。
- 「準拠」または「安全」な運用の証明ではありません。 監査ログが証明するのは、何がいつ分類され、その後に記録が改変されていないことです。分類が正しかったことや、ポリシーが遵守されたことを証明するものではありません。
よくある質問
NVIDIA GPUが必要ですか?
nvmlバックエンドの場合のみ必要です。--backend syntheticを使うと、GPUなしで、文書化された合成トレースに対して分類器とCLIの全機能を実行できます。ツールを試す場合やCIに便利です。
AMDまたはIntelのGPUワークロードを分類できますか?
まだ対応していません。テレメトリ層はプラグイン可能なインターフェース(TelemetryBackend)になっているため、分類器に手を加えずに新しいベンダーバックエンド(AMD ROCm、Intel Level Zero)を追加できます。CONTRIBUTING.mdを参照してください。
この分類器の出力に基づいて、請求やペナルティを課せるほど正確ですか?
まだです。その率直な理由は、上記のベンチマークのセクションにあります。現時点では、回避的なトレーニングワークロードに対する精度は0%です。workload_typeは、判定ではなく調査のきっかけとなるシグナルとして扱ってください。
論文のML分類器をそのまま使わないのはなぜですか? 学習済みの重みとデータセットは公開されていません。実際のトレーニングデータなしでML分類器を再実装しても、測定された精度ではなく、検証されていない精度の主張になってしまいます。分類の仕組みを参照してください。
run:aiやNVIDIA DCGMとはどう違いますか? run:aiとDCGMはどちらもGPUテレメトリを公開または利用しますが、どちらもそのテレメトリからワークロードの種類を分類しません。run:aiは、ジョブの所有者が送信時に申告するラベルに全面的に依存します。DCGMは、別の用途で解釈するための生の使用率とメモリのメトリクスを公開するだけです。WorkloadTruthは、実際にテレメトリを調べてその問いに答えるレイヤーです。比較表を参照してください。
Windows、macOS、Linuxで動作しますか?
syntheticバックエンドはPython 3.10+が動作する環境であればどこでも動作します。NVIDIA GPUのない、このプロジェクト独自のmacOSビルド環境でも動作します。nvmlバックエンドにはNVIDIA GPUとドライバーが必要です。実際には、NVIDIAハードウェアを搭載したLinuxまたはWindowsが必要です。NVML自体はmacOSでは利用できません。
ライセンスは何ですか? 商用利用できますか? Apache 2.0です。その規約に基づき、商用利用、変更、再配布がすべて許可されています。LICENSEを参照してください。
コントリビューション
CONTRIBUTING.mdを参照してください。セキュリティ上の問題については、SECURITY.mdを参照してください。
ライセンス
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。