searchcraft-mcp-server について
searchcraft-mcp-serverは、Searchcraft検索クラスターの管理やJSONデータからの検索アプリ作成に使うMCPツールを提供します。MCPクライアント経由でインデックス設定、データ取り込み、検索、分析を行う開発者向けです。
主な機能
- 01インデックス、ドキュメント、フェデレーションの管理
- 02認証キーの作成と管理
- 03インデックス検索と分析データの確認
- 04JSONの分析とインデックススキーマ生成
- 05ファイルやURLからJSONデータを取り込み
- 06ViteとReactの検索アプリを生成
活用シーン
- 01JSONデータから検索可能なインデックスを作成
- 02クラスターのキーとフェデレーションを管理
- 03インデックスを検索して分析データを確認
- 04取り込んだデータの検索アプリを試作
MCP 対応
Claude DesktopなどのMCPクライアントに、Searchcraftクラスター管理、データ取り込み、検索、分析、アプリ生成のツールを提供します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細

searchcraft-mcp-server
Searchcraft を活用した MCP サーバーです。開発者を第一に考えた垂直検索エンジンです。

Searchcraft MCP サーバーは、Searchcraft クラスターのドキュメント、インデックス、フェデレーション、アクセスキー、分析を管理するためのツール一式を提供します。Claude Desktop などの MCP クライアントから平易な英語で指示を出し、検索インデックスやアクセスキーの設定、ドキュメントの取り込み、分析の表示、インデックスの検索などの管理操作を実行できます。
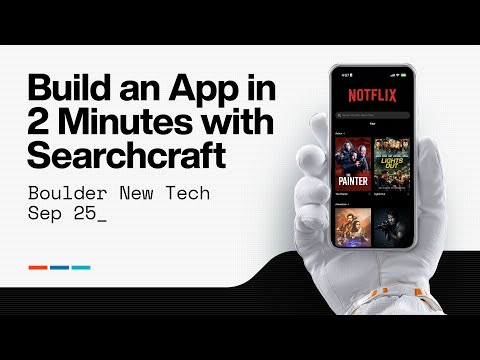
Searchcraft MCP Server で 2 分でアプリを構築(動画リンク)
プロンプトの例
Claude を Searchcraft MCP サーバーに接続すると、次のようなプロンプトを使用できます。
I'd like to create a product search application using the create_vite_app tool.

Please use this JSON dataset https://dummyjson.com/products
First use the Searchcraft create_index_from_json tool to create the index and add the documents.

Then create an API read key for the vite app using the create_key tool.

App details:
- App name: "my-ecommerce-app"
- Endpoint: http://localhost:8000
- Index name: my-ecommerce-app
利用可能なツール
Searchcraft MCP サーバーは現在、インポートツール、エンジン API ツール、アプリ生成ツールの 3 つのカテゴリのツールを提供しています。
エンジン API ツール
これらのツールを使うと、インデックス、ドキュメント、フェデレーション、認証、検索操作を管理するための Searchcraft クラスターの主要機能に直接アクセスできます。
インデックス管理
| ツール名 | 説明 |
|---|---|
| create_index | 指定したスキーマで新しいインデックスを作成します。すでに存在する場合、インデックスの内容は空になります。 |
| delete_index | インデックスと、そのすべてのドキュメントを完全に削除します。 |
| get_all_index_stats | すべてのインデックスのドキュメント数と統計情報を取得します。 |
| get_index_schema | 指定したインデックスのスキーマ定義を取得します。 |
| get_index_stats | 指定したインデックスの統計情報とメタデータ(ドキュメント数など)を取得します。 |
| list_all_indexes | Searchcraft インスタンス内のすべてのインデックスの一覧を取得します。 |
| patch_index | インデックスのスキーマ設定(search_fields、weight_multipliers など)を部分的に変更します。 |
| update_index | 既存のインデックスの内容全体を、新しいスキーマ定義で置き換えます。 |
ドキュメント管理
| ツール名 | 説明 |
|---|---|
| add_documents | 1 つまたは複数のドキュメントをインデックスに追加します。ドキュメントは JSON オブジェクトの配列として指定してください。 |
| delete_all_documents | インデックスからすべてのドキュメントを削除します。すべてのドキュメントを削除した後も、インデックスは残ります。 |
| delete_document_by_id | Searchcraft 内部 ID(_id)を指定して、インデックスから単一のドキュメントを削除します。 |
| delete_documents_by_field | フィールド値の一致(例:{id: 'xyz'} や {title: 'foo'})を使って、インデックスから 1 つまたは複数のドキュメントを削除します。 |
| delete_documents_by_query | クエリの一致を使って、インデックスから 1 つまたは複数のドキュメントを削除します。 |
| get_document_by_id | Searchcraft 内部 ID(_id)を指定して、インデックスから単一のドキュメントを取得します。 |
フェデレーション管理
| ツール名 | 説明 |
|---|---|
| create_federation | 指定した設定でフェデレーションを作成または更新します。 |
| delete_federation | フェデレーションを完全に削除します。 |
| get_federation_details | 特定のフェデレーションの詳細情報を取得します。 |
| get_federation_stats | フェデレーションのインデックスごとのドキュメント数と、合計ドキュメント数を取得します。 |
| get_organization_federations | 特定の組織のすべてのフェデレーションの一覧を取得します。 |
| list_all_federations | Searchcraft インスタンス内のすべてのフェデレーションの一覧を取得します。 |
| update_federation | 現在のフェデレーションエンティティを更新版に置き換えます。 |
認証とキー管理
| ツール名 | 説明 |
|---|---|
| create_key | 指定した権限とアクセス制御で、新しい認証キーを作成します。 |
| delete_all_keys | Searchcraft クラスター上のすべての認証キーを削除します。使用には十分注意してください! |
| delete_key | 特定の認証キーを完全に削除します。 |
| get_application_keys | 特定のアプリケーションに関連付けられたすべての認証キーの一覧を取得します。 |
| get_federation_keys | 特定のフェデレーションに関連付けられたすべての認証キーの一覧を取得します。 |
| get_key_details | 特定の認証キーの詳細情報を取得します。 |
| get_organization_keys | 特定の組織に関連付けられたすべての認証キーの一覧を取得します。 |
| list_all_keys | Searchcraft クラスター上のすべての認証キーの一覧を取得します。 |
| update_key | 既存の認証キーを新しい設定で更新します。 |
ストップワード管理
| ツール名 | 説明 |
|---|---|
| add_stopwords | インデックスにカスタムストップワードを追加します。これらは、言語ごとのデフォルト辞書に追加されます。 |
| delete_all_stopwords | インデックスからすべてのカスタムストップワードを削除します。カスタムストップワードのみが対象で、デフォルトの言語辞書には影響しません。 |
| delete_stopwords | インデックスから特定のカスタムストップワードを削除します。カスタムストップワードのみが対象で、デフォルトの言語辞書には影響しません。 |
| get_index_stopwords | デフォルトの言語辞書とカスタムストップワードを含む、インデックスのすべてのストップワードを取得します。 |
同義語管理
| ツール名 | 説明 |
|---|---|
| add_synonyms | インデックスに同義語を追加します。同義語はあいまい検索では機能しますが、完全一致検索では機能しません。 |
| delete_all_synonyms | インデックスからすべての同義語を削除します。 |
| delete_synonyms | キーを指定して、インデックスから特定の同義語を削除します。 |
| get_index_synonyms | インデックスに定義されているすべての同義語を取得します。 |
検索と分析
| ツール名 | 説明 |
|---|---|
| get_measure_conversion | オプションのフィルタリングおよび集計パラメーターを指定して、測定値の換算データを取得します。*ローカルで実行する場合は Clickhouse が必要です |
| get_measure_summary | オプションのフィルタリングおよび集計パラメーターを指定して、測定値の概要データを取得します。*ローカルで実行する場合は Clickhouse が必要です |
| get_search_results | Searchcraft API を使用して検索クエリを実行します。あいまい検索/完全一致検索、ファセット、日付範囲に対応しています。 |
| get_prelim_search_data | クエリの構築に使用できるフィールドを確認するため、検索インデックスのスキーマフィールドとファセット情報を取得します。 |
| get_searchcraft_status | Searchcraft 検索サービスの現在のステータスを取得します。 |
インポートツール
これらのツールは、JSON データをインポートし、Searchcraft のスキーマを自動生成するワークフローを提供します。既存のデータソースから新しいインデックスをすばやく設定するのに最適です。
| ツール名 | 説明 |
|---|---|
| analyze_json_from_file | ローカルファイルから JSON データを読み込み、その構造を分析して、Searchcraft のインデックススキーマ生成に必要なフィールドの型やパターンを把握します。 |
| analyze_json_from_url | URL から JSON データを取得し、その構造を分析して、Searchcraft のインデックススキーマ生成に必要なフィールドの型やパターンを把握します。 |
| generate_searchcraft_schema | 分析した JSON 構造から完全な Searchcraft インデックススキーマを生成します。検索フィールド、重み、その他のインデックス設定をカスタマイズできます。 |
| create_index_from_json | JSON データから Searchcraft のインデックスを作成する一連のワークフローを実行します。URL またはファイルから JSON を取得し、構造を分析してスキーマを生成し、インデックスを作成して、すべてのドキュメントを一度に追加します。 |
インポートツールのワークフロー
インポートツールは、次のようなシンプルなワークフローで連携するように設計されています。
- 分析 →
analyze_json_from_fileまたはanalyze_json_from_urlを使用して、JSON データの構造を調べます - 生成 →
generate_searchcraft_schemaを使用して、分析結果からカスタマイズした Searchcraft スキーマを作成します - 作成 → Engine API の
create_indexツールを使用して、生成したスキーマでインデックスを作成します - インポート →
add_documentsを使用して、新しいインデックスにデータを登録します
または、すべてを一度に実行する方法もあります。
- 1 ステップ →
create_index_from_jsonを使用して、分析、スキーマ生成、インデックス作成、すべてのドキュメントのインポートを 1 つのコマンドで実行します
アプリ生成ツール
これらのツールは、JSON データからすぐに実行できる検索アプリケーションを作成します。プロトタイピングやデモに最適です。
| ツール名 | 説明 |
|---|---|
| create_vite_app | JSON データから、完全な Vite + React 検索アプリケーションを作成します。データ構造を分析し、最適化された検索テンプレートを生成して、Searchcraft と連携する完全に機能する Web アプリを作成します。 |
アプリ生成ワークフロー
アプリ生成ツールは、検索アプリケーションを作成するためのエンドツーエンドのソリューションを提供します。
- データ分析 → JSON の構造を自動的に分析し、フィールドの型や内容を把握します
- テンプレート生成 → データフィールドに基づいて、最適化された検索結果テンプレートを作成します
- アプリ作成 → 完全な Vite + React アプリケーションをクローンして設定します
- 環境設定 → Searchcraft の接続設定を構成します
- すぐに実行可能 → すぐに起動してカスタマイズできる、完全に機能する検索アプリを提供します
ツールの詳細な使用方法
create_index_from_json の使用
create_index_from_json ツールを使用すると、1 つのコマンドで JSON データから Searchcraft のインデックスを作成する一連のワークフローを実行できます。既存のデータセットから検索インデックスをすばやく設定するのに最適です。なお、インポートするデータの言語が分かっている場合は、language パラメーターで指定してください(言語には ISO 639-1 の 2 文字コードを使用します)。
パラメーター
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
source | "url" or "file" | ✅ | URL からデータを取得するか、ローカルファイルから読み込むかを指定します |
path | string | ✅ | JSON データの URL またはファイルパス |
index_name | string | ✅ | 新しい Searchcraft インデックスの名前 |
sample_size | number | ❌ | スキーマ生成のために分析する項目数(デフォルト:10) |
search_fields | string[] | ❌ | 自動検出された検索フィールドを上書きします |
weight_multipliers | object | ❌ | 検索の関連性に対するカスタムフィールドの重み(0.0~10.0) |
language | string | ❌ | インデックスの言語コード(例:"en"、"es") |
auto_commit_delay | number | ❌ | 自動コミットの遅延時間(秒) |
exclude_stop_words | boolean | ❌ | 検索からストップワードを除外するかどうか |
time_decay_field | string | ❌ | 時間経過に伴う関連性の減衰に使用するフィールド名 |
使用例
URL から:
{
  "source": "url",
  "path": "https://api.example.com/products.json",
  "index_name": "products",
  "sample_size": 50,
  "search_fields": ["title", "description", "category"],
  "weight_multipliers": {
    "title": 2.0,
    "description": 1.0,
    "category": 1.5
  }
}
ローカルファイルから:
{
  "source": "file",
  "path": "/path/to/data.json",
  "index_name": "my_data",
  "language": "en"
}
このツールの動作
- データの取得/読み込み → URL からダウンロードするか、ローカルファイルから読み込みます
- 構造の分析 → JSON を調べてフィールドの型とパターンを把握します
- スキーマの生成 → 最適化された Searchcraft インデックススキーマを作成します
- インデックスの作成 → Searchcraft クラスターにインデックスを設定します
- ドキュメントのインポート → すべての JSON データを検索可能なドキュメントとして追加します
- 概要の返却 → 作成された内容の詳細情報を提供します
想定される JSON 形式
このツールは、さまざまな JSON 構造に対応しています。
- オブジェクトの配列:
[{...}, {...}, ...] - 配列プロパティを含むオブジェクト:
{"data": [{...}, {...}], "meta": {...}} - 単一のオブジェクト:
{...}(単一のドキュメントとして扱われます)
このツールは、インデックスに使用する最適なオブジェクト配列を自動的に検出します。
create_vite_app の使用
create_vite_app ツールは、JSON データからすぐに実行できる検索アプリケーション一式を作成します。検索インターフェイスのプロトタイプをすばやく作成したり、デモアプリケーションを作成したりするのに最適です。
パラメーター
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
data_source | "url" or "file" | ✅ | URL からデータを取得するか、ローカルファイルから読み込むかを指定します |
data_path | string | ✅ | JSON データの URL またはファイルパス |
app_name | string | ✅ | 生成するアプリの名前(ディレクトリ名として使用) |
VITE_ENDPOINT_URL | string | ✅ | Searchcraft クラスターのエンドポイント URL |
VITE_INDEX_NAME | string | ✅ | 接続する Searchcraft インデックス名 |
VITE_READ_KEY | string | ✅ | アプリケーション用の Searchcraft 読み取りキー |
sample_size | number | ❌ | テンプレート生成のために分析する項目数(デフォルト:50) |
search_fields | string[] | ❌ | 自動検出された検索フィールドを上書きします |
weight_multipliers | object | ❌ | 検索の関連性に対するカスタムフィールドの重み(0.0~10.0) |
使用例
ドキュメント内の先ほどのプロンプトをご覧になった場合は、自然言語を使って簡単に create_vite_app ツールを利用できます。ただし、より細かく制御したい場合は、JSON パラメーターを使ってツールを利用できます。
商品検索アプリの作成:
{
  "data_source": "url",
  "data_path": "https://api.example.com/products.json",
  "app_name": "product-search",
  "VITE_ENDPOINT_URL": "https://your-cluster.searchcraft.io",
  "VITE_INDEX_NAME": "products",
  "VITE_READ_KEY": "your_read_key_here",
  "sample_size": 100,
  "search_fields": ["title", "description", "brand"],
  "weight_multipliers": {
    "title": 2.5,
    "description": 1.0,
    "brand": 1.8
  }
}
ローカルデータからブログ検索アプリを作成:
{
  "data_source": "file",
  "data_path": "/path/to/blog-posts.json",
  "app_name": "blog-search",
  "VITE_ENDPOINT_URL": "https://your-cluster.searchcraft.io",
  "VITE_INDEX_NAME": "blog_posts",
  "VITE_READ_KEY": "your_read_key_here"
}
このツールの動作
- データ構造の分析 → JSON を調べてフィールドの型とコンテンツのパターンを把握します
- 検索テンプレートの生成 → データに基づいて最適化された結果表示テンプレートを作成します
- Vite テンプレートのクローン → 公式の Searchcraft Vite + React テンプレートをダウンロードします
- 依存関係のインストール → 必要な npm パッケージをすべてセットアップします
- 環境の設定 → Searchcraft の設定を含む
.envファイルを作成します - テンプレートのカスタマイズ → 動的な検索結果コンポーネントを生成します
- アプリコードの更新 → 独自のブランド設定と構成に合わせてメインアプリを変更します
生成されるアプリの機能
作成されるアプリには、次の機能が含まれます。
- React + Vite → モダンで高速な開発環境
- Searchcraft SDK Integration → すぐに使える検索機能一式
- Responsive Design → デスクトップとモバイルデバイスに対応
- Auto-generated Templates → データ構造に応じたスマートな検索結果表示
- Environment Configuration → 環境ごとの簡単な設定
- Development Server → 迅速なカスタマイズを可能にするホットリロード
テンプレート生成ロジック
このツールはデータをインテリジェントに分析し、最適な検索結果テンプレートを作成します。
- Title Field Detection → メインタイトルに使用する最適なフィールドを検索します
- Description Field Detection → 説明文のフィールドを特定します
- Image Field Detection → 検索結果に画像を表示するための画像 URL を特定します
- Date Field Detection → 時系列で並べ替えるためのタイムスタンプフィールドを検索します
- Additional Fields → 包括的な検索結果を表示するため、その他の関連するテキストフィールドを含めます
作成後の次のステップ
アプリを作成したら、次の操作を行えます。
-
Vite サーバーを起動する:
cd apps/your-app-name yarn dev -
スタイルをカスタマイズする → CSS とコンポーネントを変更して、ブランドに合わせます
-
機能を追加する → フィルター、ファセット、高度な検索オプションなどを拡張します
-
デプロイする → お好みのホスティングプラットフォーム向けにビルドしてデプロイします
前提条件
- 既存の Searchcraft インデックス →
VITE_INDEX_NAMEで指定したインデックスがすでに存在している必要があります - 有効な読み取りキー →
VITE_READ_KEYに、インデックスの読み取り権限が必要です - Git が利用可能であること → このツールは Git を使用してテンプレートリポジトリをクローンします
- Node.js と Yarn → 依存関係のインストールに必要です
JSON から検索アプリまでの一連のワークフロー
未加工の JSON データから、完全に機能する検索アプリケーションを作成するために、2 つのツールを組み合わせて使う方法を紹介します。
オプション 1:2 段階の手順(本番環境におすすめ)
ステップ 1:Searchcraft インデックスを作成する
{
  "source": "url",
  "path": "https://api.example.com/products.json",
  "index_name": "products",
  "sample_size": 100,
  "search_fields": ["title", "description", "category", "brand"],
  "weight_multipliers": {
    "title": 2.5,
    "description": 1.0,
    "category": 1.8,
    "brand": 1.5
  },
  "language": "en"
}
ステップ 2:検索アプリケーションを作成する
{
  "data_source": "url",
  "data_path": "https://api.example.com/products.json",
  "app_name": "product-search-app",
  "VITE_ENDPOINT_URL": "https://your-cluster.searchcraft.io",
  "VITE_INDEX_NAME": "products",
  "VITE_READ_KEY": "your_read_key_here",
  "sample_size": 100,
  "search_fields": ["title", "description", "category", "brand"],
  "weight_multipliers": {
    "title": 2.5,
    "description": 1.0,
    "category": 1.8,
    "brand": 1.5
  }
}
オプション 2:アプリのみを作成する手順(既存のインデックス向け)
すでに Searchcraft インデックスを設定している場合は、すぐにアプリの作成に進めます。
{
  "data_source": "url",
  "data_path": "https://api.example.com/products.json",
  "app_name": "my-search-app",
  "VITE_ENDPOINT_URL": "https://your-cluster.searchcraft.io",
  "VITE_INDEX_NAME": "existing_index",
  "VITE_READ_KEY": "your_read_key_here"
}
2 段階の手順のメリット
- インデックスの最適化 → 検索インデックスを UI とは別に細かく調整できます
- 複数のアプリ → 同じデータに対して異なる検索インターフェースを作成できます
- 本番環境への対応 → 本番環境へのデプロイで、関心事をより適切に分離できます
- デバッグの簡素化 → UI とは独立して検索機能をテストできます
はじめに
環境変数
プロジェクトのルートに .env ファイルを作成し、値を入力します。
# Server Config
USER_AGENT=searchcraft-mcp-server/<project-version>
DEBUG=true
PORT=3100

# Searchcraft Config
ENDPOINT_URL= # The endpoint url of your Searchcraft Cluster
CORE_API_KEY= # The Searchcraft API key of your Searchcraft cluster. Must match the permissions required by the tools you are using.
リモートでの使用
Searchcraft Cloud 上で Vektron を通じてインデックスをすでに作成している場合は、アクセスするインデックスの書き込みキーを使用して、管理者権限を必要としない API 操作に MCP サーバーを使用できます。 重要:MCP サーバーを使用する際に書き込みキーを使う場合、そのキーをインターネット上に公開しないでください。書き込みキーは安全に保護することを想定しています。MCP サーバーを実行すると、MCP サーバーにアクセスできるユーザーは誰でも、インデックスに書き込んだり、データを削除したりできるようになります。
インストールとセットアップ
環境で正しいバージョンの Node が選択されていることを確認してください。
nvm use
Yarn で依存関係をインストールします。
yarn
サーバーをビルドします。
yarn build
これにより、2 種類のサーバーが作成されます。
dist/server.js- テストおよびリモートデプロイ用の HTTP サーバーdist/stdio-server.js- Claude Desktop 用の stdio サーバー
使用方法
オプション 1:Claude Desktop(stdio)— 推奨
Claude Desktop でローカル利用する場合は、パフォーマンスと信頼性に優れた stdio 版を使用してください。
claude_desktop_config.json
{
  "mcpServers": {
    "searchcraft": {
      "command": "node",
      "args": [
        "/path/to/searchcraft-mcp-server/dist/stdio-server.js"
      ]
    }
  }
}
Claude Desktop の設定ファイルは、次の場所にあります。
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
ファイルが存在しない場合は、作成してください。
オプション 2:Claude Code
Claude Code で使用するには、CLI を使って MCP サーバーを設定します。
基本的なセットアップ:
# Add the Searchcraft MCP server to Claude Code
claude mcp add searchcraft -- node /path/to/searchcraft-mcp-server/dist/stdio-server.js
環境変数を使用する場合:
# Add with your Searchcraft cluster configuration
claude mcp add searchcraft \
  --env ENDPOINT_URL=https://your-cluster.searchcraft.io \
  --env CORE_API_KEY=YOUR_API_KEY \
  -- node /path/to/searchcraft-mcp-server/dist/stdio-server.js
設定スコープ:
--scope local(デフォルト):現在のプロジェクトでのみ利用できます--scope project:.mcp.jsonファイルを介してチームと共有されます(チームでの利用を推奨)--scope user:すべてのプロジェクトで利用できます
サーバーの管理:
# List configured servers
claude mcp list

# Check server status
/mcp

# Remove server
claude mcp remove searchcraft
オプション 3:Open WebUI(Pipelines 経由)
Open WebUI は、Pipelines フレームワークを通じて MCP サーバーをサポートしています。これには、MCP サーバーと Open WebUI を連携させるカスタムパイプラインを作成する必要があります。
ステップ 1:Searchcraft MCP HTTP サーバーを起動する
yarn start # Starts HTTP server on port 3100
ステップ 2:Open WebUI 用の MCP パイプラインを作成する
searchcraft_mcp_pipeline.py という名前のファイルを作成します。
"""
title: Searchcraft MCP Pipeline
author: Searchcraft Team
version: 1.0.0
license: Apache-2.0
description: A pipeline that integrates Searchcraft MCP server with Open WebUI
requirements: requests
"""

import requests
import json
from typing import List, Union, Generator, Iterator
from pydantic import BaseModel


class Pipeline:
    class Valves(BaseModel):
        MCP_SERVER_URL: str = "http://localhost:3100/mcp"
        ENDPOINT_URL: str = ""
        CORE_API_KEY: str = ""

    def __init__(self):
        self.name = "Searchcraft MCP Pipeline"
        self.valves = self.Valves()

    async def on_startup(self):
        print(f"on_startup:{__name__}")

    async def on_shutdown(self):
        print(f"on_shutdown:{__name__}")

    def pipe(
        self, user_message: str, model_id: str, messages: List[dict], body: dict
    ) -> Union[str, Generator, Iterator]:
        # This pipeline acts as a bridge between Open WebUI and your MCP server
        # You can customize this to handle specific Searchcraft operations

        # Example: If user mentions search operations, route to MCP server
        if any(keyword in user_message.lower() for keyword in ['search', 'index', 'document', 'searchcraft']):
            try:
                # Initialize MCP session
                init_payload = {
                    "jsonrpc": "2.0",
                    "id": 1,
                    "method": "initialize",
                    "params": {
                        "protocolVersion": "2025-06-18",
                        "capabilities": {},
                        "clientInfo": {"name": "open-webui-pipeline", "version": "1.0.0"}
                    }
                }

                response = requests.post(self.valves.MCP_SERVER_URL, json=init_payload)

                if response.status_code == 200:
                    # Add context about available Searchcraft tools
                    enhanced_message = f"""
{user_message}

[Available Searchcraft MCP Tools: create_index, delete_index, add_documents, get_search_results, list_all_indexes, get_index_stats, create_key, delete_key, and 20+ more tools for managing Searchcraft clusters]
"""
                    return enhanced_message

            except Exception as e:
                print(f"MCP connection error: {e}")

        return user_message
ステップ 3:Open WebUI にパイプラインをインストールする
-
管理パネルから:
- [Admin Settings]→[Pipelines]に移動します
- [Add Pipeline]をクリックします
- 上記のパイプラインコードを貼り付けます
- Searchcraft の設定でバルブを構成します:
MCP_SERVER_URL:http://localhost:3100/mcpENDPOINT_URL:Searchcraft クラスターの URLCORE_API_KEY:Searchcraft API キー
-
Docker 環境から:
# Save the pipeline to a file and mount it
docker run -d -p 3000:8080 \
  -v open-webui:/app/backend/data \
  -v ./searchcraft_mcp_pipeline.py:/app/backend/data/pipelines/searchcraft_mcp_pipeline.py \
  --name open-webui \
  ghcr.io/open-webui/open-webui:main
ステップ 4:Pipelines を使用するよう Open WebUI を設定する
-
Pipelines をサポートするよう Open WebUI を起動します:
# Using Docker Compose (recommended) services: openwebui: image: ghcr.io/open-webui/open-webui:main ports: - "3000:8080" volumes: - open-webui:/app/backend/data environment: - OPENAI_API_BASE_URL=http://pipelines:9099 - OPENAI_API_KEY=0p3n-w3bu! pipelines: image: ghcr.io/open-webui/pipelines:main volumes: - pipelines:/app/pipelines environment: - PIPELINES_API_KEY=0p3n-w3bu! -
Open WebUI の[Settings]→[Connections]で:
- OpenAI API URL を Pipelines インスタンスに設定します
- Searchcraft MCP Pipeline を有効にします
オプション 4:HTTP サーバー(テスト/リモートデプロイ用)
テスト、デバッグ、またはリモートデプロイ用に HTTP サーバーを起動します。
yarn start # Starts HTTP server on port 3100
HTTP サーバーを Claude Desktop で使用するには、mcp-remote が必要です。
claude_desktop_config.json
{
  "mcpServers": {
    "searchcraft": {
      "command": "npx",
      "args": [
        "mcp-remote",
        "http://localhost:3100/mcp"
      ]
    }
  }
}
オプション 5:Docker
Searchcraft MCP サーバーを Docker コンテナーで実行すると、簡単にデプロイでき、移植性も高まります。
Docker イメージをビルドする:
docker build --load -t searchcraft-mcp-server .
コンテナーを実行する:
docker run -it -p 8000:8000 \
  --name searchcraft-mcp-server \
  -e ENDPOINT_URL="https://your-cluster.searchcraft.io" \
  -e CORE_API_KEY="your_searchcraft_core_API_key" \
  searchcraft-mcp-server
サーバーをテストする:
# Health check
curl http://localhost:8000/health

# Test MCP endpoint
curl -X POST http://localhost:8000/mcp \
  -H "Content-Type: application/json" \
  -d '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"test","version":"1.0.0"}}}'
MCP Inspector によるリモート検査:
npx @modelcontextprotocol/inspector --transport http --server-url http://localhost:8000/mcp
Docker の設定:
- ベースイメージとして Node.js 22-slim を使用します
- デフォルトでポート 3100 を公開します(
PORT環境変数で変更可能) - SIGINT/SIGTERM でのグレースフルシャットダウンを自動的に処理します
- イメージサイズを最小限に抑え、本番環境向けに最適化されています
環境変数:
PORT- HTTP サーバーのポート(デフォルト:8000)ENDPOINT_URL- Searchcraft クラスターのエンドポイント URLCORE_API_KEY- Searchcraft API キーDEBUG- デバッグログを有効にします(任意)
利用可能なスクリプト
# Development
yarn dev          # Watch HTTP server
yarn dev:stdio    # Watch stdio server

# Production
yarn start        # Start HTTP server
yarn start:stdio  # Start stdio server

# Testing
yarn inspect      # Launch MCP inspector
yarn claude-logs  # View Claude Desktop logs
デプロイ方法の比較
| 機能 | stdio(推奨) | HTTP(ローカル) | Docker |
|---|---|---|---|
| パフォーマンス | ✅ 最良(直接 IPC) | ⚠️ HTTP のオーバーヘッド | ✅ 良好 |
| セキュリティ | ✅ ポートを公開しない | ⚠️ ネットワークポートが必要 | ✅ 隔離された環境 |
| セットアップの複雑さ | ✅ 簡単 | ⚠️ ポート管理が必要 | ✅ 簡単(1 コマンド) |
| Claude Desktop | ✅ ネイティブサポート | ⚠️ mcp-remote が必要 | ⚠️ mcp-remote が必要 |
| Claude Code | ✅ ネイティブサポート | ✅ 対応 | ✅ 対応 |
| Open WebUI | ❌ 非対応 | ✅ Pipelines 経由 | ✅ Pipelines 経由 |
| リモートデプロイ | ❌ ローカルのみ | ✅ 可能ですが、手動での設定が必要 | ✅ 簡単にコンテナ化 |
| テスト | ⚠️ MCP ツールが必要 | ✅ curl で簡単 | ✅ curl で簡単 |
| 複数のクライアント | ❌ 一度に 1 つ | ✅ 同時アクセス可能 | ✅ 同時アクセス可能 |
| 移植性 | ⚠️ Node.js が必要 | ⚠️ Node.js が必要 | ✅ どこでも実行可能 |
stdio を使用する場合:
- Claude Desktop または Claude Code をローカルで使用する場合
- 最高のパフォーマンスを求める場合
- プロセス間の直接通信を優先する場合
HTTP(ローカル)を使用する場合:
- HTTP インターフェースをテスト/デバッグする必要がある場合
- カスタム統合を開発する場合
- 複数のローカルクライアントからの同時接続が必要な場合
Docker を使用する場合:
- リモートデプロイが必要な場合
- 簡単で再現可能なセットアップを求める場合
- クラウドプラットフォームにデプロイする場合
- 分離とセキュリティを求める場合
- 検査用にサーバーを公開する必要がある場合
テスト
Searchcraft MCP Server には、Vitest で構築された包括的なテストスイートが含まれています。
テストの実行
# Run all tests
npm test

# Run tests in watch mode
npm run test:watch

# Run tests with coverage
npm run test:coverage

# Show test reports
npm run test:ui
テストカバレッジ
- ✅ 89 件のテストでコア機能を網羅
- ✅ ヘルパーとユーティリティのカバレッジ 84% 以上
- ✅ JSON アナライザーのカバレッジ 93% 以上
- ✅ サーバー作成のカバレッジ 100%
- ✅ HTTP エンドポイントの統合テスト
- ✅ すべての主要コンポーネントのユニットテスト
詳しいテストのドキュメントについては、test/README.md を参照してください。
デバッグ
Claude Desktop のログ
MCP 接続のデバッグ用に Claude Desktop のログを表示するには:
yarn claude-logs
MCP Inspector を使用したテスト
MCP Inspector を使用すると、サーバーのツールを対話的にテストできます。
stdio サーバーの場合(推奨):
yarn inspect
- Transport Type を選択:stdio
- Command:
node dist/stdio-server.js
HTTP サーバーの場合:
yarn start  # Start HTTP server first
yarn inspect
- Transport Type を選択:Streamable HTTP
- URL:
http://localhost:3100/mcp
手動テスト
HTTP サーバーをテスト:
# Health check
curl http://localhost:3100/health

# Test MCP endpoint
curl -X POST http://localhost:3100/mcp \
  -H "Content-Type: application/json" \
  -d '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"test","version":"1.0.0"}}}'
stdio サーバーをテスト:
echo '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"test","version":"1.0.0"}}}' | node dist/stdio-server.js
リソース
- 📘 Searchcraft のドキュメント
- 🛰️ Vektron ダッシュボード
- 💬 Searchcraft の Discord
- 🧠 Searchcraft の Reddit
- 🧪 npm の Searchcraft SDK
問題と機能リクエスト
https://github.com/searchcraft-inc/searchcraft-issues にアクセスしてください。
ライセンス
Apache 2.0 License の下でライセンスされています。
🛰️ Searchcraft チームが開発
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。