tokenmizer について
TokenMizerは、セッションを検索可能なグラフに変換するLLMアプリ向けローカルプロキシです。コンテキストウィンドウが埋まると関連情報を復元し、ファイル分析やキャッシュ、MCPツールによるグラフ操作も提供します。
主な機能
- 01関係とライフサイクルを持つセッショングラフ
- 02ウィンドウ枯渇時のコンテキスト復元
- 03ファイル分析
- 04応答キャッシュとトークン節約の計測
- 05複数のセッション領域に対応
活用シーン
- 01新しいセッションでプロジェクトの決定事項を再開
- 02決定と変更理由の経緯を追跡
- 03MCP経由でグラフや節約量を確認
- 04大きなファイルを分析
MCP 対応
TokenMizerは、セッションのチェックポイントと再開、グラフ・節約統計、ファイル分析、決定理由の追跡を行うツールを備えたMCPサーバーです。プロキシが稼働していなくても、ツールからグラフを直接操作できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
5掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| notes | string | いいえ | 完了した作業に関する任意のメモ |
| session_id | string | はい | このセッションの一意の識別子(例:'my-project-auth') |
詳細
TokenMizer
AI は理由を忘れます。TokenMizer が覚えておきます。
OpenAI 互換のプロキシです。セッションのナレッジグラフ(決定事項、ファイル、エラー、目標など)を構築し、
コンテキストウィンドウがいっぱいになると、内容を再現します。要約ではありません。「MongoDB から PostgreSQL に切り替えた。その理由はこれです」と把握できる、クエリ可能なグラフです。
導入は一行 · Claude、GPT、Gemini、Grok、DeepSeek、Mistral、Cohere、Ollama に対応 · MIT




クイックスタート · 動作を見る · Claude Code と MCP · ベンチマーク · アーキテクチャ · ロードマップ
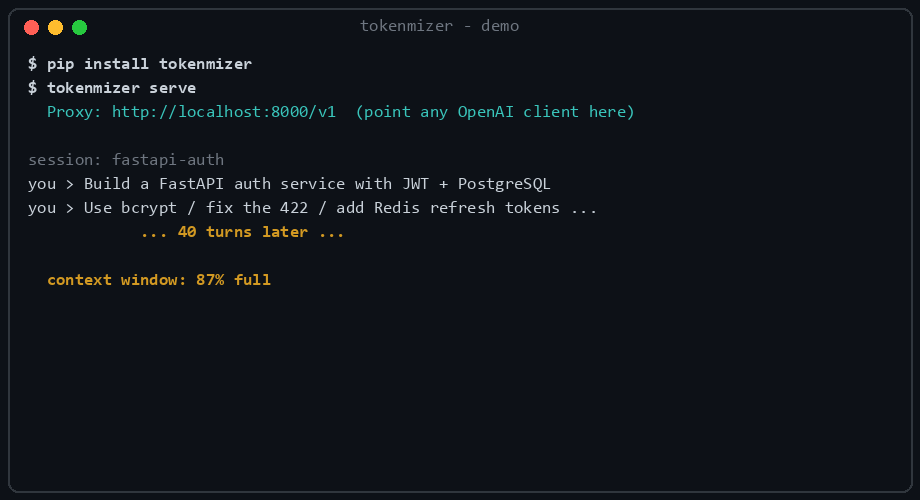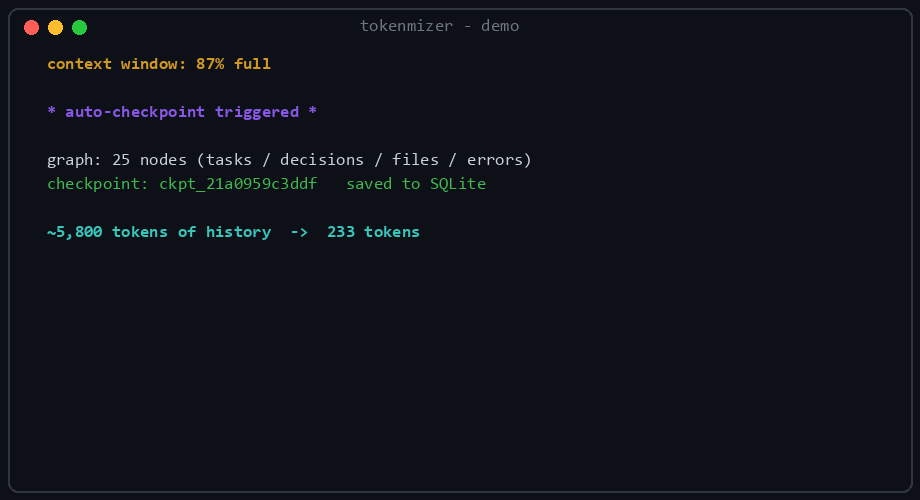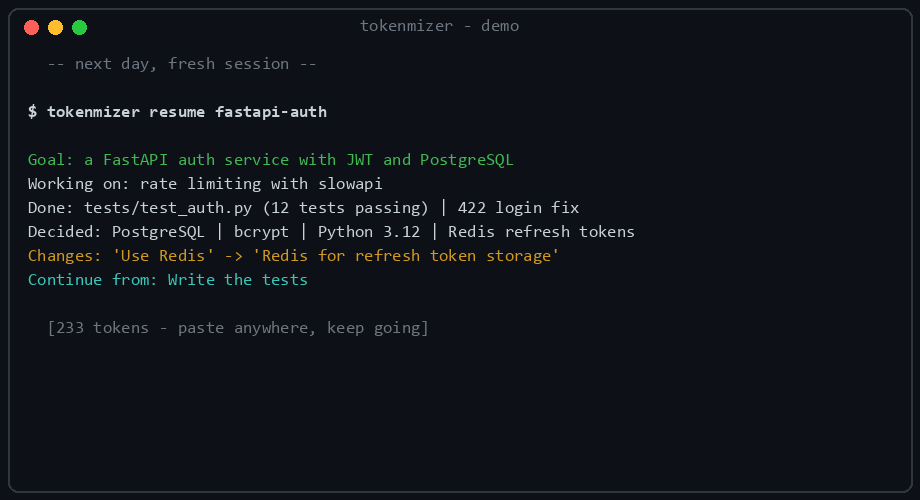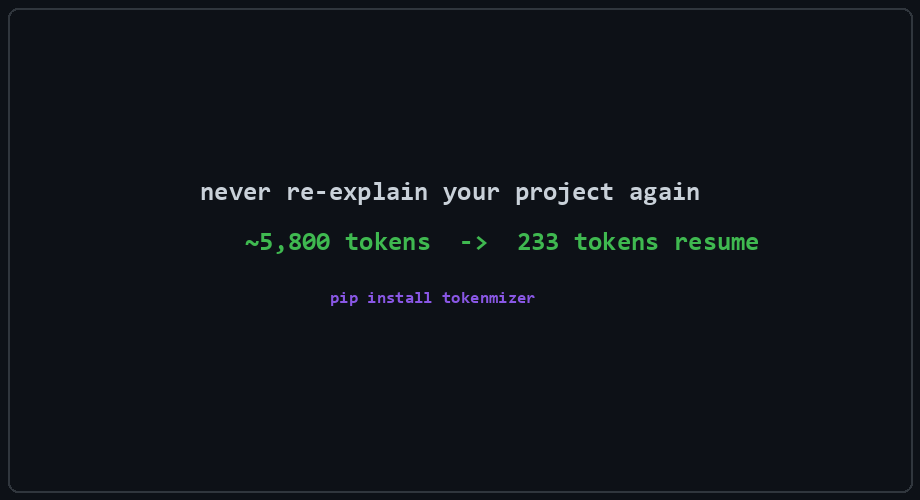
実行例:25 ノードのグラフ、チェックポイント
ckpt_21a0959c3ddf、233 トークンで再開。python scripts/gen_demo_gif.py で再生成できます。
問題
AI の各セッションにはコンテキストの上限があります。その上限に達すると、モデルは何時間もかけて積み重ねたあらゆる決定事項とその理由を忘れてしまいます。そのため、次のセッションの最初の 10 分間を費やして、プロジェクトについて説明し直すことになります。
履歴を要約しても解決にはなりません。要約は「何が」決まったかは伝えますが、「なぜ」決まったかを失い、却下した案も失われます。そのため、モデルは 3 セッション前に見送った案を平気で再提案してしまいます。
クイックスタート
pip install "tokenmizer[anthropic,cache]"
export TOKENMIZER_ANTHROPIC_API_KEY=sk-ant-...
tokenmizer serve
次に、クライアントで1行変更します。
from openai import OpenAI

client = OpenAI(
    api_key="your-key",
    base_url="http://localhost:8000/v1",   # only this changes
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-6",
    messages=[{"role": "user", "content": "Continue where we left off"}],
    extra_body={"session_id": "my-project"},   # optional, enables memory
)
それ以外はすべて変わりません。同じリクエスト形式、同じレスポンス形式に、保存された内容を示す tokenmizer ブロックが加わります。http://localhost:8000 を開けば、セッションがすでに表示されています。
Windows、Ollama、Docker、および手順の詳細
Windows(PowerShell)
$env:TOKENMIZER_ANTHROPIC_API_KEY = "sk-ant-..."   # this session
setx TOKENMIZER_ANTHROPIC_API_KEY "sk-ant-..."     # persistent
API キーがありませんか? Ollama はローカルで無料で実行できます。
ollama pull llama3
pip install tokenmizer
# then set `provider: ollama` in tokenmizer.yaml
Docker
docker compose up -d
すべてのプロバイダーの環境変数を含む詳しいインストール手順と、設定のリファレンスは、 docs/configuration.md および docs/deployment.md をご覧ください。
実際の画面を見る
ここにあるものはモックアップではありません。以下のスクリーンショットとデモはすべて、リリース済みの UI が benchmarks/eval/corpus 内のラベル付きコーパスからセッションを表示したものです。
セッショングラフは、操作できるページであり、単なる画像ではありません
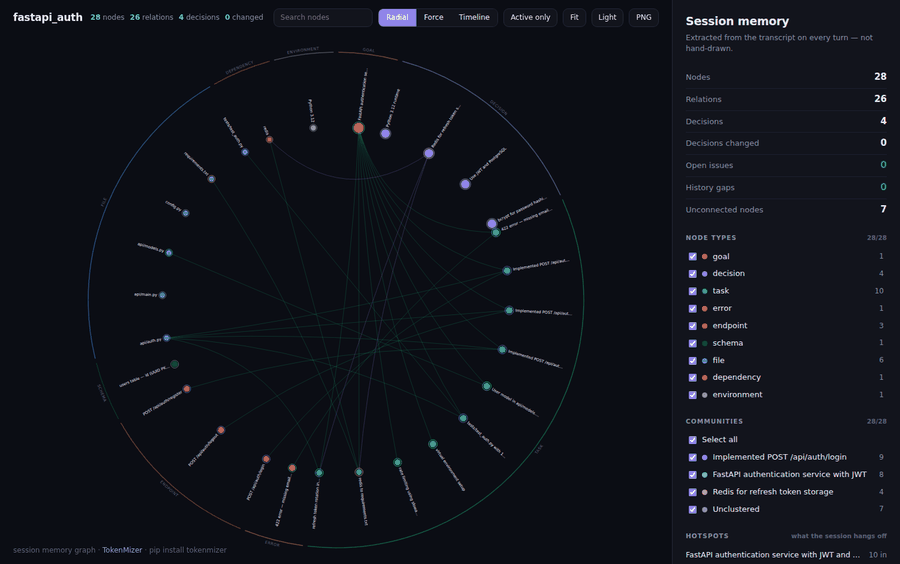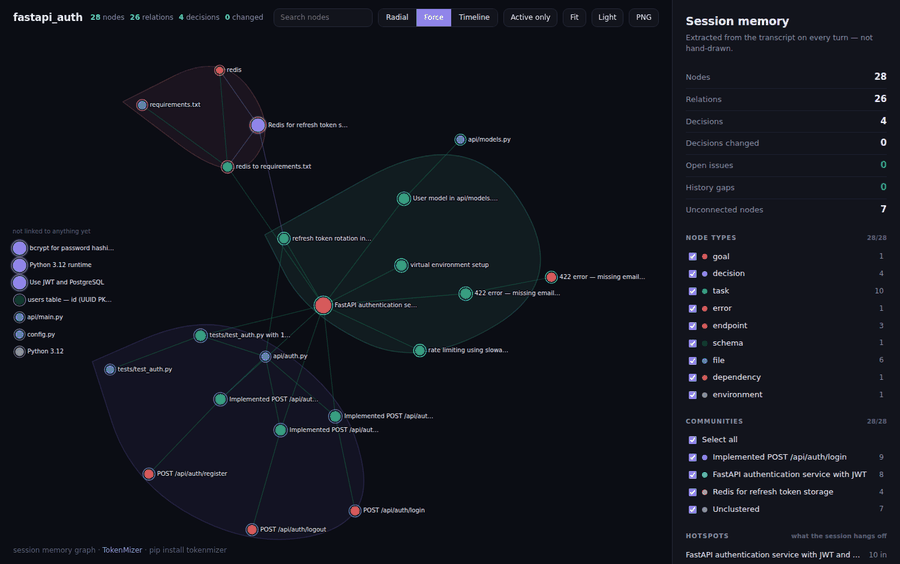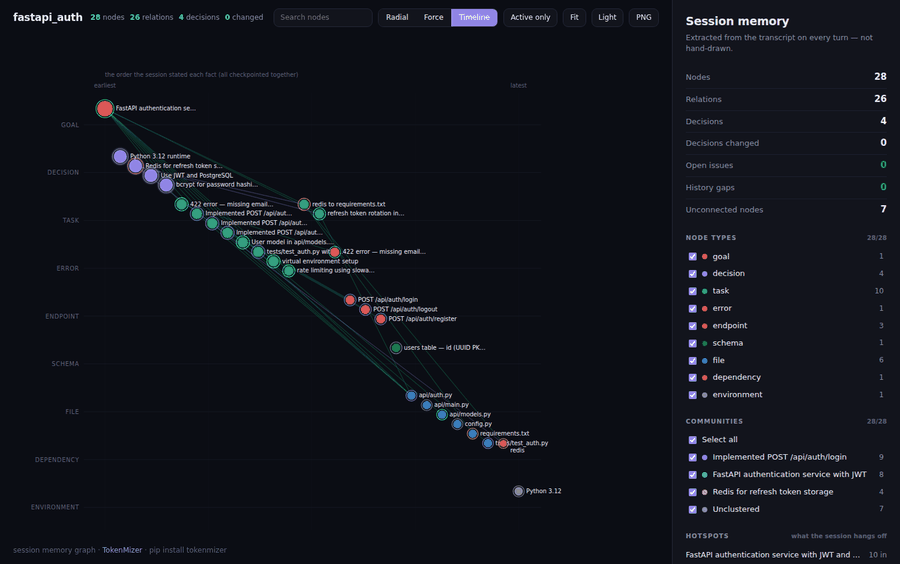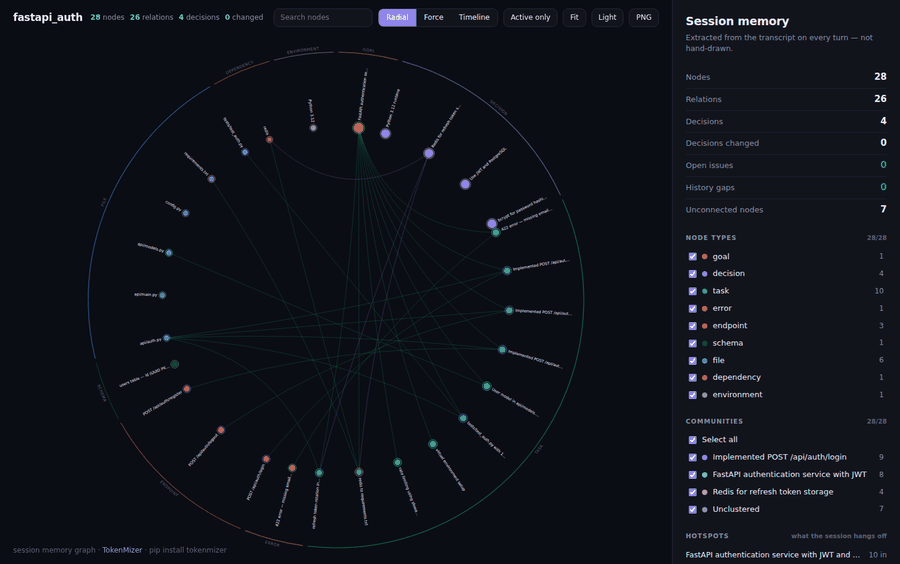
放射状 → ノードを選択 → フォース → タイプをフィルター → タイムライン → ライトテーマ。
python scripts/gen_graph_demo.py で再生成できます。
ノードを選択すると、そのタイプ、ステータス、コミュニティ、重要度、信頼度、初回確認日、そしてノードが持つすべての関係が表示されます。事実だけでなく、その事実の出典も確認できます。タイプやコミュニティでフィルターすると、件数も連動して変わります。3種類のレイアウト、ライトテーマ、PNG エクスポートは、それぞれワンクリックで利用できます。
これは外部へのリクエストを行わない、自己完結型の HTML ファイル1つです。オフラインで開けて、file:// URL からも動作するため、TokenMizer をインストールしたことのない相手にも送れます。
ダッシュボードには、実際に把握している内容が表示されます
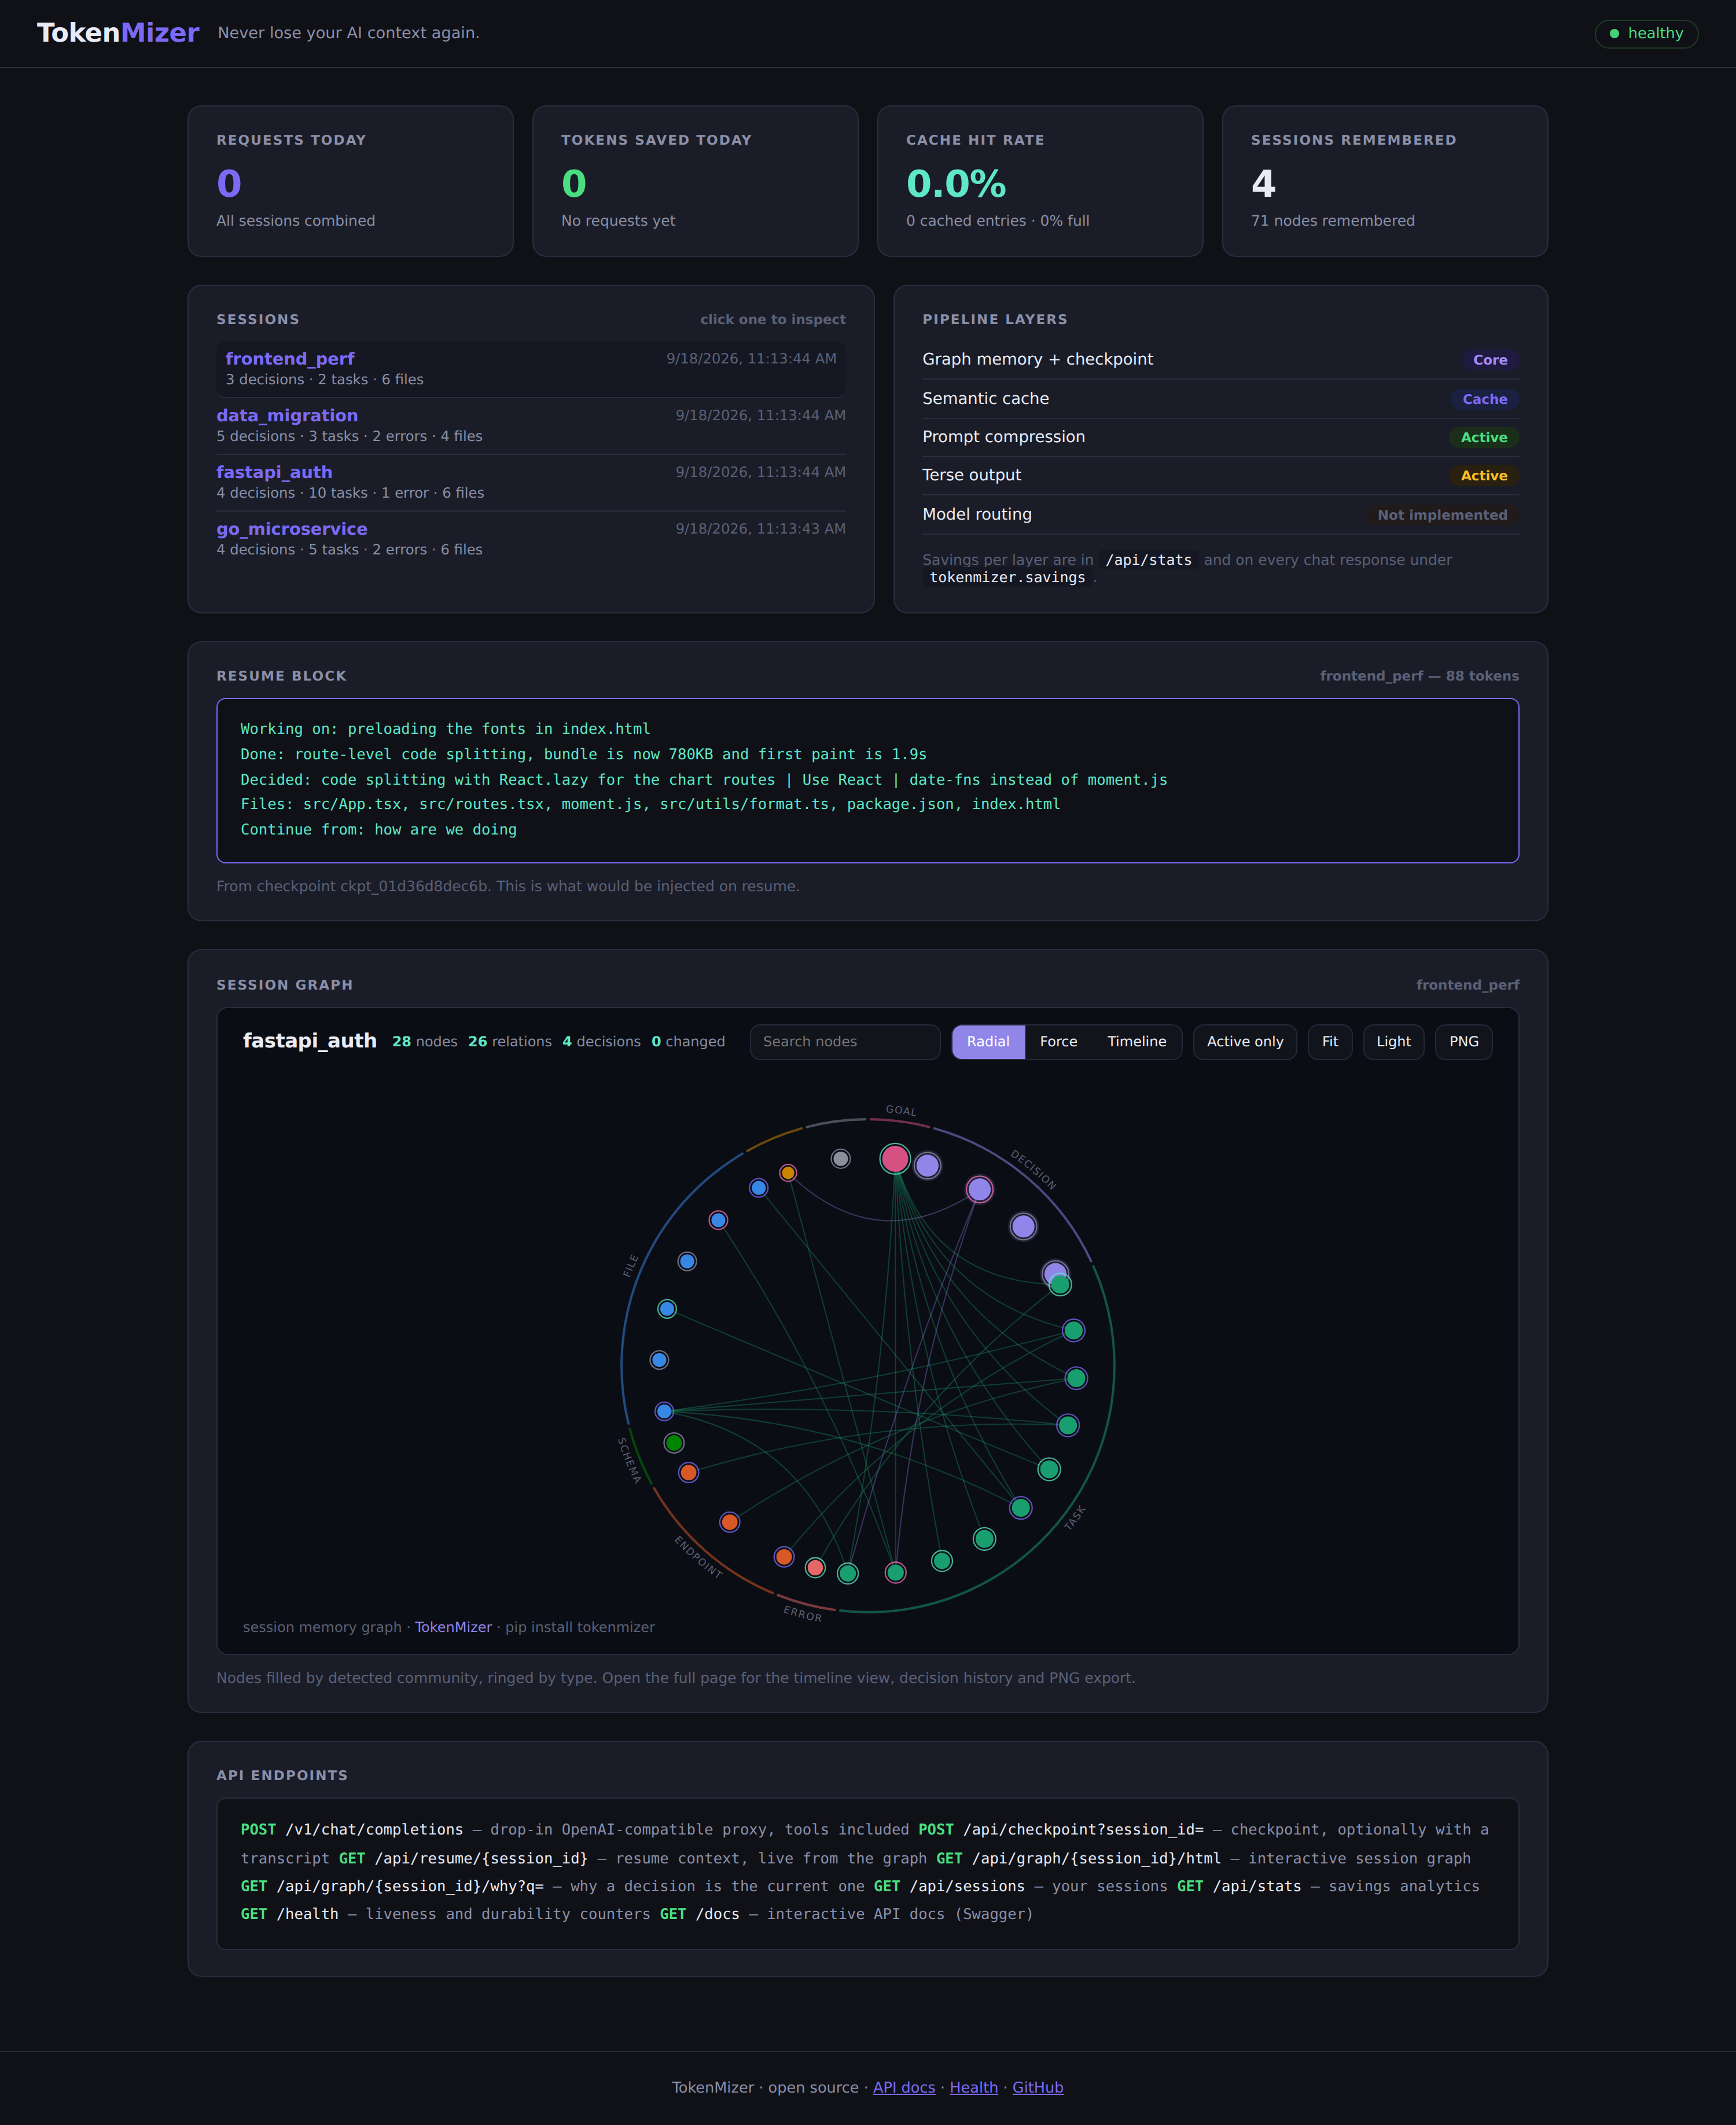
セッション、それぞれが今挿入する現在の再開ブロック、そしてそのグラフが表示されます。サンプルではありません。ヘルスピルは /health を読み込み、書き込みに失敗した場合は、何が起きても ok と表示するのではなく、カウンターとともに degraded を報告します。
グループ分けされたセッショングラフ
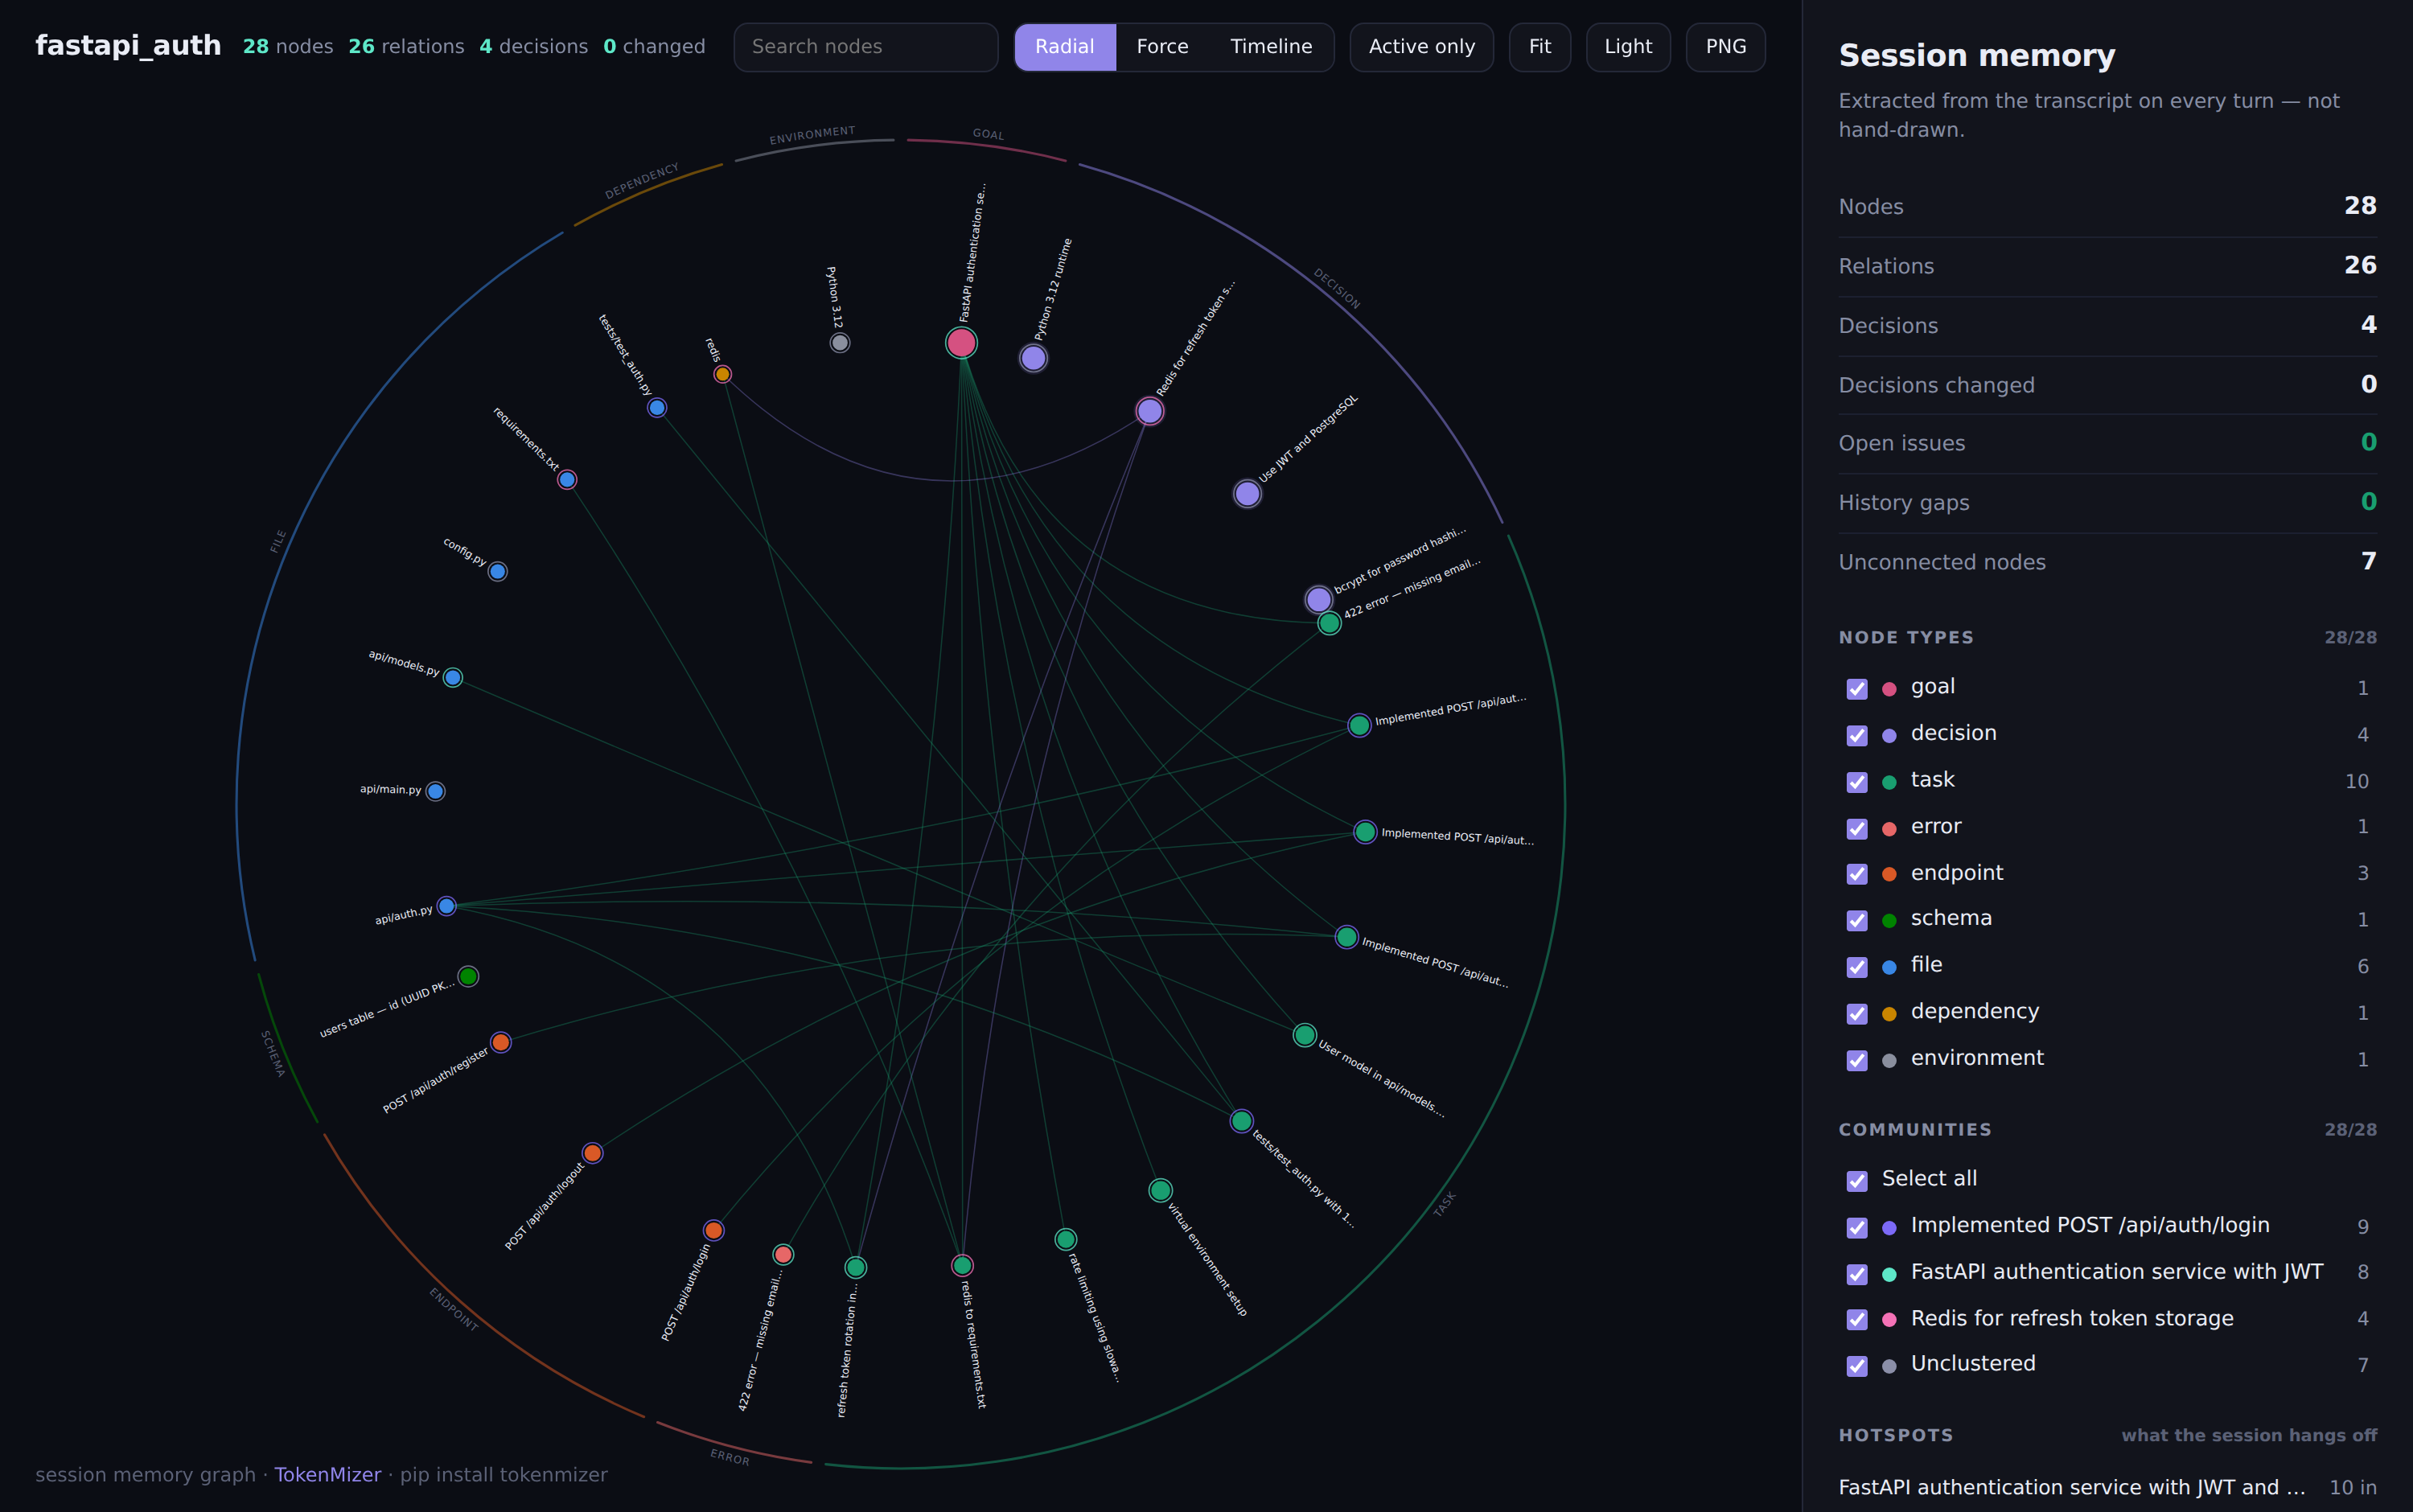
ノードタイプごとに円の独自の円弧が割り当てられ、リング上に名前が表示されます。関係は中央を通る弦として弧を描いて表示されるため、ラベルを1つも読まなくてもセッションの形が分かり、ノードのタイプは色合いの違いではなく、配置場所から判断できます。配色は目視ではなく、バリデーターで検査されています。隣り合う色の組み合わせはすべて色覚差に関する基準を満たし、それ自体に意味を持たない4種類のタイプには、共通のニュートラルなグレーが使われています。
横のパネルには、セッションで把握している内容と不足している内容(未解決の課題、変更された決定、履歴の欠落、未接続のノード)がカウントされ、検出されたコミュニティ、すべての情報が集まるホットスポット、各種ノードがどのノードを指しているかが一覧表示されます。タイプやコミュニティでフィルターしたり、検索したり、ノードをクリックしてその背後にある置き換えの連鎖を確認したりできます。
ストーリーとしての同じセッション
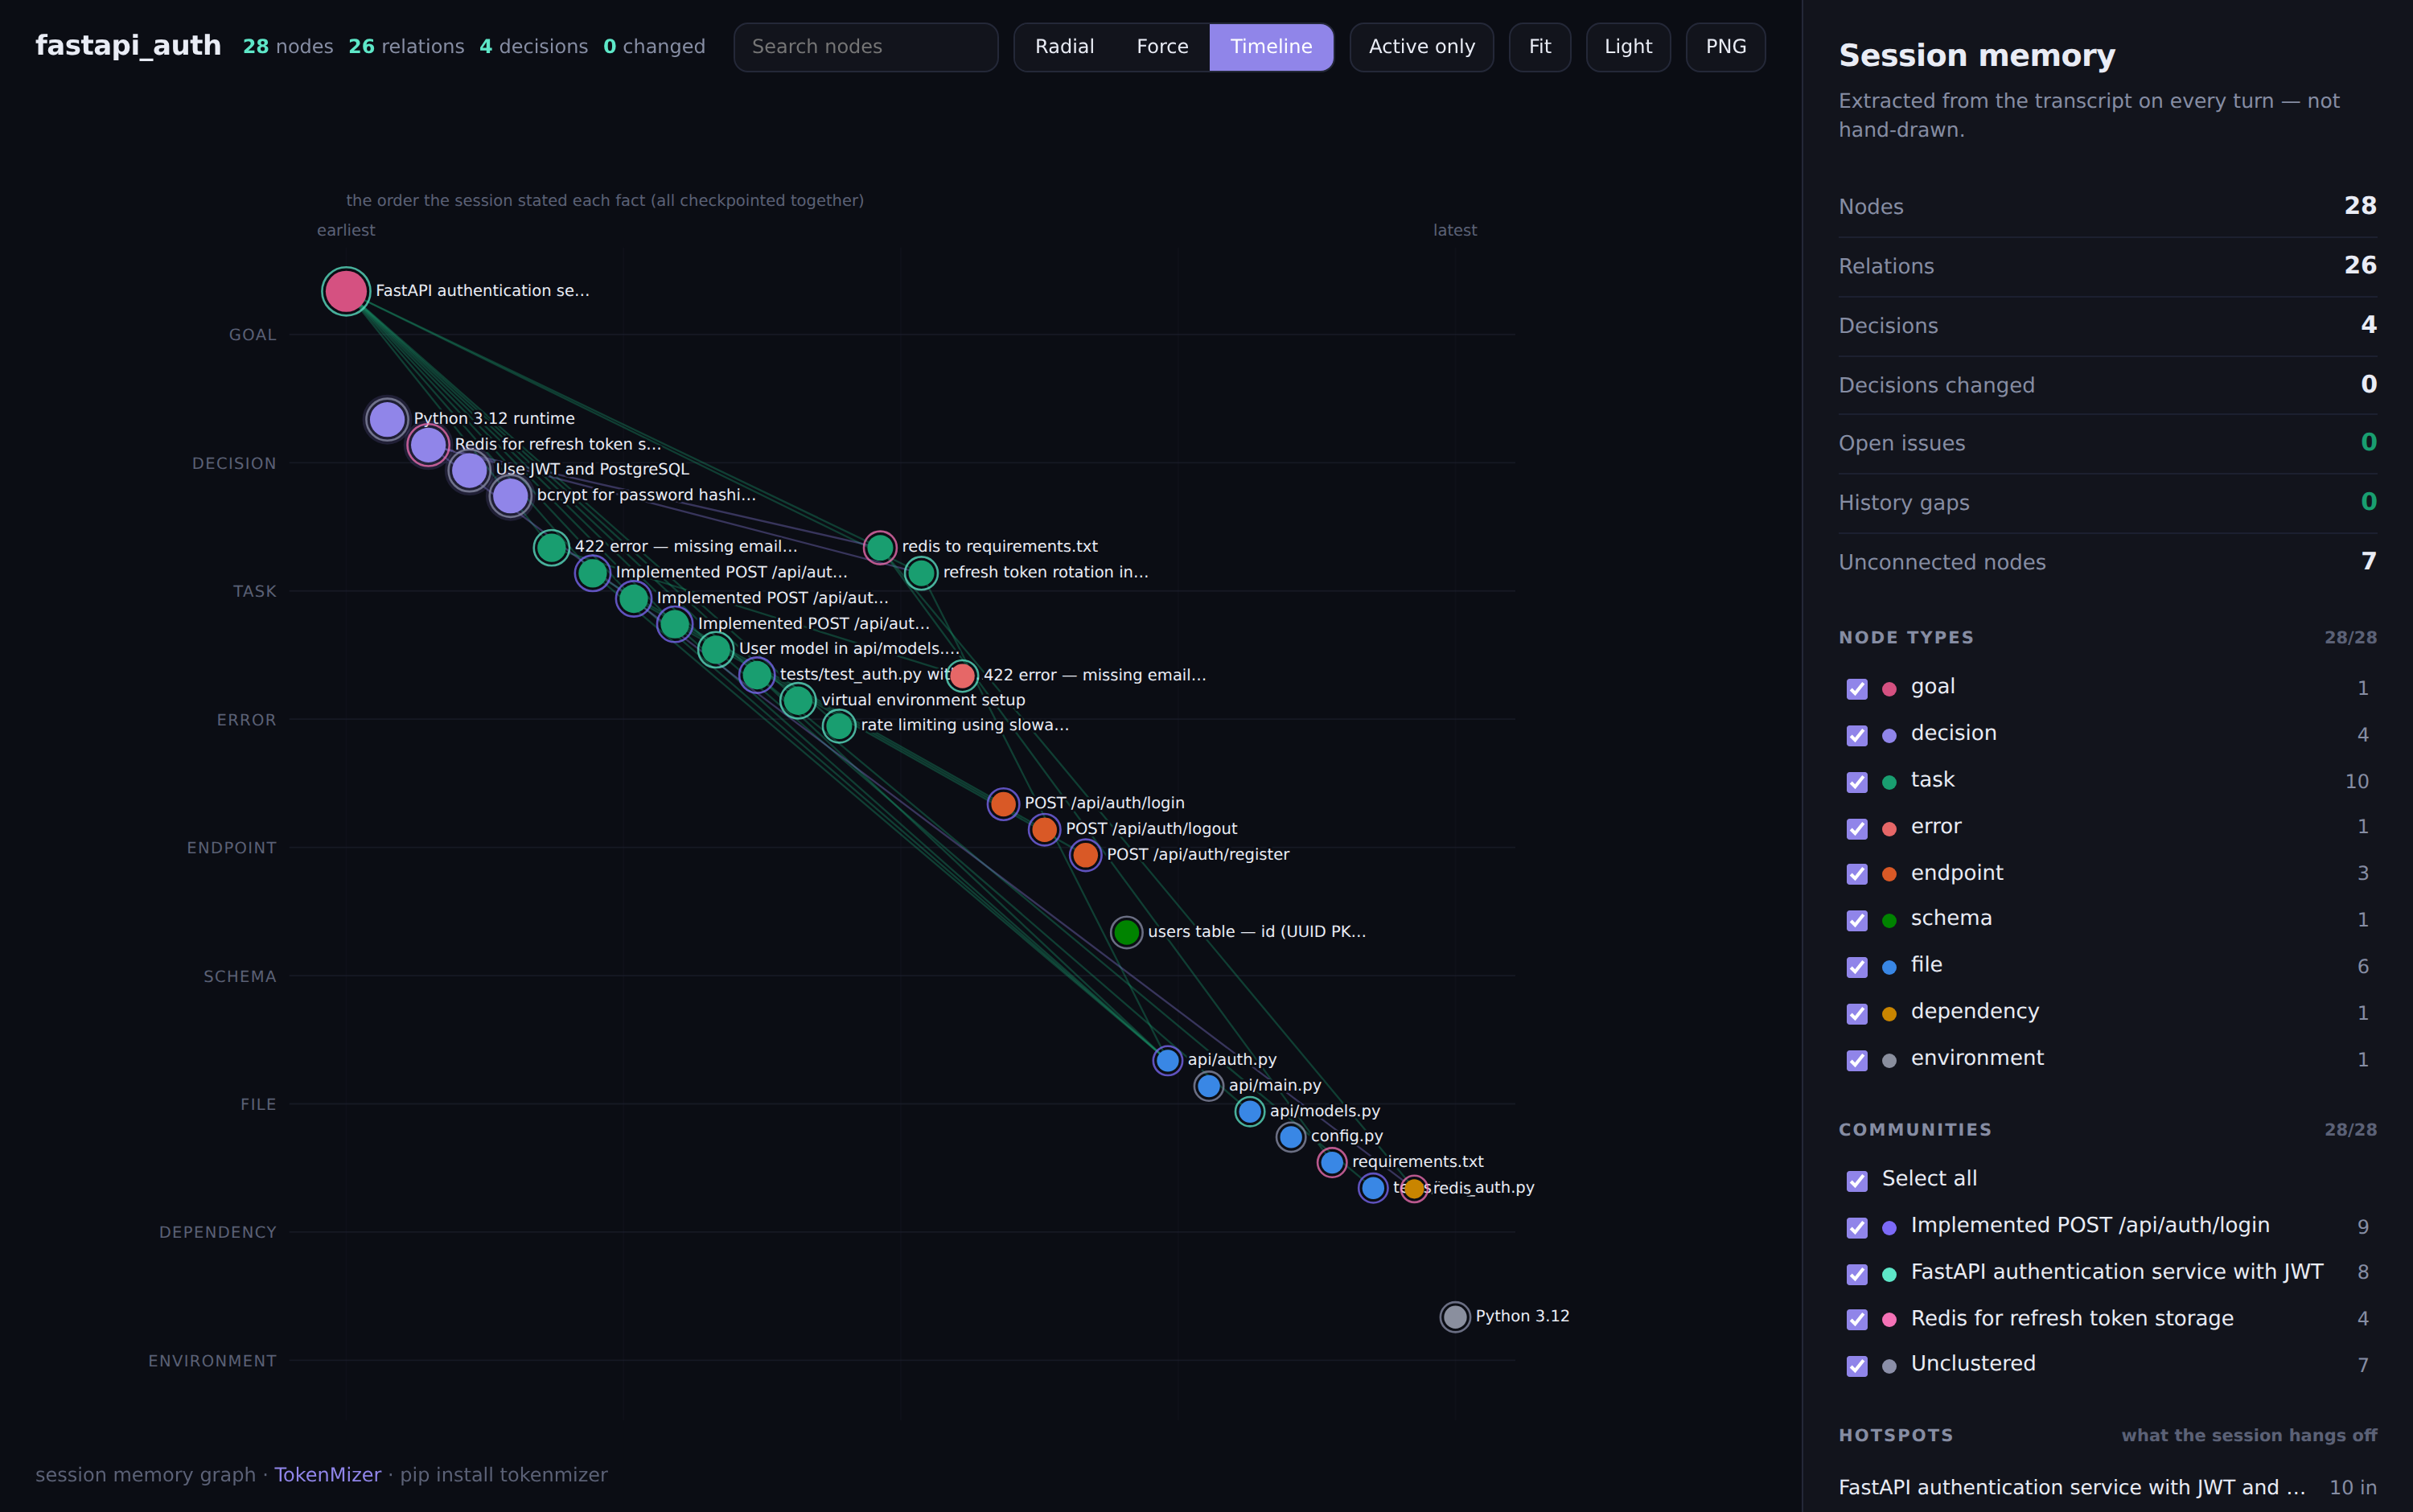
タイムラインモードでは、各ノードタイプが独自のレーンに配置され、その事実がセッションに加わった順に並び、置き換えは弧で示されます。会話記録全体が一度の呼び出しでチェックポイントとして保存された場合、すべてのノードが同じタイムスタンプを共有するため、軸にもその旨が示されます。日付をでっち上げるのではなく、セッション内で述べられた順序に切り替わります。
仕組み
TokenMizer は、アプリとあらゆる LLM の間に置かれるローカルプロキシです。すべてのリクエストはパイプラインを通り、ライブのナレッジグラフを構築し、入力を圧縮し、応答をキャッシュし、コンテキストが尽きる前にチェックポイントを保存します。
flowchart LR
    App["Your app<br/><sub>OpenAI-compatible client</sub>"]
    subgraph TM["TokenMizer :8000"]
        direction TB
        L0["<b>L0</b> File intelligence"]
        L1["<b>L1</b> Prompt compression"]
        L2["<b>L2</b> Terse-output injection"]
        L4["<b>L4</b> Graph memory<br/><sub>extract to window to inject</sub>"]
        L3["<b>L3</b> Semantic cache"]
        L5["<b>L5</b> Provider prompt cache"]
        L0 --> L1 --> L2 --> L4 --> L3 --> L5
    end
    LLM["Claude · GPT · Gemini<br/>Grok · DeepSeek · Ollama"]
    DB[("SQLite<br/><sub>graph · checkpoints · ownership</sub>")]

    App -->|"POST /v1/chat/completions"| TM
    TM --> LLM
    LLM -.->|response| TM
    TM -.->|"response + savings"| App
    L4 <-->|"per-row, locked"| DB
グラフは要約ではありません。決定、タスク、ファイル、エラー、目標といった型付きのノードとエッジにライフサイクルが備わっています。そのため、置き換えられた決定は削除されずに置き換え済みとして記録され、何がきっかけとなったかもその移行に記録されます。再開ブロックはそこから絞り込んだ投影です。現在有効な決定、未完了の作業、未解決のエラーを、数百トークンにまとめます。
エッジは、セッションに実際に存在する関係を表します。バグを修正したタスクはエラーノードをFIXESし、そのエラーをクローズします。未解決のエラーは、それに関するタスクをBLOCKSします。決定は、その決定で言及されたパッケージにDEPENDS_ONします。上記のコミュニティはこれらの関係から検出され、/whyはこれらをたどります。
アーキテクチャ — リクエストの流れ、データモデル、決定のライフサイクルをご覧ください。
再開時の表示例
Goal: FastAPI authentication service with JWT and PostgreSQL
Working on: refresh token rotation in api/auth.py | rate limiting using slowapi
Done: Implemented POST /api/auth/login | Fixed the 422 in LoginRequest | User model in api/models.py
Decided: Use JWT and PostgreSQL | bcrypt for password hashing | Redis for refresh token storage
Changes: 'Use moment.js' -> 'Use date-fns' - tree-shakeable, saves 230KB
Files: api/auth.py, api/models.py, config.py, tests/test_auth.py
Continue from: Add rate limiting to auth endpoints
会話全体の代わりに、数百トークンで済みます。要約では失われてしまうのがChanges:の行です。また、GET /api/graph/{session_id}/why?q=date-fnsを使うと、きっかけ、理由、各段階の証拠を含む一連の流れを完全に再現できます。
プロジェクトだけでなく、習慣も
セッショングラフが記憶するのは、このプロジェクトについて決めたことです。短い回答を好むといったことは記憶しません。それはリポジトリではなく、あなた自身についての情報であり、別の場所でセッションを始めても引き継がれる必要があります。
preferences:
  enabled: true      # off by default; read the note before turning it on
これを有効にすると、「TypeScript が好みです。回答は簡潔にしてください」といったターンが、プリンシパルごとに記憶され、数行のシステムプロンプトとして挿入されます。/api/preferences(GET)では、記憶された内容と挿入される正確なテキストを確認できます。同じパスでDELETEと?key=...を指定すると1件を削除でき、キーを指定しないとすべて削除されます。
意図的にデフォルトでは無効になっています。 設定の記憶における失敗は、忘れてしまうことではありません。実際には設定ではなかったことを設定として記憶し、その後1年にわたって送信するすべてのプロンプトで繰り返すことです。検出には正規表現を使用しているため、誤検出が起こる可能性があります。だからこそ上記のエンドポイントがあり、意図的に有効にする必要があります。
コーディング以外のセッションにも
domainを設定すると、同じ5つの形状を別の語彙で読み取ります。インシデント対応チャンネルで「決定事項:」と言う人はいませんし、研究ログで「修正:」と言う人もいません。そのため、これらのセッションは以前、ほとんど何も抽出されませんでした(マクロ F1 は11%、決定とエラーは0%)。
domain: ops # coding (default) · research · ops · product
Incident: We are seeing an incident on the pricing service, checkout is failing
Mitigating: Still monitoring the replica lag | Follow-up to add a pool-size alert
Done: Restarted the pool workers and rolled back to build 4471 | Traffic is recovered
Decided: Root cause is connection pool exhaustion after the 14:02 deploy
Symptoms: Error rate is 34 percent and p99 latency jumped to 8 seconds
benchmarks/eval/corpus_domainsのラベル付きセッションでは**11%から93%**に向上し、コーディングコーパスには変更がありません。パックのパターンはコーディング用パターンの後に実行され、追加することしかできません。手書きのセッションは3つだけなので、一般化を主張するものではなく、「このような形のセッションで仕組みが機能する」と捉えてください。ベンチマークにも同様の説明があります。
ツールから使う
作業環境に応じて、4つの方法で利用できます。どれを使っても同じグラフに接続するため、Claude Codeでチェックポイントを保存したセッションをCLIで再開できます。
Claude Code — プラグイン
/plugin marketplace add Shweta-Mishra-ai/tokenmizer
/plugin install tokenmizer@Shweta-Mishra-ai/tokenmizer
その後、任意のセッションで次を実行します。
/tokenmizer:checkpoint my-project      save the session to graph memory
/tokenmizer:resume my-project          load it back (~300 tokens)
/tokenmizer:analyze data/sales.csv     digest a large file
/tokenmizer:stats                      token savings report
Claude Desktop、Cursor、VS Code、Zed — MCP サーバー
{
  "mcpServers": {
    "tokenmizer": {
      "command": "tokenmizer-mcp",
      "env": { "TOKENMIZER_URL": "http://localhost:8000" }
    }
  }
}
| クライアント | 設定場所 |
|---|---|
| Claude Desktop(macOS) | ~/Library/Application Support/Claude/claude_desktop_config.json |
| Claude Desktop(Windows) | %APPDATA%\Claude\claude_desktop_config.json |
| Claude Code | プロジェクト内の .mcp.json、または ~/.claude/settings.json |
| Cursor | Settings、MCP、Add server、同じ JSON |
| VS Code / Zed | 各クライアントの MCP 設定、同じ command と env |
| Codex CLI | ~/.codex/config.toml — TOML 形式です。docs/api.md を参照してください |
設定後、クライアントを再起動してください。ほかに起動するものはありません。
tokenmizer serve が実行されていない場合でも、checkpoint_session、resume_session、get_graph_stats、why_decision、analyze_file はすべてグラフを直接読み書きし、どのパスが応答したかを伝えます。プロキシが必要なのは節約量の計測だけです。節約量はプロキシを通過したリクエストを対象に測定されるためです。tokenmizer-mcp が PATH にない場合は、"command": "python", "args": ["-m", "tokenmizer.mcp.server"] を使用してください。
6 つのツール: checkpoint_session、resume_session、get_graph_stats、get_savings_stats、analyze_file、why_decision。エージェントに 「なぜ X を選んだの?」 と尋ねると、理由と根拠を各段階について示しながら、置き換えの連鎖をたどります。
それ以外 — プロキシ
base_url を http://localhost:8000/v1 に設定すれば、OpenAI 互換クライアントを利用できます。上記のクイックスタートと同じ方法です。Continue.dev、Aider、LangChain、LlamaIndex、あらゆる言語の OpenAI SDK、curl が対象です。
ツール呼び出しにも対応しています。 OpenAI 形式の tools / tool_choice を送信すると、ストリーミングの有無にかかわらず message.tool_calls が返され、role: "tool" の結果がモデルに往復します。
resp = client.chat.completions.create(
    model="claude-sonnet-4-6",
    messages=[{"role": "user", "content": "weather in Pune?"}],
    tools=[{"type": "function", "function": {
        "name": "get_weather",
        "parameters": {"type": "object", "properties": {"city": {"type": "string"}}}}}],
    extra_body={"session_id": "my-project"},
)
call = resp.choices[0].message.tool_calls[0]     # finish_reason == "tool_calls"
OpenAI、DeepSeek、Mistral、OpenRouter、Grok ではネイティブ対応し、Anthropic、Ollama、Gemini、Cohere では変換して対応します。9 つすべてのプロバイダーで、ストリーミングの有無を問わず対応します。プロバイダーがツール呼び出しを分割して送る場合(Anthropic、Cohere)でも、まとめて送る場合(Ollama、Gemini)でも、それぞれのツール呼び出しは OpenAI 形式の差分としてストリームに届きます。ツールの通信は圧縮されず、ツール呼び出しのターンがキャッシュされることもありません。
API と CLI のリファレンス — すべてのエンドポイント、すべてのコマンド、すべての MCP ツール。
エージェント内で直接使用 — サーバー不要
メッセージをすでに管理しているエージェントループでは、メモリを直接使用します。プロキシも API キーもネットワークも不要です。プロキシが使用するものと同じ SQLite ストアなので、エージェントとプロキシでセッションを共有できます。
from tokenmizer.agents import Memory

memory = Memory("order-service")          # default: the working directory name
memory.add(messages)                      # {"role", "content"} dicts; idempotent
memory.search("what are we storing orders in", top_k=5)
memory.context(token_budget=400)          # resume block for the system prompt
memory.why("postgres")                    # the decision trail
search は通常の dict(type、label、summary、status、confidence)を返します。decisions() と errors() はそれぞれのカテゴリを一覧表示します。LangGraph、CrewAI、AutoGen、自作のループのいずれでも同じように使えます。これまでの会話を add に渡し、context() をシステムプロンプトに含めてください。
測定結果
python -m benchmarks.eval は、14 セッション(うち 6 つは実際のトランスクリプト)にラベルを付けたコーパスを使って抽出精度を評価します。
| カテゴリ | 適合率 | 再現率 | F1 |
|---|---|---|---|
| ファイル | 100% | 100% | 100% |
| 決定事項 | 97% | 100% | 99% |
| 完了したタスク | 98% | 98% | 98% |
| 保留中のタスク | 100% | 90% | 95% |
| エラー | 93% | 96% | 94% |
| マクロ F1 | 97% |
再現率だけでなく、適合率も報告しています。 トランスクリプト全体を 1 つのノードとして出力する抽出器でも、再現率は 100% になります。そのため、再現率だけに基づく抽出値は信頼すべきではありません。以前の私たちの値も例外ではありません。
手書きのテストデータは実際のトランスクリプトより簡単で、全体の単一の数値ではその差が見えないため、データの由来ごとに個別に評価しています。合成データは 98%、実データは 91% です。実際のセッションを表す数値としては、91% を基準にしてください。n=14 は小規模なサンプルであり、すべてのラベルを同じ人が作成しています。
検索性能は個別に測定しています。 python -m benchmarks.graph_retrieval.query_eval は、ノード自身の言葉ではなく、人が実際に尋ねるような表現の質問に対して query() が返す内容を評価します。キーワードランキングのみで、40件のケースにおける recall@6 は88% です。このブランチ以前は評価対象が13件だったため、1件の結果が変わるだけで公表値が8ポイント動いていました。根拠のない質問では情報抽出の性能を測ることになり、検索の失敗としていつまでも誤って評価されるため、各ケースについて、それぞれの文字起こしから回答可能であることを確認しています。semantic_retrieval: auto は、モデルが実際に読み込まれた場合に埋め込み類似度を有効にします。以前公表した92%という数値は評価対象を拡大する前のもので、再測定はしていません。
入力コストはエンドツーエンドで測定しています。 python -m benchmarks.savings.runner は、Anthropic が公開しているプロンプトキャッシュのルールを適用する代替環境に対して、実際のプロキシ経由で会話を再生します。キャッシュを使わずに履歴を送信するクライアントと比較すると、入力コストは40ターンで61%、150ターンで87%、300ターンで93%低くなります。履歴をすでに独自にキャッシュしているクライアントとの比較では、40ターンで10%高く、150ターンで同程度、300ターンで41%低くなります。10ターンのセッションでは入力コストが21%高くなります。キャッシュの最小量に届かず、約50トークンの簡潔さを促す指示はリクエストごとに課金される一方、それによって短縮される出力は測定対象ではないためです。詳細と注意事項はベンチマークをご覧ください。
エージェントのセッションは個別に測定しています。エージェントが送信する内容の大半は文章ではなくツールの出力だからです。実際の23リクエストからなるエージェントセッションでは、プロキシが送信したトークン数はクライアント単独の場合より70%少なく、リリース前は削減されていなかったトークン数を削減しました。クライアントが独自に履歴をキャッシュする場合と比べてコストは20%低く、それでもエージェントが後続のリクエストで使用した情報の97%を保持していました(58リクエストでは94%)。これは1つのセッションに基づく入力のみの推定値であり、情報の保持率は回答の品質を示すものではありません。ベンチマークをご覧ください。
ほかの7つの手法と独立して検証済みです。 別の100セッションベンチマーク(tokenmizer-research。上記の数値とは異なるコーパスと評価器を使用)では、TokenMizer 0.5.4 はマクロ F1 **60%**で首位タイです。Mem0 方式(60%)とGraphiti 方式(59%)と同水準で、GraphRAG 方式(44%)、MemGPT 方式(35%)、およびすべての単純なベースライン(20%未満)を上回っています。
ラベル付きコーパスだけでなく、実際のエージェントのトラフィックでも測定しています。 同じ調査リポジトリでは、1,467件の公開SWE-benchエージェントセッションで製品を実行しています。SWE-agentとGPT-4、GPT-4o、Claude 3 Opus、Claude 3.5 Sonnet、および関数呼び出しを使うOpenHandsを合わせ、合計約31 Mトークンです。ラベルを手作業で付与することはありません。
- エージェントが編集したファイルは、提出されたパッチから取得します。
- エラーは、ツールの結果に含まれるトレースバックとリンターの出力から取得します。
セッションは課題ごとに分割します。バグの発見には一方の半分のみを使い、もう一方の半分(716件のセッション)は修正前と修正後にそれぞれ一度ずつ評価しました。
| テスト用分割、716件のセッション | 修正前 | 修正後 |
|---|---|---|
| 再現された実行時エラー | 63% | 92% |
| 再開ブロックに到達した実行時エラー | 20% | 50% |
| 再開ブロックに到達した編集済みファイル | 51% | 67% |
| 実際のエラーと一致する抽出済みエラー(下限値) | 16% | 31% |
| 編集済みファイルの再現率 | 75% | 78% |
本番環境と同じ条件である1回の呼び出しにつき1メッセージの場合、実行時エラーの再現率は72%から**96%**に向上しました。
比較対象の手法では、該当する実行時エラーの5~12%を再現します。全表、信頼区間、妥当性への脅威については、REPORT_real_agents.mdをご覧ください。
ベンチマークへ — 単純な要約をベースラインとしたメモリ品質、ストレージ、および独自のセッションの評価方法をご紹介します。
TokenMizer を選ぶ理由(X ではなく)
Git の履歴ではだめなのですか? Git に保存されるのは「何が変わったか」であり、「なぜ変更を決めたか」ではありません。Git に「認証について何を決めたのか?」や「なぜ MySQL から PostgreSQL に切り替えたのか?」と尋ねることはできません。TokenMizer は差分ではなく、きっかけ、理由、根拠とともに決定を保存します。
RAG(検索拡張生成)ではだめなのですか?
RAG が検索するのは「関連するチャンク」であり、「決定の状態」をモデル化するものではありません。セッションの途中で bcrypt から Argon2 に切り替えた場合、RAG は両方を検索してしまい、どちらが現在の設定なのかモデルを混乱させる可能性があります。TokenMizer は決定の置き換えを明示的に追跡します。古い決定には SUPERSEDED、新しい決定には ACTIVE とマークし、再開時のコンテキストには現在の状態だけを含めます。
各セッションの開始時に、単純な要約を作るのではだめなのですか? 要約では構造が失われます。テキストの塊から「置き換えられた決定をすべて」や「認証変更のきっかけ」を検索することはできません。ベンチマークでは、グラフメモリがラベル付き情報の 89% を保持するのに対し、要約ベースラインでは 79% でした。また、要約とは異なり、グラフは検索・編集でき、ターンごとに要約し直すことなく段階的に成長します。ベンチマークをご覧ください。
Mem0 や Zep ではだめなのですか? Mem0 と Zep が保存するのは「ユーザーは Python を好む」といった「事実」です。TokenMizer が保存するのは「根拠を伴う決定」です。つまり、何が決定され、何に置き換えられ、なぜそうなったのか、どのような根拠が変更のきっかけになったのかという、因果関係の全体像です。「セッションをまたいで自分の名前を覚えておいてほしい」場合は Mem0 をお使いください。「コストが理由で PostgreSQL から SQLite に切り替えたことと、その根拠を覚えておいてほしい」場合は TokenMizer をお使いください。
Graphiti ではだめなのですか? どちらも時間的なナレッジグラフを構築しており、上記の独立したベンチマークではスコアの差は 1 ポイント以内です。違いは運用面にあります。TokenMizer はデプロイするデータベースが不要な SQLite 上で動作し、オフラインで開いたり誰かに送ったりできる、自己完結型の HTML ページとしてグラフを提供します。また、OpenAI 互換のプロキシなので、導入に必要なのはベース URL の変更だけです。すでに Neo4j を運用していて、Cypher でグラフをクエリしたい場合は Graphiti が適しています。
単にコンテキストウィンドウを長くするのではだめなのですか? コンテキストが長くなると、コストの増加、推論の遅延、長い履歴に対する注意の希薄化につながります。TokenMizer は、単に要約するのではなく本当に重要な情報を抽出し、セッションを平均 161 トークン の再開ブロックに圧縮します(実測値、n=3。ベンチマークをご覧ください)。
未実装の項目
あとから気づくことのないよう、ここに記載しています。
| 設定 | 状態 |
|---|---|
routing.* | 非推奨で、次のリリースで削除されます。 実装されたことはありません。あるモデル名を別のモデル名に送るには、model_map(以下)をお使いください。これはその目的で用意されていました。routing: ブロックを含む設定も引き続き読み込まれますが、非推奨の警告がログに記録されます。 |
state_backend: redis | 受け付けられますが、実装されたことはありません。memory として動作し、起動時に警告が表示されます。同一ホスト上のワーカー間でレート制限を共有するには、state_backend: sqlite をお使いください。 |
functions / function_call(非推奨の OpenAI 形式) | 受け付けられますが無視され、サーバー側で警告が表示されます。転送される tools / tool_choice をお使いください。 |
これらを含むすべての項目の優先順位付き計画は、 docs/roadmap.mdにあります。計画中の各項目には、 その項目を実施する根拠となる測定結果が記載されています。
ドキュメント
| アーキテクチャ | リクエストパイプライン、グラフのデータモデル、意思決定のライフサイクル、ファイルインテリジェンス |
| 設定 | すべての設定項目、環境変数、優先順位、プロバイダー |
| API と CLI | エンドポイント、コマンド、MCP ツール、ツール呼び出し、Claude Code との連携 |
| デプロイ | Docker、複数ワーカー、耐久性、セッションの分離、セキュリティ |
| ベンチマーク | 抽出品質、メモリ品質、ストレージ、自分で実行する方法 |
| ロードマップ | 各レイヤーの測定結果と優先順位付きの計画 |
| 比較 | 他のトークンツールとの併用 |
| コントリビューション | セットアップ、レイヤーのルール、抽出の改善方法 |
| テスト | テストスイートの実行方法、カバレッジの下限、既知の制限 |
| 変更履歴 · セキュリティ | リリース履歴と脆弱性の報告方法 |
コントリビューション
git clone https://github.com/Shweta-Mishra-ai/tokenmizer
cd tokenmizer
pip install -e ".[dev]"
pytest tests/ -q && ruff check tokenmizer/     # 2131 tests, must stay green
最も価値のある貢献は、抽出が間違ったセッションです。 評価コーパスは14件のセッションで構成されており、すべてのラベルを同じ人が付けています。これは、上記の数値からあなたのワークロードについてわかることの正直な上限であり、そこから先へ進む唯一の方法は、ここにいる誰もが書いたことのないトランスクリプトです。独自のセッションをいくつか、benchmarks/eval/corpus.pyに記載された形式でラベル付けしてPRを送るか、見落とされたターンを添えてイシューを作成してください。内容ではなく文章の形が重要なので、自由に伏せ字にしてください。
CONTRIBUTING.mdでは、セットアップ、レイヤーのルール、評価ハーネスの実行方法について説明しています。
プロジェクトについて質問がある場合や、何か議論したい場合は、Discord サーバーに参加してください。
コントリビューター
TokenMizer にプルリクエストがマージされたすべての皆さまに、心より感謝申し上げます。以下のアバターは、プルリクエストが初めてマージされた順に並んでいます。
TokenMizer はコミュニティ主導のプロジェクトであり、皆さまの貢献によって継続的に改善されています。全リストはコントリビューターグラフをご覧ください。


サポート
TokenMizer が役に立った場合は、スターを付けてください。ほんの一秒で済み、実際に大きな励みになります。
活動を支援したい方は、スポンサーになることもできます。もちろん任意です。
ライセンス
MIT © Shweta Mishra
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。