HKEx Filings について
HKEx Filings は、香港証券取引所の開示資料を扱う研究者、コンプライアンス担当者、AI エージェント向けの Python スクレーパー兼読み取り専用 MCP サーバーです。文書のテキストと表を抽出し、9 種のデータベースを組み合わせて保存できます。
主な機能
- 011999年4月以降のHKEx開示資料を取得
- 02PDF、HTML、Excelからテキストと表を抽出
- 039種のデータベースへの書き込み
- 04チャンク単位の取得範囲追跡
- 05ホスト型とローカルの読み取り専用MCPサーバー
活用シーン
- 01AIエージェントでHKExの最新開示資料を検索
- 02調査やコンプライアンス向けのローカル資料群を構築
- 03分析用に文書のテキストと表を抽出
MCP 対応
ホスト型Streamable HTTPゲートウェイは、開示資料の検索、分類項目の一覧、資料の取得、サーバー情報の確認に使える読み取り専用ツールを提供します。ローカルstdioサーバーは、保存済み資料群向けにより多くのツールを公開します。
設定
リモートサーバーはインストール不要です。クライアントを選んで設定をコピーするか、ワンクリックで導入できます。
https://hkex-listco-updates.ascent-partners.com/api/mcpclaude mcp add --transport http simonmak-ascent-hkex-filings https://hkex-listco-updates.ascent-partners.com/api/mcp{"mcpServers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}Cursor で開く{"servers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}VS Code で開く{"mcpServers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}{"mcpServers":{"simonmak-ascent-hkex-filings":{"serverUrl":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}コマンドはターミナルで実行し、JSON は各クライアントの MCP 設定に貼り付けて再起動します。認可が必要なサーバーは初回接続時にログインを求めます。
ツール
4このツールにパラメーターはありません。
詳細
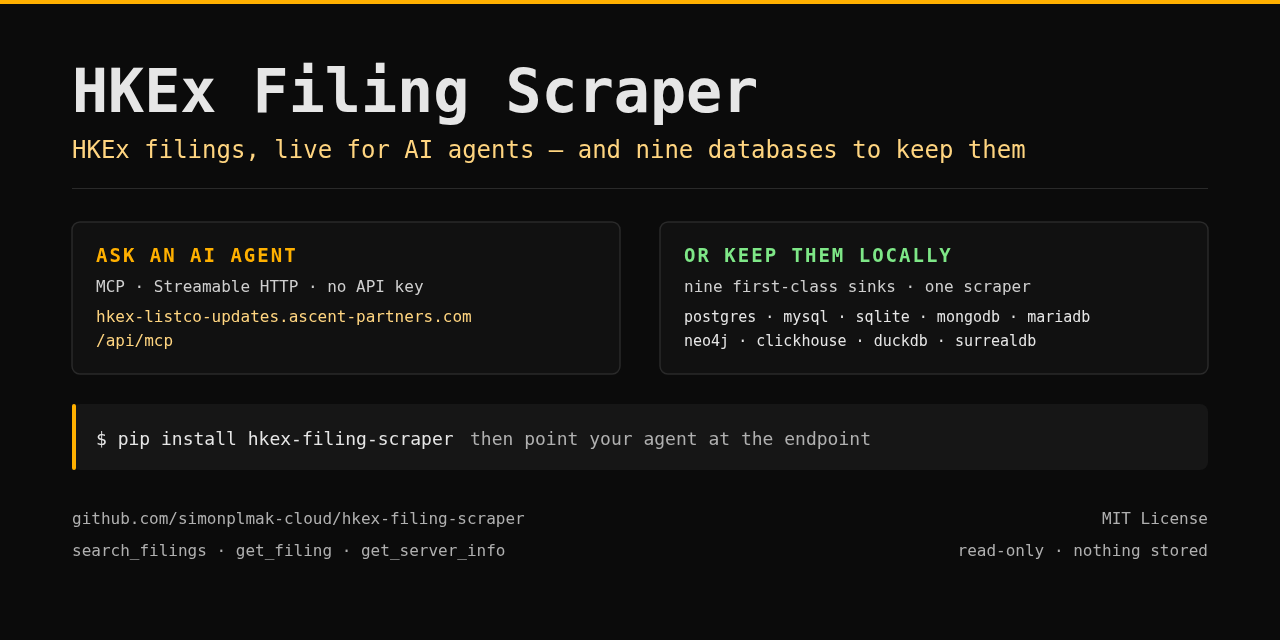
HKEx Filing Scraper
HKExの規制関連開示資料を25年以上にわたって取得するオープンソースのスクレイパー — 9種類のデータベースのいずれにも取り込み、全文抽出、グラフによるリンク付け、AIエージェント向けの読み取り専用MCPサーバーを備えています。






概要
米国にはEDGARの全文検索があり、日本にはEDINETがあります。香港には1ページずつしか表示できない検索フォームがあります。 HKExの開示資料を一括で利用できる、機械可読形式の全文コーパスは存在しません。このツールはそれを構築します。
香港証券取引所(HKEx)の規制関連開示資料を25年以上にわたってスクレイピングし、9種類のデータベースから任意の組み合わせを選んで取り込むオープンソースのPythonツールです。全文と表の抽出、チャンク単位のカバレッジ、オプションのグラフによるリンク付けに対応し、AIエージェントがコーパスやライブサイトを照会できる読み取り専用MCPサーバーも備えています。
非公開のHKEx JSON APIを直接利用するため、ブラウザーを操作する方式より高速で、耐障害性にも優れています。
ベンダーと連携機能
データベース — 人気順に記載した、主要な9つの接続先です(サポートマトリックスを参照):
- PostgreSQL — 本番環境に適したオープンソースのリレーショナルデータベース
- MySQL / MariaDB — GPLのリレーショナルデータベースサーバー。同じドライバーを使用
- SQLite — サーバー不要のファイルデータベース。インストール不要
- MongoDB — ドキュメントデータベース
- Neo4j — プロパティグラフデータベース
- ClickHouse — カラム型分析エンジン
- DuckDB — プロセス内分析エンジン
- SurrealDB — マルチモデルのグラフ・ドキュメントデータベース
AIクライアント — MCPに対応するあらゆるエージェントで利用できます。Claude、ChatGPT、Cursor、VS Code/Copilot、Gemini CLI、opencode、Manus、Perplexity向けの設定を用意しています。
提供先 — PyPI · Glama · MCP Registry · ホスト型ゲートウェイ。
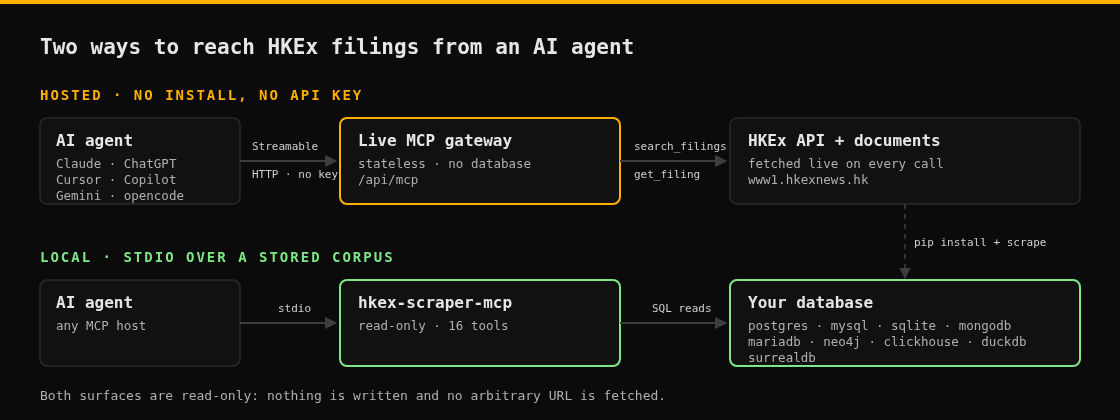
2 つの利用方法
| ホスト型 MCP ゲートウェイ | ローカルパイプライン | |
|---|---|---|
| 概要 | AI エージェントから接続する公開エンドポイントです | hkex-scraper CLI です |
| セットアップ | 不要です。URL を貼り付けるだけです | pip install と環境変数 1 つです |
| データ | HKEx からリアルタイムで取得し、何も保存しません | データベースに保存されます |
| ドキュメント | ライブ MCP ゲートウェイ · AI エージェントのサポート | はじめに |
ホスト型 MCP ゲートウェイを使う
POST、Streamable HTTP、API キー不要:
https://hkex-listco-updates.ascent-partners.com/api/mcp
読み取り専用ツールが 4 つあります:get_server_info、search_filings(最大 31 日間の期間を指定でき、銘柄コード、タイトル、文書タイプ、カテゴリ、銘柄名で絞り込むこともできます)、list_filing_facets(期間内の内容を確認できます)、get_filing(文書を 1 件ダウンロードし、テキストと表を抽出します)。
クライアントから接続します。たとえば opencode の場合:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "hkex-live": {
      "type": "remote",
      "url": "https://hkex-listco-updates.ascent-partners.com/api/mcp"
    }
  }
}
次に、以下のように尋ねます:
Use hkex-live to list the filings published between 2026-09-01 and 2026-09-18,
then summarise the interim report.
Claude、ChatGPT、Cursor、VS Code/Copilot、Gemini CLI、opencode、Manus、Perplexity 向けの設定例はAI エージェントのサポートにあります。データを保存する場合は、stdio MCP サーバーから、より幅広いツールカタログを利用できます。また、Glamaにも公開されています。ゲートウェイは、公式 MCP Registryにcom.ascent-partners/hkex-filingsとして登録されています。
Glama で紹介 — 読み取り専用のstdio MCP サーバーも Glamaに公開されています。Glama は ビルド済みサーバーをスキャンし、ツール定義の品質を評価します(現在 4.7/5)。
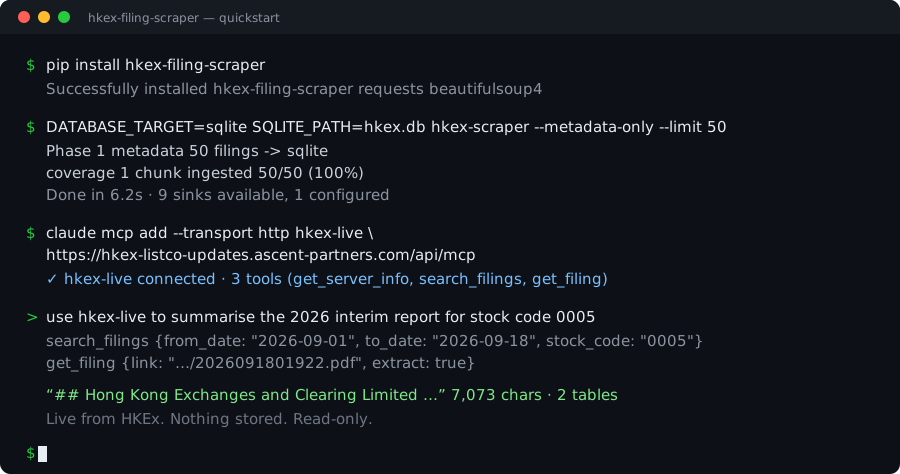
クイックスタート(5 分以内)
最短の方法: インストール不要です。https://hkex-listco-updates.ascent-partners.com/api/mcp(Streamable HTTP)のホスト型ゲートウェイを使うか、インストールしてローカルで実行します:
pip install hkex-filing-scraper        # core; SQLite needs no server
pip install "hkex-filing-scraper[all]" # Excel + dotenv + every driver + the MCP server
cp .env.example .env                   # then set DATABASE_TARGET (below)
hkex-scraper --metadata-only --limit 100
オプションの追加機能:excel、postgres、mysql、duckdb、mongodb、clickhouse、neo4j、mcp、pdf、all、dev。
DATABASE_TARGETは、順序を指定したカンマ区切りのシンク ID のリストです。順序によって、読み取りに使用するシンクが決まります。サーバーを起動せずに始めるには:
DATABASE_TARGET=sqlite
SQLITE_PATH=hkex.db
hkex-scraperはパイプライン全体(メタデータ、文書、グラフ)を実行します。hkex-scraper --full-historyを実行すると、1999 年 4 月以降のすべてのデータを取得します。スキーマは自動的に作成されます。インストール方法の詳細とシンクごとの設定については、はじめにをご覧ください。
データベースのサポート
すべてのシンクは第一級の保存先です。以下の行は、ドキュメントに記載された人気順です。ライセンス、機能の違い、エンジンごとの注意事項を含む全マトリックスは、データベースシンクをご覧ください。
| シンク | モデル | ライセンス | 追加設定 | 冪等なアップサート |
|---|---|---|---|---|
postgres | リレーショナル | PostgreSQL License | postgres | ON CONFLICT DO UPDATE |
mysql / mariadb | リレーショナル | GPLv2 | mysql | ON DUPLICATE KEY UPDATE |
sqlite | リレーショナル | パブリックドメイン | — | ON CONFLICT DO UPDATE |
mongodb | ドキュメント | SSPL¹ | mongodb | update_one(upsert=True) |
neo4j | グラフ | GPLv3(Community) | neo4j | MERGE |
clickhouse | 列指向 | Apache-2.0 | clickhouse | ReplacingMergeTree + 読み取り時のマージ |
duckdb | リレーショナル | MIT | duckdb | ON CONFLICT DO UPDATE |
surrealdb | グラフ + ドキュメント | BSL 1.1¹ | — | UPSERT / RELATE |
¹ ソース公開型であり、OSI 承認済みではありません。ADR 0003に記載の例外として明示しています。
ドキュメントに記載された順の有効なシンク ID:postgres、mysql、sqlite、mongodb、mariadb、neo4j、clickhouse、duckdb、surrealdb。変数を 1 つ設定するだけで、同じ実行ですべてのシンクにデータを送信できます。
# Order sets read precedence.
DATABASE_TARGET=postgres,sqlite
POSTGRES_DSN=postgresql://user:password@localhost:5432/hkex
SQLITE_PATH=hkex.db
他の方法との比較
HKEx の提出書類を取得する 4 つの方法と、それぞれにかかるコストを比較します。
| このプロジェクト | HKEXnews のウェブ検索 | 自作のブラウザー自動化 | HKEx のライセンス済みフィード | |
|---|---|---|---|---|
| 一括エクスポート | はい | いいえ — 1 ページずつ | はい | はい |
| 1999 年 4 月までの履歴 | はい | はい、手動で | コード次第 | はい |
| 文書の全文 | PDF/HTML/Excel から抽出 | いいえ — ファイルを 1 つずつ開きます | 抽出機能を自作します | 契約によって異なります |
| 構造化テーブル | Markdown に抽出 | いいえ | 自作します | さまざまです |
| 網羅性の検証 | チャンク単位で監査可能 | 該当なし | 自作します | ベンダーの SLA |
| 利用するエンジン | 9 種類のエンジンを任意に組み合わせ可能 | いいえ | 接続したもの | 通常は 1 形式 |
| 速度 | JSON API、ブラウザー不要 | 手動 | 遅い — ページをレンダリングします | 高速 |
| コスト | 無料、MIT | 無料 | 作業時間 | サブスクリプション |
| 商用での再配布 | docs/legal.mdを参照 | 制限あり | 制限あり | ライセンスが必要 |
ライセンス付きで再配布可能な、SLA に裏付けられたデータが必要なら、フィードをご購入ください。調査、コンプライアンス、RAG のために完全なローカルコーパスが必要なら、本来ご自身で作成するはずのパイプラインをこのプロジェクトで置き換えられます。
動作の仕組み
flowchart LR
    A[HKEx JSON API] --> B[Phase 1: metadata]
    B --> C[Canonical record]
    C --> D{DATABASE_TARGET}
    D --> E[(PostgreSQL)]
    D --> F[(MySQL / MariaDB)]
    D --> G[(SQLite)]
    D --> H[(MongoDB)]
    D --> I[(Neo4j)]
    D --> J[(ClickHouse)]
    D --> K[(DuckDB)]
    D --> L[(SurrealDB)]
    B --> M[Graph linking]
    M --> D
    B --> N[Phase 2: download and extract]
    N --> C
- フェーズ 1 では、JSF セッションを通じて提出書類のメタデータをスクレイピングし、期間を月単位のチャンクに分割して、16 文字の MD5
filingIdに基づいて重複を排除します。 - フェーズ 2 では、各提出書類の PDF/HTML/Excel 文書をダウンロードし、テキストとテーブルを Markdown に抽出して、ペイロードを書き込みます。
- グラフリンク(任意)では、
COMPANY_TABLEが設定されている場合、has_filingとreferences_filingのエッジを書き込みます。 - 障害の分離 — あるシンクで障害が発生しても、ログに記録してカウントするだけで、他のシンクを妨げることはありません。設定したシンクのいずれかで障害が発生すると、実行はゼロ以外の終了コードを返します。
詳しくは、アーキテクチャ · ADR 0002をご覧ください。
HKEx API セッション
sequenceDiagram
    autonumber
    participant C as hkex-scraper
    participant J as HKEx site (JSF)
    participant A as HKEx JSON servlet
    C->>J: GET /search/titlesearch.xhtml
    J-->>C: HTML + javax.faces.ViewState
    C->>J: POST form (from/to dates + ViewState)
    C->>A: GET /search/titleSearchServlet.do (rowRange paging)
    A-->>C: JSON page of filings
    Note over C: generate_monthly_chunks() splits ranges > 1 month
    C->>C: dedupe on 16-char MD5 filingId
データモデル
erDiagram
    COMPANY ||--o{ EXCHANGE_FILING : has_filing
    EXCHANGE_FILING ||--o{ DOCUMENT : has_document
    EXCHANGE_FILING ||--o{ EXCHANGE_FILING : references_filing
    EXCHANGE_FILING ||--o{ SCRAPE_COVERAGE : chunk_of
    EXCHANGE_FILING {
        string filingId "16-char MD5"
        string stockCode
        string title
        datetime dateTime
    }
    DOCUMENT {
        text documentText
        array documentTables
    }
    SCRAPE_COVERAGE {
        int apiCount
        int ingestedCount
        int uniqueCount
        string runId
    }
exchange_filing と scrape_coverage は SCHEMAFULL です。has_filing / references_filing は、graph.py が書き込むグラフエッジです。
シンクの契約と読み取りルーティング
flowchart LR
    CANON["canonical record<br/>per filing / document / coverage / edge"] --> DISPATCH["dispatch to every configured sink"]
    DISPATCH --> S1["sink A"]
    DISPATCH --> S2["sink B"]
    DISPATCH --> SN["sink N"]
    S1 -.->|error| LOG["logged + counted<br/>never blocks the others"]
    READ["reads: pending filings · tickers · titles · coverage"] --> FIRST["first configured sink<br/>whose capabilities include reads"]
    DISPATCH --> EXIT["sink_exit_code()<br/>non-zero if any sink failed"]
機能
- 高速な API スクレイピング — HKEx の JSON API に直接アクセスします。ブラウザーや Selenium は不要です。
- 全期間の履歴 — 1999 年 4 月から現在までのすべての提出書類を対象とし、チャンク単位でカバレッジを確認します。
- ドキュメント処理 — PDF/HTML/Excel のテキストや構造化テーブルを抽出し、Markdown に変換します。
- 複数の出力先 — 9 種類のデータベースを任意の順序で組み合わせられ、それぞれがネイティブの冪等なアップサートに対応しています。
- AI 対応 — ホスト型のライブ MCP ゲートウェイと、ローカルの stdio MCP サーバーを提供します。
- 再開可能で可観測 — バッチ処理、並列ダウンロード、停滞ジョブの検出、出力先ごとのカウンターに加え、
--coverage-report/--parity-report/--verifyに対応しています。 - オプションの依存関係 — コアは
requestsとbeautifulsoup4で構成され、ドライバーとドキュメント抽出機能は追加依存関係として、利用できない場合は適切にフォールバックします。
ドキュメント
- 使い始める · 設定 · CLI
- データベース出力先(一覧) — PostgreSQL、MySQL/MariaDB、SQLite、MongoDB、Neo4j、ClickHouse、DuckDB、SurrealDB
- ライブ MCP ゲートウェイ · AI エージェントのサポート · MCP サーバー
- アーキテクチャ · トラブルシューティング · テスト
- ロードマップ · リスク低減項目一覧 · アップグレード
- 新着情報 · リリース · 法的事項と利用規約 · 変更履歴
- ドキュメントサイト: https://hkex-listco-updates.ascent-partners.com/ · ローカルで試す(
examples/)
開発
pip install -e ".[dev,all]"
ruff check           # lint (py310, line-length 100)
ruff format --check  # formatting
pytest               # unit tests (no DB or network required)
テストは純粋なユニットテストです。SQLite と DuckDB の契約テストはプロセス内で実行され、サーバーが必要な統合テストは、その出力先が設定されていない限りスキップされます。テストを参照してください。
CI とデプロイは APG workbench パイプラインを通じて実行されます。
デプロイ時のスモークチェックでは、ローカルポートではなく、ロードバランサー経由で公開ホスト名に接続して確認します。
コントリビューション
CONTRIBUTING.mdを参照してください。セキュリティ上の問題はSECURITY.mdに従って報告してください。アイデアや質問は ディスカッションで歓迎します。
Ascent Partnersが開発しました。
これが時間の節約に役立った場合は、GitHub で ⭐ を付けていただけると、ほかの人にも見つけてもらいやすくなります。
Context7 で使う
HKEx Filing Scraper の最新ドキュメントは Context7にインデックス化されているため、コーディングエージェントは必要に応じてコンテキストに取り込めます。Context7 MCP サーバーまたは ctx7 CLI をインストールしたら、プロンプトでライブラリ名を指定してください。
use library /simonmak-ascent/hkex-filing-scraper for API and docs
ライセンス
MIT — LICENSEを参照してください。このライセンスの対象はこのプロジェクトのコードのみです。オプションの依存関係にはそれぞれ独自のライセンスがあり、特に pdf エクストラ(PyMuPDF / pymupdf4llm)はAGPL-3.0であるため、意図的に .[all] から除外されています。docs/legal.mdを参照してください。
データと利用規約: 本ツールは、仕様が公開されていない HKEx JSON API を対象とする調査用ツールであり、HKEx との提携関係はなく、HKEx の推奨を受けているものでもありません。HKEx データを商用再配布するには、HKEx のライセンス付きフィードが必要になる場合があります。docs/legal.mdを参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。