M3 Memory について
M3 Memoryは、セッション、ツール、マシンをまたいで情報を保存・検索する、AIエージェント向けの永続メモリー層です。標準ではローカルで動作し、オフラインに対応するほか、キーワード検索とセマンティック検索、履歴管理を組み合わせます。
主な機能
- 01セッションやエージェントをまたぐメモリー保存
- 02キーワードとセマンティック検索の併用
- 03メモリーのバージョンと変更履歴の保持
- 04SQLiteおよびPostgreSQLストレージ
- 05エージェント間のメモリー共有と引き継ぎ
- 06コマンドラインとWebダッシュボード
活用シーン
- 01新しいセッションでプロジェクトの決定事項を再確認
- 02複数のAIアシスタント間でプロジェクト情報を共有
- 03自然な表現で過去のメモを検索
- 04変化した事実と以前の内容を追跡
MCP 対応
M3 MemoryはMCPサーバーとして、AIエージェントにメモリーの書き込みと検索機能を提供します。同じストアはコマンドラインからも利用でき、複数のアシスタントで共有できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
10掲載時のツール一覧 · 2 日前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| timeout | number | いいえ | |
| database | string | いいえ |
詳細
🧠 m3 Memory
AI に長く残る記憶を与えましょう。
新しい会話を始めると、それまで取り組んでいたことを忘れてしまうまでは、AI アシスタントは頼りになります。m3 はその問題を解決します。
アプリを閉じたり、新しいセッションを始めたり、 別のエージェントに切り替えたりしても、アシスタントはプロジェクト、好み、決定事項、これまでの作業を覚えています。デフォルトでは、すべて自分のコンピューターに保存され、 オフラインで動作します。m3 自体にはクラウドアカウントや API キーは必要ありません。AI アシスタントには独自の要件がある場合があります。



pipx install m3-memory  # or pip install m3-memory in a virtual environment; use one, not both
m3 setup                # finds your agents and connects them to m3
m3 doctor               # checks that everything is working
まだ pipx をインストールしていませんか?sudo apt install pipx(Debian、Ubuntu)、brew install pipx(macOS)、または
py -m pip install --user pipx(Windows)を実行してください。インストール直後に m3 が見つからない場合は、
新しいターミナルを開いてください。
セットアップでエージェントを検出し、m3 に接続します。 m3 setup は AI エージェントを検出し、それぞれに m3 を組み込みます。ローカル LLM(Ollama、LM Studio)を実行している場合は、それを使ってメモリを要約し、関連付けるかどうかを確認します。この作業は任意です。使用する場合は、m3 setup の前に LLM をインストールしてください:Windows · macOS · Linux。これでインストールは完了です。
初めての方は、5 分で始めるガイドで、最初のメモリを保存する方法を確認できます。
m3 について
m3 は AI エージェント、つまり Claude Code、Codex、Cursor、Gemini CLI など、あなたのために作業する AI アシスタントのためのメモリレイヤーです。自分のコンピューター上で動作し、事実、決定事項、好み、会話履歴を保存することで、アシスタントが後からセッションやツール、マシンをまたいで思い出せるようにします。アシスタントは、AI アシスタントがツールに接続する標準的な方法である MCP を通じて m3 にアクセスできます。また、コマンドラインからも使用できます。
m3 は AI モデルでもチャットボットでもありません。これまで使っていたアシスタントをそのまま使い、記憶したり思い出したりする必要があるときに、アシスタントが m3 を呼び出します。
📅 m3 と過ごす1週間
月曜日: AI アシスタントにウェブサイトを作っていることを伝え、PostgreSQL を使うことに決めます。
水曜日: 新しいセッションを開き、「どこまで進めた?」と尋ねます。アシスタントはその決定を見つけ、あなたが繰り返し説明しなくても作業を続けます。
金曜日: Claude Code から Codex へというように、エージェントを切り替えます。Codex は同じプロジェクトのメモリを確認できます。
あるエージェントが決定事項を保存し、別のエージェントがそれを思い出す様子を、 短い動画 でご覧ください。(開発者向け:コマンドラインから同じことを確認できます。)
✨ m3 ができること
| したいこと | m3 が... | 仕組み |
|---|---|---|
| 同じことを繰り返し伝えない | 以前のセッションで伝えたことを記憶します | MCP と CLI を通じた永続的なメモリ |
| 前回の続きから始める | 会話を保存し、後から見つけられます | チャットログの記録 |
| 複数の AI アシスタントを使う | Claude Code、Cursor、Gemini CLI、その他にまたがってメモリを共有します | 1 つのローカルストアを複数のクライアントで共有 |
| 自分の言葉で検索する | 正確な言葉を思い出せなくても、メモリを見つけます | ハイブリッド検索:キーワードと意味の両方を利用 |
| AI のトークン消費を抑える | 最も関連性の高いメモリを先に提示し、アシスタントの接続時に 100 以上あるツールのうち 6 つだけを読み込みます | 質問の 91.8% で適切なセッションを最初に提示;ツールの説明は 33,000 トークンではなく約 3,200 トークン |
| 変更があったときも経緯を追う | 判断が変わったときも以前のバージョンを保持します。書き込み時の類似性に基づく置き換え、明示的な訂正、任意のモデル支援による矛盾の確認に対応します | 双時制履歴、置き換え、矛盾の確認 |
| 情報のプライバシーを守る | すべての情報をコンピューターに保存し、オフラインで動作します | デフォルトでは SQLite を使用し、エアギャップ環境にも対応 |
| アシスタント同士が連携する | 複数のアシスタントがメモを共有し、作業を引き継いだりタスクを分担したりできます | マルチエージェントのスコープと引き継ぎ |
| メモリを整理する | バックグラウンドで整理できます。関連する事実をリンクし、重複を統合し、古いメモの重要度を下げます | 組み込みの認知ループ(m3 setup で有効にします) |
仕組みがわかりやすく、すぐに使い始められ、必要なときには強力です。各行から、その機能を説明するドキュメントにアクセスできます。m3 のメモリの仕組みでは動作の詳細を説明し、技術概要とベンチマークでは測定結果を紹介します。
🎯 より優れたメモリで、無駄なトークンを削減
AI アシスタントが一度に処理できるテキスト量には限りがあります。その量はトークンで測られます。トークンは単語の小さな単位で、料金にも影響することがあります。アシスタントがメモリを検索するとき、必要な情報を最初に見つけられれば、不要な情報を読む量を減らせます。
An illustration, not a measurement:

  less precise search               m3: the right memory first
  1. unrelated note                 1. ✔ the decision you need
  2. unrelated note                    (it may already have what it needs)
  3. ✔ the decision you need
  4. unrelated note
  5. unrelated note
LongMemEval-S ベンチマークでは、500 問中 459 問で、m3 は正しいセッションを最初の検索結果として提示しました(91.8%)。これは検索精度を測るものであり、トークンの節約量を示すものではありません。節約できる量は、アシスタントが検索結果をどう使うかによって異なります。m3 は要求された数だけ結果を返すため、順位付けが正確であれば、アシスタントは要求する件数を減らしたり、最初に適切な結果が見つかった時点で検索を終えたりして、実際の作業により多くの余裕を残せます。
m3 は、もう 1 つの測定可能な方法でもコンテキストを節約します。アシスタントの接続時に登録するのは、100 以上あるツールのうち 6 つだけです。そのため、ツールの説明に必要なトークン数は、カタログ全体の場合の約 33,000 ではなく、約 3,200 です(インターフェース)。
m3 のメモリの仕組み
エージェント(またはシェルから操作するあなた)が何かを記憶したいときは、
memory_write を呼び出します。m3 は、指定されたテキストをそのまま、タイプ、タイトル、メタデータとともに保存します。
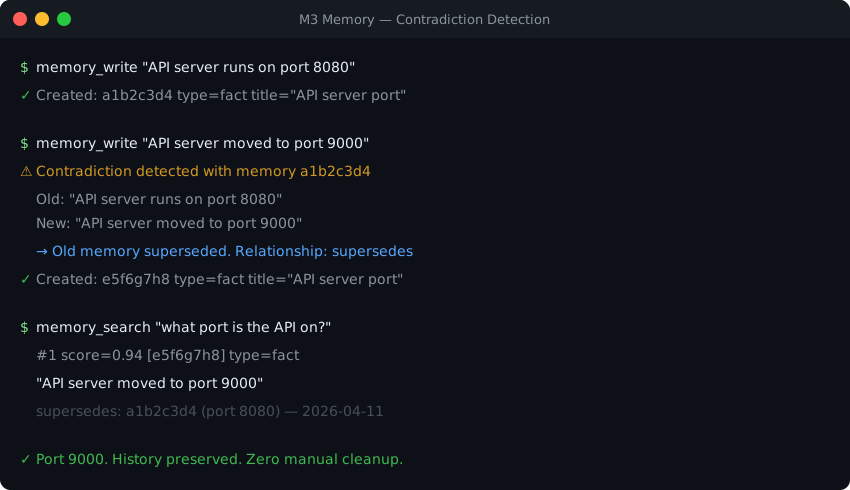
後で memory_search を使うと、ハイブリッド検索で見つけられます。キーワード照合(BM25)、
セマンティック類似度(ローカルの BGE-M3 埋め込み)、多様性を考慮した再ランキング(MMR)を組み合わせます。9 つの
シグナルがスコアに寄与し、すべての検索結果について、その理由を確認できます。
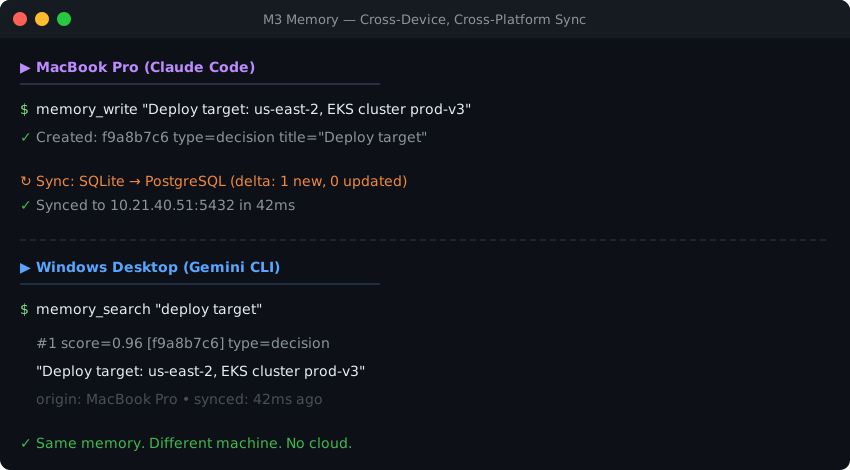
事実が変わっても、m3 は上書きしません。異なる 3 つの仕組みを使います。
- 類似度に基づく置き換え(書き込みのたびに実行)。 新しいメモリが、同じタイプの
古いメモリと非常によく似ていて(デフォルトではコサイン類似度が 0.92 を超え)、テキストが
異なる場合、新しいメモリが現行バージョンになります。古いメモリの
valid_toが設定され、 両方ともas_ofを指定して検索できます。2 つの内容が実際に矛盾しているかどうかは判定しないため、 「コネクションプーリングを使う PostgreSQL」のような詳細化でも、古い表現は置き換えられます。 履歴から失われるものはありません。これはエージェント自身のメモリにのみ適用され、書き込み時に ユーザーまたはエージェントを指定した場合に限ります。 - 明示的な置き換え。 エージェントは
memory_supersedeを呼び出して、誤りだと把握しているメモリを置き換えます。 - 矛盾の検出(モデルによる支援)。 認知ループが有効な場合、Reflector ステージがモデルを使って 実際に食い違っているメモリを見つけ、解決に向けて記録します。
認知ループを有効にすると、m3 は新しいメモリの埋め込みも作成し、エンティティと関係性を抽出して、 使われていないメモリを減衰させます。関連するメモをまとめて上位レベルの信念にする機能は、別途オプトインが必要です。
デフォルトのストアは単一の SQLite ファイルです。マシン間でストアを共有したい場合は、 PostgreSQL も第一級の選択肢です。
📍 プロジェクトの状況
コアは安定しており、Web ダッシュボード、認知ループ、Observer および Reflector ステージも安定しています。
| 状況 | 意味 | 機能 |
|---|---|---|
| 安定 | 安心して利用できます。リリースのたびにテストされ、変更には非推奨化の告知が伴います。 | メモリの保存、検索、更新、置き換え · ハイブリッド検索(キーワードと意味) · バージョン履歴 · 書き込み時の置き換え · GDPR によるエクスポートと消去 · SQLite および PostgreSQL ストレージ · MCP サーバーと m3 CLI · マシン間の同期 · Web ダッシュボード · バックグラウンドの認知ループ · Observer および Reflector ステージ |
| 予定 | 次に予定されている項目です。この順序で提供されます(ROADMAP)。 | ヘルスチェックおよび Prometheus メトリクスのエンドポイント · PostgreSQL での HNSW 近似検索 |
- メモリの読み取りを監査: 各メモリの読み取りと検索ヒットについて、誰が読み取ったか、誰のデータか、いつ読み取られたかをログに記録します。ログは 90 日間保持され、GDPR によるエクスポートと消去にも含まれます(GDPR)。チャットログの読み取りへの対応は次の予定です。
- 設定ファイルは 1 つ:
m3_config.tomlにすべての設定が含まれ、m3 config showを実行すると、それぞれの値と設定元が表示されます(設定リファレンス)。古い環境変数名は読み取られなくなりました。まだ設定されているものがあれば、m3 doctorが名前を表示します(環境変数)。 - 予測可能なアップグレード: カレンダーバージョニング(
YYYY.M.D.N)を採用しています。名前が変更された設定、引数、ツールは、削除前に警告付きで引き続き動作し、まだ使用中のものがあればm3 doctorが名前を表示します(変更履歴)。
⚡ m3 の概要:技術的な機能
m3 は、AI エージェント向けの永続的なローカルファーストのメモリレイヤーです。同じストアを使う MCP サーバーと、 JSON を入力し JSON を出力するコマンドラインツールを提供します。LLM、チャットボット、 単純なベクトルデータベース、RAG フレームワーク、エージェントランタイムではありません。 m3は検索可能なメモリストアにとどまりません。 キーワードとセマンティック検索を組み合わせたハイブリッド検索、二時点履歴、自動的な情報の置き換え、モデルの支援による矛盾の確認、ナレッジグラフ、バックグラウンドでのメモリ保守(認知ループ)を統合しています。複数のエージェントで1つのストアを共有したり、複数のマシンで1つのPostgreSQLデータベースを共有したり、PostgreSQLウェアハウスを介してローカルストアを同期したりできます。既存のアシスタントは、新しいエージェントランタイムを導入せずに、MCP、CLI、フレームワーク連携を通じてすべての機能を利用でき、完全に自分のハードウェア上で実行することもできます。
| 機能 | サポート状況 | 詳細 |
|---|---|---|
| セッションやエージェントをまたいで保持されるメモリ | 標準搭載 | テキストはそのまま保存され、再起動や新しいセッション、エージェントの切り替え後も保持されます。(メモリモデル) |
| ハイブリッド検索 | 標準搭載 | BM25 キーワード(SQLite FTS5)とローカルの BGE-M3 ベクトルを組み合わせ、多様性のために MMR を使用します。9 つのランキングシグナルがあり、各結果のスコアの根拠を確認できます。(ランキングシグナル) |
| 二時点履歴 | 標準搭載 | 各メモリに有効時間とトランザクション時間があります。任意の時点で何が信じられていたかを確認できます(as_of)。修正時は古いバージョンを閉じますが、削除はしません。(メモリモデル) |
| 類似度に基づく旧バージョンの置き換え | 標準搭載 | 書き込みのたびに、同じ種類でテキストが異なる非常に類似したメモリがある場合、そちらが現行バージョンになります。これは類似度に基づくもので、矛盾の判定ではありません。以前のバージョンは履歴に残ります(memory_history、as_of)。(矛盾の検出) |
| 明示的な修正 | 標準搭載 | memory_supersede は置き換えを記録し、以前のバージョンを引き続き検索可能な状態にします。(メモリモデル) |
| モデルを活用した矛盾の確認 | 認知ループとモデルを使用 | Reflector ステージが矛盾している可能性のあるメモリを検出し、解決のために記録します。(メモリの自己管理方法) |
| ナレッジグラフ | 標準搭載 | メモリ間のリンク、最大 3 ホップのグラフ探索、エンティティツールを利用できます。エンティティはデフォルトではルールベースで抽出され、認知ループではモデルによって抽出されます。(アーキテクチャ) |
| バックグラウンドメンテナンス(認知ループ) | 標準搭載。m3 setup で有効化 | 埋め込み、エンティティ抽出、拡充(Observer と Reflector)、分類、セッション要約、整理、重要度の減衰、同期、監査チェーンを実行します。モデルが必要な処理では、ローカルまたはクラウドの LLM を使用します。(メモリの自己管理方法) |
| セッションの想起 | 標準搭載 | 新しいセッションの開始時に、最近のセッションを番号付きメニューで表示します(0 = なし)。要約は認知ループによって作成されます。 |
| 複数エージェント間で共有するメモリ | 標準搭載 | エージェント、ユーザー、組織のスコープ、別のエージェントの受信トレイへの引き継ぎ、共有タスクツリー、安全な同時書き込みに対応します。強制設定を有効にしない限り、エージェント間の分離は推奨事項にとどまります。(マルチエージェント) |
| 複数のマシンで 1 つのストアを使用 | 標準搭載 | 各マシンが同じ PostgreSQL 16+ データベースを直接読み書きするため、別途同期する必要はありません。(マルチエージェント) |
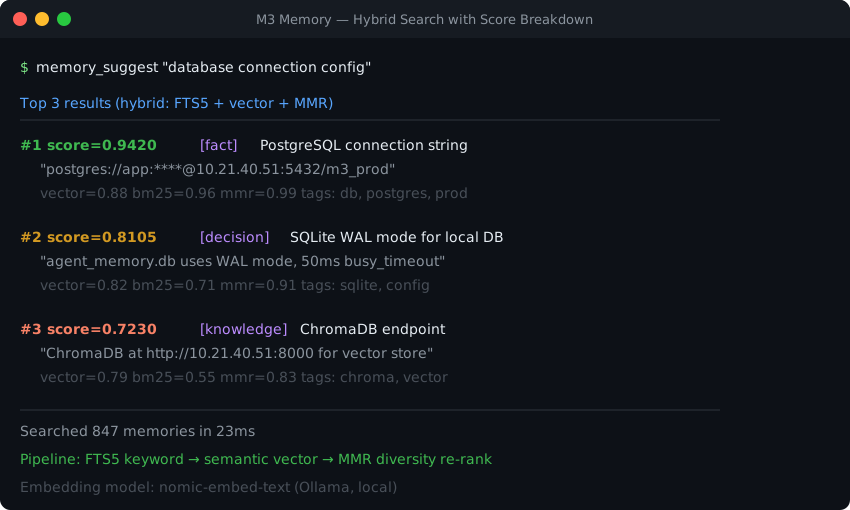
| 複数のマシンで同期 | オプション | 各マシンで SQLite を使用し、PostgreSQL ウェアハウスと双方向に毎時同期します(ハブアンドスポーク方式。最新の書き込みが優先されます)。意図的にピアツーピア方式にはしていません。1 つのハブに集約することで、競合を解決する場所と、保護すべきネットワーク接点を 1 つに保てます。(同期) |
| ローカル埋め込み、オフライン利用 | 標準搭載 | BGE-M3 はマシン上で動作します。インストール後はインターネット接続が不要で、エアギャップ環境へのインストールにも対応しています。(ソブリンデプロイ) |
| ストレージ | 標準搭載 | デフォルトでは SQLite を使用します。サーバーを実行する必要のないデータベースファイルです。PostgreSQL 16、17、18 でテスト済みです。pgvector はオプションです。(アーキテクチャ) |
| インターフェース | 標準搭載 | MCP サーバー、標準入力と標準出力で JSON を扱う m3 CLI、Bearer トークンで保護されたリモート MCP エンドポイント(m3 serve)に対応します。(CLI リファレンス) |
| コンテキスト効率 | 標準搭載 | 9 つのドメインに 100 以上のツールがあり、起動時に読み込まれるのは 6 つのみです(約 3,200 トークン、200K ウィンドウの 1.6%)。残りは必要に応じて読み込まれます。(ドメインのゲーティング) |
| エージェント連携 | 対応済み連携 | Claude Code、Codex、Gemini CLI、Antigravity(プラグインと拡張機能)。Cursor、Cline、OpenCode、OpenClaw(m3 setup で接続)。Hermes(メモリプロバイダー)。Aider(プロキシ経由)。(連携) |
| フレームワーク連携 | 対応済み連携 | LangChain と LangGraph、CrewAI、PydanticAI に対応します。(連携) |
| チャットの取得 | 標準搭載 | エージェントがコンテキストを圧縮する前に、会話のやり取りをその場で保存します。Claude Code、Codex、Gemini CLI、Antigravity(アプリ、IDE、CLI)、OpenCode、OpenClaw、Aider に対応します。(チャットログ) |
| ファイルメモリ | 標準搭載 | 25 個のツールを備えたドメインが、ディレクトリ全体を取り込み、チャンクに分割します。(ファイルメモリ) |
| ダッシュボードと Wiki | 標準搭載 | ローカルのウェブダッシュボード(グラフ、ブラウザー、監査ログ、ヘルス状態)を利用できます。m3 wiki generate は Markdown、HTML、Obsidian ボルトを書き出します。(ダッシュボード · Wiki) |
| GDPR | 標準搭載 | エクスポート(第 20 条)と消去(第 17 条)に対応します。すべてのメモリの読み取りと検索結果は 90 日間記録されます。チャットログの読み取りはまだ監査されません。(GDPR) |
| FIPS 140-3 | 対応準備済み | m3 の暗号処理は、検証済みモジュール(wolfCrypt FIPS)が提供できる単一のプロバイダーを通じて実行されます。m3 自体は検証済み製品ではありません。(FIPS の境界) |
| リモートクライアント | 検証済み | m3 serve を通じて、Claude.ai、Anthropic API、xAI API(Grok)、OpenAI Responses API に対応します。ChatGPT アプリのコネクターは OAuth が必要なため、対応していません。(リモートクライアント) |
| 近似(HNSW)検索 | 予定 | 現在の検索は厳密検索で、PostgreSQL では pgvector によって高速化されます。(ロードマップ) |
- テスト済み: Windows、macOS、Linux × Python 3.12~3.15 で5,700件以上のテストを実施し、Linux では PostgreSQL(pgvector 搭載)のテストも実施しています。m3 に同梱されるネイティブ(Rust)コアを使用し、警告がある場合はビルドに失敗します。セキュリティスキャンの結果は
docs/audits/で公開しています。(テスト) - ステータス: 安定版です。コア、ウェブダッシュボード、自律認知ループ、Observer と Reflector の各ステージが安定しています。Apache 2.0。(プロジェクトのステータス · ロードマップ)
- 設定: ファイルは
m3_config.tomlの1つだけです。m3 config showを実行すると、すべての設定と設定値の取得元が表示されます。(設定リファレンス) - AI エージェント向け: llm-context.md には実際のツール名と使用ルールが記載されており、features.json は機械可読形式の概要です。
🧭 次に読むもの
AI メモリを初めて使いますか? まず5分で読める入門ガイドを読み、 お使いのシステムに対応するインストールガイドをご覧ください:Windows · macOS · Linux。うまく 動作しませんか? トラブルシューティング · FAQ · ヘルス FAQ。
AI エージェントを使って開発していますか? インストール · クライアントのセットアップ · LangChain · CrewAI · PydanticAI · エージェント向け手順 · AI エージェント向け · 開発者向け · コーディングガイド · CLI リファレンス。
メモリシステムを評価していますか? ベンチマーク · Mem0、Letta、Zep などとの比較 · メモリモデル · アーキテクチャ · 技術詳細 · 主権型デプロイ · コンプライアンス。
すべてのドキュメント:ドキュメント一覧。
🤝 マルチエージェントのメモリとマシン間での利用
複数のエージェントやマシンで共有する、1 つのメモリレイヤー。 m3 は複数のエージェントによる 1 つのデータベースの同時共有、エージェント・ユーザー・組織ごとのスコープ、ハンドオフと共有タスクに対応しています。また、マシン間で利用する 2 つの方式があります。1 つの PostgreSQL データベースに直接アクセスする方法と、ローカルの SQLite ストアを PostgreSQL ウェアハウス経由で同期する方法です。
複数のエージェントが、同じ m3 メモリを同時に共有できます。各メモリにはスコープがあり、agent(特定のエージェント専用のメモ)、user、org から選べます。エージェントは、別のエージェントの受信トレイへのハンドオフや、共有タスクツリーを通じて連携します。SQLite では、同時に書き込む 16 個のエージェントが、失敗なしで 640 件の書き込みを完了し、各エージェントの待ち時間は最大でも 0.5 秒でした。エージェント間の分離はデフォルトではアドバイザリーです。オプトインのフィルターを使うと、SQL で分離を強制できます。
マシン間で利用する方法は 2 つあり、それぞれ仕組みが異なります。
- 1 つの PostgreSQL ストアを共有する。 すべてのマシンが同じ PostgreSQL 16 以降のデータベースを読み書きします。別途同期する必要はありません。複数のマシンで構成する環境に適した方法です。
- ウェアハウスと同期する。 各マシンが独自の SQLite ストアを保持し、メモリ、エンベディング、リレーションシップ、タスク、チャットログの行を PostgreSQL ウェアハウスと毎時双方向に同期します。ウェアハウスがハブとなるため、マシン同士が直接同期することはありません。最も新しい書き込みが優先されます。エンティティグラフなど、一部のローカル専用データはそのマシンに保持されます。
デフォルトは SQLite で、m3 setup でも SQLite が維持されます。共有 PostgreSQL ストアに切り替えるには、次を実行します。
pip install "m3-memory[postgres]" を実行し、サーバーのアドレスを m3 secret set M3_PRIMARY_PG_URL で保存してから、m3 install-m3 --db-backend postgres を実行します。
m3 をローカルで実行できないクライアント向けに、m3 serve を使うと、ベアラートークンで保護されたリモート MCP エンドポイントとしてメモリを公開できます。
(マルチエージェント · 同期 · リモートクライアント)
📊 ベンチマーク
検索品質を比較するには、まずセッションヒット率(SHR)を確認してください。 SHR は、回答を作成するモデルとは独立して、質問に必要な根拠が含まれるセッションをメモリシステムが取得できるかを測定します。
エンドツーエンドの QA 精度は、異なる成果を測定します。システム全体が正しい回答を生成できるかを評価します。検索、回答モデル、プロンプト、評価者に左右されますが、公表されている比較では、これらの条件が同一に保たれていることはほとんどありません。
m3 は両方の指標を報告し、検索の主要ベンチマークとして SHR を採用しています。SHR では、メモリレイヤーの機能すべてを測定できるわけではありません(情報の置き換え、履歴、メンテナンス、マルチエージェントの連携は評価対象外です)。
検索精度 — セッションヒット率 @ k (主要な検索指標)
m3 の本番検索機能を使用し、500 問の LongMemEval-S データセットで評価しました。
| 検索深度 (k) | セッションヒット率 (SHR) ⁂ | 成功数 |
|---|---|---|
| 1 † | 91.8% | 459 / 500 |
| 5 | 98.2% | 491 / 500 |
| 8 (デフォルト) | 99.2% | 496 / 500 |
| 10 | 99.2% | 496 / 500 |
| 20 | 100.0% | 500 / 500 |
前のエンジンと比較して、v3 は SHR@5 を 96.2% から 98.2% に、SHR@10 を 96.8% から 99.2% に向上させています。k=20 で 100% に達しており、前のエンジンが k=30 で報告した 97.8% を上回ります(LongMemEval issue #43)。 これらはすべて、回答モデルを使わない検索のみの測定値です。
† SHR@1 は、正しいセッションが最上位の結果になるかどうかを測定します。最初の結果の精度が高ければ、検索戦略が対応している場合、エージェントが取得するコンテキストを減らせます。SHR@8 は m3 のデフォルト検索深度です。質問の 99.2% で正解セッションが含まれており、LongMemEval-S では 25% 多くの行を取得する k=10 と同じ精度です。ほかのシステムでは通常、k=5、k=10、k=20、または k=50 が報告されます。比較する際は同じ k を使用し、その深度における m3 の数値を参照してください。
⁂ 集計方法。 これらは、LongMemEval の近接する提出で報告される慣例に従った、質問ごとの二値
recall_any@k値です。ベンチマークレポートの質問タイプ別の表では集計方法がわずかに異なり、浅い深度では少し高い値になります(k=5 で 98.8%、k=10 で 99.4%)。k=20 はどちらの方法でも 100.0% です。上の表では、より保守的な数値を示しています。
エンドツーエンド QA 精度 (回答モデルと判定者に依存)
データセットの質問タイプラベルを使用せず(オラクルルーティングなし)、精度 92.0%(正解応答 460/500 件)を達成しました。 これはシステム全体を測定したものです。SHR のようにシステム間で比較できない理由については、上記の注記を参照してください。
| 質問ドメイン | 件数 (n) | 精度 |
|---|---|---|
| single-session-user | 70 | 94.3% |
| single-session-assistant | 56 | 96.4% |
| single-session-preference | 30 | 80.0% |
| multi-session | 133 | 87.2% |
| temporal-reasoning | 133 | 95.5% |
| knowledge-update | 78 | 93.6% |
| 全体の概要 | 500 | 92.0% |
QA 数値の算出方法。 m3 は検索を行いますが、質問には回答しません。実運用では、呼び出し元のエージェントが検索対象を選び、回答を作成します。ベンチマークハーネスがその役割を担います。ハーネスの一部である質問テキストルーターを使って質問ごとに検索オプション(セッションの拡張と事前計算されたリコールサーフェス。どちらも m3 のエンジンで利用できますが、デフォルトではオフ)を選び、回答用のプロンプトとモデルを提供します。どちらの環境でも、m3 の組み込みインテントルーティングはデフォルトでオンです。検索指標(SHR)は m3 の検索機能のみを使用します。
手法と再現性の詳細は、LongMemEval-S ベンチマークレポートに記載されています。
パフォーマンス
- 書き込み: 埋め込みを遅延させると約 2 ms です。テキスト検索でメモリをすぐに見つけられ、認知ループを有効にすると、セマンティック検索でも 30 秒以内に見つけられます。埋め込みをインラインで実行する場合、書き込みに約 31 ms かかります。
- 検索: ベンチマーク用ストアで約 45 ms(p50)です。メモリが 50,000 件の場合、SQLite では 0.45 秒、pgvector を使用した PostgreSQL では 0.27 秒です。実際の 83,000 件のメモリを含むストアでは、SQLite で 2.7 秒、pgvector を使用した PostgreSQL で 0.54 秒で応答します。
- 並行処理: 16 個のエージェントが SQLite に同時に書き込んでもデータ損失はなく、待ち時間は最大でも 0.5 秒でした。
- ネイティブコア: Rust コアにより、MMR の再ランキングは 95×〜846×、バッチコサイン計算は 97×〜178×高速化します。コアがなくても結果は同じですが、処理に時間がかかります。
🔌 インターフェースとインテグレーション
2 つのインターフェースで 1 つのストアを共有します。 MCP サーバーと m3 CLI は同じデータベースにアクセスします。各ツールは stdin から JSON を読み込み、stdout に JSON を書き込みます。ツールは memory、files、chatlog、tasks、agent、admin、conversations、diagnostics、entity の各グループに分かれています。MCP 接続が切れてもメモリが停止するわけではありません。クライアントが再接続するまで CLI は動作を続けます。
コンテキストコストを抑えながら、カタログ全体を利用できます。 9 つのドメインに 100 個以上のツールがありますが、起動時に登録されるのは memory_write、memory_search、memory_supersede、memory_get、chatlog_search、m3_call の 6 つだけです。実際の開発セッションでは、4 つのメモリツール(memory_write、memory_search、memory_supersede、memory_get)が、直接呼び出されるツールの 95% を占めました。エージェントは m3_call を通じて名前を指定して他のツールを呼び出すか、ドメイン全体を読み込めます。
| ゲーティングモード | 登録済みツール | スキーマ内のトークン数 | 200K ウィンドウに占める割合 |
|---|---|---|---|
| 遅延(デフォルト) | 6 | 約 3,217 | 1.6% |
典型的なアクティブセッション(+memory +admin) | 60 | 約 19,549 | 9.8% |
イーガーモード(tools.lazy = false) | 120 | 約 33,149 | 16.6% |
エージェントとフレームワーク:
| エージェントまたはフレームワーク | 接続方法 |
|---|---|
| Claude Code | プラグイン(/plugin marketplace add skynetcmd/m3-memory、続けて /plugin install m3@skynetcmd):/m3:* コマンド、キュレーション用サブエージェント、チャットのキャプチャに対応します。または m3 setup を実行します。(プラグイン) |
| Codex | プラグイン(codex plugin marketplace add skynetcmd/m3-memory、続けて /plugins から m3 をインストール):スキル、チャットのキャプチャ、セッション開始に対応します。または m3 setup を実行します。(プラグイン) |
| Gemini CLI | 拡張機能(gemini extensions install https://github.com/skynetcmd/m3-memory)または m3 setup を実行します。m3 setup はチャットのキャプチャも設定します。(拡張機能) |
| Google Antigravity | プラグインまたは m3 setup を利用します。(プラグイン) |
| Cursor、Cline、OpenCode、OpenClaw | m3 setup が検出したクライアントをそれぞれ設定します。OpenClaw には 2026.3.22 以降が必要です。(クライアントのセットアップ) |
| Hermes Agent | m3 setup で設定する m3 のメモリプロバイダーを利用します。(Hermes) |
| Aider | チャットログウォッチャーとともに、m3 の MCP-to-OpenAI プロキシを介して接続します。(クライアントのセットアップ) |
| LangChain と LangGraph | Python ライブラリ:ストア、リトリーバー、チェックポインター(pip install "m3-memory[langchain]")。(ガイド) |
| CrewAI | ストレージバックエンド(pip install "m3-memory[crewai]")。(ガイド) |
| PydanticAI | ツールセットと履歴プロセッサー(pip install "m3-memory[pydantic-ai]")。(ガイド) |
| Claude.ai、Anthropic API、xAI API、OpenAI API | m3 serve を使ったリモート MCP に対応します。ChatGPT アプリのコネクターはサポートされていません(OAuth のみ)。(リモートクライアント) |
🛡️ プライバシー、セキュリティ、運用
インストール後、m3 はデフォルトでオフラインで動作します。インターネットに接続するのは、有効にした機能に必要な場合だけです。たとえば、エンリッチメント用に設定したクラウド LLM、指定したウェアハウスとの同期、m3 setup で同意した場合の日次バージョン確認(pypi.org へのリクエスト 1 回)です。
ソブリン・ローカル・エンベッダー
BGE-M3(1,024 次元)はインストール後にマシン上で動作します。127.0.0.1:8082 で共有エンベッドサーバーが 1 つ稼働し、すべての m3 プロセスが再利用するため、モデルは 1 つだけメモリに保持されます。プロセス内エンベディングは m3 setup でオプトインできます。モデルのコピーをプロセスごとに保持する代わりに、短文では約 1.9 倍、中程度の長さのテキストでは 1.75 倍高速になります。m3 embedder install-gpu で CUDA ビルド(テスト済み)、または Vulkan と Metal のビルドを追加できます。OpenAI 互換のエンベディングエンドポイントも利用できます(m3 config set embed.url …)。(エンベディング:共有方式とプロセス内方式)
Rust による高速化コア
ネイティブの Rust コア(m3_core_rs)がデフォルトでインストールされ、ランキングとベクトル演算を高速化します(パフォーマンスで測定)。これがなくても、m3 は純粋な Python で同じ結果を返しますが、処理速度は遅くなります。(Rust 化ベンチマーク)
エンタープライズ向けセキュリティとコンプライアンス
- FIPS 140-3 対応準備済み: m3 は暗号処理を実装していません。m3 独自の処理(シークレット保管庫、鍵導出、HMAC、監査チェーン、ランダム鍵)は、検証済みモジュール(wolfCrypt FIPS)で提供できる単一のプロバイダーを通じて実行され、すべてのネットワーク経路は明示的に定義され、FIPS モードではフェイルクローズします。対応準備は整っていますが、検証済みではありません。各経路とデプロイメントプロファイルについては、FIPS 境界リファレンスをご覧ください。
- エアギャップ環境へのインストール: コンパイル済みの Python wheel を使用し、インターネットに接続せずにインストールできます。(主権型デプロイメントガイドとFIPS 境界リファレンスをご覧ください。)
- ストレージの場所: データベース(
~/.m3/engine)、設定(~/.m3/config)、ログ(~/.m3/logs)はそれぞれ別のルートに保存されます。m3_config.tomlの[paths]で各ルートを個別に変更できるため、それぞれを独立して保護できます。 (設定リファレンス · アーキテクチャ)
運用
- Web ダッシュボード:
m3 dashboardを実行すると、127.0.0.1:8088でローカルのコントロールパネルが起動します。ナレッジグラフ、メモリブラウザー、競合ログと監査ログ(GDPR 対応アクションを含む)、システムの健全性を確認できます。(ダッシュボード) - Wiki:
m3 wiki generateを実行すると、メモリから相互リンク付きの Markdown 保管庫、単体で動作する HTML ビューアー、または Obsidian 保管庫を生成できます。(Wiki) - 診断:
m3 doctorはインストール全体を確認し、m3 doctor --fixは問題を修復します。m3 config show --originは、すべての設定とその取得元を表示します。 - 監査と GDPR: メモリの読み取りと検索ヒットはすべて、読み取りを行ったユーザー、データ主体、時刻とともに記録され、90 日間保持されます。
gdpr_exportとgdpr_forgetは、第 20 条と第 17 条に対応します。(GDPR)
🎯 対象ユーザー
m3 が最適なケース...
- ホームラボやセルフホストのスタックを運用している場合: m3 は
pip installひとつで導入でき、アカウントも API キーも不要です。有効にしない限り外部への通信も行いません。すでに所有しているハードウェア上で、ほかのセルフホストサービスとともに動作します。デフォルトでは SQLite を使うため、インフラは一切不要です。マシン間で共有ストアが必要な場合は PostgreSQL を使えます。 - 主権やデータレジデンシーの要件がある場合 — 企業、政府、防衛、医療など、規制対象の環境にも対応します。メモリと埋め込み表現が管理境界の外に出ることはありません。埋め込みモデルは自分のハードウェア上で動作し、ストアは自分で管理するファイルです。また、あらかじめコンパイルされたホイールを使えば、完全なエアギャップ環境でもインストールできます。FIPS 140-3 対応可能な暗号化(
crypto.fips_mode)、GDPR のgdpr_forget/gdpr_export、監査ログ、データベースと設定を個別に保護できる、移動可能なストレージルートも備えています。 - エージェントを切り替えたり追加したりしても、その知識を失いたくない場合: ツールをその場で、あるいは将来にわたって切り替えられます。Claude Code、Gemini、OpenClaw、Hermes など、今後登場するツールにも対応し、切り替え後もプロジェクトのナレッジを引き継げます。
- LangChain/LangGraph を使って開発する場合: 標準的なメモリモデルを高度に置き換え、二時点クエリ、バージョン履歴付きの置き換え、ローカル埋め込みを利用できます。
- CrewAI(v1.10–1.x)を使って開発する場合: ドロップインの
StorageBackend(Memory(storage=M3StorageBackend(user_id="crew-alpha")))を利用すると、CrewAI で二時点検索、バージョン履歴付きの置き換え、ローカル埋め込みが可能になります。さらに、単一ベクトルストアではできないことも実現できます。必要に応じて、CrewAI が書き込んだメモリを、ほかのすべての m3 エージェント(Claude Code、Gemini、LangChain)からも検索可能にできます。pip install m3-memory[crewai]を実行してください。CrewAI 統合ガイドをご覧ください。 - PydanticAI を使って開発する場合: m3 を利用したメモリを、ドロップインのツール+自動リコール(
register_m3_tools、m3_recall_processor)として、または正式なM3MemoryToolset(PydanticAI の実際のAbstractToolset)として利用できます。Pydantic v2 を基盤としているため、pip install m3-memory[pydantic-ai]だけで Python 3.14 上で動作します。PydanticAI 統合ガイドをご覧ください。 - セキュリティとコンプライアンスが必要な場合:
gdpr_forgetとgdpr_exportの組み込みツール、エアギャップ環境への対応、監査ログを備えています。 - プライバシーを重視する場合: クラウドサービスやサブスクリプションは不要です。設定しない限り、データがマシンの外に出ることはありません。
m3 が適さないケース...
- マネージドインフラを備えたホスト型 SaaS ダッシュボードが必要な場合(Lettaをご利用ください)。
- 永続的なメモリが不要な場合: 毎回のセッションをまっさらな状態で開始し、以前のセッションの知識を取得できないようにしたい場合です。m3 はその逆を実現するためのものなので、エージェントに組み込まれたデフォルト設定のほうが適しています。
⚖️ m3 の比較
m3 はローカルファーストで MCP ネイティブなメモリレイヤーです。マシン上で動作し、すでに利用しているエージェントと連携します。Mem0 は、抽出方法に独自の方針を持つクラウド指向のメモリサービスです。Letta は、会話ループを管理する完全なエージェント実行環境です。Zep と Graphiti はグラフを中心としたシステムで、通常は専用のグラフデータベースが必要です。m3 は、エージェントスタックの変更や追加インフラの運用を求めることなく、永続的で検索可能なバージョン管理付きメモリを提供します。
出典付きのベンチマークと、「別のツールを選ぶべき場合」についての率直なガイダンスを含む、m3 と Mem0、Letta、Zep、Graphiti、LangChain Memory/LangMem、agentmemory、Chronos、Hindsight、Mastra OM、Memento などとの、機能ごとの詳細な比較表は COMPARISON.md にあります。
🛠️ 開発者向け:フレームワークではなく、メモリバックエンド
MCP は任意です。 m3 はメモリ レイヤー です。永続的で検索可能なマルチエージェントメモリを担い、それ以上のことはしないため、既存の環境にそのまま組み込めます。すべてのツールは stdin から JSON を読み込み、stdout に JSON を書き出すため、SDK も MCP サーバーも使わず、あらゆる言語、フック、CI ステップ、cron ジョブから m3 をスクリプトで実行できます。
echo '{"query":"auth","k":3}' | m3 memory memory_search --json-file - | jq '.items[].id'
結果は組み合わせて利用でき、コード解析や VCS の監視など、言語固有の処理は境界のこちら側で行います。コーディング作業で m3 を使うでは、検索結果からの一括更新、ast や tree-sitter によるコードシンボルのインデックス作成、git フックや CI ステップのパターンを紹介しています。(jq は依存関係ではありません。どの JSON パーサーでも使えます。)
👀 動作を見る
MCP 経由でエージェントが行うことを、シェルから実行します(実際の実行結果を取得したものです。ID とスコアはお使いのストアによって異なります)。決定事項を保存します。
$ m3 memory memory_write --type decision --title "project-database" \
    --content "We chose PostgreSQL for our website."
"Created: 6795c684-53cb-4a6a-9518-819dbc585fe5"
後で、別のセッションまたは同じ m3 に接続された別のエージェントから、自分の言葉で質問します。
$ m3 memory memory_search --query "Which database did we decide to use?" --k 1
{
  "count": 1,
  "items": [
    {
      "id": "6795c684-53cb-4a6a-9518-819dbc585fe5",
      "content": "We chose PostgreSQL for our website.",
      "title": "project-database",
      "type": "decision",
      "importance": 0.5,
      "bm25_score": 0.0,
      "score": 0.9122939705848694
    }
  ],
  "query": "Which database did we decide to use?",
  "grade_with": [
    "6795c684-53cb-4a6a-9518-819dbc585fe5"
  ]
}
質問にはメモリと共通する単語がありません(bm25_score は 0.0)が、m3 は意味に基づいて見つけ出します。エージェントは同じツールを呼び出すため、もう一度尋ねることなく、決定事項を思い出せます。コアツールでは、最もよく使う 5 つのツールを紹介しています。動画で見たい場合は、字幕付きの短い動画で、あるエージェントが保存した決定事項を別のエージェントが思い出す様子をご覧ください(ダウンロード)。
⌨️ m3 CLI
コンテンツは --content またはファイル(memory_write_from_file --path)から取得し、ログは stderr に出力されるため、stdout をそのままパイプできます。m3 --version で m3 が起動しているか確認してください。CLI が応答すれば、MCP クライアントの接続が切れていてもメモリにアクセスできます(/mcp は Claude Code を再接続します)。(CLI リファレンス)
📦 インストール
Python 3.12 以降が必要です。 Python 3.11 では、pip によってサポート対象だった最後のリリースである 2026.9.12.0 がそのまま使われます。
python --versionで確認してください。HOW-TO-UPGRADE.mdに OS ごとのアップグレード方法を記載しています。メモリには影響ありません。仮想環境の外にある~/.m3/engineに保存されています。
先頭のインストール手順では一般的な方法(pip install m3-memory → m3 setup)を説明しています。このセクションでは、シェルインストーラー、エージェントごとの接続設定、MCP の手動設定といった代替手段を紹介します。
ワンライナー(macOS と Linux)
curl -fsSL https://raw.githubusercontent.com/skynetcmd/m3-memory/main/install.sh | bash
- Windows の場合は、Windows 手動インストールガイドに従ってください。
- どのプラットフォームでも手動でインストールする場合は、OS 別インストール手順を参照するか、インストーラースクリプトを確認してください。
開発者向けセットアップウィザード
Python 環境内で開発している場合:
pip install m3-memory
m3 setup
m3 setup ウィザードは、インストール済みのエージェント(Claude Code、Codex、Cursor、Cline、Gemini CLI、OpenCode、Antigravity、OpenClaw、Hermes)を自動的に 検出 し、それぞれに m3 memory MCP サーバーを接続して、設定ファイルやフックをインストールし、ソブリン CPU エンベッダーをプロビジョニングして、システム診断を実行します。検出と接続設定は m3 update/m3 setup の実行ごとに再度行われ、m3 doctor --fix はパスが変更された設定を付け替えます。そのため、後から インストールしたエージェントも、次回のセットアップまたは更新時に自動的に認識されます。
上記の各エージェントとフレームワークは、m3 setup またはそのプラグインを通じて接続します。連携一覧を参照してください。
MCP サーバーの手動設定
m3 を任意の Model Context Protocol ホストに公開するには、設定ファイルに追加します。
{
  "mcpServers": {
    "memory": {
      "command": "m3"
    }
  }
}
🧰 コアツール
m3 には100種類以上のツールがあります。この5つが主なインターフェースです。エージェントはこれらの名前を
正確に使用してください。別の名前を使うと unknown_tool が返されます。
| ツール名 | 機能 | 使用するタイミング |
|---|---|---|
memory_write | 事実、決定、好み、設定を保存します。 | 保存する価値のあることを初めて知ったとき。 |
memory_search | キーワード(BM25)検索とセマンティック検索(ベクトル検索)を組み合わせます。 | 書き込む前、およびユーザーが過去の作業について尋ねたとき。 |
memory_supersede | 古い事実を終了し、履歴を保持したまま置き換え先を記録します。 | 決定や認識が変わったとき。上書きするよりこちらを優先します。 |
memory_get | IDを指定してメモリを1件取得します。 | 検索結果ですでにIDがわかっているとき。 |
memory_suggest | すべての結果についてスコアの内訳を明示して検索します(m3_call 経由で使用します。起動時には読み込まれません)。 | 結果の順位の理由を確認したいとき。 |
メモリの正確性を保つためのルール:
- 書き込む前に検索します。 まず
memory_searchを呼び出してください。同様のメモリがある場合は、 重複して追加するのではなく、置き換えるか、memory_update(m3_call経由)で編集します。 - 上書きせず、置き換えます。 修正には
memory_supersede(または書き込み時の自動チェック)を使用し、as_ofを指定して古いバージョンも引き続き検索できるようにします。 - ピン留めで防げるのは経年劣化であり、修正ではありません。
memory_pinを使うと、メモリの劣化と期限切れを防げます。ピン留めされたメモリも、誤りになった場合は置き換えられます。
すべてのパラメーターはエージェント向け手順ガイドと
MCP ツールの全カタログを参照してください。機械可読スキーマは
docs/tools/MCP_CATALOG.json にあります。
🤖 AI エージェント向け
ルールセット examples/AGENT_RULES.md を
ワークスペースに追加し、メモリを適切に保つ習慣(書き込む前に検索する、重複させずに更新する)を
エージェントに教えてください。llm-context.md には
実際のツール名と使用ルールが記載されています。features.json は
機械可読な概要です。また、エージェント自身に m3 をインストールさせるための
コピー&ペースト用プロンプトは、エージェント向け手順にあります。
このページだけを読むエージェント向けの運用上の注意:
- 起動時に使用できるツールは
memory_write、memory_search、memory_supersede、memory_get、chatlog_search、m3_callです。それ以外のツールはすべてm3_call経由で利用できます。 - 書き込む前に検索し、修正には
memory_supersedeを使用してください。 - メモリにはスコープ(
agent、user、org)があり、ピン留めもできます。ピン留めで防げるのは 劣化であり、置き換えではありません。 - エンベッダーはデフォルトでローカルの
127.0.0.1:8082で実行されます。セマンティック検索で 結果が何も返されない場合は、embedder_statusを確認するか、m3 embedder fetch-modelでモデルをダウンロードしてください。
🎬 動作を見る
書き込み時の置き換えとバージョン履歴
ハイブリッド検索のスコア詳細
複数デバイス間のデータベース同期
💬 コミュニティ
コントリビューション方法 · 開発者向け FAQ · 初心者におすすめの課題
📜 ライセンスとクレジット
このプロジェクトは Apache License 2.0 の下でライセンスされています。詳細は LICENSE をご覧ください。
使用したツール
m3 Memory は skynetCMD が作成し、保守しています。開発にあたっては、AI コーディングアシスタントの Gemini CLI、Claude Code、Google Antigravity の支援を受けており、作者の指示のもとでコードを提供しました。(これらは支援ツールであり、プロジェクトの保守担当者、スポンサー、共同所有者ではありません。)
アセットとアイコンのクレジット
docs/badges/ 内のプロバイダーバッジには、小さなロゴのグリフが含まれています。
- OpenClaw と OpenCode のアイコンは、MIT ライセンスの LobeHub icon set(
lobe-icons)のものです。 - Hermes バッジには、一般的なカドゥケウスのグリフを使用しています。
サードパーティへのクレジット表記の全一覧は NOTICE をご覧ください。
PyPI の累計ダウンロード数と過去30日間のダウンロード数です。GitHub のクローン数はユニークなクローン数です。バッジはstar-history.ymlによって定期的に再生成されます。
Python:m3 のコアは Python 3.12、3.13、3.14、3.15 で動作します。オプションのフレームワーク用追加パッケージには、それぞれ個別の上限があります。PydanticAI は Python 3.14 にネイティブ対応しています(通常の pip install)。CrewAI を m3 と併用する場合は Python 3.12~3.13 が必要です(Python 3.14 での回避策はドキュメントに記載されています)。
⭐ スター履歴
⭐ スター履歴を表示 →(クリックしてグラフを展開)
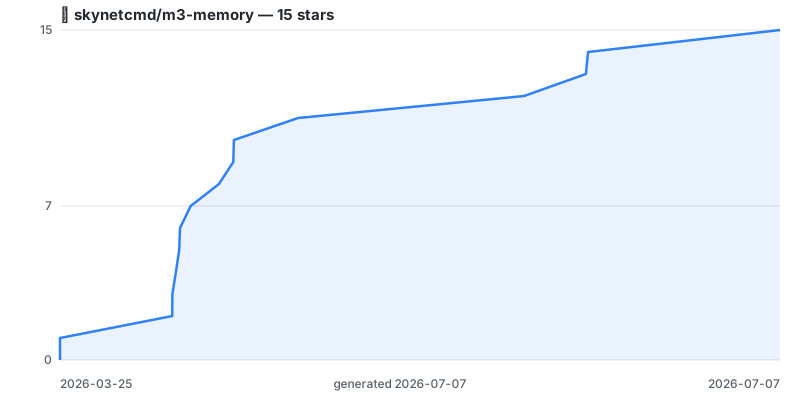
グラフはリポジトリ独自のトークンを使って.github/workflows/star-history.ymlにより定期的に再生成されます。サードパーティの埋め込みはありません。クリックすると、ライブのインタラクティブ版が表示されます。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。