MemoryPilot について
MemoryPilotは、AIエージェント向けのローカル長期記憶MCPサーバーです。ハイブリッド検索、ナレッジグラフ、記憶の圧縮を組み合わせ、単一バイナリでプロジェクトを意識したセッション横断検索を提供します。
主な機能
- 01BM25とベクトルのハイブリッド検索
- 02時系列ナレッジグラフとGraphRAG
- 03記憶の自動分類と圧縮
- 04セッション横断のプロジェクト別記憶
- 05100以上の言語に対応
活用シーン
- 01セッションをまたいでコーディング状況を引き継ぐ
- 02多言語の過去の記憶を検索する
- 03コンテキストを圧縮してトークンを節約する
MCP 対応
MCPサーバーとして、クライアントに永続記憶の保存と検索機能を提供します。READMEにはHTTP APIも記載されています。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
このサーバーのパッケージやリモートエンドポイントはまだ取得できていません。プロジェクトの README の手順に従ってください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
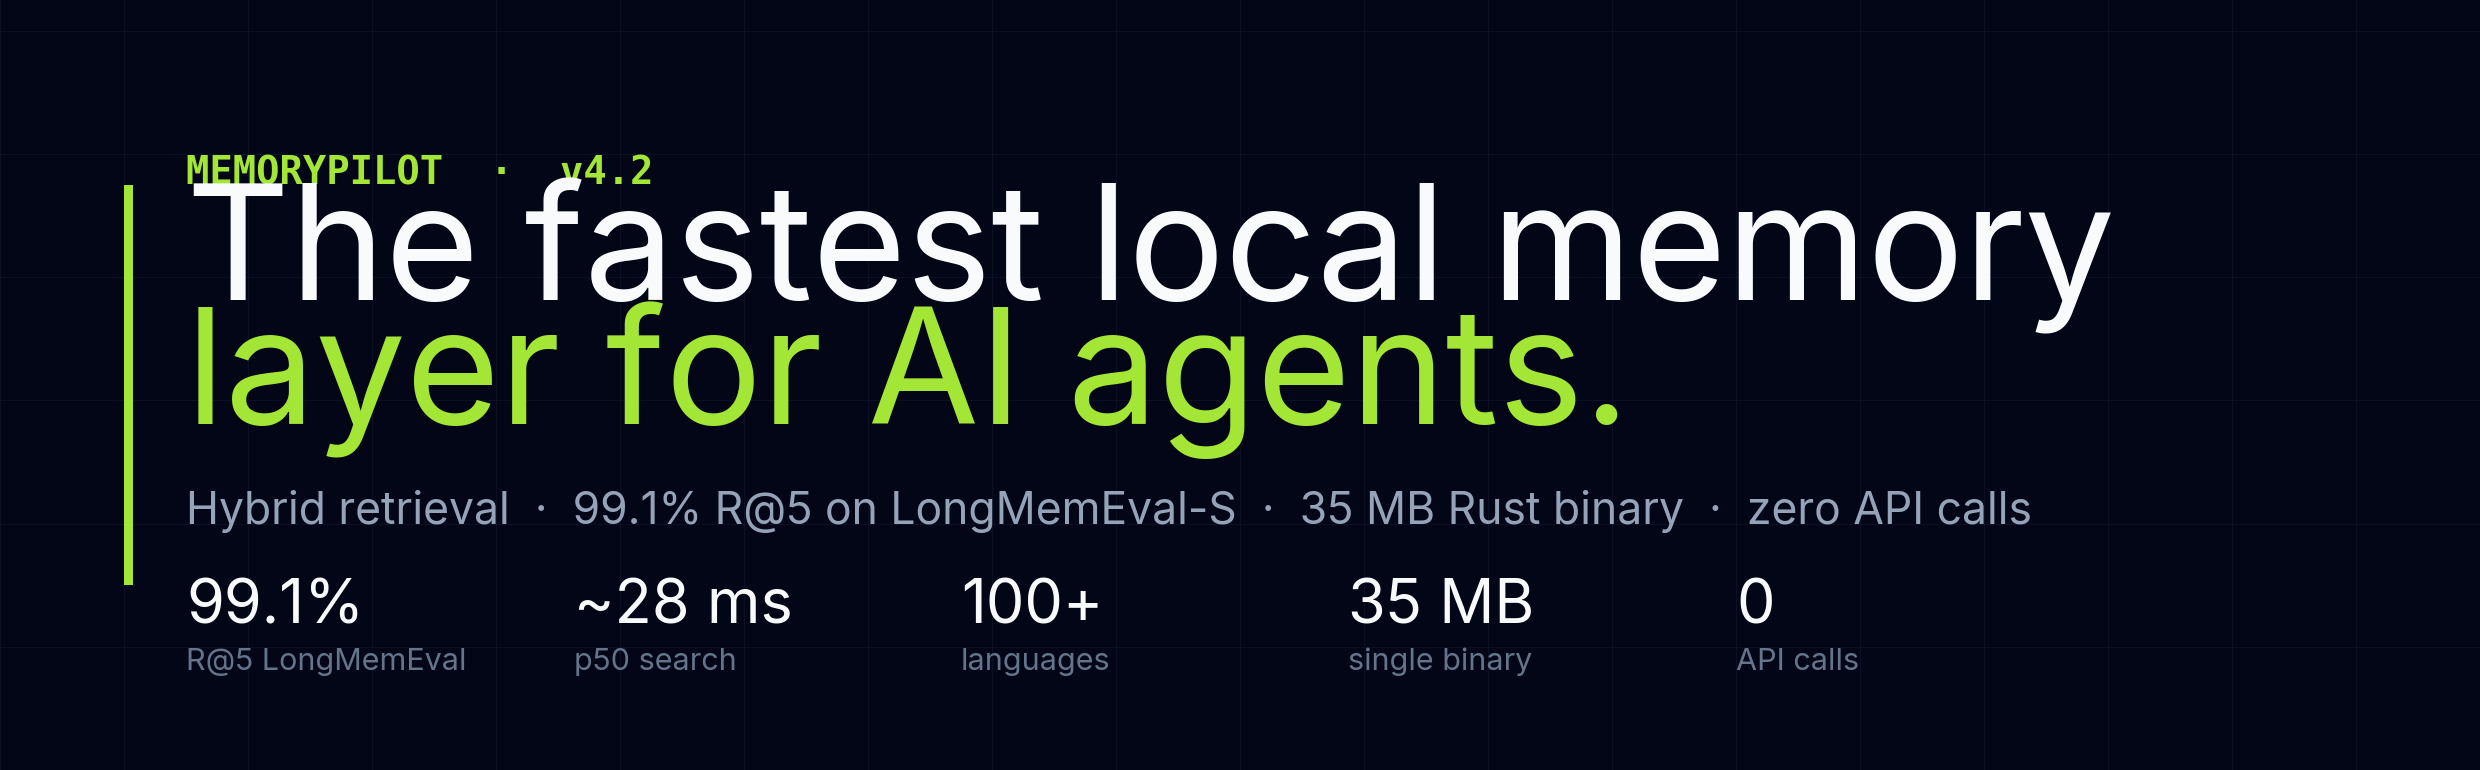
最も高度な MCP メモリサーバーです。これ以上はありません。
ハイブリッド検索(BM25 + jina-embeddings-v5 RRF + cross-encoder による再ランキング) · 100 以上の言語 · 時系列ナレッジグラフ · クエリを考慮したランキング · コーパスの出所検出 · エージェント/ペルソナの曖昧性解消 · トピックトンネル · AAAK 圧縮(トークンを 5~10 倍節約) · GraphRAG · チャンク化 RAG · 自動圧縮 · 自動分類 · メモリカプセル · HTTP API · 単一バイナリ · API 呼び出しゼロ




なぜ必要なのか
AI コーディングアシスタントは、セッションをまたぐとすべてを忘れてしまいます。MemoryPilot は、プロジェクトを認識し、意味を理解し、知識を自動整理する、永続的で検索可能なメモリを提供します。組み込みの AAAK 圧縮とメモリカプセルにより、コンテキストの読み込み時にトークン消費を 5~10 倍削減します。各メモリは登録時に、適切な重要度、種類、TTL で自動分類されます。データベースは自動的に圧縮されるため、メンテナンスは不要です。
MemoryPilot をインストールCursor、Claude Desktop、VS Code、Windsurf、Claude Code、Codex、ChatGPT 向けのワンライナーインストール。Rust の単一バイナリで、ランタイム依存関係はありません。 |
仕組み9 つの柱 — ハイブリッド検索、時系列ナレッジグラフ、GraphRAG、AAAK 圧縮、自動分類、自己修復 — を、最初から最後まで解説します。 |
ベンチマーク
LongMemEval-S(ICLR 2025)— 学術標準
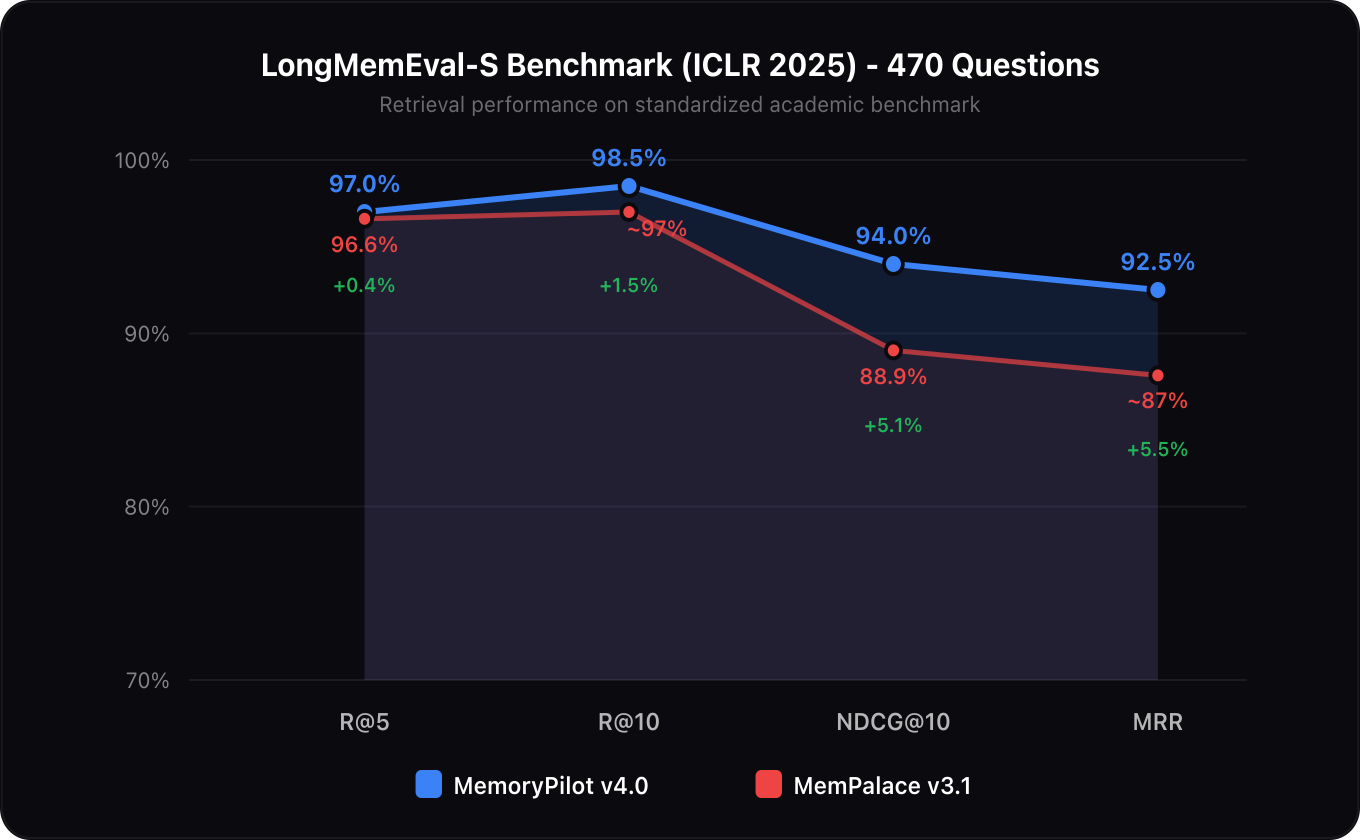
長期メモリ検索の学術標準データセットであるベンチマーク LongMemEval の 470 問で評価しました(ICLR 2025)。ターン単位の粒度で、各 haystack は約 50 セッションです。
市場全体との比較(LongMemEval-S、公開済みの数値)
| システム | R@5 / 精度 | レイテンシ | プライバシー | 技術スタック | 出典 |
|---|---|---|---|---|---|
| MemoryPilot v4.2(適応型) | 99.1% | ~900 ms | 100% ローカル | Rust · 35 MB バイナリ · API 不使用 | このリポジトリ、--benchmark-longmemeval @470 |
| MemoryPilot v4.2(デフォルト高速) | 98.7% | ~28 ms | 100% ローカル | Rust · 35 MB バイナリ · API 不使用 | このリポジトリ、--benchmark-longmemeval @470 |
| MemPalace v3.3.3(ハイブリッド) | 98.4% | 未公開 | 100% ローカル | Python + ChromaDB · ~500 MB | MemPalace v3.3.3 リリースノート |
| agentmemory v0.9(スター数 11k 以上) | 95.2% | 未公開 | 100% ローカル | Node + iii-engine + SQLite | github.com/rohitg00/agentmemory — benchmark/LONGMEMEVAL.md |
| Mem0(クラウド、OpenAI バックエンド) | 94.4% | ~6 787 トークン/クエリ | クラウド(OpenAI) | SaaS + OpenAI 埋め込み | mem0.ai blog |
| mcp-memory-service v10.34.0 | 80.4% | 未公開 | 100% ローカル | Python + SQLite-Vec + MiniLM | v10.34.0 release notes |
| Zep / Graphiti | 63.8% | 「ベースライン比で 90% 低減」 | クラウドまたはセルフホスト | Python + Neo4j + LLM による抽出 | arXiv 2501.13956 |
| Letta / MemGPT | LongMemEval で未測定 | — | セルフホスト | Python フレームワーク | Letta tracking issue #3115 |
MemoryPilot は、この比較で 100% ローカルでありながら、リーダーボードの首位に立つ唯一のシステムです。デフォルトの高速モード(~28 ms)だけでも、agentmemory(95.2%)を含む、公開済みの競合製品すべてを上回っています。agentmemory は、GitHub スター数が 11k を超える、AI エージェントメモリ分野で現在注目を集めている製品です。適応型クロスエンコーダーモードでは、クエリごとに ONNX による再ランク付けを 1 回実行する代わりに、R@5 が +0.4 pp 向上し、agentmemory に対する MRR のリードが +6.7 pp(94.9% 対 88.2%)になります。
詳細 — MemoryPilot と MemPalace(最も近いローカル競合製品)の比較
| 指標 | MemoryPilot v4.2(デフォルト高速) | MemoryPilot v4.2(適応型再ランク付け) | MemPalace v3.3.3 | MemPalace との差 |
|---|---|---|---|---|
| R@5 | 98.7% | 99.1% | 生値 96.6% / ハイブリッド 98.4% | 生値比 +2.5% / ハイブリッド比 +0.7% |
| R@10 | 99.6% | 99.4% | ~97%¹ | 生値比 +2.6% |
| NDCG@10 | 95.1% | 96.0% | 未公開 | MemoryPilot は公開 |
| MRR | 93.6% | 94.9% | 未公開 | MemoryPilot は公開 |
| 平均検索レイテンシ | ~28 ms | ~900 ms | N/A | デフォルトモードは 30 倍高速 |
¹ 保留中の 30 件の棄権問題を除いた、全 470 問の評価セットを使用して検証しました。2 つのモードがあります。デフォルトの高速ローカルハイブリッド検索(BM25 + コサイン RRF、~28 ms/クエリ。MCP のライブトラフィックに適しています)と、適応型クロスエンコーダー再ランク付け(
MEMORYPILOT_CROSS_RERANK=adaptive、jina-v2-multilingual、融合重み 0.45、~900 ms/クエリ。ベンチマークや高い再現率が求められる用途に適しています)です。デフォルトモードでも、保留データでの MemPalace のハイブリッド結果を上回ります。適応型モードでは、レイテンシと引き換えに R@5 がさらに +0.4 pp、MRR が +1.3 pp 向上します。
カテゴリ別(470 問、適応型再ランク付け)
| カテゴリ | R@5 | R@10 | MRR |
|---|---|---|---|
| single-session-user(64) | 100% | 100% | 96.6% |
| single-session-assistant(56) | 100% | 100% | 98.8% |
| multi-session(121) | 100% | 100% | 95.7% |
| knowledge-update(72) | 100% | 100% | 98.2% |
| temporal-reasoning(127) | 97.6% | 98.4% | 93.3% |
| single-session-preference(30) | 96.7% | 96.7% | 75.9% |
フランス語/多言語ベンチマーク — --benchmark-fr
英語のみの LongMemEval を補完するため、MemoryPilot には、インフラ、モバイル、ウェブ、セキュリティ、ML の各分野を対象に、109 件のメモリーと、それらを言い換えた 109 件のクエリを網羅する、決定論的な独自のフランス語ベンチマークが用意されています。クエリは、インデックス化された表現とは意図的に大きく異なる言い回しにしてあり、セマンティックレーンが実際に機能するかを検証できます。
| モード | R@5 | R@10 | MRR | 平均レイテンシ |
|---|---|---|---|---|
| デフォルトの高速モード(BM25 + jina RRF) | 92.7% | 99.1% | 74.4% | ~100 ms |
| アダプティブなクロスエンコーダーによる再ランキング(デフォルト) | 99.1% | 99.1% | 97.4% | ~210 ms |
v4.5 では、v4.0 以降このベンチマークの R@5 を約 70% に抑えていたランキングの不具合を修正しました。ナレッジグラフの近傍ノードが固定スコア(0.1)で、実際の RRF ヒット(最大 2/41 ≈ 0.049)よりも高いスコアで挿入されていたため、クロスエンコーダーのウィンドウを占有し、実際の一致候補が limit の範囲外に押し出されていました。近傍ノードは、実際の候補のうち最もスコアが低いものよりも低い位置に追加されるようになり、昇格できるのはクロスエンコーダーだけになりました。
v4.5.0 では、この対応の過程で判明した、書き込み経路に関する 2 件の安定性の不具合も解消しました。エピソードのロールアップは、エピソードがすでに存在するかを確認する前に、毎回すべての時間単位のバケットを埋め込み、さらに add_memory 内で同期的に実行されてから、複数バイトのフランス語テキストでパニックしていました。現在は、まず低コストの存在確認を行い、その後、専用スレッドで実行されます。また、自動コンパクションは run_gc/compact_to_capsules の実行中に Mutex を保持していましたが、これらの関数でマージされた行は再び add_memory に入ります。ロールアップが先にパニックしなくなるまで、このデッドロックは隠れていました。
決定論的なメモリー ID、決定論的な ID ベースの RRF 同点処理、同期的な ANN ウォームアップ、最初のクエリ前の明示的なクロスエンコーダーの事前ウォームアップにより、実行ごとの変動は R@5/R@10 で ±1 pp 以内に抑えられます。フランス語/多言語でのリグレッションを確認する際は、この指標に注目してください。
v4.6 — 単一の事実検索を超えて
v4.6.0 は、top-k リトリーバーだけでは対応しきれない LongMemEval のカテゴリ、つまり複数セッションの集約、時間的推論、知識の更新、回答の棄権を対象としています。すべてローカルで実行し、ルールベースまたは int8 ONNX を使用します。LongMemEval-S@100(64 件の単一セッション質問+36 件の複数セッション質問、およびこのスライスの棄権に関する 7 件の質問)で v4.5.0 と比較した測定結果です。同じマシンで、クロスエンコーダーは適応型です。
| 指標 | v4.5.0 | v4.6.0 |
|---|---|---|
| R@5 / R@10 | 99% / 100% | 100% / 100% |
| MRR / nDCG@10 | 96.3% / 97.2% | 96.5% / 97.3% |
| 複数セッションの正解データ網羅率@10 | 93.6% | 94.5% |
| top-10 に正解データの全セッションを含む複数セッション質問 | 30/36 | 32/36 |
| 回答可能な質問に対する誤った棄権 | — | 4% |
抽出型回答(search_memory … answer=true)、正解を含む割合 | — | 48%(単一セッションでは 72%。数え上げの質問はスパン抽出では対応できません) |
--benchmark-fr の結果は、測定誤差の範囲内で変わりません(R@1 96.3%、R@5 99.1%、MRR 97.6%)。
- MMR による多様性(
src/diversity.rs)— 最終候補と、そのすぐ下にある RRF 順位の候補を、保存済みベクトルに対する最大限の周辺関連性(λ = 0.4、冗長性の下限 0.55)で並べ替えます。最上位の結果は移動しないため、MRR は変わりません。最初の情報源の言い換えではなく、別の情報源を 2 件目として選べるようになります。MEMORYPILOT_MMR=0で無効にできます。 - 時間的根拠付け(
src/temporal.rs)— メモリ内の明示的な日付(2026-09-01、12 septembre 2026、September 12、hier…)は取り込み時にdateエンティティになり、クエリ内の時間表現(last week、il y a deux semaines、en mars、last Tuesday)は日単位の期間になります。この期間内の日付付き候補のスコアを上げ(×1.25)、大きく外れた日付付き候補のスコアをわずかに下げます(×0.85)。日付のないメモリには影響しないため、期間の解析を誤っても損失は最大でブースト分にとどまります。MEMORYPILOT_TEMPORAL=0で無効にできます。 - コンテキスト付き埋め込み — 文字起こしのチャンクなど、コンテキストが少ない種類のデータは、保存される内容とそのハッシュを変更せずに、
[date · project]のプレフィックスを付けて埋め込みます。 - 置き換え — 毎日の統合処理では、値が変わった、より新しくほぼ同一の言い換えにメモリを紐付けます(コサイン類似度 ≥ 0.86、語彙の重複率 0.55–0.95、1 時間以上の間隔)。検索時には古い方の順位を下げます(−0.35)。どちらも検索可能なままです。
consolidate_memories(apply=true)は作成されたリンクを報告します。 - 信頼度の調整 — すべての検索で
confidence: { top_cosine, peak, cross_score, margin, level, abstain }が返されます。LongMemEval の棄権用ハイスタックは、同じユーザーの別セッションから構成されており、回答可能な質問と区別できる簡易なシグナルがありません(top-1 のコサイン類似度 p50 は 0.46 対 0.54、クロスエンコーダーのロジットは完全に重複します)。そのため、明示的なabstainの判定は意図的に保守的です(コサイン類似度 < 0.35、誤った棄権は 4%)。段階的なシグナルはlevelで示されます。MEMORYPILOT_ABSTAIN_COSINEで下限を変更できます。 - 抽出型リーダー(
src/reader.rs、オプトイン)—answer: trueを指定してsearch_memoryを実行すると、上位 5 件のパッセージに対してdeepset/roberta-base-squad2(int8 ONNX、125 MB、英語対応)を実行し、必要に応じてアイドルプールから読み込んで、文字どおりのスパンまたは何も返しません。CPU では質問 1 件あたり約 480 ms です。これはベンチマーク用の手段であり、文字どおりの検索を手早く行うためのもので、言語モデルではありません。リトリーバーが回答できなかった LongMemEval の棄権質問 7 件のうち 5 件で、回答を棄権しました。--benchmark-longmemeval --readerで、SQuAD 形式の EM / F1 / 正解を含む割合を報告します。
検索品質 — 実環境(500 件のメモリ、30 のシナリオ)
| 指標 | MemoryPilot v4.2 | MemPalace v3.1(生データ) | Quantum Memory Graph |
|---|---|---|---|
| R@5 | 100% | 96.6% | 93.4% |
| R@10 | 100% | N/A | 93.4% |
| NDCG@10 | 95.6% | 88.9% | 90.8% |
| クラスターの一貫性 | 96.7% | N/A | N/A |
| 多言語対応 | 100 以上の言語(フランス語で検証済み、R@5 99.1%) | 英語のみ | 英語のみ |
| AAAK 圧縮 | 5~10 倍(再現率の低下なし) | 30 倍(再現率が 84.2% に低下) | N/A |
| 平均検索レイテンシ | 約 28 ms(デフォルト)/約 410 ms(適応型) | N/A | 約 80 ms |
| バイナリサイズ | 35 MB | 約 500 MB(Python+ChromaDB) | 1.5 GB |
| 依存関係 | 0(単一バイナリ、ONNX 同梱) | Python + ChromaDB + SQLite | Python + ONNX |
市場最高水準のメモリーサーバーとの比較:
| 機能 | MemoryPilot v4.7 | MemPalace v3.3.3 | agentmemory v0.9 | Mem0 | Zep / Graphiti |
|---|---|---|---|---|---|
| LongMemEval R@5 | 99.1% | 98.4% | 95.2% | 94.4% | 63.8% |
| LongMemEval MRR | 94.9% | 未公開 | 88.2% | 未公開 | 未公開 |
| 検索 | ハイブリッド BM25 + jina-embeddings-v5-nano RRF(768 次元、int8)+ 適応型 mmarco クロスエンコーダー | ChromaDB コサイン類似度(all-MiniLM-L6-v2) | BM25 + ベクトル + グラフ(RRF) | ベクトル検索(クラウド API) | 時間的 KG トラバーサル + ベクトル |
| 埋め込み | jina-embeddings-v5-text-nano-retrieval(100 以上の言語、8k コンテキスト、ローカル ONNX) | all-MiniLM-L6-v2(英語のみ) | all-MiniLM-L6-v2(英語のみ) | OpenAI API 呼び出し(外部) | OpenAI / クラウド LLM による抽出 |
| 多言語対応 | 100 以上の言語にネイティブ対応(FR、EN、ES、DE、JA、ZH...) | 英語のみ | 英語のみ | API に依存 | LLM バックエンドに依存 |
| ナレッジグラフ | 有効期間 + 信頼度を持つ時間的トリプル | 時間的トリプル(SQLite) | ナレッジグラフ(有効期間なし) | 基本的なグラフ(時間情報なし) | 時間的 KG(Graphiti、コア機能) |
| GraphRAG | エンティティの自動抽出 + グラフトラバーサル + 組み合わせ型リランカー | なし | 部分対応(グラフ検索レーン) | なし | あり(LLM ベースの抽出) |
| クロスエンコーダーによる再ランク付け | jina-v2-multilingual(適応型、約 250 ms) | なし | なし | なし | なし |
| クエリ対応のランキング | 設定、時間、役割、更新、技術的意図によるブースト | ハイブリッド v4 のキーワード + 時間ブースト | RRF 融合のみ | API に依存 | グラフ距離によるスコアリング |
| コーパス起源の検出 | AI のトランスクリプト / コードベース / メモ / プラットフォームを検出 | v3.3.4 で準備予定 | なし | なし | なし |
| エージェント / ペルソナの曖昧性解消 | エージェントと実在の人物を分離 | v3.3.4 で準備予定 | フックベースのセッションスコープ | なし | 部分対応(エンティティノード) |
| トピックトンネル | KG を介したプロジェクト横断のトピックリンク | v3.3.4 で準備予定 | なし | なし | なし |
| コード対応のチャンク分割 | Tree-sitter による Rust/Python/TS/TSX/JS + Svelte スクリプトの抽出 | Tree-sitter によるコードのチャンク分割 | なし | なし | なし |
| チャンク分割 RAG | トランスクリプトの自動チャンク分割 + 自動蒸留(8 種類) | 会話をやり取りごとにチャンク分割 | セッションの再生 + JSONL インポート | なし | LLM ベースの要約 |
| 圧縮 | AAAK + Memory Capsules(トークンを 5~10 倍節約) | AAAK 方言(実験的、再現率が 84.2% に低下) | 4 層統合 + 減衰 | なし | なし |
| 自動分類 | 挿入時にゼロショットで種類 / 重要度 / TTL を判定 | なし | フックによるパターンベース | なし | LLM 分類エンティティ |
| 自動コンパクション | メモリが 500 件以上になると GC を自動実行 | なし | ライフサイクル減衰 + 自動忘却 | なし | 手動 |
| Memory Capsules | 古いメモリを高密度な要約に圧縮 | なし | 階層ベースの統合 | なし | なし |
| メモリのピン留め | 重要なメモリをピン留め — 常に想起対象となり、GC の対象外 | なし | なし | なし | なし |
| グラフトラバーサル | KG 経由で関連するメモリを検索(深度 1~3) | なし | あり(グラフレーン) | なし | ネイティブ対応(Cypher / Neo4j) |
| 一括操作 | 種類 / プロジェクト / タグ / 経過時間で安全ガード付きの削除 | なし | ガバナンス削除 API | なし | 手動 |
| ヘルスダッシュボード | メモリの分布、古いメモリ数、孤立データ、DB サイズ | なし | リアルタイムのウェブビューアー(ポート 3113) | なし | なし |
| 重複検出 | 類似重複を Jaccard 類似度でスキャン | なし | ドキュメントに記載なし | なし | LLM ベースの調整 |
| 人物検出 | テキストからチームメンバーを自動検出 | なし | なし | なし | LLM による抽出エンティティ |
| 自己修復 | バックグラウンドで自動リンティングを実行 | なし | なし | なし | なし |
| ガベージコレクション | ヒューリスティックな統合 + スコアリング + 孤立データのクリーンアップ | なし | ライフサイクル + 減衰 | 基本的な TTL | 自動 GC なし |
| プロジェクトブレイン | あり、チームメンバー対応(1500 トークン未満) | なし | 必要に応じてセッションを要約 | なし | なし |
| ファイルウォッチャー | 最近の編集からコンテキストを強化 | なし | ファイルシステムコネクター(@agentmemory/fs-watcher) | なし | なし |
| 重複排除 | コンテンツハッシュ(完全一致)+ Jaccard 85%(あいまい一致) | 基本的なハッシュ | 信頼度スコアリング | 埋め込みの類似度 | LLM ベースのマージ |
| HTTP API | マルチスレッド REST サーバー(オプション) | なし | REST + MCP + リース + シグナル | クラウドホスト型 | REST + GraphQL |
| メモリの種類 | 13 種類、重要度 1~5 | Wings/Rooms の階層 | 階層ベース(作業用 / 短期 / 長期 / アーカイブ) | 1 種類 | エピソード / セマンティック |
| MCP ツール | 41 個のツール | 29 個のツール | 51 個のツール | 該当なし | 限定的な MCP サーバー |
| フック / イベントの取得 | Cursor、Claude Code、Codex 向け SessionStart の自動想起 + Stop の自動取り込み(増分処理、蒸留、エージェントのナレーションをフィルタリング、シークレットを秘匿)+ ファイルウォッチャー | なし | 名前付きフック 12 個(Claude Code、Cursor、Codex、Copilot CLI…) | なし | なし |
| プライバシー | 100% ローカル、API 呼び出しなし | 100% ローカル | 100% ローカル(SQLite) | クラウドに依存 | クラウドまたはセルフホスト可能(LLM が必要) |
| 言語 | Rust(単一バイナリ、依存関係なし) | Python(pip install) | TypeScript / Node(npm install) | SaaS | Python + Neo4j |
| 起動 | 1~2 ms(open_at)/ open_at_warm による同期ウォーム起動 | 約 5 ms | Node の起動 + iii-engine の初期化 | 該当なし(クラウド) | 重い(Neo4j の起動) |
| バイナリ | 35 MB の単一バイナリ | Python + ChromaDB(インストール後、約 500 MB) | Node ランタイム + iii-engine の依存関係 | SaaS | Python + Neo4j(約 1.5 GB) |
| ストレージ | SQLite WAL + FTS5 + 16 接続の読み取りプール | ChromaDB | SQLite + iii-engine | クラウド DB | Neo4j + Postgres |
| 並行性 | EmbedPool(4)+ RerankPool(1、調整可能)+ 読み取り接続 16 個 + デバウンス付きクリーンアップ | シングルスレッド | Node イベントループ | シングルスレッド | Neo4j に依存 |
| 外部 LLM への依存 | なし | なし | なし(ローカル埋め込み) | OpenAI が必須 | 取り込みに LLM が必須 |
| GitHub スター数(2026 年 9 月) | まだ少ない | まだ少ない | 約 28.9k | 53k | — |
9つの柱
1. ハイブリッド検索(BM25 + jina RRF)
メモリを追加すると、ONNX Runtime(jina-embeddings-v5-text-nano-retrieval、int8、ローカル推論)を使って768次元のトランスフォーマー埋め込みが生成されます。このモデルはフランス語、英語、スペイン語、ドイツ語、日本語、中国語を含む100以上の言語に対応しており、API 呼び出しや外部サービスは不要です。モデルは初回実行時に Hugging Face リポジトリから取得されます。ライセンスは CC-BY-NC-4.0 です。クエリとドキュメントには、モデルの非対称な Query: / Document: プレフィックスを使用します。int8 の重みはメモリマップされるため、埋め込みモデルが常駐するメモリは約250 MBで、その大半は再利用可能なファイルバックページです。検索では、BM25 全文検索とコサイン類似度を並行して実行し、その後、逆順位融合で結果を統合します。
結果には、重要度による重み付け、ナレッジグラフのリンク密度、ファイル監視コンテキストに基づくブーストが適用され、期限切れのナレッジトリプルにはペナルティが適用されます。
同じ MCP では、remember_working、recall_working、clear_working を使って一時的な作業メモリを利用できます。RAM 上にセッション用の高速なスクラッチパッドコンテキストを保持し、最大256項目に制限することで、SQLite や永続的な検索機能を汚しません。
パフォーマンス最適化:
- 遅延埋め込み:
add_memoryは即座に戻り、埋め込みはバックグラウンドスレッドで計算されます - 2層のクエリ埋め込みキャッシュ(LRU 256 + SQLite へのライトスルー):クエリを繰り返す場合、ONNX 推論をスキップします
- 読み取り接続プール(16接続):同時実行されるベクトル検索が書き込みをブロックしません。HTTP サーバーのワークロードに合わせて調整されています
- EmbedPool(4セッション、環境変数で調整可能):単一の ONNX ミューテックスで直列化せずに、埋め込みを並行して実行します
- RerankPool(1セッション、環境変数で最大2に調整可能):複数クライアント負荷のもとで、クロスエンコーダーによる再ランキングを並行して実行します
- コンテンツハッシュ(FNV-1a):バックフィル時に、変更されていないメモリをスキップします
- 同期ウォームアップエントリーポイント
open_at_warm:返却前に ANN インデックスを RAM に読み込み、コールドスタート時の遅延を解消します(4クライアント同時実行ベンチマークでの p95 検索レイテンシー:3939 ms → 229 ms)
2. 時間的ナレッジグラフ
時間的な有効性を備えた完全なナレッジグラフです。事実には valid_from / valid_to の日付と confidence スコアがあります。事実が古くなった場合は削除せず無効化するため、AI が知識の変遷をたどれます。
エンティティ(技術、ファイル、コンポーネント、人など)はメモリの内容から自動的に抽出され、双方向にリンクされます。トリプルがすべて期限切れになったメモリの検索結果には、ペナルティが適用されます。
専用 KG ツール5つ: kg_add、kg_invalidate、kg_query、kg_timeline、kg_stats
3. GraphRAG
すべてのメモリは、技術、ファイルパス、コンポーネント、プロジェクト、人などのエンティティについて自動的に分析されます。エンティティは専用のテーブルに保存されます。エンティティを共有するメモリは、推定された関係タイプ(resolves、implements、depends_on、deprecates など)で自動的にリンクされます。
検索時、MemoryPilot は上位の一致結果からナレッジグラフをたどり、関連するコンテキストを取り込みます。たとえば、特定のバグ修正につながったアーキテクチャ上の決定を見つけられます。さらに、組み合わせ型再ランカーが、独立した上位 K 件の結果ではなく、つながりのある最適なクラスタを選択し、一貫性のあるコンテキストを生成します(クラスタの一貫性は94%)。調整済みの RRF 融合(k=40)、完全一致する用語のカバレッジブースト、スマート FTS トークン化、クエリ時の KG 拡張、時間的な新しさ、重要度によるタイブレーカーにより、NDCG@10 は94%、R@5/R@10 は100%に達します。
4. チャンク化 RAG(トランスクリプト)
LLM のコンテキストウィンドウを圧迫せずに、会話のトランスクリプト全体を保存できます。add_transcript ツールは、大きなテキストを自動的に約 2000 文字のブロックに分割し、それらを相互にリンクします。チャンクは recall の対象外ですが、すべて検索できます。
ソースコードについては、MemoryPilot はデフォルトで Rust、Python、TypeScript、TSX、JavaScript のローカル tree-sitter 解析を使用し、Svelte は <script> の抽出とマークアップのチャンク化によってサポートします。コードは任意の段落ではなく、関数、クラス、impl ブロック、インターフェース、エクスポートなどの意味的な境界で分割されます。
自動蒸留により、トランスクリプトから decision、preference、todo、bug、milestone、problem、note の構造化メモリーが抽出されます。スマートな曖昧さ判定により、バグとその解決の両方に言及するセグメントは、bug ではなく milestone に分類されます。
複数ウィンドウのメモリースコープ設定に対応する session_id、thread_id、window_id をサポートします。
5. AAAK 圧縮
MemPalace の記号的なメモリー言語に着想を得ています。recall または get_project_brain に compact: true を渡すと、簡潔なパイプ区切り形式で出力が約 3 倍に圧縮されます。
[DEC:5] Use Clerk over Auth0 | tags:auth,stack | proj:MyApp
[PREF:4] Always use TypeScript strict mode | tags:typescript
6. 自己修復(自動リンター)
MemoryPilot はファイルを監視します。Rust、Svelte、TypeScript のファイルを保存すると、バックグラウンドでリンティングを実行します。コンパイルエラーは、正確なスタックトレースとともに bug メモリーとして自動保存されます。エラーが修正されると、メモリーは自動的に削除されます。
リンタースレッドは、その存続期間を通じて単一の DB 接続を再利用します。
7. ガベージコレクションと自動圧縮
古く重要度の低いメモリーを評価し、クリーンアップ候補としてスコアを付けます。関連する古いメモリーのグループは、ヒューリスティックなキーワード抽出を使って簡潔な要約に統合されます。孤立したリンクとエンティティはクリーンアップされます。大幅な削除の後、DB はバキュームされます。
自動圧縮はメモリー数が 500 を超えると自動的に開始されます。add_memory の後、GC がバックグラウンドで実行され、実行頻度は 5 分に 1 回までに制限されます。手動での操作は不要です。
メモリーカプセル(compact_memories ツール):古く重要度の低いメモリーを、約 100~200 トークンの高密度なカプセルに圧縮します。認証情報とアーキテクチャ上の決定は圧縮されません。カプセルはナレッジグラフのリンクを保持するため、想起精度を損なわずに、古いメモリーのトークンを 5~10 倍節約できます。
8. ゼロショット自動分類
呼び出し元が種類や重要度を指定しない場合、すべてのメモリーは挿入時に自動分類されます。パターンベースのヒューリスティックにより、次の項目を検出します。
- 認証情報(API キー、シークレット)→ 重要度 5、TTL なし
- アーキテクチャ上の決定 → 重要度 5
- 設定/パターン → 重要度 4
- バグ → 重要度 3、TTL 90 日
- TODO → 重要度 2、TTL 30 日
- コードスニペット → 重要度 2
- マイルストーン → 重要度 4
LLM は不要です。正規表現とキーワードによるヒューリスティックのみを使用します。AI は明示的な kind と importance を渡すことで、引き続き分類を上書きできます。
9. プロジェクトブレイン
ツールを 1 回呼び出すだけで、技術スタック、アーキテクチャ上の決定、対応中のバグ、最近の変更、主要コンポーネント、チームメンバー(自動検出された人物エンティティ)を含む、1500 トークン未満の高密度なプロジェクト JSON スナップショットを取得できます。AAAK 圧縮用の compact: true に対応しています。
未リリース
- Git によるメモリの検証:プロジェクトのリポジトリ内のファイルを参照するメモリは、そのメモリが作成された後のコミットと照合されます。検索、想起、取得では、伝えるべき情報がある場合に
verificationオブジェクトが追加されます。likely_resolved(後続の修正コミットが、バグで参照されたファイルに変更を加えている)、possibly_resolved(後続の修正コミットが、バグの解決を示しているように見える)、changed_since(参照されたファイルが変更されている)、または記録済みのresolved/verifiedが含まれます。40 ファイルを超える大規模なコミットと、ドキュメント、テスト、雑務のコミットは無視されます。Git は必要に応じて読み込まれ、HEAD ごとにキャッシュされます。データベースにコピーされるものはありません。verify_memoryで詳細を確認でき、resolve_memoryで修正コミットとともに open / resolved / verified を記録できます。解決済みのバグはプロジェクトのブレインから除外されます。MEMORYPILOT_VERIFY=offで無効にできます。 - リポジトリから読み取った事実:
project_factsは、プロジェクトのリポジトリに現在記載されている内容を、必要に応じて計算して返します。保存はされません。パッケージマニフェストとバージョン(package.json、Cargo.toml、pubspec.yaml)、Cloudflare の設定(wrangler.toml/.jsonc、変数名のみ)、cf-orchestrator のデプロイ先、Supabase のマイグレーション、SvelteKit のルート、最新のコミットが対象です。想起(project_facts)とプロジェクトのブレイン(derived_facts)には、数行の要約が含まれます。リポジトリで使用されているバージョンより古いフレームワークのバージョン(package.jsonに^4.1.0とあるときの「Tailwind 3」など)を記載したメモリにはcontradictedのマークが付きます。より新しいバージョンは、古い事実ではなく計画として解釈されます。 - コネクター:GitHub、デプロイ、Supabase の本番環境:
project_factsには、オープン中および最近マージされたプルリクエストとオープン中のイシュー(ログイン済みのgh)、各ターゲットの cf-orchestrator による最後の成功したデプロイと、そのディレクトリで以降に行われたコミット、最新の Git タグと以降のコミットが追加されます。また、Supabase のアクセストークンが利用できる場合は、本番環境にまだ適用されていないsupabase/migrationsのマイグレーションも追加されます(Management API、スコープdatabase:read。トークンはSUPABASE_ACCESS_TOKENまたは Keychain から取得し、サービスはMemoryPilot、アカウントはsupabase-access-token。コマンドラインには渡さず、標準入力経由で curl に渡します)。想起では、5 分ごとにバックグラウンドで更新されるキャッシュ済みのコピーが読み取られるため、ネットワークの応答を待つことはありません。バグのメモリが参照するプルリクエストまたはイシューが、メモリ作成後にマージまたはクローズされている場合は、likely_resolvedのマークが付きます。MEMORYPILOT_CONNECTORS=offで無効にできます。 - シークレットはポインターとして扱う:
fullモードやエクスポートを含め、どのツールも認証情報の値を返さなくなりました。認証情報は、マスクされたラベルとsecretポインターとして返されます。ポインターには、値の保存場所(update_memoryで設定したlocation、ラベル内のop://参照、または保管庫)と、その値の取得方法が含まれます。値を取得する唯一の方法はreveal_secret {id, reason}です。ユーザーが、エージェントにはクリックできない macOS のダイアログで確認します(Reveal / Refuse、55 秒)。値を含めず、すべての要求が~/.MemoryPilot/logs/reveal-audit.logに記録されます。更新によってシークレットが消失することもありません。マスクされたテキストの書き戻し、メタデータの置き換え、または種類のみの変更は拒否されるか、暗号文が保持されます。MEMORYPILOT_REVEAL_CONFIRM=noneでダイアログを省略できます(監査ログへの記録のみ)。MEMORYPILOT_SECRETS=revealで透過的な復号を再び有効にできます。HTTP 経由では、MEMORYPILOT_HTTP_SECRETS=onを設定しない限りreveal_secretは拒否されます。 - シークレットの保管先としての 1Password:
MemoryPilot --sync-1password [--apply]は、保管庫の鍵を 1Password(アイテム名「MemoryPilot vault key」)にバックアップし、すべての認証情報をop://参照に切り替えます。同じアカウントに関する既存アイテム(テキスト内のタイトルまたは URL ホストが一致)に値がすでに保管されている場合は、そのアイテムにリンクします。そうでない場合は、Login または Secure Note が作成されます(タグmemorypilot-import)。削除は一切行われず、デフォルトではドライランです。その後、reveal_secretはまず 1Password から値を読み取り(インストールされている場合はop-sof、それ以外の場合はopを使用。値は標準入力/標準出力経由のみ)、取得元を表示します。 memorypilot-coreライブラリ:ストレージ、検索、想起、ナレッジグラフ、保管庫は、現在crates/memorypilot-core(Cargo ワークスペース)にあります。MemoryPilotバイナリは、その上で動作する MCP サーバーです。db.rsはドメインごとのファイルに分割されています。メモリの行はMemoryStoreトレイト経由で処理され、検索と想起が読み取るすべてのデータはRecallStoreトレイト経由で取得されます(現在は SQLite)。他のストアが実装すべきコントラクトテストもあります(store-contract機能)。テストとベンチマーク結果は同じです(scripts/bench-gate.sh)。- サーバーモード、ストレージ(開発中、未リリース):
crates/memorypilot-serverは、多数の顧客のメモリを 1 つの Postgres データベースに保存します(tsvectorによる全文検索、pgvector によるベクトル検索)。テナント、スペース、エンドユーザーは二重に分離されます。すべてのクエリでこれらの条件によるフィルタリングを行い、行レベルセキュリティによって別のテナントの行を拒否します。SQLite と同じストアコントラクトに準拠しており、書き込み処理(重複排除、エンティティと日付の抽出、リンク)およびハイブリッド検索パイプラインは、どちらのストアでも変更なしで動作します。フランス語のベンチマークでは、Postgres の recall@10 は 100%、MRR は 97.9%です(SQLite はそれぞれ 100%、98.1%)。同じ 3 つのクエリで 1 位を逃しています。エンドユーザーは、自分が閲覧できるものにのみメモリをリンクできます。Postgres への接続では、証明書とホスト名を検証する TLS(Mozilla ルート証明書に加え、Supabase などの任意の CA ファイルを使用)を必須とするか、ローカルまたはプライベートデータベース用に明示的に平文接続を指定します。memorypilot-serverバイナリは、プールされたセッション経由で REST API(/v1/memories、/v1/search)を提供し、アプリごとの API キー(read、write、subjects。SHA-256 のみを保存し、失効は即時反映)で認証します。X-MemoryPilot-Subjectを指定すると、アプリは自分のエンドユーザーの 1 人として動作します。エンドユーザーは初回使用時に作成され、自分のメモリのみを変更できます。同じキーで、6 つのメモリツールを備えた MCP エンドポイント(POST /mcp、Streamable HTTP)にも接続できます。現在のステートレスなプロトコルリビジョン(2026-07-28。バージョンとヘッダーをリクエストごとに確認)と、引き続きinitializeを使用するクライアント(2025-03-26 から 2025-11-25)に対応しています。各キーにはリクエストレート制限(デフォルトは 1 分あたり 600 件。超過時は Retry-After 付きの 429)があり、各テナントにはメモリクォータ(デフォルトは 100,000 件)があります。どちらもテナントごとに調整できます。使用量(リクエスト、書き込み、検索)は課金用にスペースおよび日ごとに集計され、すべての変更は ID のみを含む監査ログに書き込まれます。アプリケーションロールは監査ログへの追記のみ可能で、読み取りはできません。GDPR 対応として、アプリはエンドユーザー自身のメモリと事実をエクスポート(GET /v1/subject/export)するか、所有するすべてのデータとともにエンドユーザーを消去(DELETE /v1/subject)できます。どちらも監査ログに記録され、エンドユーザーを新たに作成することはありません。利用を終了する顧客のデータは JSON Lines 形式でエクスポート(export-tenant)され、テナントの正確な名前を指定した場合にのみ削除されます(delete-tenant)。ベクトルはバックグラウンドでテナントごとに順番にバッチ処理されます。そのため、メモリはキーワードではすぐに見つかり、意味検索ではその直後に見つかります。大規模なスコープ(ベクトル 5,000 件以上)では、モデルの次元数(384、768、1024)に対応した pgvector HNSW インデックスで最近傍を検索し、反復スキャンによってテナントフィルターで検索結果が空にならないようにします。認証情報はテナント固有の鍵で暗号化され、その鍵はMEMORYPILOT_MASTER_KEYでラップされます(エンベロープ暗号化)。読み取りとエクスポートで返されるのは、マスクされたラベルのみです。Docker イメージ(Dockerfile、docker compose up --build)には jina 埋め込みモデルが含まれ、ポート 8080 でサービスを提供します。REST クライアントはsdks/にあります(TypeScript、Python、Dart。未公開)。MCP クライアント(claude.ai、ChatGPT)は OAuth 2.1 で接続します。PKCE S256、動的登録に対応し、/oauth/authorizeで API キーを貼り付けると、エンドユーザーごとにmpt_トークンが 1 つ発行されます。MEMORYPILOT_PUBLIC_URLに公開オリジンを設定します。SvelteKit コンソール(console/、/consoleでサービスを提供)は API キーでサインインします。Claude、ChatGPT、iPhone、Slate、LightFrame、Docix の接続方法については、integrations/を参照してください。LLM を使用しないサーバーベンチマーク:scripts/bench-server.sh。管理コマンドでテナント、スペース、キーを作成できます(memorypilot-server help)。scripts/test-postgres.shは、ローカルの pgvector コンテナに対してテストを実行します。 - Keychain のプロンプトなし:サーバーが保管庫の鍵を読み取るのは、認証情報を保管している場合のみです。読み取りはバックグラウンドスレッドで行われるため、プロンプトによってすべてのリクエストが停止することはありません。macOS リリースには署名と公証が適用され、Homebrew は Apple Silicon にインストールします。
install.shはチェックサムと署名チームを確認します。 - 保管庫の鍵の安全性と復旧:Keychain からの読み取りを拒否されても、新しい鍵は作成されなくなりました(新しい鍵が作成されるのは、アイテムが存在しない場合のみです)。
--restore-vault-keyは、標準入力から読み取った鍵ですべての暗号化済み認証情報を開けることを確認してから、鍵を復元します。--reseal-recovered [--apply]は、現在の鍵を使って、復旧した平文の認証情報(標準入力からの JSON)を再暗号化します。各認証情報は保存済みのラベルと照合され、すべて成功するか、何も変更されないかのどちらかです。
v4.10 の新機能
- 古くなったメモリを自動的に非表示:新しいメモリが古いメモリについて「Y ではなく X」と記している場合や、同じ内容の新しいステータスである場合、古いメモリには
supersededのタグが付けられます(保持され、ID で読み取り可能です。元に戻すにはunsupersedeを実行します)。また、想起や検索には表示されなくなります。 - 想起の改善:現在のタスクに一致するメモリが先に表示され、常にクロスエンコーダーで再ランキングされます。想起のゴールデンセット:top-1 は 73% → 82%、top-5 は 91% → 100%、プロジェクト間の漏えいは 9% → 0%。
- 起動時のインデックス修復(
repair_index)と、古いバックアップ内の認証情報を暗号化するMemoryPilot --seal-backup FILE...を追加しました。
v4.9 の新機能
- 想起時のプロジェクト分離:別のプロジェクトのメモリは、現在のプロジェクト名が記載されている場合にのみ表示されます(プロジェクト間の漏えいは 55% → 18%。ヒット率は変わりません)。
- 簡潔なツール一覧:コアツールは 17 個(会話あたりのスキーマは約 24 KB ではなく約 13 KB)。それ以外は
memory_admin経由で利用できます。MEMORYPILOT_TOOLS=fullを設定すると、完全な一覧に戻ります。 - 認証情報を保存時に暗号化:XChaCha20-Poly1305 を使用し、キーは macOS Keychain に保存されます(キーファイルは別の場所に保存されます)。HTTP 経由ではマスクされます(シークレットをポインターとして扱う変更以降、すべての場所でマスクされます。Unreleased を参照してください)。
archive_transcripts:古い生のトランスクリプトを~/.MemoryPilot/archive/*.jsonlに移動し、ライブインデックスから除外します。find_conflicts:同一プロジェクト内で互いに矛盾するメモリを報告します。rate_skill:学習したスキルに対する利用フィードバックです。信頼性の高いスキルは上位に表示され、失敗するスキルは順位が下がります。- リモートアクセス:
--httpにはトークンが必須になりました(~/.MemoryPilot/http.token)。Authorization: Bearerまたは/mcp/<token>として指定します。scripts/remote-access.shは LaunchAgent と Cloudflare トンネルを設定し、claude.ai、iPhone アプリ、または別の PC から同じメモリを利用できるようにします。
インストール
Homebrew(macOS / Linux)
brew install Soflutionltd/memorypilot/memorypilot
これで完了です。Apple Silicon では、Homebrew が署名と公証済みのリリースバイナリ(最初の署名付きリリース以降)をインストールします。Intel Mac と Linux では、cargo を使ってソースからビルドします(Homebrew が Rust を自動的にインストールします)。インストール後、クローンしたリポジトリから ./install.sh を実行するか、以下の MCP 設定手順に従ってください。
macOS で署名が重要な理由。 MemoryPilot に保存された認証情報は、Keychain に保持されているキーで暗号化されます。macOS が確認なしでバイナリによるキーの読み取りを許可するのは、そのバイナリがキーを作成したチームによって署名されている場合のみです。署名済みリリースはアップデート後も同じ ID を維持するため、確認を求められることはありません。ソースからビルドしたバイナリ(
cargo install、Intel 上の Homebrew)はビルドのたびに新しい ID になるため、アップデート後に macOS が Keychain のパスワードを求めます。認証情報が保存されていない場合、Keychain が読み取られることはありません。
ワンライナー — マシン上のすべての IDE を自動設定
curl -fsSL https://raw.githubusercontent.com/Soflutionltd/MemoryPilot/main/install.sh | bash
このスクリプトの動作:
- プラットフォーム(macOS arm64 / x64、Linux x64 / arm64)を検出します。
- 最新の GitHub リリースからビルド済みバイナリを取得し、その
.sha256を確認します。 - macOS では署名を確認します。別のチームによって署名されたバイナリは拒否し、署名されていない場合は警告します。
~/.local/bin/MemoryPilotにインストールし、macOS では Gatekeeper 属性をクリアします。- 対応している IDE / エージェント(Cursor、Claude Desktop、Claude Code、Codex CLI、Gemini CLI、Windsurf、VS Code、OpenCode、Cline、Roo Code)をすべて検出し、一度の実行で自動設定します。
お使いのプラットフォームで利用できるビルド済みバイナリがない場合は、自動的に cargo build --release --features http でのビルドに切り替わります(Rust が必要です)。
別の方法
# Via Cargo, pinned to a release tag — works anywhere Rust runs
# (unsigned on macOS: Keychain prompt after each update if you store credentials):
cargo install --git https://github.com/Soflutionltd/MemoryPilot --tag v4.10.0 --bin MemoryPilot

# Local clone + auto-config (same installer, run from inside the repo):
git clone https://github.com/Soflutionltd/MemoryPilot.git && cd MemoryPilot && ./install.sh
インストーラーは冪等です。ほかの設定に影響を与えずに設定を更新できるため、いつでも再実行できます。
ビルド済みバイナリ
すべてのリリースには、主要な3つのターゲット向けのビルド済みバイナリが含まれています。Linux ビルドは、すべての v*.*.* タグでリリース CI ワークフローによって作成されます。macOS ビルドは Soflution の Developer ID で署名され、Apple による公証を受けています(scripts/release-macos.sh)。
| プラットフォーム | ターゲットトリプル | アーカイブ |
|---|---|---|
| macOS Apple Silicon | aarch64-apple-darwin | MemoryPilot-aarch64-apple-darwin.tar.gz |
| Linux x86_64 | x86_64-unknown-linux-gnu | MemoryPilot-x86_64-unknown-linux-gnu.tar.gz |
| Linux arm64 | aarch64-unknown-linux-gnu | MemoryPilot-aarch64-unknown-linux-gnu.tar.gz |
各アーカイブには、検証用の .sha256 ファイルが付属しています。リリースページからダウンロードしてください。
Intel Mac(
x86_64-apple-darwin):ビルド済みバイナリはありません。fastembedが使用するort/ONNX Runtime クレートは、このターゲット向けのビルド済みバイナリを公開していません。brew install Soflutionltd/memorypilot/memorypilot(ソースからビルド)またはcargo install --git ...を使用してください。Apple Silicon 搭載 Mac(M1 以降)はビルド済みバイナリで完全にサポートされています。
サポート対象の IDE/エージェント(./install.sh で自動設定):
| エージェント | 設定ファイル/コマンド | 自動設定 |
|---|---|---|
| Cursor | ~/.cursor/mcp.json | ✓(stdio) |
| VS Code | ~/.vscode/mcp.json | ✓(stdio) |
| Claude Desktop | ~/Library/Application Support/Claude/claude_desktop_config.json | ✓(stdio) |
| Claude Code | claude mcp add | ✓(CLI) |
| Codex CLI | codex mcp add | ✓(CLI) |
| Gemini CLI | ~/.gemini/settings.json | ✓(stdio) |
| Windsurf | ~/.codeium/windsurf/mcp_config.json | ✓(stdio) |
| OpenCode | ~/.config/opencode/opencode.json | ✓(stdio) |
| Cline(VS Code) | ~/Library/Application Support/Code/User/globalStorage/saoudrizwan.claude-dev/settings/cline_mcp_settings.json | ✓(stdio) |
| Roo Code(VS Code) | ~/Library/Application Support/Code/User/globalStorage/rooveterinaryinc.roo-cline/settings/cline_mcp_settings.json | ✓(stdio) |
| ChatGPT Desktop | 設定 → アプリ → 作成 | HTTP 経由(下記参照) |
その他の MCP 対応クライアント(同じ stdio バイナリを使用し、手動で設定):
| エージェント | 備考 |
|---|---|
| Goose | ~/.config/goose/config.yaml にある YAML 設定で、extensions: の下に type: stdio、cmd: ~/.local/bin/MemoryPilot を含む MemoryPilot を追加します |
| Kilo Code | Kilo の VS Code 拡張機能のストレージパスにある、同じ cline_mcp_settings.json 形式を使用します |
| Continue.dev | ~/.continue/config.json の mcpServers に追加します |
| Zed | 設定 → アシスタント → コンテキストサーバー → stdio コマンドを追加します |
| Aider | ネイティブ MCP には対応していません。REST API を使用してください(HTTP API のセクションを参照) |
このスクリプトは冪等です。既存の MCP 設定を壊さずに更新するには、再度実行してください。
ChatGPT Desktop
ChatGPT にはリモート MCP エンドポイントが必要です。HTTP サーバーを起動してから、カスタムコネクターとして追加します。
MemoryPilot --http 7437
ChatGPT で、設定 → アプリ → 作成 → URL:http://localhost:7437/mcp の順に選択します。
手動インストール
git clone https://github.com/Soflutionltd/MemoryPilot.git
cd MemoryPilot
cargo build --release --features http
cp target/release/MemoryPilot ~/.local/bin/
chmod +x ~/.local/bin/MemoryPilot
xattr -cr ~/.local/bin/MemoryPilot  # macOS only
次に、IDE の MCP 設定に MemoryPilot を手動で追加してください(ファイルパスは上の表を参照)。
仕組み
これで完了です。 MemoryPilot は起動時に、動的なシステムプロンプトを IDE に自動で挿入します。AI は、アーキテクチャ上の決定事項、API キー、バグ修正を手動操作なしで保存するため、バックグラウンドで add_memory を積極的に呼び出します。設定済みのすべての IDE で同じメモリデータベースを共有します。
ChatGPT や HTTP が必要な MCP クライアントでは、MemoryPilot --http を実行して、/mcp で Streamable HTTP エンドポイントを公開してください。
または、McpHub を使用すると、ほかのすべての MCP サーバーとともに SSE トランスポートを利用できます。
初回実行
# If upgrading from v1 (JSON files):
MemoryPilot --migrate

# Compute embeddings for existing memories:
MemoryPilot --backfill

# Force re-embed all (skips unchanged via content hash):
MemoryPilot --backfill-force
MCP ツール(30)
コア
| ツール | 説明 |
|---|---|
recall | まずここから始めます。プロジェクトのメモリ、スコープ別のスレッド/ウィンドウのメモリ、設定、重要な事実、パターン、決定事項、グローバルプロンプトなど、すべてのコンテキストを一度に読み込みます。mode = safe/default/full をサポートし、AAAK 圧縮には compact = true を指定します。 |
get_project_brain | プロジェクトの概要を即座に取得します(<1500 トークン):技術スタック、アーキテクチャ、バグ、最近の変更、コンポーネント、チームメンバー。compact = true をサポートします。 |
search_memory | BM25 と jina RRF を組み合わせたハイブリッド検索です。重要度、グラフリンク、ファイルウォッチャーのコンテキストによって優先度が上がります。バッチで 3 段階のスコアリングを行います。 |
get_file_context | 作業ディレクトリ内で最近変更されたファイルに関連するメモリを取得します。 |
メモリの CRUD
| ツール | 説明 |
|---|---|
add_memory | 遅延埋め込み、自動重複排除(ハッシュによる完全一致+Jaccard 85%)、エンティティの自動抽出、グラフへの自動リンク、自動分類(内容から種類、重要度、TTL を推定)を行って保存します。 |
add_memories | 複数のメモリを 1 回の呼び出しで一括追加し、項目ごとに重複排除します。 |
add_transcript | 長いトランスクリプトをチャンク分割されたアーカイブとして保存し、構造化メモリ(decision、preference、todo、bug、milestone、problem、note)を自動抽出します。 |
ingest_session | ローカルの Claude/Cursor/セッションのトランスクリプトを同じ MemoryPilot MCP に取り込みます。デフォルトでは distill_only=true のため、価値の高いメモリのみがインデックス化されます。 |
get_memory | ID で取得します。 |
update_memory | 内容、種類、タグ、重要度、TTL を更新します。内容が変わっていない場合(ハッシュで確認)は再埋め込みをスキップします。 |
delete_memory | ID で削除します(エンティティとリンクにも連鎖して適用されます)。 |
list_memories | プロジェクト/種類のフィルターとページネーションを使って一覧表示します。 |
エージェントフック(自動メモリ、エージェントの作業は不要)
MemoryPilot --install-hooks
見つかったすべてのエージェントに 2 つのフックをインストールします(既存の設定とフックは保持され、.bak が作成されます)。
| エージェント | ファイル | セッション開始時の出力 |
|---|---|---|
| Cursor | ~/.cursor/hooks.json | additional_context |
| Claude Code | ~/.claude/settings.json | hookSpecificOutput.additionalContext |
| Codex | ~/.codex/hooks.json | hookSpecificOutput.additionalContext |
- セッション開始時に
MemoryPilot --hook session-start --agent <agent>を実行し、開いたプロジェクトの簡潔なリコールを注入します。 - 停止時に
MemoryPilot --hook stop --agent <agent>を実行します。すぐに{}を返し、前のターンから追加されたトランスクリプトの行だけを、切り離されたプロセスで抽出します。ユーザーメッセージについては、ユーザーが入力した内容だけを保持します(Cursor の<user_query>、Claude Code のメタ行はスキップします)。エージェントの説明文(「確認しています…」「では…」「Je vais…」)は除外され、明らかな秘密情報(API キー、JWT、IBAN)は保存前にマスキングされます。
状態:~/.MemoryPilot/cursor-hooks-state.json。ログ:~/.MemoryPilot/cursor-hooks.log。コピーに対してテストするには MEMORYPILOT_DB=/path/copy.db を設定します。
ナレッジグラフ
| ツール | 説明 |
|---|---|
kg_add | 事実のトリプル(subject → predicate → object)を、任意で有効期間と信頼度スコアを指定して追加します。 |
kg_invalidate | トリプルを期限切れとしてマークし(valid_to を設定)、履歴を保持します。 |
kg_query | 時間によるフィルタリングと方向の制御を指定して、エンティティに関連するすべてのトリプルをクエリします。 |
kg_timeline | エンティティに関係するすべてのトリプルの時系列履歴を取得します。 |
kg_stats | 概要統計:トリプルの総数、有効数、期限切れ数、ユニークな subject/object の数。 |
プロジェクトと設定
| ツール | 説明 |
|---|---|
get_project_context | 設定とパターンを含む、プロジェクトの全コンテキストです。 |
register_project | 自動検出用に、ファイルシステムのパスを指定してプロジェクトを登録します。 |
list_projects | メモリ数とともにプロジェクトを一覧表示します。 |
get_stats | DB 統計情報:合計数、種類別、プロジェクト別、DB サイズ、健全性の指標です。 |
get_global_prompt | ~/.MemoryPilot/ またはプロジェクトのルートから GLOBAL_PROMPT.md を自動検出します。 |
export_memories | 重要度を星で示して、JSON または Markdown 形式でエクスポートします。 |
set_config | 設定値を指定します(例:global_prompt_path)。 |
メンテナンス
| ツール | 説明 |
|---|---|
run_gc | ガベージコレクション:古いメモリの統合、孤立データのクリーンアップ、バキュームを行います。dry_run に対応しています。 |
compact_memories | 重要度の低い古いメモリを、簡潔なカプセル(約100~200トークン)に圧縮します。認証情報やアーキテクチャは圧縮されません。 |
cleanup_expired | TTL が期限切れのメモリを削除します(デバウンス処理により、実行は最大60秒に1回です)。 |
pin_memory | 重要なメモリをピン留めします。想起時に常に含まれ、ガベージコレクションの対象になりません。 |
unpin_memory | 以前にピン留めしたメモリのピン留めを解除し、再び GC の対象にします。 |
find_related | ナレッジグラフをたどり、指定した ID に関連するすべてのメモリを検索します(深さ1~3)。 |
bulk_delete | 種類、プロジェクト、タグ、経過時間、重要度を指定してメモリを削除します。ピン留めされたメモリには触れません。 |
get_memory_health | 種類/プロジェクト/重要度別の分布、古いメモリ数、孤立データ、圧縮可能性、DB サイズを示す健全性レポートです。 |
dedupe_report | Jaccard 類似度を用いて重複候補を検出し、手動で確認できるようにします。 |
consolidate_memories | ほぼ重複する一時メモリ(埋め込みのコサイン類似度が閾値以上、同一プロジェクト、決定事項/認証情報/ピン留め済みは除外)を最新のメモリに統合し、タグ、重要度、アクセス数、グラフのリンクをマージします。デフォルトではドライランで、実行するには apply: true を指定します。毎日1回、自動でも実行されます。 |
analyze_corpus | メモリに書き込まずにテキストを分析します:出所、プラットフォーム、エージェント/ペルソナ、信頼性の高いトピックです。 |
benchmark_recall | ゴールデンシナリオを用いた想起品質ベンチマークです。 |
benchmark_search | 検索品質ベンチマーク:R@5、R@10、NDCG@10、クラスタの一貫性、レイテンシです。 |
migrate_v1 | v1 の JSON ファイルからインポートします。 |
メモリの種類
fact · preference · decision · pattern · snippet · bug · credential · todo · note · milestone · architecture · problem · transcript_chunk
各メモリには、重要度(1~5)、任意の TTL、タグ、プロジェクトのスコープ、コンテンツハッシュ、自動生成される埋め込みとエンティティリンクが含まれます。
CLI
MemoryPilot                          # Start MCP stdio server
MemoryPilot --backfill               # Compute missing embeddings
MemoryPilot --backfill-force         # Re-embed all (skips unchanged via hash)
MemoryPilot --benchmark-recall       # Run recall quality benchmark
MemoryPilot --benchmark-search       # Search quality: R@5, R@10, NDCG@10, cluster coherence
MemoryPilot --benchmark-fr           # French/multilingual deterministic benchmark (109 queries, ±1pp variance)
MemoryPilot --benchmark-longmemeval  # LongMemEval-S benchmark, supports --limit N and --min-r5 PCT
MemoryPilot --benchmark-concurrency  # Multi-client concurrency bench (--clients N --queries-per-client N)
MemoryPilot --benchmark-latency      # open_at startup + search latency
MemoryPilot --http 7437              # Start HTTP REST server (requires --features http)
MemoryPilot --migrate                # Import v1 JSON data
MemoryPilot --version                # Show version
MemoryPilot --help                   # Show help
環境変数の調整
| 変数 | デフォルト | 効果 |
|---|---|---|
MEMORYPILOT_CROSS_RERANK | adaptive | すべてのクエリで再ランク付けを強制するには 1/always、無効にするには 0/off を指定します。適応型の再ランク付けは、難易度の高いクエリや英語以外のクエリで実行されます。 |
MEMORYPILOT_CROSS_RERANK_TOP_K | 12 | クロスエンコーダーでスコアを再計算する候補の数です。 |
MEMORYPILOT_CROSS_RERANK_WEIGHT | 0.45 | RRF スコアに対するクロスエンコーダースコアの融合重みです。0.20~0.85 を試した結果、--benchmark-fr では 0.45 が最良の運用値であり、LongMemEval でも最適値の 0.2 pp 以内の R@5 を維持します。 |
MEMORYPILOT_RERANK_POOL_SIZE | 1 | 常駐させるクロスエンコーダーの ONNX セッション数です。負荷の高い並行処理時に限り 2 が有効です。mmarco セッションを1つ追加するごとに約120 MB必要になります。 |
MEMORYPILOT_EMBED_POOL_SIZE | 1 | プール内の埋め込み ONNX セッション数です(従来の fastembed モデルでは 4、1024次元モデルでは 2 を維持します)。jina セッションを追加すると約250 MB必要になり、負荷の高い並行書き込み時に限り効果があります。 |
MEMORYPILOT_EMBED_THREADS | min(4, cores) | 埋め込みモデル用の ONNX intra-op スレッド数です。MEMORYPILOT_RERANK_THREADS(デフォルトは min(2, cores))も同様にクロスエンコーダーに適用されます。 |
MEMORYPILOT_RERANKER_MODEL | mmarco | mmarco-mMiniLMv2-L12-H384-v1 int8(Apache-2.0、常駐時約120 MB)です。代替モデルも同じ方法(int8、メモリーマップ)で提供されます。jina-v2(jina-reranker-v2-base-multilingual、280 MB、CC-BY-NC)と gte-multilingual(gte-multilingual-reranker-base、341 MB、Apache-2.0)は、どちらも --benchmark-fr での測定値が低く(v4.5 の修正前と比べて MRR 63.5%/62.1% 対 65.3%)、レイテンシーも2倍のため、デフォルトではありません。従来の fp32 fastembed モデル:jina-v2-multilingual-fp32(1.1 GB)、bge-v2-m3、bge-base、jina-v1。 |
MEMORYPILOT_MODEL_IDLE_SECS | 600 | メモリー(約250 MB)を解放するため、埋め込みおよび再ランク付けのセッションを破棄するまでのアイドル時間です。0 にすると常駐します(ベンチマーク用)。 |
MEMORYPILOT_CONSOLIDATE | on | 埋め込みに基づき、類似度の高い重複一時メモリーを毎日統合します(コサイン類似度 ≥ 0.95、単語の重複率 ≥ 0.6、同一プロジェクト内で最新のものを保持)。その後、置き換え処理を実行します(v4.6 を参照)。off にすると無効になります。consolidate_memories を使うと、必要に応じて実行できます。 |
MEMORYPILOT_MMR / MEMORYPILOT_MMR_LAMBDA | on / 0.4 | 最終候補に多様性を適用する MMR です。0 にすると無効になります。λ = 1.0 は関連性のみ、0.0 は多様性のみになります。MEMORYPILOT_MMR_FLOOR(0.55)は、2つの候補を重複と見なさないコサイン類似度のしきい値です。 |
MEMORYPILOT_TEMPORAL | on | クエリ実行時に日付範囲を加点または減点します。0 にすると無効になります(日付エンティティは取り込み時に引き続き抽出されます)。 |
MEMORYPILOT_ABSTAIN_COSINE / MEMORYPILOT_TRUST_CROSS | 0.35 / 1.0 | コサイン類似度が下限を下回ると、最上位ヒットのクロスエンコーダーロジットが信頼値に達していない限り、検索結果で confidence.abstain = true が報告されます。 |
MEMORYPILOT_READER_NULL_MARGIN | 0 | 抽出型リーダーでは、回答スパンのロジットがモデルの「回答なし」ロジットをこの値以上上回る必要があります。負の値を指定すると回答しやすくなります(−3 の場合、LongMemEval-S@100 では100件中92件に回答し、棄権すべき7件のうち3件を引き続き検出します)。 |
MEMORYPILOT_EMBED_MODEL | jina | jina-embeddings-v5-text-nano-retrieval int8(768次元)です。jina-q4 は4ビット版(ダウンロードサイズ140 MB、クエリが約5倍高速、FRで R@5 が−1 pp、MRR が−3 pp)です。fastembed 経由で利用できる Apache-2.0 の代替モデル:e5-small(384次元)、e5-base、e5-large、bge-m3(1024次元)。データベースにはベクトルの生成に使用したモデルが記録されます。モデルを変更すると既存のベクトルは破棄され、次回の起動時にバックグラウンドですべて再埋め込みされます(その間も BM25 は回答を続けます)。 |
HTTP API
--features http を指定してビルドすると、MemoryPilot はマルチスレッドの REST API を公開します(ワーカースレッド4つ、それぞれが独自の DB 接続を持ちます)。
# Health check
curl http://localhost:7437/health

# Call any MCP tool
curl -X POST http://localhost:7437/tools/call \
  -H 'Content-Type: application/json' \
  -d '{"name": "search_memory", "arguments": {"query": "auth setup", "limit": 5}}'
アーキテクチャ
src/main.rs        — CLI + MCP stdio server + file watcher init + HTTP server init + benchmark runners
src/code_chunker.rs — Tree-sitter code-aware chunking for Rust/Python/TS/TSX/JS/Go/Java/Kotlin/Swift + Svelte scripts
src/db.rs          — SQLite facade: hybrid search, CRUD, KG, GC, brain, recall, lazy embed, connection pool, ANN warm-up
src/db/benchmark.rs — Internal recall/search quality benchmark helpers
src/db/benchmark_fr.rs — French/multilingual deterministic benchmark (109 queries, ±1pp variance)
src/db/benchmark_longmemeval.rs — LongMemEval-S benchmark runner + regression guard support
src/db/transcript.rs — Transcript/session ingestion and local-only distillation
src/tools.rs       — 41 MCP tool definitions + handlers
src/protocol.rs    — JSON-RPC types
src/embedding.rs   — jina-embeddings-v5 via ONNX Runtime (fastembed for legacy models), EmbedPool, two-tier query cache
src/tokenizer.rs   — lean byte-level BPE (tiktoken ranks) and Unigram tokenizers, ~65 MB instead of ~535 MB with the `tokenizers` crate
src/onnx_external.rs — one-shot rewrite of embedded ONNX weights into a memory-mapped sidecar (ORT 1.28 keeps 3 copies otherwise)
src/pool.rs        — lazily-built, idle-evicting pool shared by the embedder and reranker sessions
src/db/consolidate.rs — embedding-based near-duplicate consolidation (daily + `consolidate_memories`)
src/reranking.rs   — Cross-encoder rerank (jina-v2-multilingual), RerankPool, adaptive trigger, confidence gate
src/ann.rs         — Persistent on-disk HNSW (usearch) with synchronous warm-up via `wait_for_ann_warm`
src/fts.rs         — FTS5 query variants (prefix, phrase, NEAR) + Snowball stemming
src/graph.rs       — Entity extraction (tech, files, components, people) + relation inference + graph traversal
src/gc.rs          — GC scoring, heuristic memory merging, stopwords
src/working_memory.rs — In-process scoped scratchpad memory for current MCP sessions
src/watcher.rs     — File system watcher + auto-linter with persistent DB connection
src/http.rs        — Optional multi-threaded HTTP REST server (feature-gated)
データベーススキーマ
memories           — id, content, kind, project, tags, importance, embedding (BLOB),
                     content_hash, expires_at, last_accessed_at, access_count, metadata
memories_fts       — FTS5 virtual table (content, tags, kind, project)
memory_entities    — memory_id, entity_kind, entity_value, valid_from, valid_to
memory_links       — source_id, target_id, relation_type, valid_from, valid_to, confidence
knowledge_triples  — id, subject, predicate, object, valid_from, valid_to, confidence, source_memory_id
projects           — name, path, description
config             — key/value store
パフォーマンス
| 指標 | 値 |
|---|---|
| バイナリサイズ | 35 MB |
起動(open_at) | 1~2 ms(ANN のウォームアップはバックグラウンドで実行されます) |
起動(open_at_warm) | 10 k 件のメモリで 50~200 ms(ANN は同期的にロードされ、クエリ #1 から決定的な検索が可能です) |
| デフォルトの高速検索(BM25 + RRF) | LongMemEval-S で平均約 28 ms |
| アダプティブなクロスエンコーダー検索 | --benchmark-fr で平均約 210 ms(R@5 99.1%、MRR 97.4%。v4.4 は 230 ms/R@5 70.6%/MRR 65%、v4.3 は 415 ms/R@5 60%/MRR 57%) |
| 同時実行時の p95(4 クライアント × 20 クエリ、500 件のメモリ、アダプティブ) | 229 ms |
add_memory のレイテンシ | 1 ms 未満(埋め込みは遅延実行) |
| 埋め込み品質 | Transformer 768 次元(jina-embeddings-v5-text-nano-retrieval int8、100 以上の言語、8k コンテキスト) |
| バックフィル(1000 件のメモリ) | バックグラウンドで約 2 分(モデルを切り替えて再埋め込み。実行中も recall は対話的に使用でき、約 1 秒で応答します) |
| RAM(両モデルをロードした定常状態) | 新規データベースでは約 370 MB、ANN インデックスに 2 000 件のメモリがある場合は約 485 MB。ほぼすべてがメモリマップされた int8 の重み(jina 247 MB + mmarco 118 MB)で、メモリ不足時には OS が解放できます(v4.3 ではアイドル時約 3.5 GB/ピーク時約 7 GB でした) |
| RAM(アイドル時) | 約 130 MB:クエリがない状態で MEMORYPILOT_MODEL_IDLE_SECS(デフォルト 600 s)が経過すると、両方の ONNX セッションが解放され、次のクエリ時に再構築されます(初回は約 0.8 s、リランカーのみなら約 0.3 s) |
RAM(--benchmark-fr、ピーク時) | 364 MB(以前は 7.05 GB) |
| 読み取りの同時実行性 | Database ハンドルごとにプールされた接続 16 個 |
| ランタイム依存関係 | なし(ONNX は同梱) |
最適化
- 遅延埋め込み:
add_memoryは埋め込みをNULLとして挿入し、バックグラウンドスレッドが非同期で計算・更新します - コンテンツハッシュ(FNV-1a):
--backfill-forceは、内容が変更されていないメモリをスキップします - 2層埋め込みキャッシュ:書き込み時に SQLite クエリキャッシュ(
*.query_cache.sqlite、LRU 退避によりソフト上限 8 192 件)へ保存する仕組みの上に、プロセス内 LRU キャッシュ(256 件)を設けることで、同一セッション内や再起動後のクエリを即座に処理します - 読み取り接続プール(4 接続):並行するベクトル検索が書き込みをブロックしません
- WAL モード:並行読み書きのための SQLite Write-Ahead Logging
- バッチスコアリング:ナレッジトリプル数とリンクブーストを、N+1 ではなく単一のクエリで取得します
- デバウンス付きクリーンアップ:期限切れメモリのクリーンアップは、最大でも 60 秒に 1 回実行されます
- プリペアドステートメント:グラフ探索では、ノードごとではなく SQL を 1 回だけ準備します
- 調整済み RRF 融合:標準の k=60 よりも上位 K 件を明確に識別できる k=40
- FTS5 の精度フォールバック:コードシンボル、エラー、名前付き概念を対象に、前方一致、完全一致フレーズ、NEAR 近接クエリをまとめて実行します
- 重み付き FTS フィールド:コンテンツ、タグ、種別、プロジェクトに個別の BM25 重みを設定し、構造化メタデータをスコアに反映します
- ACT-R スタイルの活性化:頻繁に再利用され、最近アクセスされたメモリに、最終再ランキング前に小さな認知的活性化ブーストを加えます
- int8 量子化埋め込み:格納されるベクトルは 4 分の 1 のサイズ(388 バイト、従来は 1536 バイト)になり、再現率の低下はごくわずかです。高速で SIMD に適した内積を BLOB に対して直接実行するため、検索ごとのメモリ割り当てを回避できます
- ローカル HNSW ANN インデックス(
usearch):ディスク上に永続化される近似最近傍インデックスです。切り離されたスレッドで SQLite から非同期にウォームアップするため、起動をブロックしません。バックフィル時、非同期埋め込みワーカー上、削除時に増分更新されます。vector_ann候補を提示するため、メモリベースが数万件を超えて増加しても高速性を保てます。 - ANN スキャンのバイパス:インデックスが 5,000 件以上になると、SQL ベクトルスキャンの対象を ANN の上位 K 件と BM25 ヒットの和集合に制限します。これにより、ランキングロジックを変えずに、O(N) の BLOB 読み込みを O(K) の参照に置き換えます。
- コードを考慮したチャンク分割:tree-sitter が Rust/Python/TypeScript/TSX/JavaScript を意味単位で分割し、Svelte の
<script>抽出にも対応します - 完全一致語句のカバレッジブースト:クエリ語句の 80% 以上がメモリの内容に含まれる場合、+10%
- 組み合わせリランカー:貪欲法による部分グラフ選択を行い、接続ごとに保守的な +5%(上限 15%)を加えます
- KG クエリ拡張:ナレッジグラフの関連語句に基づく検索後のスコアリングブースト(エンティティごとに +4%、上限 15%)
- 時間的な新しさ:過去 3 日間のメモリに穏やかな +5% を加え、30 日間で減衰します
- 重要度によるタイブレーカー:レベルごとに ±3%。関連性シグナルを覆すことはありません
- 適応型クロスエンコーダーリランキング(FastEmbed ONNX 経由の jina-v2-multilingual、デフォルトで有効):難しいクエリや英語以外のクエリで実行され、調整可能な 0.45 の重みで RRF スコアと融合します。簡単な英語クエリでは BM25+RRF に適切に切り替わり、30 ms 未満を維持します。N セッションのプール(
MEMORYPILOT_RERANK_POOL_SIZE)が並行負荷を吸収します。 - 信頼度ゲート:上位 1 件の RRF スコアが上位 3 件をすでに 25 % 以上上回っている場合、リランクをスキップします(潜在パス。強制リランクが有効な場合に動作します)
- 自動圧縮:メモリ数が 500 を超えると GC が自動的に実行され、実行頻度は 5 分に 1 回に制限されます
- メモリカプセル:重要度の低い古いメモリを約 100~200 トークンの要約に圧縮します(5~10 倍の削減)
- ゼロショット自動分類:パターンベースのヒューリスティックにより、LLM を使わずに挿入時に種別、重要度、TTL を割り当てます
高速なローカル開発
日常的な検証には cargo check を使用してください。リンク処理の全コストをかけずに、型や借用に関するエラーを検出できます。
make check          # cargo check
make check-http     # cargo check --features http
make test           # cargo test
make timings        # cargo build --timings
make check-cached   # RUSTC_WRAPPER=sccache cargo check
sccache は任意ですが、頻繁に再ビルドする場合は推奨されます。
make sccache-install
make build-cached
Cargo エイリアスも利用できます:cargo dev、cargo check-http、cargo test-fast、cargo timings、cargo build-http。
リリース検証とベンチマークの実行には、cargo build --release --features http を使用してください。macOS では、mold や lld などのリンカーへの切り替えは意図的にデフォルトで有効にしていません。.cargo/config.toml を変更する前に、まず cargo build --timings で計測してください。
ベンチマークを自分で実行する
MemoryPilot --benchmark-search --scenario-limit 30    # R@5, R@10, NDCG@10, cluster coherence, latency
MemoryPilot --benchmark-recall --scenario-limit 12    # top1/top5 hit rate, cross-project leak, credential safety
MemoryPilot --benchmark-longmemeval [PATH] [--limit N] [--min-r5 PCT] # LongMemEval-S with regression guard
LongMemEval ベンチマークでは、LongMemEval-S dataset をダウンロードし、ターン単位の粒度で470件の質問に対する検索品質を評価します。結果はカテゴリ別の内訳を含む JSON として出力されます。
クロスエンコーダーはデフォルトでアダプティブモードで動作します(難しいクエリや英語以外のクエリで起動します)。明示的に強制または無効化できます。
MEMORYPILOT_CROSS_RERANK=off MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json     # baseline, ~28ms/query, 98.7% R@5
MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json                                 # adaptive (default), ~900ms/query, 99.1% R@5
MEMORYPILOT_CROSS_RERANK=1 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json      # force on every query, max latency
MEMORYPILOT_CROSS_RERANK_WEIGHT=0.70 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json  # bias more toward the cross-encoder score
MEMORYPILOT_RERANKER_MODEL=bge-v2-m3 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json  # swap the model
利用可能なモデルのショートカット:jina-v2-multilingual(デフォルト)、bge-v2-m3、bge-base、jina-v1。評価可能なLongMemEval-Sの470件の質問で検証済みの全件実行結果:デフォルトの高速モードでは 98.7% R@5、95.1% NDCG@10、93.6% MRR、平均検索レイテンシ約28 msを達成します。アダプティブモードでは 99.1% R@5、96.0% NDCG@10、94.9% MRR、平均検索レイテンシ約900 msを達成します。決定論的なフランス語ベンチマーク(--benchmark-fr)は、多言語対応の変更に対する標準的な回帰テストです。実行間の変動はR@5で±1 pp以内に収まります。
ストレージ
- データベース:
~/.MemoryPilot/memory.db - グローバルプロンプト:
~/.MemoryPilot/GLOBAL_PROMPT.md - モデルキャッシュ:
~/.cache/fastembed/(Hugging Face形式。初回実行時にダウンロードされます。FASTEMBED_CACHE_PATHで上書きできます)。外部化されたONNXの重みは、その中のmemorypilot-external/に格納されます。
ライセンス
Soflution Source Available License — 使用は無料ですが、フォークや変更はできません。詳細は LICENSE をご覧ください。
SOFLUTION LTD が開発しました
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。