Sugra API MCP について
Sugra API MCPは、Sugra APIのデータカタログにAIエージェントを接続するサーバーです。金融、経済、政府、気候、海事などの調査向けに、出典と鮮度を含む構造化結果を返します。
主な機能
- 0136のデータ領域をカバー
- 021,600以上のデータエンドポイント
- 03結果に出典と鮮度のメタデータ
- 04ローカルカタログの検索と説明
- 055つのMCPリソースと6つのワークフロープロンプト
活用シーン
- 01市場やマクロ経済データの調査
- 02企業、セクター、資産の比較
- 03制裁スクリーニングとエンティティ特定
- 04気候、海事、貿易データの統合
MCP 対応
Sugra API MCP サーバーとして、データ照会ツール、分析ツール、リソース、プロンプトをクライアントに公開します。ホスト型 Streamable HTTP 接続とローカル stdio に対応します。
設定
リモートサーバーはインストール不要です。クライアントを選んで設定をコピーするか、ワンクリックで導入できます。
https://app.sugra.ai/mcpclaude mcp add --transport http sugra-api https://app.sugra.ai/mcp{"mcpServers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}Cursor で開く{"servers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}VS Code で開く{"mcpServers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}{"mcpServers":{"sugra-api":{"serverUrl":"https://app.sugra.ai/mcp"}}}コマンドはターミナルで実行し、JSON は各クライアントの MCP 設定に貼り付けて再起動します。認可が必要なサーバーは初回接続時にログインを求めます。
ツール
11| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| dob | any | いいえ | 個人の任意の生年月日。形式は YYYY-MM-DD。 |
| name | string | はい | スクリーニングする個人名または組織名(必須)。 |
| country | any | いいえ | 照合範囲を絞り込むための任意の ISO 3166-1 alpha-2 国コード。 |
| nationality | any | いいえ | 照合範囲を絞り込むための任意の国籍。 |
詳細
sugra-api-mcp


Anthropic のコネクターディレクトリに掲載されています。ウェブ、デスクトップ、モバイルの Claude、Claude Code、Cowork で利用できます。
OpenAI の公式プラグインディレクトリに掲載されています。ChatGPT と Codex で利用できます。
1つの MCP サーバーを通じて、市場、経済、企業、政府、ニュース、気候、海運、エンティティスクリーニングにわたる1,600以上のデータエンドポイントに、あらゆる AI エージェントからアクセスできます。
ChatGPT、Claude、Gemini、xAI、Cursor、VS Code、およびあらゆる MCP クライアントで動作します。
Sugra API の公式 Model Context Protocol サーバーです。1つのコネクター、同梱のエンドポイントカタログ、そしてすべての回答に出典情報を付けた構造化ツール結果を提供します。
動作例
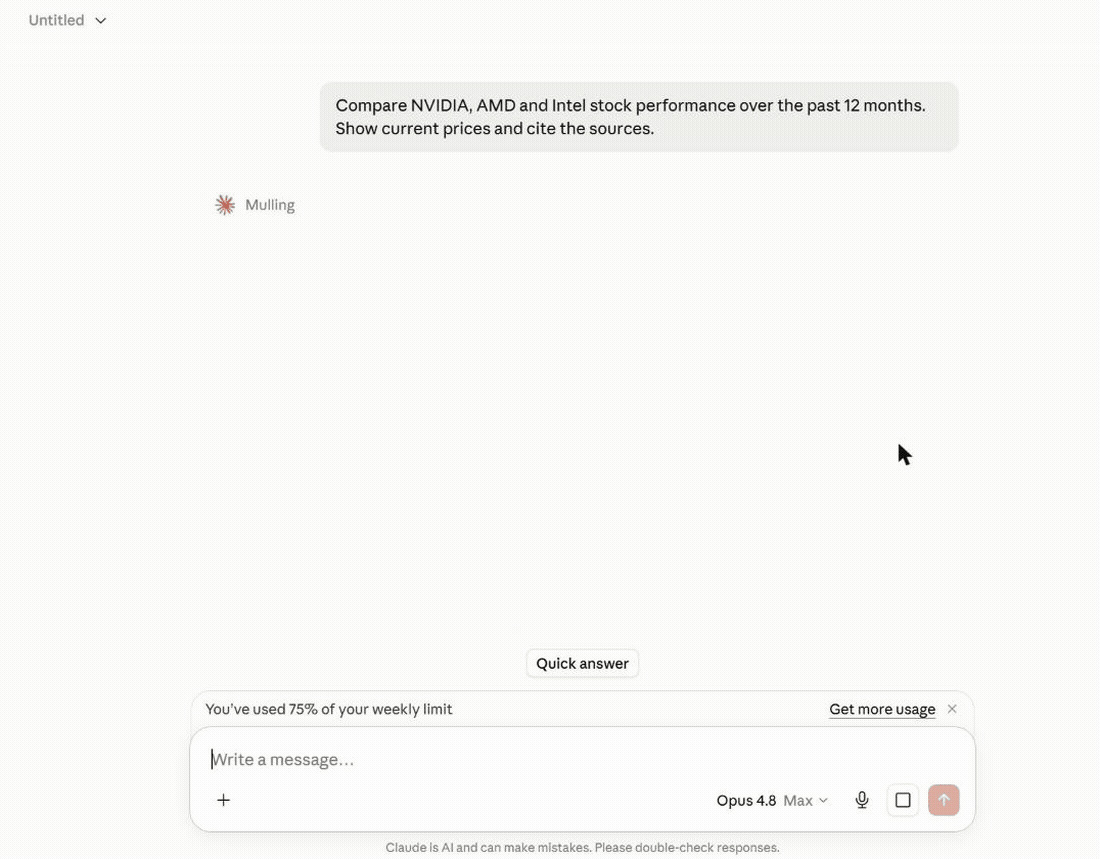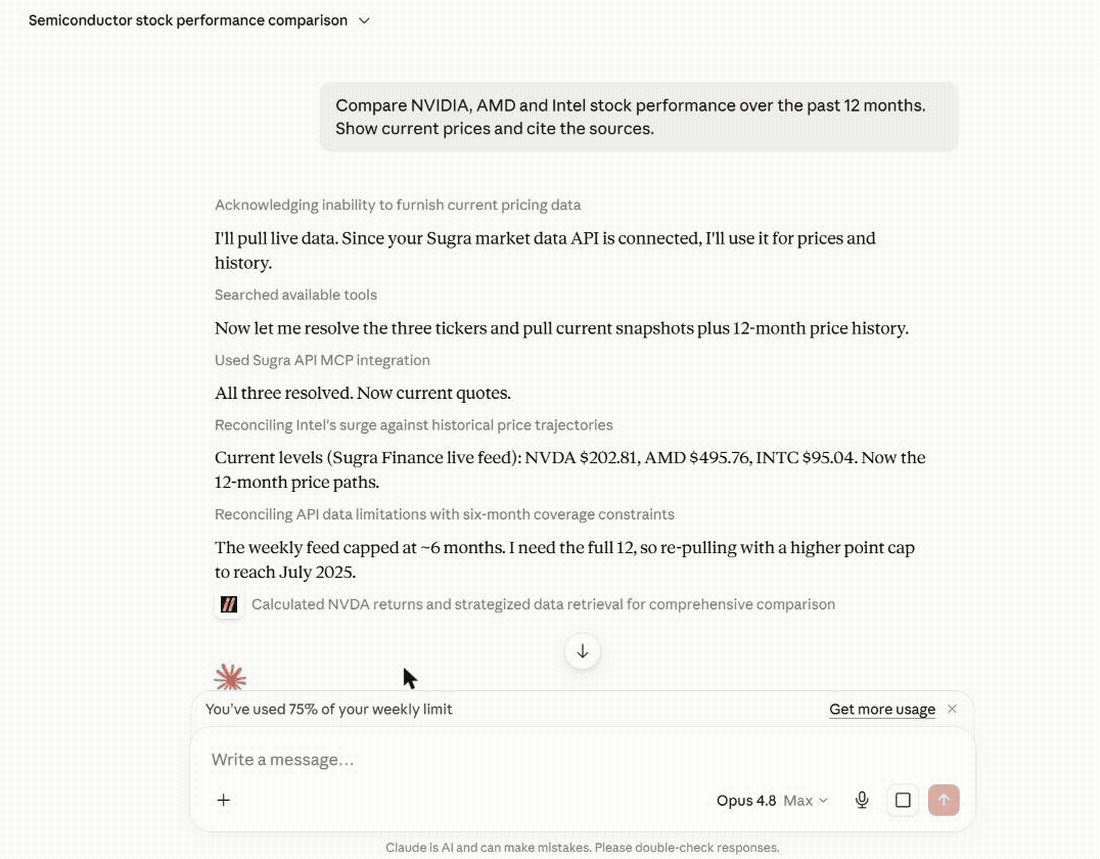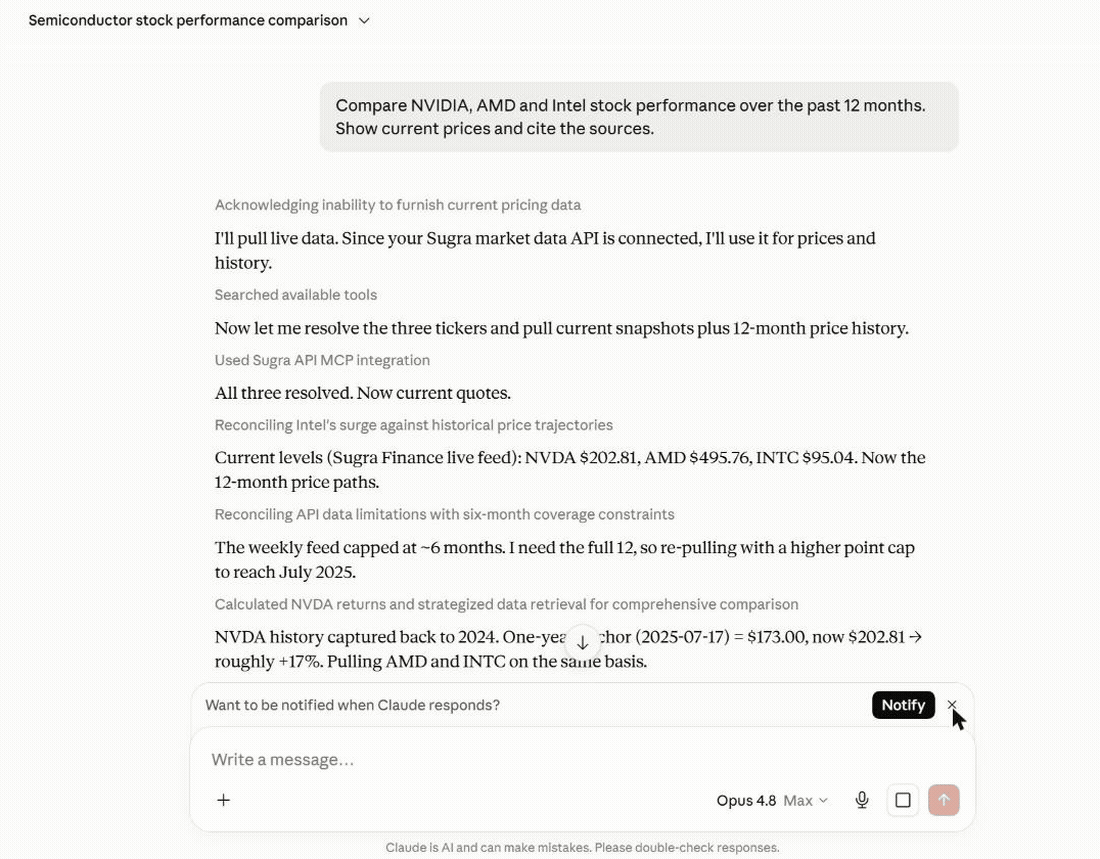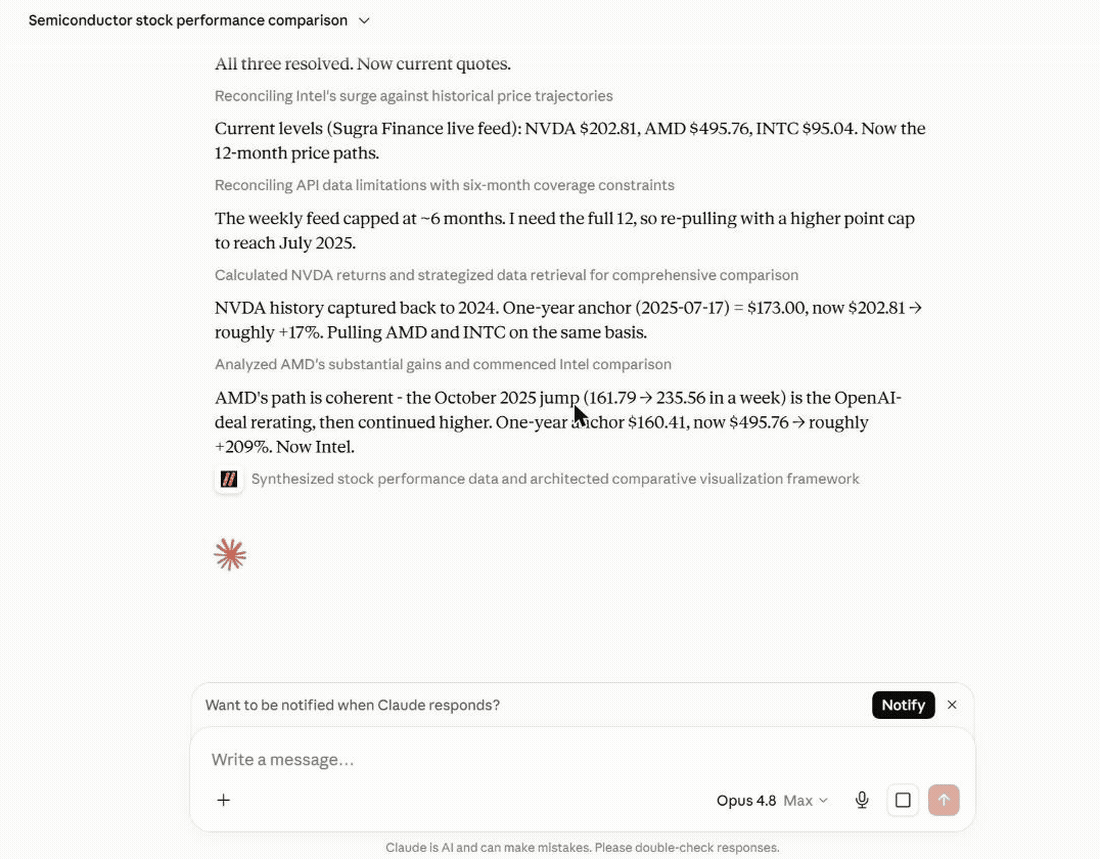
エンティティを特定し、最新スナップショットと過去データを取得して、すべての数値に出典と鮮度を付けながら、実際の質問に最初から最後まで回答するエージェントです。
その他の例:
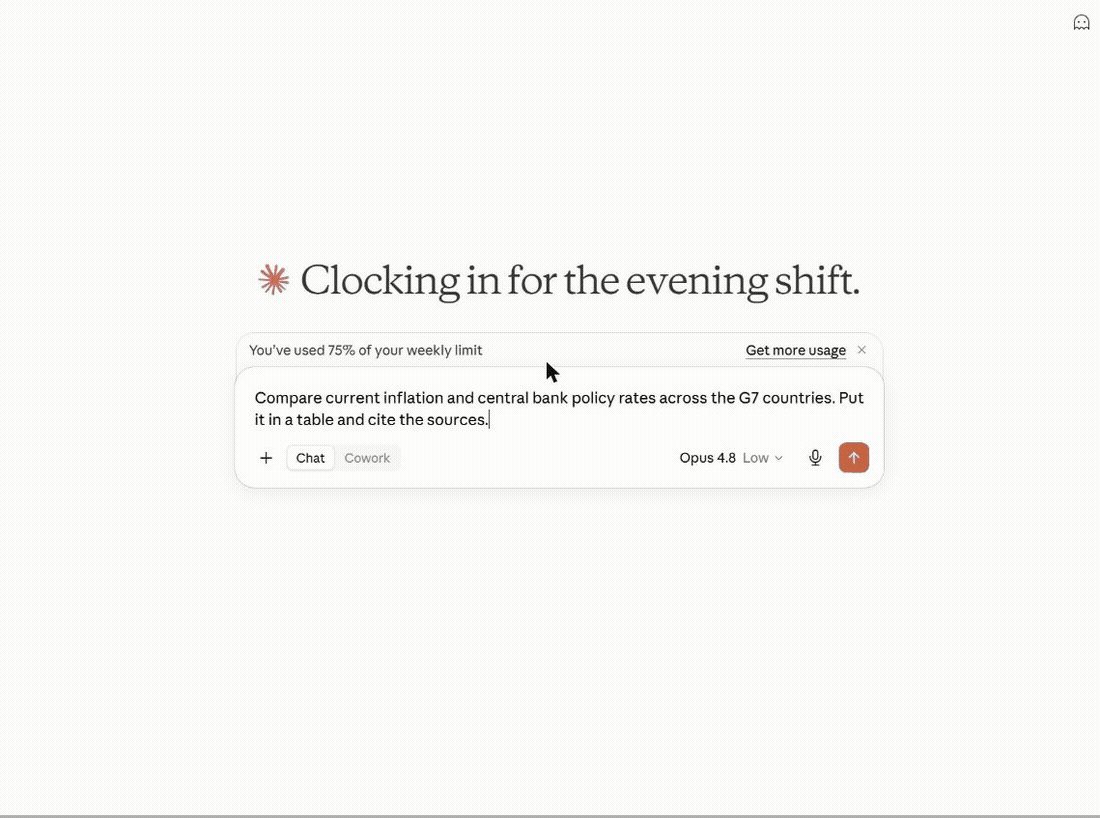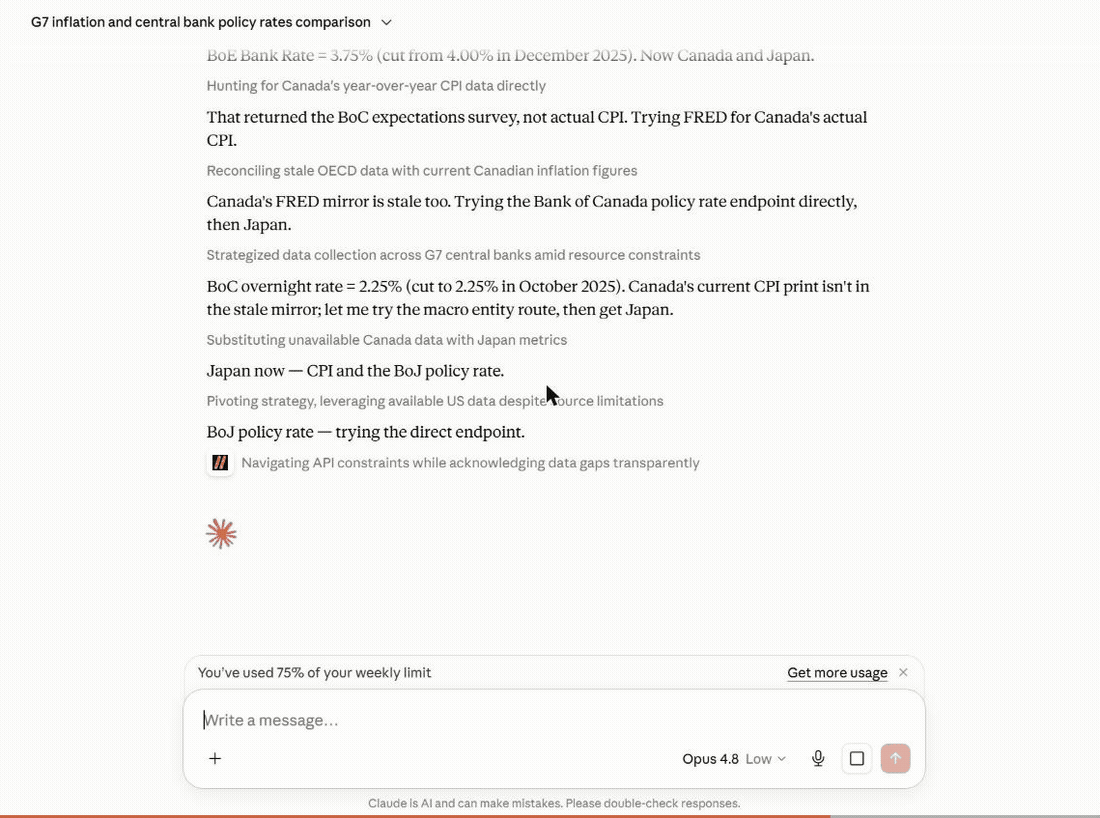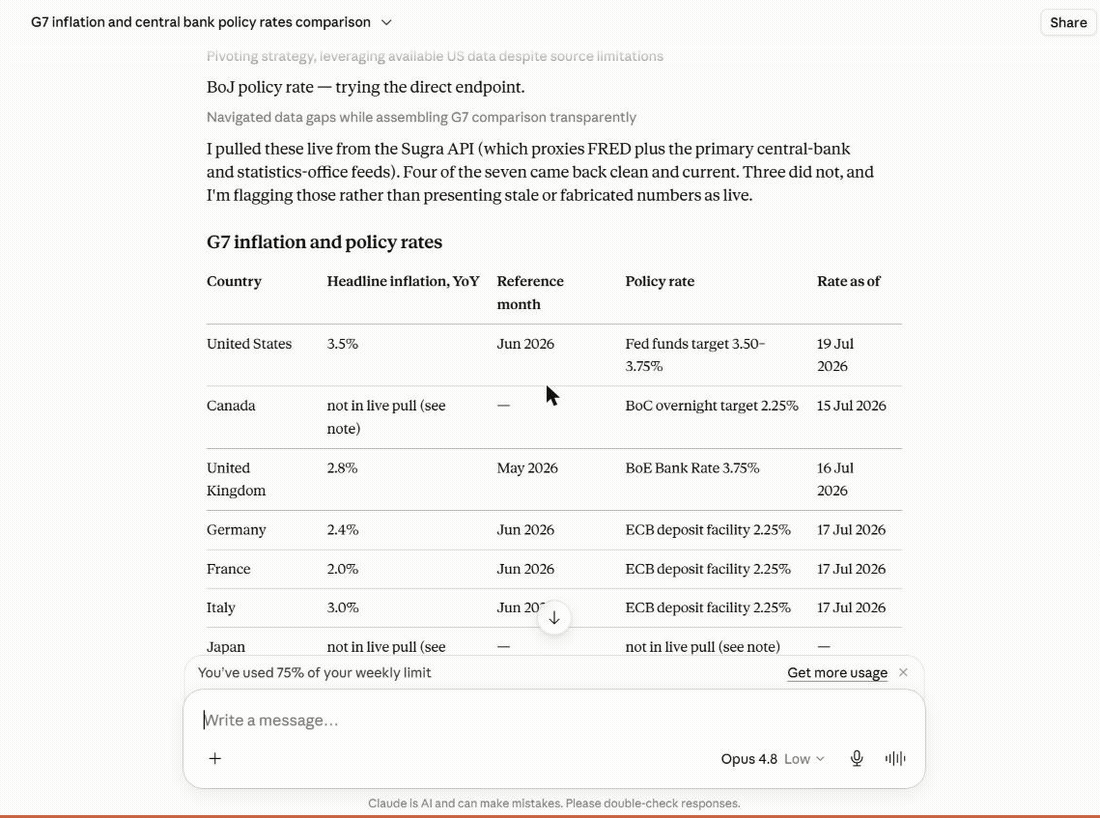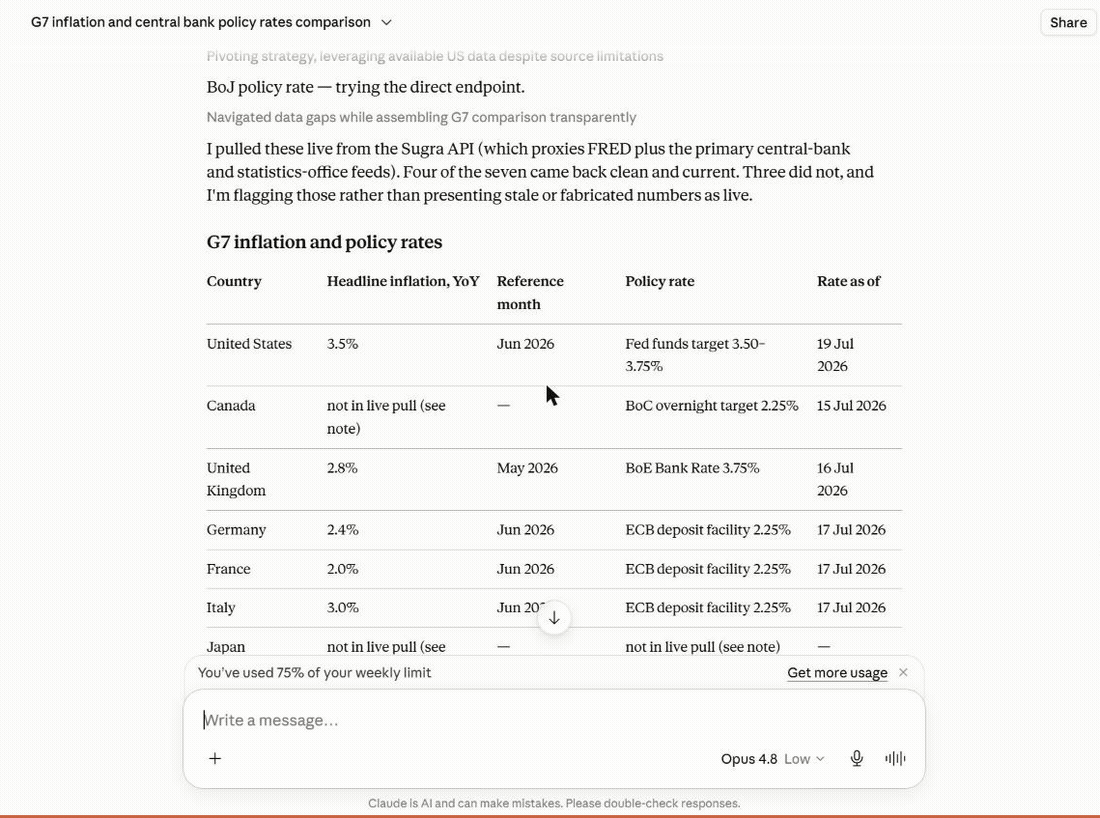
マクロ経済調査 - 1つのプロンプトから、G7のインフレ率と政策金利を網羅した表を作成します。各セルに日付と出典を付け、利用できないデータは捏造せずに明示します。
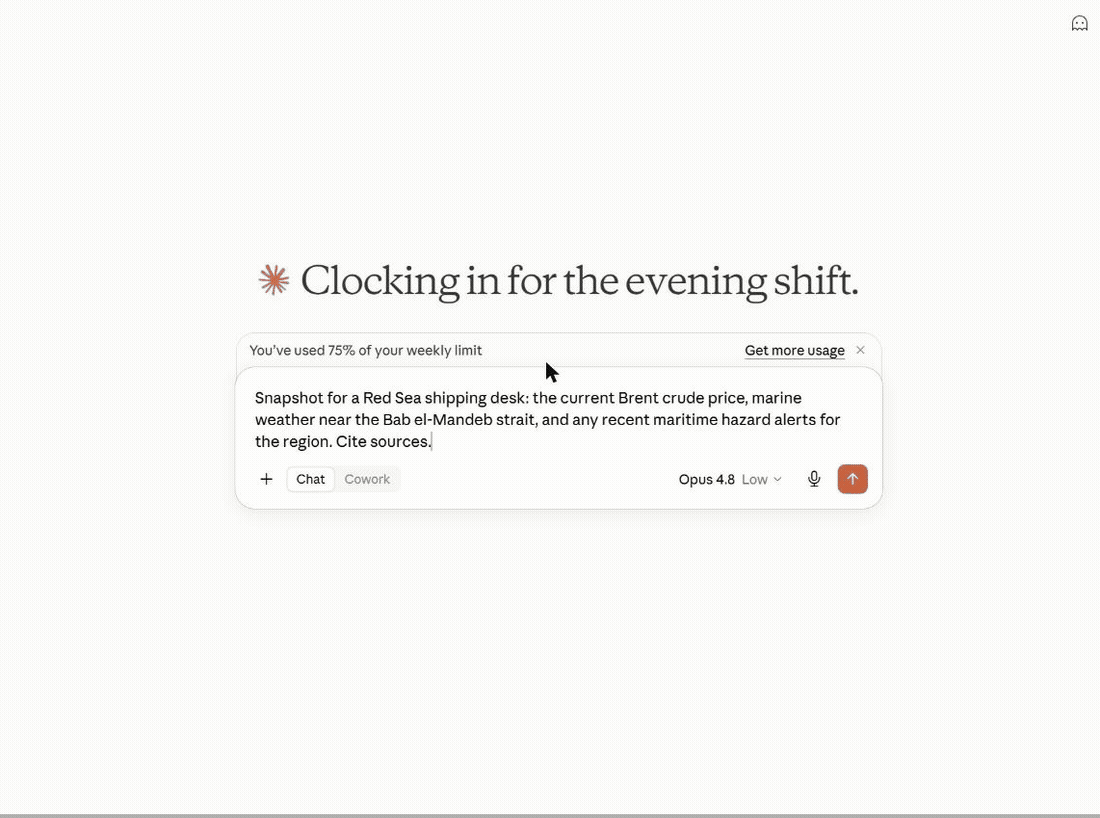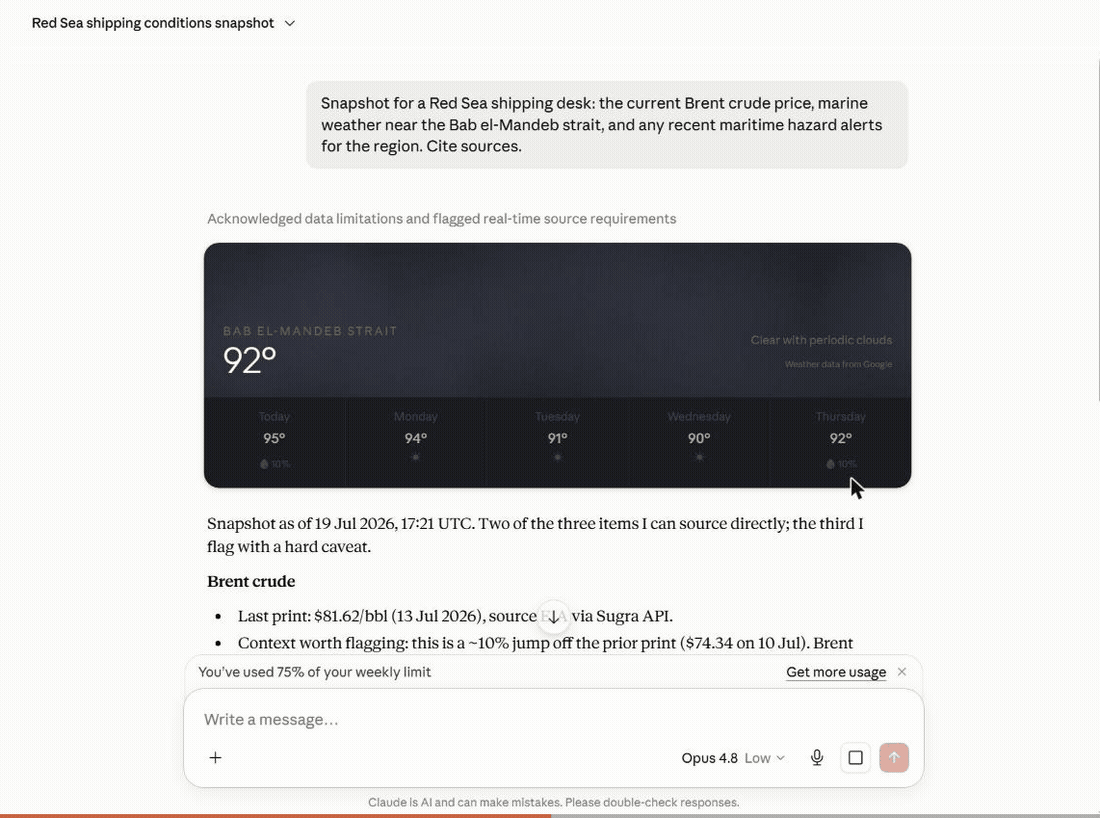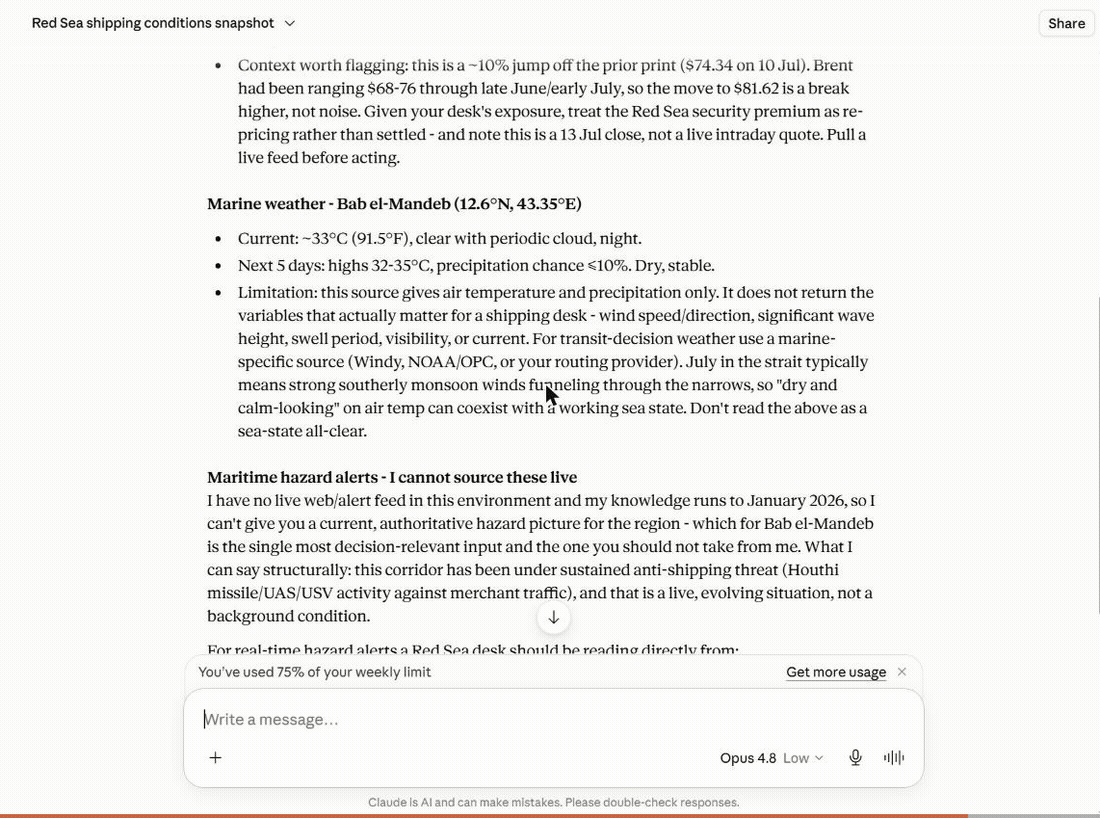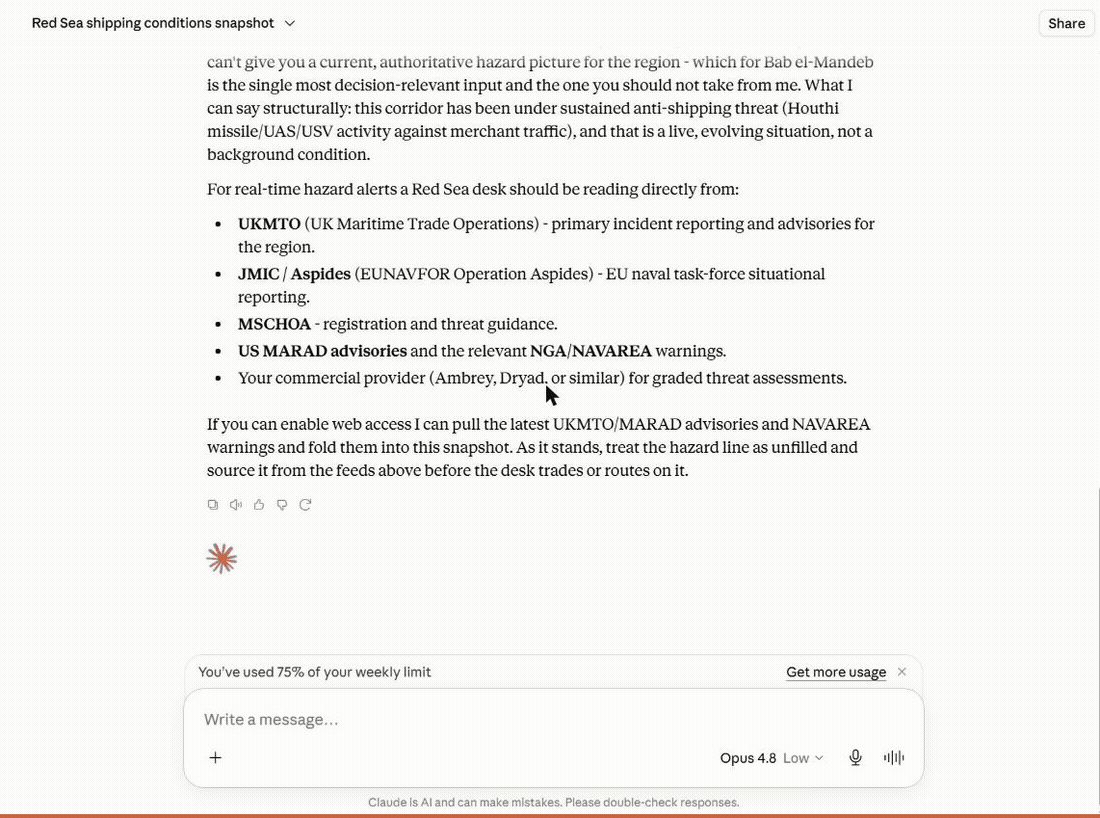
複数分野のスナップショット - 船舶運航デスク向けに、ブレント原油、海洋気象、地域リスクをまとめて取得し、それぞれの出典とタイムスタンプを付けます。
セッションの例
ホスト型 MCP のトランスクリプト(ここに示す3つの組み合わせツールは、ホスト型エンドポイントで実行されます)。掲載例の文言や数値は、実行ごとに、また新しい BLS データの公開に伴って変わります。
User: Where does US inflation stand, and how has it trended over the past year?

resolve_entity("US inflation")
  -> macro indicator cpi_us (U.S. Bureau of Labor Statistics)
get_snapshot("cpi_us")
  -> latest reading with freshness, provenance and quota cost
get_timeseries("cpi_us", metric="macro_series", range="1y")
  -> 12 monthly points with an explicit downsampling flag

Agent: US CPI printed 2.9% year over year in the latest release, down from
3.5% twelve months earlier - a steady decline since spring.
Source: U.S. Bureau of Labor Statistics via the Sugra API.
すべてのツール結果には、出典情報、鮮度、レート制限コストなどの構造化メタデータが含まれます。これにより、エージェントは推測に頼ることなく、出典を引用してリクエストを予算管理できます。
仕組み
flowchart LR
    A["AI agent<br/>(ChatGPT, Claude, Gemini, xAI, IDEs)"] --> B["Sugra MCP<br/>gateway tools, plus agent tools when hosted"]
    B --> C["Sugra API<br/>1,600+ endpoints, 36 data domains"]
    C --> D["160+ primary sources<br/>markets, economics, government,<br/>news, climate, maritime"]
ゲートウェイの背後には Sugra API があります。各国の統計機関、中央銀行、政府間機関など160以上の一次情報源からデータを取得し、36のデータドメインにわたる1,600以上のエンドポイントを提供します。サーバーにはエンドポイント全体を網羅するカタログが同梱されているため、検索、説明、ツールセットなどの検出処理はネットワーク呼び出しなしでローカルに実行されます。API にアクセスするのは、実際のデータリクエストのみです。
エージェントが構築するもの
Sugra API のスキルは Sugra-Systems/sugra-api-skills にあります。サーバーは、このリポジトリの固定コミットからそのうち5つを MCP リソース(sugra://skills/...)として提供します。接続後に URI を resources/read してください。
エージェントスキル
これらのスキルでは、カタログを使ったループを学べます。Claude Code プラグインはホスト型 Sugra MCP サーバーにも接続します。Codex と Grok のプラグイン、およびスキルフォルダーは MCP ツールを追加しないため、そこでサーバー(ホスト型またはローカル)に別途接続してください。各エージェント用のプラグインパッケージは Sugra-Systems/sugra-api-plugins にあります。
Claude Code
/plugin marketplace add Sugra-Systems/sugra-api-plugins
/plugin install sugra-api-skills@sugra-api-plugins
スキルは /sugra-api-skills:<skill> として表示されます。たとえば、/sugra-api-skills:discover-and-call です。プラグインはホスト型サーバー https://mcp.sugra.ai/mcp も追加します。/mcp から一度サインインしてください。
Codex
codex plugin marketplace add Sugra-Systems/sugra-api-plugins
codex plugin add sugra-api-skills@sugra-api-plugins
Grok
grok plugin install Sugra-Systems/sugra-api-plugins#xai
Cursor、Gemini CLI、その他のエージェント
npx skills add https://mcp.sugra.ai
または、sugra-api-skills のスキルフォルダーをエージェントのスキルディレクトリにコピーしてください。
ChatGPT
スキルは OpenAIのPlugins Directory からインストールします。MCP サーバーは、ホスト型コネクターとして https://mcp.sugra.ai/mcp(恒久的なエイリアスは https://app.sugra.ai/mcp)に接続されます。
サーバーには6つのワークフロープロンプトが用意されており、MCP プロンプトを表示するクライアントで、以下をワンクリックのフローとして利用できます。
- 市場・マクロ調査 - 「G7各国のインフレ率と中央銀行の政策金利を比較してください。」(
macro_briefing) - 出典付き株式スナップショット - 「NVIDIAの今日の状況は?株価、企業概要、市場環境を教えてください。」(
market_snapshot) - 制裁・コンプライアンス審査 - 「このサプライヤーを審査し、LEIの識別情報を特定してください。」(
sanctions_screening) - セクター比較 - 「エネルギーとテクノロジーの評価額と資金フローを並べて比較してください。」(
sector_compare) - 気候・海運・貿易インテリジェンス - 「今週の紅海の海運状況:要衝の通過状況、原油価格、航路上の天候を教えてください。」(
earth_conditionsと輸送・コモディティのカタログ) - ソースの探索 - 「カタログには債券についてどのような情報があり、どの機関が提供していますか?」(
source_overview)
すべての回答にはソースの帰属情報と鮮度のメタデータが含まれるため、エージェントは推測せずに出典を示せます。
ホスト型 MCP(推奨)
インストールは不要です。Claude、ChatGPT、Codex では、ディレクトリから Sugra API MCP サーバーを追加してください。
- Claude(ウェブ、デスクトップ、モバイル、Claude Code、Cowork):Claudeに追加 を開くと、AnthropicのConnectors Directoryにある Sugra API MCP サーバーが表示されます。接続し、Sugra アカウントでサインインしてください。claude.ai では、ディレクトリは カスタマイズ > コネクター にあります。claude.ai アカウントでサインインした Claude Code はコネクターを自動的に認識し、
/mcpに表示します。 - ChatGPT と Codex:ChatGPTに追加 を開くと、OpenAI Plugins Directoryにある Sugra API MCP サーバーが表示されます。
その他の MCP クライアントや手動で設定する場合は、ホスト型の Streamable HTTP エンドポイントを指定してください。
https://mcp.sugra.ai/mcp
- ゲートウェイツールに加えて、合成エージェントツール
resolve_entity、get_snapshot、get_timeseriesを利用できます - Claude と ChatGPT のコネクターフローを通じた OAuth サインイン、または API キーを使った
Authorization: Bearer sugra_xxx_... - claude.ai のカスタムコネクターとして設定する場合:カスタマイズ -> コネクター -> カスタムコネクターを追加
- ChatGPT の場合:設定 -> コネクター -> MCP サーバーを追加
Sugra をカスタムコネクターとして Claude に追加済みですか?その接続は引き続き利用でき、「カスタム」の下に表示されます。ディレクトリから Sugra API MCP サーバーも接続すると接続が2つになるため、まずカスタムの接続を削除してから、ディレクトリから接続してください。
ローカルパッケージ
API キーを使い、stdio(またはセルフホスト HTTP)経由でマシン上で実行します:
pip install sugra-api-mcp
- 8 つのゲートウェイツール
- デスクトップクライアントと IDE には stdio、セルフホストには Streamable HTTP を使用
SUGRA_API_KEYで認証します
app.sugra.ai/register で無料の API キーを取得できます(無料プラン:1 日 50 リクエスト)。
クイックスタート
pip install sugra-api-mcp
export SUGRA_API_KEY=sugra_xxx_...   # free key: app.sugra.ai/register
sugra-api-mcp call quotes_symbol_price --params '{"symbol":"AAPL"}'
エージェント経由でも同じように呼び出せます。サーバーをクライアントに接続して(次のセクションを参照)、「AAPL の現在の取引価格は?Sugra を使ってください。」と尋ねます。エージェントはカタログから quotes_symbol_price を見つけ、シンボルを指定して呼び出します。
クライアントを接続する
対応クライアント:
- Anthropic Claude:Claude Desktop、Claude Code(CLI)、claude.ai(Web)
- OpenAI GPT:ChatGPT(MCP コネクタ経由)
- Google Gemini:Gemini CLI、Gemini Code Assist(VS Code + JetBrains)
- xAI:xAI SDK と Responses API の Remote MCP Tools
- IDE:VS Code(ネイティブ)、Cursor、Zed、Cline、Continue.dev、Windsurf
- カスタムエージェント:Python または TypeScript の MCP SDK で構築されたものすべて
Claude Desktop(stdio)
claude_desktop_config.json に追加します:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json - Linux:Claude Desktop の Linux 版はありません。Linux では、
pip install sugra-api-mcpを実行し、Claude Code(CLI)、IDE クライアント、または以下のホスト型 HTTP エンドポイントを使用してください。
{
  "mcpServers": {
    "sugra": {
      "command": "sugra-api-mcp",
      "env": {
        "SUGRA_API_KEY": "sugra_xxx_yourkey..."
      }
    }
  }
}
Claude Desktop を再起動します。ツールメニューに Sugra ツールが表示されます。
Claude Code(Anthropic CLI)
claude.ai アカウントで Claude Code にサインインしていますか?Claude に追加 を使うと、claude.ai の Connectors Directory から Sugra API MCP サーバーに接続でき、ローカルへのインストールなしで /mcp に表示されます。代わりにローカルパッケージを実行するには:
claude mcp add sugra -- sugra-api-mcp
# then set the env var that sugra-api-mcp reads
export SUGRA_API_KEY=sugra_xxx_...
または、上記の Claude Desktop と同じ形式で ~/.claude/config.json を手動で編集します。
ホスト型サーバーにも接続するプラグインとしてスキルをインストールするには:
/plugin marketplace add Sugra-Systems/sugra-api-plugins
/plugin install sugra-api-skills@sugra-api-plugins
/mcp から一度プラグインのサーバーにサインインします。claude.ai の Sugra API コネクタも接続されている場合、Claude Code にはプラグインのサーバーのみが表示されます。ローカルパッケージも実行すると、Sugra サーバーが 2 つになります。claude mcp remove sugra でローカルパッケージを削除するか、プラグインを使わずに sugra-api-skills のスキルフォルダーを ~/.claude/skills/ にコピーしてください。
Gemini CLI での使用
Gemini CLI は MCP サーバーの設定を ~/.gemini/settings.json(ユーザースコープ)またはプロジェクト内の .gemini/settings.json から読み込みます。ローカルの stdio インストールでは、次を追加します:
{
  "mcpServers": {
    "sugra": {
      "command": "sugra-api-mcp",
      "env": {
        "SUGRA_API_KEY": "sugra_xxx_yourkey..."
      }
    }
  }
}
コンソールスクリプトが PATH にない場合は、代わりに "command": "python" と "args": ["-m", "sugra_api_mcp"] を使用してください。対応する Gemini CLI コマンドは次のとおりです:
gemini mcp add --scope user -e SUGRA_API_KEY=sugra_xxx_yourkey... sugra sugra-api-mcp
または、パッケージをインストールせずにホスト型エンドポイントに接続します:
gemini mcp add --scope user --transport http \
  --header "Authorization: Bearer sugra_xxx_yourkey..." \
  sugra https://mcp.sugra.ai/mcp
接続を確認するには gemini mcp list を実行し、対話セッションで /mcp を入力して利用可能なツールを確認します。ローカルの stdio 接続ではツールリファレンスにある 8 つのゲートウェイツールが表示されます。ホスト型エンドポイントには、これに加えてホスト型限定のエージェントツールが 3 つ表示されます。新しいディレクトリからローカルサーバーに接続できない場合は、再試行する前に gemini trust でそのワークスペースを確認し、信頼してください。
これらの例は、Gemini CLI MCP のドキュメントおよび Gemini CLI v0.51.0 で確認済みです。
Cursor、Zed、Cline、Continue.dev、Windsurf
これらはいずれも、Claude Desktop と同じ形式の stdio 設定を含む MCP 設定ファイル(通常は mcp.json または同等のファイル)を使用します。
ChatGPT
ChatGPT に追加 を使うと、OpenAI Plugins Directory から Sugra API MCP サーバーをインストールできます。または、ChatGPT はローカルの stdio プロセスを起動しないため、ホスト型 HTTP エンドポイント(以下)を MCP コネクタとして追加してください。
HTTP(claude.ai、ChatGPT、リモートエージェント)
claude.ai では、Claude に追加から、Anthropic の Connectors Directory にある Sugra API MCP サーバーに接続します。ChatGPT では、ChatGPT に追加から、OpenAI Plugins Directory を通じてインストールします。手動で設定する場合、またはその他の Streamable HTTP MCP クライアントを使用する場合は、ホストされたエンドポイントを使用してください。
https://mcp.sugra.ai/mcp
コネクタのフローで OAuth 認証を行うか、Authorization: Bearer sugra_xxx_... を使用して認証します。
claude.ai でカスタムコネクタとして追加する場合:Customize -> Connectors -> Add custom connector。 ChatGPT の場合:Settings -> Connectors -> Add MCP server。
ツールのリファレンス
ローカルパッケージでは、8 つのゲートウェイツールを公開しています。ホストされたエンドポイントでは、さらに 3 つの分析ツールを組み合わせたツールを追加で利用できます(上記の Hosted MCP を参照)。パッケージが公開するツールは、正確に 8 つです。
| ツール | 用途 |
|---|---|
fetch_data | 1 ステップで、自然言語のクエリに最適なエンドポイントを見つけて呼び出します。検索と呼び出しを 1 回のラウンドトリップにまとめます。 |
search_endpoints | 同梱されたエンドポイントカタログを検索します。実行時の検索では /openapi.json を取得しません。 |
describe_endpoint | operation_id に基づいてエンドポイントを調べ、パス、メソッド、パラメーター、必須入力、agent_hints、および JSON 本文を使用する POST 操作の request_body_schema を確認します。 |
call_endpoint | operation_id に基づいて Sugra API の操作を呼び出します。任意のパスを指定した呼び出しはサポートされなくなりました。 |
list_toolsets | エンドポイント数と説明を含むカタログのグループを一覧表示します。 |
list_sources | 同梱されたカタログのソースメタデータを表示します。 |
sugra_entity_screen | 制裁リストおよびウォッチリストに対して名称を照合します(Sugra Entity)。 |
sugra_entity_lookup | 識別子によるエンティティ検索を組み合わせて実行します。anchor は lei または vat、識別子は value で指定します。登記上の識別情報とスクリーニング結果を返します(Sugra Entity)。 |
call_endpoint と fetch_data はどちらも、limit、fields、include_raw によるレスポンスの整形をサポートしています。整形は、エンベロープ形式({"data": ...})とエンベロープなしのペイロードのどちらにも適用されます。fields の項目では、ネストされたオブジェクトへのドット区切りパス(geo.city)を指定できます。また、meta.shaped はリクエストをそのまま反映するのではなく、実際に適用された内容(fields_applied/fields_unmatched、limit_applied、records_path、order、kept_end)を報告します。limit と fields はレコードリストに適用されます。対象となるのは、エンベロープの data リスト、トップレベルの配列、または data、entries、events、history、items、observations、points、records、results、rows、series、timeseries のうち、ちょうど1つにリストが含まれるオブジェクト内のリストです(たとえば、最新ニュースの data.items、FRED シリーズの data.observations)。data にそのような単独のリストがないものの、そのすべての値が observations という名前のリストを1つだけ含むオブジェクトである場合(複数の名前付きサブシリーズが並ぶケースなど)、limit は各 data.<key>.observations リストを個別に制限します。この場合、fields では引き続き data のキーを指定します。そのリストと並ぶ total や count などのキーは送信されたまま保持され、レコード内にネストされたリストは切り詰められません。data 自体のキーを指定する fields 項目は、代わりにそのオブジェクトを射影します。また、何にも一致しない射影では、ペイロード全体がそのまま残ります。meta.shaped.limit_applied は上限が適用されたかどうかを示し、meta.shaped.records_path は使用されたリスト(data、data.<key>、data.*.observations、またはレコードリストが使用されなかった場合は null)を示します。すべてのレコードが、同じ形式の1つの日付または期間キー(date、period、year など)を持ち、リストがそのキーに基づいて一方向に並んでいる場合、limit はレコードリストの新しい側を保持します。古い順のリストでは最後の N 件を元の順序のまま保持し、新しい順のリストでは最初の N 件を保持します。それ以外の場合は、最初の N 件を保持します。limit がレコードリストを制限するたびに、meta.shaped.order は asc、desc、unknown のいずれかを示し、meta.shaped.kept_end は newest または first を示します。どちらも、サブシリーズが並列にある場合はサブシリーズ名ごとのマップになります。トップレベルの JSON 配列(またはスカラー値)は、MCP の結果がオブジェクトのままになるよう、常に {"data": ...} でラップされます。そうしないと、FastMCP の出力検証で成功した呼び出しがエラーとして報告され、行が破棄されます。 |
fields で指定できるパスは最大32個で、各パスは最大256文字、ドット区切りの部分は最大16個です。いずれかの上限を超えると、リクエストを行う前に呼び出しは projection_too_large を返します。fields を指定すると、1回の射影で処理できるリスト項目は最大100,000件、実行時間は最大5秒、射影前のレスポンスは JSON で最大2,000,000文字です。この上限は、射影後に適用される結果の18,000文字制限を大幅に上回っています。たとえば、16日間の天気予報は、fields=["daily"] で必要な部分だけに絞れば収まりますが、射影前は約295,000文字です。fields を指定しない場合、これらの上限は適用されません。整形は専用の2つのワーカースレッドからなるプールで実行され、イベントループ上では実行されません。実行中またはワーカーを待機中のジョブは最大8件で、そのうち同一呼び出し元のものは最大4件です。空きスロットがない状態で2秒以内に確保できなかった呼び出しは、スコープが shaping または caller_shaping の server_busy を返します。
describe_endpoint はエンドポイントごとに算出した agent_hints を返すため、エージェントは呼び出し前に所要時間と並列処理数を見積もれます。
duration_class-fast(約2秒未満、スナップショットベース)、slow(ライブのアップストリームへのプロキシ処理で、15秒を超えることもあります)、またはheavy(項目ごとのアップストリーム処理で、大きなバッチはゲートウェイのタイムアウトを超えることがあります)max_concurrency- 1つのセッションからの並列呼び出し数の推奨上限bulk_cost- 項目ごとの一括処理エンドポイントの場合:リクエスト本文の項目1つにつきリクエストクレジット1件(API はレスポンスヘッダーX-RateLimit-Costで合計を報告します)
ホスト型専用エージェントツール(mcp.sugra.ai/mcp)
ホスト型 MCP エンドポイント https://mcp.sugra.ai/mcp は、同じ 8 つのツールに加えて、stdio またはセルフホスト型インストールでは利用できない、組み合わせ型エージェントツールを 3 つ提供します。
| ツール | 目的 |
|---|---|
resolve_entity | ティッカー、企業、指標、コイン、通貨ペアなどの自由形式テキストを、正規の市場またはマクロエンティティに解決します。曖昧な一致の場合は、候補を順位付けして返し、暗黙に 1 つを選ぶことはありません。 |
get_snapshot | エンティティと名前付きレシピを指定して、鮮度、出所、カバレッジ、課金の各ブロックを含む、組み合わせ型の現在のビューを取得します。組み合わせ型の呼び出しでは、1~2 リクエストの固定レシピコストが 1 日あたりのクォータから差し引かれます。 |
get_timeseries | エンティティと指標(price、macro_series、etf_flows、etf_monthly_flows)を指定して、ダウンサンプリングの有無を明示した範囲限定の時系列を取得します。etf_flows は提出頻度で推定します。etf_monthly_flows は、ファンド独自の NPORT-P による月次の設定と解約です。 |
これら 3 つのツールは、ホスト型デプロイメントでのみ利用可能なインフラストラクチャ認証情報を必要とする、内部の組み合わせ型プレーンをラップしています。ツールのコードはパッケージに含まれていますが、ホスト型 HTTP エントリーポイントでのみ、かつその認証情報が存在する場合にのみ登録されます。pip install sugra-api-mcp(stdio およびセルフホスト型 HTTP)では、常に従来の 8 ツールゲートウェイが公開されます。ドキュメント内のホスト型専用の例には、その旨が記載されています。コンプライアンス目的のエンティティ検索(LEI/VAT、制裁スクリーニング)には、どのトランスポートでも利用できる sugra_entity_lookup と sugra_entity_screen を使用してください。
ChatGPT のツールセット
MCP の initialize でクライアント名に openai-mcp(ChatGPT)を指定するセッション、またはクライアント名を送信せず、User-Agent がそれで始まるセッションでは、上記のその他のツールに加えて、search_endpoints、describe_endpoint、call_endpoint、fetch_data の代わりに、型付きツールを 142 個列挙します。各操作につき 1 つのツールがあり、get_stock_quotes や get_price_history のような動詞名と、それぞれの入力スキーマおよび簡潔な結果を備えています。型付きツールでは、位置情報の生の入力(座標、住所、郵便番号)は受け付けません。型付きツールは、対応する操作より少ない入力を受け付ける場合があります。get_latest_news、search_news、search_global_news_articles では、必須のトピックまたは名前と件数を受け付けますが、他のクライアントは引き続き call_endpoint を通じて、それらの操作のすべての入力を指定できます。定義されている型付きツール 145 個のうち、これら 3 つはそのようなセッションには列挙されません(sugra_api_mcp/server.py の CHATGPT_UNLISTED_TYPED_TOOLS)。そのようなセッションに列挙されるものは、そのセッションに列挙されていないツールの名前を示しません。list_toolsets と list_sources には、search_endpoints のフィルターヒントを含まない説明があり、読み込まれるプロンプトと sugra://skills/ リソースにも、列挙されているツールのみを示す文言が使われます。それ以外のすべてのクライアントには、上記のツールが変更なしで列挙されます。どのクライアントも、これらのツールを名前で呼び出すことができます。ツールセットは sugra_api_mcp/catalog/data/typed_tools.json で定義されています。
CLI
サーバーの起動方法に変更はありません。
sugra-api-mcp
sugra-api-mcp --transport streamable-http --port 8001
カタログおよびゲートウェイのヘルパー:
sugra-api-mcp doctor
sugra-api-mcp list-toolsets
sugra-api-mcp search "NASDAQ futures"
sugra-api-mcp describe cot_financial
sugra-api-mcp call quotes_symbol_price --params '{"symbol":"AAPL"}'
環境変数
ローカルインストール、MCP クライアント、Docker stdio、ディレクトリサンドボックス(Glama Try in Browser など)向けのユーザー設定です。設定するのは次の変数だけです。
| 変数 | 必須 | デフォルト | 説明 |
|---|---|---|---|
SUGRA_API_KEY | API 呼び出しに必要 | - | Sugra API キー(sugra_...)です。無料キーは app.sugra.ai/register で取得できます(無料プラン:1 日あたり 50 件のリクエスト)。サーバーの起動には必要ありません。カタログツール(search_endpoints、describe_endpoint、list_toolsets、list_sources)はキーなしで動作しますが、API 呼び出しを行うツールは、設定されるまで構造化された missing_api_key エラーを返します。HTTP モードでクライアントの Bearer トークンを使用する場合、これはフォールバックとしてのみ使われます。 |
任意の上書き設定(必要な場合を除き、未設定のままにしてください):
| 変数 | デフォルト | 説明 |
|---|---|---|
SUGRA_API_BASE | https://sugra.ai | Sugra API のベース URL を上書きします(セルフホストまたはベータ API のみ)。 |
SUGRA_TIMEOUT | 30 | このサーバーから Sugra API への呼び出しにおける、下流 HTTP のタイムアウト秒数です。 |
セルフホストの Streamable HTTP 向けの運用者専用設定(リバースプロキシの CORS/ホスト、OAuth 認可サーバーとの接続、共有シークレット)については、docs/self-hosting.md に記載されています。公開ディレクトリのサンドボックスに運用者のシークレットを設定しないでください。SUGRA_MCP_TRUST_PROXY_HEADERS(デフォルトでは無効)を有効にすると、サーバーは X-Real-IP と X-Forwarded-Host を読み取ります。すべてのリクエストで両方を上書きするリバースプロキシの背後でのみ設定し、クライアントがプロセスに直接アクセスできる環境では絶対に設定しないでください(詳細は同じガイドを参照)。SUGRA_MCP_LIMITS(デフォルトでは無効)を有効にすると、サーバー自身のメモリ内でカウントするリクエスト制限が有効になります。設定項目については、同じガイドを参照してください。
OAuth を使った HTTP トランスポート
--transport streamable-http を指定して実行すると、サーバーは認証なしの MCP 検出リクエスト(initialize、notifications/initialized、tools/list、resources/list、prompts/list、ping)を許可するため、ChatGPT Apps やその他の混合認証クライアントがツールのメタデータを検出できます。ツールの呼び出しには引き続き Authorization: Bearer ... が必要です。次の 2 種類のトークン形式を受け付けます。
- 生の API キー(
sugra_...)— 下流のx-api-keyとして渡されます。以前のローカル API キー設定と互換性があります。 - OAuth JWT — 発行者の JWKS に対して署名が検証されます。audience は
https://app.sugra.ai/mcpと一致する必要があり、トークンにはsugra:readが含まれている必要があります。また、ユーザーのプライマリ API キーを解決する前に、ホストされたアクセス権が APP に対して検証されます。ホスト型 OAuth リクエストが成功すると、APP の MCP 接続アクティビティが更新されます。
ほとんどのユーザーには、OAuth をセルフホストする代わりに、API キーを Bearer として使い、ホスト型エンドポイント https://mcp.sugra.ai/mcp を利用する方法をおすすめします。スタンドアロンの OAuth クライアントは、現時点ではエイリアス https://app.sugra.ai/mcp でサインインしてください。独自の HTTP プロセスを実行する場合は、docs/self-hosting.md を参照してください。
タイムアウトとエラーの仕様
SUGRA_TIMEOUT は、このサーバーから Sugra API への各下流 HTTP 呼び出しのタイムアウトを設定します(デフォルトは 30 秒)。これはより長い連鎖の一部です。ツール呼び出しが失敗した場合、エラーペイロードの elapsed_ms から、どのリンクで問題が発生したかを確認できます。
MCP client (agent harness)         own tool timeout, often 60-180s, client-controlled
  -> hosted proxy (app.sugra.ai)   86400s, effectively unlimited
    -> this server (httpx)         SUGRA_TIMEOUT, default 30s
      -> Sugra API -> upstreams    15-60s per upstream call, server-side
ツールの失敗時には例外を発生させず、構造化 JSON を返すため、エージェントは再試行の方法を選べます。
error の値 | 意味 | 再試行の方法 |
|---|---|---|
upstream_timeout | SUGRA_TIMEOUT 内に応答がありませんでした(elapsed_ms は timeout_s x 1000 に近い値です) | 1 回再試行します。通常、中断された試行はサーバー側で完了し、上流キャッシュが温まります。その後、リクエストの範囲を絞ります(バッチを小さくする、フィルターを厳しくするなど)。 |
upstream_connect_error | Sugra API に接続できませんでした(DNS の失敗、接続拒否など) | 少し待ってから再試行します。 |
upstream_transport_error | リクエスト中に接続が切断されました | 1 回再試行します。 |
invalid_request_url | リクエストを作成できませんでした。多くの場合、パラメーターによって URL が 65,536 文字を超えています。何も送信されていません | パラメーターの値を減らすか短くするか、リクエストを分割します。 |
unusable_api_key | このサーバーがリクエストヘッダーで送信できない文字(ASCII 以外の文字、改行文字などの制御文字、または先頭または末尾のスペースやタブ)が API キーに含まれています。何も送信されていません | 再試行しないでください。キーを交換する必要があります(トラブルシューティングを参照)。 |
response_too_deep | API の応答が深くネストされすぎて測定できないため、返されません | 1 回再試行し、問題が続く場合は報告します。 |
自由形式の文字列 + status_code | API が HTTP 4xx/5xx で応答しました。API が Retry-After ヘッダーを送信した場合は retry_after も含まれます | 429/503 の場合は retry_after に従い、4xx の場合はリクエストを修正します。 |
tool_execution_failed | ゲートウェイ内部で予期しないエラーが発生しました(exception_type を含みます) | 問題が続く場合は報告します。 |
query_too_long | search_endpoints または fetch_data のクエリが 64 語または 1000 文字を超えています(max_terms と max_chars を含みます)。語とは 2 文字以上の ASCII 英字または数字の並びで、重複も数えられます。検索は実行されていません | クエリを短くし、金融商品、系列、場所、またはタスクを指定します。 |
projection_too_large | fields の投影が上限のいずれかを超えました。limit_kind が該当する上限を示します。fields(パスが 32 個超)、path_chars(パスが 256 文字超)、path_parts(ドット区切りの部分が 16 個超)、rows(走査したリスト項目が 100,000 個超)、shaping_ms(5 秒超)、raw_chars(投影前の応答が 2,000,000 文字超)のいずれかです。limit、actual、field_index(path_chars および path_parts の場合は 0 から始まります)、operation_id が含まれますが、フィールドのテキストは含まれません。最初の 3 種類の上限は、リクエストを送信する前に拒否されます | フィールドの数を減らすか短くし、limit を追加してリクエストの範囲を絞るか、fields を省略します。 |
server_busy | 同時実行数の上限に達しました。scope は、サーバー全体の上限の場合は tool_calls、search、shaping、単一の呼び出し元に対する上限の場合は caller_tool_calls、caller_search、caller_shaping です。shaping または caller_shaping の場合は API リクエストがすでに実行され、応答が破棄されています。それ以外の scope では呼び出しは何も実行していません | 数秒待ってから再試行します。 |
すべてのエラーペイロードには elapsed_ms が含まれます。url はトランスポートエラーと HTTP エラーに含まれます(URL がまだ存在しない場合に発生する tool_execution_failed には含まれません)。3 種類のトランスポートエラーと invalid_request_url では、status_code は null です(HTTP ステータスを受信していません)。status_code を数値として比較する場合は、null になり得ることを考慮してください。ツール呼び出しが構造化 JSON ではなく、クライアント側のメッセージだけで失敗する場合は、このサーバーより上位にあるエージェントのハーネスでタイムアウトが発生しています。SUGRA_TIMEOUT ではなく、クライアントのツールタイムアウトを延長してください。
使用例
Claude に次のように依頼します。
- 「NASDAQ先物の Sugra エンドポイントを検索してください。」
- 「
cot_financialオペレーションについて説明してください。」 - 「シンボル AAPL を指定して
quotes_symbol_priceを呼び出し、シンボルと価格だけを返してください。」 - 「利用可能な Sugra ツールセットを一覧表示してください。」
トラブルシューティング
get_market_price、get_macro_indicator、get_newsをお探しですか? これらの厳選されたツール名は、一部の古いディレクトリ掲載情報に記載されていますが、このパッケージには含まれていません。自然言語で1ステップの呼び出しを行うにはfetch_dataを、明示的にルーティングするにはsearch_endpointsとcall_endpointを使用してください。
ツールの応答にmissing_api_keyと表示される場合
サーバーはキーがなくても起動してツールを一覧表示しますが、APIを呼び出すツール(call_endpoint、fetch_data、エンティティツール)は、サーバーがキーを見つけるまで{"error": "missing_api_key"}を返します。実行方法に応じて、次を確認してください。
- クライアント(Claude、ChatGPT、Gemini、xAI、IDEなど)からMCPツールとして使用する場合:MCP設定ファイルの
envブロックを確認してください。値にはs u g r a _ a o 1 _ . . .のような完全なキーを指定し、空欄にしたり、余分な引用符で囲んだりしないでください。 - シェル/CI:
sugra-api-mcpを実行する前にexport SUGRA_API_KEY=sugra_...を実行してください。 - HTTPモード:シェルではなく、
.envまたはsystemdのEnvironmentFileで設定してください。
sugra-api-mcp doctorを実行すると、プロセスからキーが参照できるかどうかが表示されます。
ツールの応答にunusable_api_keyと表示される場合
呼び出しに使用するサーバーのキーに、このサーバーがリクエストヘッダーに送信できない文字(ASCII以外の文字、不可視文字、改行、その他の制御文字、または先頭や末尾のスペースやタブ)が含まれています。この場合、APIを呼び出すツールはリクエストを送信せず、{"error": "unusable_api_key"}を返します。再試行しても同じ結果になります。キーの入手元に応じて、次を確認してください。
- 設定ファイルや環境変数に貼り付けたキーには、転記時に不可視文字が入り込むことがあります。app.sugra.ai/developer/keysからキーを再度コピーしてください。
- 一部の古いキーのように、キー自体にそのような文字が含まれている場合は、app.sugra.ai/developer/keysでキーをローテーションし、新しいキーを使用してください。サインイン連携(claude.ai、ChatGPT)では、サーバーはアカウントのキーを使用し、5分以内に再読み込みします。ページにキーをローテーションする項目がない場合は、[email protected]にメールで問い合わせてください。
ツールの応答に401 Unauthorizedまたは403 Forbiddenと表示される場合
キーは受け付けられましたが、拒否されています。よくある原因は次のとおりです。
- app.sugra.ai/developer/keysでキーを再生成したものの、設定に古いキーが残っています。
- 入力ミスがあります。キーに含まれるのは小文字の英字と数字のみです。スペースや末尾の改行は含まれません。
- 無料プランが無効化されています。サインインして状態を確認してください。
429 Too Many Requests
プランの1日あたりの上限に達しました。応答ヘッダーには、カウンターがリセットされる時刻(UTC午前0時)を示すUTCタイムスタンプX-RateLimit-Resetが含まれています。MCP経由では、ツールの結果にreason: daily_limit_reached、status_code: 429、retry_after、およびモデルにリセット時刻(APIからリセット時刻が送信されなかった場合、または有効な値でない場合はUTC午前0時)より前にデータツールを再度呼び出さず、ユーザーに伝えるよう指示するretry_hintが含まれます。また、APIから通知された場合はdaily_limitとplanも含まれます。プランについては sugra.systems/api/pricingをご覧ください。
上限に達する前は、call_endpointまたはfetch_dataの結果で残りの利用量を確認できます。meta.quotaには、APIのX-RateLimit-*応答ヘッダーからコピーされたlimit、remaining(本日の残りリクエスト数)、resets_atが含まれます。APIからクォータが通知されなかった場合、結果にmeta.quotaは含まれません。
Invalid Host header(HTTPモードをセルフホストする場合のみ)
FastMCPは、リバースプロキシの背後にあるパブリックホスト名に対してDNSリバインディング保護を適用します。許可するホストの設定については、docs/self-hosting.mdをご覧ください。
ツールの結果がmeta.truncatedの通知とともに切り詰められる
一部のエンドポイントは、非常に大きなペイロード(長期間の価格履歴、時間ごとの予報、カタログ全件)を返します。結果は、ASCII エスケープを含む JSON の 18,000 文字で上限に達します。そのため、CJK 文字やアクセント付き文字は 6 文字のエスケープとして数えられ、非 ASCII テキストは多めにカウントされます。クライアントがモデルに渡す内容を制限する方法は、それぞれ異なります。Claude Code は 50,000 文字を超えるツールの結果をモデルに渡す代わりにファイルに書き込み、Codex はユーザーが設定した予算に基づいてツールの結果をトークン数で制限し、予算を超えた部分は中央から削除します。測定した 18,000 文字のすべての形状は、最も密度の高いものも含め、Codex のデフォルトの予算内に収まりました。ただし、より密度の高い結果や、クライアント側で予算を低く設定した場合は、クライアントによって切り詰められることがあります。この上限はすべてのクライアントで同じです。どのような形状でも、大きな結果は上限に収まるよう切り詰められます。data の下、最大 2 階層までのリスト(キー名にかかわらず、data、data.<key>、data.<key>.<key>)はレコード単位で測定され、大きなリストは隣接する小さなリストより先に切り詰められ、切り詰められたリストにも少なくとも 1 件のレコードが残ります。リストには limit と同じ順序ルールで新しい側が残り、それ以外の場合は先頭のレコードが残ります。ただし、call_endpoint 経由では、予報やカレンダーのレコードは今日以降のものが残り、古い順・新しい順のどちらであっても、kept_end は nearest になります。fetch_data は call_endpoint 経由で処理を実行し、同じ方法で切り詰められます。レスポンスの meta がオブジェクトである場合、または存在しない場合に書き込まれる meta.fetch_data も上限に含まれます。切り詰め処理はイベントループ上ではなく、整形用プールで実行されます。そのため、プールが満杯の場合は server_busy を返します。処理時間は 5 秒で、レコードごとに確認されます。時間を超えると結果は拒否されます。固定ツールはこの時間を超えてさらに 0.5 秒後、call_endpoint は fields 投影にも独自の処理時間があるため、この時間の 2 倍を超えてさらに 0.5 秒後に待機を終了し、どちらも response_too_large を返します。また、2 秒の待機時間内に切り詰め処理を開始できない場合は server_busy を返します。Sugra API からのエラー、または API に至るまでの途中で発生したエラーは、どのゲートにも渡される前に 17,000 文字に制限されます。サーバーが独自に生成する拒否も同様です。これには、未知の operation_id やパラメーター、未解決のままのパスなど、呼び出しで送信された内容を反映する場合があります。長い API メッセージ、URL、ヘッダーなど、値が長すぎて収まらない場合は、末尾が ... になるよう切り詰め、その横に <key>_truncated: true を付けます。キーは削除されないため、ステータスと短い値はすべてそのまま残ります。固定ツールは、エラーボディも他の結果と同じようにゲートに通します。call_endpoint が受け取ったまま渡す上限超過のエラーペイロードは、測定されずに拒否されます。meta.truncated には、切り詰めた内容が示されます。reason(exceeds_response_size_cap)、最大のリストを切り詰めた path とその original_count、kept_count、order、kept_end、サイズを示す original_chars、kept_chars、cap_chars、複数のリストを切り詰めた場合はパスごとの lists エントリー(残した最初と最後の日付を示す kept_range を含む)、および残した内容と、その操作で利用できるパラメーターのみを示す retry_hint です。最大約 2 週間の予報では、今日からの時間ごとのデータと daily リスト全体が残り、ヒントには fields=["daily"] またはより小さい params.forecast_days が提示されます。16 日間の予報では最後の日も失われる場合があり、その場合のヒントにはより小さい params.forecast_days のみが提示されます。ただし、fields=["daily"] を指定すれば、16 日分すべてが上限内に収まります。価格履歴では新しいローソク足が残り、ヒントには params.limit または範囲を狭めた params.start と params.end が提示されます。切り詰めても収まらない場合は、サイズと上限を文字数で示し、大きすぎる部分の内容を明記した response_too_large エラーになります。これには、単独で上限を超えるレコード、レスポンスの残りと切り詰め通知を含めると収まらないレコード(両方のサイズと、同じようなレコードを含む他のリストの数を併記)、各リストが 1 件ずつ残した場合にそれらだけで収まらないレコード(合計サイズと最大のレコードのサイズを併記)、またはリスト以外の大きすぎる部分が含まれます。可能な場合は、大きな部分を除外できる fields も示されます。拒否自体は常に上限内に収まります。収まらない場合は、サイズを示す行だけを残し、URL を 300 文字に切り詰めます。
Python version 3.12 or higher is required
sugra-api-mcp には Python 3.12 以降が必要です。python --version で確認してください。3.11 以前の場合:
- Ubuntu:ディストリビューションのパッケージまたは deadsnakes PPA から Python 3.12 以降をインストールします。
- macOS:
brew install [email protected] - Windows:python.org からダウンロードします。
その後、仮想環境を作り直してください。
ホスト版の mcp.sugra.ai/mcp が 5xx を返す
デプロイ後、ホスト版エンドポイントが一時的に再起動する場合があります。60 秒待ってから再試行してください。問題が続く場合は、[email protected] までメールでお問い合わせください。
ローカルでのツール呼び出しのデバッグ
stdio で実行し、JSON-RPC メッセージをログに記録します:
SUGRA_API_KEY=sugra_... sugra-api-mcp 2>&1 | tee mcp-debug.log
2 つ目のターミナルから nc または MCP インスペクターを使って、手動で JSON-RPC を送信します。
開発
git clone https://github.com/Sugra-Systems/sugra-api-mcp
cd sugra-api-mcp
pip install -e ".[dev,http]"
export SUGRA_API_KEY=sugra_...
python -m sugra_api_mcp  # stdio mode
python -m sugra_api_mcp --transport streamable-http --port 8001  # HTTP mode
python scripts/build_endpoint_catalog.py  # rebuild bundled catalog from sibling API openapi.json
python scripts/build_endpoint_catalog.py --source https://sugra.ai/openapi.json  # from the live spec
# On DRIFT, catalog-parity.yml opens or updates PR branch ci/catalog-resync.
テストを実行します:
pytest
Docker
リポジトリのルートからイメージをビルドします:
docker build -t sugra-api-mcp .
ローカルプロセスを起動する MCP クライアント向けに、stdio モード(デフォルトのエントリーポイント)で実行します:
docker run -i --rm -e SUGRA_API_KEY=sugra_... sugra-api-mcp
Docker Compose を使って、ポート 8001 で Streamable HTTP トランスポートを実行します:
export SUGRA_API_KEY=sugra_...
docker compose up -d
次に、MCP クライアントの接続先を http://localhost:8001/mcp に設定します。Compose サービスは、シェルで設定されている場合、SUGRA_API_KEY と任意のオーバーライド(SUGRA_API_BASE、SUGRA_TIMEOUT)を渡し、http://localhost:8001/health でコンテナーのヘルスチェックを行います。リバースプロキシおよび OAuth の運用者向け設定については、docs/self-hosting.md を参照してください。
エラーを含め、アプリケーションが送信するすべてのレスポンスには、Server: sugra-api-mcp ヘッダーが付与されます。httptools パーサーで解析できないリクエストに対して uvicorn が返す 400 にも同じヘッダーが付きます。http エクストラが httptools をインストールし、uvicorn はデフォルトでこれを使用します。h11 パーサーでは、この 400 にヘッダーは付きません。サーバーの環境変数に SUGRA_MCP_SERVER_VERSION=1(または true、yes、on)を設定すると、ヘッダー(sugra-api-mcp/<version>)と /health レスポンスにパッケージのバージョンが追加されます。これを設定しない場合、バージョンは表示されません。
認証に関する注意:イメージには環境変数は組み込まれておらず、コンテナーの起動にも必要ありません。HTTP モードでは、クライアントはリクエストごとに Authorization: Bearer sugra_... で認証するため、コンテナーの SUGRA_API_KEY は Bearer トークンのないリクエストに対するフォールバックにすぎません。
ライセンス
MIT © 2026 Sugra Systems, Inc.
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。