agentic-video について
agentic-videoは、画像とテキストを使ってローカル動画を調べるAIエージェント向けのPythonライブラリ兼stdio MCPサーバーです。フレーム、文字起こし、カット、音声測定結果を返し、処理の大半をローカルで行います。
主な機能
- 01タイムスタンプ付きコンタクトシートの作成
- 02フレームと動画メタデータの検査
- 03音声の文字起こしと検索
- 04カットと重複フレーム区間の検出
- 05ラウドネス、音声オンセット、同期の測定
活用シーン
- 01抽出フレームを使った動画の確認
- 02単語が話された時刻の検索
- 03カットと音声同期の確認
- 04レンダリング動画の品質レポート作成
MCP 対応
stdio MCPサーバーは、動画・音声分析用の25個のツールをクライアントに公開します。大半のツールはローカルで動作し、任意のwatch_forとlabel_soundsは設定して呼び出すとフレームや音声をCloudflare Workers AIに送信します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
25掲載時のツール一覧 · 1 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| fps | number | いいえ | サンプリングレート。既定値は 10 です。15 を超える値は 15 に制限され、その旨が結果に示されます。 |
| method | enum | いいえ | auto(既定値)は motion、embedding、周期性チェックから選択します。motion または embedding を指定すると、対応する振幅カウンターのみを使用します。auto | motion | embedding |
| region | any | いいえ | 繰り返す動きを含む矩形を、フレームに対する割合で指定します。x、y(左上)と w、h(幅、高さ)を指定し、x+w <= 1、y+h <= 1 とします。w/h を使用します。同じ意味の width/height も指定できます。例:{"x": 0.25, "y": 0.1, "w": 0.5, "h": 0.6}。省略するとフレーム全体が対象になります。 |
| source | string | はい | ローカル動画ファイルのパス、または動画 URL(X/Twitter の投稿、YouTube リンク、yt-dlp が対応する他のサイト、.mp4 の直接リンク)。URL は一度だけダウンロードされ、キャッシュされます。ダウンロード中は結果が status=in_progress となり、retry_after_seconds が含まれるため、同じ source で再度呼び出してください。 |
| end_sec | number|string|null | いいえ | ウィンドウの終了時刻(秒)。既定値は動画の終了位置です。動画が 180 秒を超える場合は、開始と終了の両方を指定してください。MM:SS.mmm 形式のタイムコード文字列(例:00:14.250)も指定できます。 |
| start_sec | number|string | いいえ | ウィンドウの開始時刻(秒、既定値は 0)。ウィンドウの長さは最大 180 秒です。MM:SS.mmm 形式のタイムコード文字列(例:00:14.250)も指定できます。 |
| action_hint | string | いいえ | 数える動作を示す短い語句(例:'jumping jacks')。 |
| max_period_sec | number|string | いいえ | 予想されるサイクルの最長時間(秒、既定値は 3)。min_period_sec より大きくする必要があります。振幅カウンターのみを制限し、周期性チェックでは無視されます。MM:SS.mmm 形式のタイムコード文字列(例:00:14.250)も指定できます。 |
| min_period_sec | number|string | いいえ | 予想されるサイクルの最短時間(秒、既定値は 0.4)。振幅カウンターのみを制限します。周期性チェックでは無視され、0.25 秒から検索します。MM:SS.mmm 形式のタイムコード文字列(例:00:14.250)も指定できます。 |
詳細
agentic-video
agentic-video を使うと、テキストと画像は読み取れても動画は扱えない AI エージェントが、手元のマシンにある動画ファイルを扱えるようになります。Python ライブラリと stdio MCP サーバーで構成されています。エージェントが「0:40〜1:10 のフレームを12枚見せて」「「launch」と話しているのはいつ?」といった、具体的で範囲を絞った質問をすると、測定結果、文字起こし、コンタクトシートが返されます。コンタクトシートは、タイムスタンプが各フレームのピクセルに焼き込まれたフレームのグリッドです。すべての処理は FFmpeg、Whisper、オプションのローカルモデルを使ってローカルで実行されます。ただし、オプションのクラウドツール(watch_for、label_sounds)は例外で、認証情報を設定して呼び出した場合に限り、フレームまたは音声を Cloudflare Workers AI に送信します。オプトイン方式のシャドー文字起こしトライアル(デフォルトではオフ、オーナーのマシンのみ)でも、スイッチと認証情報を設定すると音声が Cloudflare に送信されます。
動作を見る: https://agentic-video-gallery.infra-1b7.workers.dev (ギャラリー:失敗例も含む実際のタスク)。
2 分で試す
いずれかの方法を選び、手順に従ってください。
- Claude Code:
brew install ffmpeg uvを実行し、次にclaude mcp add -s user agentic-video -- uvx agentic-videoを実行します。 - Claude Desktop: 最新リリースから
.mcpbをダウンロードしてダブルクリックします(macOS。先にbrew install ffmpegを実行してください)。 - Claude Code プラグイン: まず
brew install ffmpeg uvを実行します(プラグインのサーバーはuvxを実行します)。次にclaude plugin marketplace add tlq5l/agentic-video、続いてclaude plugin install agentic-video@agentic-videoを実行します(docs/claude-code-plugin.md)。 - その他のクライアント: JSON ブロックはMCP サーバーを実行するを参照してください。
次に、最初のプロンプトとして「Use agentic-video: make a contact sheet of /path/to/video.mp4 and list its cuts」と入力します。
- 実際の出力付きタスクレシピ 6 件:それぞれにプロンプトとツールの結果が含まれています。
- 何かに活用できましたか?Discussionsでお知らせください。
- 見落としを見つけましたか?issue を作成してください。
インストール: macOS では brew install ffmpeg、Debian または Ubuntu では sudo apt-get install -y ffmpeg を実行します(uv のコマンドについてはインストールを参照してください)。次に claude mcp add -s user agentic-video -- uvx agentic-video(または pipx install agentic-video)を使って Claude Code に追加します。その他のクライアントについては、MCP サーバーを実行するを参照してください。
Claude Desktop(ワンクリック): 最新のGitHub リリースから agentic-video-<version>.mcpb をダウンロードしてダブルクリックします。brew install ffmpeg も必要です。初回起動時は Claude Desktop が Python パッケージをインストールするため、約 1 分かかります。macOS のみ対応しています。このバンドルには、ローカルのビジュアル検索や画面上のテキストのカウント機能は含まれていません。これらの機能を使うには、以下の「オプション:ビジュアル検索(CLIP)と画面上のテキスト」セクションにある git インストールを利用してください。詳細:docs/features/desktop-bundle.md。
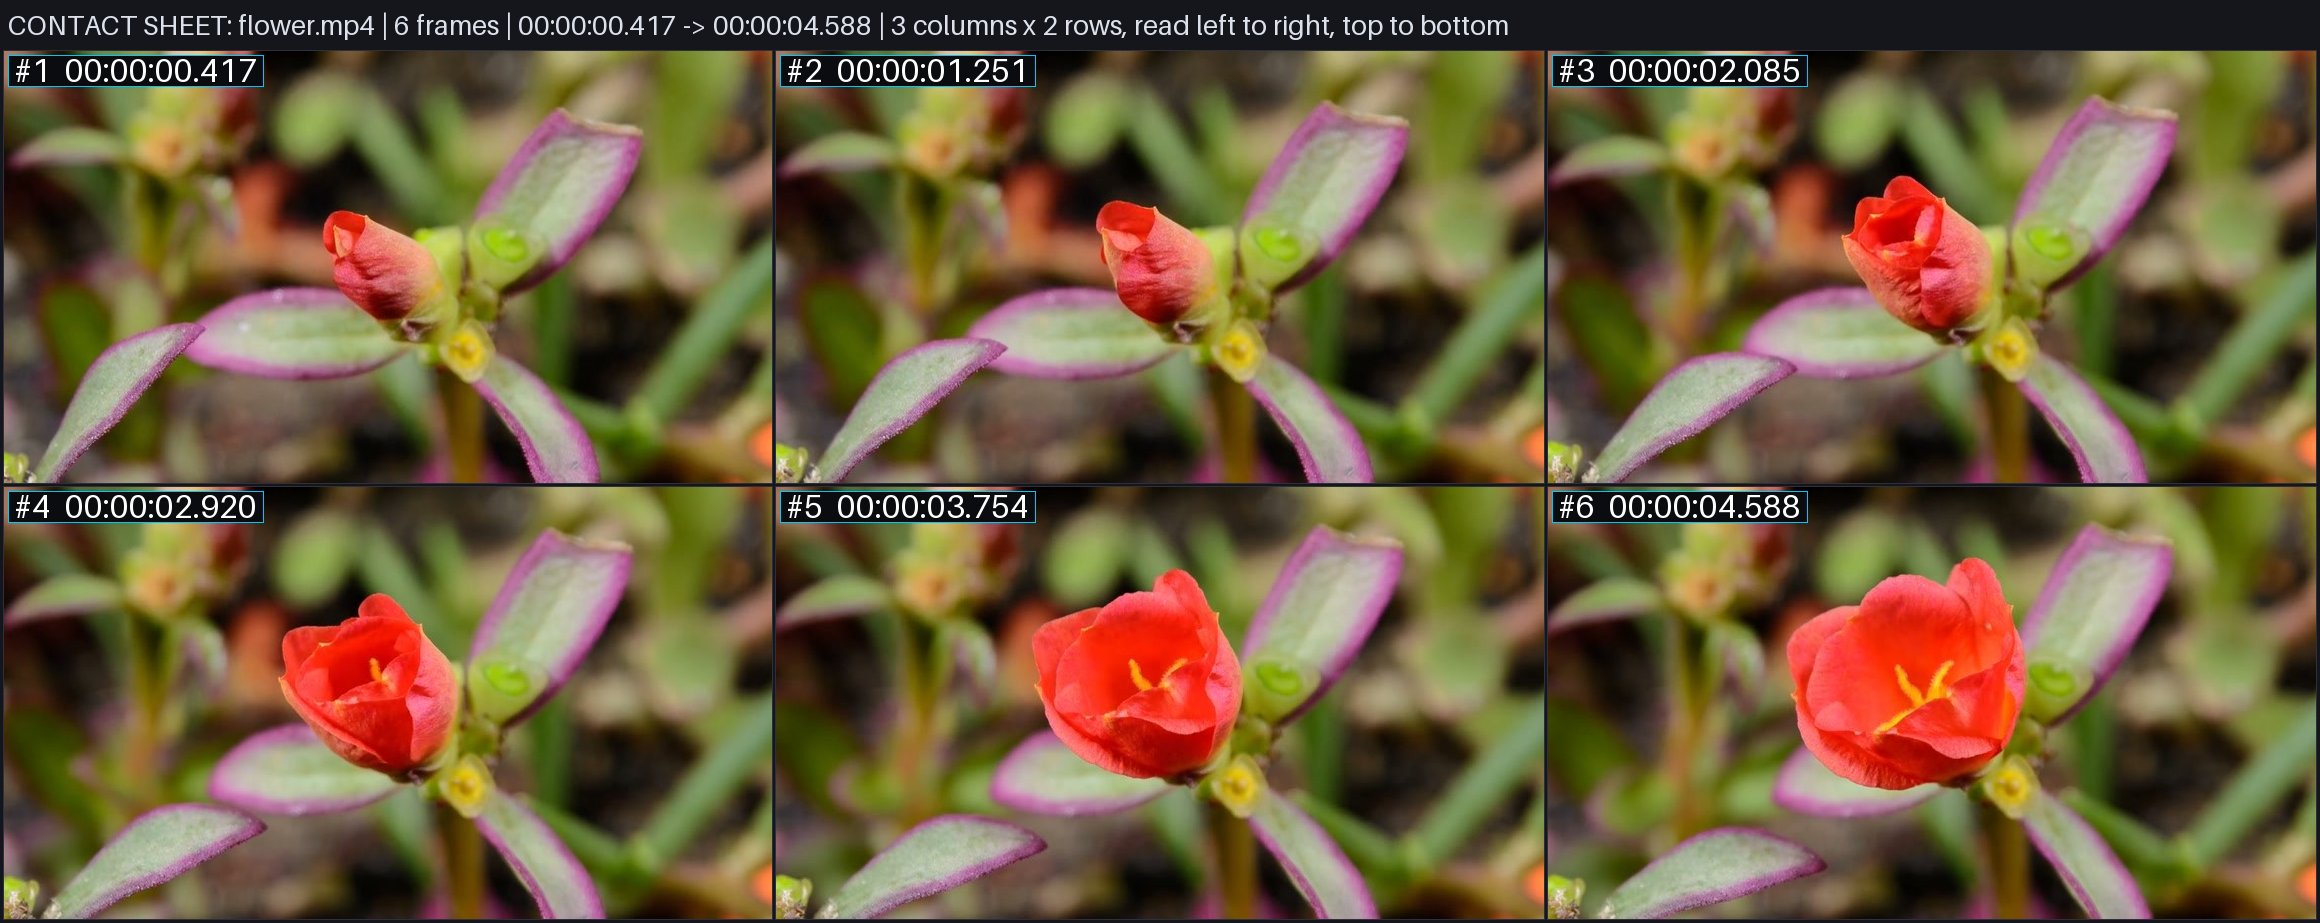
5 秒のクリップに対する contact_sheet の呼び出し 1 回で、時刻がそれぞれ記された 6 枚のフレームを、エージェントが読み取れる 1 枚の画像として作成します。
macOS なら 2 分で、エージェントがローカルの動画ファイルについて「この動画では何が起きていますか?」「X と言っているのはいつですか?」に回答できるようになります。動画の長さとサイズ、タイムスタンプ付きのコンタクトシート画像、カット、音量の概要、検索可能な音声データを取得できます。以下のオプションのクラウドツールを使う場合、またはシャドウ文字起こしの試験用スイッチ(デフォルトではオフで、オーナーのマシンのみ)を設定する場合を除き、データがマシンの外部に送信されることはありません。Claude Code のセットアップ:
brew install ffmpeg uv
git clone https://github.com/tlq5l/agentic-video.git && cd agentic-video
uv venv --python 3.12 .venv && uv pip install --python .venv/bin/python -r requirements.txt
claude mcp add -s user agentic-video -e PYTHONPATH="$PWD" -- "$PWD/.venv/bin/python" -m src.executor.mcp_server
Debian または Ubuntu では、1 行目の代わりに sudo apt-get install -y ffmpeg git と curl -LsSf https://astral.sh/uv/install.sh | sh を実行し、新しいシェルを開いて uv が PATH に含まれるようにします。
次に「Use agentic-video to review /path/to/video.mp4.」と入力します。その他のクライアントや詳細については、MCP サーバーを実行するを参照してください。
ステータス: 実験的です。作者は毎日使用していますが、サポートはベストエフォートです。issue やプルリクエストを歓迎しますが、返信には時間がかかる場合があります。
エージェントに提供する機能
MCP サーバーは25個のツールを公開します(完全なスキーマは src/adapters/mcp_schemas.json にあります)。
- 見る:
review_video(1回の呼び出しで全体を確認:メタデータ、コンタクトシート、カット、ほぼ黒い映像が続く区間、ラウドネスの概要)、probe_video(長さ、fps、サイズ、コーデック、音声)、contact_sheet、overview_chunks(長い動画全体にわたる連続したシート)、inspect_window/inspect_windows(短い範囲の詳細なフレーム。inspect_windowのread_textは各フレーム上のテキストも追加します)、frame_at(指定した時点のフレームを1枚、フルサイズで取得。小さな文字を読み取るために、必要に応じて切り抜いて拡大できます。read_text: trueを指定すると、読み取ったフレーム上のテキストも返します。macOS では Apple Vision を使用)、inspect_moments(指定した時点の前後のフレーム)、refine_temporal_beam(候補となる範囲を拡大して調べます)。 - 聞く:
transcribe(タイムスタンプ付きの音声文字起こし。キャッシュを使用します。文字起こしがキャッシュされていない動画ではバックグラウンドジョブが開始されるため、最初の呼び出しはstatus: in_progressとretry_after_secondsを返します。その秒数が経過したら、同じツールを再度呼び出してください)、search_transcript(言葉が話されている箇所を検索します。まず完全一致の言葉を探し、オプションのオンデバイス EmbeddingGemma 2 モデルが設定されている場合は、意味が一致する箇所も探します。モデルが設定されていない場合はキーワードのみで検索します)。 - 探す:
detect_cuts(ハードカットとアニメーションによるシーン変化)、check_frame_cadence(フレームが繰り返され、30 fps の映像を60 fpsに引き伸ばした場合のように、フレームレートより低い頻度で映像が更新される区間)、build_visual_index+search_visual(映像内に見えるものをローカルの CLIP で検索します。任意。最上位の一致を含む区間は、まず最適なフレームのみから始まり、最良スコアに近いスコアを持つ隣接フレームに限って最大8秒まで広がるため、8秒より短くなることがあります。静止フレームや複数の一致が結合された場合など、すでに8秒を超えている区間は全体が保持されるため、8秒より長くなり、スコアの低い一致が含まれることもあります)。watch_for(クラウド:画像についてのはい/いいえ形式の質問に答えられるようになるまで、サンプリングしたフレームを監視します)。 - 数える・追跡する:
count_occurrences(オブジェクトまたは画面上のテキストが個別に出現した回数。directionは、フレーム内を一方向に移動する出現を数え、動きを示すには短すぎる区間も含みます)、count_repetitions(繰り返される動作のサイクル数)、track_region_changes/track_region_events(固定した1つの矩形内の変化)。 - 音声と同期:
audio_onsets(min_gap_secより間隔が短い検出箇所を統合します。デフォルトは0.035秒です)、loudness_timeline、spectrogram_window、sync_check(カットと音の合図を、測定した音声と照合します。各合図はcandidate_onsets_countを返します。verbose: trueを指定すると、件数の代わりに各合図のcandidate_onsets全件を返します)。label_sounds(クラウド:音声区間内の音を識別します)。
Mac、Apple Vision、CLIP モデル付きの torch、または Cloudflare の認証情報が必要なツールと、それぞれの実行環境については、docs/capabilities.md を参照してください。エージェントは inspect_moments の時点を数値のみ、または {"time": 12.5} の形式で渡せます。また、region は [x, y, width, height] として渡せます。どちらの形式も、ドキュメントに記載された形式として読み取られます。docs/features/argument-shapes.md を参照してください。
レンダリング済み動画を確認するコマンドラインチェッカーもあります。python -m src.loop check <video> は同期、ラウドネス、オンセット、カット、および一部の映像の不具合を測定し、証拠画像とともに report.md を出力します。python -m src.loop cadence <video> は check_frame_cadence の結果を JSON として出力します。
AGENTS.md は、どのような場合にどのツールを使うかをエージェント向けに説明したガイドです。FEATURES.md では、各機能に対応するコードとテストを確認できます。
インストール(macOS または Linux)
FFmpeg、Git、uv が必要です。Apple silicon(macOS)および Debian 12(x86_64)で、Python 3.12 を使ってテストしています。
macOS(Homebrew):
brew install ffmpeg uv
git clone https://github.com/tlq5l/agentic-video.git
cd agentic-video
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -r requirements.txt pytest jsonschema
.venv/bin/python -m pytest -q   # optional: about 3 minutes
Debian または Ubuntu(apt と uv インストーラーを使用。uv を PATH に含めるには、uv の行を実行した後、新しいシェルを開いてください):
sudo apt-get install -y ffmpeg git
curl -LsSf https://astral.sh/uv/install.sh | sh
git clone https://github.com/tlq5l/agentic-video.git
cd agentic-video
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -r requirements.txt pytest jsonschema
.venv/bin/python -m pytest -q   # optional: about 3 minutes
テストの実行は任意です。
すべてのコミット前に lint を実行するには(uvx ruff check .、ruff.toml のコアルール)、クローンごとに一度、フックを有効にします:git config core.hooksPath .githooks。
macOS 専用の機能:
count_occurrencesの画面上のテキスト照合(text=)では、pyobjc を介して Apple Vision を使用します。- bench-v1 ハーネスでは
sandbox-execを使用し、一部のテストとジェネレーターではsayを使用します。必要なツールがないテストは、自動的にスキップされます。
コアツールは Linux で動作します。Debian 12(x86_64、ffmpeg 5.1)に 0.3.1 を新規インストールして実行したところ、プローブ、フレーム、音声テキスト変換のチェックに合格しました。他のディストリビューションや CPU ではテストしていません。
任意:より高速で高精度な音声認識(whisper.cpp turbo)
デフォルトでは、transcribe は CPU 上で faster-whisper を使用します(tiny、base、small。重みは初回使用時にダウンロードされます)。Apple silicon では、大規模な v3 turbo モデルを使う whisper.cpp のほうが大幅に高速かつ高精度です:
brew install whisper-cpp
mkdir -p ~/.cache/whisper.cpp
curl -L -o ~/.cache/whisper.cpp/ggml-large-v3-turbo-q5_0.bin \
  https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-large-v3-turbo-q5_0.bin
モデルを別の場所に保存する場合は、AGENTIC_VIDEO_WHISPER_CPP_MODEL を設定してください。インストールすると、turbo がデフォルトモデルになります。
任意:ビジュアル検索(CLIP)と画面上のテキスト
uv pip install --python .venv/bin/python -r requirements-visual.txt
.venv/bin/python -c 'from huggingface_hub import snapshot_download; snapshot_download(repo_id="openai/clip-vit-base-patch32", revision="3d74acf9a28c67741b2f4f2ea7635f0aaf6f0268", allow_patterns=["*.json", "*.txt", "pytorch_model.bin"])'
これにより、PyTorch、Transformers、および(macOS の場合)Apple Vision バインディングがインストールされ、約 605 MB の CLIP 重みがダウンロードされます。ビジュアル検索ではローカルファイルのみを読み込み、有料 API は呼び出しません。これらがない場合、search_visual と build_visual_index はセットアップ方法を説明するエラーを返します。
任意:クラウドツール(watch_for、label_sounds)
watch_for と label_sounds は、動画フレームまたは音声を Cloudflare Workers AI(Clef モデル)に送信します。これらは任意です。オフに設定されているシャドウ文字起こしの試験機能(下記の試験用スイッチを参照)を除き、他のツールが Cloudflare を呼び出すことはありません。非公開にしておく必要がある録画には使用しないでください。サーバーの環境変数に次の値を設定します:
CLOUDFLARE_ACCOUNT_ID:アカウント ID。CLOUDFLARE_API_TOKEN:Workers AI へのアクセス権を持つトークン。または、トークンを最後の行に出力するコマンドをAGENTIC_VIDEO_CF_TOKEN_COMMANDに設定します(例:wrangler auth token)。コマンドはプロセスごとに最大 50 分に一度だけ実行され、各デタッチされたシャドウ子プロセスは独自のトークンキャッシュを保持します。
設定しない場合、2 つのツールは不足しているものを示すメッセージとともに失敗し、データは何も送信されません。
試験用スイッチ(メンテナー専用):AGENTIC_VIDEO_SHADOW_CF_ASR にこのマシンのホスト名を設定すると、ローカルの文字起こしが新たに行われるたびに 音声が CLOUDFLARE に送信され、ログ内でローカルの結果と比較されます。ユーザーの文字起こし結果は変更されません。この変数にマシン名が指定されていない限り無効で、14 日後または 200 回の使用後に自動で停止します。詳細:docs/features/shadow-cf-asr.md。
任意:ハイブリッド文字起こし検索(macOS、EmbeddingGemma 2)
search_transcript は、まずキーワードの完全一致を返し、次に意味的に一致する文章を返します。意味検索には、EmbeddingGemma 2 Core ML モデルのフォルダーと、coremltools、tokenizers、numpy を備えたインタープリターが必要です。AGENTIC_VIDEO_EG2_DIR にモデルフォルダーを、AGENTIC_VIDEO_EG2_PYTHON にそのインタープリターを設定してから、サーバーを再起動してください。設定しない場合、このツールはキーワードの一致のみを返し、その理由を note に記載します。詳細:docs/features/transcribe.md。
MCP サーバーを実行する
サーバーは stdio を介して、1 行につき 1 つの JSON メッセージで MCP を通信します:
.venv/bin/python -m src.executor.mcp_server
MCP クライアント(Claude Code、Claude Desktop、Cursor など)に追加するには、venv の Python を使い、どのフォルダーからでもサーバーを起動できるようにリポジトリを PYTHONPATH に指定します:
{
  "mcpServers": {
    "agentic-video": {
      "command": "/absolute/path/to/agentic-video/.venv/bin/python",
      "args": ["-m", "src.executor.mcp_server"],
      "env": { "PYTHONPATH": "/absolute/path/to/agentic-video" }
    }
  }
}
ツールには動画の絶対パスを渡してください。結果は ~/.cache/agentic-video にキャッシュされます(AGENTIC_VIDEO_CACHE_DIR で変更できます)。
Claude Code に追加する(1 コマンド)
クローンしたフォルダーからこれを実行します(現在のフォルダーのパスが使われます)。-s user を指定すると、このフォルダーだけでなく、すべてのプロジェクトでツールを利用できます。
claude mcp add -s user agentic-video -e PYTHONPATH="$PWD" -- "$PWD/.venv/bin/python" -m src.executor.mcp_server
デフォルトでは、結果は Claude Code で扱いやすいサイズに収まります。画像はファイルとして保存され、結果にはその file_path が含まれます(エージェントがファイルを開きます)。frame_at と spectrogram_window は PNG を書き出し、コンタクトシートとフレームグリッド(contact_sheet、review_video、overview_chunks、inspect_window、inspect_windows、inspect_moments)は JPEG を書き出します。また、長い transcribe の結果には、トランスクリプトの最初の部分と、残りの内容を含む transcript_path ファイルがリストされます。結果から画像をレンダリングするクライアントでは、-e AGENTIC_VIDEO_INLINE_IMAGES=1 を追加できます。その場合、結果には base64 画像が含まれ、サイズが 1 MB に達することがあります。変更点:以前のバージョンでは、デフォルトで base64 画像が含まれていました。これに依存していた場合は、AGENTIC_VIDEO_INLINE_IMAGES=1 を設定すると元に戻せます。
エージェントに使い方を伝える(AGENTS.md または CLAUDE.md に貼り付け)
エージェントがツールを見つけることを期待するより、常に読み込まれるメモを用意するほうが効果的です。
## Video files (agentic-video MCP)
You cannot watch video. For any .mp4/.mov/.webm question, use the agentic-video MCP tools; never guess from the filename.
- First look: `review_video` with an absolute path. It returns metadata, a contact sheet, cuts, near-black stretches and loudness. Open the JPEG at `file_path` to see the frames.
- Spoken words: `search_transcript` (when is X said) or `transcribe`. Do this before looking at frames.
- A short range: `inspect_window` (start_sec, end_sec). Counting: `count_occurrences`. Sync and audio faults: `sync_check`, `loudness_timeline`.
- Sampling can miss brief events and a missing hit is not proof. Quote the burned-in timestamps. Full guide: AGENTS.md in the agentic-video repo.
5 行の例
リポジトリのフォルダーから実行します。ハンドシェイク、動画のメタデータ、6 フレームのコンタクトシートを取得します(JPEG のパスは file_path にあります)。
printf '%s\n' \
  '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{}}' \
  '{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"probe_video","arguments":{"source":"fixtures/reference_videos/flower.mp4"}}}' \
  '{"jsonrpc":"2.0","id":3,"method":"tools/call","params":{"name":"contact_sheet","arguments":{"source":"fixtures/reference_videos/flower.mp4","samples":6,"cols":3}}}' \
  | .venv/bin/python -m src.executor.mcp_server
Python でも同じことができます。
from src.retrieval.engine import AgenticVideoEngine

engine = AgenticVideoEngine("fixtures/reference_videos/flower.mp4")
print(engine.metadata.duration_sec)                  # 5.005
print(engine.overview(samples=6, cols=3).file_path)  # contact sheet JPEG
これまでの結果
以下は作者自身による小規模なテストであり、独立したベンチマークではありません。生の実行結果はこのリポジトリには含まれていません。
- 仕込んだ不具合: 20 個の不具合を意図的に仕込んだプロモーション動画で、チェッカー(
python -m src.loop check)は 20 個中 14 個を見つけ、誤検知は 2 件でした。エージェント型動画モードの Gemini は 20 個中 4 個を見つけました。 - bench-v1(
benchmarks/bench_v1): 作者による小規模なベンチマークでは、これらのツールを使った Claude は、カウント、場面の発見、長尺動画の検索で Gemini のエージェント型動画モードを上回りました。 - LVBench(公開されている長尺動画ベンチマーク): スコアは約 86% でした。Gemini の公開スコアは 88.6% であり、ここでは Gemini を上回っていません。
動画理解全般において Gemini を上回るものではありません。
制限事項
- 画像はファイルとして返されます。 画像ツールは MCP の画像コンテンツブロックではなく
file_pathを返します。structuredContent内の base64 コピーはデフォルトで無効です(含めるにはAGENTIC_VIDEO_INLINE_IMAGES=1を設定します)。多くのクライアントはエージェントに JSON テキストしか表示しないため、エージェントは自身でfile_pathの画像を開く必要があります(たとえば、ファイル読み取りツールを使います)。 - サンプリングで見逃すことがあります。 コンタクトシートと視覚検索では、サンプリングしたフレームを確認します。サンプル間にある短い出来事は見逃す可能性があり、該当箇所が見つからなくても存在しないとは限りません。視覚検索は CPU で CLIP を実行するため、長い動画では時間がかかります。
- トランスクリプトに存在しないセリフが含まれることがあります。 Whisper(特に turbo)は、音楽や無音部分でセリフを捏造することがあります。同じセリフが 3 回以上連続して繰り返される場合は
suspectとしてフラグ付けされますが、1 回だけの捏造はフラグ付けされません。 - カットを見逃すことがあります。 似た画像間のハードカットが 0.25 のしきい値を下回る場合、見逃されることがあります。
- カウントと同期にはヒューリスティックを使用しており、 作者の動画に合わせて調整されています。出力は確定的な事実ではなく、確認すべき証拠として扱ってください。
- 修正ループには追加のツールが必要です。
python -m src.loop runは Codex CLI を修正ツールとして呼び出します(デフォルトのモデルラダーはsrc/loop.pyにあります)。オプションの--judge jevには、環境内のTYPESAFE_API_KEYまたはOPENROUTER_API_KEYが必要です。 - bench-v1 の実行にはアカウントが必要です。 Codex CLI、環境内の
GEMINI_API_KEY、Node.js、および macOS のsandbox-execが必要です。詳しくはbenchmarks/bench_v1/README.mdを参照してください。 - 安定した API はありません。 ツール名と出力はコミット間で変更される場合があります。
リポジトリの構成
src/:ライブラリ(media/、transcript/、retrieval/、core/)、MCP サーバー(executor/mcp_server.py)、チェッカー(loop.py)、ツールスキーマ(adapters/)。tests/:pytest テストスイート。evals/adversarial_runner.pyには、tests/test_adversarial_failures.pyで実行する障害注入チェックが含まれています。benchmarks/bench_v1/:3者によるブラインドベンチマークのハーネス。データと解答はリポジトリの外部にあります。benchmarks/dev/count_dev/:カウントツール用の小規模な開発用データセット。scripts/generate_synthetic_benchmark.py:合成フィクスチャ動画を再生成します。fixtures/:小規模なテスト動画(メディアクレジットを参照)。docs/:アーキテクチャに関するメモと機能ごとのページ。
メディアクレジット
fixtures/reference_videos/sample_10s.mp4:Big Buck Bunny(Sunflower版)の10秒間の抜粋(音声なし)。(c)2008 Blender Foundation、www.bigbuckbunny.org / peach.blender.org;Sunflower版はJanus Bager Kristensenによるもの、2013年(bbb3d.renderfarming.net)。Creative Commons 表示 3.0のライセンスに基づいています。fixtures/reference_videos/flower.mp4:MDN Web Docsのサンプル動画。CC0(パブリックドメイン)のもとで公開されています。fixtures/synthetic_bench_60s.mp4と.srt、.vtt、fixtures/synthetic_ground_truth.json:このリポジトリのscripts/generate_synthetic_benchmark.pyによって生成されています。コードと同じライセンスです。
ライセンス
MIT。LICENSEを参照してください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。