Vidlizer について
Vidlizerは、動画・画像・PDFを解析し、映像と音声をシーンごとの構造化データにまとめるコマンドラインツールです。ローカルのビジョンモデルまたはOpenRouterに対応し、複数の出力形式とMCPツールを備えています。
主な機能
- 01動画・画像・PDF・URLの解析
- 02シーン単位の構造化JSON生成
- 03ローカルモデルとOpenRouterに対応
- 04音声を文字起こしして各シーンに統合
- 05JSON・Markdown・テキスト出力
活用シーン
- 01動画内のシーン・人物・テキストの整理
- 02PDFや画像から視覚情報を抽出
- 03動画の指定した時間範囲を分析
MCP 対応
analyze_videoツールを含むMCPサーバーを提供し、Claude Code、Cursor、Claude DesktopなどのMCPクライアントから利用できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
vidlizer
動画、画像、PDFを指定するだけで、シーンごとの構造化JSONを取得できます。


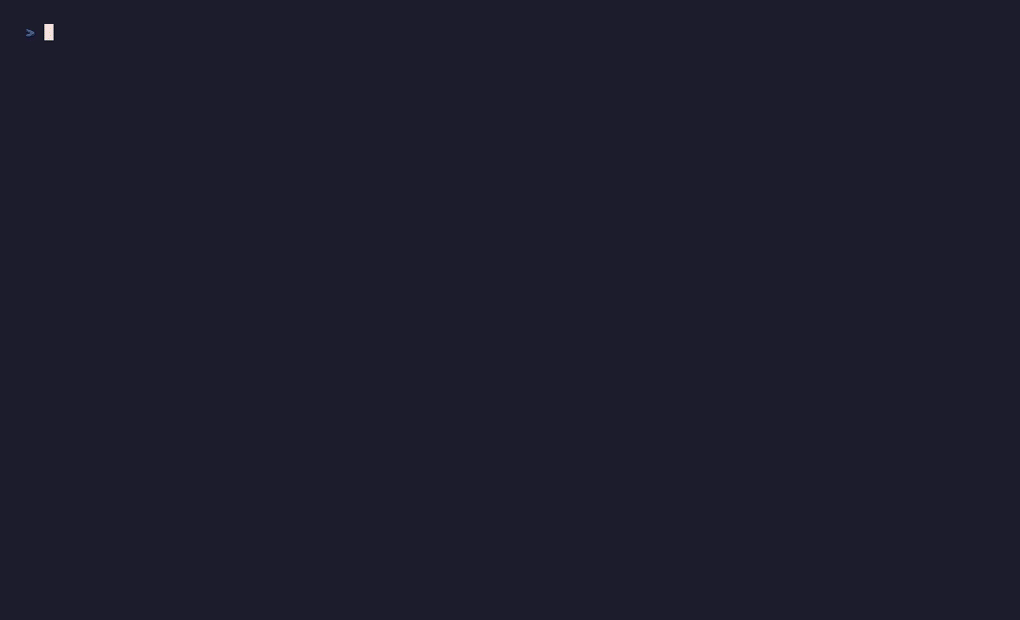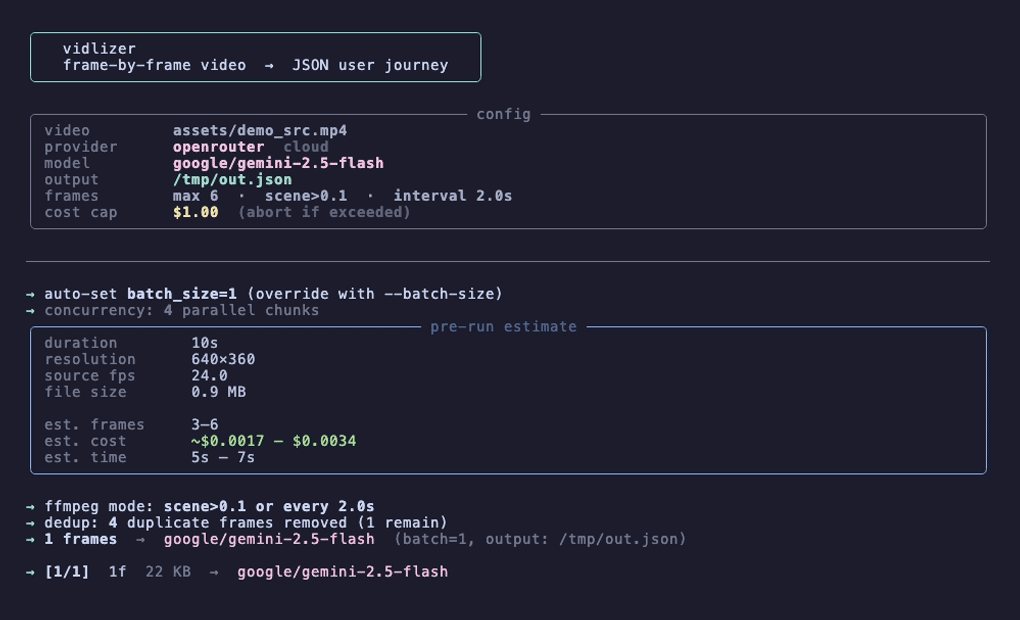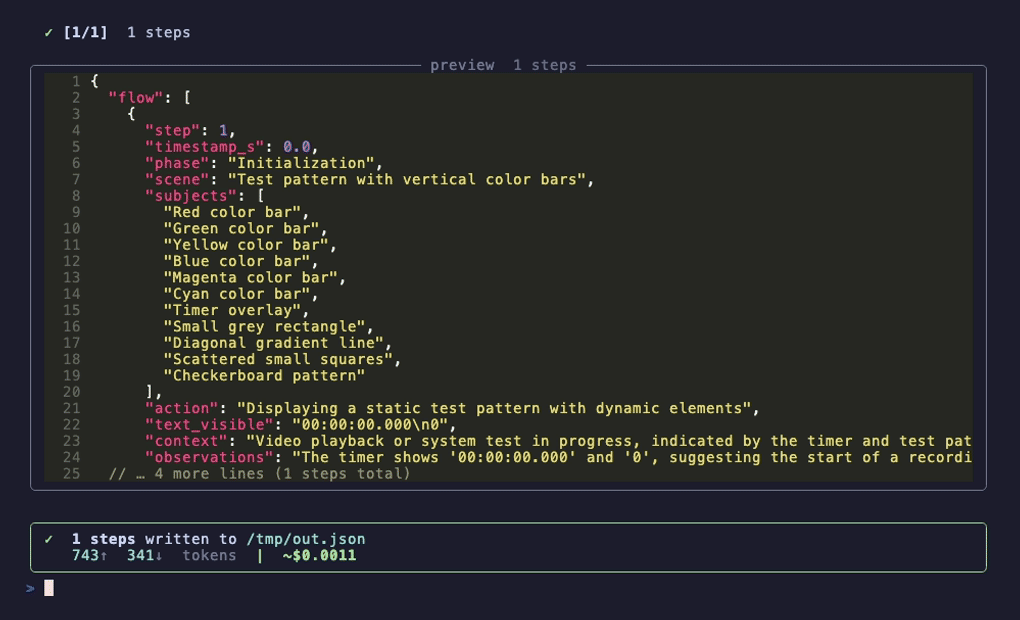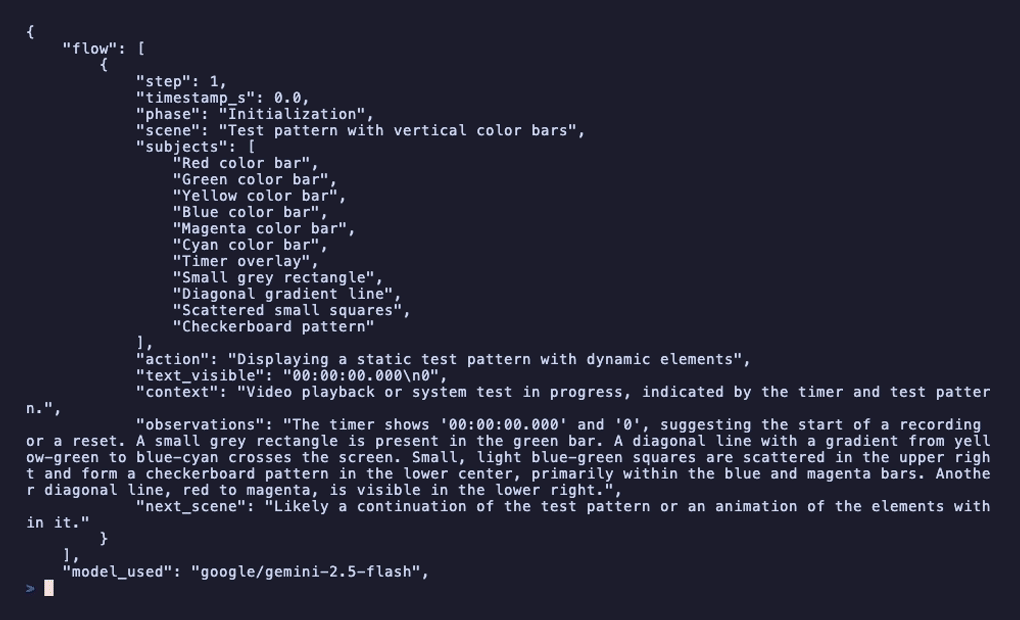
vidlizerはffmpegを使ってあらゆる動画、画像、PDFからフレームを抽出し、ビジョンLLMに送信して、シーンごとに1つのエントリーを含むflow配列を返します。各エントリーには、何が起きたか、誰が画面に映っていたか、どのようなテキストが表示されていたか、何が変化したかが記録されます。動画に音声が含まれている場合は、Apple MLX Whisperで文字起こしし、その発話内容を各ステップに統合します。
OllamaまたはOpenAI互換サーバー(LM Studio、vLLM、oMLX)を使って完全にローカルで実行できます。APIキーは不要で、データがマシンの外に送信されることもありません。または、クラウドモデルを利用するにはOpenRouterに接続できます。vidlizer setupを実行すると、インストール済みのものを検出し、1分以内に設定を書き込みます。
vidlizer demo.mp4
vidlizer "https://youtube.com/watch?v=..."
vidlizer screenshot.png
vidlizer document.pdf
✨ 特長
- あらゆる入力に対応 — ローカル動画、画像(jpg/png/webp/…)、PDF、URL(YouTube、Loom、Vimeo、Twitter)
- 4つのプロバイダー — Ollama(完全オフライン)、LM Studio(ポート1234)、oMLX(Apple Silicon、ポート8000)、OpenRouter(クラウド)。この順に自動検出します
- プロバイダー間のフォールバック — メインモデルに問題が発生すると、プロバイダーを自動で切り替えます(例:oMLX → OpenRouter)
- JSON修復 — 不正なモデル出力をスキップする前にモデルへ再送信して修正し、不完全なJSONからも復元します
- 無料モデルのガード —
:freeのOpenRouterモデルでは、レート制限を超えないようconcurrency=1を自動的に強制します - 3つの出力形式 —
--format json(デフォルト)、summary(フェーズごとのプレーンテキスト)、markdown(ステップごとのセクション形式のドキュメント) - 使用状況の追跡 —
--statsで、すべての実行におけるモデルごとのトークン数とコストの内訳を表示します。MCPツールget_usage_stats()も利用できます - 自動文字起こし — 音声を検出し、Apple MLX Whisper(Neural Engine)で文字起こしして、発話内容を各flowステップに統合します
- 知覚的重複排除 — 送信前に類似したフレームを削除します(トークンを節約)
- analyze_moment —
--start/--endフラグで時間範囲を指定して解析します - メモリ内キャッシュ — 同じファイルを再実行する場合、API呼び出しをスキップします
- コストガード — 支出が
MAX_COST_USD(デフォルトは$1.00)を超えると処理を中止します - リアルタイムの進捗表示 — Richのストリーミングインジケーターで、バッチごとの経過時間とトークン数を表示します
- MCP サーバー — Claude Code、Cursor、Claude Desktopから利用できます。プロバイダーとモデルは環境変数で固定でき、結果には
model_usedとprovider_usedが含まれます - 自動インストール —
ffmpegが見つからない場合はbrewでインストールし、mlx-whisperはデフォルトのインストールに同梱されています(macOS) doctor --fix— インタラクティブな修復ウィザードです。Homebrew経由で不足しているffmpeg/Ollama/LM Studioをインストールし、.env用にvidlizer setupを再実行して、mlx-whisperをアップグレードしますmcp-setup— 1コマンドで完了するMCP設定ウィザードです。vidlizer-mcpを検出し、.envを読み込み、エディターの設定を書き込むか、claude mcp add-jsonのワンライナーを表示します- Macネイティブ — ファイル選択ダイアログ、Apple MLXによる文字起こしに対応し、macOSのUnicodeファイル名(例:「11:26 AM」)を処理します
📦 必要条件
- macOS(文字起こしを高速化するには Apple Silicon を推奨)
- Python 3.10+
- Ollama モード:Ollama がインストール済みで、ビジョンモデルをダウンロード済み(RAM 5 GB 以上)
- LM Studio モード:ビジョンモデルを読み込み済みの LM Studio 0.3.16+
- クラウドモード:OpenRouter API キー
ffmpeg が見つからない場合は、初回実行時に Homebrew で自動的にインストールされます。
🚀 インストール
オプション 1 — uvx(インストール不要で直接実行)
uvx vidlizer setup
オプション 2 — pipx(環境を分離してグローバルに利用可能)
pipx install vidlizer
vidlizer setup    # interactive wizard: detects providers, writes .env
オプション 3 — pip / virtualenv
pip install vidlizer
vidlizer setup
オプション 4 — ソースから
git clone https://github.com/arizawan/vidlizer.git
cd vidlizer
python -m venv .venv && source .venv/bin/activate
pip install -e .
vidlizer setup    # or: cp env.sample .env
初回セットアップウィザード
vidlizer setup はインストール済みのプロバイダーをすべて検出し、プライマリとフォールバックを選択できるようにして、.env を書き込みます。また、Ollama にモデルがインストールされていない場合は、ビジョンモデルのダウンロードも提案します。
$ vidlizer setup
  Detected providers:
    1.  Ollama        → qwen2.5vl:3b
    2.  OpenRouter    → google/gemma-3-27b-it:free

  Primary provider (1–2): 1
  Fallback (1–1, Enter to skip): 2

✓  .env written → /your/project/.env
ヘルスチェック
vidlizer doctor          # shows ffmpeg, .env, provider, mlx-whisper status
vidlizer doctor --fix    # interactive repair: brew-installs ffmpeg/Ollama/LM Studio, re-runs setup
プロバイダーの手動セットアップ
Ollama(完全オフライン、API キー不要):
# Install Ollama from https://ollama.com, then:
ollama pull qwen2.5vl:3b   # ~3.2 GB, requires 5 GB+ RAM (recommended)
ollama pull qwen2.5vl:7b   # ~6.0 GB, requires 10 GB+ RAM (best quality)
LM Studio(GPU で高速化されたローカル推論):
# In LM Studio: load a vision model (e.g. Qwen2.5-VL 7B), enable the local server
# Set PROVIDER=openai and OPENAI_BASE_URL=http://localhost:1234/v1 in .env
OpenRouter(クラウド):
# Paste your OpenRouter key in .env:
# OPENROUTER_API_KEY=sk-or-v1-...
⚡ クイックスタート
# Ollama — fully local, no API key
vidlizer demo.mp4 --provider ollama --model qwen2.5vl:3b

# LM Studio (or any OpenAI-compat server)
vidlizer demo.mp4 --provider openai --model qwen/qwen2.5-vl-7b-instruct

# OpenRouter (cloud)
vidlizer demo.mp4 --provider openrouter --model google/gemini-2.5-flash

# Analyze a YouTube video
vidlizer "https://www.youtube.com/watch?v=dQw4w9WgXcQ"

# Analyze a single image or PDF
vidlizer screenshot.png
vidlizer report.pdf

# Focus on a time range
vidlizer demo.mp4 --start 30 --end 90

# Output as Markdown or plain-text summary
vidlizer demo.mp4 --format markdown -o result.md
vidlizer demo.mp4 --format summary -o result.txt
引数なしで実行すると、対話型のファイル選択画面とプロバイダー/モデル選択画面が表示されます。
📄 出力
--format で 3 種類の形式を指定できます。
| 形式 | フラグ | デフォルトの拡張子 | 説明 |
|---|---|---|---|
| JSON | --format json | .analysis.json | 構造化されたフロー配列全体(デフォルト) |
| Markdown | --format markdown | .analysis.md | シーン/アクション/発話ごとにセクションを分けたドキュメント |
| 要約 | --format summary | .analysis.txt | フェーズごとにまとめたプレーンテキスト |
デフォルトの出力先は <normalized-name>.analysis.json(または対応する拡張子)です。-o path を指定することもできます。
{
  "flow": [
    {
      "step": 1,
      "timestamp_s": 0.0,
      "phase": "Introduction",
      "scene": "Title card with product logo on dark background.",
      "subjects": ["Logo", "Text overlay"],
      "action": "Static title card displayed.",
      "text_visible": "vidlizer — analyze any video",
      "context": "Opening of a product demo.",
      "observations": "Clean minimal design.",
      "next_scene": "Screen recording of the CLI.",
      "speech": "Welcome to the vidlizer demo."
    }
  ],
  "transcript": [
    { "start": 0.0, "end": 2.4, "text": "Welcome to the vidlizer demo." }
  ],
  "model_used": "gemma-4-E2B-it-MLX-4bit",
  "provider_used": "openai"
}
model_used と provider_used には、フォールバック後も含め、実際に結果を生成したモデルが反映されます。MCP の analyze_video レスポンスに表示されるため、エージェントはどのプロバイダーが実行されたかを確認できます。
フローステップのフィールド
| フィールド | 説明 |
|---|---|
step | 連番の整数 |
timestamp_s | おおよその時間(秒)(フレームラベルから取得) |
phase | 論理的なセクション — Introduction、Demo、Action、Conclusion… |
scene | 現在表示されている内容 |
subjects | 登場する主要な人物、物体、UI 要素 |
action | 起きていること — 操作、動き、ナレーション、イベント |
text_visible | 画面上で読み取れるすべてのテキスト |
context | 継続的な状態 — タイマー、スコア、トピック、ブランド… |
observations | エラー、異常、感情、重要な事実 |
next_scene | 次に続く内容の簡潔な説明 |
speech | このステップ中に話された発話の文字起こしテキスト(音声付き動画のみ) |
🤖 モデル
すべてのプロバイダーは、コンテキスト長に制限のあるモデルとの互換性を最大限に高めるため、リクエストごとにフレームを 1 枚ずつ送信します(batch_size=1)。思考モードの出力(<think> タグ)は自動的に除去されます。
ローカル — Ollama
完全オフラインで、API キーは不要です。ollama pull <name> でインストールできます。
| モデル | ディスク | RAM | 備考 |
|---|---|---|---|
qwen2.5vl:3b ★ | 3.2 GB | 約 5 GB | 推奨 — 128K ctx、JSON に強く、複数画像に対応 |
qwen2.5vl:7b ★ | 6.0 GB | 約 9 GB | Ollama で最高品質 — 128K ctx、RAM 10 GB 以上が必要 |
minicpm-v:8b | 5.5 GB | 約 8 GB | OCR と視覚的推論に強く、32K ctx |
llava-onevision:7b | 5.5 GB | 約 8 GB | 複数画像と動画フレームに強く、JSON の信頼性が高い |
フォールバック順(設定したモデルを利用できない場合):qwen2.5vl:7b → qwen2.5vl:3b → minicpm-v:8b → llava-onevision:7b → llava:13b → llava:7b
Ollama のネイティブな /api/chat を format: json とともに使用し、信頼性の高い構造化出力を実現します。
ローカル — LM Studio / oMLX / vLLM / LocalAI(OpenAI 互換)
OpenAI 互換サーバーを使用した GPU アクセラレーション推論です。PROVIDER=openai を設定し、OPENAI_BASE_URL をサーバーの URL に指定します。
| モデル | VRAM | 備考 |
|---|---|---|
qwen/qwen2.5-vl-7b-instruct ★ | 約 8 GB | 推奨 — 128K コンテキスト、信頼性の高い JSON、複数画像に対応 |
qwen/qwen3-vl-8b ★ | 約 10 GB | 最新の Qwen ビジョンモデル — 思考タグは自動的に除去されます |
qwen/qwen2.5-vl-3b-instruct | 約 5 GB | 軽量 — 高速、VRAM は 5~6 GB |
google/gemma-4-e4b-it | 約 6 GB | Google MoE — LM Studio 0.3.16 以降でネイティブサポート |
google/gemma-4-9b-it | 約 10 GB | より高性能な Gemma 4 — 128K コンテキスト、指示への追従性が向上 |
zai-org/glm-4.6v-flash | 約 8 GB | ZhipuAI MoE — 128K コンテキスト、強力な JSON 対応、低レイテンシ |
openbmb/minicpm-v-4.5 | 約 8 GB | Qwen3 ベースの 8B モデル — 強力な OCR、複数画像に対応、vLLM 対応 |
oMLX(Apple Silicon ネイティブ、omlx.ai)— HuggingFace の MLX 形式モデルに対応し、ポート 8000 で自動検出されます(LM Studio とは別です)。モデル ID は HuggingFace のパスです。
| oMLX モデル | ユニファイドメモリ | 備考 |
|---|---|---|
mlx-community/Qwen2.5-VL-7B-Instruct-8bit ★ | 約 8 GB | Apple Silicon で最適 — 高速、強力な JSON 対応 |
mlx-community/Qwen2.5-VL-3B-Instruct-8bit | 約 4 GB | 軽量 — RAM は 4~5 GB |
mlx-community/Qwen3-VL-8B-8bit | 約 9 GB | 最新の Qwen ビジョンモデル — 思考タグは除去されます |
mlx-community/MiniCPM-V-2_6-8bit | 約 8 GB | 強力な OCR と推論 |
モデル ID は、LM Studio のモデルブラウザー、oMLX の管理パネル、または vLLM の設定に表示されているものを使用します。LM Studio / oMLX は一度に 1 つのモデルを提供するため、フォールバックは不要です。複数のモデルを読み込んだ vLLM では、同じフォールバック順序が使用されます。
フォールバックの順序(複数のモデルを読み込んだ vLLM / oMLX):qwen2.5-vl-7b → qwen2.5-vl-3b → qwen3-vl → gemma-4 → glm-4 → minicpm-v → llava-onevision → llava
クラウド — OpenRouter
モデルと現在の料金をライブで取得します。vidlizer --list-models を実行すると、最新の一覧を確認できます。
| モデル | 入力 / 100 万トークン | 備考 |
|---|---|---|
google/gemini-2.5-flash ★ | $0.15 | 推奨 — 100 万コンテキスト、高速、高精度 |
google/gemini-2.5-flash-lite | $0.075 | より低価格 — 精度はやや劣ります |
google/gemini-2.5-pro | $1.25 | 最高品質、料金は高め |
openai/gpt-4o | $2.50 | OpenAI のフラッグシップモデル |
openai/gpt-4o-mini | $0.15 | OpenAI の低価格モデル |
nvidia/nemotron-nano-12b-v2-vl:free | 無料 ⚡ | レート制限あり(1 リクエストあたり 8K)、128K コンテキスト |
google/gemma-4-31b-it:free | 無料 ⚡ | レート制限あり、128K コンテキスト |
無料モデルでエラーが発生すると、利用可能な最安の有料モデルに自動的にフォールバックします。
🎙️ 文字起こし
音声トラックがある動画では、vidlizer が自動的に次の処理を行います。
- ffmpeg でモノラル 16kHz の WAV を抽出します
- Apple MLX Whisper(M シリーズの Neural Engine と GPU)で文字起こしします
- 各文字起こしセグメントを、最も近いフローステップに
speechとして結合します
macOS のデフォルトインストールには mlx-whisper が含まれています。基本の Whisper モデル(約 150 MB)は、初回の文字起こし時にダウンロードされます。
無効にするには:--no-transcript
🛠️ CLI リファレンス
サブコマンド
vidlizer setup              # interactive wizard: detects providers, writes .env
vidlizer doctor             # health check: ffmpeg, .env, providers, mlx-whisper
vidlizer doctor --fix       # auto-repair: brew-installs missing deps, re-runs setup
vidlizer mcp-setup          # generate MCP config for Claude Code / Cursor / Claude Desktop
分析オプション
vidlizer [video] [options]

positional:
  video                 Path to file or URL (YouTube/Loom/Vimeo/Twitter)

options:
  -o, --output PATH     Output path (default: <name>.analysis.json/.md/.txt)
  --format FORMAT       Output format: json (default), summary, markdown
  --provider PROVIDER   ollama | openai | openrouter  (openai covers LM Studio + oMLX + vLLM)
  --model MODEL         Model slug — Ollama name, OpenAI-compat ID, or OpenRouter slug
  --max-frames N        Max frames to send (default 60, hard cap 200)
  --start SECONDS       Analyze from this timestamp
  --end SECONDS         Analyze up to this timestamp
  --scene THRESHOLD     Scene-change sensitivity 0–1 (default 0.1)
  --min-interval SECS   Minimum seconds between frames (default 2)
  --fps FPS             Extract at fixed FPS instead of scene-change
  --scale PX            Frame width in pixels (default 512)
  --batch-size N        Frames per API call (0 = auto, default 1 for all providers)
  --concurrency N       Parallel batch workers (default: 4 for OpenRouter, 1 for local)
  --dedup-threshold N   Perceptual dedup Hamming distance (default 8, 0 = off)
  --no-transcript       Skip audio transcription
  --max-cost USD        Abort if spend exceeds this (default 1.00)
  --timeout SECS        Per-request timeout (default 600)
  -v, --verbose         Debug output
  --stats               Show token + cost usage stats by model, then exit
  --clear-stats         Reset usage log, then exit
🔧 環境変数
env.sample を .env にコピーします。
# ── Provider ────────────────────────────────────────────────────────────────
# ollama    — local Ollama server (no API key, no cost)
# openai    — any OpenAI-compatible server (LM Studio, oMLX, vLLM, LocalAI, real OpenAI)
# openrouter — cloud inference via OpenRouter
PROVIDER=ollama

# ── Ollama (local, no API key) ──────────────────────────────────────────────
OLLAMA_HOST=http://localhost:11434
OLLAMA_MODEL=qwen2.5vl:3b

# ── OpenAI-compatible (LM Studio, oMLX, vLLM, LocalAI, real OpenAI) ─────────
#   LM Studio default port: 1234  |  oMLX default port: 8000  |  vLLM: 8000
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_API_KEY=lm-studio        # "not-needed" for oMLX/vLLM, real key for OpenAI
OPENAI_MODEL=                   # exact model ID as shown in server (required)

# ── OpenRouter (cloud) ──────────────────────────────────────────────────────
OPENROUTER_API_KEY=sk-or-v1-...
OPENROUTER_MODEL=google/gemini-2.5-flash

# ── Frame extraction ────────────────────────────────────────────────────────
SCENE_THRESHOLD=0.1     # lower = more frames
MIN_INTERVAL=2          # seconds between forced frames
MAX_FRAMES=60
FRAME_WIDTH=512
MAX_COST_USD=1.00
BATCH_SIZE=0            # 0 = auto (defaults to 1 per request for all providers)
REQUEST_TIMEOUT=600

# ── Fallback ────────────────────────────────────────────────────────────────
# Same-provider fallback: set FALLBACK_MODEL only.
#   Blank = auto-detect installed models (Ollama) or available models (OpenAI-compat).
# Cross-provider fallback: set FALLBACK_PROVIDER + FALLBACK_MODEL.
#   FALLBACK_BASE_URL and FALLBACK_API_KEY default to the primary provider's values
#   if not set — override only when the fallback uses a different server/key.
FALLBACK_PROVIDER=      # ollama | openai | openrouter  (blank = same as PROVIDER)
FALLBACK_MODEL=         # model ID for fallback  (blank = auto-detect same-provider)
FALLBACK_BASE_URL=      # base URL for fallback openai/ollama server (optional)
FALLBACK_API_KEY=       # API key for fallback provider (optional)
📊 使用状況の追跡
実行が正常に完了するたびに、~/.cache/vidlizer/usage.jsonl に記録が追加されます。テスト実行(pytest)は除外されます。
vidlizer --stats          # print per-model breakdown
vidlizer --clear-stats    # reset log
出力例:
Usage statistics  (/Users/you/.cache/vidlizer/usage.jsonl)

  Total runs:       12
  Total tokens in:  58,240
  Total tokens out: 6,102
  Total cost:       ~$0.0312
  Total steps:      94

  Model                               Provider     Runs   Tokens in  Tokens out  Cost USD
  gemma-4-E2B-it-MLX-4bit             openai          9      45,800       4,900      free
  google/gemini-2.5-flash             openrouter       3      12,440       1,202  ~$0.0312
MCP ツールとしても利用できます:get_usage_stats() → 同じデータを JSON 形式で返します。clear_usage_stats() でログをリセットします。
🔌 MCP サーバー
MCP 対応のエージェント(Claude Code、Cursor、Claude Desktop、Gemini CLI)から vidlizer を使用できます。
**モデルとプロバイダーは環境変数で設定され、AI エージェントから変更することはできません。**これにより、エージェントがセッション中に予期しないモデルや高額なモデルへ切り替えるのを防ぎます。
インストール
# uvx (no install — run directly)
uvx "vidlizer[mcp]" vidlizer-mcp

# pipx (isolated, globally available)
pipx install "vidlizer[mcp]"

# If vidlizer is already installed via pipx — inject mcp into the same venv
pipx inject vidlizer mcp

# pip / virtualenv
pip install "vidlizer[mcp]"
vidlizer-mcp は自動的に PATH に追加されます。which vidlizer-mcp を実行して確認してください。
pipx に関する注意:
pipx install vidlizerを実行するとvidlizer-mcpのエントリーポイントが作成されますが、mcpパッケージはインストールされません。pipx inject vidlizer mcpを実行して追加するか、最初からpipx install "vidlizer[mcp]"を使用してください。
1 コマンドで MCP をセットアップ
vidlizer mcp-setup
対話型ウィザードです。vidlizer-mcp を検出し、.env を読み込み、設定をエディターの設定ファイルに書き込むか、コピーして貼り付ける 1 行のコマンドを表示します。Claude Code、Cursor、Claude Desktop、Windsurf に対応しています。
手動で設定
クイックスタート — uvx(インストール不要)
pip install や pipx は不要です。uvx が vidlizer をダウンロードして、その場で実行します。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "uvx",
      "args": ["--from", "vidlizer[mcp]", "vidlizer-mcp"],
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
env ブロックは任意のプロバイダー(OpenRouter、LM Studio、oMLX)に置き換えられます。command/args はそのままです。
バイナリの絶対パスを使用してください。which vidlizer-mcp で確認できます。以下の設定はすべて JSON を使用します(Claude Code、Cursor、Claude Desktop、Gemini CLI で動作します)。
CLI 経由で Claude Code を使用する場合:
claude mcp add-json vidlizer '{"type":"stdio","command":"/path/to/vidlizer-mcp","env":{"PROVIDER":"openrouter","OPENROUTER_API_KEY":"sk-or-v1-...","OPENROUTER_MODEL":"google/gemini-2.5-flash"}}'
# Add --scope project for per-project config instead of global
単一プロバイダー — OpenRouter(クラウド)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openrouter",
        "OPENROUTER_API_KEY": "sk-or-v1-...",
        "OPENROUTER_MODEL": "google/gemini-2.5-flash"
      }
    }
  }
}
無料モデル(
:free接尾辞)は、レート制限に達すると自動的に最安の有料モデルにフォールバックします。追加の設定は不要です。
単一プロバイダー — Ollama(ローカル、API キー不要)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
FALLBACK_MODELは任意です。省略すると、インストール済みのモデルを自動検出し、優先順に試します。
単一プロバイダー — LM Studio(OpenAI 互換、ポート 1234)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:1234/v1",
        "OPENAI_API_KEY": "lm-studio",
        "OPENAI_MODEL": "qwen/qwen2.5-vl-7b-instruct"
      }
    }
  }
}
単一プロバイダー — oMLX(Apple Silicon、ポート 8000)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit"
      }
    }
  }
}
プロバイダー間のフォールバック — oMLX → OpenRouter
プライマリはローカルの oMLX で実行されます。失敗した場合は、自動的に OpenRouter クラウドに切り替わります。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
プロバイダー間のフォールバック — oMLX → Ollama
どちらもローカルです。oMLX が失敗した場合(モデルがない/サーバーがダウン)、Ollama が引き継ぎます。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "ollama",
        "FALLBACK_MODEL": "qwen2.5vl:7b"
      }
    }
  }
}
FALLBACK_BASE_URLのデフォルト値はOLLAMA_HOST(またはhttp://localhost:11434)です。Ollama が標準以外のホストで動作している場合にのみ設定してください。
プロバイダー間のフォールバック — Ollama → OpenRouter
ローカルを優先し、モデルがインストールされていない場合や推論に失敗した場合はクラウドに切り替わります。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
同一プロバイダー内のフォールバック — 明示的なフォールバックモデルを固定
自動検出を使わない場合に使用します。どちらのモデルも同じプロバイダーを使用します。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_MODEL": "qwen2.5vl:3b"
      }
    }
  }
}
フォールバック環境変数のリファレンス:
| 変数 | 用途 | デフォルト値 |
|---|---|---|
FALLBACK_PROVIDER | フォールバックに使用するプロバイダー(ollama/openai/openrouter) | PROVIDER と同じ |
FALLBACK_MODEL | フォールバックに使用するモデル ID | 自動検出(同じプロバイダー) |
FALLBACK_BASE_URL | フォールバック先の openai/ollama サーバーのベース URL | OPENAI_BASE_URL または OLLAMA_HOST |
FALLBACK_API_KEY | フォールバック先プロバイダーの API キー | OPENAI_API_KEY または OPENROUTER_API_KEY |
ログ
すべてのアクティビティ(フレーム抽出、API 呼び出し、エラー)は次の場所に書き込まれます:
tail -f ~/.cache/vidlizer/mcp.log
ツール
| ツール | 戻り値 | 出力トークン数 |
|---|---|---|
analyze_video(path, **opts) | analysis_id +メタデータ | 約 100 |
list_analyses() | 保存されているすべての分析(メタデータのみ) | 1 件あたり約 50 |
get_summary(id, level) | 簡潔/中程度/詳細なテキスト要約 | 約 200~2K |
get_step(id, step) | 単一のフロー手順 | 約 150 |
get_steps(id, start, end) | 手順の範囲 | 可変 |
get_phase(id, phase) | 指定したフェーズのすべての手順 | 可変 |
search_analysis(id, query) | テキストに一致する手順(query または keyword) | 該当項目のみ |
get_transcript(id, start_s, end_s) | トランスクリプトの一部 | 可変 |
get_full_analysis(id) | フロー全体+トランスクリプト | 全体 |
delete_analysis(id) | 確認 | 約 10 |
get_usage_stats() | モデルごとのトークン数とコストの内訳 | モデルあたり約 50 |
clear_usage_stats() | 使用状況ログをリセット | 約 10 |
トークン効率の高いワークフロー
analyze_video は結果全体をディスクに保存し、analysis_id とメタデータのみを返します(約 100 トークン)。LLM は必要に応じて特定の部分を取得します。60 手順の動画でも、登録には約 100 トークンしかかからず、クエリごとに必要な情報だけが読み込まれます。
agent: analyze_video("demo.mp4")
→ { "analysis_id": "abc123", "step_count": 42, "phases": ["Intro", "Demo", "Outro"] }

agent: get_summary("abc123", level="brief")
→ "Intro: Title card displayed | Demo: CLI recording | Outro: Results shown"

agent: get_phase("abc123", "Demo")
→ [ { step, timestamp_s, action, scene }, … ]

agent: search_analysis("abc123", "error")
→ [ { step: 17, matched_field: "observations", matched_value: "Stack trace visible" } ]
MCP リソース
| URI | 内容 |
|---|---|
vidlizer://analyses | すべての分析(メタ JSON) |
vidlizer://analyses/{id} | 分析の完全な JSON |
vidlizer://analyses/{id}/summary | 中程度の長さのテキスト要約 |
🧪 テスト
完全自動化されたテストスイート — ユニットテストと統合テストが248件、E2Eテストが3件。
make install-dev    # installs pytest, pytest-html, pytest-mock
make test           # runs unit + integration (no network) → reports/test-report.html
make test-e2e       # also runs YouTube download + full pipeline e2e
make smoke          # real-provider smoke test against all detected providers
ユニットテスト/統合テストのレポート:reports/test-report.html。テスト対象:
- フレーム抽出(ffmpeg)、知覚的重複排除、キャッシュ TTL
- 音声検出、文字起こしの結合(重複なし)
- PDF → フレーム、画像エンコード、URL 検出
- 出力フォーマッター:json/summary/markdown の正確性
- OpenRouter をモックした完全なパイプライン(偽の HTTP サーバー)
- HTTP レイヤー:SSE 解析、429 処理、コスト上限、Ollama のストリーミング
- バッチ:JSON 修復の再試行、無料モデルの同時実行ガード
- モデル:料金の検索、フォールバックシーケンス、フォーマットヘルパー
- 使用状況の追跡:記録/統計/クリアのライフサイクル
- 実際のメディアを使った、実際の CLI サブプロセスの呼び出し
- 実際の YouTube ダウンロードと完全な分析(オプトインの
-m e2e)
スモークテスト
make smoke は、検出されたすべてのプロバイダーに対して、実際のプロバイダーを使った完全なパイプラインを順番に実行します(Ollama → LM Studio → oMLX → OpenRouter)。テスト開始前に、各ローカルプロバイダーについて対話形式で確認します。
- ビジョンモデルが見つかった場合 →
"Test ollama with qwen2.5vl:3b? [Y/n]" - ビジョンモデルがない場合(Ollama) →
"Download qwen2.5vl:3b (~2.3 GB)? [y/N]" - ビジョンモデルがない場合(LM Studio/oMLX) → モデルをロードして再試行するよう案内
各プロバイダーは専用の出力ディレクトリで個別にテストされます(キャッシュ汚染を防止)。各プロバイダーのテスト後、ローカルモデルは VRAM からアンロードされます。結果は、プロバイダーごとの合否スコアカードを含む reports/smoke-TIMESTAMP.html に出力されます。
make smoke                                  # auto-detect all providers
make smoke ARGS="--provider ollama"         # force single provider
make smoke ARGS="--provider openrouter"     # OpenRouter only (no local needed)
🤝 コントリビューション
コントリビューションを歓迎します!環境構築、コードスタイル、PR のガイドラインについては、CONTRIBUTING.md をご覧ください。
- バグ報告:issue を作成 — プロバイダー、モデル、macOS のバージョン、完全なエラー内容を記載してください
- 機能リクエスト:ユースケースを説明する issue を作成してください
- PR:
mainからブランチを作成し、テストを追加して、make testが成功し、ruff check vidlizer/がクリーンであることを確認してください
❤️ サポート
vidlizer は無料のオープンソースソフトウェアです。時間の節約に役立った場合は、ぜひご支援ください。
📝 ライセンス
MIT — LICENSE をご覧ください。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。