Web Researcher MCP について
Web Researcher MCP は、研究者、記者、アナリスト向けのローカルなウェブ調査 MCP サーバーです。指定した情報源を検索してページ全体を読み、引用を検証し、チャットをまたいで調査内容を保持できます。
主な機能
- 01信頼するサイトに検索を限定
- 02SEC・裁判記録・学術情報を検索
- 03ページや文書を全体読み込み
- 04引用と参考文献を検証
- 05チャットをまたいで調査を保存
活用シーン
- 01文献レビュー用の引用を探して検証
- 02法律文書の判例引用を確認
- 03ニュースと公的記録を照合
MCP 対応
MCP クライアントに、ウェブ検索、ページ読み込み、引用検証のツールを提供します。ローカル実行のほか、チーム向けの共有サーバーとしても運用できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
docker run -i --rm -e GOOGLE_CUSTOM_SEARCH_API_KEY -e GOOGLE_CUSTOM_SEARCH_ID -e SEARCH_PROVIDER -e SEARCH_ROUTING -e BRAVE_API_KEY -e SERPER_API_KEY -e SEARCHAPI_API_KEY -e SEARXNG_URL -e TAVILY_API_KEY -e EXA_API_KEY -e XQUIK_API_KEY -e EDGAR_CONTACT_EMAIL -e COURTLISTENER_API_TOKEN -e FRED_API_KEY ghcr.io/zoharbabin/web-researcher-mcp:1.50.4GOOGLE_CUSTOM_SEARCH_API_KEYシークレットGoogle Custom Search API keyGOOGLE_CUSTOM_SEARCH_IDGoogle Programmable Search Engine IDSEARCH_PROVIDERSearch provider: google, brave, serper, searxng, searchapi, duckduckgo, tavily, exa, hackernews, reddit, bluesky, github, or xquikSEARCH_ROUTINGUse multiple search engines with automatic switching if one goes down (e.g. brave,google,serper)BRAVE_API_KEYシークレットBrave Search API keySERPER_API_KEYシークレットSerper.dev API keySEARCHAPI_API_KEYシークレットSearchAPI.io API keySEARXNG_URLSearXNG instance URLTAVILY_API_KEYシークレットTavily Search API keyEXA_API_KEYシークレットExa API key (neural/semantic web search provider)XQUIK_API_KEYシークレットXquik API key (metered X/Twitter post search provider)EDGAR_CONTACT_EMAILContact email for SEC EDGAR (enables filing_search); falls back to OPENALEX_EMAILCOURTLISTENER_API_TOKENシークレットCourtListener API token (legal_search works without it; a token raises the rate limit)FRED_API_KEYシークレットFRED API key (enables econ_search for Federal Reserve economic data)ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細

web-researcher-mcp
あなたの AI リサーチアシスタントです。検索し、アクセス可能なページを読み、情報源を確認します。
SEC の提出書類、裁判記録、特許、臨床試験、全文論文など、ウェブや一次資料を検索できます。
LinkedIn や X のように、ご自身のログインが必要なページを含め、ページ全体を読み取ります。
すべての引用を確認し、チャットをまたいでリサーチを保持し、すべてをお使いのマシンで実行できます。
すぐに始めるのに API キーは不要です。
⭐ AI がでっち上げることにうんざりしていて、web-researcher-mcp が役に立ったら、ぜひスターを付けてください ⭐ — より多くのチームにこのプロジェクトを知ってもらう助けになります。
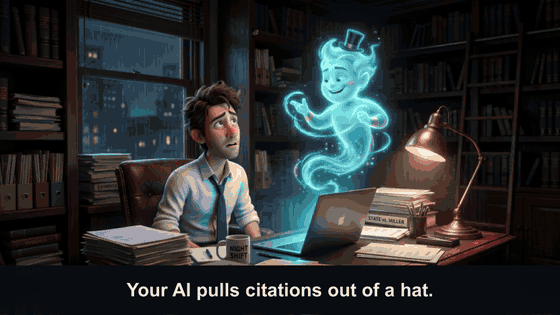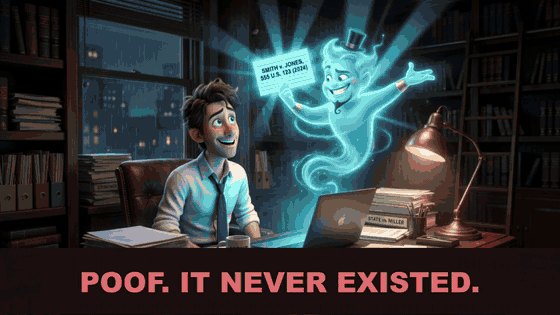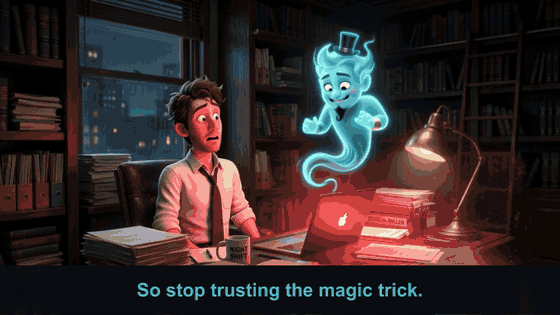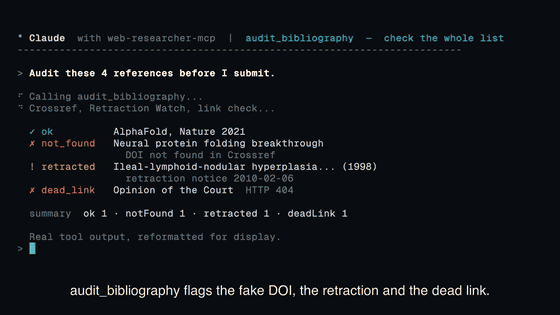
問題を描いたアニメーションと、実際のツール出力です。43 秒の動画を見る。





Python ユーザー — uvx(コンパイル不要、あらゆる OS に対応):
# One-time: install uv (skip if you already have it)
curl -LsSf https://astral.sh/uv/install.sh | sh        # macOS/Linux  (Windows: winget install astral-sh.uv)

claude mcp add --scope user web-researcher -- uvx web-researcher-mcp
uv がプラットフォームに適したビルド済みバイナリを取得して実行するため、Go もコンパイルも手動での PATH 設定も不要です。任意の MCP クライアントから uvx web-researcher-mcp を指定してください。uv tool install web-researcher-mcp または pip install web-researcher-mcp でも利用できます。
macOS(Homebrew):
brew install zoharbabin/tap/web-researcher-mcp
claude mcp add --scope user web-researcher -- web-researcher-mcp
macOS / Linux(パッケージマネージャー不要):
curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
Windows(PowerShell):
powershell -ExecutionPolicy Bypass -c "irm https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.ps1 | iex"
開発ツールは不要です。どの方法でも同じ署名済みバイナリが提供され(PyPI のホイールにはバンドルされており、その他の方法ではダウンロードしてチェックサムを検証します)、PATH に追加されます。curl/PowerShell のインストーラーは、claude CLI が存在する場合、Claude Code への登録も自動で行います。Homebrew はバイナリをインストールするため、接続するには上記の claude mcp add の行を実行してください。
ワンクリックでインストール:

Cursor/VS Code/LM Studio のボタンを使うと、設定不要の uvx セットアップがインストールされます(エディターで追加前に確認を求められます。 uv が必要です。上記を参照してください)。API キーなしで DuckDuckGo ウェブ検索を実行できるため、すぐに試すのに最適です。image_search/news_search や、より高機能なプロバイダーにはキーが必要です(2分で設定できます。設定を参照)。**Claude Desktop:**お使いのプラットフォーム用の .mcpb バンドルをダウンロードしてダブルクリックする(Settings → Extensions)か、上記の uvx の行を使用してください。
別の MCP クライアントを使用する場合や、API キーを渡したい場合は、アプリごとの設定についてAI アシスタントへの接続を、検索プロバイダーの選択について設定を参照してください。
AI はウェブや一次情報源を検索し、ページを読み込み(ログインが必要なページを含む)、引用を確認して、複数ステップの調査を実行できるようになります。信頼できる情報源を選んでください。
Python SDK
from web_researcher_mcp import WebResearcherClient

async with WebResearcherClient() as client:
    response = await client.web_search("CRISPR off-target effects 2024", num_results=5)
    for r in response.results:
        verified = await client.verify_citation(r.url)
        print(r.title, "—", "✓" if verified.exists else "?")
詳しいドキュメント:docs/PYTHON_CLIENT.md

同期ラッパー(async を使用しないスクリプトやノートブック向け):
with WebResearcherClient.sync() as client:
    response = client.web_search("climate change 2024")
    print(response.results[0].title)
できること
| どのように役立つか | |
|---|---|
| あらゆる場所を検索 | 信頼できるサイト(レンズ)に絞ったウェブ検索ができます。SEC提出書類、米国の裁判記録、特許、臨床試験、経済データ、全文論文に特化したツールも利用できます。APIキーは不要です。 |
| あなたとして作業 | オプトインの site_login を使うと、LinkedIn、X、Facebook、Instagram、YouTubeなど、すでにあなたが閲覧できるページをAIが読み取れます。自分のブラウザーまたはプライベートなログインウィンドウで、自分でサインインします。2FAにも対応しています。パスワードは保存されません。ログイン情報は暗号化され、ユーザーごとに管理され、有効期限があり、site_logout で削除されます。LinkedInなど、一部のサイトでは利用規約により自動アクセスが禁止されています。利用が許可されているサイトでお使いください。 |
| 頼る前に確認 | verify_citation、audit_bibliography、verify_recommendation は、出典が実在するか、撤回されていないか、リンクが有効か、主張の内容を裏付けているかを確認します。返されるのは証拠であり、判定ではありません。精度はラベル付きゴールドセットで評価されています(docs/TRUST_EVAL.md)。 |
| ページ全体を読む | PDF、Word、PowerPointのファイル、YouTubeの文字起こし、Hacker Newsのスレッドを、抜粋だけでなく全体まで読み取れます。 |
| 保存して追跡 | セッションはコンテキストを失っても保持されます。research_panel では複数のモデルの回答を比較できます。引用はAPA、MLA、BibTeX、RIS、CSL-JSON形式でエクスポートできます。オプトインの保存済みクエリモニターは新しい検索結果を知らせ、メモリーはチャットをまたいで調査結果を保持し、チームワークスペースではそれらを共有できます。 |
| 自分で実行 | 無料のオープンソース(MIT)で、アカウントは不要です。クエリは選択した検索プロバイダーにのみ送信されます。ノートパソコンで単一のバイナリーを使うことも、チーム向けの共有サーバーで使うこともできます。 |
| 常にバックアップあり | 複数の検索エンジンが連携します。1つが失敗すると、次のエンジンが引き継ぎます。 |
| 監査証跡 | オプトインの監査ログには、改ざんを検知できるハッシュチェーンで各ツール呼び出しが記録されます。リリースには署名とSLSA来歴証明が付属します。 |
なぜこれがあるのか?
AIの回答は出典があるように見えて、実際にはそうでないことがよくあります。
- 裁判所: Charlotinデータベースには、AIが生成した幻覚を含むコンテンツが関係する裁判所の判決が2,200件以上掲載されています。2027-01-01から、California SB 574により、弁護士は裁判所に提出する書類の引用すべてを自分で確認する必要があります。
- 検索: 2026年のWashUによる監査では、Google AI Overviewsにおける検証可能な主張の約9件に1件が、引用先のページで裏付けられていないことが判明しました(著者らはこれを上限値としています)。CJRのTow Centerは8つのAI検索エンジンをテストし、いずれもニュースの引用が不適切であることを明らかにしました。
- あなたの仕事: 引用、公開、提出、またはクライアントへの提示が伴うなら、「おそらく本当」では不十分です。
この問題への対応: AIが、あなたの選んだ情報源から実際のページや記録を読み取り、その後、引用を確認します。すべての主張を、あなたが開けるリンクまでたどれます。
Claude、Claude Desktop、Cursor、VS Code、Codex、Gemini CLI、およびMCPに対応するあらゆるAIアシスタントで動作します。
どのような人に使われていますか
- 学術研究者 — 「でっち上げの引用ではなく、実在する DOI を使った文献レビューが必要です」
- ビジネスアナリスト — 「納品物に、クライアントが実際にクリックして確認できる出典が必要です」
- 弁護士 — 「存在しない判例を引用したら、50,000 ドルの罰金を科されます」
- ジャーナリスト — 「Perplexity の要約ではなく、政府記録や裁判所への提出書類を照合する必要があります」
- 医学研究者 — 「健康ブログに基づく臨床判断は、誰かを傷つけるおそれがあります」
- 大学院生 — 「AI がでっち上げた引用を追跡するのに、3 時間もかかりました」
- 市場調査・営業調査担当者 — 「最も役立つ情報は、サインインしないと開けないページにあります」
- エンタープライズチーム — 「競合調査を第三者のサーバー経由で行うことはできません」
- エージェントを構築する開発者 — 「クエリごとの課金やベンダーロックインなしで、検索とページの読み取りをしたいです」

比較
| web-researcher-mcp | 組み込みの AI 検索(Perplexity、ChatGPT、Google AI) | 検索 API(Tavily、Exa、Brave) | 論文ツール(Scite、Consensus、Elicit) | |
|---|---|---|---|---|
| 引用が実在し、撤回されておらず、主張された内容を述べているか確認する | はい | いいえ | いいえ | 論文のみ |
| 検索するソースを自分で選べる | はい(レンズ) | いいえ | ドメインフィルター | いいえ |
| SEC への提出書類、裁判記録、特許、臨床試験 | はい | ウェブページのみ | ウェブページのみ | いいえ |
| ページ全文、PDF、YouTube の文字起こしを読み取る | はい | 抜粋と要約 | サービスによって異なります | いいえ |
| 自分のマシンで動作し、アカウント不要 | はい | いいえ | いいえ(ホスト型 API) | いいえ(ホスト型) |
| 既存の AI クライアント内で動作する | はい | 別アプリ | はい | 一部対応 |
| 費用 | 無料、オープンソース(MIT) | サブスクリプションまたはパッケージに含まれる | 従量課金制 API キー | サブスクリプション |
各ベンダーの公開ドキュメントに基づきます。2026年10月時点。古い情報があれば、issue を作成してください。
使い分け
- 組み込みの AI 検索 — 出典を引用する必要がない、気軽な調べもの
- 検索 API — ランキングされたリンクだけが必要な場合。このツールと組み合わせれば(どの API もプロバイダーとして接続できます)、ページの読み取りや引用の確認もできます
- 論文ツール — 学術論文データベースを1つ閲覧する場合
- web-researcher-mcp — 研究に自分の評判がかかっている場合全般:クライアント向け業務、裁判所への提出書類、出版物、助成金の申請、医療上の判断、ジャーナリズム
AI でできること

| ツール | 内容 |
|---|---|
web_search | ウェブを検索します。レンズを使って、信頼するソースのみに検索対象を限定することもできます |
scrape_page | URL の内容をすべて読み取ります。ウェブページ、PDF、Word 文書、スライドショー、YouTube の文字起こし、Hacker News のスレッドに対応しています(HN API を使ってネイティブに読み取ります)。mode: raw を指定すると、サニタイズされていないソースをそのまま取得できます(JSON や HTML の調査など) |
search_and_scrape | 検索して最適な結果を読み取ります。品質スコアにより、信頼性の高いソースを見つけやすくします |
image_search | サイズ、種類、色、形式を指定して画像を検索します |
news_search | 日付指定やソースの絞り込みを使って、最新ニュースを検索します |
academic_search | 実在する DOI を持つ論文を検索します。著者、引用数、オープンアクセスのリンクを取得できます |
paper_fulltext | DOI、Semantic Scholar ID、または URL を指定して、論文の全文を 1 回の呼び出しで取得します。academic_search の後に scrape_page を実行する必要はありません |
citation_graph | 論文の引用関係をたどります。引用している論文と引用されている論文を、意図や影響度のシグナルとともに確認できます |
patent_search | 分類コードを使って、特許庁(米国、欧州、国際)を検索します |
filing_search | SEC EDGAR で米国上場企業の提出書類(10-K、10-Q、8-K、…)を検索するか、構造化された XBRL 企業データを取得します |
legal_search | CourtListener を通じて、米国の裁判所の判決文や訴訟記録を検索します。実際の判例と引用を確認できます |
econ_search | 経済データを検索します。世界銀行の世界開発指標、OECD の経済指標、Eurostat の欧州統計(いずれもキー不要)、FRED の米国マクロ経済系列(GDP、CPI、失業率、金利。FRED_API_KEY が必要)を利用できます |
clinical_search | ClinicalTrials.gov を検索します。臨床試験の登録情報から、ステータス、フェーズ、スポンサー、結果の公開状況を確認できます(情報検索用であり、医療上の助言ではありません) |
monarch_search | Monarch Initiative の生物医学ナレッジグラフを検索します。表現型の類似性で疾患や遺伝子をランク付けし、疾患・遺伝子・表現型のエンティティを調べ、遺伝子・疾患・表現型の関連をたどることができます |
awesome_list_search | ecosyste.ms Awesome API で、GitHub のトピックに関するコミュニティ編集の「awesome-*」リストを検索します。フリーテキスト検索よりも構造化され、絞り込み可能な情報(スター数、編集済み項目数、トピック)を取得できます |
local_search | ローカル検索の意図を示すクエリで、実在する場所(レストラン、ショップ、サービス、スポット)を検索します。POI の詳細情報と説明を構造化して取得できます。BRAVE_API_KEY が必要です |
brand_research | 任意のドメインまたは企業名から、企業のブランドアイデンティティ全体(カラー(16 進数)、ロゴ、タイポグラフィ、トーン・オブ・ボイス、ソーシャルメディアのハンドル)を調査します。AI コンテンツ生成用の構造化 JSON を返します。API キーは不要です。より豊富なデータを取得する場合は BrandFetch キーを任意で指定できます |
company_recon | 企業の OSINT 調査を行います。Certificate Transparency ログの SAN、Wayback Machine の過去の URL 一覧、派生サブドメイン、ウェブ検索による企業概要を取得します。各フェーズは個別に選択でき、失敗しても他のフェーズに影響しません |
verify_citation | 引用を頼りにする前に、その引用が実在するか、実際の記録と一致するか、撤回済みまたはリンク切れになっていないかを確認します。結論ではなく、根拠を提示します |
audit_bibliography | 参考文献リスト全体を一度に監査します。CSL-JSON/RIS/BibTeX ファイル(またはセッション)を貼り付けると、撤回済み、リンク切れ、検証不能な引用について、各項目および文献全体のフラグを取得できます |
verify_recommendation | AI が生成したおすすめリスト(リスト記事、製品ランキング)を監査し、自社宣伝、著者の利益相反、ドメインの評判、リンク切れを確認します。GEO 対策で操作された候補も検出します。結論ではなく、根拠を提示します |
archive_source | Save Page Now を通じて、URL の最新スナップショットを Internet Archive(Wayback Machine)に保存します。ページが後に変更または削除されても、引用元を検証できるようにします。スナップショット URL とタイムスタンプを返します(書き込みツール) |
sequential_search | 複数ステップで深掘り調査を行います。AI が見つけた情報を記憶し、それをもとに調査を進めます |
get_research_session | コンテキストの喪失後に調査セッションを復元し、中断した箇所から再開します |
research_export | 調査セッションを、各ステップの出典情報をすべて含む共有可能なレポート(Markdown または JSON)としてエクスポートします |
format_bibliography | 収集したソースを、書式設定済みの参考文献リストに変換します。APA、MLA、BibTeX、RIS、CSL-JSON(Zotero/EndNote/Mendeley に対応)を選択できます |
research_panel | 独立して設定された複数の LLM に同じ質問をして回答を比較します。合意点、矛盾点、モデル固有の指摘を決定論的に算出し、調停役のモデルによって丸めることはありません |
上記のツールのほとんどは常に利用できます。一部のツールは、適切なプロバイダーまたは設定がある場合にのみ有効になります。citation_graph と research_panel には、設定済みのバックエンドプロバイダーが少なくとも1つ必要です。filing_search には EDGAR_CONTACT_EMAIL が必要です。local_search には BRAVE_API_KEY が必要です。 |
オプトインツール。 これらの機能は、有効にするまでオフのままです。個人データを扱う機能には、記録された同意も必要です。
| ツール | 機能 | 有効にする方法 |
|---|---|---|
site_login, site_logout | ログイン情報(Cookie またはブラウザープロファイル)を保存または削除し、scrape_page がログインを必要とするページを読み取れるようにします。ユーザーごとに暗号化されます。 | COOKIE_VAULT_ENABLED=true |
monitor_query_save, monitor_query_check | クエリを保存し、後で新しい結果だけを取得します | MONITORING_ENABLED=true |
memory_save, memory_recall | セッションをまたいで、ユーザーごとに保持期間の上限付きで調査結果を保存します | MEMORY_ENABLED=true |
workspace_contribute, workspace_read | 出典情報を付けて、調査結果をチームのワークスペースに共有します | WORKSPACES_ENABLED=true |
get_my_analytics | 自分の使用状況統計を確認します | USER_ANALYTICS_ENABLED=true |
正規版の、CI で検証済みのツール一覧と完全なスキーマについては、docs/TOOLS.md を参照してください。
すぐに使える調査テンプレート
このサーバーには、AI アシスタントがワンクリックで呼び出せる、ガイド付きのプロンプトテンプレートも用意されています。実績のある複数ステップのプロセスに沿って進めるため、指示を一つひとつ指定する必要はありません。
| テンプレート | AI が実行する作業 |
|---|---|
comprehensive-research | トピックについて、構成化された複数ステップの詳細調査を行います |
fact-check | 複数の独立した情報源に照らして主張を検証します |
competitive-analysis | 企業とその市場(ニュース、特許、ウェブ)を分析します |
literature-review | トピックに関する学術文献を体系的にレビューします |
brand-guidelines | ブランドを調査し、用途に応じたクリエイティブディレクション(ランディングページ、メール、動画ブリーフ)を作成します。brand_research を呼び出し、構造化された JSON を解釈します |
company-recon | 企業の詳細な OSINT 調査を行い、インフラ、提出書類、関係者、公開情報をマッピングします |
rare-disease-research | Monarch ナレッジグラフを使って希少疾患の鑑別と遺伝子・疾患の調査を行い、文献や臨床試験で裏付けます |
research-panel-factcheck | LLM のパネルで主張をファクトチェックし、意見の相違をすべて追究します |
research-panel-synthesis | 矛盾を不確実性として扱いながら、LLM のパネル全体から一つの回答を統合します |
curriculum-research | 科目のシラバスでの扱い、教育機関の風土、学問の自由に関する背景を調査します。curriculum レンズを指定して web_search を呼び出します |
ほとんどの AI アプリでは、プロンプトや「/」コマンドを選ぶ場所に表示されます。サーバーは、ライブのステータスリソース(stats://tools、stats://sessions、stats://rate-limits、stats://providers)、レンズカタログ(lenses://catalog)、診断情報(diagnostics://errors/recent、diagnostics://health、diagnostics://panel/spend)、大容量ペイロード用のアーティファクトストア(research://artifact/{id})を公開しているため、あなたや AI は使用状況、制限、稼働中のプロバイダーを確認できます。全一覧については、docs/DEPLOYMENT.md を参照してください。
クイックスタート
オプション 1:Homebrew(macOS / Linux — 推奨)
brew install zoharbabin/tap/web-researcher-mcp
claude mcp add --scope user web-researcher -- web-researcher-mcp
Homebrew が信頼性の確保、更新、PATH の設定を自動で処理するため、署名に関する警告は表示されません。
オプション 2:ワンコマンドでインストール(すべての OS 対応 — 開発ツール不要)
macOS / Linux:
curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
Windows(PowerShell):
powershell -ExecutionPolicy Bypass -c "irm https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.ps1 | iex"
バイナリをダウンロードし、署名済みリリースの SHA-256 チェックサムと照合して検証したうえで、PATH に配置し、インストール済みの場合は Claude Code に登録します。インストール先を変更するには、次のようにします。
INSTALL_DIR=/opt/tools curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
その他のインストール方法
AUR(Arch Linux):
# Using any AUR helper (yay, paru, etc.)
yay -S web-researcher-mcp
または手動で実行します:git clone https://aur.archlinux.org/web-researcher-mcp.git && cd web-researcher-mcp && makepkg -si
Nix / NixOS:
# Run without installing
nix run github:zoharbabin/web-researcher-mcp

# Add to your flake inputs
nix profile install github:zoharbabin/web-researcher-mcp
NixOS モジュールの使い方については、packaging/nix/flake.nix を参照してください。
Continue.dev:
Continue の ~/.continue/config.json に追加します。
{
  "mcpServers": {
    "web-researcher": {
      "command": "uvx",
      "args": ["web-researcher-mcp"]
    }
  }
}
または、packaging/continue/config.json を出発点としてコピーしてください。
WinGet(Windows):
winget install zoharbabin.web-researcher-mcp
Scoop(Windows):
scoop bucket add zoharbabin https://github.com/zoharbabin/scoop-bucket
scoop install web-researcher-mcp
Chocolatey(Windows):
choco install web-researcher-mcp
Homebrew Cask(macOS — Developer ID 署名済み + 公証済みバイナリ):
brew install --cask zoharbabin/tap/web-researcher-mcp
この Cask には公証済みの darwin バイナリ(Gatekeeper 対応済み)が含まれています。ほとんどのユーザーには、上記の formula(brew install zoharbabin/tap/web-researcher-mcp)がおすすめです。これは brew install web-researcher-mcp で解決されます。公証済みの成果物を使うには、--cask を明示的に指定してください。
Go install(Go がインストール済みの場合):
go install github.com/zoharbabin/web-researcher-mcp/cmd/web-researcher-mcp@latest
claude mcp add --scope user web-researcher -- web-researcher-mcp
Docker:
# STDIO mode needs -i so the container's stdin stays attached for MCP JSON-RPC
docker run -i --rm \
           -e SEARCH_PROVIDER=brave \
           -e BRAVE_API_KEY=YOUR_KEY \
           docker.io/zoharbabin/web-researcher-mcp:latest
ソースからビルド:
git clone https://github.com/zoharbabin/web-researcher-mcp.git
cd web-researcher-mcp
go build -o web-researcher-mcp ./cmd/web-researcher-mcp
AI アシスタントに接続する
インストールスクリプトにより、Claude Code には自動的に登録されます。それ以外のアプリでは、AI の設定ファイルに追加してください。
{
  "mcpServers": {
    "web-researcher": {
      "command": "web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "YOUR_BRAVE_API_KEY"
      }
    }
  }
}
まだキーをお持ちでない場合は、env を省略してください。DuckDuckGo は設定不要で使えます。
その他のクライアント:
| クライアント | 設定場所 |
|---|---|
| Gemini CLI | gemini mcp add web-researcher uvx web-researcher-mcp を実行するか、上記の JSON ブロックを ~/.gemini/settings.json に追加します |
| Codex | ~/.codex/config.toml に [mcp_servers.web-researcher] を追加し、command = "uvx" と args = ["web-researcher-mcp"] を指定します |
Configuration テーブルに記載されているプロバイダーに置き換えるには、SEARCH_PROVIDER とそのプロバイダーのキーを設定してください。これで完了です。AI アシスタントがすべての調査ツールを利用できるようになります。
設定

API キーは不要です。 DuckDuckGo は組み込みの、設定不要なフォールバックです。インストールすればすぐ使えます。検索結果の品質を高め、画像検索やニュース検索を利用するには、以下のプロバイダーからいずれか1つを追加してください。いずれも任意で、相互に切り替え可能です。すでに利用しているもの、または好みのものを選んでください。サーバーはすべてのプロバイダーを同等に扱います。
検索プロバイダー
SEARCH_PROVIDER=<name> を設定し、該当プロバイダーのキーを指定してください。すべてのプロバイダーは検索レンズに対応しており、任意のプロバイダーを組み合わせて自動フェイルオーバーを利用できます(検索プロバイダーを参照)。
| プロバイダー | SEARCH_PROVIDER | キー変数 | キーの取得先 |
|---|---|---|---|
| DuckDuckGo | duckduckgo | なし | 組み込み — 設定不要 |
| Google PSE | google | GOOGLE_CUSTOM_SEARCH_API_KEY + GOOGLE_CUSTOM_SEARCH_ID | クラウドコンソール + エンジン |
| Brave | brave | BRAVE_API_KEY | brave.com/search/api |
| Serper | serper | SERPER_API_KEY | serper.dev |
| SearchAPI.io | searchapi | SEARCHAPI_API_KEY | searchapi.io |
| You.com | youcom | YOUDOTCOM_API_KEY | you.com/docs/api-reference/search/v1-search |
| SearXNG | searxng | SEARXNG_URL | セルフホスト |
| Tavily | tavily | TAVILY_API_KEY | app.tavily.com |
| Exa | exa | EXA_API_KEY | dashboard.exa.ai |
| Hacker News | hackernews | なし | 組み込み — 設定不要(HN Algolia インデックス) |
reddit | なし | 組み込み — 設定不要(公開 RSS) | |
| Bluesky | bluesky | なし | 組み込み — 設定不要(公開 AT Protocol API) |
| GitHub | github | なし(GITHUB_TOKEN は任意。設定するとレート制限が緩和されます) | 組み込み — 設定不要(公開 REST Search API) |
| Xquik | xquik | XQUIK_API_KEY | dashboard.xquik.com |
Google PSE は終了予定です。 Google は Custom Search JSON API の新規顧客の受付を終了し、2027-01-01 にサービスを終了します(Google)。既存のキーはその日まで使用できます。新しく設定する場合は、Brave、Serper、SearXNG、または別のプロバイダーを使用してください。
各プロバイダーには、それぞれ無料枠、登録手順、対応機能(画像、ニュース、鮮度)があります。詳しい比較(インデックスの分類、機能マトリックス、用途別の選び方)は docs/PROVIDERS.md を、キーの設定手順は docs/API_SETUP.md を参照してください。複数のプロバイダーを設定すると、サーバーが自動的にフェイルオーバーします。詳しくは検索プロバイダーを参照してください。
SEARCH_PROVIDER が未設定の場合、キーが設定されていればサーバーは Google を使用し、設定されていなければ設定不要の DuckDuckGo プロバイダーにフォールバックします。そのため、キーの有無にかかわらず、すぐに利用できます。
学術検索(任意 — 登録不要)
学術検索プロバイダー(OpenAlex、CrossRef)では、連絡先メールアドレスを指定すると、ポライトプール経由でより高速にアクセスできます。登録は不要で、メールアドレスだけで利用できます。設定方法は docs/API_SETUP.md、変数の一覧は docs/DEPLOYMENT.md を参照してください。
これらを設定すると、
academic_searchは DOI、著者、引用数、オープンアクセスの PDF リンクを含む実際の論文を返します。設定しなくても利用できますが、フォールバックとしてウェブ検索を使用します。
特許検索(任意)
特許プロバイダー(EPO、USPTO、The Lens)で構造化された特許データを取得するには、API キーが必要です。設定手順は docs/API_SETUP.md、変数の一覧は docs/DEPLOYMENT.md を参照してください。
これらを設定すると、
patent_searchは分類コード、日付、発明者を含む構造化された特許データを返します。設定しない場合は、ウェブ検索にフォールバックします。
詳細設定:HTTP モード、OAuth、その他すべての設定
HTTP モード、OAuth、レート制限、キャッシュ、スクレイピング、オブザーバビリティの設定については、docs/DEPLOYMENT.md に記載されています。
内部の仕組み
アーキテクチャ(開発者とコントリビューター向け)
パッケージごとの全体マップと、階層図(MCP トランスポート → ツールのディスパッチ → サービス層 → インフラストラクチャ)は ARCHITECTURE.md にまとめられています。記載内容にずれが生じないよう、情報を一か所に集約しています。
設計原則(開発者向け)
- グローバル状態ゼロ -- すべての依存関係はコンストラクター経由で注入します
- インターフェース駆動 -- テストや差し替えができるよう、外部依存はすべてインターフェースの背後に配置します
- 同時実行数の制限 -- 外部 API 呼び出しには明示的なセマフォを使用します
- 多層防御 -- すべての層で SSRF 対策、レート制限、コンテンツのサニタイズを行います
- エラーを明示する -- エラーは返し、決して握りつぶしません。境界で検証します
検索プロバイダー
リサーチに使用する検索エンジンを選択できます。どのプロバイダーもレンズに対応しています。
| プロバイダー | ウェブ全体 | 画像 | ニュース | 備考 |
|---|---|---|---|---|
| DuckDuckGo | はい | — | — | 設定不要のデフォルト(API キー不要)。大量利用時はレート制限があります |
| Google PSE | はい | はい | はい | 新規顧客の受付を終了しています。2027-01-01 に終了します。無料枠は 1 日あたり 100 クエリです |
| Brave Search | はい | はい | はい | 独自のインデックスを使用。無料枠があります |
| Serper.dev | はい | はい | はい | Google と同一の検索結果 |
| SearXNG | はい | はい | はい | セルフホスト可能で、プライバシーを重視。エアギャップ環境に対応します |
| SearchAPI.io | はい | はい | はい | 複数のエンジンバックエンドに対応した統合 API |
| You.com | はい | — | はい | You.com API によるウェブ検索とニュース検索 |
| Tavily | はい | — | はい | AI エージェント向け検索。クリーンで LLM に適したコンテンツ |
| Exa | はい | — | はい | ニューラル検索/セマンティック検索。academic_search と任意の有料スクレイピングプランにも使用されます |
| Hacker News | HN のみ | — | はい | 設定不要(HN Algolia インデックス)。ウェブ全体ではなく、HN のスレッドを検索します |
| Reddit のみ | — | はい | 設定不要(公開 RSS)。ウェブ全体ではなく、Reddit の投稿を検索します | |
| Bluesky | Bluesky のみ | — | — | 設定不要(公開 AT Protocol API)。ウェブ全体ではなく、Bluesky の投稿を検索します |
| GitHub | GitHub のみ | — | はい | 設定不要(公開 REST Search API)。ウェブ全体ではなく、Issue/PR を検索します |
| Xquik | X/Twitter のみ | — | はい | ウェブ全体ではなく、X の投稿を検索します。XQUIK_API_KEY が必要です |
複数のプロバイダー(推奨)
複数の検索エンジンを設定しておけば、いずれかに問題が発生してもリサーチを続けられます。
export SEARCH_ROUTING=brave,serper,duckduckgo
Brave が停止している場合は、自動的に Serper を試します。Serper がレート制限されている場合は、DuckDuckGo に切り替えます。リサーチをそのまま続けられます。
プロバイダーの詳細な比較(インデックスの分類、機能、無料枠)については docs/PROVIDERS.md を、詳細なルーティングオプション(トピックごとのルーティング、特許に特化したプロバイダーなど)については docs/DEPLOYMENT.md を参照してください。
単一のプロバイダー
検索 API キーが 1 つしかない場合でも問題ありません。設定するだけで利用できます。
プロバイダー設定例
複数プロバイダーのルーティング(推奨):
export SEARCH_ROUTING=brave,serper
export BRAVE_API_KEY=BSAxxxxxxxxxx
export SERPER_API_KEY=...
単一プロバイダー — Brave Search:
export SEARCH_PROVIDER=brave
export BRAVE_API_KEY=BSAxxxxxxxxxx
単一プロバイダー — SearXNG(セルフホスト可能、プライバシー重視):
export SEARCH_PROVIDER=searxng
export SEARXNG_URL=http://localhost:8080
単一プロバイダー — Exa:
export SEARCH_PROVIDER=exa
export EXA_API_KEY=...
単一プロバイダー — Brave:
export SEARCH_PROVIDER=brave
export BRAVE_API_KEY=BSA...
Configuration テーブルにあるプロバイダーはどれも同じ方法で利用できます。SEARCH_PROVIDER と、そのプロバイダーのキーを設定してください。
検索レンズ
検索レンズを使うと、AI が検索できるウェブサイトを制御できます。ウェブ全体を検索してブログやスパム、AI 生成の低品質なコンテンツを取得する代わりに、レンズを使えば、そのトピックで信頼できる情報源だけに検索結果を絞り込めます。
組み込みレンズ
| レンズ | 対象 |
|---|---|
docs | 公式ドキュメントと API リファレンスのみ |
academic | プレプリントサーバー、リポジトリ、オープンアクセスジャーナル |
academic-extended | 中核的なジャーナル索引以外のプレプリントサーバー、OA アグリゲーター、リポジトリ |
biomed | 希少疾患および生物医学のナレッジグラフソース — オントロジーポータル、遺伝子・疾患データベース、キュレーションされた希少疾患レジストリ |
clinical | 臨床試験、医薬品の安全性、エビデンスに基づく医療 |
curriculum | 学術カリキュラムデータ、教育機関の言論の自由に関する環境、世界の教育統計 |
security | CVE、勧告、脆弱性調査 |
investigative_records | 公開記録、企業の提出書類、情報公開請求 |
programming | コードのドキュメント、チュートリアル、Q&A |
programming-goggle | Brave の Programming Goggle によって再ランク付けされた、開発者向けの検索結果 — ドキュメント、リポジトリ、信頼できる技術コンテンツを表示します(Brave が必要です) |
devops | インフラストラクチャと運用 — Kubernetes、Docker、Terraform、クラウド、CI/CD |
news | 時事問題、ジャーナリズム |
tech | テクノロジー業界 |
legal | 法律、判例、法令 |
medical | 健康、医療 |
finance | 市場、提出書類 |
science | 研究、論文 |
government | 政策、規制 |
osint | オープンソースインテリジェンス — 公開記録、企業登記簿、ソーシャルフットプリント、インフラストラクチャ |
awesome-lists | GitHub 上でコミュニティがキュレーションした「awesome-*」リスト — あらゆる分野の、PR レビュー済みのツールとリソースのコレクション |
信頼できるドメインをリストするだけで、どの分野にも対応した独自のレンズを作成できます。
仕組み
あなた(または AI)がレンズを使うと、結果はそのレンズに含まれるサイトからのみ取得されます。たとえば、medical レンズを使うと、AI は PubMed、WHO、NIH などの臨床情報源を検索し、健康ブログやサプリメント広告は検索しません。
AI に依頼すると、レンズは自動的に使われます。たとえば、「clinical レンズを使って、SGLT2 阻害薬に関する最近の知見を検索してください。」 のように依頼できます。
独自のレンズを作成する
カスタムレンズ用のディレクトリを作成し、それぞれのレンズに JSON ファイルを追加します。
{
  "name": "my-industry",
  "description": "Only searches sources I trust for my field",
  "domains": [
    "trusted-source.com",
    "industry-journal.org",
    "official-database.gov"
  ],
  "cx": ""
}
次に、サーバーにレンズディレクトリを指定します。
export CUSTOM_LENSES_PATH=/path/to/my-lenses
これで、AI が使用できるレンズとして my-industry が追加されます。カスタムレンズは組み込みレンズの後に読み込まれるため、組み込みレンズと同じ name を持つカスタムレンズがあれば、そちらが優先されます。レンズごとに最大約 10 個のドメインを追加できます。
高度なオプション(任意 — ほとんどのユーザーは無視できます):
- cx — Google Programmable Search Engine の範囲に限定されたレンズとして指定します。この場合、レンズでは
site:の挿入がスキップされます。そのエンジンをグローバルなGOOGLE_CUSTOM_SEARCH_IDに設定してください。Google の API は 2027-01-01 に終了するため、domainsレンズを推奨します - goggle — サーバー側の再ランク付けに使用する Brave Goggle の URL(Brave のみ)
プライバシーとセキュリティ
調査クエリは、お使いのマシンから選択した検索プロバイダーに直接送信されます。当社のサーバーを経由することはありません(当社はサーバーを運用していません)。ツールはすべてお使いのコンピューター上で実行されます。
個人データを保存する機能(ログイン情報の保存、メモリ、分析、ワークスペース)は、デフォルトでオフになっています。それぞれの機能を有効にするには、オプトイン、同意の記録、暗号化されたストレージが必要です。
技術的なセキュリティの詳細(エンタープライズ/コンプライアンスチーム向け)
- SSRF 対策 — 内部ネットワークへのアクセス、クラウドメタデータのエンドポイント、DNS リバインディング攻撃をブロックします
- OAuth 2.1(HTTP モード)— JWKS トークン検証、テナントごとの分離、オーディエンス/発行者の検証
- レート制限(HTTP モード)— 上流 API を保護するための、テナントごとおよび全体の制限
- コンテンツのサニタイズ — ホワイトリスト方式で HTML をクリーンアップし、重複排除と品質スコアリングを行います
脅威モデルの全文については、docs/SECURITY.md をご覧ください。
各 AI アプリのセットアップ
Claude Code
MCP 設定(~/.claude.json)に追加します。使用するプロバイダーの SEARCH_PROVIDER と対応するキーを設定してください(設定の表を参照)。以下の例では Brave を使用しています。
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
Claude Desktop
~/Library/Application Support/Claude/claude_desktop_config.json(macOS)または %APPDATA%\Claude\claude_desktop_config.json(Windows)に追加します。
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
Cursor
プロジェクトのルートにある .cursor/mcp.json に追加します。
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
HTTP モード(チーム/共有サーバー)
チームで 1 つの共有インスタンスに接続する場合は、次のように設定します。
PORT=3000 \
OAUTH_ISSUER_URL=https://auth.example.com \
OAUTH_AUDIENCE=https://api.example.com \
./web-researcher-mcp
任意の AI アプリを http://localhost:3000/mcp/ に接続します。
Docker Compose の例
services:
  web-researcher:
    image: zoharbabin/web-researcher-mcp
    ports:
      - "3000:3000"
    environment:
      PORT: "3000"
      SEARCH_PROVIDER: brave
      BRAVE_API_KEY: ${BRAVE_API_KEY}
注: ツールの動作はすべての接続モード(STDIO と HTTP)で同一です。違いは認証(HTTP では OAuth が必要)とレート制限(HTTP ではテナントごとの制限が適用され、STDIO では上流 API のクォータのみが適用されます)だけです。詳細は docs/DEPLOYMENT.md を参照してください。
パフォーマンス
検索結果は 1 秒未満で返されます。以前に取得した結果はキャッシュされるため、再検索は瞬時に完了します。ウェブ上の記事の 95%以上を完全に抽出でき、ボットをブロックしようとするサイトにも対応しています。JavaScript を多用するサイトでは、バックグラウンドで実際のブラウザーを使用します(自動で動作し、設定は不要です)。
開発
go build -o web-researcher-mcp ./cmd/web-researcher-mcp   # Build
go test -race ./...                                        # Test (with race detector)
make verify                                                # Full CI gate (see Makefile for steps)
lint、gosec、govulncheck の各ツールは go.mod のツールディレクティブでバージョンが固定されているため、make verify を実行すると CI と同じバージョンで実行されます(グローバルへのインストールは不要です)。ブランチ保護では、Lint、Test、Security、E2E の各チェックへの合格が必須です。
開発ワークフロー、コードスタイルガイド、PR の手順については、CONTRIBUTING.md を参照してください。
トラブルシューティング
サーバーは起動するが、ツールで「API key」エラーが発生する
MCP ハンドシェイクを行えるよう、認証情報が不足していてもサーバーは起動します。API キーはシェルのプロファイルではなく、MCP クライアント設定の env ブロックに設定してください。
一部のページが空で返される
JavaScript を多用するサイトでは、ツールは実際のブラウザー(Chromium)を使用します。バイナリーをインストールした場合、初回使用時に自動でダウンロードされます(約 200MB)。Chrome がすでにインストールされている場合は、CHROME_PATH にそのパスを設定してください。Docker イメージには Chromium が同梱されており(CHROME_PATH は設定済み)、ダウンロードなしで JavaScript をレンダリングできます。
アップグレード後もキャッシュから古い結果が返される
ディスクキャッシュは OS のキャッシュディレクトリにあります(例:macOS では ~/Library/Caches/web-researcher-mcp/、Linux では ~/.cache/web-researcher-mcp/)。このディレクトリを削除してキャッシュをクリアするか、CACHE_DIR に任意のパスを設定してください。
検索制限に達する(429 エラー)
プロバイダーの無料枠を使い切った場合:
- 別のプロバイダーに切り替えてください。
SEARCH_PROVIDERに他の選択肢を設定できます(設定を参照)。それぞれに独自の無料枠があります - 複数のプロバイダーを設定してください(例:
SEARCH_ROUTING=brave,serper)。1 つがレート制限に達すると、自動的に次のプロバイダーに切り替わります - または、プロバイダーのプランをアップグレードしてください
macOS:「Failed to reconnect」/手動アップデート後にエラー -32000 が発生する
既存のファイルに新しいバイナリーを上書きコピーした場合にのみ発生します(cp new /path/to/web-researcher-mcp)。Apple Silicon では、macOS がファイルに対するバイナリーのアドホックコード署名をキャッシュするため、ファイルをその場で上書きすると、次回の起動時にプロセスが開始前に強制終了されることがあります。公式インストーラー(Homebrew、1 コマンドで実行できる install.sh、Claude Code プラグイン)は、新しいファイルにインストールすることでこれを回避しています。手動インストールを修正するには、ファイルを正しく置き換えて再署名してください。
rm -f /path/to/web-researcher-mcp
cp /path/to/new-build /path/to/web-researcher-mcp
codesign --force -s - /path/to/web-researcher-mcp   # ad-hoc re-sign
その後、クライアントを再接続してください。(install.sh を再実行すれば、正しく処理されます。)
コントリビューション
コントリビューションを歓迎します。コードスタイルのガイドライン、開発ワークフロー、プルリクエストの提出方法については、CONTRIBUTING.mdをご覧ください。
ドキュメント
| ドキュメント | 説明 |
|---|---|
| ARCHITECTURE.md | 設計上の決定、技術スタック、依存関係 |
| CONTRIBUTING.md | 開発環境のセットアップ、コードスタイル、PR のワークフロー |
| docs/TOOLS.md | ツールの仕様とパラメータのスキーマ |
| docs/EXAMPLES.md | JSON ツール呼び出しの使用例 |
| docs/API_SETUP.md | すべてのプロバイダー向け検索プロバイダー API キーの設定 |
| docs/SECURITY.md | 脅威モデル、SSRF、認証、コンプライアンス(SOC2/GDPR/FedRAMP) |
| docs/PRIVACY.md | データの送信先、サードパーティの処理業者、保持期間 |
| docs/DEPLOYMENT.md | ビルド、Docker、Kubernetes、クライアント設定、スケーリング |
| docs/PYTHON_CLIENT.md | Python SDK — WebResearcherClient リファレンス、同期ラッパー、インストール |
| docs/LESSONS_LEARNED.md | Node.js から Go への移行の経緯と学び |
| docs/SESSION_PERSISTENCE.md | コンテキストが失われてもセッションを維持する方法 — 設計、データフロー、引用 |
| docs/MIGRATION.md | 非推奨の google-researcher-mcp からの移行 |
ライセンス
Zohar Babin が Go と Model Context Protocol を使用して開発
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。